第一篇收了 41 张图,评论区(其实就是我自己复盘)发现问题:不是每张图都带了绘图代码。这一篇补上,并且把版图扩到上一篇没碰的领域——群体遗传与 GWAS、比较基因组、基因家族、微生物组、单细胞轨迹、WGCNA、生化曲线、机器学习、品种试验和蛋白结构模拟,共 33 张新图,编号接着第一篇从 42 排到 74。测序 QC、GWAS 精细定位、Hi-C 与空间组学放在第三篇,蛋白、生态与 AI 多组学放在第四篇。
规则与第一篇一致:每张图四段式(回答什么问题、怎么读、用什么画、图注示例),图下默认折叠的「展开查看」块里是数据加完整绘图代码。区别在于:点云类大图(曼哈顿、共线性点阵、拟时序等)的数据由代码现场生成,折叠块里就是生成代码本身——代码即数据源;表格类图照旧给原样 CSV。全部图仍是 WSL 里 Python 3.14 + matplotlib 渲染的模拟数据,带水印,脚本在仓库 tools/bio-plots/ch9*_more.py。
本系列已出七篇:第一篇(41 张,统计与转录组临床) · 第二篇(33 张,群体遗传与基因组) · 第三篇(29 张,测序、表观与空间组学) · 第四篇(30 张,蛋白、生态与 AI 多组学) · 第五篇(40 张,蛋白结构、变异与表达验证,含真实 PDB 结构与交互 3D) · 第六篇(22 张,真实公开数据实战) · 第七篇(190 张图 Nature 风格重构与方法选型)。
自推一句:本篇的变异统计、序列指标、基因家族比对,在我主导开发的 Linxira Bio SDK(本地优先的生信执行工具链)里有对应能力:正式分支已发布 v1.0.1,提供
variant stats、sequence stats、interval intersect等 CLI 与 35 个 agent skills,另有官网与我的拆解文。免责声明:本文所有配图均为模拟数据的教学演示;SDK 实际可用的分析能力,请以仓库正式分支的最新 release 为准——文中部分图对应的分析尚在开发路线中,目前仅存在于本地开发分支,未合并进正式分支、代码未公开。
一、地图
{% mermaid %} flowchart LR START([“第二篇 · 33 张”]):::hub subgraph A[“① 群体遗传 GWAS”] direction TB A1[“曼哈顿 · QQ · LD 衰减”] A2[“ADMIXTURE · 树 · pi/Fst”] end subgraph B[“② 比较基因组”] direction TB B1[“共线性点阵 · Ka/Ks”] B2[“基因定位 · Circos · 密度”] end subgraph C[“③ 基因家族”] direction TB C1[“Motif logo · 基因结构 · MSA”] end subgraph D[“④ 微生物 单细胞”] direction TB D1[“PCoA · 多样性 · 丰度堆叠”] D2[“拟时序 · 点图”] end subgraph E[“⑤ 网络 生化”] direction TB E1[“PPI 网络 · 模块性状”] E2[“IC50 · 米氏 · 凝胶 · 生长”] end subgraph F[“⑥ 评估 育种 结构”] direction TB F1[“PR · 混淆 · 碎石 · 雷达”] F2[“GGE · 拉氏 · RMSD”] end START —> A —> B —> C —> D —> E —> F classDef hub fill:#1f4e79,color:#fff,font-weight:bold {% endmermaid %}
速查表先过一遍,四张表按章节分。
表 1 群体遗传与比较基因组
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| 曼哈顿图 | 哪个位点与性状关联 | 染色体位置 | -log10(p) | CMplot |
| QQ 图 | 关联分析有无膨胀 | 期望 -log10(p) | 观测 -log10(p) | CMplot |
| LD 衰减图 | 连锁不平衡衰减多快 | 物理距离 | r2 | PopLDdecay |
| ADMIXTURE 图 | 群体由几个祖先成分构成 | 个体 | 祖先成分比例 | ADMIXTURE |
| 系统发育树 | 谁和谁亲缘近 | 遗传距离 | 物种或材料 | MEGA/iTOL |
| 滑窗 pi/Fst | 多样性与分化在哪异常 | 窗口位置 | pi 与 Fst 双轨 | VCFtools |
| 共线性点阵 | 两基因组怎么对上 | 物种 A 位置 | 物种 B 位置 | MCScanX |
| Ka/Ks 分布 | 新基因进化压力多大 | Ka/Ks | 基因对数 | KaKs_Calculator |
| 染色体定位图 | 基因家族铺在哪 | 无 | 染色体示意 | MapChart |
| Circos 圈图 | 多染色体关系总览 | 弧段 | 风扇带与散点 | circos |
| 基因密度图 | 基因沿染色体疏密 | 染色体位置 | 每窗基因数 | 自绘 |
表 2 基因家族、微生物与单细胞
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| Motif logo | 保守基序每位偏好什么碱基 | 基序位置 | 碱基概率 | MEME |
| 基因结构图 | 外显子内含子怎么排 | 基因组位置 | 基因 | GSDS |
| MSA 保守性图 | 比对各位多保守 | 比对位置 | 一致性比例 | Jalview |
| PCoA | 群落组成按什么分开 | PCo1 | PCo2+椭圆 | QIIME2 |
| Alpha 多样性 | 各组多样性高低 | 分组 | Shannon 指数 | QIIME2 |
| 丰度堆叠图 | 群落由谁构成 | 样本 | 相对丰度 | QIIME2 |
| 拟时序轨迹 | 细胞沿哪条路成熟 | 成分 1 | 成分 2+拟时序 | Monocle3 |
| 基因点图 | 基因在哪群表达 | 群 | 基因,点大小与颜色双编码 | scanpy |
表 3 网络、生化、评估与育种
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| PPI 网络图 | 谁和谁互作、谁是枢纽 | 无 | 节点度 | Cytoscape |
| 模块-性状热图 | WGCNA 模块关联哪个性状 | 性状 | 模块,颜色=r | WGCNA |
| 剂量响应曲线 | 药多强(IC50) | 剂量(log) | 响应率 | GraphPad |
| 米氏动力学 | 酶的 Km 与 Vmax | 底物浓度 | 反应速度 | GraphPad |
| 凝胶电泳图 | 酶切或 PCR 对不对 | 泳道 | 分子量 | 手绘 |
| 生长曲线 | 菌株长多快多好 | 时间 | OD600 | 手绘 |
| PR 曲线 | 类别不平衡下模型多好 | recall | precision | sklearn |
| 混淆矩阵 | 错都错在哪 | 预测类 | 真实类 | sklearn |
| 碎石图 | 保留几个主成分 | 主成分 | 特征值 | FactoMineR |
| 特征重要性 | 哪些变量最管用 | 重要性 | 特征 | sklearn |
| 雷达图 | 品种多性状综合比较 | 性状轴 | 得分 | 手绘 |
| GGE 双标图 | 品种在哪个环境表现好 | GGE PC1 | GGE PC2 | GenStat |
| 拉氏图 | 二面角落不落允许区 | phi | psi | PyMOL |
| RMSD 曲线 | 分子动力学平衡没平衡 | 模拟时间 | RMSD | VMD/GROMACS |
二、群体遗传与 GWAS
2.1 曼哈顿图
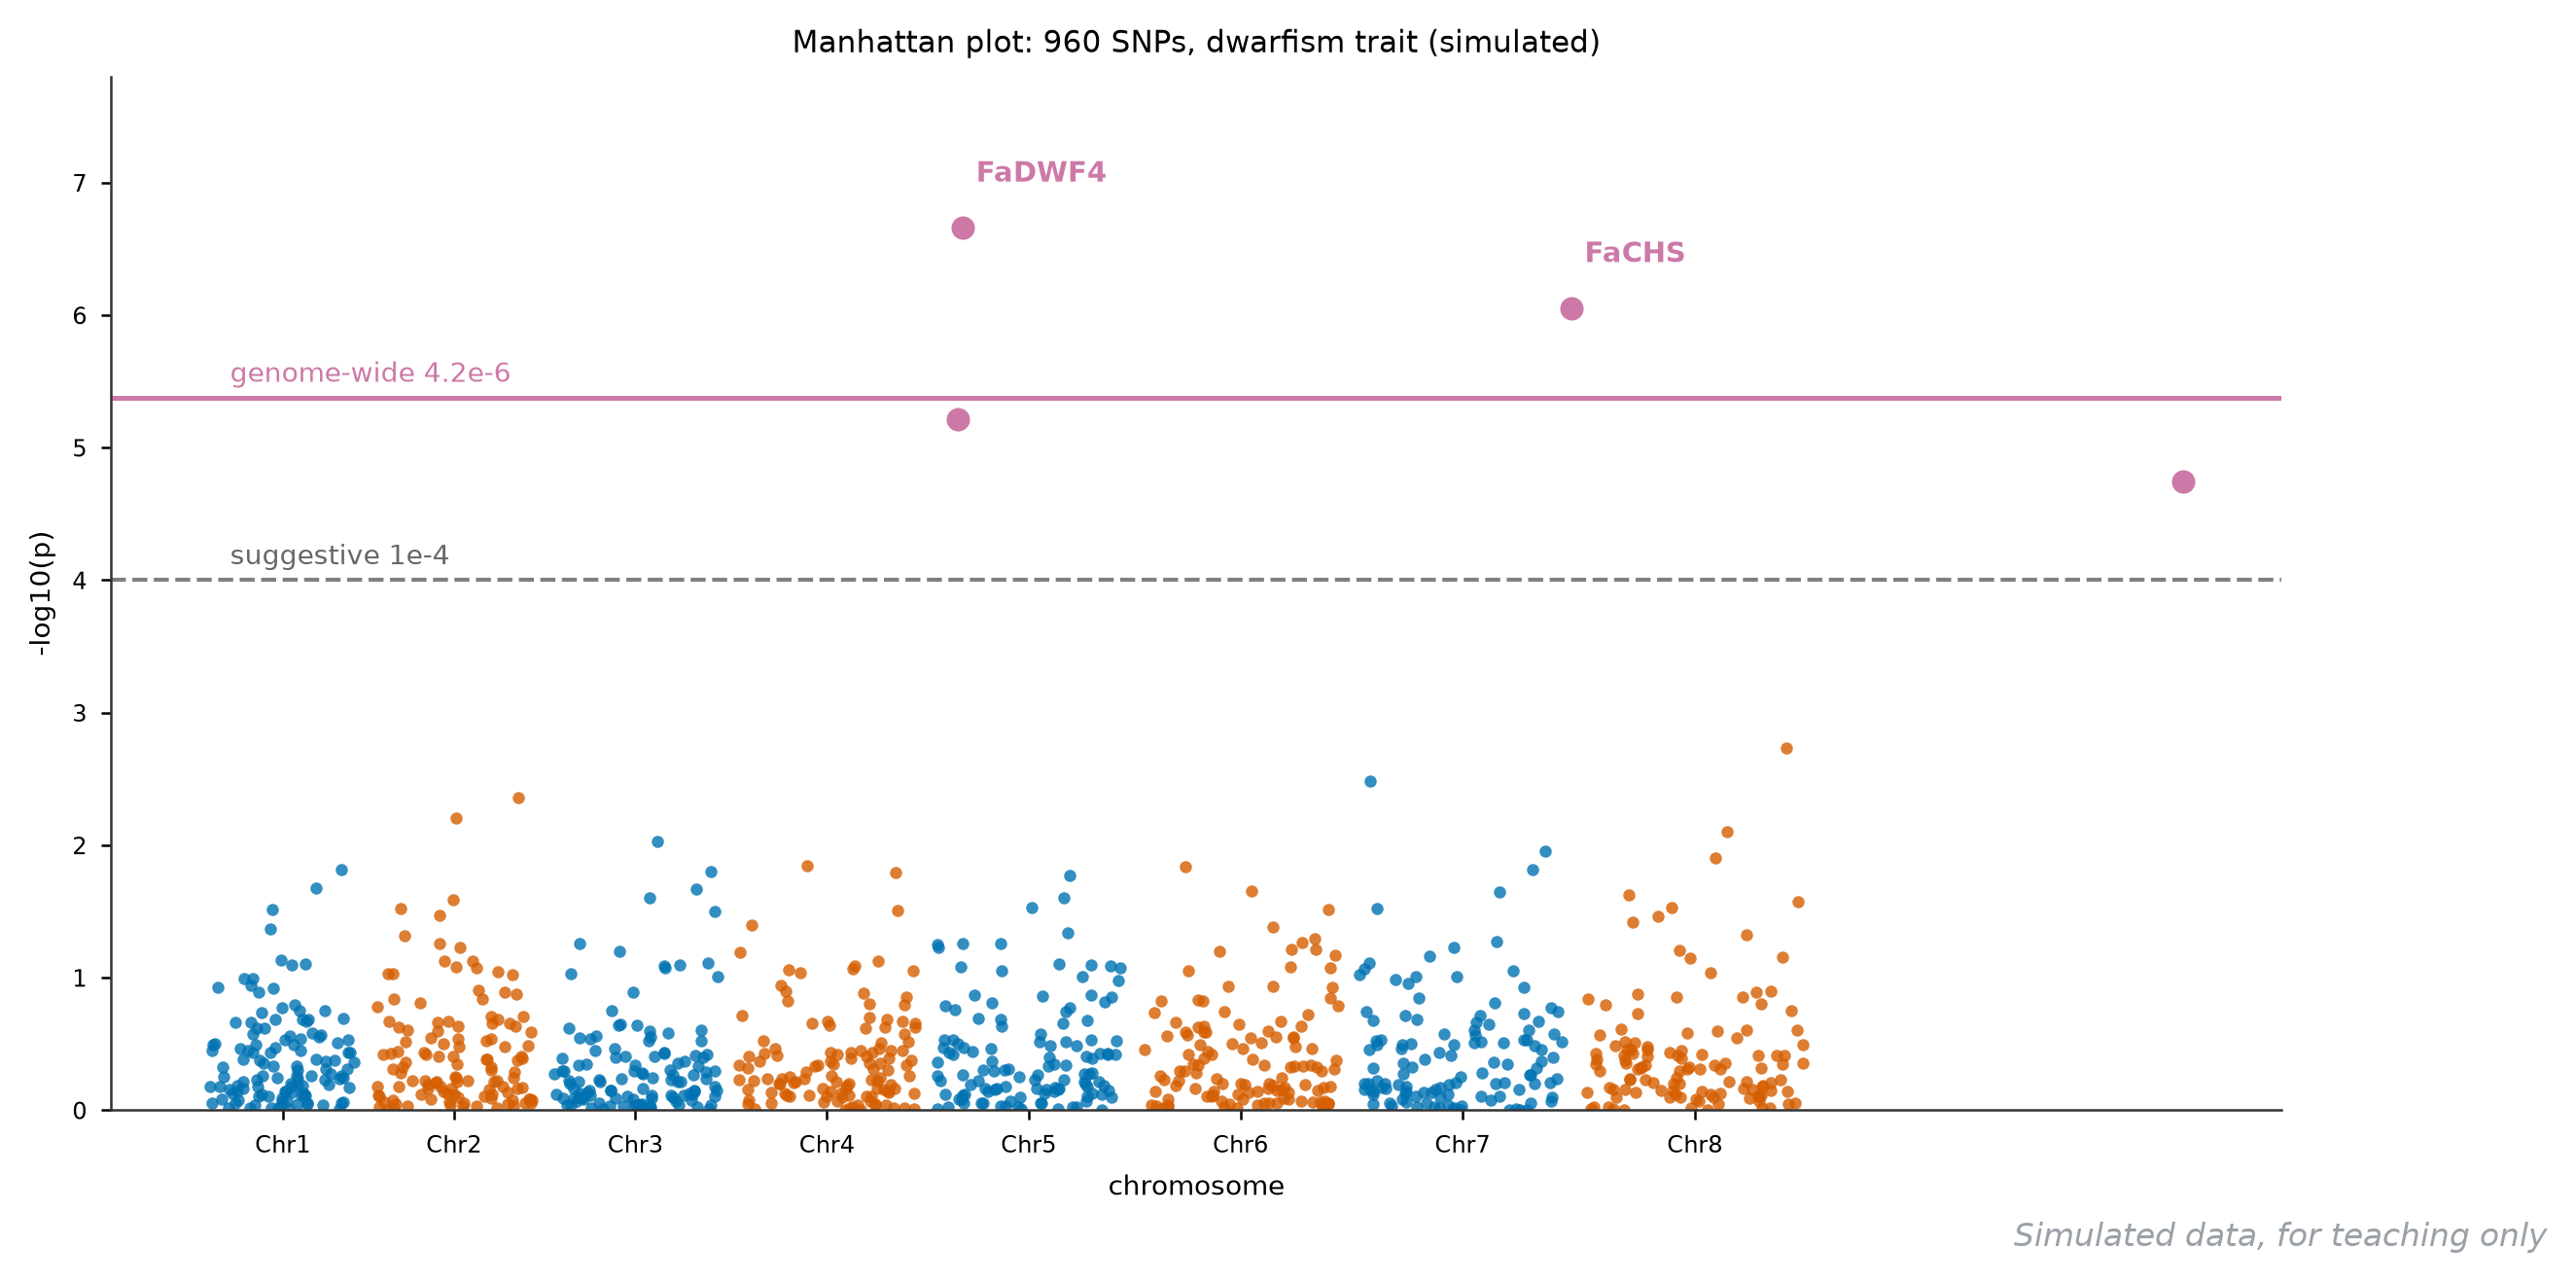
它回答什么问题:全基因组几十万个位点里,哪几个与性状显著关联——GWAS 的招牌图,也是群体重测序流程的终点站。
怎么读:每个点一个 SNP,横轴按染色体从左到右排(颜色交替方便辨认染色体边界),纵轴 -log10(p)。红色实线是全基因组显著阈值(Bonferroni 校正,本例 4.2e-6),灰色虚线是 suggestive 阈值 1e-4。看点两处:显著线以上的孤立大点(FaDWF4、FaCHS,直接进结论)和成片抬升的「山包」(暗示可能存在多个连锁位点或群体结构干扰)。这张模拟数据里 Chr5 的山包上有两个连续高信号点,值得圈进候选区间。
用什么画:R 语言 CMplot 一行出发表级图;Python 用 matplotlib 按染色体分段 scatter。
图注示例:
图 42 矮秆性状的全基因组关联曼哈顿图(960 个背景 SNP 加 4 个显著位点,模拟)。横轴为 8 条染色体的物理位置,纵轴为 -log10(p);红色实线为 Bonferroni 全基因组显著阈值,FaDWF4 与 FaCHS 位点达到显著水平。
展开查看:显著位点数据与完整绘图代码
chr,pos_kb,pvalue,gene
3,1210,2.20e-07,FaDWF4
5,1875,8.90e-07,FaCHS
3,1195,6.10e-06,FaBRI1
7,2430,1.80e-05,FaANS
绘图代码(Python,独立可运行;背景 960 个 SNP 由代码生成,随机种子固定)
# 数据:显著位点见上方 CSV;背景点由固定种子随机生成,代码即数据源
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(2026)
sig = [(3, 1210, 2.2e-7), (5, 1875, 8.9e-7), (3, 1195, 6.1e-6), (7, 2430, 1.8e-5)]
chr_len = {c: 400 + c * 30 for c in range(1, 9)}
pts = [(c, int(x), rng.uniform(1e-4, 1))
       for c in range(1, 9)
       for x in np.sort(rng.uniform(0, chr_len[c], 120))]
fig, ax = plt.subplots(figsize=(9.6, 4.6))
xoff, xt = 0, []
for c in range(1, 9):
    sub = np.array([[p, -np.log10(q)] for cc, p, q in pts if cc == c])
    ax.scatter(sub[:, 0] + xoff, sub[:, 1], s=9,
               color="#4C72B0" if c % 2 else "#DD8452", alpha=0.8)
    ss = np.array([[p, -np.log10(q)] for cc, p, q in sig if cc == c])
    ax.scatter(ss[:, 0] + xoff, ss[:, 1], s=42, color="#C44E52",
               edgecolors="white", zorder=4)
    xt.append(xoff + chr_len[c] / 2)
    xoff += chr_len[c] + 60
ax.axhline(-np.log10(1e-4), color="0.5", ls="--", lw=1)
ax.text(60, -np.log10(1e-4) + 0.12, "suggestive 1e-4", fontsize=8.5, color="0.4")
ax.axhline(-np.log10(4.2e-6), color="#C44E52", lw=1.2)
ax.text(60, -np.log10(4.2e-6) + 0.12, "genome-wide 4.2e-6", fontsize=8.5,
        color="#C44E52")
for g, c, pos, p in [("FaDWF4", 3, 1210, 2.2e-7), ("FaCHS", 5, 1875, 8.9e-7)]:
    x = sum(chr_len[i] + 60 for i in range(1, c)) + pos
    ax.annotate(g, (x, -np.log10(p)), (x + 40, -np.log10(p) + 0.35),
                fontsize=9, fontweight="bold", color="#C44E52")
ax.set_xticks(xt, ["Chr%d" % c for c in range(1, 9)])
ax.set_ylim(0, 7.8)
ax.set_xlabel("chromosome")
ax.set_ylabel("-log10(p)")
ax.set_title("Manhattan plot: 960 SNPs, dwarfism trait (simulated)")
fig.savefig("42-manhattan.png", dpi=200, bbox_inches="tight")
2.2 QQ 图
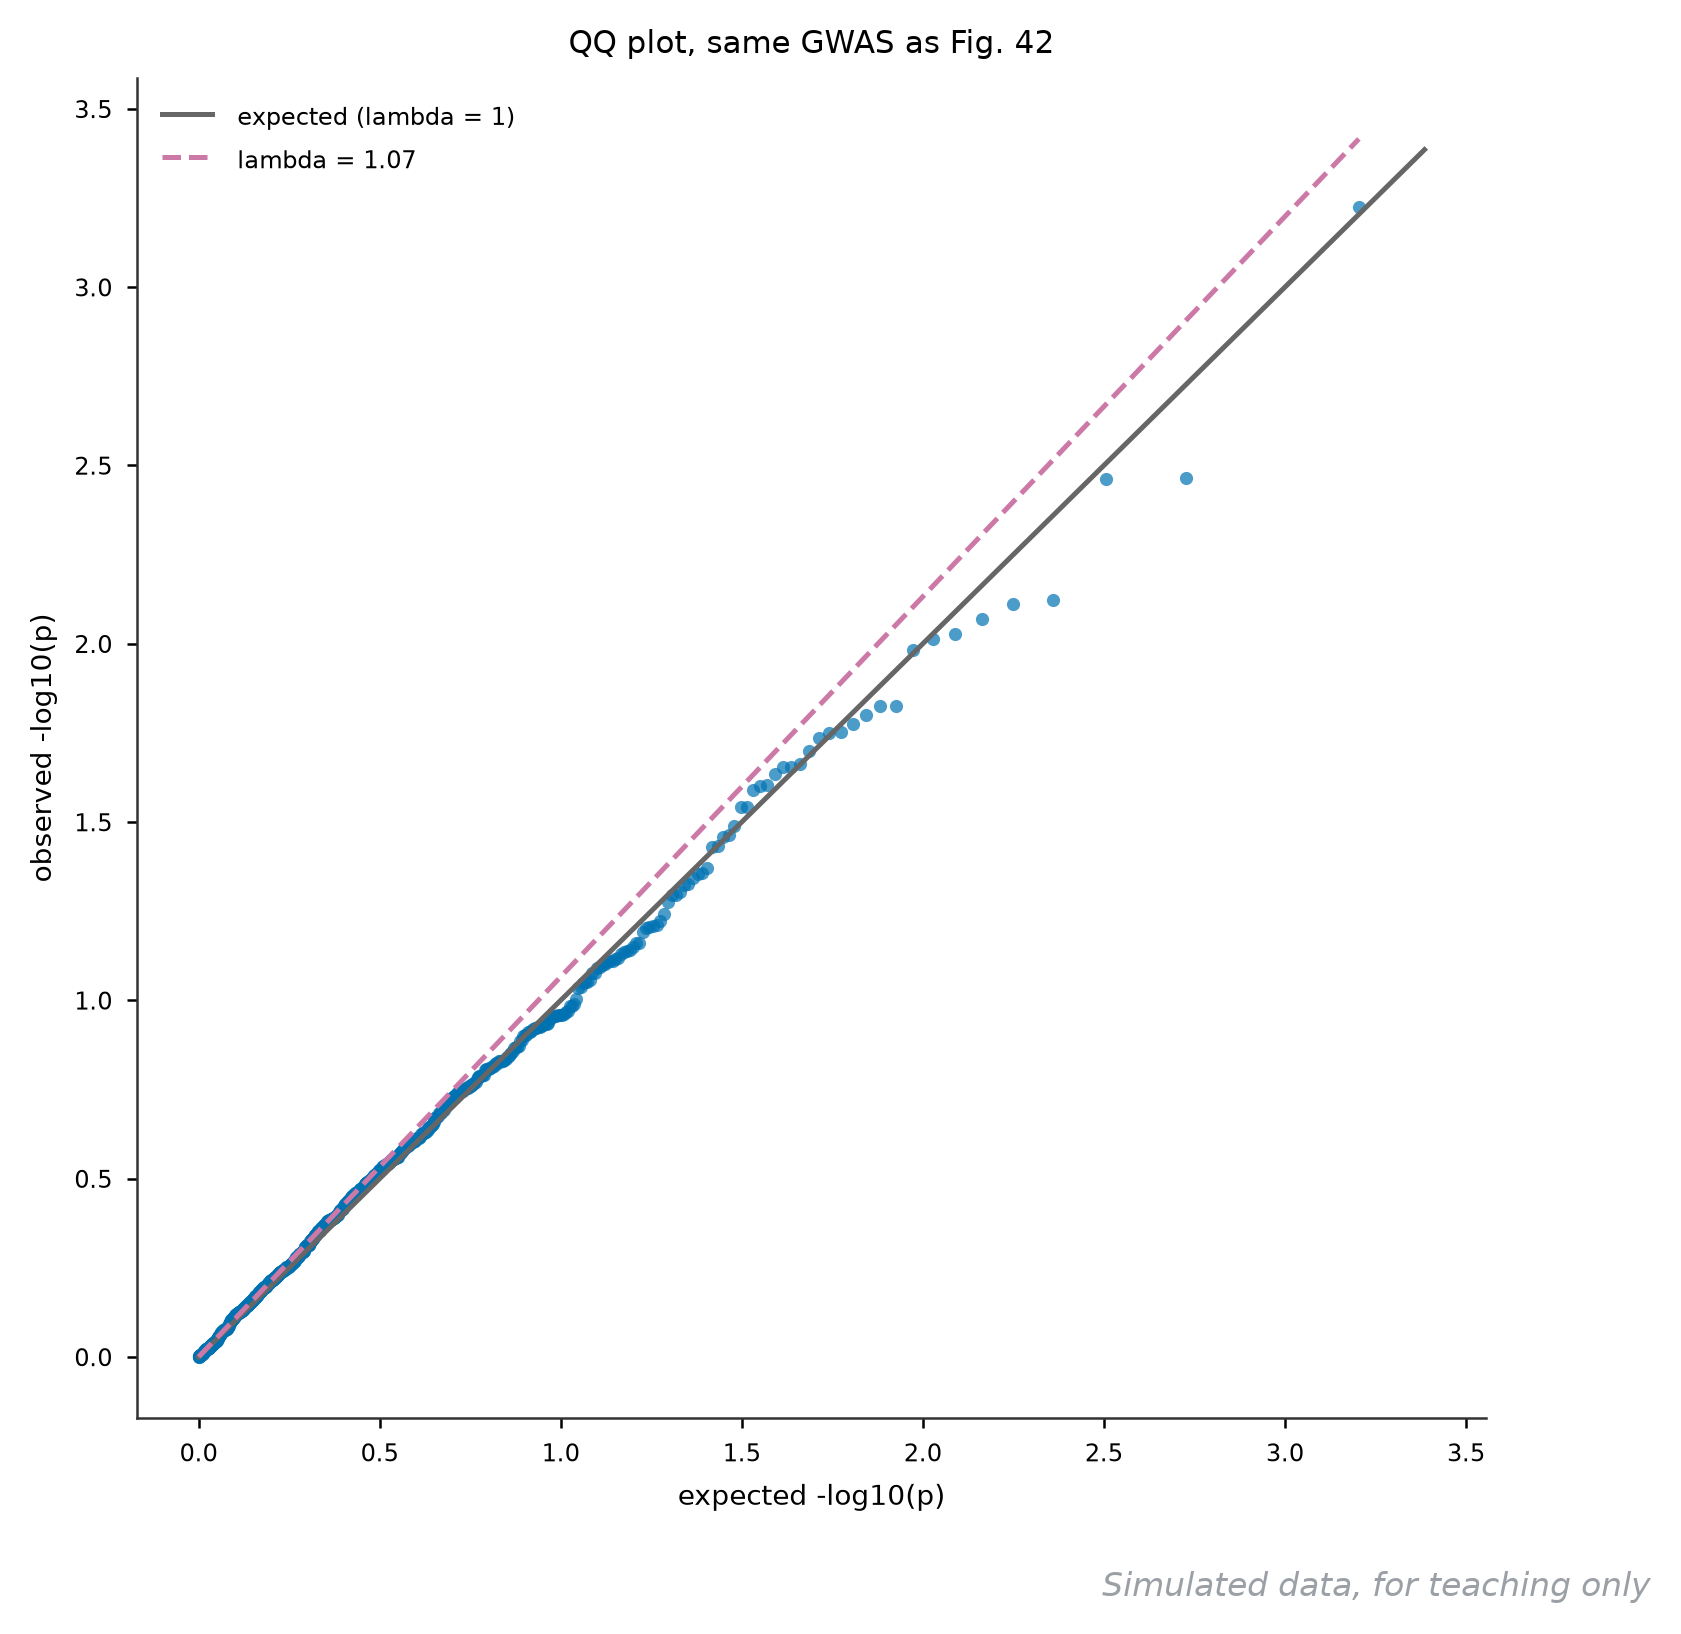
它回答什么问题:关联分析的 p 值分布是否符合「大多数是背景、少数是真信号」的预期——曼哈顿图的质检搭档,检查群体结构有没有把全图抬高。
怎么读:横轴是 p 值从小到大排的期望分位数,纵轴是观测值,都取 -log10。理想状态下点贴着对角线走,尾巴右侧翘起的部分是真信号。如果整条点云离开对角线、像被整体抬高,说明有基因组膨胀(inflation),要用 genomic control 或混合模型校正。量化指标是 lambda:中位观测卡方除以理论中位 0.4549,1.0 最好,超过 1.1 就要警惕。
用什么画:R 语言 qqman::qq;Python 用 scipy.stats.chi2 算分位数后手绘。
图注示例:
图 43 与图 42 同一 GWAS 的 QQ 图。lambda 基因组膨胀因子为 1.07,处于可接受范围(小于 1.1);尾部离群点对应显著关联信号(模拟数据演示)。
展开查看:完整绘图代码(含数据生成)
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

rng = np.random.default_rng(2026)
chr_len = {c: 400 + c * 30 for c in range(1, 9)}
for c in range(1, 9):
    # 同步随机流:消耗与曼哈顿图相同的随机数,使数据与文中图完全一致
    rng.uniform(0, chr_len[c], 120)
    rng.uniform(1e-4, 1, 120)
n = 800
p = rng.uniform(1e-6, 1, n)
chi2_obs = stats.chi2.isf(p, 1)
lam = np.median(chi2_obs) / 0.4549          # 基因组膨胀因子
chi2_exp = stats.chi2.ppf((np.arange(n) + 0.5) / n, 1)
ox = -np.log10(1 - stats.chi2.cdf(chi2_exp, 1))
oy = -np.log10(1 - stats.chi2.cdf(np.sort(chi2_obs), 1))
fig, ax = plt.subplots(figsize=(5.8, 5.8))
ax.scatter(ox, oy, s=10, color="#4C72B0", alpha=0.7)
lim = max(ox.max(), oy.max()) * 1.05
ax.plot([0, lim], [0, lim], color="0.4", lw=1.2, label="expected (lambda = 1)")
ax.plot(ox, ox * lam, "--", color="#C44E52", lw=1.2,
        label="lambda = %.2f" % lam)
ax.set_xlabel("expected -log10(p)")
ax.set_ylabel("observed -log10(p)")
ax.set_title("QQ plot, same GWAS as Fig. 42")
ax.legend(loc="upper left")
fig.savefig("43-qq.png", dpi=200, bbox_inches="tight")
2.3 LD 衰减图
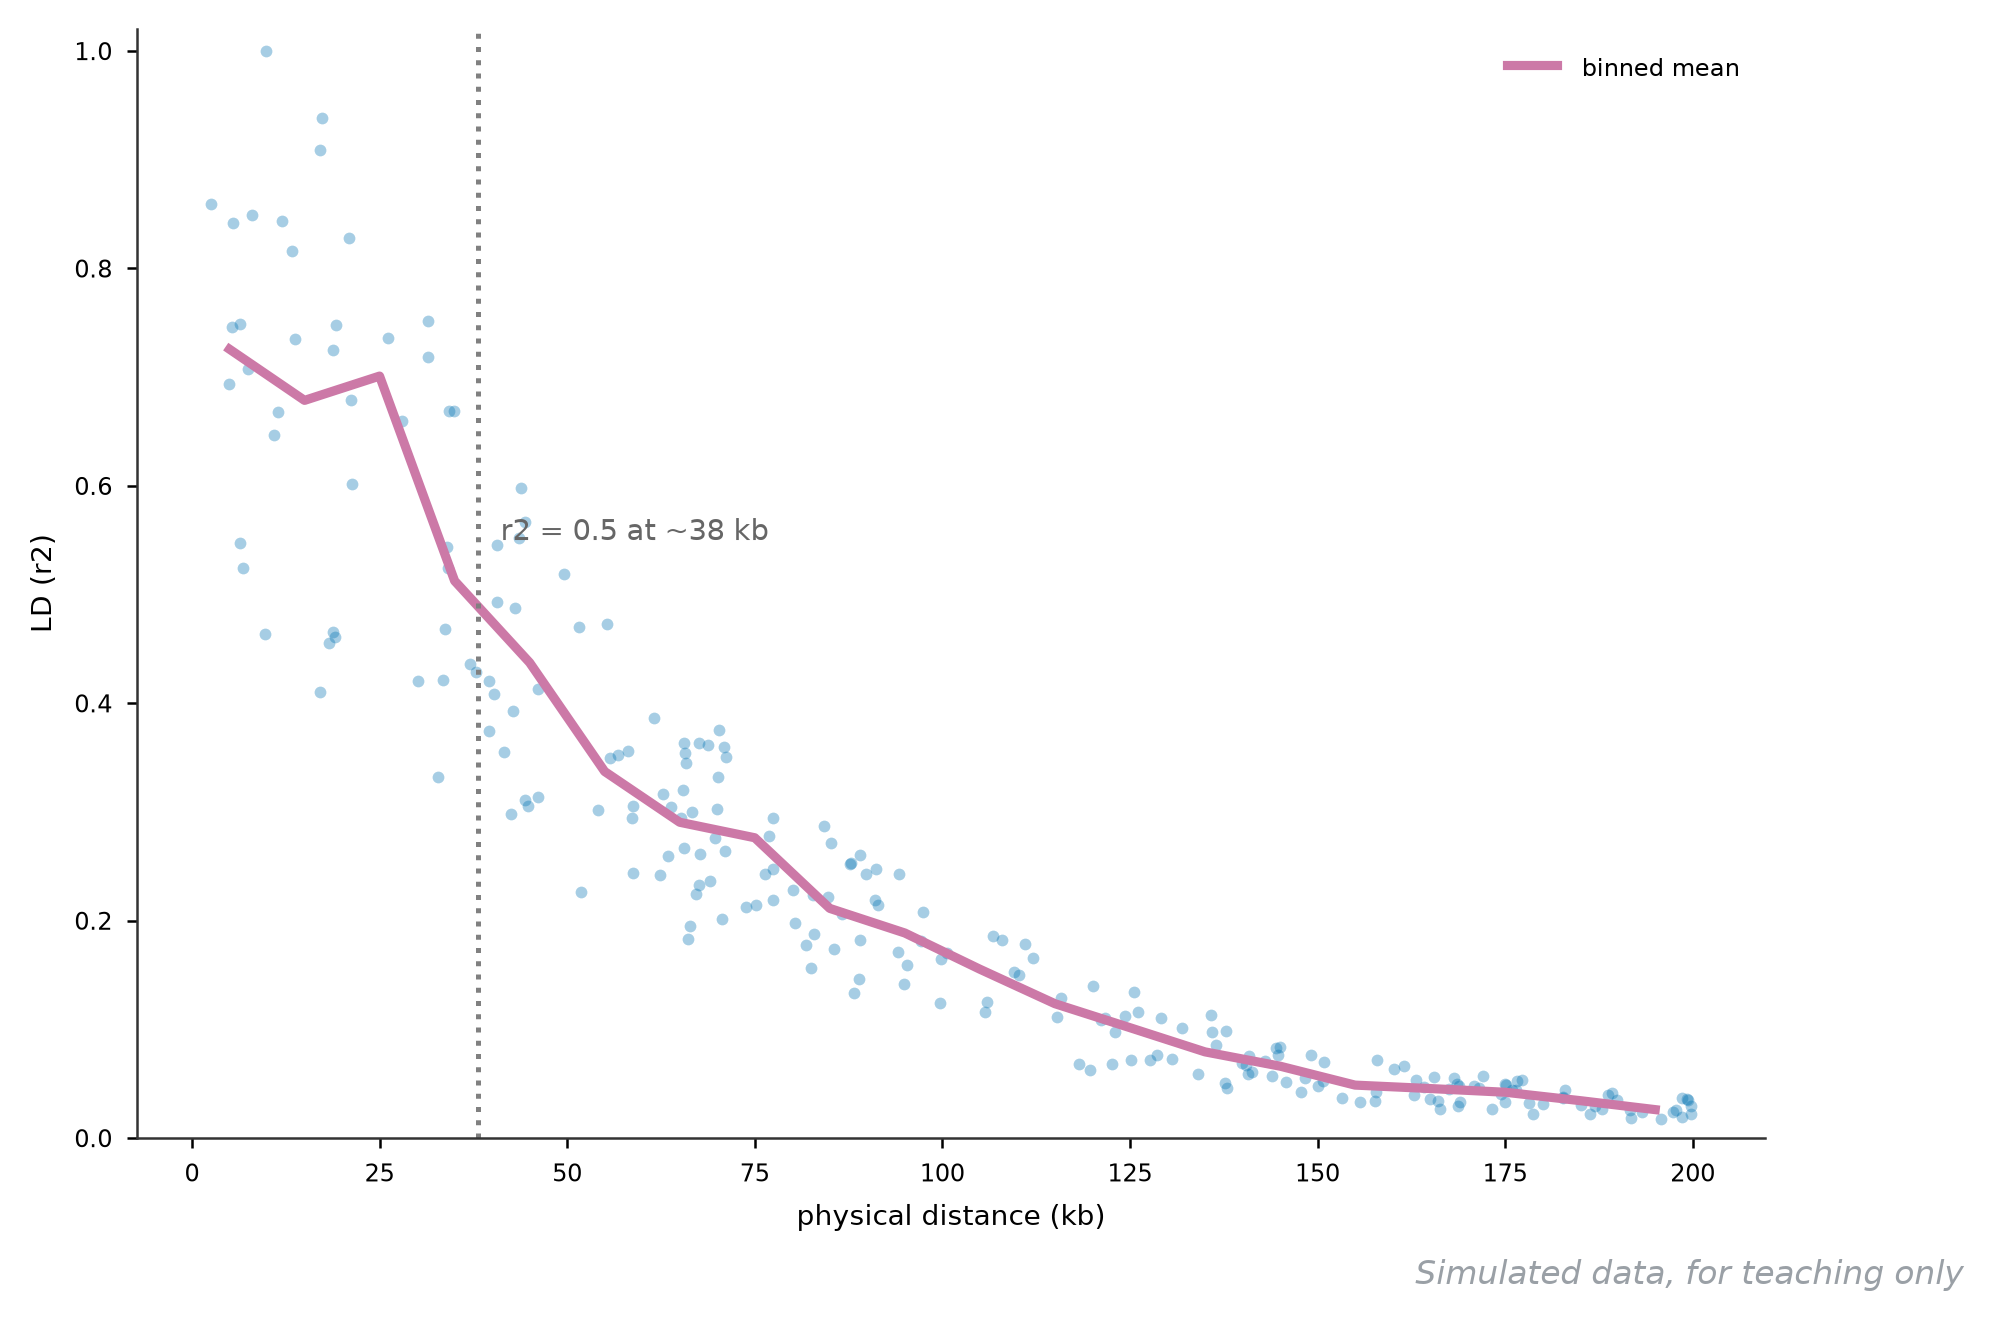
它回答什么问题:连锁不平衡随物理距离衰减多快——决定 GWAS 分辨率(衰减快=定位准)和显著位点该往上下游找多远。
怎么读:横轴是 SNP 对之间的物理距离,纵轴 r2(可由 0 衰减到 1),散点是每一对 SNP 的实测 r2,红线是按距离分箱后的均值。最常用的报告值是「r2 衰减到一半(0.5)时的距离」,这张模拟数据约 38 kb,含义是 38 kb 内的标记才互相「代表」。两个群体各画一条线做对比时,衰减快的那条说明历史重组多、有效群体大。
用什么画:PopLDdecay 算 r2,R 语言或 Python 画散点加分箱均值线。
图注示例:
图 44 群体连锁不平衡衰减曲线。散点为 SNP 对的 r2,红线为每 10 kb 分箱均值;r2 衰减至 0.5 的距离约 38 kb(模拟数据演示)。
展开查看:分箱数据与完整绘图代码
distance_kb,mean_r2
5,0.726
15,0.678
25,0.701
35,0.512
45,0.437
55,0.337
65,0.290
75,0.276
85,0.211
95,0.189
105,0.155
115,0.123
125,0.101
135,0.079
145,0.066
155,0.049
165,0.045
175,0.042
185,0.034
195,0.026
绘图代码(Python,独立可运行;散点由代码生成)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("44-lddecay.csv")
rng = np.random.default_rng(2026)
d = rng.uniform(0.5, 200, 240)                      # 背景散点
r2 = np.clip(np.exp(-d / 55) * rng.uniform(0.55, 1.35, len(d)), 0.01, 1)
fig, ax = plt.subplots(figsize=(7.0, 4.8))
ax.scatter(d, r2, s=8, color="#4C72B0", alpha=0.35)
ax.plot(df.distance_kb, df.mean_r2, color="#C44E52", lw=2.2, label="binned mean")
ax.axvline(38, color="0.5", ls=":", lw=1.2)
ax.text(41, 0.55, "r2 = 0.5 at ~38 kb", fontsize=9, color="0.4")
ax.set_xlabel("physical distance (kb)")
ax.set_ylabel("LD (r2)")
ax.legend()
fig.savefig("44-lddecay.png", dpi=200, bbox_inches="tight")
2.4 ADMIXTURE 群体结构图
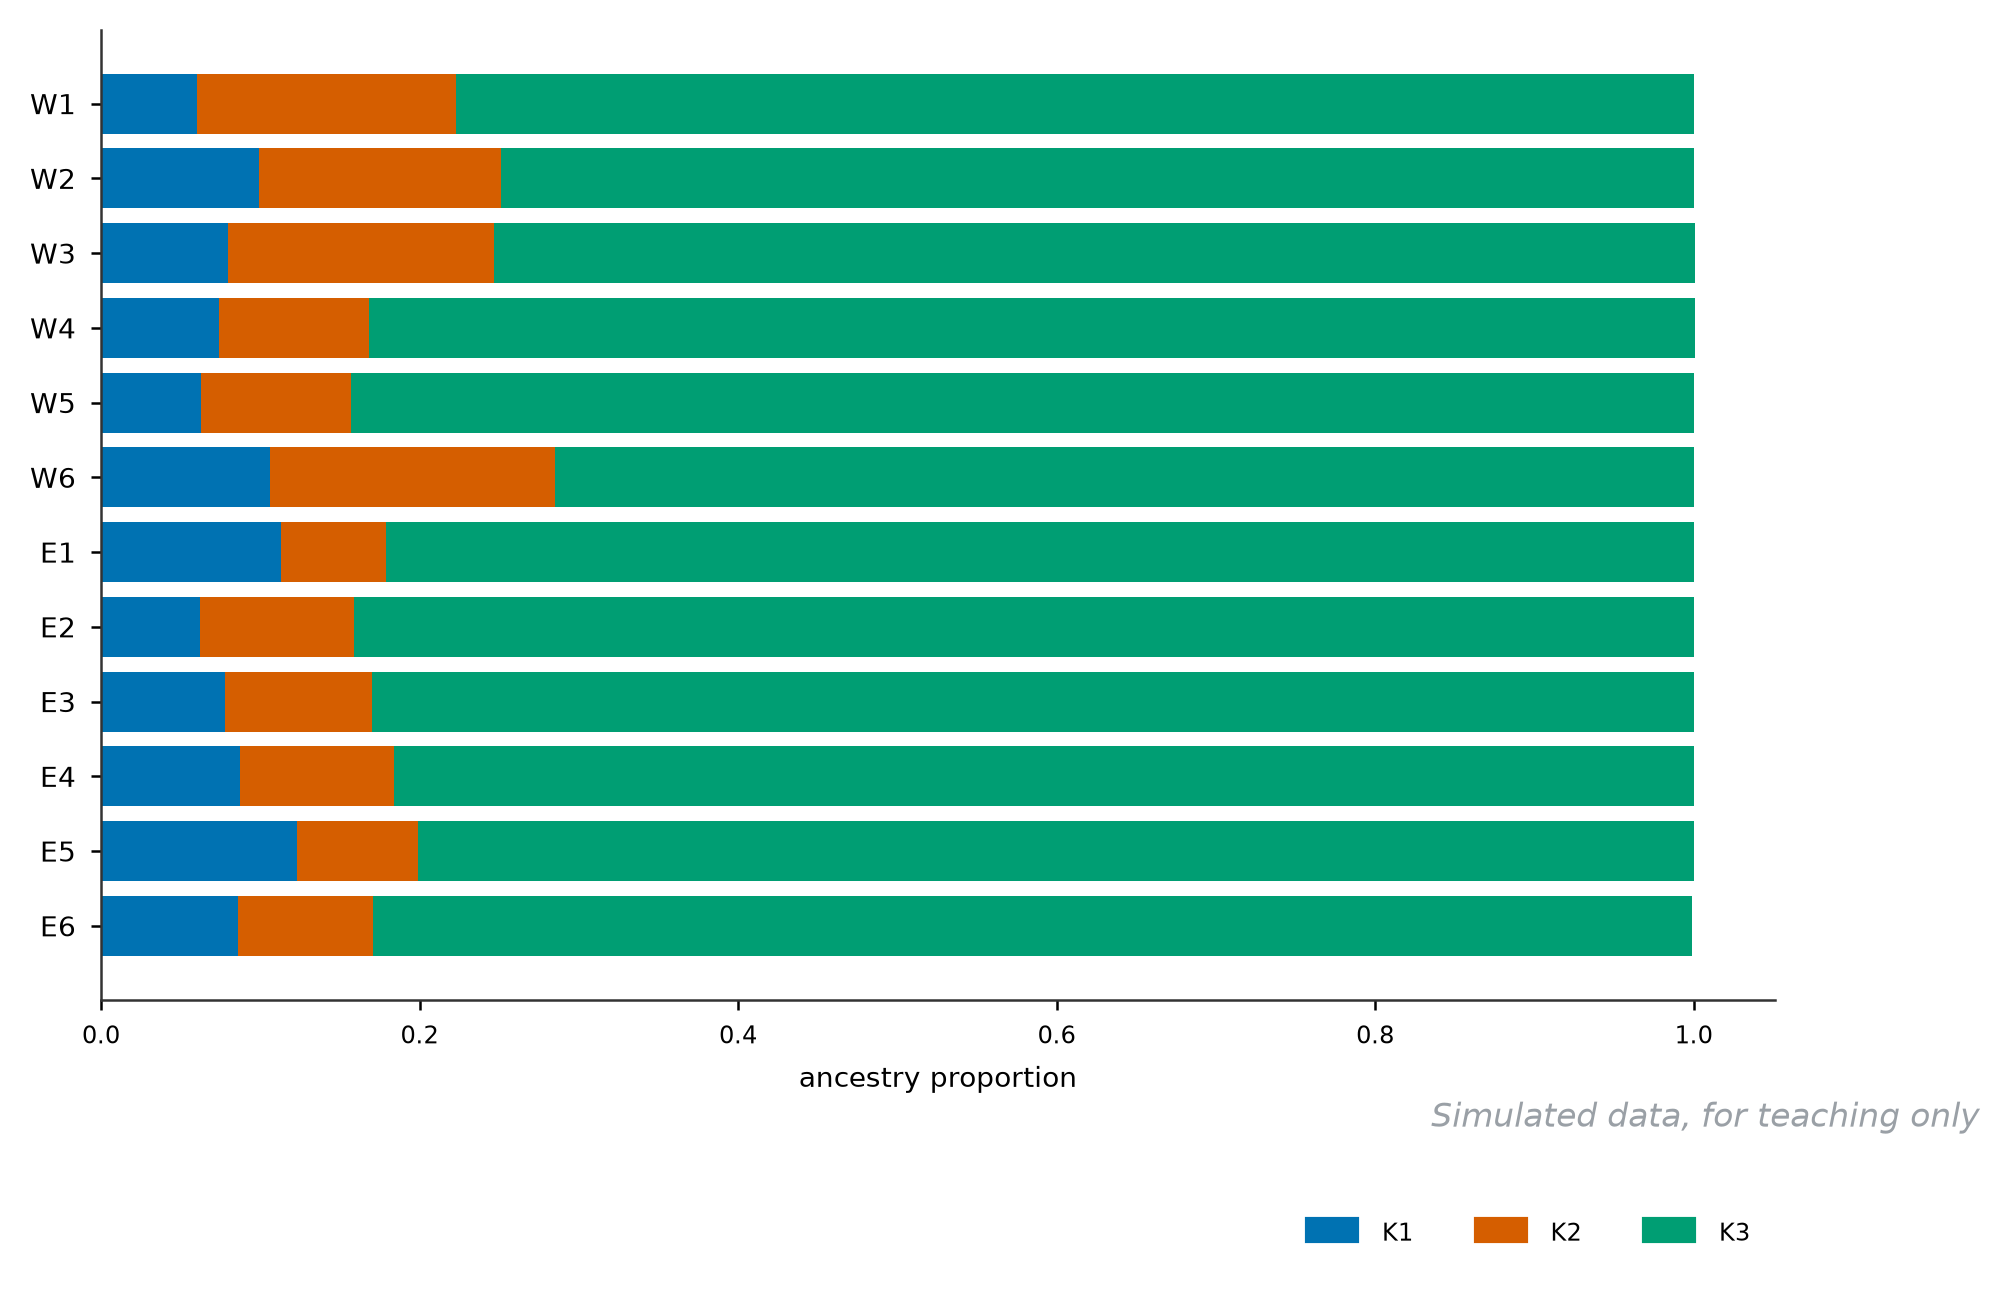
它回答什么问题:群体由几个祖先成分混成、每个个体各占多少——群体结构的标准展示,K 值选择的故事全在这张图里。
怎么读:每个个体一根细横条,条内颜色段是各祖先成分(K1-K3)的比例,总长恒为 1。读法看两点:同一群体的条是不是颜色组成一致(一致=成分纯);以及 K 取多少时条形「分得最干净」。这张模拟数据里 K = 3 时 west 群体以 K3 为主、east 群体 K1 略占优但混有少量 K2,说明 east 内部还有亚结构,值得对 K = 4 再跑一轮。注意排个体顺序会影响可读性,一般按群体再按 Q 值排序。
用什么画:ADMIXTURE 输出 Q 文件后用 R 语言 pophelper 或 Python pandas 堆叠条形图绘制。
图注示例:
图 45 K = 3 时 12 个个体的 ADMIXTURE 祖先成分估计。每个体横条按 K1-K3 依次堆叠;west 群体以 K3 为主,east 群体含少量 K2 成分(模拟数据演示)。
展开查看:模拟数据与绘图代码
individual,pop,K1,K2,K3
W1,west,0.060,0.163,0.777
W2,west,0.099,0.152,0.749
W3,west,0.080,0.167,0.754
W4,west,0.074,0.094,0.833
W5,west,0.063,0.094,0.843
W6,west,0.106,0.179,0.715
E1,east,0.113,0.066,0.821
E2,east,0.062,0.097,0.841
E3,east,0.078,0.092,0.830
E4,east,0.087,0.097,0.816
E5,east,0.123,0.076,0.801
E6,east,0.086,0.085,0.828
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("45-admixture.csv")
CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig, ax = plt.subplots(figsize=(7.2, 4.2))
left = pd.Series(0.0, index=df.index)
for k, col in zip(["K1", "K2", "K3"], CAT):
    ax.barh(df.index, df[k], left=left, color=col, label=k)
    left = left + df[k]
ax.set_yticks(df.index, df.individual, fontsize=8.5)
ax.invert_yaxis()
ax.set_xlabel("ancestry proportion")
ax.legend(ncol=3, loc="lower right", bbox_to_anchor=(1.0, -0.28))
fig.savefig("45-admixture.png", dpi=200, bbox_inches="tight")
2.5 系统发育树
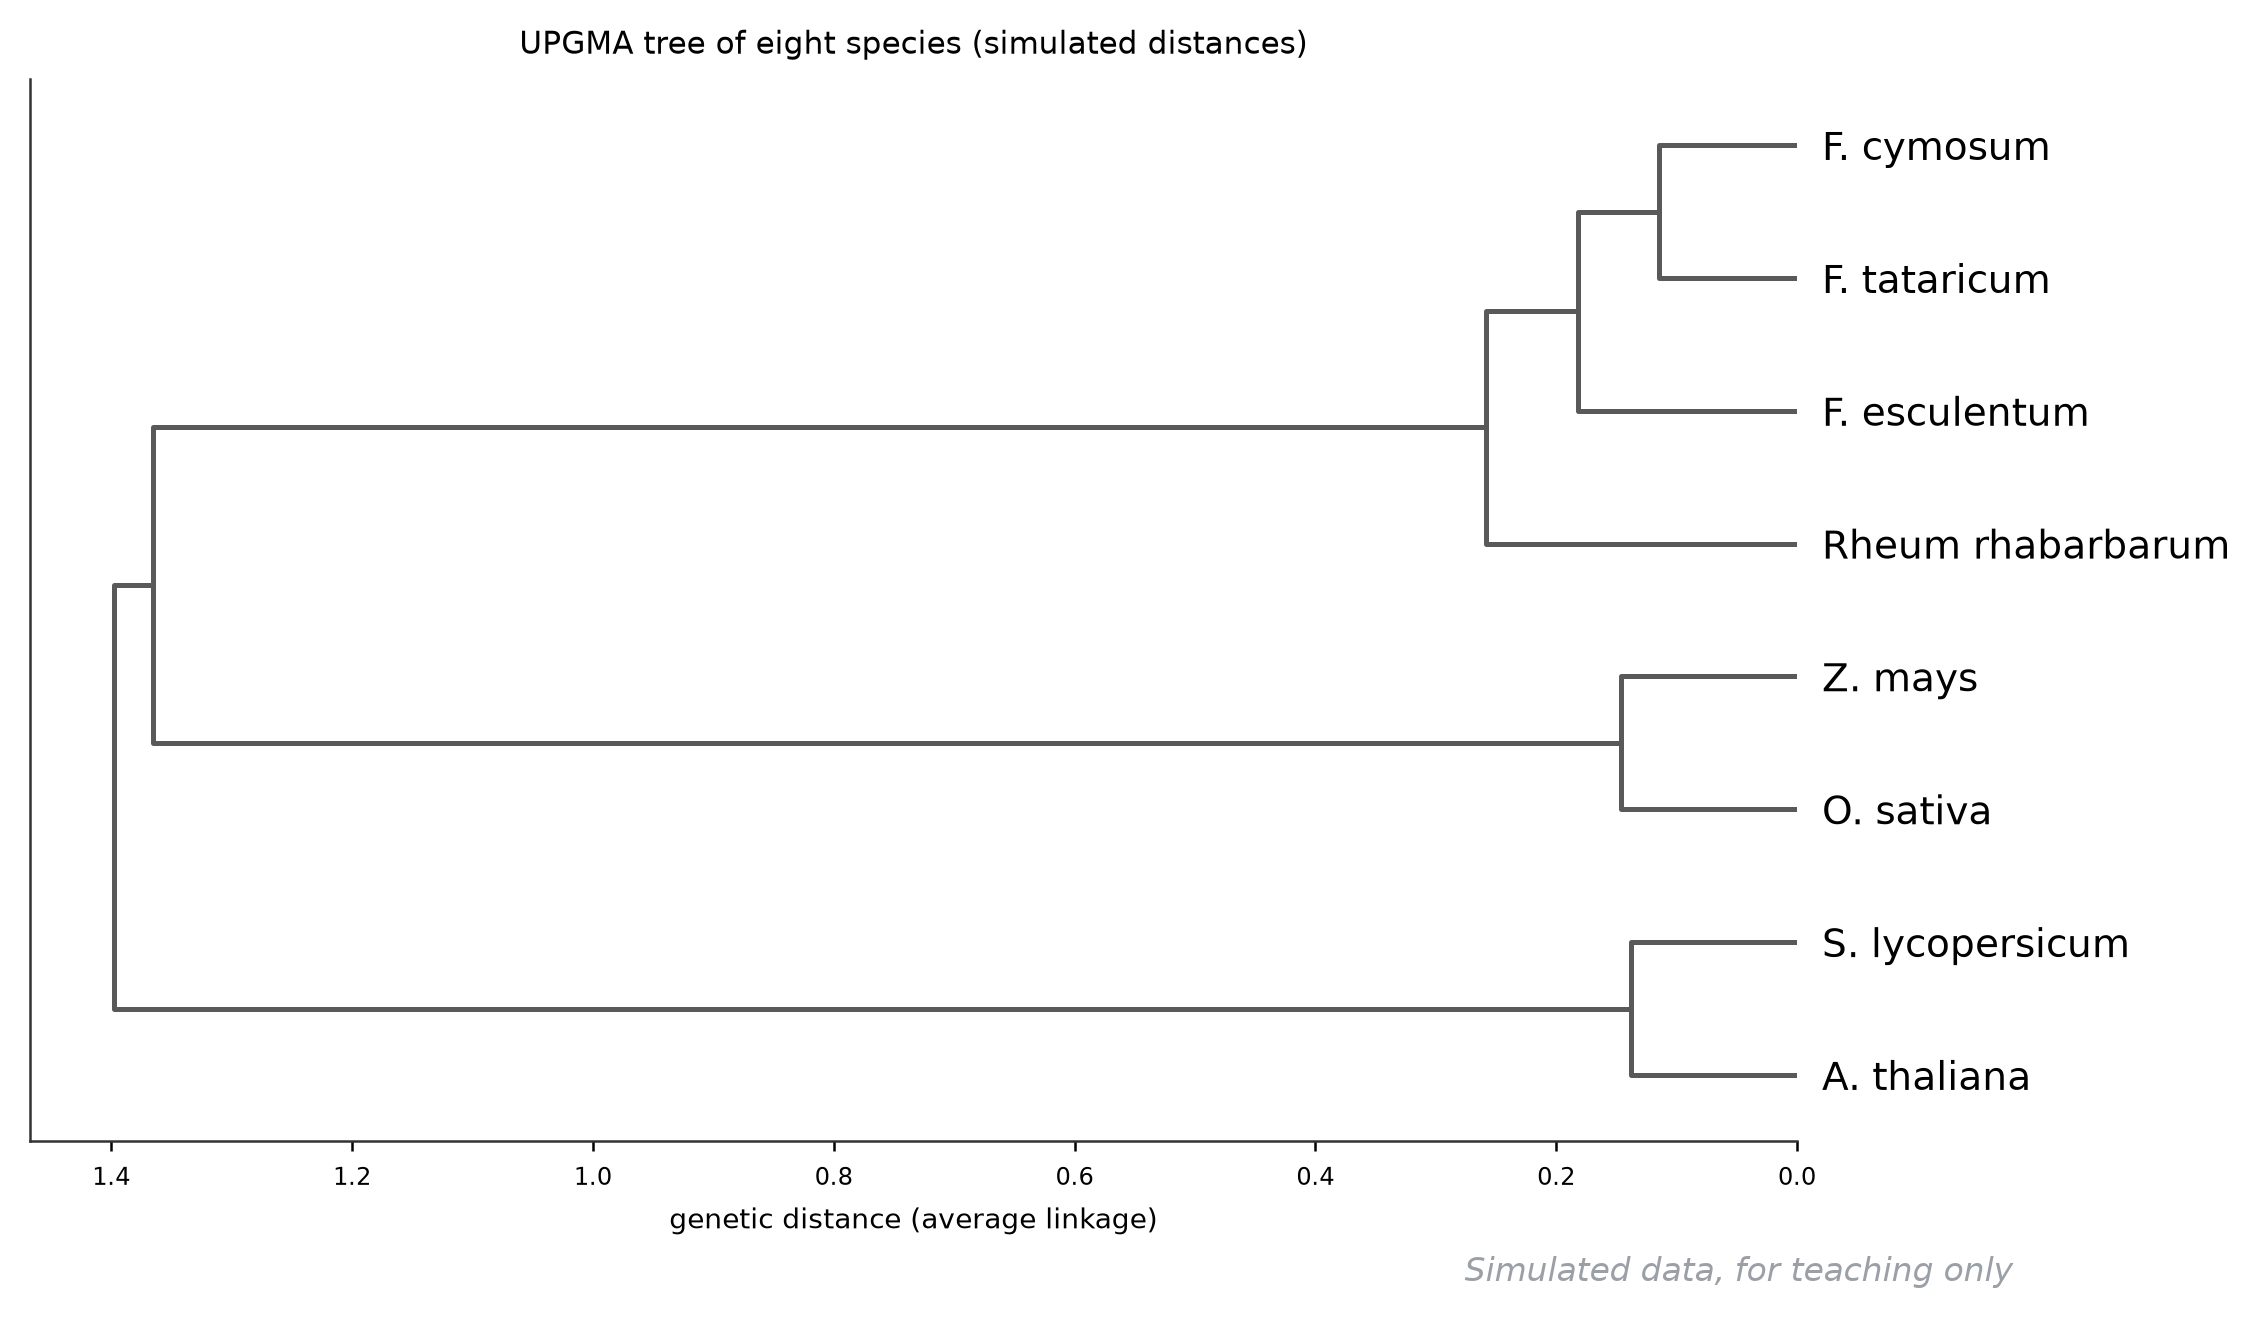
它回答什么问题:谁和谁亲缘最近、类群怎么分化——比较基因组学和群体遗传的骨架图。
怎么读:横向树(本图)从左到右是「从根到叶」,分枝点越靠右(距离越小)说明两个类群越像。看三样:拓扑结构(哪些聚成一枝,本图蓼科的三个荞麦属物种与近缘的 Rheum 聚成一大枝,单子叶的水稻玉米聚在另一侧,符合分类学预期)、枝长(分歧程度)以及自展值(真实分析应在节点标 bootstrap,大于 70 才算硬)。注意 UPGMA 假定进化速率恒定,论文更常用邻接法或最大似然树。
用什么画:MEGA/IQ-TREE 建树,iTOL 或 R 语言 ggtree 上色出图;本图用 scipy.cluster.hierarchy 的平均 linkage 示意。
图注示例:
图 46 基于模拟遗传距离的八物种 UPGMA 树。两个荞麦属近缘种聚为一枝,Rheum 属稍远;单子叶的水稻与玉米聚为另一大枝,与经典分类一致(模拟拓扑,仅作图型演示)。
展开查看:坐标数据与绘图代码
0.95,-0.01,0.06
1.06,0.07,-0.05
0.97,0.09,0.11
1.19,0.19,0.07
0.03,1.04,0.02
0.14,1.09,0.08
0.06,0.03,0.96
0.13,-0.01,1.09
(上表为 8 个物种按图中顺序排列的三维原型坐标,聚类前先按进化枝赋坐标,保证拓扑符合分类学。)
import numpy as np
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import linkage, dendrogram

names = ["F. tataricum", "F. esculentum", "F. cymosum", "Rheum rhabarbarum",
         "A. thaliana", "S. lycopersicum", "O. sativa", "Z. mays"]
M = np.loadtxt("46-phylo-matrix.csv", delimiter=",")
Z = linkage(M, "average")
fig, ax = plt.subplots(figsize=(7.6, 4.6))
dendrogram(Z, orientation="left", labels=names, ax=ax,
           color_threshold=0, link_color_func=lambda k: "0.35")
ax.set_xlabel("genetic distance (average linkage)")
fig.savefig("46-phylo.png", dpi=200, bbox_inches="tight")
2.6 滑窗 pi 与 Fst 双轨图
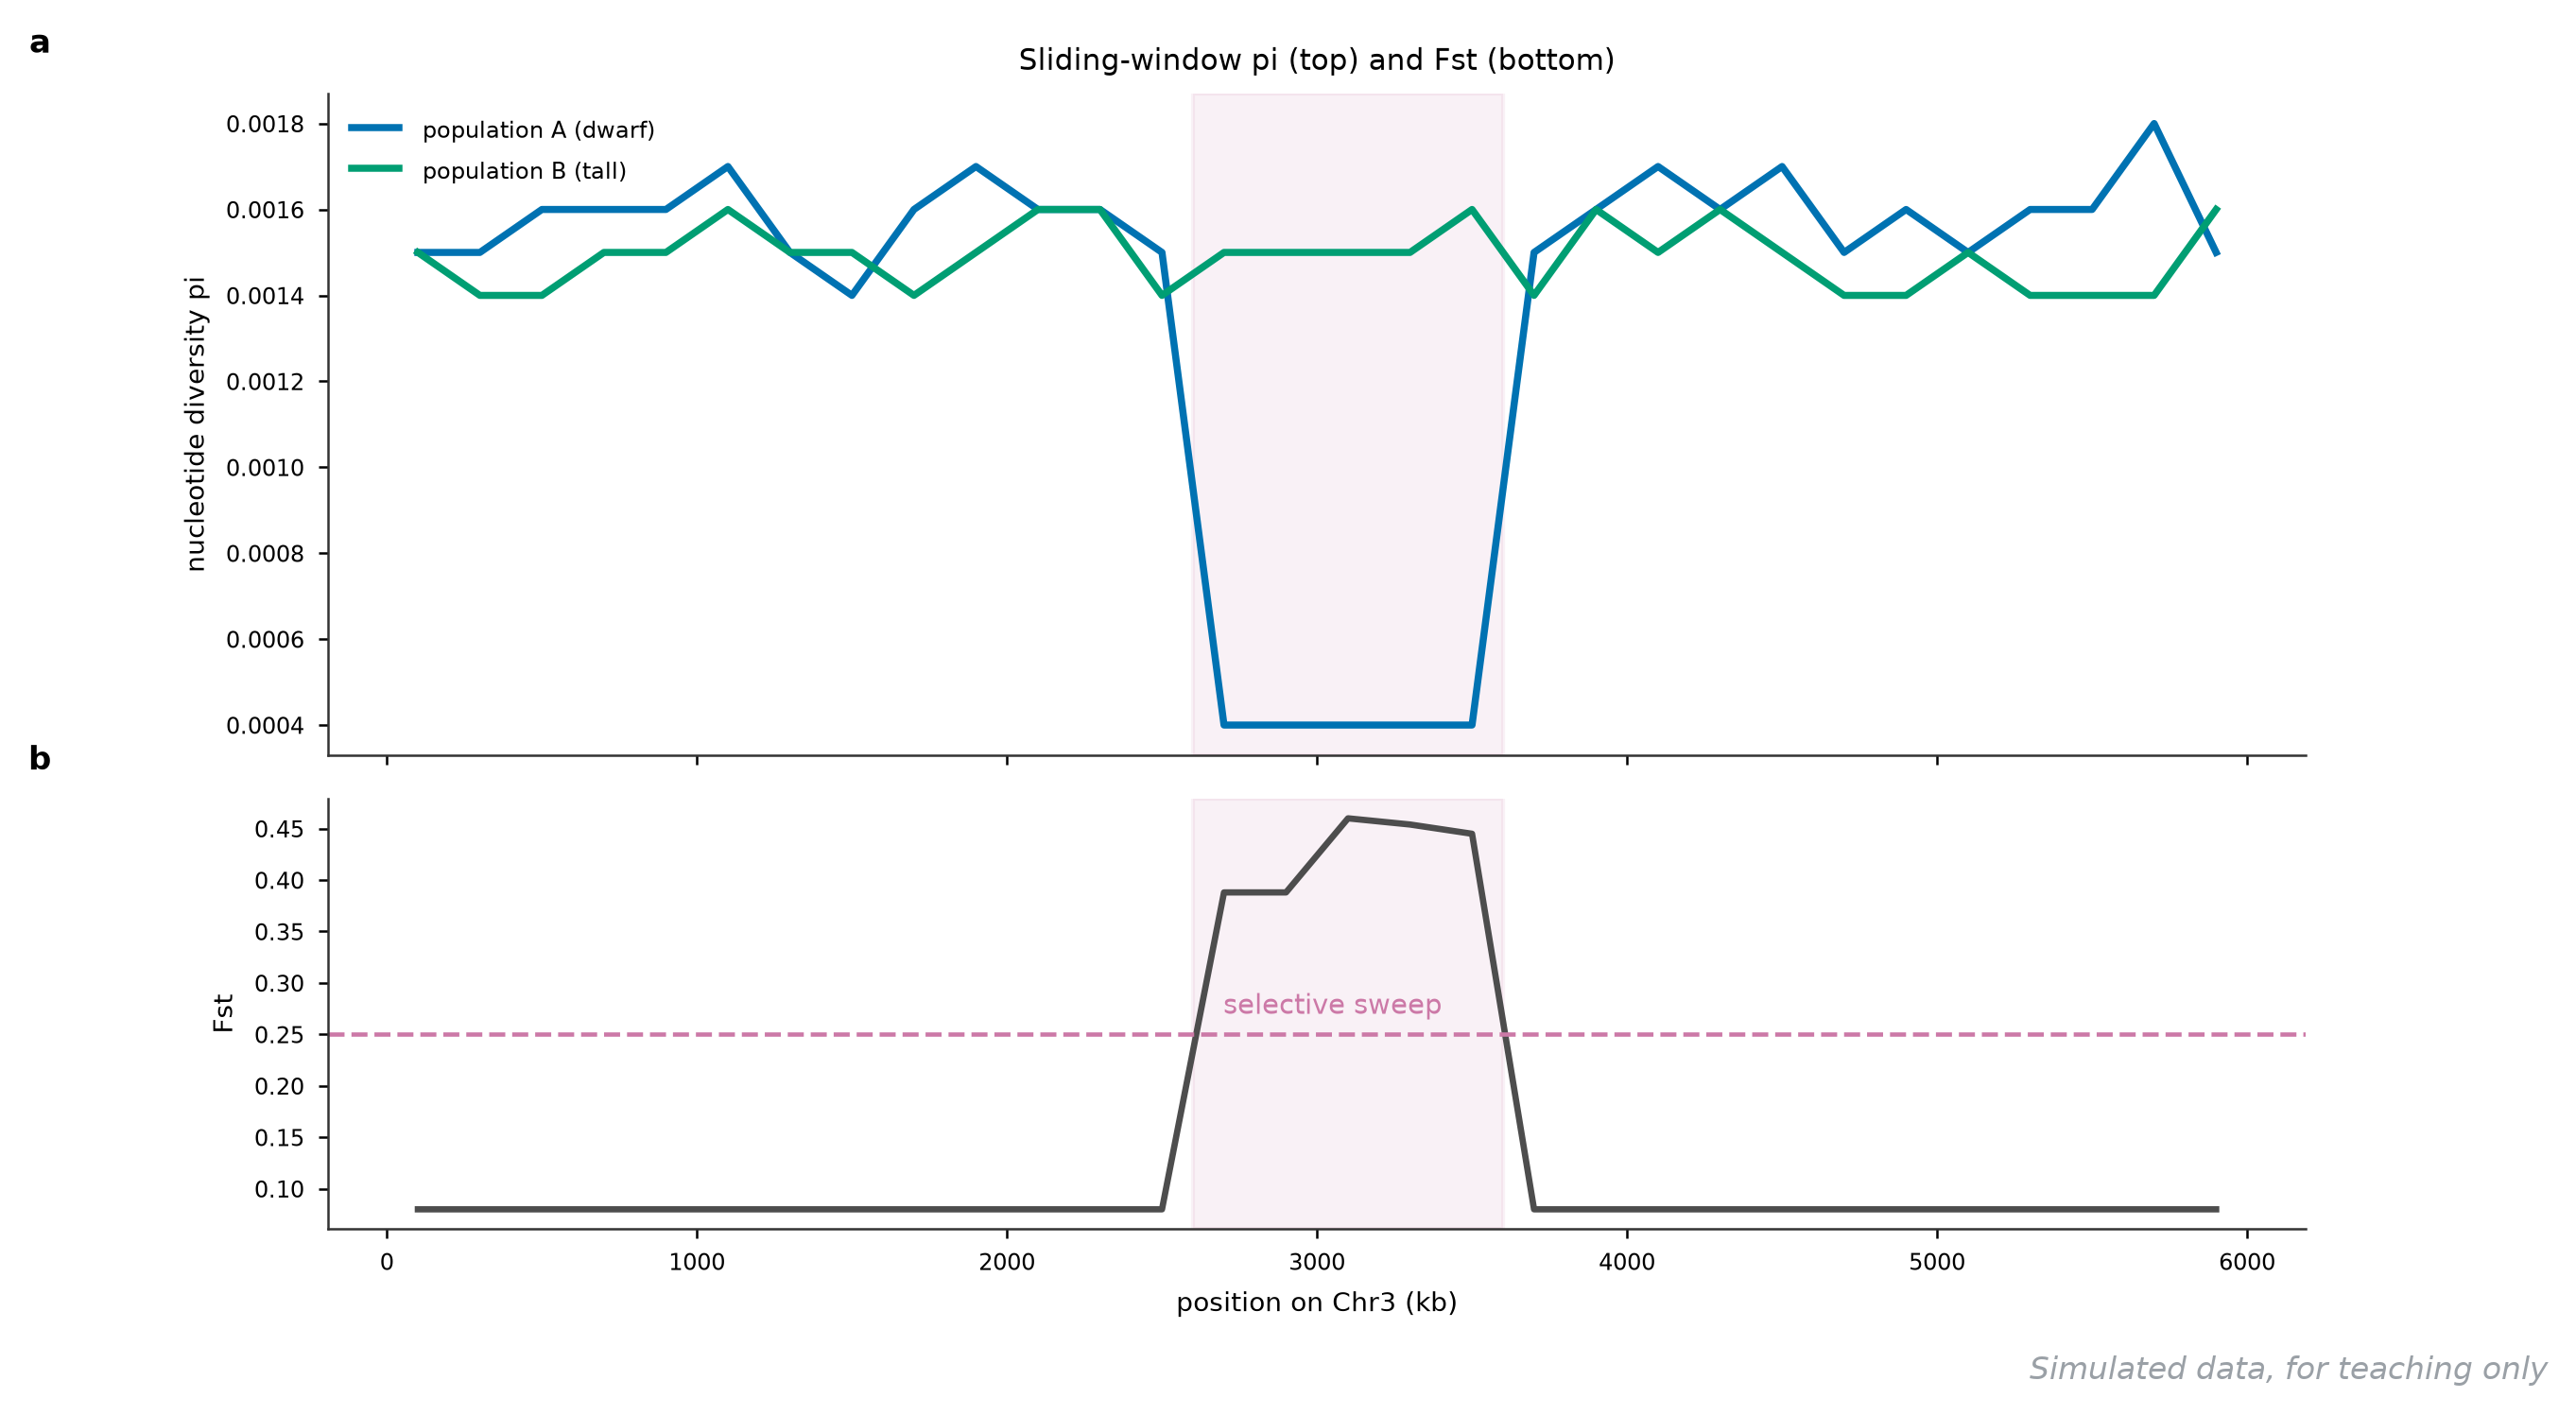
它回答什么问题:基因组哪些窗口多样性异常低、群体间分化异常高——找选择清除区间的标配组合图,两个统计一张图讲完。
怎么读:上轨是 nucleotide diversity pi(群体内多样性),下轨是 Fst(群体间分化,0 到 1)。找「pi 掉下去 + Fst 窜上去」的窗口:图上 2.6-3.6 Mb 这段,群体 A 的 pi 从 0.0015 砍到 0.0004,同时 Fst 从 0.08 跳到 0.45——典型的选择清除指纹,候选区间就是它。只有 Fst 高而 pi 不低的窗口更可能是平衡选择或结构变异,不要混着解读。
用什么画:VCFtools 的 --site-pi 与 --weir-fst-pop 分窗计算,Python 双子图对齐绘制。
图注示例:
图 47 群体 A(矮秆)与群体 B 在 Chr3 的 200 kb 滑窗 pi(上)与 Fst(下)。阴影区间的 pi 显著下降且 Fst 升至 0.45,为候选选择清除区间(模拟数据演示)。
展开查看:模拟数据与绘图代码
window_kb,pi_A,pi_B,fst
100,0.0015,0.0015,0.080
300,0.0015,0.0014,0.080
500,0.0016,0.0014,0.080
700,0.0016,0.0015,0.080
900,0.0016,0.0015,0.080
1100,0.0017,0.0016,0.080
1300,0.0015,0.0015,0.080
1500,0.0014,0.0015,0.080
1700,0.0016,0.0014,0.080
1900,0.0017,0.0015,0.080
2100,0.0016,0.0016,0.080
2300,0.0016,0.0016,0.080
2500,0.0015,0.0014,0.080
2700,0.0004,0.0015,0.388
2900,0.0004,0.0015,0.388
3100,0.0004,0.0015,0.460
3300,0.0004,0.0015,0.454
3500,0.0004,0.0016,0.445
3700,0.0015,0.0014,0.080
3900,0.0016,0.0016,0.080
4100,0.0017,0.0015,0.080
4300,0.0016,0.0016,0.080
4500,0.0017,0.0015,0.080
4700,0.0015,0.0014,0.080
4900,0.0016,0.0014,0.080
5100,0.0015,0.0015,0.080
5300,0.0016,0.0014,0.080
5500,0.0016,0.0014,0.080
5700,0.0018,0.0014,0.080
5900,0.0015,0.0016,0.080
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("47-pifst.csv")
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(9.0, 5.2), sharex=True,
                               gridspec_kw=dict(height_ratios=[2, 1.3], hspace=0.08))
ax1.plot(df.window_kb, df.pi_A, color="#4C72B0", lw=1.8, label="population A")
ax1.plot(df.window_kb, df.pi_B, color="#55A868", lw=1.8, label="population B")
ax1.axvspan(2600, 3600, color="#C44E52", alpha=0.10)
ax1.set_ylabel("nucleotide diversity pi")
ax1.legend()
ax2.plot(df.window_kb, df.fst, color="0.3", lw=1.6)
ax2.axhline(0.25, color="#C44E52", ls="--", lw=1.1)
ax2.axvspan(2600, 3600, color="#C44E52", alpha=0.10)
ax2.set_ylabel("Fst")
ax2.set_xlabel("position on Chr3 (kb)")
fig.savefig("47-pi-fst.png", dpi=200, bbox_inches="tight")
三、比较基因组与基因组学
3.1 共线性点阵图
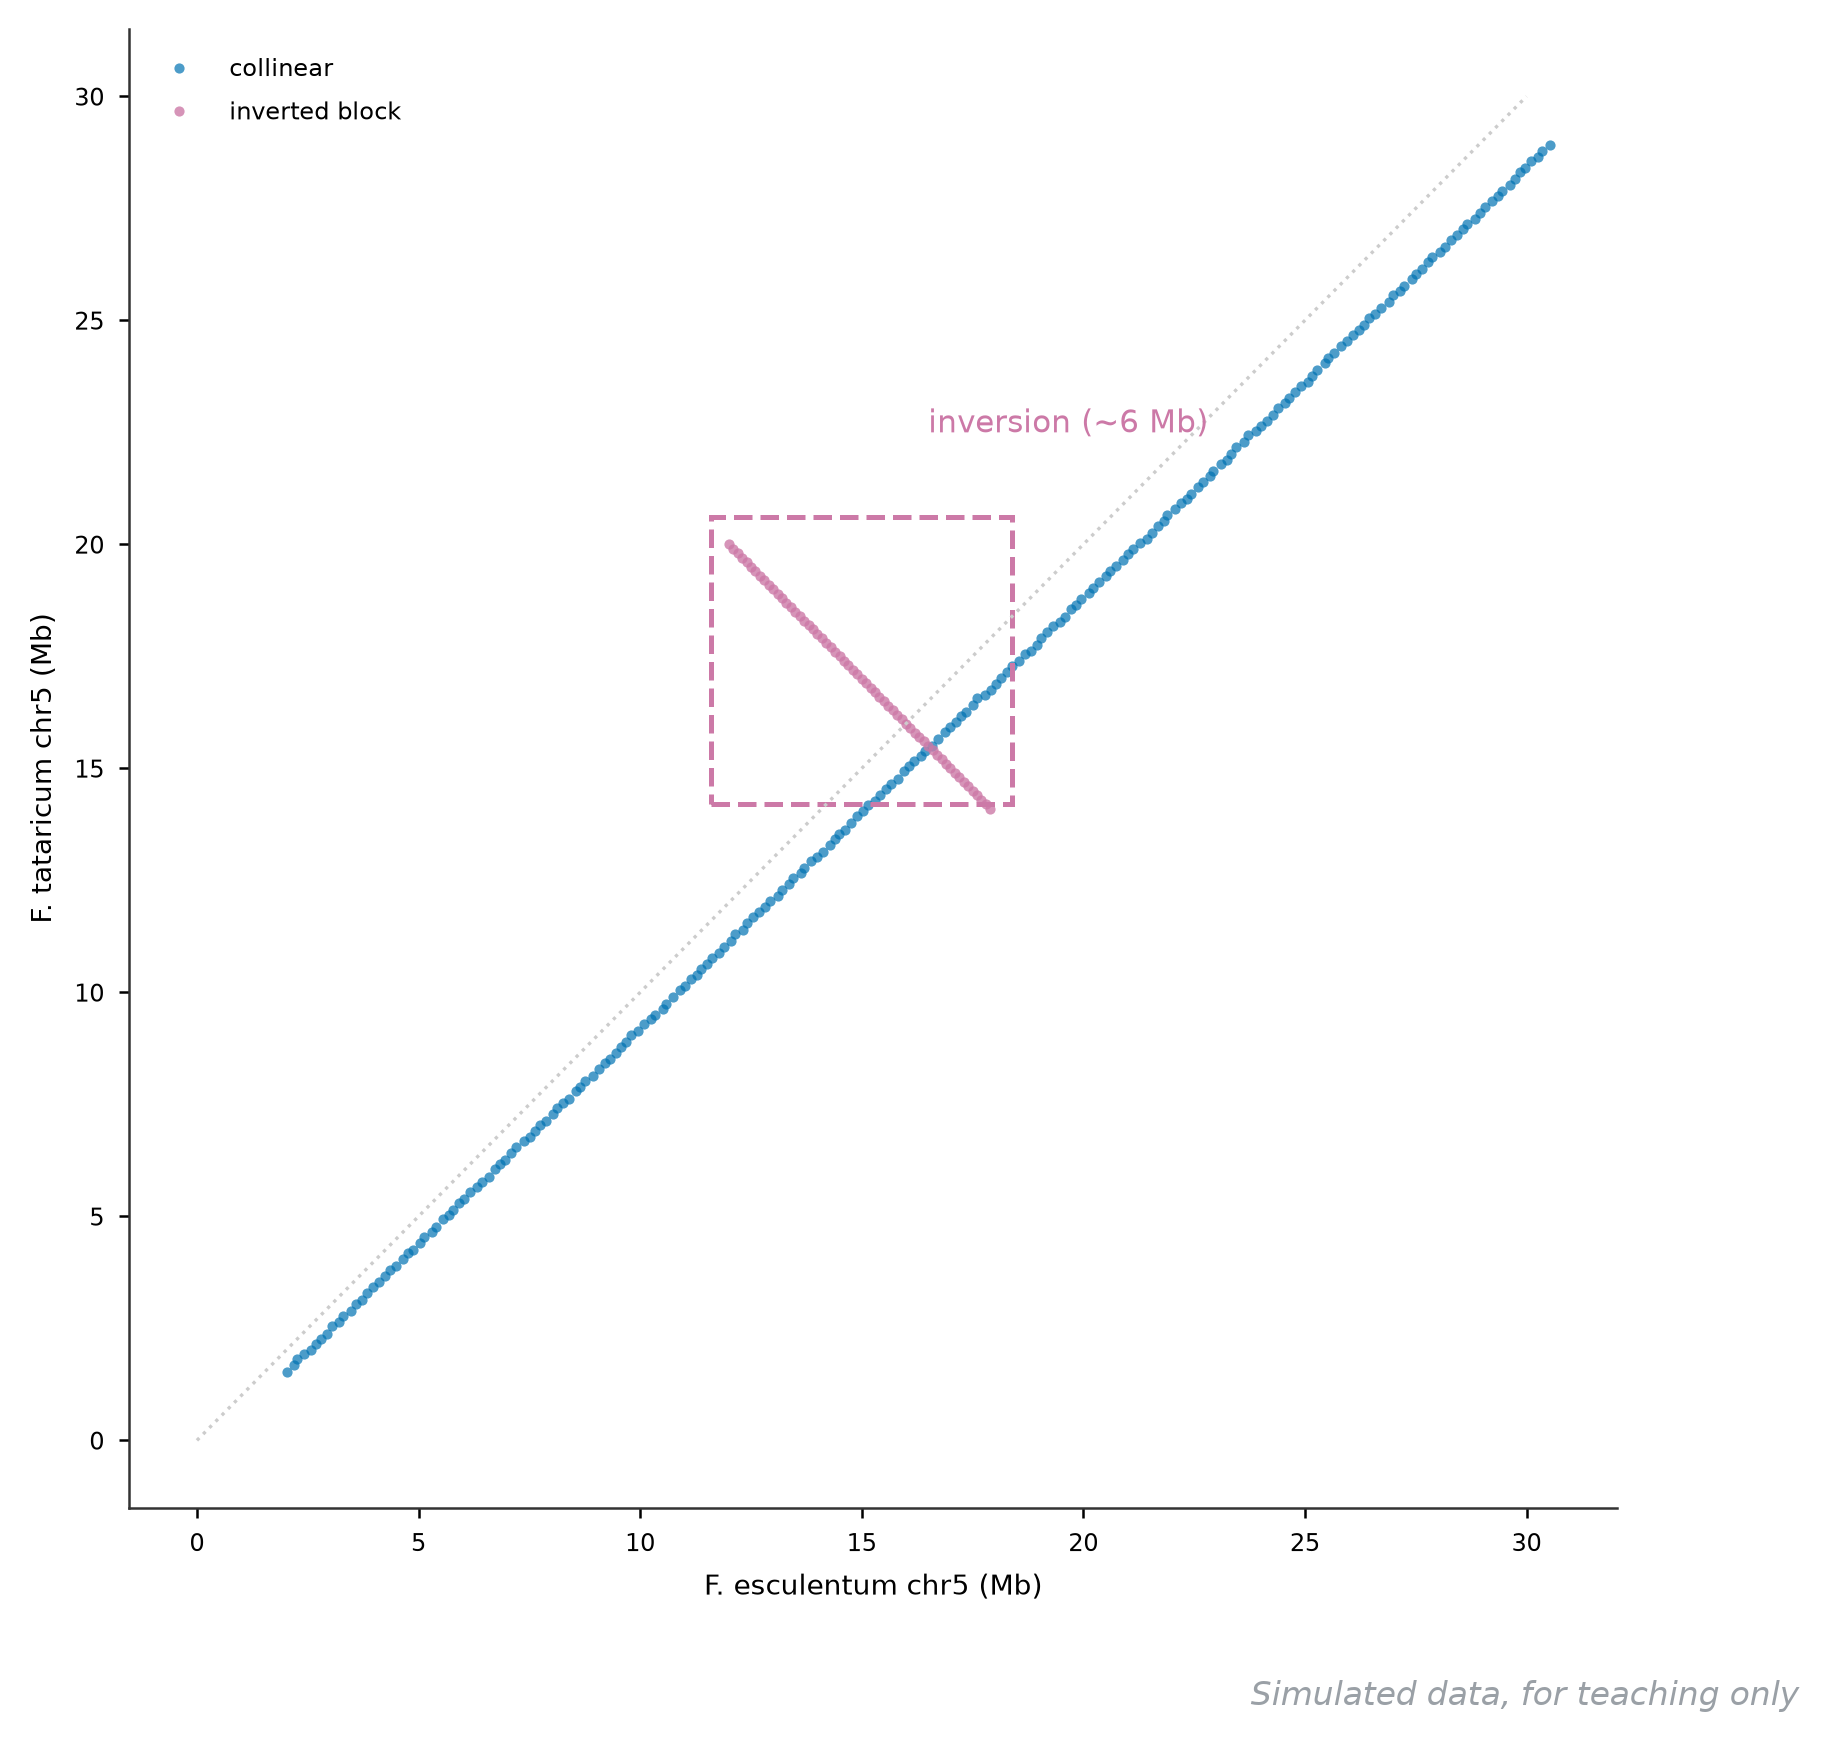
它回答什么问题:两个基因组(或两条染色体)怎么对上号——点阵图是比较基因组学最古老也最诚实的一张图,重复、倒位、易位全都藏不住。
怎么读:每个点是一对同源基因,横纵轴分别是两个物种的染色体坐标。看四样:主对角线的连续点带(大片共线性,方向一致)、偏离主线的次级带(片段重复或易位)、斜率相反的带(倒位,图上红色虚框区块斜率与主线相反)、以及点带的断层(着丝粒或组装缺口)。点云里混着大量噪声点时先做内联筛选(两两互为最佳命中)再画。
用什么画:MCScanX 或 minimap2 的 paf 坐标输出,Python matplotlib scatter 即可;大基因组用 mummerplot。
图注示例:
图 48 甜荞与苦荞 Chr5 的共线性点阵(模拟)。对角线点带为共线性区块,红框内斜率相反的区块提示约 6 Mb 的倒位。
展开查看:完整绘图代码(含数据生成)
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(2026)
collinear = [(2 + i * 0.13 + rng.uniform(0, 0.06),
              1.5 + i * 0.125 + rng.uniform(0, 0.06)) for i in range(220)]
inverted = [(12 + i * 0.1, 20 - i * 0.1) for i in range(60)]
fig, ax = plt.subplots(figsize=(6.4, 6.4))
ax.scatter(*zip(*collinear), s=6, color="#4C72B0", alpha=0.7, label="collinear")
ax.scatter(*zip(*inverted), s=6, color="#C44E52", alpha=0.8, label="inverted")
ax.add_patch(plt.Rectangle((11.6, 14.2), 6.8, 6.4, fill=False,
                           edgecolor="#C44E52", ls="--", lw=1.2))
ax.annotate("inversion (~6 Mb)", (15, 17.4), (16.5, 22.5), fontsize=9.5,
            color="#C44E52")
ax.plot([0, 30], [0, 30], color="0.8", lw=0.8, ls=":")
ax.set_xlabel("F. esculentum chr5 (Mb)")
ax.set_ylabel("F. tataricum chr5 (Mb)")
ax.legend(loc="upper left")
fig.savefig("48-dotplot.png", dpi=200, bbox_inches="tight")
3.2 Ka/Ks 分布图
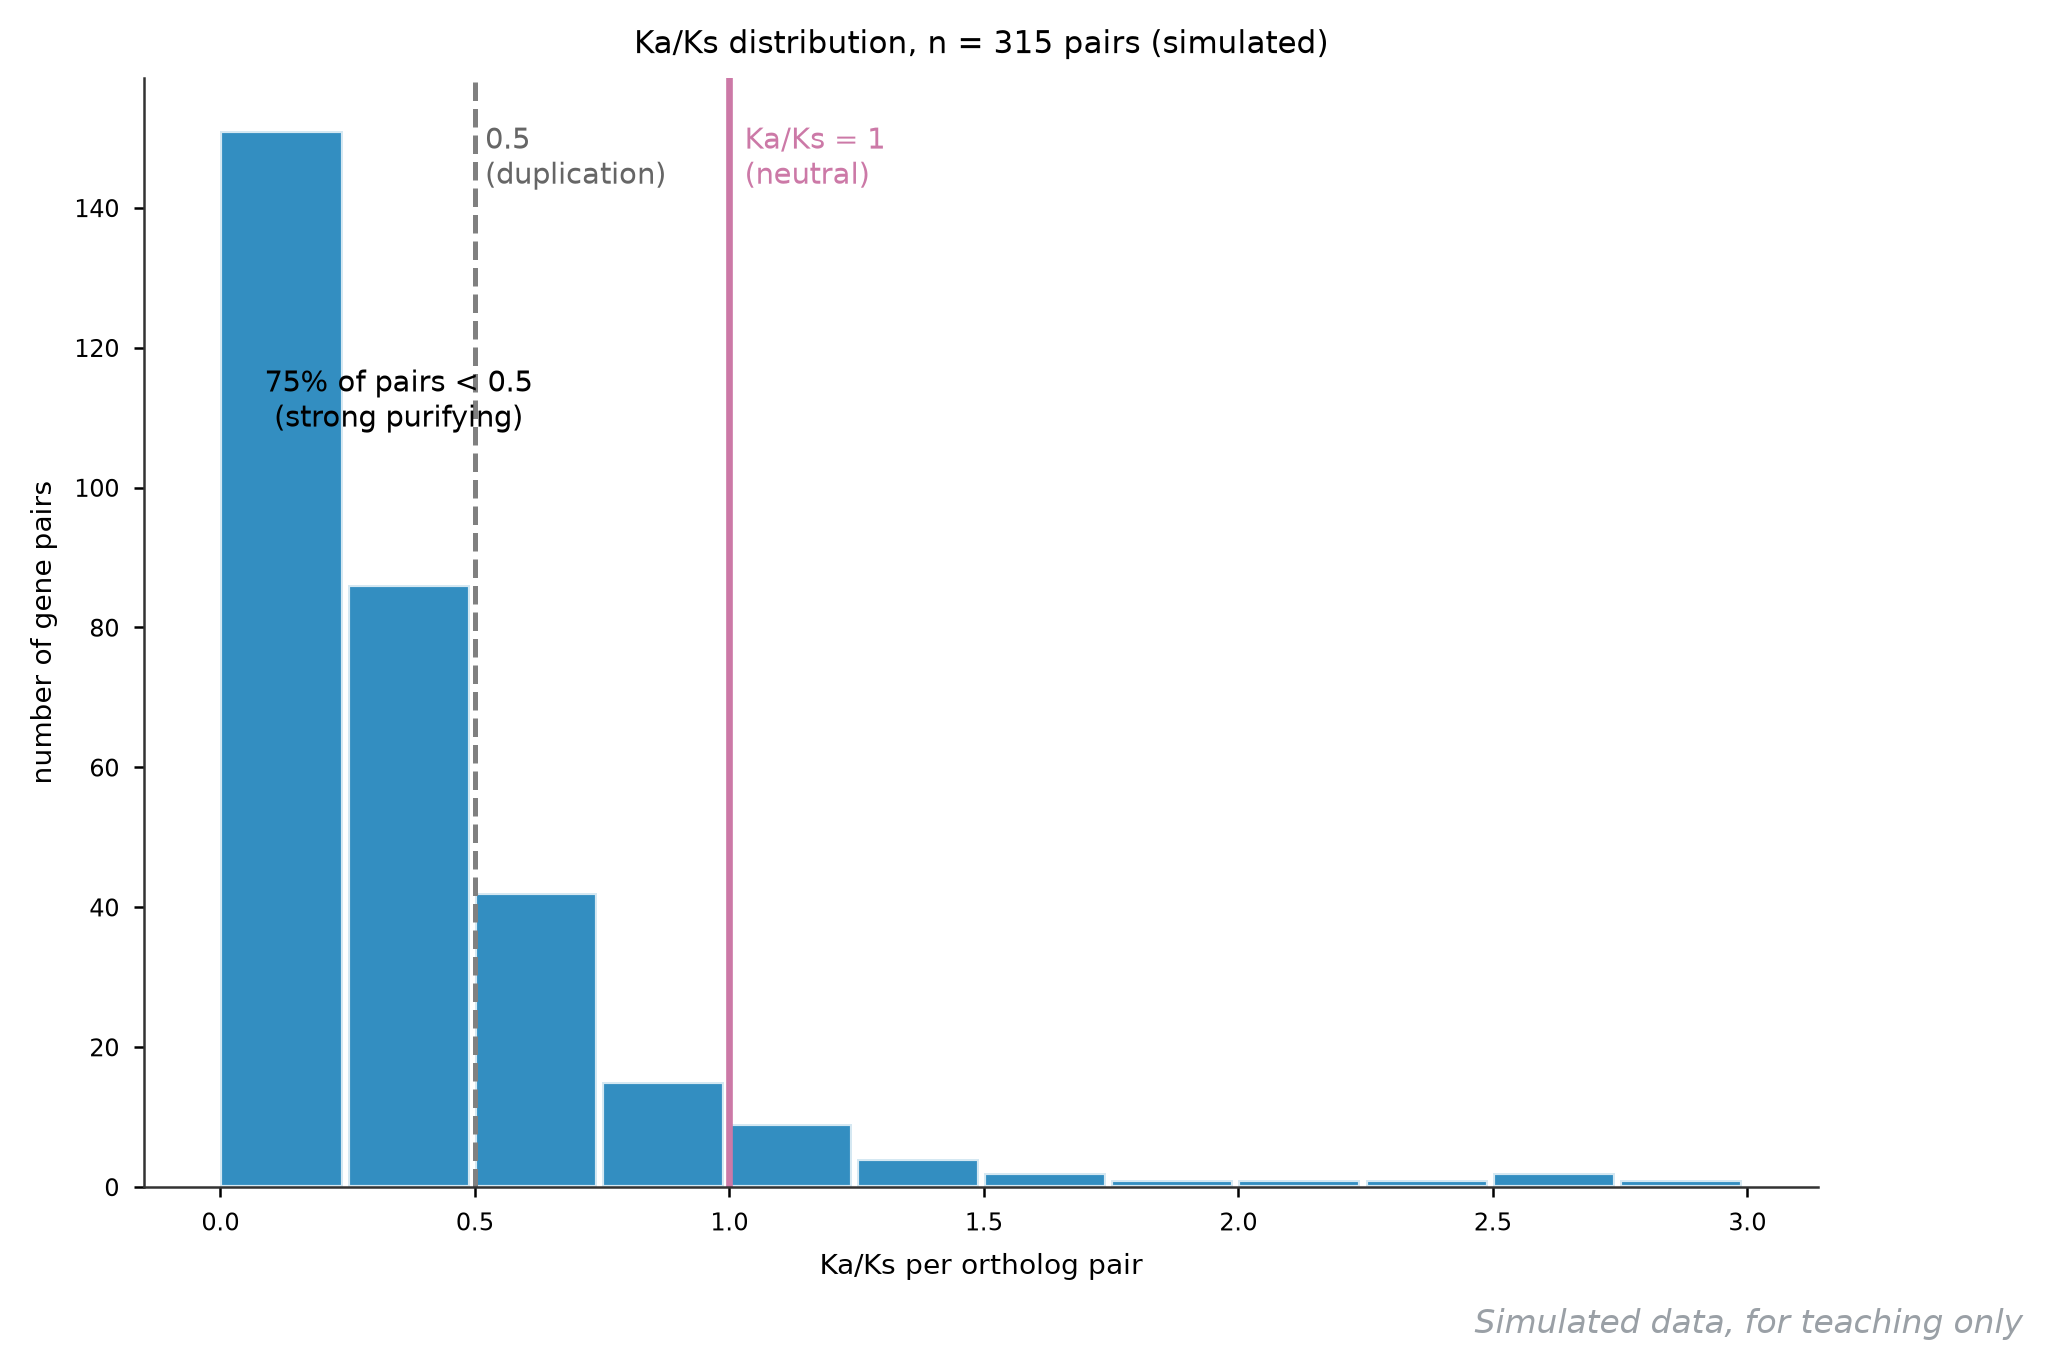
它回答什么问题: duplicated 基因对还在被净化选择吗——Ka/Ks(非同义替换率/同义替换率)是判断一对基因命运的分子进化标尺。
怎么读:直方图是基因对的 Ka/Ks 分布。三条参考线:Ka/Ks = 1 是中性(两条线上下的概率均等)、0.3-0.5 常用作「近期重复事件」的分界、大于 1 是正选择。这张模拟数据 75% 的基因对 Ka/Ks 小于 0.5——绝大多数重复基因要么被净化选择保功能、要么退化成假基因;右尾那几个大于 1.5 的点才是「可能正在干新活」的候选,值得逐个看功能注释。
用什么画:KaKs_Calculator 或 Bioperl 算值,直方图用 matplotlib hist 加参考线。
图注示例:
图 49 315 对直系同源基因的 Ka/Ks 分布(模拟,取样 320 对、Ka/Ks 大于 3 的极端值截去)。75% 的基因对 Ka/Ks 小于 0.5,受强净化选择;虚线为 0.5 分界,实线为中性值 1。
展开查看:分箱数据与绘图代码
bin_left,bin_right,count
0.00,0.25,151
0.25,0.50,86
0.50,0.75,42
0.75,1.00,15
1.00,1.25,9
1.25,1.50,4
1.50,1.75,2
1.75,2.00,1
2.00,2.25,1
2.25,2.50,1
2.50,2.75,2
2.75,3.00,1
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("49-kaks.csv")
fig, ax = plt.subplots(figsize=(7.2, 4.8))
ax.bar(df.bin_left, df["count"], width=0.24, align="edge",
       color="#4C72B0", alpha=0.8, edgecolor="white")
ax.axvline(1.0, color="#C44E52", lw=1.6)
ax.text(1.03, 140, "Ka/Ks = 1\n(neutral)", fontsize=9, color="#C44E52")
ax.axvline(0.5, color="0.5", ls="--", lw=1.2)
ax.text(0.52, 140, "0.5\n(duplication)", fontsize=9, color="0.4")
ax.set_xlabel("Ka/Ks per ortholog pair")
ax.set_ylabel("number of gene pairs")
fig.savefig("49-kaks.png", dpi=200, bbox_inches="tight")
3.3 染色体基因定位图
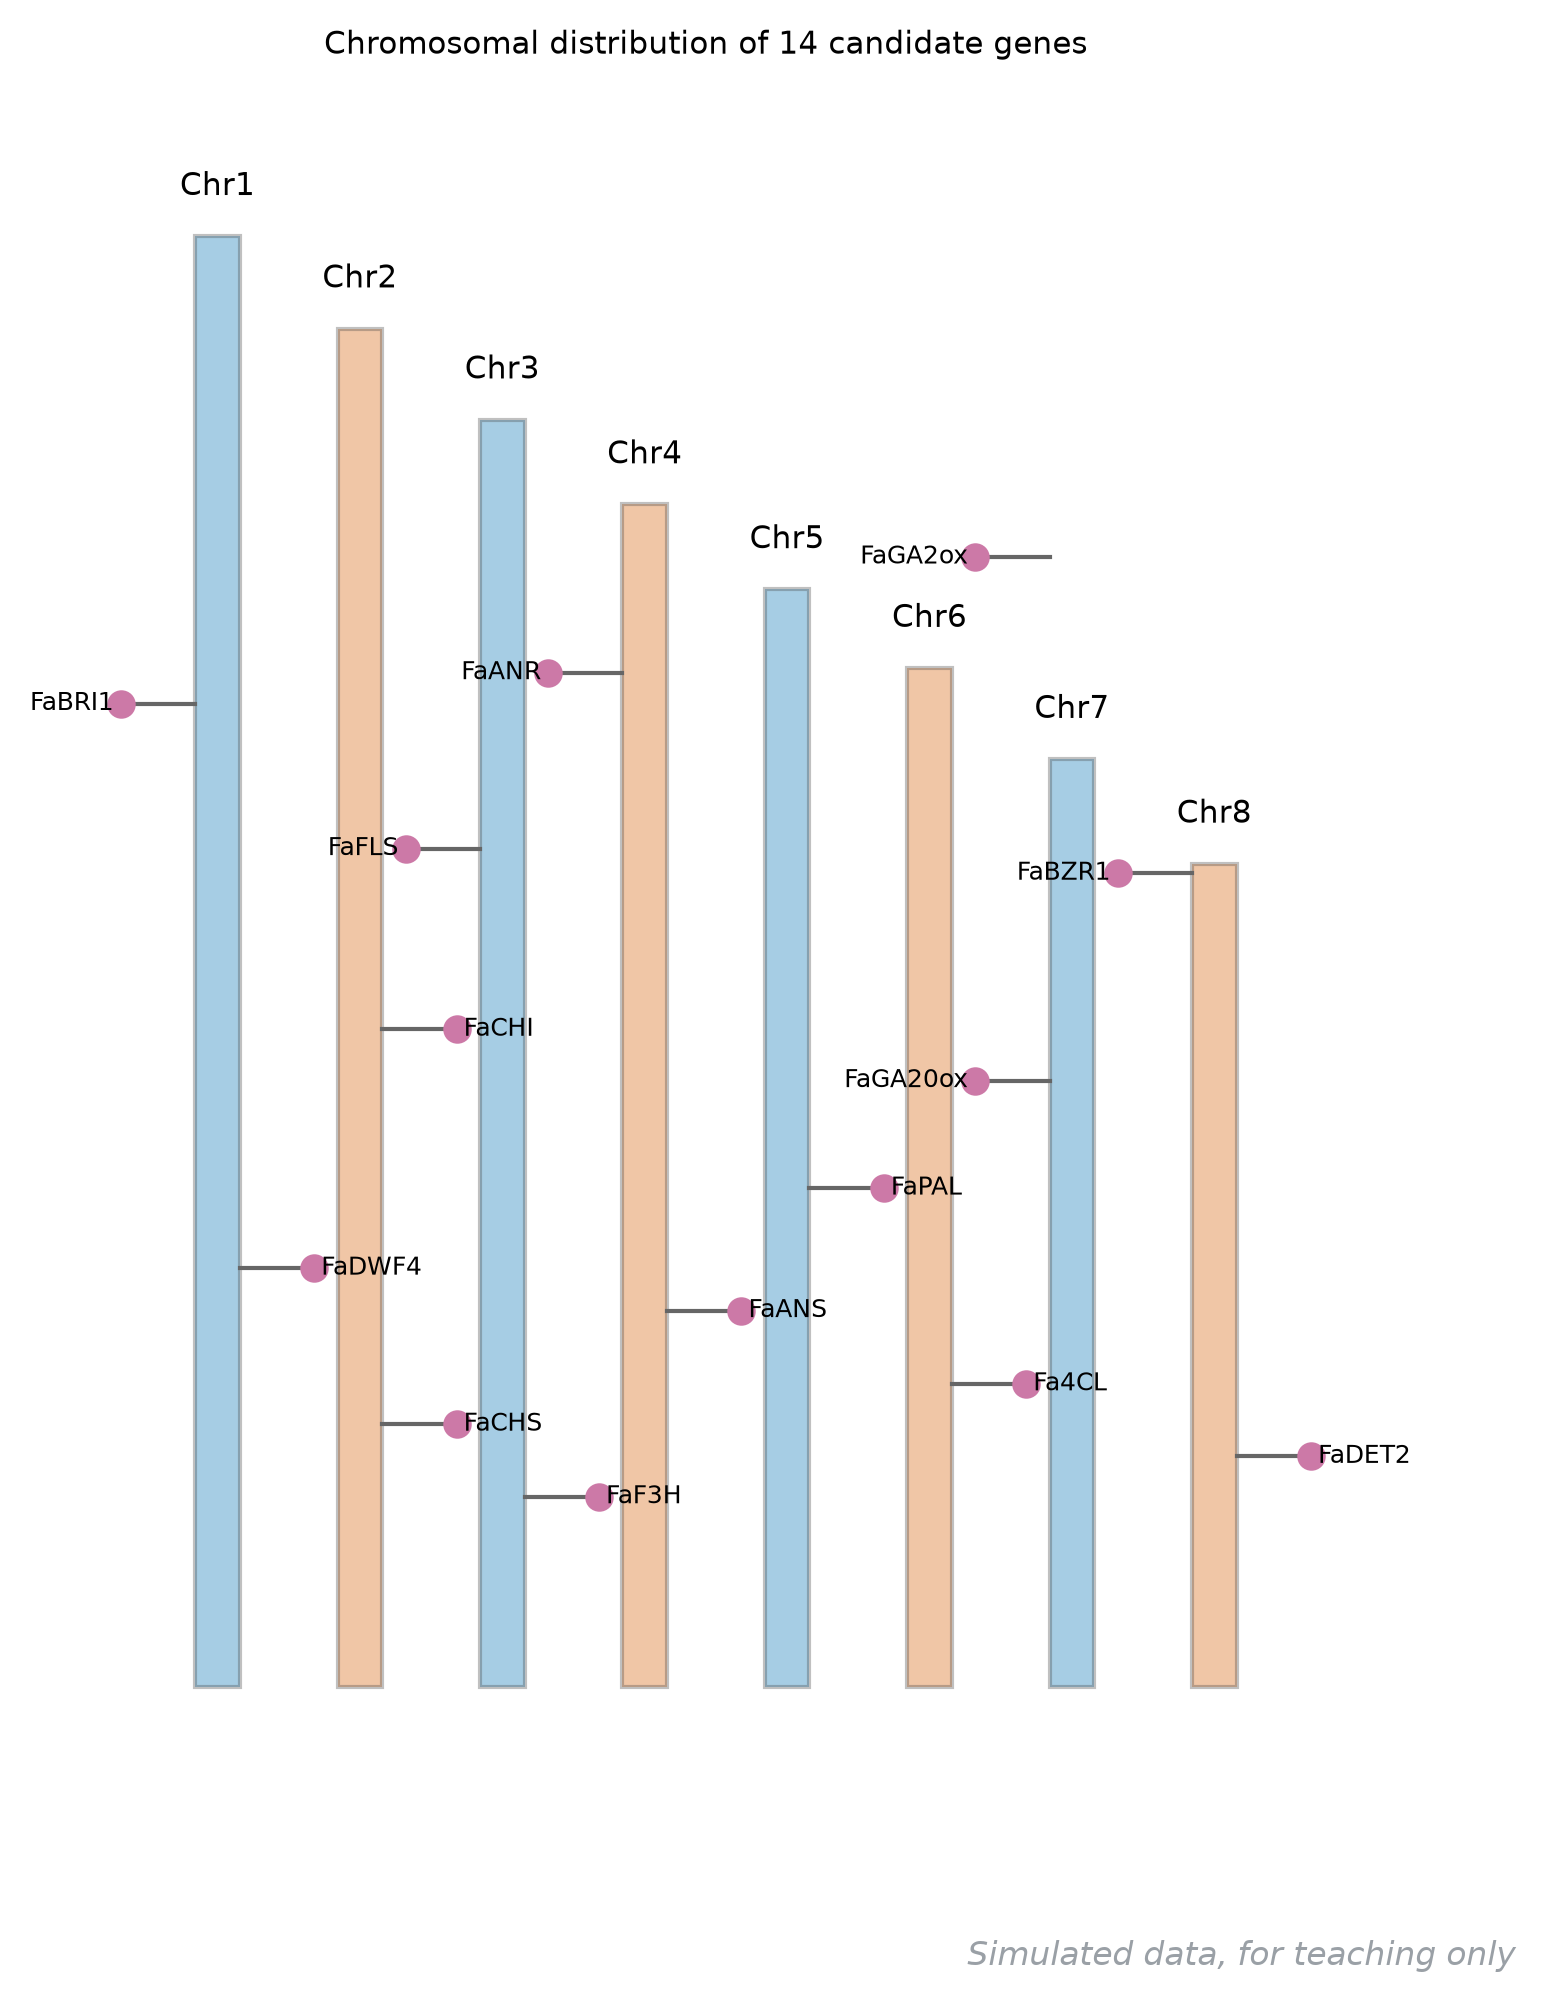
它回答什么问题:基因家族 14 个成员铺在 8 条染色体的哪里——基因家族论文的标配图,成簇分布一眼可见。
怎么读:每根竖条是一条染色体,高度正比于实际长度,红点是基因,引线从染色体拉向左右两侧交替排开避免文字打架。看两样:串联重复(同一条染色体上紧挨的点对,提示 tandem duplication)和均匀铺开的成员(提示古老家族)。图注常配一句「共有 X 对串联重复基因」,就是数这种紧挨的点对数出来的。
用什么画:MapChart(GB)或 MG2C 网页版;批量出图用 matplotlib 按坐标画方块加点,数据就是下面那张坐标表。
图注示例:
图 50 14 个候选基因在 8 条染色体上的分布(模拟)。染色体长度按实际比例绘制;FaCHS 与 FaF3H 所在区域附近未见串联成簇。
展开查看:坐标数据与绘图代码
gene,chr,pos_mb
FaDWF4,1,61.2
FaBRI1,1,143.7
FaCHS,2,38.4
FaCHI,2,96.1
FaF3H,3,27.8
FaFLS,3,122.5
FaANS,4,55.0
FaANR,4,148.2
FaPAL,5,72.9
Fa4CL,6,44.3
FaGA20ox,7,88.6
FaGA2ox,7,165.1
FaDET2,8,33.7
FaBZR1,8,118.9
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("50-chrloc.csv")
lens = {1: 212.0, 2: 198.5, 3: 185.2, 4: 172.8, 5: 160.4,
        6: 148.9, 7: 135.6, 8: 120.3}
fig, ax = plt.subplots(figsize=(5.6, 7.2))
for i, (c, L) in enumerate(lens.items()):
    x = i * 1.4
    ax.add_patch(plt.Rectangle((x - 0.22, 0), 0.44, L, facecolor="#B9CAF2"
                               if c % 2 else "#F9DCC4", edgecolor="0.3", alpha=0.9))
    ax.text(x, L + 6, "Chr%d" % c, ha="center", fontsize=9.5)
for _, row in df.iterrows():
    x = (row.chr - 1) * 1.4
    side = 1 if row.pos_mb < lens[row.chr] / 2 else -1
    ax.plot([x + side * 0.22, x + side * 0.95], [row.pos_mb] * 2, color="0.4", lw=1)
    ax.scatter([x + side * 0.95], [row.pos_mb], s=34, color="#C44E52")
    ax.text(x + side * 1.02, row.pos_mb, row.gene, fontsize=7.6, va="center",
            ha="left" if side == 1 else "right")
ax.set_xlim(-1.6, 11.2)
ax.set_ylim(-8, 235)
ax.axis("off")
fig.savefig("50-chrloc.png", dpi=200, bbox_inches="tight")
3.4 Circos 风格圈图
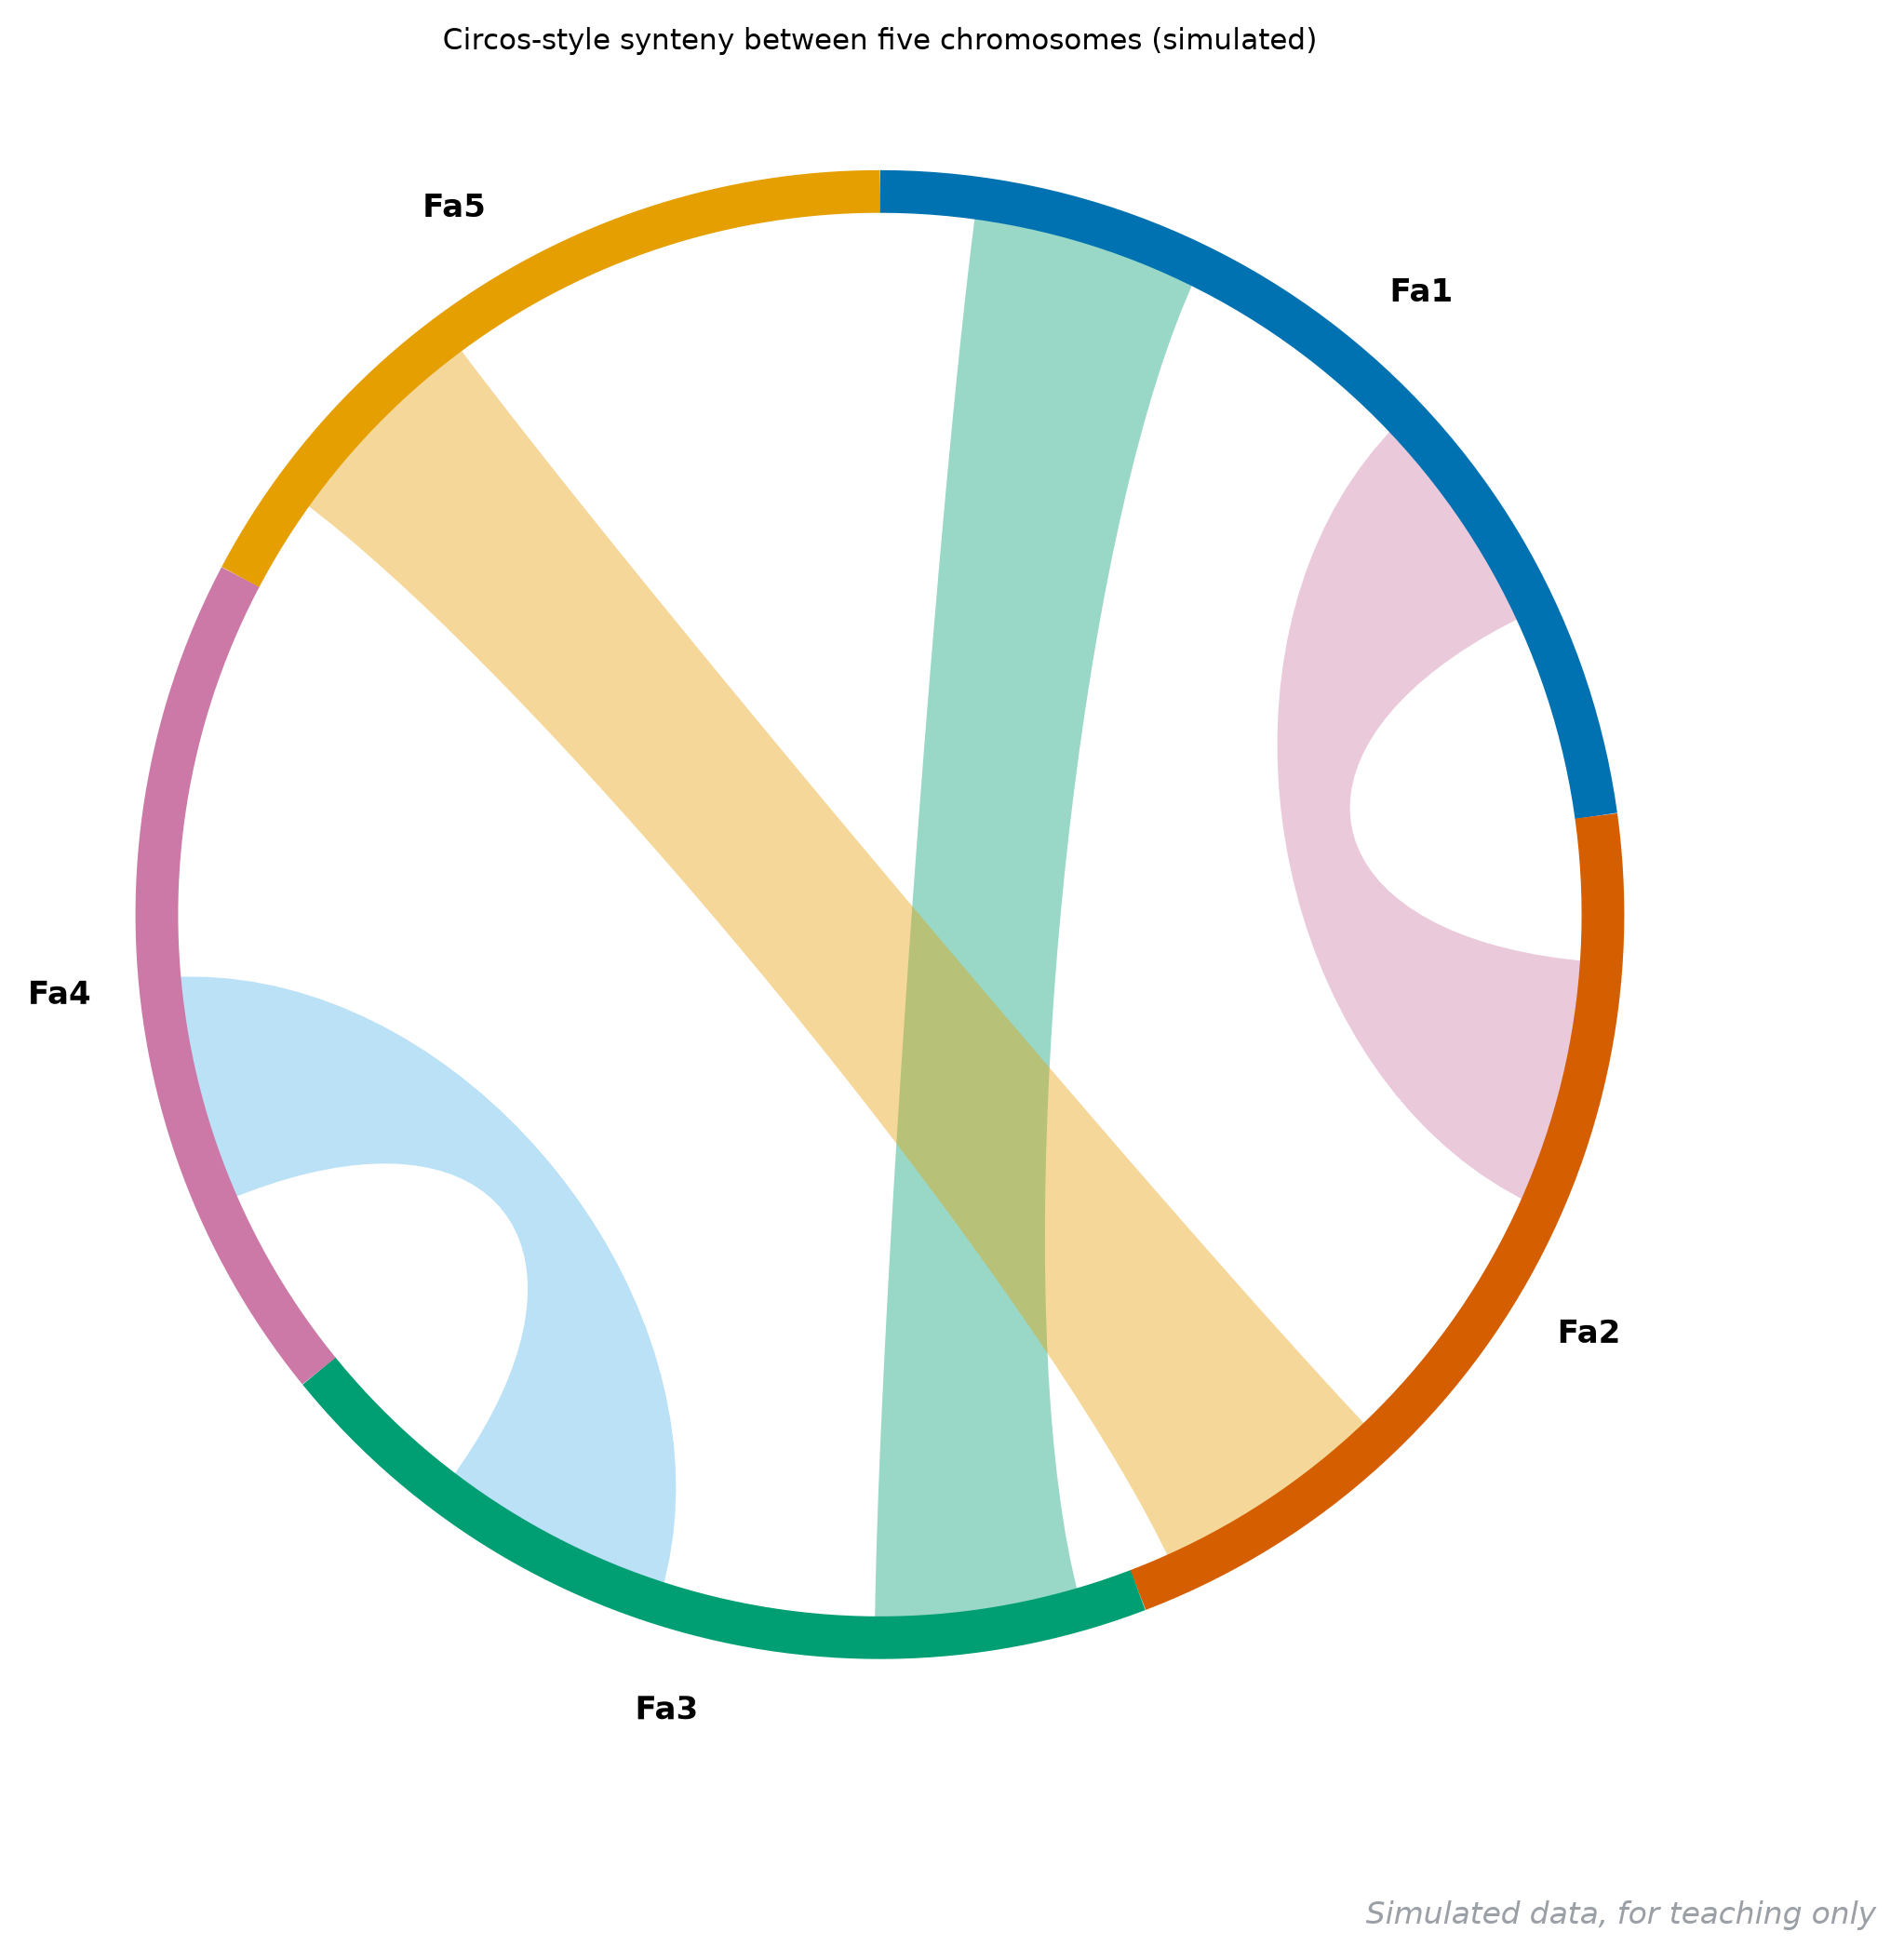
它回答什么问题:把多条染色体的长度、块状共线性关系收进一个圆环里——基因组论文封面图的专业感来源,本质是「点阵图的环形版」。
怎么读:外圈每段彩色弧是一条染色体(弧长正比实际长度),内圈飘带连接两段染色体之间的同源区块,飘带越宽同源区块越大。看两样:飘带的分布是否均匀(集中在个别染色体对说明特异扩增)、以及同一条染色体自己绕回来的飘带(自共线性,通常是近期的串联重复爆发)。Circos 原版还能叠热圈、散点、连线等多种轨道,读法是「一圈一数据轨道,由外向内讲」。
用什么画:官方 circos(Perl)配置繁但功能全;Python 可用 pyCirclize,本图用 matplotlib 弧段加贝塞尔飘带手绘。
图注示例:
图 51 五条染色体的 Circos 风格共线性圈图(模拟)。外圈弧长正比染色体长度,飘带连接四对共线性区块,其中 Fa1-Fa3 区块最大(48 Mb 对 43 Mb)。
展开查看:区块坐标与绘图代码
chr1,start_mb,end_mb,chr2,start_mb,end_mb
Fa1,20,68,Fa3,12,55
Fa1,120,168,Fa2,30,82
Fa2,140,190,Fa5,20,66
Fa3,100,150,Fa4,40,88
绘图代码(Python,独立可运行;染色体长度表内置)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

blocks = pd.read_csv("51-circos-blocks.csv")
lens = {"Fa1": 212.0, "Fa2": 198.5, "Fa3": 185.2, "Fa4": 172.8, "Fa5": 160.4}
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3"]
total = sum(lens.values())
start, a = {}, 90.0
for c, L in lens.items():
    start[c] = a
    a -= L / total * 360
tsl = np.linspace(0, 1, 40)
fig, ax = plt.subplots(figsize=(7.4, 7.4))
ax.set_aspect("equal"); ax.axis("off")
for i, (c, L) in enumerate(lens.items()):
    a0, a1 = np.deg2rad(start[c]), np.deg2rad(start[c] - L / total * 360)
    arc = np.linspace(a1, a0, 60)
    ax.plot(np.cos(arc), np.sin(arc), color=CAT[i], lw=11, solid_capstyle="butt")
    am = (a0 + a1) / 2
    ax.text(1.14 * np.cos(am), 1.14 * np.sin(am), c, ha="center", fontsize=10.5)
P = lambda a: np.array([np.cos(a), np.sin(a)])
def ang(c, mb):
    return np.deg2rad(start[c] - mb / lens[c] * (lens[c] / total * 360))
for k, row in blocks.iterrows():
    a1a, a1b = ang(row.chr1, row.start_mb), ang(row.chr1, row.end_mb)
    a2a, a2b = ang(row.chr2, row.start_mb), ang(row.chr2, row.end_mb)
    p0, p1, q0, q1 = P(a1a), P(a1b), P(a2b), P(a2a)
    top = ((1 - tsl) ** 3)[:, None] * p0 + (3 * (1 - tsl) ** 2 * tsl)[:, None] \
        * (0.58 * P(a1a)) + (3 * (1 - tsl) * tsl ** 2)[:, None] \
        * (0.58 * P(a2b)) + (tsl ** 3)[:, None] * q0
    bot = ((1 - tsl) ** 3)[:, None] * p1 + (3 * (1 - tsl) ** 2 * tsl)[:, None] \
        * (0.58 * P(a1b)) + (3 * (1 - tsl) * tsl ** 2)[:, None] \
        * (0.58 * P(a2a)) + (tsl ** 3)[:, None] * q1
    poly = np.vstack([top, bot[::-1]])
    ax.fill(poly[:, 0], poly[:, 1], color=CAT[(k + 2) % 5], alpha=0.4, lw=0)
fig.savefig("51-circos.png", dpi=200, bbox_inches="tight")
3.5 基因密度分布图
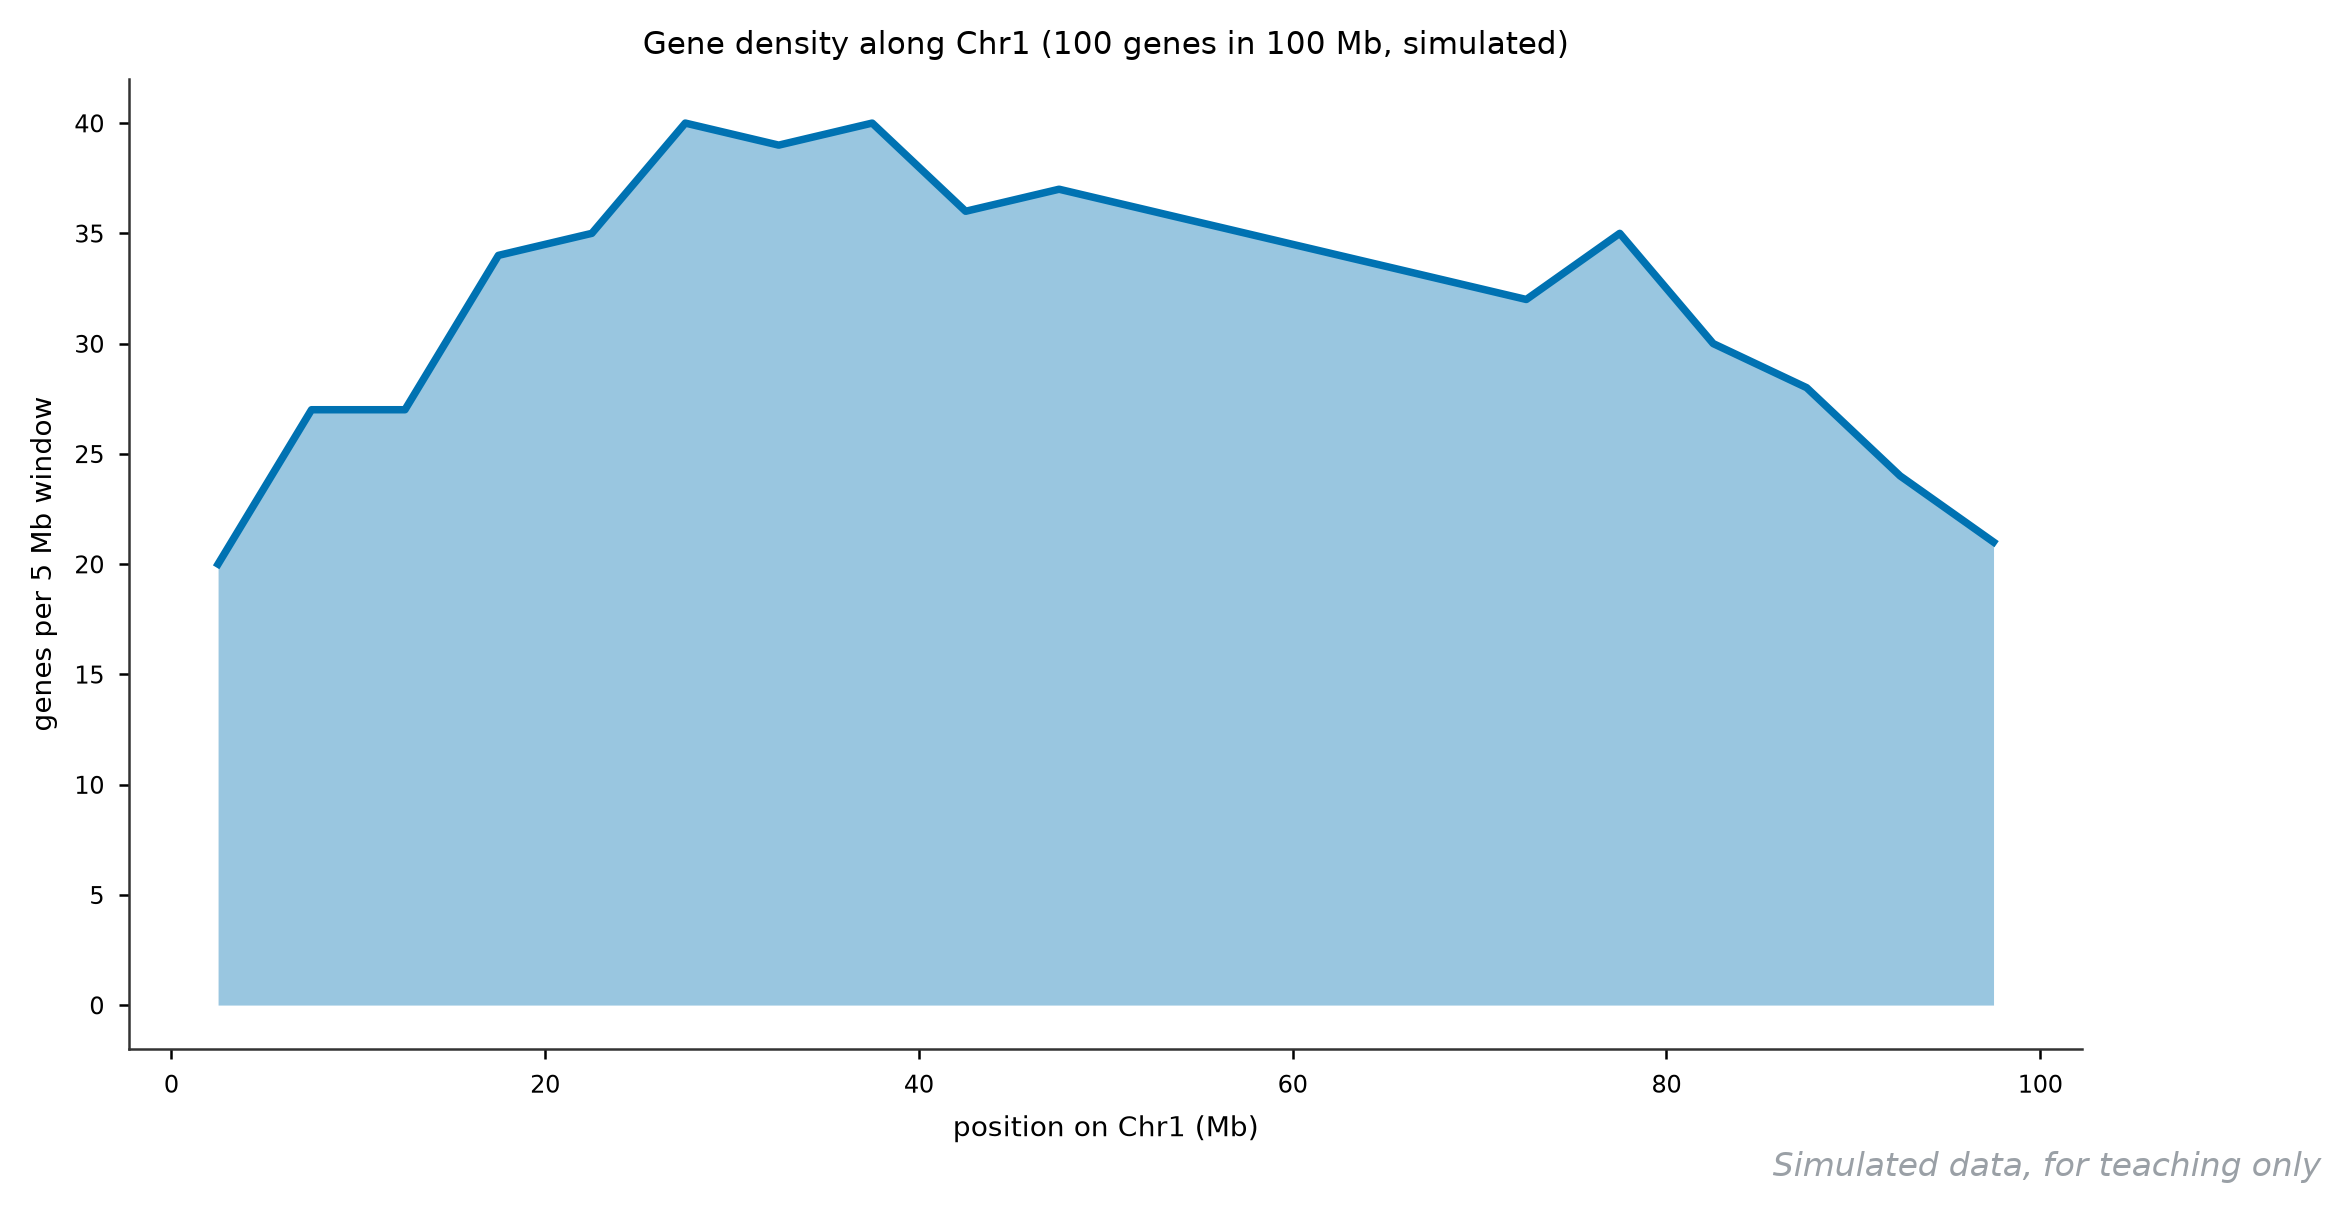
它回答什么问题:基因沿染色体疏密怎么变化——基因组注释质量的直觉检查,也常用来对照重复序列转座子的分布(通常互为镜像)。
怎么读:横轴是染色体位置,纵轴是每个窗口的基因数,填充曲线下面积方便看趋势。典型真核基因组是「着丝粒附近密度低、臂上密度高」;本图 30-40 Mb 处密度最高(每窗 40 个基因),向两端缓慢下降,真实基因组里的密度低谷往往对应着丝粒或重复序列爆发区。如果全染色体密度均匀得可疑,先怀疑注释跑漏了。
用什么画:从 GFF3 统计每窗基因数(bedtools makewindows 加 intersect),matplotlib 画填充折线。
图注示例:
图 52 模拟 Chr1 的基因密度分布(5 Mb 窗)。基因密度峰值出现在 30-40 Mb,两端密度下降,符合着丝粒附近基因稀少的普遍模式(模拟数据演示)。
展开查看:模拟数据与绘图代码
window_mb,count
2.5,20
7.5,27
12.5,27
17.5,34
22.5,35
27.5,40
32.5,39
37.5,40
42.5,36
47.5,37
52.5,36
57.5,35
62.5,34
67.5,33
72.5,32
77.5,35
82.5,30
87.5,28
92.5,24
97.5,21
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("52-genedensity.csv")
fig, ax = plt.subplots(figsize=(8.4, 4.2))
ax.fill_between(df.window_mb, df["count"], color="#4C72B0", alpha=0.4)
ax.plot(df.window_mb, df["count"], color="#4C72B0", lw=1.8)
ax.set_xlabel("position on Chr1 (Mb)")
ax.set_ylabel("genes per 5 Mb window")
fig.savefig("52-genedensity.png", dpi=200, bbox_inches="tight")
四、基因家族与序列分析
4.1 Motif logo 图
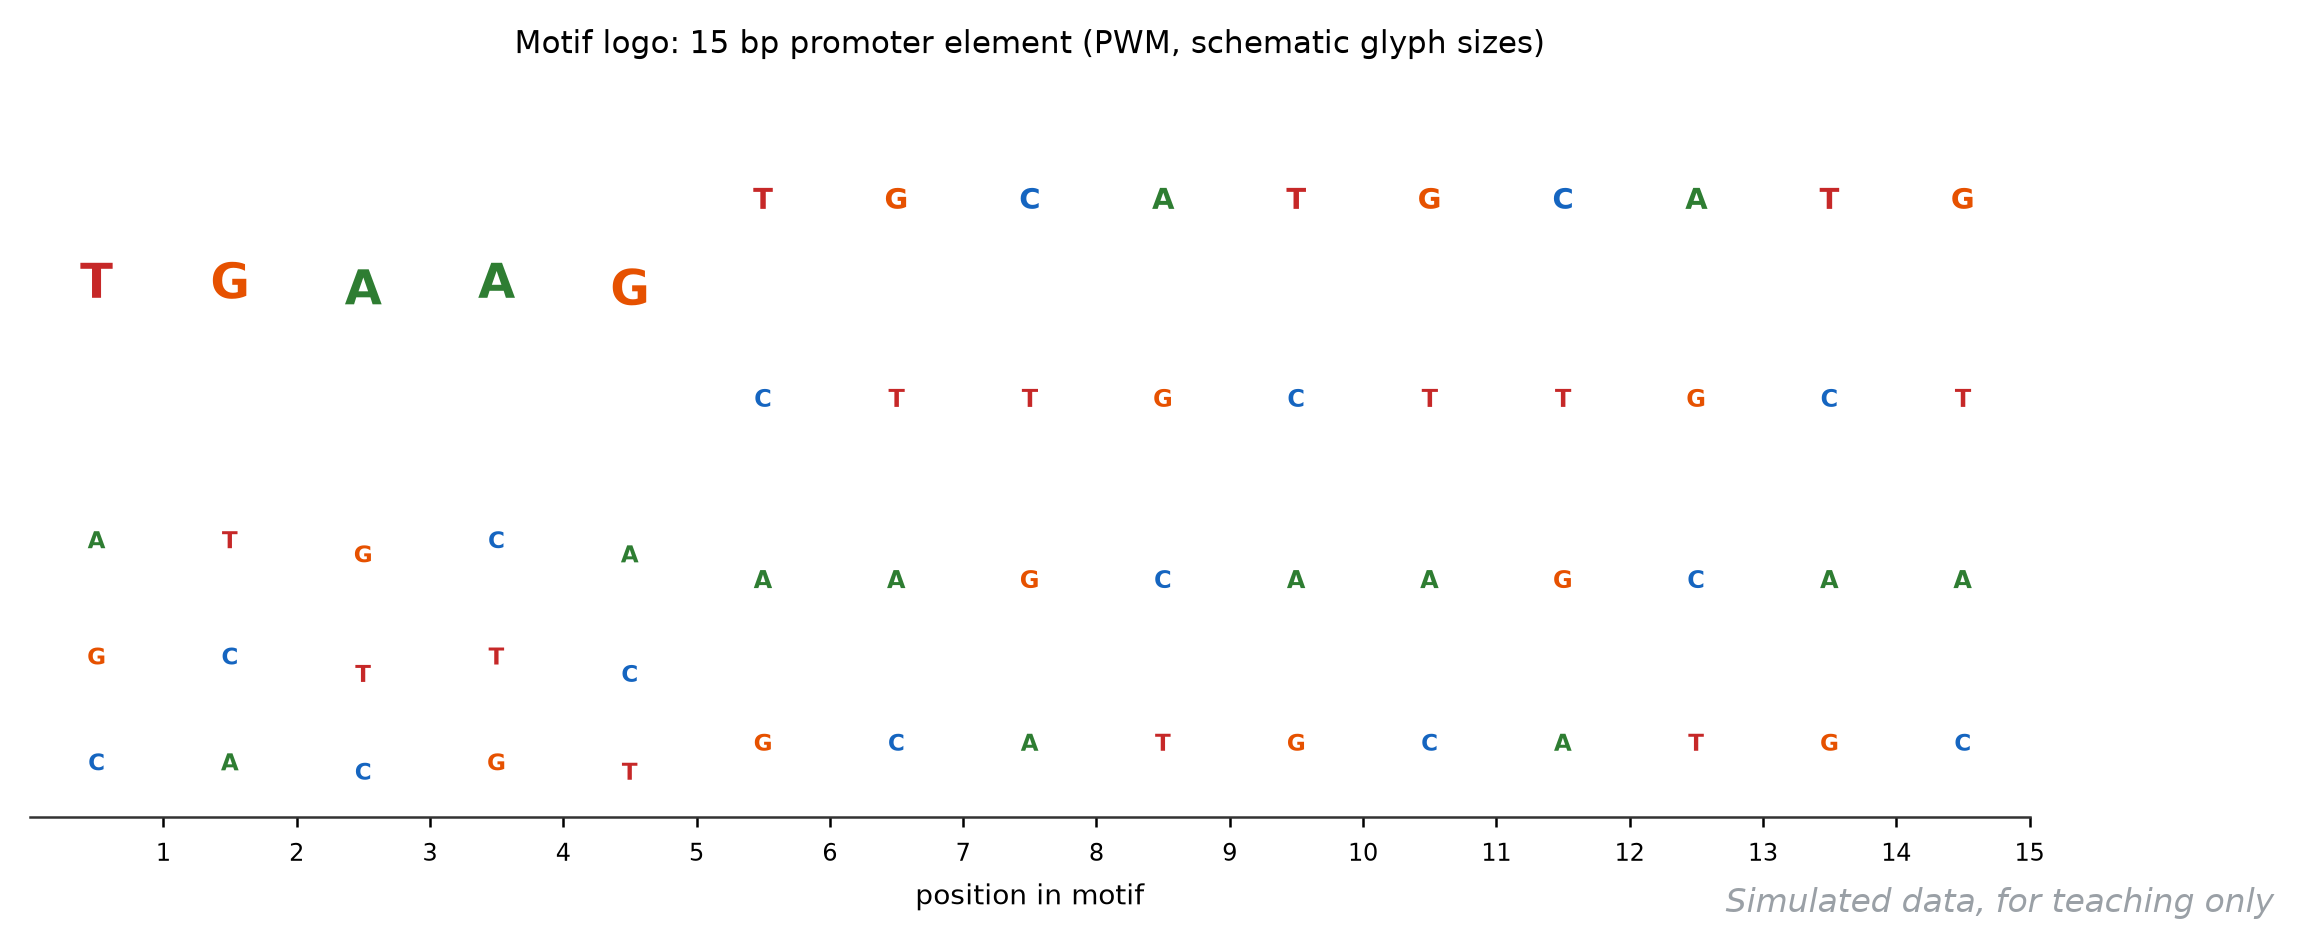
它回答什么问题:一段保守基序的每个位置偏好哪种碱基、偏好多强——MEME 扫完启动子或蛋白序列后的标准展示。
怎么读:每个位置一摞字母,字母大小正比于该碱基在此位置的出现概率(信息量),从上往下按概率堆叠。读法是先扫大字母拼出核心序列(本图前 5 位拼出 TGAAG,典型的 bZIP/WRKY 类元件风格),再看弱位置的小字母差异。真实 logo 的高度是 bits(信息量,0 到 2),本图教学版直接用概率,图注要写清。多物种同源启动子的 logo 变浅说明基序在退化。
用什么画:MEME 输出 PWM 后用 WebLogo 或 R 语言 ggseqlogo;本图按 PWM 用 matplotlib 字母堆叠示意。
图注示例:
图 53 启动子 15 bp 保守基序的 sequence logo(PWM 模拟)。字母高度正比该位置碱基频率,前 5 位保守核心为 TGAAG。
展开查看:PWM 数据与绘图代码
pos,A,C,G,T
0,0.175,0.146,0.146,0.534
1,0.146,0.146,0.534,0.175
2,0.550,0.120,0.180,0.150
3,0.534,0.175,0.146,0.146
4,0.180,0.150,0.550,0.120
5,0.250,0.250,0.200,0.300
6,0.250,0.200,0.300,0.250
7,0.200,0.300,0.250,0.250
8,0.300,0.250,0.250,0.200
9,0.250,0.250,0.200,0.300
10,0.250,0.200,0.300,0.250
11,0.200,0.300,0.250,0.250
12,0.300,0.250,0.250,0.200
13,0.250,0.250,0.200,0.300
14,0.250,0.200,0.300,0.250
绘图代码(Python,独立可运行;字母大小示意概率)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("53-motif-pwm.csv")
bcol = {"A": "#2E7D32", "C": "#1565C0", "G": "#E65100", "T": "#C62828"}
fig, ax = plt.subplots(figsize=(8.6, 3.2))
for _, row in df.iterrows():
    i, stack = int(row.pos), 0.0
    for b in sorted("ACGT", key=lambda x: row[x]):
        h = row[b]
        ax.text(i + 0.5, stack + h / 2, b, fontsize=h * 30, color=bcol[b],
                ha="center", va="center", fontweight="bold")
        stack += h
ax.set_xlim(0, 15)
ax.set_ylim(0, 1.02)
ax.set_xticks(range(1, 16))
ax.set_yticks([])
ax.spines["left"].set_visible(False)
ax.set_xlabel("position in motif")
fig.savefig("53-motiflogo.png", dpi=200, bbox_inches="tight")
4.2 基因结构图
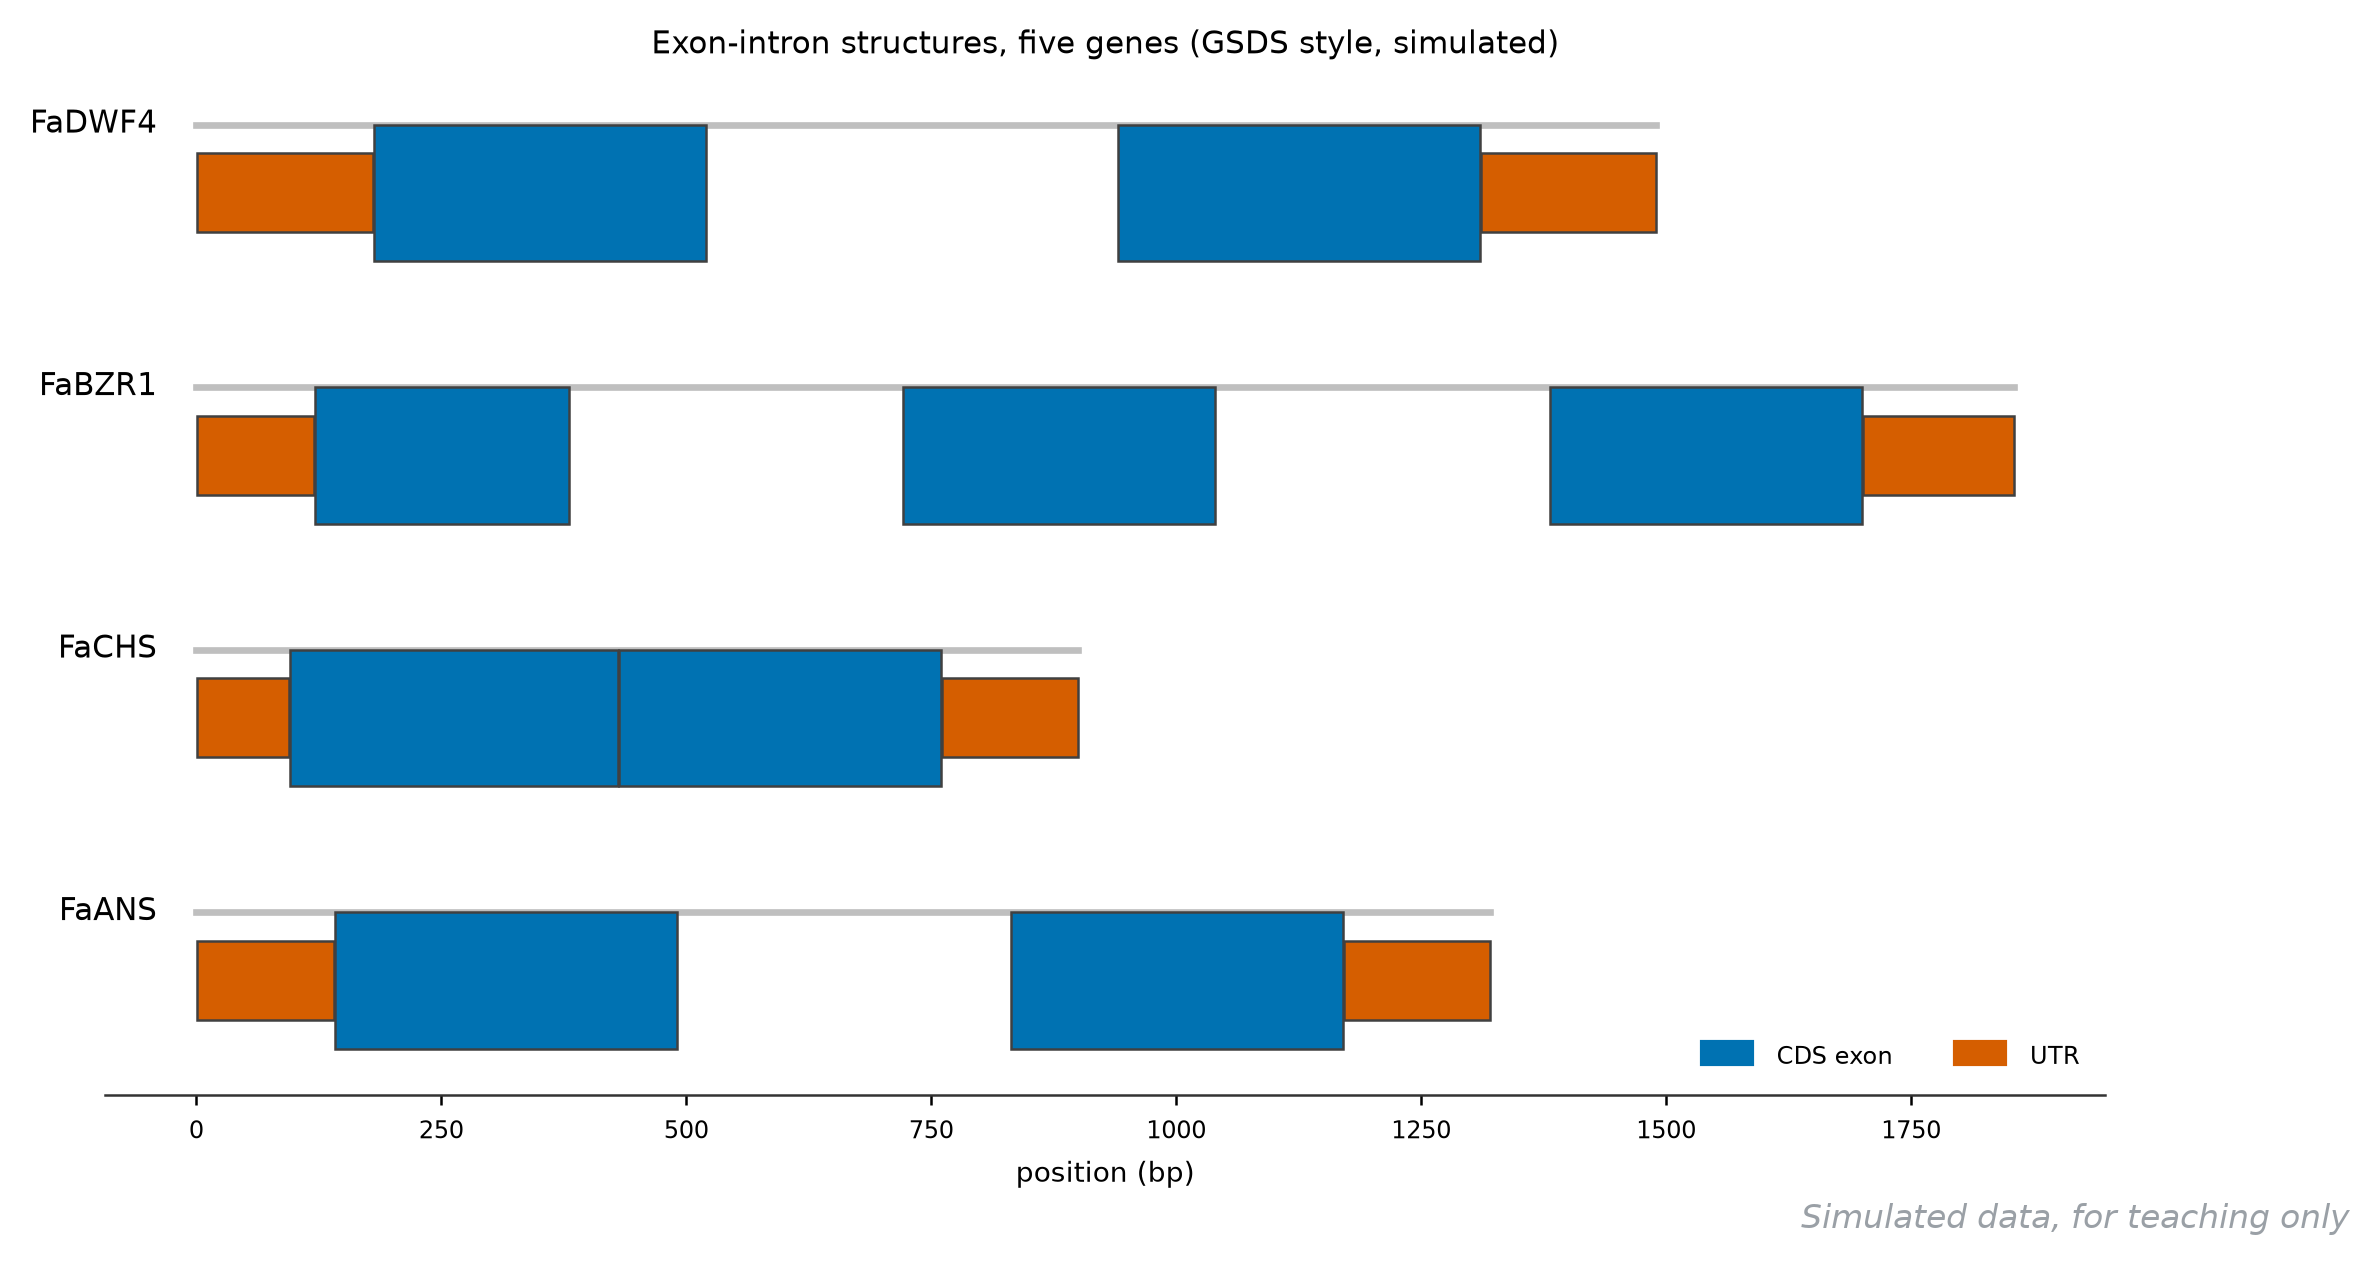
它回答什么问题:家族成员的外显子-内含子结构是否保守、外显子有没有增减——基因家族分析三件套(树、motif、结构)之一。
怎么读:每行一个基因,宽方块是 CDS 外显子,窄方块是 UTR,细线是内含子。看三样:外显子数量和长度模式是否一致(一致=剪接模式保守)、内含子相位有没有丢(丢失常暗示假基因化)、5端 3端 UTR 长短差异(影响转录后调控)。本图 FaBZR1 是三外显子两内含子,FaDWF4 与 FaANS 为两段式,而 FaCHS 的两段外显子直接相连、中间没有内含子,剪接结构的差异一目了然。
用什么画:GSDS 2.0 网页版提交 GFF 即可;批量自定义用 matplotlib 按坐标画方块。
图注示例:
图 54 五个候选基因的外显子-内含子结构(模拟)。宽框为 CDS 外显子,窄框为 UTR,细线为内含子;FaCHS 的两段外显子直接相连、无内含子,结构与其余基因明显不同。
展开查看:结构坐标与绘图代码
gene,part,start,end
FaDWF4,utr5,1,180
FaDWF4,exon,181,520
FaDWF4,intron,521,940
FaDWF4,exon,941,1310
FaDWF4,utr3,1311,1490
FaBZR1,utr5,1,120
FaBZR1,exon,121,380
FaBZR1,intron,381,720
FaBZR1,exon,721,1040
FaBZR1,intron,1041,1380
FaBZR1,exon,1381,1700
FaBZR1,utr3,1701,1855
FaCHS,utr5,1,95
FaCHS,exon,96,430
FaCHS,exon,431,760
FaCHS,utr3,761,900
FaANS,utr5,1,140
FaANS,exon,141,490
FaANS,intron,491,830
FaANS,exon,831,1170
FaANS,utr3,1171,1320
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("54-genestructure.csv")
genes = list(dict.fromkeys(df.gene))
CAT = {"exon": "#4C72B0", "utr5": "#DD8452", "utr3": "#DD8452"}
fig, ax = plt.subplots(figsize=(8.6, 4.4))
for y, g in enumerate(genes):
    sub = df[df.gene == g]
    ax.plot([0, sub.end.max()], [y, y], color="0.75", lw=1.6, zorder=1)
    for _, row in sub[sub.part != "intron"].iterrows():
        w = 0.52 if row.part == "exon" else 0.30
        ax.add_patch(plt.Rectangle((row.start, y + (0.52 - w) / 2),
                                   row.end - row.start, w,
                                   facecolor=CAT[row.part], edgecolor="0.25"))
    ax.text(-40, y, g, ha="right", va="center", fontsize=9.5)
ax.set_yticks([])
ax.set_xlabel("position (bp)")
ax.invert_yaxis()
ax.spines["left"].set_visible(False)
fig.savefig("54-genestructure.png", dpi=200, bbox_inches="tight")
4.3 多序列比对保守性图
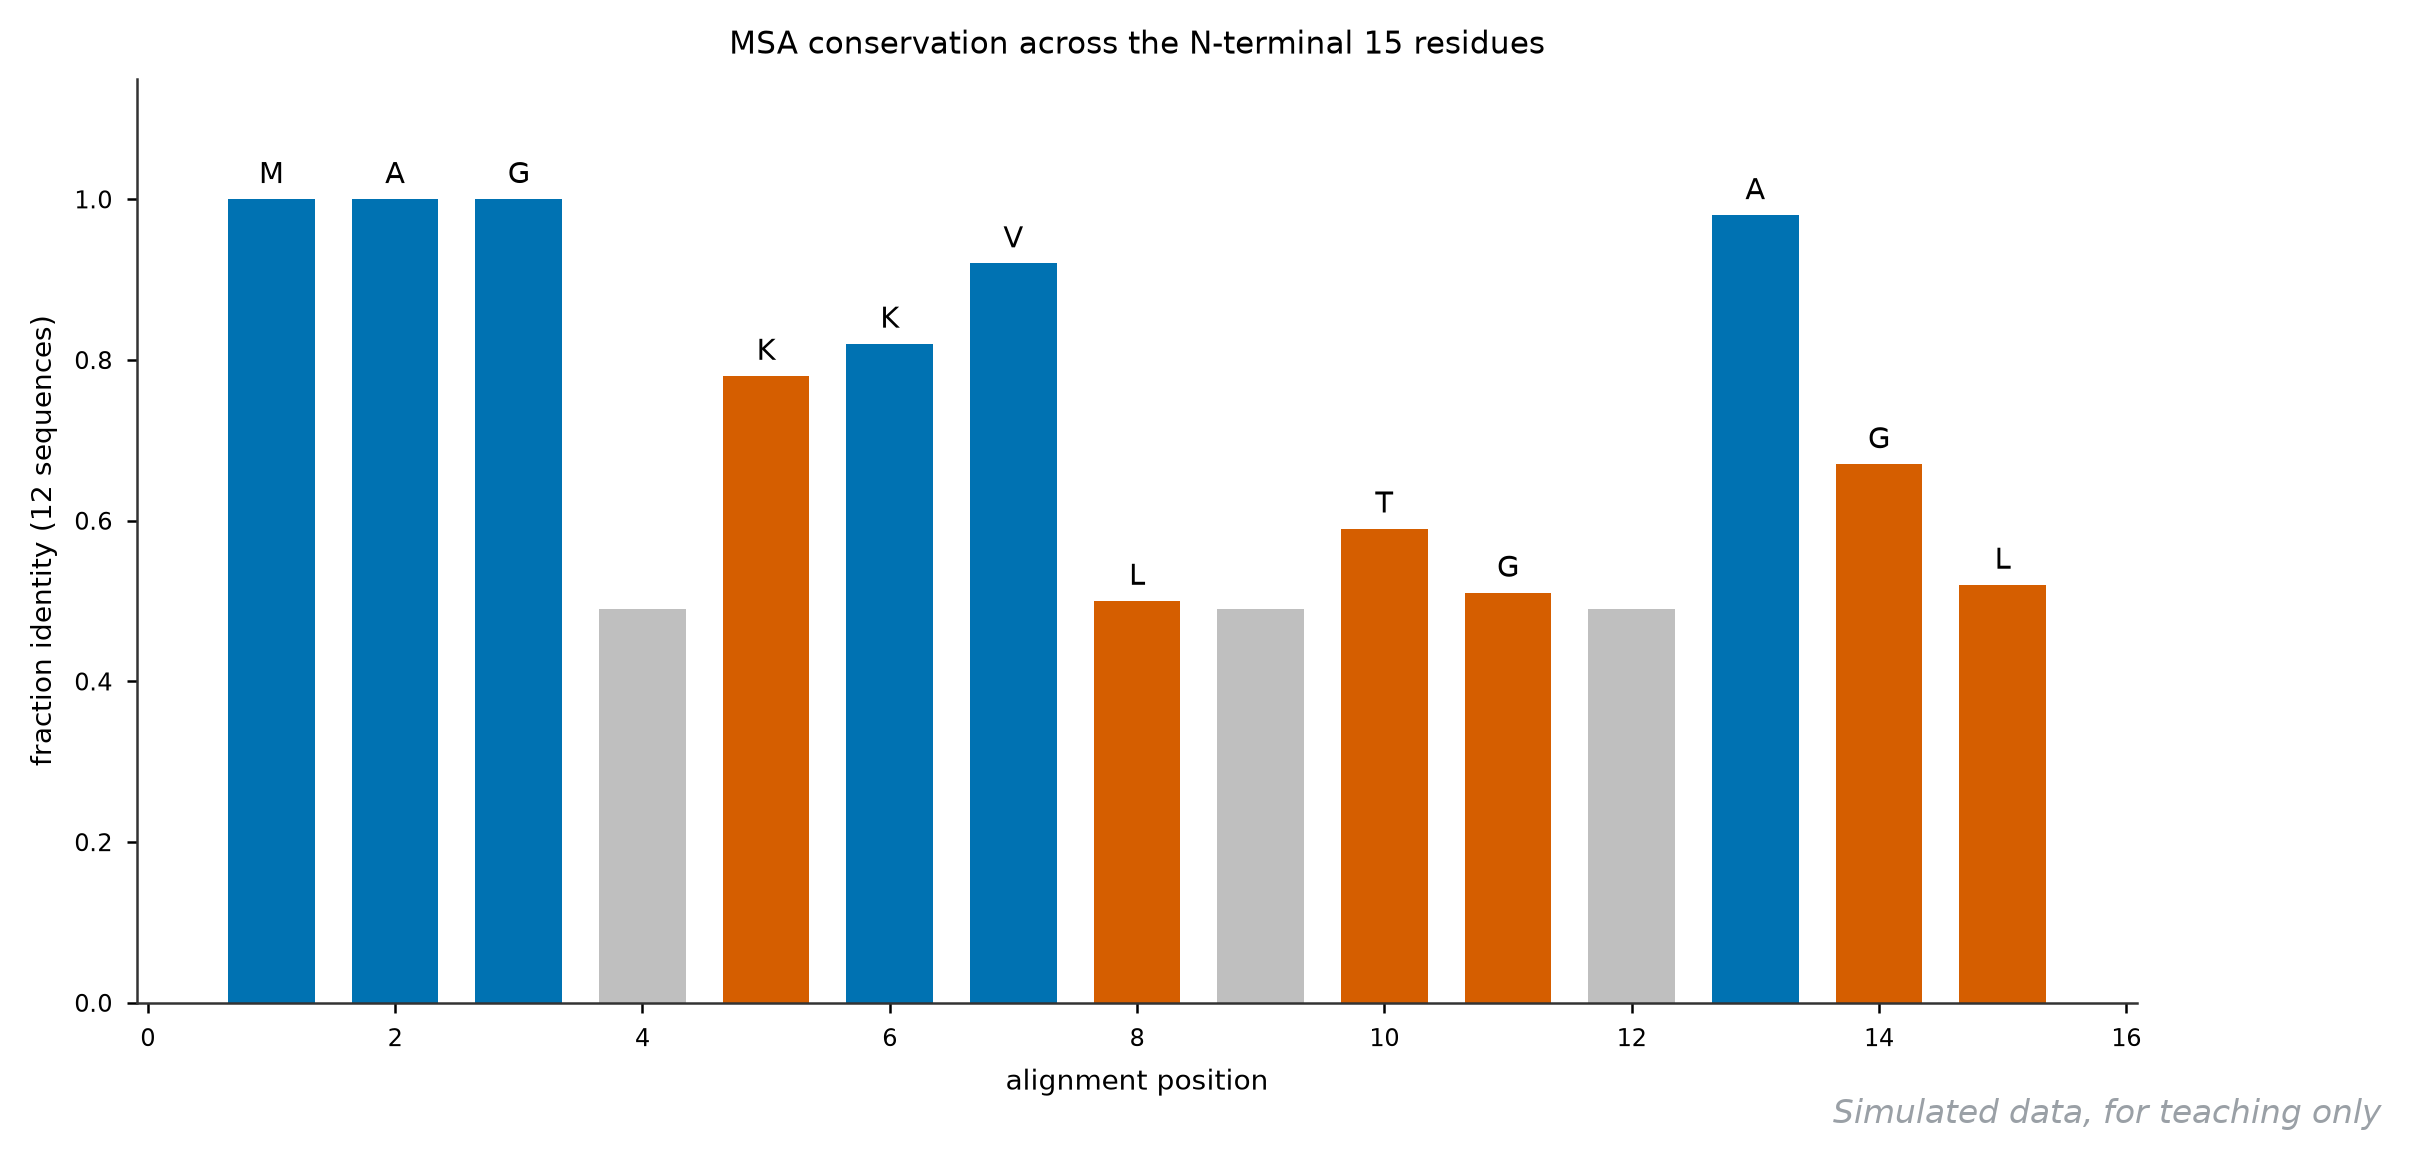
它回答什么问题:比对后的 12 条序列在每一位上有多保守——比 logo 更「定量」的逐位视图,常放在 motif 分析后面核对关键残基。
怎么读:横轴是比对位置,柱高是 12 条序列在该位的一致性比例,柱顶字母是共识残基。深蓝柱(>= 0.8)是硬保守位点,适合写进「功能位点」;橙色中保守位点(0.5-0.8)暗示功能约束松一些;灰柱是可变区。开头三个 100% 的残基 M-A-G 通常是起始甲硫氨酸加保守基序起点,正文里指认功能时优先引用这类位点。
用什么画:Jalview 自带保守性着色;批量出图用 Python 对比对文件逐列统计再画柱。
图注示例:
图 55 12 条同源序列 N 端 15 个比对位点的保守性。柱高为一致残基比例,柱顶字母为共识残基;前三位完全保守(模拟数据演示)。
展开查看:逐位数据与绘图代码
pos,identity,consensus
1,1.00,M
2,1.00,A
3,1.00,G
4,0.49,K
5,0.78,K
6,0.82,K
7,0.92,V
8,0.50,L
9,0.49,A
10,0.59,T
11,0.51,G
12,0.49,G
13,0.98,A
14,0.67,G
15,0.52,L
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("55-msa.csv")
cols = ["#4C72B0" if v >= 0.8 else ("#DD8452" if v >= 0.5 else "0.75")
        for v in df.identity]
fig, ax = plt.subplots(figsize=(8.6, 4.0))
ax.bar(df.pos, df.identity, color=cols, width=0.7)
for _, row in df.iterrows():
    if row.identity >= 0.5:
        ax.text(row.pos, row.identity + 0.02, row.consensus, ha="center", fontsize=9)
ax.set_ylim(0, 1.15)
ax.set_xlabel("alignment position")
ax.set_ylabel("fraction identity (12 sequences)")
fig.savefig("55-msa.png", dpi=200, bbox_inches="tight")
五、微生物组与生态
5.1 PCoA 置信椭圆图
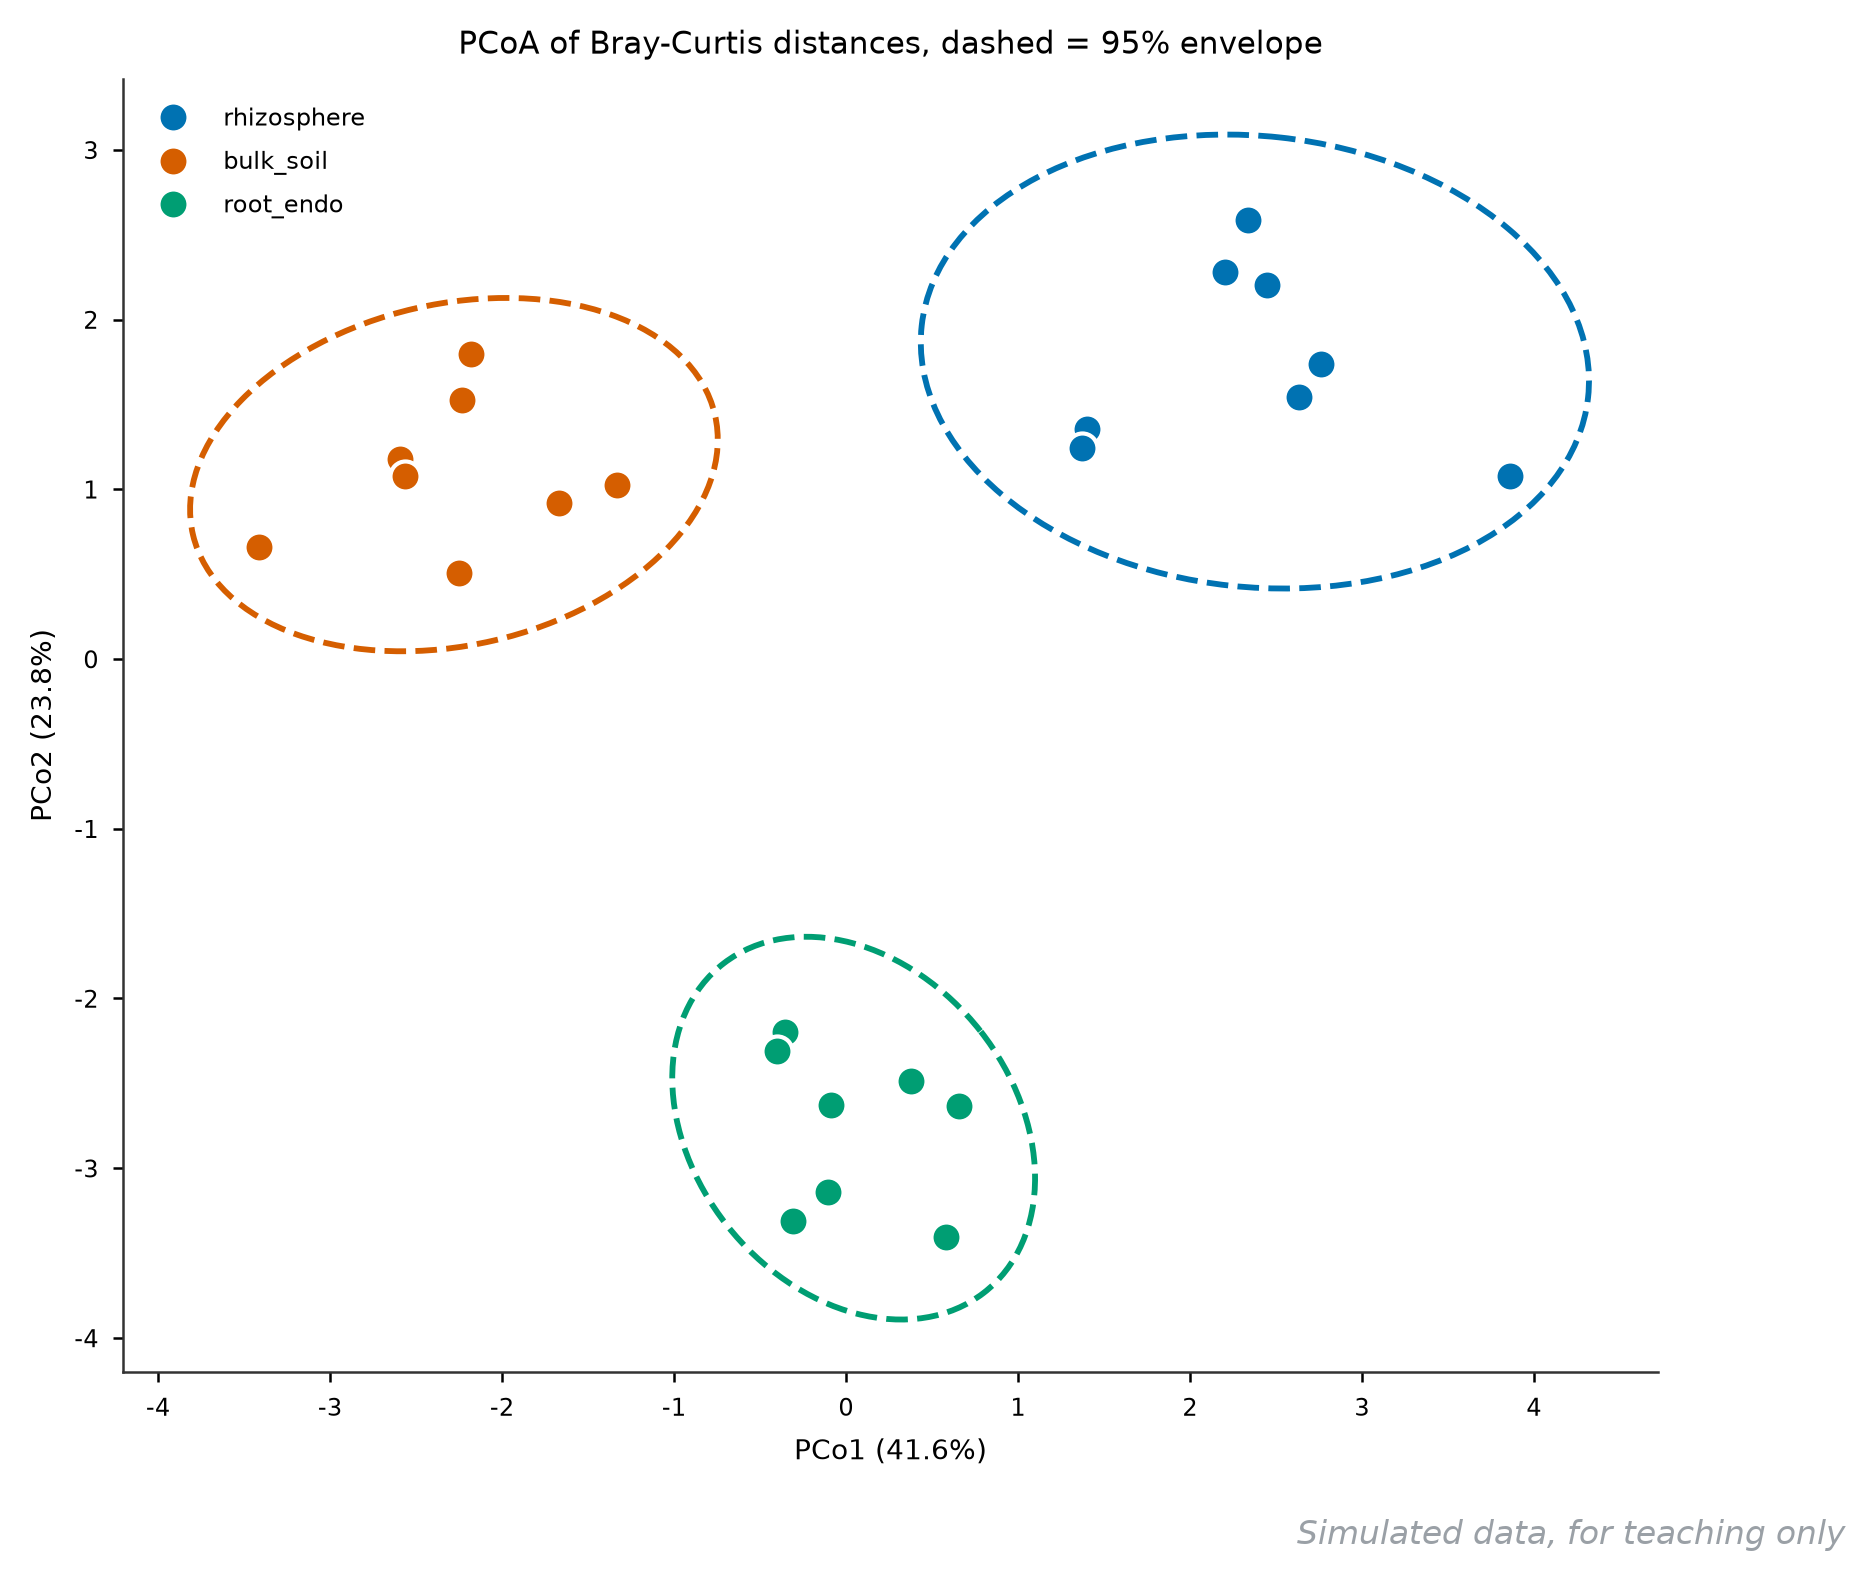
它回答什么问题:不同生境的微生物群落组成是否分得开——Beta 多样性主坐标分析,微生物组文章的第一张图。
怎么读:每个点是一个样本的群落「指纹」,距离越近组成越像;轴标签的百分比是该轴解释的方差。虚线椭圆是各组的 95% 置信包络(基于协方差),包络不重叠=组间差异肉眼可见(是否显著还要看 PERMANOVA 的 p 值,图注要报)。与 PCA 的区别:PCoA 可以用任意距离(这里 Bray-Curtis),所以先在方法里写清距离选择。
用什么画:QIIME2 core-metrics 出 qzv 后在 view.qiime2.org 看;重绘用 skbio.stats.ordination 或按坐标表手绘。
图注示例:
图 56 根际、 bulk 土壤与根内三个生境的 PCoA 分析(Bray-Curtis 距离)。PCo1 与 PCo2 分别解释 41.6% 与 23.8%;虚线椭圆为 95% 置信包络(模拟数据演示)。
展开查看:坐标数据与绘图代码
site,group,PCo1,PCo2
S1,rhizosphere,2.64,1.54
S2,rhizosphere,3.86,1.08
S3,rhizosphere,2.76,1.74
S4,rhizosphere,2.21,2.28
S5,rhizosphere,1.40,1.36
S6,rhizosphere,2.34,2.58
S7,rhizosphere,2.45,2.20
S8,rhizosphere,1.38,1.24
S9,bulk_soil,-1.67,0.92
S10,bulk_soil,-2.23,1.53
S11,bulk_soil,-3.41,0.66
S12,bulk_soil,-2.25,0.50
S13,bulk_soil,-2.59,1.18
S14,bulk_soil,-2.57,1.08
S15,bulk_soil,-2.18,1.80
S16,bulk_soil,-1.33,1.02
S17,root_endo,-0.36,-2.20
S18,root_endo,0.38,-2.49
S19,root_endo,-0.40,-2.31
S20,root_endo,0.58,-3.40
S21,root_endo,0.66,-2.63
S22,root_endo,-0.31,-3.31
S23,root_endo,-0.09,-2.63
S24,root_endo,-0.11,-3.14
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

df = pd.read_csv("56-pcoa.csv")
CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig, ax = plt.subplots(figsize=(6.6, 5.6))
for i, g in enumerate(df.group.unique()):
    sub = df[df.group == g]
    ax.scatter(sub.PCo1, sub.PCo2, s=52, color=CAT[i], edgecolors="white", label=g)
    cov = np.cov(sub.PCo1, sub.PCo2)
    vals, vecs = np.linalg.eigh(cov)
    o = vals.argsort()[::-1]
    ang = np.degrees(np.arctan2(*vecs[:, o[0]][::-1]))
    ax.add_patch(Ellipse((sub.PCo1.mean(), sub.PCo2.mean()),
                         2 * np.sqrt(vals[o[0]] * 5.99),
                         2 * np.sqrt(vals[o[1]] * 5.99), angle=ang,
                         fill=False, edgecolor=CAT[i], ls="--", lw=1.4))
ax.set_xlabel("PCo1 (41.6%)")
ax.set_ylabel("PCo2 (23.8%)")
ax.legend()
fig.savefig("56-pcoa.png", dpi=200, bbox_inches="tight")
5.2 Alpha 多样性箱线图(字母标记)
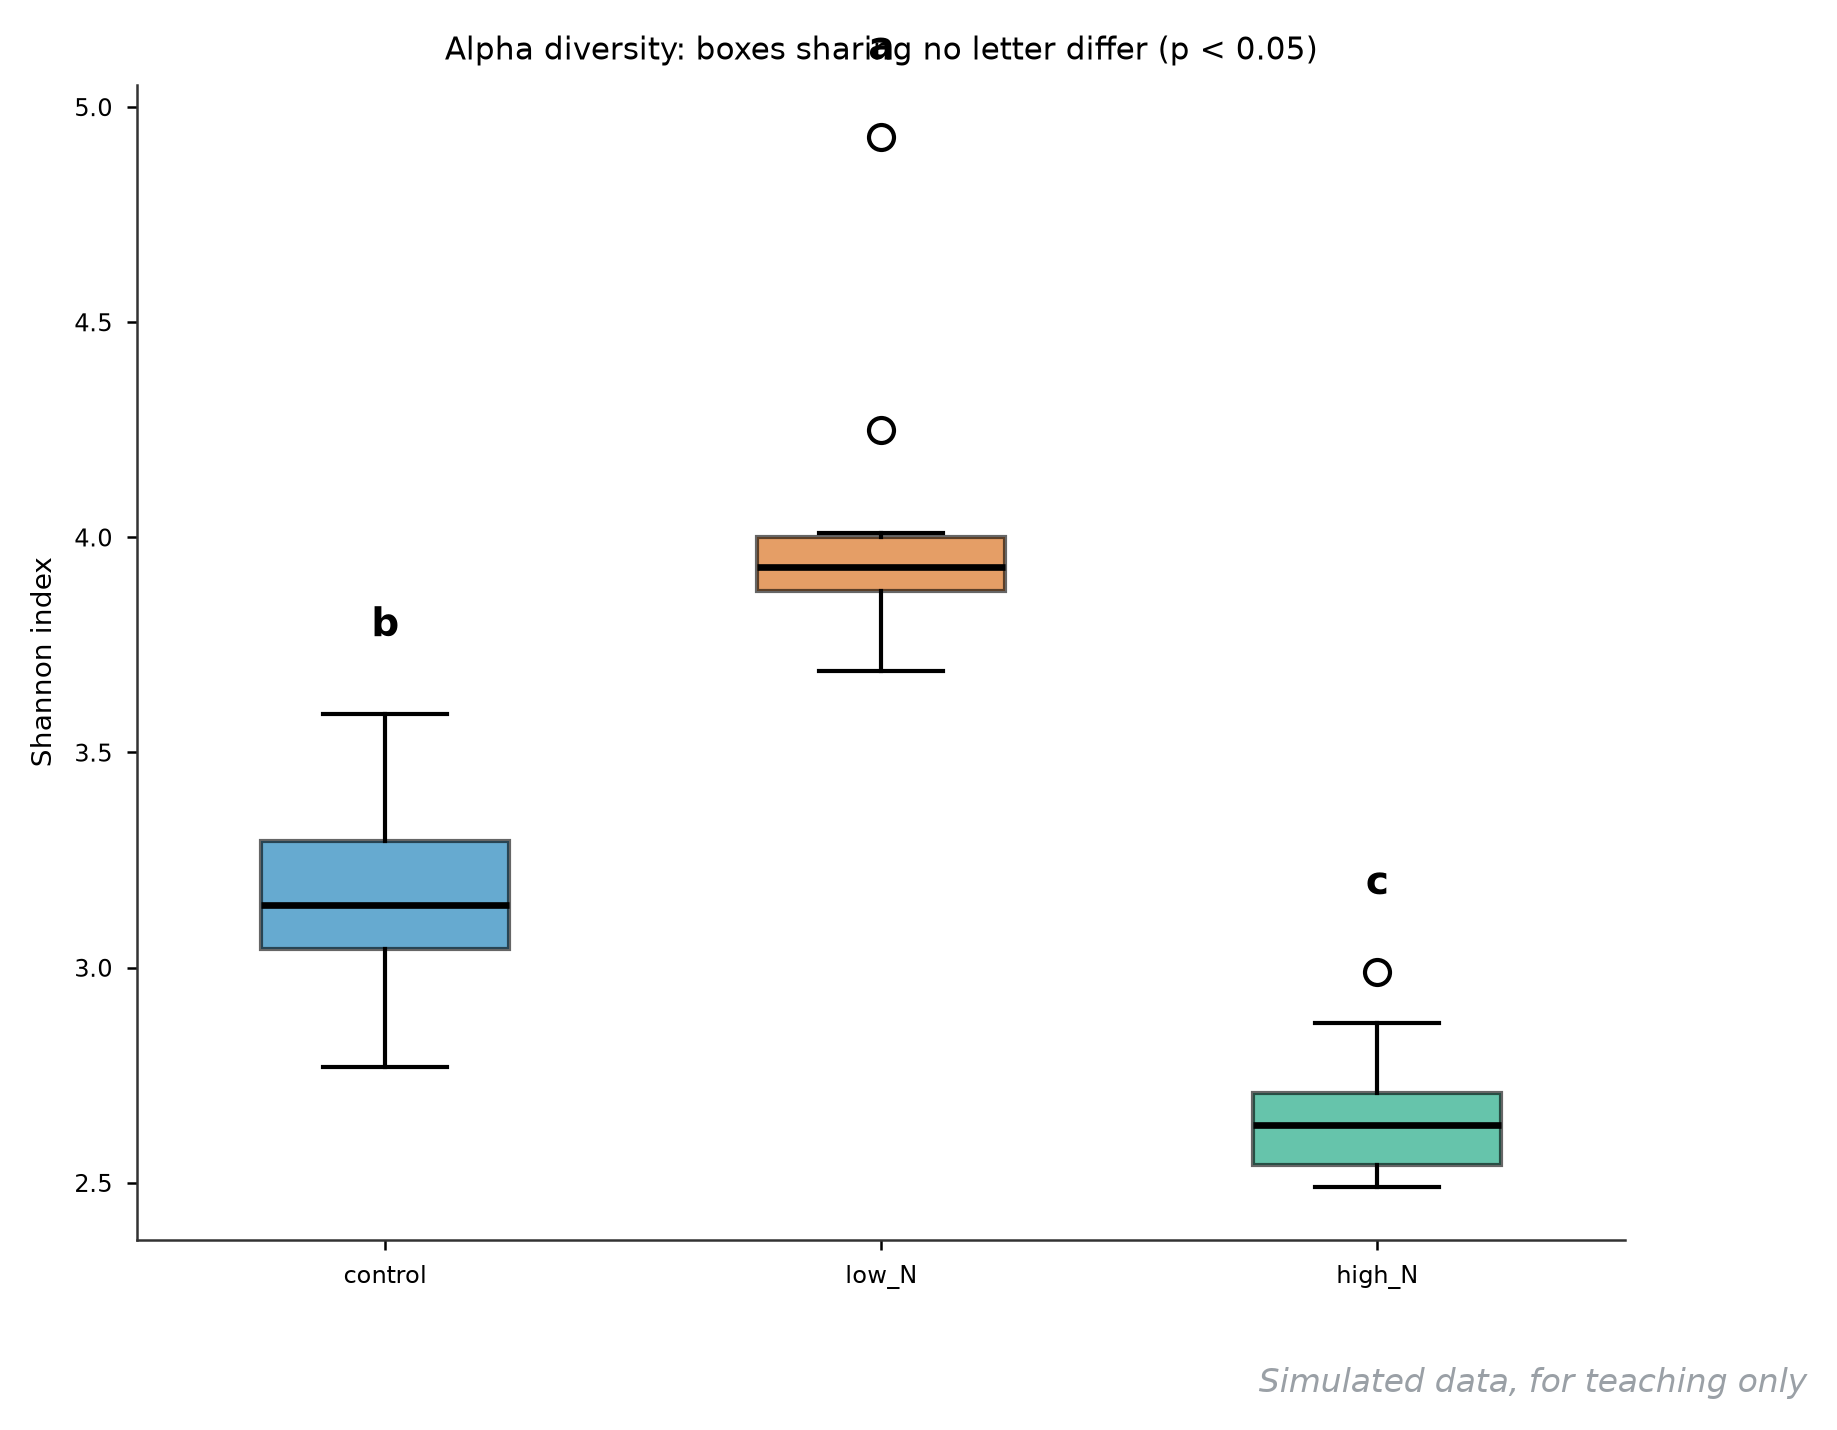
它回答什么问题:三组处理的群落多样性(组内 richness 加均匀度)谁高谁低——用 a/b/c 字母标记的多重比较版本,比星号更适合三组以上。
怎么读:每箱一组的 Shannon 指数分布,箱顶字母是多重比较的「简写结论」:字母完全不同的组之间差异显著(p < 0.05),共享字母的不显著。本图 low_N 标 a 显著最高,control 标 b 居中,high_N 标 c 显著最低——「加氮压低多样性」的故事一眼讲完。审稿人常追问用的是哪种事后检验(Dunn、Tukey),方法里写明即可。
用什么画:QIIME2 alpha-group-significance,或 R 语言 vegan 加 agricolae 的字母标记流程。
图注示例:
图 57 三种氮处理下根际细菌 Shannon 指数(n = 10)。箱体为四分位距;不同字母表示组间差异显著(Kruskal-Wallis 加 Dunn 事后检验,p < 0.05,模拟数据演示)。
展开查看:模拟数据与绘图代码
treatment,shannon
control,2.77
control,3.30
control,3.11
control,3.18
control,3.28
control,3.30
control,3.59
control,3.08
control,3.03
control,2.83
low_N,3.97
low_N,3.97
low_N,3.69
low_N,3.89
low_N,3.89
low_N,4.93
low_N,3.76
low_N,4.25
low_N,4.01
low_N,3.87
high_N,2.71
high_N,2.70
high_N,2.59
high_N,2.53
high_N,2.50
high_N,2.49
high_N,2.68
high_N,2.57
high_N,2.87
high_N,2.99
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("57-alpha.csv")
groups = df.treatment.unique()
data = [df[df.treatment == g].shannon for g in groups]
CAT = ["#4C72B0", "#DD8452", "#55A868"]
letters = ["b", "a", "c"]                        # 由事后检验得出,此处按中位数演示
fig, ax = plt.subplots(figsize=(6.4, 5.0))
bp = ax.boxplot(data, tick_labels=groups, patch_artist=True, widths=0.5,
                medianprops=dict(color="black", lw=1.6))
for patch, col in zip(bp["boxes"], CAT):
    patch.set_facecolor(col)
    patch.set_alpha(0.6)
for i, (d, letter) in enumerate(zip(data, letters), 1):
    ax.text(i, d.max() + 0.18, letter, ha="center", fontsize=12, fontweight="bold")
ax.set_ylabel("Shannon index")
fig.savefig("57-alpha.png", dpi=200, bbox_inches="tight")
5.3 物种相对丰度堆叠柱状图
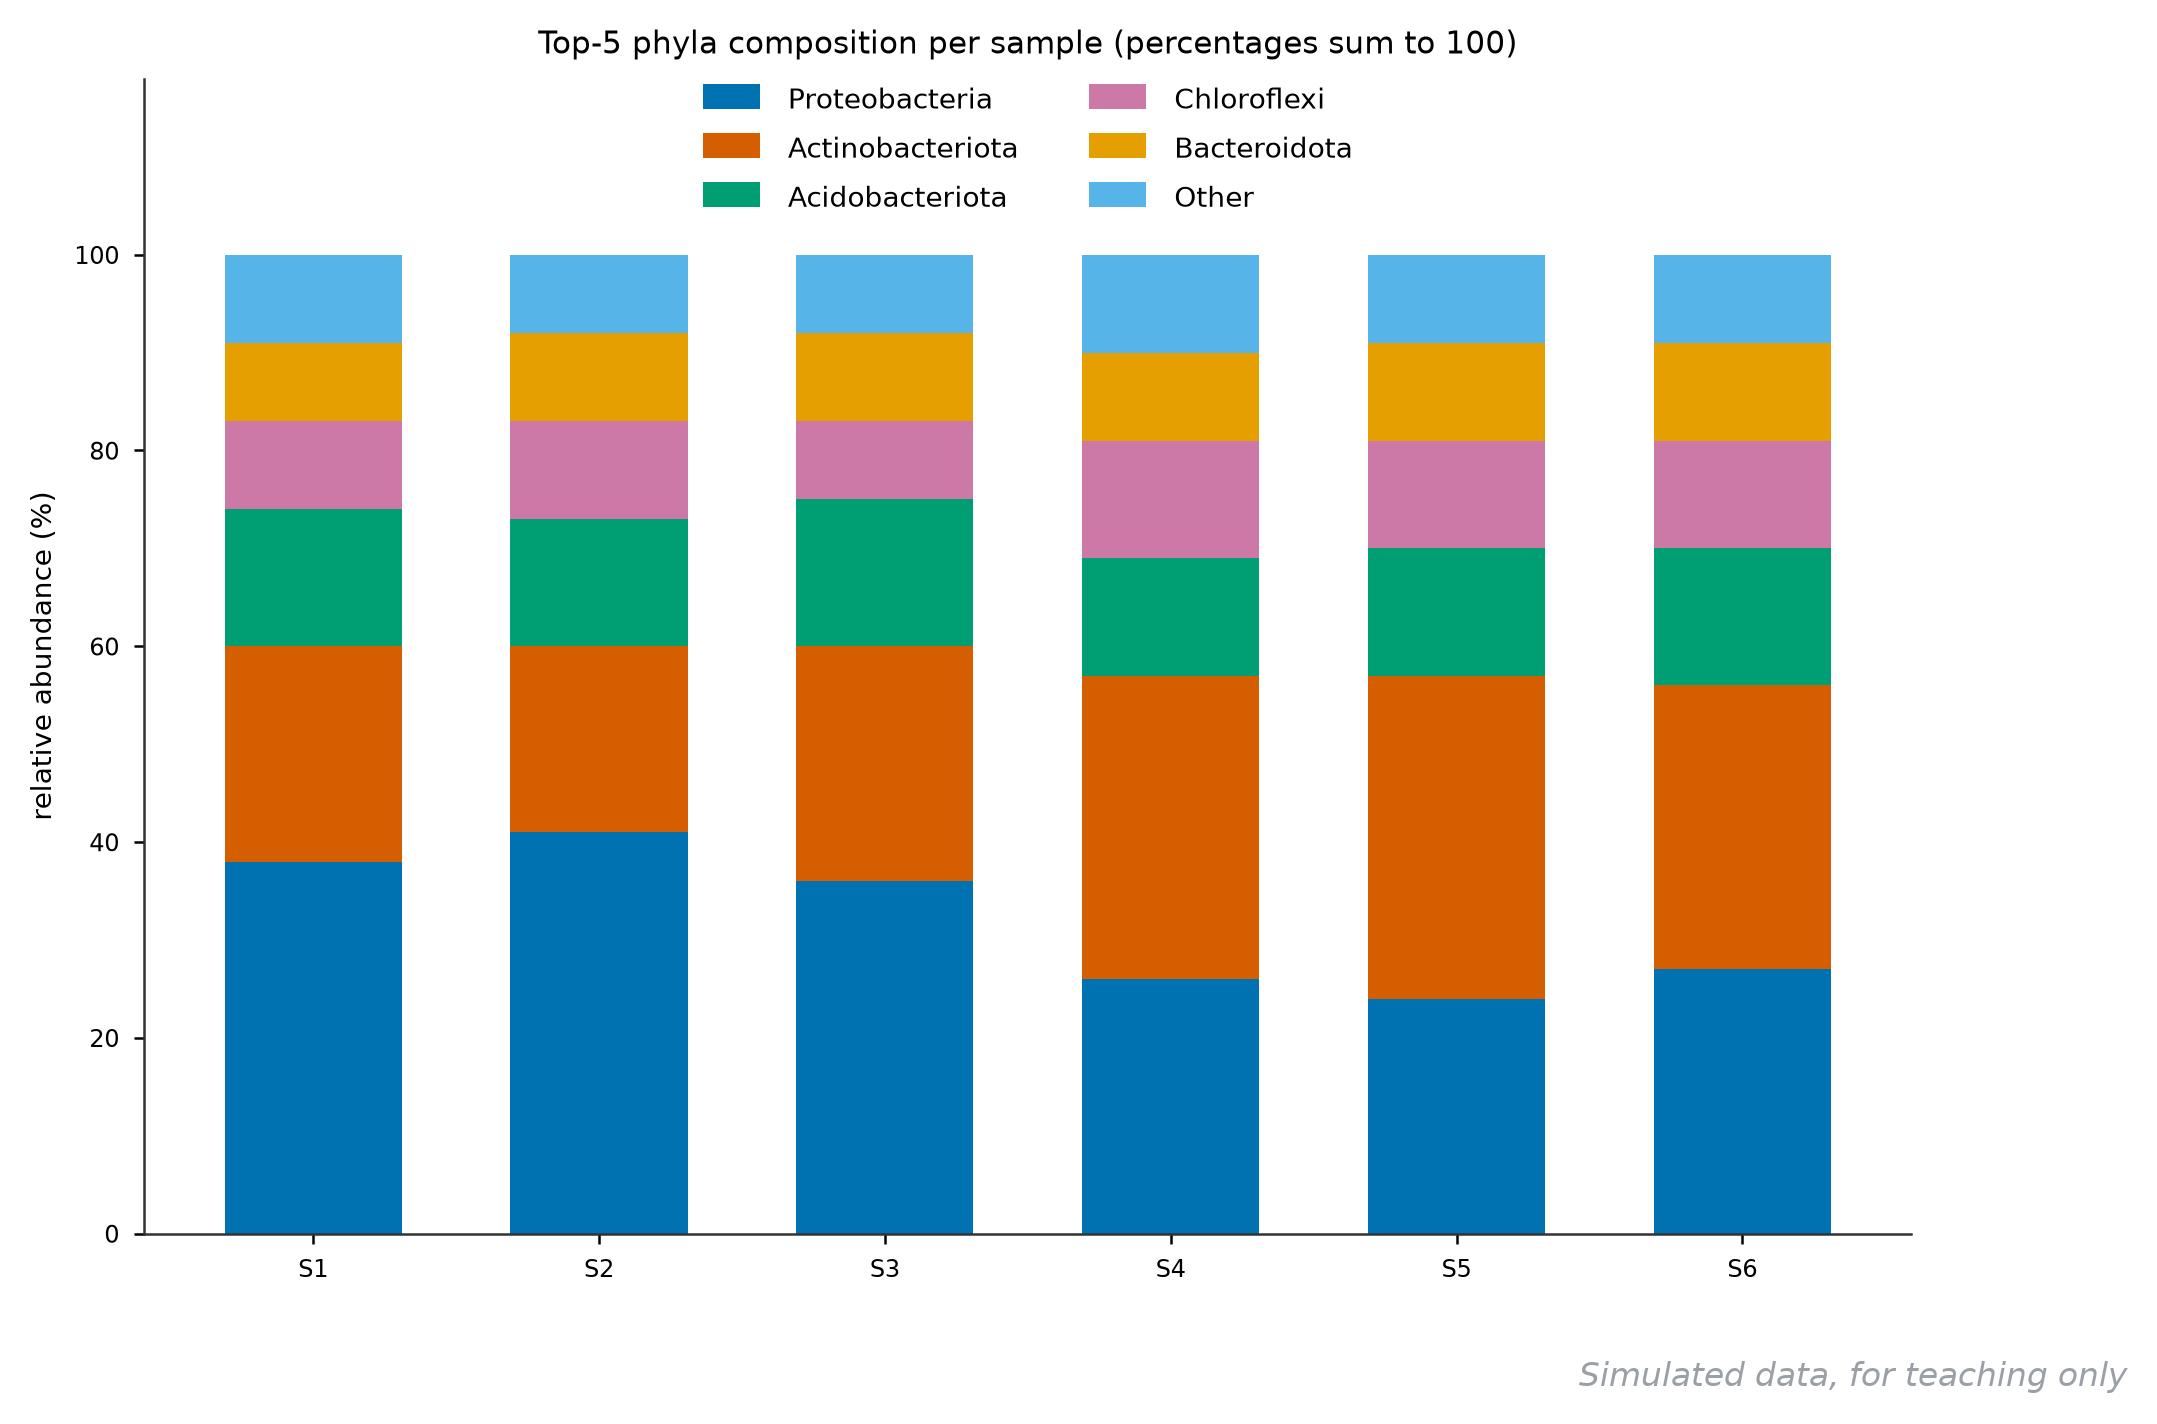
它回答什么问题:每个样本的群落由哪些门类构成、各占多少——物种组成的标准总览。
怎么读:每根柱一个样本,颜色段是各门的相对丰度,从下往上堆叠。看两样:优势门的切换(S1-S3 以变形菌为主,S4-S6 放线菌上升——处理或时间点的信号)、以及低丰度门的取舍(本图把长尾合并成 Other,否则图例比柱子还长)。百分比的分母是「本样本全部序列」,所以各段加起来恒等于 100,读相对比例即可,不要跨样本比绝对量。
用什么画:QIIME2 taxa-bar-plots;重绘用 pandas 宽表 plot.bar(stacked=True)。
图注示例:
图 58 六个样本的门水平相对丰度堆叠图(前 5 门加 Other)。S4-S6 中放线菌门比例上升,与处理组对应(模拟数据演示)。
展开查看:模拟数据与绘图代码
sample,Proteobacteria,Actinobacteriota,Acidobacteriota,Chloroflexi,Bacteroidota,Other
S1,38,22,14,9,8,9
S2,41,19,13,10,9,8
S3,36,24,15,8,9,8
S4,26,31,12,12,9,10
S5,24,33,13,11,10,9
S6,27,29,14,11,10,9
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("58-abundance.csv", index_col="sample")
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860"]
fig, ax = plt.subplots(figsize=(7.6, 5.0))
bottom = np.zeros(len(df))
for j, col in enumerate(df.columns):            # 逐门堆叠,x 轴为样本
    ax.bar(df.index, df[col], bottom=bottom, label=col, color=CAT[j], width=0.62)
    bottom += df[col].values
ax.set_ylabel("relative abundance (%)")
ax.set_ylim(0, 118)
ax.legend(ncol=2, fontsize=8.5, loc="upper center", bbox_to_anchor=(0.5, 1.02))
fig.savefig("58-abundance.png", dpi=200, bbox_inches="tight")
六、单细胞补充
6.1 拟时序轨迹图
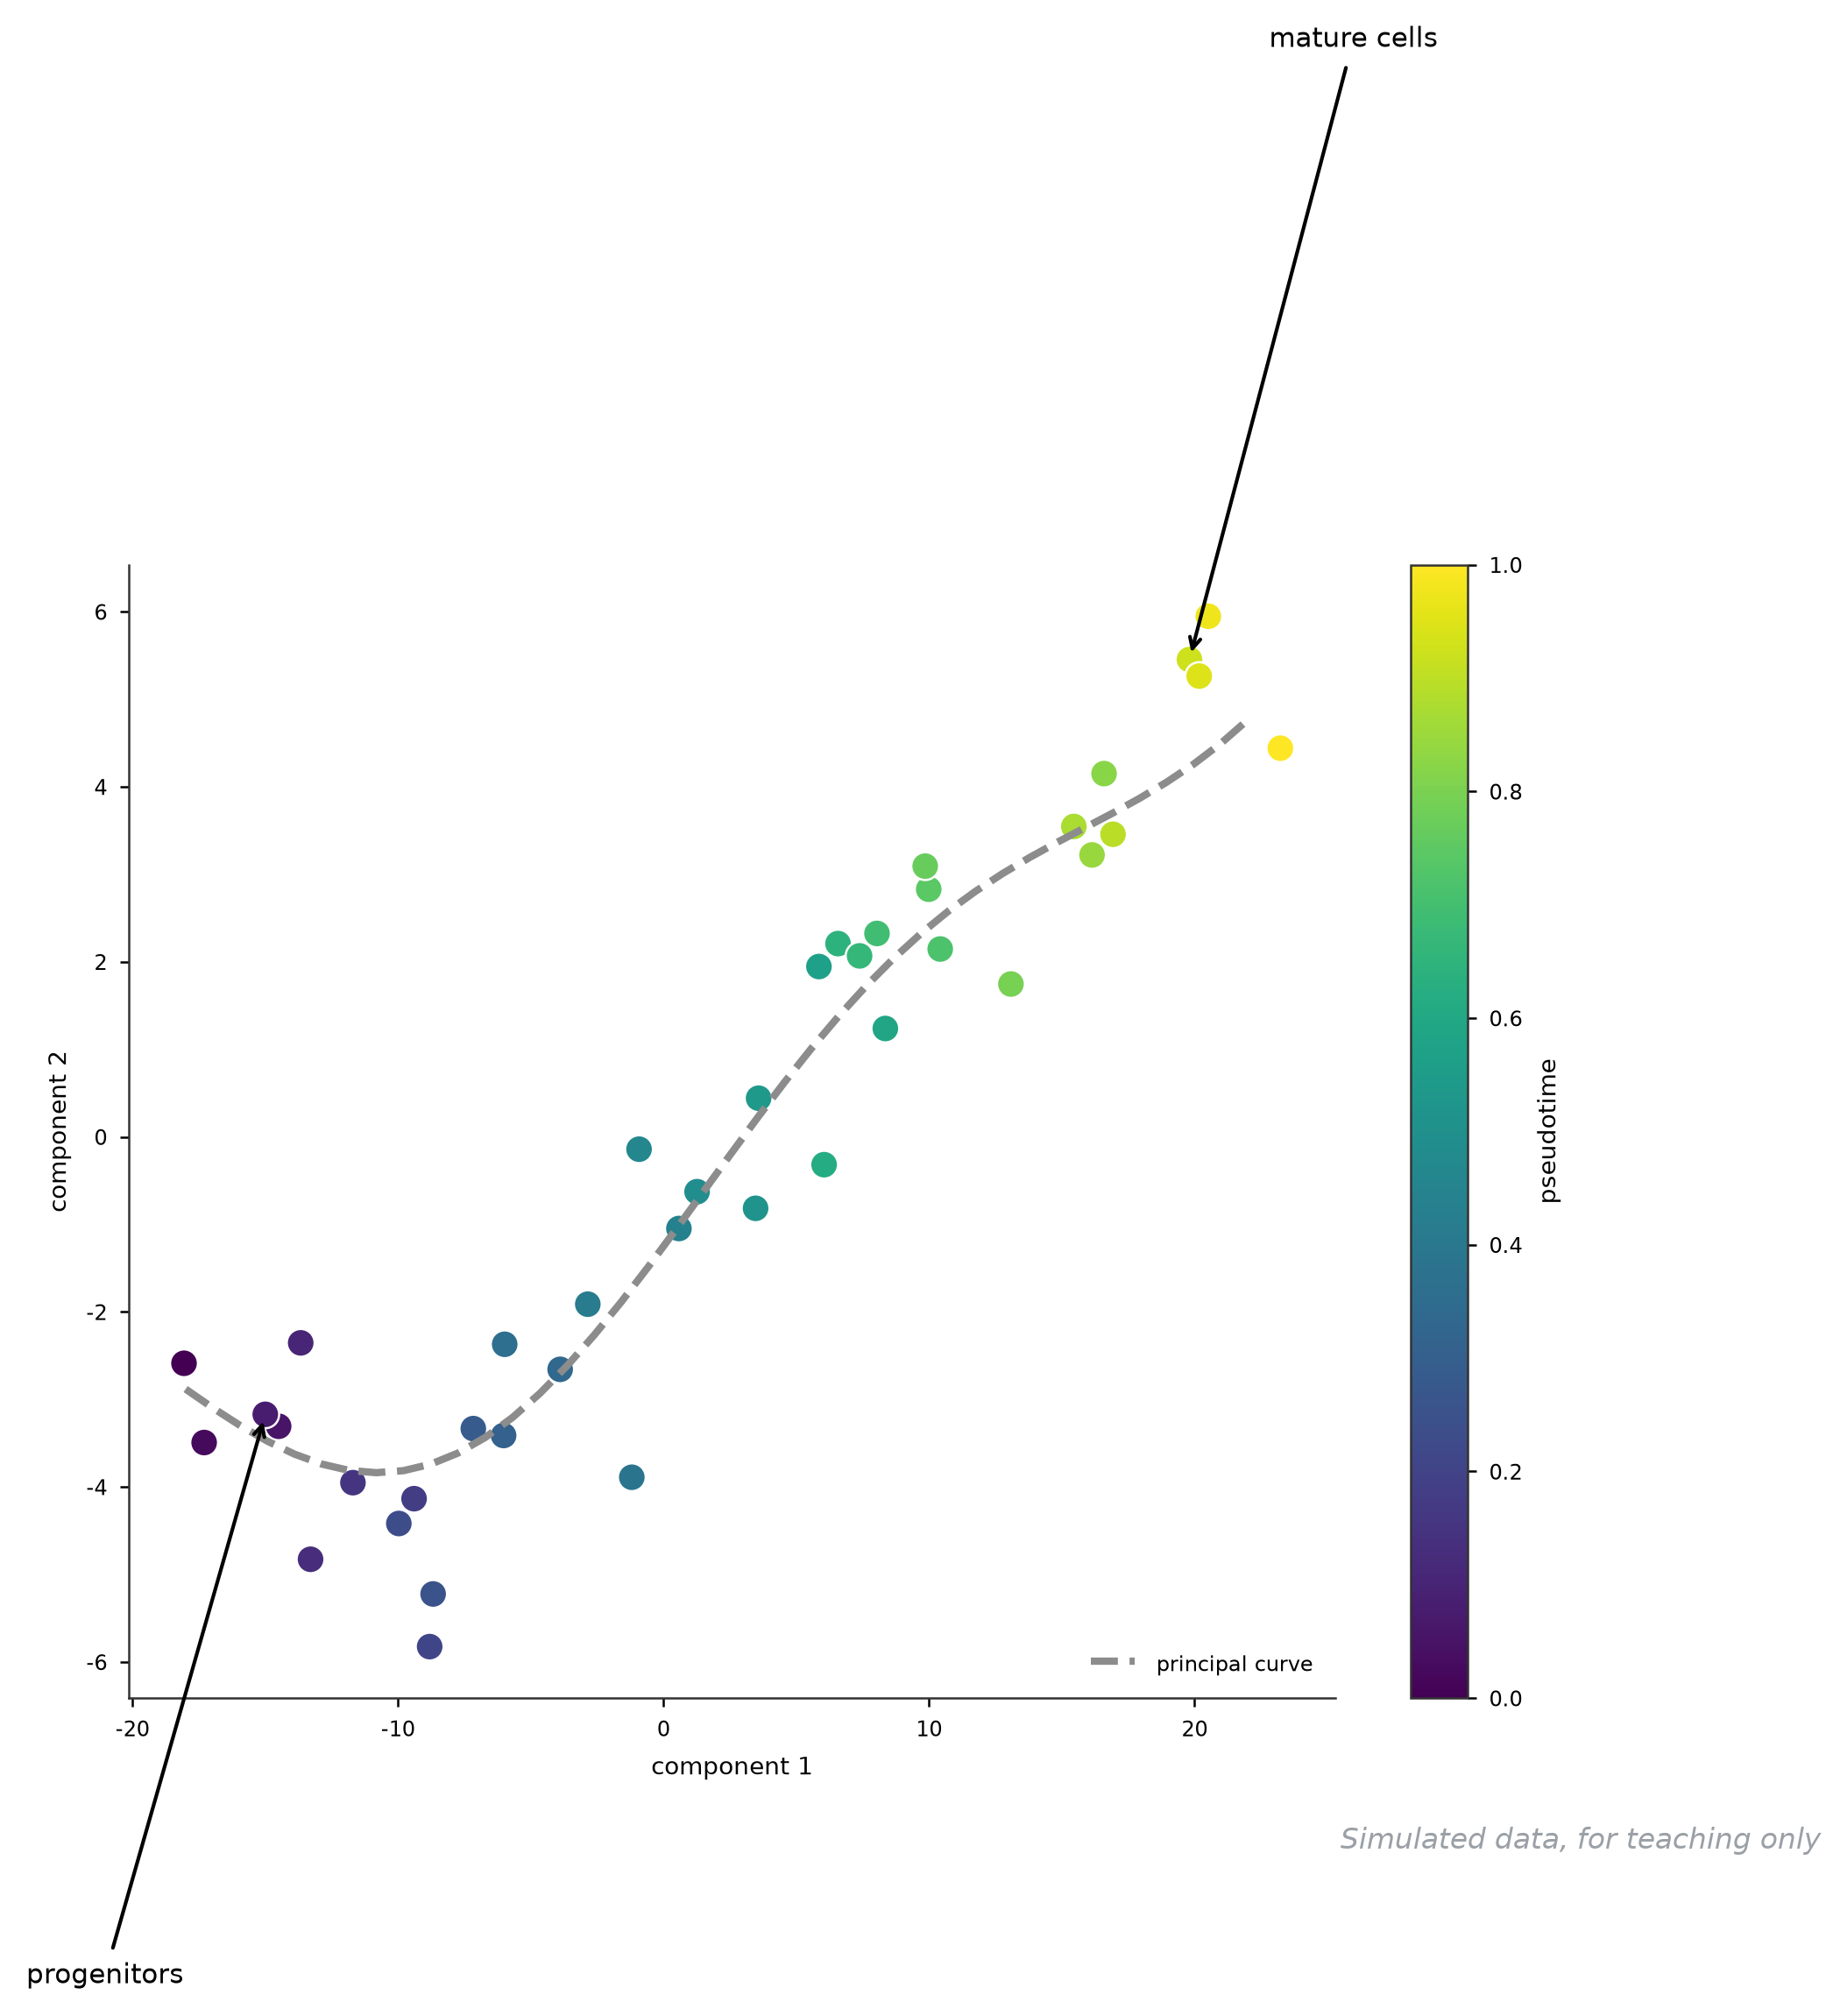
它回答什么问题:细胞沿着什么路径从一个状态成熟到另一个状态——Monocle 风格的轨迹推断,把散点图讲成「发育河流」。
怎么读:每个点是一个细胞,颜色是拟时序(pseudotime,从起点累计的成熟程度,0 到 1),虚线是主曲线(principal curve),箭头由起点指向终点。读三样:路径的形状(单线是简单分化,分叉是命运选择,本图是一条平滑单线)、颜色渐变是否连续(跳跃提示有亚群被强行拉直)、起终点的生物学标签是否站得住。轨迹是推断不是事实,换参数可能换形状,图注要报方法与关键参数。
用什么画:Monocle3 或 scanpy 的 tl.diffmap + pl.paga;本图用固定种子生成马蹄形点云加主曲线演示画法。
图注示例:
图 59 40 个细胞的拟时序轨迹(模拟)。颜色为 pseudotime,虚线为主曲线;细胞从左侧前体状态沿曲线推进至右上成熟状态。
展开查看:坐标数据与绘图代码
cell,x,y,pseudotime
c1,-18.06,-2.59,0.00
c2,-17.30,-3.49,0.03
c3,-14.50,-3.31,0.05
c4,-15.00,-3.17,0.08
c5,-13.67,-2.35,0.10
c6,-13.30,-4.83,0.13
c7,-11.70,-3.95,0.15
c8,-9.40,-4.13,0.18
c9,-8.81,-5.82,0.21
c10,-9.97,-4.42,0.23
c11,-8.68,-5.22,0.26
c12,-7.17,-3.33,0.28
c13,-6.03,-3.41,0.31
c14,-3.90,-2.66,0.33
c15,-5.98,-2.37,0.36
c16,-1.20,-3.89,0.38
c17,-2.85,-1.91,0.41
c18,0.58,-1.05,0.44
c19,-0.92,-0.14,0.46
c20,1.26,-0.63,0.49
c21,3.46,-0.82,0.51
c22,3.58,0.44,0.54
c23,5.85,1.95,0.56
c24,8.35,1.24,0.59
c25,6.05,-0.32,0.62
c26,6.57,2.21,0.64
c27,7.38,2.07,0.67
c28,8.04,2.32,0.69
c29,10.42,2.15,0.72
c30,9.98,2.83,0.74
c31,9.85,3.09,0.77
c32,13.08,1.75,0.79
c33,16.59,4.15,0.82
c34,16.14,3.22,0.85
c35,15.45,3.55,0.87
c36,16.93,3.46,0.90
c37,19.81,5.45,0.92
c38,20.17,5.26,0.95
c39,20.52,5.95,0.97
c40,23.23,4.44,1.00
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("59-trajectory.csv")
fig, ax = plt.subplots(figsize=(7.4, 5.6))
sc = ax.scatter(df.x, df.y, c=df.pseudotime, cmap="viridis", s=58,
                edgecolors="white", linewidths=0.6)
ax.plot(df.x, df.y.rolling(7, center=True).mean(), color="0.55", lw=2,
        ls="--", label="principal curve")
ax.annotate("progenitors", (-16, -3), (-25, -10), fontsize=9.5,
            arrowprops=dict(arrowstyle="->", lw=1))
ax.annotate("mature cells", (21, 5), (24, 1), fontsize=9.5,
            arrowprops=dict(arrowstyle="->", lw=1))
fig.colorbar(sc, ax=ax, label="pseudotime")
ax.set_xlabel("component 1")
ax.set_ylabel("component 2")
ax.legend(loc="lower right")
fig.savefig("59-trajectory.png", dpi=200, bbox_inches="tight")
6.2 单细胞基因表达点图
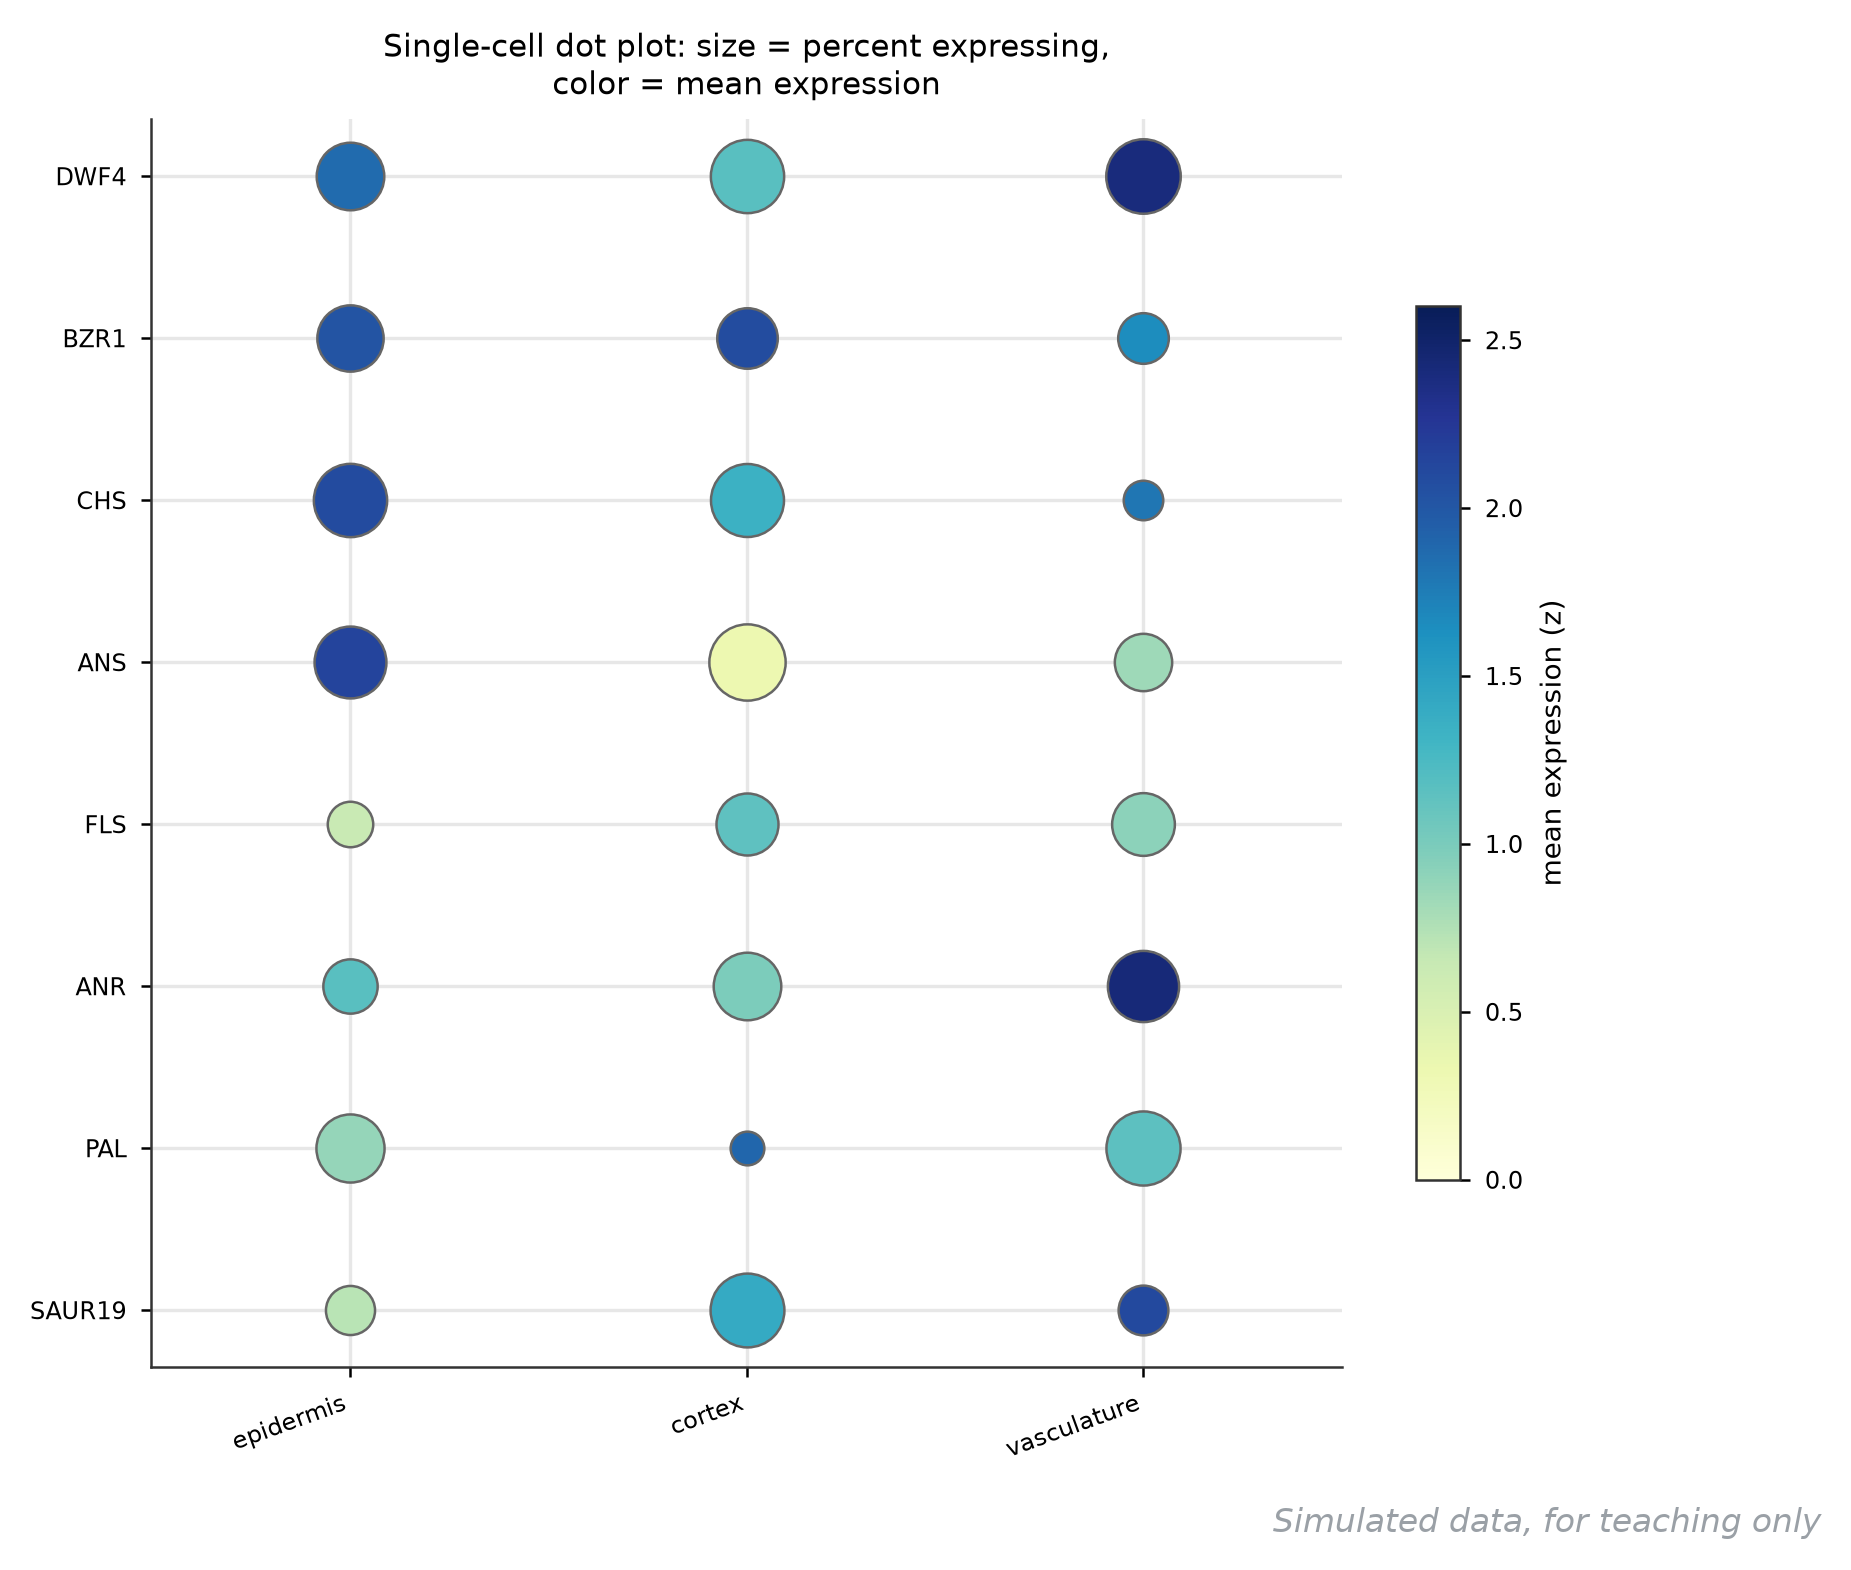
它回答什么问题:一组 marker 基因在各细胞群中「表达比例」与「表达强度」的双重展示——scanpy/Monocle 出图清单里的固定项目。
怎么读:每列一个细胞群,每行一个基因,一个点双重编码:点大小是该群中表达该基因的细胞百分比,点颜色是平均表达量(蓝色越深越高)。看「大而深」的点——DWF4 在维管束群(94% 细胞表达、均值 2.4)和 CHS 在表皮群(91%、2.10)都是又大又深,说明既特异又强;「小而深」是少数细胞高表达,「大而浅」是广撒网低表达,三种模式对应的生物学结论完全不同。
用什么画:scanpy sc.pl.dotplot 一行;本图按百分比+均值表用 matplotlib scatter 双编码手绘。
图注示例:
图 60 8 个候选基因在 3 个细胞群的表达点图。点大小为表达细胞比例,颜色为平均表达水平;DWF4 在维管束群高比例高表达(模拟数据演示)。
展开查看:数据与绘图代码
gene,cluster,pct_expr,avg_expr
DWF4,epidermis,77,1.86
DWF4,cortex,91,1.18
DWF4,vasculature,94,2.40
BZR1,epidermis,74,2.02
BZR1,cortex,62,2.09
BZR1,vasculature,43,1.65
CHS,epidermis,91,2.10
CHS,cortex,90,1.35
CHS,vasculature,26,1.80
ANS,epidermis,87,2.15
ANS,cortex,99,0.33
ANS,vasculature,56,0.84
FLS,epidermis,35,0.63
FLS,cortex,65,1.14
FLS,vasculature,67,0.92
ANR,epidermis,50,1.17
ANR,cortex,77,0.99
ANR,vasculature,86,2.42
PAL,epidermis,79,0.88
PAL,cortex,19,1.89
PAL,vasculature,93,1.15
SAUR19,epidermis,41,0.71
SAUR19,cortex,92,1.41
SAUR19,vasculature,42,2.11
绘图代码(Python,独立可运行)
import matplotlib.pyplot as plt
import pandas as pd

df = pd.read_csv("60-scdotplot.csv")
genes = list(dict.fromkeys(df.gene))
clusters = list(dict.fromkeys(df.cluster))
fig, ax = plt.subplots(figsize=(6.4, 5.4))
for _, row in df.iterrows():
    i, j = genes.index(row.gene), clusters.index(row.cluster)
    ax.scatter(j, i, s=row.pct_expr * 3.4, c=row.avg_expr, cmap="YlGnBu",
               vmin=0, vmax=2.6, edgecolor="0.4", linewidth=0.6)
ax.set_xticks(range(3), clusters, rotation=20, ha="right")
ax.set_yticks(range(len(genes)), genes)
ax.invert_yaxis()
sm = plt.cm.ScalarMappable(cmap="YlGnBu", norm=plt.Normalize(0, 2.6))
fig.colorbar(sm, ax=ax, shrink=0.7, label="mean expression (z)")
ax.set_title("size = percent expressing, color = mean expression")
fig.savefig("60-scdotplot.png", dpi=200, bbox_inches="tight")
七、网络与共表达
7.1 PPI / 共表达网络图
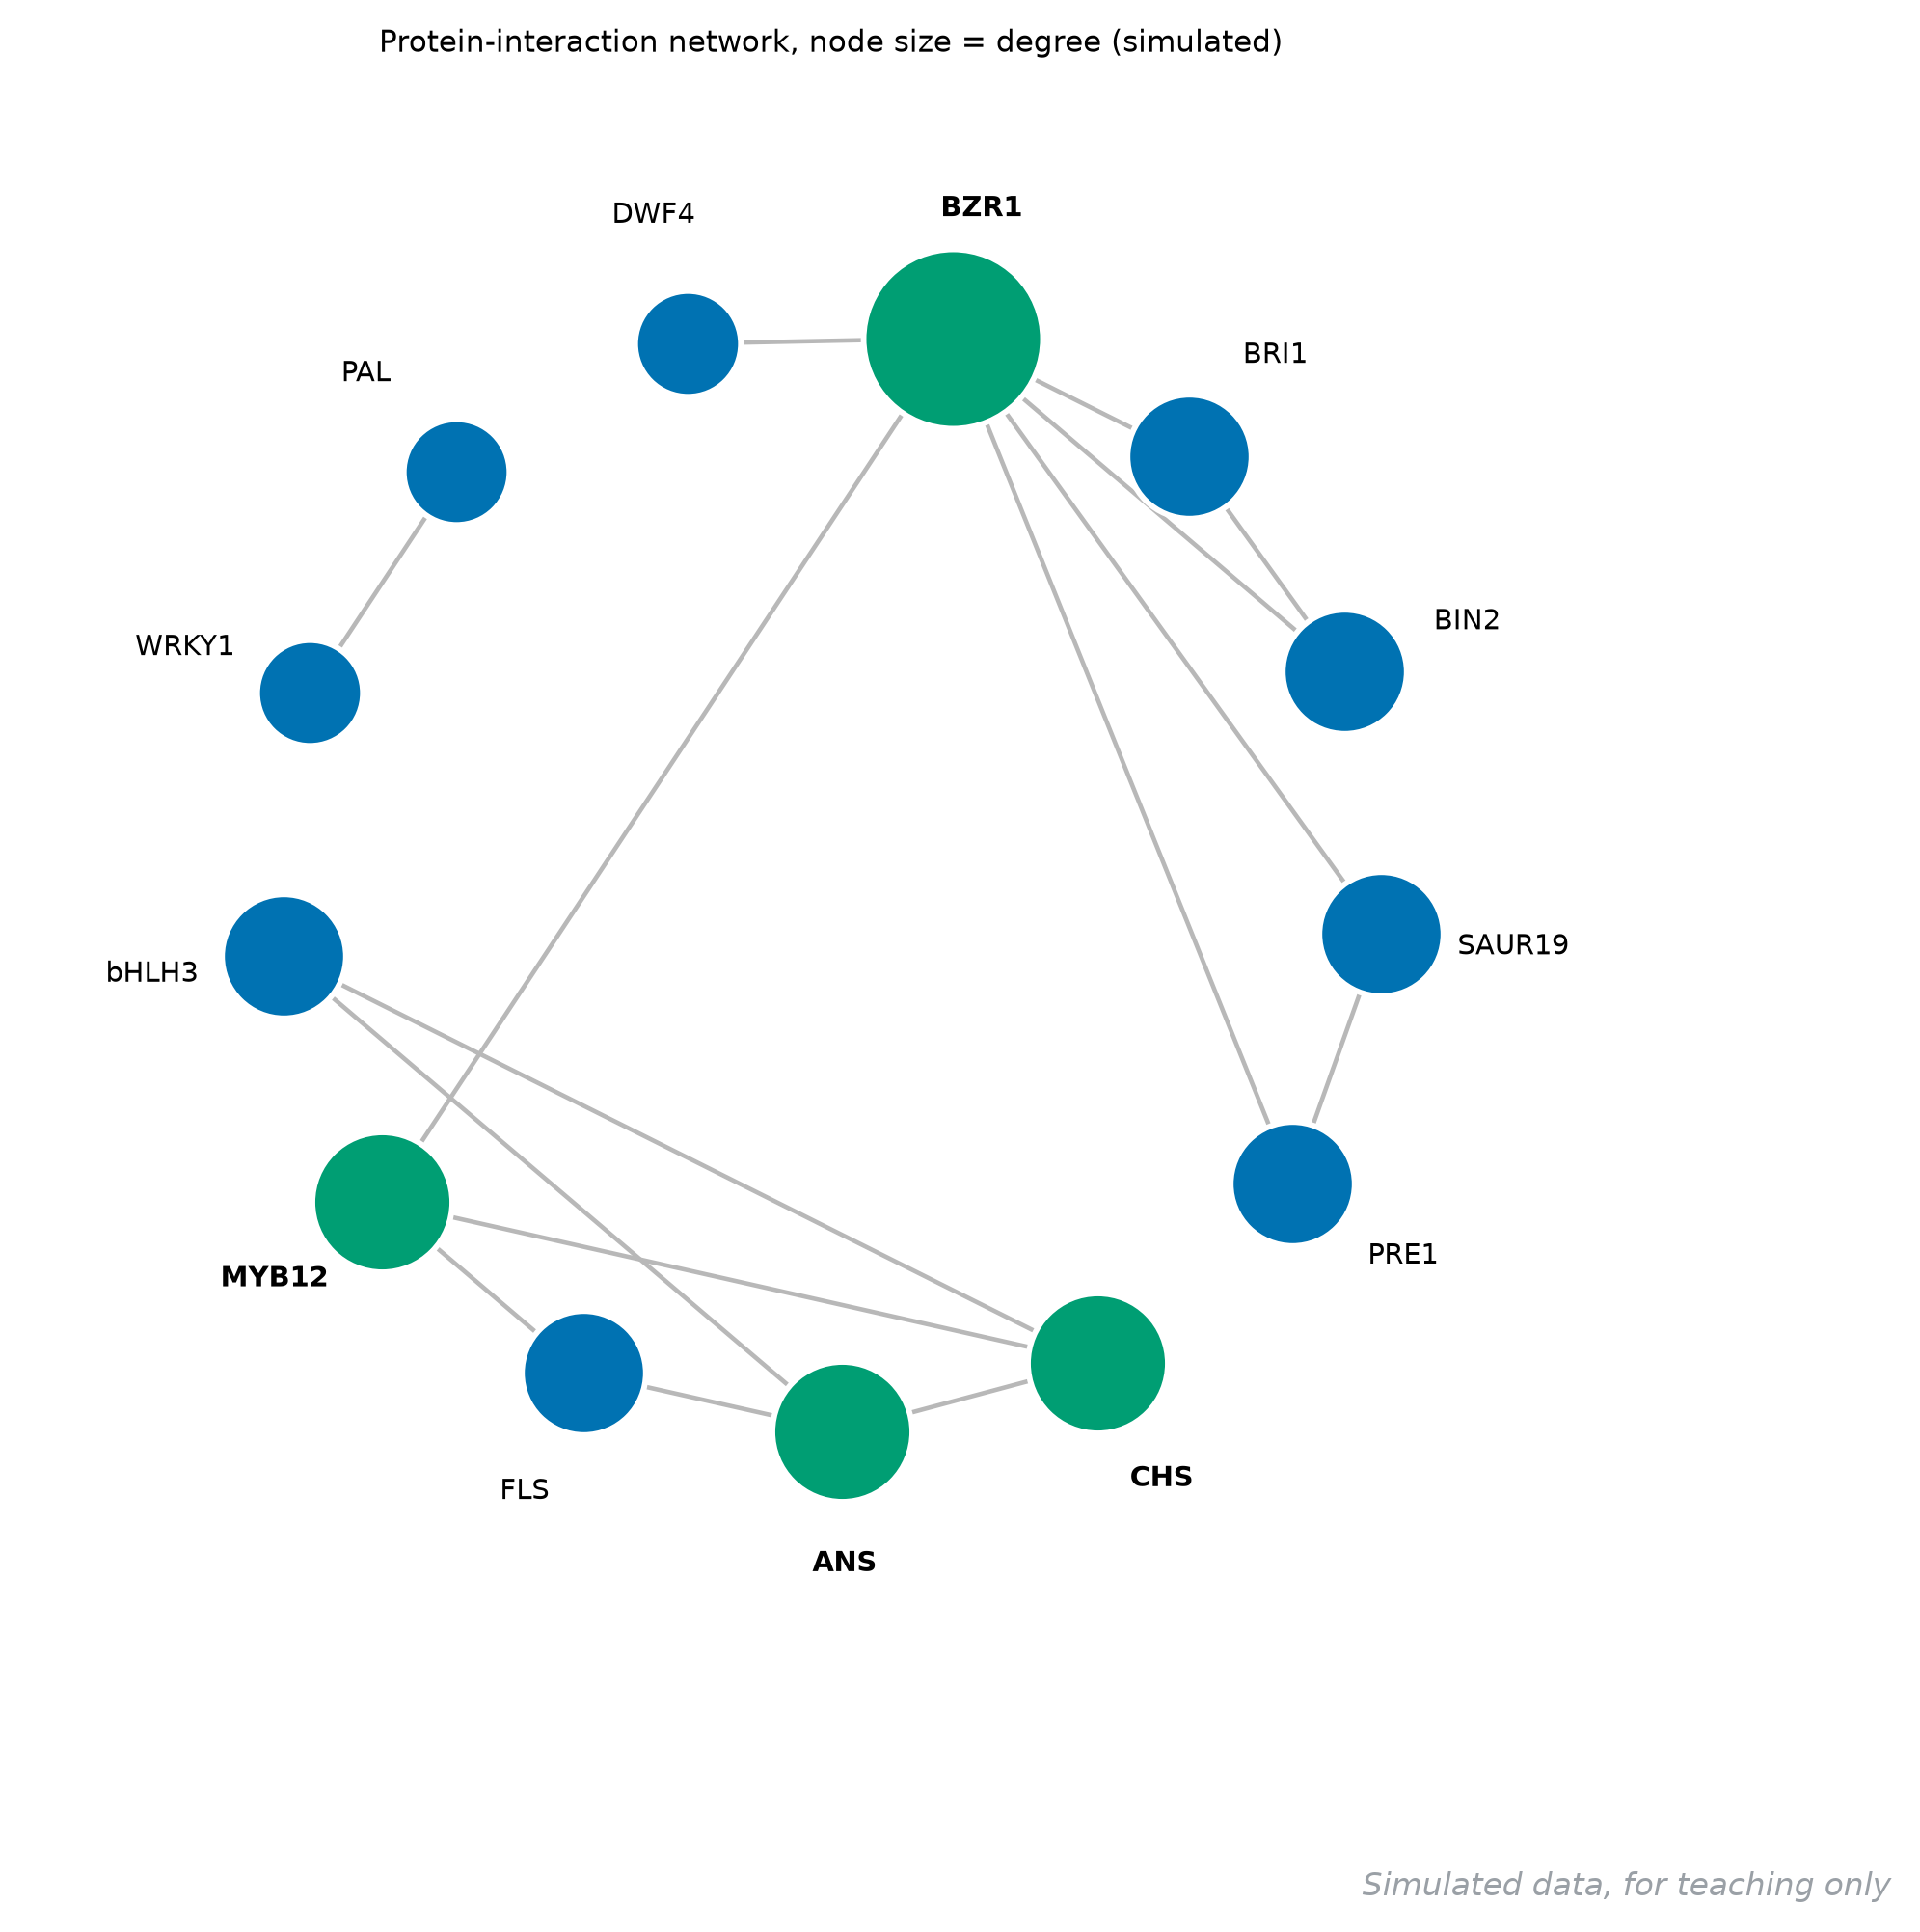
它回答什么问题:谁和谁互作(或共表达),谁是枢纽——把基因清单升级成「关系网」的图,枢纽节点是下一个实验的靶点来源。
怎么读:节点是蛋白或基因,边是互作/共表达关系,节点越大度数(连接数)越高。看两样:绿色大节点是枢纽(BZR1 连了 6 条边,典型的转录调控中心),红色小节点是外围功能执行者;再看有没有「模块」——黄酮合成基因 CHS、ANS、FLS 依次相连抱成一个小团,对外主要靠 MYB12 和 bHLH3 两个转录因子接口,这种模块结构正是 WGCNA 共表达模块的图形版。边太多时先按置信度过滤,不然画出来是一团毛线。
用什么画:STRING 网页导出后用 Cytoscape 排版(力导向布局最常用);本图用环形布局手绘,边表如下。
图注示例:
图 61 油菜素内酯与黄酮合成相关蛋白的互作网络(模拟)。节点大小正比连接度,绿色为度数大于等于 3 的枢纽;BZR1 为网络核心。
展开查看:边表与绘图代码
node1,node2,edge_type
DWF4,BZR1,protein_interaction
BZR1,BRI1,protein_interaction
BRI1,BIN2,protein_interaction
BZR1,BIN2,protein_interaction
BZR1,PRE1,protein_interaction
BZR1,SAUR19,protein_interaction
BZR1,MYB12,protein_interaction
MYB12,CHS,protein_interaction
MYB12,FLS,protein_interaction
CHS,ANS,protein_interaction
ANS,FLS,protein_interaction
bHLH3,CHS,protein_interaction
bHLH3,ANS,protein_interaction
WRKY1,PAL,protein_interaction
PRE1,SAUR19,protein_interaction
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("61-ppi.csv")
nodes = list(dict.fromkeys(df.node1.tolist() + df.node2.tolist()))
deg = {n: 0 for n in nodes}
for _, r in df.iterrows():
    deg[r.node1] += 1
    deg[r.node2] += 1
ang = np.linspace(90, 90 - 360, len(nodes), endpoint=False) + 15
pos = {n: (np.cos(np.deg2rad(a)), np.sin(np.deg2rad(a)))
       for n, a in zip(nodes, ang)}
fig, ax = plt.subplots(figsize=(7.6, 7.2))
ax.set_aspect("equal")
ax.axis("off")
for _, r in df.iterrows():
    (x0, y0), (x1, y1) = pos[r.node1], pos[r.node2]
    ax.plot([x0, x1], [y0, y1], color="0.72", lw=1.1, zorder=1)
for n in nodes:
    x, y = pos[n]
    ax.scatter([x], [y], s=430 + deg[n] * 260,
               color="#55A868" if deg[n] >= 3 else "#4C72B0",
               edgecolors="white", linewidths=1.4, zorder=3)
    ax.text(x * 1.24, y * 1.24, n, ha="center", va="center", fontsize=9)
ax.set_xlim(-1.45, 1.45)
ax.set_ylim(-1.45, 1.45)
fig.savefig("61-ppi.png", dpi=200, bbox_inches="tight")
7.2 WGCNA 模块-性状相关热图
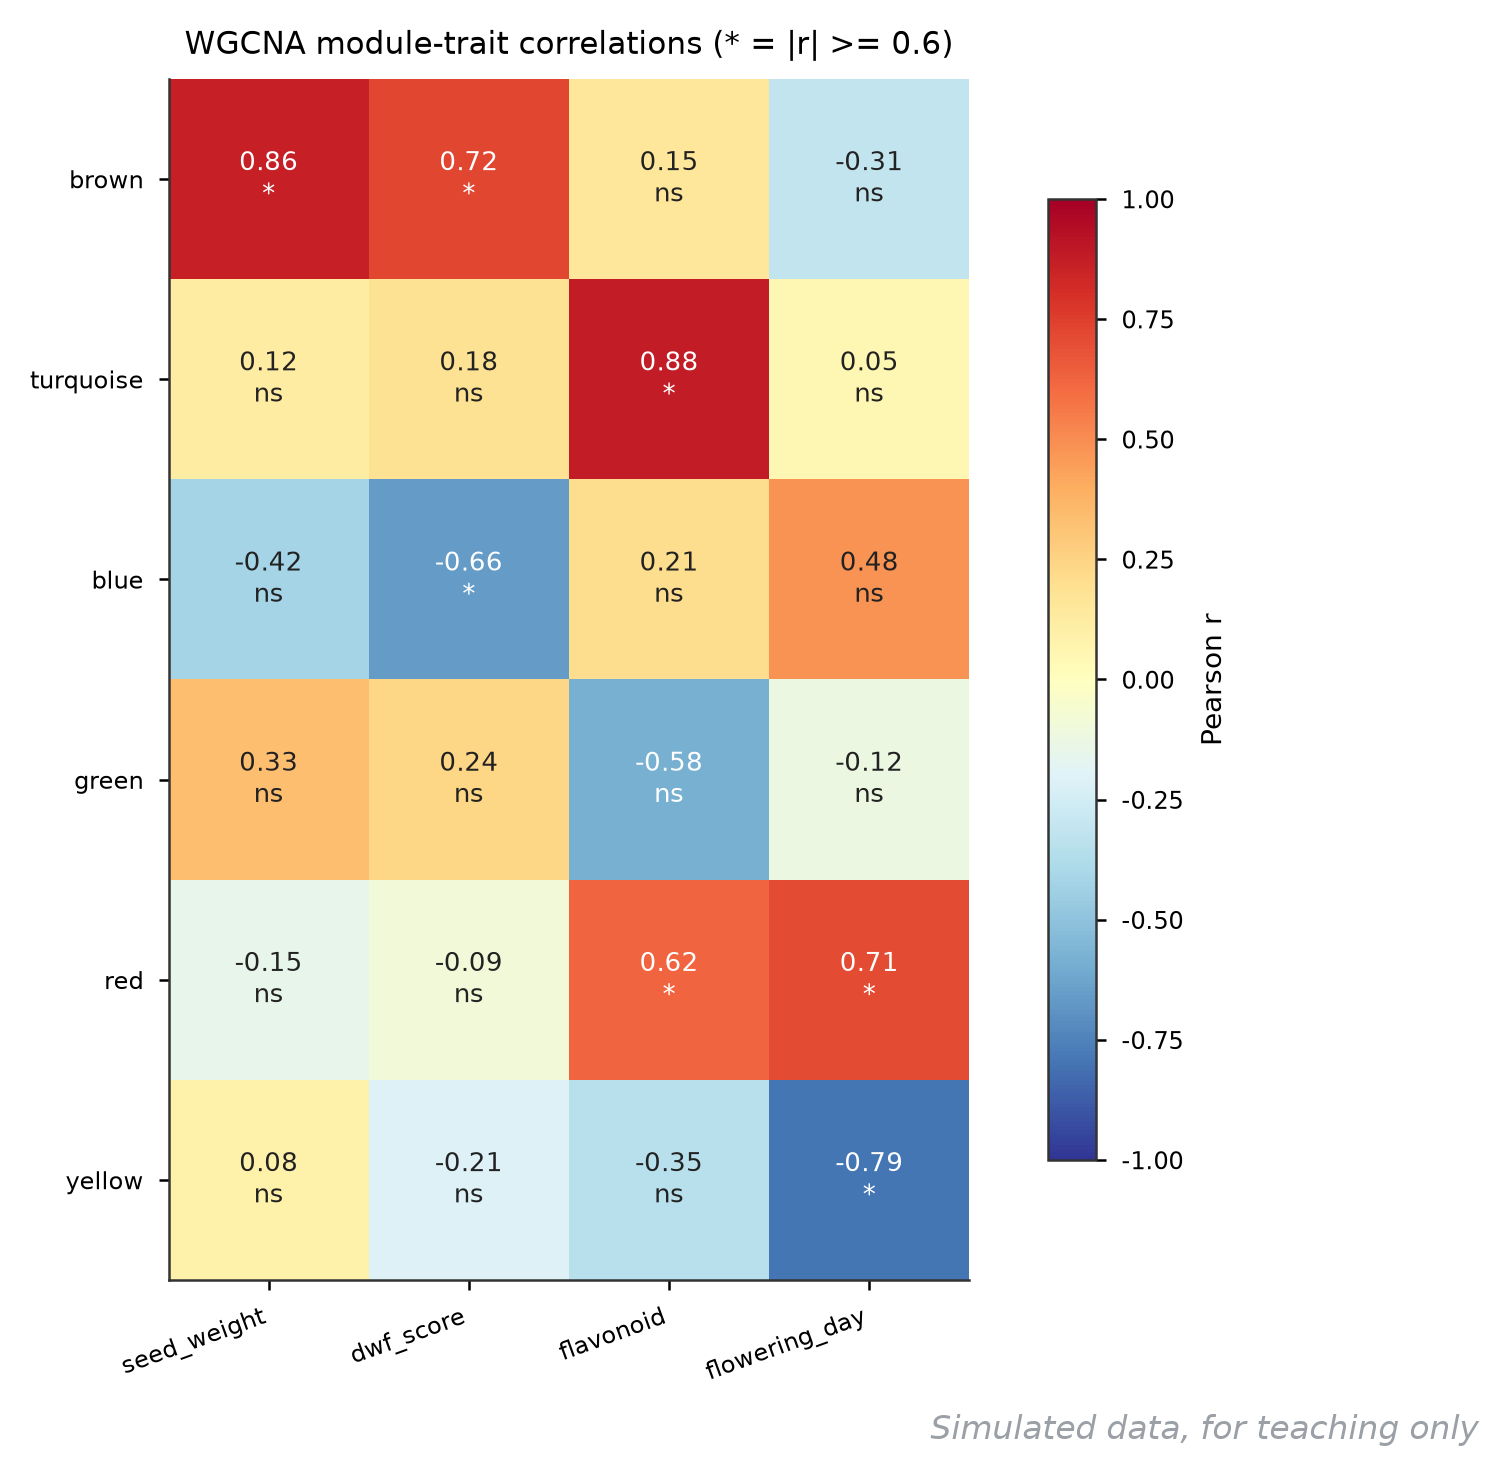
它回答什么问题:哪个共表达模块和哪个表型走得近——WGCNA 的收官图,把几十个基因的模块压缩成几行相关系数,直接点名「该研究哪个模块」。
怎么读:每行一个颜色命名的模块,每列一个表型,格子里是相关系数 r(蓝正红负),并标星号(本例以 |r| >= 0.6 记显著)。读法是扫「深色格子」:brown 模块与粒重 r = 0.86、turquoise 与黄酮 0.88——这两个模块就是各自性状的候选基因库,下一步是提取模块内 hub 基因做验证。黄色端与蓝色端的颜色约定要在 colorbar 里写明方向,别让读者猜。
用什么画:WGCNA 流程自带 labeledHeatmap;重绘用 matplotlib imshow 加数值标注。
图注示例:
图 62 六个 WGCNA 共表达模块与四个表型的相关热图(模拟)。颜色为 Pearson r;brown 模块与粒重(r = 0.86)、turquoise 模块与黄酮含量(r = 0.88)显著相关。
展开查看:相关矩阵与绘图代码
module,seed_weight,dwf_score,flavonoid,flowering_day
brown,0.86,0.72,0.15,-0.31
turquoise,0.12,0.18,0.88,0.05
blue,-0.42,-0.66,0.21,0.48
green,0.33,0.24,-0.58,-0.12
red,-0.15,-0.09,0.62,0.71
yellow,0.08,-0.21,-0.35,-0.79
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("62-moduletrait.csv", index_col="module")
fig, ax = plt.subplots(figsize=(6.8, 5.2))
im = ax.imshow(df.values, cmap="RdYlBu_r", vmin=-1, vmax=1)
ax.set_xticks(range(df.shape[1]), df.columns, rotation=20, ha="right")
ax.set_yticks(range(df.shape[0]), df.index)
ax.grid(False)
for i in range(df.shape[0]):
    for j in range(df.shape[1]):
        v = df.values[i, j]
        ax.text(j, i, "%.2f\n%s" % (v, "*" if abs(v) >= 0.6 else "ns"),
                ha="center", va="center", fontsize=8,
                color="white" if abs(v) > 0.55 else "#222")
fig.colorbar(im, ax=ax, shrink=0.8, label="Pearson r")
fig.savefig("62-moduletrait.png", dpi=200, bbox_inches="tight")
八、生化与湿实验补充
8.1 剂量响应曲线(IC50)
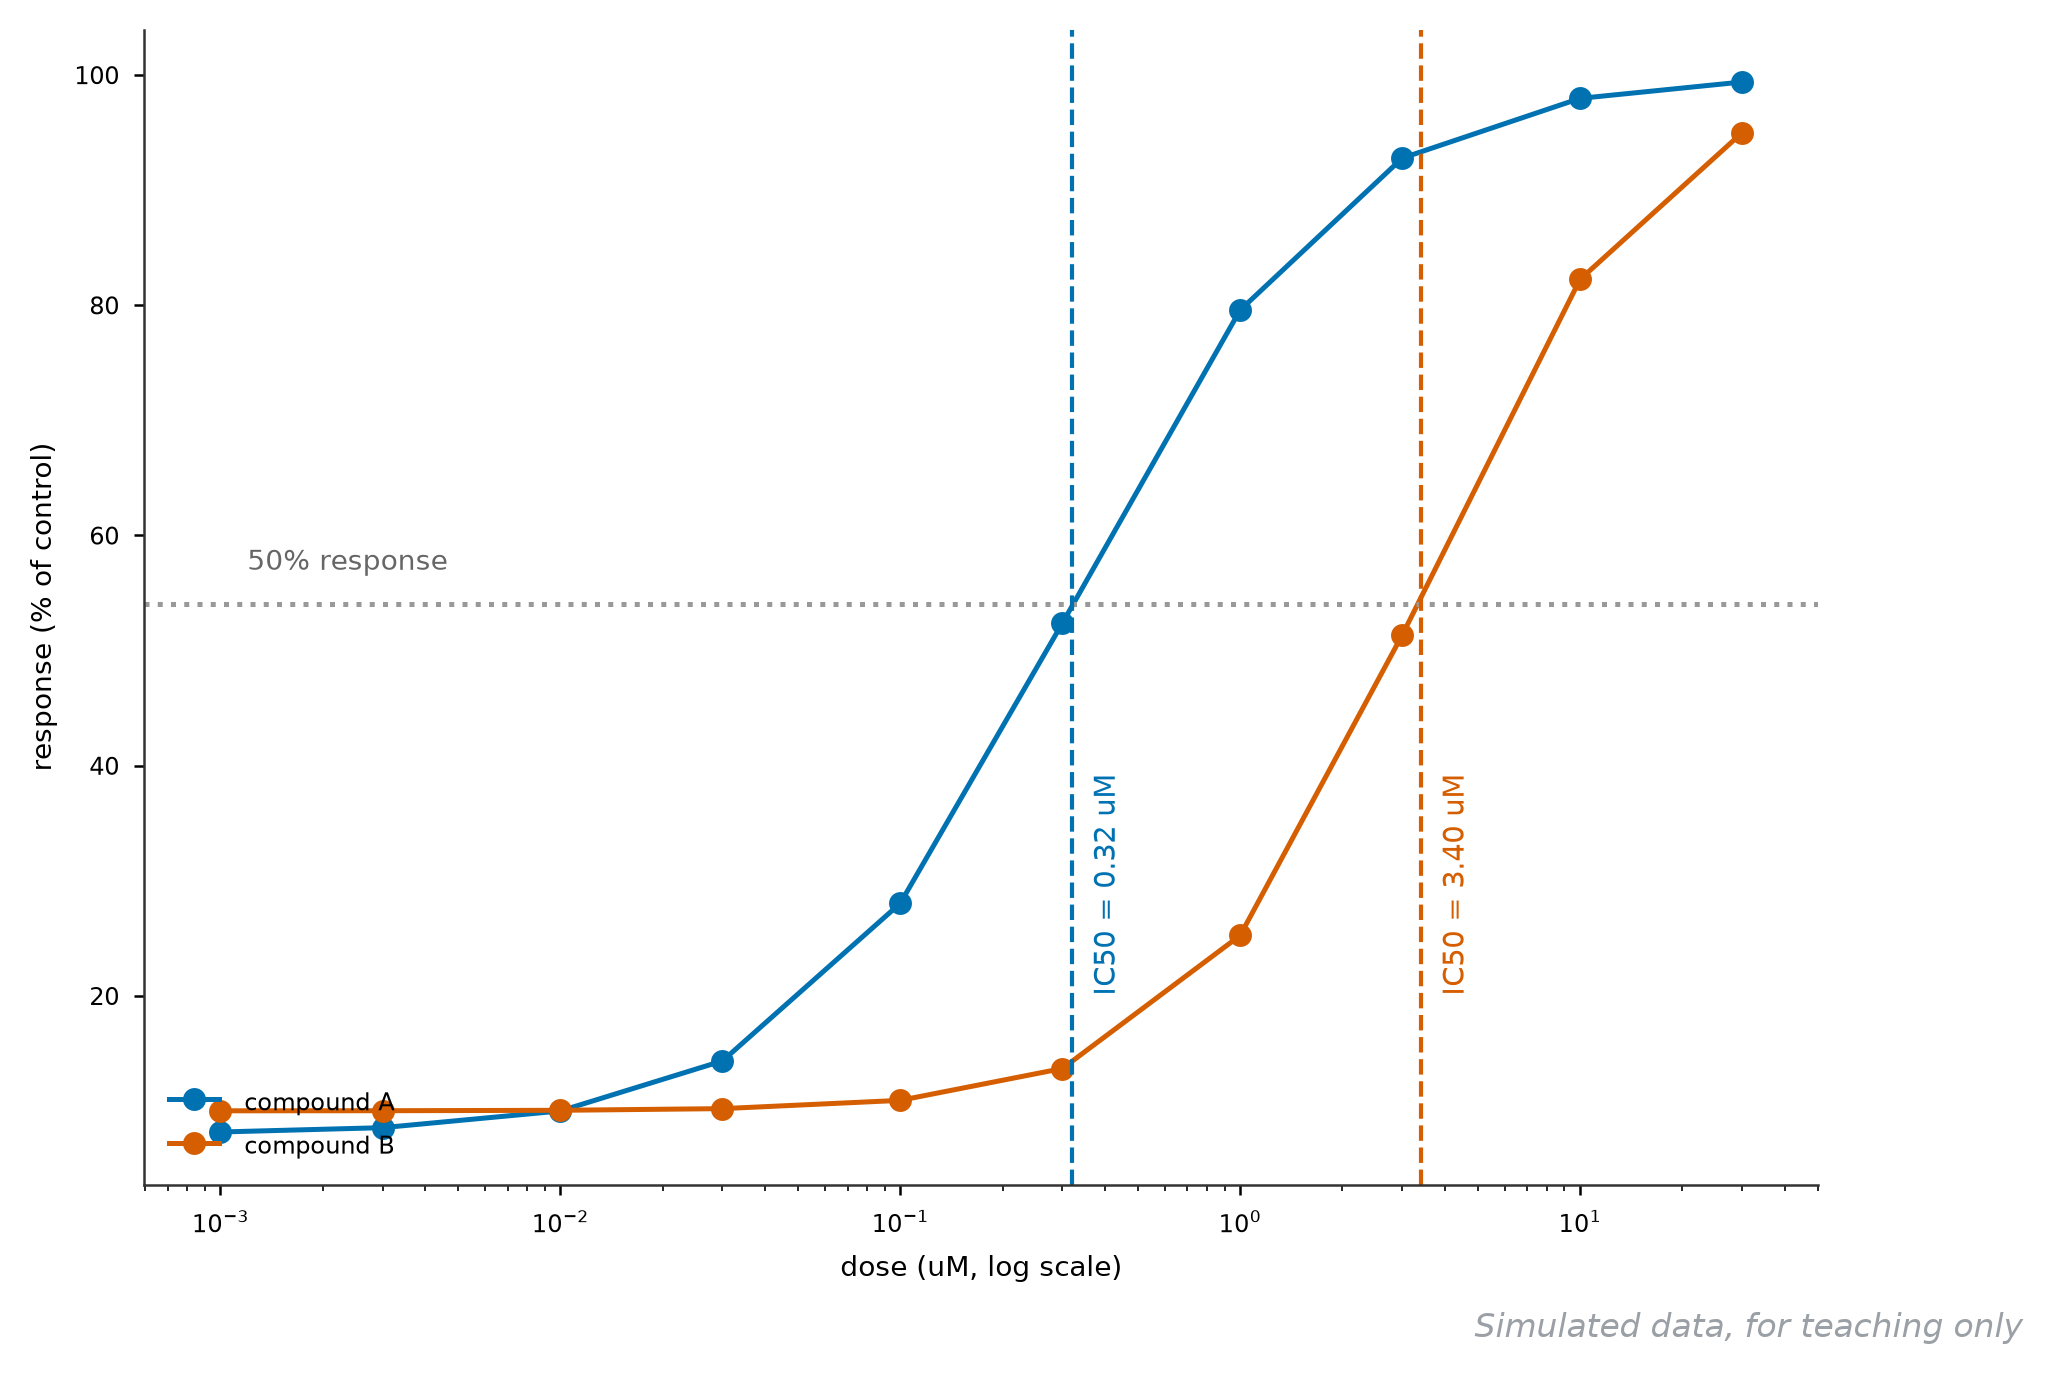
它回答什么问题:药或激素多浓时效果打对折——四参数 logistic 拟合出的 IC50,是衡量效力的标准数字,比「看哪根柱子矮」严谨一个量级。
怎么读:横轴剂量取对数(log 轴上 S 形才对称),纵轴响应率。四个参数各管一段:下平台(本底)、上平台(最大响应)、斜率(敏感度陡缓)、IC50(响应降到上下平台中点的浓度)。本图化合物 A 的 IC50 = 0.32 uM,比 B 的 3.4 uM 效力高一个数量级。误差线来自重复孔,拟合置信区间比单点更重要,GraphPad 会直接给。
用什么画:GraphPad Prism 的 dose-response 内置四参数拟合;Python 用 scipy.optimize.curve_fit。
图注示例:
图 63 两种化合物对种子萌发抑制的四参数 logistic 拟合(模拟)。横轴为对数剂量;化合物 A 的 IC50 = 0.32 uM,约为化合物 B(3.4 uM)的十分之一。
展开查看:剂量数据与绘图代码
dose_uM,response_A,response_B
0.001,8.2,10.0
0.003,8.5,10.0
0.010,10.0,10.0
0.030,14.3,10.2
0.100,28.0,10.9
0.300,52.4,13.7
1.000,79.6,25.2
3.000,92.8,51.3
10.000,98.0,82.2
30.000,99.4,95.0
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("63-dose.csv")
xs = np.logspace(-3, np.log10(30), 200)

def fourpl(x, bottom, top, ic50, slope):
    return bottom + (top - bottom) / (1 + (x / ic50) ** slope)

fig, ax = plt.subplots(figsize=(7.2, 5.0))
for resp, col, ic, lab in [("response_A", "#4C72B0", 0.32, "compound A"),
                           ("response_B", "#DD8452", 3.4, "compound B")]:
    ax.semilogx(df.dose_uM, df[resp], "o", ms=5, color=col)
    p, _ = __import__("scipy.optimize", fromlist=["curve_fit"]).curve_fit(
        fourpl, df.dose_uM, df[resp], p0=[10, 100, 1, -1])
    ax.semilogx(xs, fourpl(xs, *p), color=col, label=lab)
    ax.axvline(p[2], color=col, ls="--", lw=1)
    ax.text(p[2] * 1.15, 20, "IC50 = %.2f uM" % p[2], fontsize=9, color=col,
            rotation=90, va="bottom")
ax.set_xlabel("dose (uM, log scale)")
ax.set_ylabel("response (% of control)")
ax.legend(loc="lower left")
fig.savefig("63-dose.png", dpi=200, bbox_inches="tight")
8.2 米氏酶动力学曲线
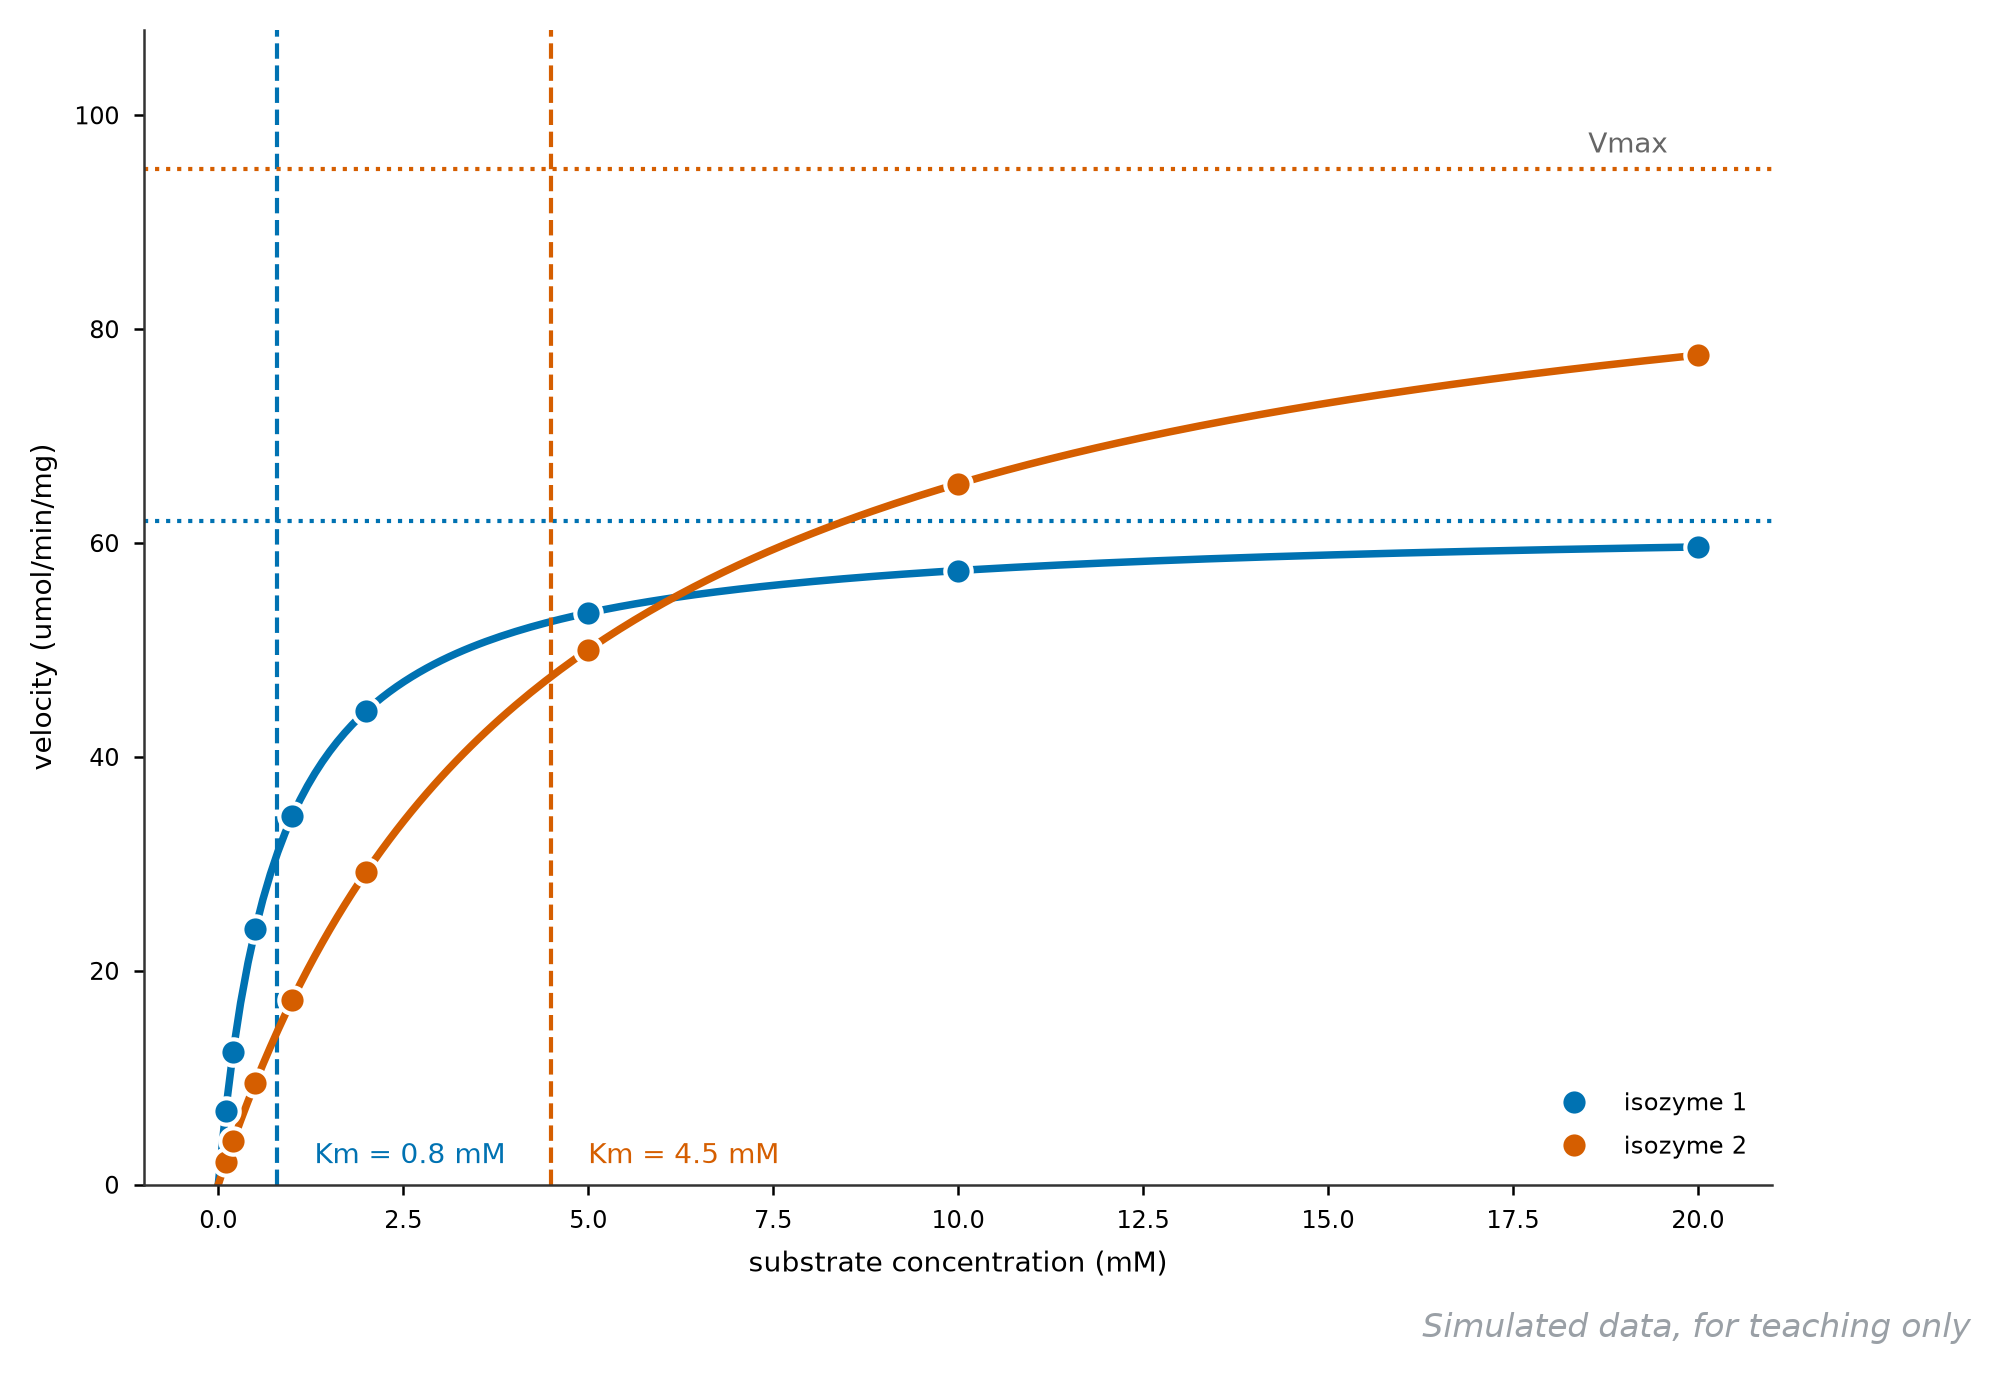
它回答什么问题:酶吃底物的速度常数——Km(半速底物浓度,代表亲和力)与 Vmax(最大转速),酶学实验的基本盘。
怎么读:横轴底物浓度,纵轴初速度,点符合米氏方程 v = Vmax*S/(Km+S) 的双曲线。虚线标出两条关键参考:水平虚线是 Vmax 渐近线(底物无限多时的速度上限),竖直虚线在 Km 处(速度恰为 Vmax 一半时的底物浓度,越小亲和越强)。本图同工酶 1 的 Km = 0.8 mM 远小于同工酶 2 的 4.5 mM——前者低底物下就全力工作,正是适应低养分环境的典型演化。注意测的必须是初速度,底物耗尽前的线性段。
用什么画:GraphPad 的 Michaelis-Menten 拟合;Python 用 curve_fit 拟合后叠加理论线。
图注示例:
图 64 两种同工酶的米氏动力学曲线(模拟)。同工酶 1 的 Km = 0.8 mM、Vmax = 62 umol/min/mg;同工酶 2 的 Km = 4.5 mM、Vmax = 95。点为实测初速度,线为拟合曲线。
展开查看:数据与绘图代码
substrate_mM,v_iso1,v_iso2
0.1,6.9,2.1
0.2,12.4,4.0
0.5,23.8,9.5
1.0,34.4,17.3
2.0,44.3,29.2
5.0,53.4,50.0
10.0,57.4,65.5
20.0,59.6,77.6
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("64-michaelis.csv")
xs = np.linspace(0, 20, 200)
CAT = [(0.8, 62, "#4C72B0", "isozyme 1", "v_iso1"),
       (4.5, 95, "#DD8452", "isozyme 2", "v_iso2")]
fig, ax = plt.subplots(figsize=(7.0, 5.0))
for km, vmax, col, lab, colname in CAT:
    ax.plot(xs, vmax * xs / (km + xs), color=col, lw=1.8)
    ax.scatter(df.substrate_mM, df[colname], s=40, color=col,
               edgecolors="white", zorder=3, label=lab)
    ax.axhline(vmax, color=col, ls=":", lw=1)
    ax.axvline(km, color=col, ls="--", lw=1)
ax.set_xlabel("substrate concentration (mM)")
ax.set_ylabel("velocity (umol/min/mg)")
ax.legend(loc="lower right")
fig.savefig("64-michaelis.png", dpi=200, bbox_inches="tight")
8.3 琼脂糖凝胶电泳示意图
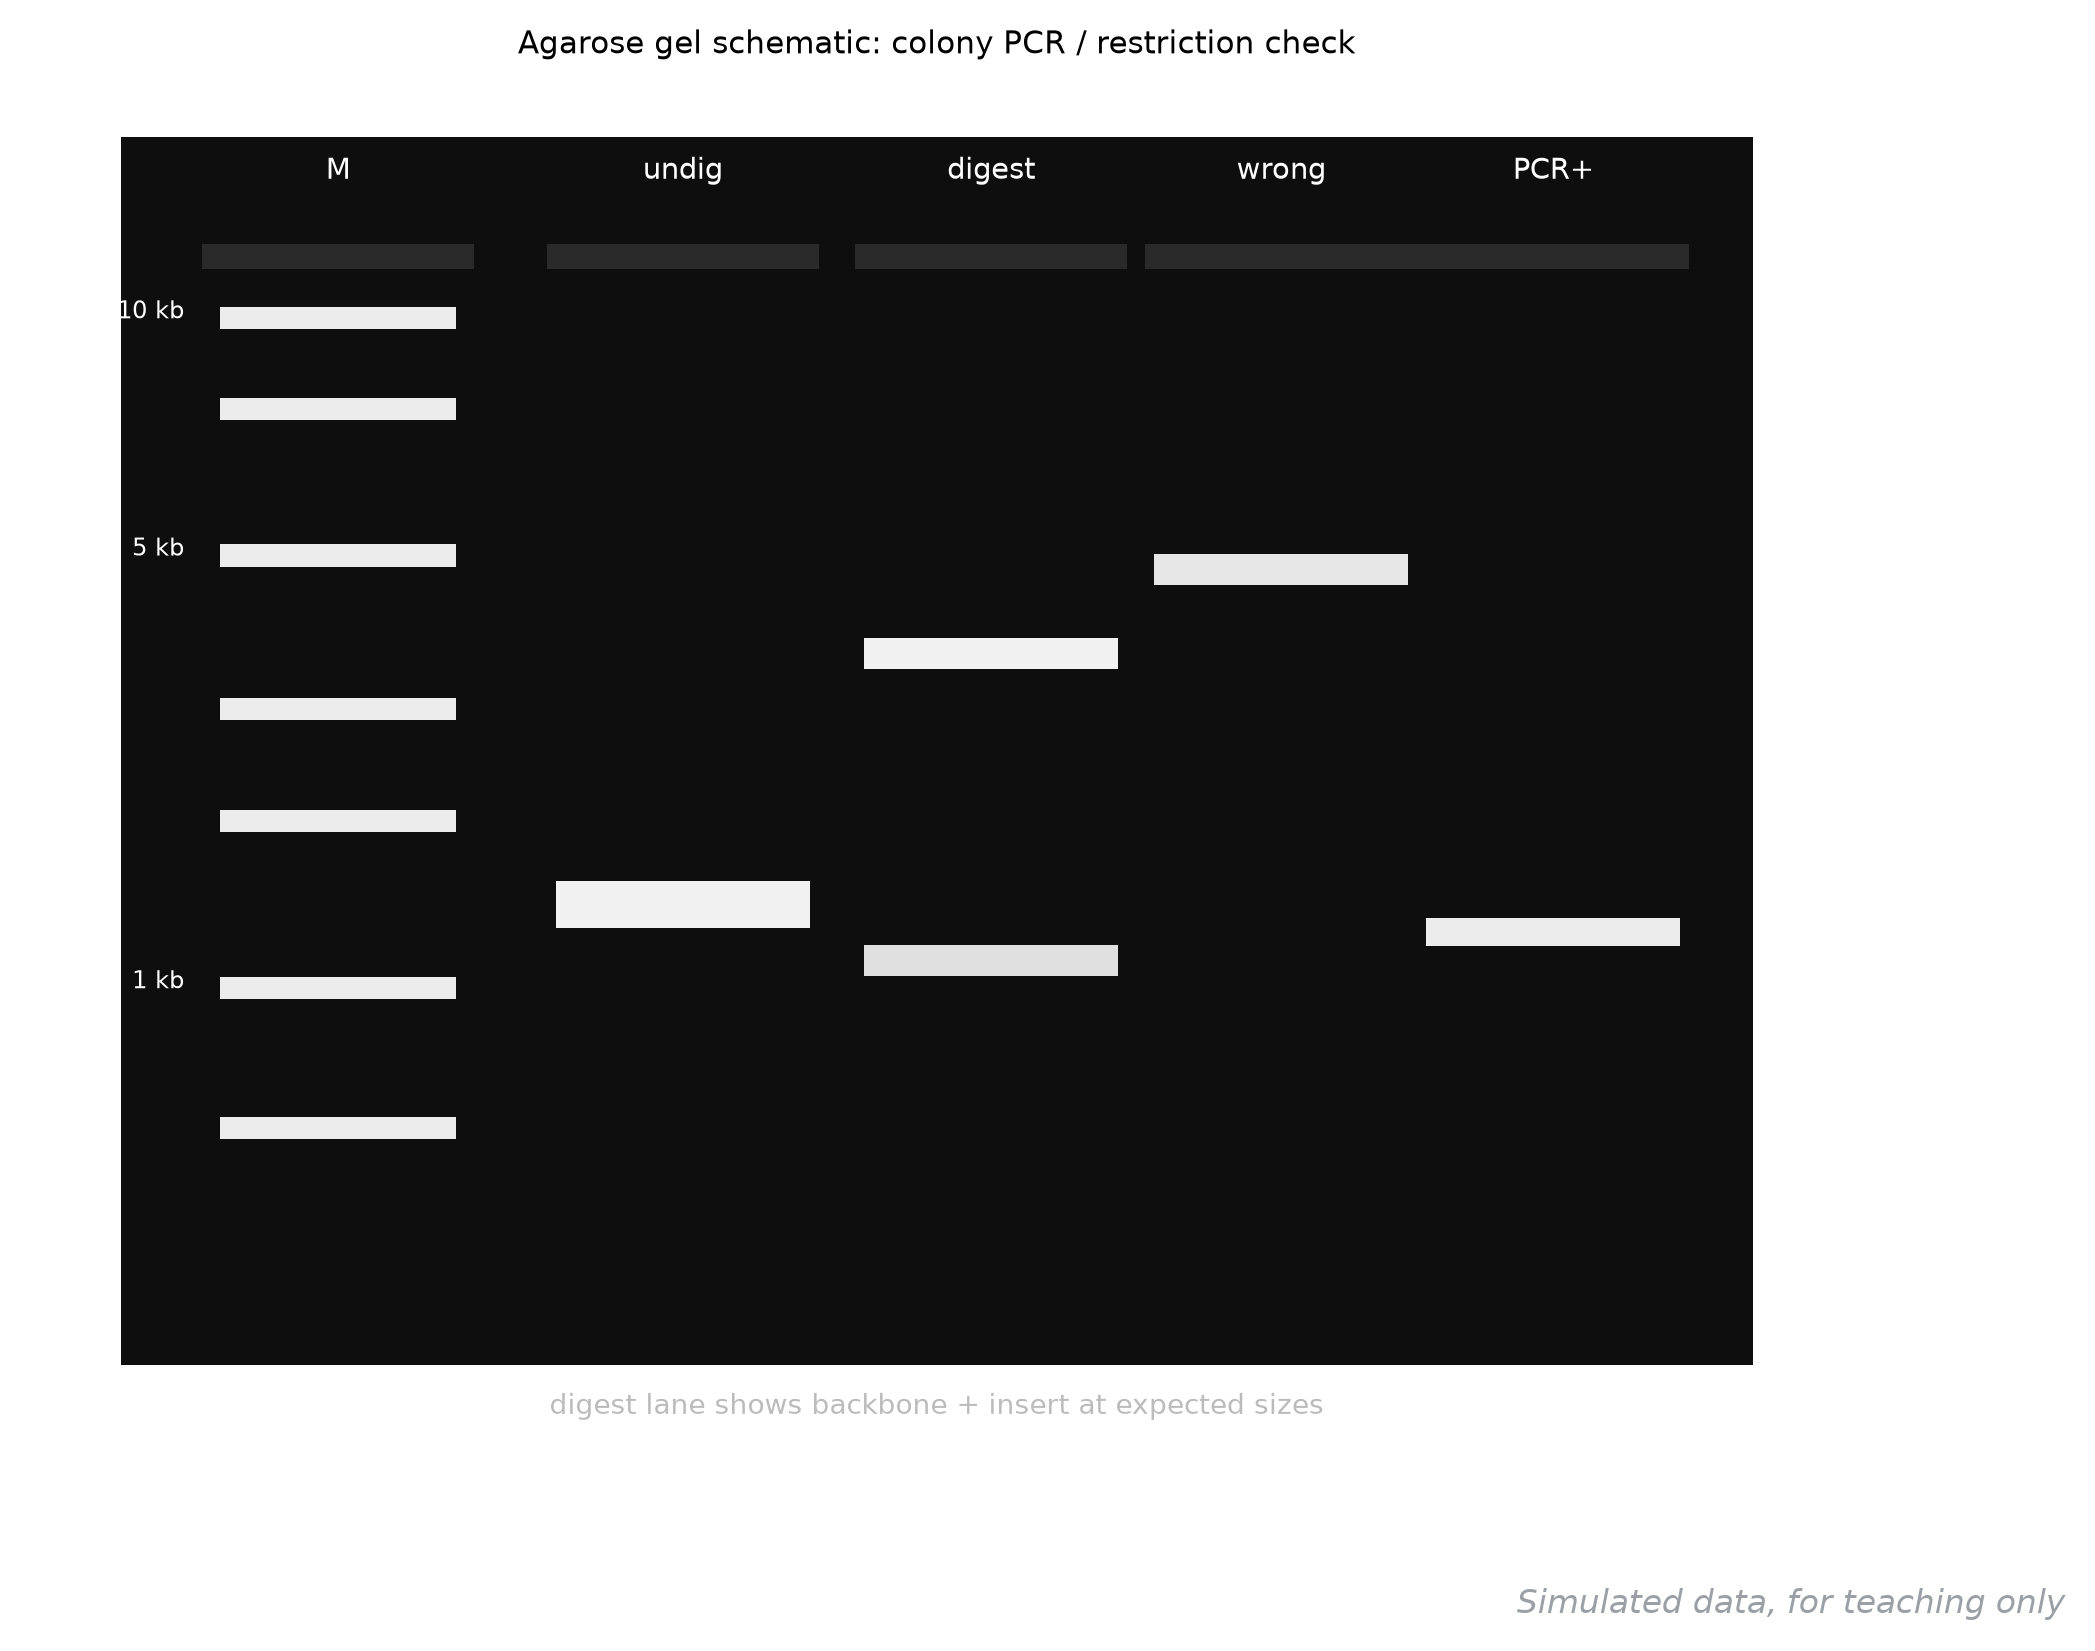
它回答什么问题:载体构建的每一步成没成功——菌落 PCR、酶切验证都靠这张图交作业,是湿实验里出场率最高的「图」。
怎么读:泳道从左到右讲一个故事:M 是分子量 ladder(对照尺子),undig 只有一条超螺旋质粒带(质粒提对了),digest 切出两条带(5.4 kb 载体骨架加 2.1 kb 插入片段,连接正确),wrong 是错误克隆(切出一条 6.2 kb,插入片段大小不对),PCR+ 是阳性对照。读图三步:先看 ladder 认尺子、再对着预期片段大小逐泳道比对、最后检查有没有拖尾和非特异条带。这张为示意图,真实胶图请扫描原图并保留原始文件备查。
用什么画:真实胶图用凝胶成像仪拍;示意图与排版用 matplotlib 画泳道条带即可(脚本如下)。
图注示例:
图 65 重组质粒酶切验证凝胶电泳示意。M 为 DNA ladder;digest 泳道出现 5.4 kb 载体骨架与 2.1 kb 目的片段两条带,表明插入片段大小正确。
展开查看:绘图代码(示意条带)
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(7.8, 5.8))
ax.add_patch(plt.Rectangle((0.5, 0.5), 9.0, 8.8, facecolor="#0E0E0E"))
lanes = {"M": 1.7, "undig": 3.6, "digest": 5.3, "wrong": 6.9, "PCR+": 8.4}
for name, x0 in lanes.items():
    ax.text(x0, 9.0, name, ha="center", fontsize=9, color="white")

def band(x0, y0, w, h, it=1.0):
    ax.add_patch(plt.Rectangle((x0 - w / 2, y0 - h / 2), w, h,
                               facecolor="white", alpha=0.5 + 0.5 * it))

for label, y0 in [("10 kb", 8.0), ("8000", 7.35), ("5 kb", 6.3),
                  ("3000", 5.2), ("2000", 4.4), ("1 kb", 3.2), ("500", 2.2)]:
    band(1.7, y0, 1.3, 0.16, 0.85)
    ax.text(0.85, y0, label if label.endswith("kb") else "", ha="right",
            fontsize=7.5, color="white")
band(3.6, 3.8, 1.4, 0.34, 0.9)     # undigested
band(5.3, 5.6, 1.4, 0.22, 0.9)     # backbone 5.4 kb
band(5.3, 3.4, 1.4, 0.22, 0.75)    # insert 2.1 kb
band(6.9, 6.2, 1.4, 0.22, 0.8)     # wrong clone
band(8.4, 3.6, 1.4, 0.2, 0.85)     # PCR positive
ax.set_xlim(0, 10)
ax.set_ylim(0, 9.6)
ax.axis("off")
fig.savefig("65-gel.png", dpi=200, bbox_inches="tight")
8.4 生长曲线
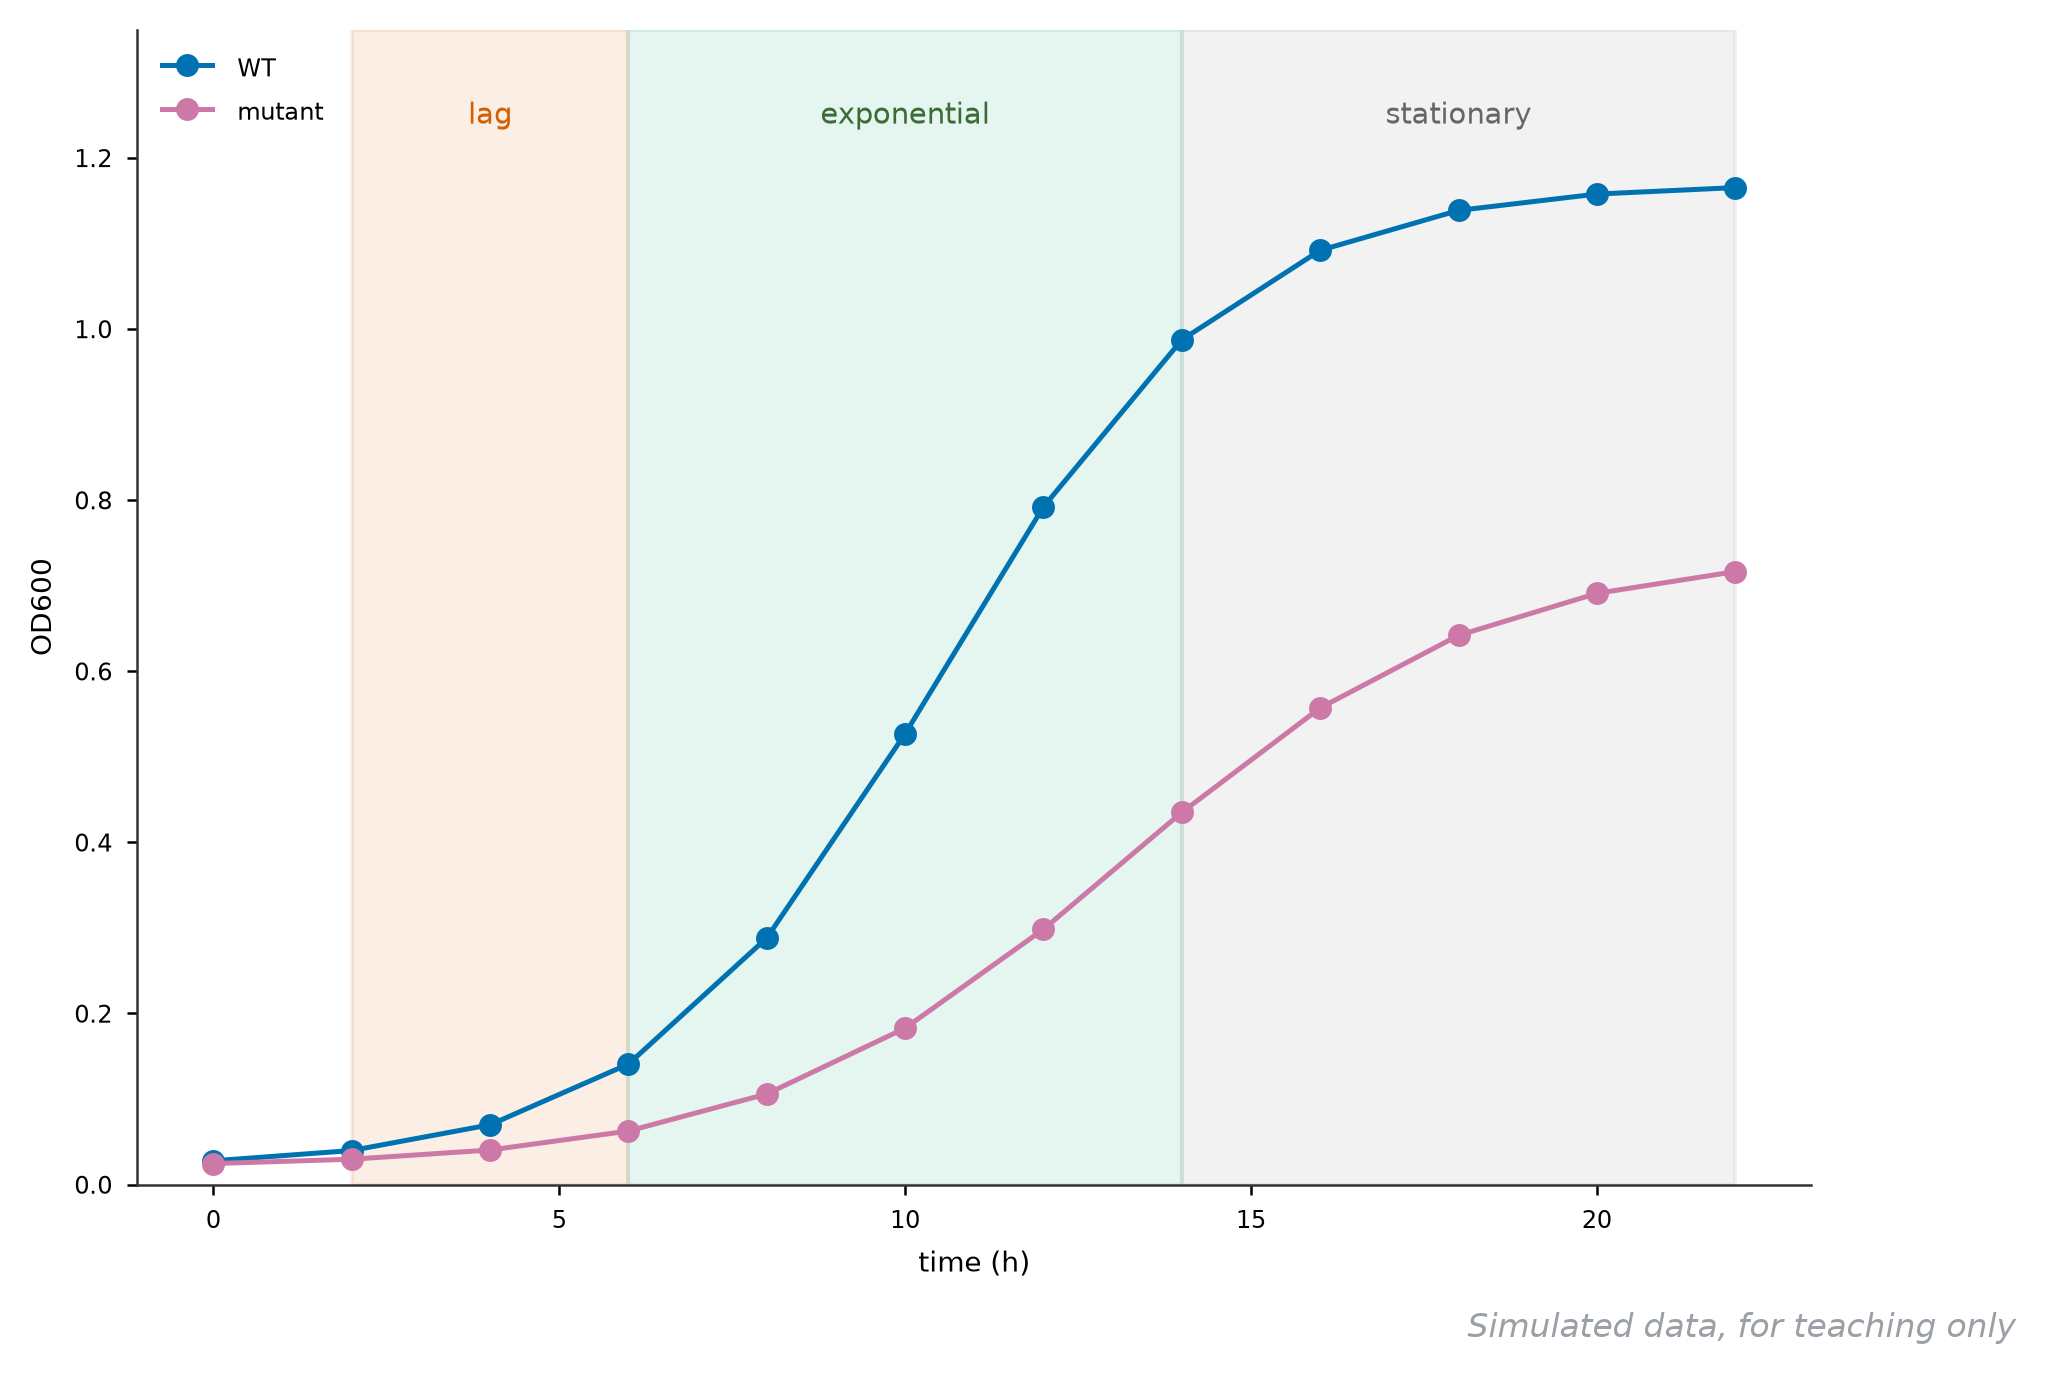
它回答什么问题:菌株(或细胞系)长得快不快、最终量够不够——微生物与细胞实验的基线图,也是基因功能「长势」表型的定量版。
怎么读:横轴时间,纵轴 OD600(浑浊度正比菌量),典型 S 形分三期:迟缓期(适应,斜率近零)、对数期(指数增长,斜率最大的直线段,世代时间从这里算)、稳定期(养分耗尽,平台)。本图野生型约 10.5 小时进入对数中后期、最终 OD 1.17;突变体起迟(13.2 小时)且封顶 0.72——既慢又矮,生长缺陷实锤。报告世代时间要取对数期两点换算,别直接读横轴。
用什么画:酶标仪定时读数后 GraphPad 或 Python 拟合 logistic;三期背景色带纯属辅助阅读。
图注示例:
图 66 野生型与突变体在液体培养基中的生长曲线(模拟)。阴影标注迟缓期、对数期与稳定期;突变体对数期延后约 2.7 小时且平台期 OD600 显著低于野生型。
展开查看:数据与绘图代码
time_h,WT,mutant
0,0.028,0.024
2,0.040,0.030
4,0.070,0.040
6,0.141,0.062
8,0.288,0.106
10,0.527,0.183
12,0.792,0.298
14,0.987,0.435
16,1.092,0.557
18,1.139,0.642
20,1.158,0.691
22,1.165,0.716
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("66-growth.csv")
fig, ax = plt.subplots(figsize=(7.2, 5.0))
ax.plot(df.time_h, df.WT, "-o", ms=5, color="#4C72B0", label="WT")
ax.plot(df.time_h, df.mutant, "-o", ms=5, color="#C44E52", label="mutant")
ax.axvspan(2, 6, color="#DD8452", alpha=0.10)
ax.text(4, 1.24, "lag", ha="center", fontsize=9, color="#DD8452")
ax.axvspan(6, 14, color="#55A868", alpha=0.10)
ax.text(10, 1.24, "exponential", ha="center", fontsize=9, color="#3D6B35")
ax.axvspan(14, 22, color="0.5", alpha=0.10)
ax.text(18, 1.24, "stationary", ha="center", fontsize=9, color="0.4")
ax.set_xlabel("time (h)")
ax.set_ylabel("OD600")
ax.set_ylim(0, 1.35)
ax.legend(loc="upper left")
fig.savefig("66-growth.png", dpi=200, bbox_inches="tight")
九、机器学习与模型评估
9.1 PR 曲线
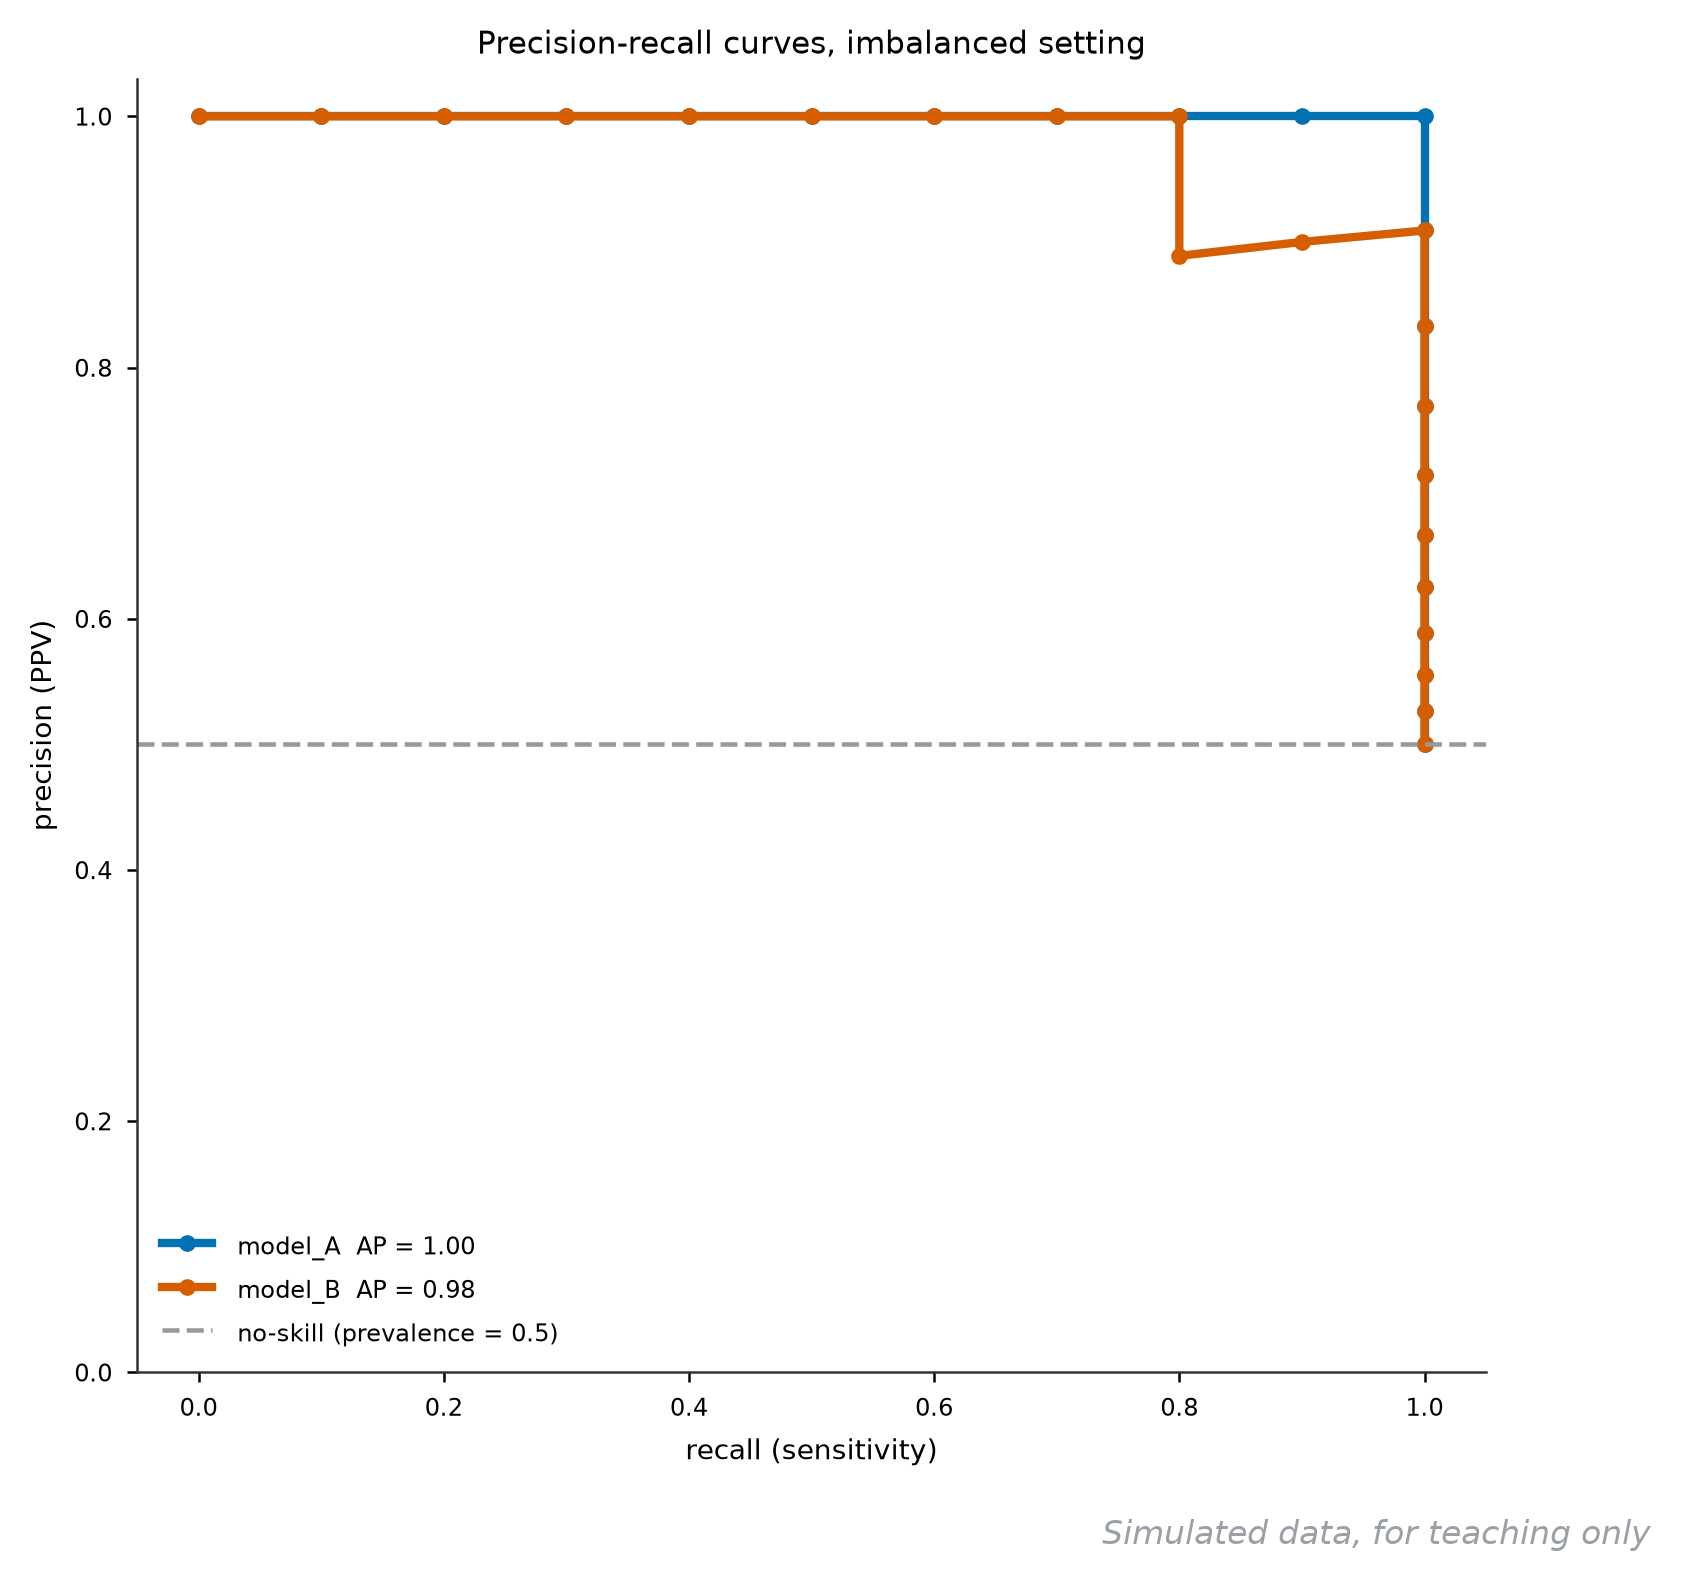
它回答什么问题:类别不平衡时(阳性远少于阴性),ROC 会显得过于乐观,precision-recall 曲线才是诚实的那把尺。
怎么读:横轴 recall(阳性里抓住了多少),纵轴 precision(抓出来的里面真是阳性的比例),从右往左松开判定阈值扫出曲线。基线不是 0.5 而是阳性占比(不平衡数据里基线会贴地,本例 50% 恰好居中);曲线下的近似面积 AP 越大越好,曲线右上角越凸越好。本例 model_A 把 20 个样本完全分开(AP = 1.00),model_B 因为混进两个高分阴性(0.55、0.51)在 recall 0.8 附近掉了一小截精度(AP = 0.98)。与 ROC 的分工:筛查场景(漏检代价高)看 recall,确认场景(误报代价高)看 precision,PR 曲线把这两者的权衡摆在一起。
用什么画:Python sklearn.metrics.precision_recall_curve 加 average_precision_score;R 语言 PRROC。
图注示例:
图 67 两个模型的 precision-recall 曲线(n = 20,模拟)。model_A 的平均精度 AP = 1.00,model_B 为 0.98;灰色虚线为随机水平(阳性占比 50%)。
展开查看:打分数据与绘图代码
sample,label,model_A,model_B
P1,1,0.97,0.90
P2,1,0.94,0.84
P3,1,0.91,0.79
P4,1,0.88,0.72
P5,1,0.85,0.83
P6,1,0.81,0.60
P7,1,0.76,0.66
P8,1,0.71,0.45
P9,1,0.65,0.58
P10,1,0.60,0.51
N1,0,0.42,0.40
N2,0,0.38,0.35
N3,0,0.33,0.55
N4,0,0.29,0.30
N5,0,0.25,0.41
N6,0,0.21,0.24
N7,0,0.17,0.36
N8,0,0.13,0.19
N9,0,0.09,0.12
N10,0,0.05,0.22
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52"]
df = pd.read_csv("67-pr.csv")
label = df.label.values.astype(int)
fig, ax = plt.subplots(figsize=(5.8, 5.6))
for i, m in enumerate(["model_A", "model_B"]):
    order = np.argsort(-df[m].values)
    lab = label[order]
    tp = np.cumsum(lab)
    fp = np.cumsum(1 - lab)
    prec = np.r_[1, tp / (tp + fp)]
    rec = np.r_[0, tp / tp[-1]]
    ax.plot(rec, prec, lw=2, color=CAT[i], marker="o", ms=3.5,
            label="%s  AP = %.2f" % (m, np.trapezoid(prec, rec)))
base = label.mean()
ax.axhline(base, color="0.6", ls="--", lw=1.1,
           label="no-skill (prevalence = %.1f)" % base)
ax.set_xlabel("recall (sensitivity)")
ax.set_ylabel("precision (PPV)")
ax.set_ylim(0, 1.03)
ax.set_title("Precision-recall curves, imbalanced setting")
ax.legend(loc="lower left")
fig.savefig("67-pr.png", dpi=200, bbox_inches="tight")
9.2 混淆矩阵热图
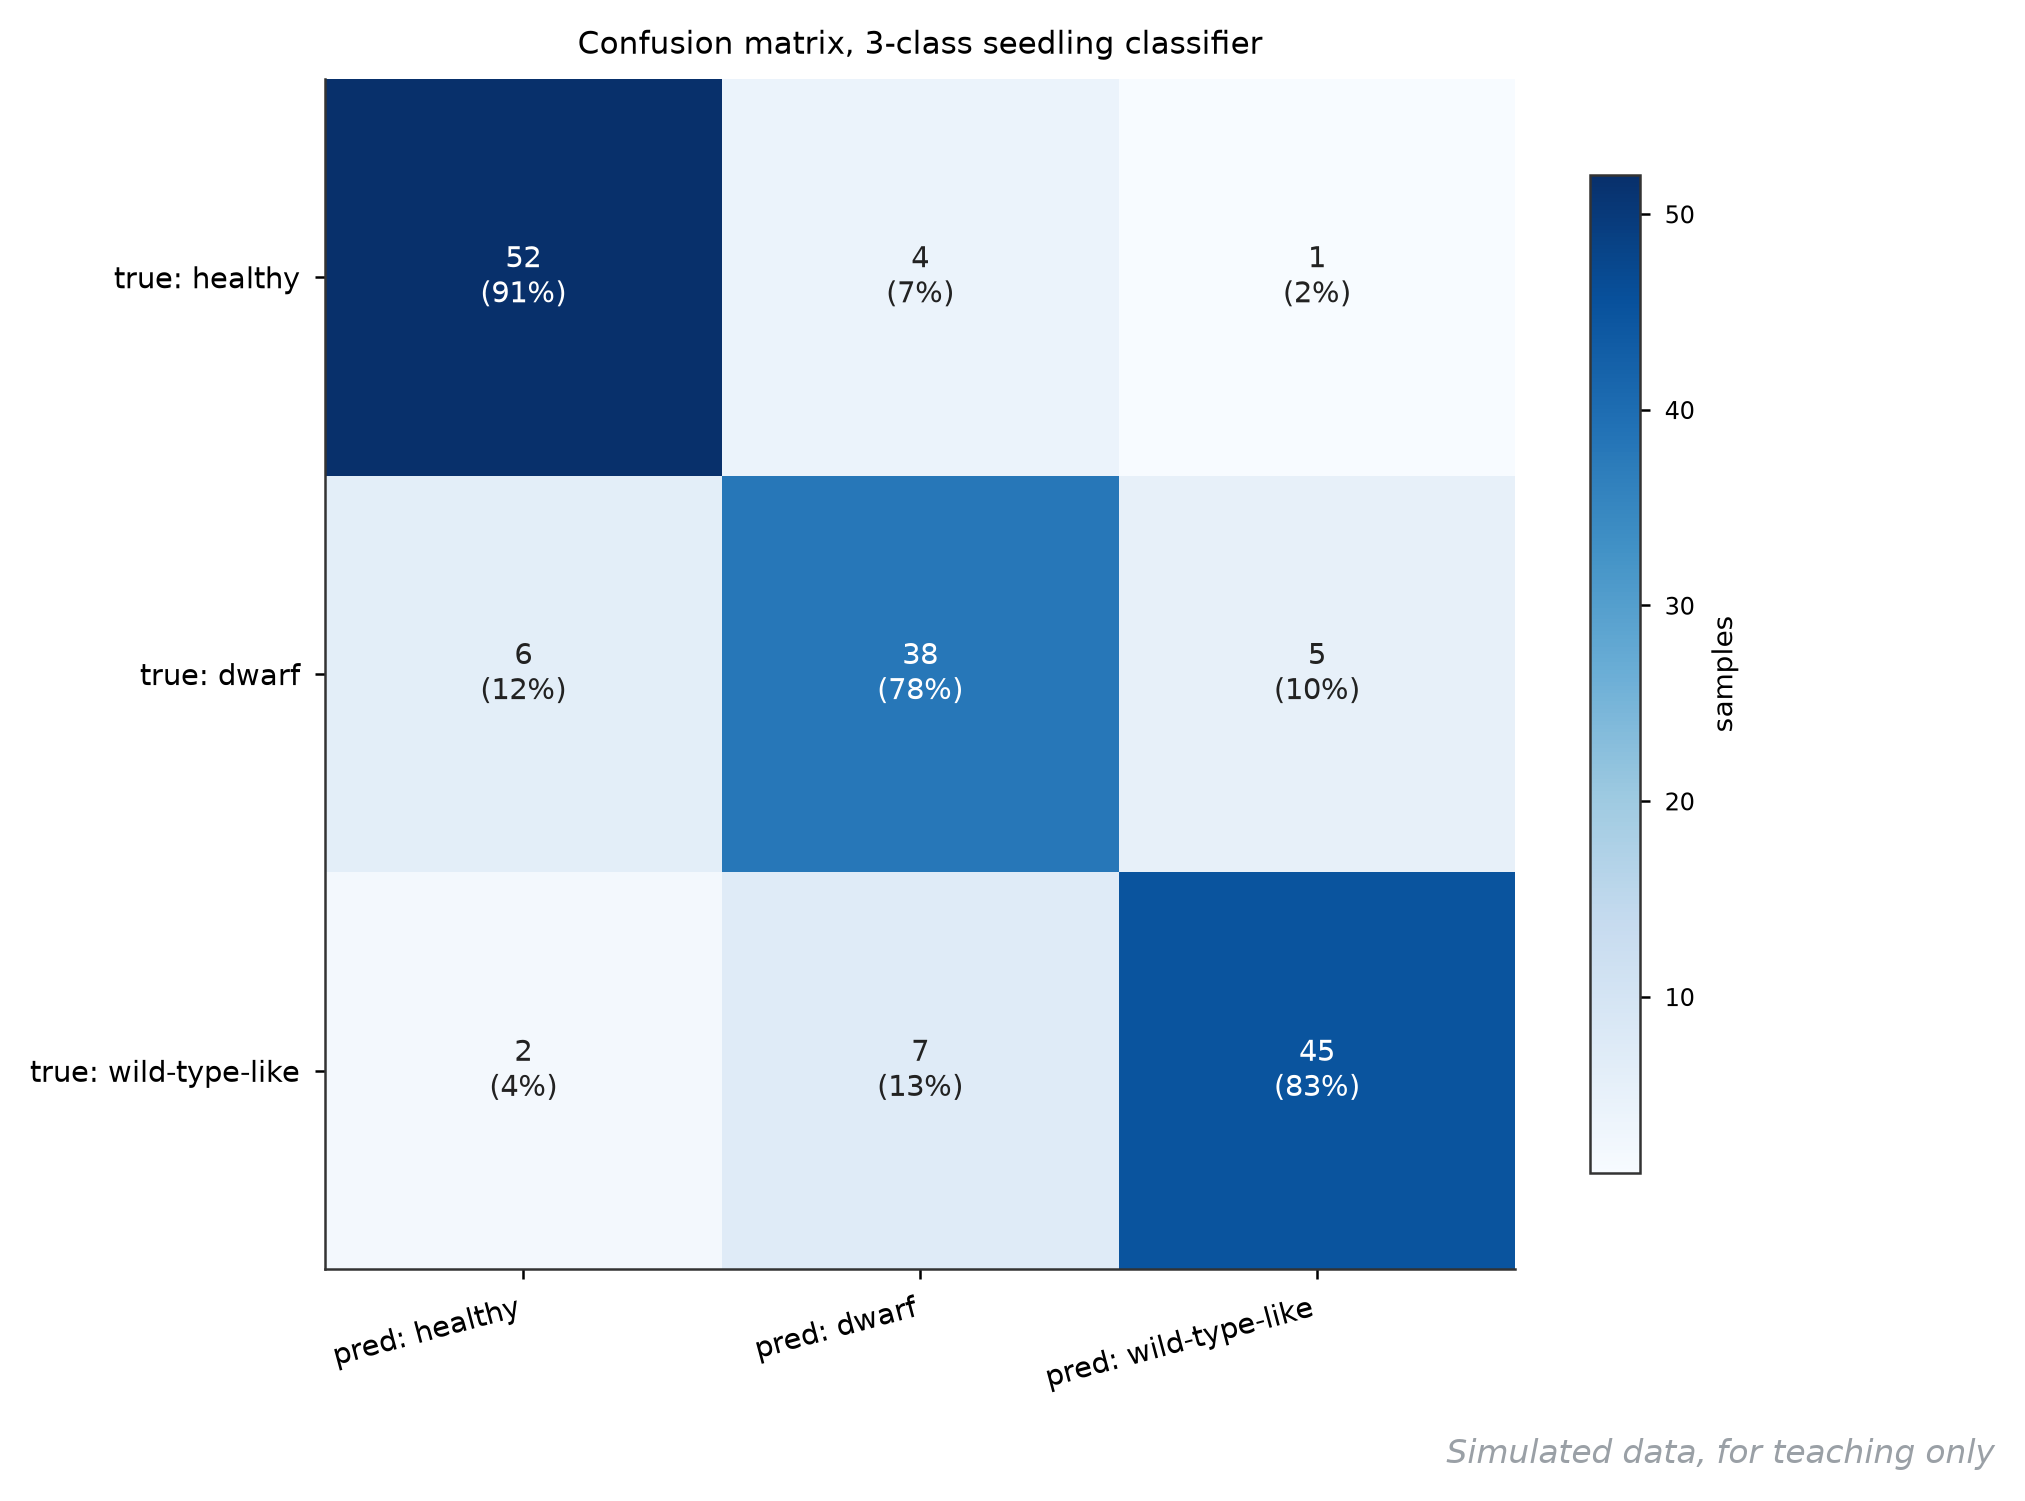
它回答什么问题:分类模型错在哪一类上——总体准确率之外,逐类的错分方向才是改进模型的线索。
怎么读:行是真实类别,列是预测类别,对角线是分对的(数值越大越蓝),非对角线每个格子都是一种具体的错误。看两样:dwarf 被误判成 wild-type-like 有 5 个(错把矮秆认成正常,育种筛选里代价最高的方向);healthy 准确率 91% 最高。每格括号里是按行归一的百分比,比裸计数好读——各类样本数不相等时,百分比才公平。
用什么画:Python sklearn.metrics.ConfusionMatrixDisplay,或 seaborn heatmap 按本图样式标注计数与行百分比。
图注示例:
图 68 三类幼苗表型分类器的混淆矩阵(模拟)。行为真实类别、列为预测类别,括号内为按行归一的百分比;dwarf 类有 10.4% 被误判为野生型表型。
展开查看:数据与绘图代码
true,pred_healthy,pred_dwarf,pred_wildtype
healthy,52,4,1
dwarf,6,38,5
wild-type-like,2,7,45
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("68-confusion.csv", index_col="true")
M = df.values
labels = df.index.tolist()
fig, ax = plt.subplots(figsize=(6.4, 5.4))
im = ax.imshow(M, cmap="Blues")
ax.set_xticks(range(3), ["pred: " + l for l in labels], rotation=15,
              ha="right", fontsize=9)
ax.set_yticks(range(3), ["true: " + l for l in labels], fontsize=9)
ax.grid(False)
for i in range(3):
    for j in range(3):
        ax.text(j, i, "%d\n(%.0f%%)" % (M[i, j], M[i, j] / M[i].sum() * 100),
                ha="center", va="center", fontsize=9,
                color="white" if M[i, j] > 30 else "#222")
fig.colorbar(im, ax=ax, shrink=0.8, label="samples")
ax.set_title("Confusion matrix, 3-class seedling classifier")
fig.savefig("68-confusion.png", dpi=200, bbox_inches="tight")
9.3 PCA 碎石图
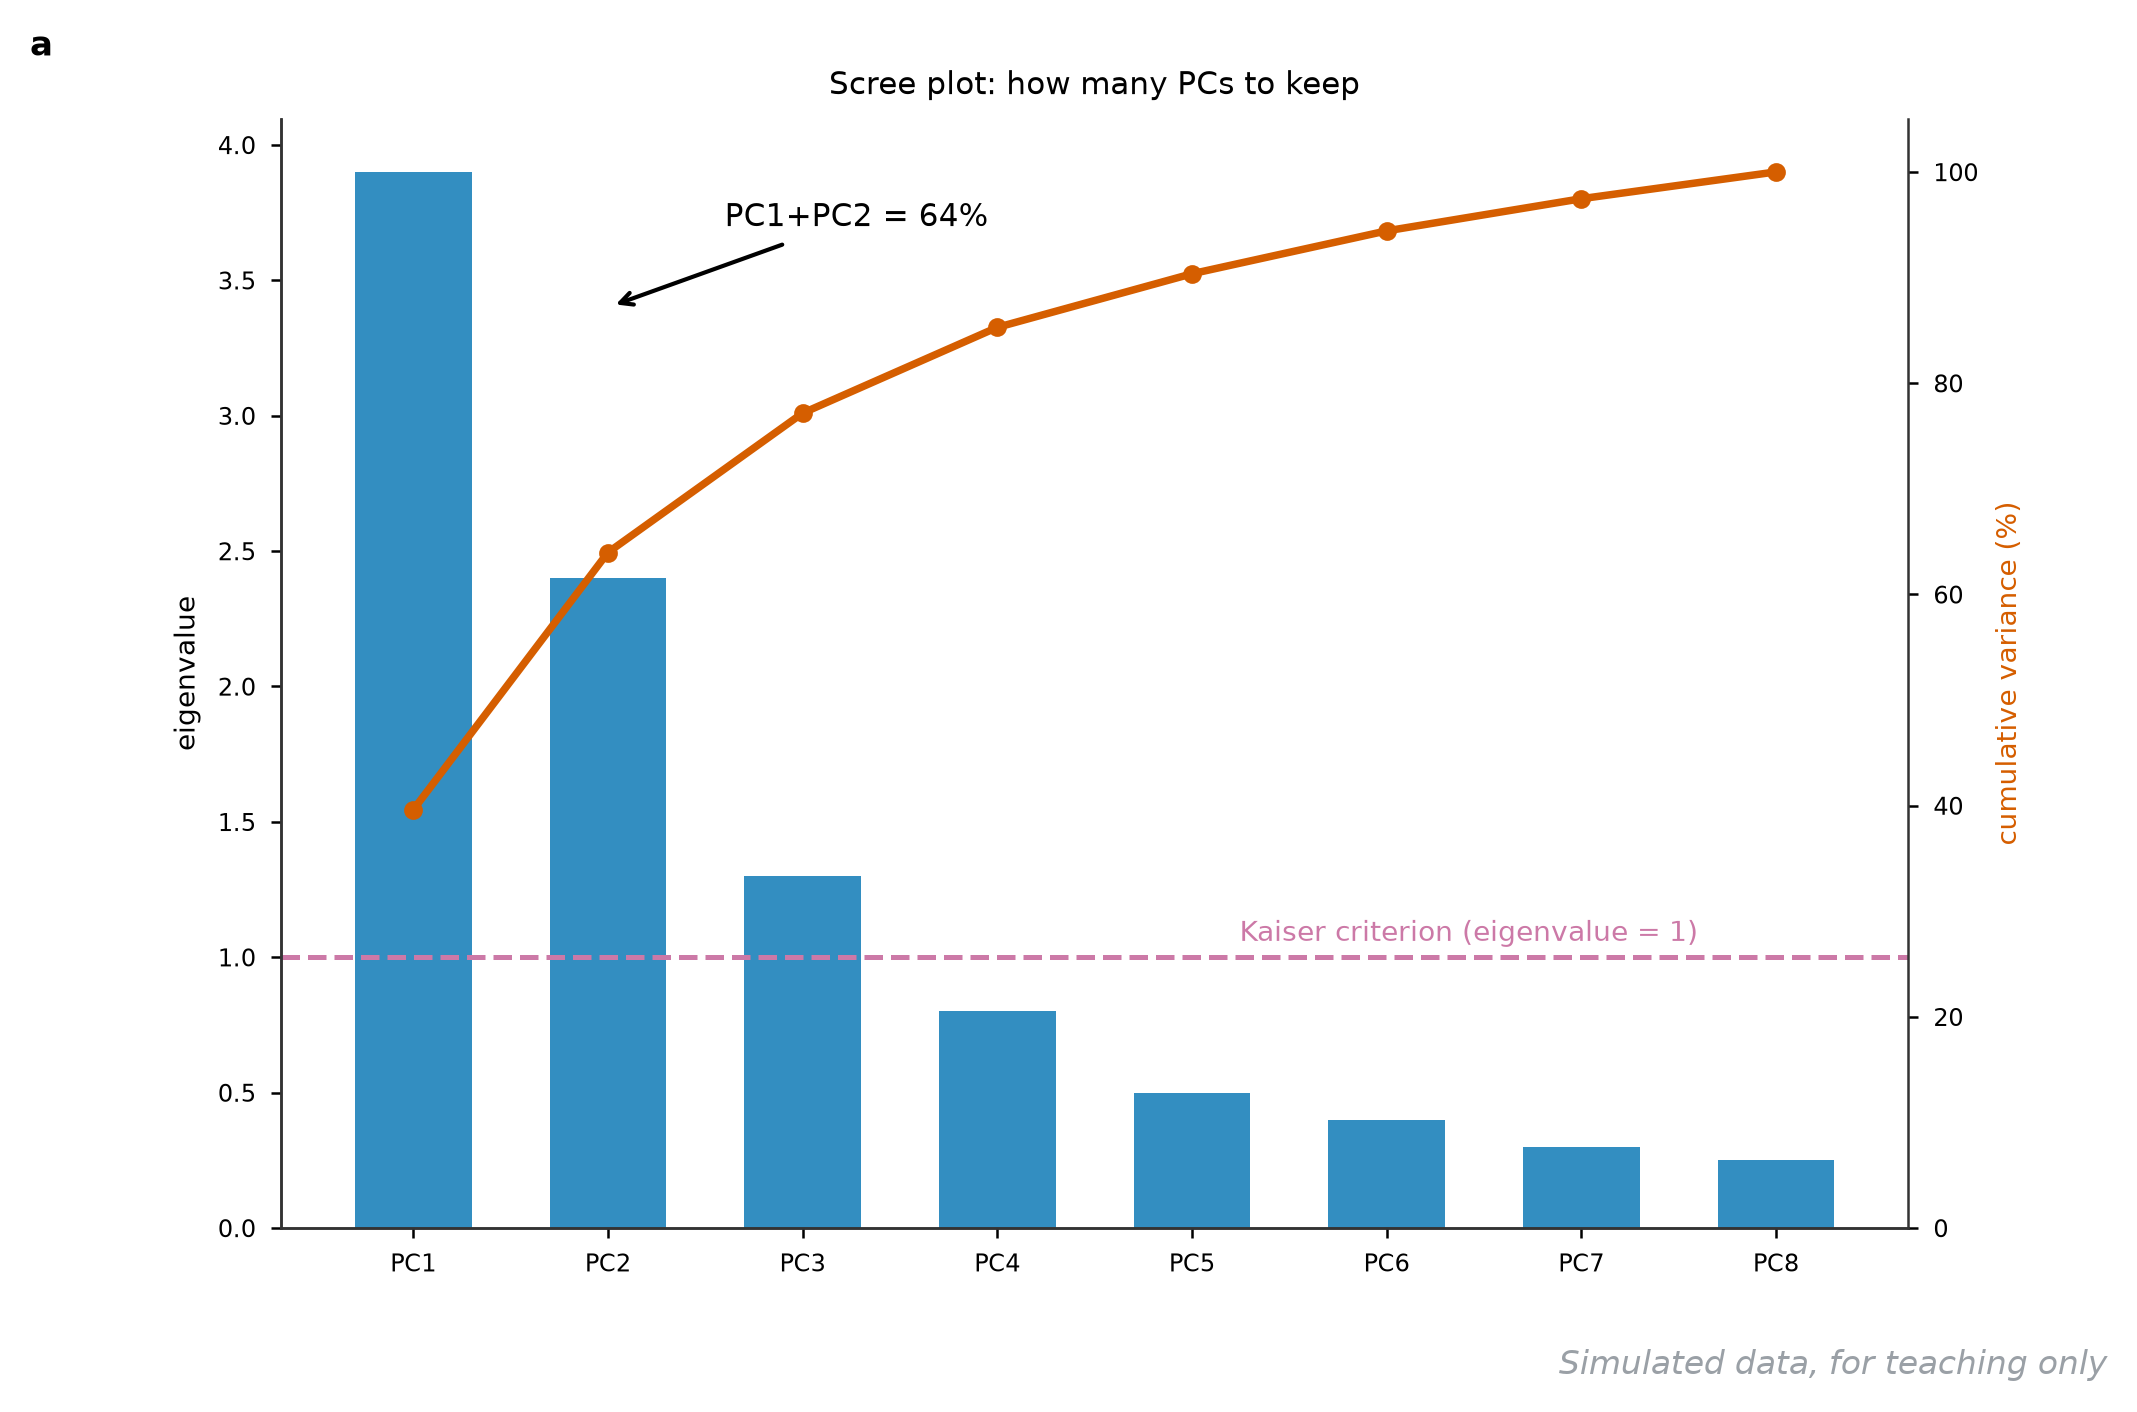
它回答什么问题:降维时保留几个主成分合适——上一篇 PCA 图怎么来的,这篇告诉你选轴的依据。
怎么读:柱子是每个主成分的特征值(解释的方差量),折线是累计解释率。两个常用判据:Kaiser 准则保留特征值大于 1 的成分(本图 PC1-PC3);肘点法找折线「弯下去」的位置(本图在 PC2 与 PC3 之间)。两条判据经常打架,结论写法是「前 k 个主成分累计解释 xx% 方差,依据肘点与 Kaiser 准则保留」,别只报一条判据。
用什么画:R 语言 factoextra::fviz_screeplot;Python 直接对 PCA.explained_variance_ 画柱加累计折线。
图注示例:
图 69 八个主成分的碎石图(模拟)。柱为特征值,折线为累计解释方差;PC1 与 PC2 合计解释 64%,按 Kaiser 准则保留特征值大于 1 的前三个成分。
展开查看:数据与绘图代码
pc,eigenvalue,var_pct
PC1,3.90,39.6
PC2,2.40,24.4
PC3,1.30,13.2
PC4,0.80,8.1
PC5,0.50,5.1
PC6,0.40,4.1
PC7,0.30,3.0
PC8,0.25,2.5
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("69-scree.csv")
x = np.arange(1, len(df) + 1)
fig, ax = plt.subplots(figsize=(7.0, 4.8))
ax.bar(x, df.eigenvalue, color="#4C72B0", alpha=0.8, width=0.6)
ax.axhline(1, color="#C44E52", ls="--", lw=1.2)
ax.text(7.6, 1.06, "Kaiser criterion (eigenvalue = 1)", fontsize=8.5,
        color="#C44E52", ha="right")
ax2 = ax.twinx()
ax2.plot(x, np.cumsum(df.var_pct), "-o", color="#DD8452", lw=1.8)
ax2.set_ylabel("cumulative variance (%)", color="#DD8452")
ax2.set_ylim(0, 105)
ax2.spines["right"].set_visible(True)
ax.annotate("PC1+PC2 = 64%", (2, 3.4), (2.6, 3.7), fontsize=9.5,
            arrowprops=dict(arrowstyle="->", lw=1))
ax.set_xticks(x, df.pc)
ax.set_ylabel("eigenvalue")
ax.set_title("Scree plot: how many PCs to keep")
fig.savefig("69-scree.png", dpi=200, bbox_inches="tight")
9.4 随机森林特征重要性条形图
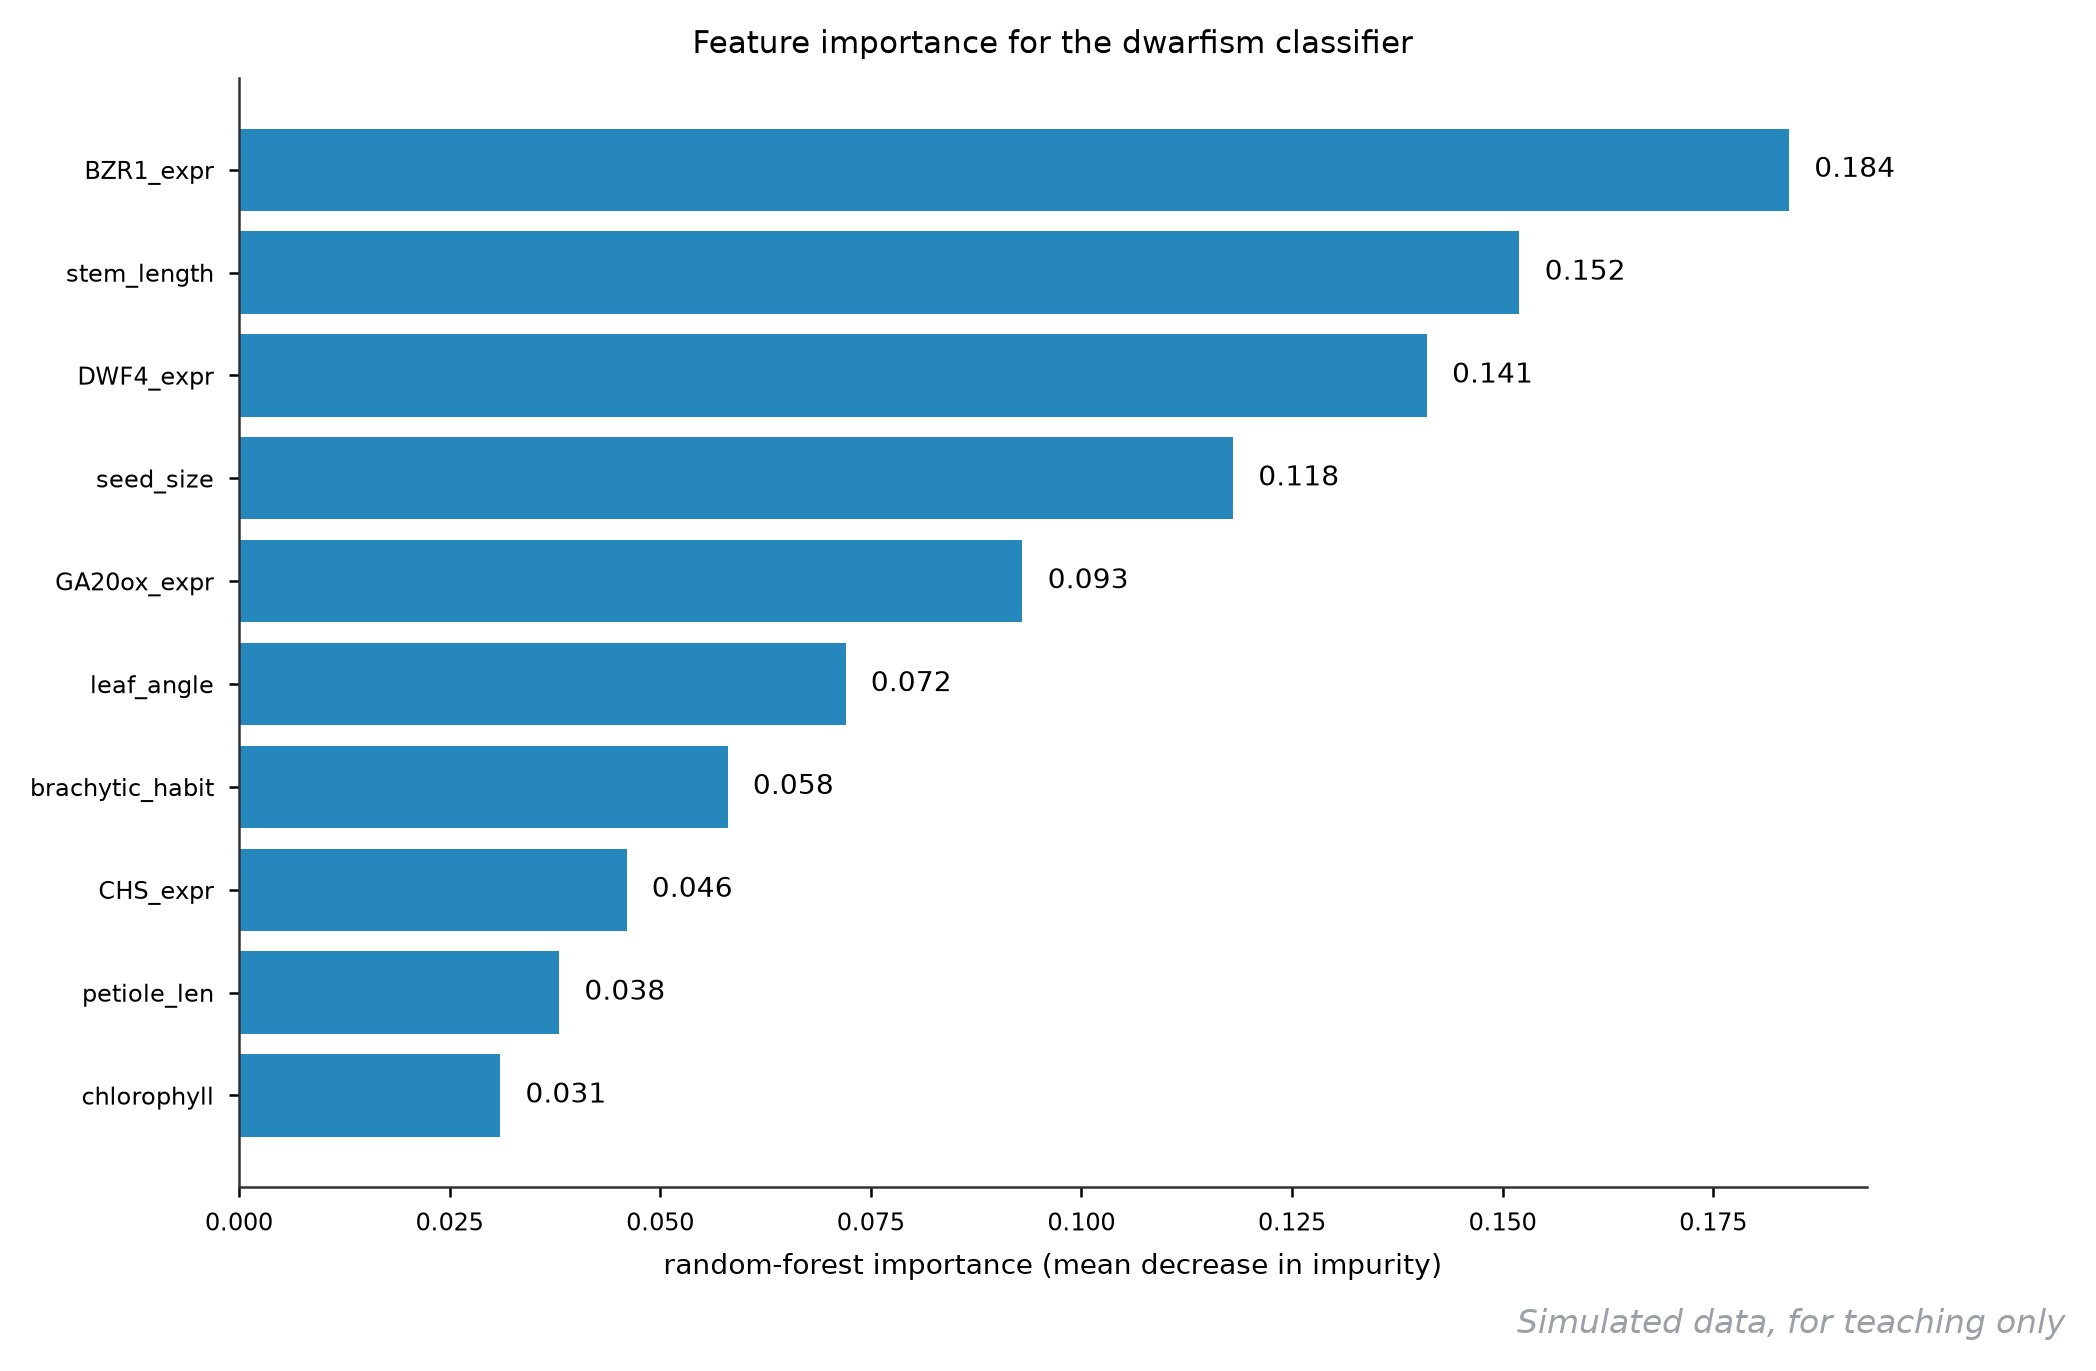
它回答什么问题:模型做判断时最看重哪些变量——机器学习解释性的入门图,也是「从关联走向候选标记」的桥梁。
怎么读:横轴是重要性得分(默认为不纯度下降均值),条越长说明该变量对分类贡献越大。看两样:头部变量的量级差(BZR1 表达量 0.184 独占鳌头,配合上一篇的相关分析互相印证)、以及长尾截断的位置(本图展示前 10,其余合计不到 7%,截掉不亏)。提醒一句:相关性高的变量会分摊重要性,解读时别把排名当成因果强度。
用什么画:Python sklearn 训练后读 feature_importances_,按值排序画横条;R 语言 vip 包。
图注示例:
图 70 随机森林矮秆分类器的特征重要性前 10 名(模拟)。BZR1 表达量与茎长为主要判别特征,前两个特征合计贡献 34%。
展开查看:数据与绘图代码
feature,importance
BZR1_expr,0.184
stem_length,0.152
DWF4_expr,0.141
seed_size,0.118
GA20ox_expr,0.093
leaf_angle,0.072
brachytic_habit,0.058
CHS_expr,0.046
petiole_len,0.038
chlorophyll,0.031
绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("70-featimp.csv").sort_values("importance")
fig, ax = plt.subplots(figsize=(7.0, 4.8))
ax.barh(df.feature, df.importance, color="#4C72B0", alpha=0.85)
for i, v in enumerate(df.importance):
    ax.text(v + 0.003, i, "%.3f" % v, va="center", fontsize=8.5)
ax.set_xlabel("random-forest importance (mean decrease in impurity)")
ax.set_title("Feature importance for the dwarfism classifier")
fig.savefig("70-featimp.png", dpi=200, bbox_inches="tight")
十、育种与数量遗传
10.1 品种多性状雷达图
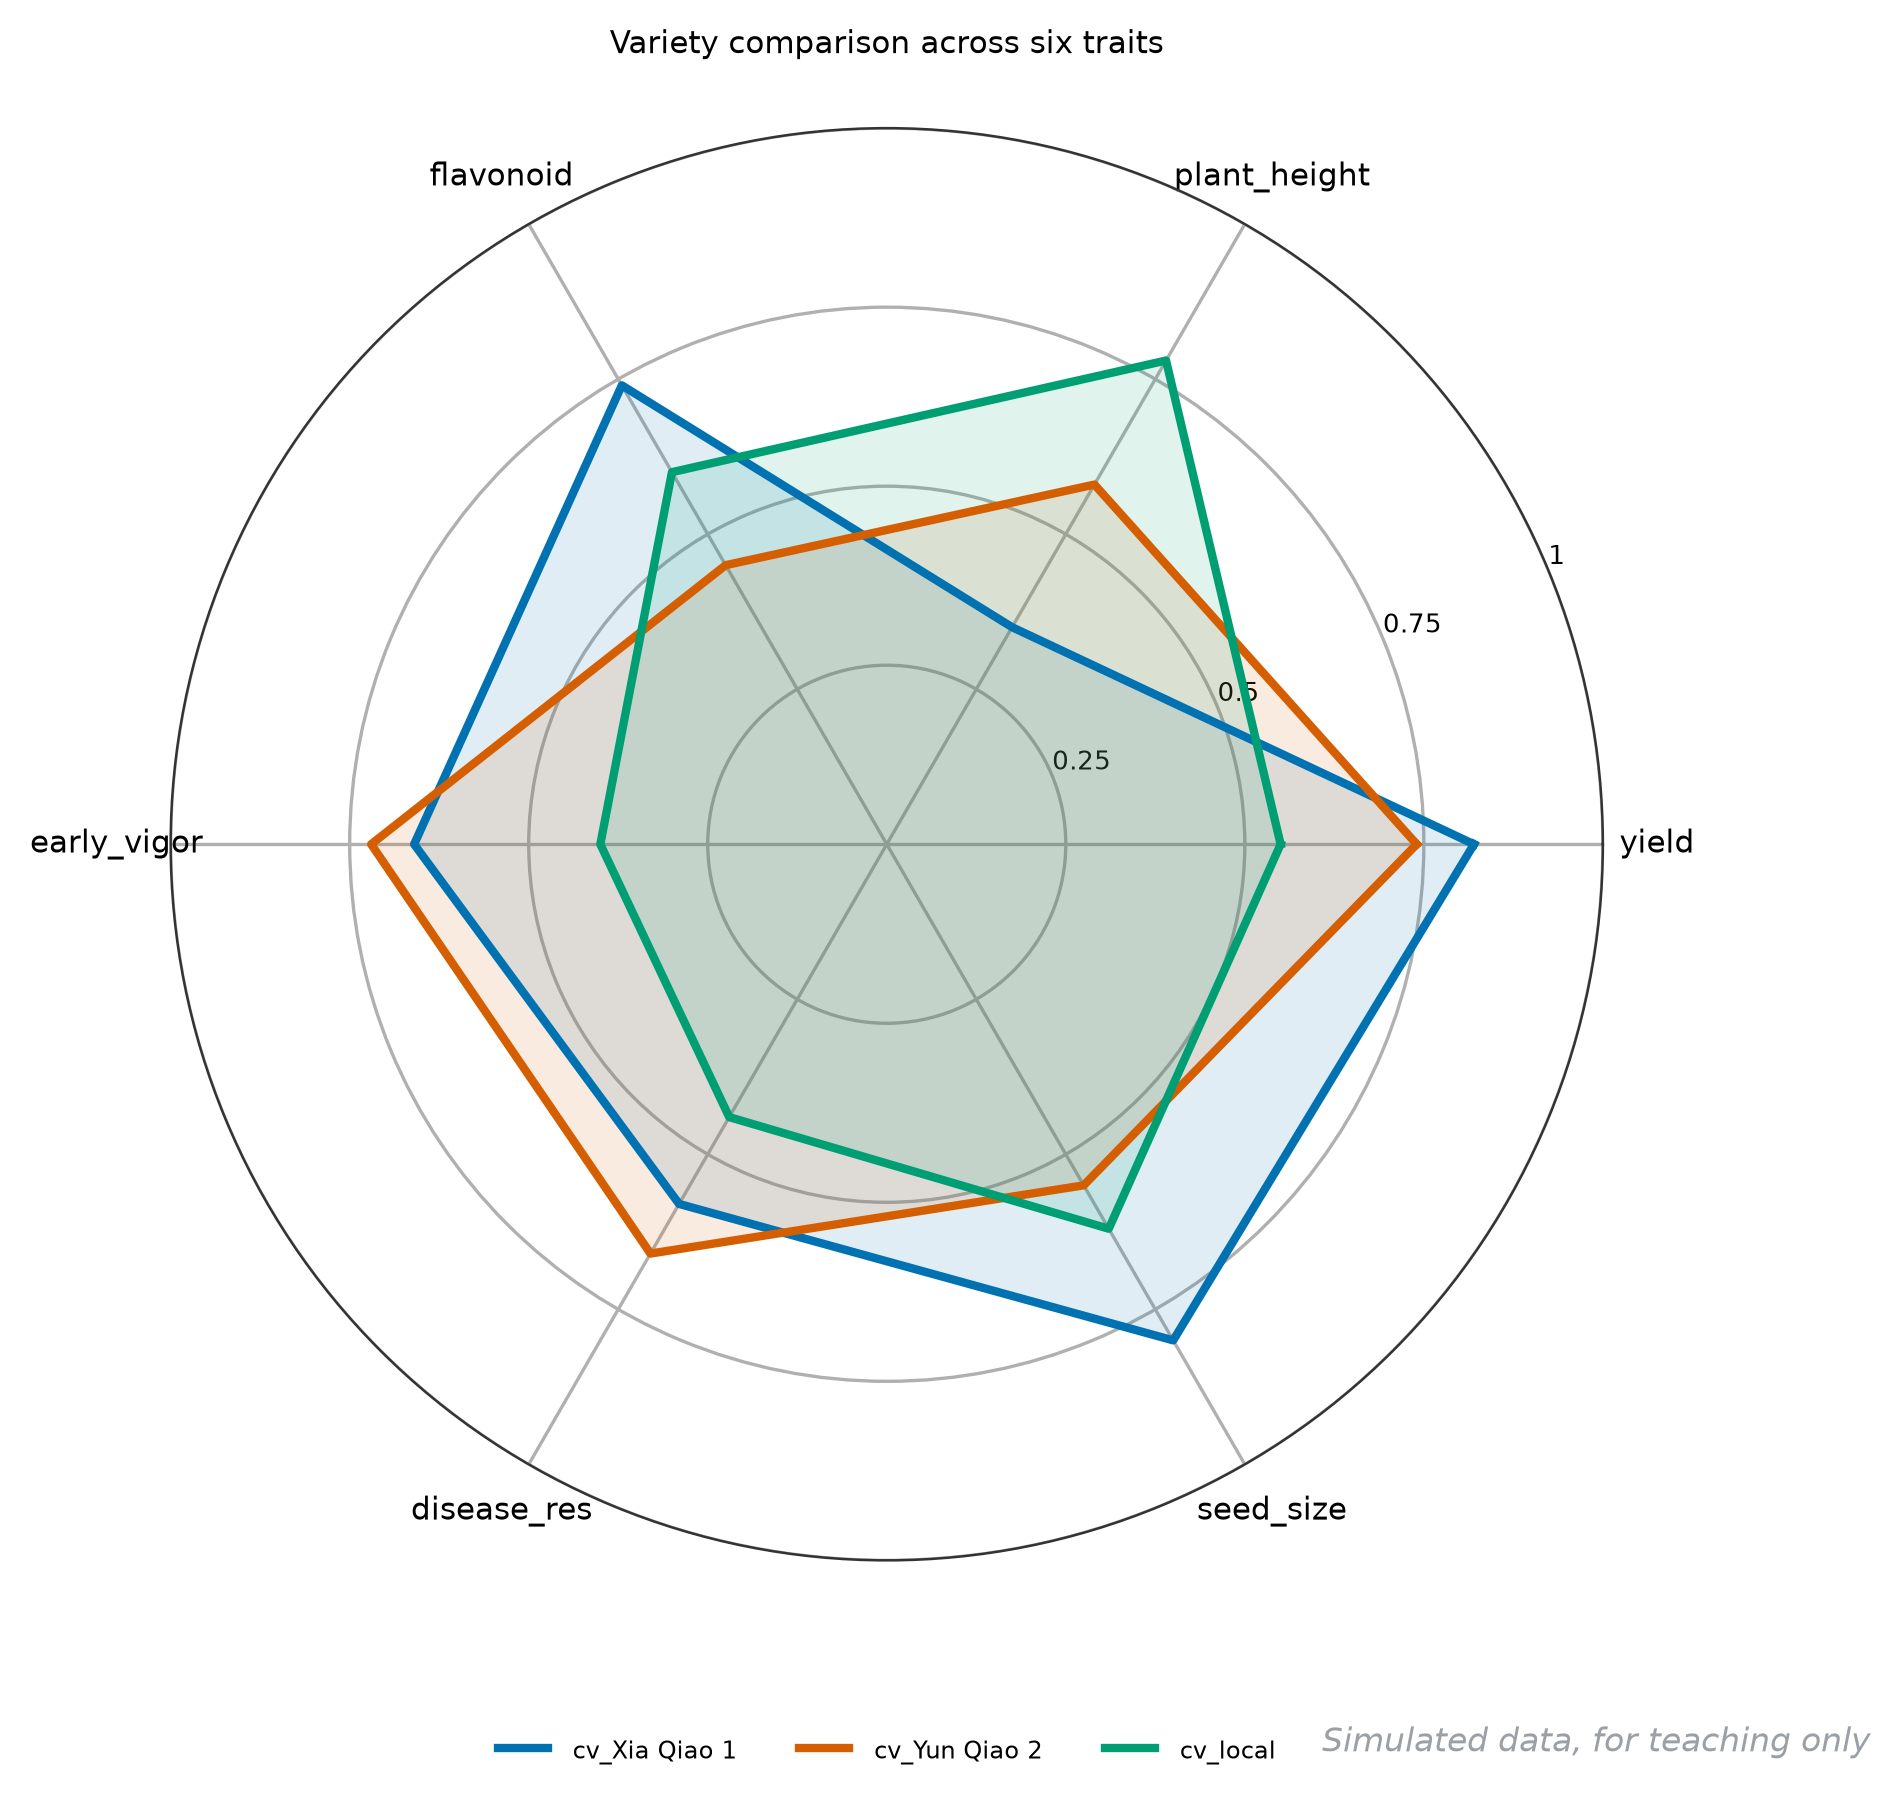
它回答什么问题:三个品种在六个性状上的「形状」差异——育种汇报和品种介绍里最直观的综合比较图。
怎么读:每个轴一个性状(建议先统一归一化到 0-1,比如除以对照最大值),一圈一圈是刻度,品种折线围出的面积就是「综合轮廓」。看两点:覆盖面积大且形状匀称的是全能型(夏荞 1 号),某一轴突出但内凹的是专长型(本地品种株高轴突出但长势弱)。雷达图的坑在于轴顺序和归一化方式会显著改变观感,图注必须交代归一化方法,性状超过 8 个就该换热图了。
用什么画:R 语言 ggradar 或 fmsb;Python 用 matplotlib 极坐标 subplot(polar=True)。
图注示例:
图 71 三个荞麦品种六性状比较雷达图(模拟)。各性状按对照最大值归一化到 0-1;夏荞 1 号综合轮廓最优,云荞 2 号早发性状突出。
展开查看:数据与绘图代码
trait,cv_Xia Qiao 1,cv_Yun Qiao 2,cv_local
yield,0.82,0.74,0.55
plant_height,0.35,0.58,0.78
flavonoid,0.74,0.45,0.60
early_vigor,0.66,0.72,0.40
disease_res,0.58,0.66,0.44
seed_size,0.80,0.55,0.62
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("71-radar.csv", index_col="trait")
ang = np.linspace(0, 2 * np.pi, len(df), endpoint=False)
ang = np.r_[ang, ang[0]]
CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig = plt.figure(figsize=(6.8, 6.2))
ax = fig.add_subplot(polar=True)
for i, col in enumerate(df.columns):
    v = np.r_[df[col].values, df[col].values[0]]
    ax.plot(ang, v, color=CAT[i], lw=2, label=col)
    ax.fill(ang, v, color=CAT[i], alpha=0.12)
ax.set_xticks(ang[:-1], df.index, fontsize=9.5)
ax.set_ylim(0, 1)
ax.set_yticks([0.25, 0.5, 0.75, 1.0], ["0.25", "0.5", "0.75", "1"], fontsize=8)
ax.set_title("Variety comparison across six traits", pad=18)
ax.legend(loc="lower center", bbox_to_anchor=(0.5, -0.16), ncol=3)
fig.savefig("71-radar.png", dpi=200, bbox_inches="tight")
10.2 GGE 双标图
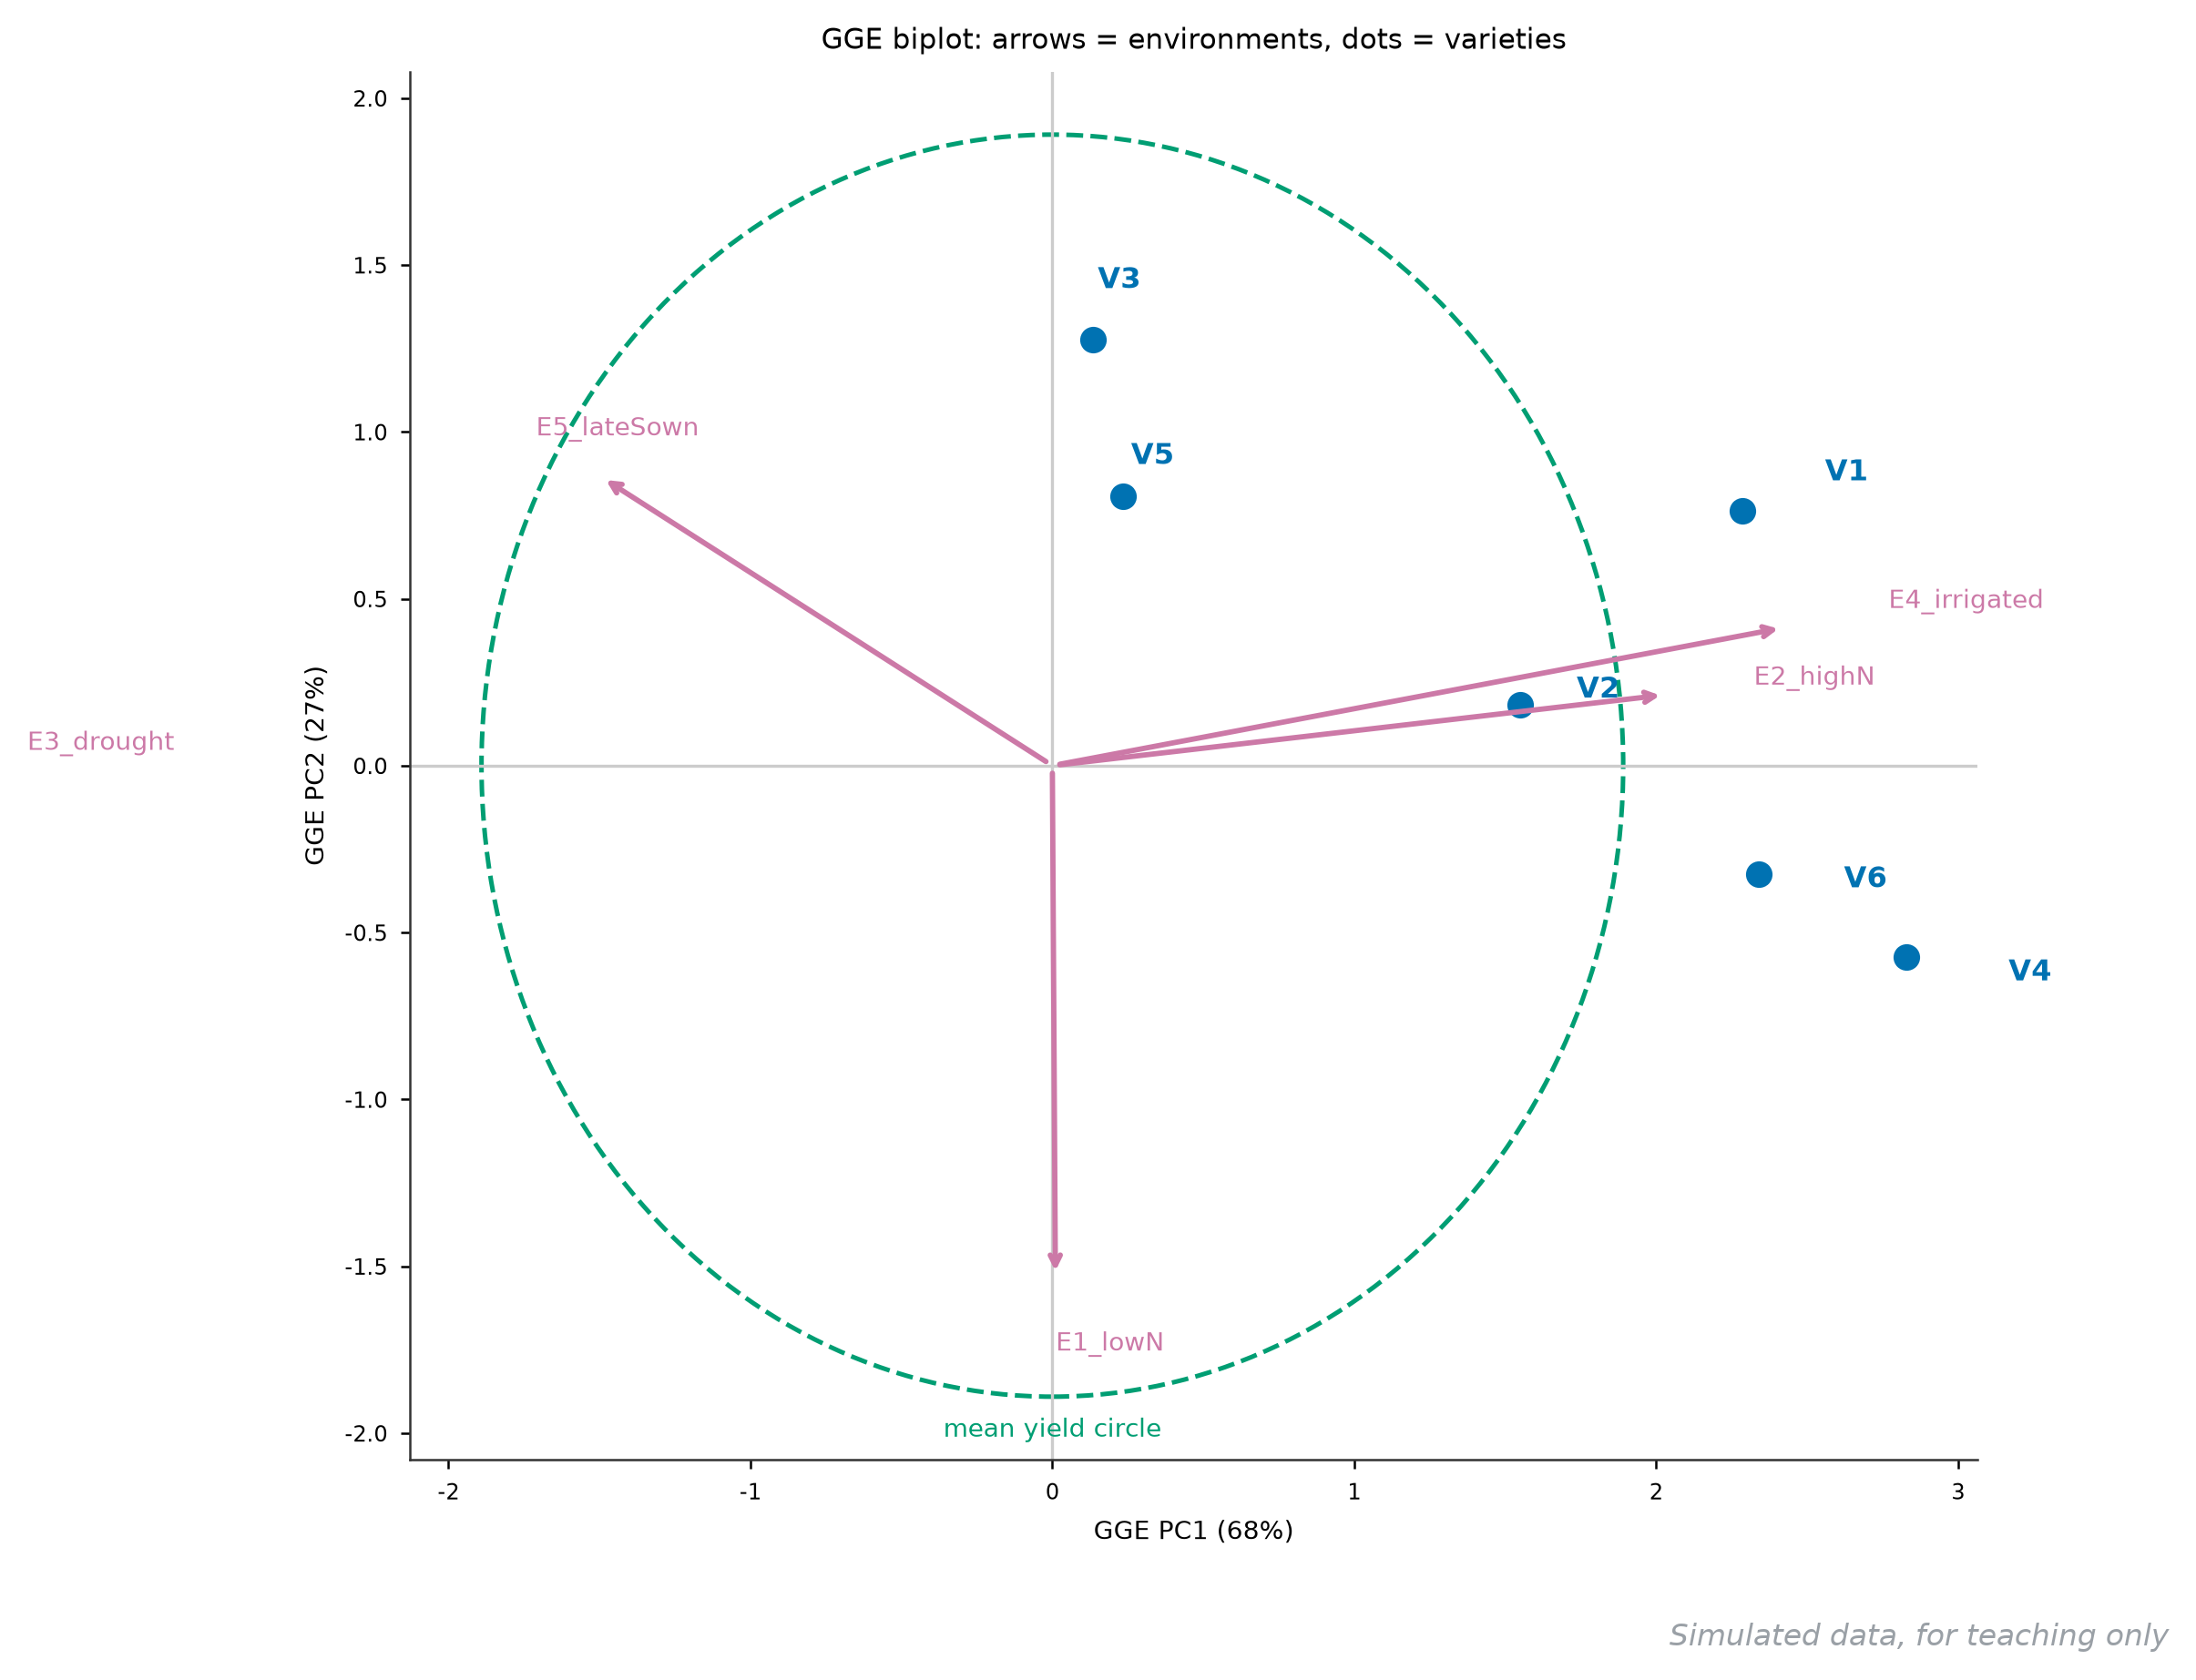
它回答什么问题:品种多点试验里,哪个品种在哪个环境表现好、产量差异主要由基因型还是环境驱动——品种区域试验的官方答案图,比两两比较的表格强一个量级。
怎么读:先把品种-环境产量矩阵做 GGE 分解(G 加 E 双重中心化后做 SVD),品种是点、环境是箭头。读四句口诀:箭头长=该环境区分力强;品种点在箭头同方向且离原点远=在该环境高产(V4、V6 在灌溉环境);绿色虚线只是各品种到原点平均距离的参考圈,点离原点越远说明基因型与环境互作越大(V4、V6 产量潜力最高但怕干旱,V3、V5 在晚播与干旱方向占优);箭头夹角小说明两个环境对品种的排序一致(E2 与 E4 几乎同向——高氮和灌溉优选同一批品种)。
用什么画:R 语言 metan::gge() 一行出标准双标图;本图对中心化矩阵做 SVD 后手绘品种点与环境向量。
图注示例:
图 72 六个品种在五个环境的 GGE 双标图(模拟)。红色箭头为环境向量,蓝点为品种,绿色虚线为平均产量圈;V6 平均产量最高,V4 在高氮与灌溉环境领先,V5 产量中等但在干旱环境下最稳产,E2 与 E4 环境向量方向几乎一致。
展开查看:产量矩阵与绘图代码
environment,V1,V2,V3,V4,V5,V6
E1_lowN,3.1,4.4,2.8,4.9,3.6,5.1
E2_highN,4.9,5.2,4.1,5.6,4.4,5.8
E3_drought,2.2,3.6,3.9,2.6,4.1,3.3
E4_irrigated,5.0,5.5,4.3,5.8,4.6,6.0
E5_lateSown,3.4,4.1,4.4,3.2,4.6,3.9
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("72-gge.csv", index_col="environment")
M = df.values - df.values.mean(axis=0)          # 环境中心化(GGE 的 G+E)
U, S, Vt = np.linalg.svd(M, full_matrices=False)
env = U[:, :2] * S[:2]
var = Vt.T[:, :2] * S[:2]
fig, ax = plt.subplots(figsize=(7.4, 6.6))
for i, v in enumerate(df.columns):
    ax.scatter(var[i, 0], var[i, 1], s=64, color="#4C72B0",
               edgecolors="white", zorder=3)
    ax.text(var[i, 0] * 1.12, var[i, 1] * 1.12, v, fontsize=10,
            color="#4C72B0", fontweight="bold")
for j, e in enumerate(df.index):
    ax.annotate("", xy=(env[j, 0], env[j, 1]), xytext=(0, 0),
                arrowprops=dict(arrowstyle="->", color="#C44E52", lw=1.4))
    ax.text(env[j, 0] * 1.14, env[j, 1] * 1.14, e, fontsize=8.5, color="#C44E52")
r = np.hypot(var[:, 0], var[:, 1]).mean()
ax.add_patch(plt.Circle((0, 0), r, fill=False, color="#55A868",
                        ls="--", lw=1.2))
ax.text(0, -r - 0.12, "mean yield circle", ha="center", fontsize=8.5,
        color="#55A868")
ax.axhline(0, color="0.8", lw=0.8)
ax.axvline(0, color="0.8", lw=0.8)
ax.set_xlabel("GGE PC1 (68%)")
ax.set_ylabel("GGE PC2 (27%)")
ax.set_title("GGE biplot: arrows = environments, dots = varieties")
fig.savefig("72-gge.png", dpi=200, bbox_inches="tight")
十一、蛋白结构补充
11.1 Ramachandran 拉氏图
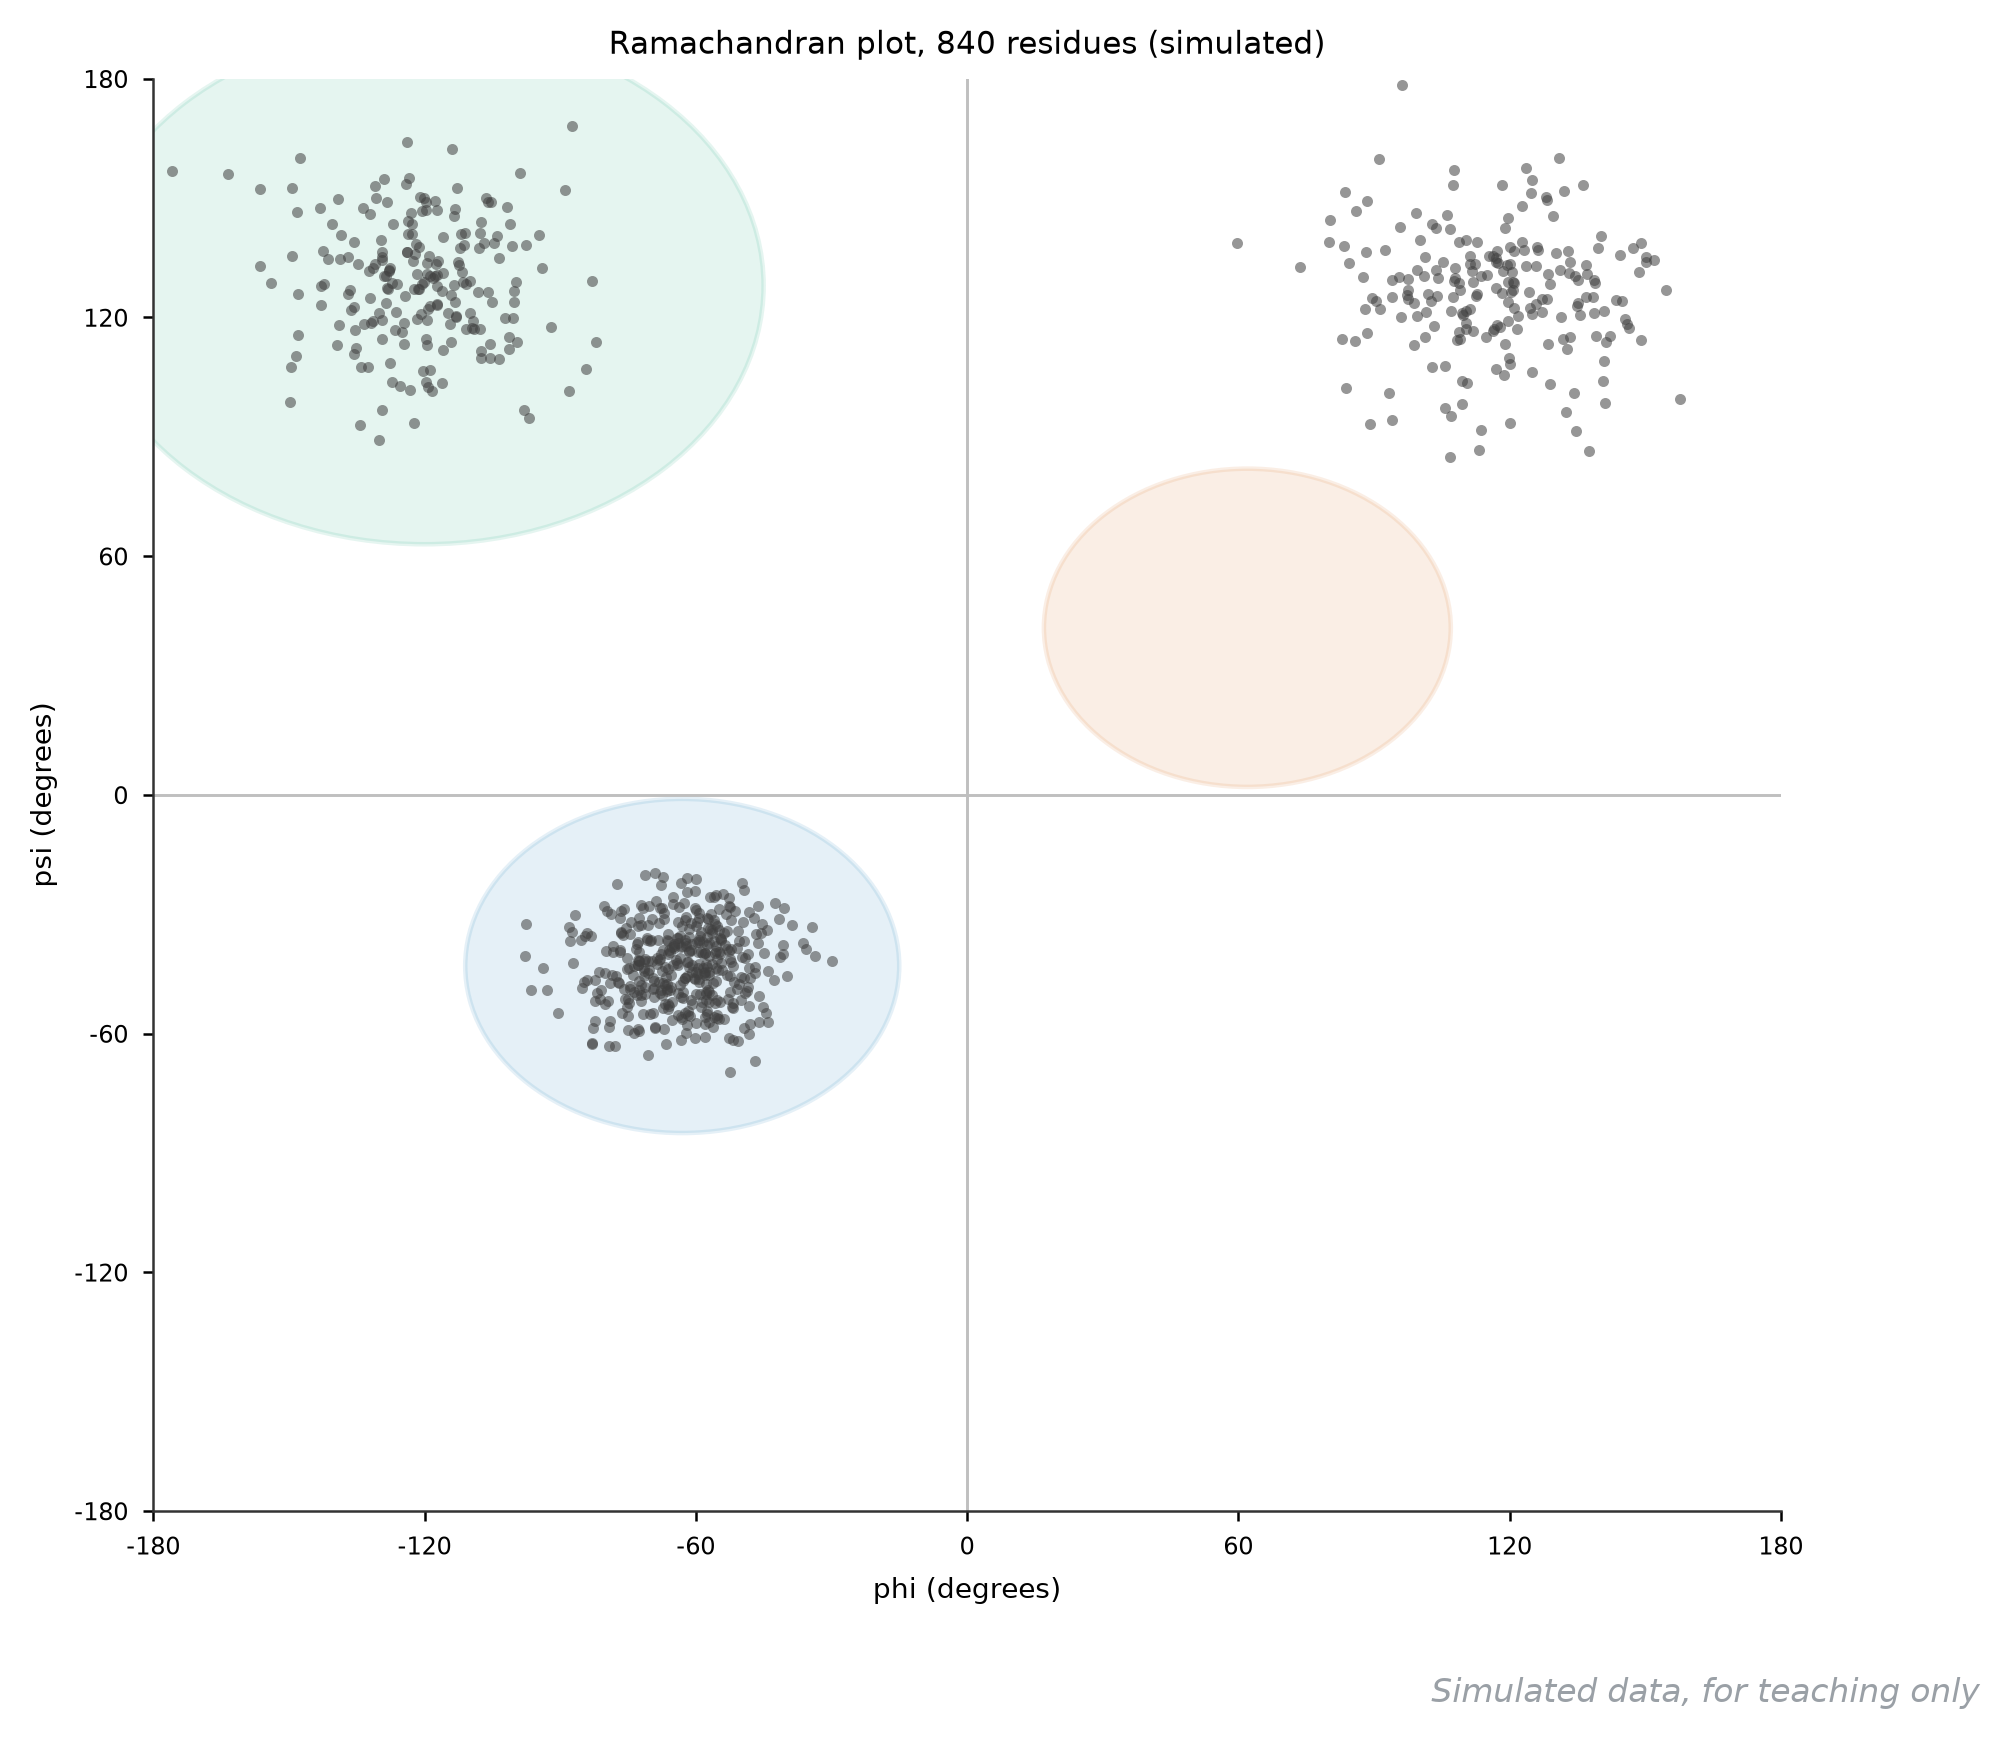
它回答什么问题:结构模型里每个残基的二面角(phi/psi)落不落在物理上允许的区域——AlphaFold 模型投喂分子动力学前的质检,也是验证实验结构质量的经典手段。
怎么读:横轴 phi、纵轴 psi,每个点一个残基。三个允许区要认识:左上大片绿色是 beta 折叠区(本图残基最多)、左下蓝色是 alpha 螺旋区、右上橙色小岛是左手 alpha 螺旋(稀有,出现多了要警惕)。落在三个椭圆之外的残基叫 outlier,拉氏图评估软件会报百分比——优质结构 outlier 应小于 0.05%,超过 2% 先检查要不要重折叠再谈下游模拟。
用什么画:PyMOL 或 MolProbity 的 rama 输出;教学重绘用 matplotlib 散点加三个允许区椭圆。
图注示例:
图 73 模拟蛋白模型的 Ramachandran 图(840 个残基)。绿色为 beta 区、蓝色为 alpha 区、橙色为左手 alpha 区;绝大多数残基落在三个允许区内,真实模型的 outlier 比例应远低于 2%。
展开查看:完整绘图代码(含数据生成)
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

rng = np.random.default_rng(99)
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52"]
n = 420
phi_a, psi_a = rng.normal(-63, 11, n), rng.normal(-43, 10, n)
phi_b = np.where(rng.uniform(0, 1, n) > 0.5, rng.normal(-120, 16, n),
                 rng.normal(115, 18, n))
psi_b = rng.normal(128, 16, n)
phi = np.r_[phi_a, phi_b]
psi = np.r_[psi_a, psi_b]
fig, ax = plt.subplots(figsize=(7.0, 6.2))
for (cx, cy), w, h, col in [((-63, -43), 96, 84, CAT[0]),
                            ((-120, 128), 150, 130, CAT[2]),
                            ((62, 42), 90, 80, CAT[1])]:
    ax.add_patch(Ellipse((cx, cy), w, h, facecolor=col, alpha=0.10,
                         edgecolor=col, lw=1.1))
ax.scatter(phi, psi, s=7, color="0.25", alpha=0.55, linewidths=0)
ax.set_xlim(-180, 180)
ax.set_ylim(-180, 180)
ax.set_xticks(range(-180, 181, 60))
ax.set_yticks(range(-180, 181, 60))
ax.axhline(0, color="0.75", lw=0.7)
ax.axvline(0, color="0.75", lw=0.7)
ax.set_xlabel("phi (degrees)")
ax.set_ylabel("psi (degrees)")
ax.set_title("Ramachandran plot, %d residues (simulated)" % len(phi))
fig.savefig("73-ramachandran.png", dpi=200, bbox_inches="tight")
11.2 分子动力学 RMSD 曲线
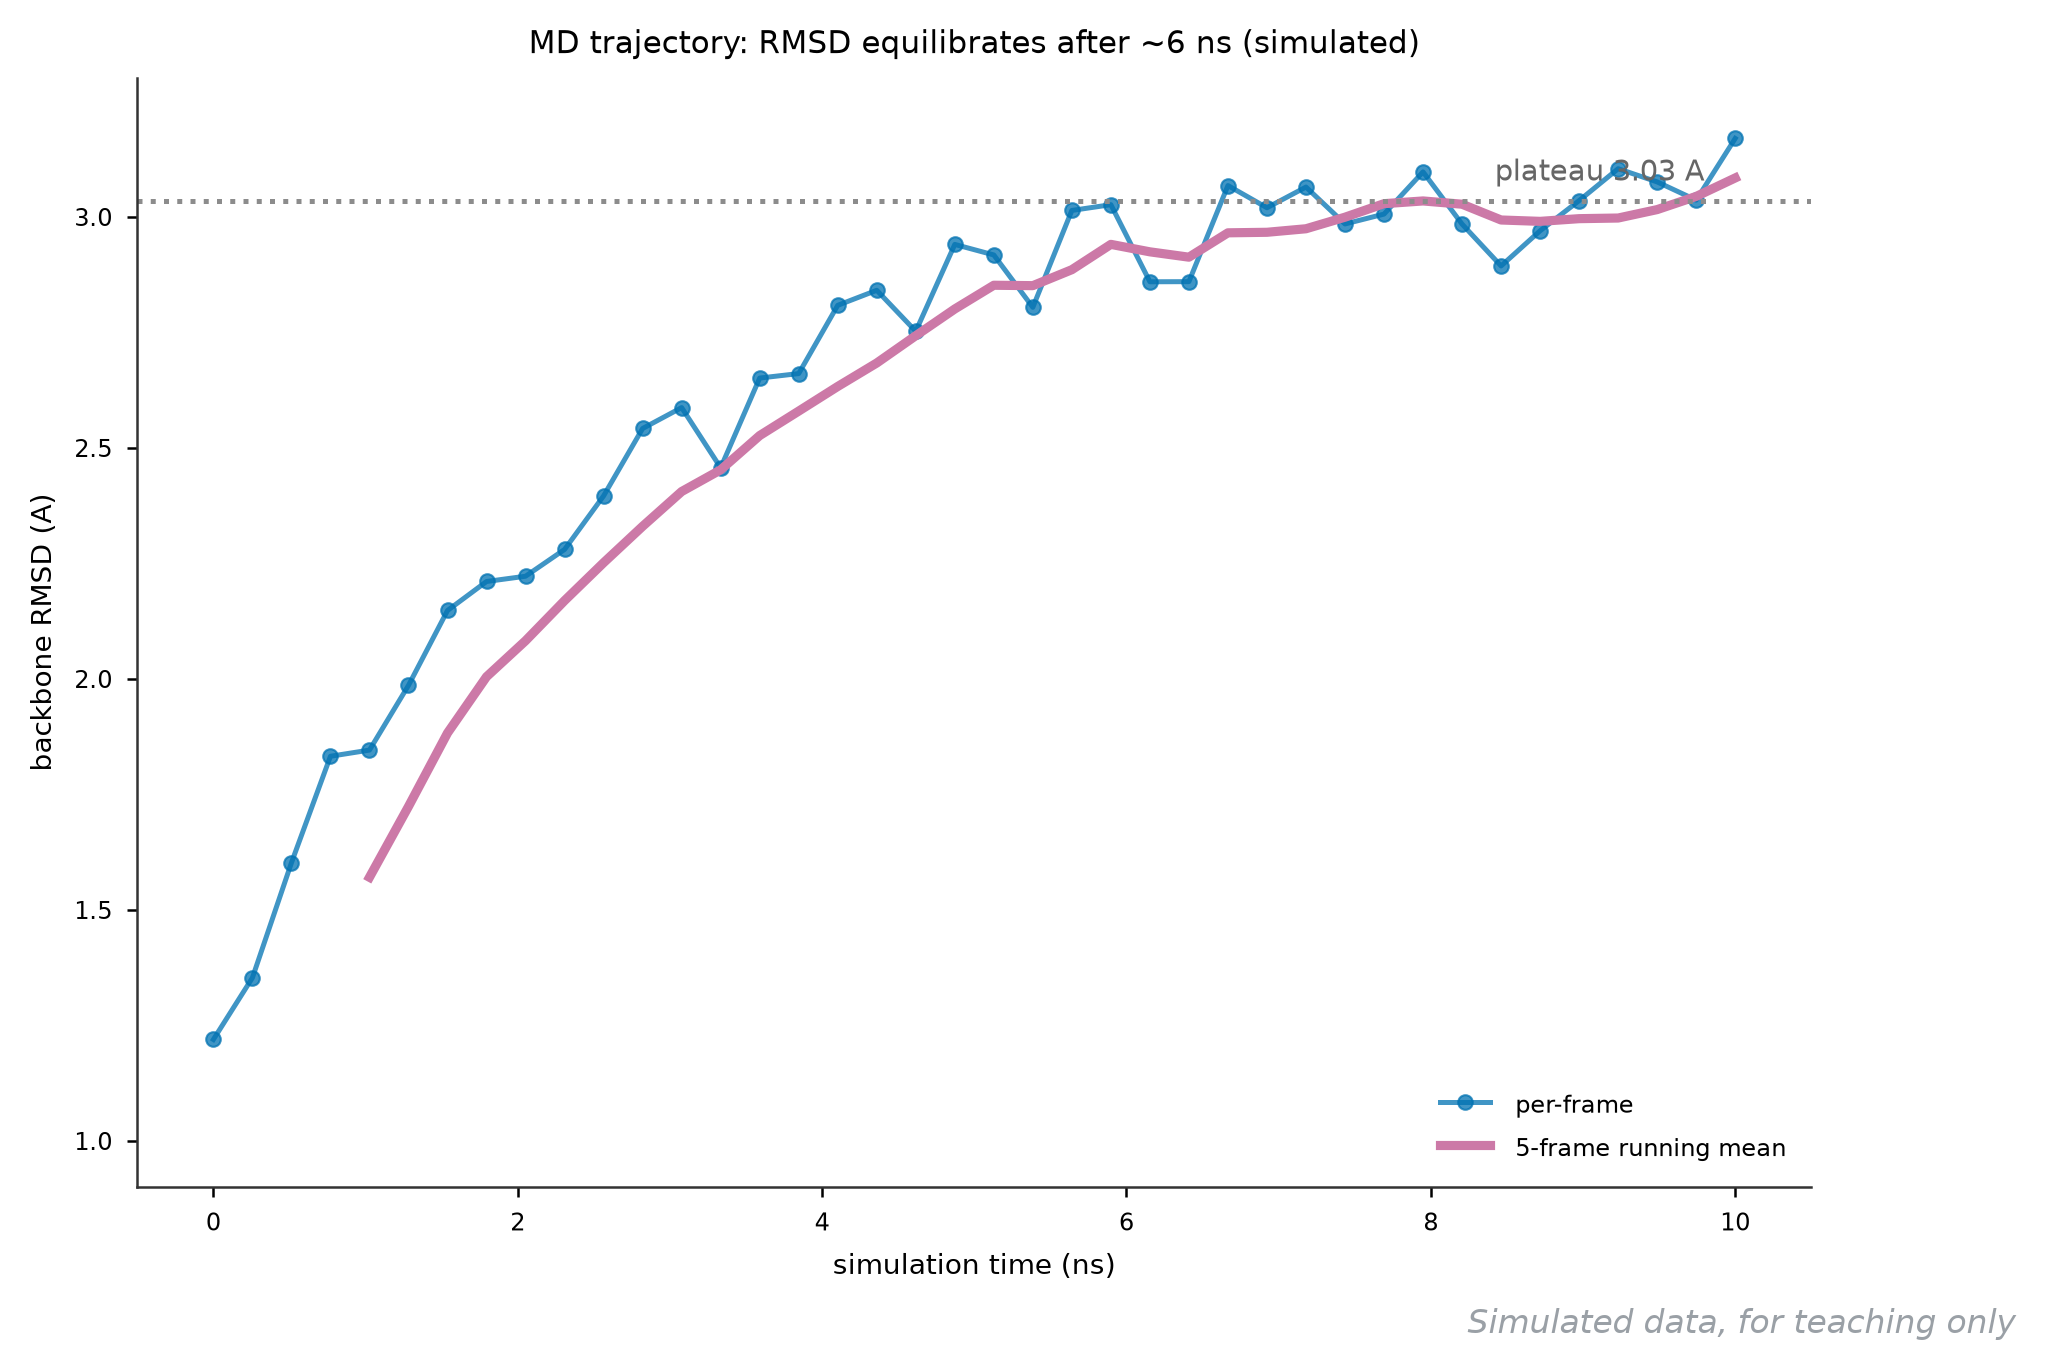
它回答什么问题:分子动力学模拟跑平衡了没有——RMSD(骨架相对初始结构的偏差)随时间收敛,是 MD 轨迹分析的第一张图,不做这张就往下分析能量或构象等于地基没打。
怎么读:横轴模拟时间,纵轴骨架 RMSD(埃)。健康轨迹是「快速爬升后进入平台小幅抖动」:本图前 6 ns 从 1.2 埃升到 3 埃附近,之后在 3.0 埃上下窄幅波动,红点线为滑动平均,说明体系已平衡;统计性质(能量、氢键、RMSF)都应只在平台段计算。如果 RMSD 持续线性上爬不收敛,多半是体系没压好、参数错或者蛋白在解折叠,先回去查再谈分析。
用什么画:GROMACS 的 gmx rms 输出 xvg,VMD 或 seaborn 画线加滑动平均。
图注示例:
图 74 蛋白骨架 RMSD 随模拟时间变化(10 ns,模拟)。粗线为 5 帧滑动平均;体系约 6 ns 后进入平台期(约 3.0 埃),后续统计仅取平衡段。
展开查看:数据与绘图代码
time_ns,rmsd_A
0.00,1.22
0.26,1.35
0.51,1.60
0.77,1.83
1.03,1.85
1.28,1.99
1.54,2.15
1.79,2.21
2.05,2.22
2.31,2.28
2.56,2.40
2.82,2.54
3.08,2.59
3.33,2.46
3.59,2.65
3.85,2.66
4.10,2.81
4.36,2.84
4.62,2.75
4.87,2.94
5.13,2.92
5.38,2.80
5.64,3.01
5.90,3.03
6.15,2.86
6.41,2.86
6.67,3.07
6.92,3.02
7.18,3.06
7.44,2.98
7.69,3.01
7.95,3.10
8.21,2.98
8.46,2.89
8.72,2.97
8.97,3.03
9.23,3.10
9.49,3.08
9.74,3.04
10.00,3.17
绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("74-rmsd.csv")
win = np.convolve(df.rmsd_A, np.ones(5) / 5, mode="valid")
fig, ax = plt.subplots(figsize=(7.2, 4.8))
ax.plot(df.time_ns, df.rmsd_A, "-o", ms=3.5, color="#4C72B0",
        alpha=0.75, label="per-frame")
ax.plot(df.time_ns[4:], win, color="#C44E52", lw=2.2, label="5-frame running mean")
m = df.rmsd_A[-8:].mean()
ax.axhline(m, color="0.55", ls=":", lw=1.2)
ax.text(9.8, m + 0.045, "plateau %.2f A" % m, fontsize=9, color="0.4",
        ha="right")
ax.set_xlabel("simulation time (ns)")
ax.set_ylabel("backbone RMSD (A)")
ax.set_ylim(0.9, 3.3)
ax.legend(loc="lower right")
ax.set_title("MD trajectory: RMSD equilibrates after ~6 ns (simulated)")
fig.savefig("74-rmsd.png", dpi=200, bbox_inches="tight")
十二、写到第二篇为止
上下两篇加起来 74 张图,覆盖了从统计图表到结构模拟的主要出图场景。回头看会发现一个朴素的规律:图没有新不新,只有回答的问题准不准。曼哈顿图再花哨,回答的仍是「哪里关联最强」;混淆矩阵再朴素,它是模型改进唯一的路标。写作时先写下这张图要回答的那句话,再决定用什么图,顺序反了就会画出漂亮但没用的图。
本篇全部图与数据的生成脚本在仓库 tools/bio-plots/ch9a_more.py、ch9b_more.py、ch9c_more.py,模拟数据的随机种子固定,跑出来的图与文中的每一根线条一致。系列没有断在这里:第三篇接着收测序 QC、GWAS 精细定位、Hi-C 与空间组学,第四篇收蛋白、生态与 AI 多组学的新图,四篇合计 133 张。
参考文献
- Purcell S, et al. PLINK: a tool set for whole-genome association and population-based linkage analyses. American Journal of Human Genetics, 2007.
- Alexander DH, Novembre J, Lange K. Fast model-based estimation of ancestry in unrelated individuals (ADMIXTURE). Genome Research, 2009.
- Weir BS, Cockerham CC. Estimating F-statistics for the analysis of population structure. Evolution, 1984.
- Tajima F. Statistical method for testing the neutral mutation hypothesis by DNA polymorphism. Genetics, 1989.
- Krzywinski M, et al. Circos: an information aesthetic for comparative genomics. Genome Research, 2009.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics, 2008.
- Yang Z. PAML 4: phylogenetic analysis by maximum likelihood. Molecular Biology and Evolution, 2007.
- Tamura K, et al. MEGA11: molecular evolutionary genetics analysis version 11. Molecular Biology and Evolution, 2021.
参考代码
- 本文 33 张图的绘图脚本:仓库
tools/bio-plots/ch9a_more.py、ch9b_more.py、ch9c_more.py,逐图独立、随机种子固定; - Linxira Bio SDK(GitHub)· 官网:
variant stats、sequence stats、interval intersect等能力即本篇群体遗传图的直接上游; - 工具链架构细节见拆解文:拆 Bio SDK:一个”不生成脚本”的本地生信工具链是怎么搭的。
原文存档:本文初版发布于旧站(Butterfly 主题)。如遇图表、代码高亮或 3D 交互显示异常,请查阅 完整存档版。