读文献时最怕的不是方法看不懂,而是图看不懂。火山图为什么长两个翅膀,GSEA 那座小山包是什么,KM 曲线上的小加号又是谁——每张图都在用坐标轴和颜色讲一个统计故事,讲不通就会被审稿人抓住。
这篇把我做转录组、蛋白结构和湿实验验证时反复打交道的 41 种图 一次收齐:每种图固定四段——它回答什么问题、怎么读(横轴纵轴阈值参数)、用什么语言什么包画、图注怎么写。所有配图都是我用 WSL 里的 Python 3.14 + matplotlib 3.11 现场渲染的模拟数据,完整脚本放在仓库 tools/bio-plots/ 目录,每张图右下角都盖了 “Simulated data” 水印,别拿去冒充真实结果。
每张图下面有一个默认折叠的「展开查看」块:里面放的是画这张图的 那一组模拟数据的原样 CSV 和 可直接运行的完整绘图代码(Python,逐图独立,不依赖仓库环境),点开复制就能复现。管线思路见之前的群体重测序学习地图,那篇讲流程,这篇讲流程里每一步产出的图。
本系列已出七篇:第一篇(41 张,统计与转录组临床) · 第二篇(33 张,群体遗传与基因组) · 第三篇(29 张,测序、表观与空间组学) · 第四篇(30 张,蛋白、生态与 AI 多组学) · 第五篇(40 张,蛋白结构、变异与表达验证,含真实 PDB 结构与交互 3D) · 第六篇(22 张,真实公开数据实战) · 第七篇(190 张图 Nature 风格重构与方法选型)。
自推一句:画图的上游——表达矩阵 QC、归一化、差异分析——在我主导开发的 Linxira Bio SDK(本地优先的生信执行工具链)里有对应能力:正式分支已发布 v1.0.1,提供 expression matrix QC、FASTQ/比对质检、变异统计等 CLI 与 35 个 agent skills,另有官网与我的拆解文。免责声明:本文所有配图均为模拟数据的教学演示;SDK 实际可用的分析能力,请以仓库正式分支的最新 release 为准——文中部分图对应的分析尚在开发路线中,目前仅存在于本地开发分支,未合并进正式分支、代码未公开。
一、图表地图:先看森林,再看树
{% mermaid %} flowchart LR START([“第一篇 · 41 张”]):::hub subgraph A[“① 差异表达”] direction TB A1[“火山 · 热图 · 韦恩 · UpSet”] end subgraph B[“② 降维聚类”] direction TB B1[“PCA · UMAP · 聚类树”] end subgraph C[“③ 富集分析”] direction TB C1[“KEGG 气泡 · GO 弦图 · GSEA”] end subgraph D[“④ 建模评估”] direction TB D1[“ROC · 生存 · DCA · 森林”] end subgraph E[“⑤ 湿实验验证”] direction TB E1[“qPCR · 凝胶 · 流式 · IHC/IF”] end subgraph F[“⑥ 结构与专题”] direction TB F1[“pLDDT · 顺式元件 · 桑基 · 脊线”] end START —> A —> B —> C —> D —> E —> F classDef hub fill:#1f4e79,color:#fff,font-weight:bold {% endmermaid %}
按分析阶段分四张速查表,先混个脸熟,后面每张图都有专门小节。
表 1 差异表达与数据全景
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| 火山图 | 哪些基因变化大且可信 | log2FC | -log10(padj) | EnhancedVolcano |
| 热图 | 基因×样本表达全景 | 样本 | 基因,颜色=z-score | pheatmap |
| 相关性热图 | 谁和谁同步表达 | 基因 | 基因,颜色=r | corrplot |
| Pearson 散点 | 两变量线性相关 | 变量 x | 变量 y | R pairs |
| Spearman 对比 | 非线性或离群点下的相关 | 变量 x | 变量 y | scipy.stats |
| 箱线图 | 组间分布与中位数 | 分组 | 数值 | boxplot |
| 小提琴图 | 组间分布形状 | 分组 | 数值,宽=密度 | vioplot |
| 韦恩图 | 几组基因名单交并集 | 无 | 集合成员 | TBtools |
| 物种间韦恩图 | 直系同源基因规模 | 无 | 集合成员 | OrthoVenn |
| UpSet 图 | 4 组以上交集谁最大 | 交集 | 交集大小 | UpSetR |
| TPM 分布 | 文库标准化后量级 | 文库 | TPM | ggplot2 |
表 2 降维、富集与建模
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| PCA | 样本按什么分开 | PC1+方差占比 | PC2+方差占比 | FactoMineR |
| UMAP | 单细胞/高维邻域结构 | UMAP1 | UMAP2 | scanpy |
| 聚类树+热图 | 基因如何成簇 | 样本 | 基因+树高 | pheatmap |
| KEGG 气泡图 | 通路富集强度与基因数 | 富集因子 | -log10(padj),点大小=count | clusterProfiler |
| KEGG 柱形图 | 通路基因数排行 | 基因数 | 通路 | clusterProfiler |
| GO 弦图 | 基因与功能的连接关系 | 弧段 | 带宽=关联数 | GOplot |
| GSEA | 预设基因集整体是否偏移 | 排名 | running ES | clusterProfiler |
| ROC | 模型区分能力 | 假阳性率 | 真阳性率 | pROC |
| 生存曲线 | 两组随时间生存差异 | 时间 | 生存概率 | survival+survminer |
| DCA | 模型有没有临床净收益 | 阈值概率 | 净收益 | dcurves |
| 森林图 | 多研究效应量合并 | OR(log 轴) | 研究 | metaforest |
表 3 湿实验与结构专题
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| qRT-PCR 柱状图 | 转录水平验证 | 基因 | 2^-ΔΔCt | GraphPad |
| 扩增曲线 | 扩增何时越过阈值 | 循环数 | 荧光 Rn | QuantStudio |
| 熔解曲线+导数峰 | 扩增产物是否单一 | 温度 | -dF/dT | QuantStudio |
| 扩增子 CDS 锚定图 | 引物钉在哪里 | CDS 位置 | 示意 | SnapGene |
| WB 与 Co-IP | 蛋白量与蛋白互作 | 泳道 | 分子量 | ImageJ |
| 免疫组化 | 蛋白在组织原位分布 | 无 | 视野 | CaseViewer |
| 免疫荧光 | 亚细胞定位与共定位 | 无 | 通道 | Fiji |
| TUNEL | 凋亡核比例 | 无 | 视野 | Fiji |
| 流式-细胞周期 | G1/S/G2 分布 | DNA 含量 | 细胞数 | FlowJo |
| 流式-表型门控 | 亚群比例 | 标志物 A | 标志物 B | FlowJo |
| 流式-凋亡 | 活细胞/早凋/晚凋/坏死 | Annexin V | PI | FlowJo |
| 桑基图 | reads 或类群去向 | 阶段 | 流量 | SankeyMATIC |
| pLDDT 锚点图 | 结构可信度+关键残基 | 残基号 | pLDDT | PyMOL+AF |
| 证据矩阵 | 每个基因的证据链 | 证据类型 | 基因 | 手绘 |
| 组织表达图 | 哪个器官表达多 | 组织 | TPM | ggplot2 |
| 顺式元件扫描 | 启动子 2kb 有什么开关 | 距 TSS 位置 | 链方向 | PlantCARE |
| 通路表达动态 | 发育过程中何时达峰 | 发育时期 | TPM | ggplot2 |
| 级联表达热图 | 表达波沿基因传递 | 时间点 | 基因,颜色=z | pheatmap |
| 脊线图 | 各簇分布形状对比 | 表达量 | 簇,高度=密度 | ggridges |
二、差异表达与数据全景
2.1 火山图(volcano plot)
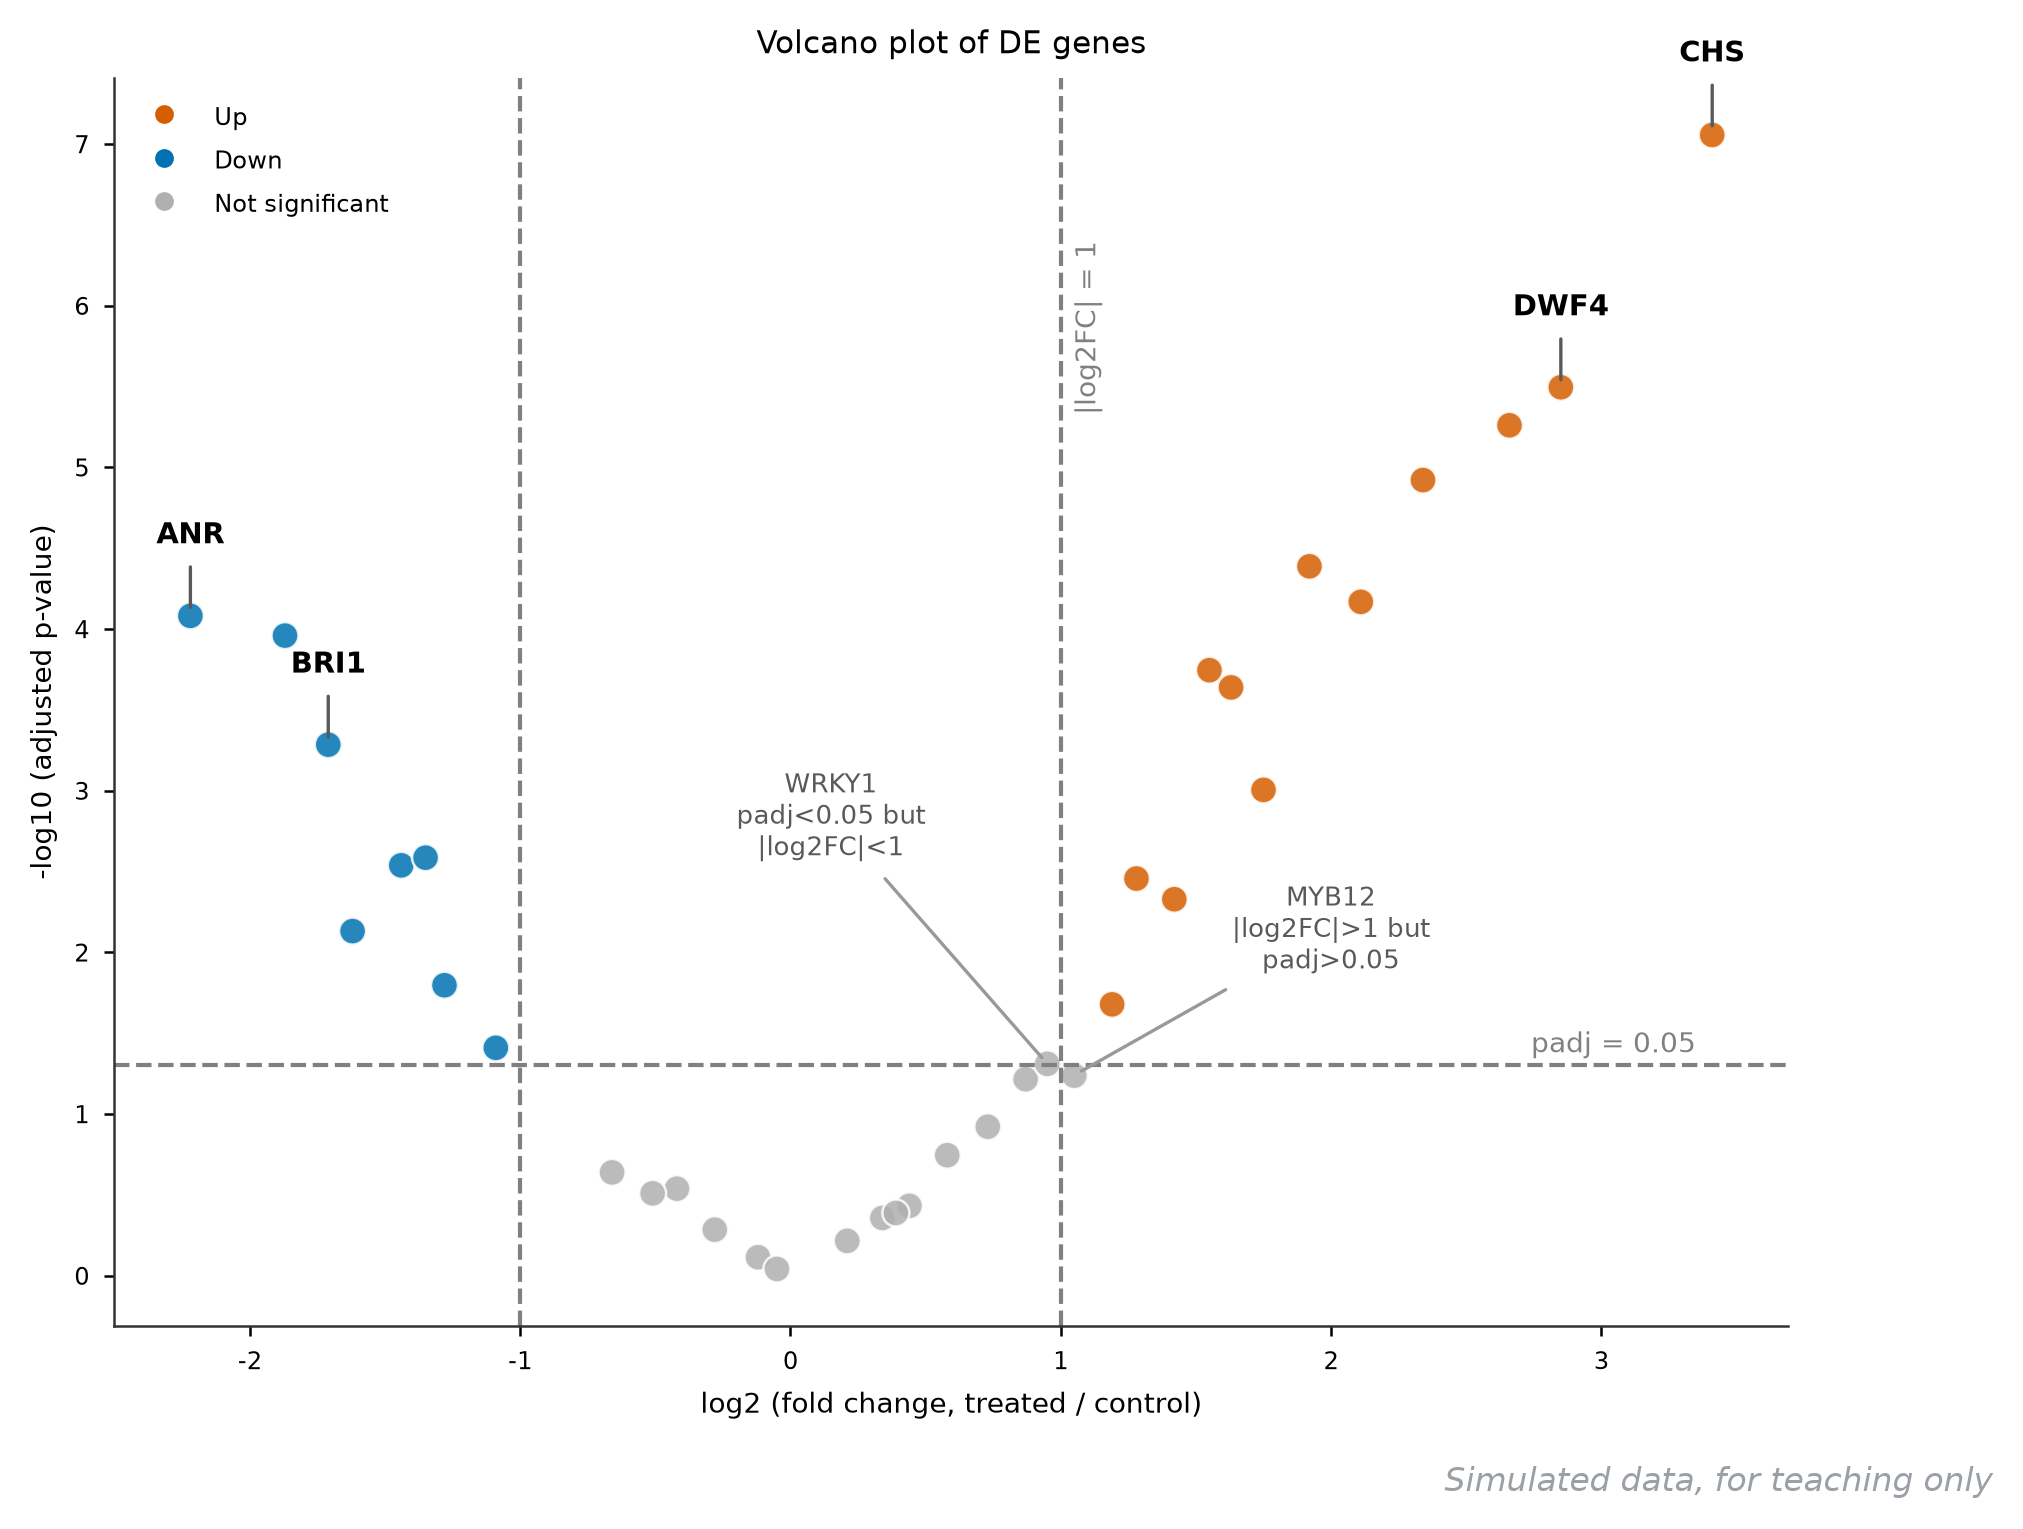
它回答什么问题:处理后哪些基因「变化够大且统计上可信」,是转录组文章的身份证。
怎么读:横轴 log2 倍数变化,右正左负;纵轴 -log10(padj),越靠上越显著。两条竖线(log2FC 绝对值 = 1)和一条横线(padj = 0.05)把画面切成三块:右上红点显著上调,左上蓝点显著下调,下方灰点不显著。真正值得学的是两个踩线基因:WRKY1 过了显著性线但倍数不足 2 倍,MYB12 倍数够但 padj 差一口气,双阈值缺一不可。
用什么画:R 语言 EnhancedVolcano 包一行出图;Python 用 matplotlib 的 scatter 加三条阈值线。DESeq2 自带的 plotMA 是它的近亲。
图注示例:
图 1 处理组与对照组差异表达基因火山图(处理 48 h)。横轴为 log2 倍数变化(处理/对照),纵轴为校正 p 值的负对数;红点为显著上调基因,蓝点为显著下调基因(阈值:log2FC 绝对值 ≥ 1 且 padj < 0.05),灰色为未达阈值基因。图中展示倍数变化最大的 35 个基因。
展开查看:这组模拟数据(CSV,与图中完全一致)
gene,log2FC,padj
DWF4,2.85,3.2e-06
BZR1,1.92,4.1e-05
CHS,3.41,8.8e-08
F3H,2.34,1.2e-05
ANS,2.66,5.5e-06
PAL,1.63,2.3e-04
SAUR32,1.28,3.5e-03
GA20ox,1.75,9.9e-04
EXP8,1.42,4.7e-03
CHI,2.11,6.8e-05
FLS,1.55,1.8e-04
PER12,1.19,2.1e-02
DET2,-1.87,1.1e-04
GA2ox,-1.44,2.9e-03
ANR,-2.22,8.3e-05
F3H5H,-1.62,7.4e-03
LAC4,-1.28,1.6e-02
SUS1,-1.09,3.9e-02
BRI1,-1.71,5.2e-04
XTH22,-1.35,2.6e-03
ACT7,0.21,0.61
EF1a,-0.12,0.77
TUB6,0.34,0.44
UBQ10,-0.05,0.91
RBCS,0.58,0.18
LHCB,-0.42,0.29
NCED3,0.87,0.061
PYL4,-0.66,0.23
ABF2,0.44,0.37
SOD,-0.28,0.52
APX1,0.73,0.12
CAT2,-0.51,0.31
HSP70,0.39,0.41
WRKY1,0.95,0.049
MYB12,1.05,0.058
展开查看:完整绘图代码(Python matplotlib)
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd

df = pd.read_csv("volcano.csv")          # 上面折叠块里的数据
y = -np.log10(df["padj"])
up = (df.log2FC >= 1) & (y > -np.log10(0.05))
dn = (df.log2FC <= -1) & (y > -np.log10(0.05))

fig, ax = plt.subplots(figsize=(7.2, 5.4))
ax.scatter(df.log2FC[up], y[up], c="#C0392B", label="Up", s=42)
ax.scatter(df.log2FC[dn], y[dn], c="#2471A3", label="Down", s=42)
ax.scatter(df.log2FC[~(up | dn)], y[~(up | dn)], c="#B0B0B0",
           label="Not significant", s=42)
for v in (1, -1):
    ax.axvline(v, color="grey", ls="--", lw=1)
ax.axhline(-np.log10(0.05), color="grey", ls="--", lw=1)
ax.set_xlabel("log2 (fold change, treated / control)")
ax.set_ylabel("-log10 (adjusted p-value)")
ax.legend()
fig.savefig("01-volcano.png", dpi=200, bbox_inches="tight")
2.2 表达热图(heatmap)
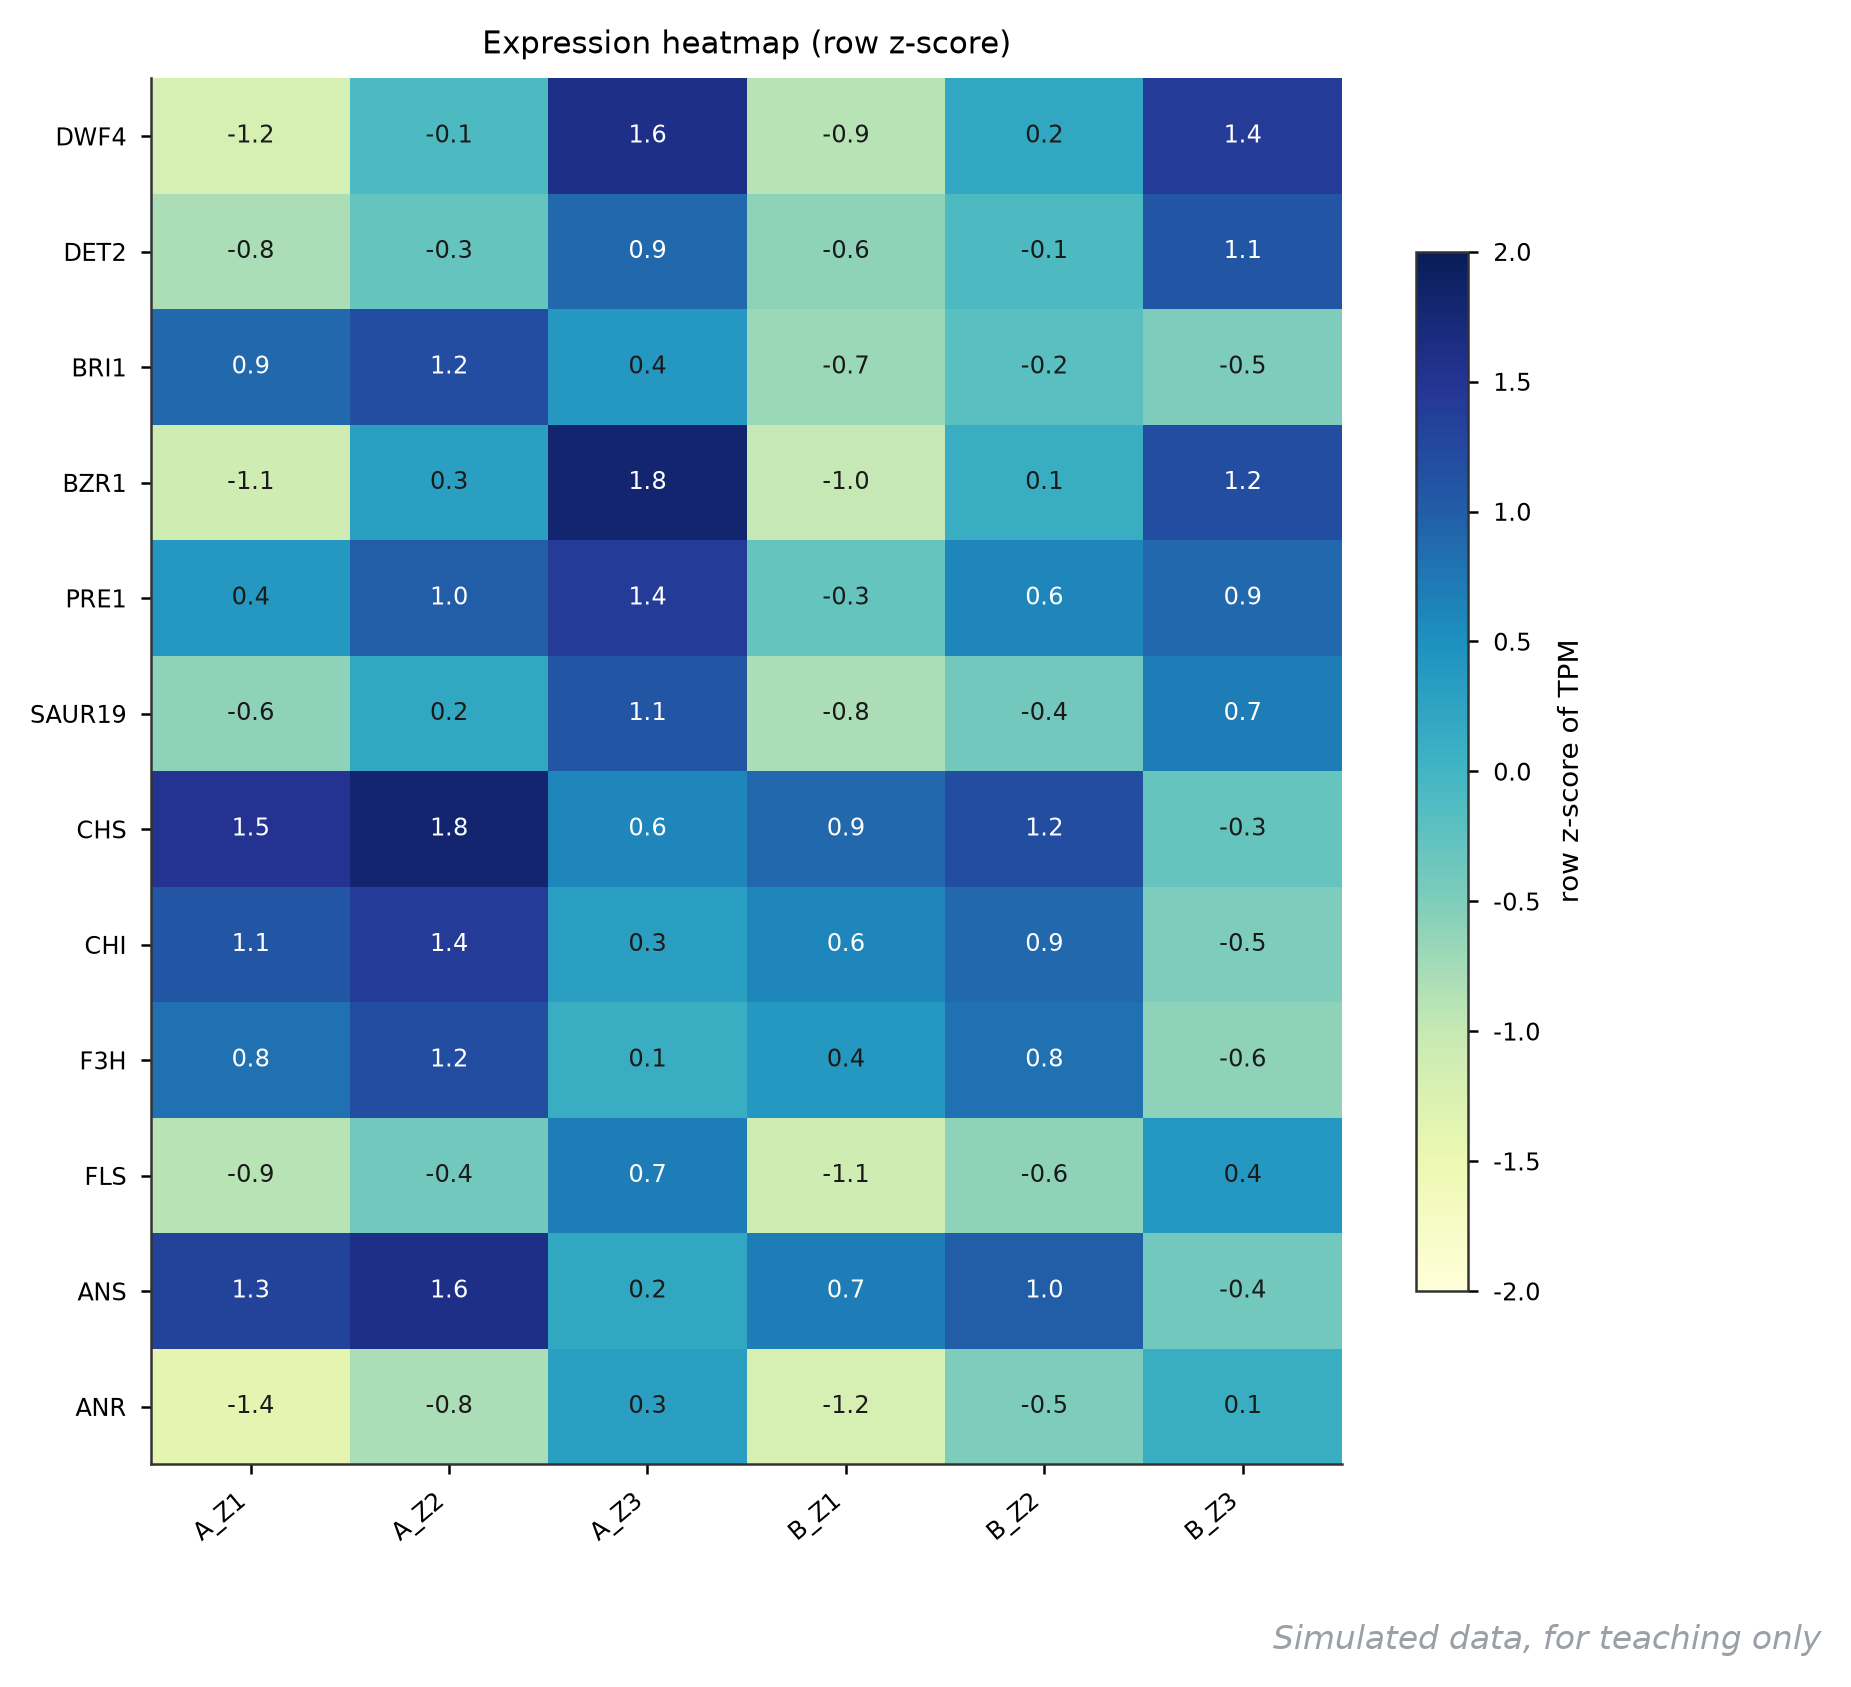
它回答什么问题:几十上百个基因在所有样本里的表达全景,一屏看出「谁跟谁一起涨落」。
怎么读:每列一个样本,每行一个基因,颜色是行内 z-score(该样本相对此基因平均值的偏差,单位是标准差),所以只能比较「相对高低」而不能直接比 TPM 数值。看三件事:整行颜色带是否随阶段渐变、同一基因在 A/B 两个遗传背景间的差异、以及行的聚类 grouping(这里 BR 信号基因与黄酮基因明显分两派)。
用什么画:R 语言 pheatmap 或 ComplexHeatmap(要拼注释条就用后者);Python 用 seaborn.heatmap,一行 z_score=1 完成标准化。
图注示例:
图 2 差异表达基因聚类热图。颜色表示行内 z-score 标准化后的 TPM 值,红色系为高于行均值,蓝色系为低于行均值;A、B 为两个遗传背景,Z1-Z3 为三个种子发育阶段。
展开查看:模拟数据(CSV)
gene,A_Z1,A_Z2,A_Z3,B_Z1,B_Z2,B_Z3
DWF4,-1.2,-0.1,1.6,-0.9,0.2,1.4
DET2,-0.8,-0.3,0.9,-0.6,-0.1,1.1
BRI1,0.9,1.2,0.4,-0.7,-0.2,-0.5
BZR1,-1.1,0.3,1.8,-1.0,0.1,1.2
PRE1,0.4,1.0,1.4,-0.3,0.6,0.9
SAUR19,-0.6,0.2,1.1,-0.8,-0.4,0.7
CHS,1.5,1.8,0.6,0.9,1.2,-0.3
CHI,1.1,1.4,0.3,0.6,0.9,-0.5
F3H,0.8,1.2,0.1,0.4,0.8,-0.6
FLS,-0.9,-0.4,0.7,-1.1,-0.6,0.4
ANS,1.3,1.6,0.2,0.7,1.0,-0.4
ANR,-1.4,-0.8,0.3,-1.2,-0.5,0.1
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 02-heatmap.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("02-heatmap.csv", index_col="gene")
fig, ax = plt.subplots(figsize=(6.4, 6.0))
im = ax.imshow(df.values, cmap="YlGnBu", vmin=-2, vmax=2, aspect="auto")
ax.set_xticks(range(df.shape[1]), df.columns, rotation=40, ha="right")
ax.set_yticks(range(df.shape[0]), df.index)
ax.grid(False)
for i in range(df.shape[0]):
    for j in range(df.shape[1]):
        ax.text(j, i, "%.1f" % df.values[i, j], ha="center", va="center", fontsize=7.5)
fig.colorbar(im, ax=ax, shrink=0.75, label="row z-score of TPM")
fig.savefig("02-heatmap.png", dpi=200, bbox_inches="tight")
2.3 相关性热图(correlation heatmap)
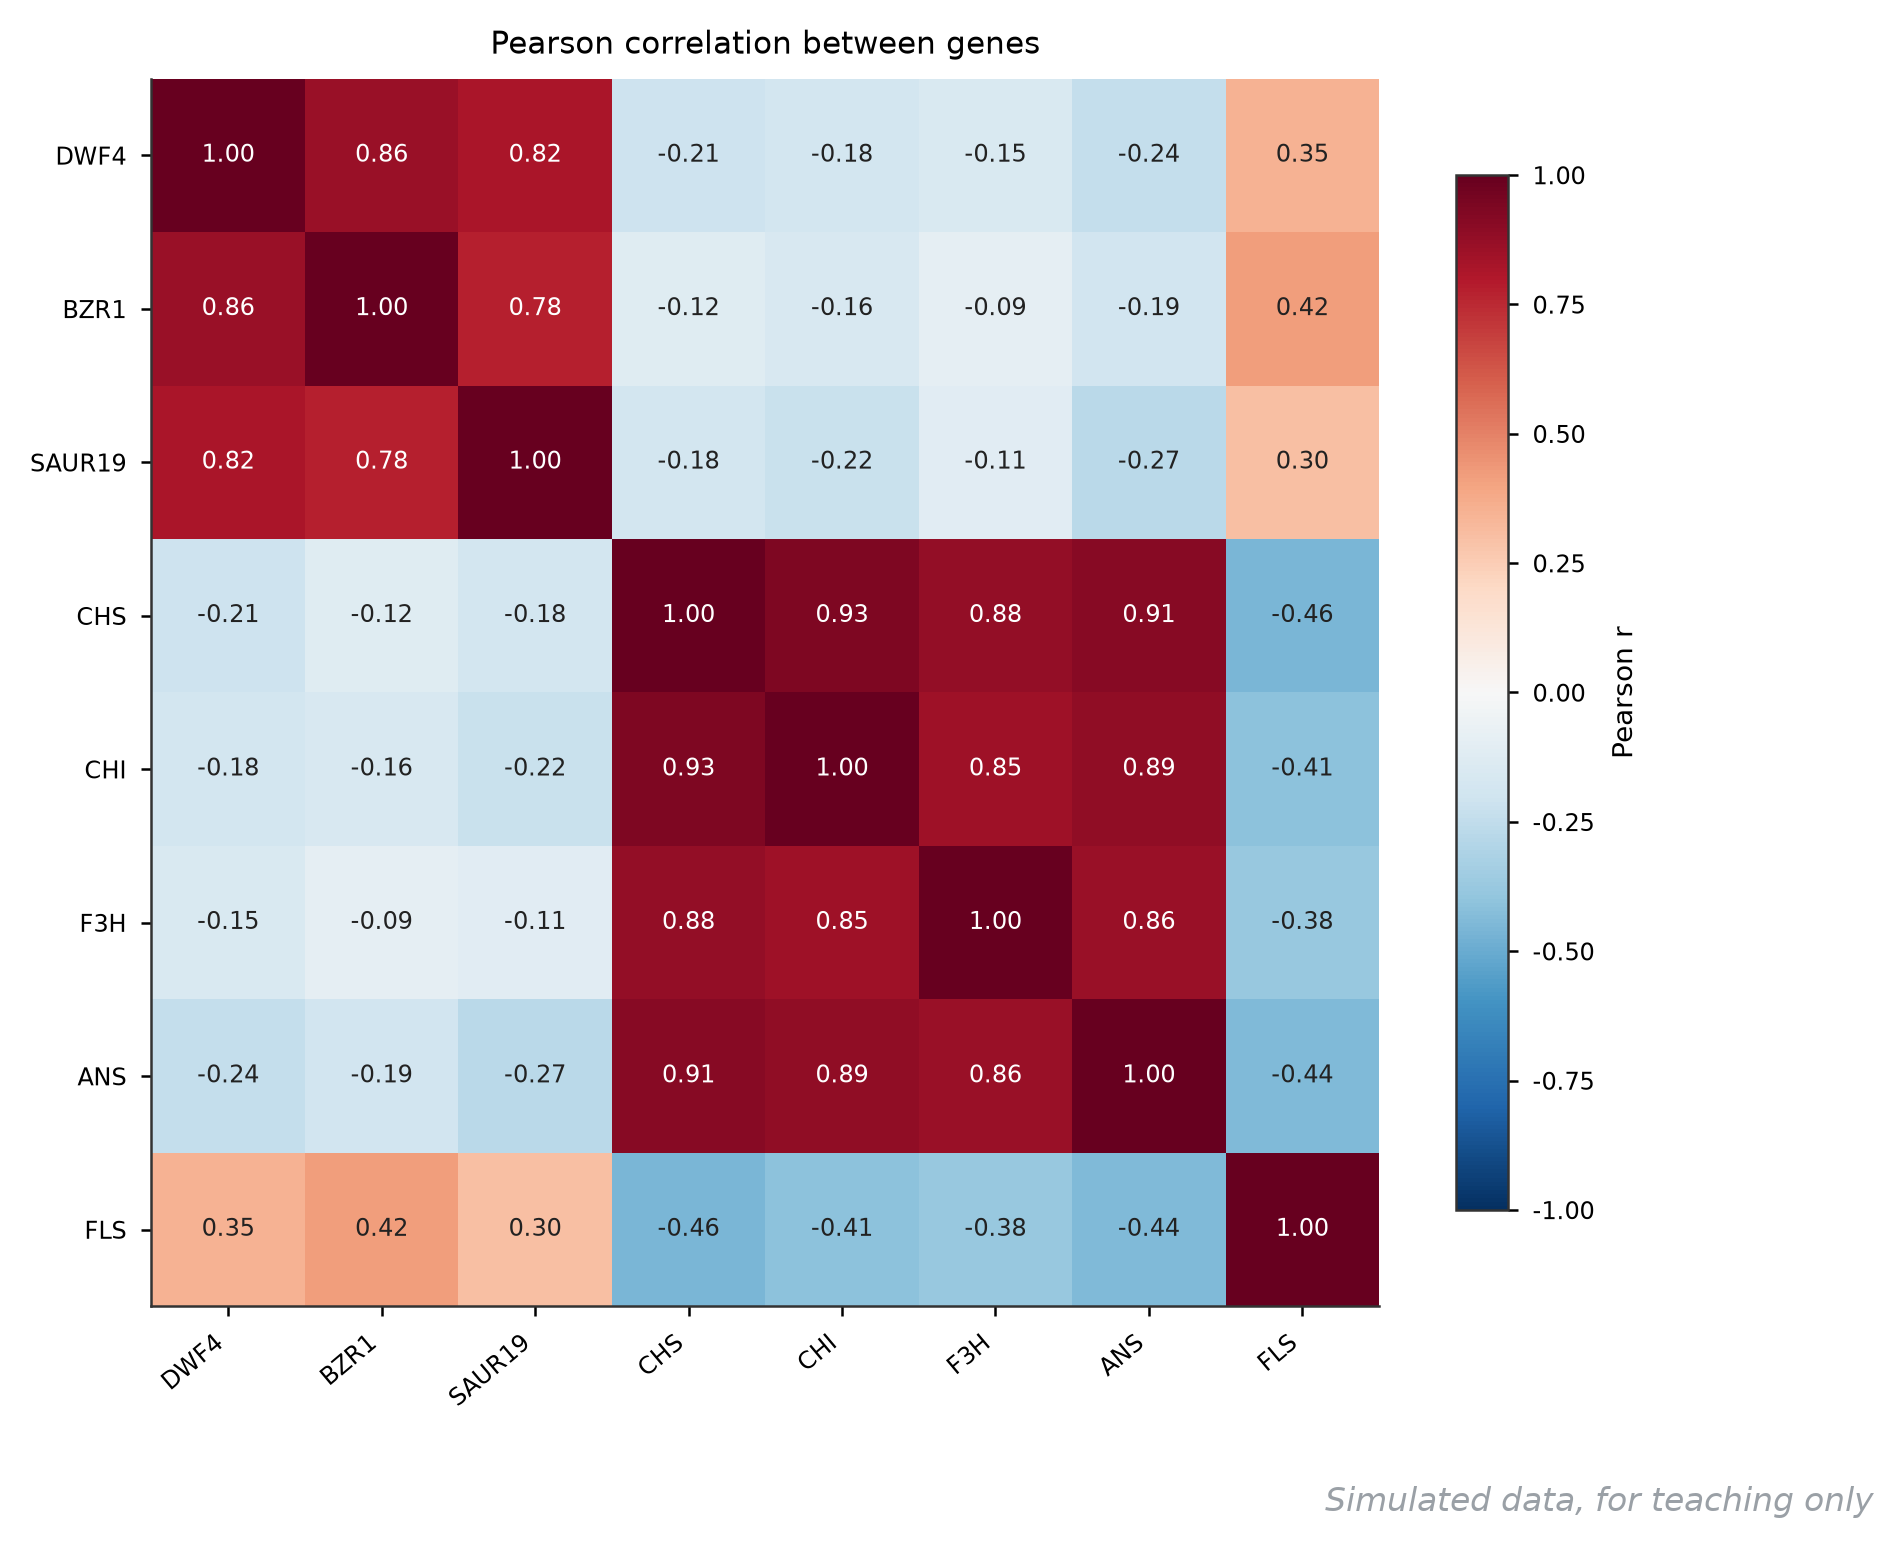
它回答什么问题:基因之间是否同步表达,是共调控与候选基因共表达证据的第一层。
怎么读:对称方阵,对角线恒为 1;颜色从蓝(-1 负相关)到红(+1 正相关)。看两处:块状高相关区(这里 CHS/CHI/F3H/ANS 四个黄酮基因 r > 0.85,像在同一个盒子里)和跨模块的负相关(FLS 与黄酮合成基因 r ≈ -0.4, suggesting 抢底物)。注意相关不等于调控,只是提示。
用什么画:R 语言 corrplot::corrplot(M) 或 pheatmap;Python 里 df.corr() 加 seaborn.heatmap(annot=True)。
图注示例:
图 3 候选基因间表达相关性热图。颜色与数字为 Pearson 相关系数 r,n = 12 样本;r > 0.85 的基因对被视为共表达模块成员。
展开查看:模拟数据(CSV,下三角与图一致)
gene,DWF4,BZR1,SAUR19,CHS,CHI,F3H,ANS,FLS
DWF4,1.00,0.86,0.82,-0.21,-0.18,-0.15,-0.24,0.35
BZR1,0.86,1.00,0.78,-0.12,-0.16,-0.09,-0.19,0.42
SAUR19,0.82,0.78,1.00,-0.18,-0.22,-0.11,-0.27,0.30
CHS,-0.21,-0.12,-0.18,1.00,0.93,0.88,0.91,-0.46
CHI,-0.18,-0.16,-0.22,0.93,1.00,0.85,0.89,-0.41
F3H,-0.15,-0.09,-0.11,0.88,0.85,1.00,0.86,-0.38
ANS,-0.24,-0.19,-0.27,0.91,0.89,0.86,1.00,-0.44
FLS,0.35,0.42,0.30,-0.46,-0.41,-0.38,-0.44,1.00
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 03-corr.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("03-corr.csv", index_col="gene")
M = df.values
fig, ax = plt.subplots(figsize=(6.6, 5.6))
im = ax.imshow(M, cmap="RdBu_r", vmin=-1, vmax=1)
ax.set_xticks(range(len(df)), df.columns, rotation=40, ha="right")
ax.set_yticks(range(len(df)), df.index)
ax.grid(False)
for i in range(M.shape[0]):
    for j in range(M.shape[1]):
        ax.text(j, i, "%.2f" % M[i, j], ha="center", va="center", fontsize=7.5,
                color="white" if abs(M[i, j]) > 0.6 else "#222222")
fig.colorbar(im, ax=ax, shrink=0.8, label="Pearson r")
fig.savefig("03-corr-heatmap.png", dpi=200, bbox_inches="tight")
2.4 Pearson 相关散点图
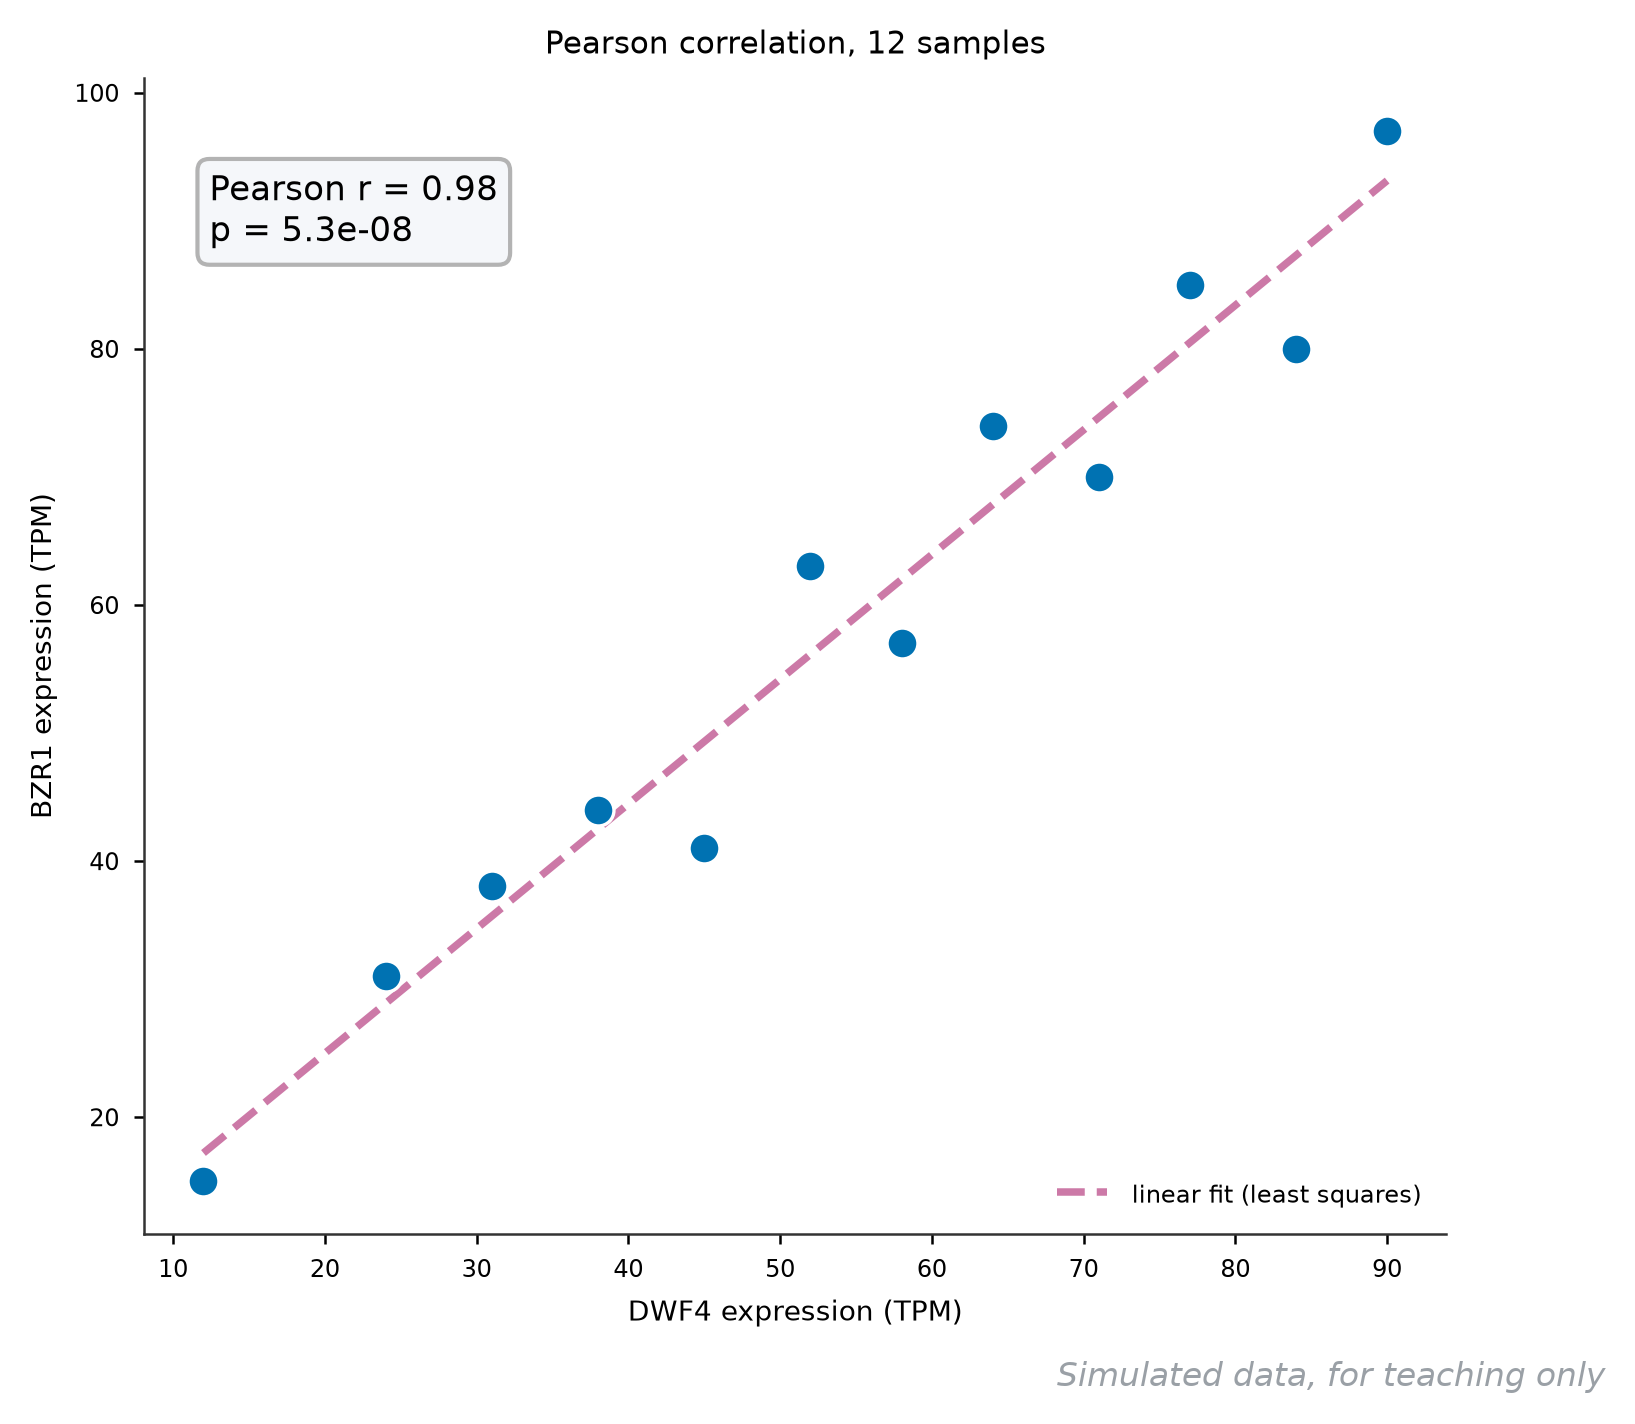
它回答什么问题:两个连续变量之间有没有线性同步关系,给相关性热图里的一个格子放大看原始点。
怎么读:每个点是一个样本,虚线是最小二乘拟合;左上角标着 r 和 p。看三样:点的走向、离群点、r 的置信度(n < 10 时 r 再好看也别太当真)。这张图 n = 12,r ≈ 0.97,是「DWF4 高的样本 BZR1 也高」的直观证据。
用什么画:R 语言 ggplot2::geom_point + geom_smooth(method="lm");Python 用 scipy.stats.pearsonr 算 r、matplotlib 画点线。
图注示例:
图 4 DWF4 与 BZR1 表达量的 Pearson 相关分析。每点代表一个样本(n = 12),虚线为线性拟合;r = 0.97,p < 0.001。
展开查看:模拟数据(CSV)
sample,DWF4_TPM,BZR1_TPM
S1,12,15
S2,24,31
S3,31,38
S4,38,44
S5,45,41
S6,52,63
S7,58,57
S8,64,74
S9,71,70
S10,77,85
S11,84,80
S12,90,97
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 04-pearson.csv
import numpy as np
import pandas as pd
from scipy import stats
import matplotlib.pyplot as plt

df = pd.read_csv("04-pearson.csv")
x, y = df["DWF4_TPM"], df["BZR1_TPM"]
r, p = stats.pearsonr(x, y)
fig, ax = plt.subplots(figsize=(5.6, 5.0))
ax.scatter(x, y, s=55, color="#4C72B0", edgecolors="white", zorder=3)
k, b = np.polyfit(x, y, 1)
xs = np.array([x.min(), x.max()])
ax.plot(xs, k * xs + b, "--", color="#C44E52", lw=1.8, label="linear fit")
ax.text(0.05, 0.92, "Pearson r = %.2f\\np = %.1e" % (r, p), transform=ax.transAxes,
        va="top", bbox=dict(boxstyle="round,pad=0.35", fc="#F5F7FA", ec="0.7"))
ax.set_xlabel("DWF4 expression (TPM)")
ax.set_ylabel("BZR1 expression (TPM)")
ax.legend(loc="lower right")
fig.savefig("04-pearson.png", dpi=200, bbox_inches="tight")
2.5 Pearson 与 Spearman 对比图
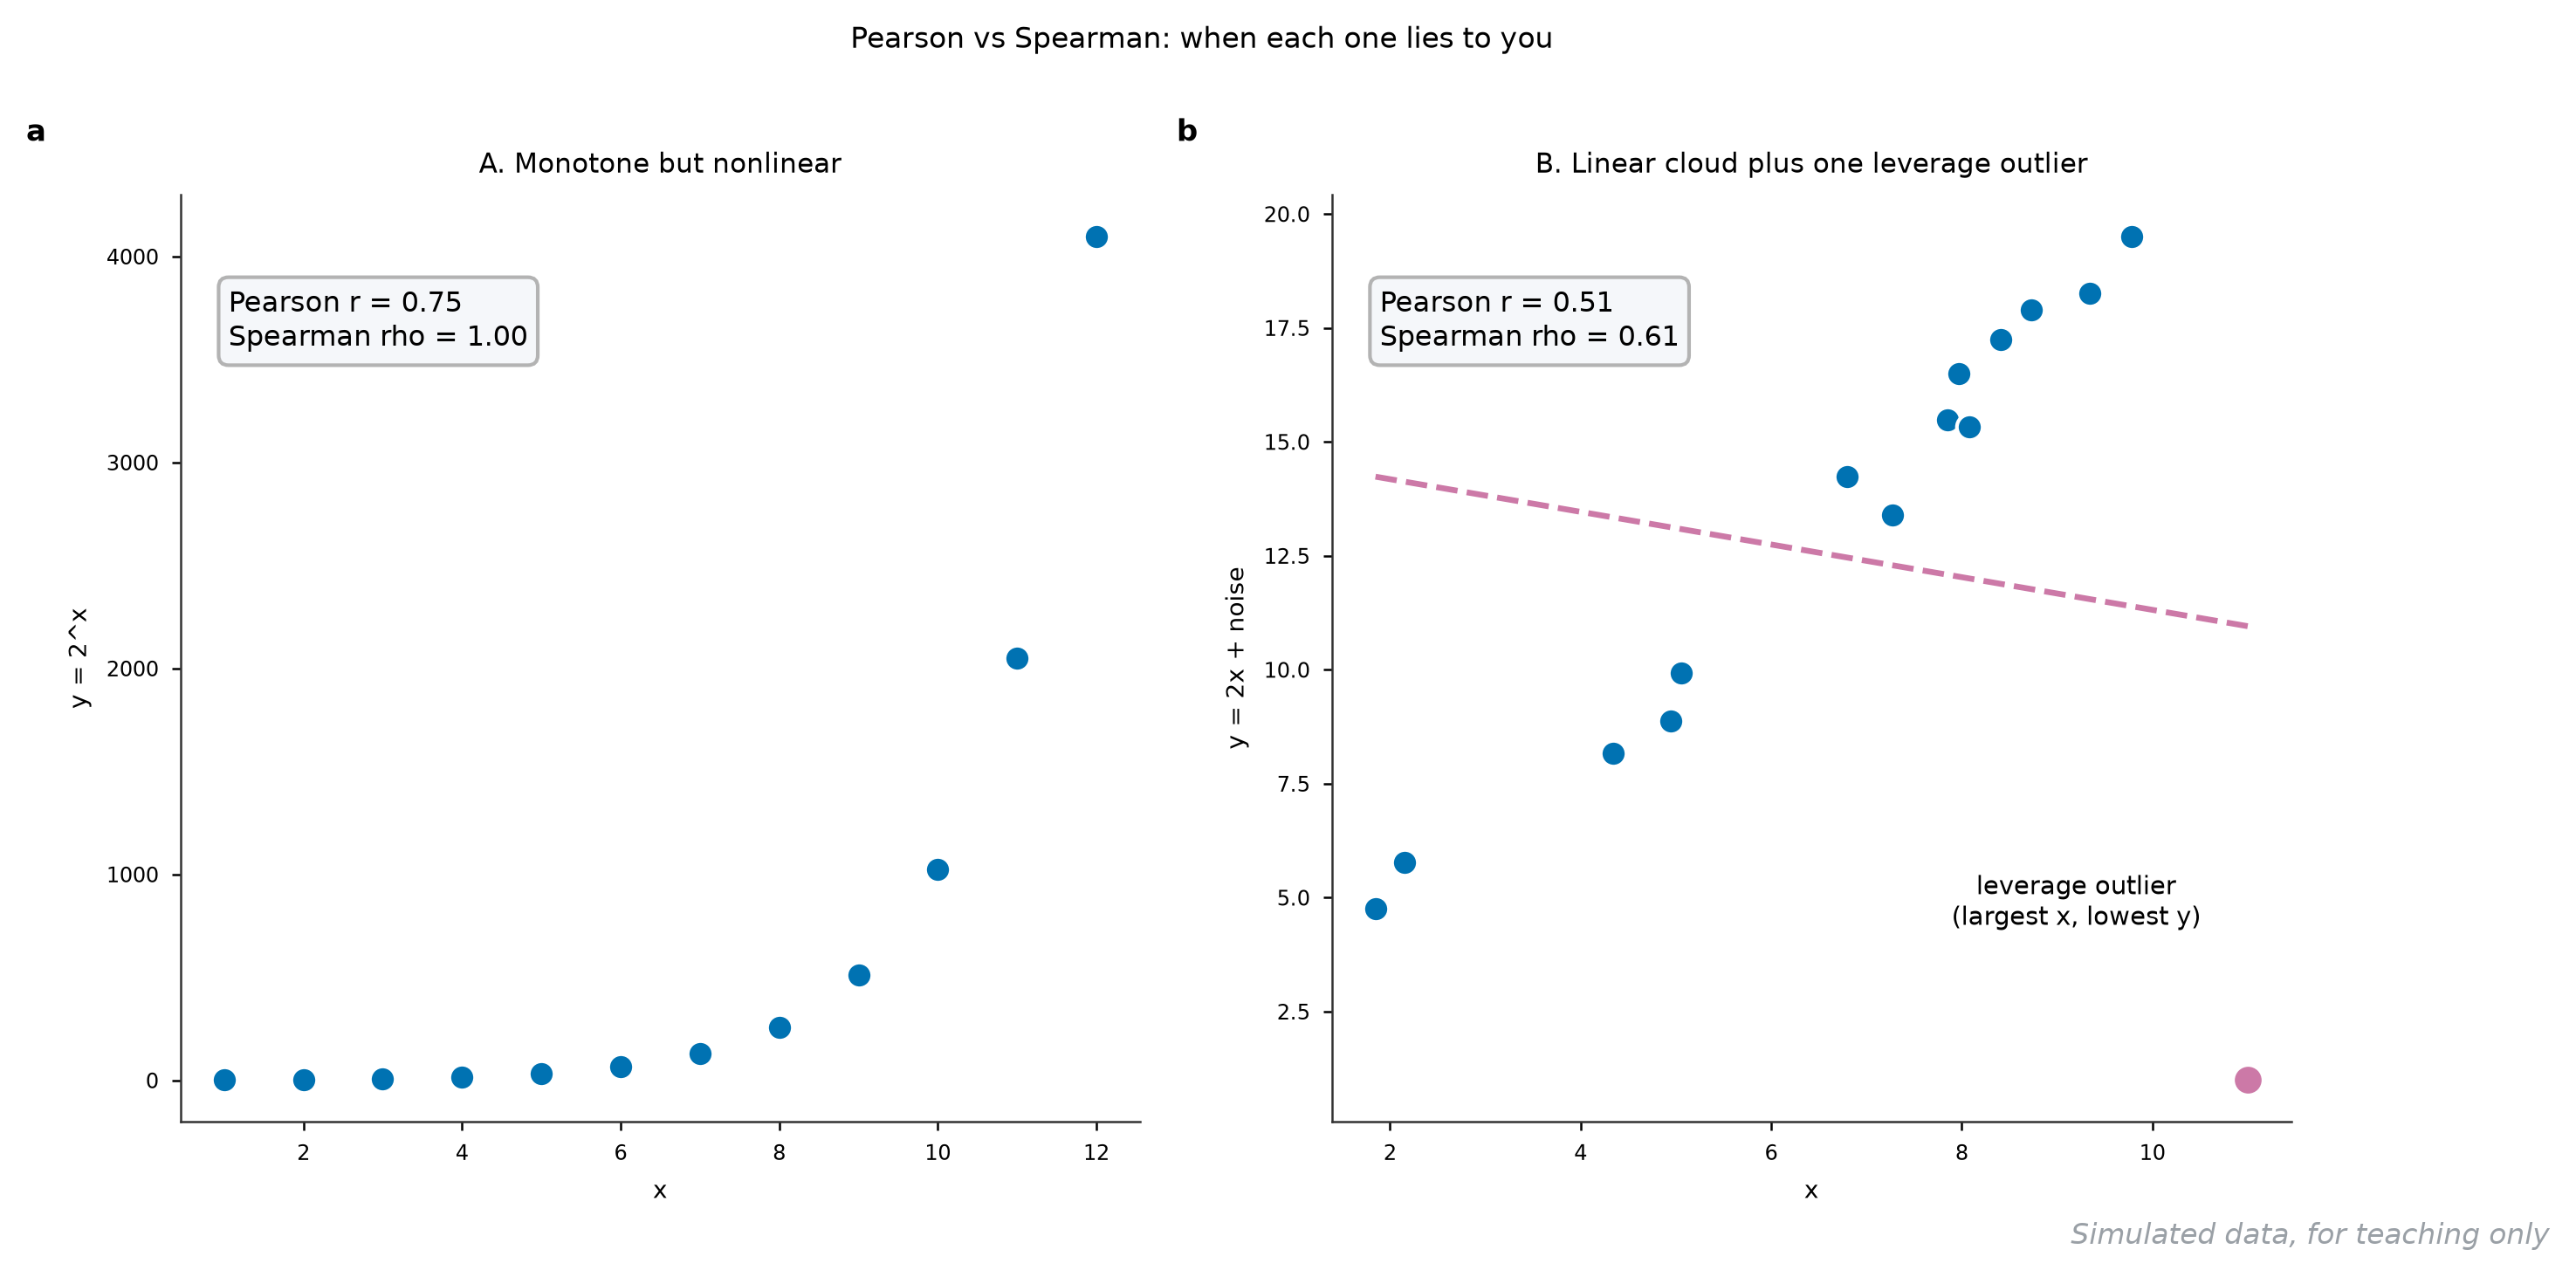
它回答什么问题:该报哪个相关系数。Pearson 看数值的线性关系,Spearman 只看秩次,两者经常打架。
怎么读:左图是指数型单调关系,Pearson 只有 0.75,Spearman 却是满分 1.00——「单调但非线性」时请用 Spearman。右图是漂亮线性云加一个右下角杠杆离群点,回归线被拽得几乎躺平,Pearson 从 0.98 掉到 0.51,而 Spearman 只掉到 0.61。结论:有离群点先看秩相关,并交代为什么。
用什么画:R 语言 cor(x, y, method="spearman");Python 用 scipy.stats.spearmanr。图本身还是散点。
图注示例:
图 5 两种相关系数的适用性对比。A:单调非线性关系,Spearman 秩相关(ρ = 1.00)优于 Pearson(r = 0.75);B:单个杠杆离群点使 Pearson 降至 0.51,Spearman(ρ = 0.61)受影响较小。
展开查看:模拟数据(CSV)
panel,x,y
A,1,2
A,2,4
A,3,8
A,4,16
A,5,32
A,6,64
A,7,128
A,8,256
A,9,512
A,10,1024
A,11,2048
A,12,4096
B,7.97,16.49
B,4.95,8.87
B,8.73,17.90
B,7.28,13.40
B,1.85,4.75
B,9.78,19.50
B,7.85,15.48
B,8.07,15.33
B,2.15,5.77
B,5.05,9.92
B,4.34,8.16
B,9.34,18.26
B,6.79,14.23
B,8.40,17.25
B,11.00,1.00
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 05-spearman.csv
import pandas as pd
from scipy import stats
import matplotlib.pyplot as plt

df = pd.read_csv("05-spearman.csv")
fig, axes = plt.subplots(1, 2, figsize=(10.4, 4.6))
for ax, panel, title in [(axes[0], "A", "A. Monotone but nonlinear"),
                         (axes[1], "B", "B. One leverage outlier")]:
    sub = df[df.panel == panel]
    r, _ = stats.pearsonr(sub.x, sub.y)
    rho, _ = stats.spearmanr(sub.x, sub.y)
    ax.scatter(sub.x, sub.y, s=50, color="#4C72B0", edgecolors="white", zorder=3)
    ax.set_title(title)
    ax.text(0.05, 0.9, "Pearson r = %.2f\\nSpearman rho = %.2f" % (r, rho),
            transform=ax.transAxes, va="top", fontsize=10,
            bbox=dict(boxstyle="round,pad=0.35", fc="#F5F7FA", ec="0.7"))
# B 组末行 (11.00, 1.00) 即红色杠杆离群点,会把虚线回归线拽到几乎躺平
fig.savefig("05-spearman.png", dpi=200, bbox_inches="tight")
2.6 箱线图(boxplot)
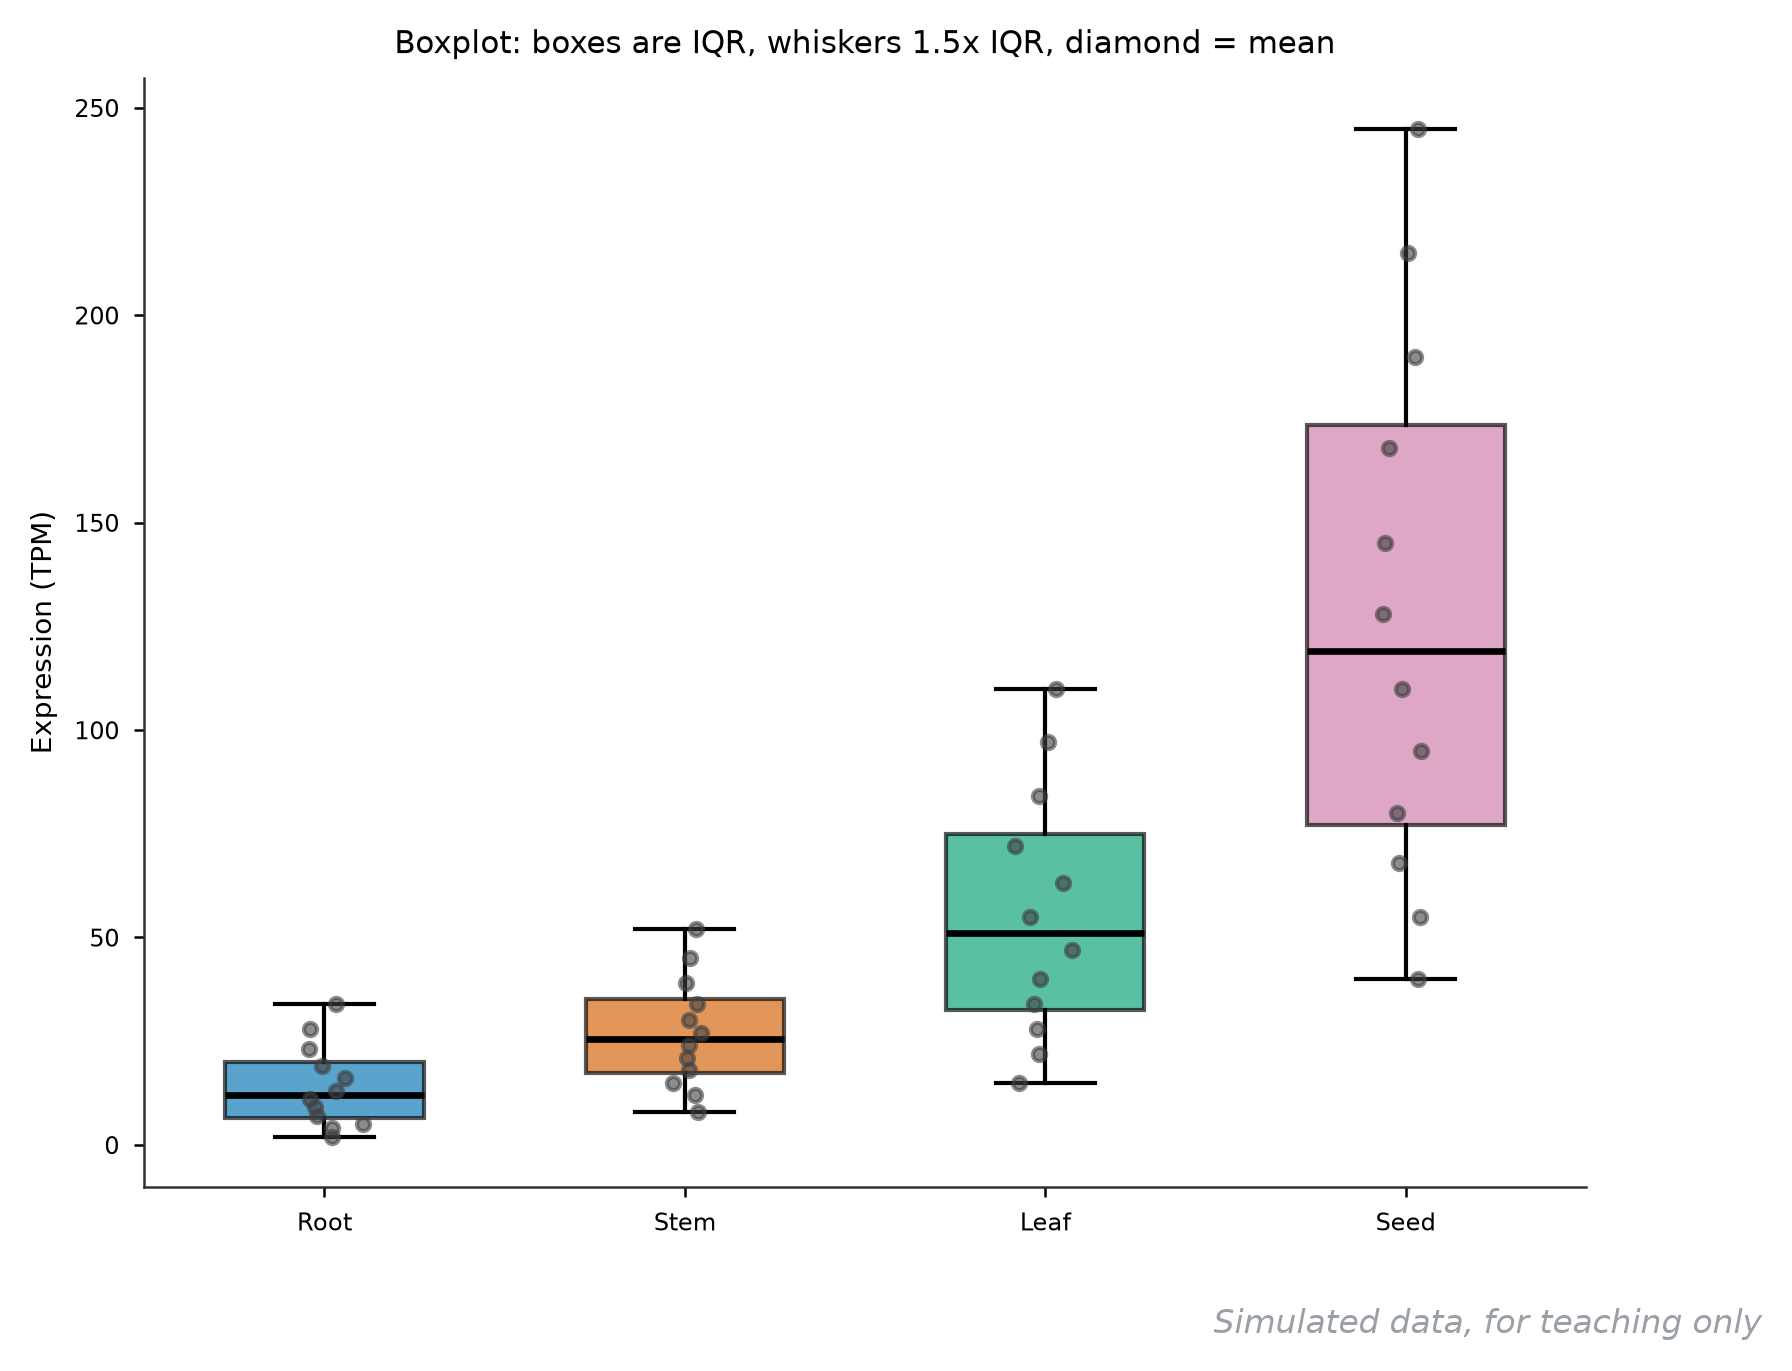
它回答什么问题:一组数的中位数、四分位距和离群值,组间比较的底盘。
怎么读:盒子是 Q1 到 Q3(中间 50% 数据),盒内横线是中位数,菱形是均值,须为 1.5 倍 IQR,须外的点是离群值。看三处:中位数的高度差、盒子的胖瘦(方差)、须外点。图上 Seed 组织不仅中位数高,盒子也整体上移——是整段分布的抬升,不只是一两个大值。
用什么画:R 语言 ggplot2::geom_boxplot;Python 用 matplotlib.pyplot.boxplot 或 seaborn.boxplot。
图注示例:
图 6 四个组织中目标基因表达水平分布(n = 12 个转录组样本)。箱体为四分位距,横线为中位数,菱形为均值,须为 1.5 倍四分位距。
展开查看:模拟数据(CSV,与 2.7 小提琴图共用同一组)
tissue,tpm
Root,2
Root,4
Root,5
Root,7
Root,9
Root,11
Root,13
Root,16
Root,19
Root,23
Root,28
Root,34
Stem,8
Stem,12
Stem,15
Stem,18
Stem,21
Stem,24
Stem,27
Stem,30
Stem,34
Stem,39
Stem,45
Stem,52
Leaf,15
Leaf,22
Leaf,28
Leaf,34
Leaf,40
Leaf,47
Leaf,55
Leaf,63
Leaf,72
Leaf,84
Leaf,97
Leaf,110
Seed,40
Seed,55
Seed,68
Seed,80
Seed,95
Seed,110
Seed,128
Seed,145
Seed,168
Seed,190
Seed,215
Seed,245
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 06-boxplot.csv
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("06-boxplot.csv")
groups = df.tissue.unique()
data = [df[df.tissue == g].tpm.values for g in groups]
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52"]
fig, ax = plt.subplots(figsize=(6.2, 4.8))
bp = ax.boxplot(data, tick_labels=groups, patch_artist=True, widths=0.55,
                medianprops=dict(color="black", lw=1.6))
for patch, col in zip(bp["boxes"], CAT):
    patch.set_facecolor(col)
    patch.set_alpha(0.65)
rng = np.random.default_rng(1)
for i, d in enumerate(data, 1):
    ax.scatter(rng.normal(i, 0.05, len(d)), d, s=10, color="0.25",
               alpha=0.6, zorder=3)
ax.set_ylabel("Expression (TPM)")
fig.savefig("06-boxplot.png", dpi=200, bbox_inches="tight")
2.7 小提琴图(violin plot)
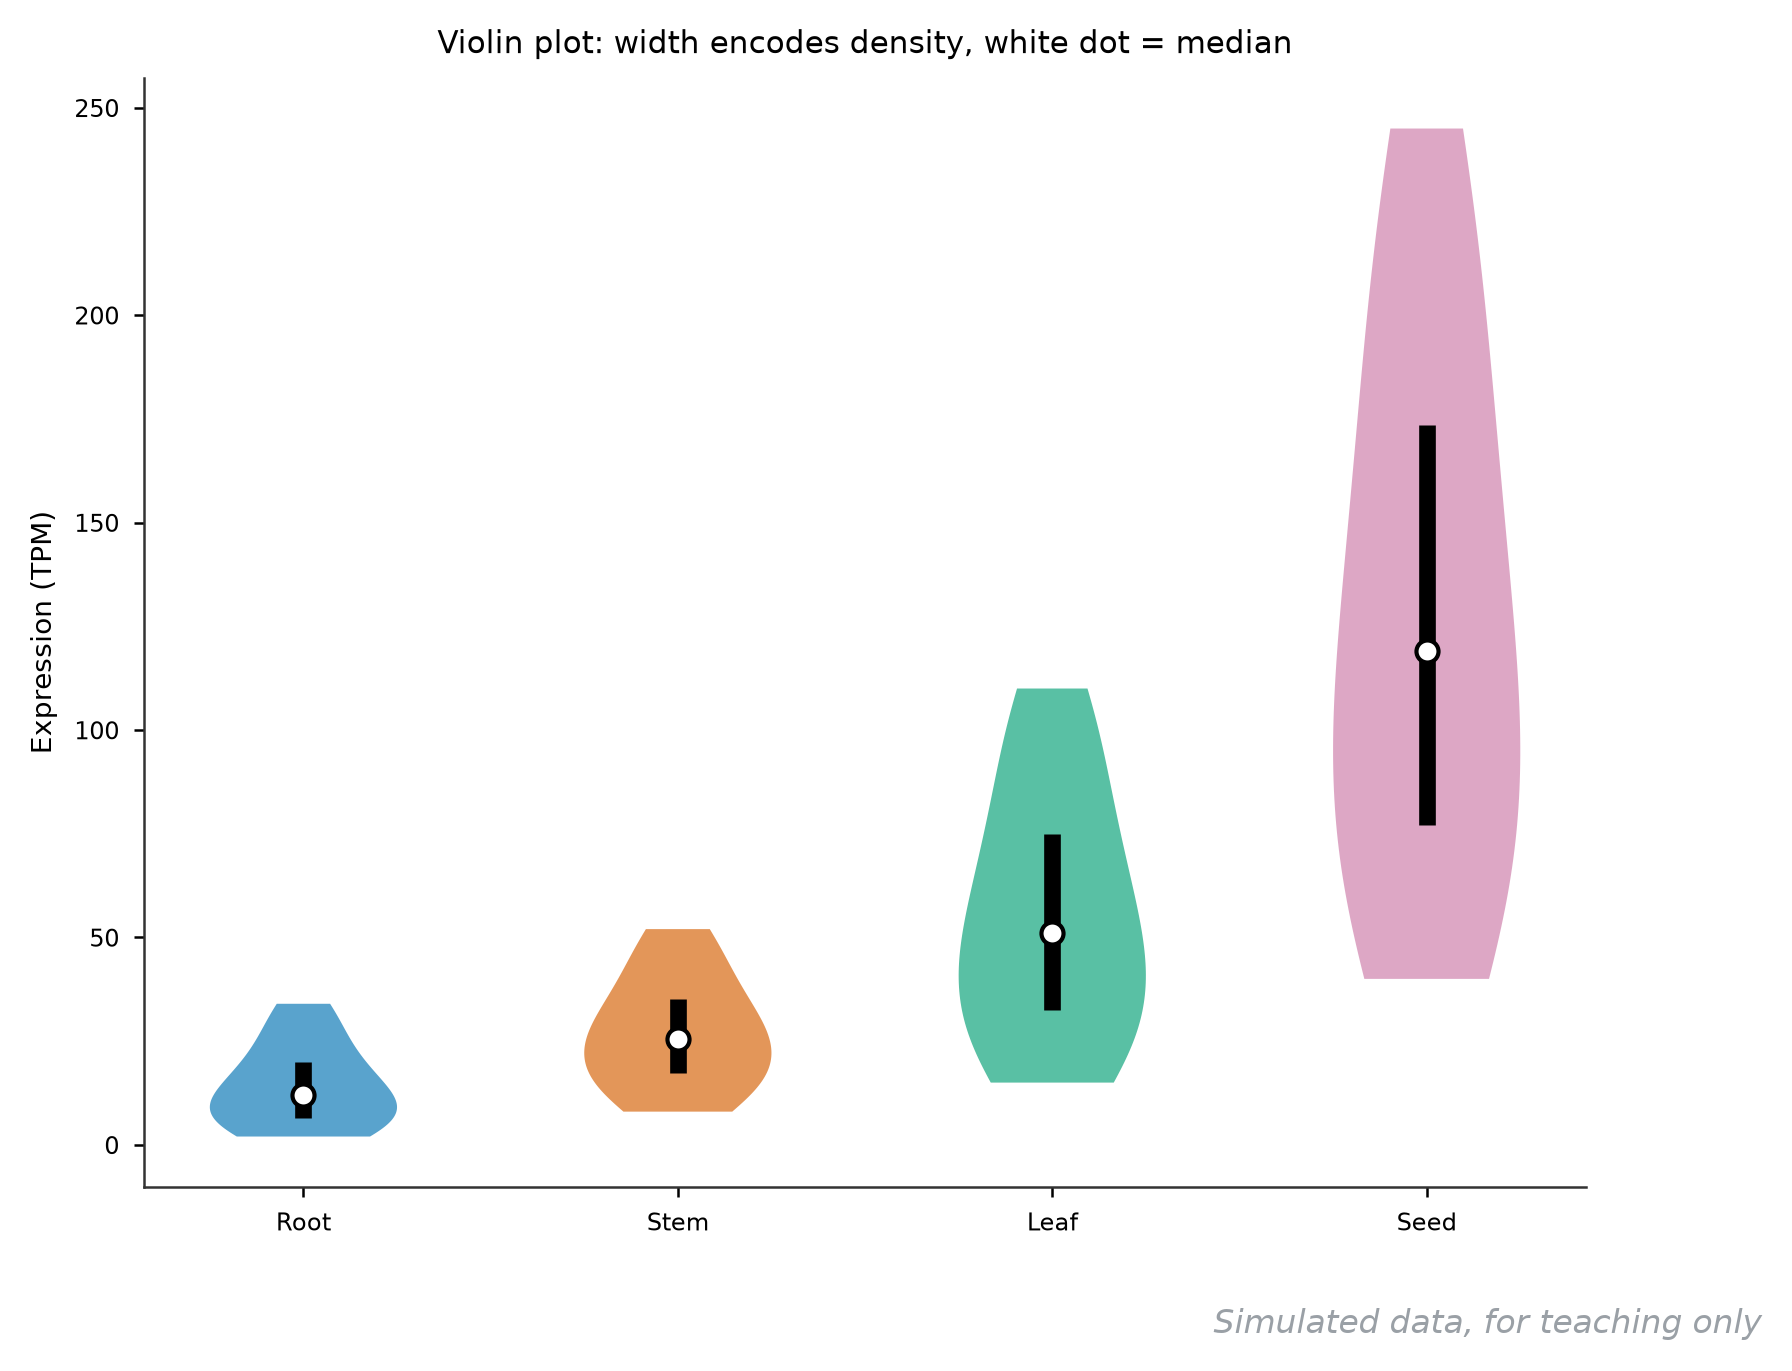
它回答什么问题:和箱线图同一份数据,但把「分布形状」画出来——双峰、偏态一目了然。
怎么读:宽度编码该位置的样本密度,内部白点是中位数、粗竖线是四分位距。看箱线图看不出「中间空、两头挤」,小提琴一眼见底;反过来小提琴是核密度估计,样本太少(n < 10)时会画出欺骗性的平滑形状,这时老实画箱线。
用什么画:R 语言 ggplot2::geom_violin(常用 trim=FALSE);Python 用 seaborn.violinplot 或 matplotlib.pyplot.violinplot。
图注示例:
图 7 四个组织表达分布的核密度估计。宽度编码样本密度,白点为中位数,粗线为四分位距;数据与图 6 相同。
展开查看:绘图代码(Python,独立可运行)
# 数据:与 2.6 节的 06-boxplot.csv 完全相同
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("06-boxplot.csv")
groups = df.tissue.unique()
data = [df[df.tissue == g].tpm.values for g in groups]
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52"]
fig, ax = plt.subplots(figsize=(6.2, 4.8))
vp = ax.violinplot(data, showextrema=False)
for body, col in zip(vp["bodies"], CAT):
    body.set_facecolor(col)
    body.set_alpha(0.65)
for i, d in enumerate(data, 1):
    q1, med, q3 = np.percentile(d, [25, 50, 75])
    ax.vlines(i, q1, q3, color="black", lw=4)
    ax.scatter(i, med, s=28, color="white", edgecolors="black", zorder=3)
ax.set_xticks(range(1, 5), groups)
ax.set_ylabel("Expression (TPM)")
fig.savefig("07-violin.png", dpi=200, bbox_inches="tight")
2.8 韦恩图(Venn diagram,样本/处理间)
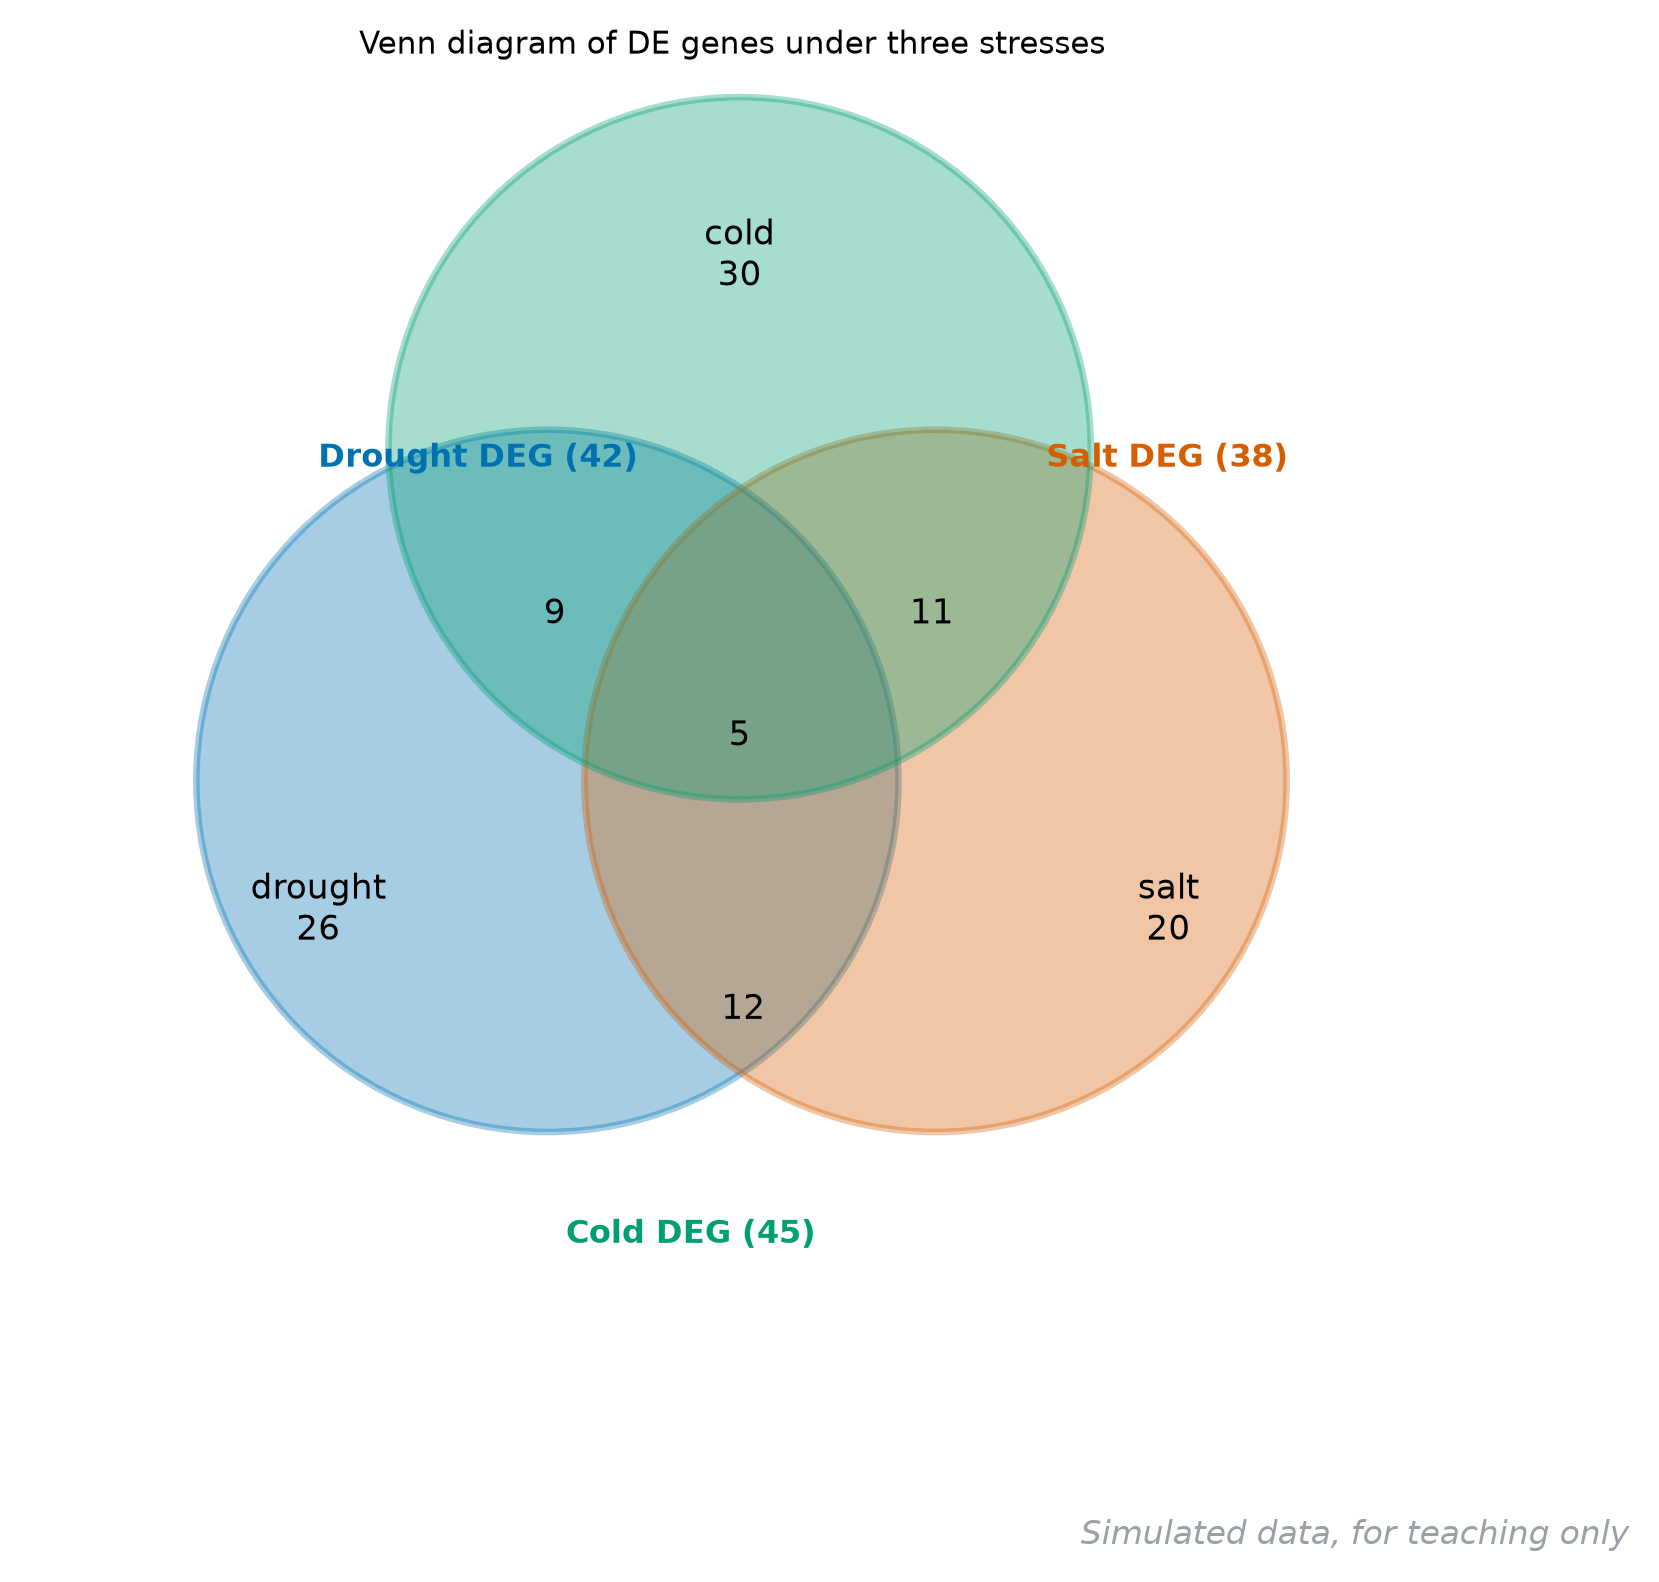
它回答什么问题:几份基因名单之间有多少共有、多少独有,最直观的交集展示。
怎么读:每个圆一份名单,圆内数字是区间基因数。看两点:中心三重交集是不是你真正的「核心响应集」(这里只有 5 个,说明三种胁迫共享响应很小);再看两两交集的不对称(干旱与盐交集 12 > 干旱与冷交集 9,提示前两者机制更近)。圆的大小通常不按比例,读数字别读面积。
用什么画:R 语言 VennDiagram 或 ggVennDiagram;不想写代码用 TBtools 的图形界面。
图注示例:
图 8 干旱、盐、低温处理下差异表达基因的韦恩图。数值为各区间基因数目;三处理共同诱导的基因为 5 个。
展开查看:模拟数据(各区间基因数)
set,size
drought_only,26
salt_only,20
cold_only,30
drought_and_salt,12
drought_and_cold,9
salt_and_cold,11
all_three,5
drought_total,42
salt_total,38
cold_total,45
绘图代码(Python,独立可运行)
# 数据:区间数字取自上方 CSV,几何为三个半透明圆 + 区间文字
import matplotlib.pyplot as plt
from matplotlib.patches import Circle

CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig, ax = plt.subplots(figsize=(6.2, 5.6))
for (x0, y0), col in zip([(-0.1, 0), (0.95, 0), (0.42, 0.9)], CAT):
    ax.add_patch(Circle((x0, y0), 0.95, facecolor=col, alpha=0.35,
                        edgecolor=col, lw=1.6))
for t, x0, y0 in [("drought 26", -0.72, -0.35), ("salt 20", 1.58, -0.35),
                  ("cold 30", 0.42, 1.42), ("12", 0.43, -0.62),
                  ("9", -0.08, 0.45), ("11", 0.94, 0.45), ("5", 0.42, 0.12)]:
    ax.text(x0, y0, t, ha="center", va="center", fontsize=9.5)
ax.set_xlim(-1.5, 2.4)
ax.set_ylim(-1.6, 1.9)
ax.axis("off")
fig.savefig("08-venn-treatment.png", dpi=200, bbox_inches="tight")
2.9 物种间直系同源韦恩图
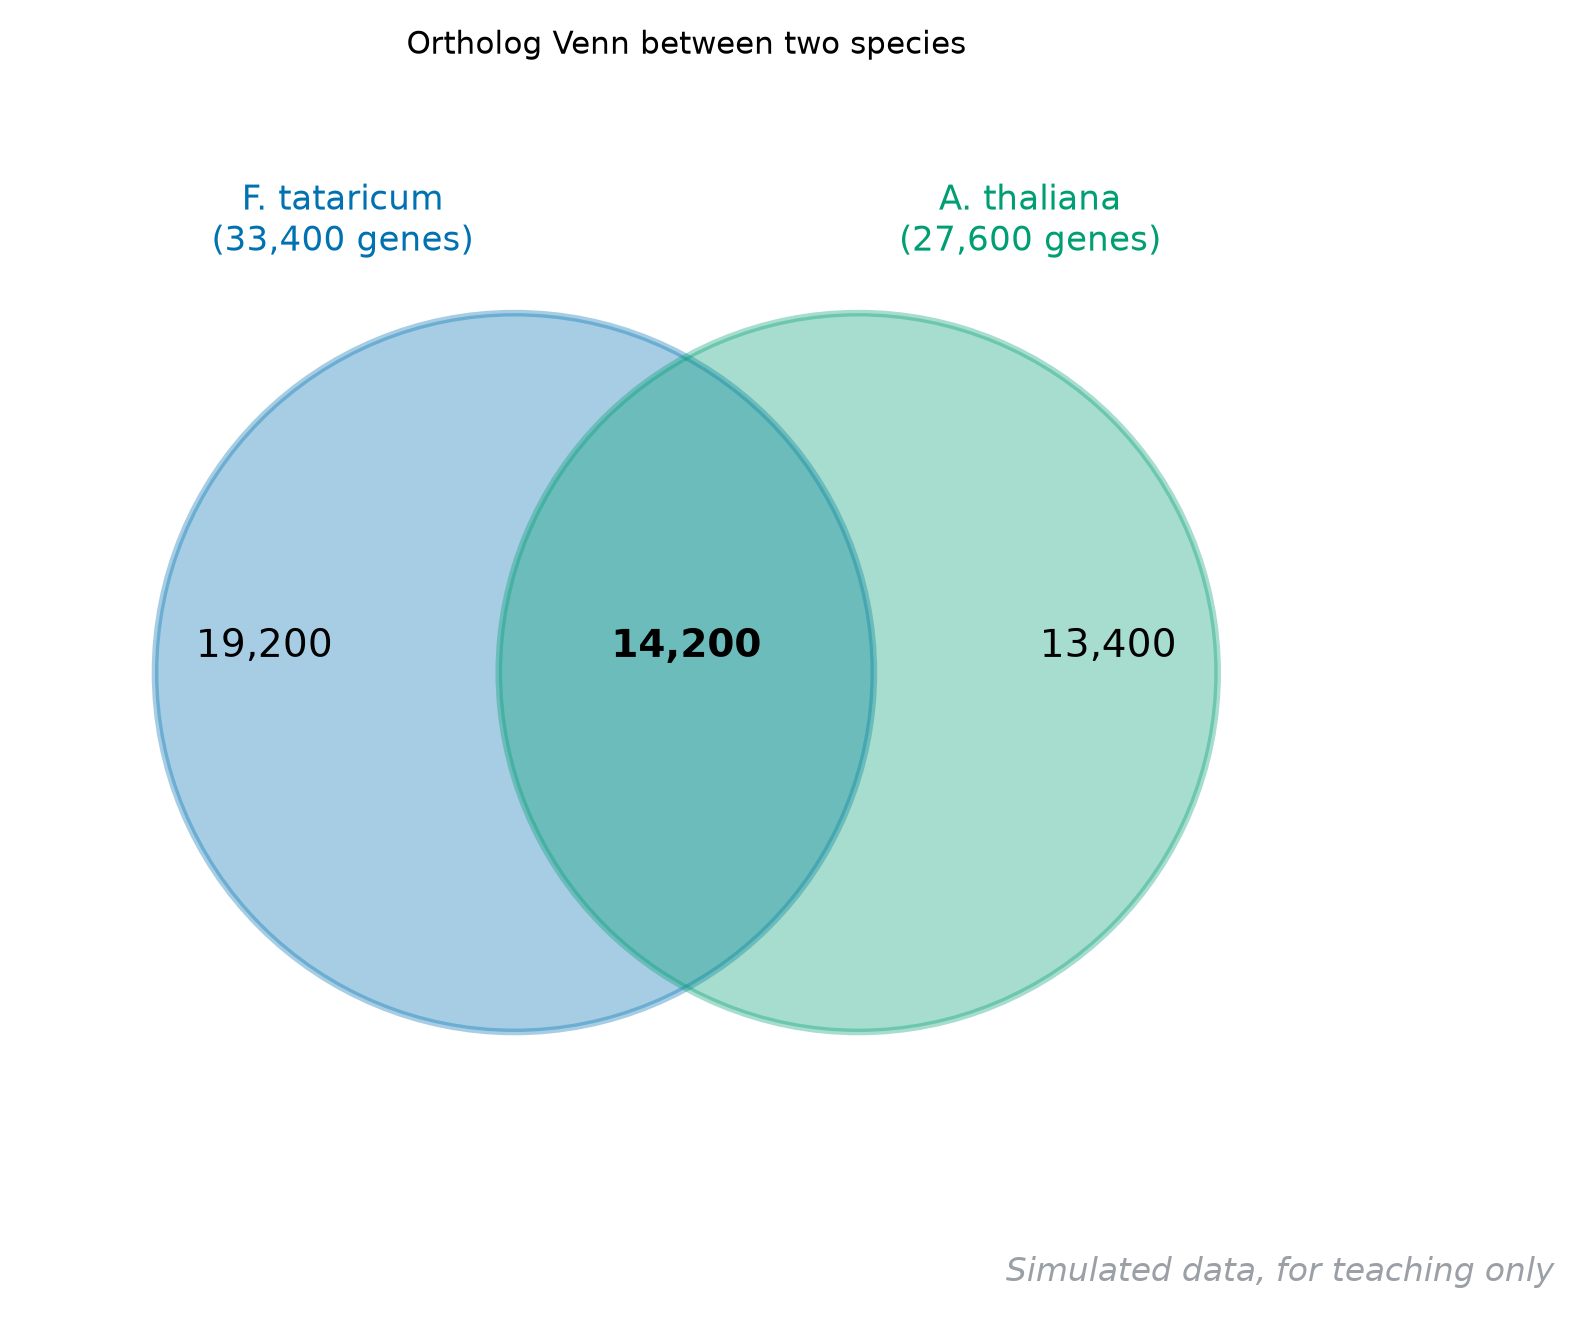
它回答什么问题:两个物种的基因在另一个物种里「找得到对应」的规模,比较基因组学的开场图。这就是我记忆里「影物之间」的那张韦恩图——物种(species)之间的直系同源统计,几乎每篇带新基因组的文章都有一张。
怎么读:两圆分别是一个物种的全部基因,交集是一对一 ortholog 数。看交集占比而不是绝对数:这里荞麦 33,400 个基因里 14,200 个在拟南芥有一对一同源体(42%),说明两个基因组整体同线性尚可;差异基因部分(各自独有的)才是物种特异新功能的方向。
用什么画:OrthoVenn2 网页版直接出图;本地跑 OrthoFinder 后用 R VennDiagram 画。
图注示例:
图 9 苦荞与拟南芥直系同源基因韦恩图。交集为 OrthoFinder 鉴定的一对一直系同源基因(14,200 个),两侧为物种特异基因。
展开查看:模拟数据(CSV)
species,total_genes,one2one_orthologs
Fagopyrum_tataricum,33400,14200
Arabidopsis_thaliana,27600,14200
绘图代码(Python,独立可运行)
# 数据:两物种基因数与一对一同源数,两个圆即可
import matplotlib.pyplot as plt
from matplotlib.patches import Circle

fig, ax = plt.subplots(figsize=(6.0, 4.6))
ax.add_patch(Circle((-0.55, 0), 1.15, facecolor="#4C72B0", alpha=0.35,
                    edgecolor="#4C72B0", lw=1.6))
ax.add_patch(Circle((0.55, 0), 1.15, facecolor="#55A868", alpha=0.35,
                    edgecolor="#55A868", lw=1.6))
ax.text(-1.35, 0, "19,200", ha="center", fontsize=12)
ax.text(0.0, 0, "14,200", ha="center", fontsize=12, fontweight="bold")
ax.text(1.35, 0, "13,400", ha="center", fontsize=12)
ax.text(-1.1, 1.35, "F. tataricum", ha="center", fontsize=10.5, color="#4C72B0")
ax.text(1.1, 1.35, "A. thaliana", ha="center", fontsize=10.5, color="#55A868")
ax.set_xlim(-2.1, 2.1)
ax.set_ylim(-1.5, 1.9)
ax.axis("off")
fig.savefig("09-venn-ortholog.png", dpi=200, bbox_inches="tight")
2.10 UpSet 图
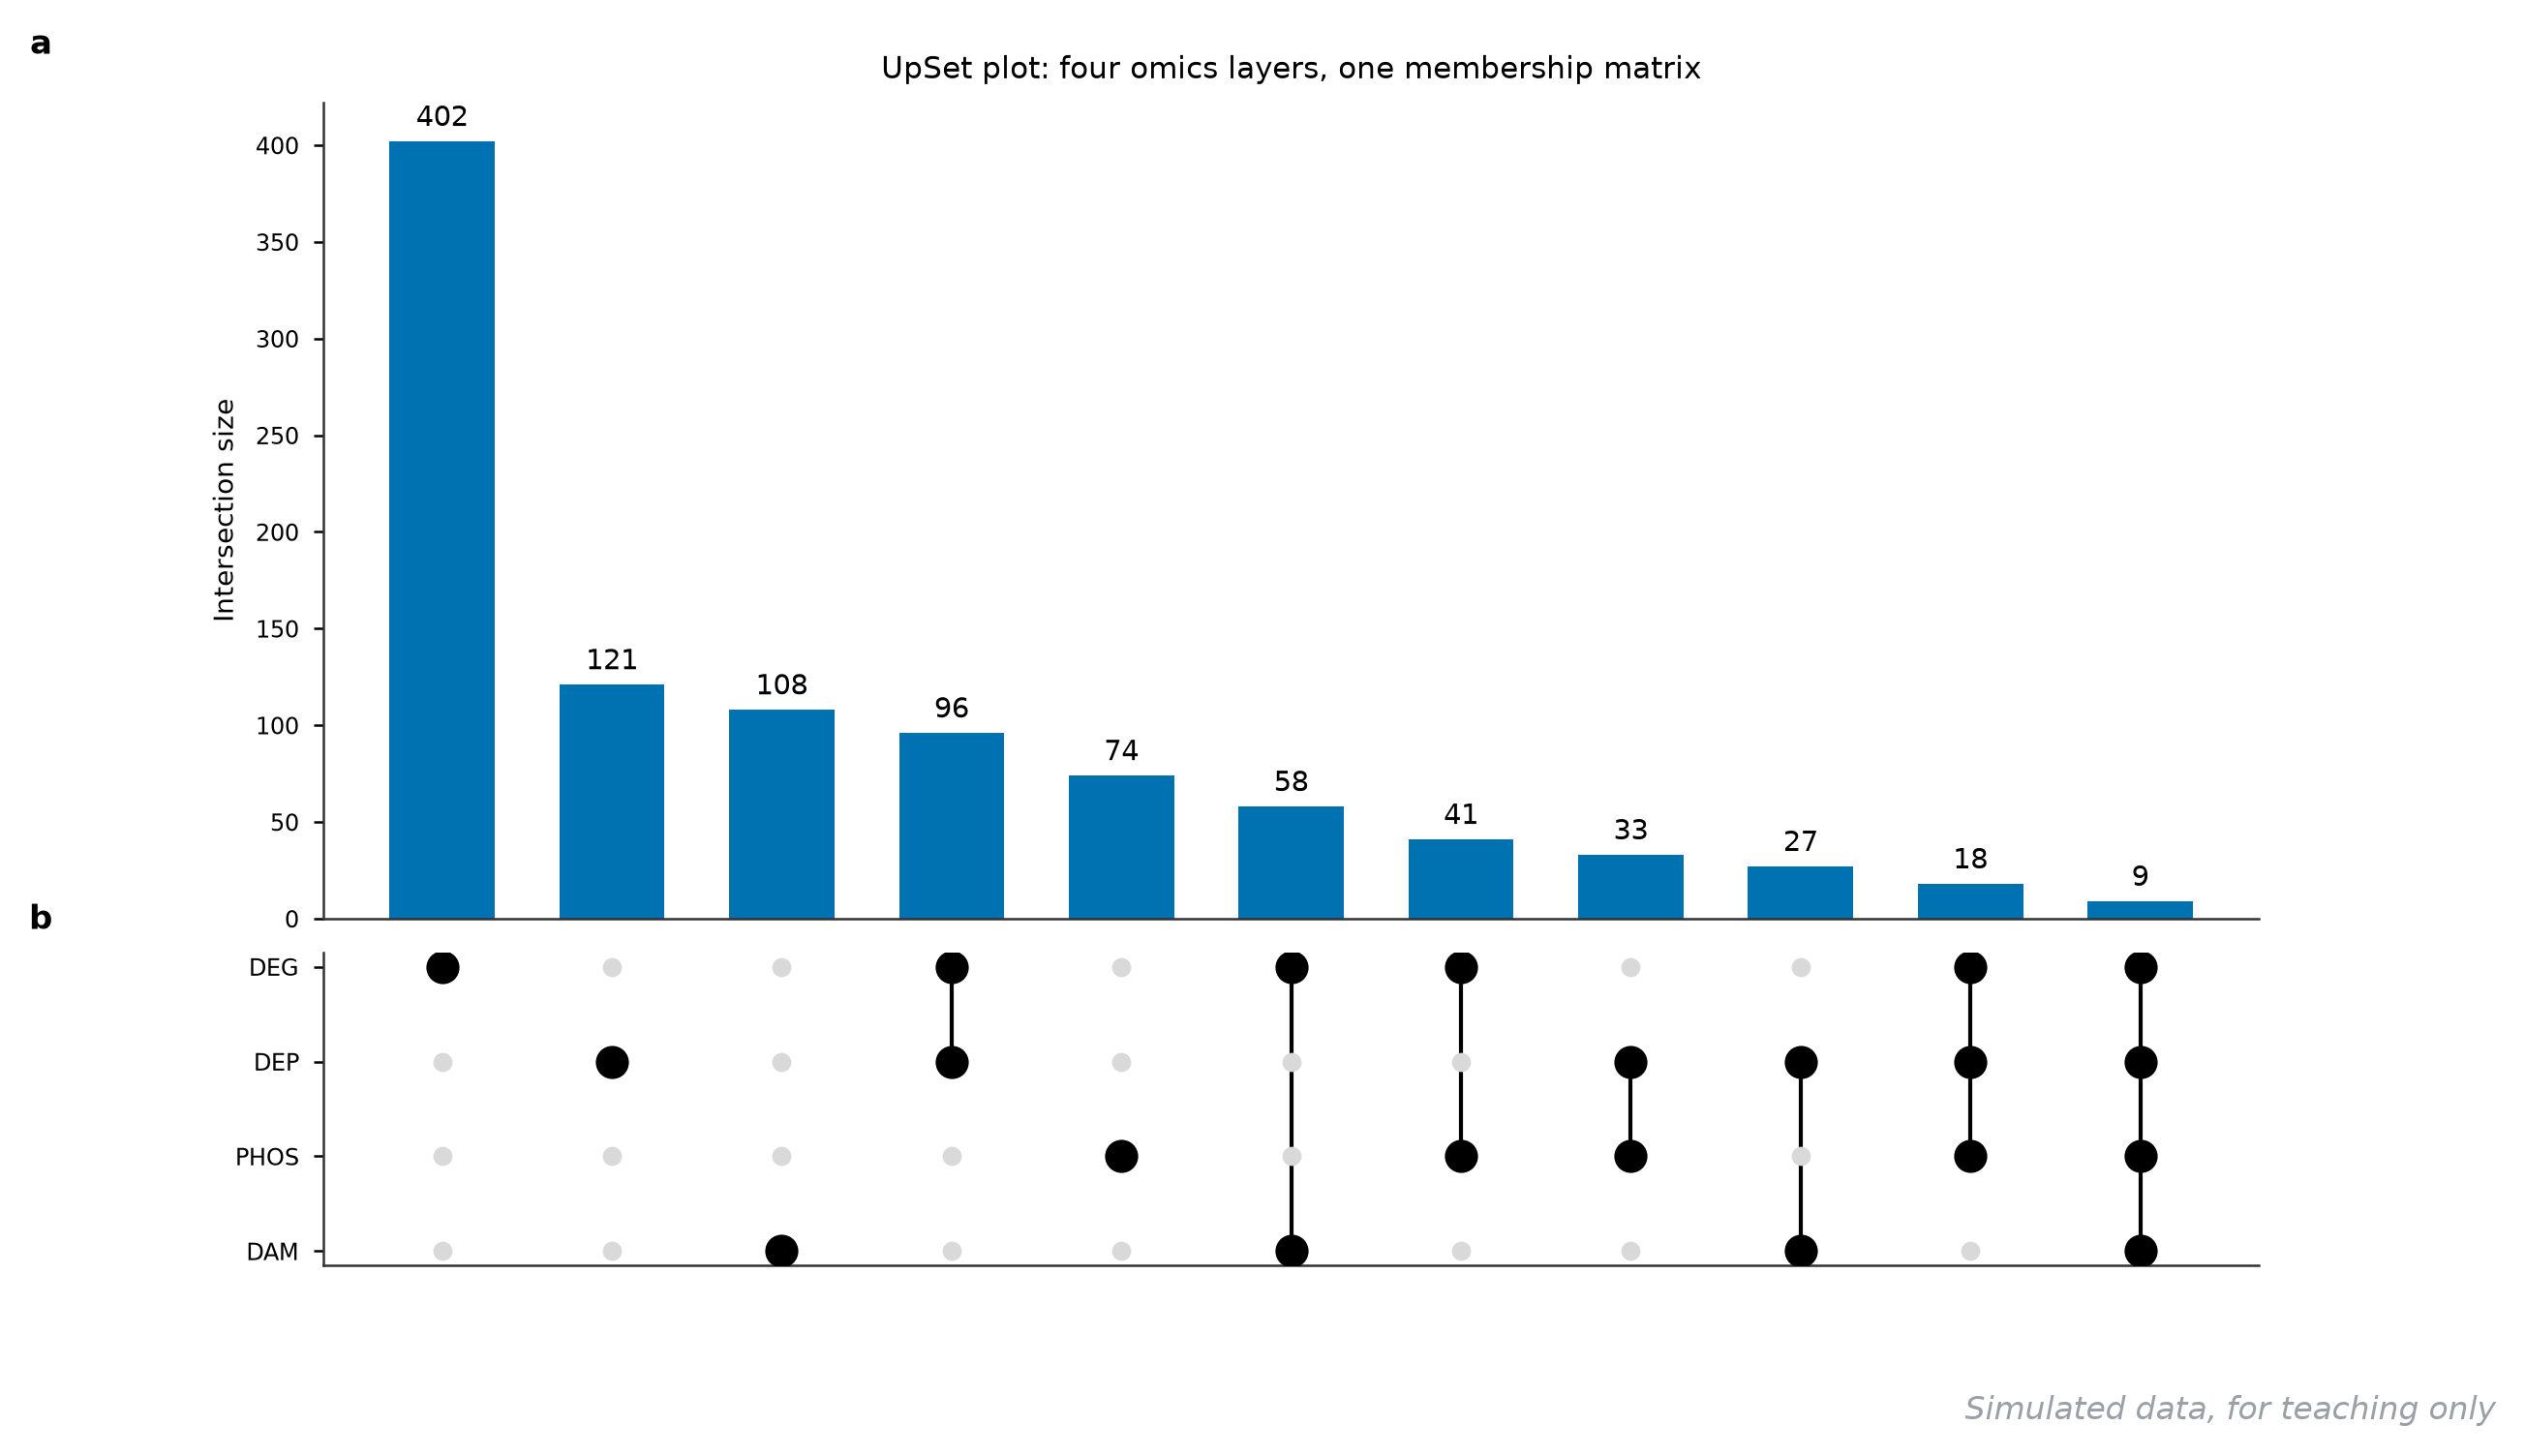
它回答什么问题:集合超过 3 个之后韦恩图就画不动了,UpSet 用「柱高+打点矩阵」回答同样的问题,而且读交集大小更准。
怎么读:上面是柱状图,一根柱子一个交集,高度是交集大小;下面的矩阵告诉你这根柱子由哪些集合相交而来——实心点且有线连着的是成员,浅灰点是无关集合。最左柱 402 是「只有转录组差异」的基因,第三根 108 是「只有代谢物差异」,第五根 96(DEG×DEP 两点相连)才是两种组学共同命中的核心,多组学文章的高光数字。
用什么画:R 语言 UpSetR::upset 或 ComplexUpset;Python 用 upsetplot 包。
图注示例:
图 10 转录组(DEG)、蛋白组(DEP)、磷酸化蛋白组(PHOS)与代谢组(DAM)差异分子 UpSet 图。柱高为交集分子数,下方实心点标识交集的成员集合;DEG 与 DEP 共有 96 个分子。
展开查看:模拟数据(交集成员矩阵与大小)
DEG,DEP,PHOS,DAM,size
1,0,0,0,402
0,1,0,0,121
0,0,0,1,108
1,1,0,0,96
0,0,1,0,74
1,0,0,1,58
1,0,1,0,41
0,1,0,1,27
0,1,1,0,33
1,1,1,0,18
1,1,1,1,9
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 10-upset.csv(0/1 成员矩阵 + 交集大小)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("10-upset.csv").sort_values("size", ascending=False).reset_index(drop=True)
sets = ["DEG", "DEP", "PHOS", "DAM"]
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(8.6, 5.2), sharex=True,
                               gridspec_kw=dict(height_ratios=[3, 1.15], hspace=0.06))
ax1.bar(df.index, df["size"], color="#4C72B0", width=0.62)
for i, v in df["size"].items():
    ax1.text(i, v + 8, str(int(v)), ha="center", fontsize=9)
ax1.set_ylabel("Intersection size")
for i, row in df.iterrows():
    on = [s for s in sets if row[s] == 1]
    ax2.plot([i, i], [sets.index(on[0]), sets.index(on[-1])], color="black", lw=1)
    for s in sets:
        ax2.scatter(i, sets.index(s), s=52 if s in on else 14,
                    color="black" if s in on else "0.85")
ax2.set_yticks(range(4), sets)
ax2.invert_yaxis()
ax2.set_xticks([])
ax2.grid(False)
fig.savefig("10-upset.png", dpi=200, bbox_inches="tight")
2.11 TPM 定量与文库分布图
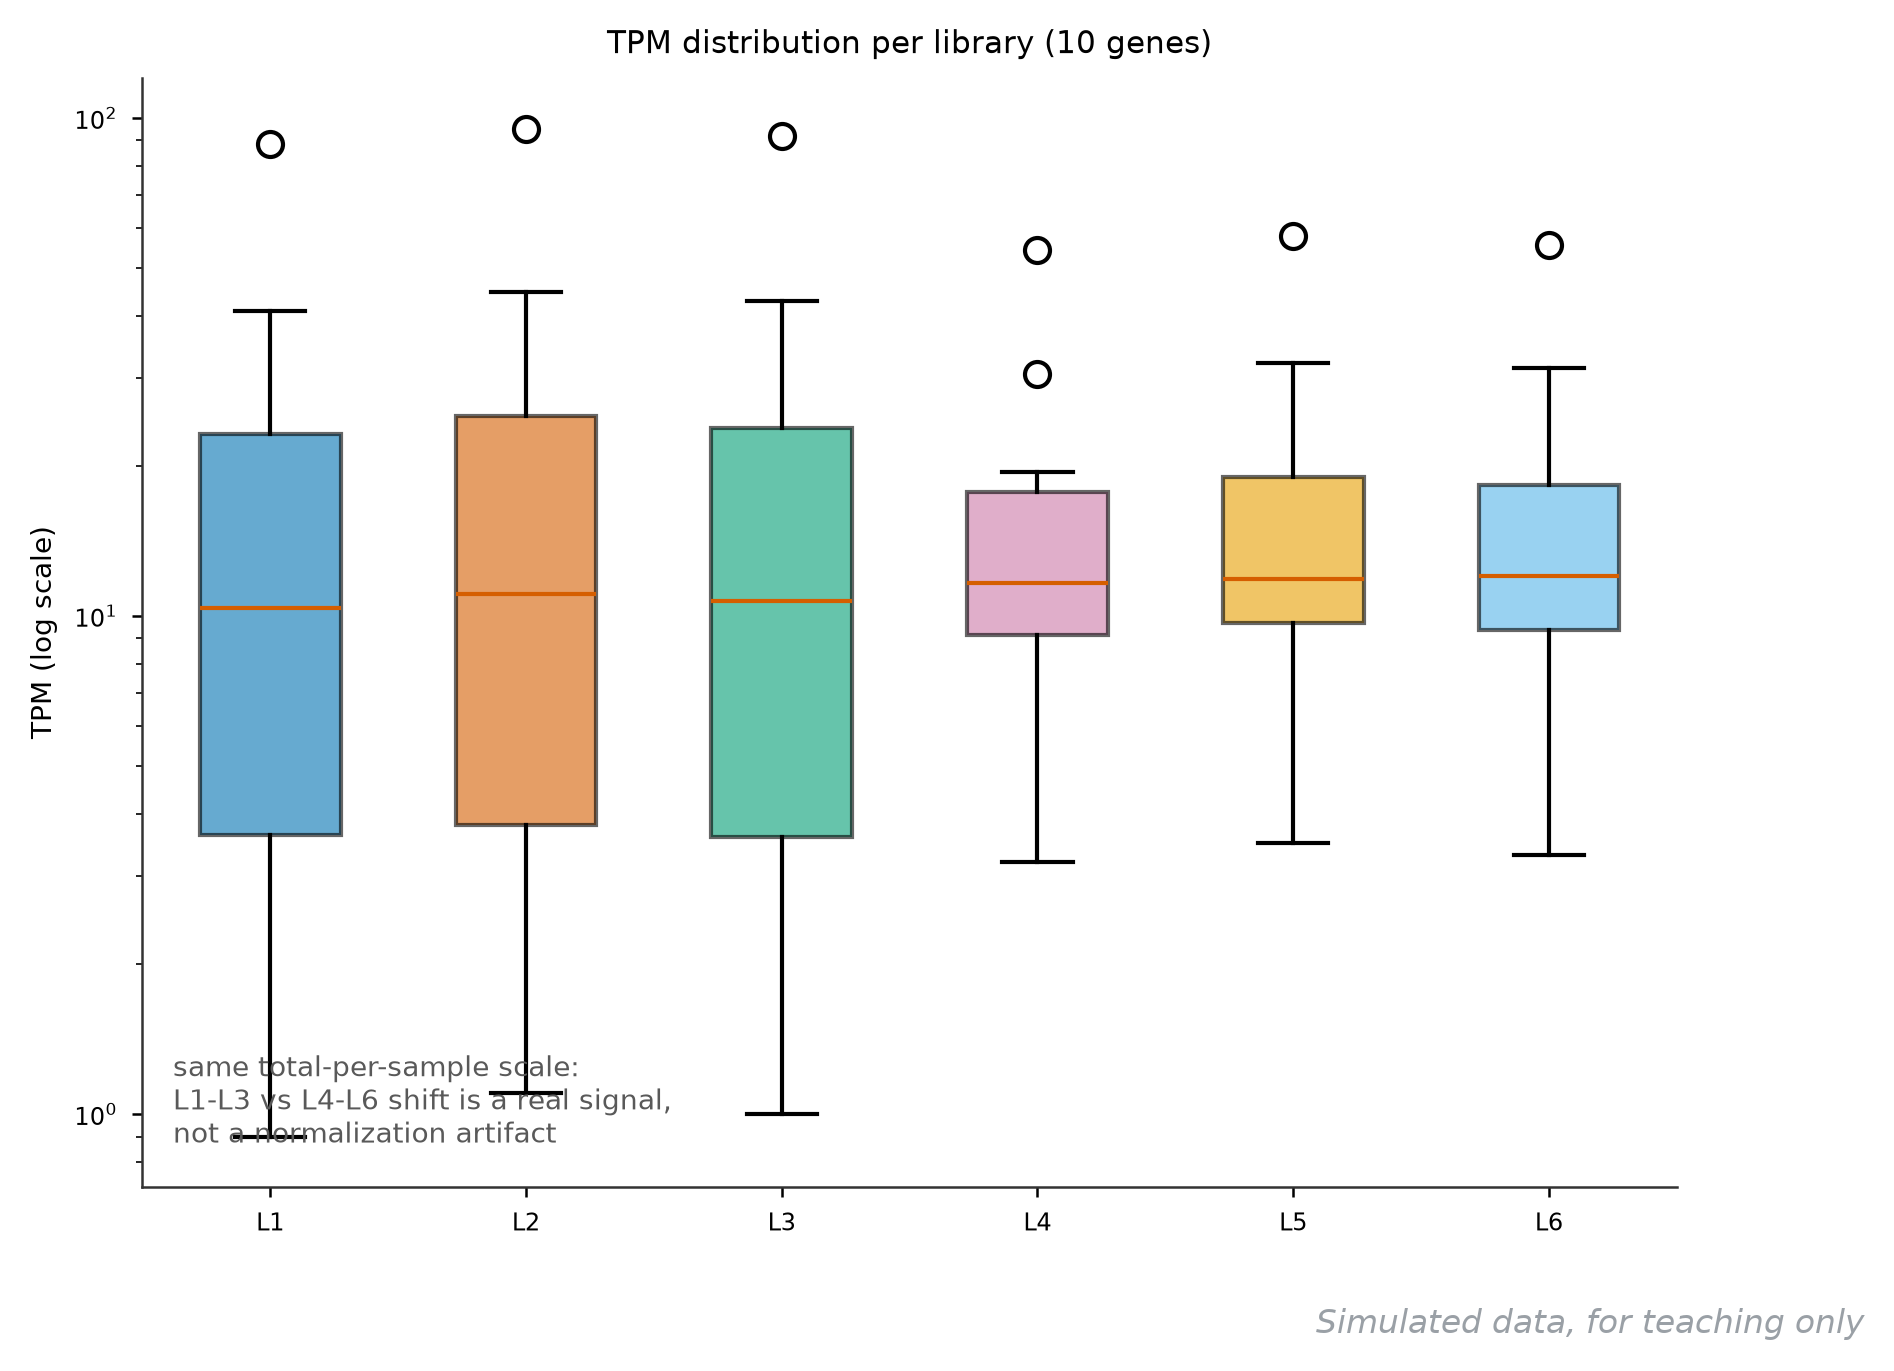
它回答什么问题:标准化之后的表达量处于什么量级、各文库分布是否可以比较——TPM 定量分析的质检位。
怎么读:每个箱是一个文库 10 个基因的 TPM 分布,纵轴取了对数(表达量横跨两个数量级是常态)。看两点:文库间分布形状是否一致(形状突变提示上机批次或 RNA 质量出问题);以及 L4-L6 这组整体向高表达偏移是真实生物学信号(这里是发育阶段切换),不是没归一化。TPM 只在样本内比基因、或同量级样本间粗比,跨样本严格比较请回到 counts 做 DESeq2。
用什么画:R 语言 ggplot2::geom_boxplot + scale_y_log10;Python 用 seaborn.boxplot 加 ax.set_yscale("log")。
图注示例:
图 11 六个文库的 TPM 分布(10 个候选基因)。纵轴为对数刻度;L1-L3 与 L4-L6 的整体偏移对应两个发育阶段。
展开查看:模拟数据与绘图代码
gene,L1,L2,L3,L4,L5,L6
DWF4,3.1,3.4,3.0,12.5,13.1,12.8
CHS,88.4,95.1,91.7,54.2,57.8,55.6
CHI,12.2,13.0,12.6,9.8,10.4,10.1
F3H,25.6,27.8,26.3,19.4,20.9,20.1
ANS,1.8,2.1,1.9,6.7,7.0,6.9
PAL,41.0,44.6,42.8,30.5,32.2,31.4
BZR1,8.5,9.1,8.8,11.2,10.8,11.5
DET2,5.2,5.0,5.4,8.9,9.4,9.1
FLS,15.9,17.2,16.4,12.1,12.9,12.5
ANR,0.9,1.1,1.0,3.2,3.5,3.3
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 11-tpm.csv(行=基因,列=文库)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("11-tpm.csv", index_col="gene")
fig, ax = plt.subplots(figsize=(6.6, 4.8))
bp = ax.boxplot([df[c] for c in df.columns], tick_labels=df.columns,
                patch_artist=True, widths=0.55)
colors = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860"]
for patch, col in zip(bp["boxes"], colors):
    patch.set_facecolor(col)
    patch.set_alpha(0.6)
ax.set_yscale("log")
ax.set_ylabel("TPM (log scale)")
fig.savefig("11-tpm-dist.png", dpi=200, bbox_inches="tight")
三、降维与聚类
3.1 PCA 得分图
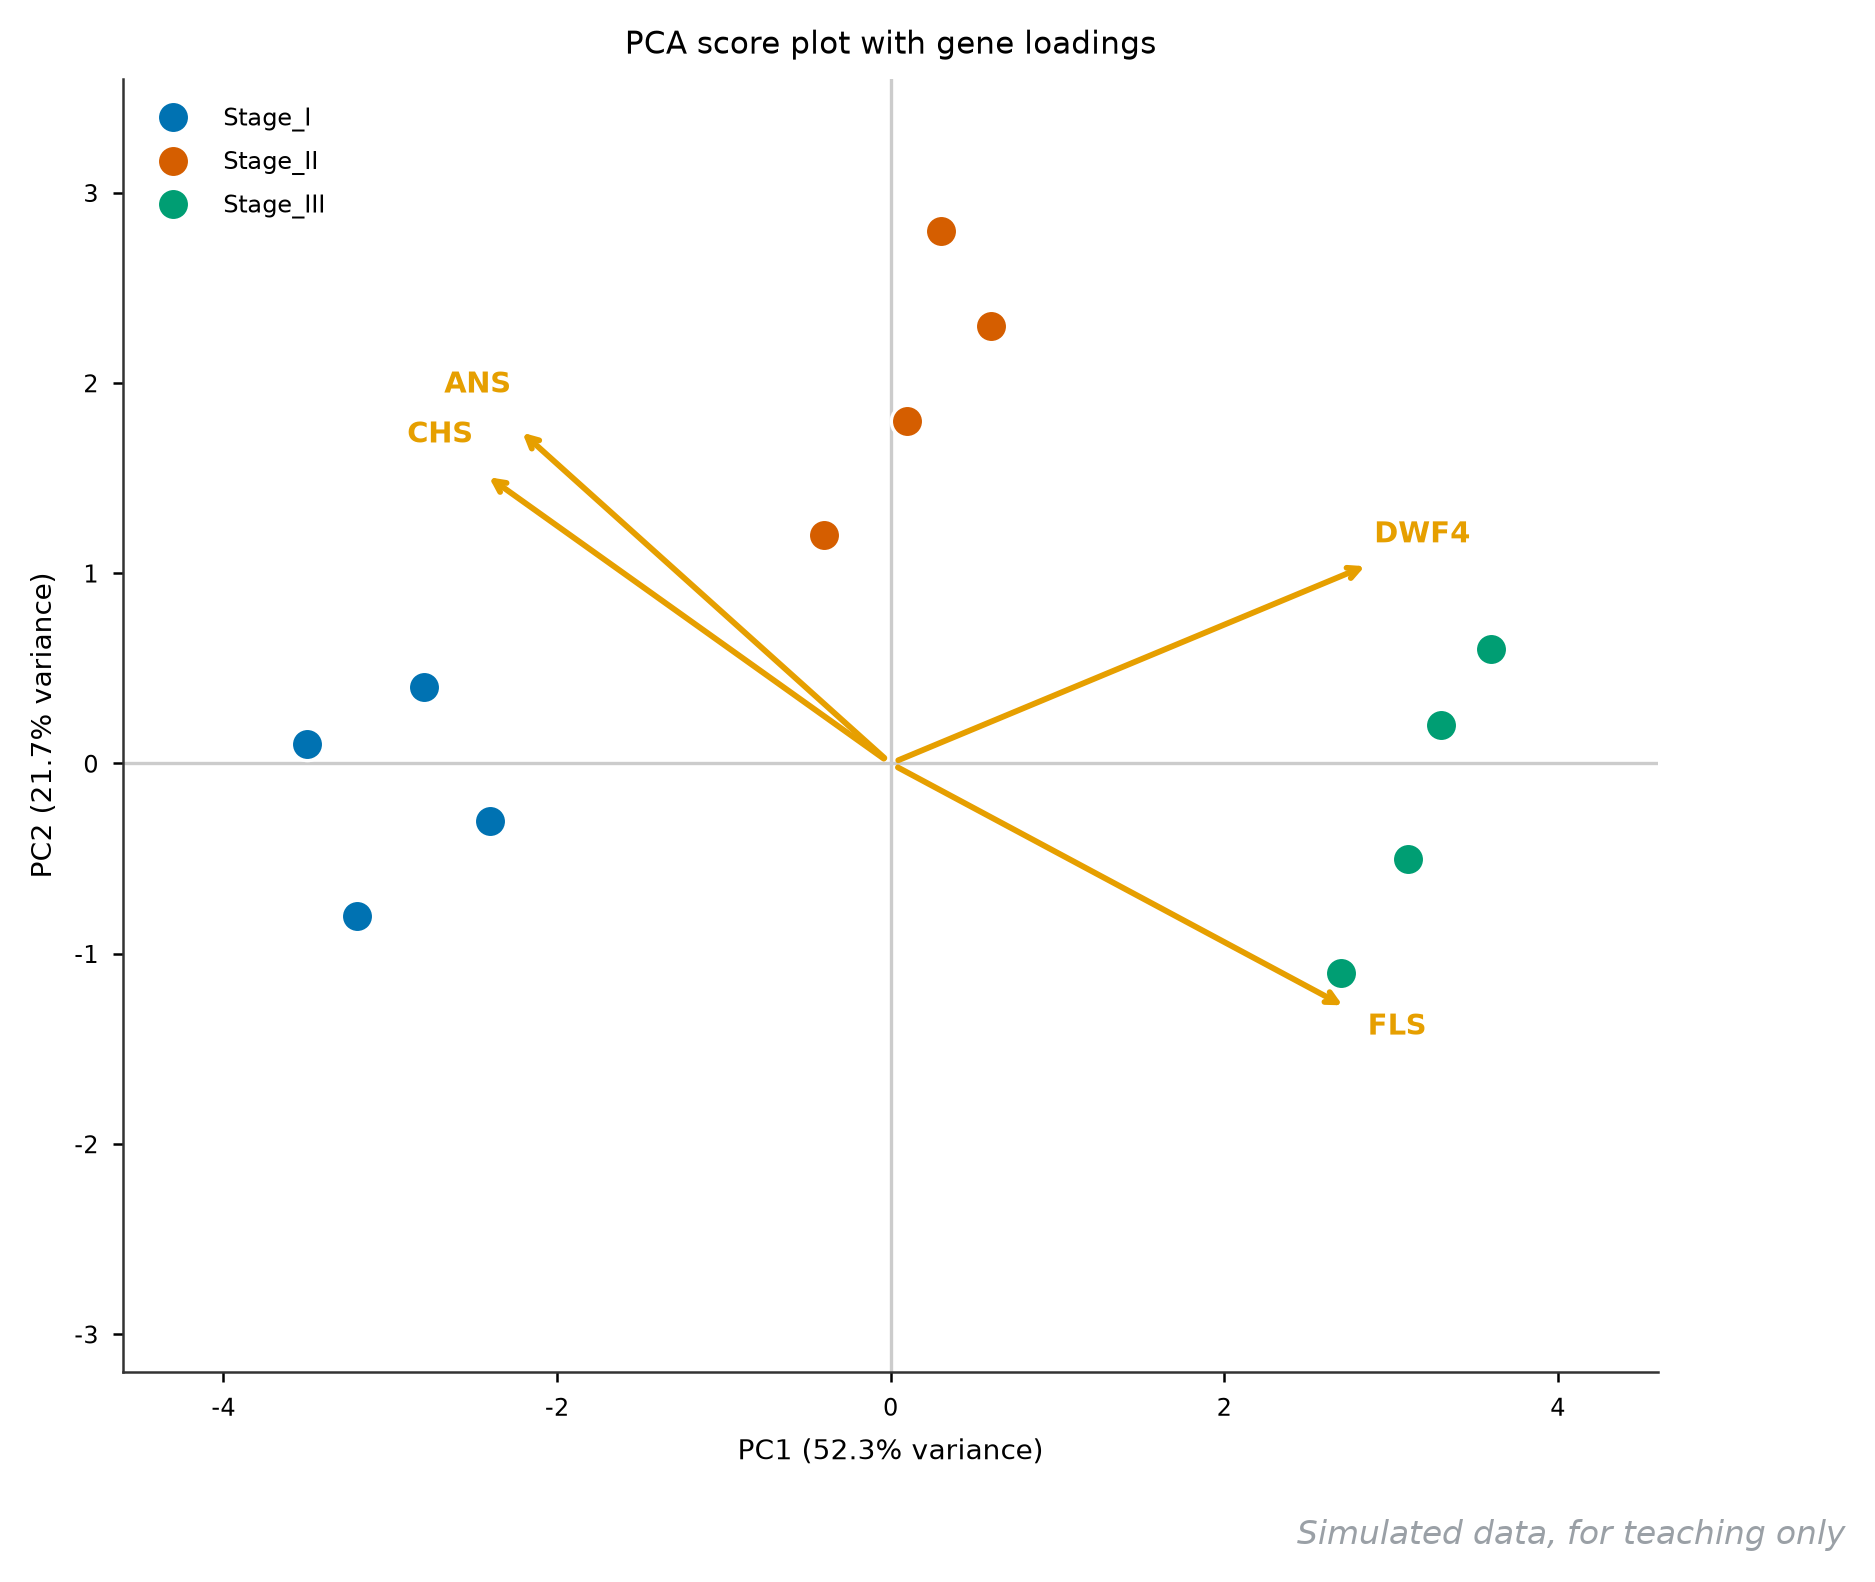
它回答什么问题:把全部基因的表达压成两三个主成分,看样本靠什么分开——批次、处理还是发育阶段。
怎么读:每个点是一个样本,坐标是它在 PC1/PC2 上的得分,轴标签里必须带方差解释率(这张图 PC1 = 52.3%,PC2 = 21.7%,两轴合计 74%,说明二维压缩没丢多少信息)。紫色箭头是载荷(loading),指哪边就说明哪边的样本在那个基因上高表达:Stage_I 被 CHS、ANS 拉向左,Stage_III 被 DWF4、FLS 拉向右。样本点应按生物学分组聚拢,若按测序批次聚拢就是批次效应没除干净。
用什么画:R 语言 FactoMineR::PCA 加 factoextra::fviz_pca_biplot;Python 用 sklearn.decomposition.PCA 加手绘箭头。
图注示例:
图 12 三个发育阶段转录本 PCA 得分图(n = 12)。PC1 与 PC2 分别解释 52.3% 与 21.7% 的方差;箭头为载荷绝对值前四的基因。
展开查看:模拟数据(样本得分 CSV)
sample,group,PC1,PC2
Z1_r1,Stage_I,-3.2,-0.8
Z1_r2,Stage_I,-2.8,0.4
Z1_r3,Stage_I,-3.5,0.1
Z1_r4,Stage_I,-2.4,-0.3
Z2_r1,Stage_II,0.1,1.8
Z2_r2,Stage_II,0.6,2.3
Z2_r3,Stage_II,-0.4,1.2
Z2_r4,Stage_II,0.3,2.8
Z3_r1,Stage_III,3.1,-0.5
Z3_r2,Stage_III,3.6,0.6
Z3_r3,Stage_III,2.7,-1.1
Z3_r4,Stage_III,3.3,0.2
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 12-pca.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("12-pca.csv")
CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig, ax = plt.subplots(figsize=(6.6, 5.6))
for i, g in enumerate(df.group.unique()):
    sub = df[df.group == g]
    ax.scatter(sub.PC1, sub.PC2, s=60, color=CAT[i], edgecolors="white", label=g)
for gene, lx, ly in [("DWF4", 0.85, 0.31), ("CHS", -0.72, 0.45),
                     ("FLS", 0.81, -0.38), ("ANS", -0.66, 0.52)]:
    ax.annotate("", xy=(lx * 3.4, ly * 3.4), xytext=(0, 0),
                arrowprops=dict(arrowstyle="->", color="#8172B3", lw=1.4))
    ax.text(lx * 3.75, ly * 3.75, gene, color="#8172B3", fontsize=9,
            ha="center", fontweight="bold")
ax.axhline(0, color="0.8", lw=0.8)
ax.axvline(0, color="0.8", lw=0.8)
ax.set_xlabel("PC1 (52.3% variance)")
ax.set_ylabel("PC2 (21.7% variance)")
ax.legend()
fig.savefig("12-pca.png", dpi=200, bbox_inches="tight")
3.2 UMAP 降维图
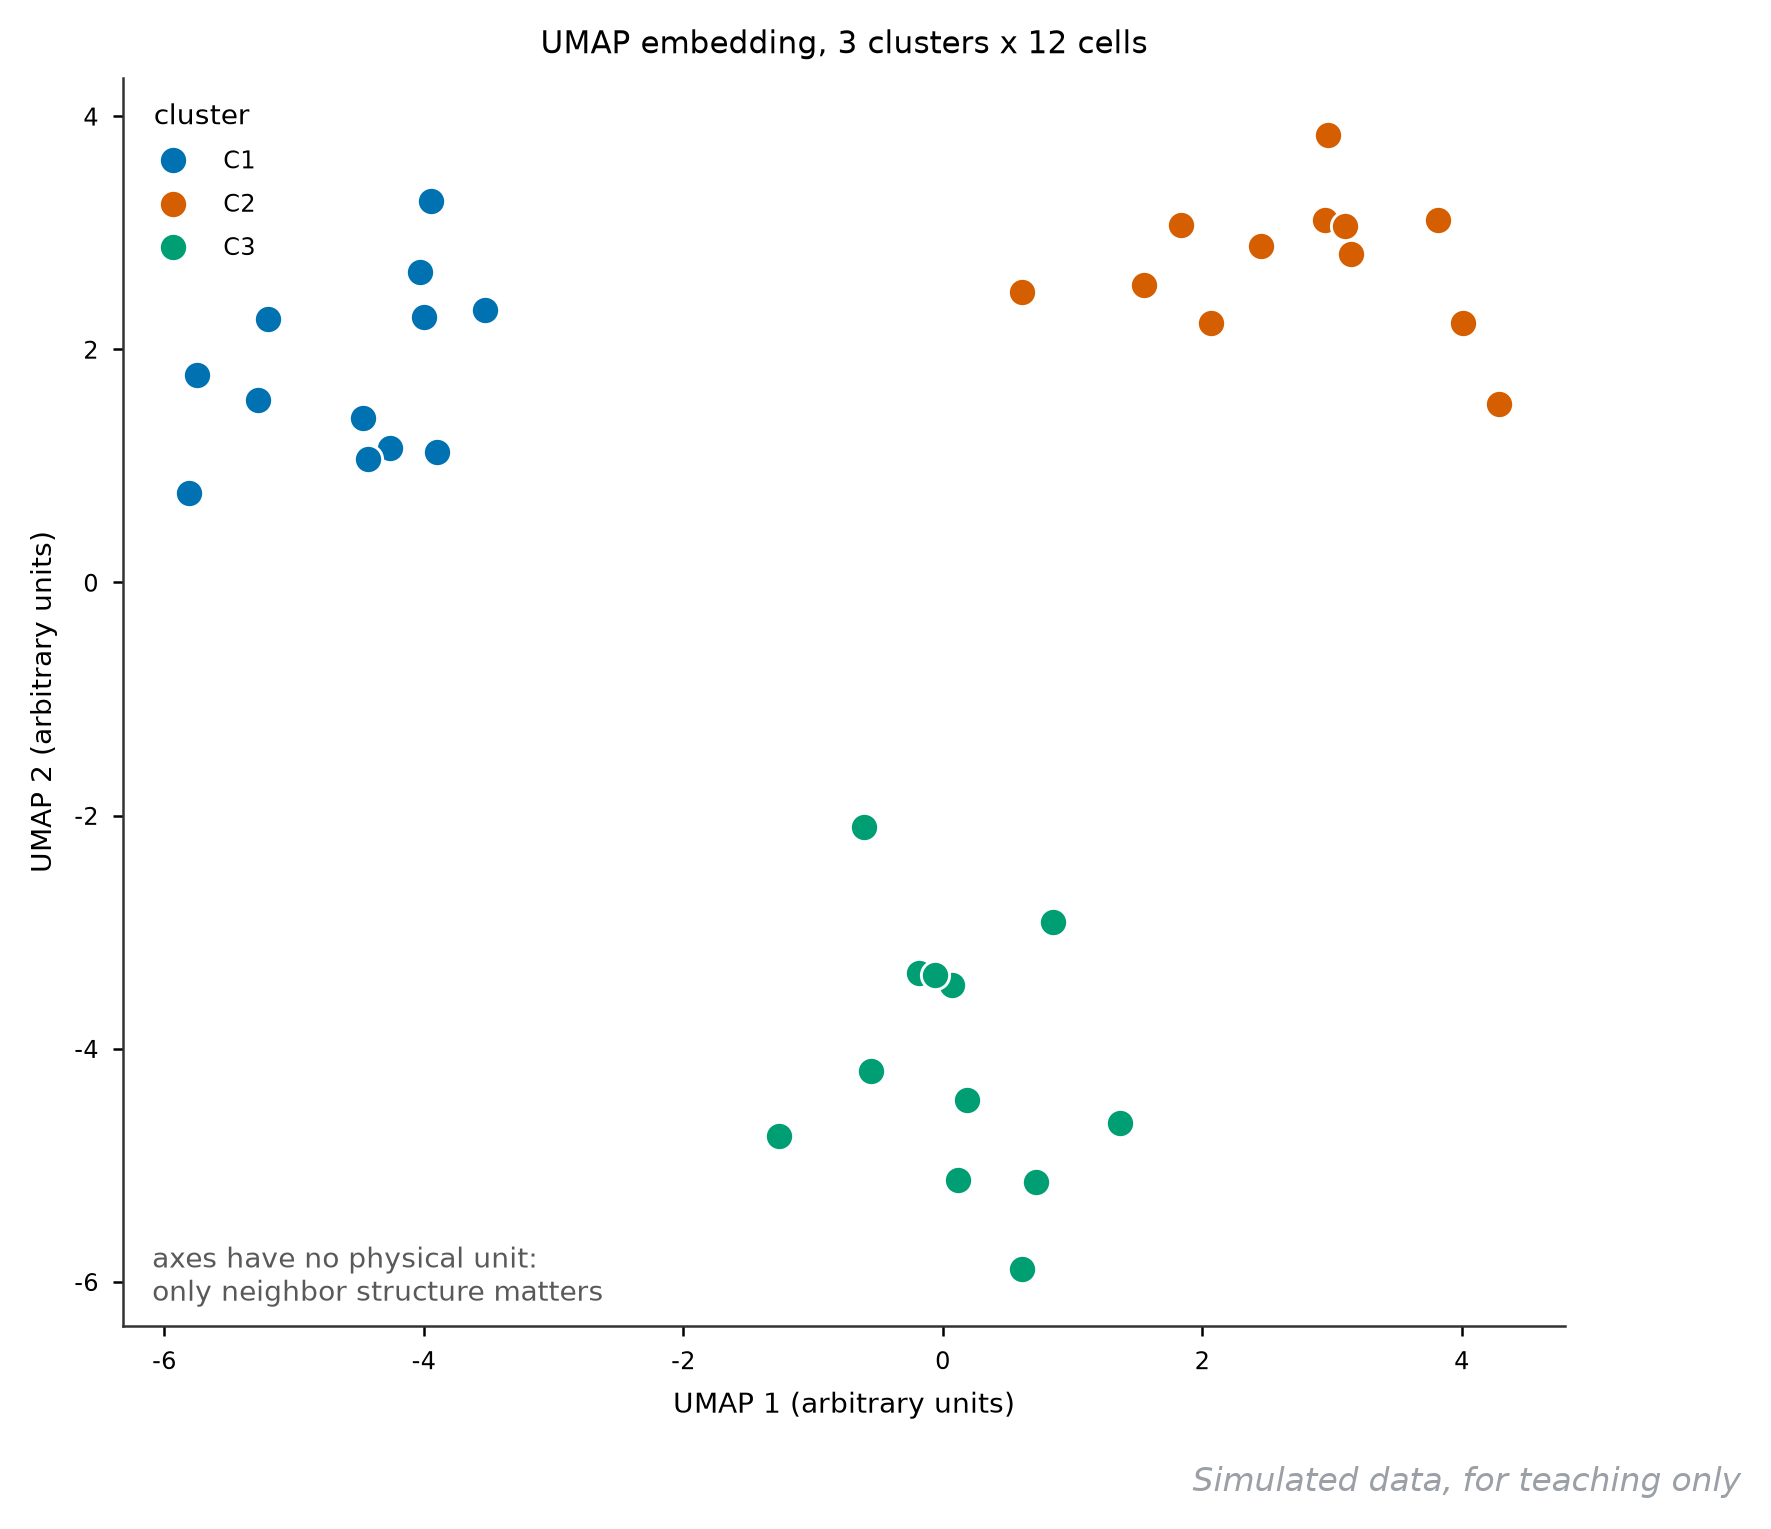
它回答什么问题:单细胞或高维数据的邻域结构——谁跟谁是邻居,簇与簇之间隔多远。
怎么读:每个点是一个细胞(或样本),颜色是已知的分组或聚类标签。横纵轴是任意单位的嵌入坐标,只有「相对位置」有意义,轴刻度数字没有生物学含义——这是 PCA 图和 UMAP 图最大的读图区别。簇内连片、簇间有空隙才叫分得开;若一簇拖成长条贴着另一簇,要怀疑参数(n_neighbors、min_dist)调猛了。
用什么画:Python scanpy.tl.umap(单细胞标准流程)或 umap-learn 包;R 语言 uwot::umap。
图注示例:
图 13 36 个单细胞转录组的 UMAP 嵌入。颜色为 Louvain 聚类标签;坐标为任意单位,仅反映相对邻域关系。
展开查看:模拟数据(细胞坐标 CSV)
cell,cluster,UMAP1,UMAP2
c1,C1,-4.00,2.28
c2,C1,-4.26,1.15
c3,C1,-4.43,1.06
c4,C1,-3.94,3.27
c5,C1,-4.47,1.41
c6,C1,-3.53,2.34
c7,C1,-3.90,1.12
c8,C1,-4.03,2.66
c9,C1,-5.28,1.57
c10,C1,-5.81,0.77
c11,C1,-5.75,1.78
c12,C1,-5.20,2.26
c13,C2,3.15,2.82
c14,C2,0.61,2.49
c15,C2,2.95,3.11
c16,C2,1.55,2.55
c17,C2,2.07,2.23
c18,C2,4.01,2.23
c19,C2,2.97,3.84
c20,C2,2.45,2.89
c21,C2,3.10,3.06
c22,C2,1.84,3.07
c23,C2,4.29,1.53
c24,C2,3.82,3.11
c25,C3,-0.61,-2.10
c26,C3,0.72,-5.14
c27,C3,0.07,-3.45
c28,C3,-0.18,-3.35
c29,C3,-0.06,-3.37
c30,C3,1.37,-4.64
c31,C3,0.19,-4.44
c32,C3,0.12,-5.13
c33,C3,-0.55,-4.19
c34,C3,0.85,-2.91
c35,C3,-1.26,-4.75
c36,C3,0.61,-5.89
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 13-umap.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("13-umap.csv")
CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig, ax = plt.subplots(figsize=(6.2, 5.4))
for i, c in enumerate(df.cluster.unique()):
    sub = df[df.cluster == c]
    ax.scatter(sub.UMAP1, sub.UMAP2, s=46, color=CAT[i], edgecolors="white", label=c)
ax.set_xlabel("UMAP 1 (arbitrary units)")
ax.set_ylabel("UMAP 2 (arbitrary units)")
ax.legend(title="cluster")
fig.savefig("13-umap.png", dpi=200, bbox_inches="tight")
3.3 层次聚类树 + 热图
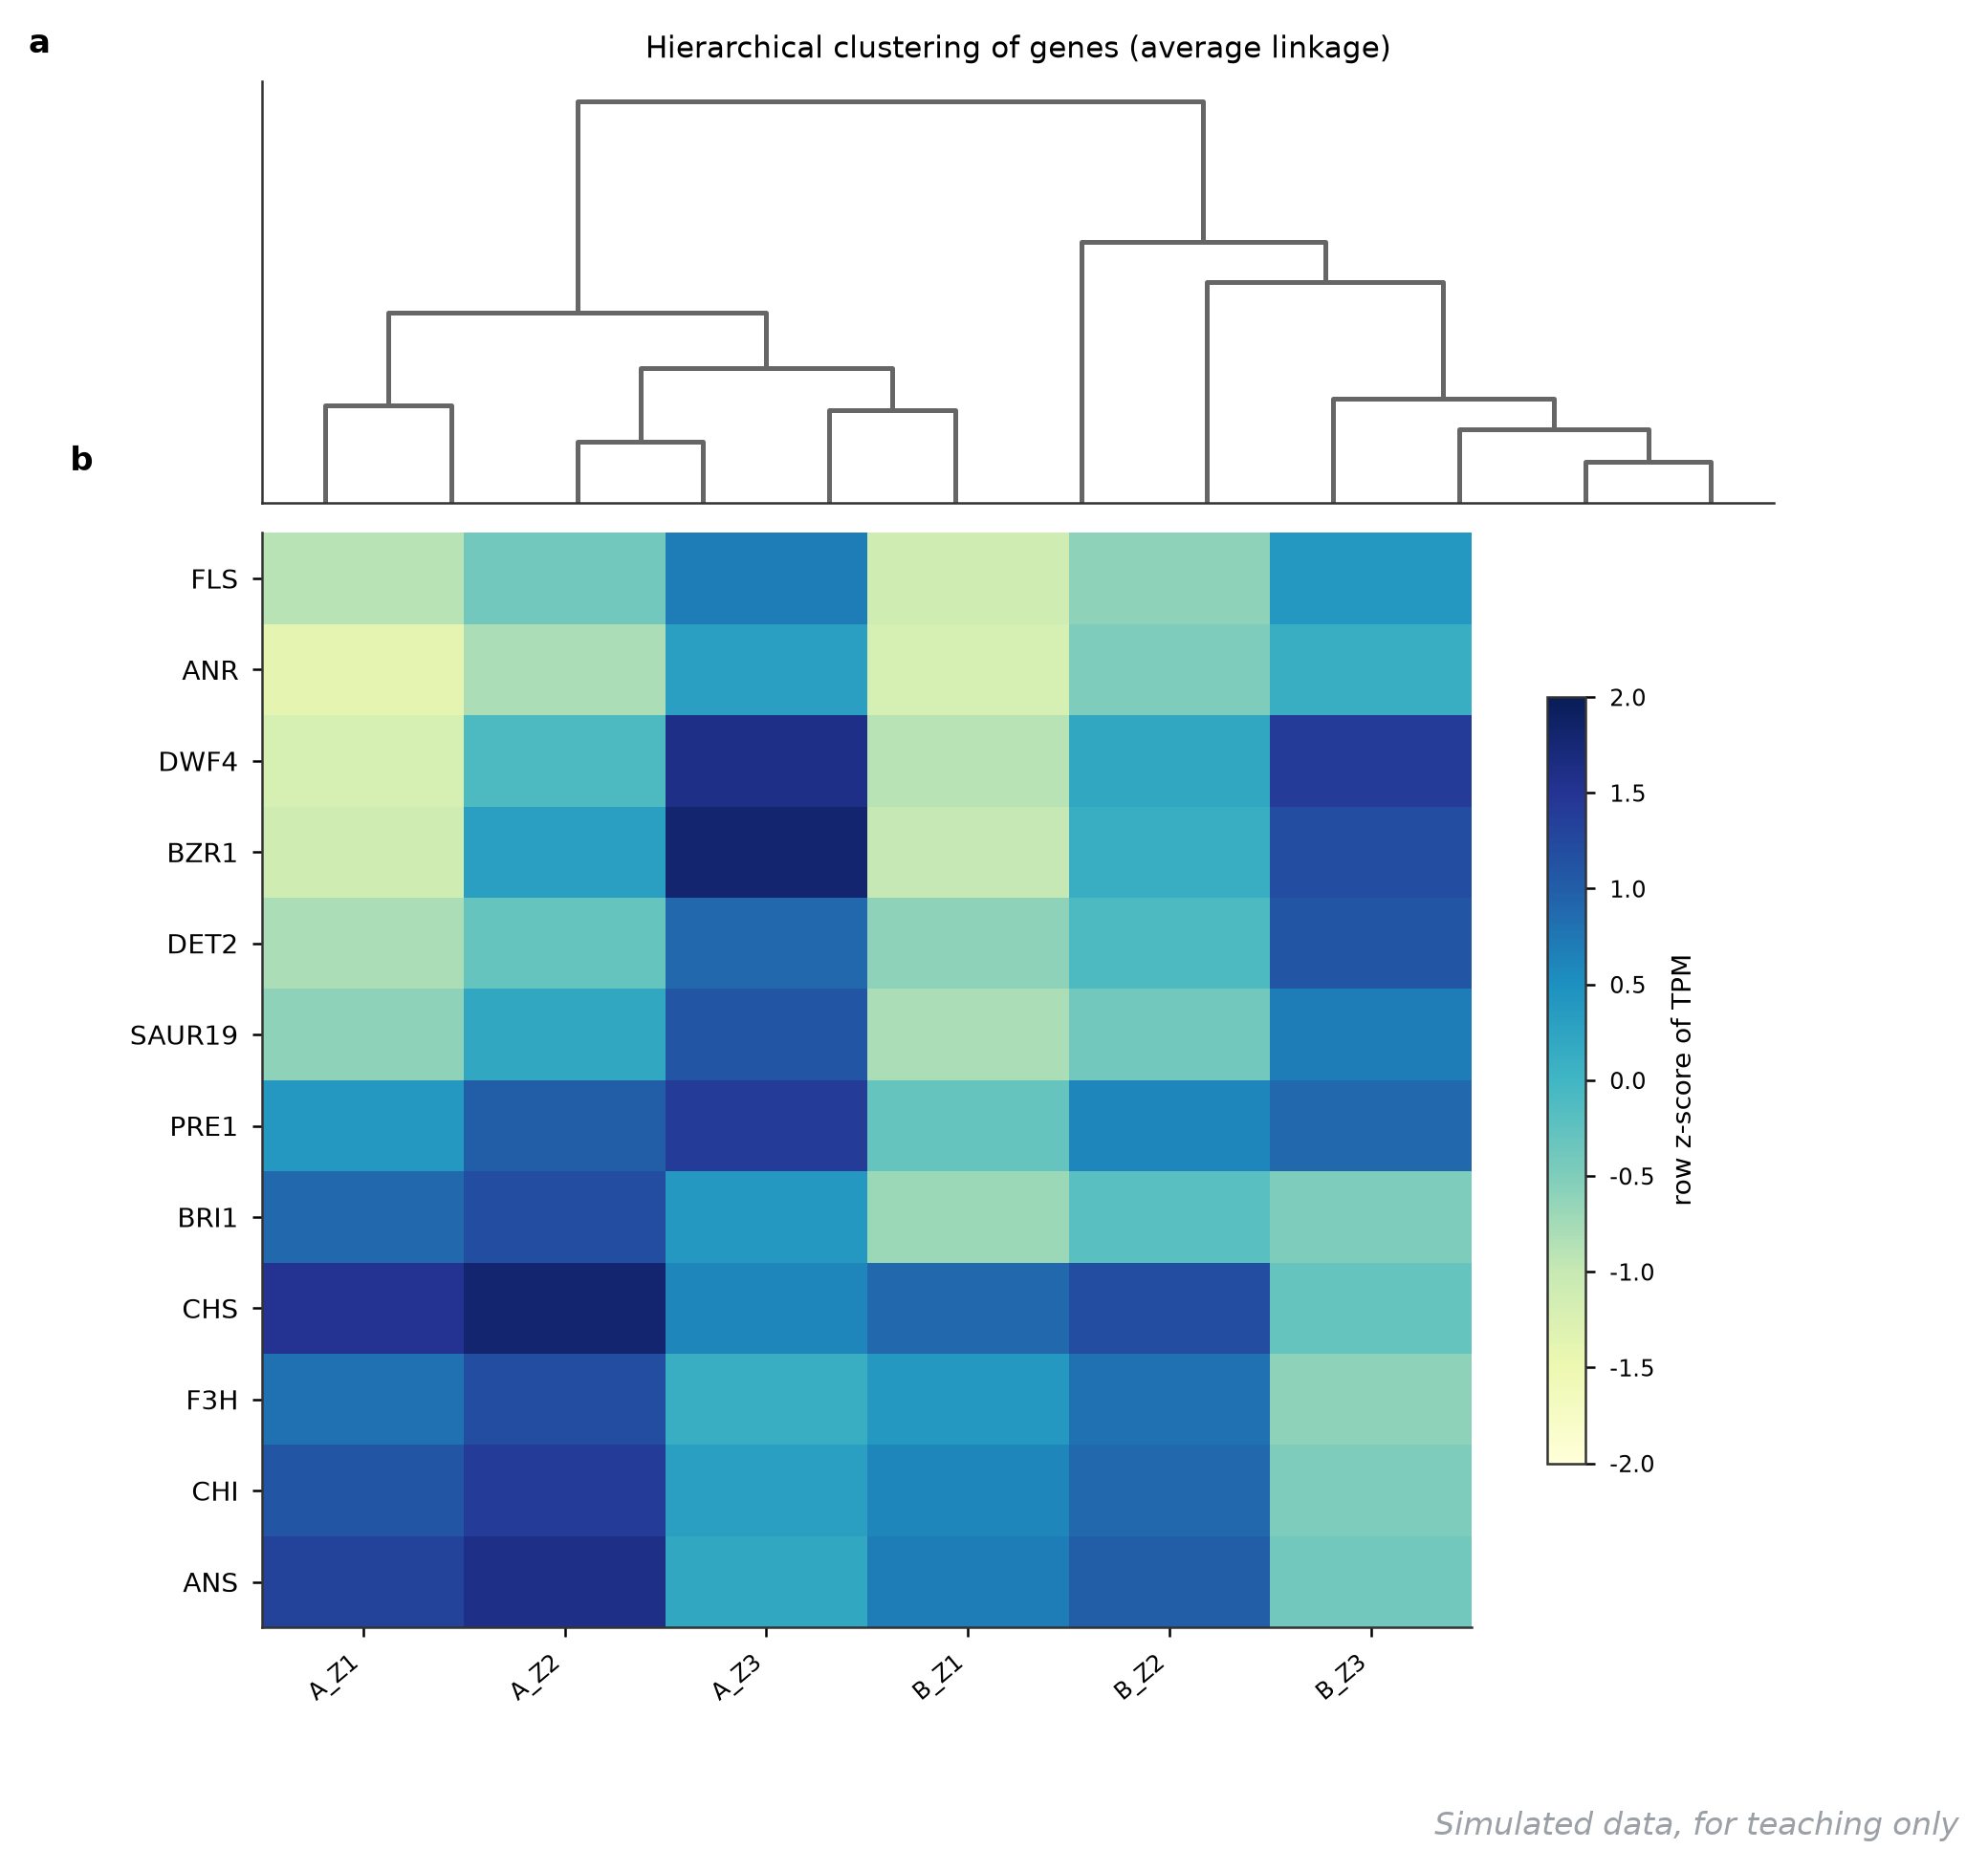
它回答什么问题:基因按表达模式自动分成几伙,树状图把「谁和谁更像」画成谱系。
怎么读:上方树状图是行(基因)聚类,枝越高表示两个基因的表达模式差异越大;热图行序按树重新排过,所以相似基因会贴在一起形成色带。看两处:第一层分叉把基因分成两大支(这里黄酮合成 vs BR 相关基因),以及选择在哪里「剪树」得到几簇——剪在 0.6 倍树高处和 0.3 倍得到的簇数完全不同,图注要交代聚类方法与距离(这张图是平均连锁 + 欧氏距离)。
用什么画:R 语言 pheatmap(cluster_rows=TRUE) 一行搞定;Python 用 seaborn.clustermap,底层都是 scipy.cluster.hierarchy。
图注示例:
图 14 候选基因层次聚类热图。行聚类采用平均连锁法与欧氏距离;颜色为行内 z-score,右侧为基因名。
展开查看:绘图代码(Python,独立可运行,数据复用 2.2 节)
# 数据:与 2.2 节的 02-heatmap.csv 完全相同
import pandas as pd
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import linkage, dendrogram

df = pd.read_csv("02-heatmap.csv", index_col="gene")
Z = linkage(df.values, method="average", metric="euclidean")
fig = plt.figure(figsize=(6.8, 7.0))
gs = fig.add_gridspec(2, 1, height_ratios=[1, 2.6], hspace=0.04)
axd = fig.add_subplot(gs[0])
dd = dendrogram(Z, ax=axd, no_labels=True, color_threshold=0,
                link_color_func=lambda k: "0.4")
axd.set_yticks([])
axd.grid(False)
axh = fig.add_subplot(gs[1])
order = dd["leaves"]
im = axh.imshow(df.values[order], cmap="YlGnBu", vmin=-2, vmax=2, aspect="auto")
axh.set_xticks(range(df.shape[1]), df.columns, rotation=40, ha="right")
axh.set_yticks(range(len(order)), [df.index[i] for i in order], fontsize=8.5)
axh.grid(False)
fig.colorbar(im, ax=axh, shrink=0.7, label="row z-score of TPM")
fig.savefig("14-dendro-heatmap.png", dpi=200, bbox_inches="tight")
四、富集分析
4.1 KEGG 富集气泡图
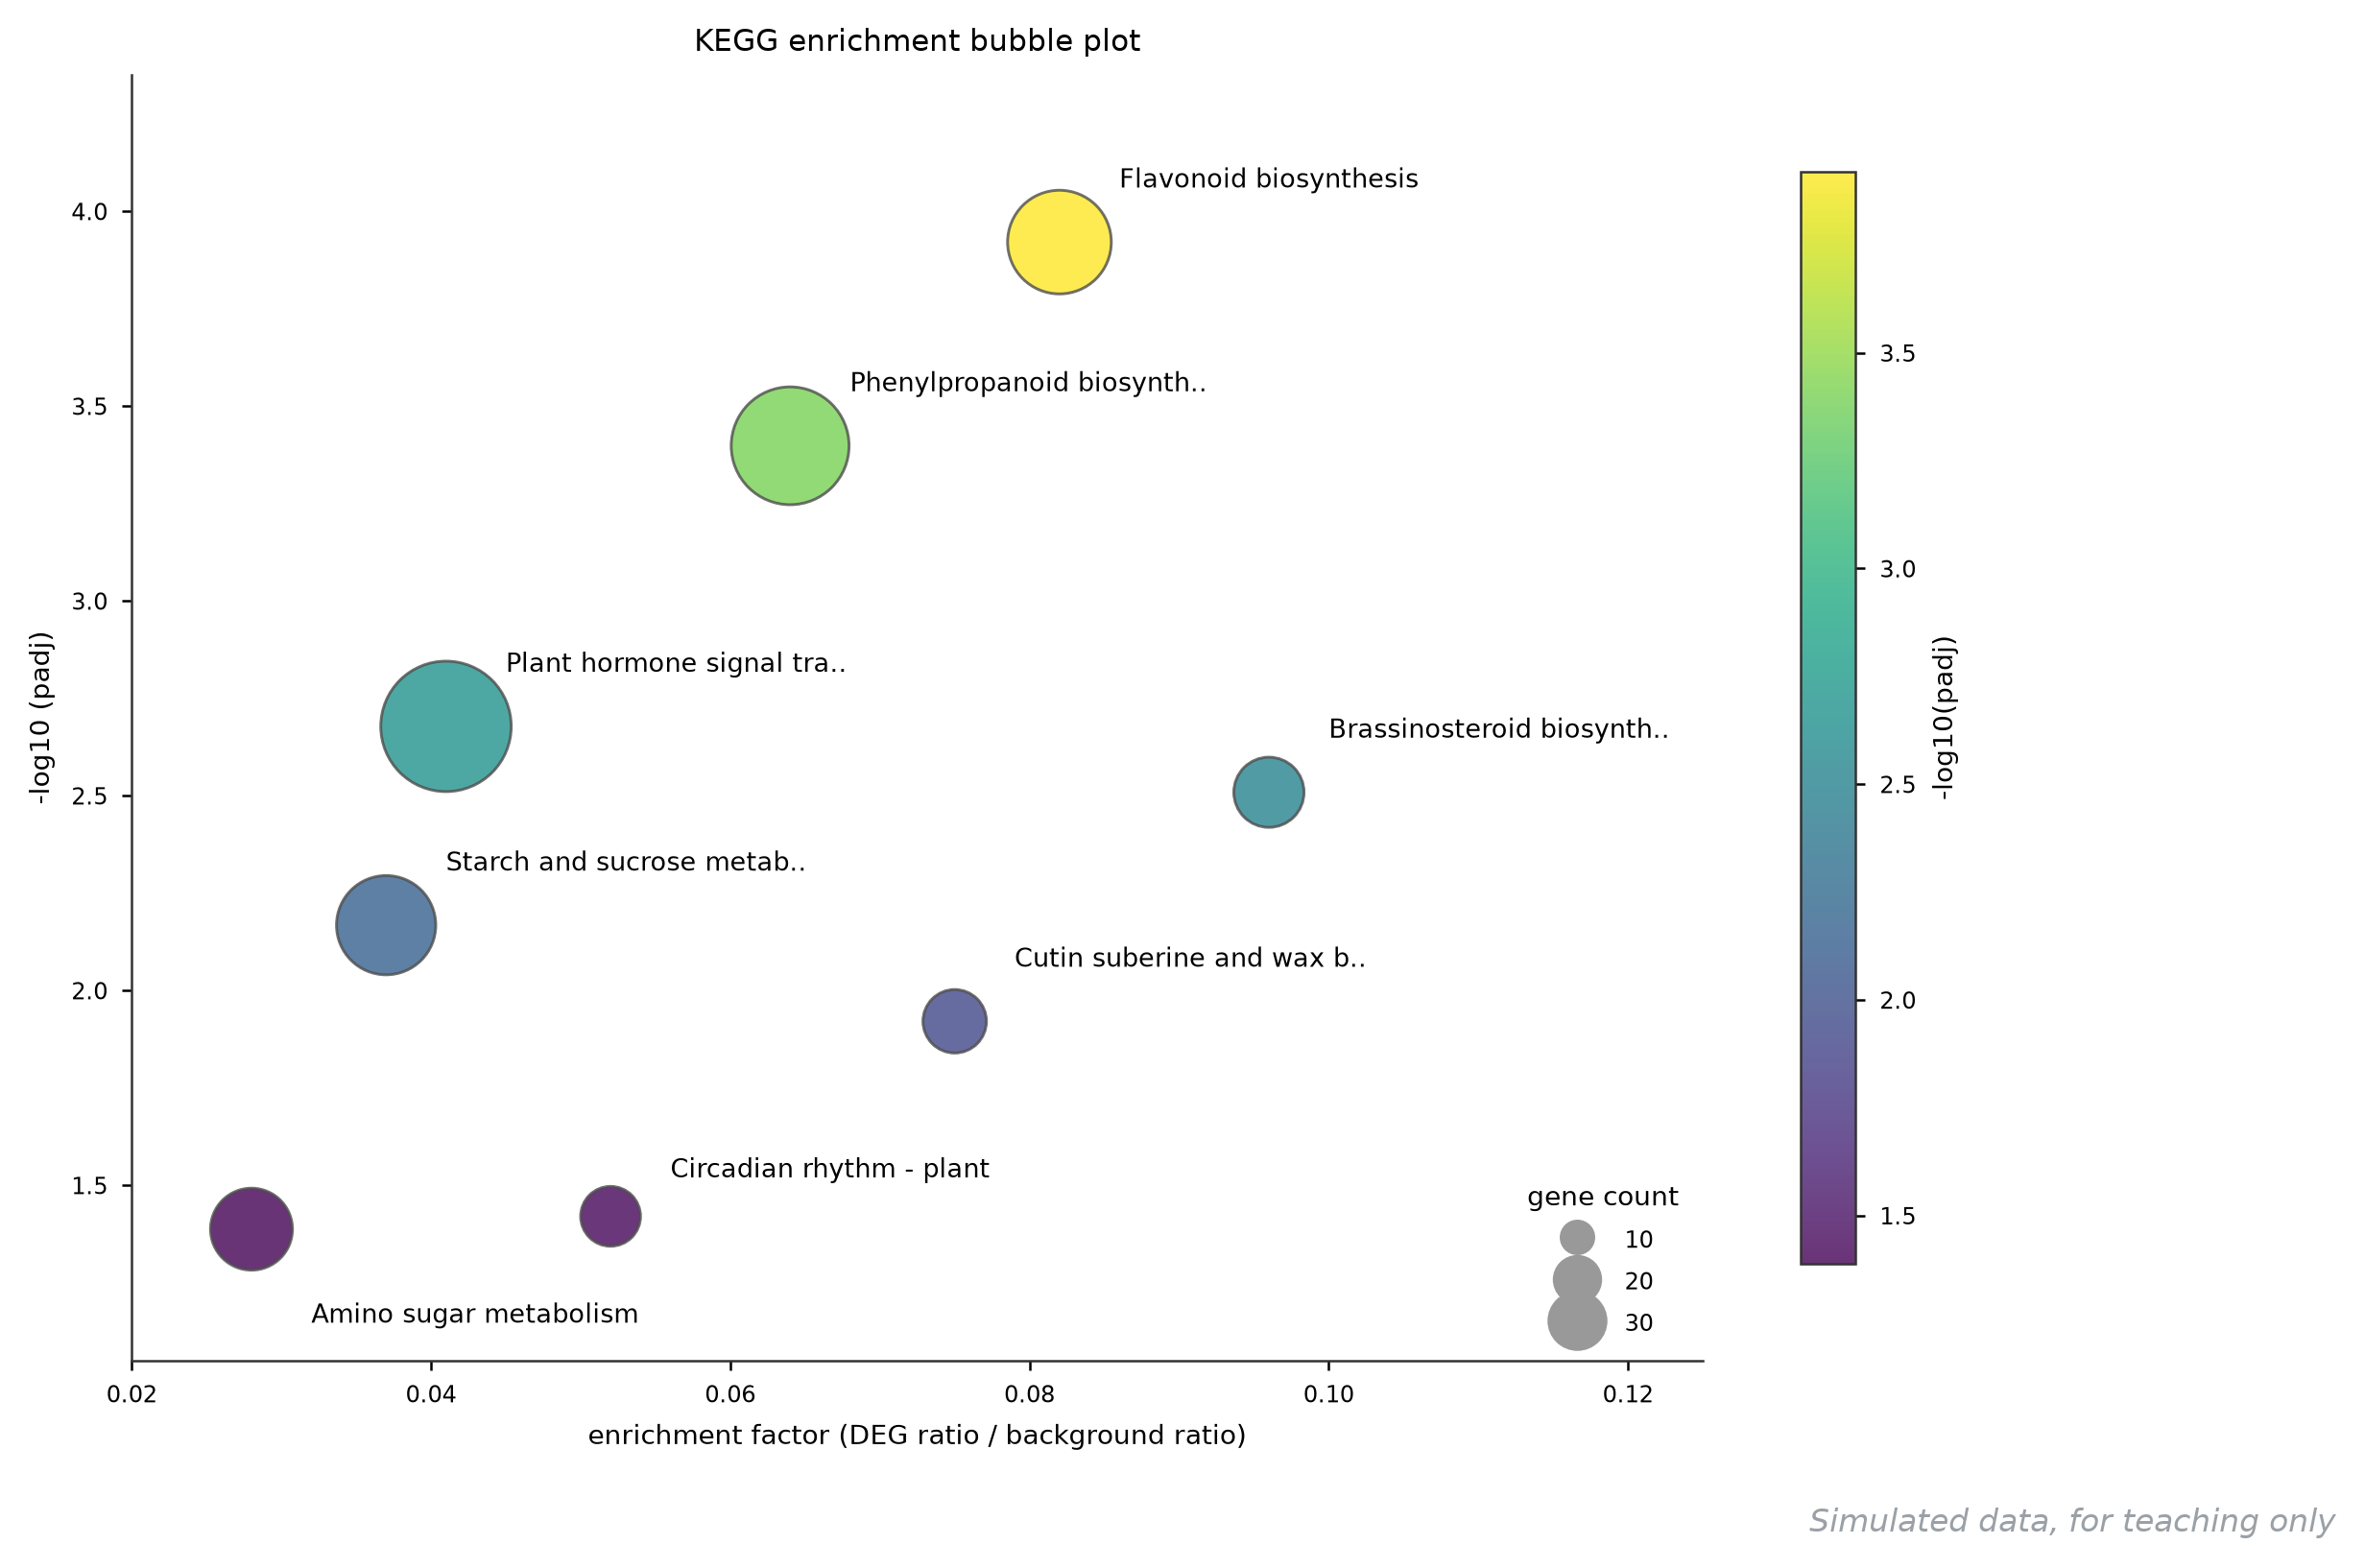
它回答什么问题:差异基因落在哪些通路上、富集到什么强度,转录组文章出镜率最高的一张图。
怎么读:四个编码一次记牢——横轴富集因子(差异基因里落在通路的比值除以全基因组的背景比值,越大越好)、纵轴 -log10(padj)(越高越显著)、点大小是通路里命中的基因数、颜色也是 -log10(padj)(与纵轴冗余,专为快速扫图)。右上角的点就是黄金通路:黄酮生物合成(0.082、padj = 0.00012)无论从位置还是大小都赢。左下角 padj 接近 0.05 的通路只能说「擦边」,别写进结论。
用什么画:R 语言 clusterProfiler::dotplot;Python 用 matplotlib scatter 加 s=count。代表图完整代码如下。
展开查看:模拟数据(CSV)
pathway,enrich_factor,count,padj
Flavonoid biosynthesis,0.082,24,0.00012
Brassinosteroid biosynthesis,0.096,11,0.0031
Phenylpropanoid biosynthesis,0.064,31,0.00040
Plant hormone signal transduction,0.041,38,0.0021
Cutin suberine and wax biosynthesis,0.075,9,0.012
Starch and sucrose metabolism,0.037,22,0.0068
Circadian rhythm - plant,0.052,8,0.038
Amino sugar metabolism,0.028,15,0.041
展开查看:完整绘图代码(Python matplotlib)
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd

df = pd.read_csv("kegg.csv")
y = -np.log10(df.padj)

fig, ax = plt.subplots(figsize=(8.8, 5.8))
sc = ax.scatter(df.enrich_factor, y, s=df["count"] * 28, c=y,
                cmap="viridis", alpha=0.8, edgecolors="0.3")
for name, xe, ye in zip(df.pathway, df.enrich_factor, y):
    ax.annotate(name[:24], (xe, ye), (xe + 0.004, ye + 0.14), fontsize=8)
ax.set_xlabel("enrichment factor (DEG ratio / background ratio)")
ax.set_ylabel("-log10 (padj)")
fig.colorbar(sc, label="-log10(padj)")
fig.savefig("16-kegg-bubble.png", dpi=200, bbox_inches="tight")
4.2 KEGG 富集柱形图
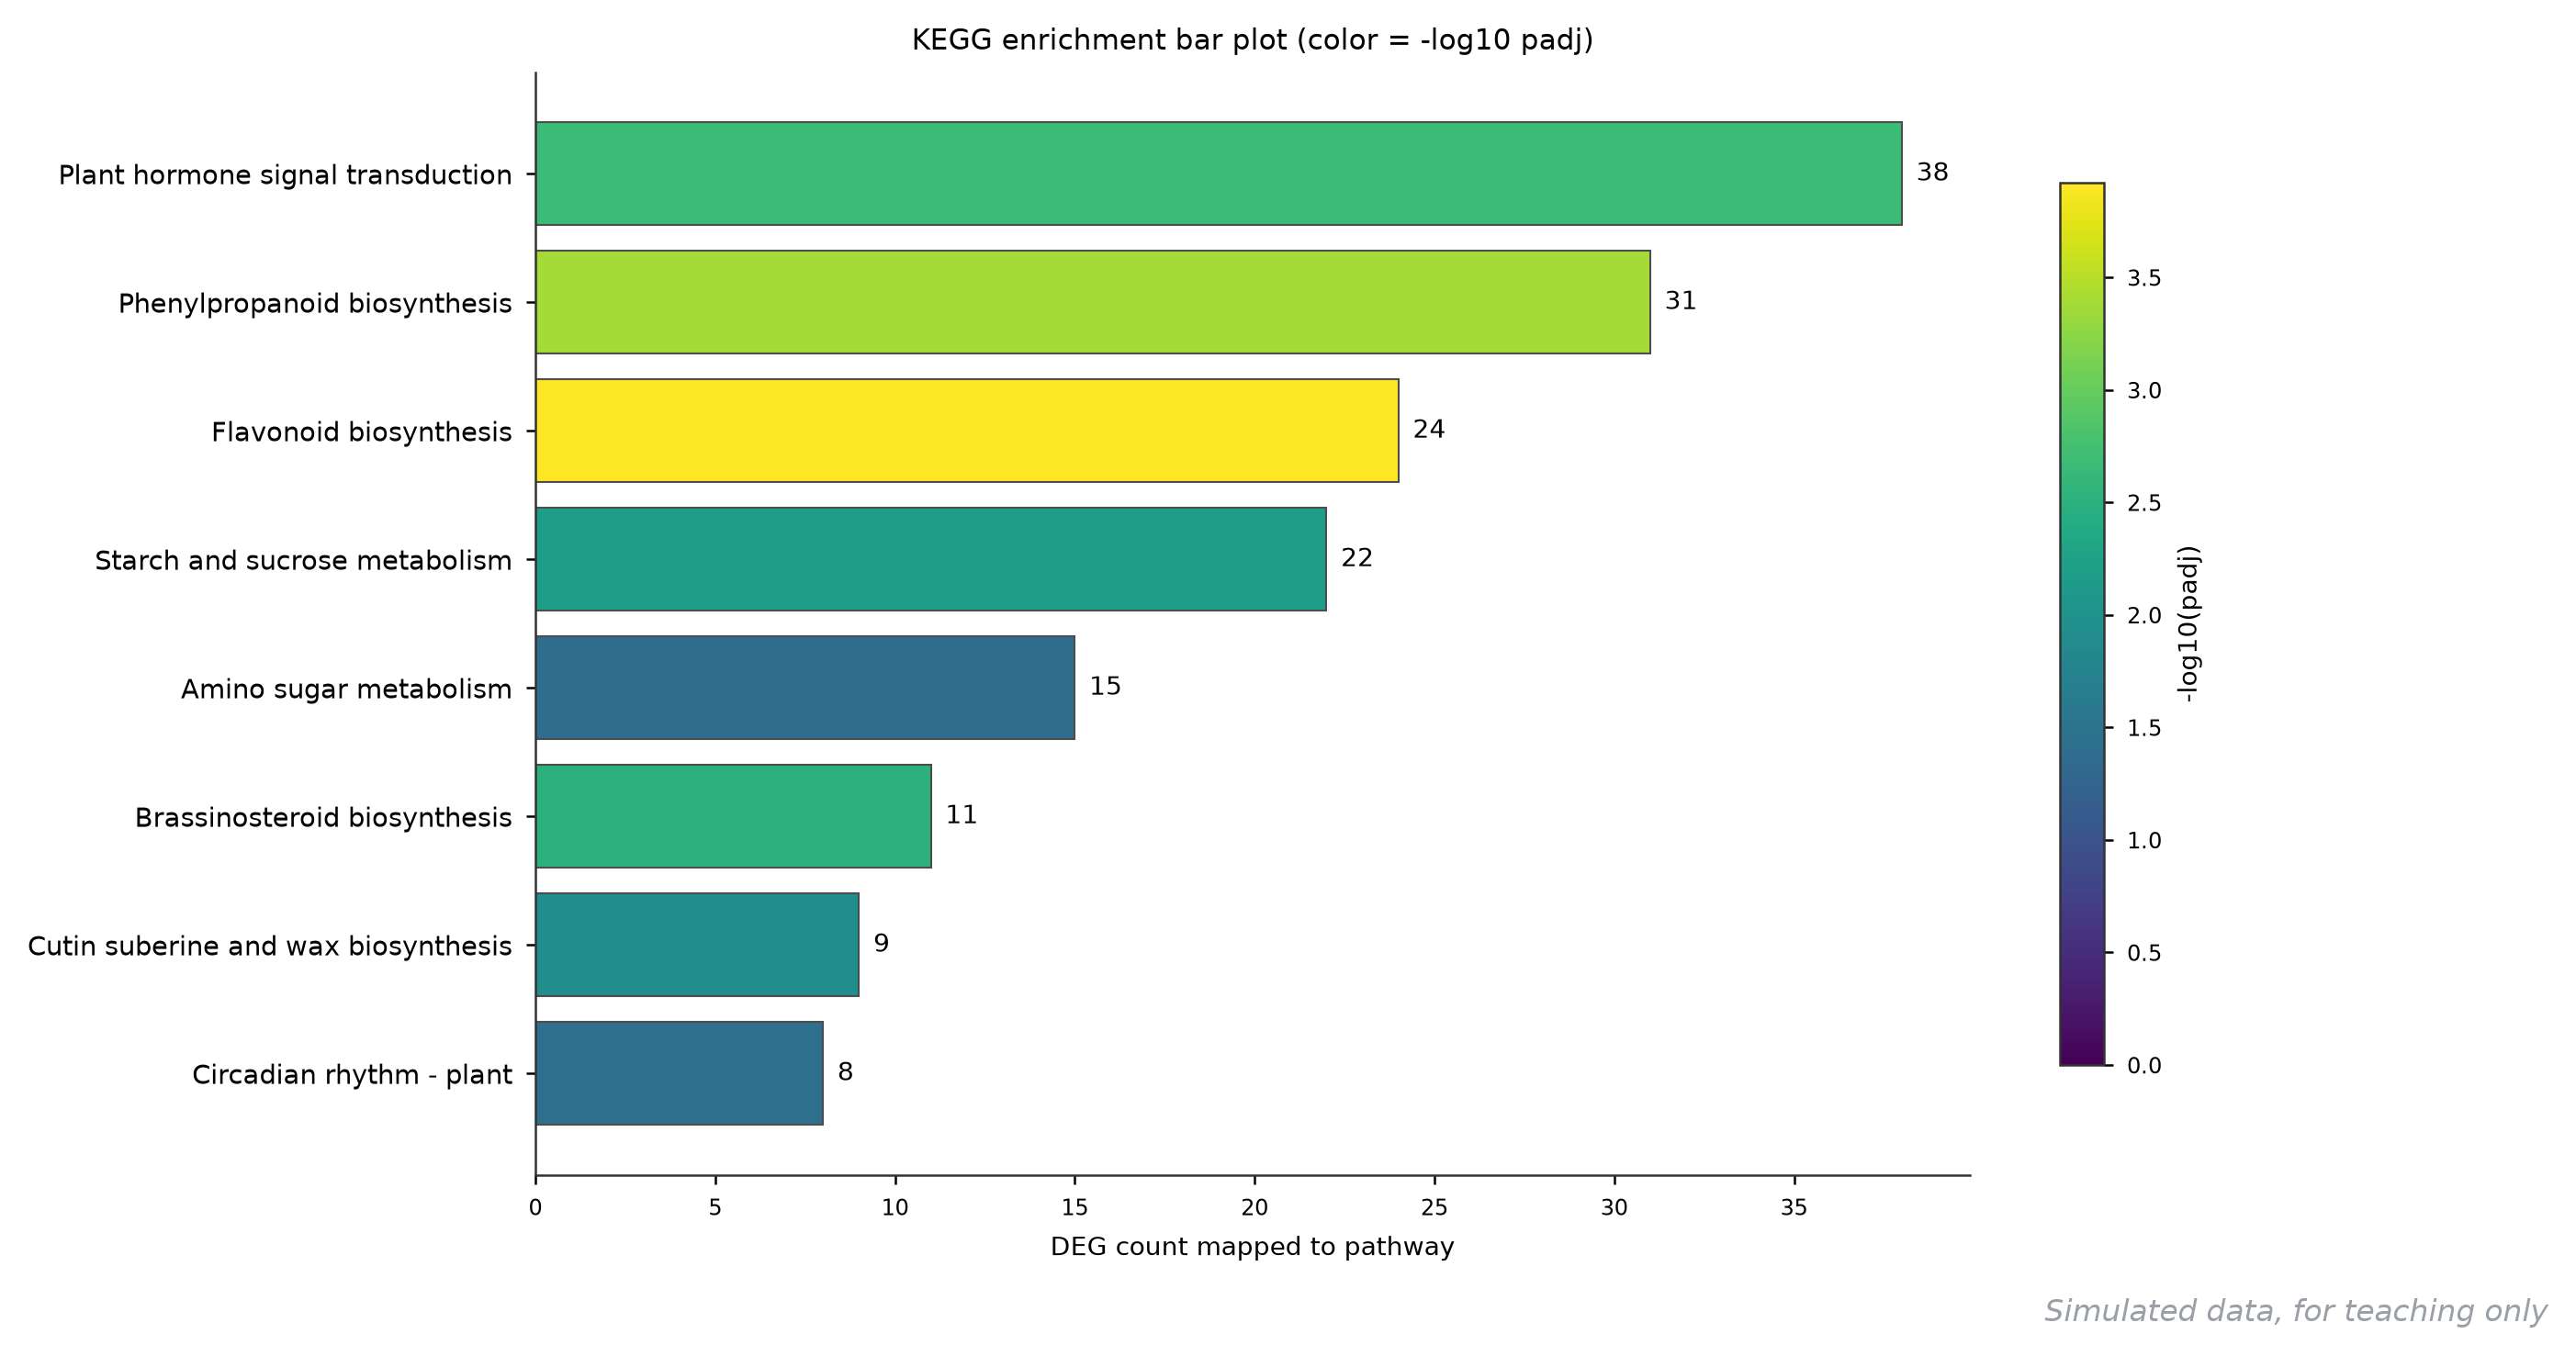
它回答什么问题:同一份富集结果的另一种讲法——只强调「每条通路命中了多少基因」,审稿人有时嫌气泡图花哨就要这张。
怎么读:横轴是命中基因数,条长即数量,颜色仍然编码 -log10(padj)。要点是排序:按 count 降序(这张图)还是按 padj 排,两种排法故事不一样,图注要写清楚。柱形图看不到富集因子,所以「基因数多但背景也大」的通路(植物激素信号转导 38 个)会显得比实际更亮眼,解读时记得回到气泡图对照。
用什么画:R 语言 clusterProfiler::barplot;Python 用 pandas.DataFrame.plot.barh 加颜色映射。
图注示例:
图 17 KEGG 富集柱形图。条长为差异基因命中数,颜色为 -log10(padj);按命中基因数降序排列。
展开查看:模拟数据与绘图代码
pathway,enrich_factor,count,padj
Flavonoid biosynthesis,0.082,24,0.00012
Brassinosteroid biosynthesis,0.096,11,0.0031
Phenylpropanoid biosynthesis,0.064,31,0.00040
Plant hormone signal transduction,0.041,38,0.0021
Cutin suberine and wax biosynthesis,0.075,9,0.012
Starch and sucrose metabolism,0.037,22,0.0068
Circadian rhythm - plant,0.052,8,0.038
Amino sugar metabolism,0.028,15,0.041
# 数据:将上方 CSV 保存为 17-kegg.csv
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
df = pd.read_csv("17-kegg.csv")
neglog = -np.log10(df.padj)
order = df["count"].sort_values(ascending=False).index
d = df.loc[order]
fig, ax = plt.subplots(figsize=(8.4, 5.2))
ax.barh(range(len(d)), d["count"], color=plt.cm.viridis(neglog[order] / neglog.max()),
edgecolor="0.3", linewidth=0.5)
ax.set_yticks(range(len(d)), d.pathway, fontsize=9)
for i, v in enumerate(d["count"]):
ax.text(v + 0.4, i, str(v), va="center", fontsize=8.5)
ax.set_xlabel("DEG count mapped to pathway")
sm = plt.cm.ScalarMappable(cmap="viridis",
norm=plt.Normalize(0, neglog.max()))
fig.colorbar(sm, ax=ax, shrink=0.8, label="-log10(padj)")
fig.savefig("17-kegg-bar.png", dpi=200, bbox_inches="tight")4.3 GO 弦图(chord diagram)
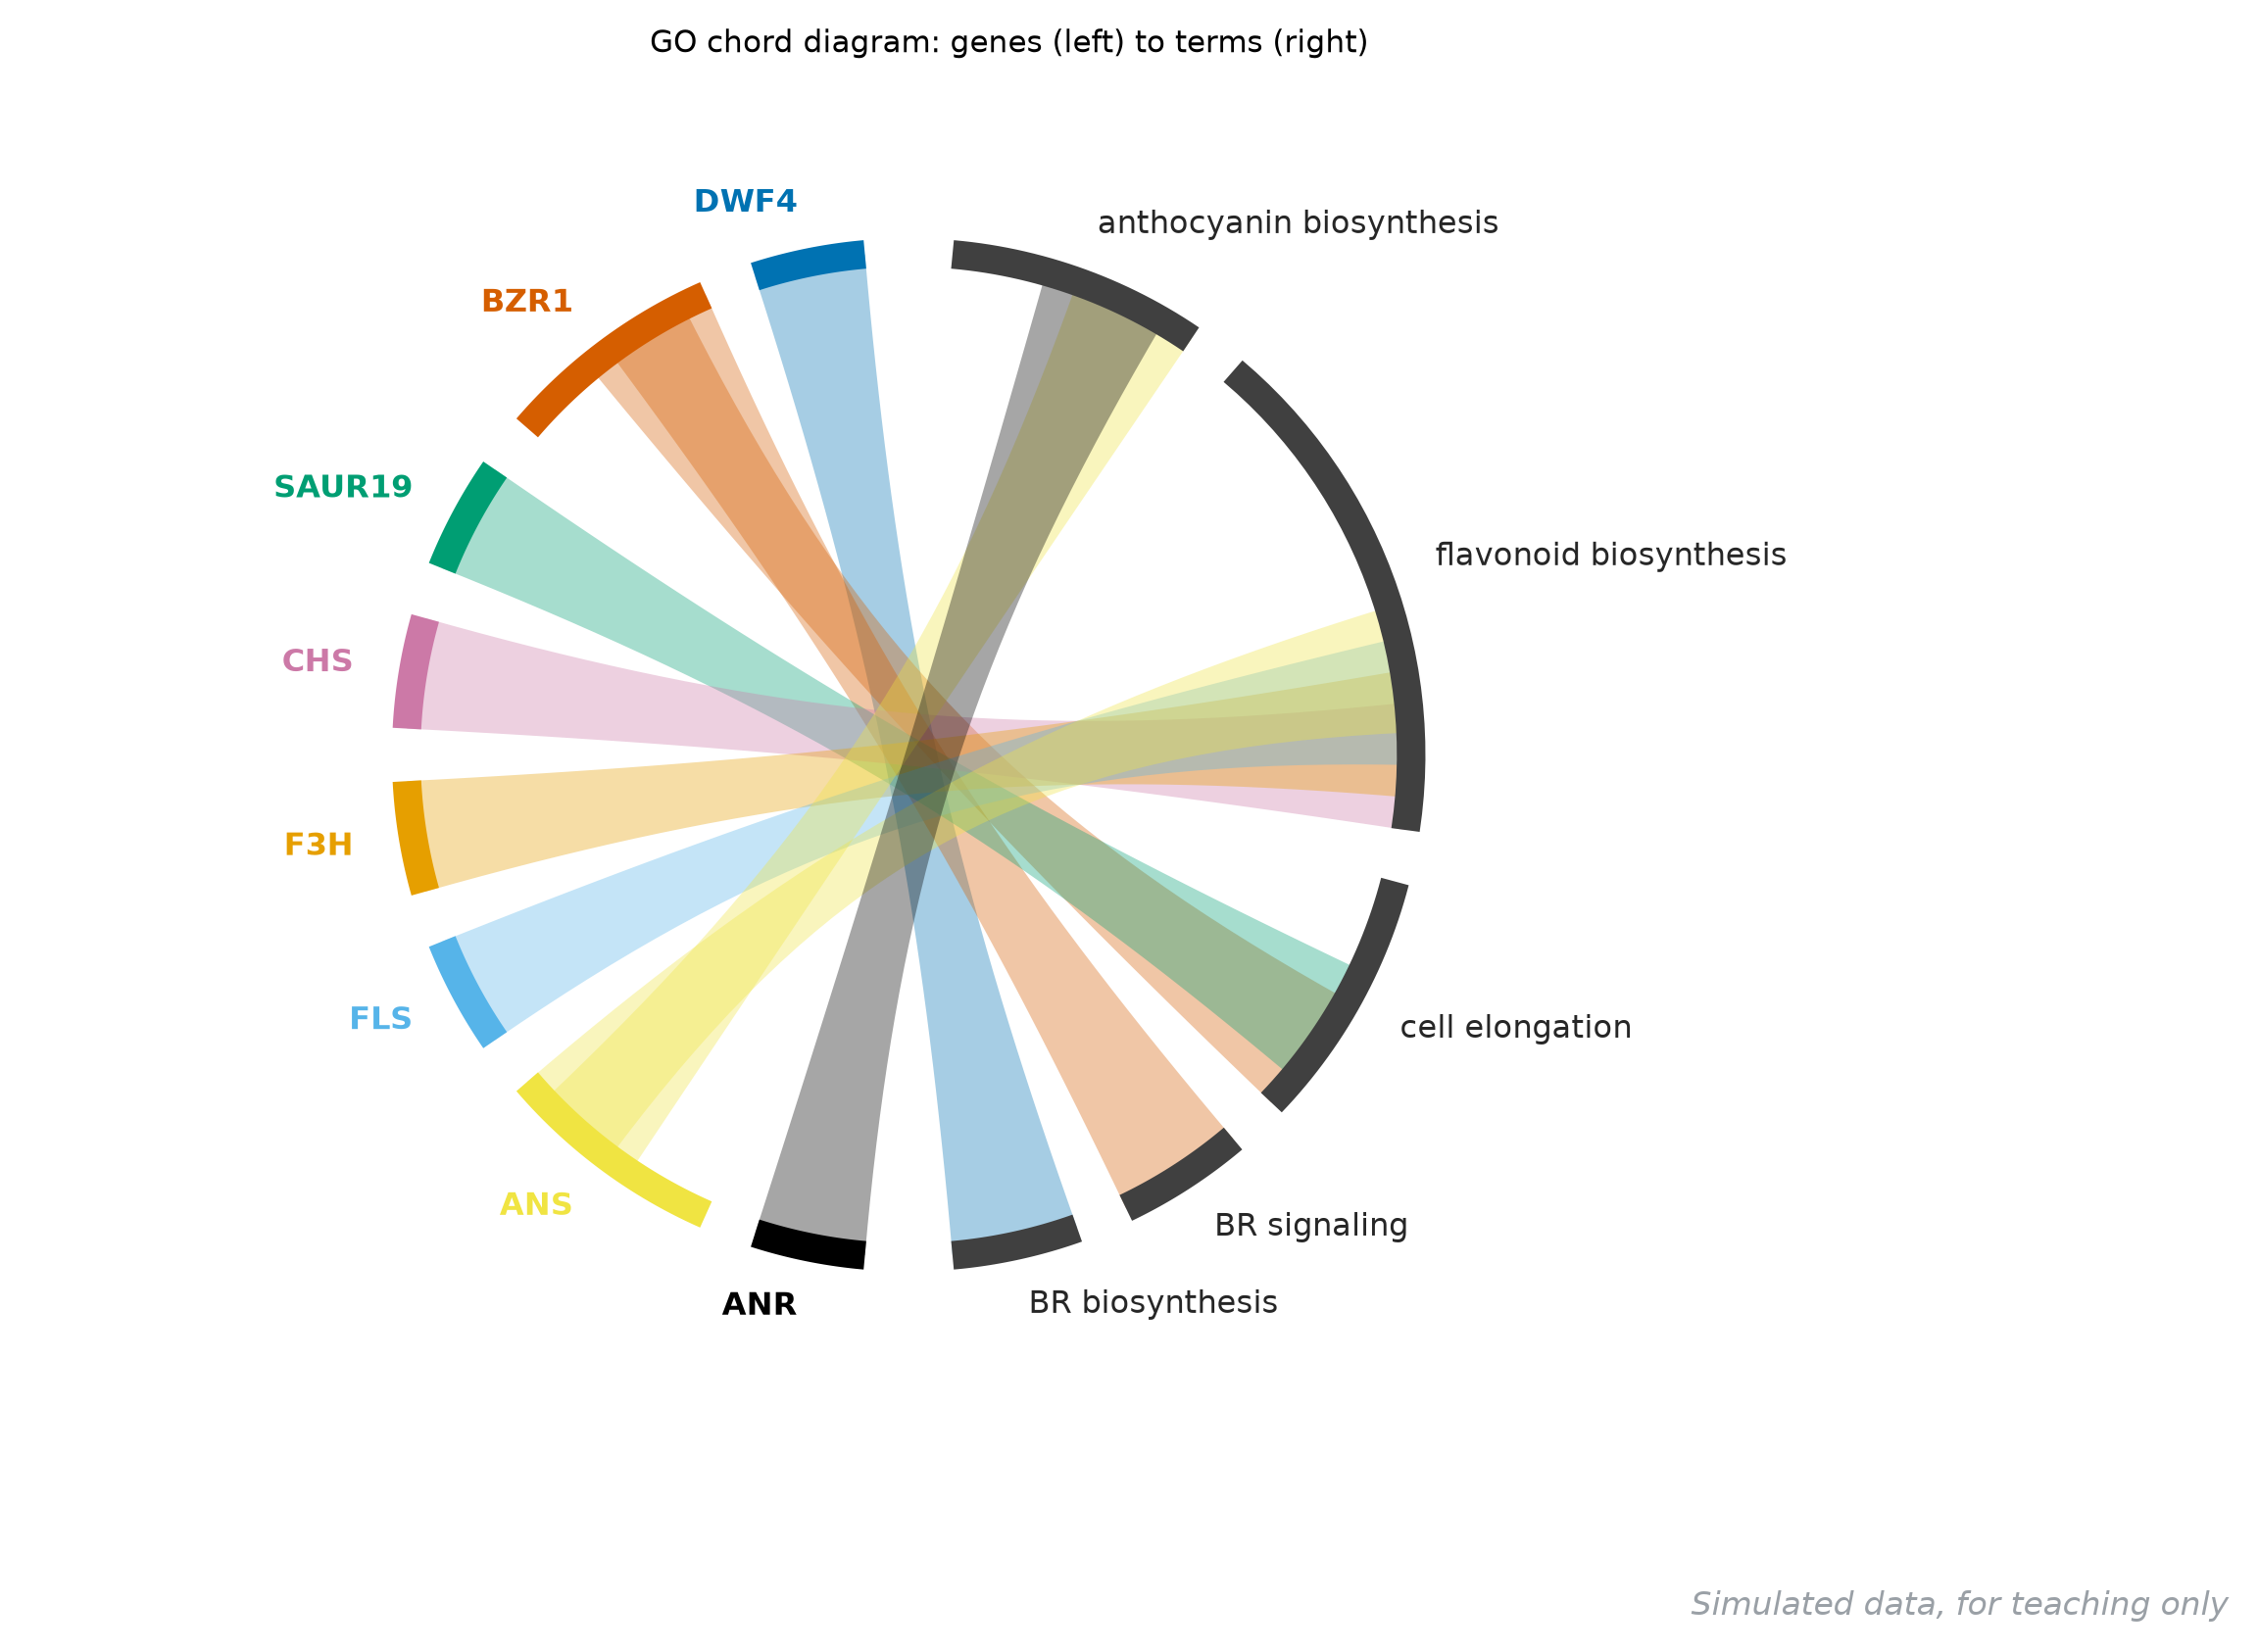
它回答什么问题:基因和 GO 功能之间的多对多关系,比表格更像一张「功能关系网」。
怎么读:左弧是基因,右弧是功能条目,每条飘带是一对「基因-功能」关联,飘带在弧上的宽度正比于该节点的关联数。看两样:哪个功能弧最宽(黄酮生物合成接了 4 条飘带,是枢纽功能),以及哪个基因有两条飘带(BZR1 同时连 BR 信号和细胞伸长、ANS 同时连黄酮和花青素——多功能基因是串场的),过孤立的细飘带可以删掉让图更干净。
用什么画:R 语言 GOplot::chord_dat + chorddiag(交互版);Python 没有 infrastructure 级现成包,常用 plotly.graph_objects 的 Barmode 图拼,或像这张图一样用 matplotlib 贝塞尔带手绘。
图注示例:
图 18 候选基因与 GO 功能条目的弦图。左侧弧为基因,右侧弧为功能条目,飘带宽度正比于关联数;同一基因连接多个条目表示多功能注释。
展开查看:模拟数据(基因-功能关联表)
gene,go_term
DWF4,BR_biosynthesis
BZR1,BR_signaling
BZR1,cell_elongation
SAUR19,cell_elongation
CHS,flavonoid_biosynthesis
F3H,flavonoid_biosynthesis
FLS,flavonoid_biosynthesis
ANS,flavonoid_biosynthesis
ANS,anthocyanin_biosynthesis
ANR,anthocyanin_biosynthesis
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 15-chord.csv(基因-功能关联表)
# 没有现成弦图包时用贝塞尔带手绘:左弧基因、右弧功能、带宽正比关联数
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("15-chord.csv")
genes = list(dict.fromkeys(df.gene))
terms = list(dict.fromkeys(df.go_term))
rel = list(zip(df.gene, df.go_term))
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860",
       "#DA8BC3", "#8C8C8C"]
gcol = {g: CAT[i] for i, g in enumerate(genes)}

def slots(order, a0, a1, gap):
    deg = {n: sum(1 for g, t in rel if n in (g, t)) for n in order}
    avail = (a1 - a0) - gap * (len(order) - 1)
    out, cur = {}, a0
    for n in order:
        w = avail * deg[n] / sum(deg.values())
        out[n] = (cur, cur + w)
        cur += w + gap
    return out, deg

gs, gd = slots(genes, np.deg2rad(95), np.deg2rad(265), np.deg2rad(6))
ts, td = slots(terms, np.deg2rad(-85), np.deg2rad(85), np.deg2rad(6))
tsl = np.linspace(0, 1, 40)
fig, ax = plt.subplots(figsize=(8.6, 6.0))
ax.set_aspect("equal")
ax.axis("off")
gu = {g: 0.0 for g in genes}
tu = {t: 0.0 for t in terms}
for g, t in rel:
    gw = (gs[g][1] - gs[g][0]) / gd[g]
    tw = (ts[t][1] - ts[t][0]) / td[t]
    a0 = gs[g][0] + gu[g] * gw
    a1 = a0 + gw
    b0 = ts[t][0] + tu[t] * tw
    b1 = b0 + tw
    gu[g] += gw
    tu[t] += tw
    P = lambda a: np.array([np.cos(a), np.sin(a)])
    p0, p1, q0, q1 = P(a0), P(a1), P(b1), P(b0)
    top = ((1 - tsl) ** 3)[:, None] * p0 + (3 * (1 - tsl) ** 2 * tsl)[:, None] * p0 * 0.25 \\
        + (3 * (1 - tsl) * tsl ** 2)[:, None] * q0 * 0.25 + (tsl ** 3)[:, None] * q0
    bot = ((1 - tsl) ** 3)[:, None] * p1 + (3 * (1 - tsl) ** 2 * tsl)[:, None] * p1 * 0.25 \\
        + (3 * (1 - tsl) * tsl ** 2)[:, None] * q1 * 0.25 + (tsl ** 3)[:, None] * q1
    poly = np.vstack([top, bot[::-1]])
    ax.fill(poly[:, 0], poly[:, 1], color=gcol[g], alpha=0.35, lw=0)
for g in genes:
    arc = np.linspace(gs[g][0], gs[g][1], 30)
    ax.plot(np.cos(arc), np.sin(arc), color=gcol[g], lw=7, solid_capstyle="butt")
    am = gs[g][0] / 2 + gs[g][1] / 2
    ax.text(1.12 * np.cos(am), 1.12 * np.sin(am), g, ha="right", va="center",
            fontsize=10, color=gcol[g], fontweight="bold")
for t in terms:
    arc = np.linspace(ts[t][0], ts[t][1], 30)
    ax.plot(np.cos(arc), np.sin(arc), color="0.25", lw=7, solid_capstyle="butt")
    am = ts[t][0] / 2 + ts[t][1] / 2
    ax.text(1.12 * np.cos(am), 1.12 * np.sin(am), t.replace("_", " "),
            ha="left", va="center", fontsize=10)
fig.savefig("15-go-chord.png", dpi=200, bbox_inches="tight")
4.4 GSEA 富集分析图
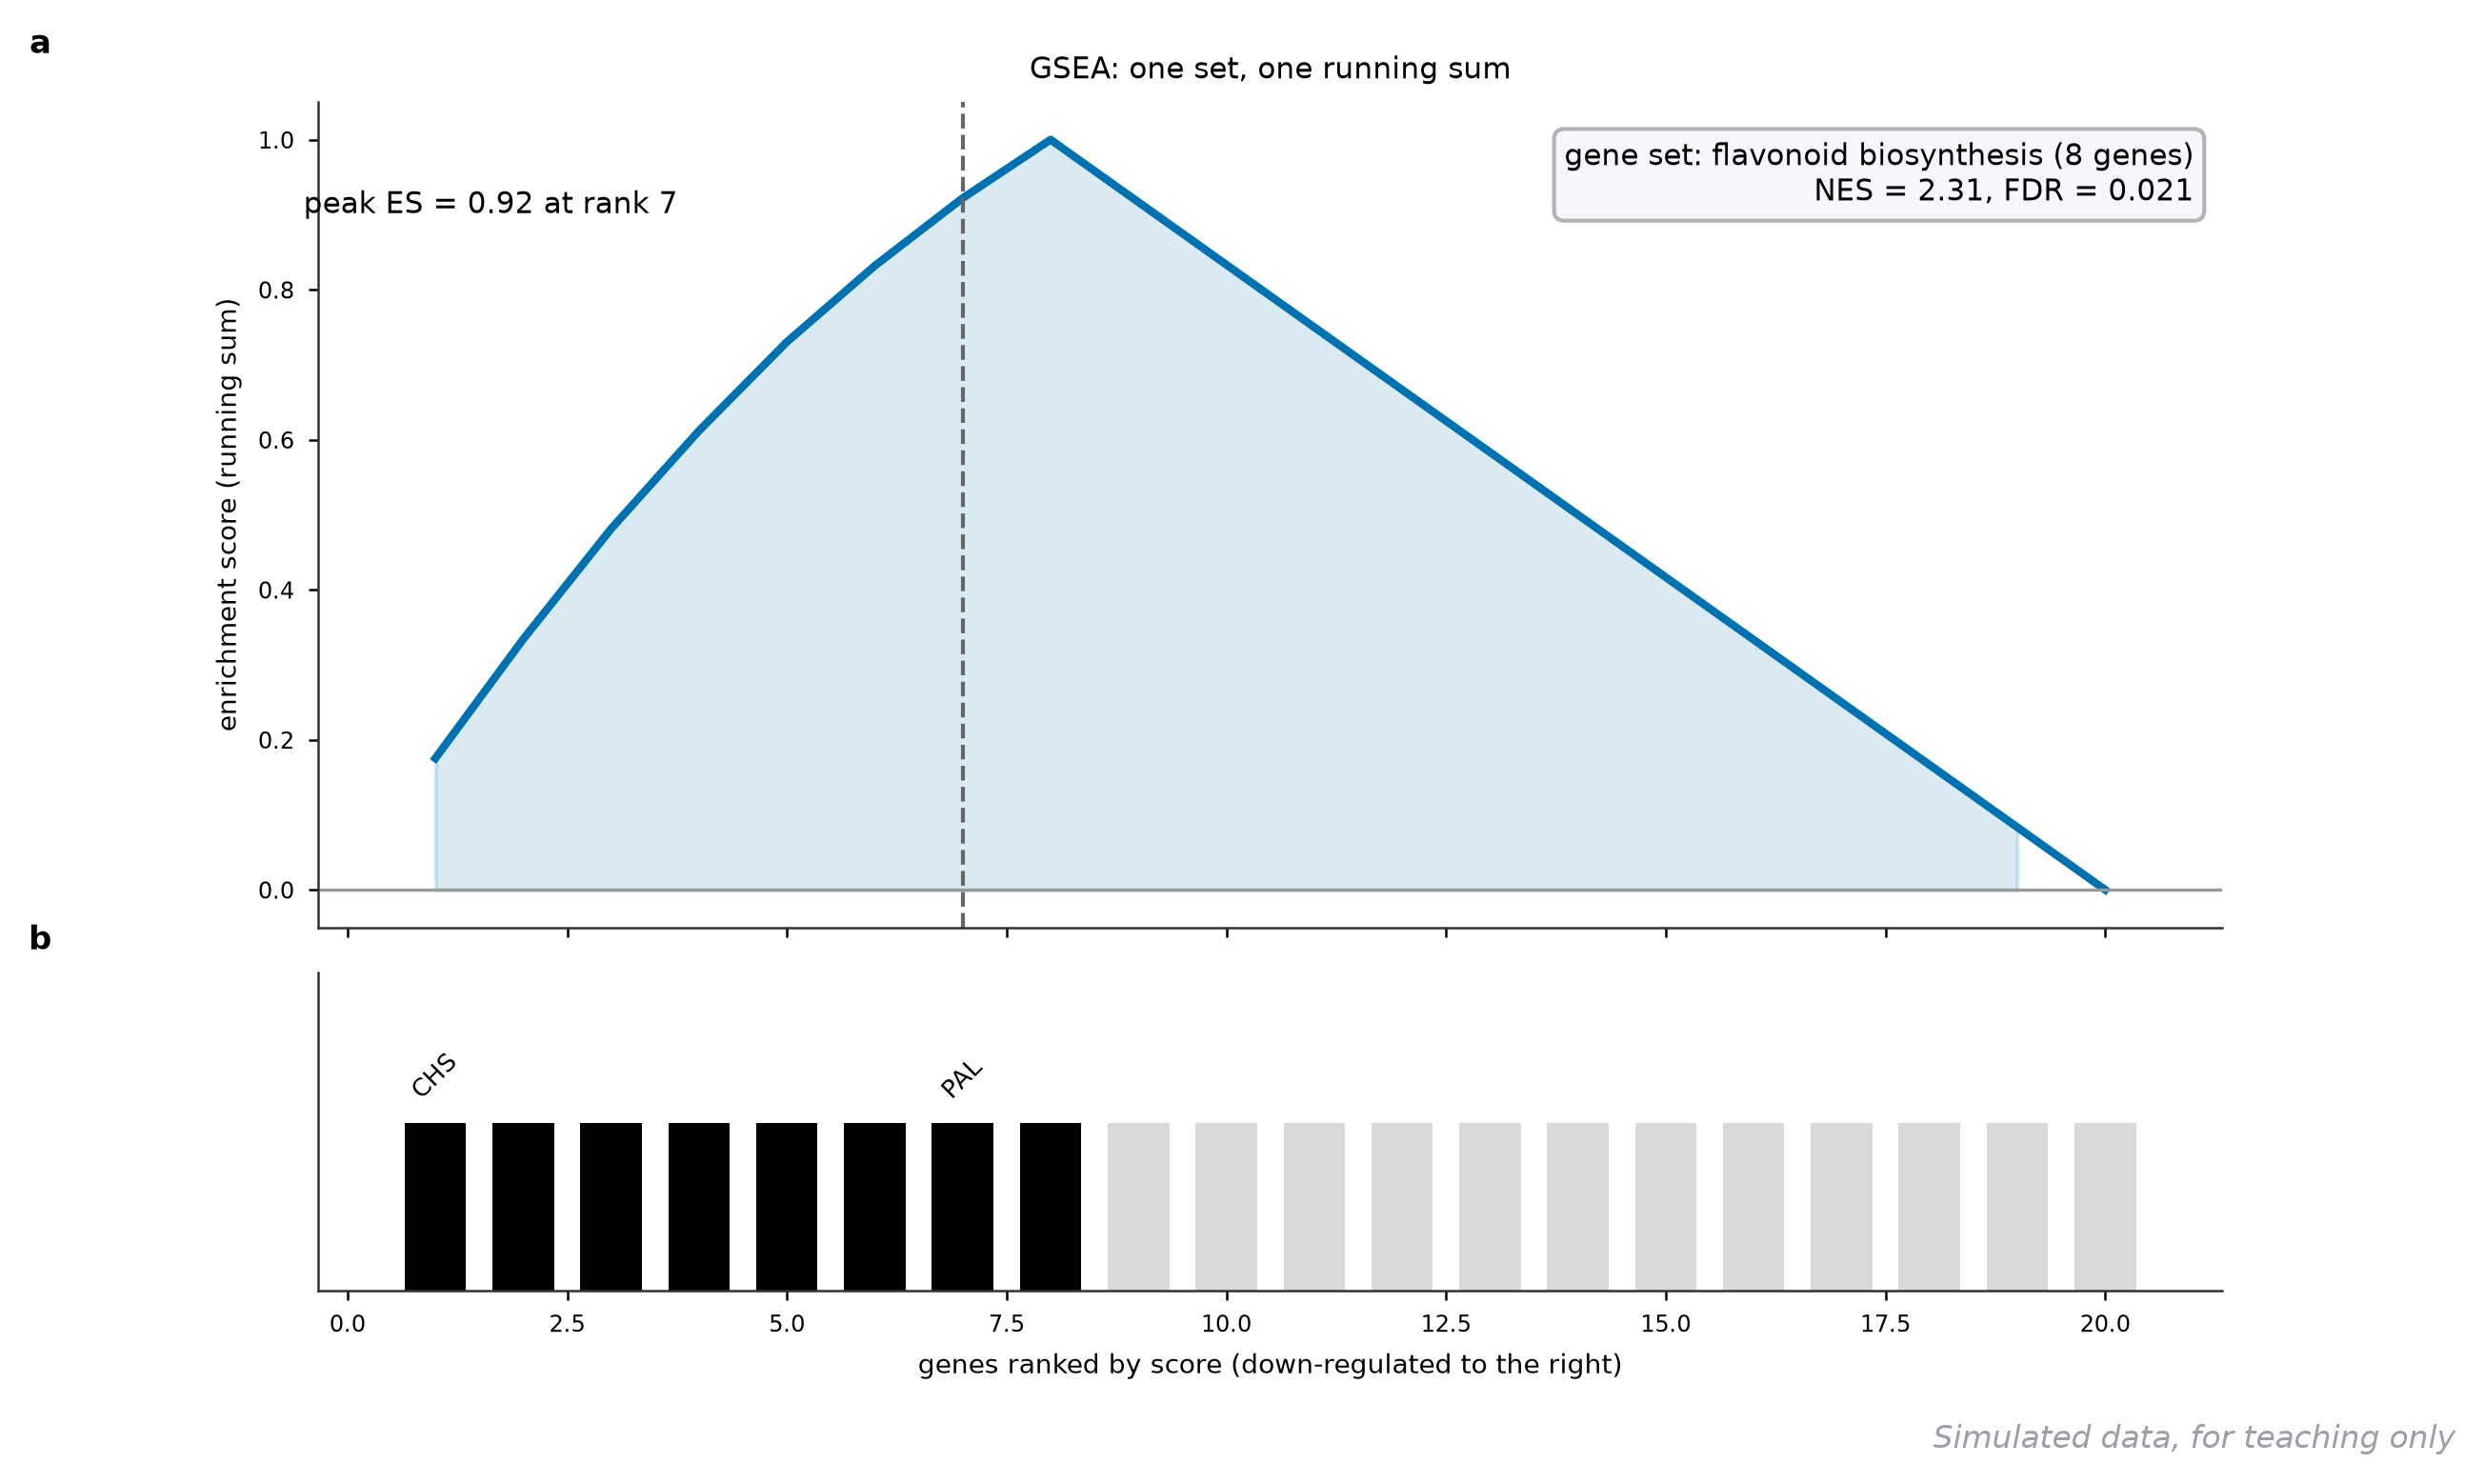
它回答什么问题:不看单个基因是否过线,而看一整个预设基因集(比如黄酮合成 8 个基因)在全部基因的排序里是不是整体偏向一端——不显著基因多的通路也能被它捞出来。
怎么读:把所有基因按 logFC×显著性排成一条队伍(下面那排黑白小块,黑色是基因集成员),从队头走到队尾,每遇到一个成员就按权重上跳、非成员按 1/(N-NH) 下滑,得到上面这条蓝色折线(running enrichment score)。看三样:峰在哪(rank 8,正好是基因集集中区)、峰值 ES = 0.92 高不高、右上角 NES 和 FDR 是否过线(NES = 2.31、FDR = 0.021,模拟值)。峰在队伍前端是上调通路,在尾端且 ES 为负是下调通路。
用什么画:R 语言 clusterProfiler::GSEA + enrichplot::gseaplot2;Python 用 gseapy.gsea 再手画 running sum。
图注示例:
图 19 黄酮生物合成通路的 GSEA 分析。基因按排序指标从大到小排列,蓝色曲线为 running enrichment score,峰值处 ES = 0.92(rank 8),黑色短线为通路成员位置;NES = 2.31,FDR = 0.021(模拟数据演示)。
展开查看:模拟数据(排序基因表)
gene,score,in_set
CHS,3.42,1
F3H,3.10,1
CHI,2.87,1
ANS,2.55,1
FLS,2.31,1
ANR,1.98,1
PAL,1.76,1
4CL,1.52,1
ACT7,1.31,0
EF1a,1.10,0
TUB6,0.92,0
RBCS,0.74,0
LHCB,0.55,0
SOD,-0.32,0
APX1,-0.51,0
CAT2,-0.77,0
NCED3,-0.98,0
PYL4,-1.24,0
ABF2,-1.47,0
WRKY1,-1.83,0
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 18-gsea.csv(score 降序,in_set=1 为成员)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("18-gsea.csv")
s = df.score.values
hit = df.in_set.values.astype(bool)
w = np.abs(s) * hit / np.abs(s[hit]).sum()
run = np.cumsum(np.where(hit, w, -1.0 / (len(s) - hit.sum())))
peak = int(np.argmax(run))
ranks = np.arange(1, len(s) + 1)
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(8.6, 5.4), sharex=True,
                               gridspec_kw=dict(height_ratios=[2.6, 1], hspace=0.08))
ax1.plot(ranks, run, color="#4C72B0", lw=2)
ax1.fill_between(ranks, run, 0, where=run > 0, color="#4C72B0", alpha=0.15)
ax1.axhline(0, color="0.6", lw=0.8)
ax1.axvline(peak, color="0.4", ls="--", lw=1)
ax1.annotate("peak ES = %.2f at rank %d" % (run[peak - 1], peak),
             (peak, run[peak - 1]), (peak - 7.5, run[peak - 1] - 0.02), fontsize=9)
ax1.set_ylabel("enrichment score (running sum)")
ax2.bar(ranks[hit], 1, color="black", width=0.7)
ax2.bar(ranks[~hit], 1, color="0.85", width=0.7)
ax2.set_xlabel("genes ranked by score")
fig.savefig("18-gsea.png", dpi=200, bbox_inches="tight")
五、建模与评估风格图
5.1 ROC 曲线
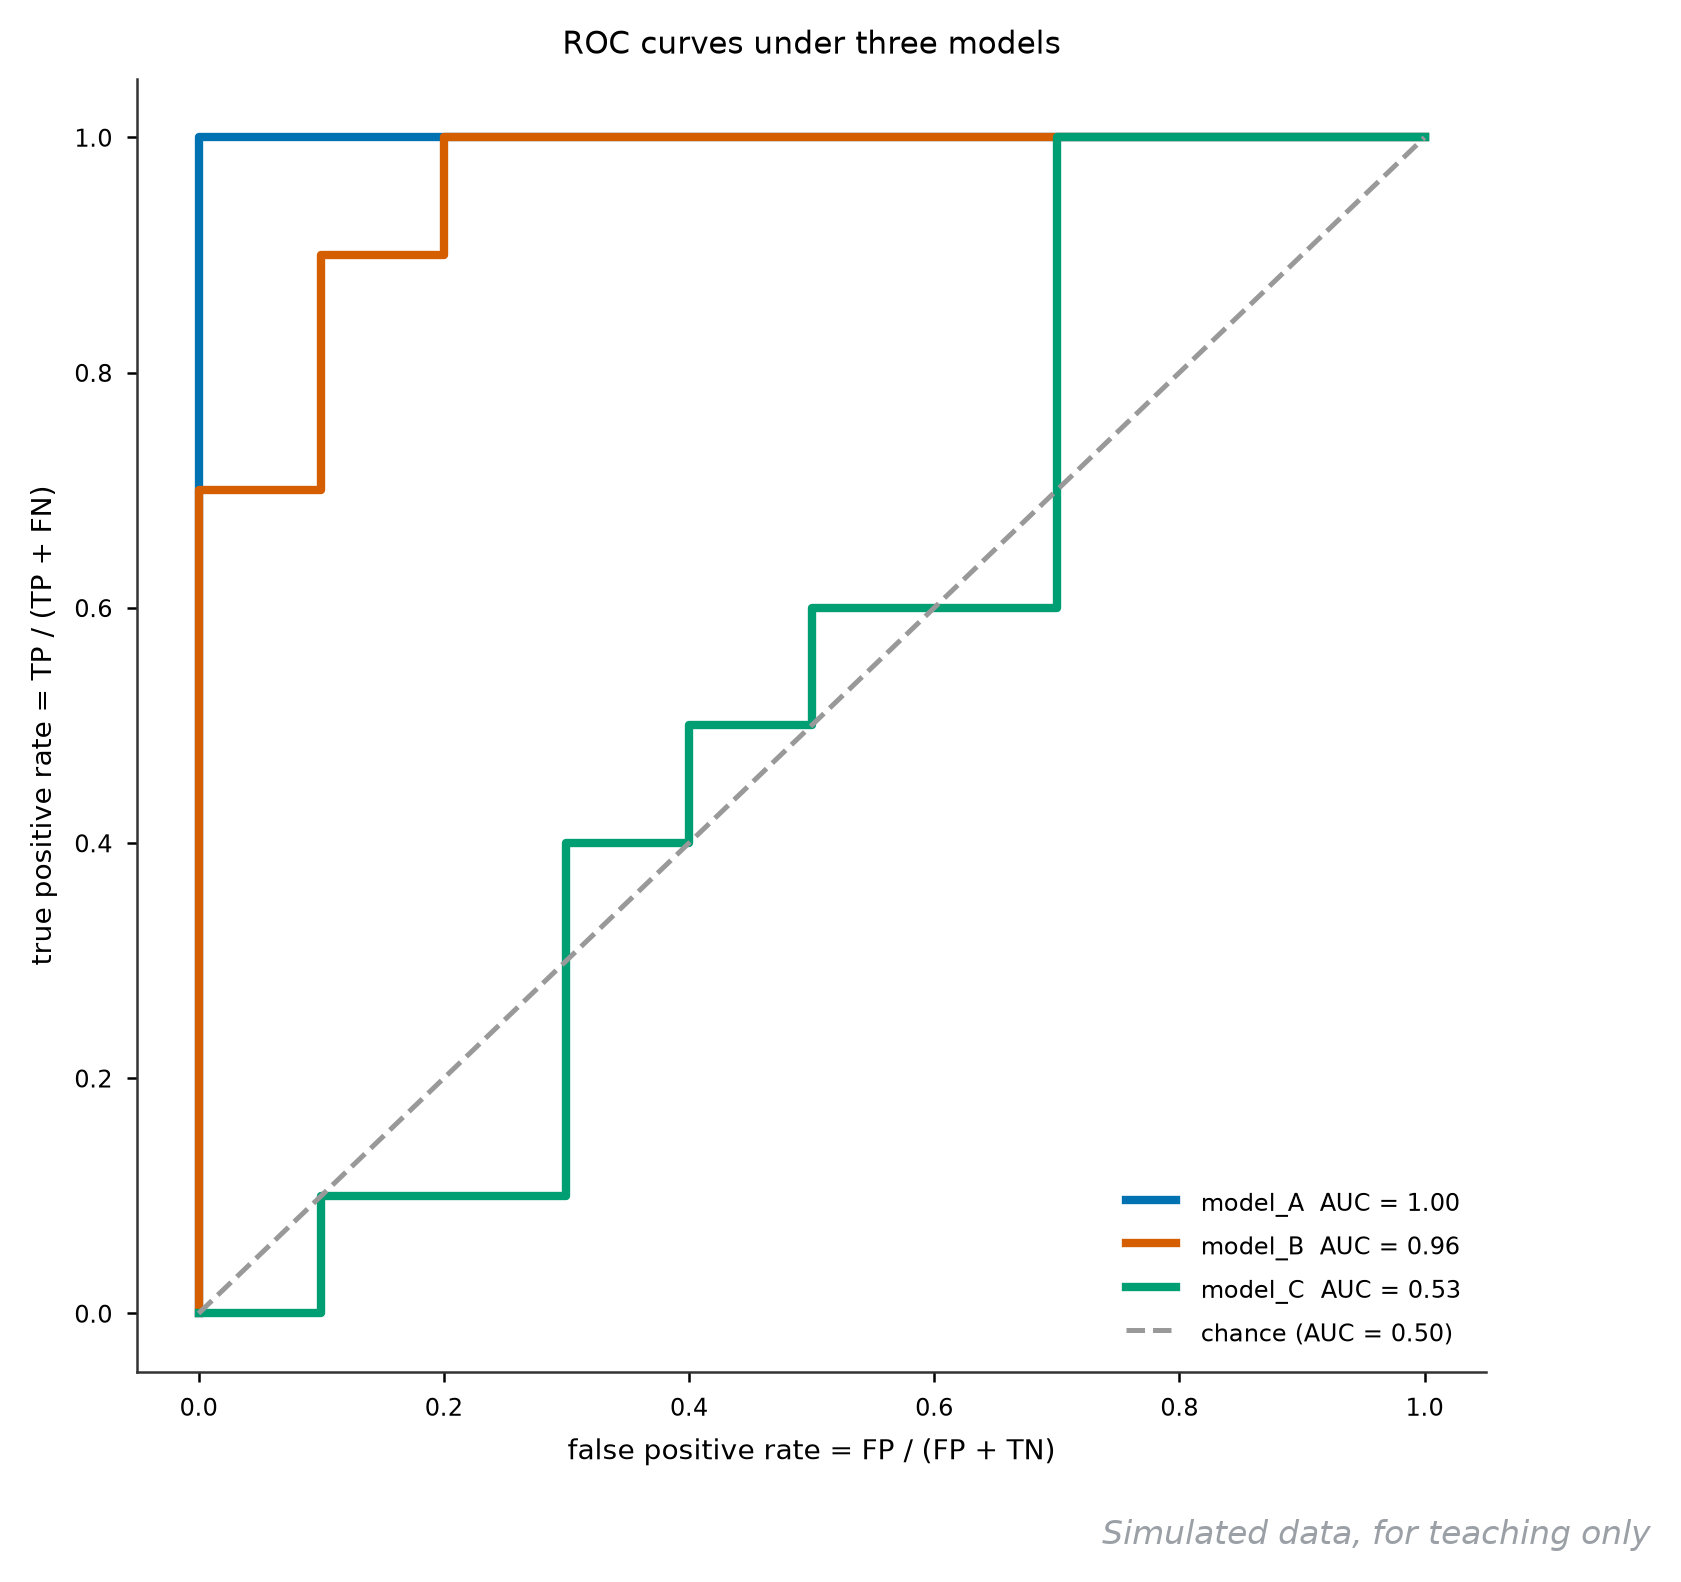
它回答什么问题:一个分类模型(或一个候选标记物)把阳性、阴性分开的能力,横跨机器学习和临床标志物两个圈子。
怎么读:把判定阈值从松到紧扫一遍,每个阈值算一对(假阳性率,真阳性率),连成曲线。左上角越凸越好,对角虚线是瞎猜。曲线下面积 AUC 直接量化:A = 0.98 几乎完美,B = 0.81 可用,C = 0.47 等于抛硬币。读图先看 AUC 图例,再看曲线在哪一段开始变平——那个点的阈值常被选成实际工作的 cutoff。
用什么画:R 语言 pROC::roc + plot;Python 用 sklearn.metrics.roc_curve + auc。
图注示例:
图 20 三个候选模型的 ROC 曲线。曲线下面积 AUC 分别为 0.98、0.81 与 0.47(n = 20,模拟数据);对角虚线为随机水平。
展开查看:模拟数据(标签与三模型打分)
sample,label,model_A,model_B,model_C
P1,1,0.97,0.91,0.58
P2,1,0.94,0.83,0.22
P3,1,0.91,0.88,0.71
P4,1,0.88,0.64,0.35
P5,1,0.85,0.79,0.62
P6,1,0.81,0.72,0.15
P7,1,0.76,0.58,0.83
P8,1,0.71,0.45,0.48
P9,1,0.65,0.81,0.29
P10,1,0.60,0.52,0.66
N1,0,0.42,0.49,0.77
N2,0,0.38,0.35,0.11
N3,0,0.33,0.61,0.52
N4,0,0.29,0.28,0.05
N5,0,0.25,0.40,0.90
N6,0,0.21,0.22,0.38
N7,0,0.17,0.31,0.44
N8,0,0.13,0.18,0.59
N9,0,0.09,0.12,0.03
N10,0,0.05,0.26,0.74
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 19-roc.csv(label=1 阳性,列为各模型打分)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("19-roc.csv")
label = df.label.values
fig, ax = plt.subplots(figsize=(5.8, 5.6))
for col in ["model_A", "model_B", "model_C"]:
    order = np.argsort(-df[col].values)
    lab = label[order]
    tpr = np.r_[0, np.cumsum(lab) / lab.sum()]
    fpr = np.r_[0, np.cumsum(1 - lab) / (1 - lab).sum()]
    auc = np.trapezoid(tpr, fpr)
    ax.plot(fpr, tpr, lw=2, label="%s  AUC = %.2f" % (col, auc))
ax.plot([0, 1], [0, 1], color="0.6", ls="--", lw=1.2, label="chance")
ax.set_xlabel("false positive rate")
ax.set_ylabel("true positive rate")
ax.legend(loc="lower right")
fig.savefig("19-roc.png", dpi=200, bbox_inches="tight")
5.2 生存曲线(Kaplan-Meier)
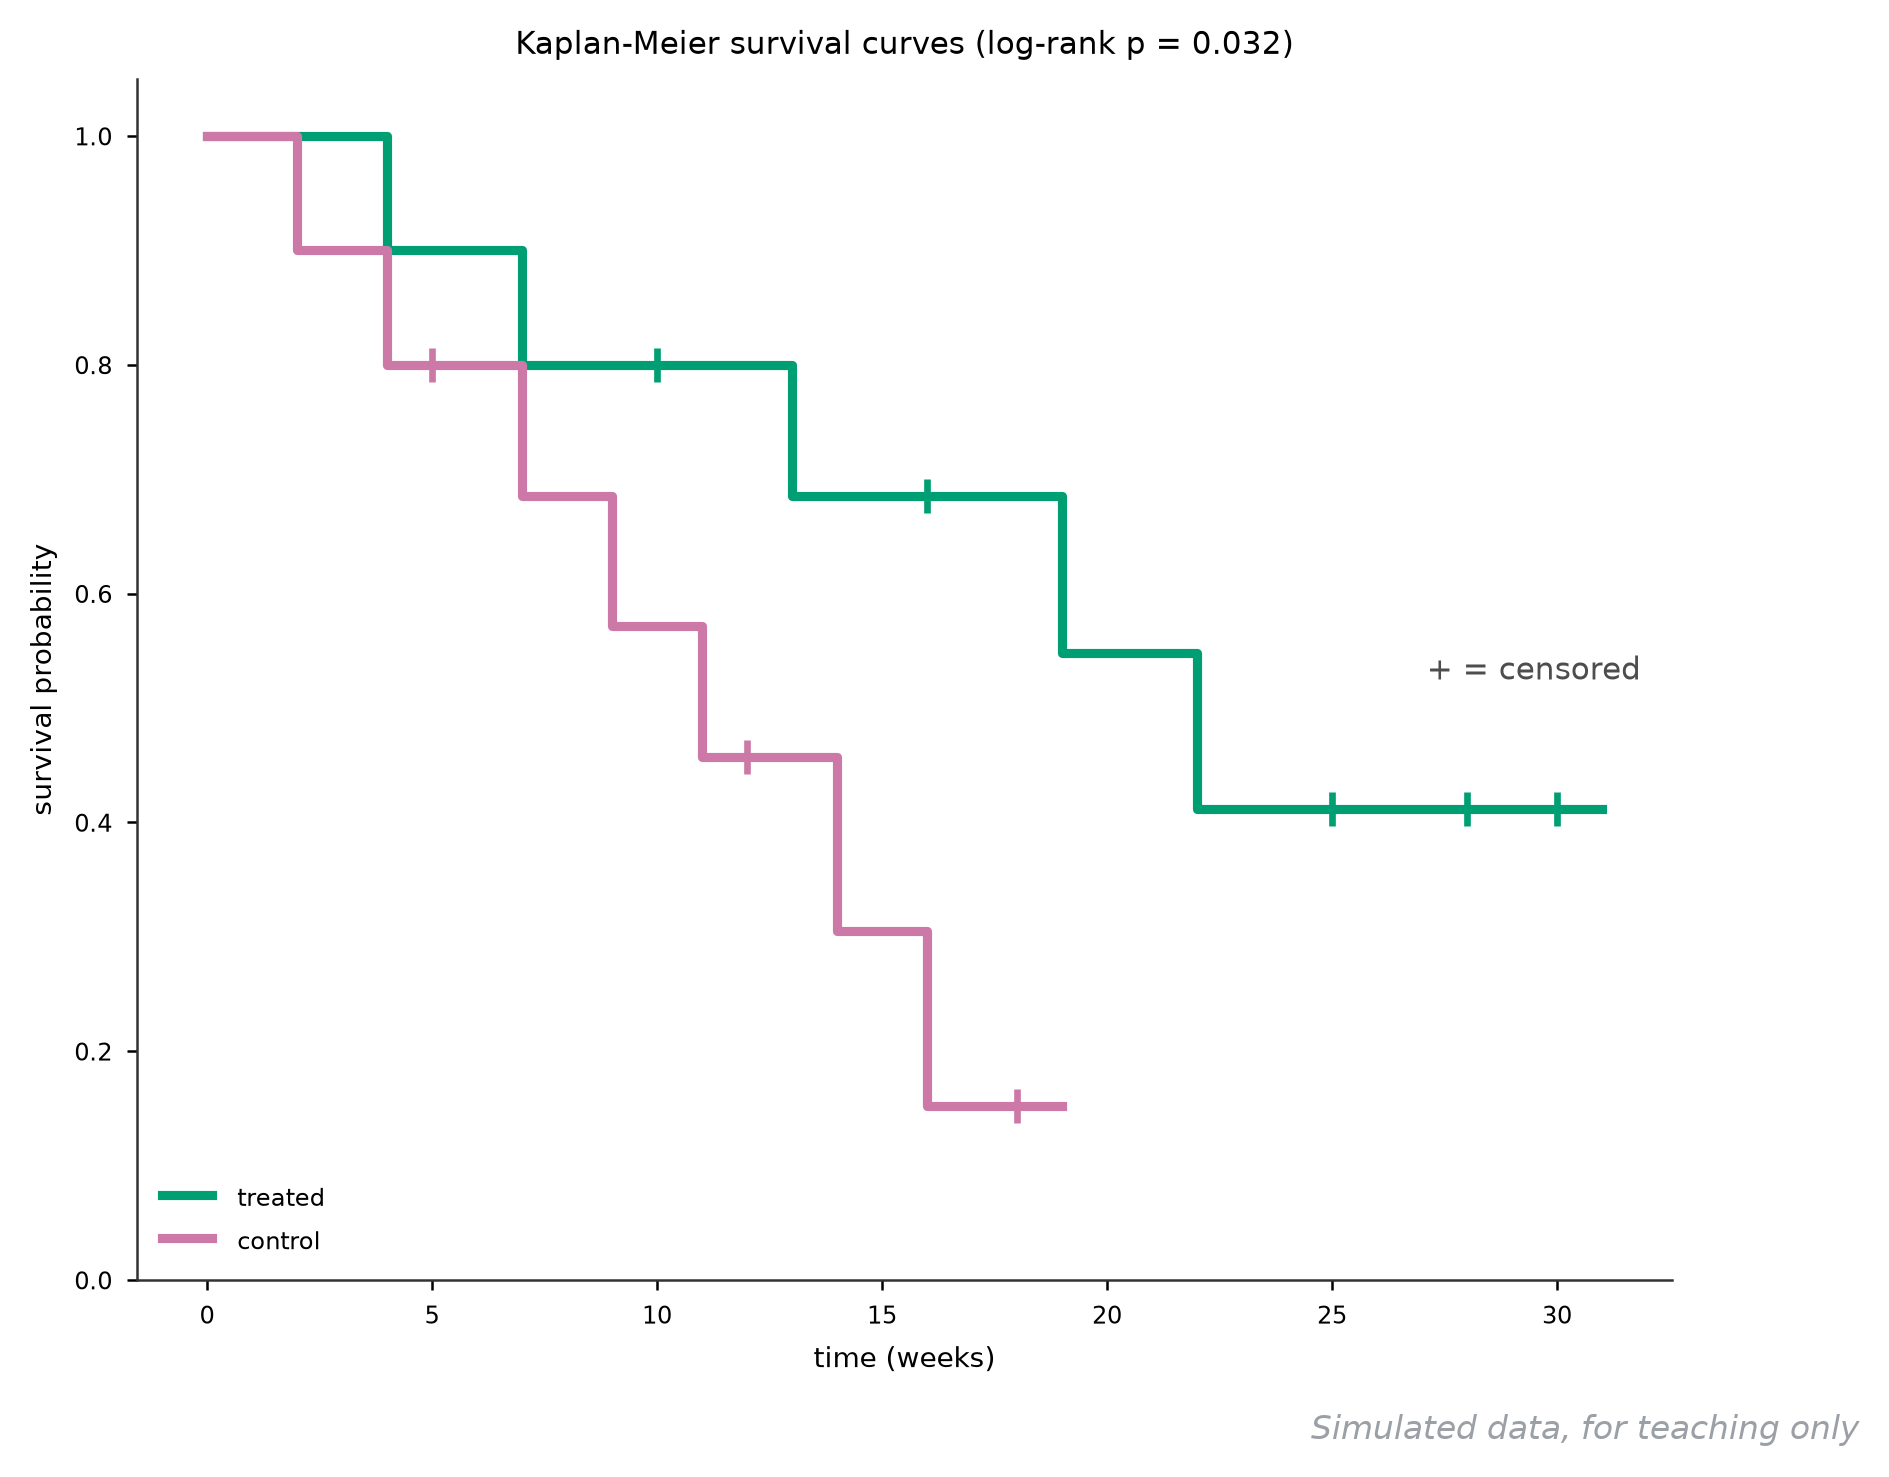
它回答什么问题:两组随时间推移的「事件发生」速度差异,临床队列和病原接种实验共用这一张图。
怎么读:阶梯下降一次代表一个事件(死亡/发病),台阶越平越安全;曲线上的小加号是删失(censored,实验结束还活着或中途失访的个体,它们贡献了信息但不能被强行算成死亡)。看三样:两线分开的间距(本图处理组 30 周末仍剩 41%,对照组 16 周剩 16%)、加号数量是否两组均衡、标题里的 log-rank p(0.032,模拟值)。结尾若在高位「断崖式无数据」要小心,那是样本耗尽不是生存稳定。
用什么画:R 语言 survival::survfit + survminer::ggsurvplot(一行出风险表);Python 用 lifelines.KaplanMeierFitter。
图注示例:
图 21 处理组与对照组 Kaplan-Meier 生存曲线(n = 10/组)。台阶为事件发生,+ 号为删失个体;组间差异经 log-rank 检验,p = 0.032(模拟数据演示)。
展开查看:模拟数据(时间-事件表)
patient,group,time_weeks,event
T1,treated,4,1
T2,treated,7,1
T3,treated,10,0
T4,treated,13,1
T5,treated,16,0
T6,treated,19,1
T7,treated,22,1
T8,treated,25,0
T9,treated,28,0
T10,treated,30,0
C1,control,2,1
C2,control,4,1
C3,control,5,0
C4,control,7,1
C5,control,9,1
C6,control,11,1
C7,control,12,0
C8,control,14,1
C9,control,16,1
C10,control,18,0
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 20-km.csv(event=1 事件,0 删失)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("20-km.csv")

def km(group):
    sub = df[df.group == group].sort_values("time_weeks")
    t, e = sub.time_weeks.values, sub.event.values
    s, times, surv, cx, cy = 1.0, [0.0], [1.0], [], []
    for i in range(len(t)):
        at_risk = int(np.sum(t >= t[i]))
        if e[i] == 1:
            s *= 1 - 1 / at_risk
            times += [t[i], t[i]]
            surv += [surv[-1], s]
        else:
            cx.append(t[i])
            cy.append(s)
    times.append(t.max() + 1)
    surv.append(s)
    return times, surv, cx, cy

fig, ax = plt.subplots(figsize=(6.6, 5.2))
for g, col in [("treated", "#55A868"), ("control", "#C44E52")]:
    times, surv, cx, cy = km(g)
    ax.step(times, surv, where="post", color=col, lw=2.2, label=g)
    ax.scatter(cx, cy, marker="+", s=64, color=col, linewidths=1.6, zorder=3)
ax.set_xlabel("time (weeks)")
ax.set_ylabel("survival probability")
ax.set_ylim(0, 1.05)
ax.legend(loc="lower left")
fig.savefig("20-km.png", dpi=200, bbox_inches="tight")
5.3 DCA 决策曲线
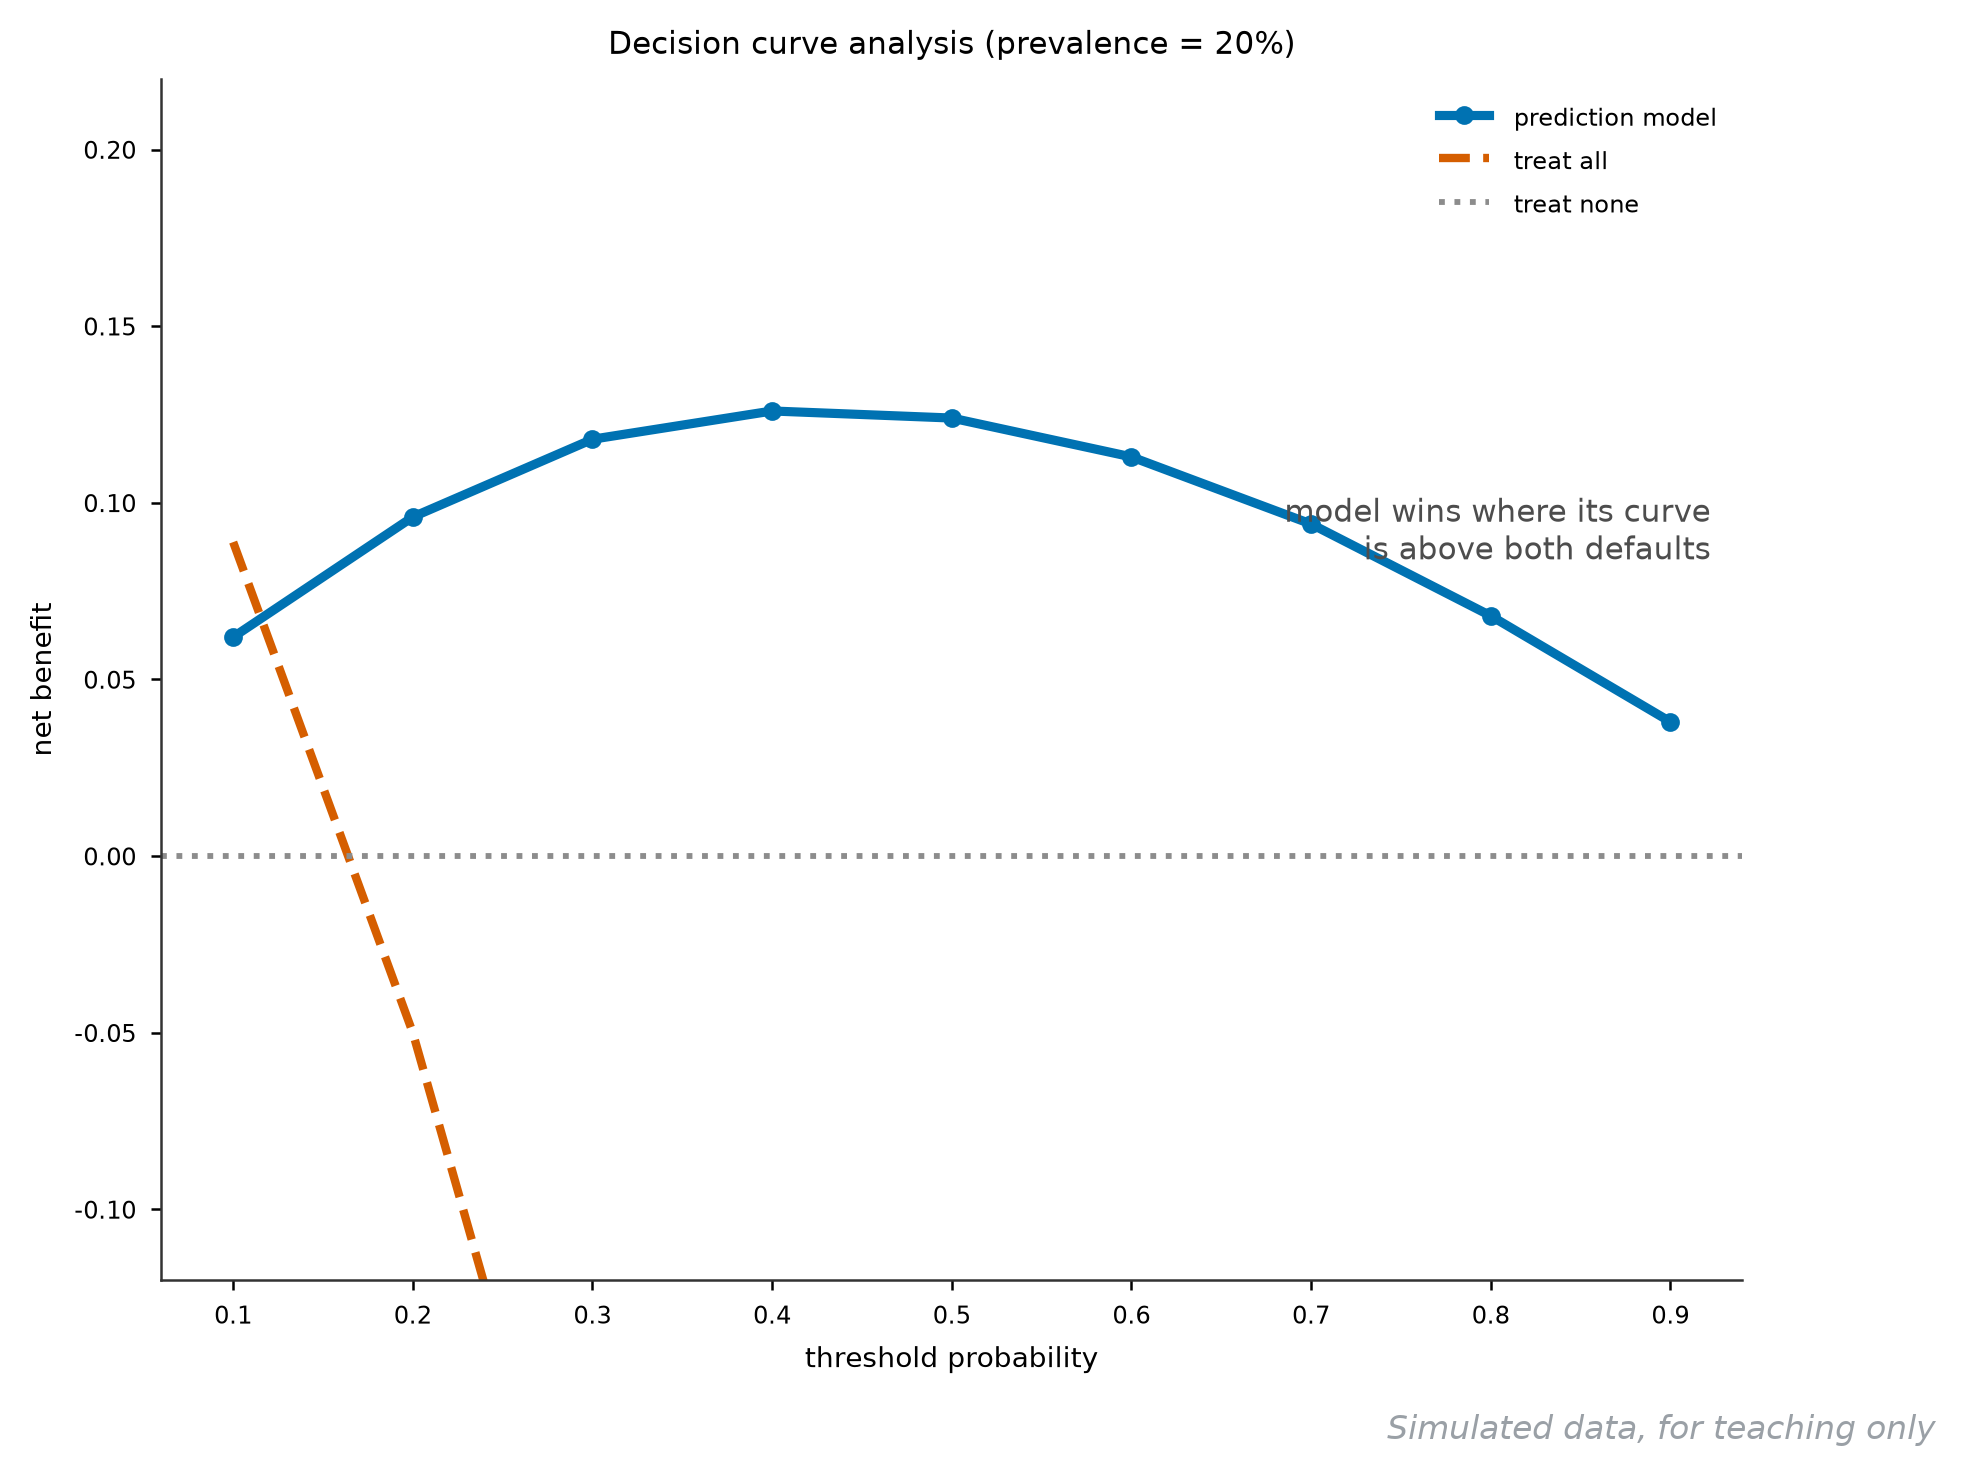
它回答什么问题:ROC 只管准不准,DCA 问更实际的一句——按这个模型决策,净收益比「全部干预」和「都不干预」两个默认策略多多少。
怎么读:横轴是你愿意为「真阳性」付出的假阳性代价(阈值概率),纵轴净收益。三条线里灰平线是「都不干预」(恒为 0),橙虚线是「全部干预」(患病率 20% 时随阈值快速变负)。模型曲线在 0.1 到 0.7 这段区间同时压住两条默认线,说明在这个临床决策窗口内用它划算;超出区间就回到默认策略。两线交叉点就是策略切换点,图注要写明。
用什么画:R 语言 dcurves::dca;Python 用 dcurves 包或按公式手算净收益。
图注示例:
图 22 预测模型的决策曲线分析(患病率 20%)。横轴为阈值概率,纵轴为净收益;模型曲线在阈值 0.1-0.7 区间优于全部干预与不干预两种默认策略(模拟数据演示)。
展开查看:模拟数据(净收益表)
threshold,model_net_benefit,treat_all,treat_none
0.1,0.062,0.089,0.000
0.2,0.096,-0.050,0.000
0.3,0.118,-0.229,0.000
0.4,0.126,-0.467,0.000
0.5,0.124,-0.800,0.000
0.6,0.113,-1.300,0.000
0.7,0.094,-2.133,0.000
0.8,0.068,-3.800,0.000
0.9,0.038,-8.800,0.000
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 21-dca.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("21-dca.csv")
fig, ax = plt.subplots(figsize=(6.8, 5.2))
ax.plot(df.threshold, df.model_net_benefit, "-o", ms=4, color="#4C72B0",
        label="prediction model")
ax.plot(df.threshold, df.treat_all, "--", color="#DD8452", label="treat all")
ax.axhline(0, color="0.55", lw=1.4, ls=":", label="treat none")
ax.set_xlabel("threshold probability")
ax.set_ylabel("net benefit")
ax.legend()
fig.savefig("21-dca.png", dpi=200, bbox_inches="tight")
5.4 森林图(forest plot)
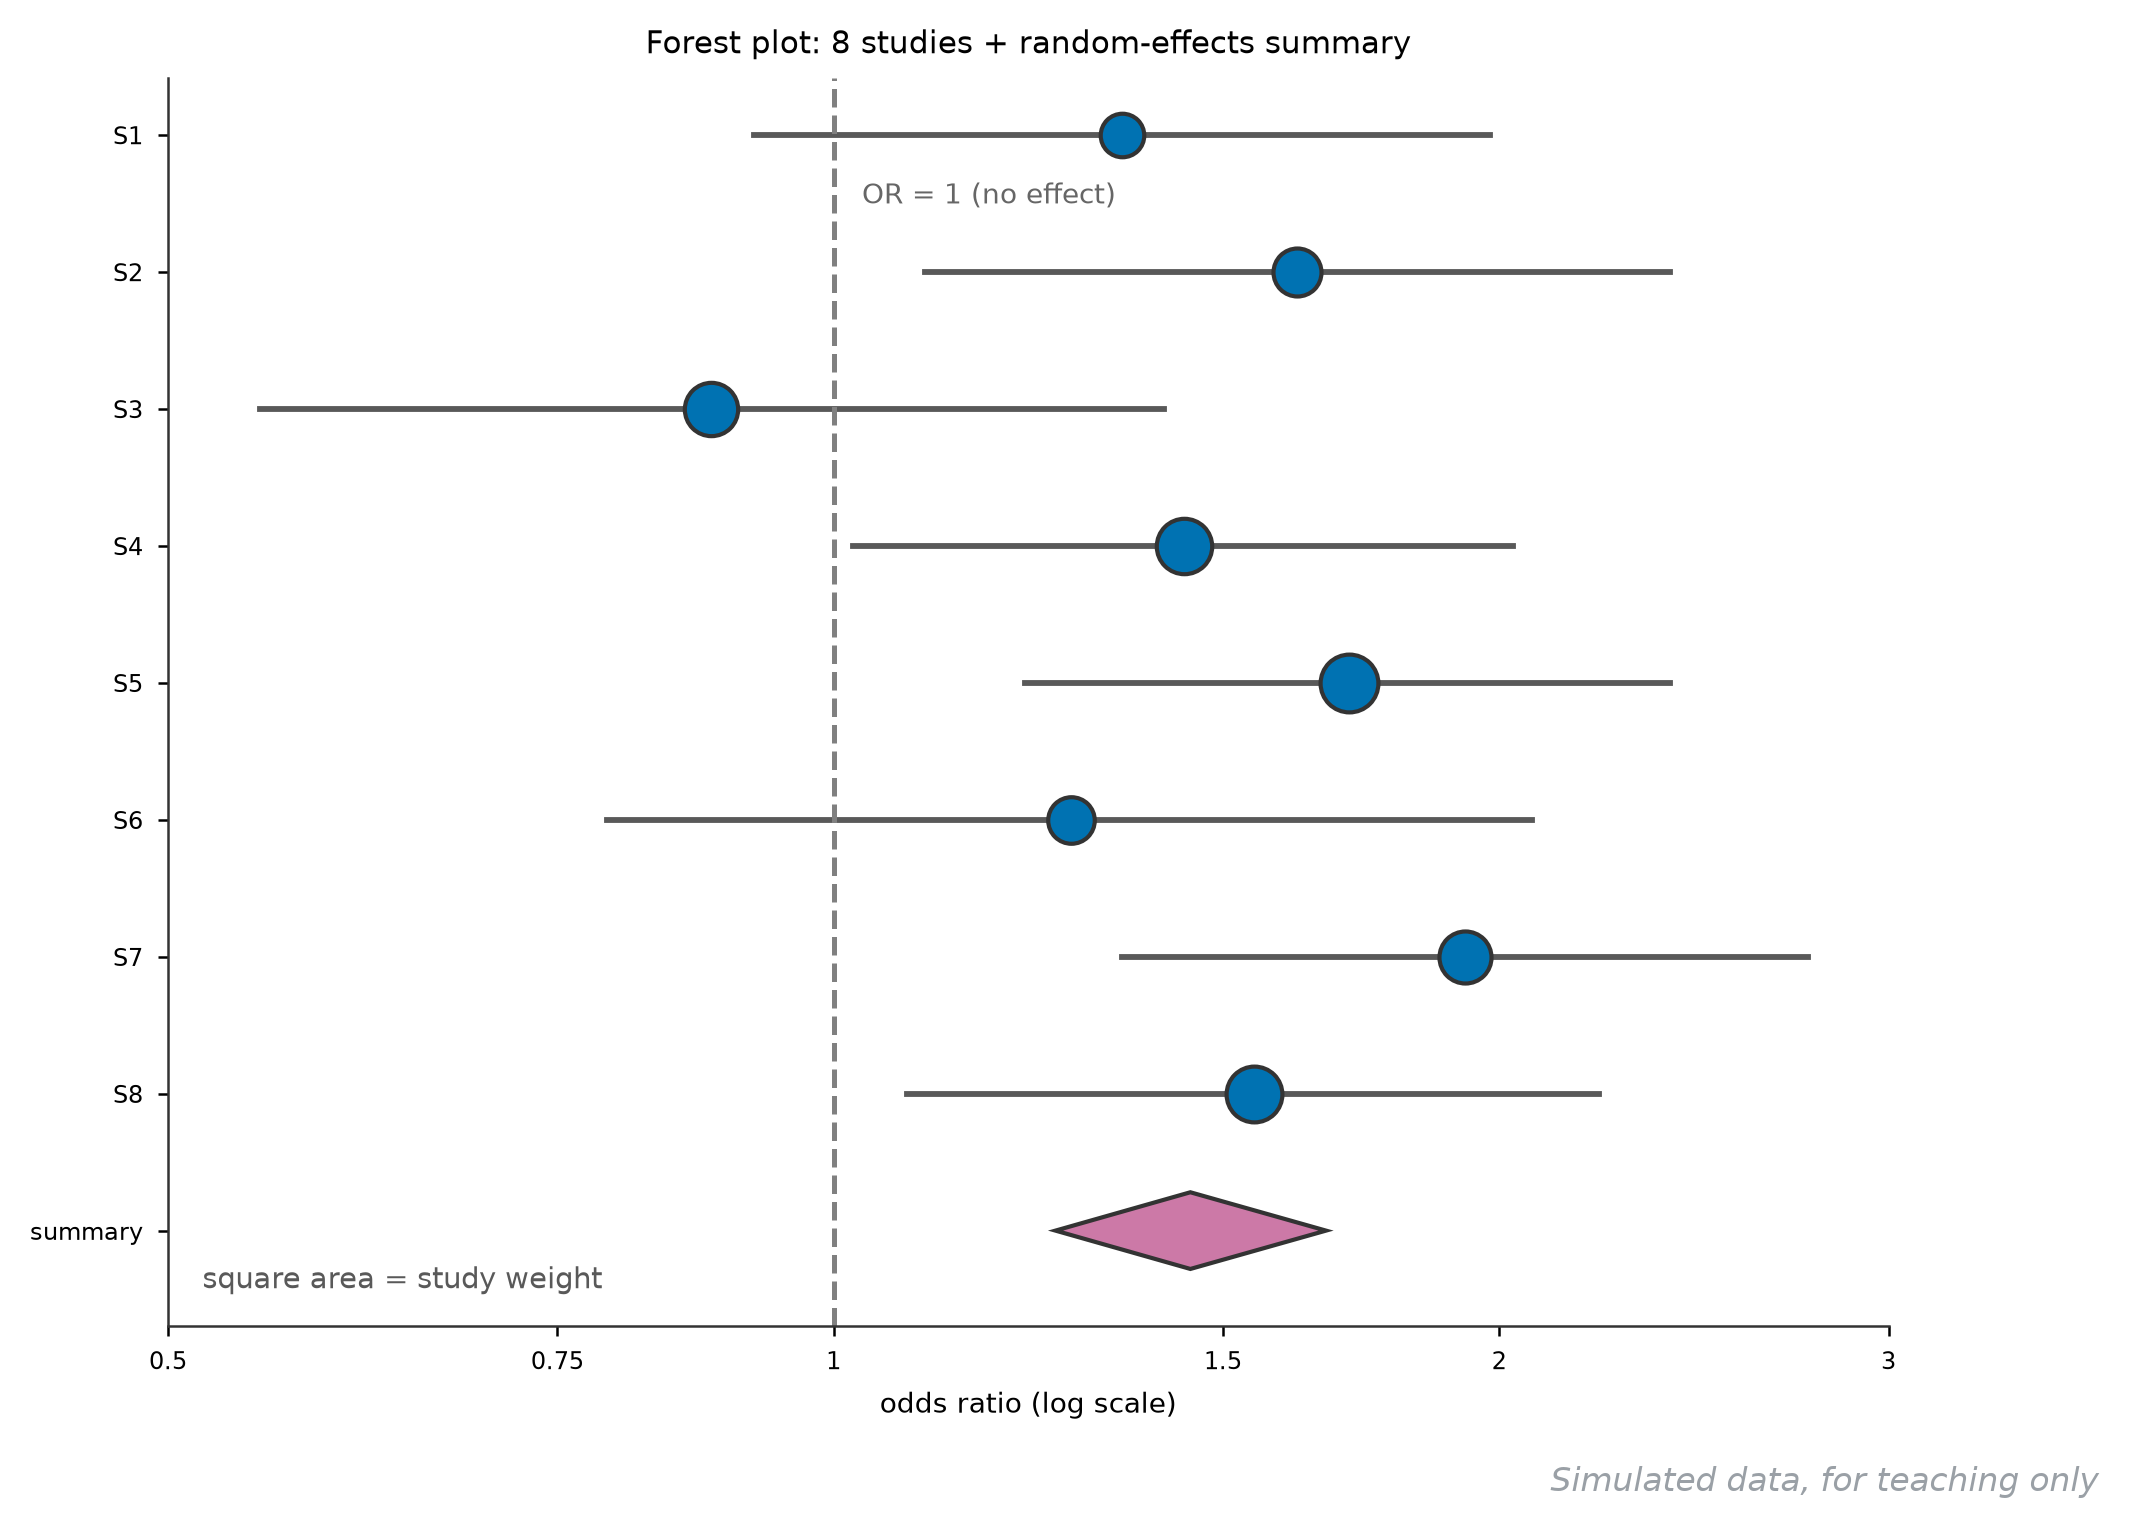
它回答什么问题:把多个独立研究(或多个模型/亚组)的效应量合并成一条总结论,元分析和多队列验证的标配。
怎么读:每行一个研究,方块是效应量(这里为 OR),方块面积正比于研究权重,横线是 95% 置信区间;最下面的红色菱形是合并效应(菱形横向跨度即置信区间)。看三处:菱形是否完全在 OR = 1 参考线右侧(在,说明合并后显著);横线越过 1 的研究(S1、S3、S6 单独看不显著)有几个;以及各研究点是否大致落在一条竖直带上——散得太开要报异质性 I²。
用什么画:R 语言 forestplot 或 meta::forest;Python 用 matplotlib 手绘(方块大小映射权重)。
图注示例:
图 23 8 项独立研究的效应量森林图与随机效应合并结果。方块面积正比研究权重,横线为 95% 置信区间,菱形为合并 OR = 1.45(1.26-1.67)。
展开查看:模拟数据(研究效应量表)
study,or,low,high,weight_pct
S1,1.35,0.92,1.98,4.2
S2,1.62,1.10,2.39,5.1
S3,0.88,0.55,1.41,6.3
S4,1.44,1.02,2.03,6.8
S5,1.71,1.22,2.39,7.4
S6,1.28,0.79,2.07,4.8
S7,1.93,1.35,2.76,6.0
S8,1.55,1.08,2.22,6.9
summary,1.45,1.26,1.67,100.0
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 22-forest.csv
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("22-forest.csv")
orr = df["or"].values
ys = np.arange(len(df))[::-1]
fig, ax = plt.subplots(figsize=(7.4, 5.4))
for i in range(len(df) - 1):
    ax.plot([df.low[i], df.high[i]], [ys[i]] * 2, color="0.35", lw=1.4)
    ax.scatter(orr[i], ys[i], s=df.weight_pct[i] * 26, color="#4C72B0",
               edgecolors="0.2", zorder=3)
si = len(df) - 1
ax.fill([df.low[si], orr[si], df.high[si], orr[si]],
        [ys[-1], ys[-1] + 0.28, ys[-1], ys[-1] - 0.28],
        color="#C44E52", edgecolor="0.2", zorder=3)
ax.axvline(1, color="0.5", ls="--", lw=1.2)
ax.set_yticks(ys, df.study)
ax.set_xscale("log")
ax.set_xlabel("odds ratio (log scale)")
fig.savefig("22-forest.png", dpi=200, bbox_inches="tight")
六、湿实验验证类图
6.1 qRT-PCR 相对表达柱状图
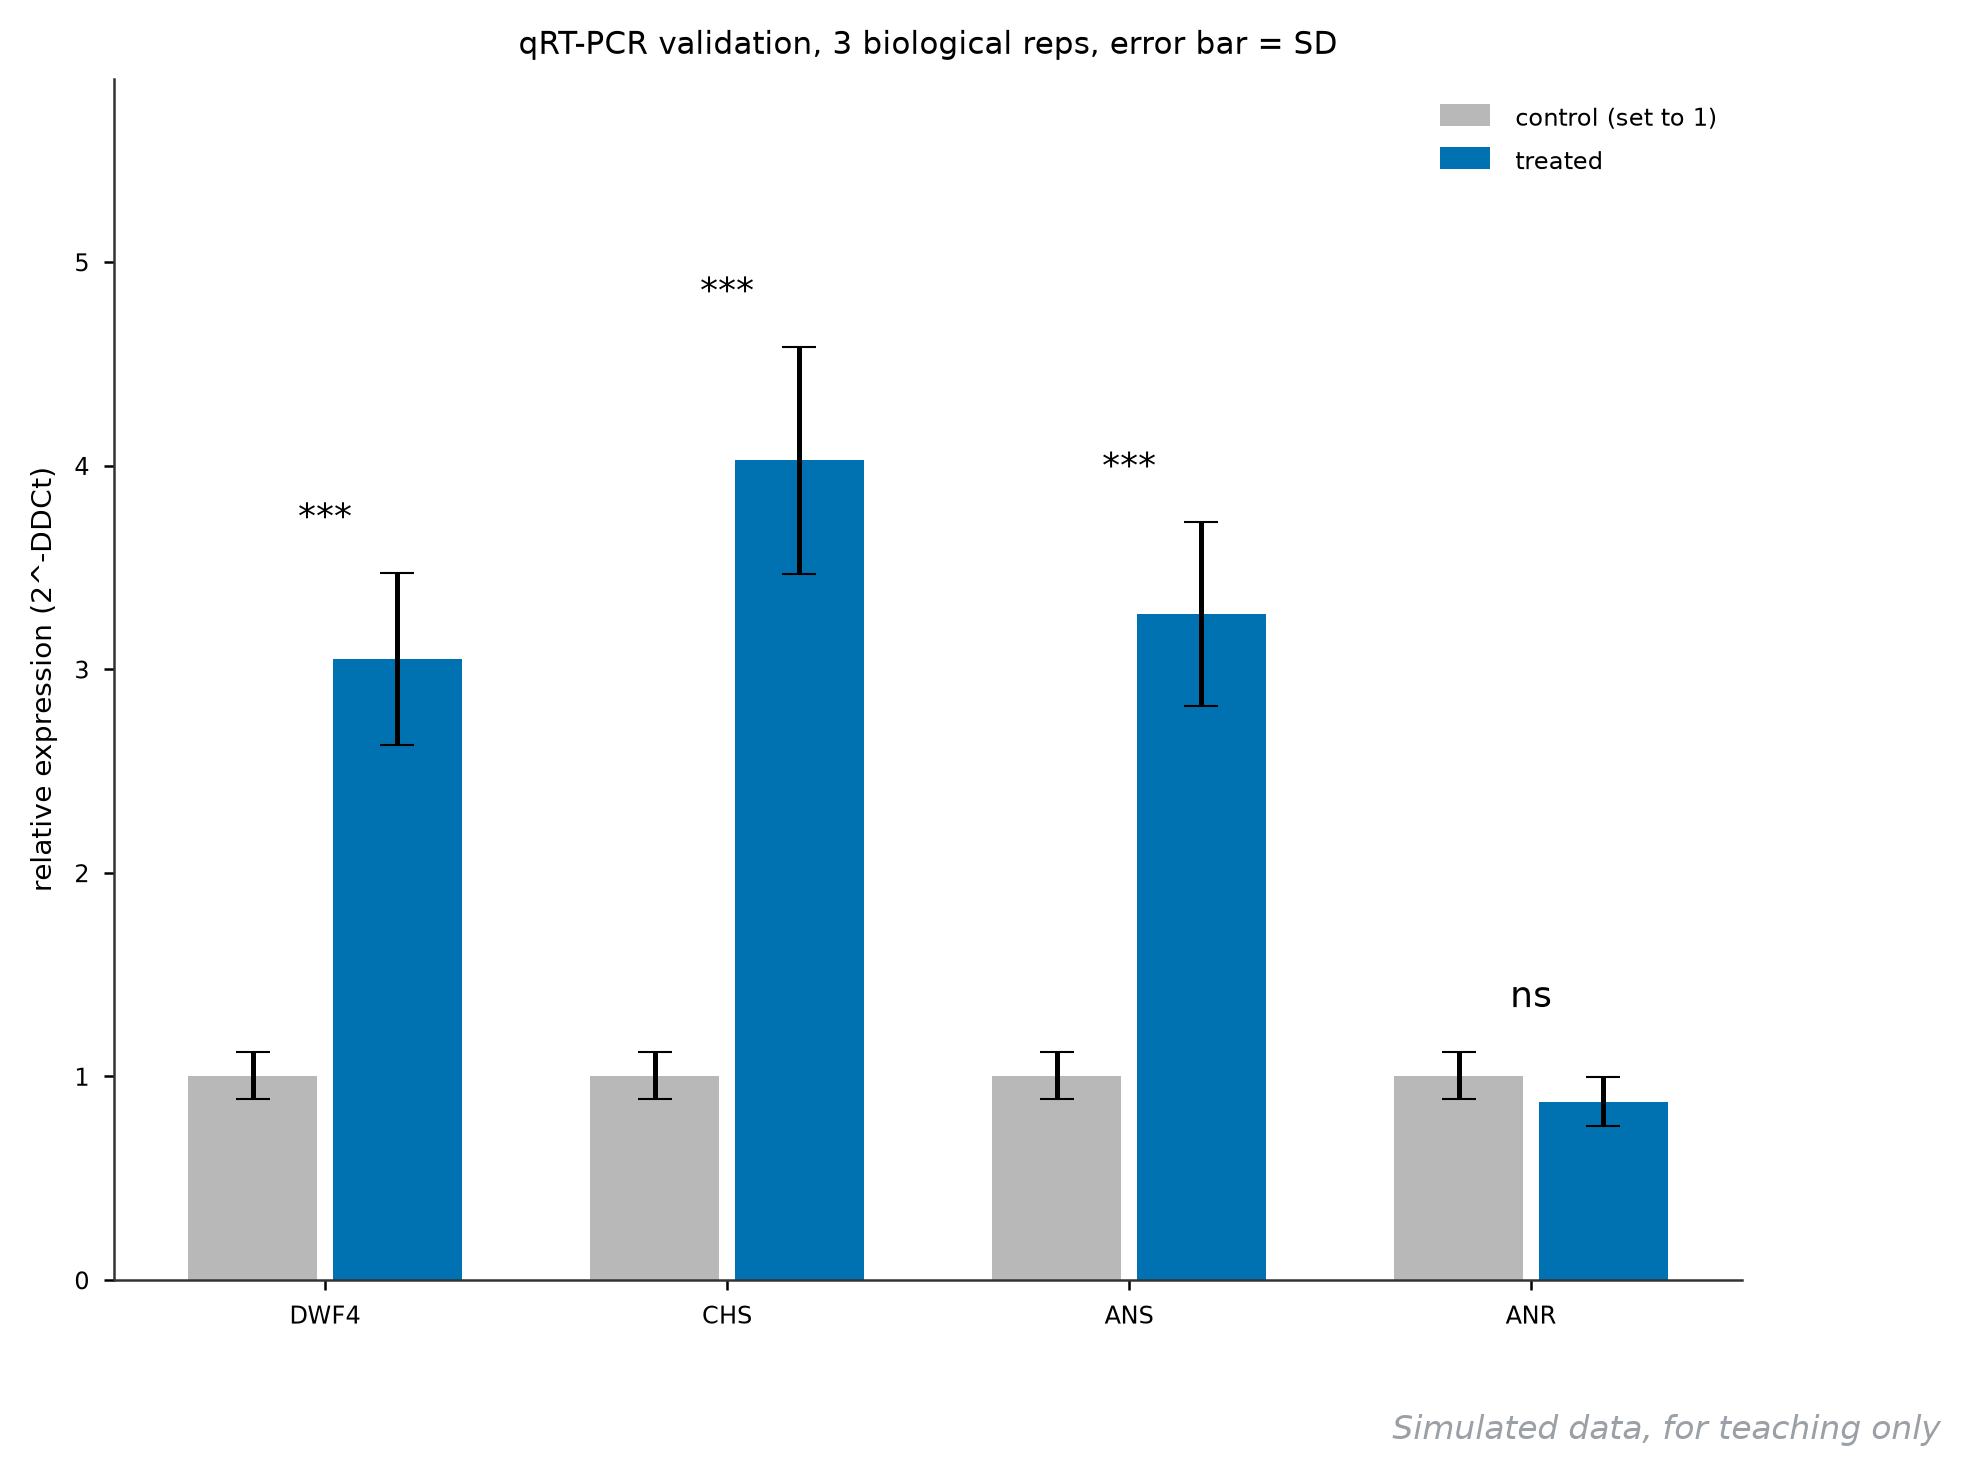
它回答什么问题:转录组测序找到的差异,用独立样本在 qPCR 里再验一遍——审稿人必问的一步。
怎么读:纵轴是 2^-ΔΔCt 相对表达量(对照组校准为 1),误差线是 3 个生物学重复的标准差,柱顶星号来自对 ΔCt 做的 t 检验。看三样:误差线长短(生物学重复间一致性,误差线比效应还大就是白做)、星号数量、以及别忘了反例的价值——这张图里 ANR 明明转录组有信号,qPCR 却是 ns,正适合在正文里诚实讨论「测序信号未获验证」。
用什么画:Excel/GraphPad Prism 是湿实验圈主流;Python 用 matplotlib bar 加 yerr,星号手标。
图注示例:
图 24 qRT-PCR 验证四个候选基因的表达变化。相对表达量以 2^-ΔΔCt 法计算,Actin 为内参,n = 3 次生物学重复,误差线为标准差;与对照组相比,*** 表示 p < 0.001,ns 表示不显著(t 检验)。
展开查看:模拟数据(原始 Ct 值,图中柱高由它算出)
gene,condition,rep,Ct_target,Ct_ref
DWF4,control,1,24.1,18.2
DWF4,control,2,24.3,18.1
DWF4,control,3,24.2,18.3
DWF4,treated,1,22.4,18.2
DWF4,treated,2,22.6,18.0
DWF4,treated,3,22.5,18.1
CHS,control,1,21.0,18.2
CHS,control,2,21.2,18.1
CHS,control,3,21.1,18.3
CHS,treated,1,18.9,18.2
CHS,treated,2,19.1,18.0
CHS,treated,3,19.0,18.1
ANS,control,1,23.2,18.2
ANS,control,2,23.4,18.1
ANS,control,3,23.3,18.3
ANS,treated,1,21.4,18.2
ANS,treated,2,21.6,18.0
ANS,treated,3,21.5,18.1
ANR,control,1,22.8,18.2
ANR,control,2,23.0,18.1
ANR,control,3,22.9,18.3
ANR,treated,1,22.9,18.2
ANR,treated,2,23.1,18.0
ANR,treated,3,23.0,18.1
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 23-qrt-pcr.csv(原始 Ct 值,Actin 为内参)
import numpy as np
import pandas as pd
from scipy import stats
import matplotlib.pyplot as plt

df = pd.read_csv("23-qrt-pcr.csv")
df["dCt"] = df.Ct_target - df.Ct_ref
ctl_mean = df[df.condition == "control"].groupby("gene").dCt.mean()
df["fold"] = 2 ** -(df.dCt - df.gene.map(ctl_mean))
genes = ["DWF4", "CHS", "ANS", "ANR"]
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52"]
x = np.arange(len(genes))
fig, ax = plt.subplots(figsize=(7.0, 5.2))
for k, cond in enumerate(["control", "treated"]):
    sub = df[df.condition == cond]
    m = sub.groupby("gene").fold.mean()[genes]
    e = sub.groupby("gene").fold.std(ddof=1)[genes]
    ax.bar(x + (k - 0.5) * 0.36, m, 0.32, yerr=e, capsize=4,
           color="0.72" if k == 0 else "#C44E52", label=cond)
for i, g in enumerate(genes):                     # 对 dCt 做 t 检验标星号
    a = df[(df.gene == g) & (df.condition == "control")].dCt
    b = df[(df.gene == g) & (df.condition == "treated")].dCt
    p = stats.ttest_ind(a, b).pvalue
    star = "***" if p < 0.001 else ("**" if p < 0.01 else ("*" if p < 0.05 else "ns"))
    ax.text(x[i], 5.3, star, ha="center", fontsize=11)
ax.set_xticks(x, genes)
ax.set_ylim(0, 5.9)
ax.set_ylabel("relative expression (2^-DDCt)")
ax.legend()
fig.savefig("23-qrt-pcr-bar.png", dpi=200, bbox_inches="tight")
6.2 qPCR 扩增曲线
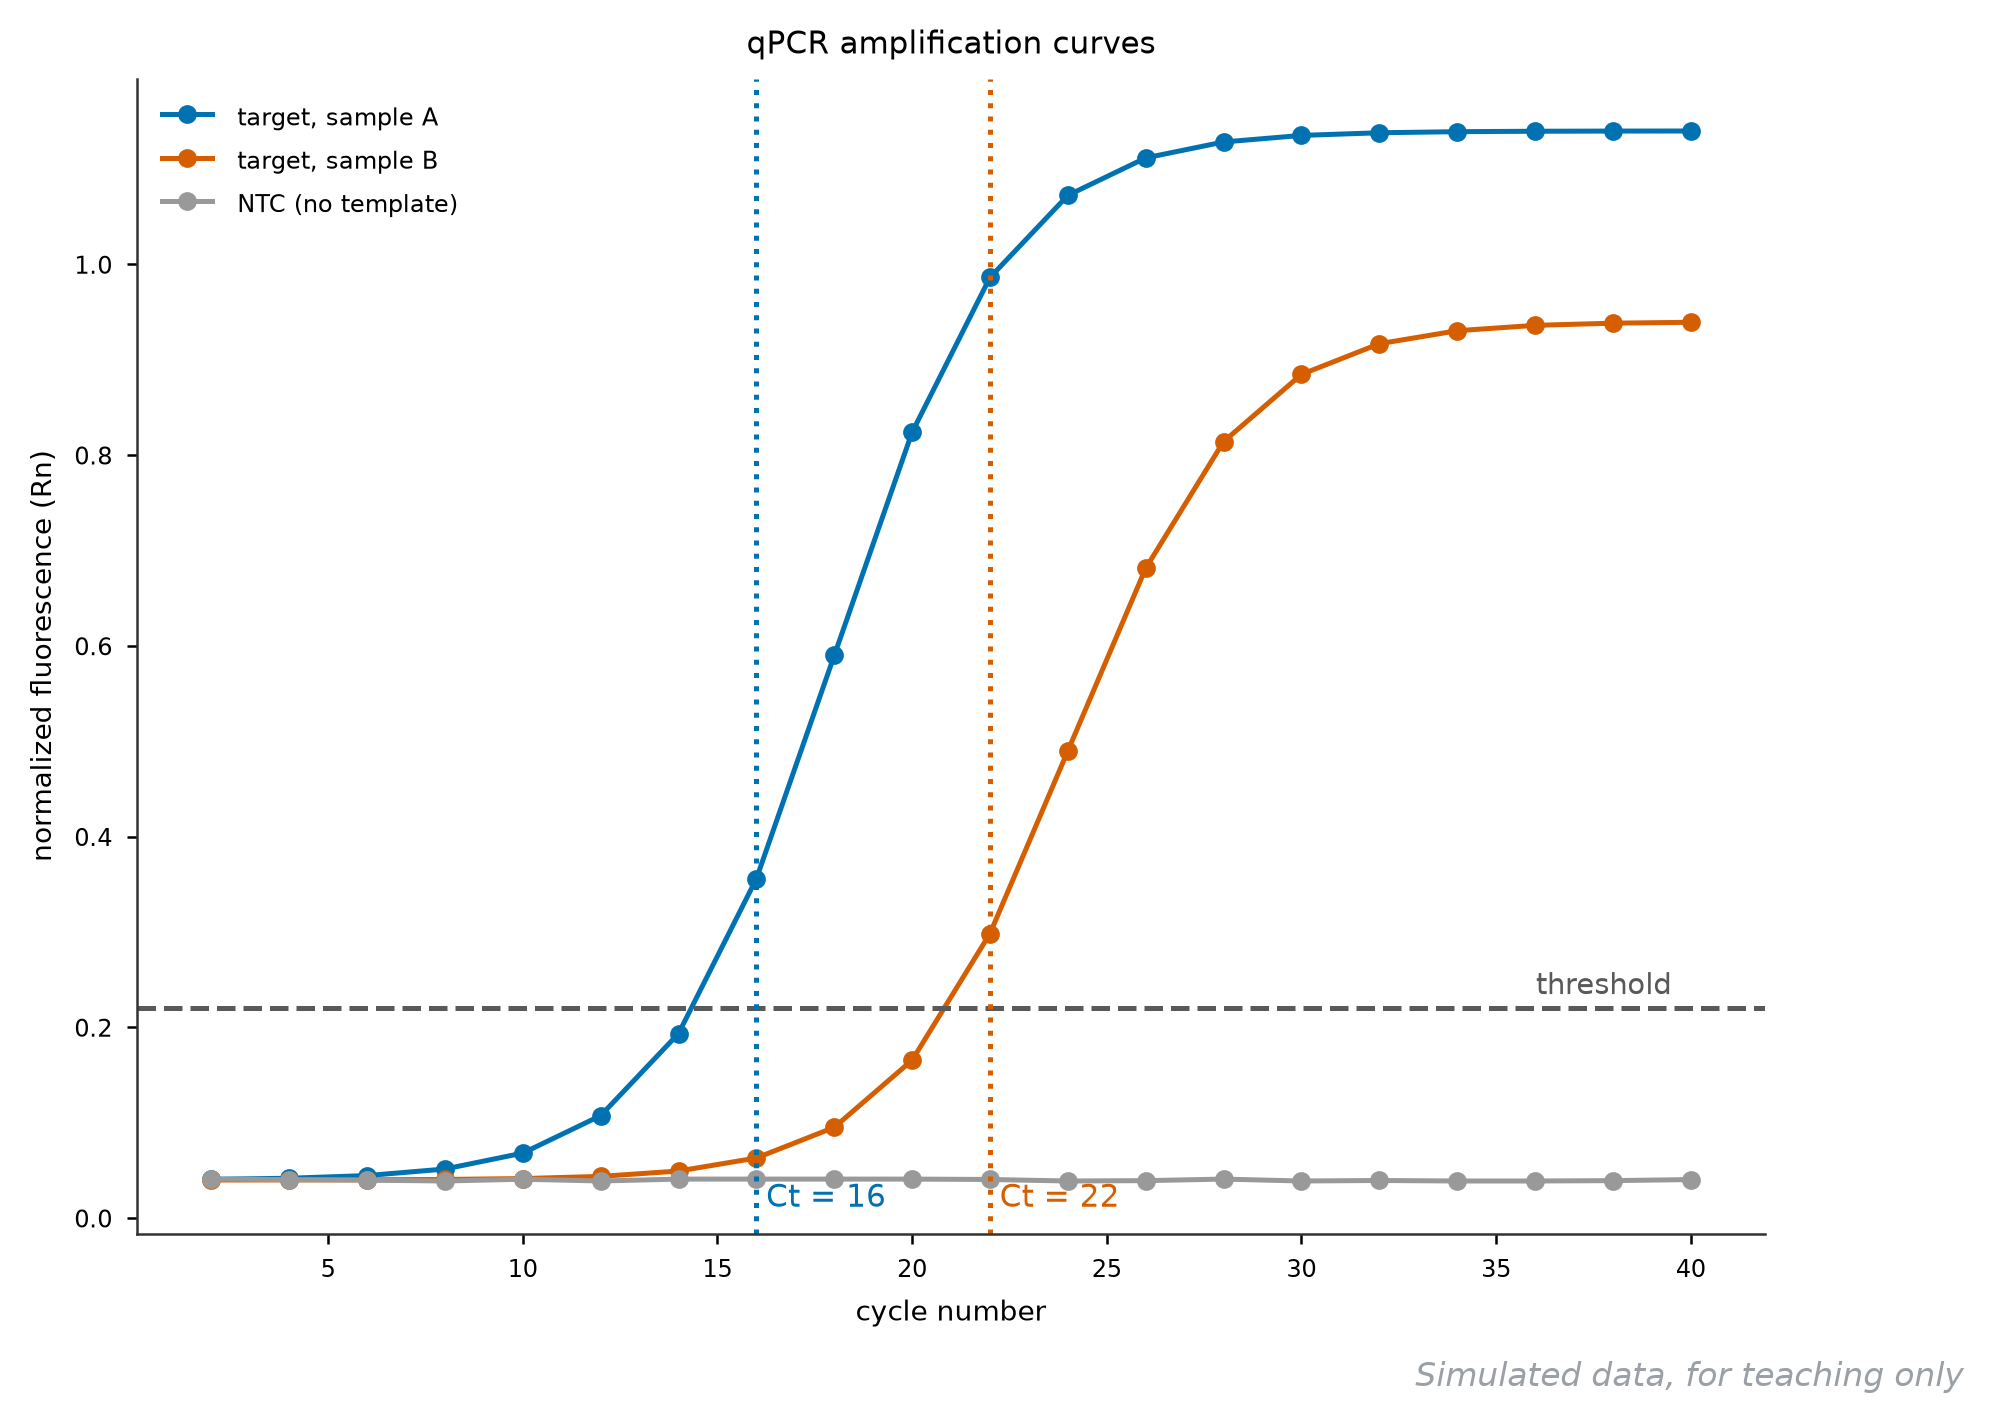
它回答什么问题:荧光信号什么时候起跳——Ct 值的来源,也是判断扩增有没有发生的原始证据。
怎么读:S 形曲线分四段:基线期(荧光在背景噪声里)、指数期(模板充足,Ct 就定义在荧光越过阈值线的那一刻)、线性期和平台期(底物耗尽,不要再读平台期的高矮)。看三样:样本 A 的 Ct = 16 早于样本 B 的 Ct = 22,差距约 6 个循环对应约 64 倍起始模板差(每 10 倍约 3.3 循环);NTC(无模板对照)整条贴地,一旦 NTC 也起跳就是污染,这组数据全部作废。
用什么画:仪器自带软件导出;重绘用 Python matplotlib 画点线加阈值横线即可。
图注示例:
图 25 目标基因 qPCR 扩增曲线。横轴为循环数,纵轴为归一化荧光信号(Rn);灰色虚线为荧光阈值,样本 A、B 的 Ct 值分别为 16 与 22,NTC 无扩增。
展开查看:模拟数据(循环-荧光表)
cycle,sample_A,sample_B,NTC
2,0.041,0.040,0.041
4,0.042,0.040,0.040
6,0.045,0.040,0.040
8,0.052,0.041,0.039
10,0.068,0.042,0.041
12,0.108,0.044,0.039
14,0.194,0.049,0.041
16,0.356,0.063,0.041
18,0.590,0.095,0.041
20,0.824,0.166,0.041
22,0.986,0.298,0.041
24,1.072,0.490,0.039
26,1.112,0.682,0.039
28,1.128,0.814,0.041
30,1.135,0.885,0.039
32,1.138,0.917,0.040
34,1.139,0.931,0.039
36,1.140,0.936,0.039
38,1.140,0.938,0.039
40,1.140,0.939,0.041
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 24-amp.csv(也可以像本例一样直接用逻辑函数生成)
import numpy as np
import matplotlib.pyplot as plt

cyc = np.arange(2, 41, 2)
sig = lambda c, ct, amp: 0.04 + amp / (1 + np.exp(-(c - ct) / 2.2))
fa, fb = sig(cyc, 18, 1.1), sig(cyc, 24, 0.9)
thr = 0.22
fig, ax = plt.subplots(figsize=(7.0, 5.0))
ax.plot(cyc, fa, "-o", ms=4, color="#4C72B0", label="sample A")
ax.plot(cyc, fb, "-o", ms=4, color="#DD8452", label="sample B")
ax.plot(cyc, np.full_like(cyc, 0.04), "-o", ms=4, color="0.6", label="NTC")
ax.axhline(thr, color="0.35", ls="--", lw=1.2)
for f, col in [(fa, "#4C72B0"), (fb, "#DD8452")]:
    ct = cyc[np.argmax(f > thr)]
    ax.axvline(ct, color=col, ls=":", lw=1.2)
    ax.text(ct + 0.3, 0.015, "Ct = %d" % ct, fontsize=9.5, color=col)
ax.set_xlabel("cycle number")
ax.set_ylabel("normalized fluorescence (Rn)")
ax.legend(loc="upper left")
fig.savefig("24-amp-curve.png", dpi=200, bbox_inches="tight")
6.3 熔解曲线与一阶导数峰
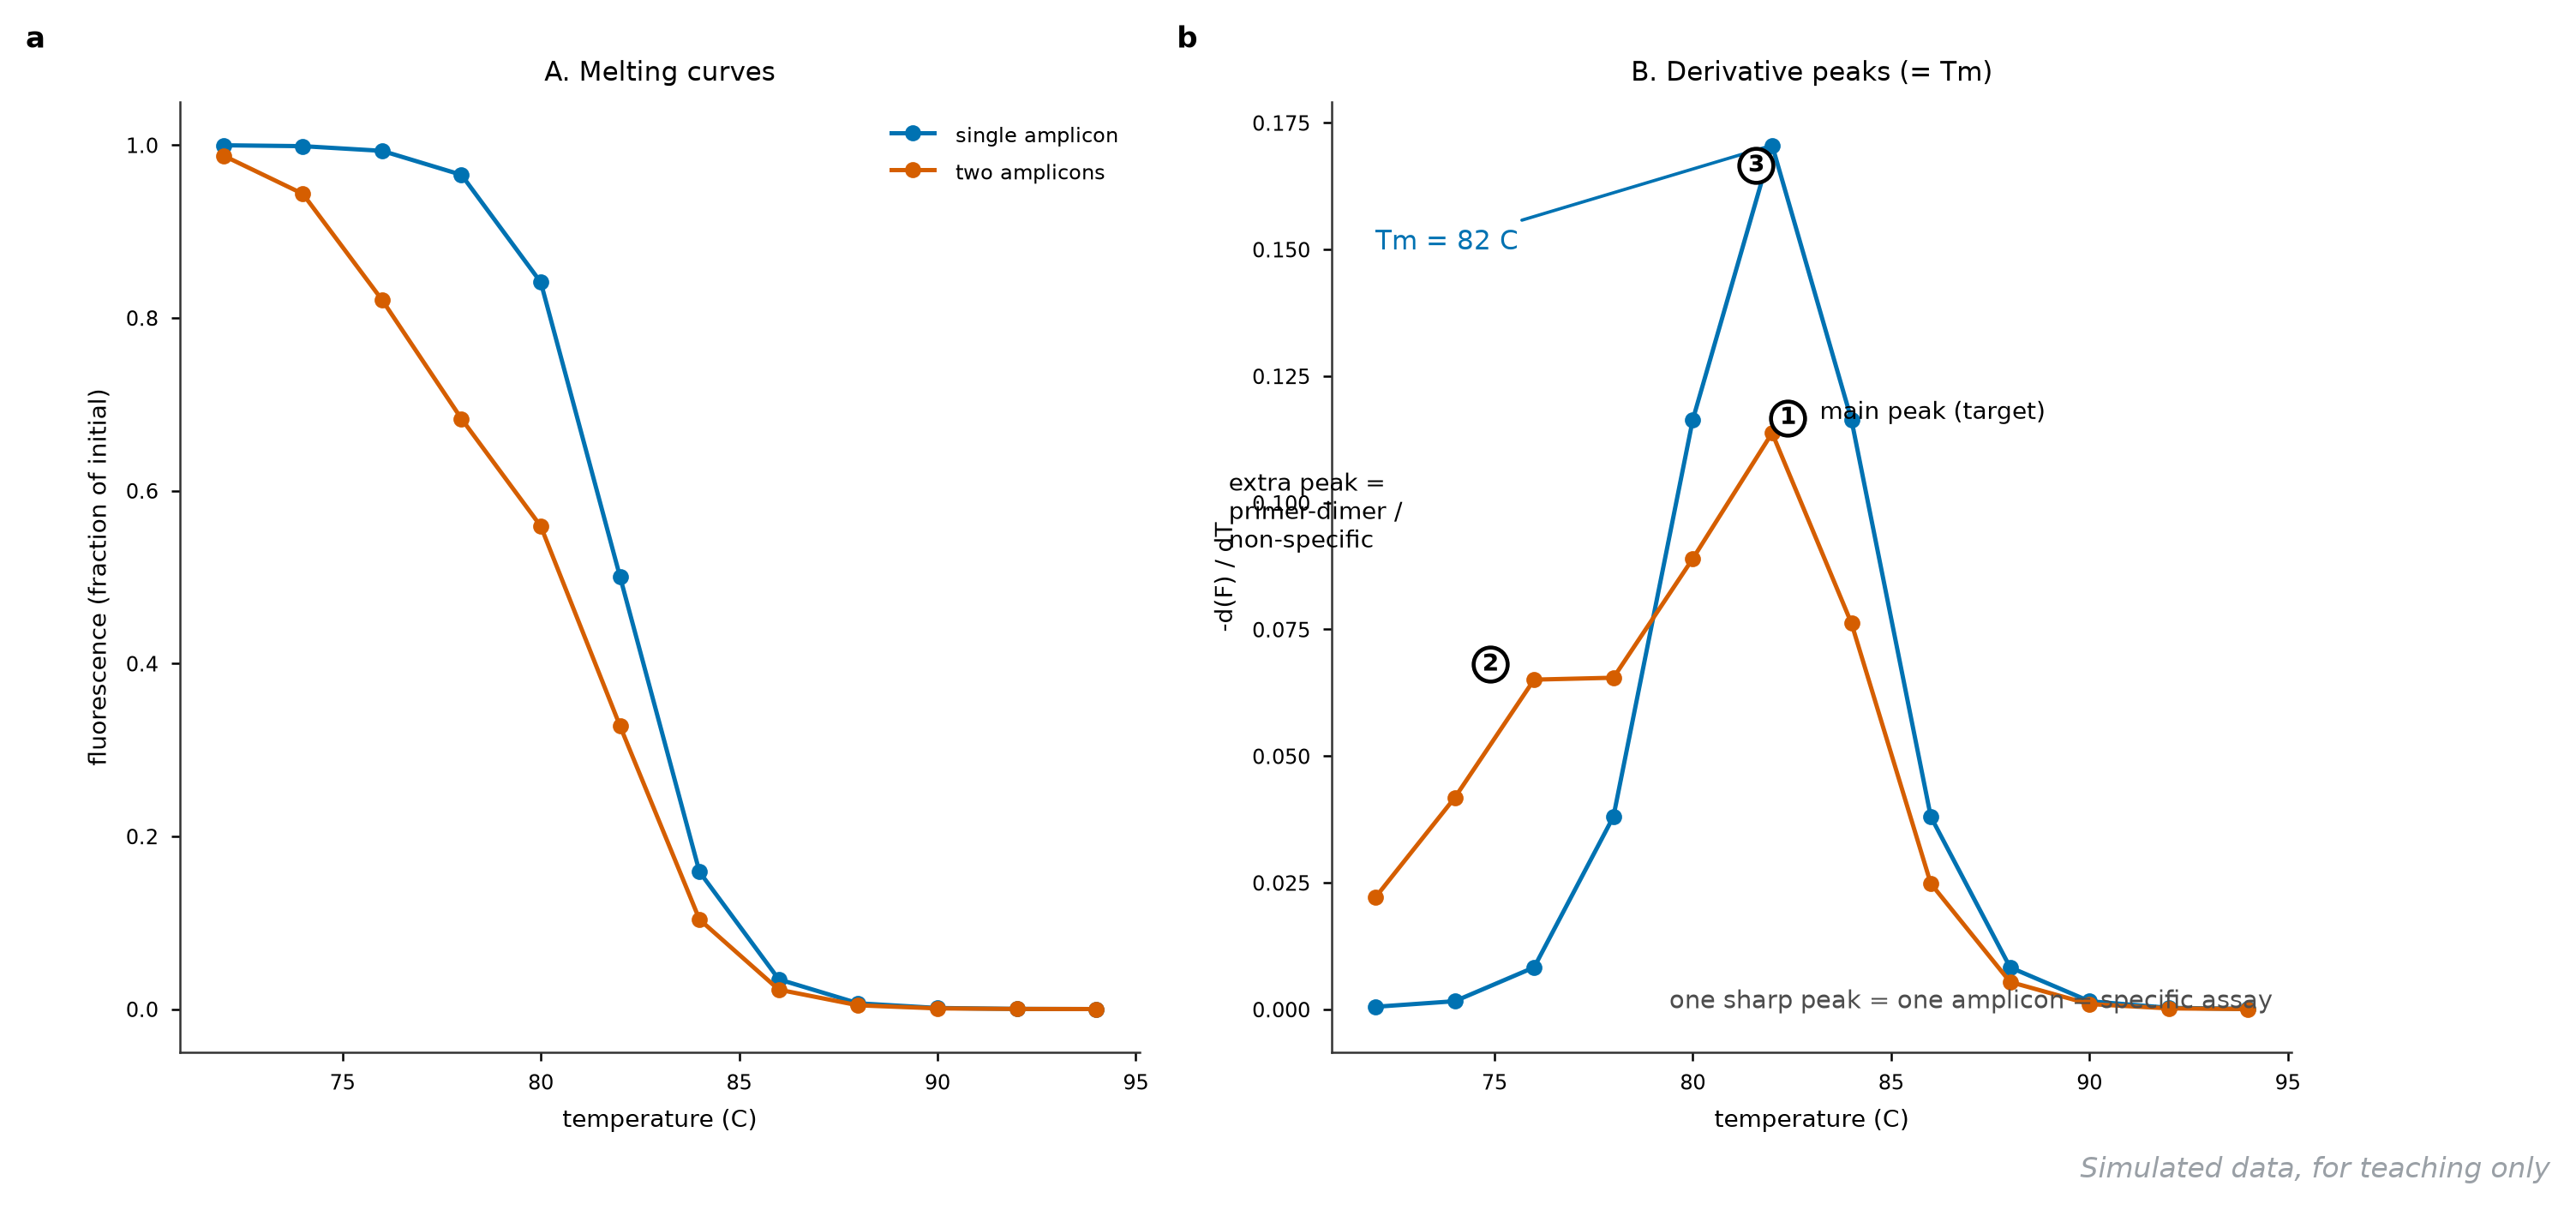
它回答什么问题:扩增出的产物是不是你想要的那一条——融解曲线是 qPCR 特异性的最后防线,图上那 ①②③ 的标注写法也是本文第九章的示范案例。
怎么读:左图荧光随温度升高而骤降(双链解开,染料掉光),拐点就是熔解温度 Tm;右图对负斜率求导得到峰,一个尖峰 = 一种产物。图上三个标注:① 双扩增样本在 82 C 的主峰(目标条带)、② 它在 76 C 多出来的小肩峰(引物二聚体或非特异产物,出现即弃掉这一孔)、③ 单扩增样本干净的单峰。导数峰比肉眼读拐点可靠得多,报告 Tm 一律从峰顶取。
用什么画:仪器软件直接给;重绘时对荧光曲线做 numpy.gradient 求一阶导数再取负。
图注示例:
图 26 qPCR 熔解曲线(A)及其一阶负导数(B)。单扩增样本呈单一尖锐峰(Tm = 82 C,③);双扩增样本可见 82 C 主峰(①)与 76 C 附加峰(②),提示存在引物二聚体或非特异扩增。
展开查看:模拟数据(温度-荧光表)
temperature,fluor_good,fluor_two_peak
72,1.000,0.988
74,0.999,0.944
76,0.993,0.821
78,0.966,0.683
80,0.841,0.559
82,0.500,0.327
84,0.159,0.104
86,0.034,0.022
88,0.007,0.004
90,0.001,0.001
92,0.000,0.000
94,0.000,0.000
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 25-melt.csv(也可用 sigmoid 生成,见 Tm 列表)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("25-melt.csv")
T = df.temperature.values
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.8), sharex=True)
ax1.plot(T, df.fluor_good, "-o", ms=4, color="#4C72B0", label="single amplicon")
ax1.plot(T, df.fluor_two_peak, "-o", ms=4, color="#DD8452", label="two amplicons")
ax1.set(xlabel="temperature (C)", ylabel="fluorescence (fraction)")
ax1.legend()
der_good = -np.gradient(df.fluor_good, T)      # 一阶负导数,注意用 T 作坐标
der_bad = -np.gradient(df.fluor_two_peak, T)
ax2.plot(T, der_good, "-o", ms=4, color="#4C72B0")
ax2.plot(T, der_bad, "-o", ms=4, color="#DD8452")
ax2.set(xlabel="temperature (C)", ylabel="-d(F) / dT")
pk = T[np.argmax(der_good)]
ax2.annotate("Tm = %d C" % pk, (pk, der_good.max()), (pk - 7, der_good.max() * 0.85),
             fontsize=9.5, color="#4C72B0",
             arrowprops=dict(arrowstyle="-", color="#4C72B0", lw=0.9))
fig.savefig("25-melt-curve.png", dpi=200, bbox_inches="tight")
6.4 引物扩增子在 CDS 上的锚定图
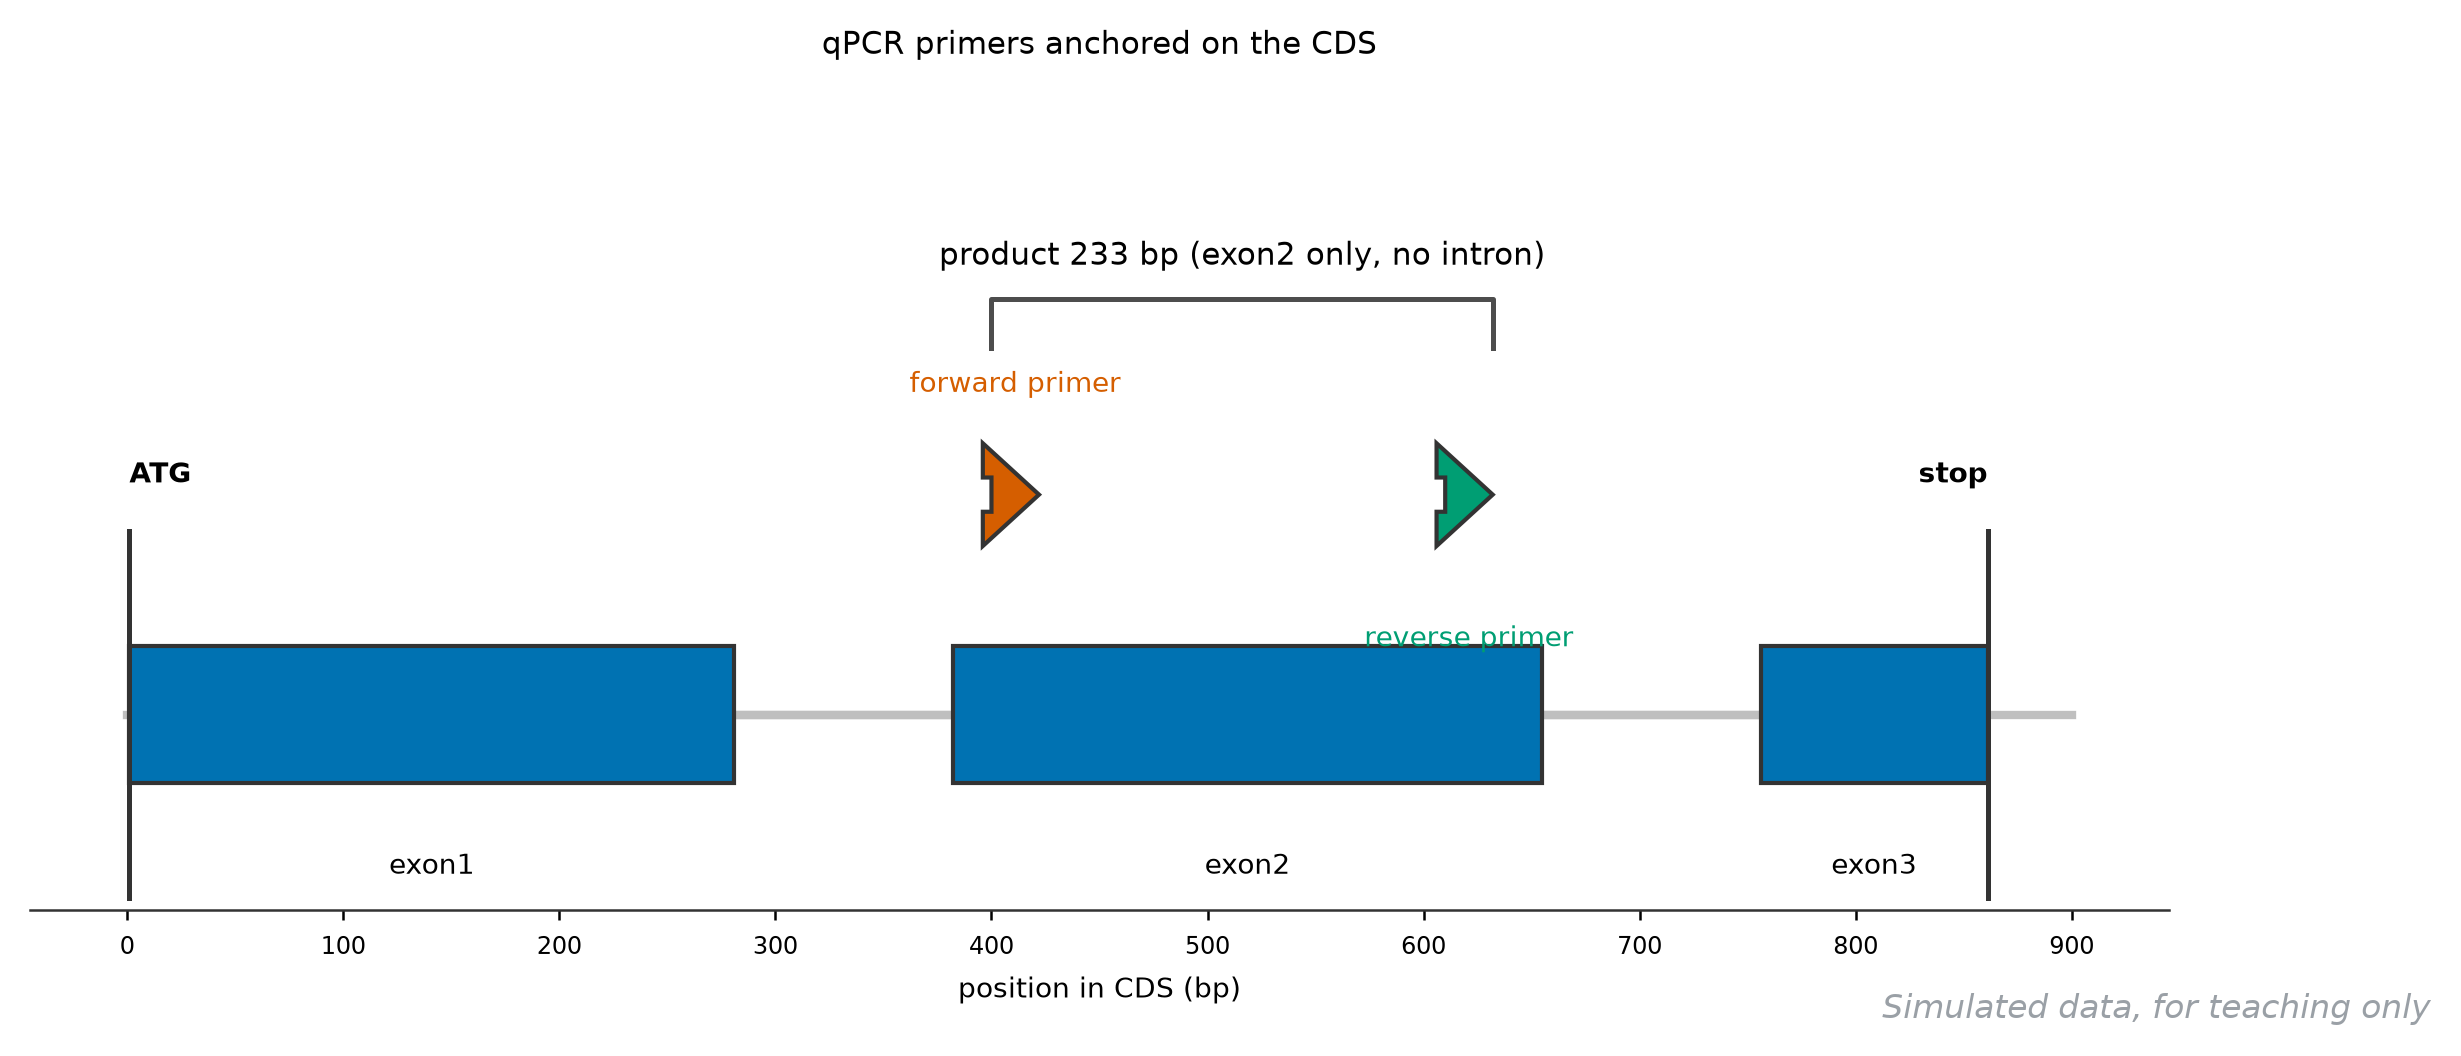
它回答什么问题:qPCR 引物钉在基因模型的哪个位置、产物跨不跨内含子——载体设计与引物交付前的自检图。这就是你说的「候选基因 qPCR 在 CDS 上锚定的位置与扩增子范围」。
怎么读:蓝色方块是外显子,细线是内含子,左侧 ATG 右侧 stop 标出编码区边界;橙色、绿色箭头是一对引物的结合区,上方括号是预期产物。这张设计的三个要点全部画在图上:产物 233 bp 完全落在 exon2 内部(qRT-PCR 要跨 cDNA,不跨内含子反而稳)、正反引物间距约 200 bp(扩增效率的最适区间)、产物远离外显子边界(避免基因组 DNA 污染干扰)。载体构建示意图也是同一套画法,把引物换成酶切位点即可。
用什么画:SnapGene 交互式设计;出发表级图用 Python matplotlib 按坐标画方块加箭头(数据就是下面那张坐标表)。
图注示例:
图 27 候选基因 CDS 结构与 qPCR 引物锚定位置。蓝色方框为外显子,箭头为引物结合区,产物长度 233 bp,完全位于第二外显子内。
展开查看:模拟数据(基因结构坐标表)
feature,start,end
exon1,1,281
intron1,282,381
exon2,382,655
intron2,656,755
exon3,756,861
forward_primer,400,422
reverse_primer,610,632
product,400,632
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 26-amplicon.csv
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle, FancyArrow

df = pd.read_csv("26-amplicon.csv")
fig, ax = plt.subplots(figsize=(9.2, 3.6))
ax.plot([0, 900], [1, 1], color="0.75", lw=2)
for _, row in df.iterrows():
    f, s, e = row.feature, int(row.start), int(row.end)
    if f.startswith("exon"):
        ax.add_patch(Rectangle((s, 0.72), e - s, 0.56, facecolor="#4C72B0",
                               edgecolor="0.2"))
        ax.text((s + e) / 2, 0.35, f, ha="center", fontsize=8.5)
    elif f.endswith("primer"):
        col = "#DD8452" if f.startswith("forward") else "#55A868"
        ax.add_patch(FancyArrow(s, 1.9, e - s, 0, width=0.14, head_width=0.42,
                                head_length=26, length_includes_head=True,
                                facecolor=col, edgecolor="0.2"))
        dy = 0.42 if f.startswith("forward") else -0.62
        ax.text((s + e) / 2, 1.9 + dy, f.replace("_", " "), ha="center",
                fontsize=8.5, color=col)
ax.plot([400, 400, 632, 632], [2.5, 2.7, 2.7, 2.5], color="0.3", lw=1.2)
ax.text(516, 2.84, "product 233 bp", ha="center", fontsize=9.5)
ax.set_xticks(range(0, 901, 100))
ax.set_xlabel("position in CDS (bp)")
ax.set_yticks([])
ax.spines["left"].set_visible(False)
fig.savefig("26-amplicon-cds.png", dpi=200, bbox_inches="tight")
6.5 Western Blot 与 Co-IP 图(示意)
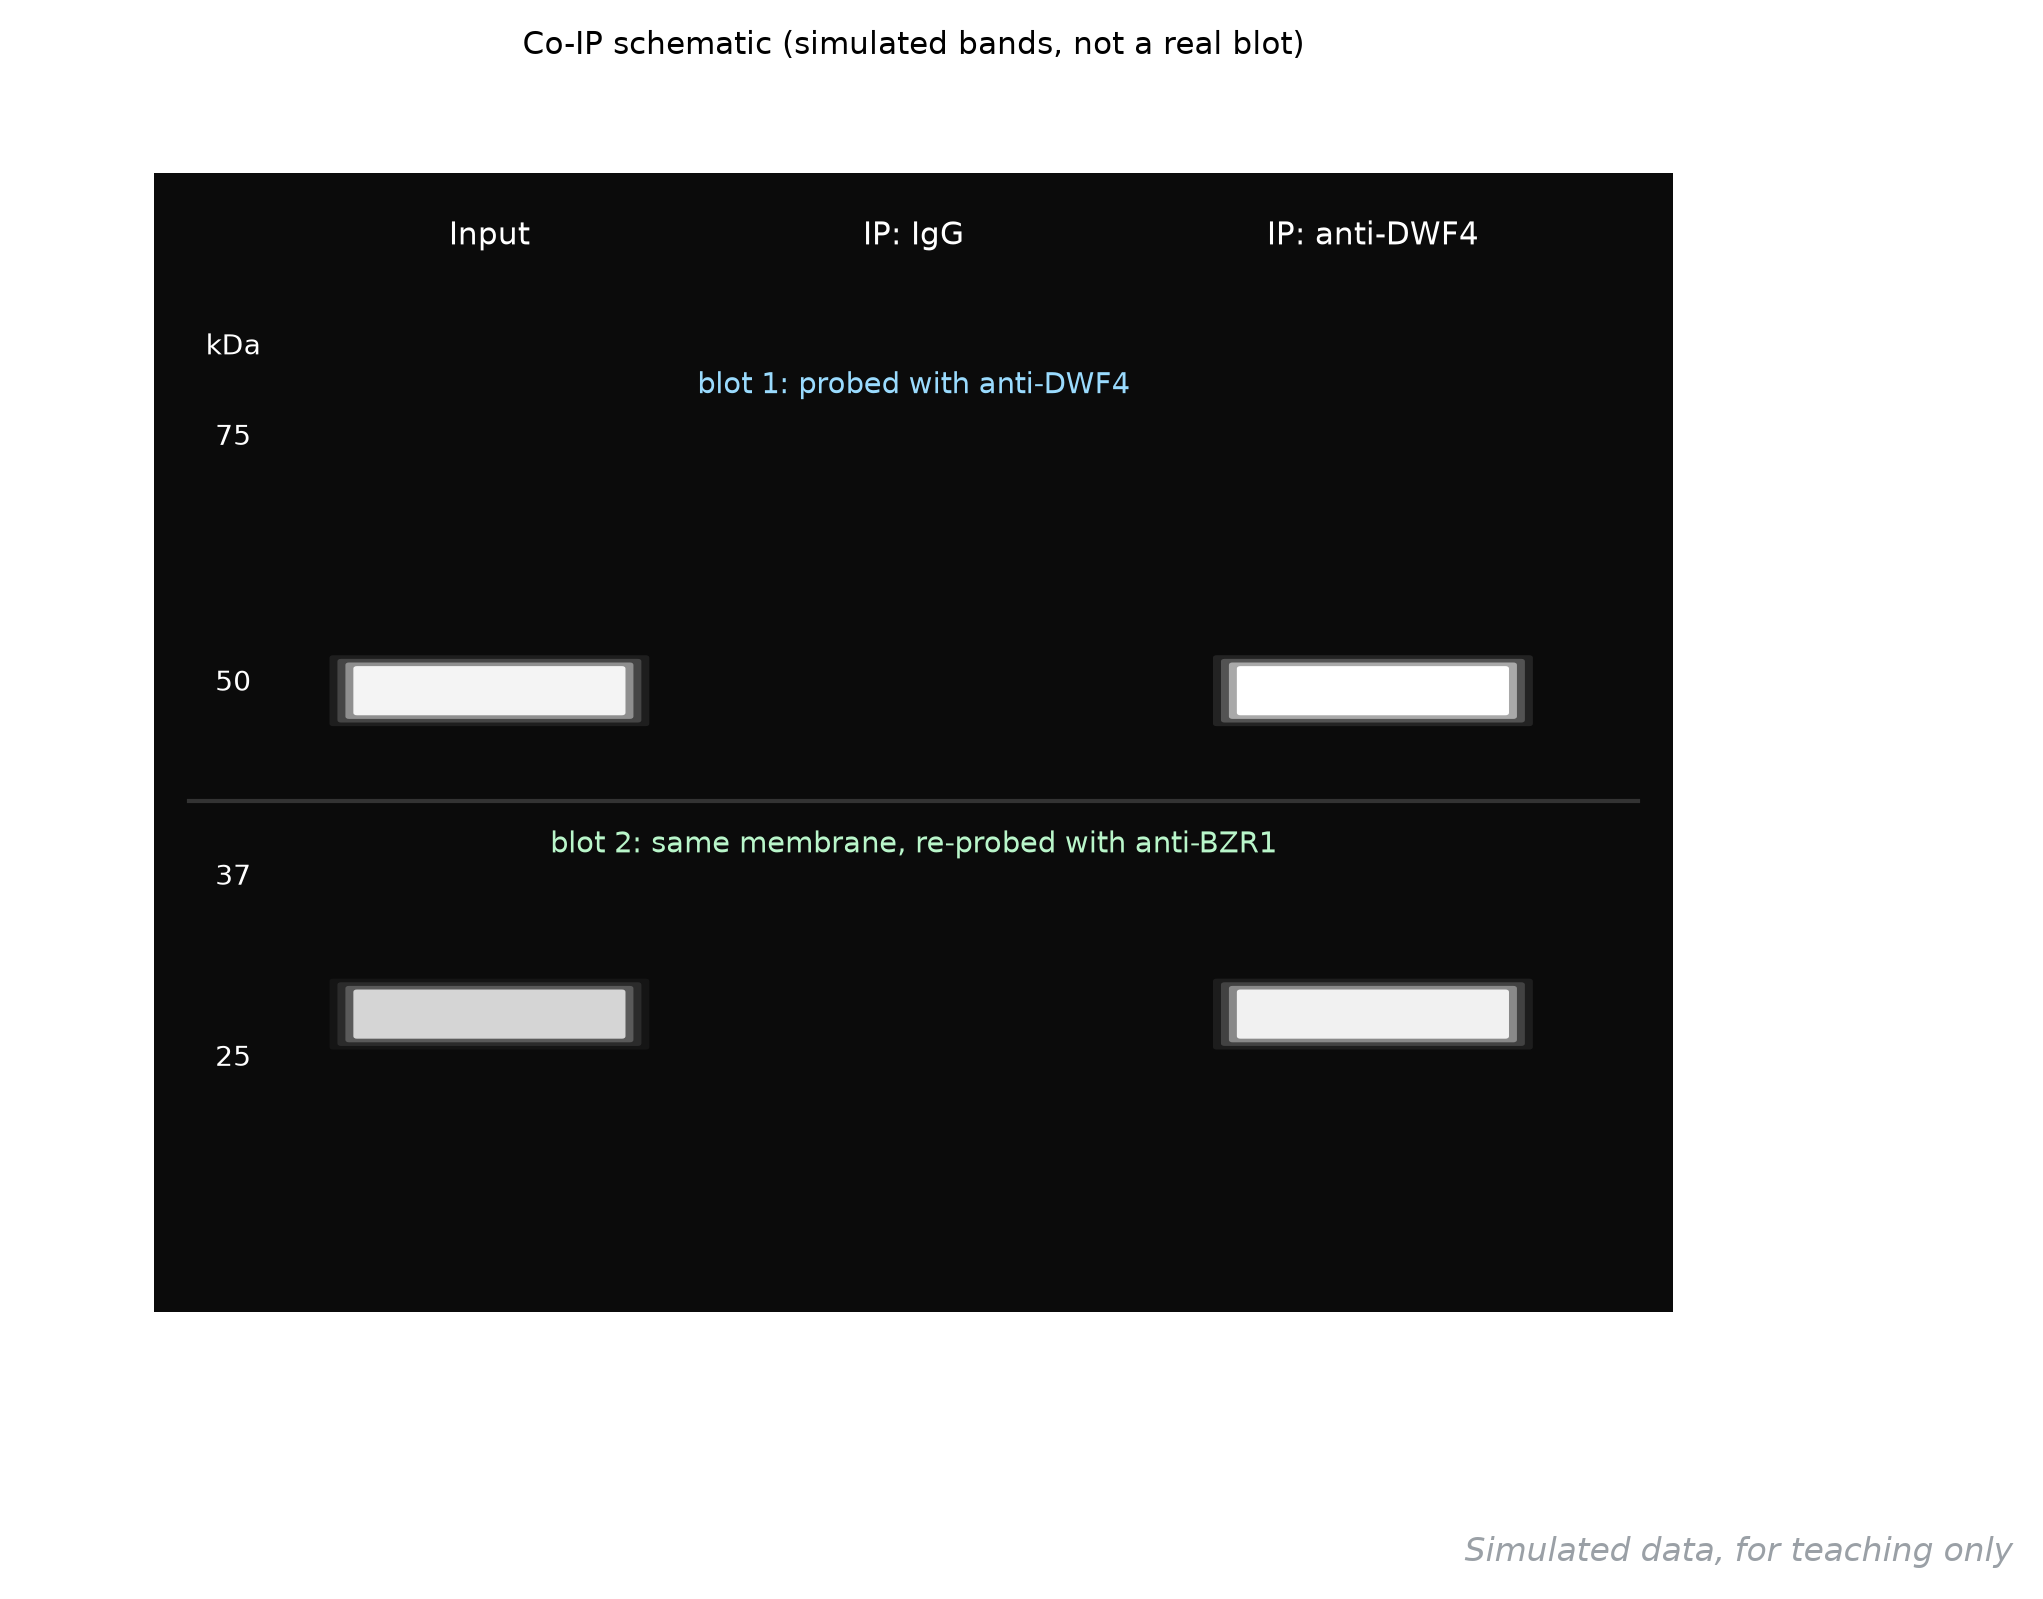
它回答什么问题:WB 看蛋白「有多少」,Co-IP 看「谁拉着谁」——蛋白互作的经典湿实验证据。这张是示意绘制,黑底白带只是排版模仿,真实膜图请扫描原图。
怎么读:三个泳道从左到右是逻辑链:Input(裂解液总蛋白,证明你的抗体认得出目标)、IP: IgG(阴性对照,非特异 IgG 应拉不下东西)、IP: anti-DWF4(用 DWF4 抗体做免疫沉淀)。上面那张膜用 anti-DWF4 探测,Input 和 IP 泳道 43 kDa 处有条带;下面重探 anti-BZR1,关键在于 IP: anti-DWF4 泳道 58 kDa 处也出现条带——BZR1 被 DWF4 连带拉下来了,两者存在互作。IgG 泳道干净是结论成立的命门,IgG 脏了全部重做。
用什么画:定量用 ImageJ 测条带灰度;示意图用 matplotlib 画圆角矩形即可(脚本见仓库)。
图注示例:
图 28 Co-IP 检测 DWF4 与 BZR1 的体内互作(示意)。Input 为总蛋白对照,IP: IgG 为阴性对照;以 anti-DWF4 沉淀后经 anti-BZR1 检测出现 58 kDa 条带,表明两者存在互作。
展开查看:绘图代码(Python,示意条带,非真实膜图)
# 示意图:黑底白带模拟膜图排版,真实结果请扫描原图
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle, FancyBboxPatch

fig, ax = plt.subplots(figsize=(7.6, 5.6))
ax.add_patch(Rectangle((0.7, 0.6), 8.6, 8.8, facecolor="#0B0B0B"))
lanes = {"Input": 2.6, "IP: IgG": 5.0, "IP: anti-DWF4": 7.6}
for name, x0 in lanes.items():
    ax.text(x0, 8.85, name, ha="center", fontsize=9.5, color="white")

def band(x0, y0, w, h, intensity):
    ax.add_patch(FancyBboxPatch((x0 - w / 2, y0 - h / 2), w, h,
                                boxstyle="round,pad=0.04", facecolor="white",
                                alpha=0.55 + 0.45 * intensity, edgecolor="none"))

ax.text(5.0, 7.7, "blot 1: probed with anti-DWF4", ha="center",
        fontsize=9, color="#9ADBFE")
band(2.6, 5.4, 1.5, 0.34, 0.8)            # Input 泳道
band(7.6, 5.4, 1.5, 0.34, 1.0)            # IP 泳道 43 kDa
ax.plot([0.9, 9.1], [4.55, 4.55], color="#333333", lw=1)
ax.text(5.0, 4.15, "blot 2: re-probed with anti-BZR1", ha="center",
        fontsize=9, color="#B9F6CA")
band(2.6, 2.9, 1.5, 0.34, 0.45)
band(7.6, 2.9, 1.5, 0.34, 0.75)           # 58 kDa 共沉淀条带 = 互作证据
for label, y0 in [("75", 7.3), ("50", 5.4), ("37", 3.9), ("25", 2.5)]:
    ax.text(1.15, y0, label, ha="center", fontsize=8.5, color="white")
ax.set_xlim(0, 10)
ax.set_ylim(0, 10)
ax.axis("off")
fig.savefig("27-wb-coip.png", dpi=200, bbox_inches="tight")
6.6 免疫组化图(IHC,示意)
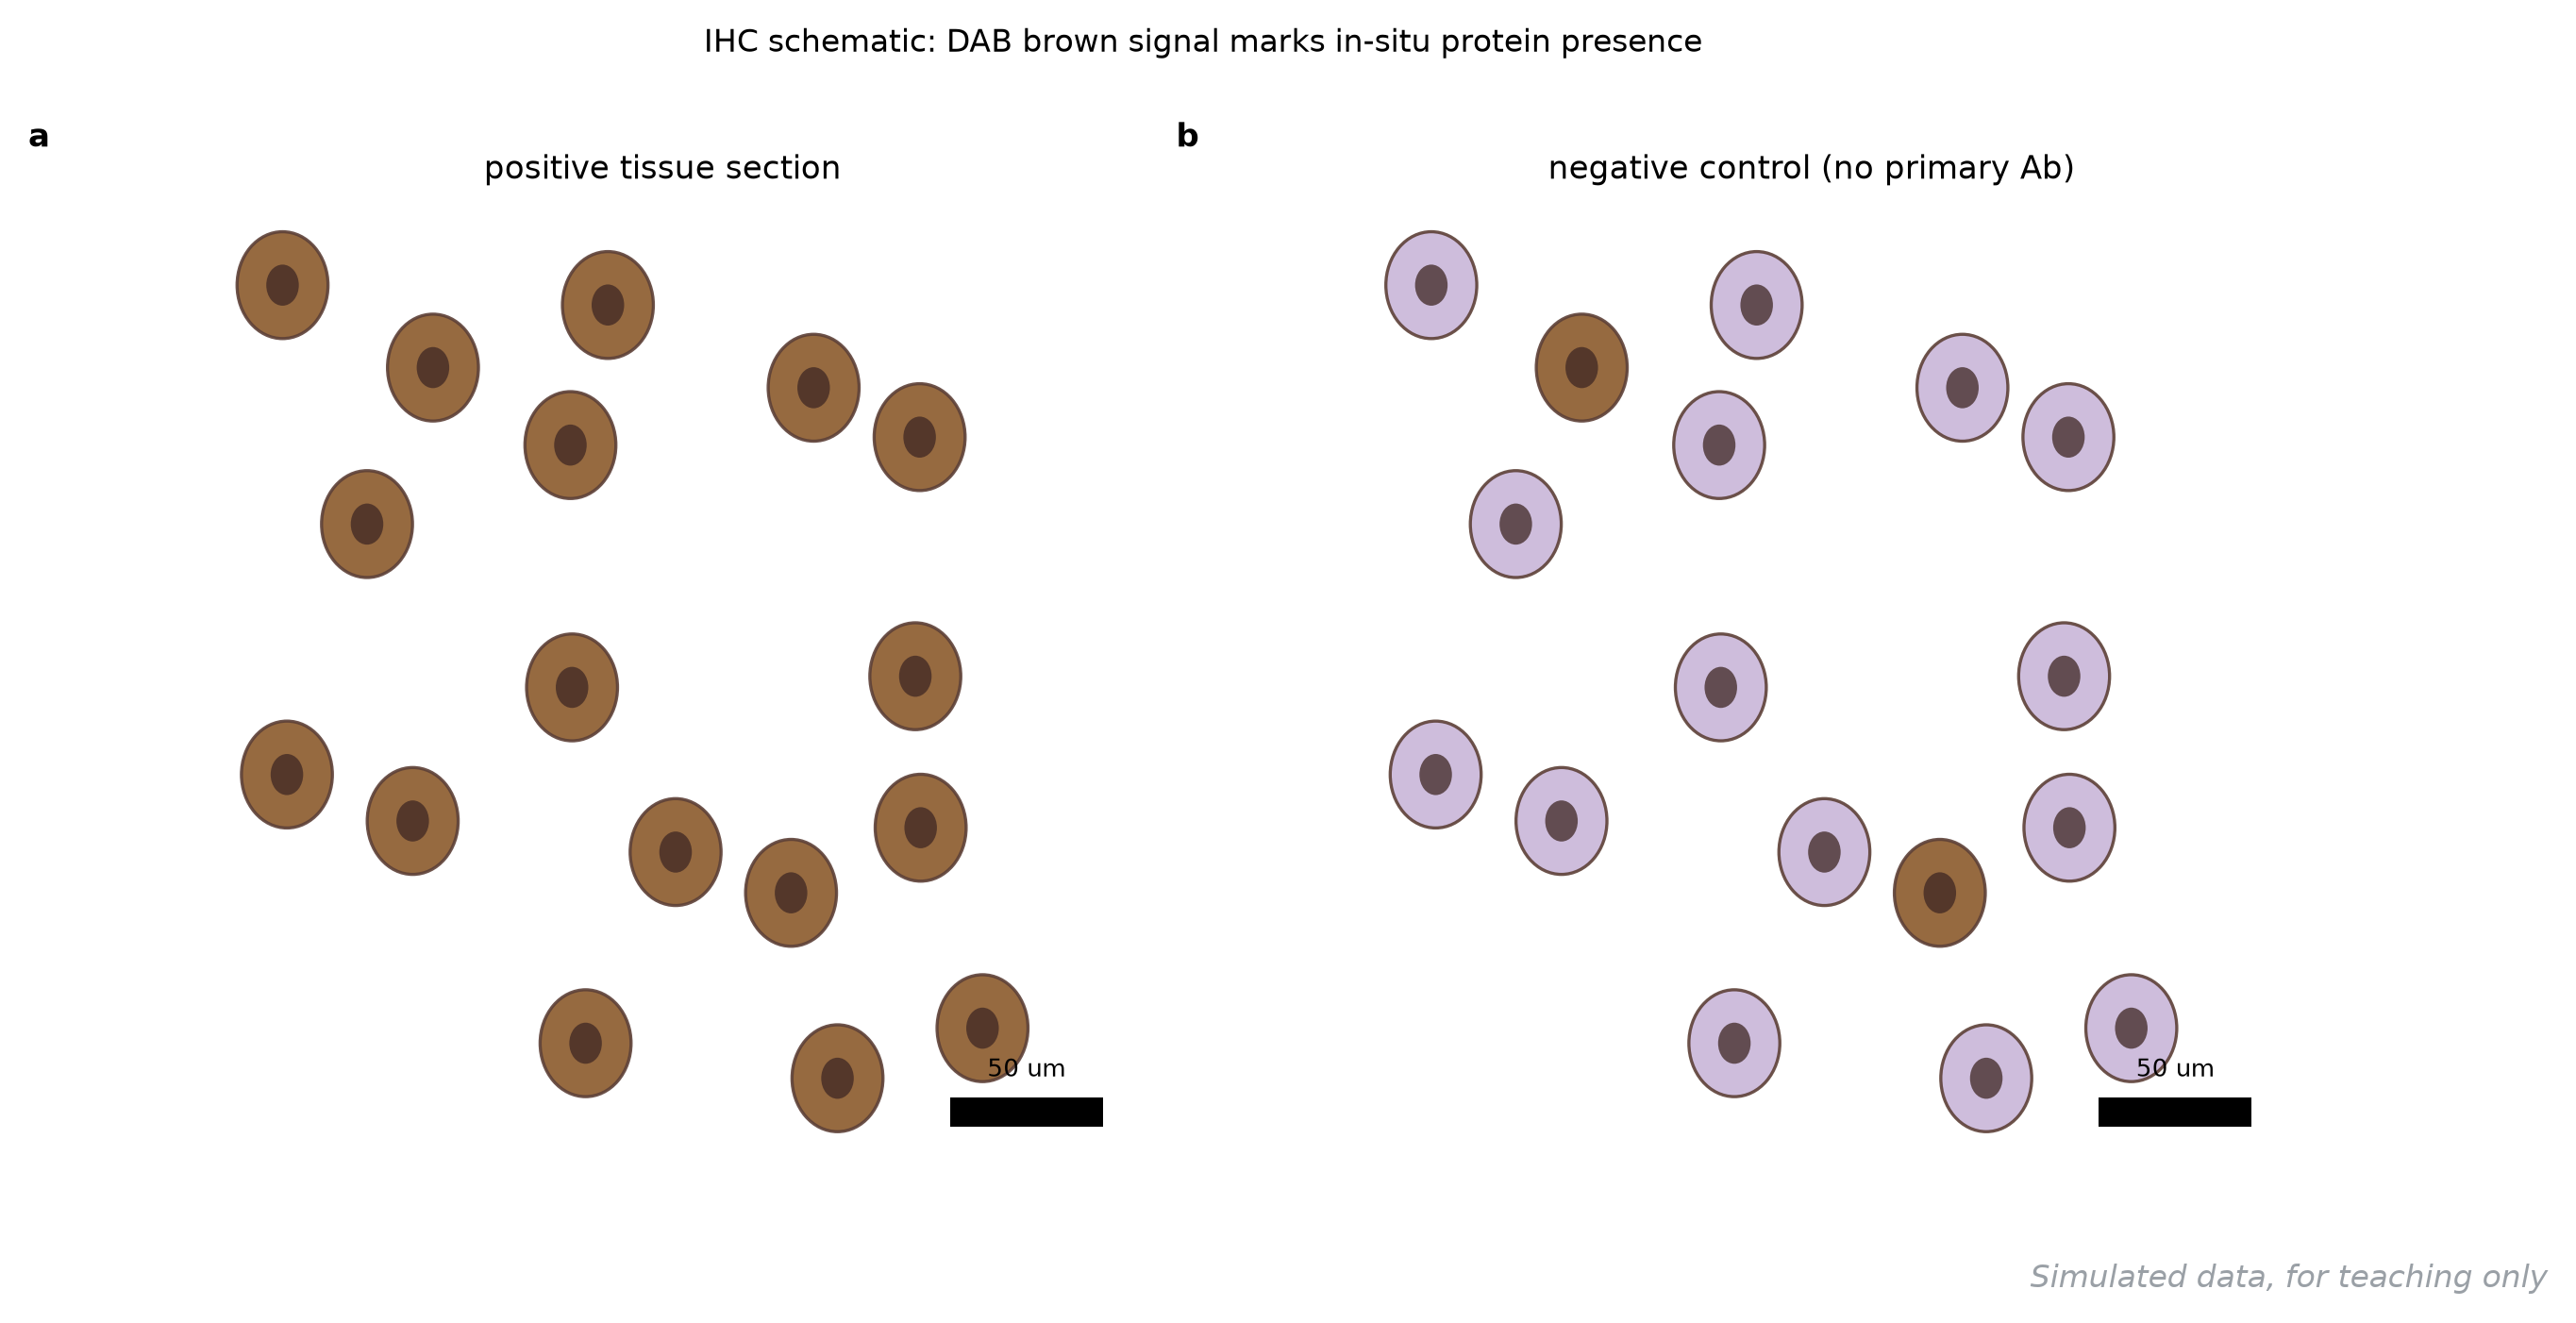
它回答什么问题:目标蛋白在组织切片里的原位分布——转录组说「有」,IHC 说「在哪里有」。同样为示意绘制。
怎么读:棕色(DAB 显色)即阳性细胞,紫色是苏木精复染的阴性细胞。读图必配阴性对照:右图不加一抗,基本全紫,证明棕色确实来自特异性结合;左图 22/36 个细胞棕色阳性。正文里要写的三件事:阳性信号定位在哪类细胞/组织区域(皮层还是维管束)、阳性率、对照是否干净。紫棕比例别用面积目测,用 Fiji 数阳性细胞。
用什么画:显微镜拍片后 Fiji 计数;示意版用 matplotlib 画椭圆细胞群。
图注示例:
图 29 免疫组化检测目标蛋白在种子横切面中的分布(示意)。棕色信号为 DAB 阳性细胞,右图为不加一抗的阴性对照;阳性细胞占 61%(22/36)。标尺 50 μm。
展开查看:模拟统计(阳性细胞计数)
panel,dab_positive_cells,total_cells
positive_section,22,36
negative_control,2,36
绘图代码(Python,独立可运行)
# 示意图:无真实数据集,细胞群用随机椭圆模拟(固定种子可复现)
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

rng = np.random.default_rng(5)
pos = []
while len(pos) < 36:
    x, y = rng.uniform(0.6, 9.4), rng.uniform(0.6, 6.4)
    if all((x - a) ** 2 + (y - b) ** 2 > 1.1 for a, b in pos):
        pos.append((x, y))
fig, axes = plt.subplots(1, 2, figsize=(9.6, 4.4))
for ax, title, npos in zip(axes, ["positive section", "negative control"], [22, 2]):
    idx = set(rng.permutation(36)[:npos])
    for i, (x, y) in enumerate(pos):
        ax.add_patch(Ellipse((x, y), 0.95, 0.78, facecolor="#8B5A2B" if i in idx
                             else "#C9B6D9", edgecolor="#5D4037", lw=0.8))
        ax.add_patch(Ellipse((x, y), 0.34, 0.3, facecolor="#3E2723", alpha=0.75))
    ax.add_patch(plt.Rectangle((8.0, 0.25), 1.6, 0.22, color="black"))
    ax.text(8.8, 0.62, "50 um", ha="center", fontsize=8)
    ax.set_title(title, fontsize=10.5)
    ax.set_xlim(0, 10); ax.set_ylim(0, 7); ax.axis("off")
fig.savefig("28-ihc.png", dpi=200, bbox_inches="tight")
6.7 免疫荧光图(IF,示意)
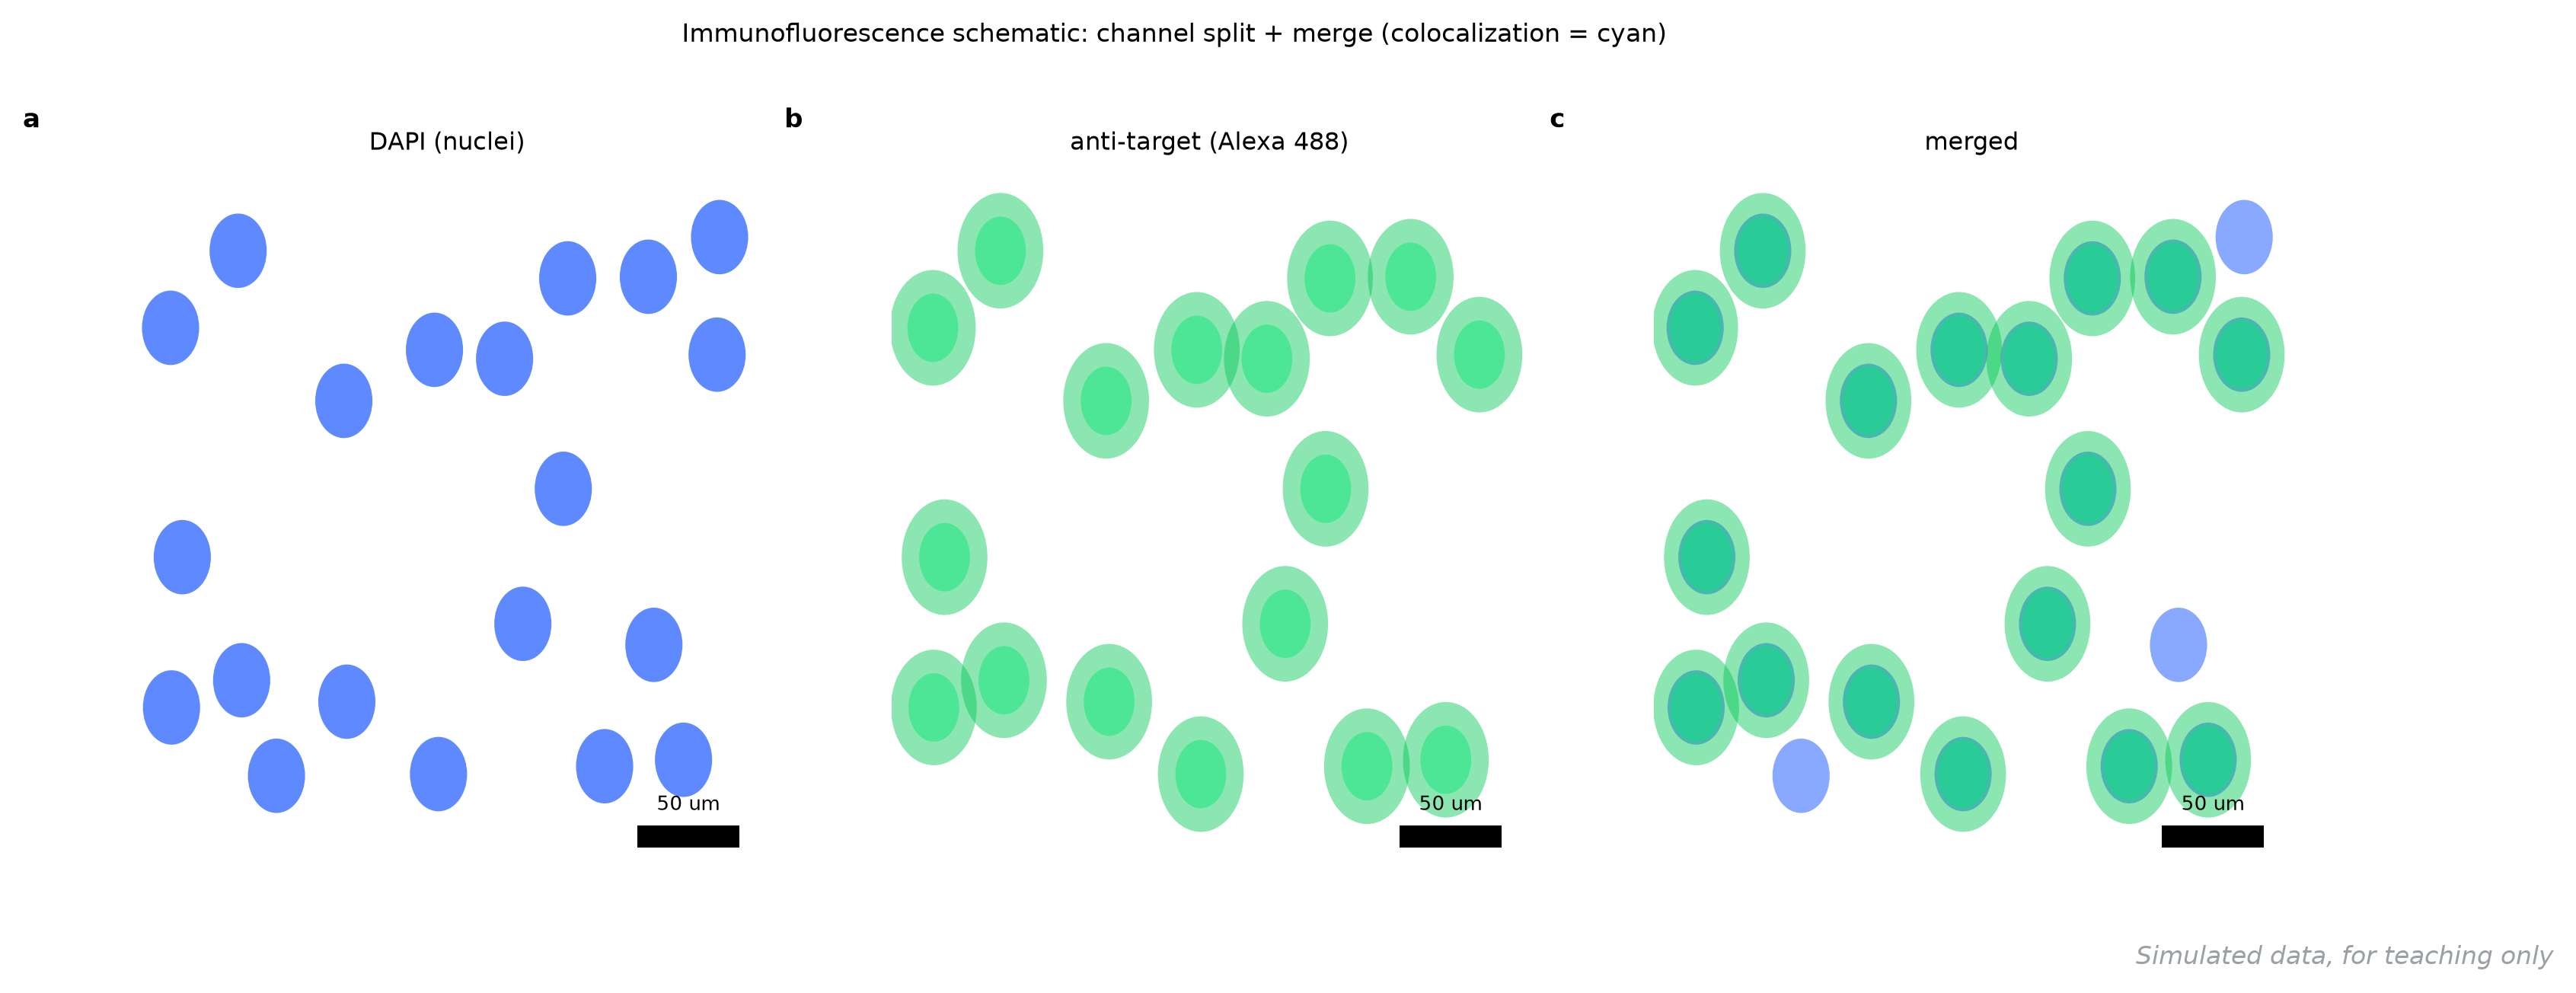
它回答什么问题:蛋白的亚细胞定位,以及两个蛋白是否共定位——比 IHC 更精细的「在哪」。
怎么读:三联画法是行规:左 DAPI 通道(蓝,所有细胞核),中目标蛋白通道(绿,Alexa 488),右合并。看合并图:蓝绿叠出的青色就是共定位(该蛋白在细胞核),只绿不蓝的说明在核外区室;绿色亮斑但对应位置无核,可能连的是细胞膜或质体。判读共定位别靠肉眼,用 Fiji 算 Pearson 相关系数或 Manders 系数再报数。通道一定单拍单放,合并图永远放第三张。
用什么画:共聚焦仪器软件导出各通道,Fiji 合成;示意版 matplotlib 分面板画椭圆。
图注示例:
图 30 免疫荧光检测目标蛋白亚细胞定位(示意)。左为 DAPI 核染色,中为 anti-target/Alexa 488 通道,右为合并图;绿色信号与细胞核重合呈现青色,表明目标蛋白定位于细胞核。标尺 50 μm。
展开查看:模拟统计(各通道信号计数)
panel,signal
DAPI_nuclei,36
anti_target_positive_cells,17
merged_colocalized,17
绘图代码(Python,独立可运行)
# 示意图:三个通道面板(DAPI / 目标蛋白 / 合并),细胞位置固定种子复现
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

rng = np.random.default_rng(9)
pos = []
while len(pos) < 36:
    x, y = rng.uniform(0.6, 9.4), rng.uniform(0.6, 6.4)
    if all((x - a) ** 2 + (y - b) ** 2 > 1.1 for a, b in pos):
        pos.append((x, y))
green = set(rng.permutation(36)[:17])
fig, axes = plt.subplots(1, 3, figsize=(12.2, 4.0))
for ax, (title, mode) in zip(axes, [("DAPI (nuclei)", "blue"),
                                    ("anti-target (Alexa 488)", "green"),
                                    ("merged", "merge")]):
    for i, (x, y) in enumerate(pos):
        if mode in ("blue", "merge"):
            ax.add_patch(Ellipse((x, y), 0.9, 0.74, facecolor="#2962FF",
                                 edgecolor="none", alpha=0.55 if mode == "merge" else 0.75))
        if mode in ("green", "merge") and i in green:
            ax.add_patch(Ellipse((x, y), 1.35, 1.15, facecolor="#00C853",
                                 edgecolor="none", alpha=0.45))
    ax.set_title(title, fontsize=10)
    ax.set_xlim(0, 10); ax.set_ylim(0, 7); ax.axis("off")
fig.savefig("29-if.png", dpi=200, bbox_inches="tight")
6.8 TUNEL 凋亡染色图(示意)
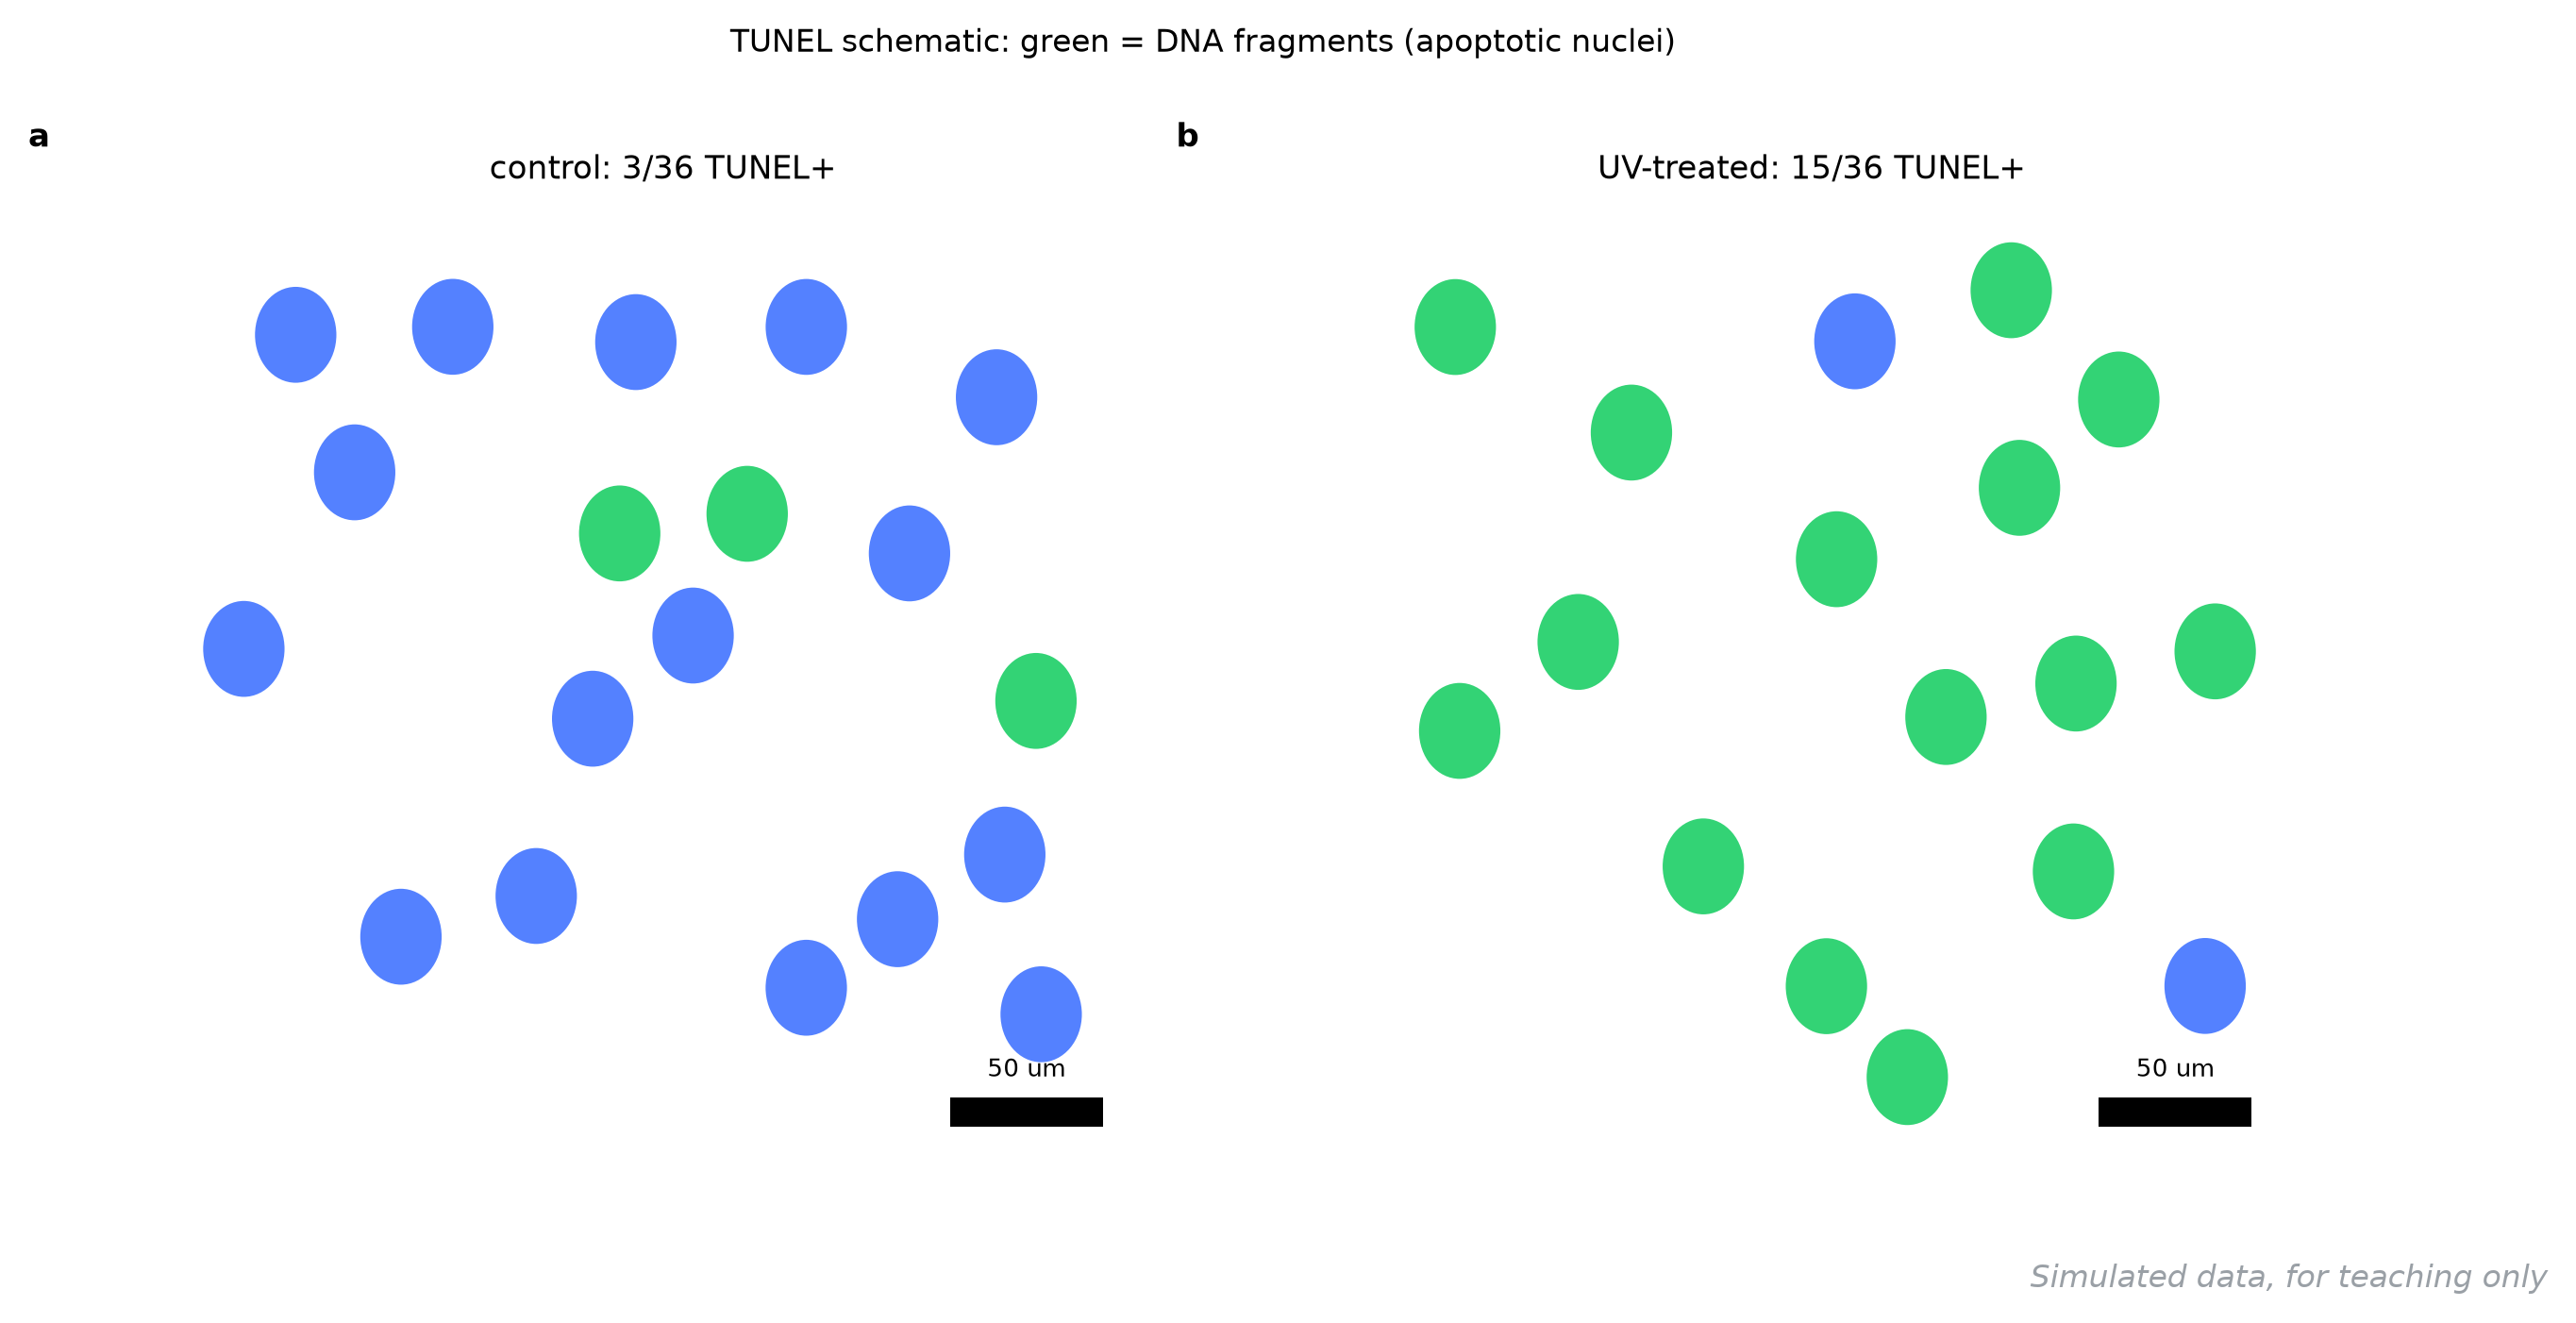
它回答什么问题:哪些细胞核里的 DNA 断了——细胞程序性死亡的金标染色,也是你说的那张「裂线图」的候选答案之一(TUNEL 与免疫荧光常在同一张拼图里出现)。
怎么读:绿色荧光核 = TUNEL 阳性(DNA 断裂末端被标记),蓝色是全部细胞核。左图对照只有 3/36 阳性,右图 UV 处理后 15/36。读图要做的三件事:数阳性率(不是数亮度)、确认每个绿色都在 DAPI 阳性范围内(防非特异)、正文交代阳性判定标准(比如核质浓缩加绿色信号)。它和流式凋亡图(6.11 节)互为印证:一个给空间信息,一个给定量比例。
用什么画:荧光显微镜拍片,Fiji 计数;示意版 matplotlib 双色椭圆。
图注示例:
图 31 TUNEL 染色检测细胞凋亡(示意)。绿色为 TUNEL 阳性细胞核,蓝色为 DAPI 复染;UV 处理组阳性率 42%(15/36),对照组 8%(3/36)。标尺 50 μm。
展开查看:模拟统计(阳性核计数)
panel,green_apoptotic_nuclei,total_nuclei
control,3,36
uv_treated,15,36
绘图代码(Python,独立可运行)
# 示意图:TUNEL 双面板(对照 vs 处理),绿色核为凋亡阳性
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

fig, axes = plt.subplots(1, 2, figsize=(9.6, 4.4))
for ax, title, ngreen, seed in zip(axes, ["control", "UV-treated"], [3, 15],
                                   [12, 13]):
    rng = np.random.default_rng(seed)
    pos = []
    while len(pos) < 36:
        x, y = rng.uniform(0.6, 9.4), rng.uniform(0.6, 6.4)
        if all((x - a) ** 2 + (y - b) ** 2 > 1.1 for a, b in pos):
            pos.append((x, y))
    idx = set(rng.permutation(36)[:ngreen])
    for i, (x, y) in enumerate(pos):
        ax.add_patch(Ellipse((x, y), 0.85, 0.7,
                             facecolor="#00C853" if i in idx else "#2962FF",
                             edgecolor="none", alpha=0.8))
    ax.set_title("%s: %d/36 TUNEL+" % (title, ngreen), fontsize=10.5)
    ax.set_xlim(0, 10); ax.set_ylim(0, 7); ax.axis("off")
fig.savefig("30-tunel.png", dpi=200, bbox_inches="tight")
6.9 流式细胞术:细胞周期分析
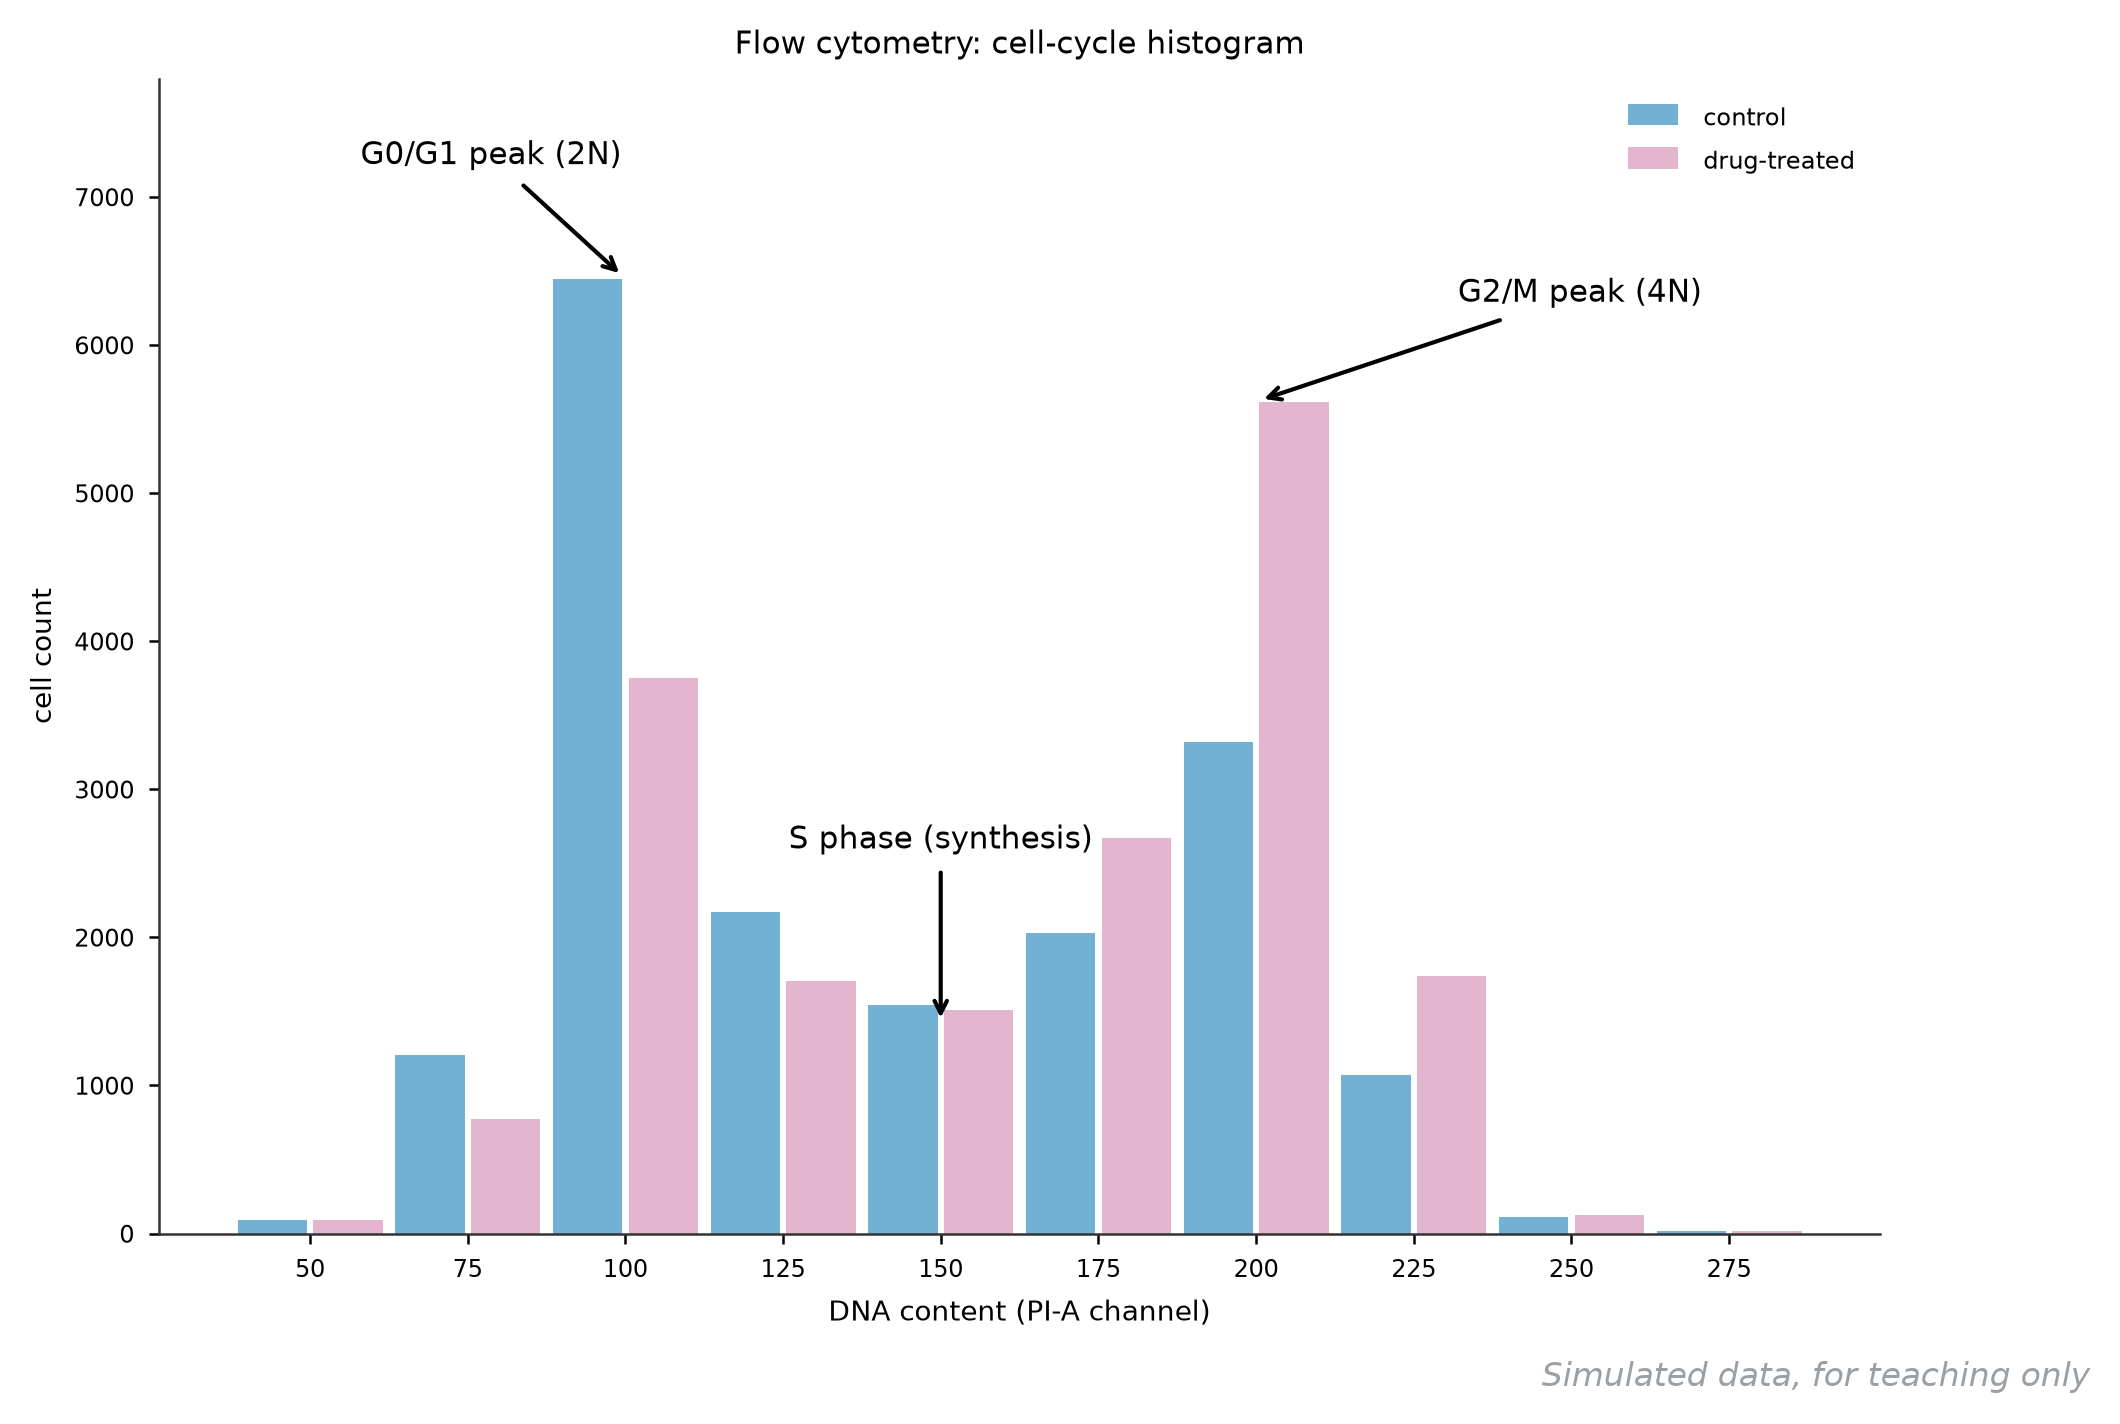
它回答什么问题:一群细胞停在周期的哪个站台上——G0/G1、S 还是 G2/M,三种流式图的第一张。
怎么读:横轴是 DNA 含量(PI 染色强度),2N 位置立着 G0/G1 主峰,4N 位置是 G2/M 峰,两峰之间的缓坡是正在复制的 S 期。对比两组:对照 G1 峰 6448 个细胞、G2 峰 3321;加药后 G2 峰涨到 5618、G1 缩到 3749——G2/M 阻滞的教科书图型。定量时在 G1 和 G2 峰各画门(gate),软件按峰面积算各期百分比,图注报数。
用什么画:FlowJo 或 FCS Express 画门;重绘用 matplotlib 叠加两组直方图(数据是分箱计数)。
图注示例:
图 32 PI 染色流式细胞周期分析。横轴为 DNA 含量,左侧主峰为 G0/G1 期(2N),右侧为 G2/M 期(4N),两峰间为 S 期;药物处理后 G2/M 期细胞比例由 18% 升至 31%(模拟数据演示)。
展开查看:模拟数据(分箱计数表)
channel,control_counts,treated_counts
50,93,88
75,1205,774
100,6448,3749
125,2168,1706
150,1540,1507
175,2030,2674
200,3321,5618
225,1068,1742
250,109,123
275,18,18
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 31-cycle.csv(分箱计数表)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("31-cycle.csv")
fig, ax = plt.subplots(figsize=(7.4, 5.0))
ax.bar(df.channel - 6, df.control_counts, width=11, color="#4C72B0",
       alpha=0.55, label="control")
ax.bar(df.channel + 6, df.treated_counts, width=11, color="#C44E52",
       alpha=0.55, label="drug-treated")
ax.set_xticks(df.channel)
ax.set_xlabel("DNA content (PI-A channel)")
ax.set_ylabel("cell count")
ax.legend()
fig.savefig("31-flow-cycle.png", dpi=200, bbox_inches="tight")
6.10 流式细胞术:表型门控散点图
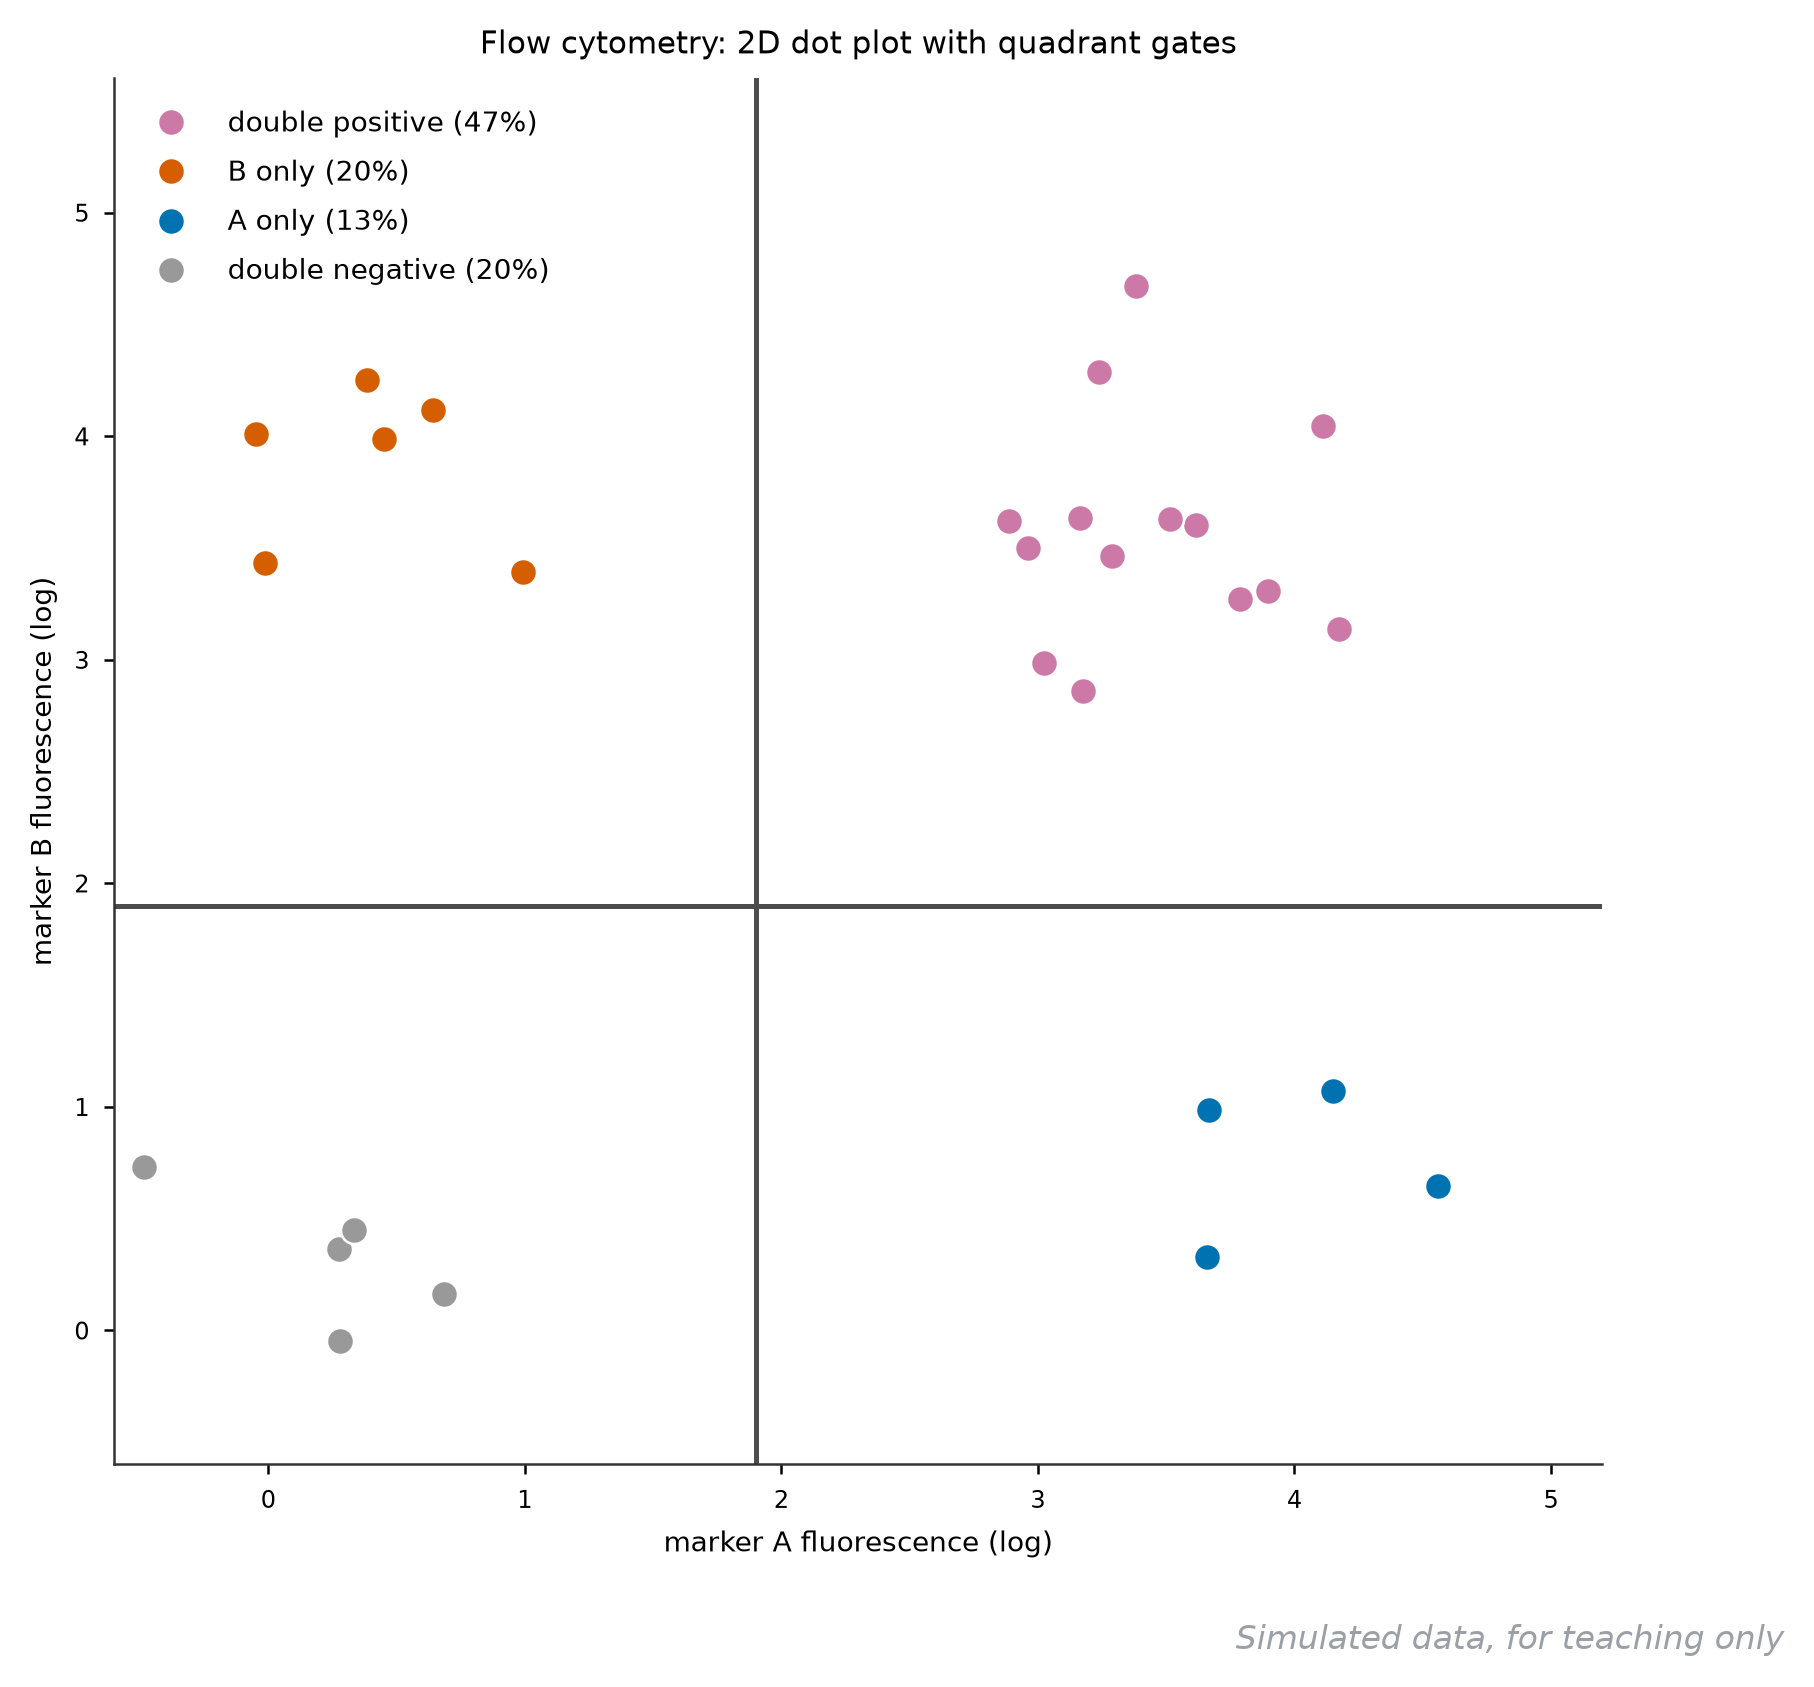
它回答什么问题:按两个表面标志把细胞切成四象限亚群,谁的 immune phenotype 是谁,第二种流式图。
怎么读:横纵轴各一个荧光标志物(对数坐标),灰色十字线是「门」的位置,由阴性对照定。四象限各管一类:右上双阳性、左上 B 单阳、右下 A 单阳、左下双阴性,图例里已经按点数折算了百分比。画门的铁律:门的位置只由阴性对照决定,画完就锁死,不许为了好看再挪。
用什么画:FlowJo 画门出图;重绘用 matplotlib 散点加两条参考线。
图注示例:
图 33 双标志物流式细胞表型分析。横纵轴分别为标志物 A、B 的荧光强度(对数坐标),十字实线为依据阴性对照设定的象限门;双阳性亚群占 47%(模拟数据演示)。
展开查看:模拟数据(细胞散点表)
marker_A,marker_B,population
3.29,3.47,double_positive
3.17,3.63,double_positive
2.89,3.62,double_positive
3.90,3.31,double_positive
3.38,4.67,double_positive
3.02,2.98,double_positive
3.24,4.29,double_positive
4.17,3.14,double_positive
3.62,3.60,double_positive
3.18,2.86,double_positive
3.79,3.27,double_positive
3.51,3.63,double_positive
4.11,4.05,double_positive
2.96,3.50,double_positive
0.99,3.39,B_only
0.45,3.99,B_only
-0.01,3.43,B_only
-0.05,4.01,B_only
0.39,4.25,B_only
0.64,4.12,B_only
3.67,0.99,A_only
3.66,0.33,A_only
4.15,1.07,A_only
4.56,0.65,A_only
0.28,-0.05,double_negative
-0.97,0.00,double_negative
0.68,0.16,double_negative
-0.49,0.73,double_negative
0.28,0.36,double_negative
0.34,0.45,double_negative
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 32-pheno.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("32-pheno.csv")
CAT = {"double_positive": "#C44E52", "B_only": "#DD8452",
       "A_only": "#4C72B0", "double_negative": "0.6"}
fig, ax = plt.subplots(figsize=(6.4, 6.0))
for name, col in CAT.items():
    sub = df[df.population == name]
    ax.scatter(sub.marker_A, sub.marker_B, s=42, color=col,
               edgecolors="white", linewidths=0.6,
               label="%s (%d%%)" % (name.replace("_", " "),
                                    round(100 * len(sub) / len(df))))
ax.axvline(1.9, color="0.3", lw=1.2)
ax.axhline(1.9, color="0.3", lw=1.2)
ax.set_xlabel("marker A fluorescence (log)")
ax.set_ylabel("marker B fluorescence (log)")
ax.legend(loc="upper left", fontsize=8.5)
fig.savefig("32-flow-pheno.png", dpi=200, bbox_inches="tight")
6.11 流式细胞术:Annexin V/PI 凋亡检测
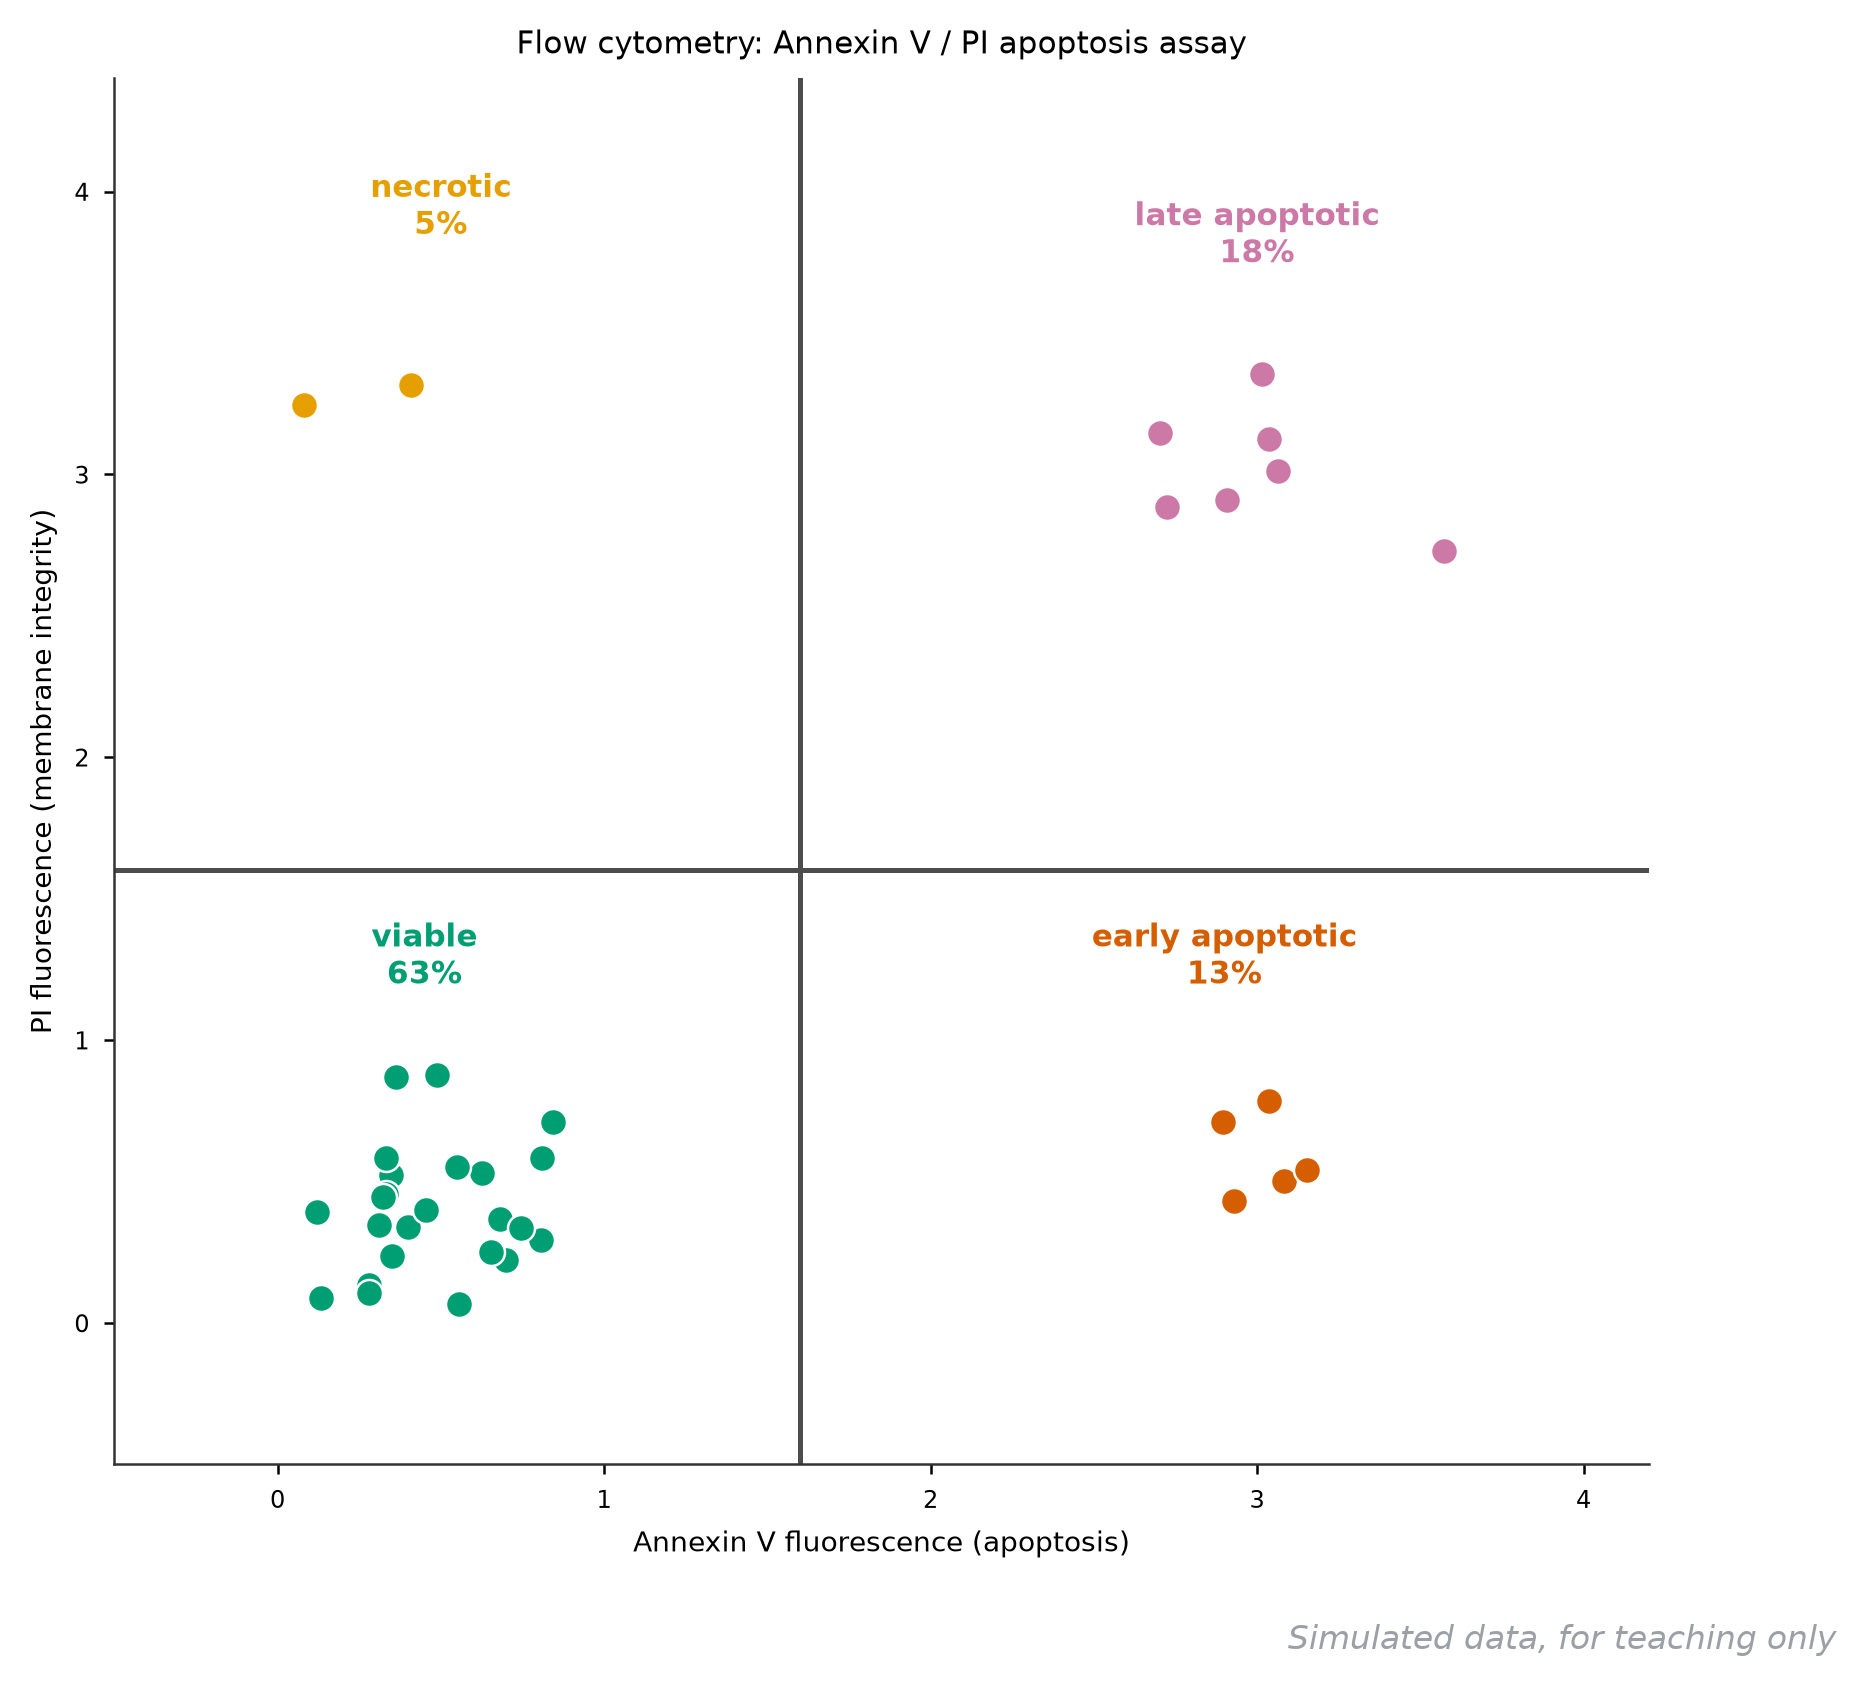
它回答什么问题:把「活的、正在死的、已经死的」一次性分开,第三种流式图,与 6.8 的 TUNEL 互为印证。
怎么读:横轴 Annexin V(磷脂酰丝氨酸外翻,凋亡早期标志),纵轴 PI(膜完整性,死了才进得去)。四象限读法是固定的:左下双阴=活细胞 63%,右下 Annexin 单阳=早期凋亡 13%,右上双阳=晚期凋亡 18%,左上 PI 单阳=机械性坏死 5%。这四类比例加起来必须等于 100%,正文里讨论药效时重点看早凋加晚凋之和的变化。
用什么画:FlowJo 四象限门;重绘用 matplotlib 散点加象限线。
图注示例:
图 34 Annexin V/PI 双染色流式凋亡分析。右下象限为早期凋亡细胞(Annexin V^+/PI^-),右上为晚期凋亡(Annexin V^+/PI^+),左下为活细胞;总凋亡率 31%(模拟数据演示)。
展开查看:模拟数据(细胞散点表)
annexin_V,PI,population
0.55,0.07,viable
0.40,0.34,viable
0.70,0.22,viable
0.81,0.58,viable
0.81,0.30,viable
0.63,0.53,viable
0.12,0.39,viable
0.35,0.24,viable
0.28,0.13,viable
0.35,0.52,viable
0.28,0.11,viable
0.68,0.37,viable
0.46,0.40,viable
0.33,0.58,viable
0.33,0.46,viable
0.13,0.09,viable
0.36,0.87,viable
0.49,0.88,viable
0.55,0.55,viable
0.32,0.45,viable
0.84,0.71,viable
0.31,0.35,viable
0.74,0.34,viable
0.65,0.25,viable
3.04,0.79,early_apoptotic
3.08,0.50,early_apoptotic
2.93,0.43,early_apoptotic
2.89,0.71,early_apoptotic
3.15,0.54,early_apoptotic
2.72,2.89,late_apoptotic
3.07,3.01,late_apoptotic
2.70,3.15,late_apoptotic
3.57,2.73,late_apoptotic
3.01,3.36,late_apoptotic
2.91,2.91,late_apoptotic
3.04,3.12,late_apoptotic
0.41,3.32,necrotic
0.08,3.24,necrotic
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 33-apop.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("33-apop.csv")
CAT = {"viable": "#55A868", "early_apoptotic": "#DD8452",
       "late_apoptotic": "#C44E52", "necrotic": "#8172B3"}
fig, ax = plt.subplots(figsize=(6.6, 6.0))
for name, col in CAT.items():
    sub = df[df.population == name]
    ax.scatter(sub.annexin_V, sub.PI, s=42, color=col, edgecolors="white")
    ax.text(sub.annexin_V.mean(), sub.PI.mean() + 0.75,
            "%s\n%d%%" % (name.replace("_", " "),
                          round(100 * len(sub) / len(df))),
            ha="center", fontsize=9.5, color=col, fontweight="bold")
ax.axvline(1.6, color="0.3", lw=1.2)
ax.axhline(1.6, color="0.3", lw=1.2)
ax.set_xlabel("Annexin V fluorescence (apoptosis)")
ax.set_ylabel("PI fluorescence (membrane integrity)")
fig.savefig("33-flow-apop.png", dpi=200, bbox_inches="tight")
七、数据流转图
7.1 桑基图(Sankey diagram)
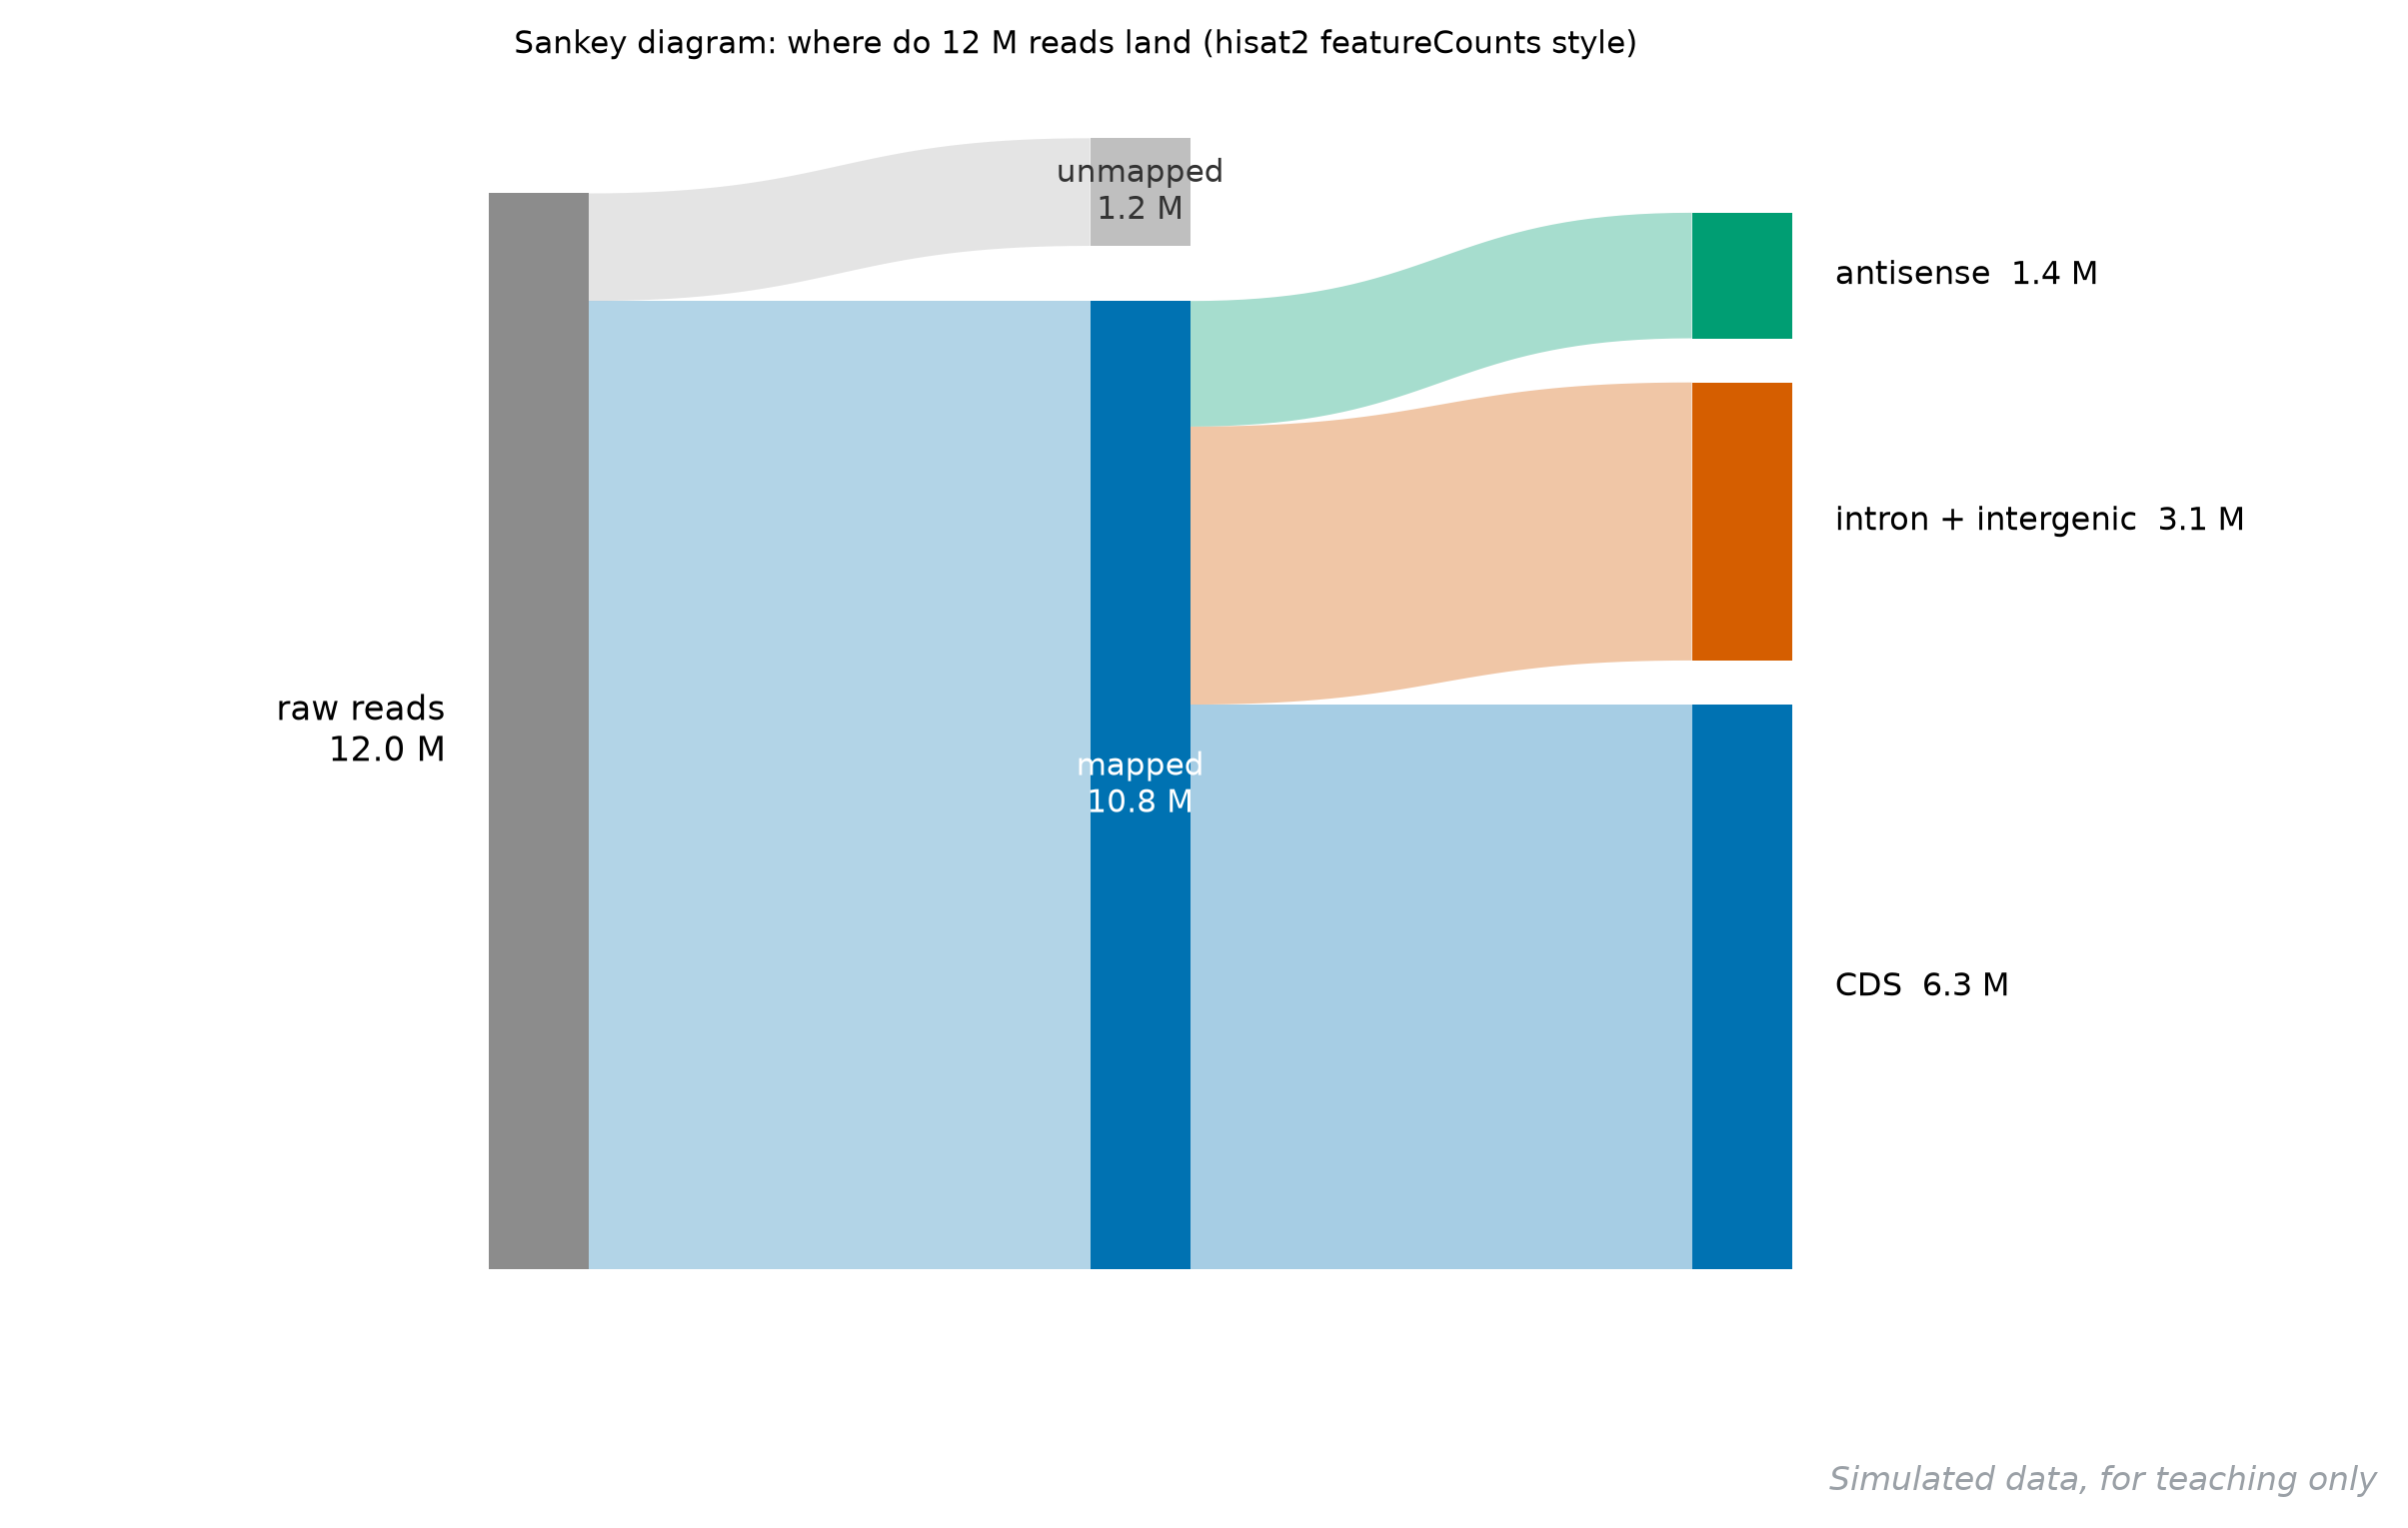
它回答什么问题:一批东西分几步流到哪里去了、每步漏掉多少——RNA-seq 比对定量环节的「去向公示」,菌群、代谢流分析里也常见。
怎么读:节点高度正比于流量(这里是 reads 数),飘带从源头流向去向。看两处:第一跳 mapped 10.8 M / unmapped 1.2 M,比对率 90% 及格线是 70-80%,不合格先查参考基因组和测序质量;第二跳 CDS 6.3 M、内含子与基因间区 3.1 M、antisense 1.4 M——内含子占比过高通常提示 pre-mRNA 污染。每根飘带粗细直接对应下一张表里的数字,正文别重复读图,挑异常值讲即可。
用什么画:SankeyMATIC 网页版最省事;R 语言 ggalluvial,Python 用 plotly.graph_objects.Sankey。
图注示例:
图 35 RNA-seq reads 去向桑基图。共 12.0 M reads,比对率 90%;比对上的 reads 中 58% 落在 CDS 区。
展开查看:模拟数据(流量表)
flow,from,to,value_M
mapping,total,mapped,10.8
mapping,total,unmapped,1.2
region,mapped,CDS,6.3
region,mapped,intron_intergenic,3.1
region,mapped,antisense,1.4
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 34-sankey.csv;飘带用三次贝塞尔带手绘
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

df = pd.read_csv("34-sankey.csv")
V = dict(zip(df.to, df.value_M))
S = 10.0 / 12.3
X0, X1, X2, W = 0.04, 0.46, 0.88, 0.07

def band(ax, x0, t0, t1, x1, u0, u1, color, alpha=0.35):
    ts = np.linspace(0, 1, 40)
    xm = (x0 + x1) / 2
    M = np.column_stack([(1 - ts) ** 3, 3 * (1 - ts) ** 2 * ts,
                         3 * (1 - ts) * ts ** 2, ts ** 3])
    top = M @ np.array([[x0, t0], [xm, t0], [xm, u0], [x1, u0]])
    bot = M @ np.array([[x0, t1], [xm, t1], [xm, u1], [x1, u1]])
    poly = np.vstack([top, bot[::-1]])
    ax.fill(poly[:, 0], poly[:, 1], color=color, alpha=alpha, lw=0)

fig, ax = plt.subplots(figsize=(9.0, 5.4))
ax.add_patch(Rectangle((X0, 0), W, 12.0 * S, facecolor="0.55"))
ax.add_patch(Rectangle((X1, 0), W, 10.8 * S, facecolor="#4C72B0"))
y_unm = 10.8 * S + 0.5
ax.add_patch(Rectangle((X1, y_unm), W, 1.2 * S, facecolor="0.75"))
band(ax, X0 + W, 0, 10.8 * S, X1, 0, 10.8 * S, "#4C72B0", alpha=0.3)
band(ax, X0 + W, 10.8 * S, 12.0 * S, X1, y_unm, y_unm + 1.2 * S, "0.7")
ycur, yfrom = 0.0, 0.0
for to, col in [("CDS", "#4C72B0"), ("intron_intergenic", "#DD8452"),
                ("antisense", "#55A868")]:
    v = V[to]
    ax.add_patch(Rectangle((X2, ycur), W, v * S, facecolor=col))
    ax.text(X2 + W + 0.03, ycur + v * S / 2, "%s  %.1f M" % (to, v),
            va="center", fontsize=10)
    band(ax, X1 + W, yfrom, yfrom + v * S, X2, ycur, ycur + v * S, col)
    ycur += v * S + 0.4
    yfrom += v * S
ax.set_xlim(-0.28, 1.35)
ax.set_ylim(-0.5, 10.8)
ax.axis("off")
fig.savefig("34-sankey.png", dpi=200, bbox_inches="tight")
八、基因与蛋白结构专题
8.1 蛋白结构锚点与保守残基标注
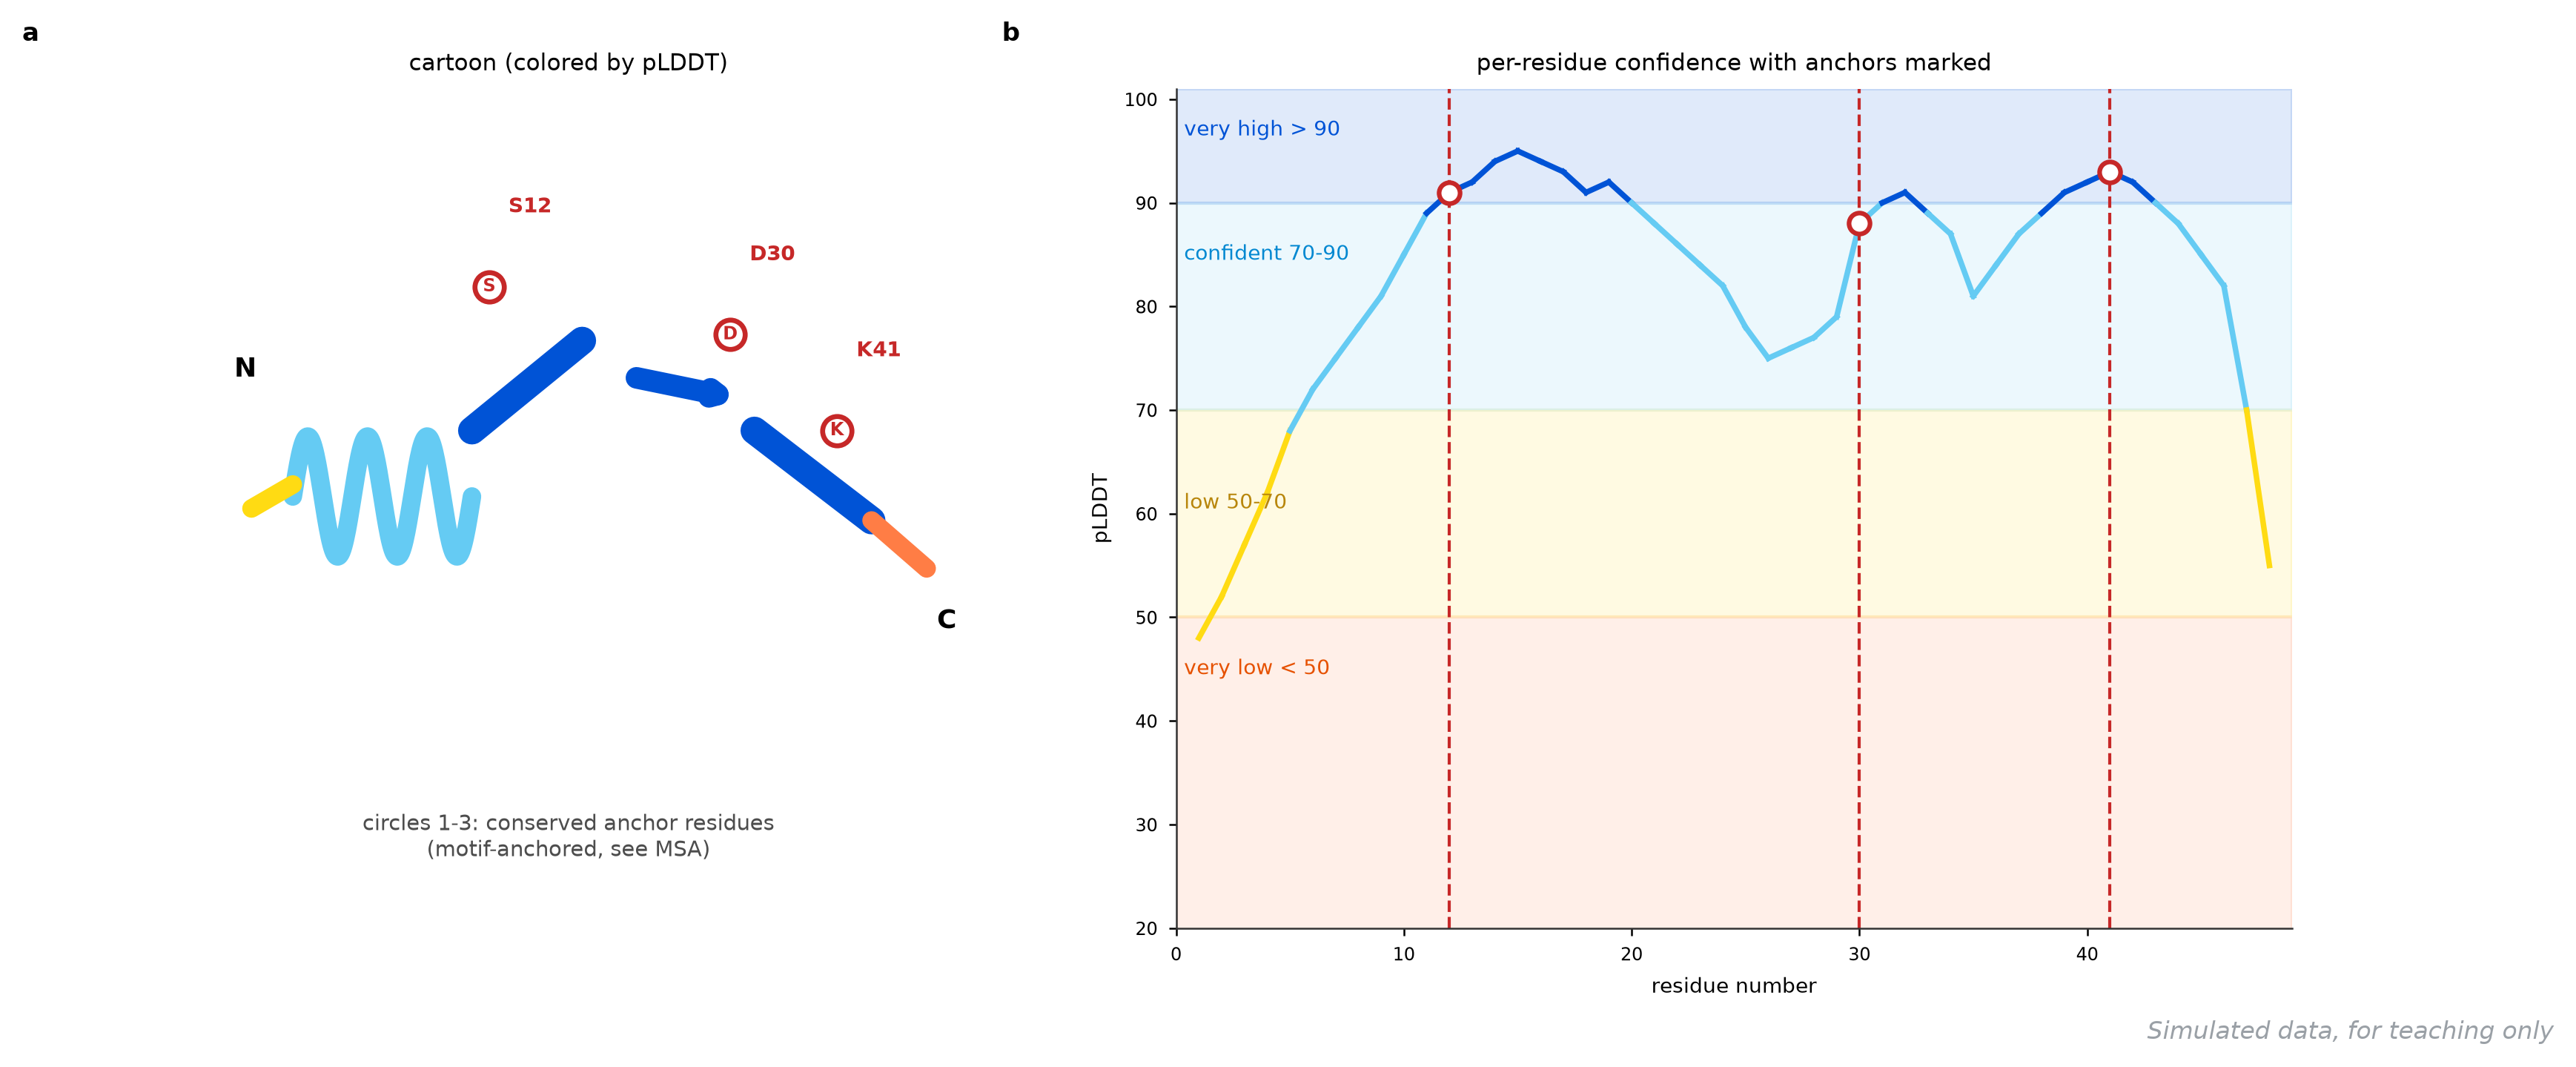
它回答什么问题:AlphaFold 建出来的结构哪里可信、你关注的催化残基落在可信区还是垃圾区——结构锚点(anchor residue)分析的标准画法。
怎么读:右图是每个残基的 pLDDT 置信度,背景四条色带对应 AlphaFold 官方口径:90 以上非常可信(深蓝区)、70-90 可信(浅蓝)、50-70 低(黄)、50 以下别看(橙)。三个红圈是保守性残基锚点(S12、D30、K41,来自多序列比对的催化三联体假说),全部落在 88 分以上的区段——这是「结构支持功能假说」的关键论据。左图卡通 ribbon 按同款配色上色,两个深蓝螺旋夹着一个 strand,锚点用白圈红边标出,正文描述构象时指着它说话。N 端与 C 端两截黄色橙色是无序区,讨论功能时主动绕开。
用什么画:pLDDT 曲线从 AlphaFold 的 PDB 文件 B-factor 列提取,Python matplotlib 一条折线;3D 渲染用 PyMOL(spectrum b, blue_red 按 B-factor 上色)。
图注示例:
图 36 目标蛋白 AlphaFold 结构置信度与保守残基锚点。右图折线为逐残基 pLDDT,背景色带按 AlphaFold 置信度分级;红色竖线标注三个保守残基锚点(S12、D30、K41),均位于高置信区(pLDDT > 88)。左图 cartoon 按 pLDDT 同款配色渲染。
展开查看:模拟数据(逐残基 pLDDT 与锚点表)
residue,plddt,anchor
1,48,
2,52,
3,57,
4,62,
5,68,
6,72,
7,75,
8,78,
9,81,
10,85,
11,89,
12,91,S12 catalytic
13,92,
14,94,
15,95,
16,94,
17,93,
18,91,
19,92,
20,90,
21,88,
22,86,
23,84,
24,82,
25,78,
26,75,
27,76,
28,77,
29,79,
30,88,D30 strand
31,90,
32,91,
33,89,
34,87,
35,81,
36,84,
37,87,
38,89,
39,91,
40,92,
41,93,K41 catalytic
42,92,
43,90,
44,88,
45,85,
46,82,
47,70,
48,55
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 35-plddt.csv;背景色带按 AlphaFold 官方置信度分级
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("35-plddt.csv")
AF = [("#FF7D45", 0, 50), ("#FFDB13", 50, 70), ("#65CBF3", 70, 90), ("#0053D6", 90, 101)]
anchors = df[df.anchor != ""][["residue", "plddt"]]
fig, ax = plt.subplots(figsize=(8.0, 4.6))
for col, a, b in AF:
    ax.axhspan(a, b, color=col, alpha=0.12)
for col, a, b in AF:                       # 折线按数值分段上色
    seg = df[(df.plddt >= a) & (df.plddt < b)]
    ax.plot(seg.residue, seg.plddt, color=col, lw=1.8)
for _, row in anchors.iterrows():
    ax.axvline(row.residue, color="#C62828", ls="--", lw=1)
    ax.scatter([row.residue], [row.plddt], s=46, facecolor="white",
               edgecolor="#C62828", linewidth=1.5, zorder=5)
ax.set_ylim(20, 101)
ax.set_xlabel("residue number")
ax.set_ylabel("pLDDT")
fig.savefig("35-protein-anchor.png", dpi=200, bbox_inches="tight")
8.2 核心基因功能证据矩阵图
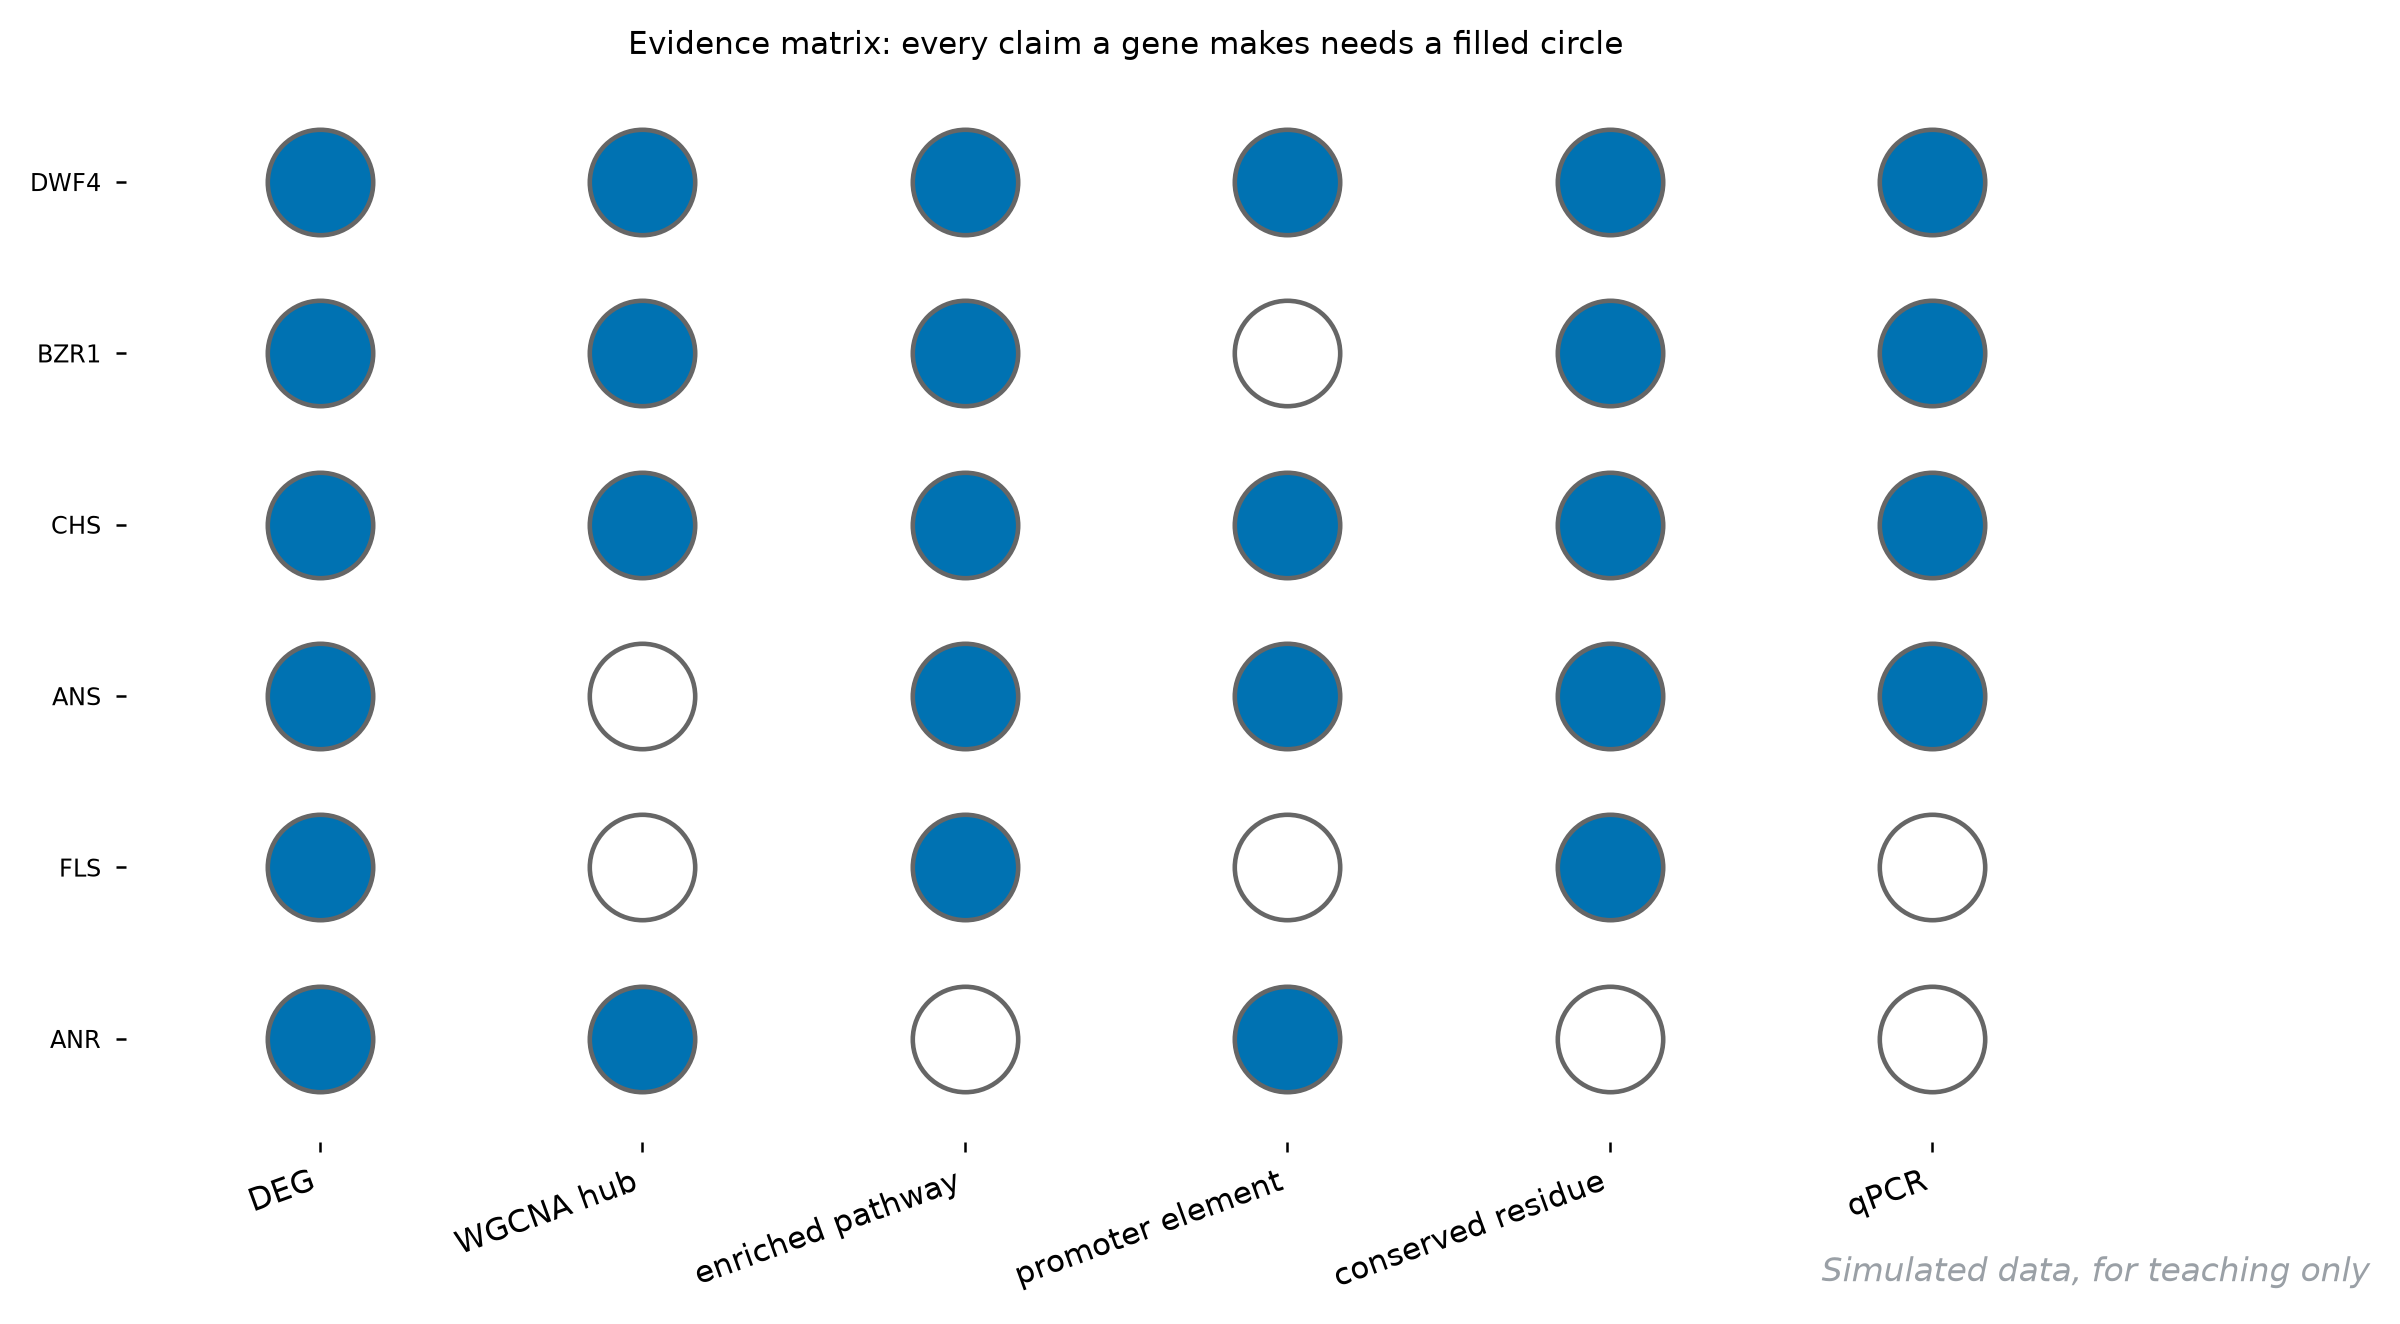
它回答什么问题:载体设计挑基因时,每个候选手里有几张牌——把六类证据摊在一张矩阵里,挑牌不靠感觉。这是载体设计专题图里最实用的一张。
怎么读:每行一个基因,每列一类证据(差异表达、WGCNA 枢纽、通路富集、启动子元件、保守残基、qPCR 验证),实心圆是有证据,空心是缺。读法是找「满行」:DWF4 和 CHS 六项全满,是无脑优先的载体候选;FLS 只剩三个圈,基因家族冗余又没验证,放进备胎池。这张图还是答辩神器——评委问「凭什么选这个基因」,你翻到这张图逐列讲完就是完整证据链。
用什么画:Excel 打点表最朴素;正式图用 matplotlib scatter 双色(实/空)画矩阵,脚本见仓库。
图注示例:
图 37 六个候选基因的功能证据矩阵。实心圆表示具备该类证据:转录组差异表达、WGCNA 模块枢纽、通路富集、启动子顺式元件、保守残基与 qPCR 验证。
展开查看:模拟数据(证据矩阵 0/1 表)
gene,DEG,WGCNA_hub,enriched_pathway,promoter_element,conserved_residue,qPCR
DWF4,1,1,1,1,1,1
BZR1,1,1,1,0,1,1
CHS,1,1,1,1,1,1
ANS,1,0,1,1,1,1
FLS,1,0,1,0,1,0
ANR,1,1,0,1,0,0
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 36-evidence.csv(0/1 证据矩阵)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("36-evidence.csv", index_col="gene")
fig, ax = plt.subplots(figsize=(8.6, 4.6))
for i, g in enumerate(df.index):
    for j, e in enumerate(df.columns):
        on = df.loc[g, e] == 1
        ax.scatter(j, i, s=640, facecolor="#4C72B0" if on else "white",
                   edgecolor="0.4", linewidth=1.1)
ax.set_xticks(range(df.shape[1]), [c.replace("_", " ") for c in df.columns],
              rotation=20, ha="right", fontsize=9.5)
ax.set_yticks(range(df.shape[0]), df.index)
ax.spines["left"].set_visible(False)
ax.spines["bottom"].set_visible(False)
fig.savefig("36-evidence-matrix.png", dpi=200, bbox_inches="tight")
8.3 组织特异性表达图
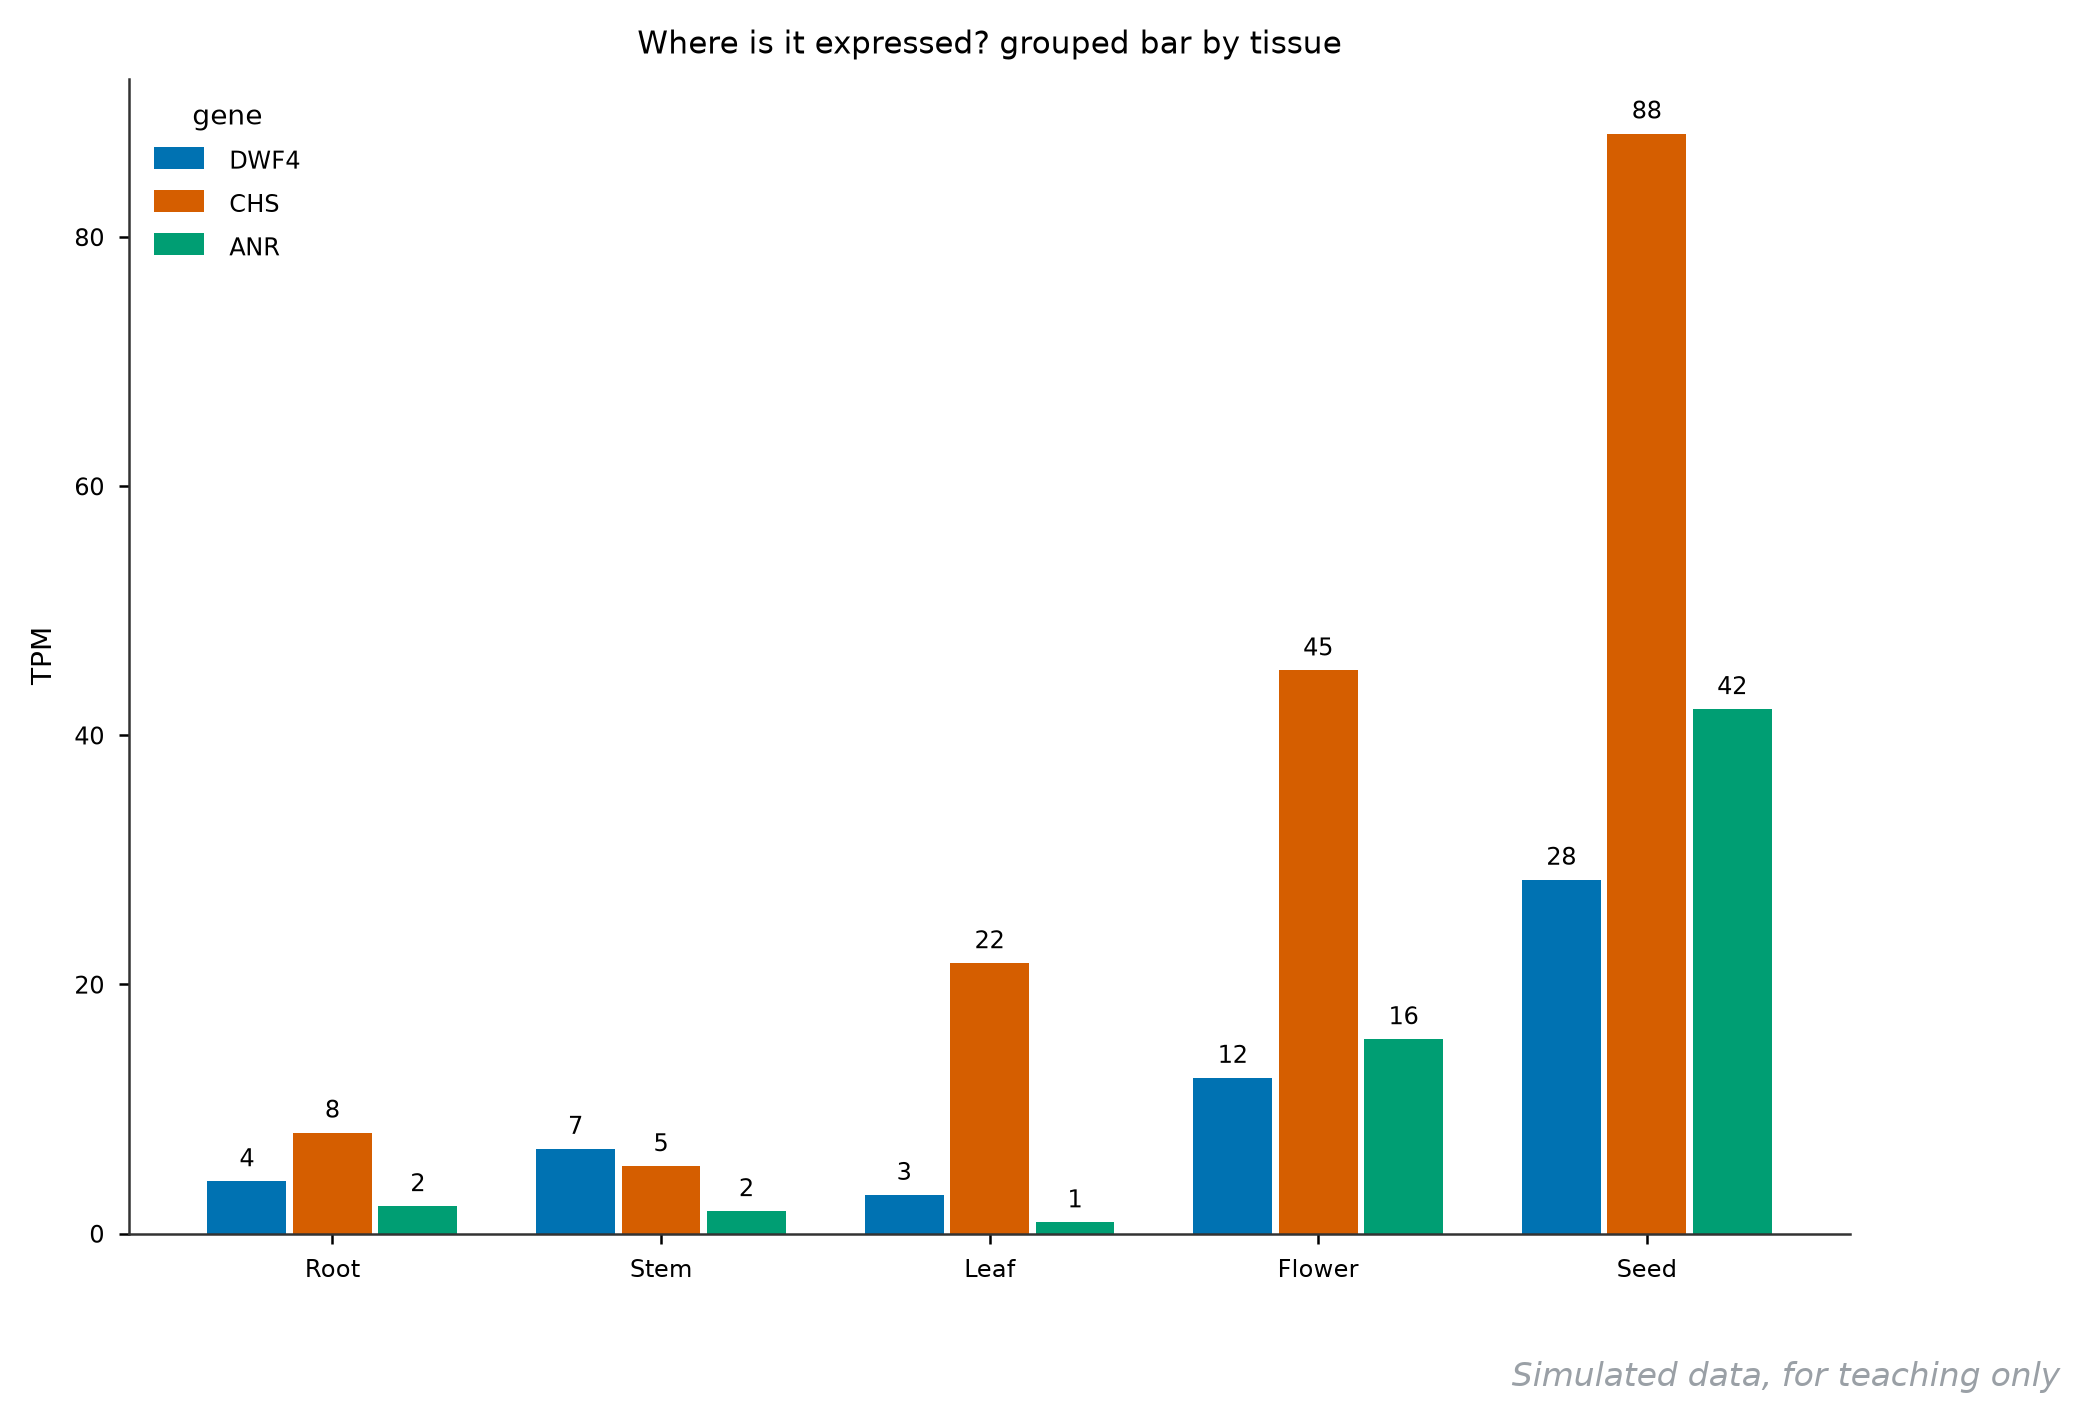
它回答什么问题:基因在哪个器官里干活最多——「哪里表达多」最直接的回答,也是启动子拿来做特异表达载体前的必查项。
怎么读:分组柱状图,一个组织一组三根柱(三个基因)。看两样:CHS 在种子里的 TPM 是叶子的 4 倍(组织偏好性)、DWF4 的峰值也落在种子(28.4),两者与黄酮积累的器官一致,互相咬合。注意 TPM 数值不能跨基因比高低(不同基因长度和丰度天然不同),只能同基因跨组织比。
用什么画:R 语言 ggplot2::geom_col(position="dodge");Python 用 pandas 分组柱状图。
图注示例:
图 38 三个候选基因在五种组织中的表达水平(TPM)。DWF4 与 CHS 在种子中表达最高,提示其与种子发育关联。
展开查看:模拟数据(组织表达表)
tissue,DWF4,CHS,ANR
Root,4.2,8.1,2.2
Stem,6.8,5.4,1.8
Leaf,3.1,21.7,0.9
Flower,12.5,45.2,15.6
Seed,28.4,88.3,42.1
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 37-tissue.csv
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("37-tissue.csv")
x = np.arange(len(df))
CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig, ax = plt.subplots(figsize=(7.4, 5.0))
for i, g in enumerate(["DWF4", "CHS", "ANR"]):
    ax.bar(x + (i - 1) * 0.26, df[g], 0.24, label=g, color=CAT[i])
ax.set_xticks(x, df.tissue)
ax.set_ylabel("TPM")
ax.legend(title="gene")
fig.savefig("37-tissue-expression.png", dpi=200, bbox_inches="tight")
8.4 启动子顺式调控元件扫描图
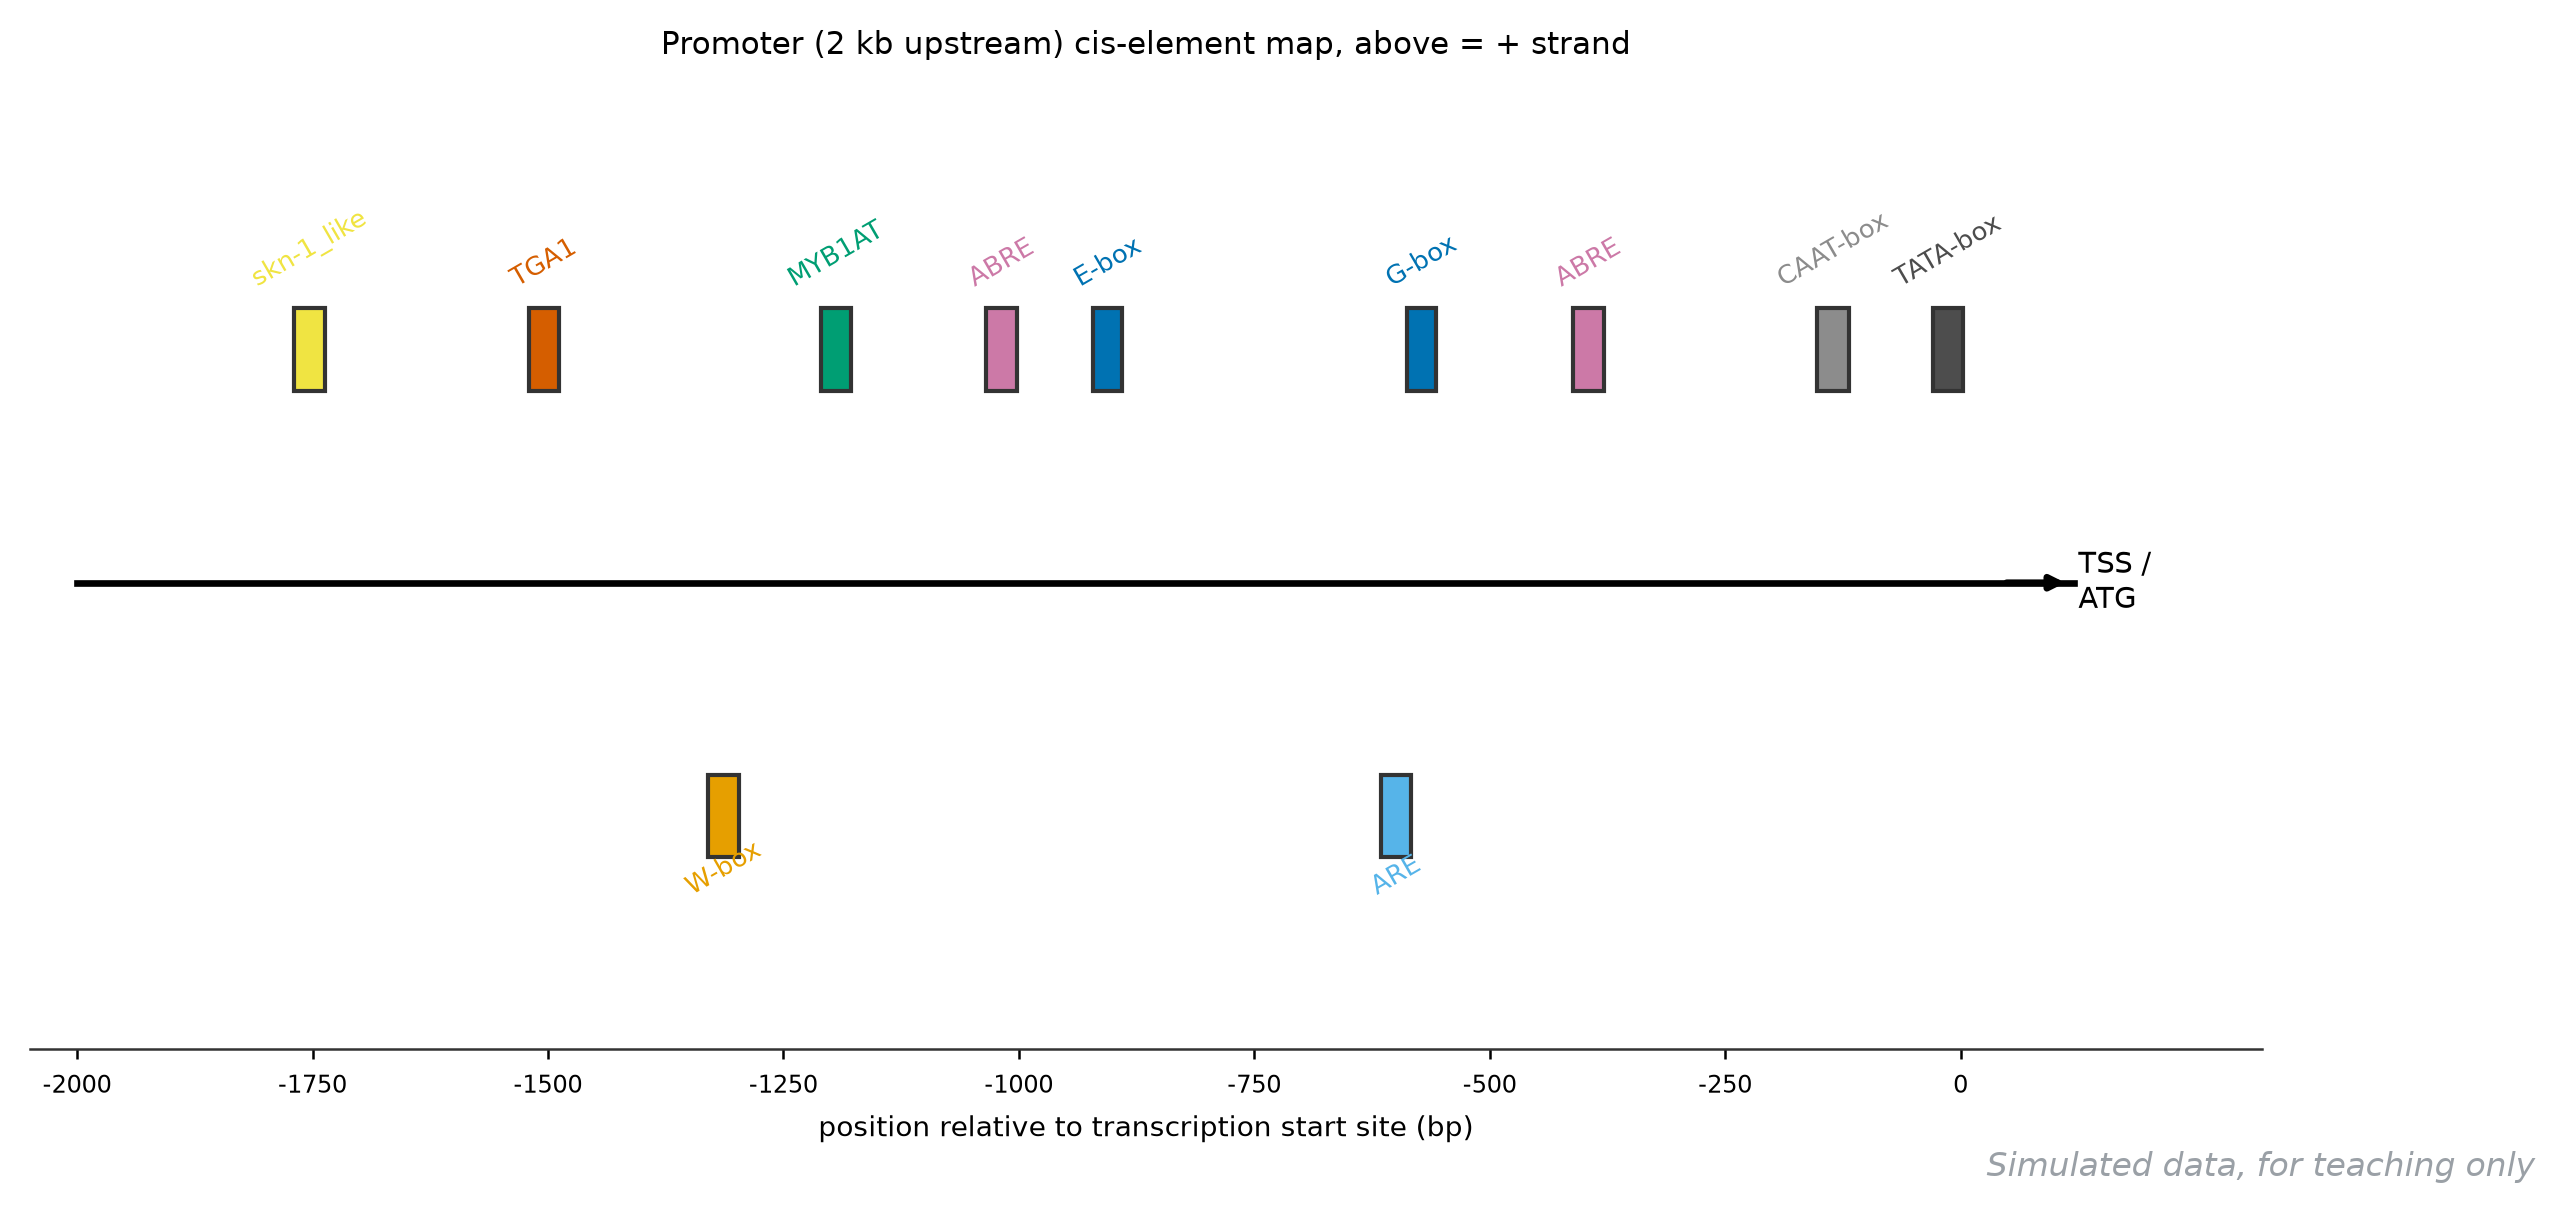
它回答什么问题:转录起始位点上游 2 kb 里埋着哪些环境与激素响应开关——顺式元件扫描(PlantCARE 风格)的可视化,解释「这个基因受谁调控」。
怎么读:横轴是相对 TSS 的位置,轴上方是编码链(+)上的元件,下方是反义链(-)。每根小柱一个元件,颜色分家族:红色 ABRE(ABA 响应,出现两次,暗示该基因受干旱胁迫调控)、蓝色 G-box/E-box(光响应 MYB 识别位)、深灰 TATA-box(核心启动子,-29 处雷打不动)。读图输出一句话:「上游 400 bp 内有一个 ABRE 和一个 G-box,适合做 2 kb 全长启动子;近端 -600 bp 内密度最高,做截短载体先保这一段。」
用什么画:PlantCARE / JASPAR 扫完得到坐标表,出图用 matplotlib 按 start-end 画色块(正链在上、负链在下)。
图注示例:
图 39 目标基因启动子区(TSS 上游 2 kb)顺式作用元件分布。柱上方为编码链元件,下方为反义链元件;ABRE 为 ABA 响应元件,G-box/E-box 为光响应元件,TATA-box 为核心启动子元件。
展开查看:模拟数据(元件坐标表)
element,start,end,strand
TATA-box,-29,-24,+
CAAT-box,-152,-145,+
ABRE,-412,-405,+
G-box,-588,-583,+
ARE,-615,-610,-
E-box,-921,-916,+
ABRE,-1035,-1028,+
MYB1AT,-1210,-1204,+
W-box,-1330,-1323,-
TGA1,-1520,-1514,+
skn-1_like,-1770,-1763,+
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 38-promoter.csv(+ 链在上、- 链在下)
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

df = pd.read_csv("38-promoter.csv")
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860",
       "#DA8BC3", "#8C8C8C", "#CCB974", "#64B5CD"]
fam = list(dict.fromkeys(df.element))
fcol = {f: CAT[i % 10] for i, f in enumerate(fam)}
fig, ax = plt.subplots(figsize=(9.6, 4.2))
for _, row in df.iterrows():
    y = 1.25 if row.strand == "+" else -1.25
    ax.add_patch(Rectangle((row.start, y - 0.22), row.end - row.start + 26,
                           0.44, facecolor=fcol[row.element], edgecolor="0.2"))
    ax.text(row.start + 13, y + (0.34 if row.strand == "+" else -0.42),
            row.element, ha="center", fontsize=8, rotation=30,
            color=fcol[row.element])
ax.plot([-2000, 120], [0, 0], color="black", lw=1.6)
ax.text(125, 0, "TSS", va="center", fontsize=9)
ax.set_xlim(-2050, 320)
ax.set_ylim(-2.5, 2.7)
ax.set_yticks([])
ax.set_xticks(range(-2000, 1, 250))
ax.set_xlabel("position relative to TSS (bp)")
ax.spines["left"].set_visible(False)
fig.savefig("38-promoter-cis.png", dpi=200, bbox_inches="tight")
8.5 发育进程通路表达动态图
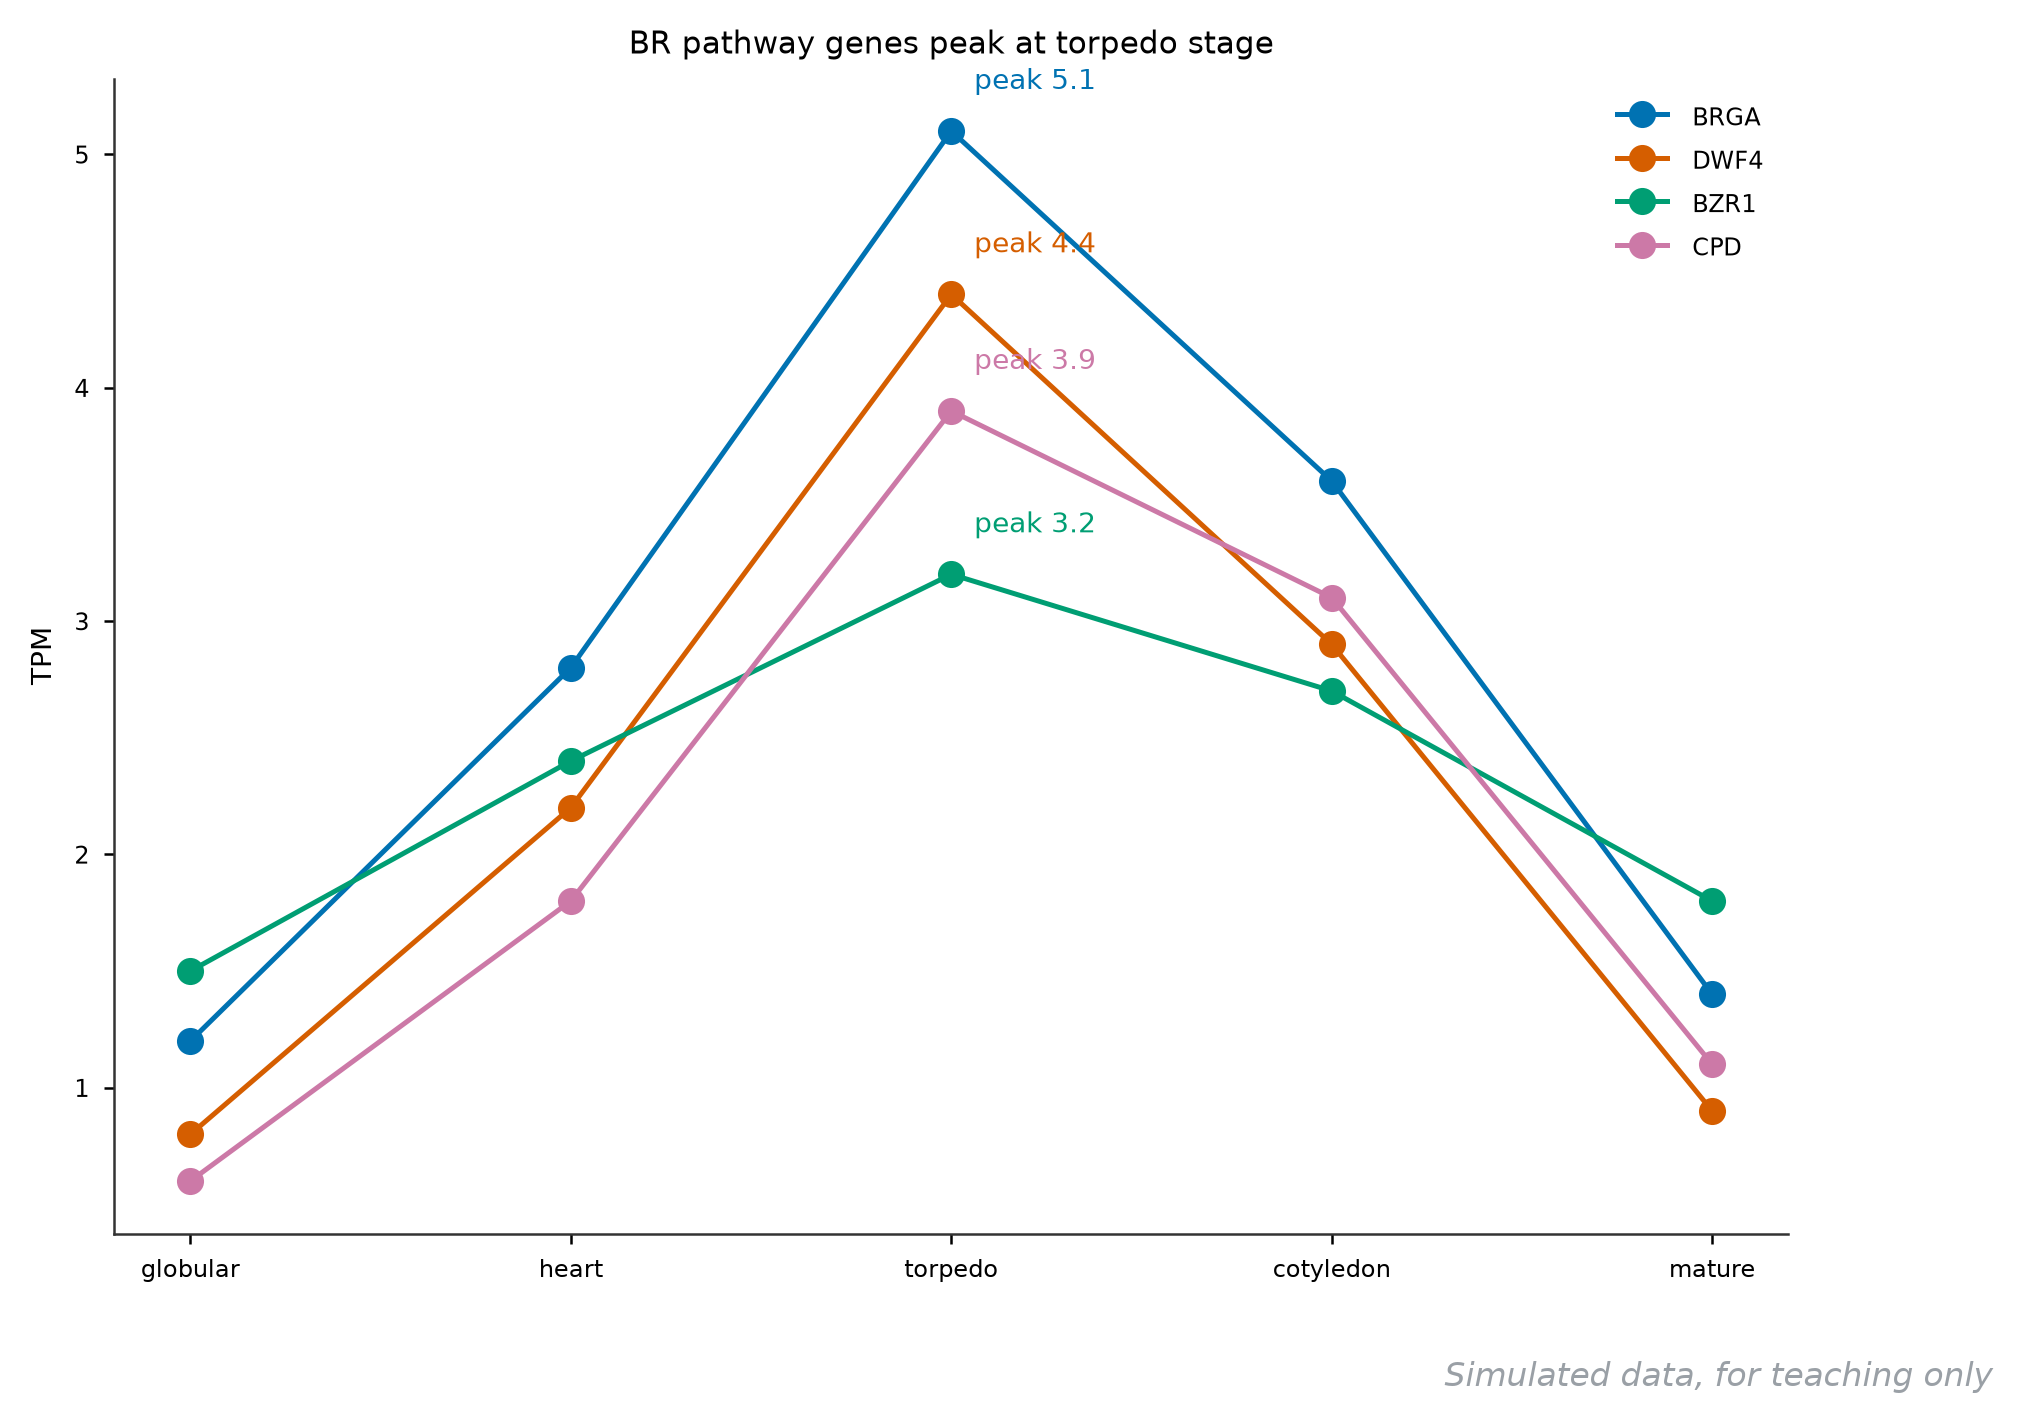
它回答什么问题:种子发育一路走过来,BRGA 和它所在的油菜素内酯通路基因什么时候活最凶——「种子发育过程中 BR 通路表达动态变化」的正面回答。
怎么读:横轴五个发育时期,每条折线一个基因,标注各自峰值。看点线关系:四个基因全部在心形胚到鱼雷胚之间冲顶(BRGA 峰值 5.1 TPM),成熟期集体回落——通路整体「先开后关」,说明 BR 信号集中在形态建成期。两条线峰谷是否同步本身就是证据:同步是协同调控,错位是级联(上下游关系),配合 8.6 的级联热图一起讲。
用什么画:R 语言 ggplot2::geom_line + geom_point;Python 用 matplotlib 折线加 annotate 标峰值。
图注示例:
图 40 BR 通路四个基因在种子五个发育阶段的表达动态(TPM)。BRGA、DWF4、BZR1 与 CPD 均在鱼雷胚期达到峰值,成熟期回落。
展开查看:模拟数据(时期表达表)
stage,BRGA,DWF4,BZR1,CPD
globular,1.2,0.8,1.5,0.6
heart,2.8,2.2,2.4,1.8
torpedo,5.1,4.4,3.2,3.9
cotyledon,3.6,2.9,2.7,3.1
mature,1.4,0.9,1.8,1.1
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 39-brga.csv
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("39-brga.csv", index_col="stage")
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52"]
x = range(len(df))
fig, ax = plt.subplots(figsize=(7.2, 5.0))
for i, g in enumerate(df.columns):
    ax.plot(x, df[g], "-o", ms=6, color=CAT[i], label=g)
    pk = df[g].idxmax()
    ax.annotate("peak %.1f" % df[g].max(), (list(df.index).index(pk), df[g].max()),
                xytext=(8, 8), textcoords="offset points", fontsize=8.5, color=CAT[i])
ax.set_xticks(x, df.index)
ax.set_ylabel("TPM")
ax.legend()
fig.savefig("39-brga-dynamics.png", dpi=200, bbox_inches="tight")
8.6 级联表达热图
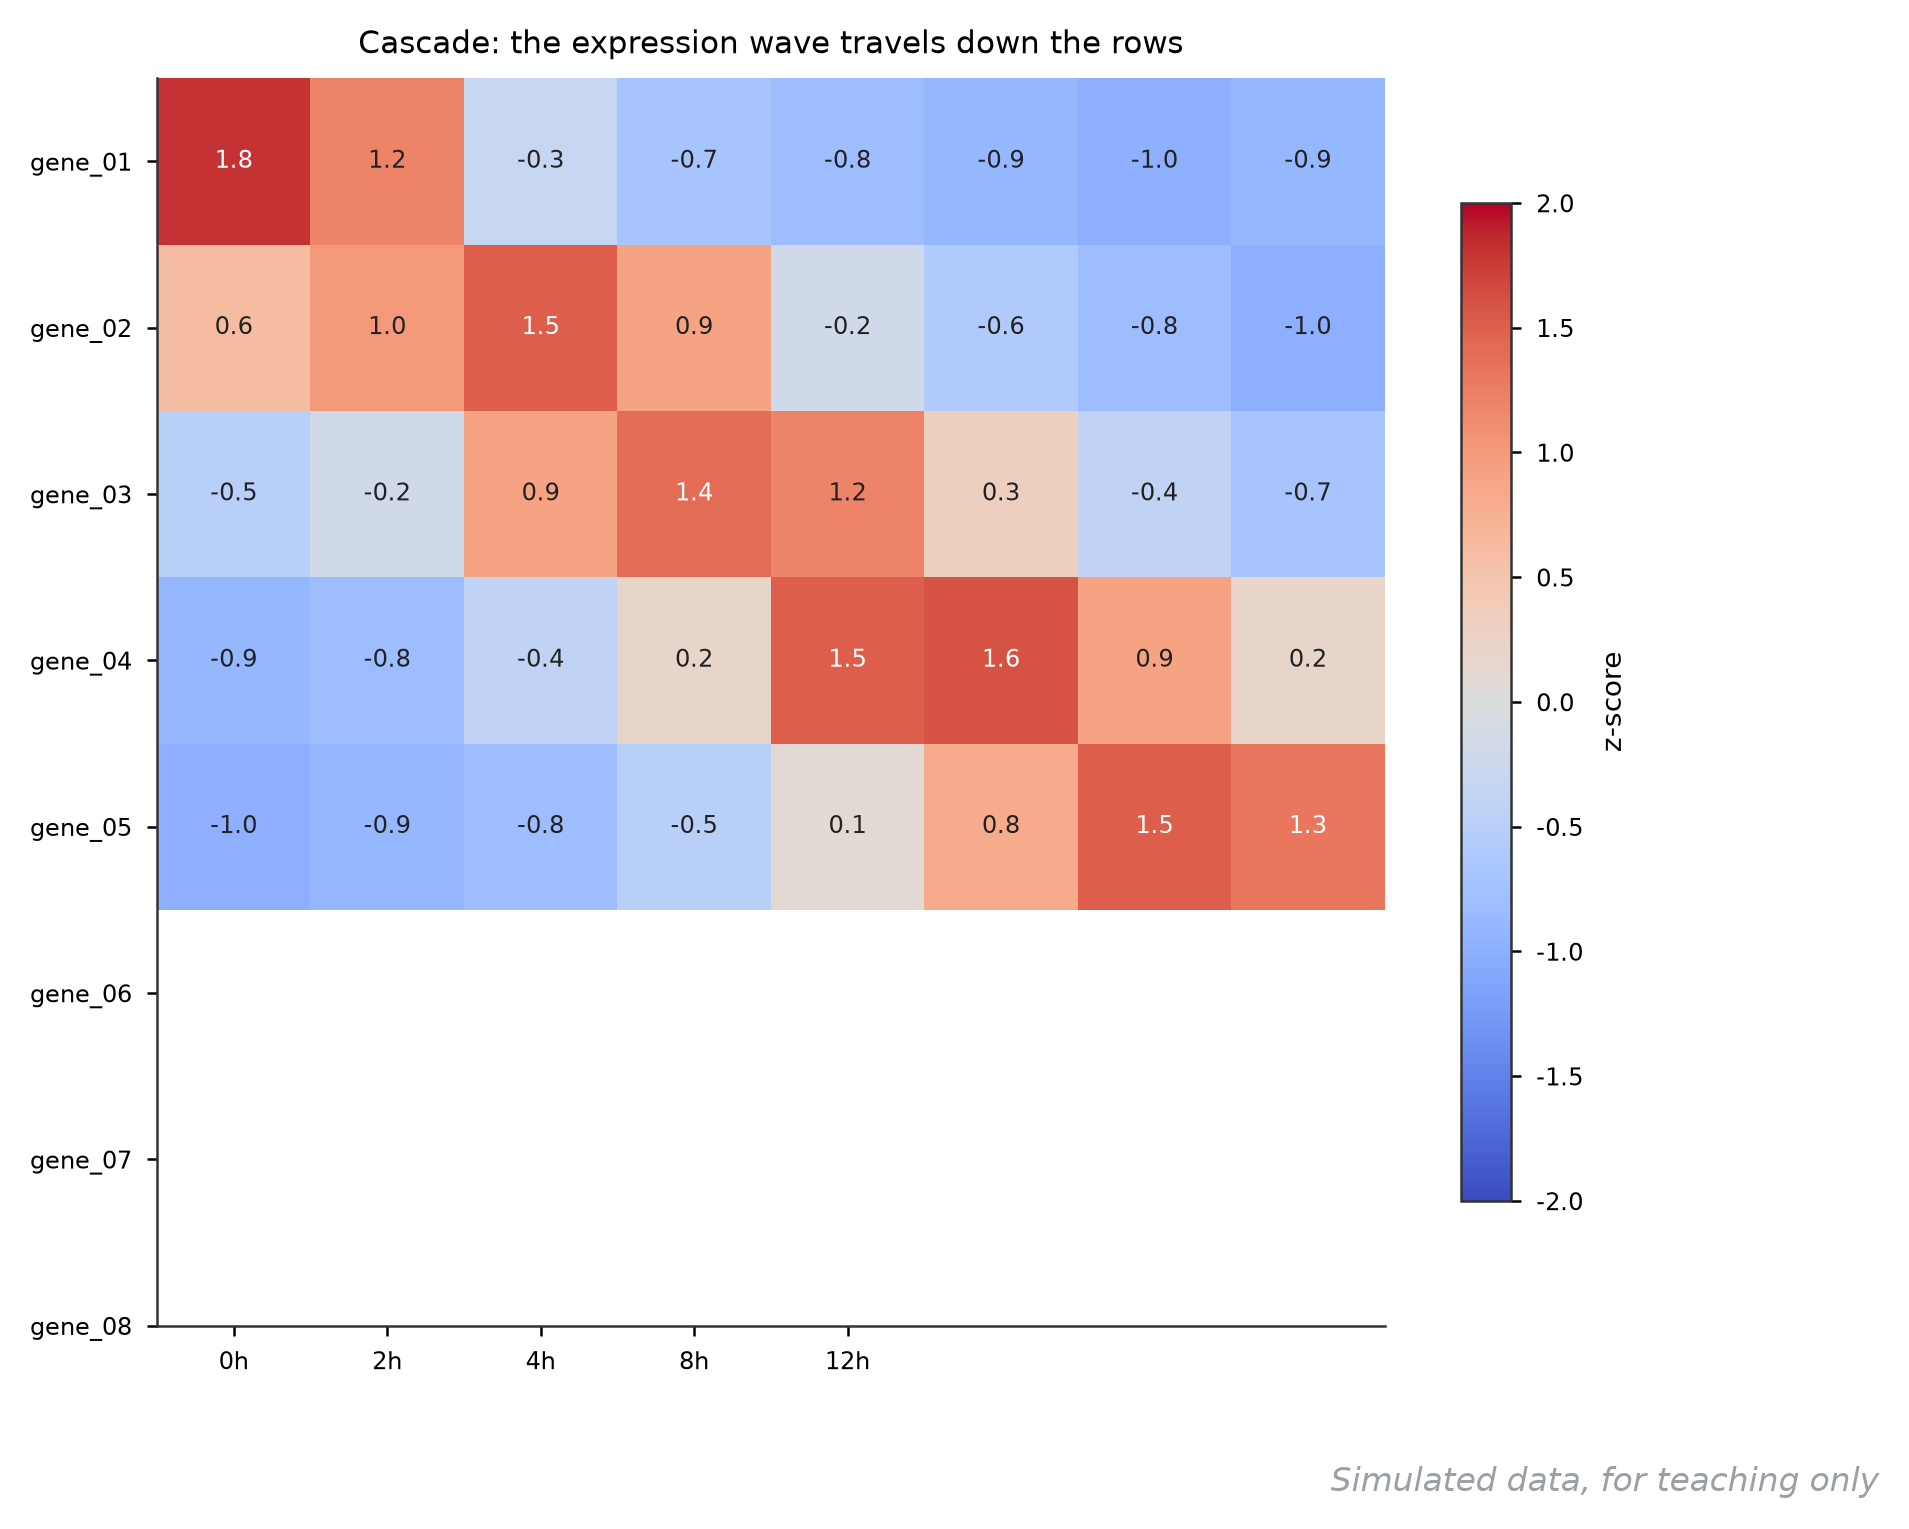
它回答什么问题:把一串基因按响应顺序排好,看「表达波」沿时间轴一级一级传下去——激素级联或信号级联的时序证据,也是两基因/多基因级联表达的标准展示。
怎么读:横轴时间点,纵轴基因按响应先后排好,颜色是 z-score。看色块的走向:高亮区域从左上角斜着扫到右下角(gene_01 在 0 h 最亮,gene_08 在 12 h 才亮),波前每前进一格约 2-4 小时——这个斜率就是级联的传递速度。排序有讲究:按峰值时间重排基因再画,斜带才会出现;按字母序排就是一锅粥。两基因级联是它的最小版本:只留上下游两行,斜带照样成立。
用什么画:R 语言 pheatmap(行按峰值时间排序后画);Python 用 seaborn.heatmap。
图注示例:
图 41 信号级联相关基因的时序表达热图。基因按表达峰值时间自上而下排列,颜色为 z-score;高表达区沿时间轴斜向推进,体现级联激活顺序。
展开查看:模拟数据(时间进程 z-score 表)
gene,0h,2h,4h,8h,12h
gene_01,1.8,0.6,-0.5,-0.9,-1.0
gene_02,1.2,1.0,-0.2,-0.8,-0.9
gene_03,-0.3,1.5,0.9,-0.4,-0.8
gene_04,-0.7,0.9,1.4,0.2,-0.5
gene_05,-0.8,-0.2,1.2,1.5,0.1
gene_06,-0.9,-0.6,0.3,1.6,0.8
gene_07,-1.0,-0.8,-0.4,0.9,1.5
gene_08,-0.9,-1.0,-0.7,0.2,1.3
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 40-cascade.csv;行按峰值时间排序后斜带才会出现
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("40-cascade.csv", index_col="gene")
order = df.values.argmax(axis=1).argsort()       # 按峰值所在时间点排序
df = df.iloc[order]
fig, ax = plt.subplots(figsize=(6.6, 5.4))
im = ax.imshow(df.values, cmap="coolwarm", vmin=-2, vmax=2, aspect="auto")
ax.set_xticks(range(df.shape[1]), df.columns)
ax.set_yticks(range(df.shape[0]), df.index)
ax.grid(False)
for i in range(df.shape[0]):
    for j in range(df.shape[1]):
        ax.text(j, i, "%.1f" % df.values[i, j], ha="center", va="center",
                fontsize=7.5, color="white" if abs(df.values[i, j]) > 1.2 else "#222")
fig.colorbar(im, ax=ax, shrink=0.8, label="z-score")
fig.savefig("40-cascade-heatmap.png", dpi=200, bbox_inches="tight")
8.7 脊线图(ridgeline plot)
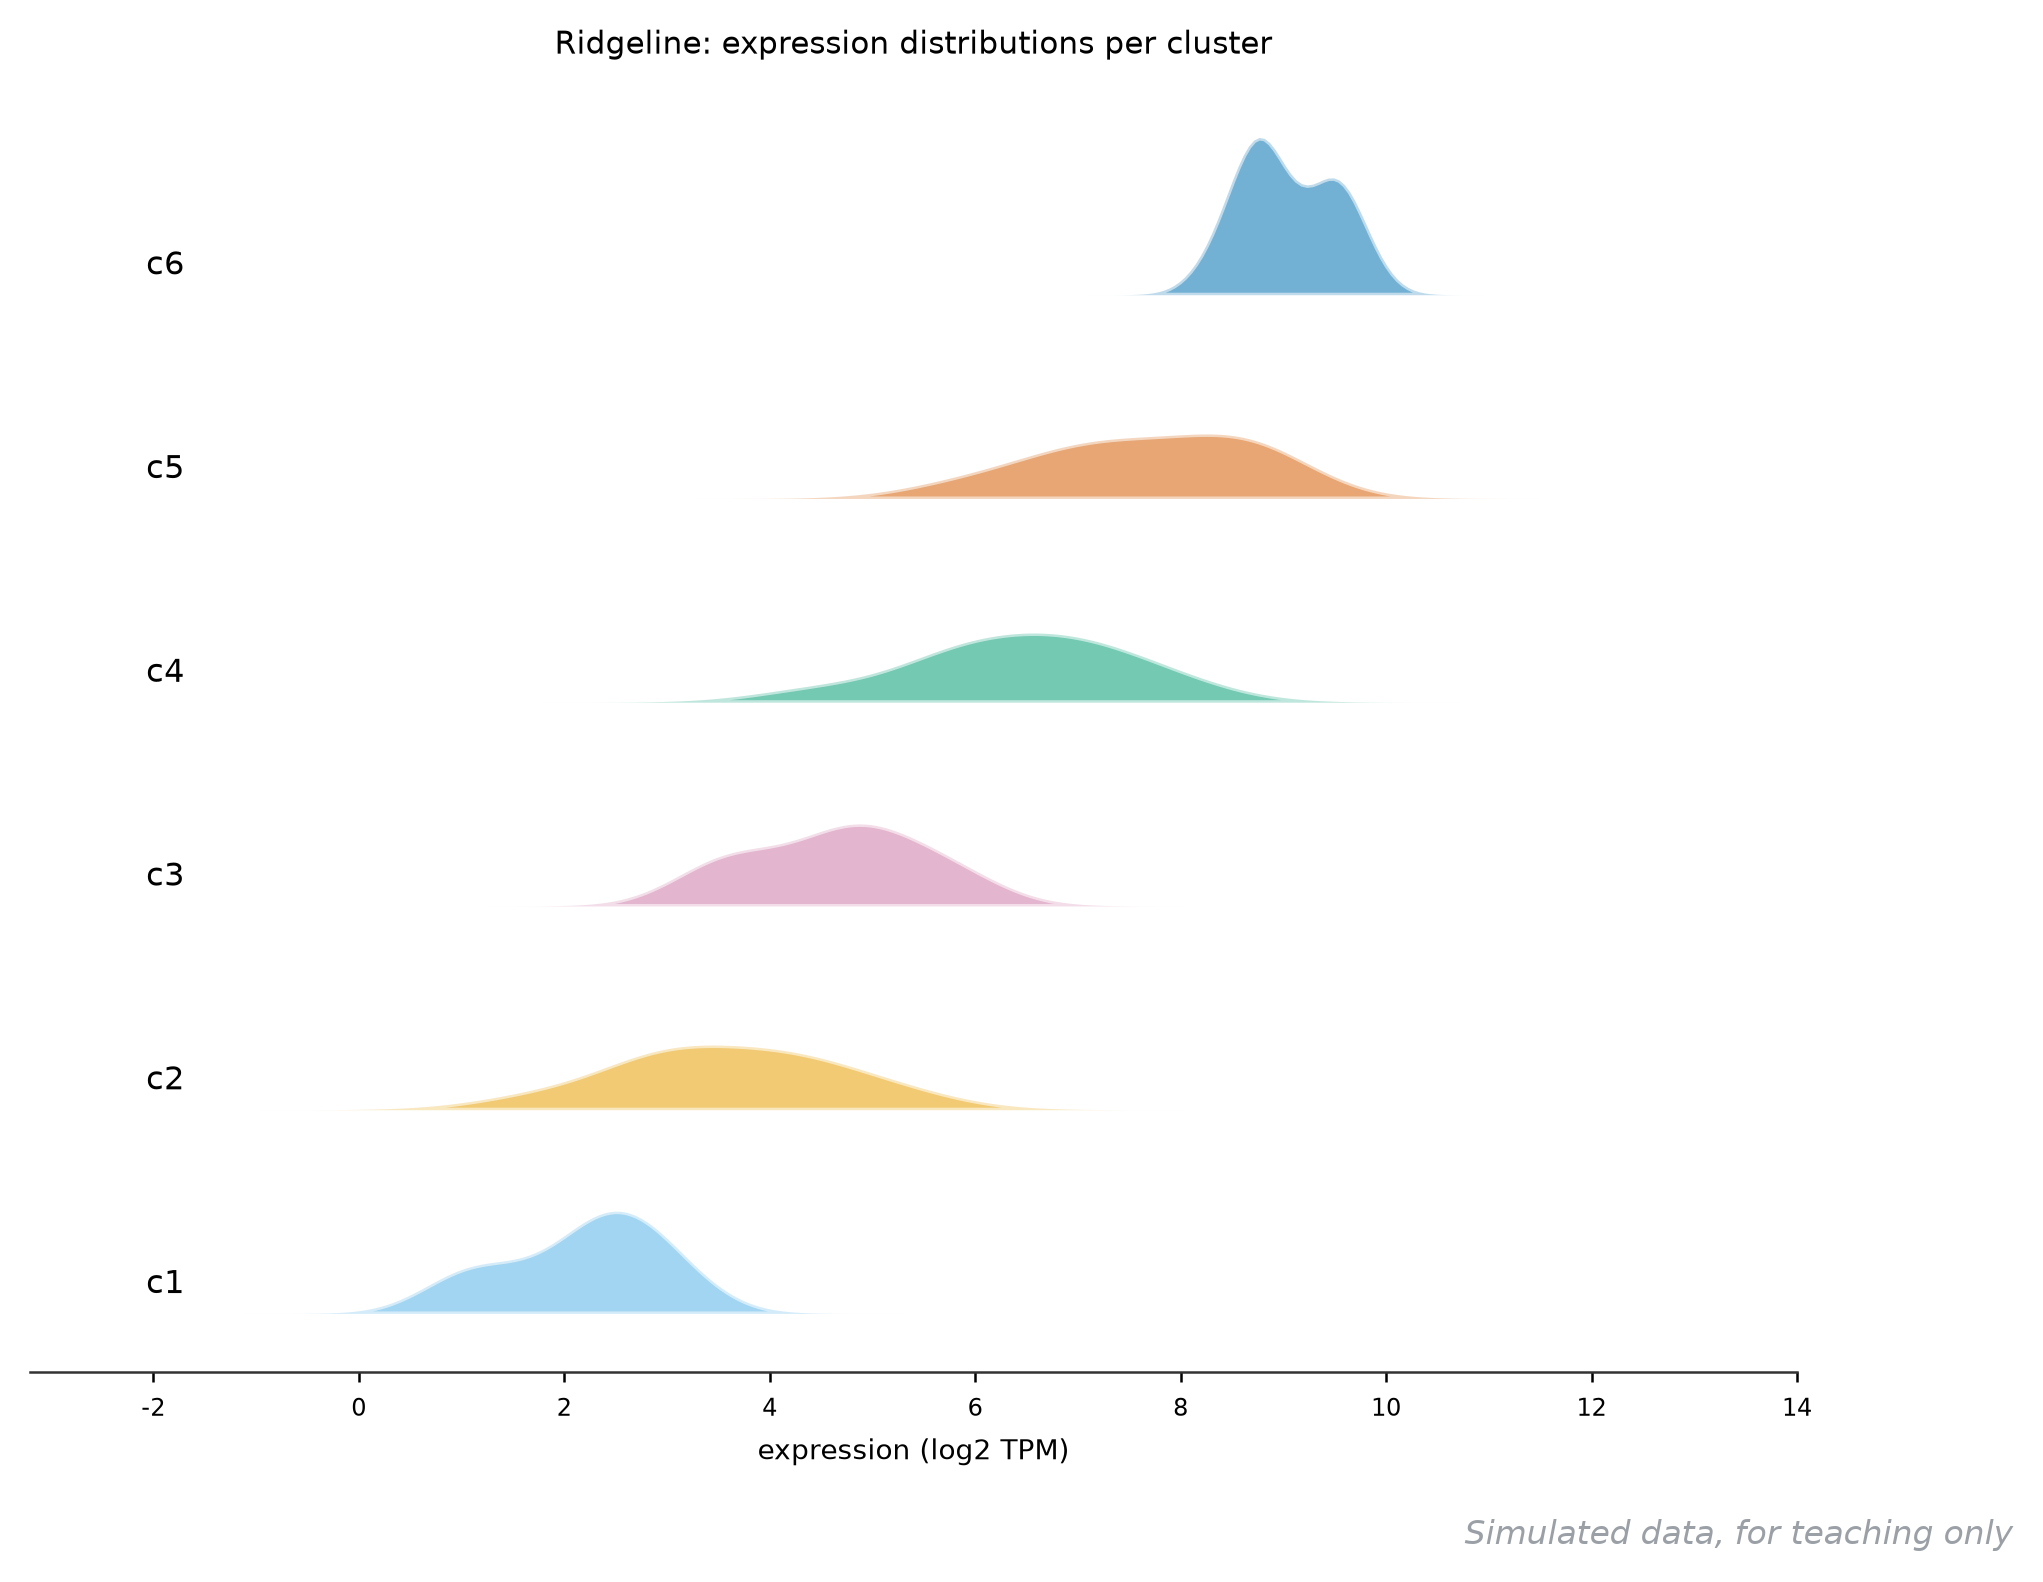
它回答什么问题:六七个簇的表达分布一层层叠出山脊——单细胞文章里比较各簇表达分布形状的头号选手,也就是你印象里那张「裂线图」的另一个候选答案。
怎么读:每条「山脊」是一个簇的核密度估计,横向位置是表达量,纵向错开只为不重叠(山与山的落差没有数值含义,别读纵轴)。看两样:山谷整体从 c1 到 c6 逐级右移(均值递增的梯度),以及某条山脊是否双峰(c6 的右肩小鼓包提示簇内还有异质性,值得 sub-cluster)。样本量小于 20 时密度是猜的,先画小提琴或箱线确认。
用什么画:R 语言 ggridges::geom_density_ridges 一行成名;Python 用 joypy.joyplot,或像这张图一样 scipy 算 KDE 后手绘。
图注示例:
图 42 六个细胞簇目标基因表达分布的脊线图。曲线为各簇核密度估计(n = 10/簇,模拟数据演示),纵向偏移仅为排版,无数值含义;c1 至 c6 表达水平逐簇升高。
展开查看:模拟数据(各簇表达值)
cluster,expression
c1,1.60
c1,2.26
c1,2.61
c1,1.03
c1,2.77
c1,2.26
c1,2.78
c1,2.27
c1,3.16
c1,1.06
c2,5.28
c2,4.70
c2,2.90
c2,4.16
c2,3.94
c2,1.75
c2,4.10
c2,2.91
c2,3.25
c2,2.90
c3,4.57
c3,5.07
c3,5.10
c3,3.44
c3,4.73
c3,3.66
c3,3.73
c3,4.65
c3,5.86
c3,5.63
c4,5.90
c4,5.79
c4,5.67
c4,6.64
c4,7.44
c4,6.52
c4,7.19
c4,6.82
c4,8.00
c4,4.49
c5,5.87
c5,7.80
c5,8.64
c5,7.59
c5,8.43
c5,6.83
c5,6.74
c5,7.28
c5,8.84
c5,8.70
c6,8.79
c6,9.68
c6,8.85
c6,9.52
c6,8.39
c6,9.45
c6,8.76
c6,9.46
c6,8.85
c6,8.68
绘图代码(Python,独立可运行)
# 数据:将上方 CSV 保存为 41-ridge.csv;山脊高度=核密度,纵向错开仅为排版
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy.stats import gaussian_kde

df = pd.read_csv("41-ridge.csv")
groups = list(df.groupby("cluster"))
xs = np.linspace(-1.5, 14, 300)
fig, ax = plt.subplots(figsize=(7.6, 5.6))
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860"]
for i, (name, sub) in enumerate(reversed(groups)):
    d = gaussian_kde(sub.expression.values)(xs)
    base = (len(groups) - i) * 1.0
    ax.fill_between(xs, base, base + d, color=CAT[i % 6], alpha=0.55, lw=1.2,
                    edgecolor="white")
    ax.text(-1.7, base + 0.1, name, ha="right", fontsize=10)
ax.set_xlim(-3.2, 14)
ax.set_yticks([])
ax.spines["left"].set_visible(False)
ax.set_xlabel("expression (log2 TPM)")
fig.savefig("41-ridgeline.png", dpi=200, bbox_inches="tight")
九、图注写作法:让审稿人不用猜
前面每张图都给了一句图注示例,这里把套路摊开。一条合格的图注永远是五段式:图名(WHAT)+ 材料条件(WHO)+ 参数口径(HOW)+ 结论句(SO WHAT)+ 标注说明(①②③)。
第一段,图名:图里画的是什么,一句话,不带结论。例如「处理组与对照组转录组差异火山图」。
第二段,材料与条件:样本是什么、n 是多少、几个生物学重复。写进图注而不是正文,因为读图的人第一件事就是找 n。
第三段,参数口径:阈值和计算方法。火山图写「log2FC 绝对值 ≥ 1 且 padj < 0.05」,qPCR 写「2^-ΔΔCt 法,Actin 内参,误差线为 SD,n = 3」,聚类写「平均连锁,欧氏距离」。审稿人挑刺 80% 挑在这一段缺东西。
第四段,结论句:允许写进图注的最大胆的一句话,只描述图支持的结论,不外推。例如「处理后黄酮合成通路基因整体上调」可以,「处理激活了植物免疫」不行。
第五段,标注说明:图上凡是画了 ①②③ 标注线,图注必须逐条对应。这就是「图上弄些线条去标注一二三,注释那边说明」的完整闭环——图上标号,图注给编号字典:
图 26 qPCR 熔解曲线(A)及其一阶负导数(B)。①主峰为目标产物熔解峰;②附加峰提示引物二聚体;③单扩增样本的单一尖峰。一个样本只有出现 ③ 型曲线时其 Ct 值才可用于定量。
峰值与拐点的描述句式,直接套用:
- 火山图:「共鉴定出 X 个上调、Y 个下调差异基因(log2FC 绝对值 ≥ 1,padj < 0.05)」
- 熔解峰:「产物单一,熔解温度 Tm = 82.0 C,峰形尖锐无杂峰」
- GSEA:「该通路显著富集(NES = 2.31,FDR = 0.021),leading edge 位于排序前 8 位」
- 流式周期:「G2/M 期细胞比例由 18% 升至 31%,提示 G2/M 阻滞」
- 生存曲线:「处理组中位生存期显著长于对照组(log-rank p = 0.032)」
- 相关性:「二者表达呈显著正相关(Pearson r = 0.97,p < 0.001,n = 12)」
最后是三条硬性自检:坐标轴必须有物理量与单位(TPM、log2FC、循环数、温度 C,不能只有数字);统计标记必须能追溯到检验方法(星号、误差线类型、n);每张模拟或拼合示意图必须在图注声明,本文所有图右下角的 Simulated data 水印就是这条纪律的示范。
十、写在最后
41 张图过完一遍,你会发现它们的底层逻辑其实只有四种动作:比较(柱状图、箱线图)、关系(散点、相关热图、弦图)、分布(小提琴、脊线图、流式直方图)和排序(GSEA、火山图、森林图)。拿到一张陌生图,先问它是哪种动作、坐标轴各是什么、颜色编码什么,大部分图不教自会。
本文全部图片由 Python 3.14 + matplotlib 3.11 在 WSL 里渲染,绘图脚本和这 38 组模拟数据都在仓库 tools/bio-plots/ 目录下,想复现哪张就翻哪个 ch*.py。清单没有断在这里:第二篇把 Circos 圈图、共线性点阵、系统发育树这些群体遗传与比较基因组的图收了,第三篇和第四篇还有 Sanger 峰图、LocusZoom、Hi-C、空间转录组和 AI 多组学,四篇合计 133 张。
参考文献
- Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biology, 2014.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. PNAS, 2005.
- Kanehisa M, Goto S. KEGG: Kyoto encyclopedia of genes and genomes. Nucleic Acids Research, 2000.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nature Genetics, 2000.
- Kaplan EL, Meier P. Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 1958.
- Wu T, et al. clusterProfiler 4.0: a universal enrichment tool for interpreting omics data. The Innovation, 2021.
- Hunter JD. Matplotlib: a 2D graphics environment. Computing in Science & Engineering, 2007.
- Wickham H. ggplot2: Elegant Graphics for Data Analysis. Springer, 2016.
参考代码
- 本文 41 张图的绘图脚本:仓库
tools/bio-plots/ch2_diff_expr.py至ch7_ch8_gene_prot.py,逐图独立、随机种子固定; - Linxira Bio SDK(GitHub)· 官网:表达矩阵 QC、归一化、差异分析等本篇图的直接上游,均为此处版本化能力;
- 工具链架构细节见拆解文:拆 Bio SDK:一个”不生成脚本”的本地生信工具链是怎么搭的。
原文存档:本文初版发布于旧站(Butterfly 主题)。如遇图表、代码高亮或 3D 交互显示异常,请查阅 完整存档版。