第四篇收在 AI 多组学,但「结构 → 变异 → 表达」这条主线还欠一整篇:拿到一个点突变,怎么把它标到三维结构上?口袋是松了还是紧了?预测完之后,qPCR 和半定量 RT-PCR 怎么把结论落成柱状图和凝胶?这篇 40 张图(编号 134-173)专门铺满三件事:蛋白结构的各种画法(含 4 张浏览器里点按加载、直接拖拽的交互 3D)、从预测质量到口袋功能的结构分析图、qPCR / 半定量 / 基因型差异的表达验证图。
从这篇起,系列第一次大规模使用真实实验数据。16 张真实图基于四套公开坐标:PDB 6A15 ↗(拟南芥油菜素甾醇合成酶 CYP90B1/DWF4 与胆固醇、血红素共晶,链 A 共 439 个解析残基)、PDB 1BI5 ↗ / 1I89 ↗(苜蓿查尔酮合酶野生型与 G256L 突变体)、AlphaFold DB ↗ 的 DWF4 预测模型(O64989,全局 pLDDT 89.75)、PDB 5ZD4 ↗(BIL1/BZR1 转录因子 DNA 结合域-DNA 复合物)。每张图配图下面第一行就是「数据」标签:真实图写明入口号、原始文件下载链接与本站镜像路径,图右下水印为「Real structure data: PDB …」;模拟图水印为「Simulated data, for teaching only」。全篇 16 张真实 + 24 张模拟,一张不混,速查表里再对一遍总账。
每张图固定四段:它回答什么问题、怎么读(横轴纵轴阈值参数)、用什么画、图注怎么写。每张图下面有默认折叠的「展开查看」块,里面是画这张图的那组数据的原样 CSV 和可直接运行的绘图代码——真实结构图的折叠块里给的代码吃的是 PDB 坐标文件(下载链接就在代码第一行注释里),模拟图吃的是 CSV,替换成自己的数据就能跑。管线思路仍见群体重测序学习地图。
本系列已出七篇:第一篇(41 张,统计与转录组临床) · 第二篇(33 张,群体遗传与基因组) · 第三篇(29 张,测序、表观与空间组学) · 第四篇(30 张,蛋白、生态与 AI 多组学) · 第五篇(40 张,蛋白结构、变异与表达验证)即本篇 · 第六篇(22 张,真实公开数据实战) · 第七篇(190 张图 Nature 风格重构与方法选型)。
自推一句:结构分析与湿实验验证之间的「跑分析、出表、到画图前的最后一公里」,正是我在做的 Linxira Bio SDK ↗(本地优先生信工具链)想版本化的对象:正式分支已发布 v1.0.1,提供 expression matrix QC、FASTQ/比对质检、变异统计等 CLI 与 35 个 agent skills,另有官网 ↗与我的拆解文。免责声明:本篇配图分真实结构数据(PDB/AlphaFold 公开坐标,图内右下角「Real structure data」水印,来源与下载链接见每节「数据」行与文末参考数据)与模拟数据(「Simulated data」水印,仅教学演示,勿作真实结果引用)两类;SDK 实际可用的分析能力,请以仓库 ↗正式分支的最新 release 为准——文中部分图对应的分析尚在开发路线中,目前仅存在于本地开发分支,未合并进正式分支、代码未公开。
一、图表地图与速查表#
{% mermaid %} flowchart LR START([“第五篇 · 40 张”]):::hub subgraph A[“① 结构表示”] direction TB A1[“CA 迹线 · 线框 · 口袋棍棒 · 缎带”] end subgraph B[“② 交互 3D”] direction TB B1[“cartoon · WT/突变 对比”] B2[“pLDDT 上色 · TF-DNA”] end subgraph C[“③ 预测与突变”] direction TB C1[“PAE · 接触图 · 叠合”] C2[“棒棒糖 · 替换矩阵 · ddG · 注释轨道”] end subgraph D[“④ 口袋到功能”] direction TB D1[“口袋定位 · 体积 · 保守性”] D2[“对接 · 界面接触 · SASA”] end subgraph E[“⑤ 表达验证”] direction TB E1[“qPCR 标准曲线 · 凝胶 · 热图”] E2[“箱线 · GxE · 相关散点”] end subgraph F[“⑥ 结构细节 补遗”] direction TB F1[“拉氏图 · B 因子 · 接触数 · 共进化”] F2[“RMSD/Rg · 氢键 · 熔解 · Western”] end START —> A —> B —> C —> D —> E —> F classDef hub fill:#1f4e79,color:#fff,font-weight:bold {% endmermaid %}
| 编号 | 图型 | 一句话用途 | 数据 |
|---|---|---|---|
| 134 | C-alpha 骨架迹线 | 蛋白整体折叠一览 | 真实 6A15 |
| 135 | 全原子线框图 | 键级细节、元素组成 | 真实 6A15 |
| 136 | 口袋残基棍棒图 | 配体周围谁在搭口袋 | 真实 6A15 |
| 137 | 空间填充球状模型 | 配体是否埋进内部 | 真实 6A15 |
| 138 | 缎带示意图 | 出版物最常见的呈现 | 真实 6A15 |
| 139 | 交互 3D:cartoon+配体 | 浏览器里转着看 | 真实 6A15(交互) |
| 140 | 交互 3D:WT vs 突变体 | 口袋前后对比 | 真实 1BI5/1I89(交互) |
| 141 | 交互 3D:pLDDT 上色 | 模型哪段可信 | 真实 AlphaFold(交互) |
| 142 | 交互 3D:TF-DNA 复合物 | 转录因子怎么抓 DNA | 真实 5ZD4(交互) |
| 143 | PAE 预测对齐误差热图 | 结构域边界与相对取向 | 模拟 |
| 144 | 残基接触图 | 折叠拓扑、互作模式 | 真实 6A15 |
| 145 | WT/突变体结构叠合 | 点突变动了哪里 | 真实 1BI5/1I89 |
| 146 | 突变棒棒糖图 | 一排突变的危害排序 | 模拟 |
| 147 | 氨基酸替换容忍度矩阵 | 哪些替换破坏大 | 模拟 |
| 148 | ΔΔG 稳定性条形图 | 突变会不会拆台 | 模拟 |
| 149 | 二级结构注释轨道图 | SRS/催化位点定位 | 模拟布局 |
| 150 | 口袋定位图 | 口袋在全局的位置 | 真实 6A15 |
| 151 | 口袋体积条形图 | 突变后装不装得下 | 模拟 |
| 152 | 保守性剖面 | 口袋是否被进化盯紧 | 模拟+真实位点 |
| 153 | 对接位姿与打分 | 谁能进口袋、姿势对不对 | 模拟 |
| 154 | 界面接触频率热图 | PPI 热点残基 | 模拟 |
| 155 | 逐残基 SASA 曲线 | 谁暴露谁埋没 | 真实 6A15 |
| 156 | qPCR 标准曲线 | 引物效率合格证 | 模拟 |
| 157 | 半定量 RT-PCR 凝胶 | 无 qPCR 时的表达量 | 模拟 |
| 158 | 多基因组织热图 | 基因家族组织特异性 | 模拟 |
| 159 | 野生种 vs 栽培种热图 | 驯化改变了什么表达 | 模拟 |
| 160 | 突变体 vs WT 箱线图 | 遗传学救回表达 | 模拟 |
| 161 | 基因型×环境折线图 | 诱导是否有互作 | 模拟 |
| 162 | 灰度 vs qPCR 相关性 | 半定量可信度标定 | 模拟 |
| 163 | 表达-表型散点回归 | 表达量连到农艺性状 | 模拟 |
| 164 | 拉氏图(Ramachandran) | 骨架二面角合不合理 | 真实 6A15 |
| 165 | 逐残基 B 因子曲线 | 晶体里哪里最”晃” | 真实 6A15 |
| 166 | 逐残基接触数曲线 | 谁埋在疏水核心 | 真实 6A15 |
| 167 | RMSD/Rg 动力学轨迹 | 模拟跑稳了没有 | 模拟 |
| 168 | 氢键占用率热图 | 哪些氢键真的常在 | 模拟 |
| 169 | 二维蛋白-配体互作图 | 口袋互作一张讲完 | 模拟绘制+真实位点 |
| 170 | 共进化接触 vs 真实接触 | 序列协变能不能预测接触 | 模拟打分+真实接触 |
| 171 | qPCR 熔解曲线峰 | 引物特异性体检 | 模拟 |
| 172 | 半定量循环数线性检验 | 循环数选对没有 | 模拟 |
| 173 | Western blot + 灰度定量 | 蛋白层面的表达验证 | 模拟 |
总账:16 张真实(12 张静态渲染 + 4 张交互 3D)+ 24 张模拟 = 40 张。
二、蛋白结构的五种静态表示(134-138)#
同一套坐标,五种画法各答一个问题。这一章全部用 PDB 6A15 真实坐标:拟南芥 CYP90B1(DWF4,油菜素内酯合成通路 C-22 羟化酶)与胆固醇(CLR)、血红素(HEM)的共晶结构。
2.1 C-alpha 骨架迹线(134)#
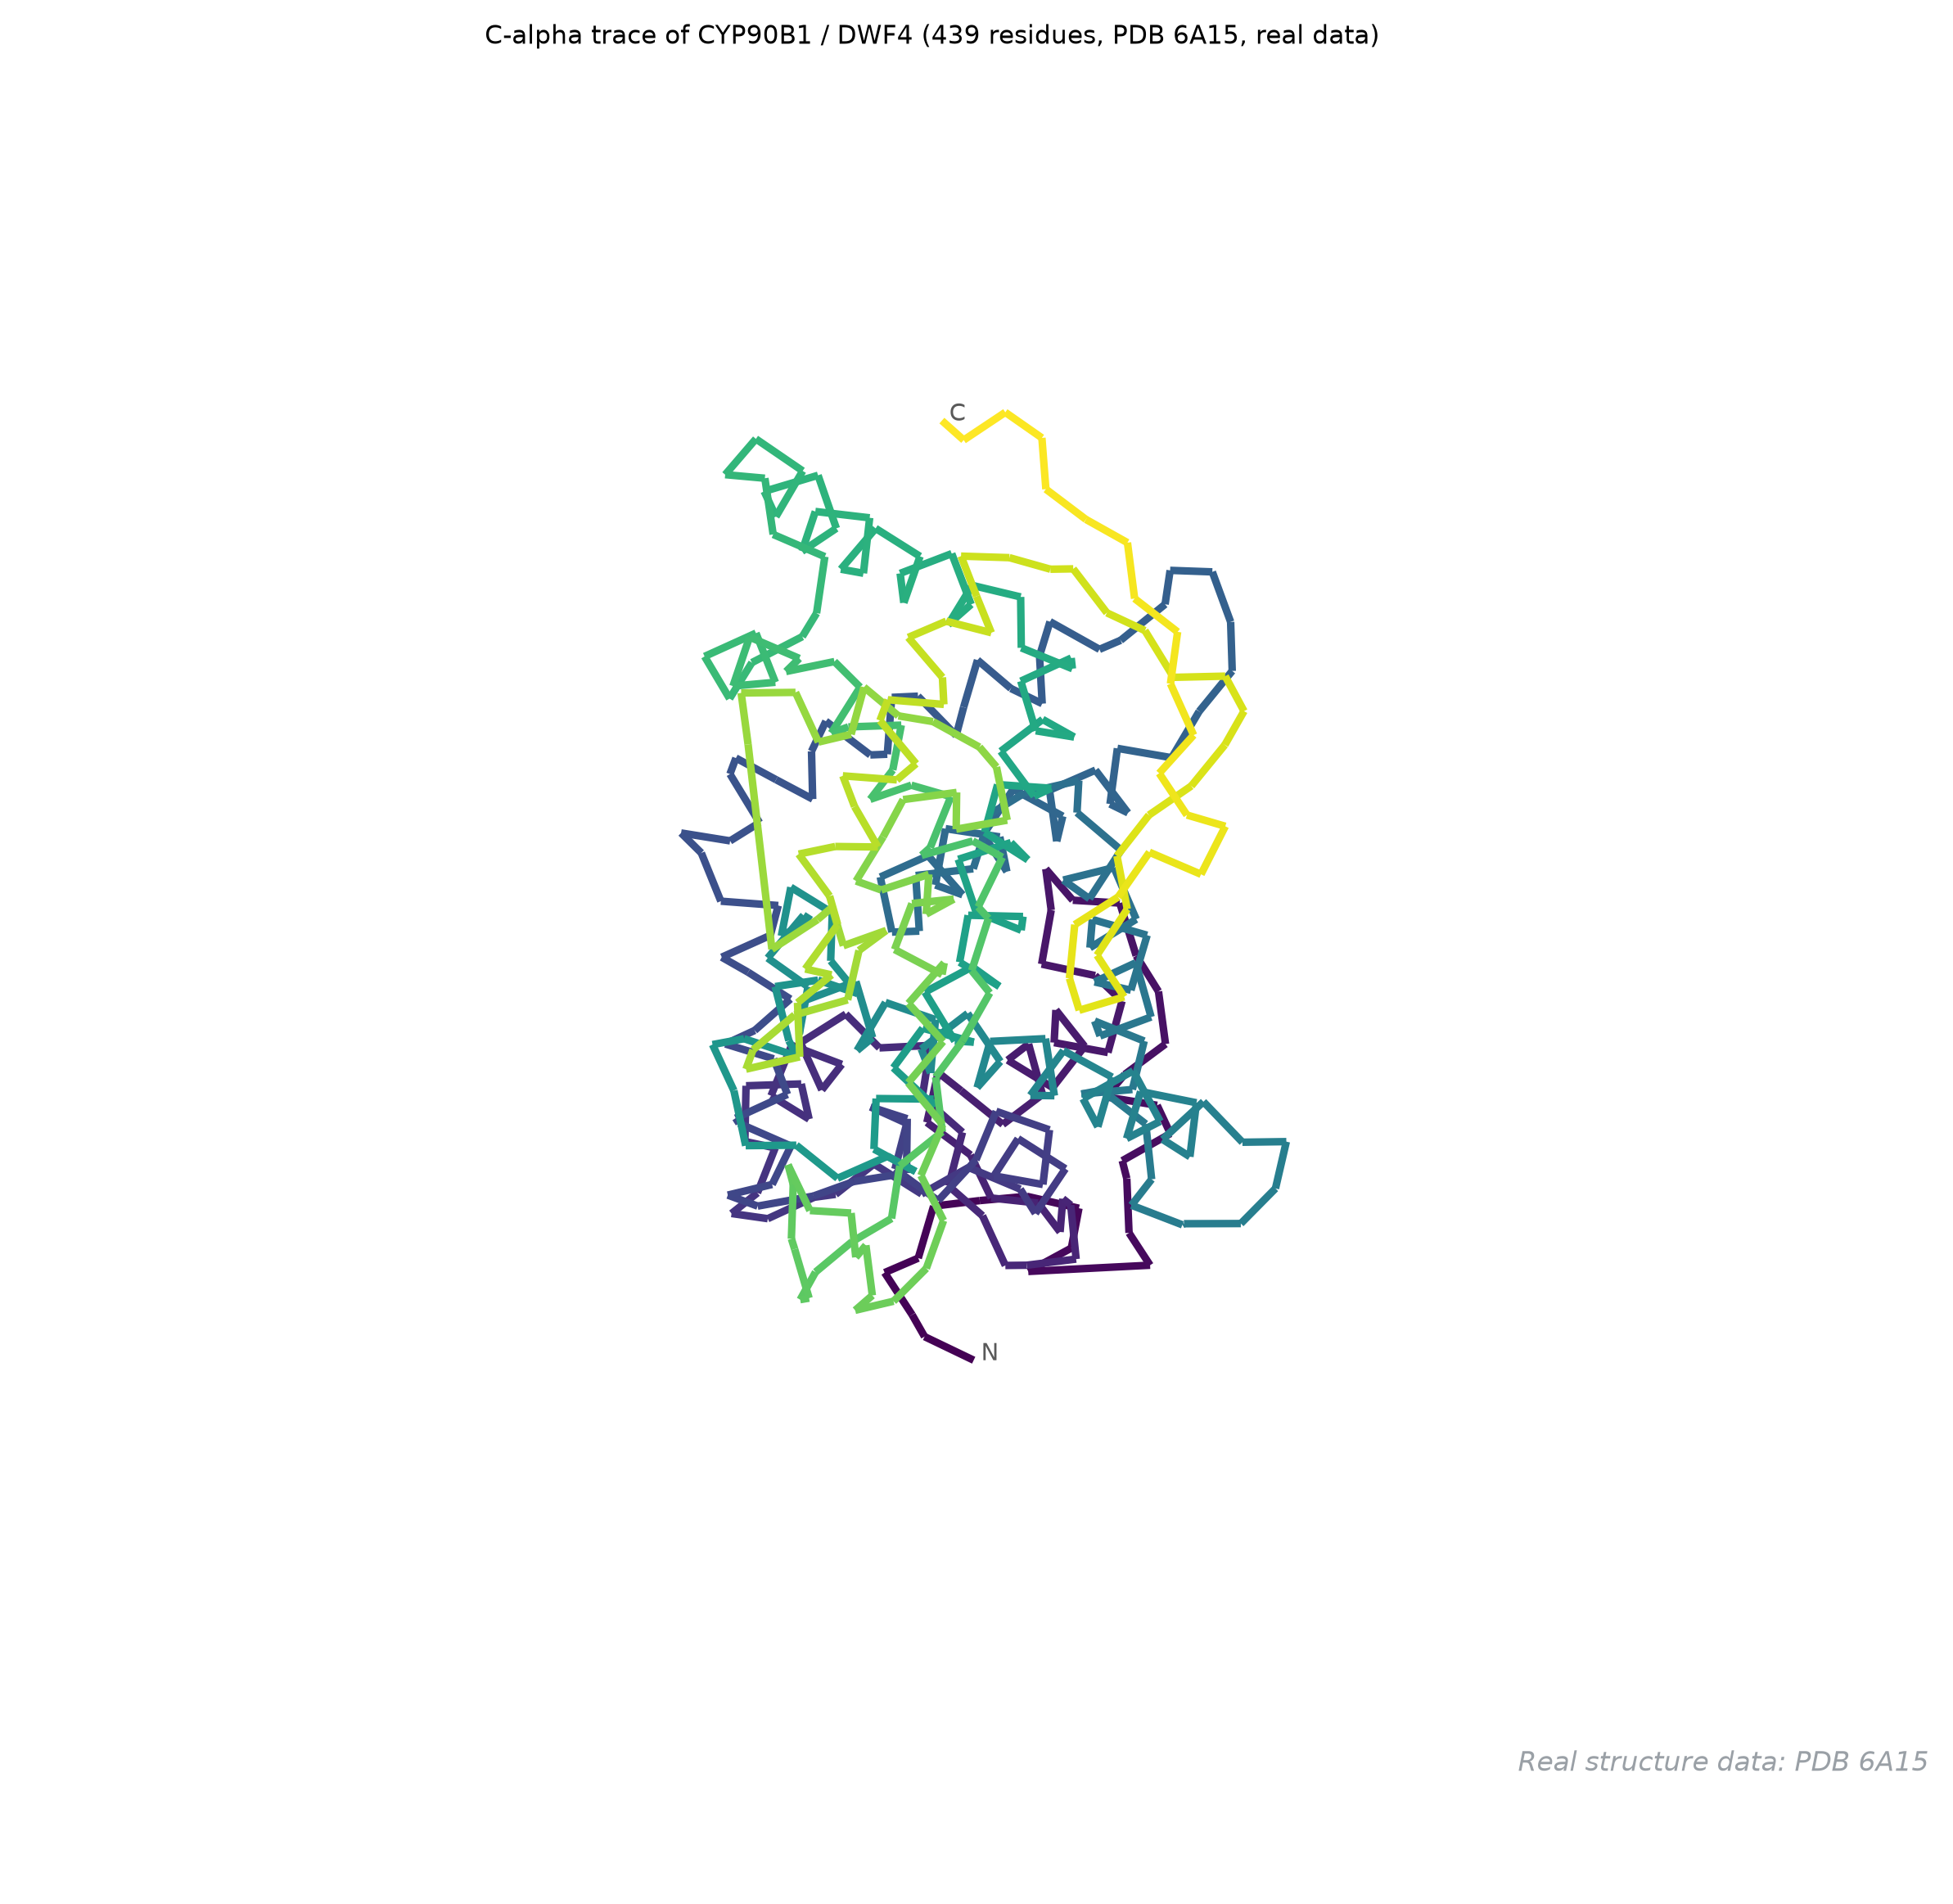
数据:真实 —— PDB 6A15 ↗(下载 PDB 文件 ↗ · 本站镜像),图右下水印「Real structure data: PDB 6A15」。
它回答什么问题:这个蛋白整体长什么样——是紧凑球状还是拖条长尾,N 端 C 端各在哪,折叠够不够”拧”。结构文章的第一张图和组会第一页常就是它。
怎么读:每个残基的 C-alpha 原子连成一条线,一个残基一个折点;颜色沿序列渐变(这里 viridis:深蓝=N 端,黄绿=C 端),所以颜色能告诉你”这条线从哪走到哪”。链 A 共 439 个解析残基(编号至 516,中间的柔性环在晶体里没有密度,这是正常现象),整体一个紧凑的 P450 折叠桶。
用什么画:PyMOL 的 show lines + spectrum;本文用 matplotlib 的 Line3DCollection 逐段上色,好处是跟其他图表同一套风格、直接进论文版式。
图注示例:
图 134 拟南芥 CYP90B1/DWF4 的 C-alpha 骨架迹线(真实数据,PDB 6A15 链 A,439 个解析残基,编号至 516)。颜色沿序列由 N 端(深蓝)渐变至 C 端(黄绿);N/C 标签为链两端。
展开查看:PDB 解析与绘图代码
真实结构图的”数据”就是 PDB 坐标文件本身,折叠块里给解析与渲染代码(下面 135-138、150 共用同一套解析函数,不再重复)。
绘图代码(Python,独立可运行;先下载 https://files.rcsb.org/download/6A15.pdb ↗ 存为 6a15.pdb)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d.art3d import Line3DCollection

def parse(path):  # PDB 定宽列解析:只取需要的字段
    atoms = []
    for ln in open(path, encoding="ascii", errors="ignore"):
        if ln[:6] in ("ATOM  ", "HETATM"):
            atoms.append(dict(het=ln[:6] == "HETATM",
                              name=ln[12:16].strip(), resn=ln[17:20].strip(),
                              chain=ln[21], resi=int(ln[22:26]),
                              xyz=(float(ln[30:38]), float(ln[38:46]),
                                   float(ln[46:54])),
                              elem=ln[76:78].strip() or ln[12:16].strip()[0]))
    return atoms

atoms = parse("6a15.pdb")
P = np.array([a["xyz"] for a in atoms
              if a["chain"] == "A" and not a["het"] and a["name"] == "CA"])
fig = plt.figure(figsize=(8.2, 6.6))
ax = fig.add_subplot(projection="3d")
ax.view_init(elev=12, azim=-70)
ax.set_axis_off()
ax.set_box_aspect((1, 1, 1))
pts = np.concatenate([P[:-1, None, :], P[1:, None, :]], axis=1)
cmap = matplotlib.colormaps["viridis"]
ax.add_collection3d(Line3DCollection(
    pts, colors=[cmap(i / (len(P) - 2)) for i in range(len(P) - 1)],
    linewidths=2.2))
ax.text(*P[0], " N", color="0.35", fontsize=9)
ax.text(*P[-1], " C", color="0.35", fontsize=9)
m, M = P.min(0), P.max(0)
ctr, span = (m + M) / 2, (M - m).max() / 2 * 1.05
ax.set_xlim(ctr[0] - span, ctr[0] + span)
ax.set_ylim(ctr[1] - span, ctr[1] + span)
ax.set_zlim(ctr[2] - span, ctr[2] + span)
ax.set_title("C-alpha trace of CYP90B1 (%d residues, PDB 6A15, real data)"
             % len(P))
fig.savefig("134-ca-trace.png", dpi=200, bbox_inches="tight")2.2 全原子线框图(135)#
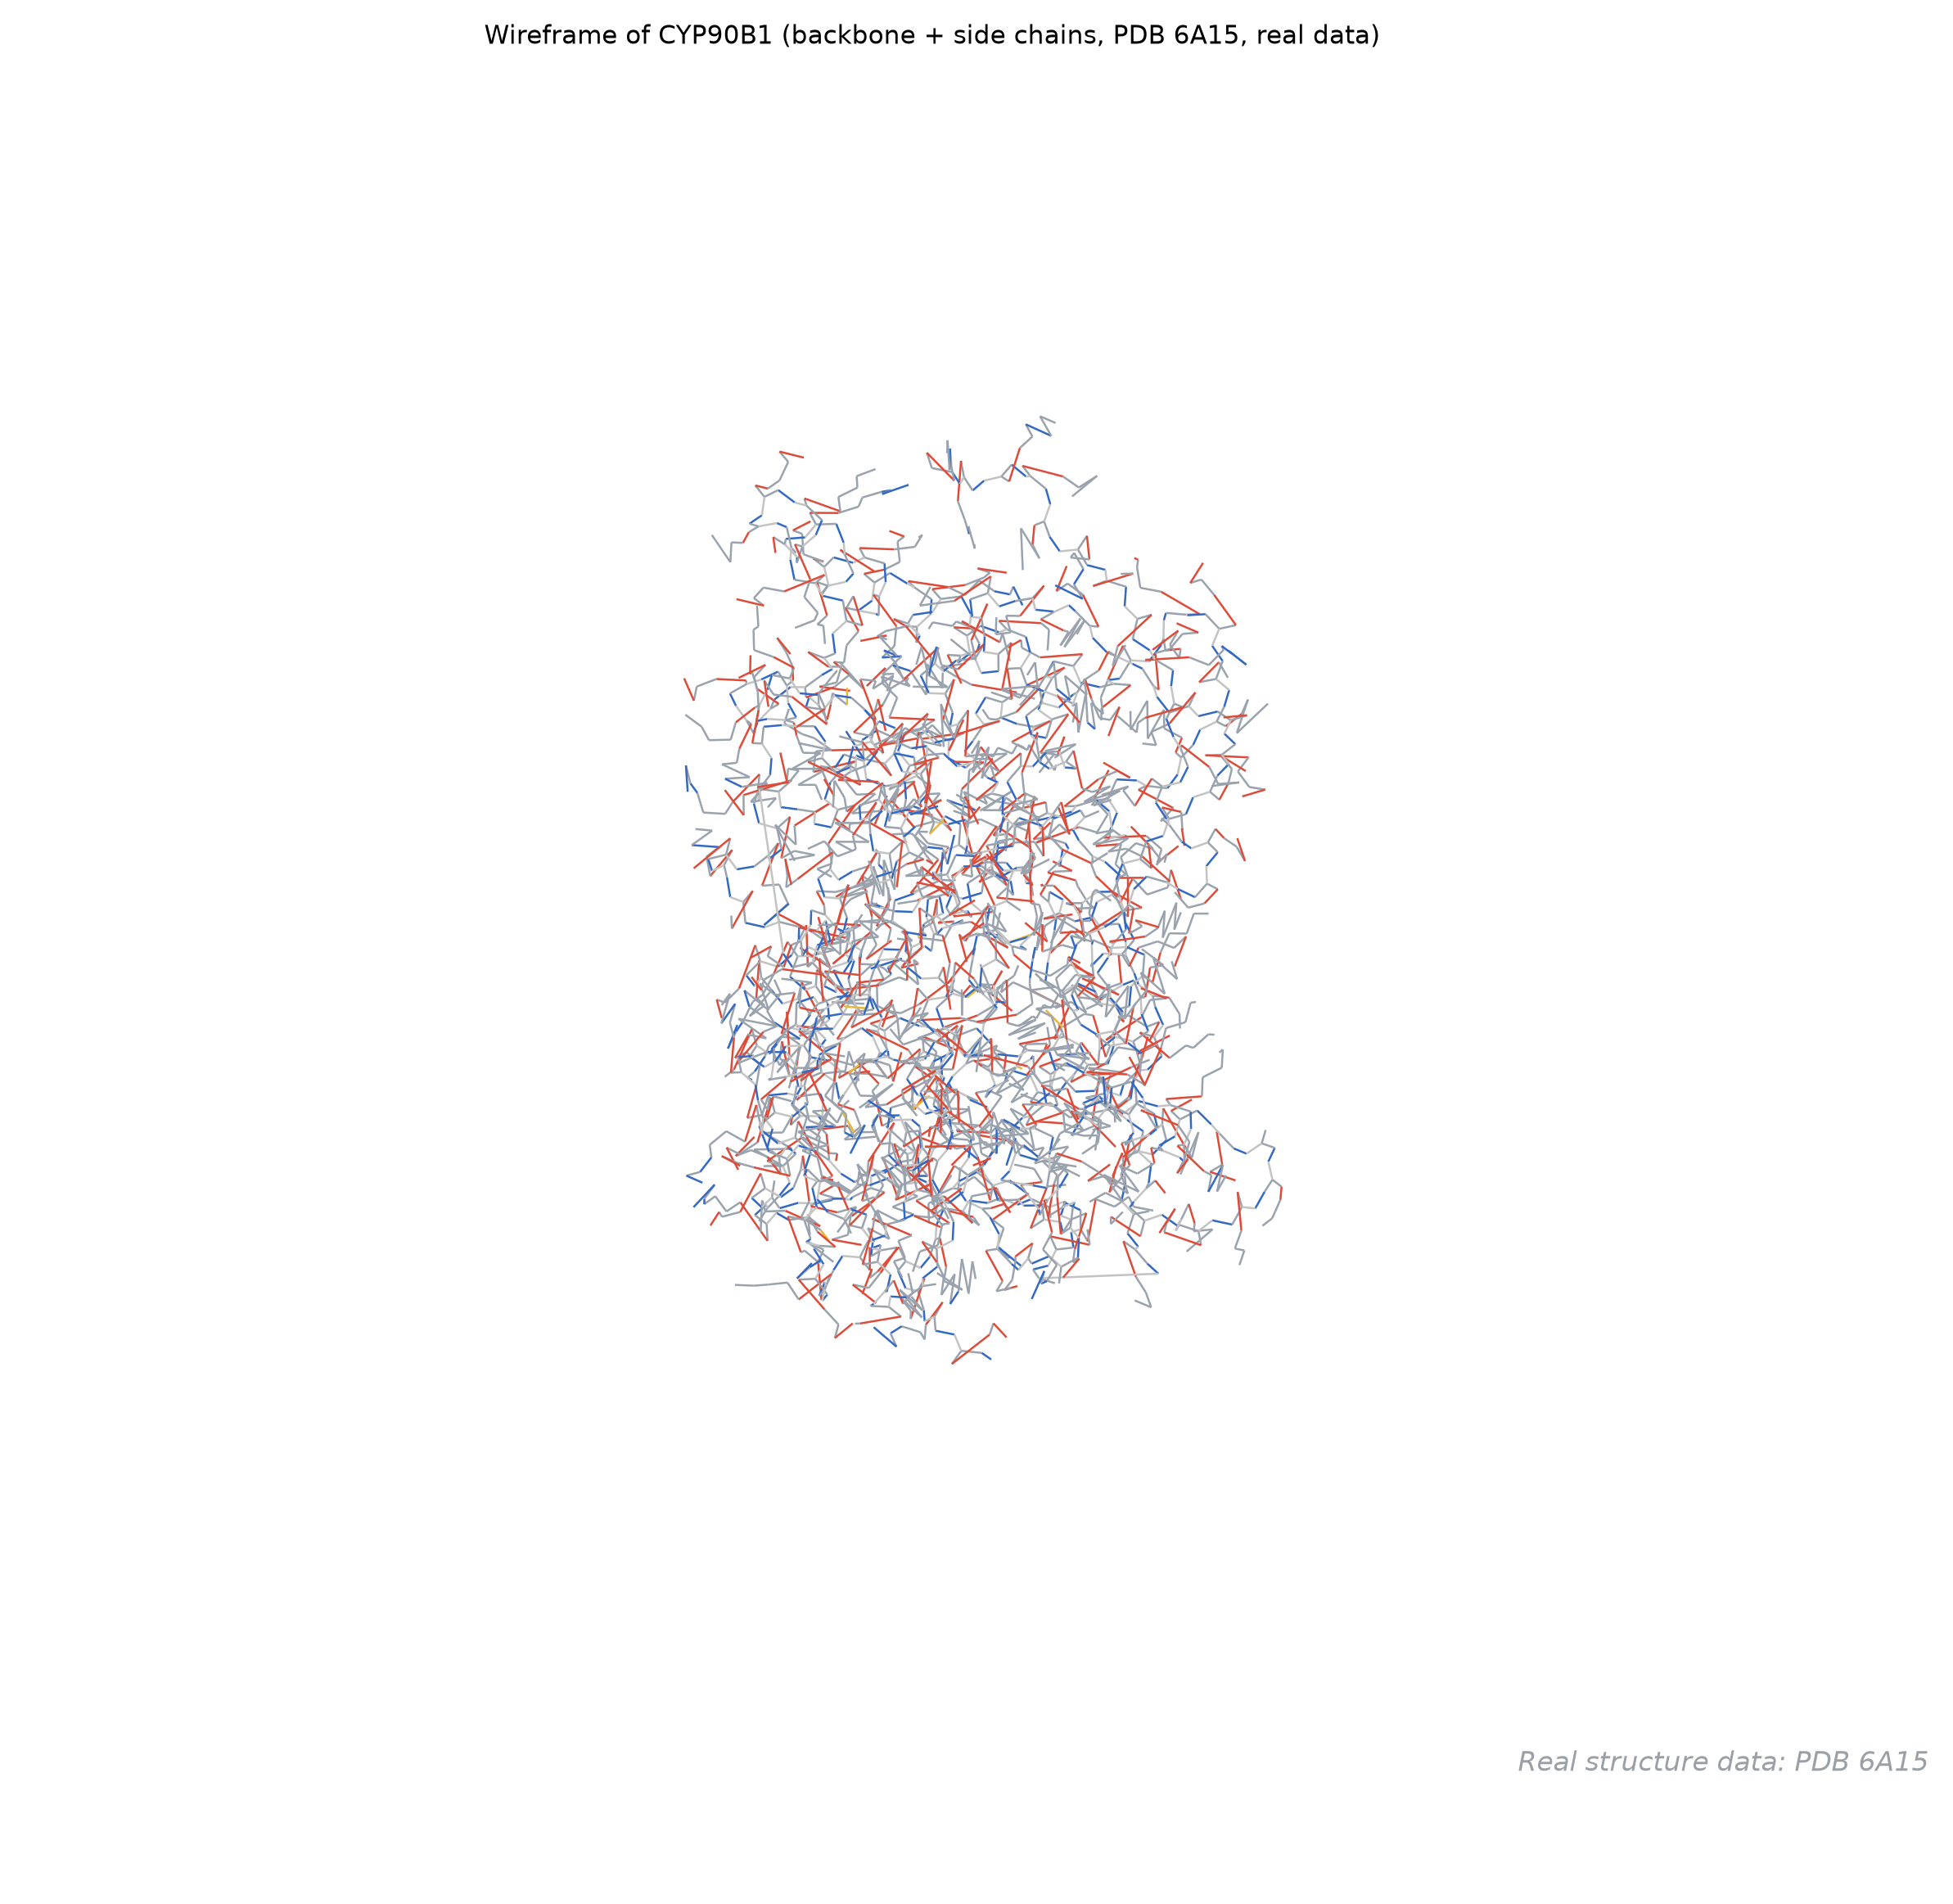
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),水印「Real structure data: PDB 6A15」。
它回答什么问题:蛋白的化学细节长什么样——侧链朝哪、二硫键/配位键在哪、原子密度多大。当你要讨论”某个侧链够不够得着配体”时,先看线框。
怎么读:每条键一条线,按元素着色(CPK 惯例:碳灰、氮蓝、氧红、硫黄、铁橙)。信息量最大的表示法,也最密——印刷图里通常只对局部口袋使用,全蛋白线框是”看清底牌”用的。本图画的是链 A 全部聚合物原子(血红素与胆固醇配体未画入,留给 136)。
用什么画:PyMOL show lines;本文 matplotlib 把每个残基内部按键连成短线、肽键 C→N 用灰线连,全部走 Line3DCollection。
图注示例:
图 135 CYP90B1 全原子线框图(真实数据,PDB 6A15 链 A 聚合物原子)。键按元素着色:碳灰、氮蓝、氧红、硫黄;血红素与胆固醇配体未画出(见图 136)。
展开查看:线段集合绘图代码
绘图代码(接图 134 的 parse(),独立运行需先粘贴该函数)
ELEMCOL = {"C": "#9aa3ad", "N": "#3369c3", "O": "#dd4b39",
           "S": "#e8b636", "FE": "#e07b39"}

def segs_by_res(atoms, lw=0.6):
    """残基内按键序连线 + 肽键 C->N,返回 Line3DCollection。"""
    from mpl_toolkits.mplot3d.art3d import Line3DCollection
    segs, cols, byres, prev_c = [], [], {}, None
    for a in atoms:
        byres.setdefault((a["chain"], a["resi"]), []).append(a)
    for key in sorted(byres):
        lst = byres[key]
        for i in range(len(lst) - 1):
            segs.append([lst[i]["xyz"], lst[i + 1]["xyz"]])
            cols.append(ELEMCOL.get(lst[i]["elem"], "#9aa3ad"))
        if prev_c is not None and lst[0]["name"] == "N":
            segs.append([prev_c, lst[0]["xyz"]])
            cols.append("#c3c3c3")
        for a in lst:
            if a["name"] == "C":
                prev_c = a["xyz"]
    return Line3DCollection(segs, colors=cols, linewidths=lw)

pa = [a for a in parse("6a15.pdb") if a["chain"] == "A" and not a["het"]]
fig = plt.figure(figsize=(8.2, 6.6))
ax = fig.add_subplot(projection="3d")
ax.view_init(elev=12, azim=-70)
ax.set_axis_off()
ax.set_box_aspect((1, 1, 1))
ax.add_collection3d(segs_by_res(pa, 0.6))
P = np.array([a["xyz"] for a in pa])
m, M = P.min(0), P.max(0)
ctr, span = (m + M) / 2, (M - m).max() / 2 * 1.05
ax.set_xlim(ctr[0] - span, ctr[0] + span)
ax.set_ylim(ctr[1] - span, ctr[1] + span)
ax.set_zlim(ctr[2] - span, ctr[2] + span)
ax.set_title("Wireframe of CYP90B1 (PDB 6A15, real data)")
fig.savefig("135-wireframe.png", dpi=200, bbox_inches="tight")2.3 口袋残基棍棒图(136)#
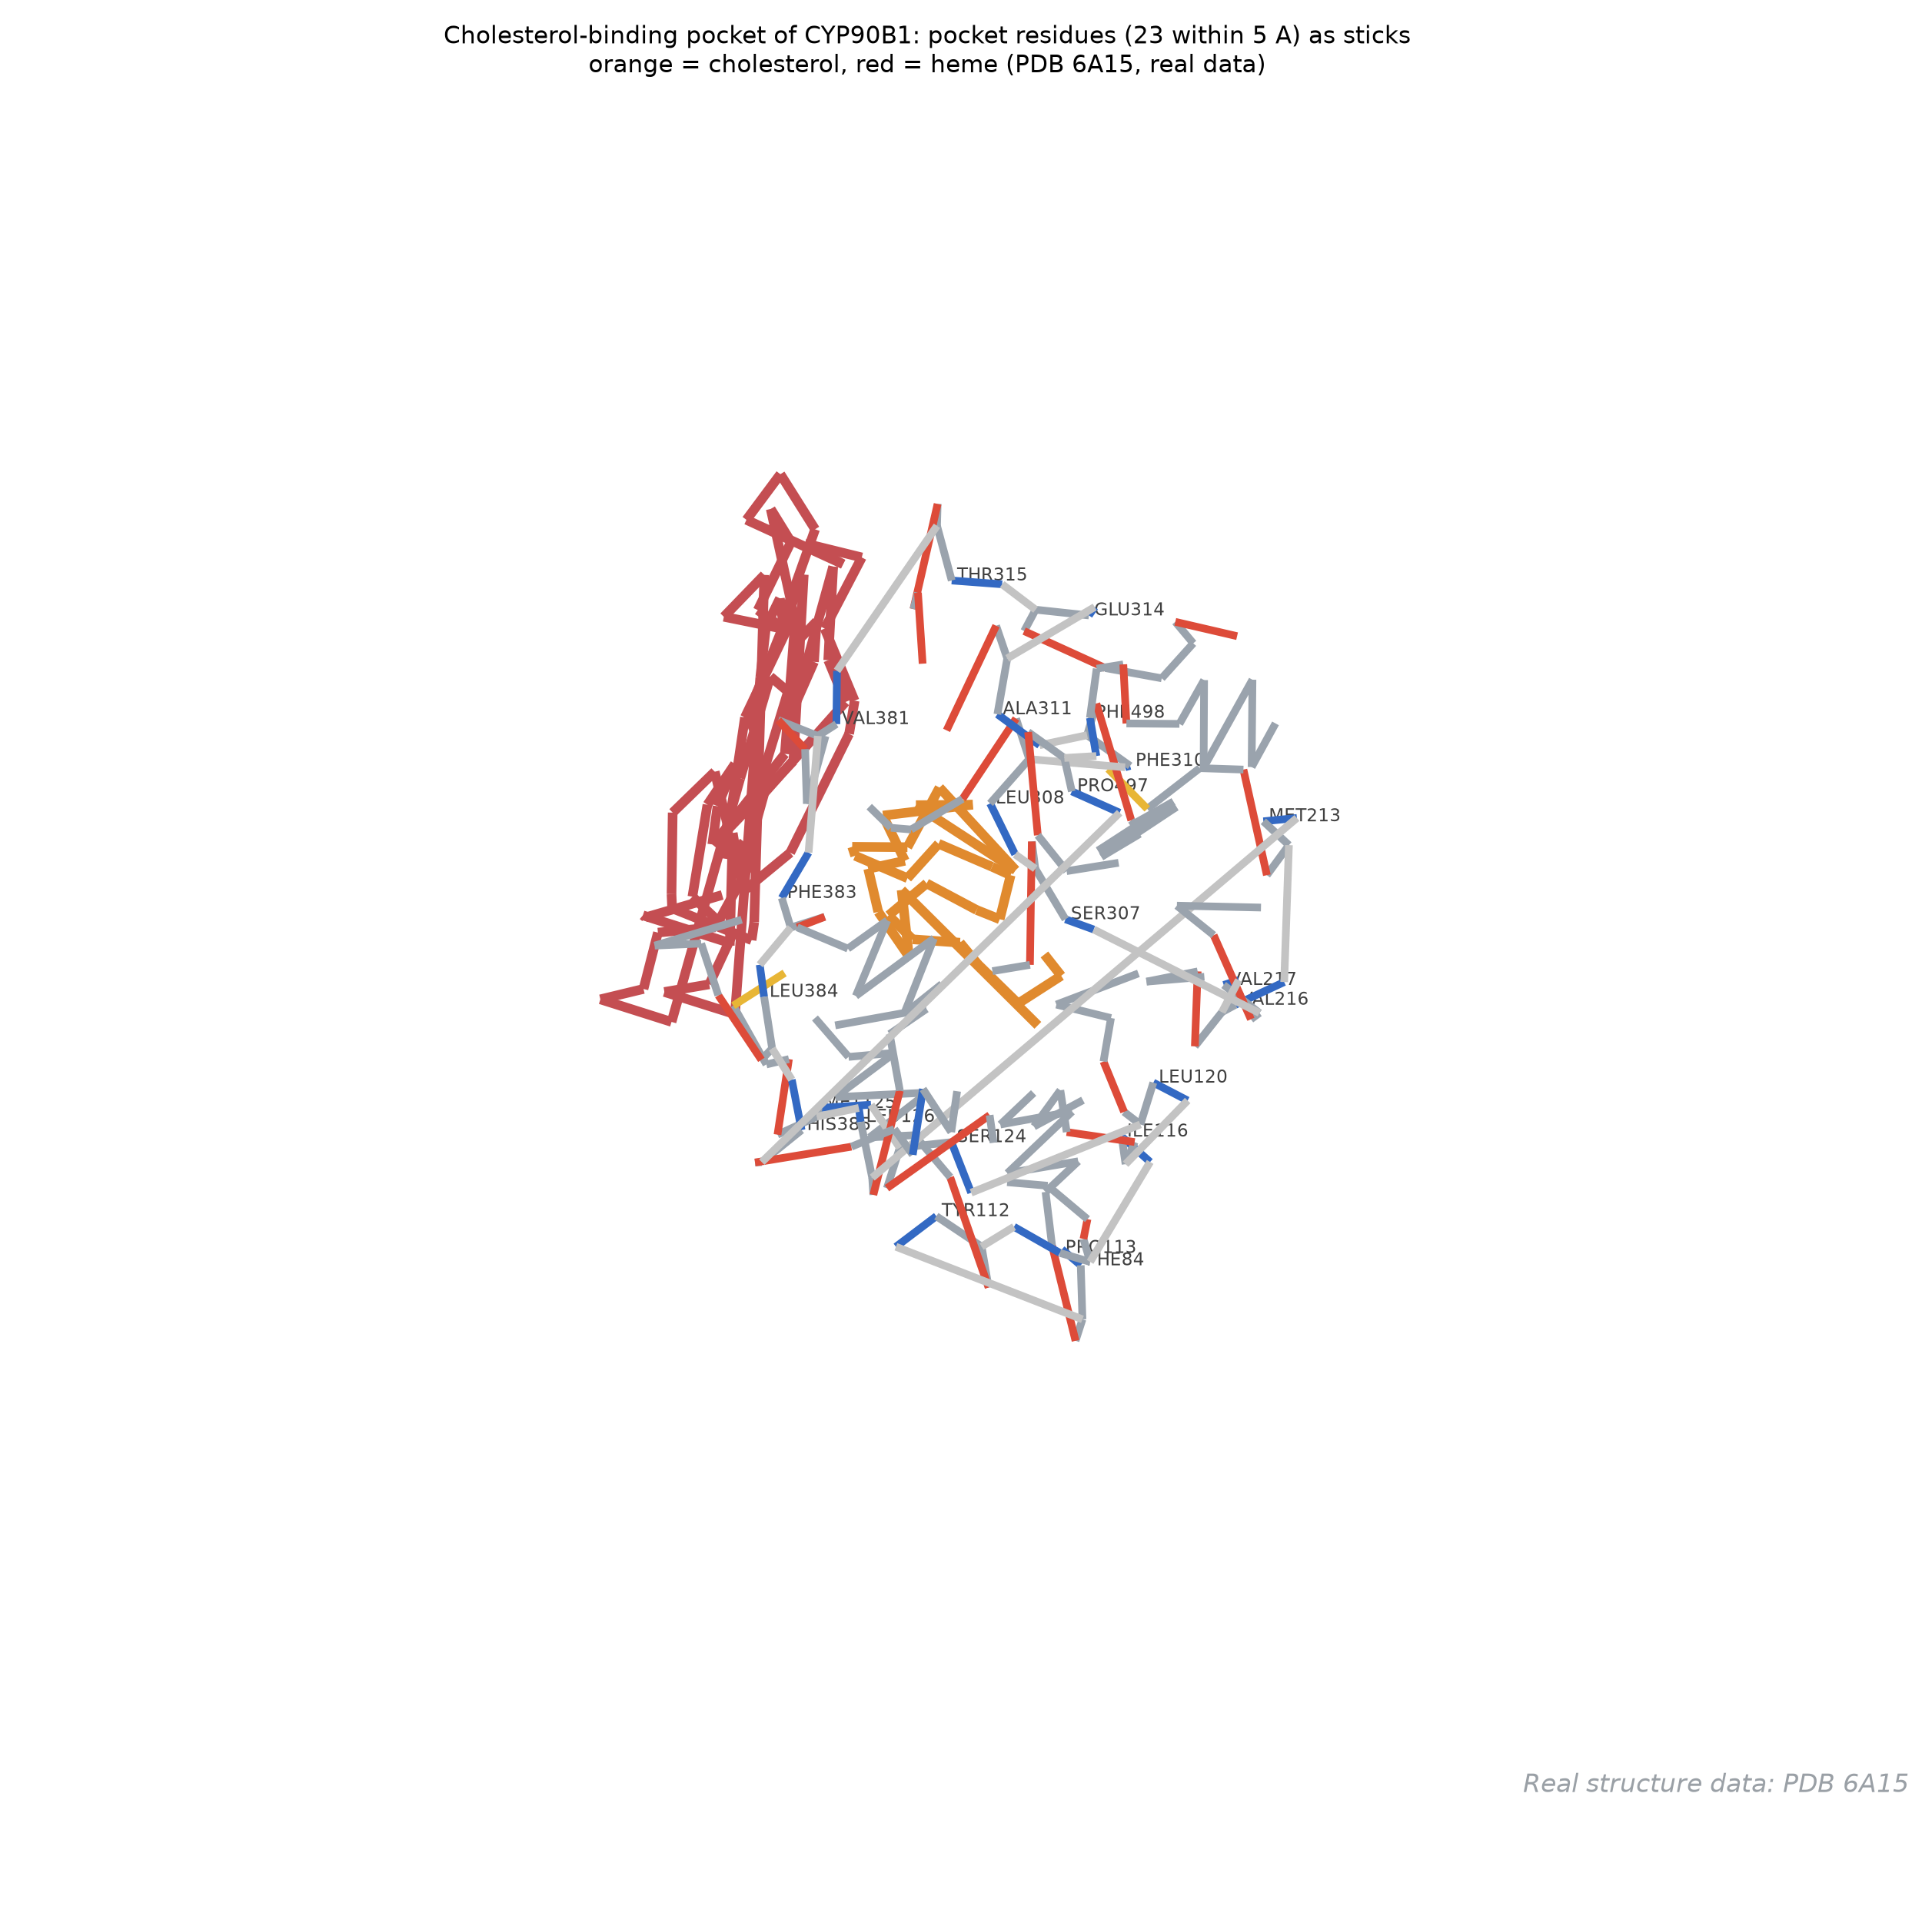
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),水印「Real structure data: PDB 6A15」。
它回答什么问题:配体周围到底是谁在搭口袋——距离口袋几埃、什么化学性质、哪个残基贴得最近。“底物通道由芳香/疏水残基构成”这类结论句,必须靠这张图支撑。
怎么读:判定标准通常取配体任一原子 5 Å 以内的残基为口袋残基(棍棒加粗显示),配体本体(橙色=胆固醇 CLR,红色=血红素 HEM)画成粗线。本图算出 23 个口袋残基,最近的三个是 HIS385(2.88 Å)、PHE383(3.17 Å)、VAL216(3.55 Å);23 个里 17 个是疏水残基(PHE/LEU/VAL/ILE/MET/ALA/PRO),口袋整体是疏水芳香环境——这正是甾醇底物结合舱的标配。
用什么画:PyMOL select pocket, resn CLR within 5 of resn CLR; show sticks;本文 python 逐残基算最小距离后筛选渲染。
图注示例:
图 136 CYP90B1 胆固醇结合口袋(真实数据,PDB 6A15)。棍棒为距胆固醇任一原子 5 Å 以内的 23 个口袋残基(最近的 HIS385 为 2.88 Å),17 个为疏水残基;橙色线为胆固醇(CLR 602),红色线为血红素(HEM 601)。
展开查看:口袋残基距离表与绘图代码
residue,dist_to_ligand_A
PHE84,3.85
TYR112,3.60
PRO113,4.54
ILE116,4.37
LEU120,4.57
SER124,4.96
MET125,4.39
LEU126,3.91
MET213,3.93
VAL216,3.55
VAL217,3.74
SER307,3.64
LEU308,3.91
PHE310,3.70
ALA311,4.14
GLU314,4.92
THR315,3.79
VAL381,3.87
PHE383,3.17
LEU384,4.03
HIS385,2.88
PRO497,4.30
PHE498,4.71绘图代码(接图 134 的 parse() 与图 135 的 segs_by_res())
import numpy as np

atoms = parse("6a15.pdb")
lig = [a for a in atoms if a["het"] and a["resn"] == "CLR"]
heme = [a for a in atoms if a["het"] and a["resn"] == "HEM"]
L = np.array([a["xyz"] for a in lig])
byres = {}
for a in atoms:
    if a["chain"] == "A" and not a["het"]:
        byres.setdefault(a["resi"], []).append(a)
pocket = []
for ri, lst in byres.items():
    X = np.array([a["xyz"] for a in lst])
    d = np.linalg.norm(X[:, None, :] - L[None, :, :], axis=-1).min()
    if d <= 5.0:
        pocket.append((ri, lst[0]["resn"], d))
# 渲染:pocket 残基棍棒 lw=2.4、CLR 橙 lw=3、HEM 红 lw=3,
# 每个 CA 打一个 "RES123" 标签;视角 azim=-96 elev=16。
# 完整渲染代码见仓库 tools/bio-plots/ch11a_struct.py 的 pocket_stick()。
print("pocket residues:", len(pocket))
print("nearest:", sorted(pocket, key=lambda t: t[2])[:3])2.4 空间填充球状模型(137)#
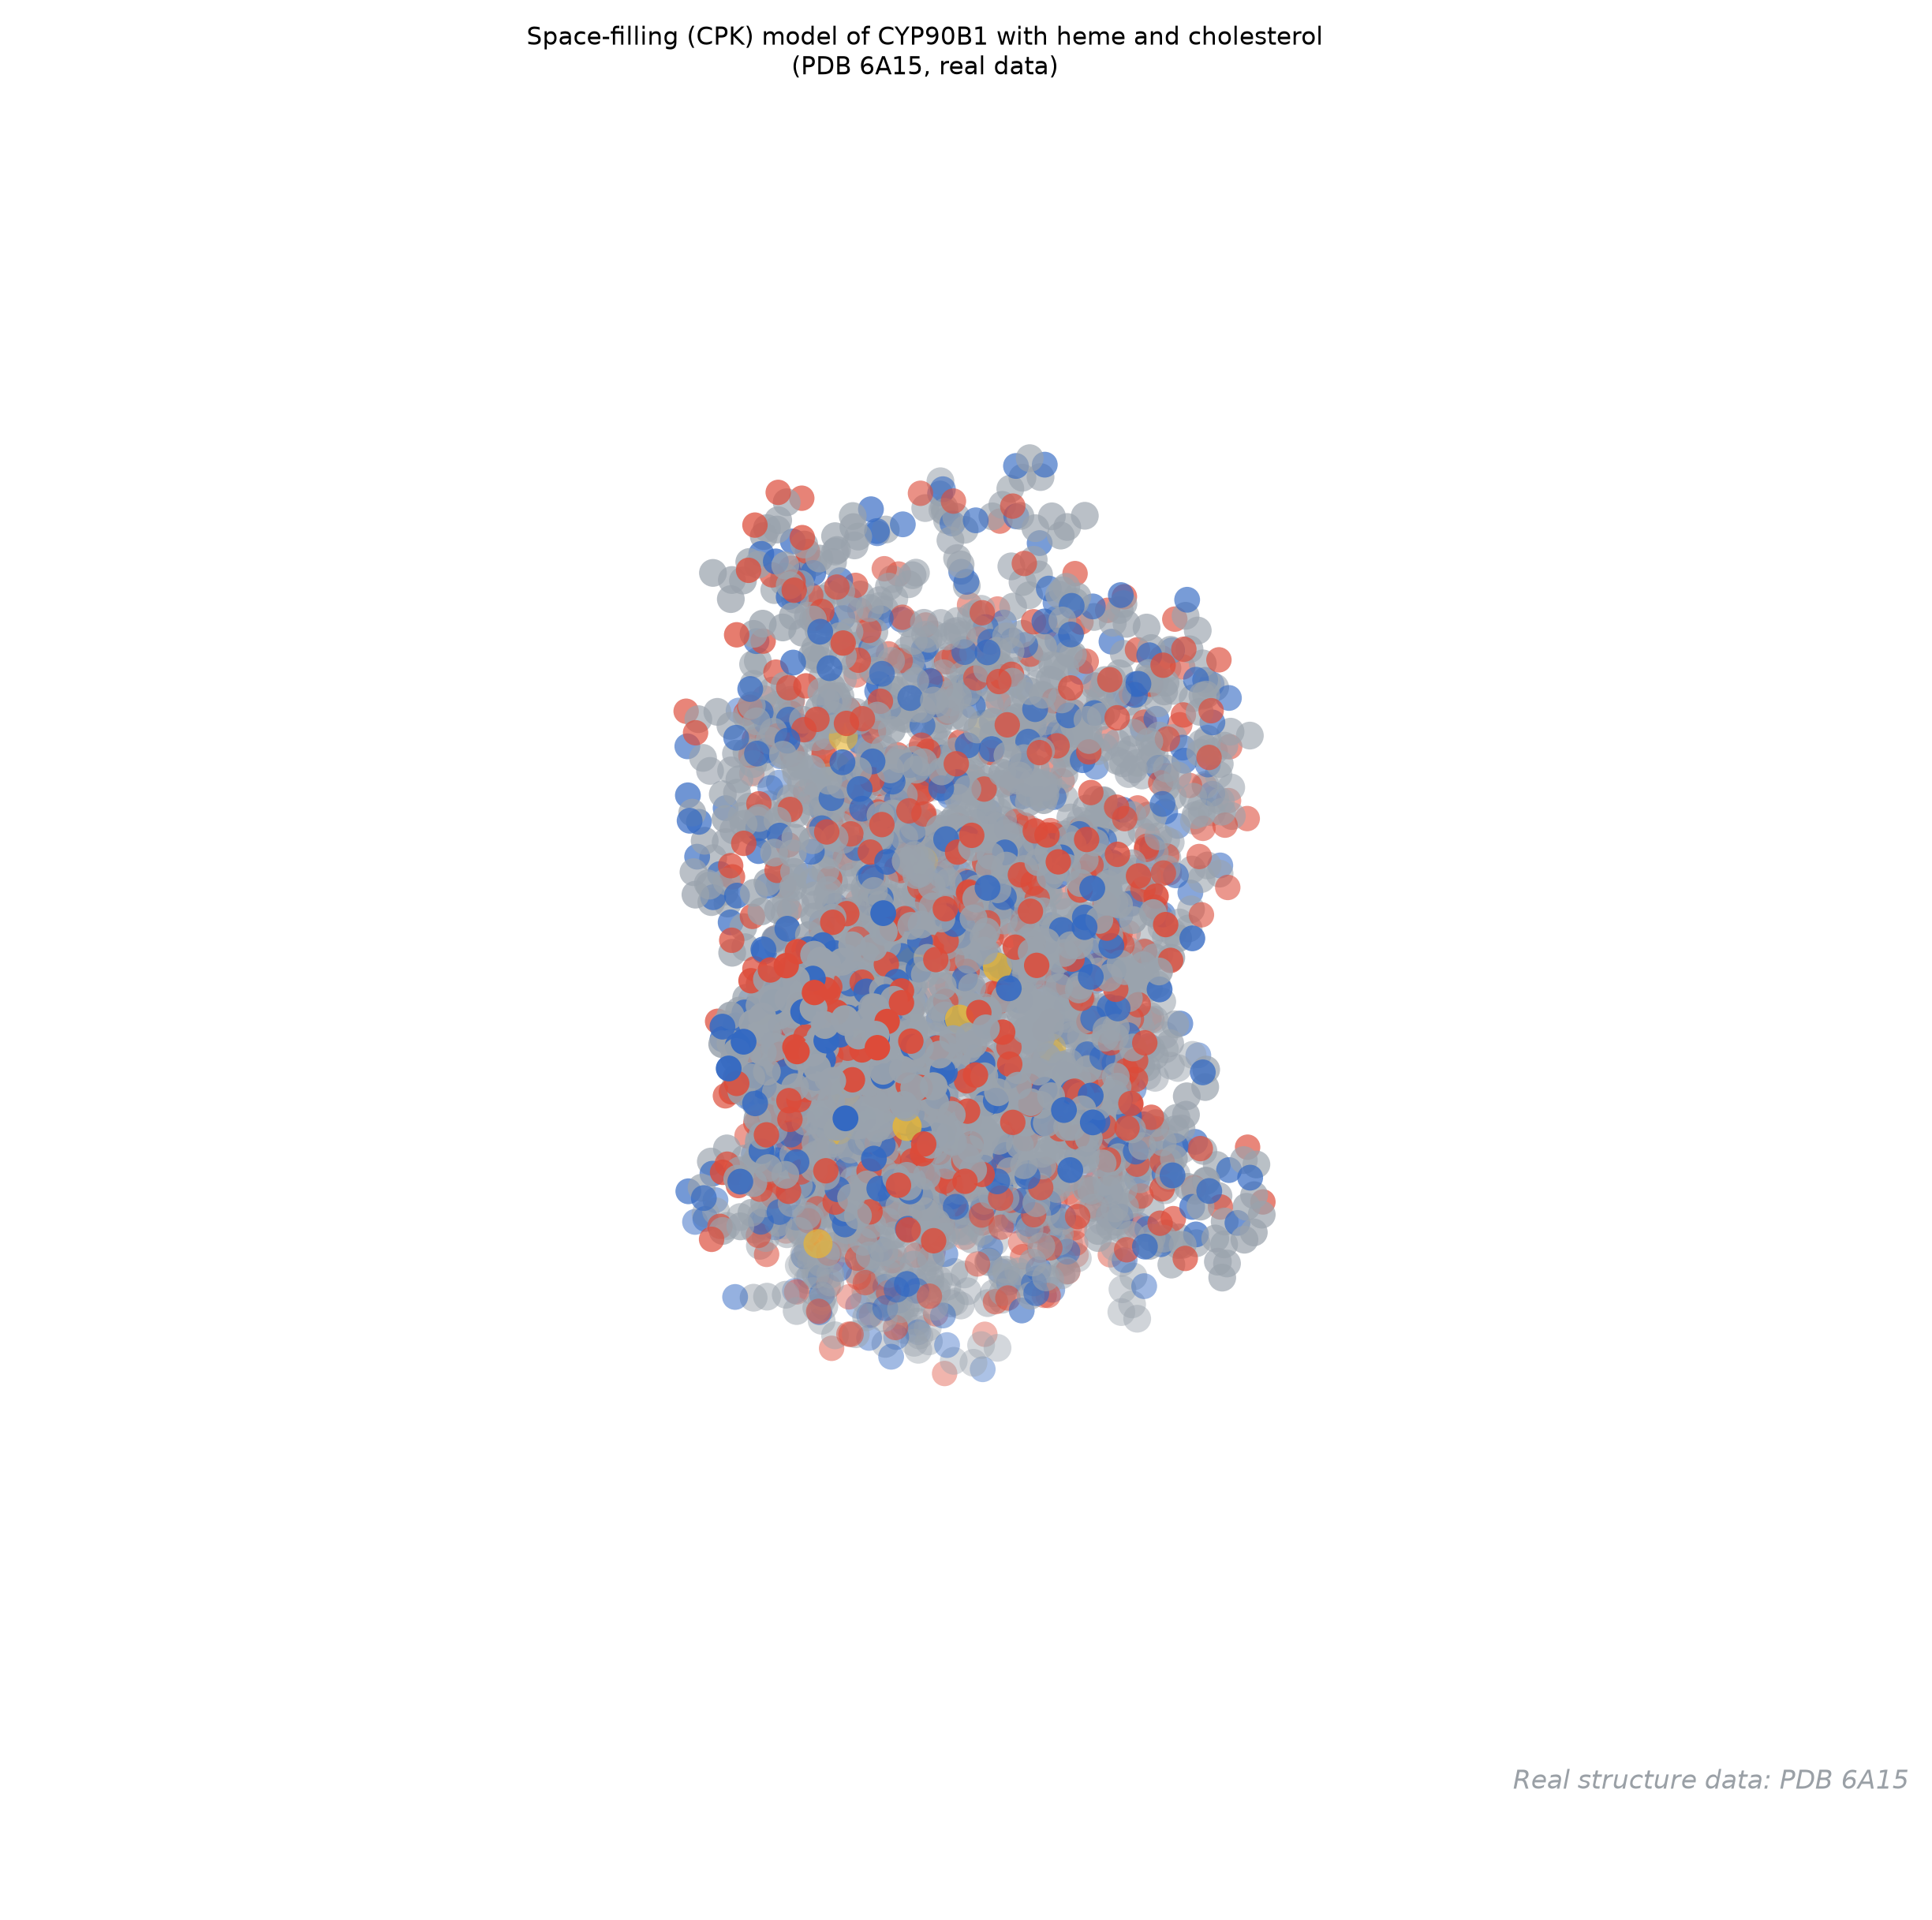
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),水印「Real structure data: PDB 6A15」。
它回答什么问题:蛋白表面长什么样、配体从外面还看得见吗——空间填充(CPK 球)模型回答”埋没程度”。做分子对接、讨论底物进入通道时,这是最直观的一张。
怎么读:每个原子一个球,半径按范德华半径,颜色按元素。本图把血红素与胆固醇一起画入:从表面几乎看不到橙色胆固醇——它整体埋在蛋白内部(定量证据见 155:胆固醇的溶剂可及面积只有 10.1 Ų,完全暴露的残基可达 100-200 Ų)。底部还能看到血红素铁的橙色小点,那是催化位点朝溶剂开的一扇小窗。
用什么画:PyMOL show spheres;本文 matplotlib 散点半径按 vdW*26 缩放近似。
图注示例:
图 137 CYP90B1 空间填充模型(真实数据,PDB 6A15,含血红素与胆固醇)。原子半径按范德华半径、颜色按元素;胆固醇(橙)几乎完全埋入蛋白内部,仅血红素铁附近露出少量表面。
展开查看:球体缩放绘图代码
绘图代码(接图 134 的 parse())
import numpy as np

RAD = {"C": 1.70, "N": 1.55, "O": 1.52, "S": 1.80, "FE": 1.45, "P": 1.80}
atoms = [a for a in parse("6a15.pdb")
         if not a["het"] or a["resn"] in ("HEM", "CLR")]
P = np.array([a["xyz"] for a in atoms])
r = np.array([RAD.get(a["elem"], 1.7) for a in atoms])
c = [ELEMCOL.get(a["elem"], "#9aa3ad") for a in atoms]
fig = plt.figure(figsize=(8.4, 6.8))
ax = fig.add_subplot(projection="3d")
ax.view_init(elev=12, azim=-70)
ax.set_axis_off()
ax.set_box_aspect((1, 1, 1))
ax.scatter(P[:, 0], P[:, 1], P[:, 2], s=(r * 26) ** 1.6 / 6, c=c,
           linewidths=0)
m, M = P.min(0), P.max(0)
ctr, span = (m + M) / 2, (M - m).max() / 2 * 1.08
ax.set_xlim(ctr[0] - span, ctr[0] + span)
ax.set_ylim(ctr[1] - span, ctr[1] + span)
ax.set_zlim(ctr[2] - span, ctr[2] + span)
ax.set_title("Space-filling model of CYP90B1 (PDB 6A15, real data)")
fig.savefig("137-spacefill.png", dpi=200, bbox_inches="tight")2.5 缎带示意图(138)#
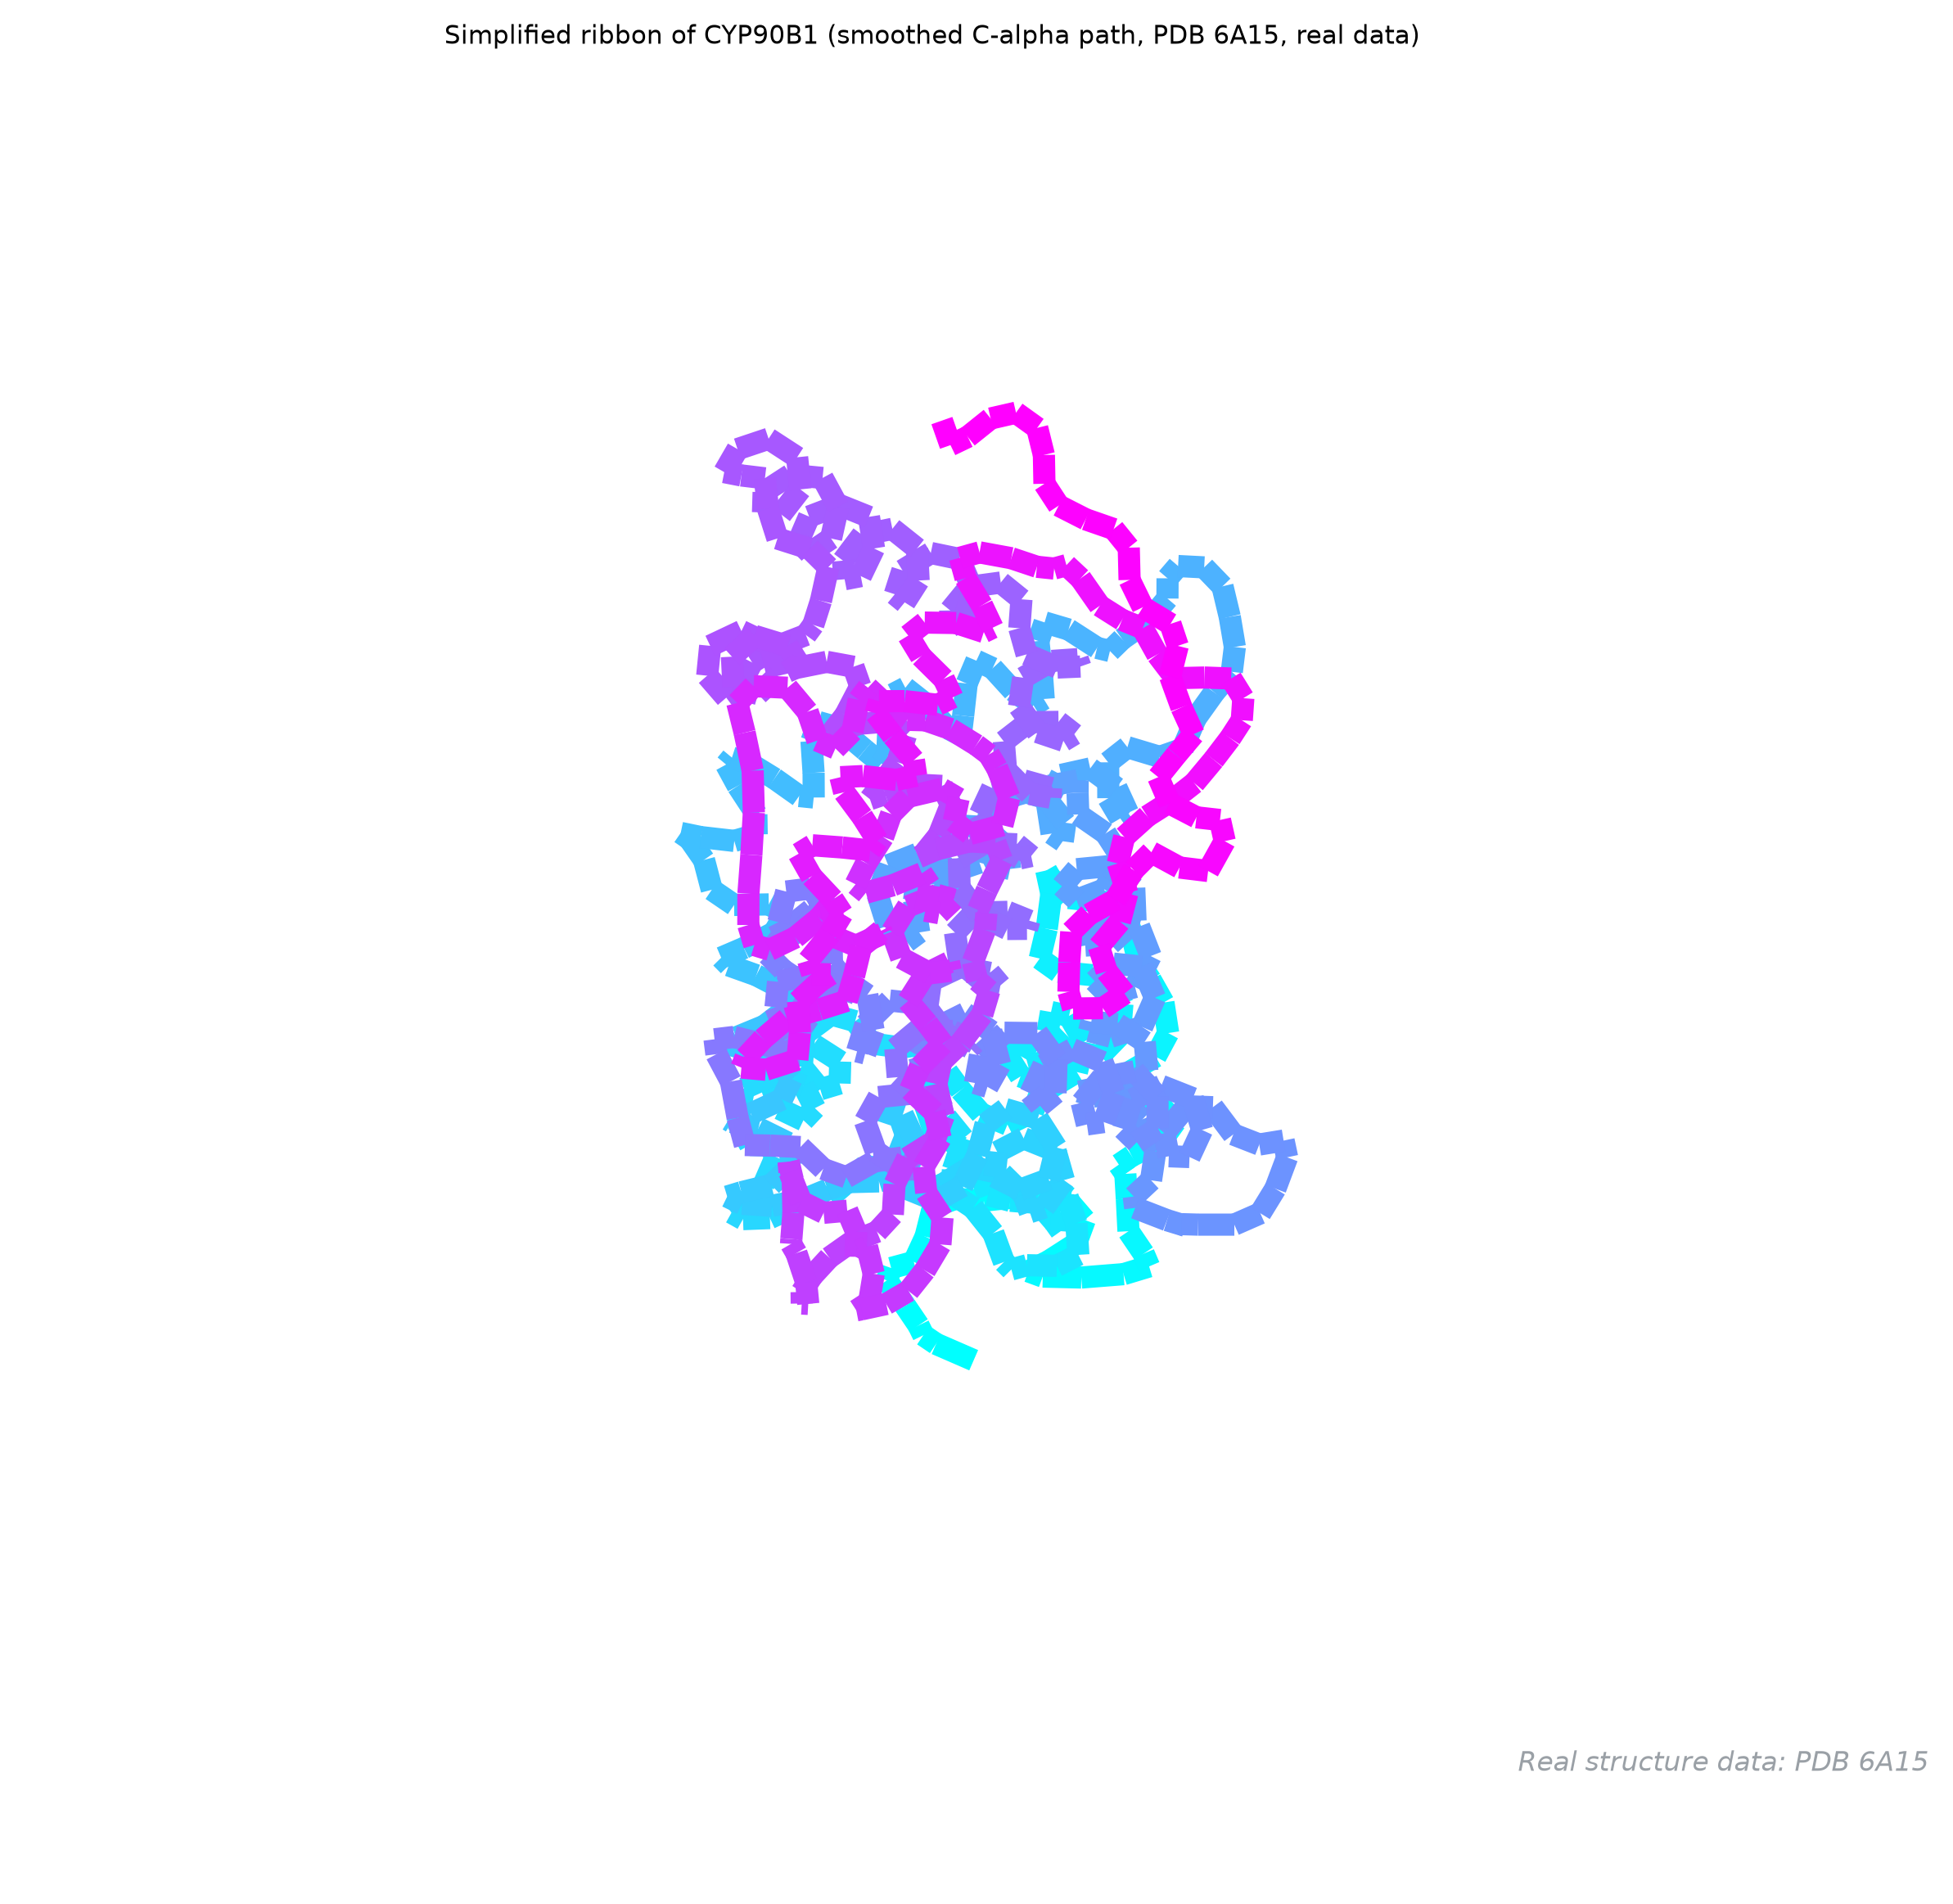
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),水印「Real structure data: PDB 6A15」。
它回答什么问题:出版物的”定妆照”——缎带图是综述、教材、封面里出现频率最高的蛋白表示法,一眼看出螺旋束、片层堆叠和整体拓扑。
怎么读:本图是 C-alpha 路径的平滑样条加粗(教学简化版):圆柱=α 螺旋、箭头=β 折叠的真缎带要靠二级结构指派(DSSP)后再画,3Dmol/PyMOL 的 cartoon 都是这么做的;但”平滑路径缎带”已经能读出 P450 标志性的螺旋篮子。颜色沿序列(青→品红),与 134 呼应。
用什么画:PyMOL/ChimeraX cartoon automatic;本文 matplotlib 对弧长参数做三次样条插值后加粗到 lw≈6.5。
图注示例:
图 138 CYP90B1 缎带示意(真实数据,PDB 6A15,C-alpha 平滑样条)。颜色沿序列渐变;P450 折叠以 α 螺旋为主(可见螺旋篮包围血红素),为简化示意,未做二级结构指派。
展开查看:样条缎带绘图代码
绘图代码(接图 134 的 parse())
from scipy.interpolate import make_interp_spline
from mpl_toolkits.mplot3d.art3d import Line3DCollection

ca = [a for a in parse("6a15.pdb")
      if a["chain"] == "A" and not a["het"] and a["name"] == "CA"]
P = np.array([a["xyz"] for a in ca])
t = np.zeros(len(P))
t[1:] = np.cumsum(np.linalg.norm(np.diff(P, axis=0), axis=1))
S = make_interp_spline(t, P, k=3)(np.linspace(t[0], t[-1], 800))
fig = plt.figure(figsize=(8.2, 6.6))
ax = fig.add_subplot(projection="3d")
ax.view_init(elev=12, azim=-70)
ax.set_axis_off()
ax.set_box_aspect((1, 1, 1))
pts = np.concatenate([S[:-1, None, :], S[1:, None, :]], axis=1)
cmap = matplotlib.colormaps["cool"]
ax.add_collection3d(Line3DCollection(
    pts, colors=[cmap(i / (len(S) - 2)) for i in range(len(S) - 1)],
    linewidths=6.5))
m, M = P.min(0), P.max(0)
ctr, span = (m + M) / 2, (M - m).max() / 2 * 1.05
ax.set_xlim(ctr[0] - span, ctr[0] + span)
ax.set_ylim(ctr[1] - span, ctr[1] + span)
ax.set_zlim(ctr[2] - span, ctr[2] + span)
ax.set_title("Simplified ribbon of CYP90B1 (PDB 6A15, real data)")
fig.savefig("138-ribbon.png", dpi=200, bbox_inches="tight")三、浏览器里拖得动的 3D:3Dmol.js(139-142)#
静态截图看单帧,交互 3D 看关系。本站把 3Dmol.js ↗(BSD 协议的 WebGL 分子查看器)与四套 PDB 坐标全部自托管在仓库里(/js/ 与 /lib/pdb/),渲染不发任何第三方请求。为了不让一页背着 5 个 WebGL 上下文,每个视图都是先点「▶ 点击加载 3D 视图」按钮才真正渲染,且同一时间全页只保留一个:打开新的会自动关闭上一个(旧视图的 WebGL 上下文被释放、容器恢复成按钮,随时可以再点开)。加载后左键拖动旋转、滚轮缩放、右键平移(手机端单指旋转、双指缩放)。四张图全部加载真实坐标。
3.1 交互 cartoon:全酶 + 配体(139)#
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像,交互视图直接加载镜像)。
它回答什么问题:口袋在整体折叠中的位置——灰 cartoon 是全酶,红棍是血红素,橙棍是胆固醇;初始视角直接zoom 到胆固醇,转一转就能看到它坐在螺旋篮的芯里,血红素在它斜下方。
怎么读:cartoon 把二级结构画成弹簧(螺旋)与箭头(片层),是信息/噪声比最高的表示。交互的价值在于”自问自答”:胆固醇离血红素铁多远?口袋有没有朝溶剂的开口?拖两下就有答案,这是截图给不了的。
用什么画:本站 /js/pdb-viewer.js(约 60 行的安全封装)+ 自托管 3Dmol 2.4.0;每个视图就是一个 div.pdb3d 加一段 JSON 配置,见折叠块。
图注示例:
图 139 CYP90B1 全酶 cartoon 与双配体交互视图(真实数据,PDB 6A15)。灰 cartoon 为蛋白链 A;红棍为血红素(HEM 601),橙棍为胆固醇(CLR 602);初始视角聚焦胆固醇口袋,可拖拽旋转、缩放。
展开查看:本站 3D 视图的嵌入代码
<!-- 两个脚本全篇只需引入一次(本节开头已引入) -->
<script src="/js/3dmol-min.js" defer></script>
<script src="/js/pdb-viewer.js" defer></script>

<!-- 一个交互视图 = 一个 div + 一段 JSON 配置 -->
<div class="pdb3d" data-cfg='{
  "pdb":   "/old/lib/pdb/6a15.pdb",
  "bg":    "white",
  "styles": [
    { "sel": { }, "style": { "cartoon": { "color": "#b9c6d4" } } },
    { "sel": { "resn": "HEM" }, "style": { "stick": { "colorscheme": "redCarbon" } } },
    { "sel": { "resn": "CLR" }, "style": { "stick": { "colorscheme": "orangeCarbon" } } }
  ],
  "zoom": { "sel": { "resn": "CLR" } }
}' style="height:420px"></div>配置字段:pdb 只允许本站相对路径(查看器会拒绝 .. 与绝对 URL,不发第三方请求);styles 数组依次 addStyle,后写的规则覆盖先写的;zoom.sel 控制初始聚焦。自托管 PDB 文件放在 /lib/pdb/。
3.2 交互对比:野生型 vs G256L 突变体口袋(140)#
数据:真实 —— PDB 1BI5 ↗(苜蓿查尔酮合酶 CHS 野生型,下载 ↗ · 本站镜像,上视图)与 PDB 1I89 ↗(G256L 突变体,下载 ↗ · 本站镜像,下视图);两图初始都聚焦红球标出的 256 位残基。
它回答什么问题:“一个点突变把口袋撑松/挤紧”到底长什么样——G256 是 CHS 底物通道口的小氨基酸,换成大侧链亮氨酸(L)会占据底物进入通道。这是第四篇 EMSA 之外、结构侧最有说服力的真实案例。
怎么读:上(蓝)野生型:256 号红球处通道敞开;下(红)突变体:同一位置的甘氨酸换成亮氨酸后体积堵住通道口。两个视图都是初始 zoom 到 256 位,旋转对比口袋开合。别用肉眼下定量结论——定量版是图 145 的叠合与图 151 的口袋体积。
用什么画:同 139 的本站查看器,两个 div 各指向一个 PDB 镜像;{ "resi": 256 } 选中残基画球。
图注示例:
图 140 苜蓿查尔酮合酶野生型(上,PDB 1BI5)与 G256L 突变体(下,PDB 1I89)口袋对比交互视图(真实数据)。cartoon 着色区分两结构,红球为 256 位残基:野生型为甘氨酸(通道敞开),突变体为亮氨酸(侧链占据底物通道)。可拖拽旋转对比。
展开查看:两个视图的嵌入配置
<div class="pdb3d" data-cfg='{ "pdb": "/old/lib/pdb/1bi5.pdb", "bg": "white",
  "styles": [
    { "sel": { }, "style": { "cartoon": { "color": "#7fa8d0" } } },
    { "sel": { "resi": 256 }, "style": { "sphere": { "color": "#e05252" } } }
  ], "zoom": { "sel": { "resi": 256 } } }'
  style="height:400px"></div>

<div class="pdb3d" data-cfg='{ "pdb": "/old/lib/pdb/1i89.pdb", "bg": "white",
  "styles": [
    { "sel": { }, "style": { "cartoon": { "color": "#d99696" } } },
    { "sel": { "resi": 256 }, "style": { "sphere": { "color": "#e05252" } } }
  ], "zoom": { "sel": { "resi": 256 } } }'
style="height:400px"></div>3.3 交互 pLDDT 上色:AlphaFold 模型哪段可信(141)#
数据:真实 —— AlphaFold DB 入口 O64989 ↗(拟南芥 DWF4/CYP90B1 预测模型,模型文件 ↗ · 本站镜像),全局平均 pLDDT 89.75。
它回答什么问题:预测模型能不能用、哪一段不能用——第四篇图 105 讲过 pLDDT 曲线(模拟),这张直接把 pLDDT 画在真实 AF 模型的 3D 骨架上,蓝=可信、红=不可信,一眼看到低置信段都摊在表面环上。
怎么读:AlphaFold PDB 文件的 B-factor 列存的就是 pLDDT,配色 rwb 渐变区间 50-100:蓝(>90)原子级可信、白(70-90)骨架可信、红(<50-60)当无序环处理。DWF4 模型整体偏蓝(均值 89.75),N 端膜锚定段与若干长环发红——它们不参与结构解读,但正是柔性/互作信号所在。
用什么画:本站查看器 + 3Dmol 的按属性着色:"colorscheme": { "prop": "b", "gradient": "rwb", "min": 50, "max": 100 }。
图注示例:
图 141 拟南芥 DWF4 的 AlphaFold 预测模型,按逐残基 pLDDT 着色(真实数据,AlphaFold DB O64989,全局平均 pLDDT 89.75)。蓝>90、白 70-90、红<60;低置信段集中于 N 端与表面长环,不参与结构解读。
展开查看:pLDDT 渐变着色配置
<div class="pdb3d" data-cfg='{ "pdb": "/old/lib/pdb/af-o64989.pdb", "bg": "white",
  "styles": [
    { "sel": { }, "style": { "cartoon": {
        "colorscheme": { "prop": "b", "gradient": "rwb",
                         "min": 50, "max": 100 } } } }
] }' style="height:420px"></div>AlphaFold 模型文件(AF-<UniProt>-F1-model_v*.pdb)的 B-factor 列存 pLDDT,所以 "prop": "b" 就是按 pLDDT 上色;min/max 收窄渐变区间可以放大中段的色差。
3.4 交互转录因子-DNA 复合物:BZR1 怎么抓启动子(142)#
数据:真实 —— PDB 5ZD4 ↗(BIL1/BZR1 DNA 结合域与 E-box 序列 DNA 的复合物,下载 ↗ · 本站镜像)。
它回答什么问题:第四篇的 EMSA(图 108)证明”结合”,双荧光素酶(图 114)证明”激活”,这张回答最后一步:转录因子在原子层面怎么抓住 DNA——BZR1 的 bHLH 结合域(橙色)插进 DNA 大沟。
怎么读:灰色长条是结晶用的 MBP 融合标签(残基编号是负数 -367 到 0,这是融合蛋白晶体的常见做法,读结构时先把它们认出来剔除);橙色 1-88 才是 BZR1 DNA 结合域;青色棍是两条 15 bp DNA。初始视角 zoom 到 DNA,四个复合物拷贝在晶胞里。把橙色螺旋转到 DNA 大沟里,就是 EMSA 那条迁移带的全部分子基础。
用什么画:本站查看器;用 "A:1-88" 这样的字符串选区避开负编号的 MBP 段,DNA 链按链名 E-H 选。
图注示例:
图 142 BIL1/BZR1 DNA 结合域与靶 DNA 复合物交互视图(真实数据,PDB 5ZD4)。灰 cartoon 为 MBP 融合标签(残基 -367 至 0),橙色为 BZR1 结合域(1-88),青色棍为 15 bp DNA;初始视角聚焦 DNA,BZR1 螺旋插入大沟。可拖拽旋转。
展开查看:链选择与融合标签剔除配置
<div class="pdb3d" data-cfg='{ "pdb": "/old/lib/pdb/5zd4.pdb", "bg": "white",
  "styles": [
    { "sel": { "chain": "A" }, "style": { "cartoon": { "color": "#d8d8d8" } } },
    { "sel": { "chain": "B" }, "style": { "cartoon": { "color": "#d8d8d8" } } },
    { "sel": { "chain": "C" }, "style": { "cartoon": { "color": "#d8d8d8" } } },
    { "sel": { "chain": "D" }, "style": { "cartoon": { "color": "#d8d8d8" } } },
    { "sel": "A:1-88", "style": { "cartoon": { "color": "#e0a13f" } } },
    { "sel": "B:1-88", "style": { "cartoon": { "color": "#e0a13f" } } },
    { "sel": "C:1-88", "style": { "cartoon": { "color": "#e0a13f" } } },
    { "sel": "D:1-88", "style": { "cartoon": { "color": "#e0a13f" } } },
    { "sel": { "chain": "E" }, "style": { "stick": { "colorscheme": "cyanCarbon" } } },
    { "sel": { "chain": "F" }, "style": { "stick": { "colorscheme": "cyanCarbon" } } },
    { "sel": { "chain": "G" }, "style": { "stick": { "colorscheme": "cyanCarbon" } } },
    { "sel": { "chain": "H" }, "style": { "stick": { "colorscheme": "cyanCarbon" } } }
], "zoom": { "sel": { "chain": "E" } } }' style="height:420px"></div>选区两种写法:对象 { "chain": "A" } 按属性;字符串 "A:1-88" 按链名+残基号区间。融合蛋白里 MBP 的残基号是负数,用区间选择可以只染真蛋白。
四、预测质量与突变扫描(143-149)#
4.1 PAE 预测对齐误差热图(143)#
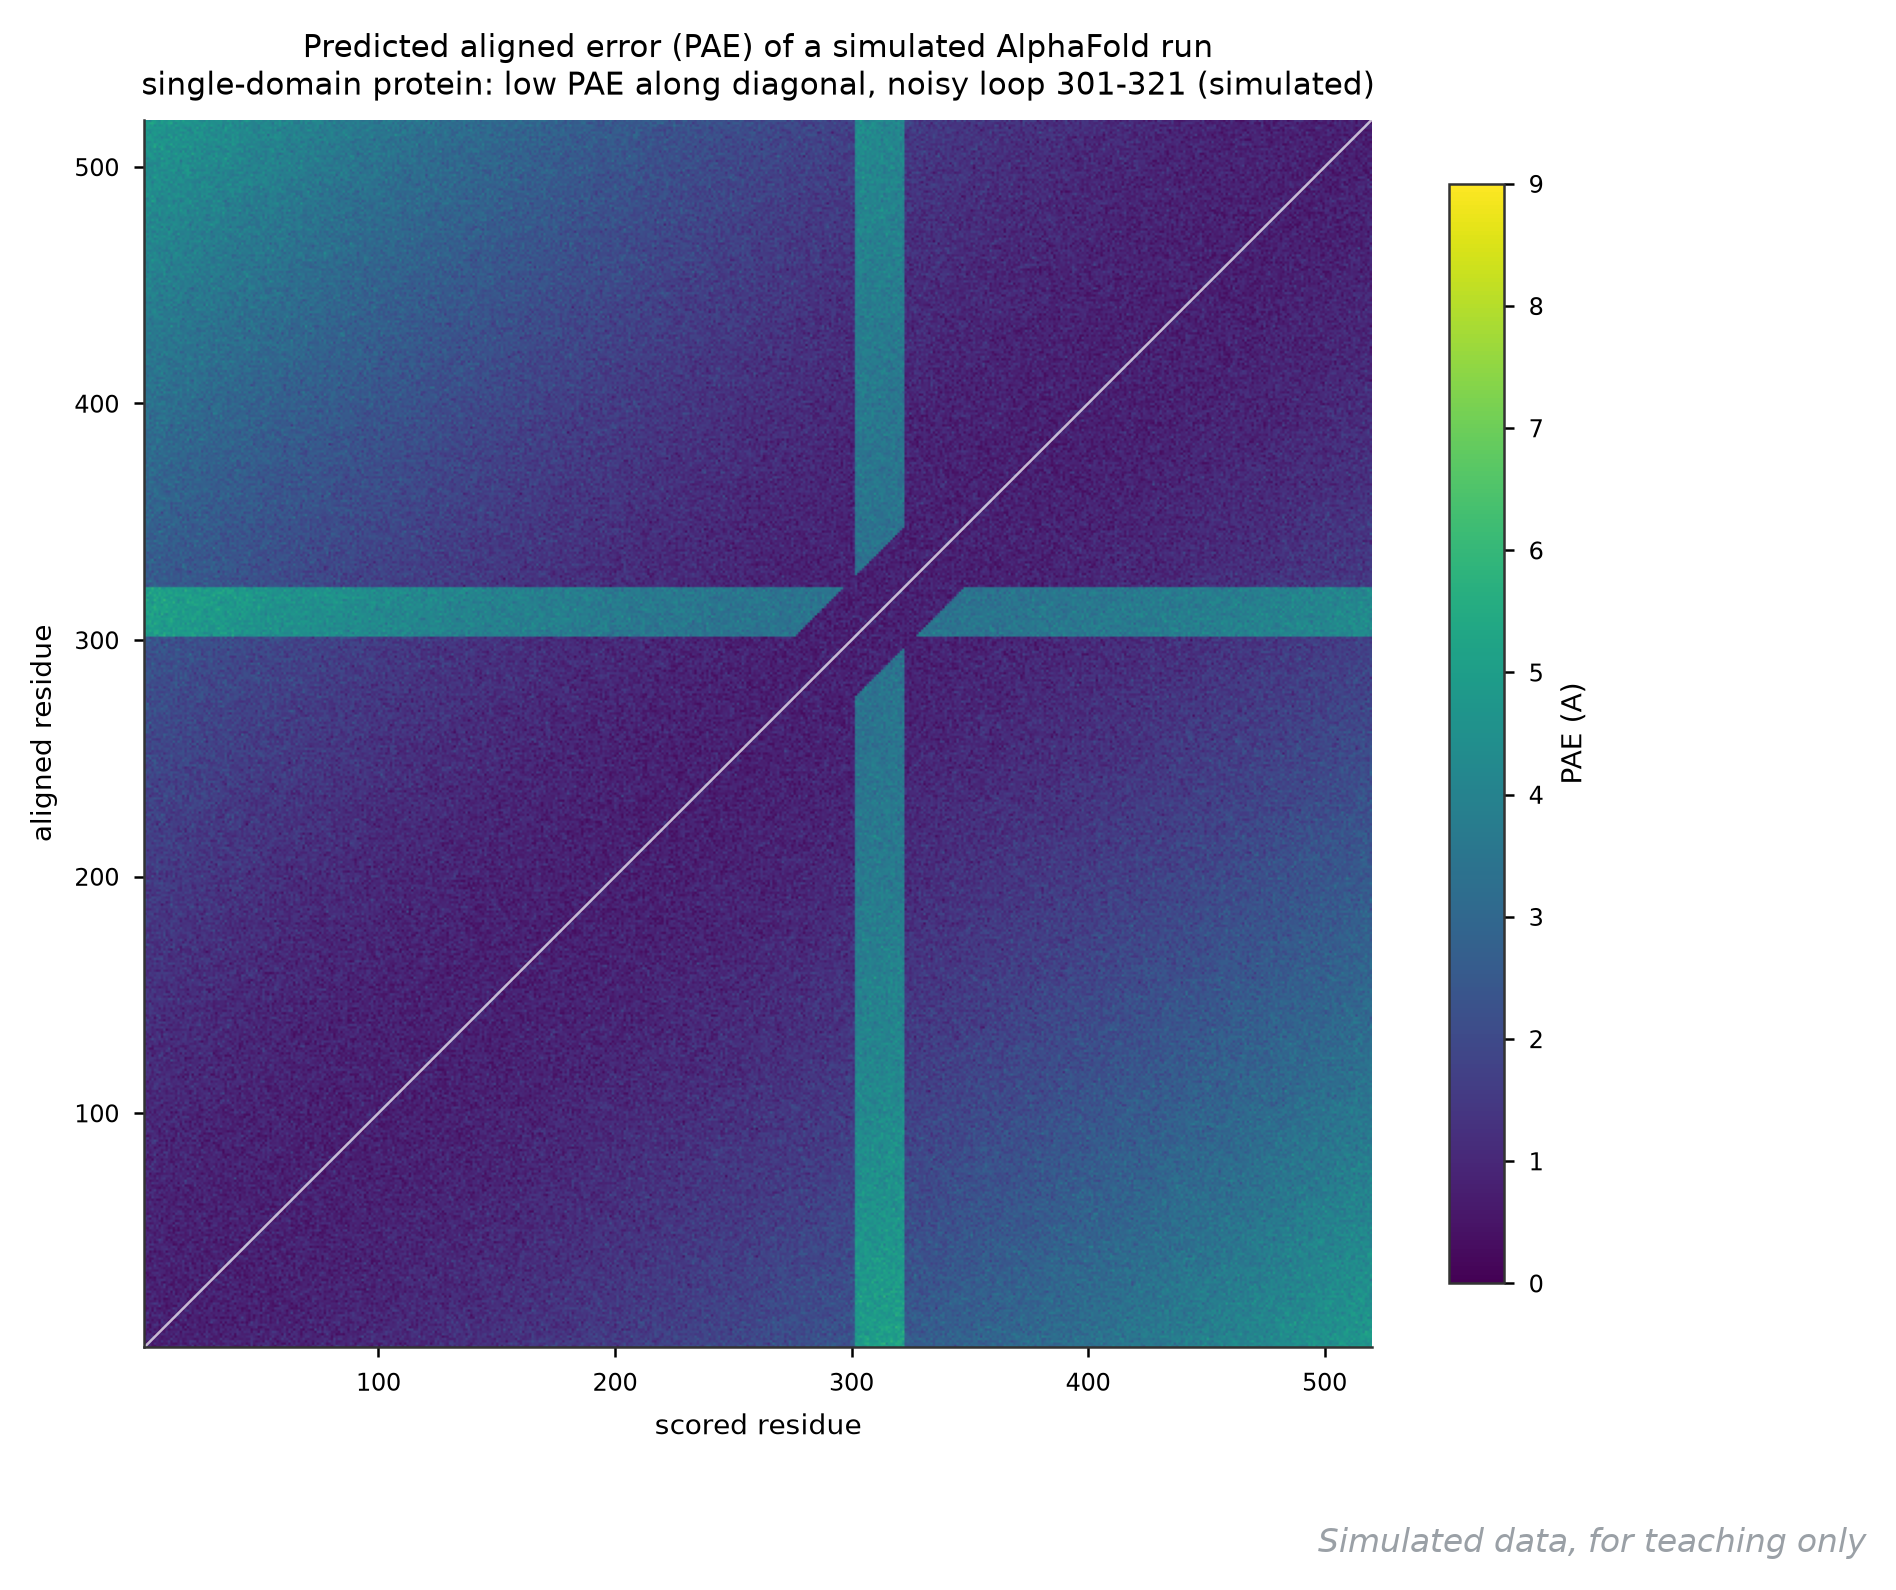
数据:模拟 —— 固定随机种子生成(单结构域蛋白的典型 PAE 形态),水印「Simulated data」。
它回答什么问题:pLDDT 说”每个残基自身位置准不准”,PAE 说”两个残基的相对位置准不准”——判断结构域边界、域间取向是否可信,看 PAE 不看 pLDDT。
怎么读:横纵轴都是残基号,颜色=预测对齐误差(Å)。对角线附近永远低(自身邻域);关键看远处:i 与 j 相隔很远仍然低,说明这两段相对位置可信。单结构域蛋白像本图:误差随序列间隔缓慢升高(对角带窄而暗,角落最亮约 3-4 Å),301-321 一段出现横竖亮条——那段柔性环与其他部分的相对位置预测不佳。多结构域蛋白则呈”棋盘格”:域内块暗、域间块亮,一亮一亮就是域边界。
用什么画:AlphaFold 输出的 PAE JSON 直接 imshow;重绘注意 origin="lower" 与对称性。
图注示例:
图 143 单结构域蛋白的预测对齐误差(PAE)热图(模拟)。对角带低误差、随序列距离缓慢升高,301-321 柔性环呈横竖亮条;无多结构域棋盘格特征。
展开查看:PAE 数据(节选)与绘图代码
residue_i,residue_j,PAE_A
60,60,1.0
60,120,0.5
60,240,1.0
60,360,2.6
60,480,3.6
180,300,1.0
300,300,1.1
300,480,0.8
480,60,3.8
480,480,0.9(完整 520×520 矩阵由代码生成;上表为每 60 个残基的采样格。)
绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

N, rng = 520, np.random.default_rng(5143)
i = np.arange(N)[:, None]
j = np.arange(N)[None, :]
sep = np.abs(i - j)
base = 0.8 + 4.0 * (sep / N) ** 1.7
loop = ((i > 300) & (i < 322)) | ((j > 300) & (j < 322))
M = np.clip(base + rng.normal(0, 0.3, (N, N))
            + loop * np.where(sep > 25, 2.6, 0), 0.3, 9.0)
fig, ax = plt.subplots(figsize=(6.6, 5.6))
im = ax.imshow(M, cmap="viridis", origin="lower", vmin=0, vmax=9,
               extent=[1, N, 1, N])
ax.plot([1, N], [1, N], color="white", lw=0.6, alpha=0.7)
ax.set_xlabel("scored residue")
ax.set_ylabel("aligned residue")
fig.colorbar(im, ax=ax, shrink=0.85, label="PAE (A)")
ax.set_title("Predicted aligned error (simulated)")
fig.savefig("143-pae-map.png", dpi=200, bbox_inches="tight")4.2 残基接触图(144)#
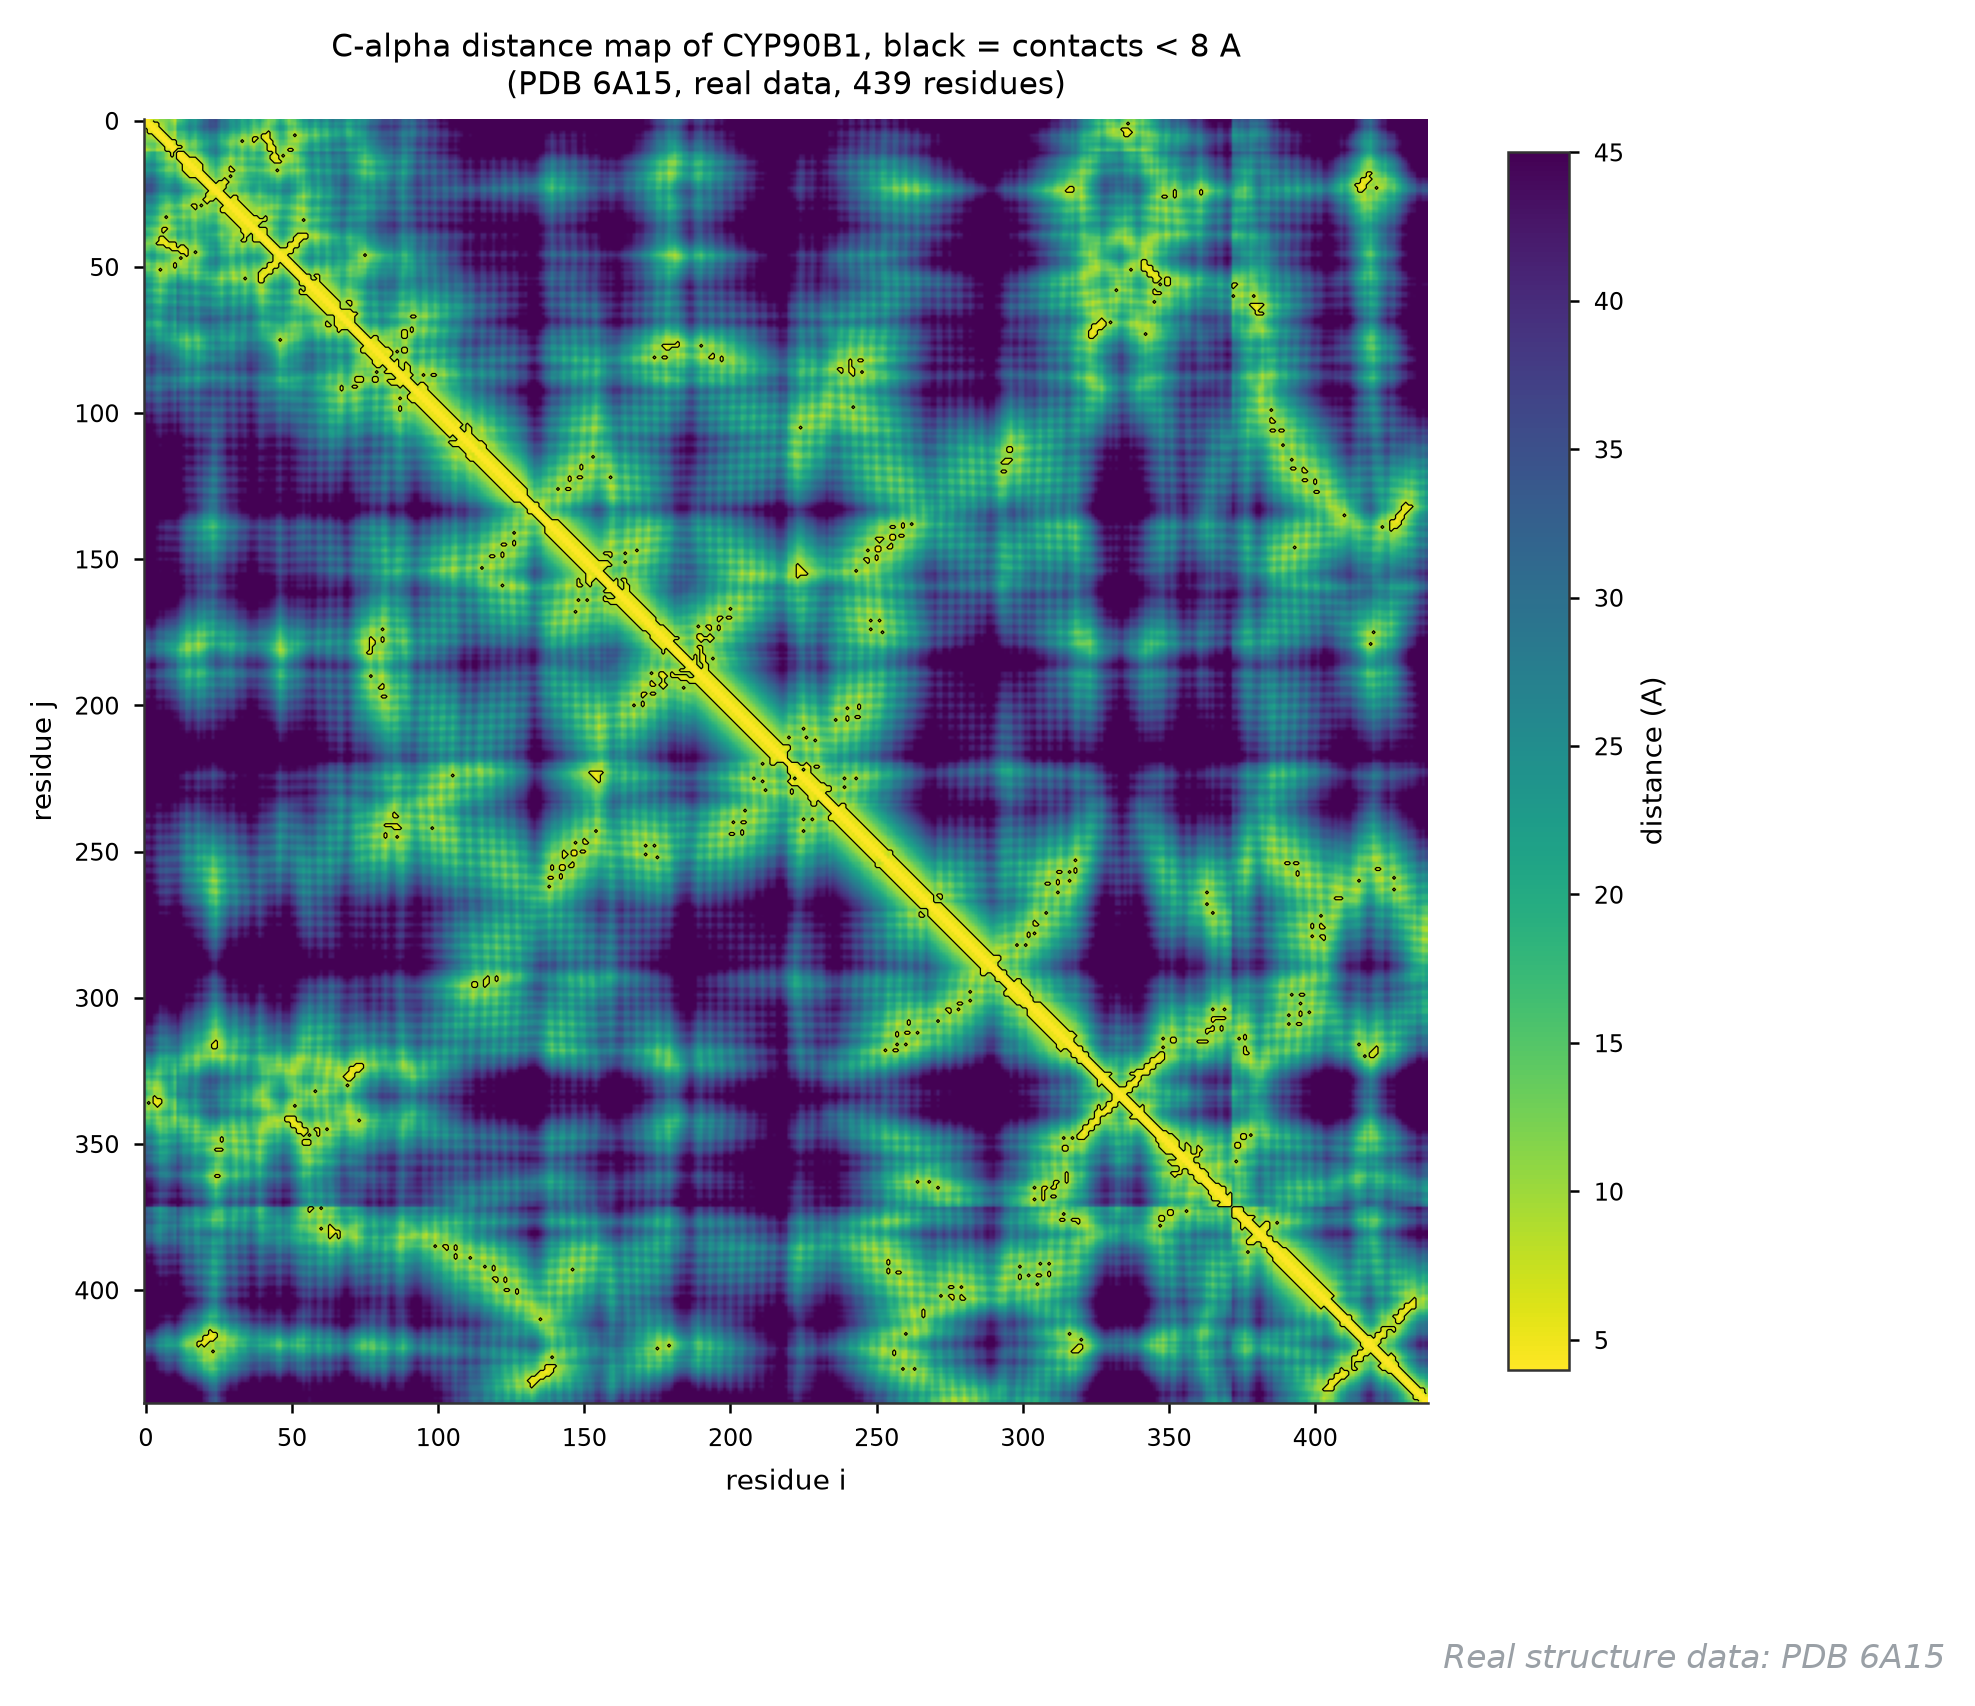
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),水印「Real structure data: PDB 6A15」。
它回答什么问题:蛋白的折叠拓扑——哪些远程序列片段在空间里贴在一起。接触图还是结构预测评测的”对答案”工具:预测结构与晶体结构的接触图几乎一样,折叠就对了。
怎么读:横纵轴都是残基号(链 A 439 个解析残基),颜色=C-alpha 距离(viridis 反色:近=暗),黑线勾出 <8 Å 接触。主对角线=序列相邻;对角线附近平行的细线带=α 螺旋(残基 i 与 i+3/i+4 规律接触);短的正/负偏对角线=平行/反平行 β 折叠;远处的孤立黑块=把两端拉到一起的疏水核心。AlphaFold 的 PAE(143)与接触图同构——一个是预测置信度,一个是实测距离。
用什么画:距离矩阵 numpy 一行算出,imshow + contour 勾接触线。
图注示例:
图 144 CYP90B1 的 C-alpha 距离矩阵与接触图(真实数据,PDB 6A15 链 A,439 残基)。色标为距离(4-45 Å),黑线为 <8 Å 接触;主对角线附近的平行条纹对应 α 螺旋堆积,远离对角线的接触块对应疏水核心。
展开查看:距离矩阵绘图代码
绘图代码(接图 134 的 parse())
import numpy as np

ca = [a for a in parse("6a15.pdb")
      if a["chain"] == "A" and not a["het"] and a["name"] == "CA"]
P = np.array([a["xyz"] for a in ca])
D = np.linalg.norm(P[:, None, :] - P[None, :, :], axis=-1)
fig, ax = plt.subplots(figsize=(6.9, 6.2))
im = ax.imshow(D, cmap="viridis_r", vmin=4, vmax=45)
ax.contour(np.arange(len(P)), np.arange(len(P)),
           (D < 8).astype(float), levels=[0.5], colors="black",
           linewidths=0.3)
ax.set_xlabel("residue i")
ax.set_ylabel("residue j")
fig.colorbar(im, ax=ax, shrink=0.85, label="distance (A)")
ax.set_title("C-alpha distance map (PDB 6A15, real data)")
fig.savefig("144-contact-map.png", dpi=200, bbox_inches="tight")4.3 野生型/突变体结构叠合(145)#
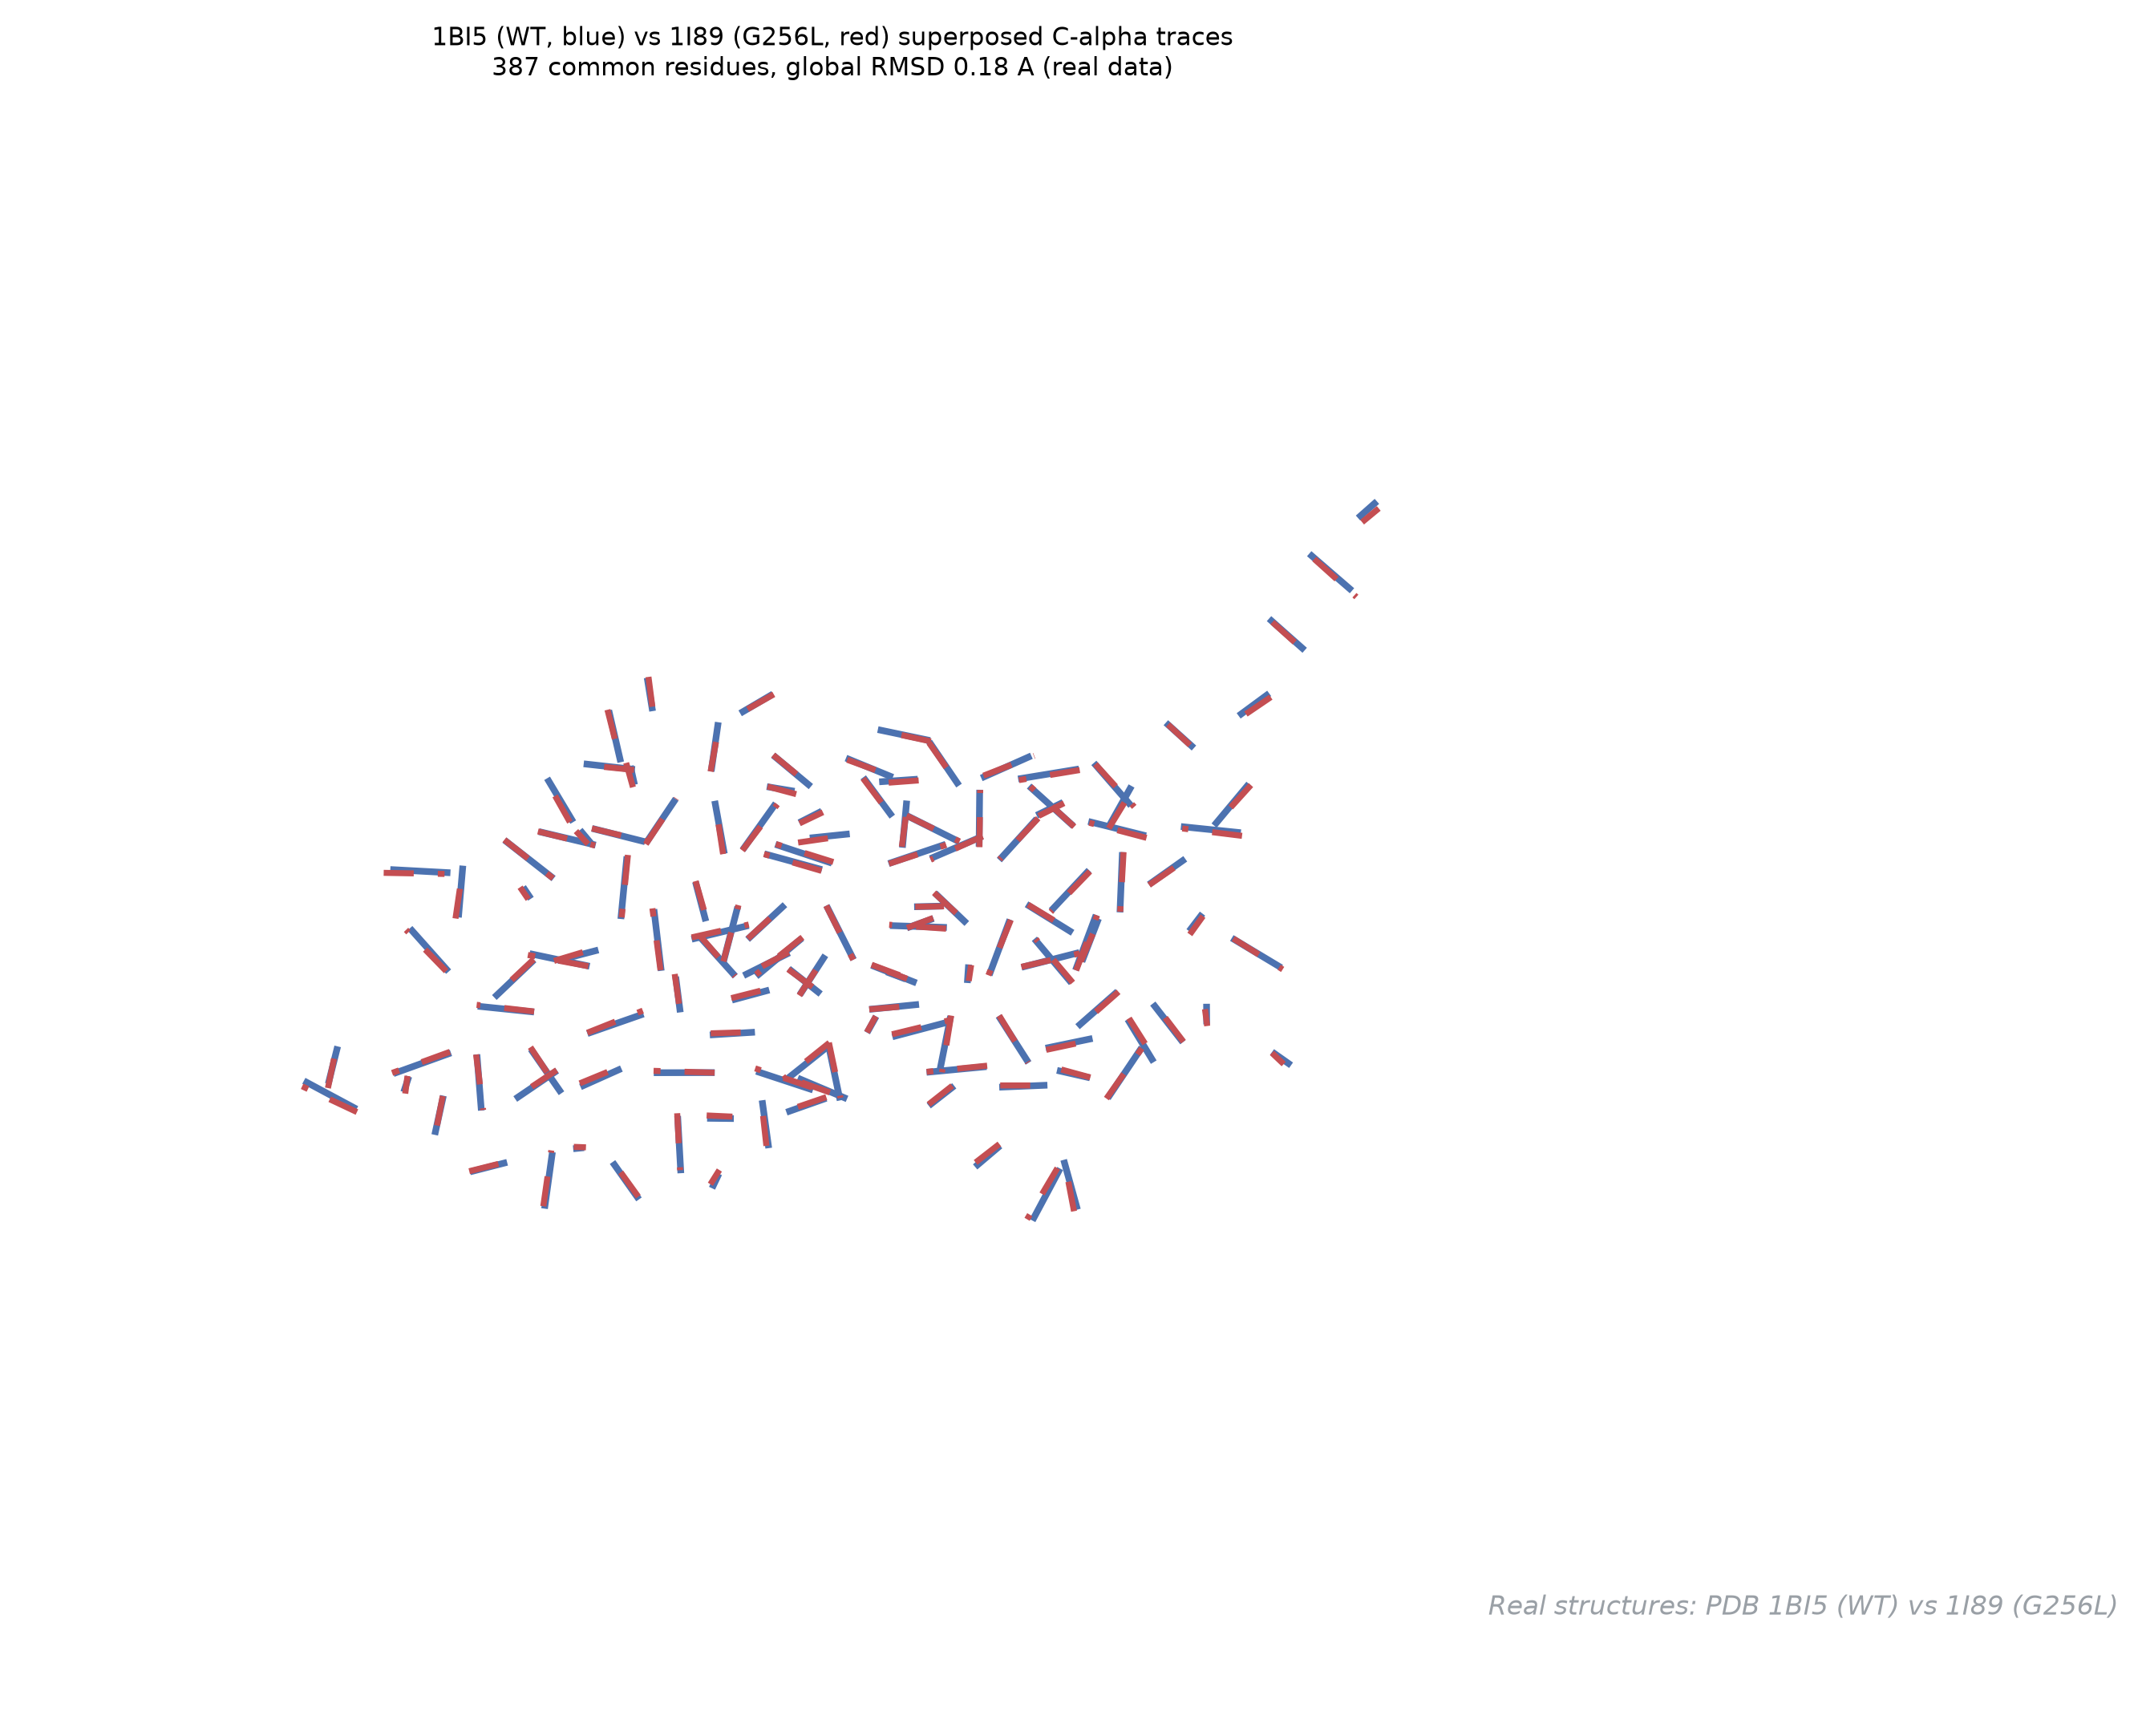
数据:真实 —— PDB 1BI5 ↗(CHS 野生型)与 1I89 ↗(G256L),镜像 /lib/pdb/1bi5.pdb、/lib/pdb/1i89.pdb,水印「Real structures: PDB 1BI5 (WT) vs 1I89 (G256L)」。
它回答什么问题:一个点突变到底动了多少结构——是整体散架,还是只把 256 位附近的口袋微调了一下。结构生物学的标准动作:先叠合,再看偏差。
怎么读:蓝实线=野生型(1BI5),红虚线=突变体(1I89,G256L),Kabsch 算法按 387 个共同残基最优叠合。两条线几乎重合:全局 RMSD 仅 0.18 Å(晶体结构间分辨率级别的差异);逐残基偏差里 G256 本身 0.20 Å,最大的也只到 PHE165 的 0.84 Å。结论写法:“G256L 不改变整体折叠,仅局部微调底物通道”——这就是”点突变→口袋变紧”的定量版本。
用什么画:Kabsch 叠合(SVD 求旋转矩阵)十行搞定;画图时突变体用虚线叠在野生型实线上,虚线空隙里透出蓝色,两色都看得见。
图注示例:
图 145 查尔酮合酶野生型(1BI5,蓝实线)与 G256L 突变体(1I89,红虚线)C-alpha 叠合(真实数据)。387 个共同残基全局 RMSD 0.18 Å;G256 位偏差 0.20 Å,最大逐残基偏差 0.84 Å(PHE165)——突变不改变整体折叠,效应局限于底物通道。
展开查看:逐残基偏差表与 Kabsch 叠合代码
residue,dev_A
G256,0.20
VAL2,0.47
SER5,0.46
GLU6,0.49
PHE165,0.84
THR204,0.49
GLU231,0.49
PRO321,0.44
ILE389,0.45(G256 行为目标残基,其余为偏差最大的 8 个残基。)
绘图代码(Python,独立可运行;需 1bi5.pdb 与 1i89.pdb)
import numpy as np

def kabsch(P, Q):  # 把 P 旋转平移到 Q 上(最小二乘)
    pc, qc = P.mean(0), Q.mean(0)
    U, _, Vt = np.linalg.svd((P - pc).T @ (Q - qc))
    d = np.sign(np.linalg.det(Vt.T @ U.T))
    R = Vt.T @ np.diag([1, 1, d]) @ U.T
    return (P - pc) @ R + qc

def cas(path, chain="A"):
    out = []
    for ln in open(path, encoding="ascii", errors="ignore"):
        if ln[:6] == "ATOM  " and ln[21] == chain and ln[12:16].strip() == "CA":
            out.append((int(ln[22:26]),
                        (float(ln[30:38]), float(ln[38:46]),
                         float(ln[46:54]))))
    return dict(out)

w, m = cas("1bi5.pdb"), cas("1i89.pdb")
common = sorted(set(w) & set(m))
Q = np.array([w[i] for i in common])          # WT
Pt = kabsch(np.array([m[i] for i in common]), Q)
dev = np.linalg.norm(Pt - Q, axis=1)
print("common=%d global RMSD=%.2f G256=%.2f max=%.2f@%d"
      % (len(common), np.sqrt((dev ** 2).mean()),
dev[common.index(256)], dev.max(), common[dev.argmax()]))4.4 突变棒棒糖图(146)#
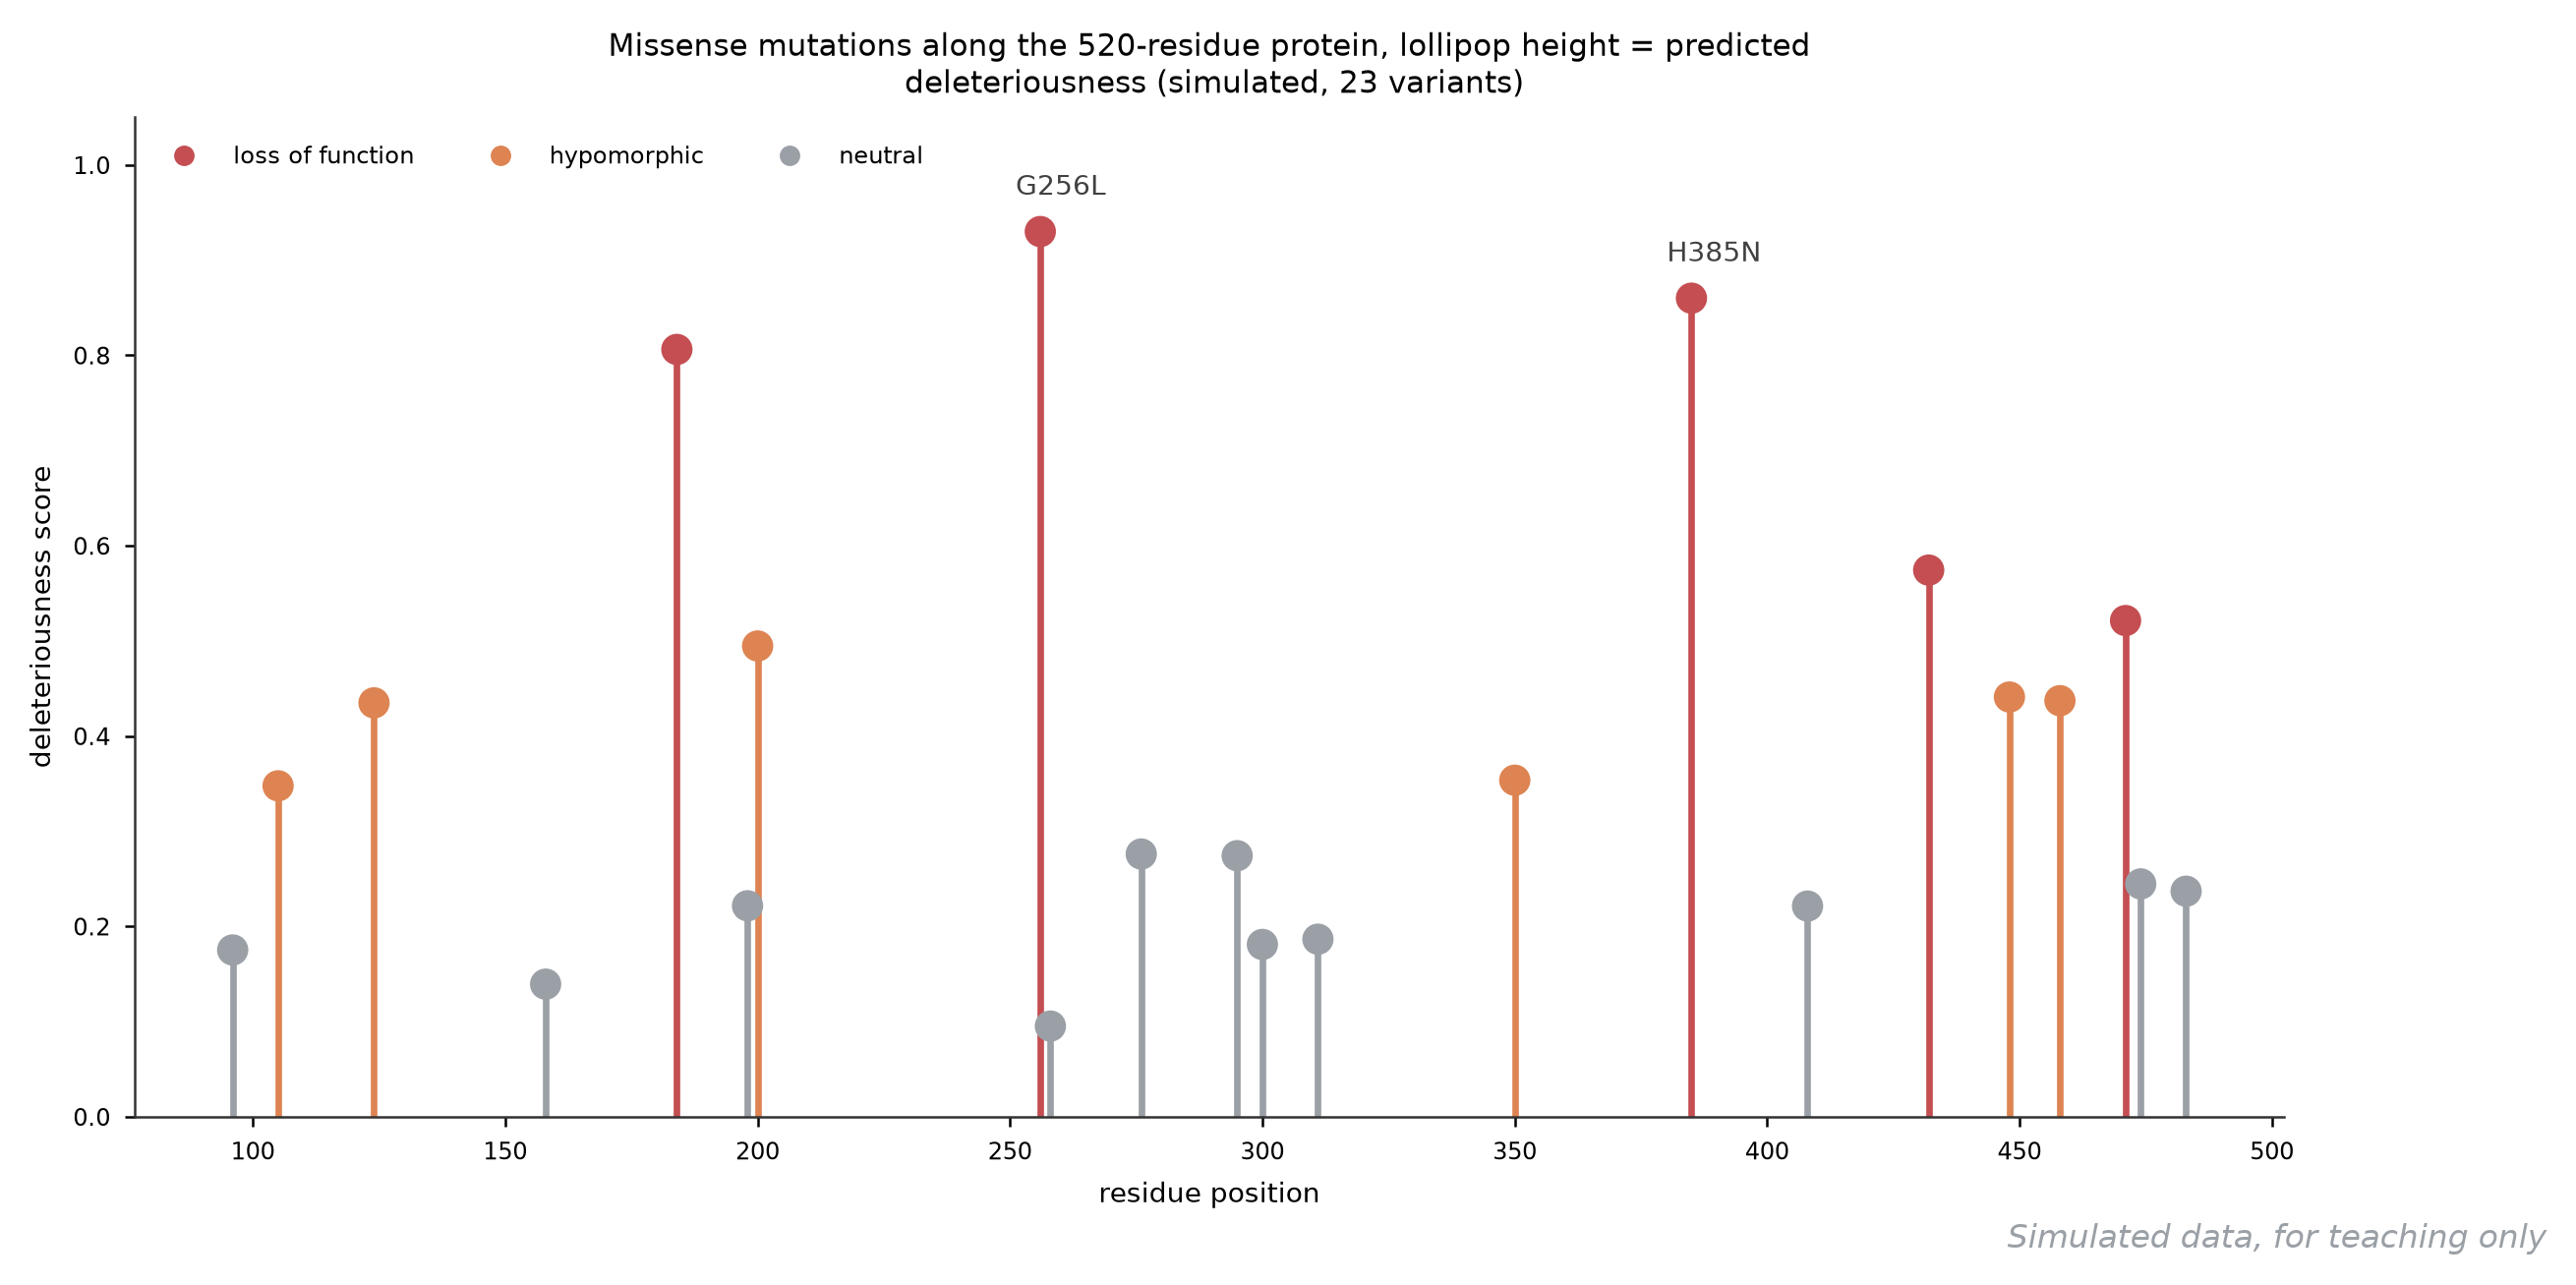
数据:模拟 —— 危害得分由随机模型生成(固定种子);水印「Simulated data」。
它回答什么问题:一批错义突变谁狠谁温和——群体里筛出的变异位点、EMS 诱变池、候选功能位点排序,都用棒棒糖图一排看尽。
怎么读:横轴=残基位置(蛋白全长 520),每根棒的高度=预测危害得分(0-1),颜色分级:红>0.5 预测功能丧失、橙 0.3-0.5 亚效、灰中性。本图 23 个突变里 5 个红,最高的两个恰是口袋位点的 G256(0.93)与 H385(0.86)——与 136 算出的口袋残基位置对应(真实口袋位点、模拟得分,这种”真实位置+模拟值”的组合作教学演示非常顺手)。
用什么画:vlines + scatter 两行主体;SIFT/PolyPhen/PROVEAN 得分画高度即可。
图注示例:
图 146 520 aa 蛋白上 23 个错义突变的危害棒棒糖图(模拟得分)。棒高为预测危害得分(0-1):>0.5 红(5 个)、0.3-0.5 橙(6 个)、其余灰;G256(0.93)与 H385(0.86)为口袋位点中得分最高的两个突变。
展开查看:突变得分表与绘图代码
position,score,class
96,0.18,neutral
105,0.35,hypomorphic
124,0.43,hypomorphic
158,0.14,neutral
184,0.81,loss_of_function
198,0.22,neutral
200,0.49,hypomorphic
256,0.93,loss_of_function
258,0.10,neutral
276,0.28,neutral
295,0.27,neutral
300,0.18,neutral
311,0.19,neutral
350,0.35,hypomorphic
385,0.86,loss_of_function
408,0.22,neutral
432,0.57,loss_of_function
448,0.44,hypomorphic
458,0.44,hypomorphic
471,0.52,loss_of_function
474,0.24,neutral
483,0.24,neutral绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rows = [ln.split(",") for ln in open("146-lollipop.csv").read().splitlines()[1:]]
pos = np.array([int(r[0]) for r in rows])
sc = np.array([float(r[1]) for r in rows])
cols = np.where(sc > 0.5, "#C44E52", np.where(sc > 0.3, "#DD8452", "#9AA0A6"))
fig, ax = plt.subplots(figsize=(9.4, 4.4))
ax.vlines(pos, 0, sc, color=cols, lw=1.6)
ax.scatter(pos, sc, s=44, c=cols, zorder=3)
ax.set_xlabel("residue position")
ax.set_ylabel("deleteriousness score")
ax.set_ylim(0, 1.05)
fig.savefig("146-mutation-lollipop.png", dpi=200, bbox_inches="tight")4.5 氨基酸替换容忍度矩阵(147)#
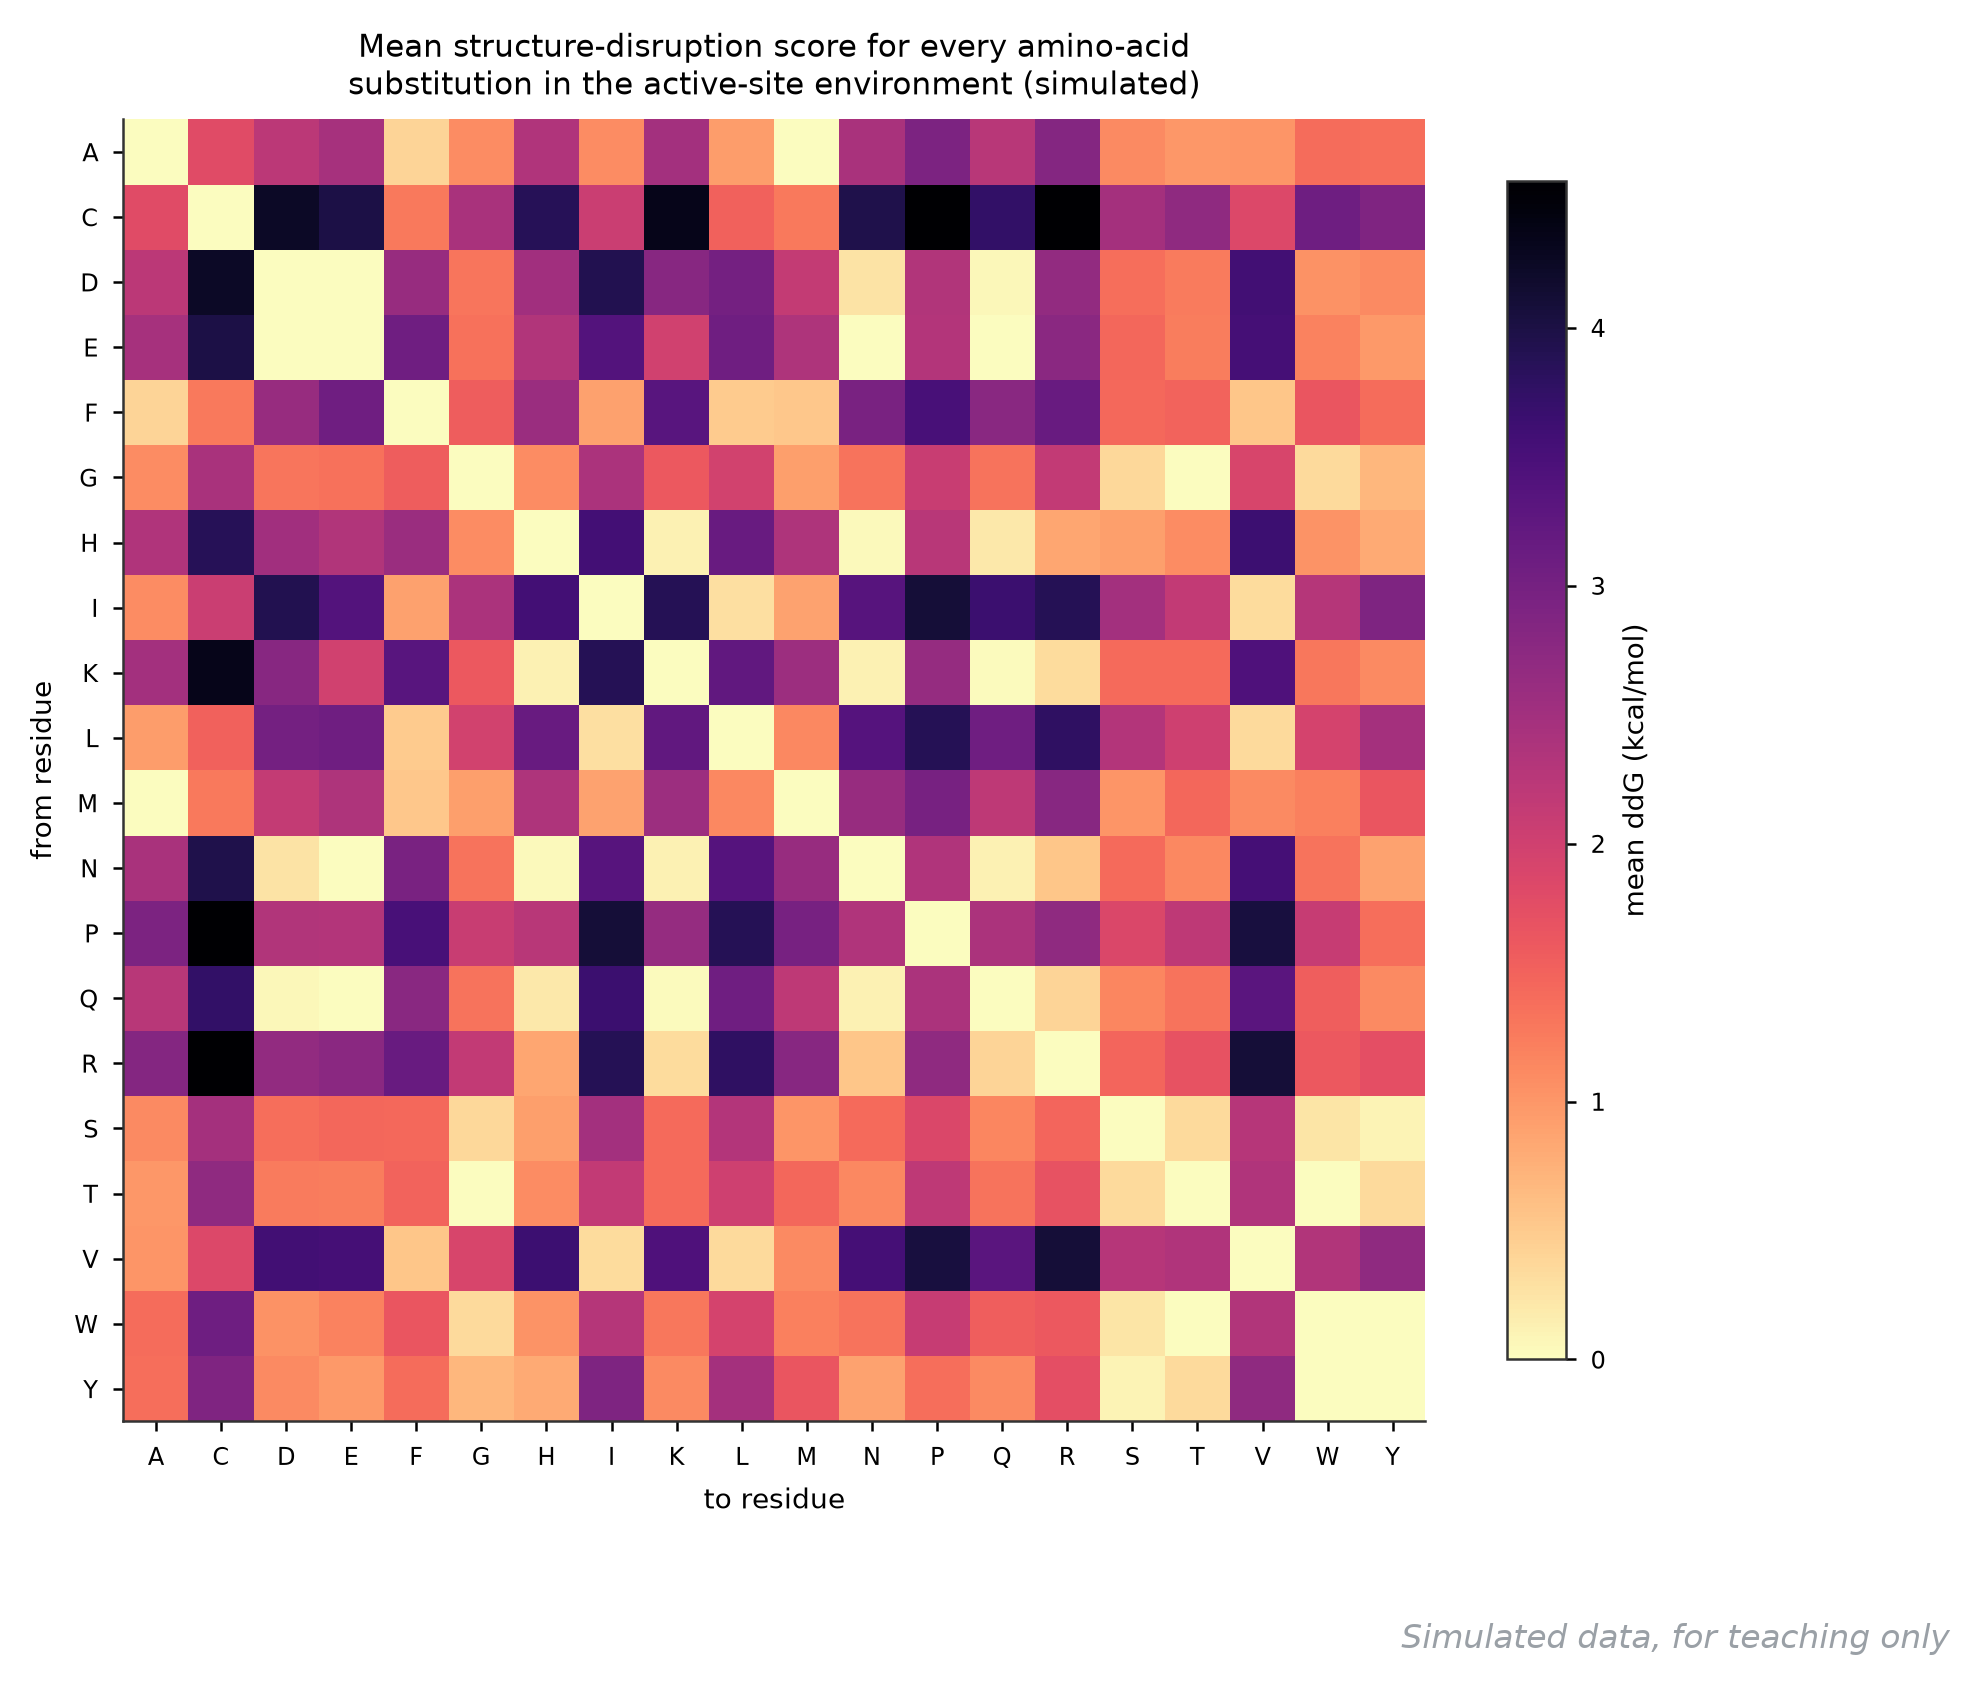
数据:模拟 —— 由疏水性差、电荷反转、Pro/Cys 特判公式生成(固定种子);水印「Simulated data」。
它回答什么问题:把某位点的氨基酸换成另一个,结构会坏多少——饱和突变实验(deep mutational scanning)的汇总视图就是它;工程改造前先看这张表”哪些替换安全”。
怎么读:行=原氨基酸,列=替换后,色深=平均 ΔΔG(kcal/mol,越亮越破坏)。规律一眼可读:对角线=0(不变);电荷反转 K/R/H→D/E 一带最亮(需要拆盐桥);含 Pro 的行列亮(破坏主链构象);含 Cys 的行列亮(拆二硫键);疏水内部互换(L↔I↔V↔M)最暗——与实验直觉完全一致,这正是这张图适合教学的原因。
用什么画:imshow + 二十个单字母刻度;真实分析用 DMS 实验矩阵或 Rosetta/FoldX 扫描值替换即可。
图注示例:
图 147 活性位点环境中 20×20 氨基酸替换的平均结构破坏得分矩阵(模拟)。对角线为零;电荷反转(K/R/H 与 D/E 互换)、含 Pro 与含 Cys 的替换最亮;疏水互换(L/I/V/M)最温和。
展开查看:替换矩阵数据与绘图代码
from\to,A,C,D,E,F,G,H,I,K,L,M,N,P,Q,R,S,T,V,W,Y
A,0.0,1.8,2.2,2.4,0.4,1.1,2.3,1.1,2.5,0.9,0.0,2.4,2.9,2.3,2.8,1.1,1.0,1.0,1.4,1.4
C,1.8,0.0,4.2,4.0,1.3,2.4,3.9,2.1,4.3,1.5,1.3,4.0,4.6,3.7,4.6,2.5,2.7,1.9,3.1,2.9
D,2.2,4.2,0.0,0.0,2.6,1.3,2.5,3.9,2.8,3.0,2.1,0.3,2.3,0.1,2.7,1.4,1.3,3.6,1.0,1.1
E,2.4,4.0,0.0,0.0,3.1,1.3,2.3,3.4,2.0,3.1,2.4,0.0,2.3,0.0,2.8,1.5,1.2,3.5,1.2,1.0
F,0.4,1.3,2.6,3.1,0.0,1.6,2.6,0.9,3.3,0.5,0.5,3.0,3.5,2.8,3.2,1.4,1.5,0.6,1.7,1.4
G,1.1,2.4,1.3,1.3,1.6,0.0,1.1,2.4,1.6,2.0,0.9,1.3,2.1,1.3,2.1,0.4,0.0,1.9,0.4,0.7
H,2.3,3.9,2.5,2.3,2.6,1.1,0.0,3.6,0.1,3.1,2.4,0.0,2.3,0.2,0.8,0.9,1.1,3.6,1.0,0.8
I,1.1,2.1,3.9,3.4,0.9,2.4,3.6,0.0,3.9,0.3,0.9,3.3,4.1,3.7,3.9,2.5,2.2,0.3,2.3,2.9
K,2.5,4.3,2.8,2.0,3.3,1.6,0.1,3.9,0.0,3.2,2.6,0.1,2.6,0.0,0.3,1.4,1.4,3.4,1.3,1.1
L,0.9,1.5,3.0,3.1,0.5,2.0,3.1,0.3,3.2,0.0,1.1,3.4,3.9,3.1,3.8,2.3,2.0,0.4,1.9,2.5
M,0.0,1.3,2.1,2.4,0.5,0.9,2.4,0.9,2.6,1.1,0.0,2.6,3.0,2.2,2.8,1.0,1.5,1.1,1.2,1.7
N,2.4,4.0,0.3,0.0,3.0,1.3,0.0,3.3,0.1,3.4,2.6,0.0,2.3,0.1,0.5,1.4,1.1,3.5,1.3,0.9
P,2.9,4.6,2.3,2.3,3.5,2.1,2.3,4.1,2.6,3.9,3.0,2.3,0.0,2.4,2.7,1.9,2.2,4.0,2.1,1.4
Q,2.3,3.7,0.1,0.0,2.8,1.3,0.2,3.7,0.0,3.1,2.2,0.1,2.4,0.0,0.4,1.1,1.3,3.3,1.5,1.1
R,2.8,4.6,2.7,2.8,3.2,2.1,0.8,3.9,0.3,3.8,2.8,0.5,2.7,0.4,0.0,1.5,1.7,4.1,1.6,1.7
S,1.1,2.5,1.4,1.5,1.4,0.4,0.9,2.5,1.4,2.3,1.0,1.4,1.9,1.1,1.5,0.0,0.3,2.3,0.2,0.1
T,1.0,2.7,1.3,1.2,1.5,0.0,1.1,2.2,1.4,2.0,1.5,1.1,2.2,1.3,1.7,0.3,0.0,2.4,0.0,0.4
V,1.0,1.9,3.6,3.5,0.6,1.9,3.6,0.3,3.4,0.4,1.1,3.5,4.0,3.3,4.1,2.3,2.4,0.0,2.3,2.7
W,1.4,3.1,1.0,1.2,1.7,0.4,1.0,2.3,1.3,1.9,1.2,1.3,2.1,1.5,1.6,0.2,0.0,2.3,0.0,0.0
Y,1.4,2.9,1.1,1.0,1.4,0.7,0.8,2.9,1.1,2.5,1.7,0.9,1.4,1.1,1.7,0.1,0.4,2.7,0.0,0.0绘图代码(Python,独立可运行;数据由公式生成)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

AA = list("ACDEFGHIKLMNPQRSTVWY")
kd = dict(zip(AA, [1.8, 2.5, -3.5, -3.5, 2.8, -0.4, -3.2, 4.5, -3.9,
                   3.8, 1.9, -3.5, -1.6, -3.5, -4.5, -0.8, -0.7, 4.2,
                   -0.9, -1.3]))                      # Kyte-Doolittle
rng = np.random.default_rng(5147)
M = np.zeros((20, 20))
for a in range(20):
    for b in range(20):
        if a == b:
            continue
        charge = 2.2 if (("KRH".find(AA[a]) >= 0 and "DE".find(AA[b]) >= 0)
                         or ("DE".find(AA[a]) >= 0 and "KRH".find(AA[b]) >= 0)) else 0
        M[a, b] = 0.45 * abs(kd[AA[a]] - kd[AA[b]]) + charge \
            + 1.5 * ("P" in (AA[a], AA[b])) + 1.2 * ("C" in (AA[a], AA[b])) \
            + rng.normal(0, 0.25)
M = np.clip((M + M.T) / 2, 0, None)
np.fill_diagonal(M, 0.0)
fig, ax = plt.subplots(figsize=(7.0, 6.0))
im = ax.imshow(M, cmap="magma_r")
ax.set_xticks(range(20), AA)
ax.set_yticks(range(20), AA)
fig.colorbar(im, ax=ax, shrink=0.85, label="mean ddG (kcal/mol)")
fig.savefig("147-substitution-matrix.png", dpi=200, bbox_inches="tight")4.6 ΔΔG 稳定性预测条形图(148)#
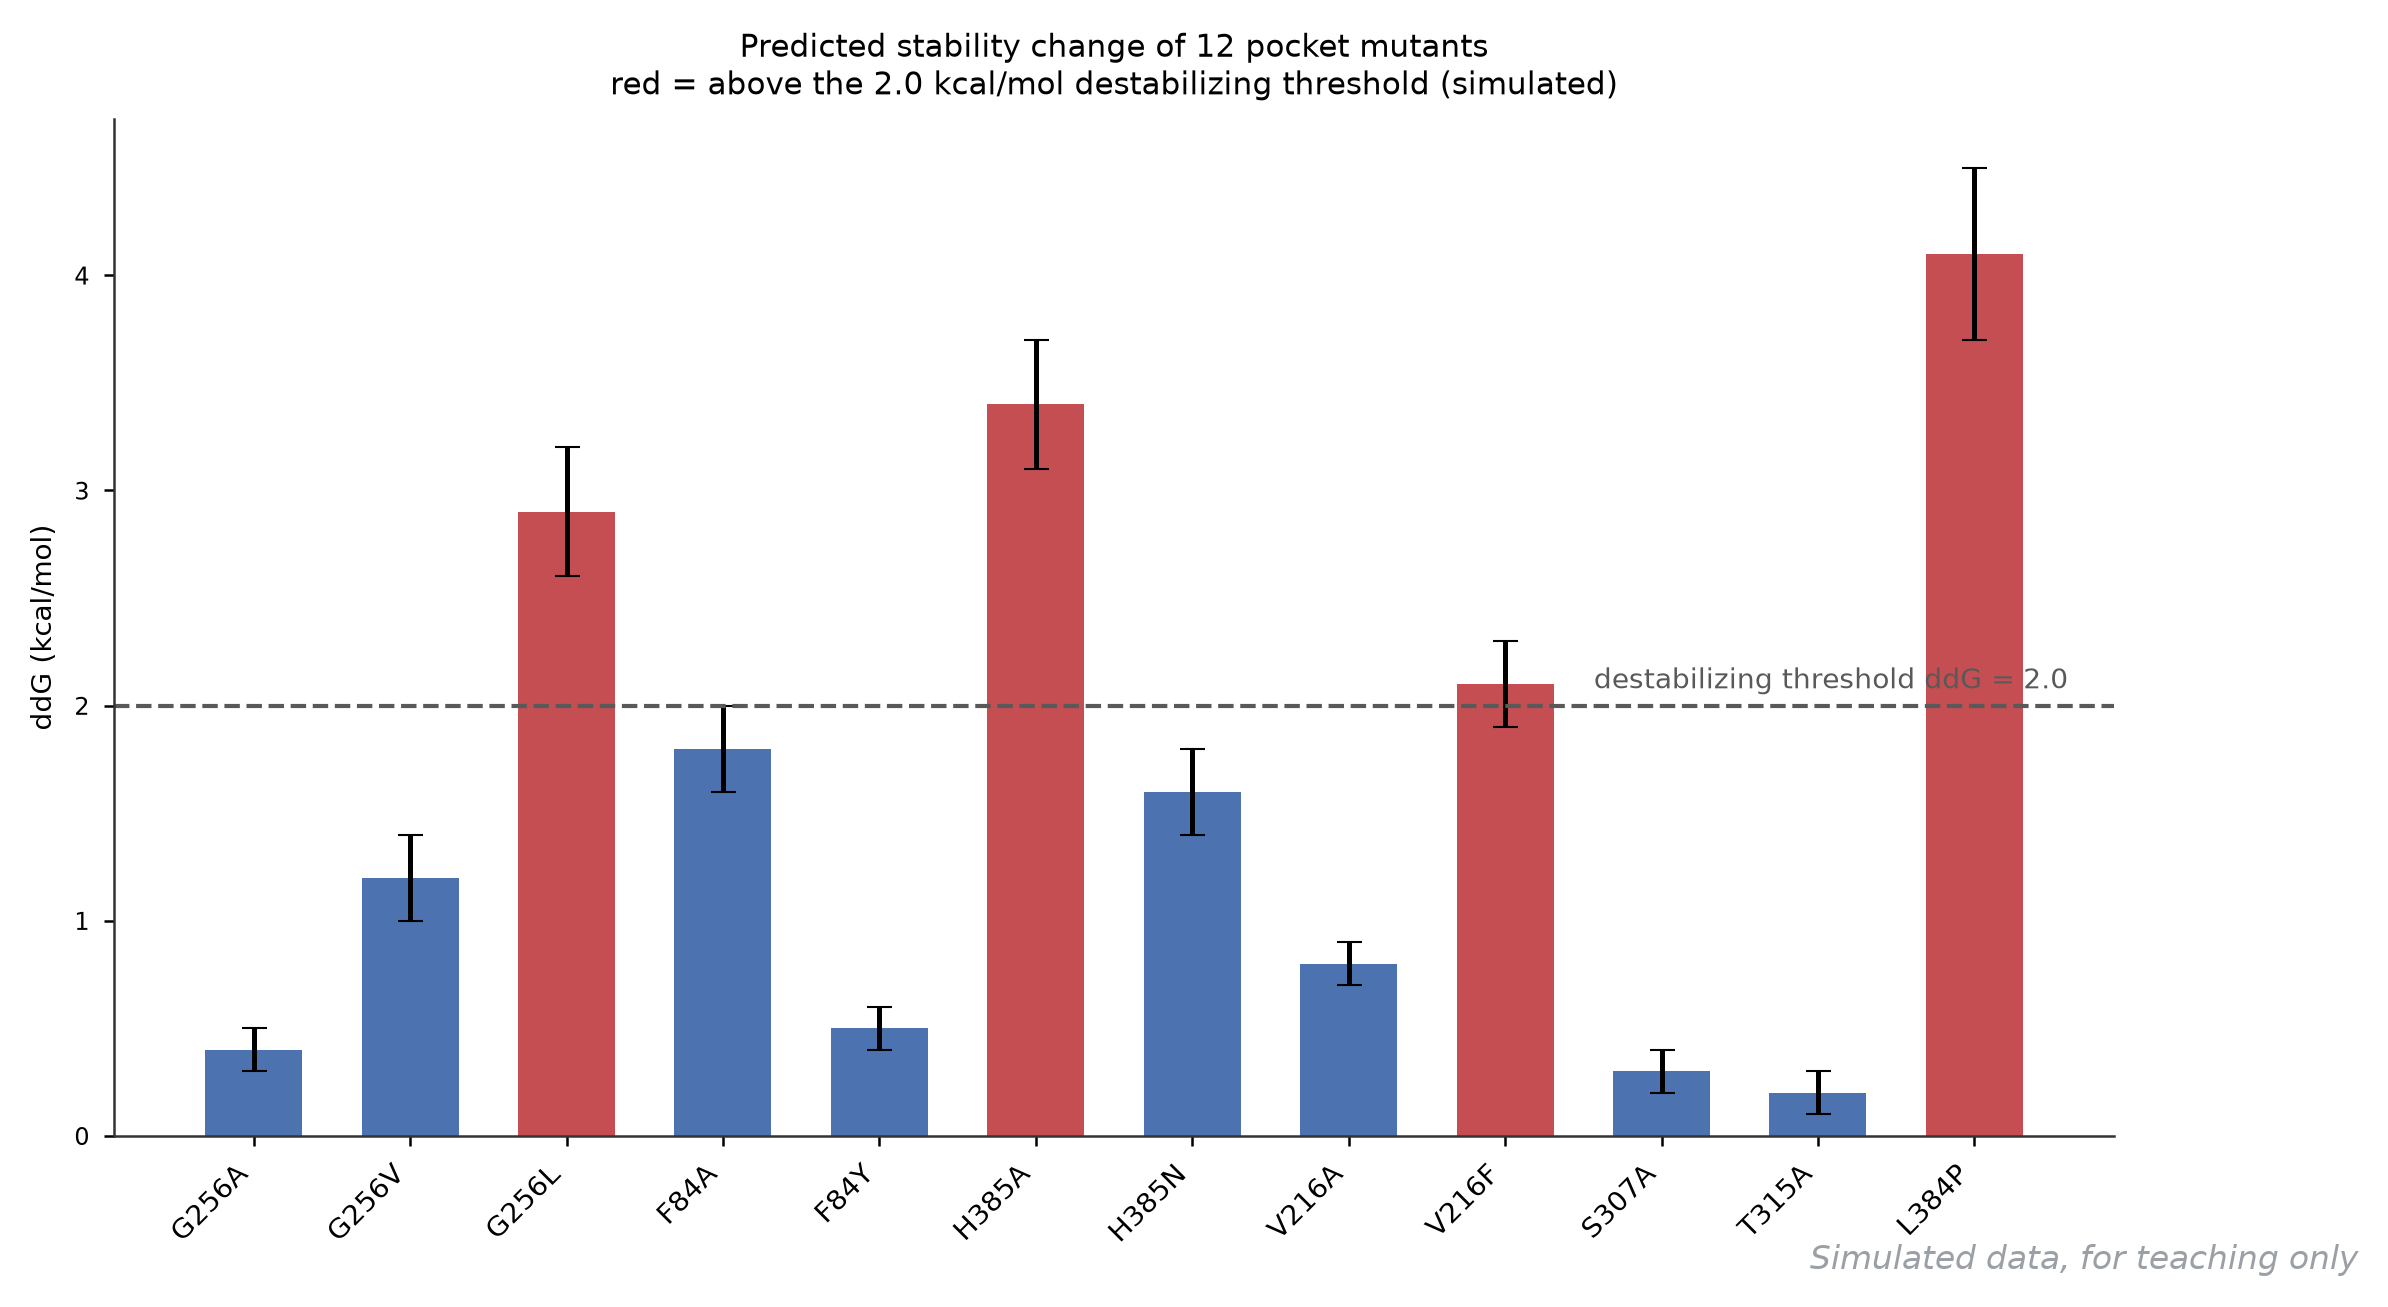
数据:模拟 —— FoldX/Rosetta 风格的稳定性变化值;水印「Simulated data」。
它回答什么问题:突变会不会把蛋白折散——ΔΔG 是”结构与功能”之间最常用的一句话:ΔΔG>2 kcal/mol 通常既失稳又失活。设计突变验证、解释错义突变危害时都要它。
怎么读:每根柱=一个突变体的预测折叠自由能变化(柱顶误差棒=多次建模的标准差),红色=越过 2.0 kcal/mol 失稳阈值。本图 12 个口袋突变里 4 个红:L384P 4.1 > H385A 3.4 > G256L 2.9 > V216F 2.1——Pro 破坏主链最狠、催化组氨酸拆掉配位其次、口袋甘氨酸换亮氨酸紧随其后;S307A/T315A 这类保守替换几乎无感(≤0.3)。ΔΔG 高≠一定失活(有些突变失稳但仍有活性),但”高 ΔΔG+口袋位”是双重红灯。
用什么画:FoldX BuildModel 或 Rosetta ddg_monomer 出表后 bar + 阈值线。
图注示例:
图 148 12 个口袋突变体的预测稳定性变化 ΔΔG(模拟)。误差棒为重复建模标准差;红柱越过 2.0 kcal/mol 失稳阈值(L384P 4.1、H385A 3.4、G256L 2.9、V216F 2.1),保守替换(S307A、T315A)ΔΔG ≤ 0.3。
展开查看:ΔΔG 数据与绘图代码
mutant,ddG_kcal_mol,se
G256A,0.4,0.1
G256V,1.2,0.2
G256L,2.9,0.3
F84A,1.8,0.2
F84Y,0.5,0.1
H385A,3.4,0.3
H385N,1.6,0.2
V216A,0.8,0.1
V216F,2.1,0.2
S307A,0.3,0.1
T315A,0.2,0.1
L384P,4.1,0.4绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rows = [ln.split(",") for ln in open("148-ddg.csv").read().splitlines()[1:]]
mut = [r[0] for r in rows]
v = np.array([float(r[1]) for r in rows])
e = np.array([float(r[2]) for r in rows])
fig, ax = plt.subplots(figsize=(8.6, 4.4))
ax.bar(range(len(mut)), v, yerr=e, capsize=3, width=0.62,
       color=np.where(v > 2.0, "#C44E52", "#4C72B0"))
ax.axhline(2.0, ls="--", color="0.35", lw=1)
ax.set_xticks(range(len(mut)), mut, rotation=45, ha="right", fontsize=8.5)
ax.set_ylabel("ddG (kcal/mol)")
fig.savefig("148-ddg-bars.png", dpi=200, bbox_inches="tight")4.7 二级结构注释轨道图(149)#
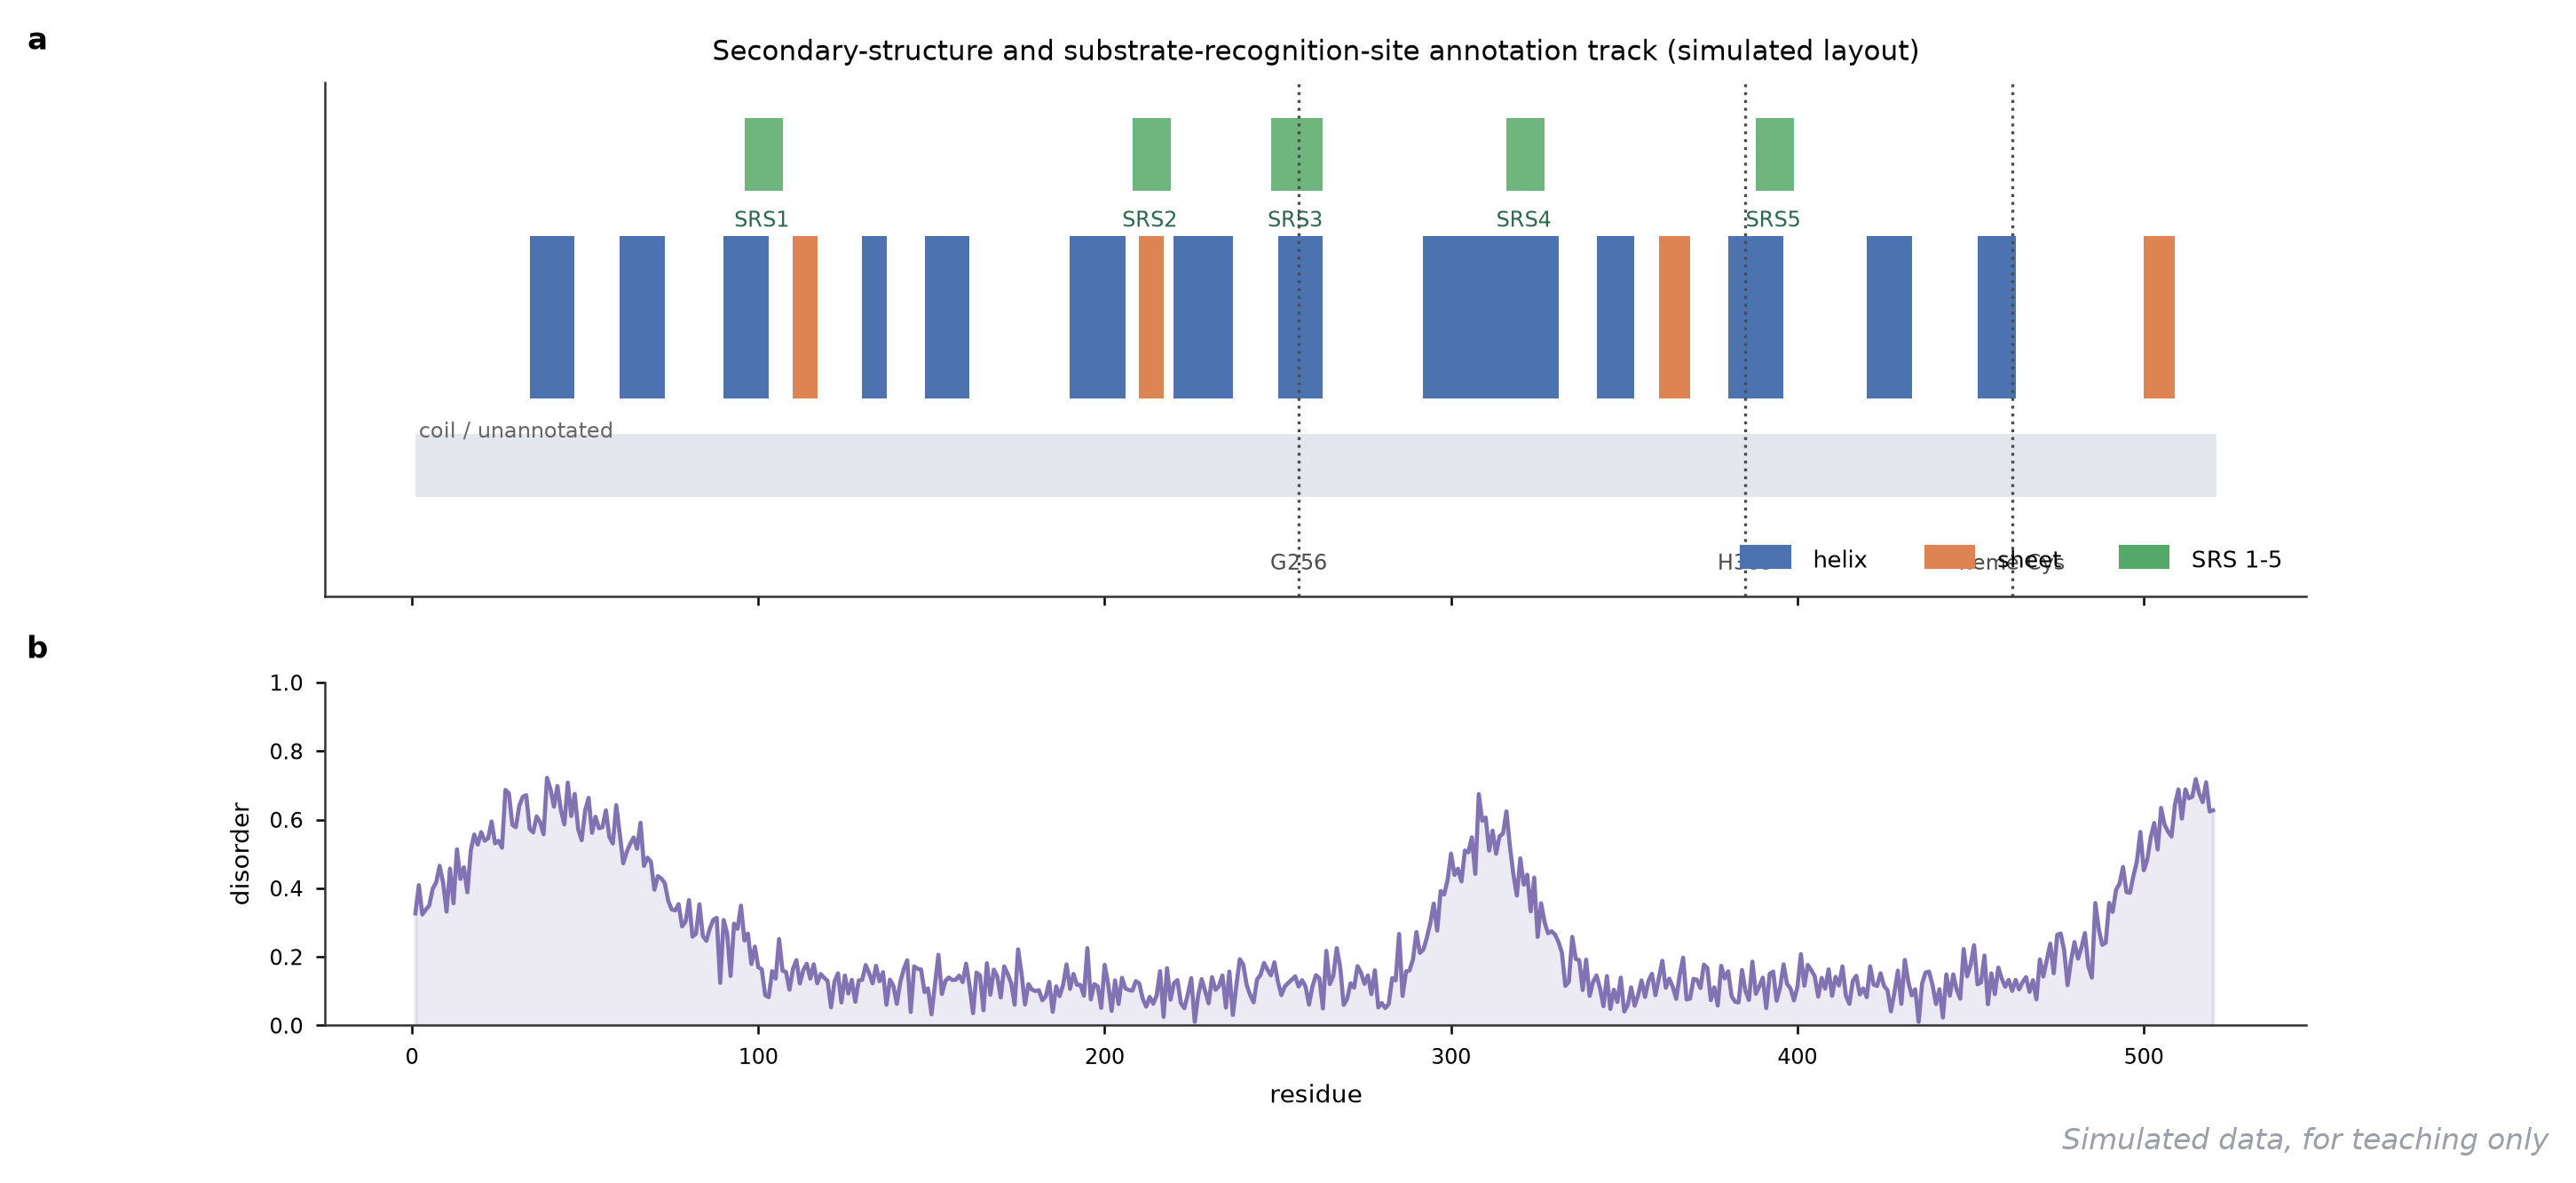
数据:模拟布局(P450 家族典型拓扑的示意排布);水印「Simulated data」。
它回答什么问题:把”哪个残基在哪个螺旋/折叠上、SRS 底物识别环在哪”铺成一条可扫视的轨道——相当于把基因组浏览器思路搬到蛋白序列上,突变、保守性、置信度都可以往上叠。
怎么读:上轨道:蓝块=α 螺旋(按 P450 命名 A-L,含标志性的 I 螺旋 292-330)、橙块=β 折叠;绿色一排是 SRS1-SRS5(底物识别位点);下方浅灰=未注释线圈;三个虚线标记是口袋位点 G256(正好压在 G 螺旋/SRS3 上)、H385(K’ 螺旋/SRS5)与血红素 Cys 铰链区。下轨道是无序倾向(模拟值):N 端约 40 处最高 0.71,301-321 环与 C 端各有一个 0.5 上上的峰——与 143 PAE 里那段亮条互为印证。
用什么画:broken_barh/Rectangle 画块,下方面板画无序概率线;数据结构就是一张 start,end,type 表。
图注示例:
图 149 蛋白二级结构与 SRS 注释轨道(模拟布局示意)。蓝/橙块为 α 螺旋/β 折叠,绿色为底物识别位点 SRS1-5;虚线标记 G256(G 螺旋/SRS3)、H385(K’ 螺旋/SRS5)与血红素 Cys 铰链;下轨为无序倾向(N 端 0.71 最高)。
展开查看:注释段表与绘图代码
start,end,type,label
34,46,helix,A
60,72,helix,B
90,102,helix,B'
110,116,sheet,b1
130,136,helix,C
148,160,helix,D
190,205,helix,E
210,216,sheet,b2
220,236,helix,F
250,262,helix,G
292,330,helix,I
342,352,helix,J
360,368,sheet,b3
380,395,helix,K'
420,432,helix,meander
452,462,helix,heme loop
500,508,sheet,b4start,end,label
96,106,SRS1
208,218,SRS2
248,262,SRS3
316,326,SRS4
388,398,SRS5绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

N = 520
x = np.arange(1, N + 1)
dis = np.clip(0.12 + 0.5 * np.exp(-((x - 40) / 45.0) ** 2)
              + 0.45 * np.exp(-((x - 311) / 16.0) ** 2)
              + 0.55 * np.exp(-((x - 516) / 26.0) ** 2), 0.01, 0.98)
fig, (ax, ax2) = plt.subplots(2, 1, figsize=(9.6, 4.6), sharex=True)
for s, e, c in [(34, 46, "#4C72B0"), (60, 72, "#4C72B0"),
                (90, 102, "#4C72B0"), (292, 330, "#4C72B0"),
                (250, 262, "#4C72B0"), (380, 395, "#4C72B0"),
                (110, 116, "#DD8452"), (210, 216, "#DD8452")]:
    ax.add_patch(Rectangle((s, 0.32), e - s + 1, 0.36, color=c, lw=0))
for k, (s, e) in enumerate([(96, 106), (208, 218), (248, 262),
                            (316, 326), (388, 398)]):
    ax.add_patch(Rectangle((s, 0.78), e - s + 1, 0.16, color="#55A868", lw=0))
    ax.text((s + e) / 2, 0.70, "SRS%d" % (k + 1), ha="center",
            fontsize=7.5, color="#2d6a4f")
for p, lab in [(256, "G256"), (385, "H385"), (462, "heme Cys")]:
    ax.axvline(p, color="0.3", lw=0.8, ls=":")
ax.set_yticks([])
ax.set_ylim(-0.12, 1.02)
ax2.plot(x, dis, color="#8172B3", lw=1.1)
ax2.set_ylabel("disorder")
ax2.set_xlabel("residue")
fig.savefig("149-ss-track.png", dpi=200, bbox_inches="tight")五、从口袋到功能(150-155)#
5.1 口袋定位图(150)#
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),水印「Real structure data: PDB 6A15」。
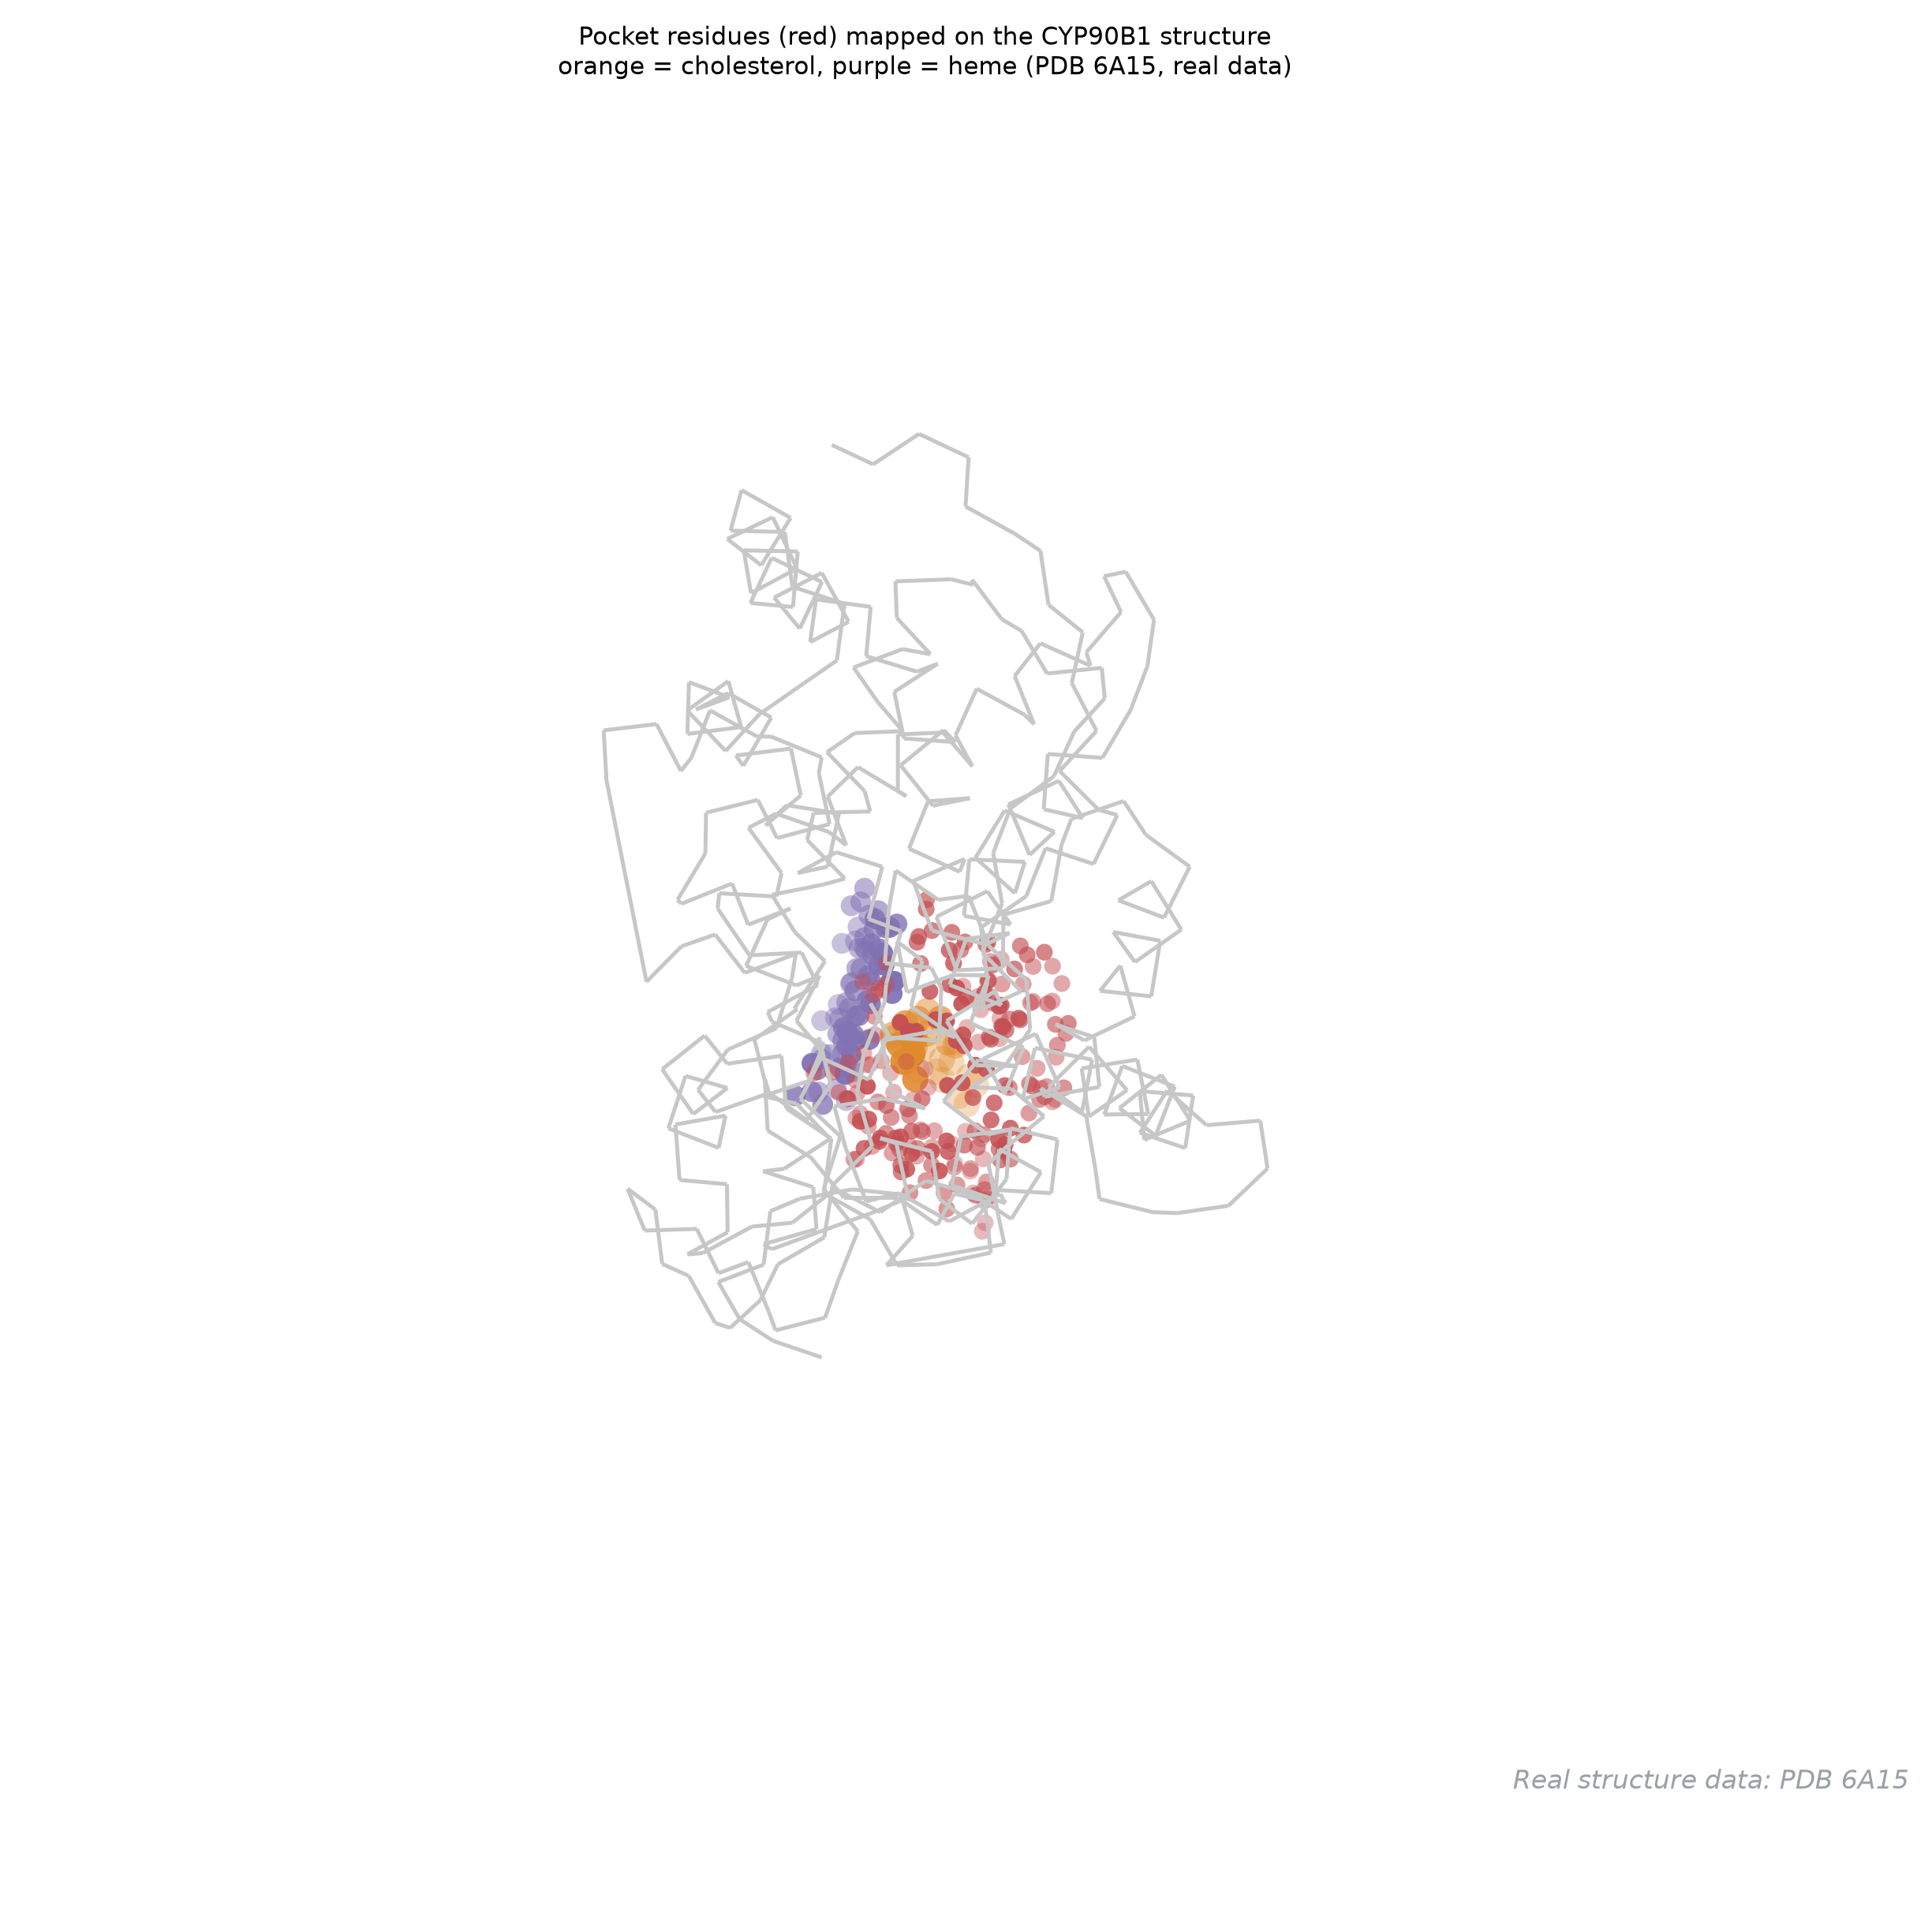
它回答什么问题:口袋在蛋白全局的哪个位置——136 是钻进口袋里看,这张退出来看全局:灰轨迹是全酶骨架,红点是 23 个口袋残基,橙/紫大球是胆固醇与血红素。
怎么读:红点聚成一个壳包住橙色胆固醇——口袋是内埋型而不是表面凹坑(对比 137 球状模型从外面几乎看不到胆固醇)。血红素(紫)紧邻口袋但位置独立。这类图适合放进课题汇报第一页:“我们讨论的口袋在这里”。
用什么画:全局 CA 轨迹灰线 + 口袋原子红色散点 + 配体大球三层叠加;PyMOL 同理(surface+sticks+spheres)。
图注示例:
图 150 CYP90B1 底物口袋的全局定位(真实数据,PDB 6A15)。灰线为 C-alpha 轨迹,红点为 23 个口袋残基(距胆固醇 ≤5 Å),橙球为胆固醇、紫球为血红素;口袋为内埋型,位于螺旋篮核心。
展开查看:三层叠加绘图代码
绘图代码(接图 134 的 parse();残基筛选同图 136)
import numpy as np

atoms = parse("6a15.pdb")
lig = np.array([a["xyz"] for a in atoms
                if a["het"] and a["resn"] == "CLR"])
heme = np.array([a["xyz"] for a in atoms
                 if a["het"] and a["resn"] == "HEM"])
pa = [a for a in atoms if a["chain"] == "A" and not a["het"]]
byres = {}
for a in pa:
    byres.setdefault(a["resi"], []).append(a)
pk = []
for ri, lst in byres.items():
    X = np.array([a["xyz"] for a in lst])
    if np.linalg.norm(X[:, None, :] - lig[None, :, :],
                      axis=-1).min() <= 5.0:
        pk += lst
P = np.array([a["xyz"] for a in pa if a["name"] == "CA"])
X = np.array([a["xyz"] for a in pk])
fig = plt.figure(figsize=(8.4, 6.8))
ax = fig.add_subplot(projection="3d")
ax.view_init(elev=16, azim=-96)
ax.set_axis_off()
ax.set_box_aspect((1, 1, 1))
pts = np.concatenate([P[:-1, None, :], P[1:, None, :]], axis=1)
ax.add_collection3d(Line3DCollection(pts, colors="0.78", linewidths=1.2))
ax.scatter(X[:, 0], X[:, 1], X[:, 2], s=26, c="#C44E52", linewidths=0)
ax.scatter(lig[:, 0], lig[:, 1], lig[:, 2], s=64, c="#e08a2e", linewidths=0)
ax.scatter(heme[:, 0], heme[:, 1], heme[:, 2], s=40, c="#8172B3",
           linewidths=0)
fig.savefig("150-pocket-map.png", dpi=200, bbox_inches="tight")5.2 口袋体积条形图(151)#
数据:模拟 —— CASTp 风格的口袋体积测量值;水印「Simulated data」。
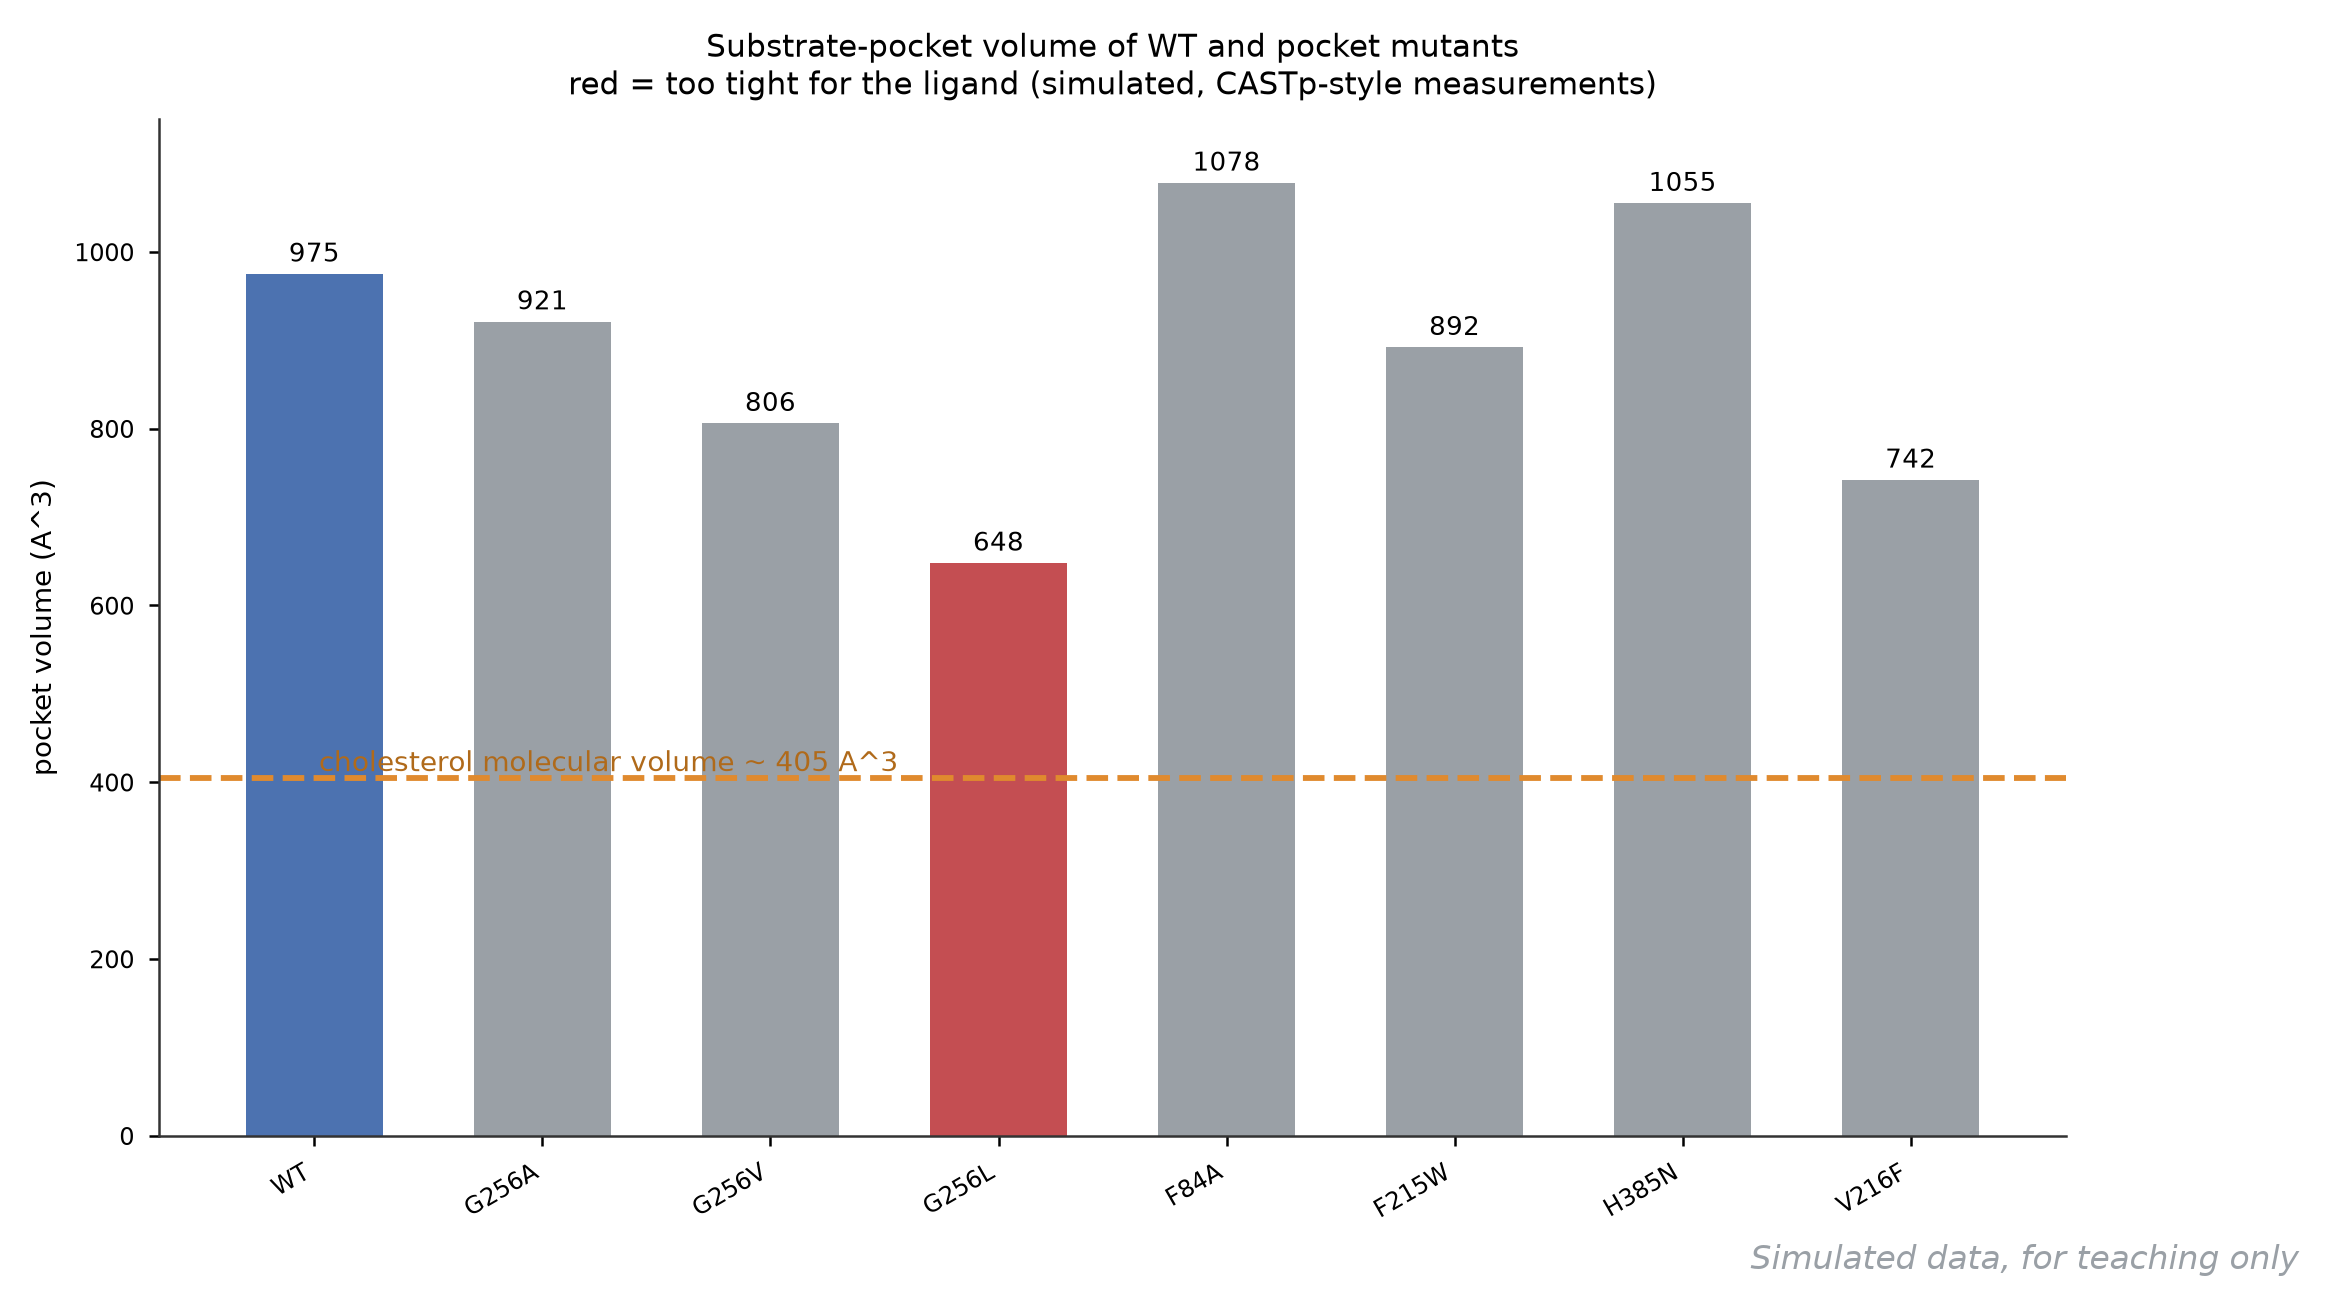
它回答什么问题:突变后口袋还装得下底物吗——把 140 的肉眼对比变成一个数。口袋体积 < 配体分子体积的约 1.7 倍(要给配体留结合水层与进入路径),底物就进不去了。
怎么读:横轴野生型与 7 个口袋突变,纵轴口袋体积(ų),橙色虚线是胆固醇分子体积约 405 ų(参考线),红色柱=体积跌破 700 ų 的”装不下”区。WT 975 ų 从容;G256 系列逐级收窄:G256A 921 → G256V 806 → G256L 648——甘氨酸越小,换成大侧链挤占越多,与 140/145 的 G256L 案例严丝合缝;反而”删侧链”的 F84A/H385N 把口袋撑大(1078/1055)。
用什么画:CASTp/fpocket 批量测量出表后 bar + 配体体积参考线。
图注示例:
图 151 野生型与 7 个口袋突变体的底物口袋体积(模拟,CASTp 风格测量)。橙色虚线为胆固醇分子体积(约 405 ų);G256 系列体积随侧链增大递减(G256A 921、G256V 806、G256L 648 ų),G256L 与 V216F(742 ų)低于 700 ų 的可结合下限(红)。
展开查看:口袋体积数据与绘图代码
variant,pocket_volume_A3
WT,975
G256A,921
G256V,806
G256L,648
F84A,1078
F215W,892
H385N,1055
V216F,742绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rows = [ln.split(",") for ln in open("151-pocket-volume.csv").read().splitlines()[1:]]
labs = [r[0] for r in rows]
v = np.array([float(r[1]) for r in rows])
cols = ["#4C72B0" if l == "WT" else ("#C44E52" if x < 700 else "#9AA0A6")
        for l, x in zip(labs, v)]
fig, ax = plt.subplots(figsize=(8.2, 4.4))
ax.bar(range(len(v)), v, color=cols, width=0.6)
ax.axhline(405, ls="--", color="#e08a2e", lw=1.4)
ax.set_xticks(range(len(v)), labs, rotation=30, ha="right")
ax.set_ylabel("pocket volume (A^3)")
ax.set_ylim(0, 1150)
fig.savefig("151-pocket-volume.png", dpi=200, bbox_inches="tight")5.3 序列保守性剖面(152)#
数据:模拟值 + 真实位点 —— 保守度曲线为模拟;红点标出的 23 个口袋残基位置来自图 136 的真实计算(PDB 6A15),水印「Simulated data」。
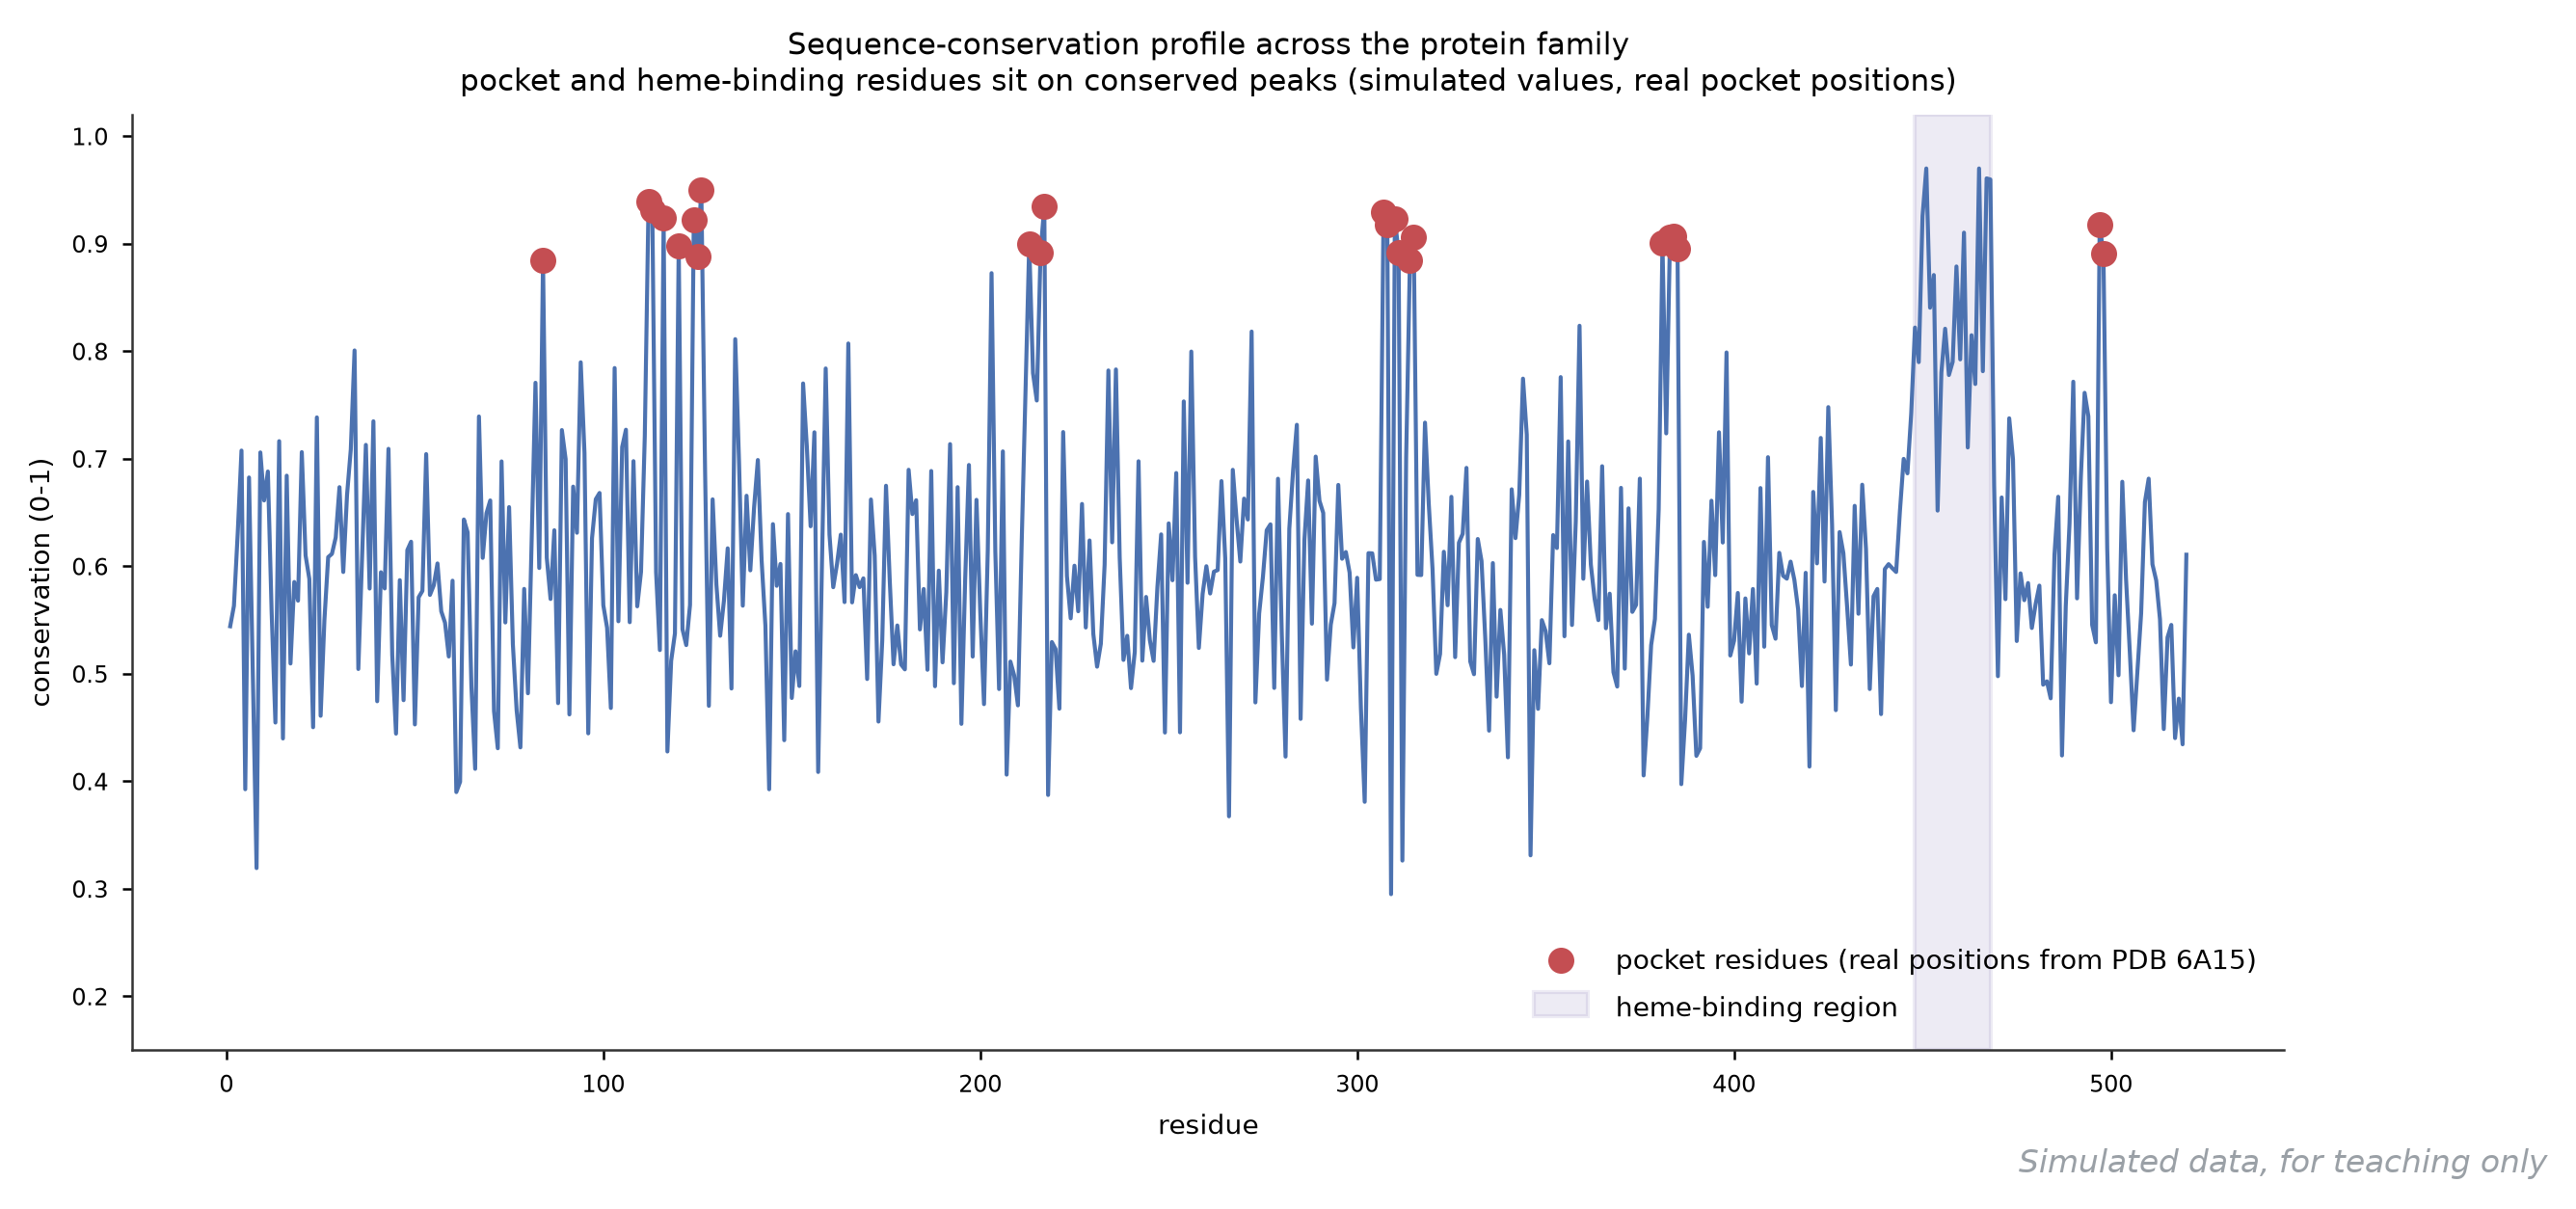
它回答什么问题:进化有没有盯紧这个口袋——催化位点与底物口袋残基在多序列比对里几乎不变,“口袋残基=高保守”是功能位点的第一证据。
怎么读:横轴残基,纵轴保守度(0-1)。背景曲线 0.4-0.7 起伏(模拟),23 个红点(真实口袋位点)全部落在 0.88-0.95 的高位;紫色带是血红素结合区 448-468,整段抬升。读图纪律:先看红点是不是系统性高于背景(是→口袋受纯化选择),再看个别低谷(可能是允许漂变的环)。
用什么画:ConSurf/ jalview 出分后画线+散点;红点位置直接用 136 的口袋残基表。
图注示例:
图 152 蛋白多序列比对的逐残基保守性剖面(模拟值;红点位置为图 136 计算的 23 个真实口袋残基)。口袋残基保守度全部 ≥0.88(背景 0.4-0.7);血红素结合区 448-468(紫带)整体抬升。
展开查看:保守性数据(节选)与绘图代码
residue,conservation
5,0.39
45,0.44
85,0.61
125,0.89
165,0.81
205,0.49
245,0.53
285,0.46
325,0.66
365,0.69
405,0.58
445,0.70
485,0.61pocket_residue,conservation
84,0.88
112,0.94
113,0.93
116,0.92
120,0.90
124,0.92
125,0.89
126,0.95
213,0.90
216,0.89
217,0.93
307,0.93
308,0.92
310,0.92
311,0.89
314,0.88
315,0.91
381,0.90
383,0.91
384,0.91
385,0.90
497,0.92
498,0.89绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rng = np.random.default_rng(5152)
N = 520
POCKET = [84, 112, 113, 116, 120, 124, 125, 126, 213, 216, 217, 307,
          308, 310, 311, 314, 315, 381, 383, 384, 385, 497, 498]
x = np.arange(1, N + 1)
cons = np.clip(0.58 + rng.normal(0, 0.10, N), 0.25, 0.9)
cons[np.array(POCKET) - 1] = 0.90
cons[(x >= 448) & (x <= 468)] += 0.25
fig, ax = plt.subplots(figsize=(9.6, 4.2))
ax.plot(x, cons, color="#4C72B0", lw=1.0)
ax.scatter(POCKET, cons[np.array(POCKET) - 1], s=30, color="#C44E52",
           zorder=3)
ax.axvspan(448, 468, color="#8172B3", alpha=0.14)
ax.set_xlabel("residue")
ax.set_ylabel("conservation (0-1)")
fig.savefig("152-conservation.png", dpi=200, bbox_inches="tight")5.4 分子对接位姿与打分图(153)#
数据:模拟 —— AutoDock Vina 风格的打分与位姿;水印「Simulated data」。
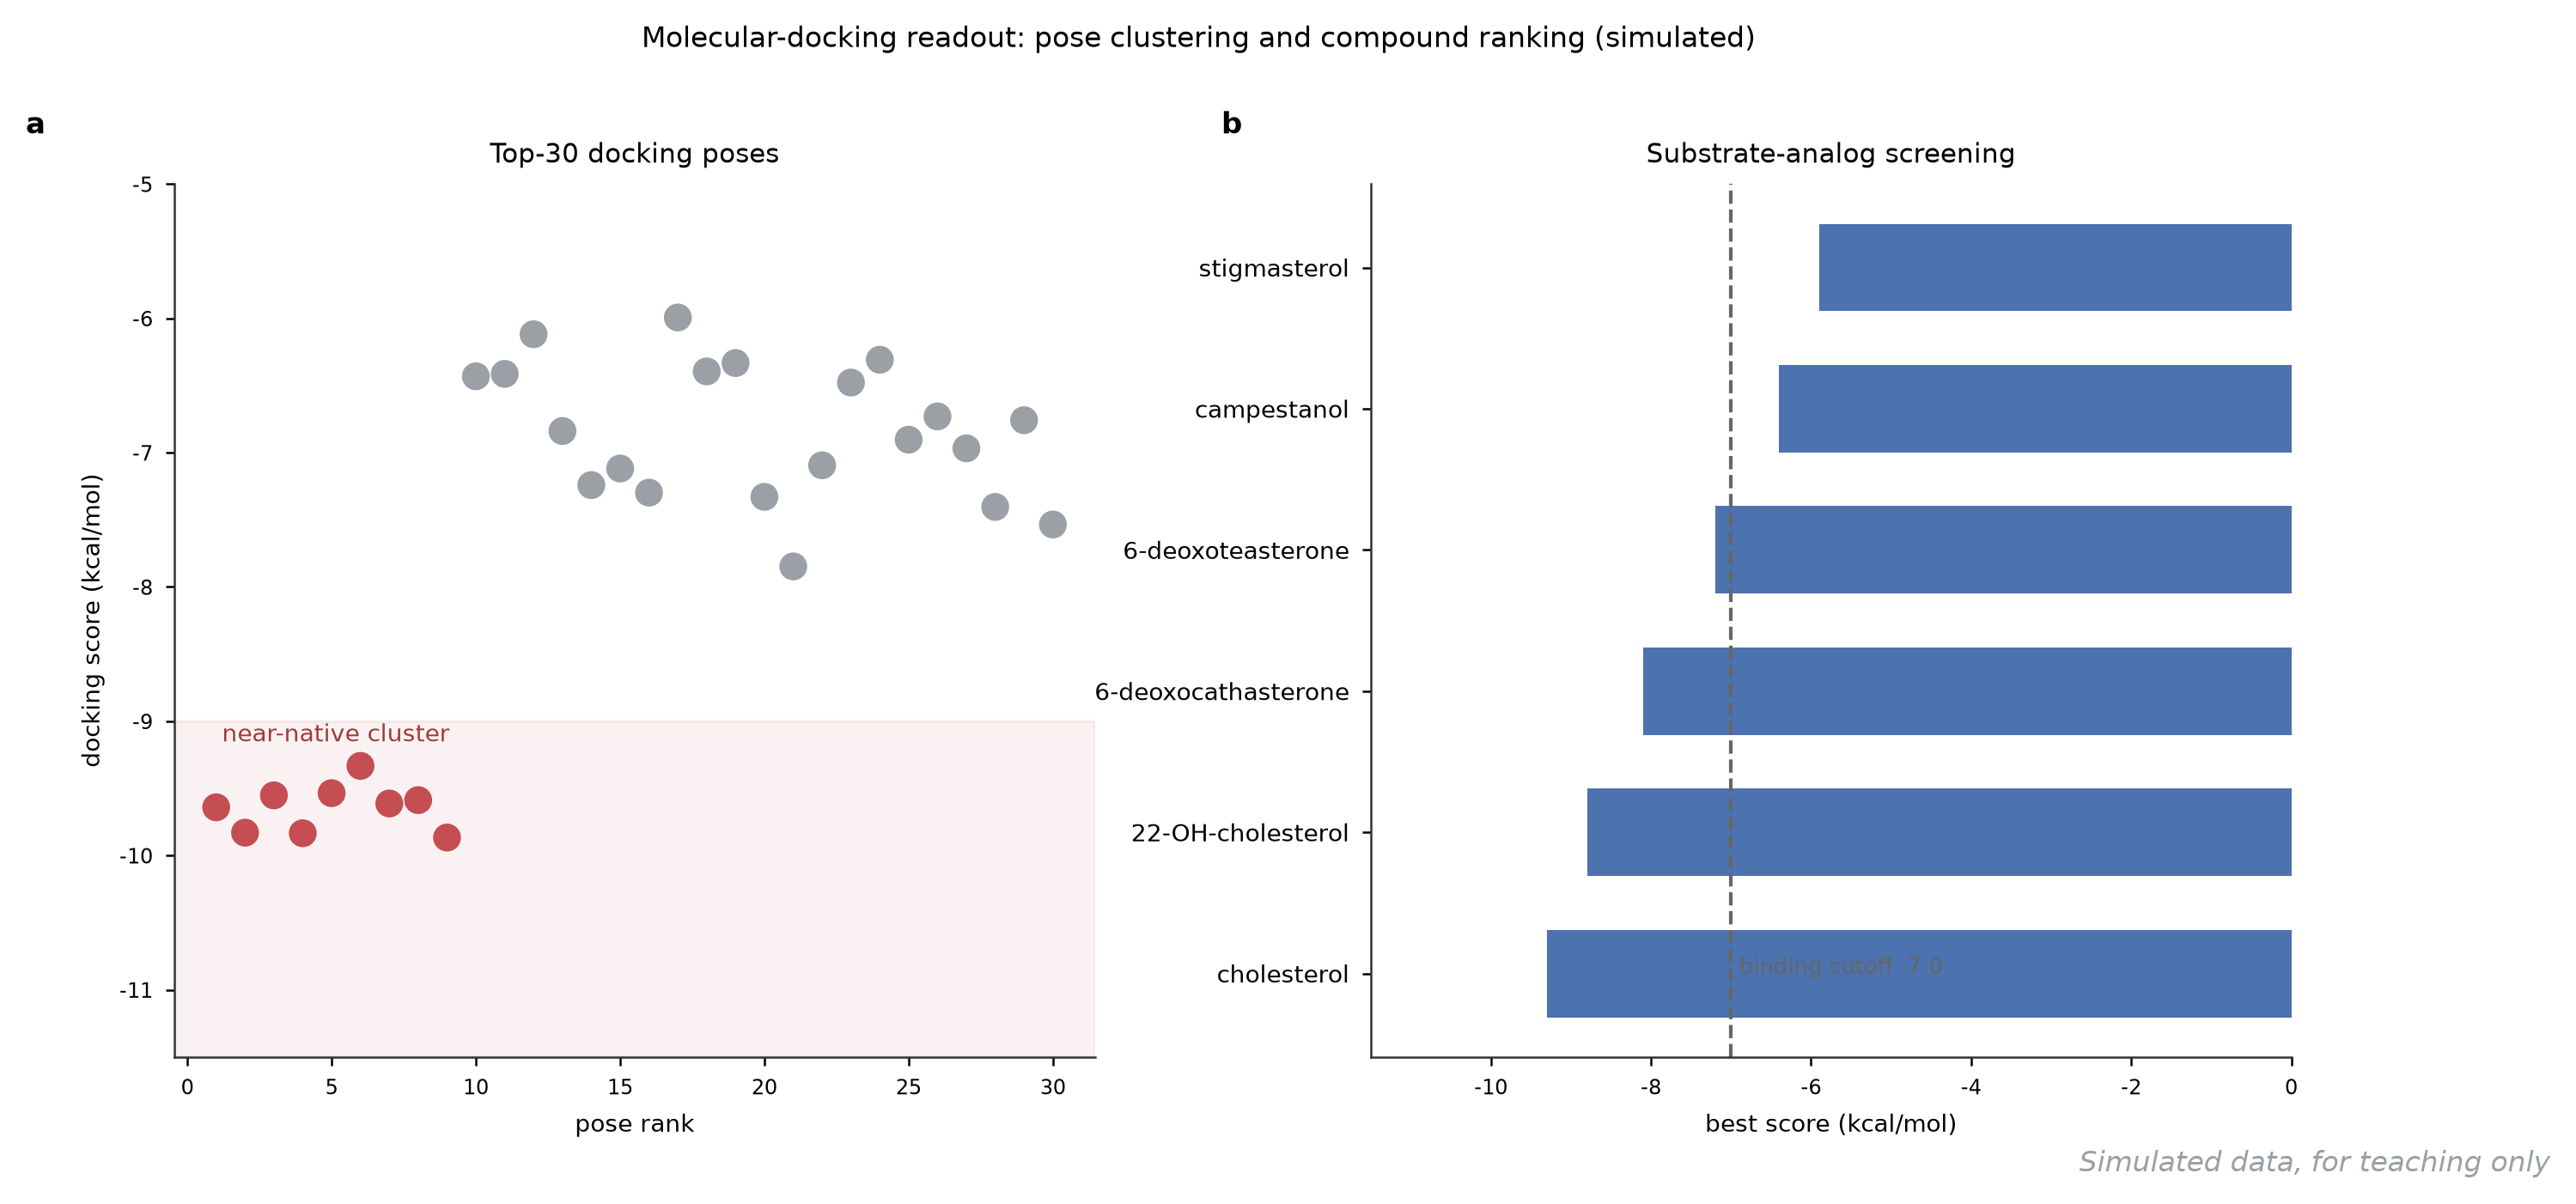
它回答什么问题:一堆候选分子谁能进口袋、最佳姿势长什么样——虚拟筛选的两张标准汇报图:位姿聚类(左)与化合物排行(右)。
怎么读:左图 30 个对接位姿按打分排序,红色位姿 1-9 组成”近天然簇”:RMSD 0.83-1.46 Å、打分 -9.3 至 -9.9 kcal/mol,灰色位姿 RMSD 2.8-7.1 Å 且打分明显差——好对接的标志是头部位姿聚成一个低 RMSD、好打分的簇,而不是”运气最好的一根高柱”。右图 6 个甾醇类似物排行:胆固醇 -9.3 最好,22-OH-胆固醇 -8.8、6-脱氧栗甾酮 -8.1、6-脱氧茶甾酮 -7.2 依次通过 -7.0 结合阈值线;菜甾烷醇 -6.4 与豆甾醇 -5.9 不过线。注意打分是相对排序工具,绝对值别当结合自由能引用。
用什么画:Vina/GNINA 输出位姿表与打分表,双面板 scatter+barh。
图注示例:
图 153 分子对接汇总(模拟)。左:前 30 位姿的打分,位姿 1-9 构成近天然簇(RMSD 0.83-1.46 Å,打分 -9.9 至 -9.3 kcal/mol,红);右:6 个底物类似物最佳打分,-7.0 kcal/mol 阈值线(虚线)以上 4 个化合物通过,胆固醇(-9.3)居首。
展开查看:位姿与化合物打分表及绘图代码
pose,rmsd_A,score_kcal_mol
1,0.83,-9.64
2,0.95,-9.83
3,1.09,-9.55
4,1.19,-9.83
5,1.46,-9.54
6,0.87,-9.33
7,0.91,-9.61
8,0.87,-9.59
9,1.03,-9.87
10,2.82,-6.43
11,7.09,-6.41
12,3.26,-6.12
13,6.77,-6.84
14,4.35,-7.24
15,3.59,-7.12
16,4.59,-7.30
17,5.92,-5.99
18,5.17,-6.39
19,5.84,-6.33
20,6.80,-7.33
21,4.25,-7.85
22,3.71,-7.09
23,5.07,-6.48
24,5.43,-6.31
25,5.96,-6.90
26,3.94,-6.73
27,4.53,-6.97
28,5.83,-7.40
29,3.99,-6.76
30,4.08,-7.53compound,score_kcal_mol
cholesterol,-9.3
22-OH-cholesterol,-8.8
6-deoxocathasterone,-8.1
6-deoxoteasterone,-7.2
campestanol,-6.4
stigmasterol,-5.9绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

P = np.genfromtxt("153-docking-poses.csv", delimiter=",", names=True)
C = np.genfromtxt("153-docking-compounds.csv", delimiter=",", names=True,
                  dtype=None, encoding="utf8")
fig, (ax, ax2) = plt.subplots(1, 2, figsize=(10.6, 4.4))
cols = np.where(P["rmsd_A"] < 2.5, "#C44E52", "#9AA0A6")
ax.scatter(P["pose"], P["score_kcal_mol"], c=cols, s=46, zorder=3)
ax.axhspan(-11.5, -9.0, color="#C44E52", alpha=0.07)
ax.set_xlabel("pose rank")
ax.set_ylabel("docking score (kcal/mol)")
ax2.barh(range(len(C["compound"])), C["score_kcal_mol"], color="#4C72B0",
         height=0.62)
ax2.set_yticks(range(len(C["compound"])), C["compound"], fontsize=8.5)
ax2.axvline(-7.0, ls="--", color="0.4", lw=1)
ax2.set_xlabel("best score (kcal/mol)")
fig.savefig("153-docking.png", dpi=200, bbox_inches="tight")5.5 界面接触频率热图(154)#
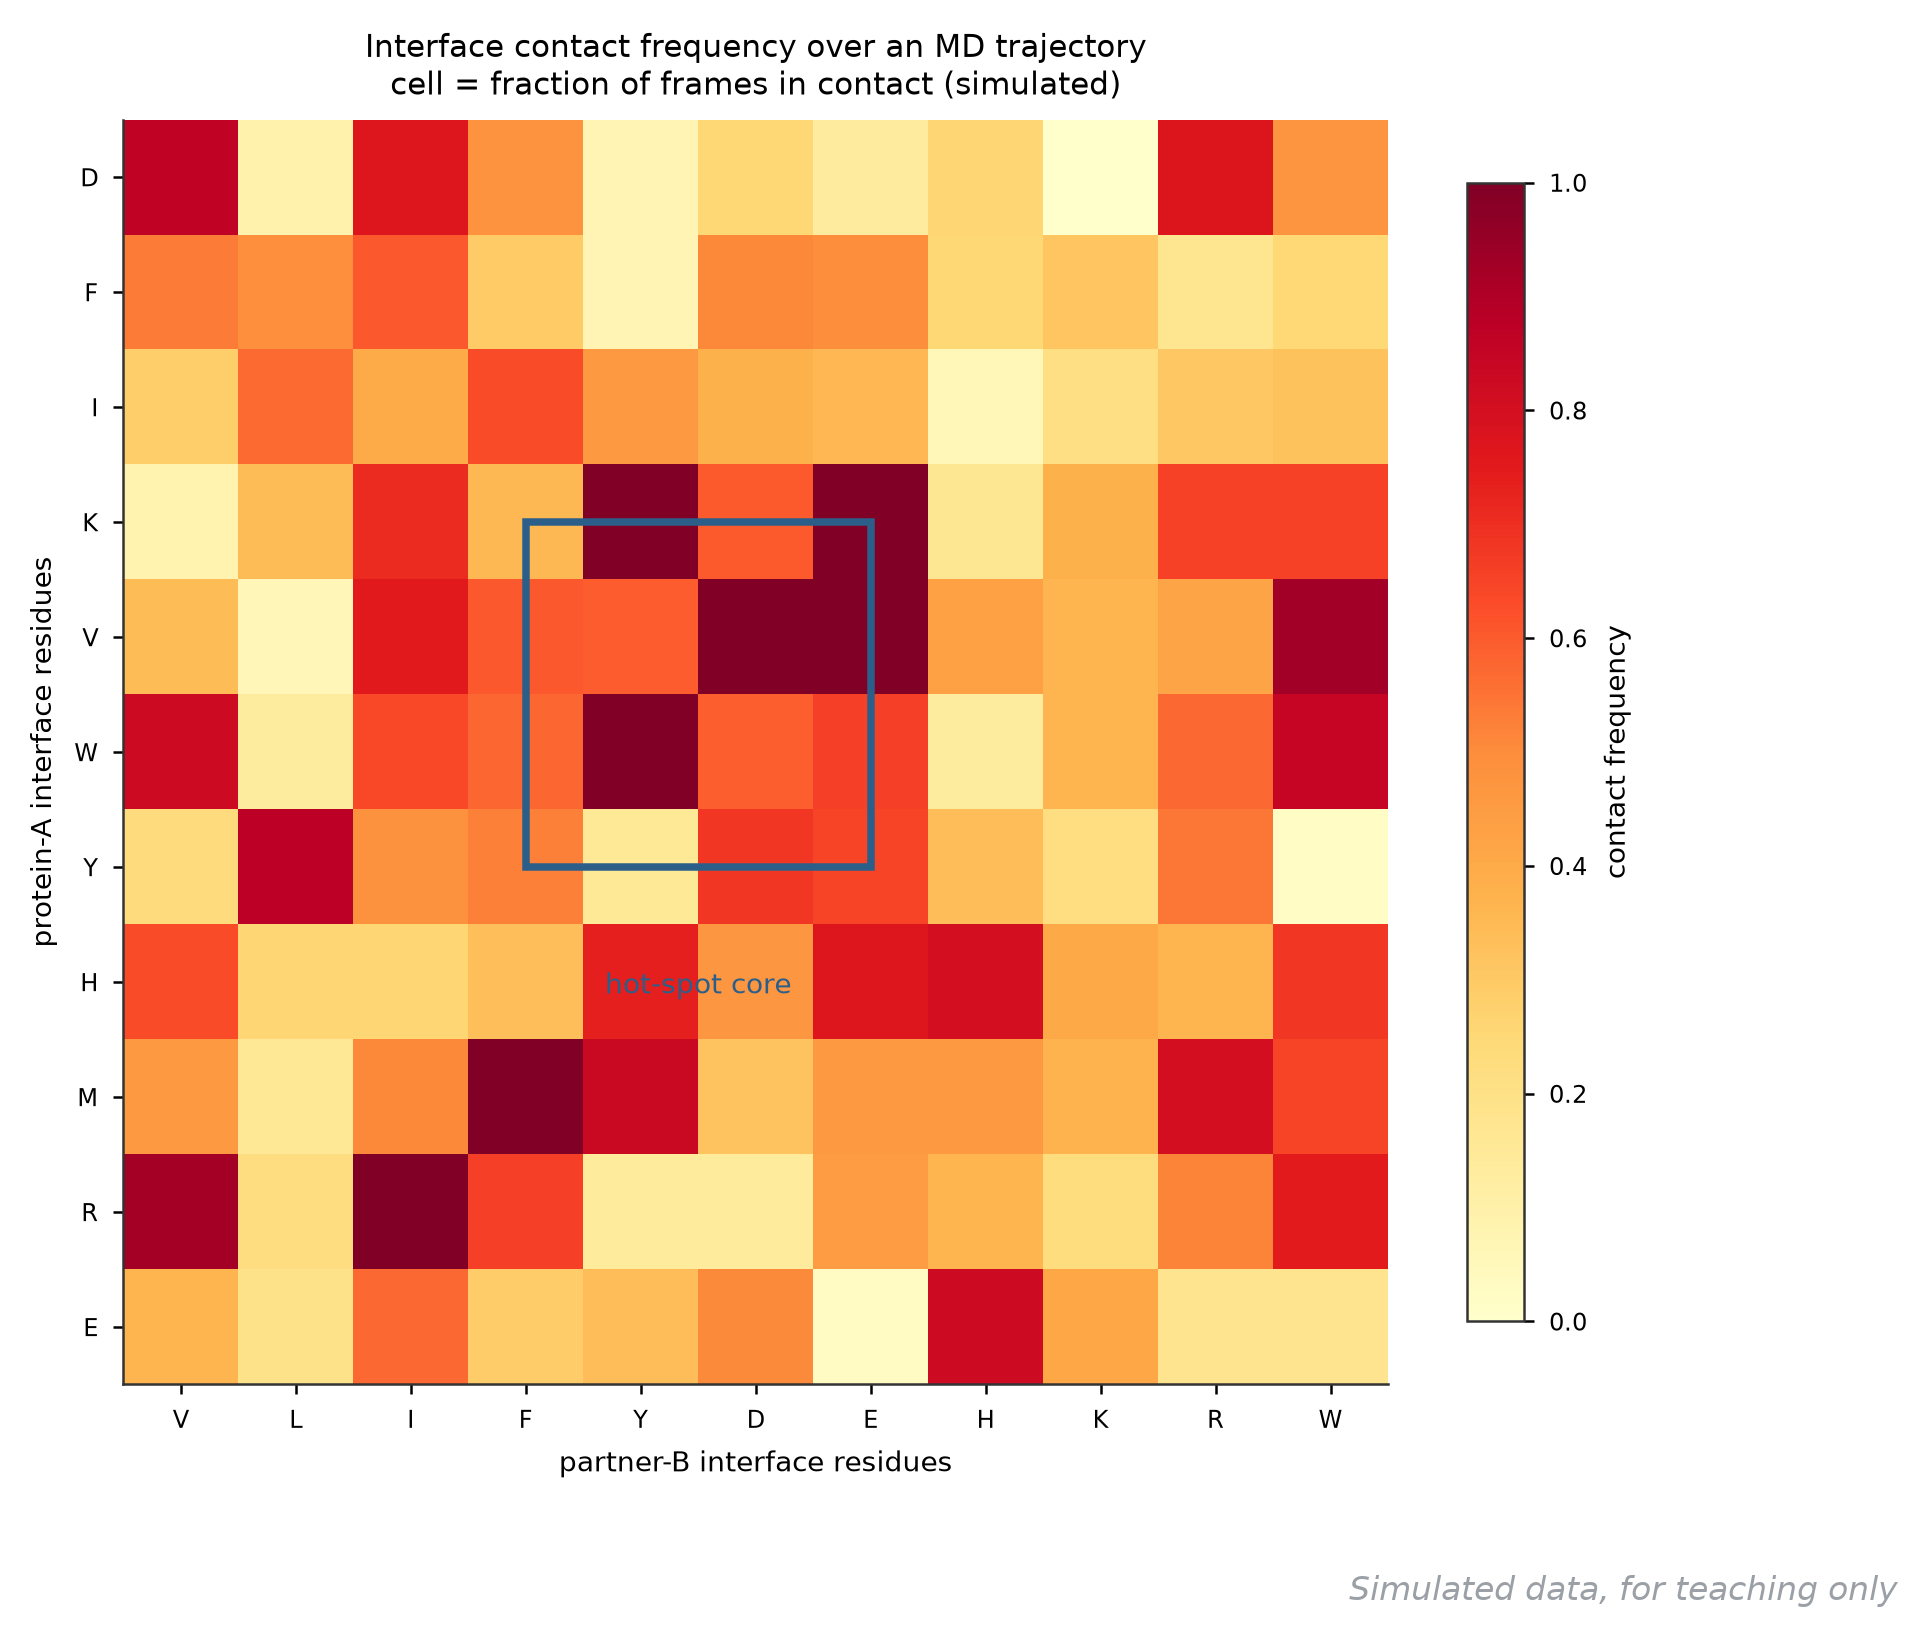
数据:模拟 —— 分子动力学轨迹中界面残基对的接触占比;水印「Simulated data」。
它回答什么问题:蛋白-蛋白界面上哪些残基对真正”焊”在一起——平均结构只能看一帧,接触频率图看整条轨迹,热点残基(hot spot)在这里现形。
怎么读:行=蛋白 A 的 11 个界面残基,列=伙伴蛋白 B 的 12 个,颜色=轨迹中接触的帧占比(1.0=从头粘到尾)。蓝框圈出的 K/V/W × Y/D/E 中心块 0.6-1.0 是热点核心—— Ala 扫描突变打它们,ΔΔG 最大;周边 0.2-0.5 的”边缘带”贡献小、可替换。PPI 抑制剂肽的设计目标就是这块核心。
用什么画:MD 轨迹逐帧算残基对距离 <5 Å 的占比,imshow;GetContacts/MDeepMAcK 都能直接出。
图注示例:
图 154 蛋白-蛋白界面残基对接触频率(模拟,MD 轨迹)。单元格为两残基接触的帧占比;蓝框核心区(K/V/W 行 × Y/D/E 列)频率 0.6-1.0,为界面热点,外围边缘带频率多低于 0.5。
展开查看:接触频率矩阵与绘图代码
A\B,V,L,I,F,Y,D,E,H,K,R,W
D,0.86,0.09,0.77,0.48,0.07,0.25,0.13,0.25,0.00,0.77,0.48
F,0.53,0.49,0.60,0.29,0.07,0.51,0.49,0.25,0.32,0.17,0.25
I,0.28,0.57,0.40,0.63,0.46,0.38,0.36,0.06,0.21,0.31,0.32
K,0.09,0.34,0.71,0.35,1.00,0.60,1.00,0.16,0.38,0.65,0.65
V,0.34,0.06,0.75,0.60,0.60,1.00,1.00,0.43,0.37,0.42,0.93
W,0.82,0.13,0.64,0.58,1.00,0.59,0.66,0.13,0.37,0.57,0.85
Y,0.23,0.87,0.48,0.53,0.15,0.68,0.65,0.34,0.22,0.55,0.02
H,0.63,0.26,0.26,0.34,0.74,0.47,0.77,0.80,0.41,0.36,0.68
M,0.45,0.16,0.51,1.00,0.84,0.32,0.45,0.46,0.37,0.80,0.65
R,0.93,0.22,1.00,0.66,0.14,0.14,0.45,0.36,0.22,0.52,0.75
E,0.36,0.19,0.57,0.29,0.34,0.50,0.03,0.82,0.41,0.18,0.18绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

lines = open("154-interface.csv").read().splitlines()
B = lines[0].split(",")[1:]
A = [ln.split(",")[0] for ln in lines[1:]]
M = np.array([[float(v) for v in ln.split(",")[1:]] for ln in lines[1:]])
fig, ax = plt.subplots(figsize=(6.8, 5.8))
im = ax.imshow(M, cmap="YlOrRd", vmin=0, vmax=1)
ax.add_patch(Rectangle((3.5, 2.5), 3, 3, fill=False, ec="#2b5f8a", lw=1.8))
ax.set_xticks(range(len(B)), B)
ax.set_yticks(range(len(A)), A)
fig.colorbar(im, ax=ax, shrink=0.85, label="contact frequency")
fig.savefig("154-interface-contacts.png", dpi=200, bbox_inches="tight")5.6 逐残基溶剂可及面积 SASA(155)#
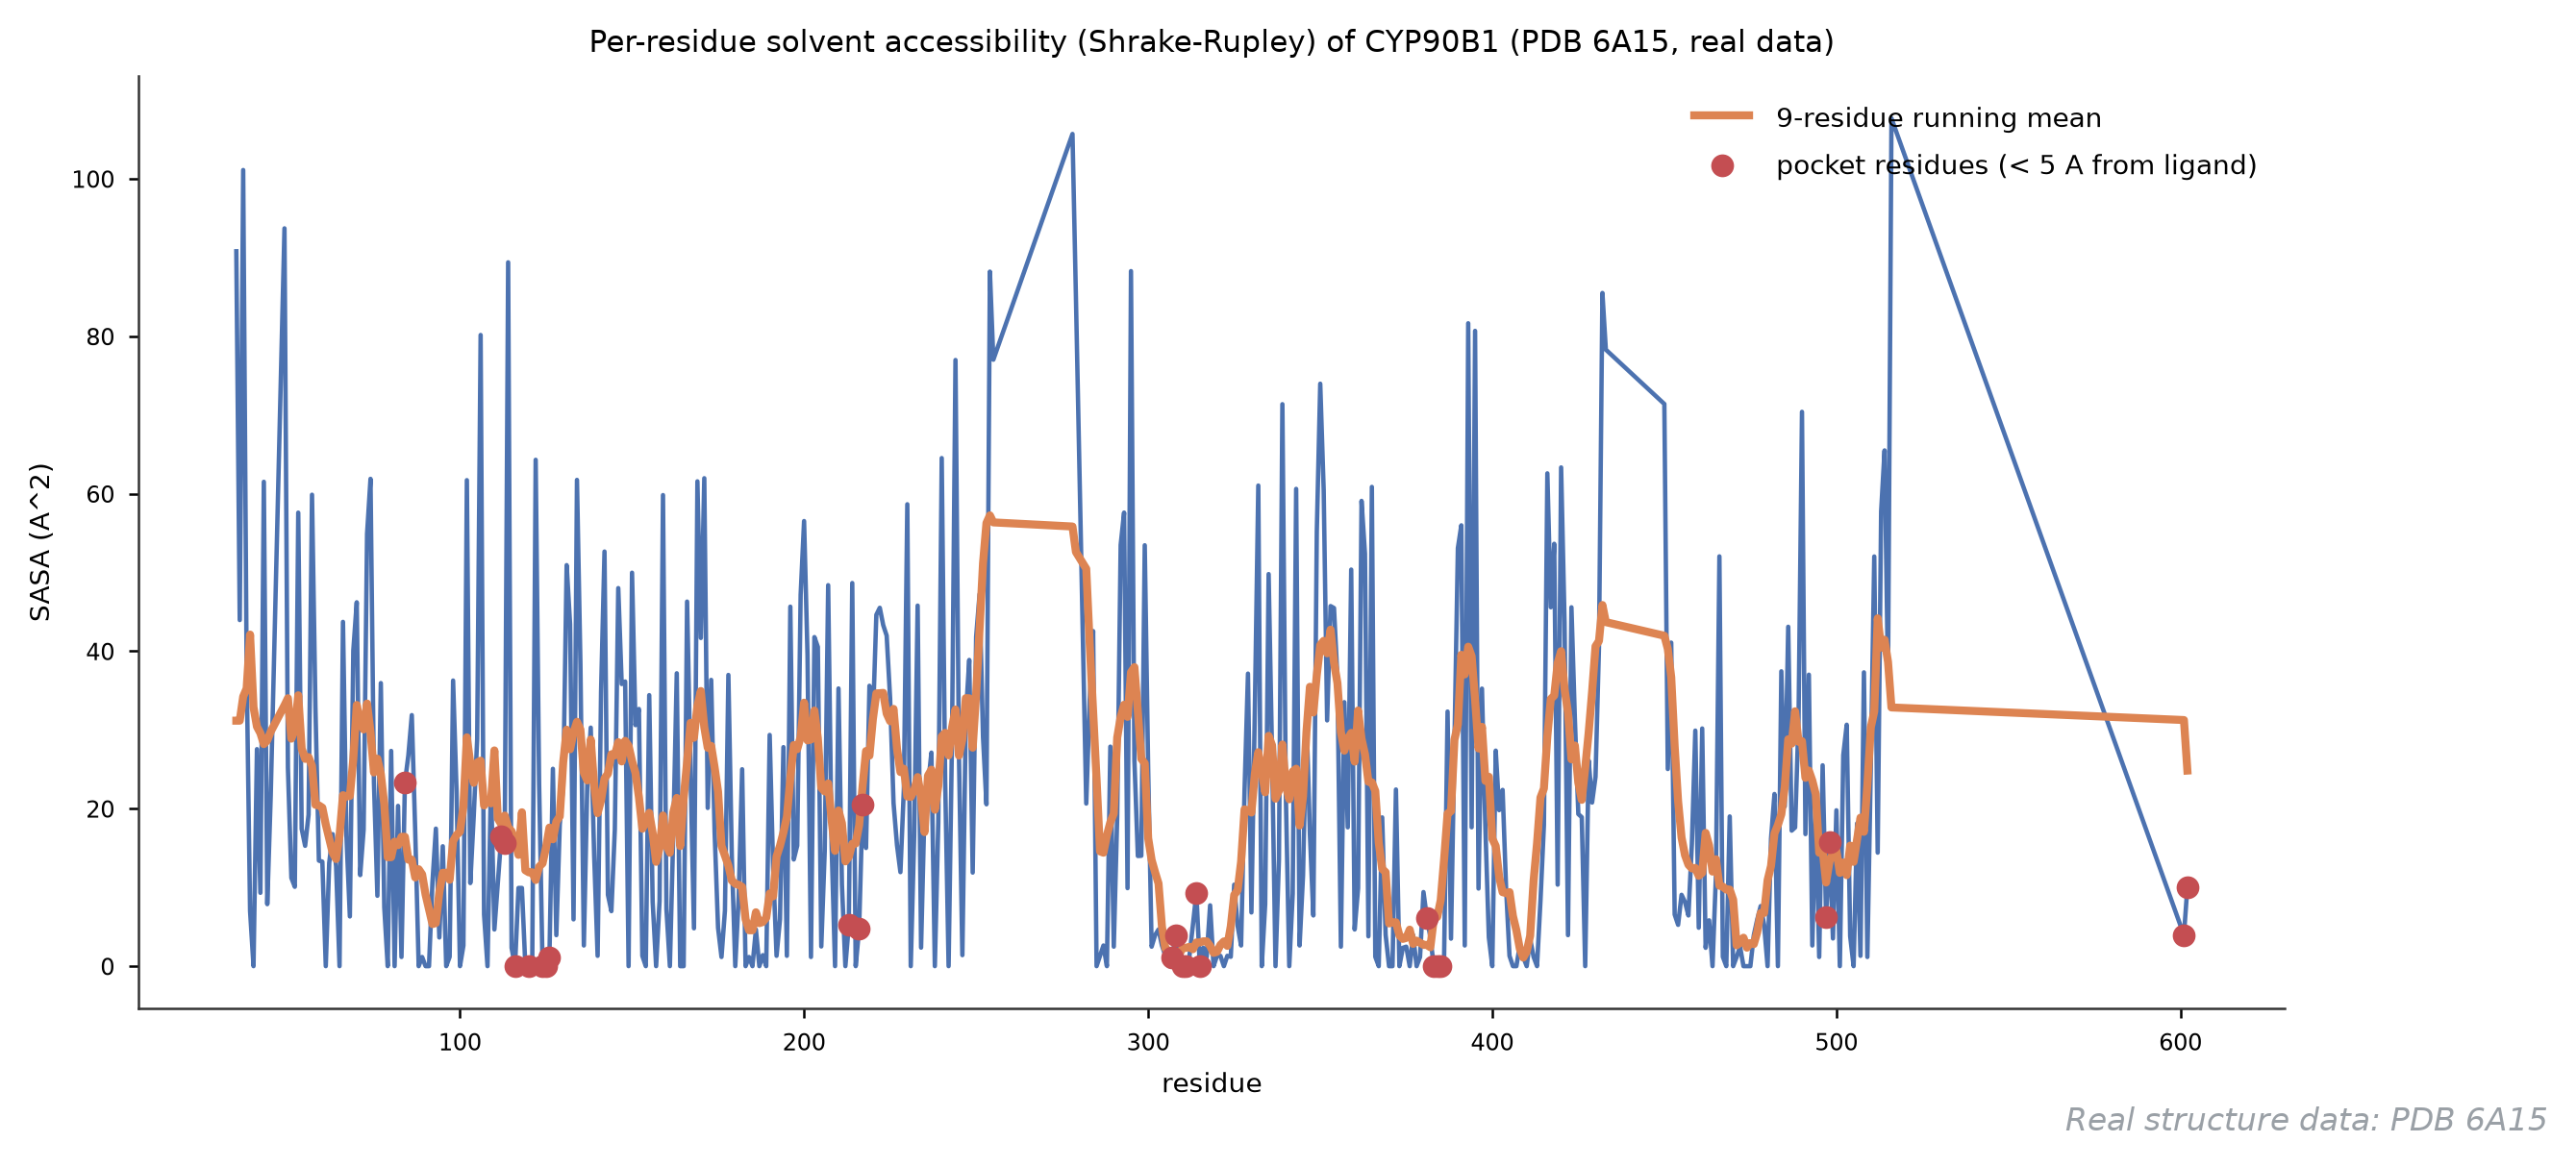
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),Shrake-Rupley 算法计算;水印「Real structure data: PDB 6A15」。
它回答什么问题:每个残基暴露多少在水里——埋没核心、表面环、配体封舱,一个数说清。图 137 的”胆固醇几乎看不见”在这里定量兑现。
怎么读:蓝细线=逐残基 SASA(Ų),橙线=9 残基滑动平均(读趋势用),红点=23 个口袋残基。三个层次:表面残基 80-110 Ų(如 HIS516 达 107.7);核心埋没残基接近 0;红点整体贴地——23 个口袋残基中 8 个 SASA 恰为 0(完全埋没),暴露最多的 PHE84 也只有 23.3 Ų。最下面两行是配体:胆固醇仅 10.1 Ų、血红素 3.9 Ų——配体被蛋白整个包住,与 137/150 的视觉结论闭环。
用什么画:Shrake-Rupley(92 点黄金螺旋采样 + 邻域查询)或 FreeSASA;注意探针半径 1.4 Å 是水分子约定。
图注示例:
图 155 CYP90B1 逐残基溶剂可及面积(真实数据,PDB 6A15,Shrake-Rupley,探针 1.4 Å)。细线为逐残基值、橙线为 9 残基滑动平均、红点为 23 个口袋残基(8 个为 0,最大 PHE84 23.3 Ų);胆固醇与血红素的 SASA 分别为 10.1 与 3.9 Ų,接近完全埋没。
展开查看:SASA 数据(节选)与计算代码
residue,sasa_A2
PHE84,23.3
TYR112,16.5
PRO113,15.6
ILE116,0.0
LEU120,0.0
SER124,0.0
MET125,0.0
LEU126,1.2
MET213,5.3
VAL216,4.8
VAL217,20.5
SER307,1.2
LEU308,3.9
PHE310,0.0
ALA311,0.0
GLU314,9.3
THR315,0.0
VAL381,6.1
PHE383,0.0
LEU384,0.0
HIS385,0.0
PRO497,6.3
PHE498,15.8
HIS516,107.7
HEM601,3.9
CLR602,10.1(完整 439 残基表见仓库 tools/bio-plots/data_dump/;上表为口袋残基 + 表面最高残基 + 两个配体。)
计算代码(Python,独立可运行;接图 134 的 parse())
import numpy as np
from scipy.spatial import cKDTree

RAD = {"C": 1.70, "N": 1.55, "O": 1.52, "S": 1.80, "FE": 1.45, "P": 1.80}
keep = [a for a in parse("6a15.pdb")
        if not a["het"] or a["resn"] in ("HEM", "CLR")]
X = np.array([a["xyz"] for a in keep])
r = np.array([RAD.get(a["elem"], 1.7) + 1.4 for a in keep])  # +水探针
n = 92                                    # Shrake-Rupley 采样点数
k = np.arange(n) + 0.5
phi = np.arccos(1 - 2 * k / n)            # 黄金螺旋均匀布点
theta = np.pi * (1 + 5 ** 0.5) * k
SP = np.c_[np.cos(theta) * np.sin(phi), np.sin(theta) * np.sin(phi),
           np.cos(phi)] * r[:, None, None]
pts = (SP + X[:, None, :]).reshape(-1, 3)
tree = cKDTree(X)
cnt = np.array([len(nb) for nb in
                tree.query_ball_point(pts, r.repeat(n), workers=-1)]
               ).reshape(len(keep), n)
frac = (cnt == 0).mean(1)                 # 没被邻居挡住的采样点比例
area = 4 * np.pi * r ** 2 * frac           # 该原子的 SASA
per = {}
for a, s in zip(keep, area):
    per[a["resi"]] = per.get(a["resi"], 0) + s   # 残基求和
print("CLR602 SASA = %.1f A^2" % per[602])六、表达验证:qPCR、半定量与基因型差异(156-163)#
结构侧说完,最后把”预测”落成”数据”。这一章全是模拟图,但每一张的读法与合格线都是真实世界的规矩。
6.1 qPCR 标准曲线(156)#
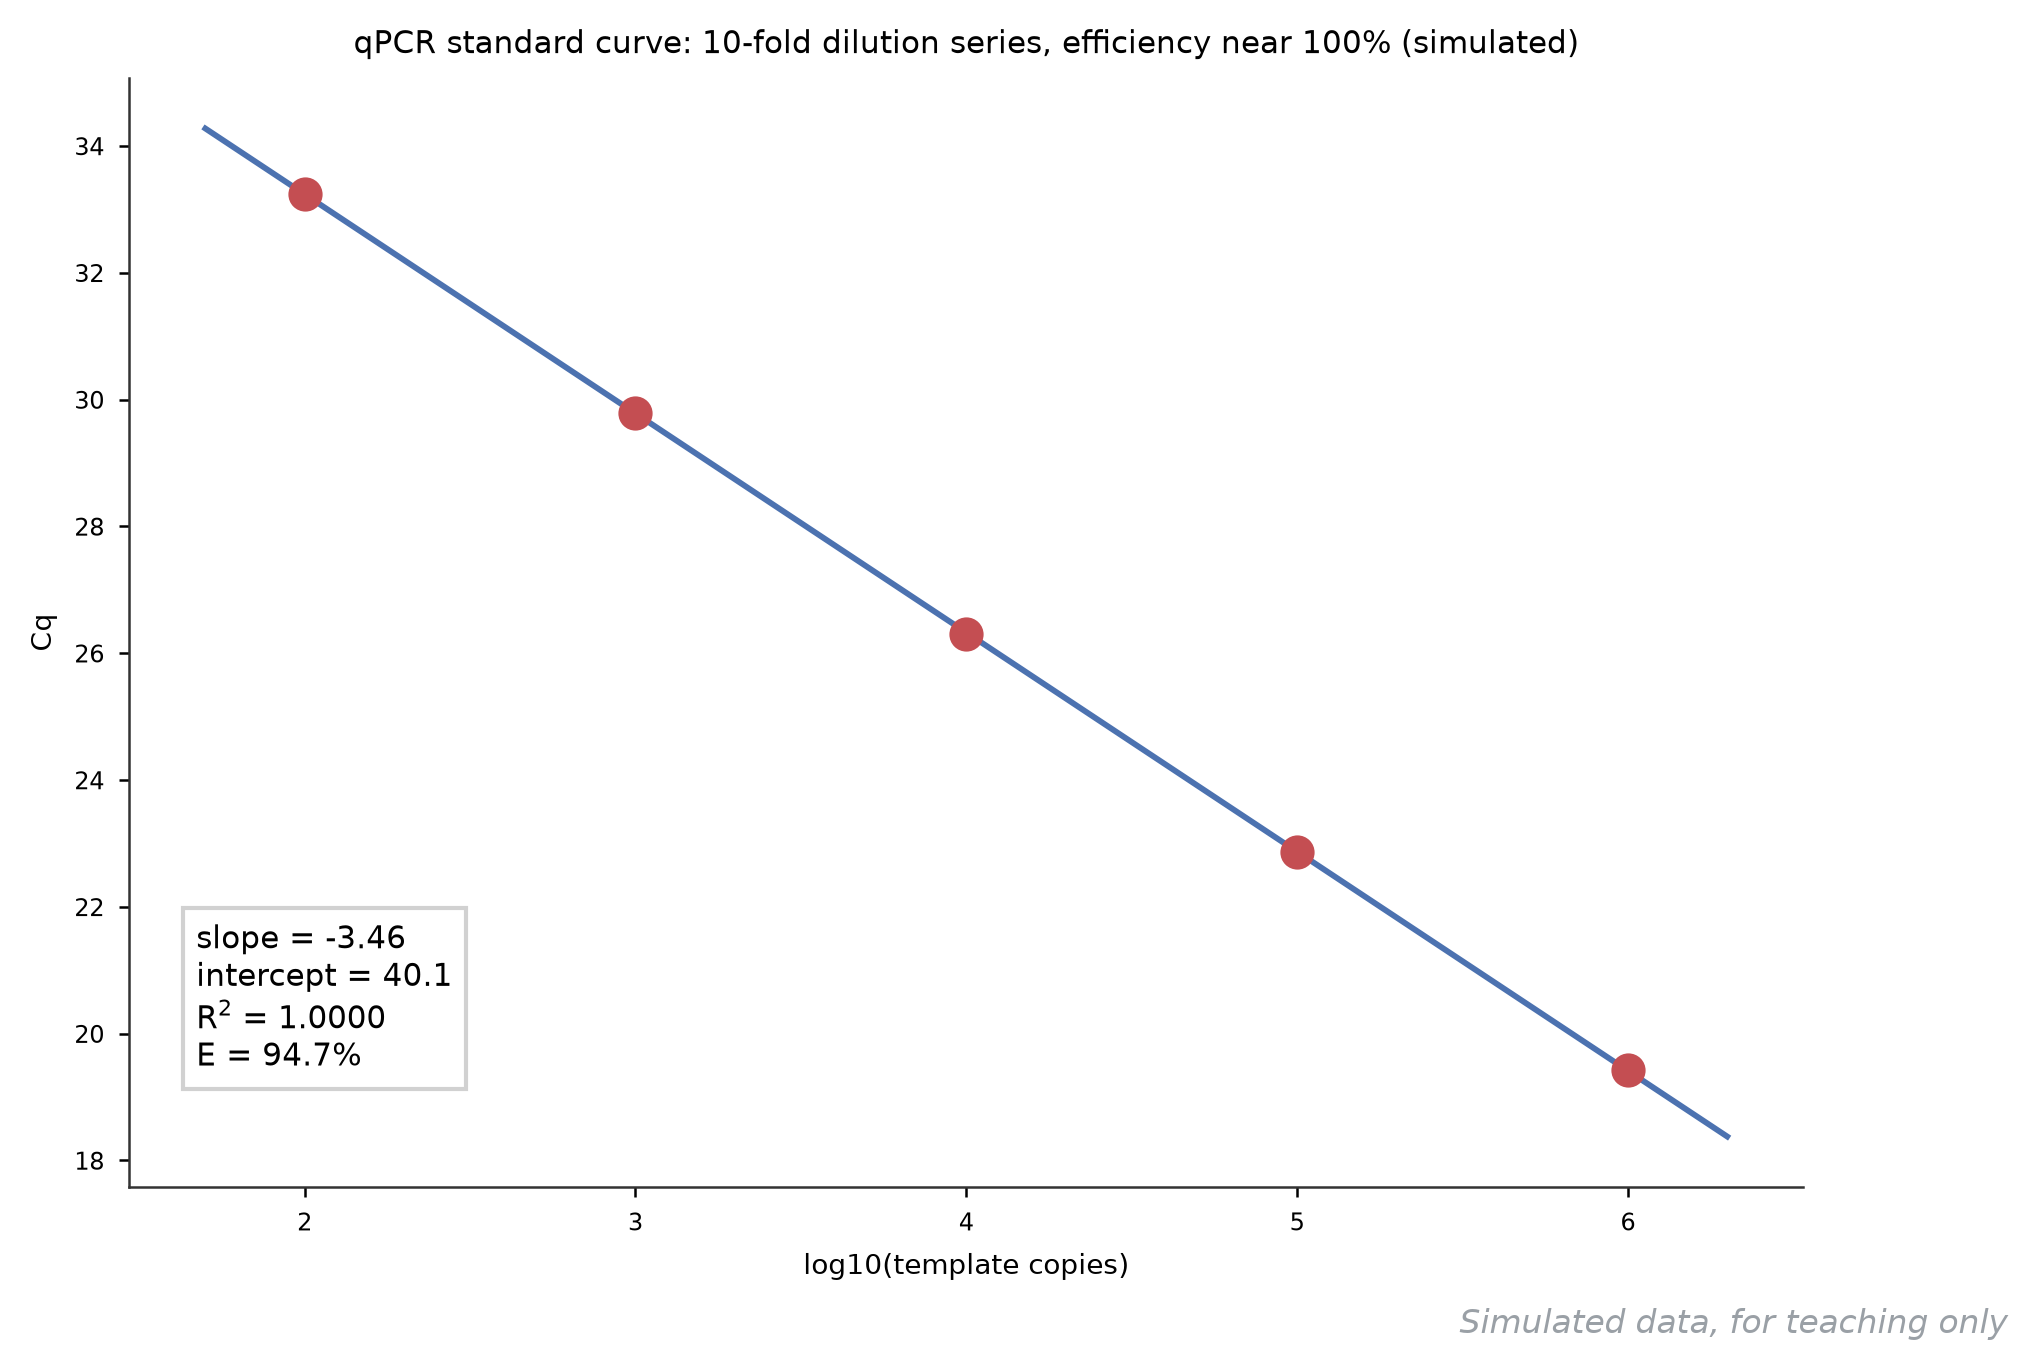
数据:模拟 —— 10 倍梯度稀释的 Cq 值(固定种子);水印「Simulated data」。
它回答什么问题:这对引物/这个反应能不能用来定量——qPCR 论文方法部分的第一张图,审稿人要看的就是斜率、截距、R²、效率四件套。
怎么读:横轴 log10(模板拷贝数)(10⁶→10² 五个点),纵轴 Cq。合格线:斜率 -3.1 至 -3.6(对应效率 90-110%,本图 -3.46 → 效率 94.7%)、R² ≥ 0.99(本图 1.0000)、截距合理(40.2,与 100% 效率的理论值 3.32/数量级同量级)。斜率陡于 -3.1 是效率虚高(引物二聚体/污染),缓于 -3.6 是效率不足(抑制剂、退火温度不对)。
用什么画:五个梯度点 scatter + polyfit 一条线,参数框写进图里(MIQE 规范要求报告这些数)。
图注示例:
图 156 qPCR 标准曲线(模拟)。10 倍梯度稀释 5 点,Cq 对 log10(拷贝数) 线性拟合:斜率 -3.46、截距 40.2、R² = 1.0000、扩增效率 E = 94.7%,符合 MIQE 定量要求。
展开查看:Cq 数据与绘图代码
copies,Cq
1e6,19.42
1e5,22.87
1e4,26.31
1e3,29.79
1e2,33.24绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rows = [ln.split(",") for ln in open("156-qpcr-std.csv").read().splitlines()[1:]]
x = np.log10(np.array([float(r[0]) for r in rows]))
y = np.array([float(r[1]) for r in rows])
k, b = np.polyfit(x, y, 1)
r2 = 1 - ((y - (k * x + b)) ** 2).sum() / ((y - y.mean()) ** 2).sum()
eff = (10 ** (-1 / k) - 1) * 100
fig, ax = plt.subplots(figsize=(7.2, 4.8))
xx = np.linspace(1.7, 6.3, 50)
ax.plot(xx, k * xx + b, color="#4C72B0", lw=1.4)
ax.scatter(x, y, s=52, color="#C44E52", zorder=3)
ax.text(0.04, 0.10, "slope=%.2f\nintercept=%.1f\nR2=%.4f\nE=%.1f%%"
        % (k, b, r2, eff), transform=ax.transAxes, fontsize=9.5)
ax.set_xlabel("log10(template copies)")
ax.set_ylabel("Cq")
fig.savefig("156-qpcr-stdcurve.png", dpi=200, bbox_inches="tight")6.2 半定量 RT-PCR 凝胶 + 灰度柱(157)#
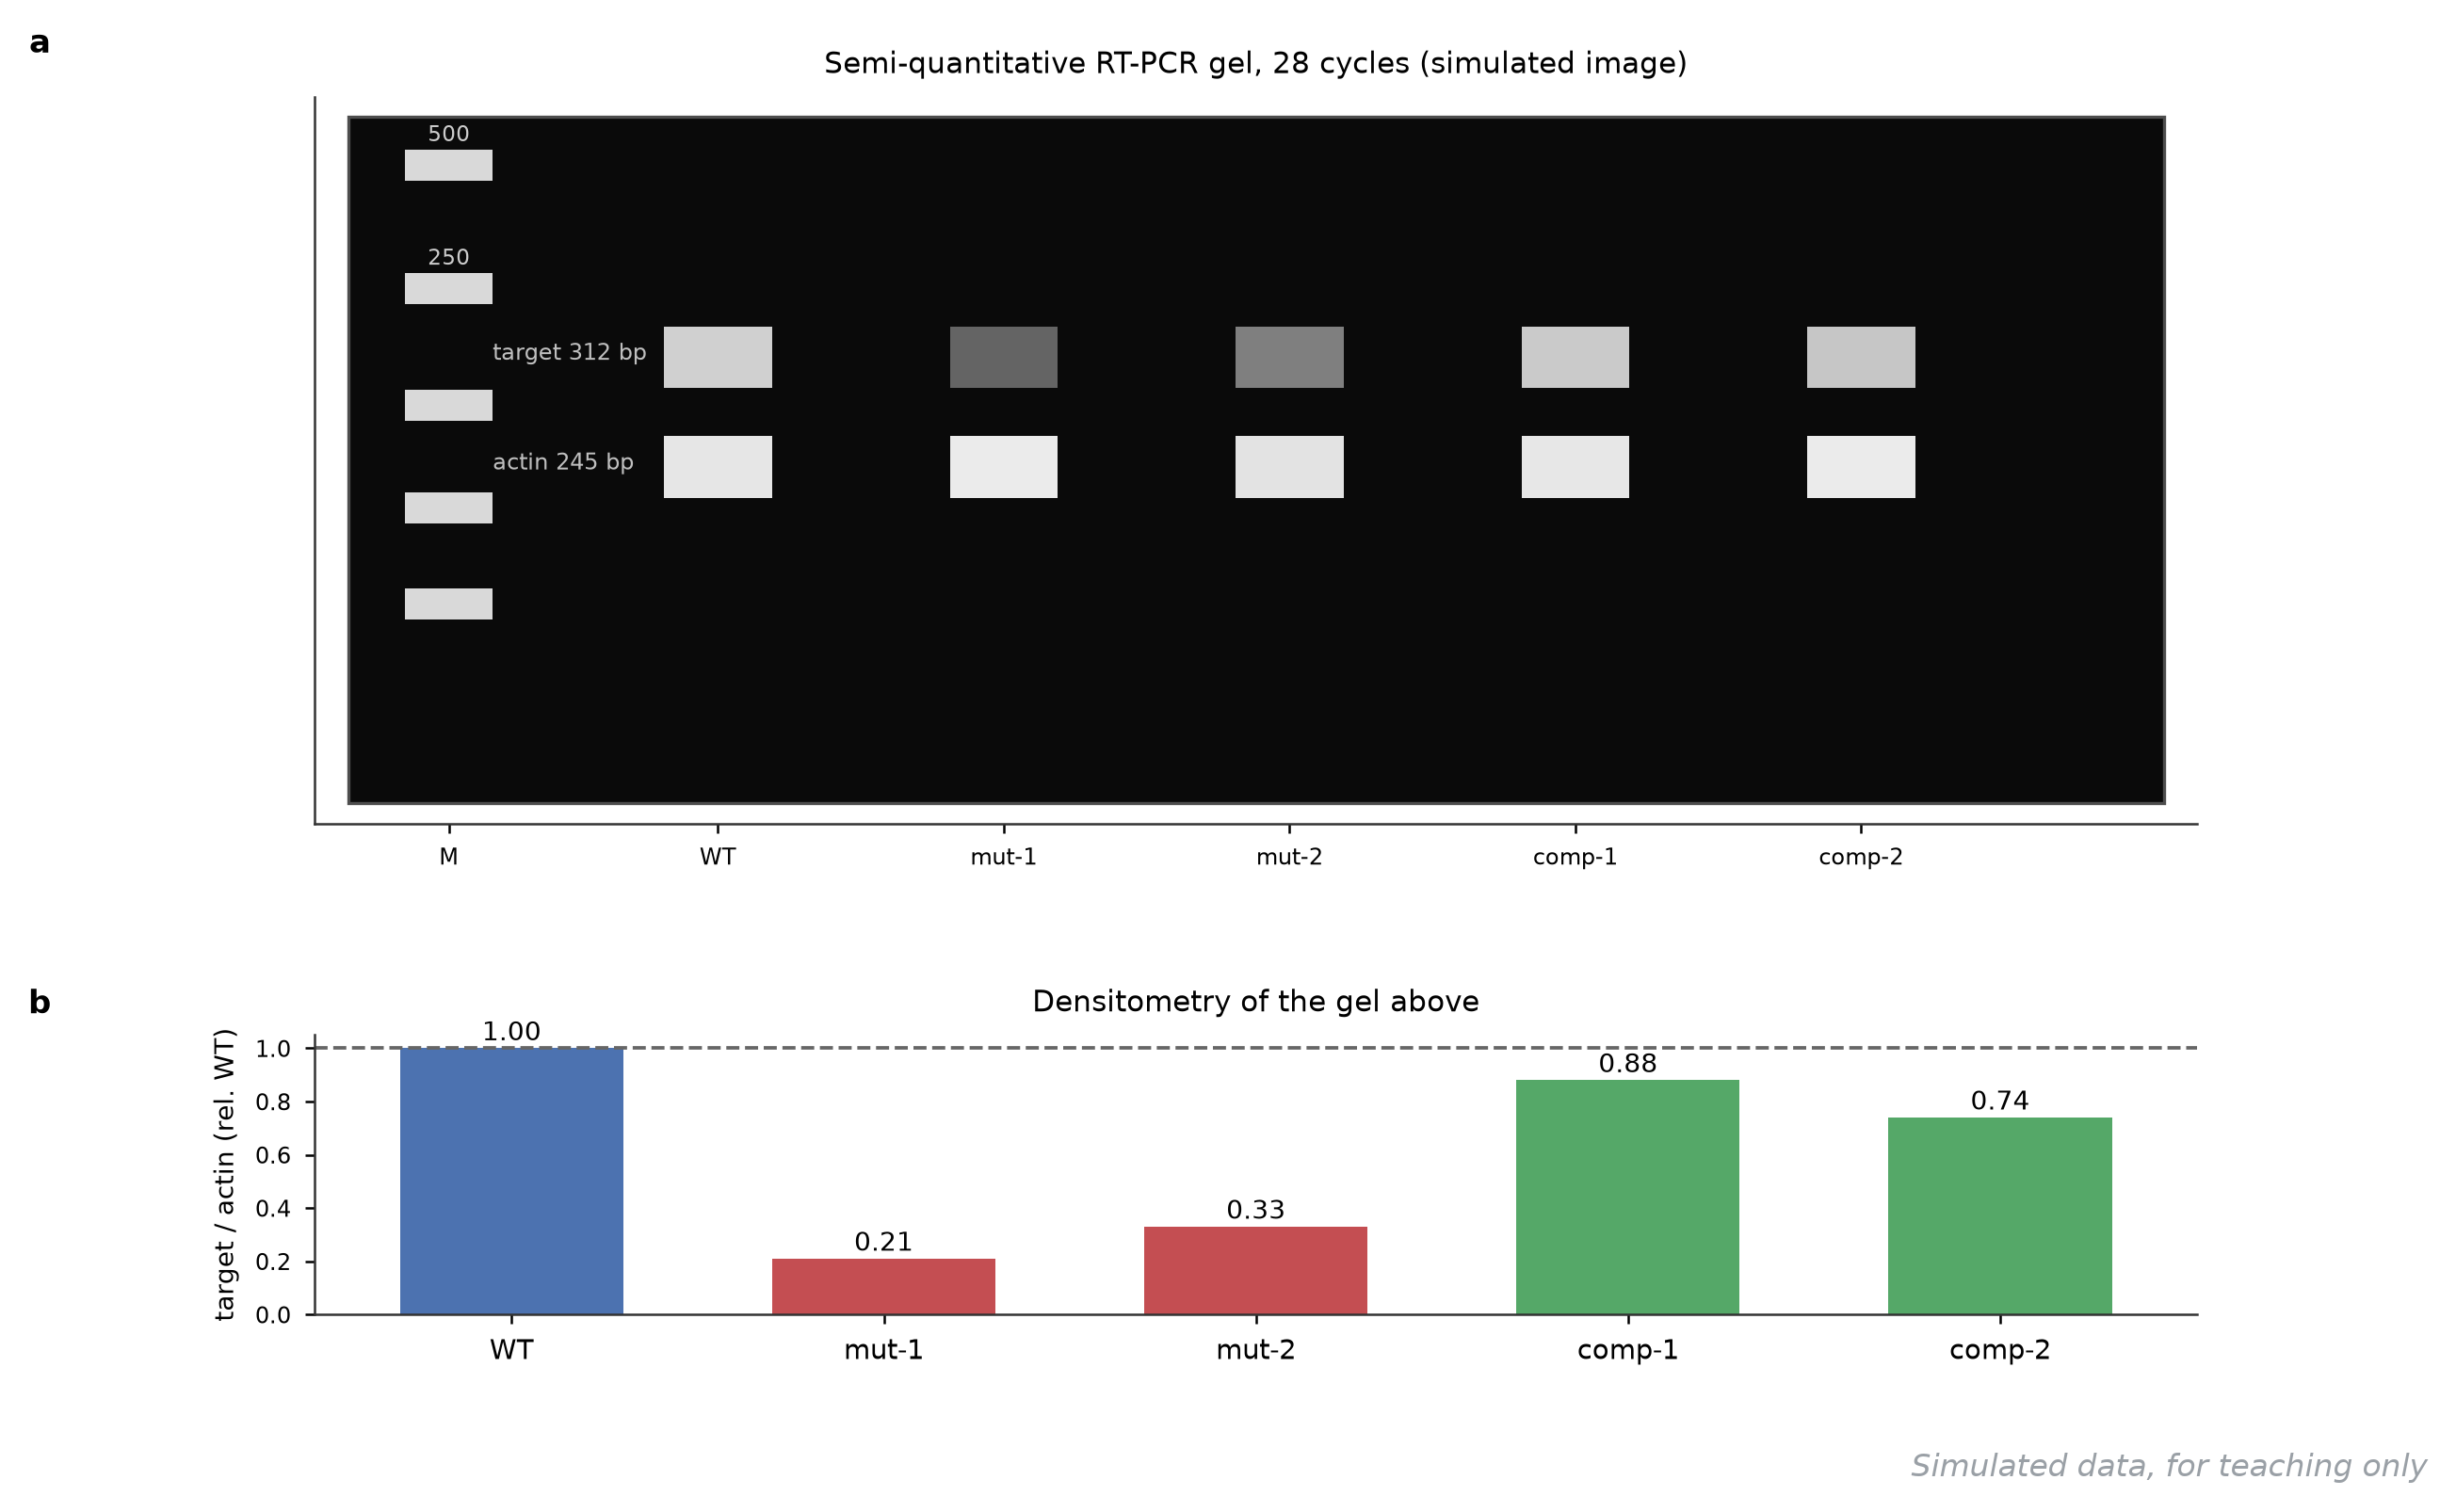
数据:模拟 —— 条带灰度由设定值生成;水印「Simulated data」。
它回答什么问题:没有 qPCR 仪器时怎么比较表达量——半定量 RT-PCR:内参基因(actin)拉平上样,目标基因比条带。研究生轮转、教学实验、以及大量早期文献都是它。
怎么读:上板模拟凝胶:M 道 marker(500/250 bp 定大小),每道两条带:上排目标基因(312 bp)、下排 actin(245 bp)。actin 带各道等亮=上样一致;目标带 WT 最亮,mut-1 只剩 21%、mut-2 剩 33%,互补系恢复到 88%/74%。下板把灰度做成柱:读数就是”目标/actin 相对 WT”。半定量的死线是循环数:必须落在扩增的线性区间(本例 28 个循环),过曝后所有道一样亮,图就废了。
用什么画:凝胶成像后 ImageJ 划道测灰度;本文用矩形灰阶模拟条带 + bar 灰度柱。
图注示例:
图 157 半定量 RT-PCR(模拟凝胶,28 循环)。上:M 为 marker,目标条带 312 bp、actin 内参 245 bp;下:灰度定量(目标/actin,相对 WT=1.00)。mut-1 与 mut-2 分别降至 0.21 与 0.33,互补系恢复至 0.88 与 0.74。
展开查看:灰度数据与绘图代码
lane,target_gray,actin_gray,ratio_rel_WT
WT,1.00,0.97,1.00
mut-1,0.21,1.02,0.21
mut-2,0.33,0.95,0.33
comp-1,0.88,0.98,0.88
comp-2,0.74,1.01,0.74绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

lanes = ["WT", "mut-1", "mut-2", "comp-1", "comp-2"]
target = np.array([1.00, 0.21, 0.33, 0.88, 0.74])
actin = np.array([0.97, 1.02, 0.95, 0.98, 1.01])
fig = plt.figure(figsize=(8.6, 5.6))
gs = fig.add_gridspec(2, 1, height_ratios=[2.6, 1.0], hspace=0.42)
axg = fig.add_subplot(gs[0])
axg.add_patch(Rectangle((0.25, 0), 5.4, 2.0, fc="0.04", ec="0.3"))
for yy, lab in [(1.86, "500"), (1.50, "250")]:        # marker 道
    axg.add_patch(Rectangle((0.42, yy - 0.045), 0.26, 0.09,
                            fc="0.85", ec="none"))
    axg.text(0.55, yy + 0.07, lab, fontsize=6.5, color="0.8",
             ha="center")
for i, g in enumerate(target):                        # 目标带 + actin 带
    cx = 1.35 + i * 0.85
    axg.add_patch(Rectangle((cx - 0.16, 1.21), 0.32, 0.18,
                            fc=str(min(0.92, 0.28 + 0.62 * g)), ec="none"))
    axg.add_patch(Rectangle((cx - 0.16, 0.89), 0.32, 0.18,
                            fc=str(min(0.92, 0.30 + 0.62 * actin[i])),
                            ec="none"))
axg.set_xticks([0.55] + [1.35 + i * 0.85 for i in range(5)],
               ["M"] + lanes)
axg.set_yticks([])
axb = fig.add_subplot(gs[1])
axb.bar(range(5), target, color=["#4C72B0", "#C44E52", "#C44E52",
                                 "#55A868", "#55A868"], width=0.6)
axb.axhline(1.0, ls="--", color="0.4", lw=0.9)
axb.set_xticks(range(5), lanes)
axb.set_ylabel("target / actin (rel. WT)")
fig.savefig("157-rt-pcr-gel.png", dpi=200, bbox_inches="tight")6.3 多基因组织表达热图(158)#
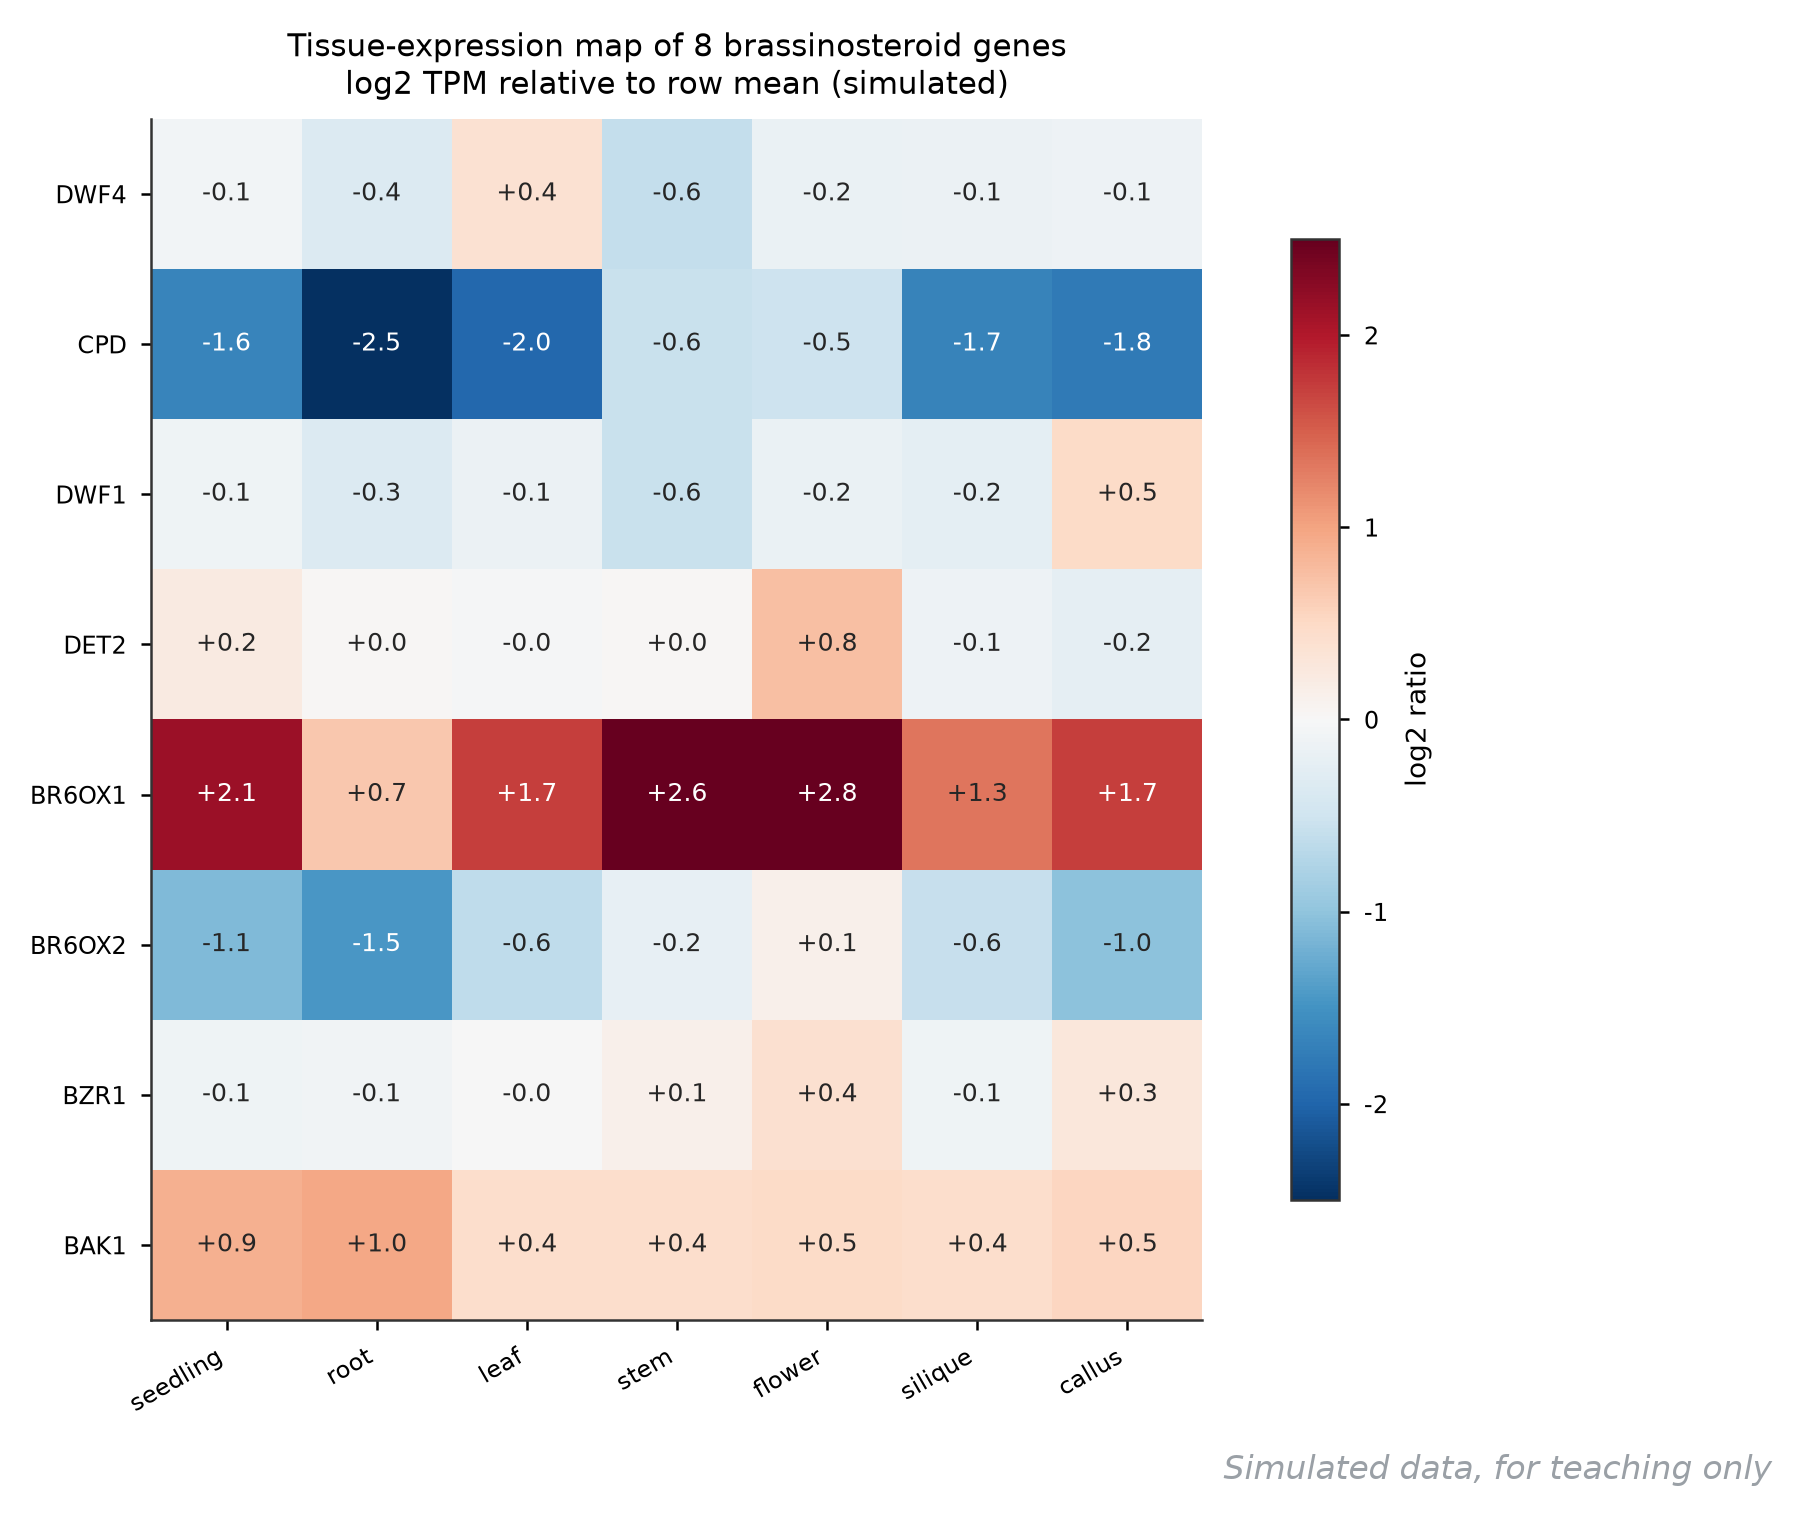
数据:模拟 —— 8 基因 × 7 组织的 log2 相对表达;水印「Simulated data」。
它回答什么问题:一个基因家族在各组织里怎么分工——qPCR 多基因多组织做完后的汇总视图,比 8 张柱状图省 7 张版面。
怎么读:行=基因(油菜素内酯通路 8 个成员),列=组织,颜色=log2(相对行均值),红=高于均值绿=低于。三句话结论模板:通路基因表达模式分化明显(BR6OX1 在茎和花强红 +2.6/+2.8,是器官特异的氧化步骤;CPD 全线偏低(根 -2.5 最低));看家位置的分母效应——行标准化后每行均值恒为 0,别跨行直接比绝对量;找”块”——相邻组织列颜色相近(flower 与 stem)提示共调控。
用什么画:热图 + 单元格写数值(8×7 规模写数值比纯色块好读);行标准化用 log2(TPM/行均值)。
图注示例:
图 158 油菜素内酯通路 8 基因在 7 个组织中的表达热图(模拟,log2 相对行均值)。BR6OX1 在茎(+2.6)与花(+2.8)高表达,CPD 各组织普遍偏低(根 -2.5),提示通路步骤间的组织分工。
展开查看:表达矩阵与绘图代码
gene,seedling,root,leaf,stem,flower,silique,callus
DWF4,-0.1,-0.4,+0.4,-0.6,-0.2,-0.1,-0.1
CPD,-1.6,-2.5,-2.0,-0.6,-0.5,-1.7,-1.8
DWF1,-0.1,-0.3,-0.1,-0.6,-0.2,-0.2,+0.5
DET2,+0.2,+0.0,-0.0,+0.0,+0.8,-0.1,-0.2
BR6OX1,+2.1,+0.7,+1.7,+2.6,+2.8,+1.3,+1.7
BR6OX2,-1.1,-1.5,-0.6,-0.2,+0.1,-0.6,-1.0
BZR1,-0.1,-0.1,-0.0,+0.1,+0.4,-0.1,+0.3
BAK1,+0.9,+1.0,+0.4,+0.4,+0.5,+0.4,+0.5绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

lines = open("158-gene-tissue.csv").read().splitlines()
tis = lines[0].split(",")[1:]
genes = [ln.split(",")[0] for ln in lines[1:]]
M = np.array([[float(v) for v in ln.split(",")[1:]] for ln in lines[1:]])
fig, ax = plt.subplots(figsize=(7.6, 5.2))
im = ax.imshow(M, cmap="RdBu_r", vmin=-2.5, vmax=2.5)
ax.set_xticks(range(len(tis)), tis, rotation=30, ha="right")
ax.set_yticks(range(len(genes)), genes)
for i in range(len(genes)):
    for j in range(len(tis)):
        ax.text(j, i, "%+.1f" % M[i, j], ha="center", va="center",
                fontsize=7.6,
                color="white" if abs(M[i, j]) > 1.4 else "0.15")
fig.colorbar(im, ax=ax, shrink=0.8, label="log2 ratio")
fig.savefig("158-gene-tissue-heatmap.png", dpi=200, bbox_inches="tight")6.4 野生种 vs 栽培种表达热图(159)#
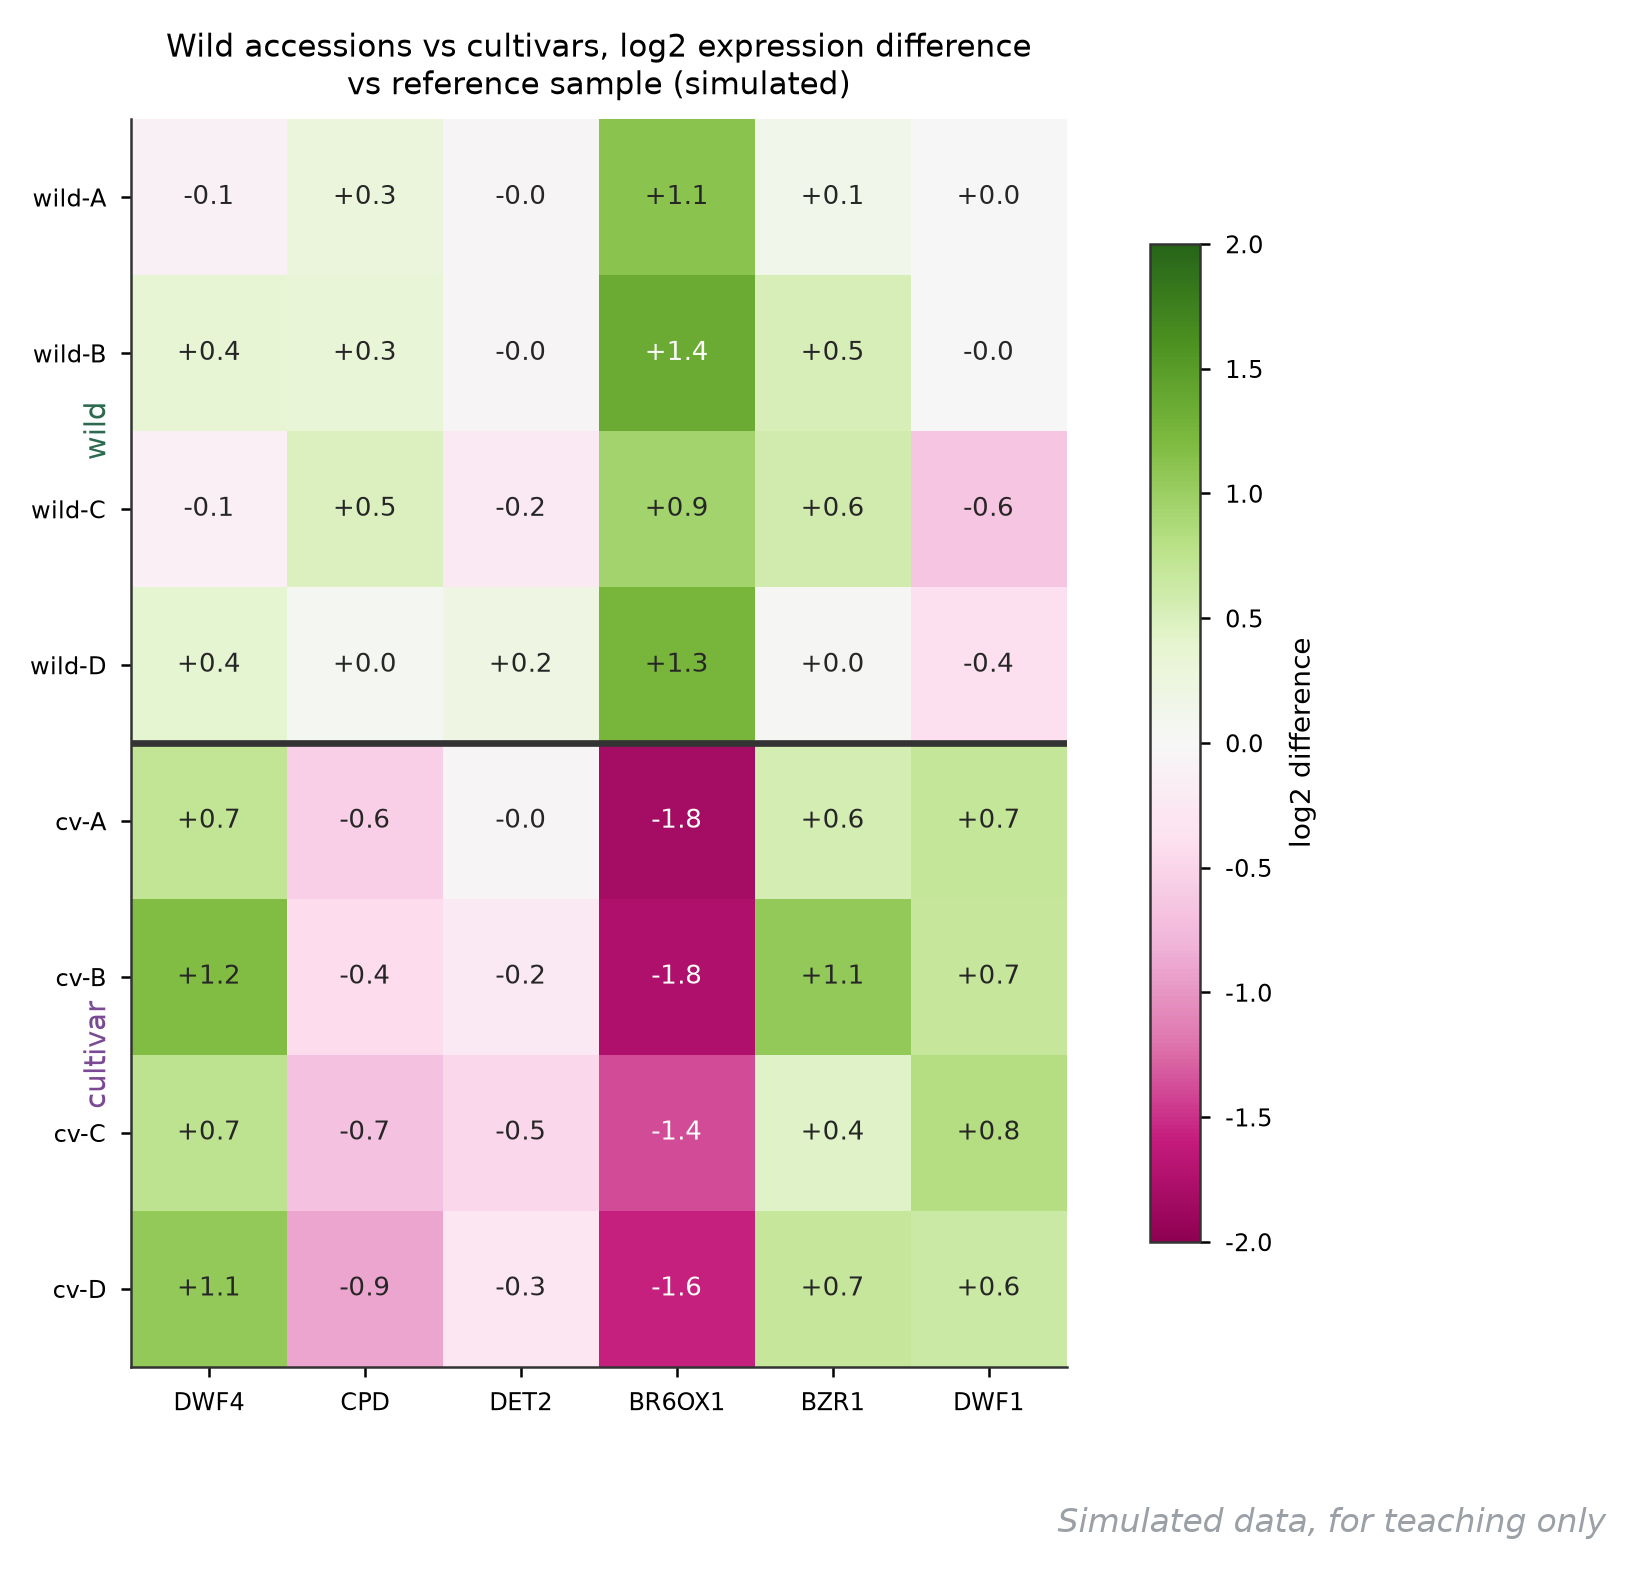
数据:模拟 —— 4 野生材料 + 4 栽培品种 × 6 基因;水印「Simulated data」。
它回答什么问题:驯化/育种在转录层面留下了什么——野生种与栽培种同田种植后比表达,是”驯化综合征”研究的标准开局图。
怎么读:行=4 个野生材料(上)与 4 个栽培品种(下),黑线分隔两组;列=6 个基因,颜色=log2(与参考样的表达差)。组间模式差一眼可见:栽培种 DWF4 普遍 +0.7 至 +1.2、DWF1 +0.6 至 +0.8(驯化可能上调了株型相关合成基因),而 BR6OX1 反向(野生 +0.9 至 +1.4,栽培 -1.4 至 -1.8);CPD 在栽培种一致偏低。读图要点:组内重复的一致性比单个极值重要——4 个材料方向一致才敢说”驯化信号”。
用什么画:同 158 的热图加一条 axhline 分组线 + 侧边组标签;材料数 4+4 偏少,写数值必须。
图注示例:
图 159 4 个野生材料与 4 个栽培品种的 6 基因表达差异热图(模拟,log2 相对参考样品)。栽培种 DWF4(+0.7 至 +1.2)与 DWF1(+0.6 至 +0.8)一致上调、BR6OX1 一致下调(-1.4 至 -1.8),野生种 BR6OX1 反向偏高,呈现组间一致的驯化表达信号。
展开查看:基因型表达数据与绘图代码
accession,DWF4,CPD,DET2,BR6OX1,BZR1,DWF1
wild-A,-0.1,+0.3,-0.0,+1.1,+0.1,+0.0
wild-B,+0.4,+0.3,-0.0,+1.4,+0.5,-0.0
wild-C,-0.1,+0.5,-0.2,+0.9,+0.6,-0.6
wild-D,+0.4,+0.0,+0.2,+1.3,+0.0,-0.4
cv-A,+0.7,-0.6,-0.0,-1.8,+0.6,+0.7
cv-B,+1.2,-0.4,-0.2,-1.8,+1.1,+0.7
cv-C,+0.7,-0.7,-0.5,-1.4,+0.4,+0.8
cv-D,+1.1,-0.9,-0.3,-1.6,+0.7,+0.6绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

lines = open("159-wild-cultivar.csv").read().splitlines()
genes = lines[0].split(",")[1:]
acc = [ln.split(",")[0] for ln in lines[1:]]
M = np.array([[float(v) for v in ln.split(",")[1:]] for ln in lines[1:]])
fig, ax = plt.subplots(figsize=(7.2, 5.4))
im = ax.imshow(M, cmap="PiYG", vmin=-2.0, vmax=2.0)
ax.set_xticks(range(len(genes)), genes)
ax.set_yticks(range(len(acc)), acc)
ax.axhline(3.5, color="0.2", lw=1.6)
for i in range(len(acc)):
    for j in range(len(genes)):
        ax.text(j, i, "%+.1f" % M[i, j], ha="center", va="center",
                fontsize=8,
                color="white" if abs(M[i, j]) > 1.3 else "0.15")
fig.colorbar(im, ax=ax, shrink=0.8, label="log2 difference")
fig.savefig("159-wild-cultivar.png", dpi=200, bbox_inches="tight")6.5 突变体 vs WT vs 互补系表达箱线图(160)#
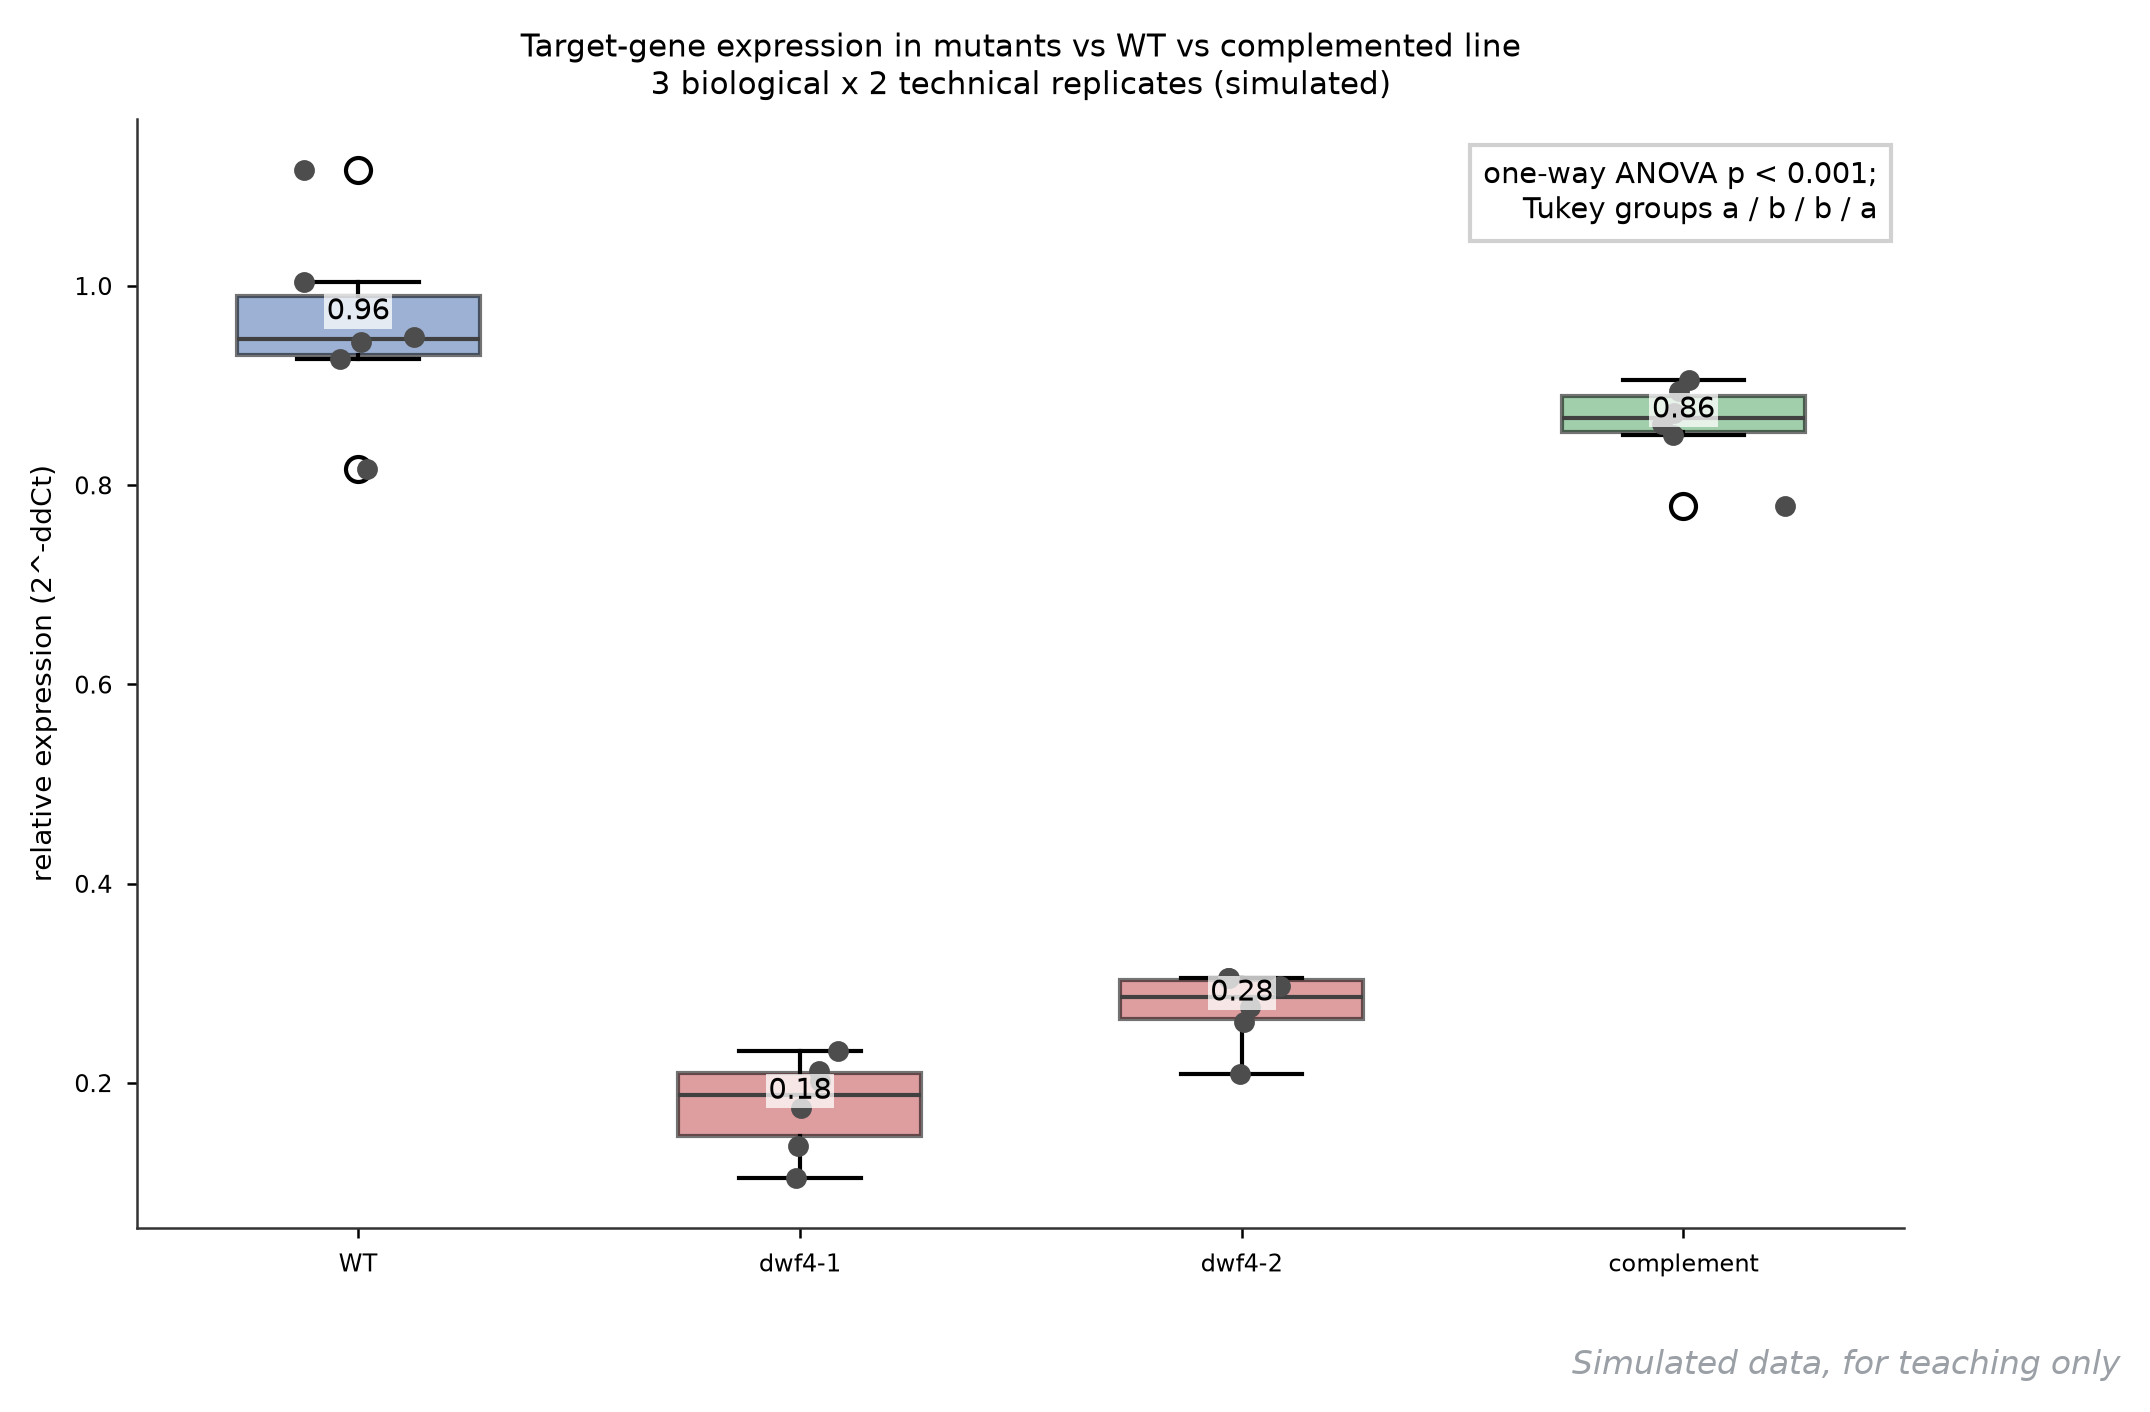
数据:模拟 —— 每基因型 6 个重复(3 生物学 × 2 技术);水印「Simulated data」。
它回答什么问题:一个表型是不是这个基因造成的——突变体表达塌了、把基因转回去(互补系)表达恢复,因果链就闭合了。这是遗传学” rescue 实验”在 qPCR 上的标准呈现。
怎么读:四组箱线:WT(均值 0.96)、dwf4-1(0.18)、dwf4-2(0.28)、互补系(0.86),点=单个重复。统计三件套:单因素 ANOVA p < 0.001(组间有差异);Tukey HSD 事后分组 a/b/b/a(突变体与 WT/互补系不同组,两个等位基因彼此同组);每组 ≥3 生物学重复(MIQE 底线)。箱体不重叠 + 字母不同 = 差异真实;只看均值不画重复的柱状图在 qPCR 语境是会被退回的。
用什么画:boxplot + 抖动散点 + 字母标注;qPCR 数据先做 2^-ΔΔCt 再进箱线图(别对原始 Cq 求平均)。
图注示例:
图 160 目标基因在 WT、两个突变等位基因与互补系中的相对表达(模拟,2^-ΔΔCt,每组 6 重复)。单因素 ANOVA p < 0.001,Tukey 分组 a/b/b/a:dwf4-1(0.18)与 dwf4-2(0.28)显著低于 WT(0.96),互补系恢复至 0.86(与 WT 同组)。
展开查看:重复数据摘要与绘图代码
genotype,mean,sd,n
WT,0.96,0.090,6
dwf4-1,0.18,0.044,6
dwf4-2,0.28,0.034,6
complement,0.86,0.041,6(每个重复的原始值由代码按该均值/标准差生成;论文汇报用原始点图。)
绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rng = np.random.default_rng(5160)
groups = ["WT", "dwf4-1", "dwf4-2", "complement"]
mu = [0.96, 0.18, 0.28, 0.86]
sd = [0.090, 0.044, 0.034, 0.041]
data = [rng.normal(m, s, 6) for m, s in zip(mu, sd)]
fig, ax = plt.subplots(figsize=(7.6, 4.8))
bp = ax.boxplot(data, patch_artist=True, widths=0.55)
for patch, c in zip(bp["boxes"], ["#4C72B0", "#C44E52",
                                  "#C44E52", "#55A868"]):
    patch.set_facecolor(c)
    patch.set_alpha(0.55)
for i, d in enumerate(data):
    ax.scatter(rng.normal(i + 1, 0.055, len(d)), d, s=16, color="0.3",
               zorder=3)
ax.set_xticks(range(1, 5), groups)
ax.set_ylabel("relative expression (2^-ddCt)")
fig.savefig("160-mutant-box.png", dpi=200, bbox_inches="tight")6.6 基因型 × 环境诱导折线图(161)#
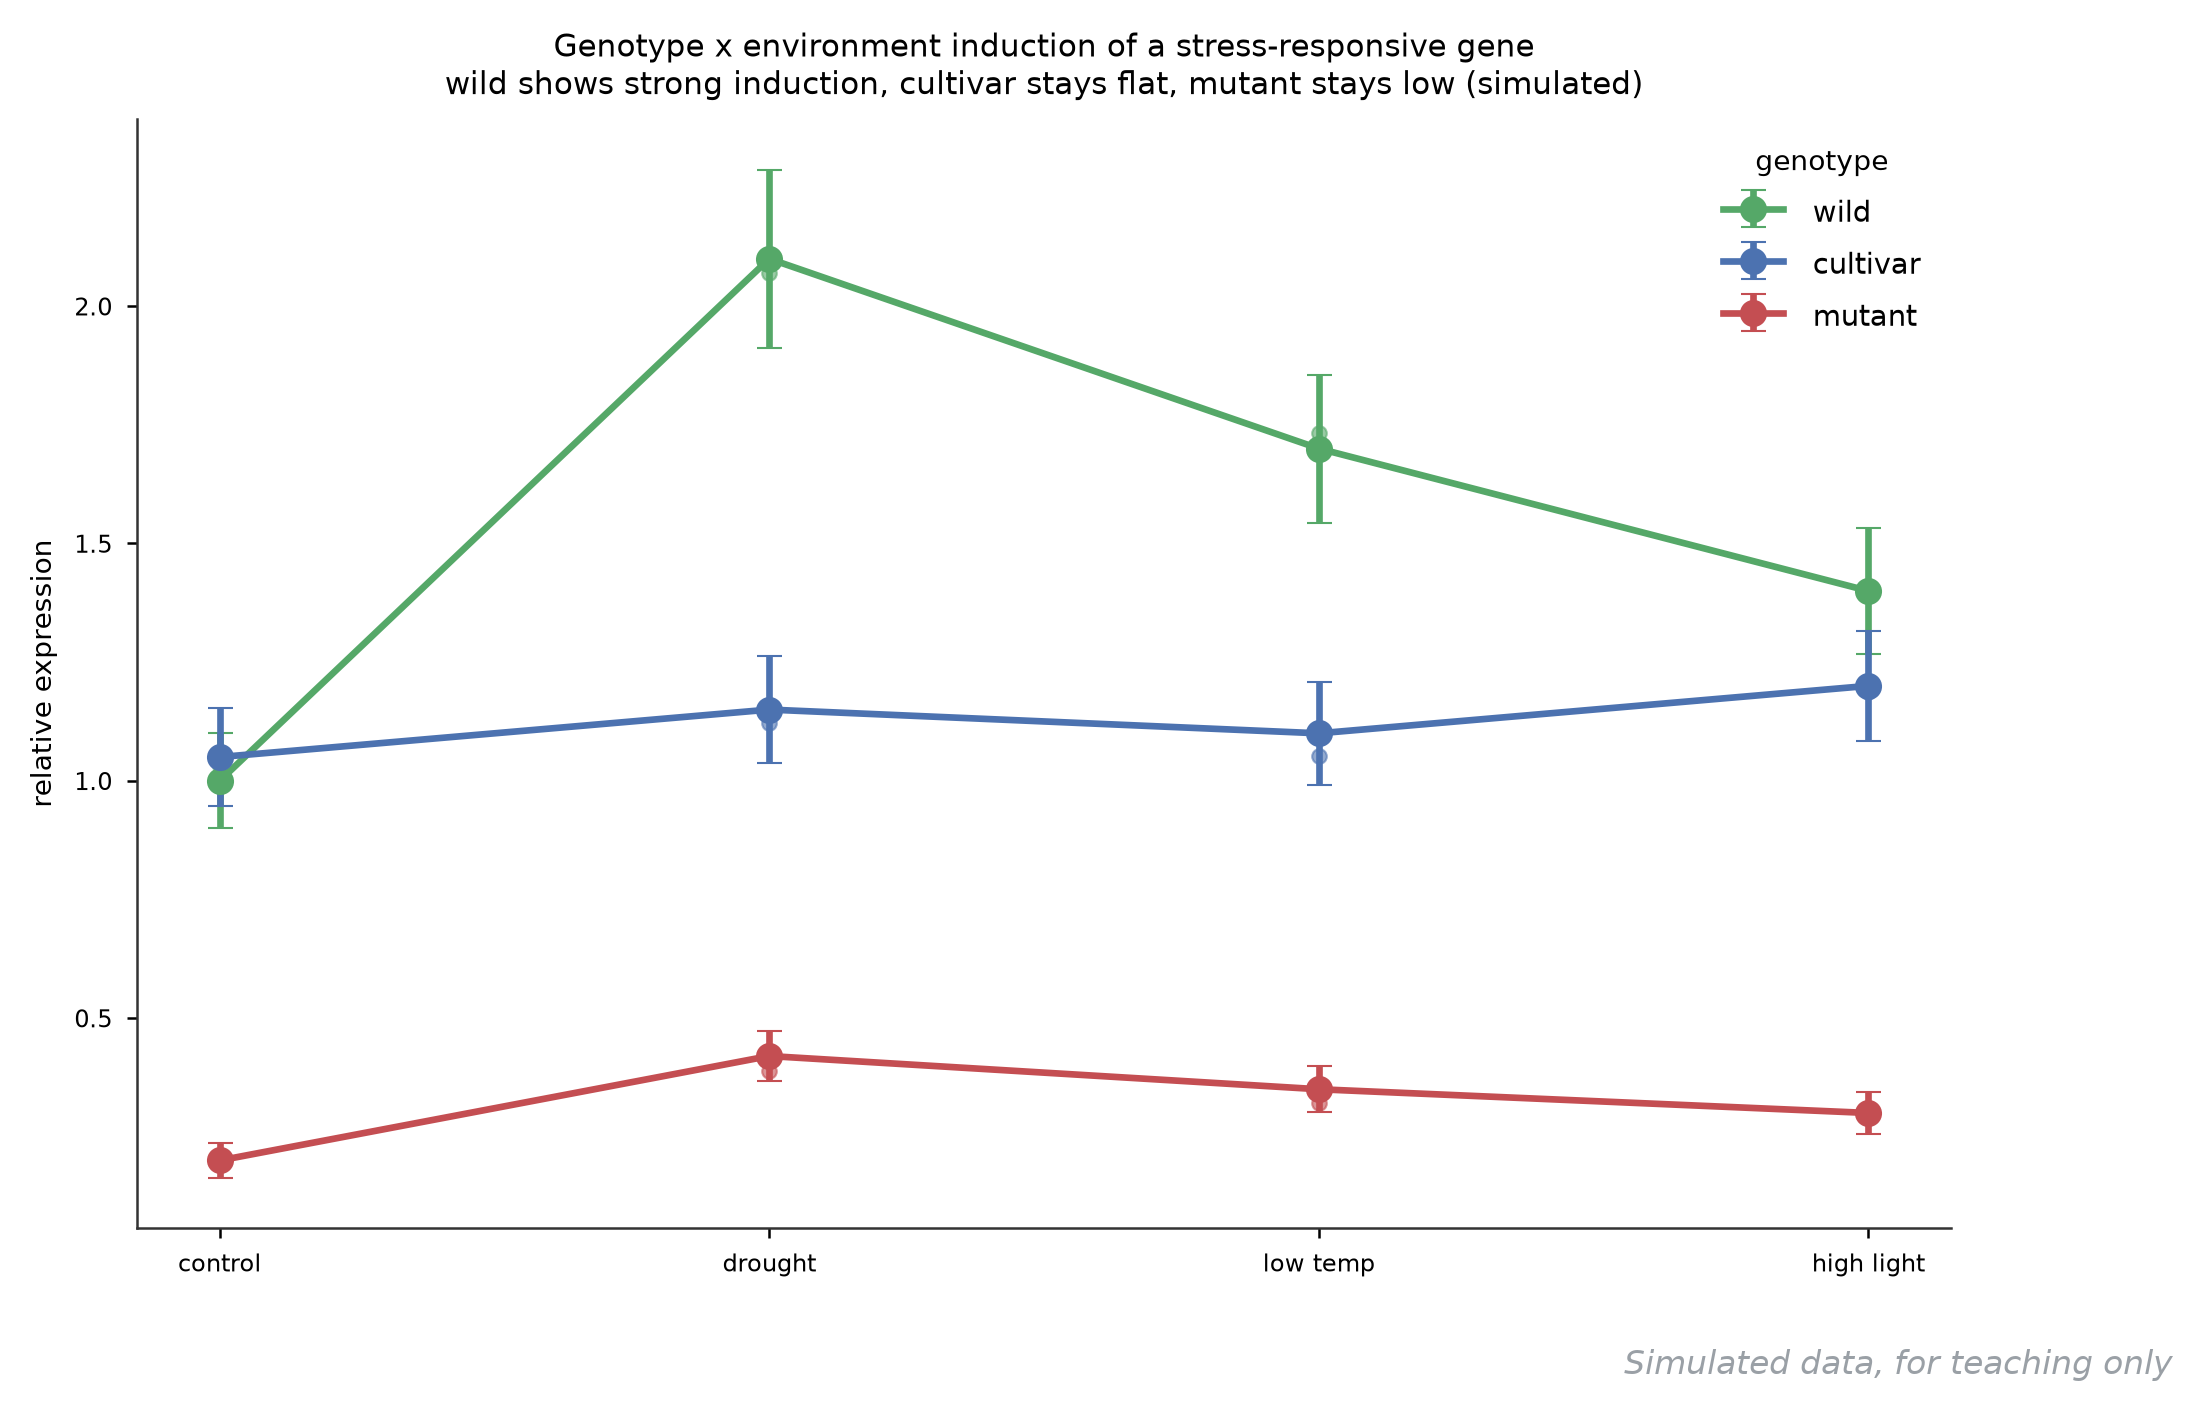
数据:模拟 —— 3 基因型 × 4 环境(固定种子);水印「Simulated data」。
它回答什么问题:同一个基因在不同材料里的诱导响应是否相同——基因型×环境互作(G×E)在表达层面的样子。抗逆候选基因验证的高频图。
怎么读:横轴 4 个环境(对照/干旱/低温/高光),三条线三个基因型,误差棒=标准差。判互作看”剪刀口”:野生型干旱下被诱导到 2.10 倍,栽培种几乎平走(1.05→1.15),突变体全程贴地(0.20-0.42)——三线不平行=互作显著;若三条线平行抬升则是共同响应无互作。线平行上色的意义:诱导倍数>2 且基因型间分离,是”野生等位基因更抗逆”的表达证据。
用什么画:errorbar 折线;环境是有序类别,横轴保持顺序别按字母排序;每个点 ≥3 生物学重复。
图注示例:
图 161 三种基因型目标基因在四种环境下的相对表达(模拟,误差棒为标准差)。野生型干旱下诱导至 2.10 倍,栽培种平缓(1.05→1.15),突变体持续低表达(0.20-0.42);三线分离即基因型×环境互作。
展开查看:G×E 数据与绘图代码
genotype,control,drought,low temp,high light
wild,1.00,2.10,1.70,1.40
cultivar,1.05,1.15,1.10,1.20
mutant,0.20,0.42,0.35,0.30绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

lines = open("161-gxe.csv").read().splitlines()
envs = lines[0].split(",")[1:]
fig, ax = plt.subplots(figsize=(7.8, 4.8))
for ln, c in zip(lines[1:], ["#55A868", "#4C72B0", "#C44E52"]):
    parts = ln.split(",")
    v = np.array([float(x) for x in parts[1:]])
    se = 0.08 * v + 0.02
    ax.errorbar(range(len(envs)), v, yerr=se, marker="o", ms=6, lw=1.6,
                color=c, label=parts[0], capsize=3)
ax.set_xticks(range(len(envs)), envs)
ax.set_ylabel("relative expression")
ax.legend(title="genotype", fontsize=9)
fig.savefig("161-gxe-lines.png", dpi=200, bbox_inches="tight")6.7 半定量灰度 vs qPCR 相关性(162)#
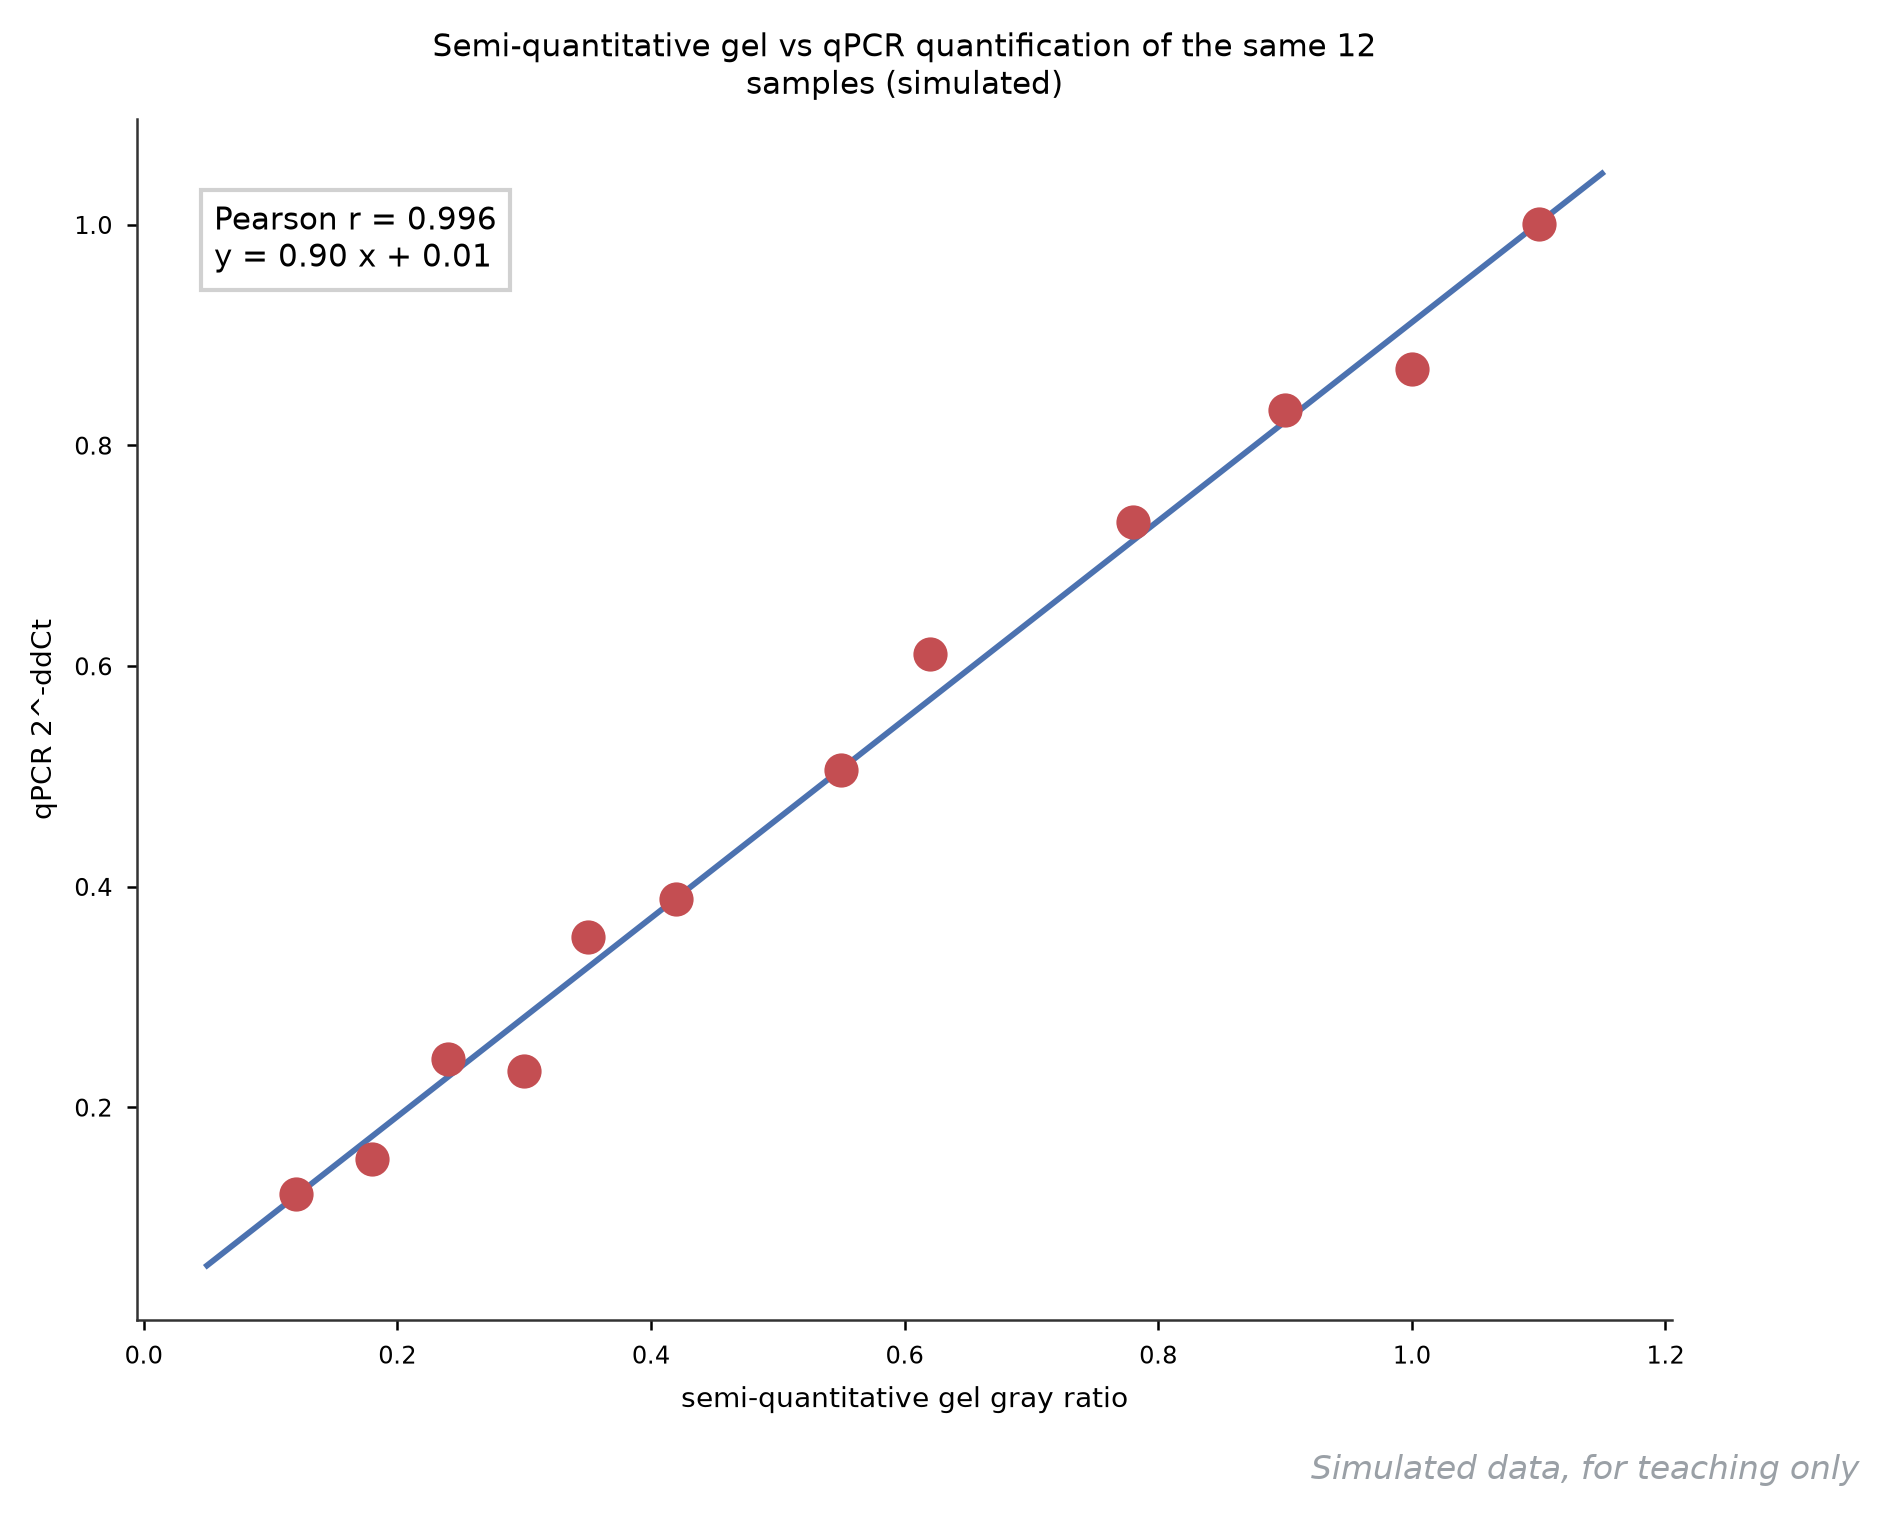
数据:模拟 —— 12 个样品两法同测;水印「Simulated data」。
它回答什么问题:我的半定量凝胶到底可不可信——把同一批样品的凝胶灰度与 qPCR 定量做相关,给半定量方法发一张”可信度证书”。
怎么读:横轴凝胶灰度比值、纵轴 qPCR 2^-ΔΔCt,12 个点一条回归线。Pearson r = 0.996,斜率 0.90:相关极高说明两法排序一致;斜率小于 1 说明凝胶在高表达端被压缩(条带过饱和),这正是半定量”只能排序、不能精确定量”的定量表述。汇报写法:r > 0.99 用于趋势判断,绝对量以 qPCR 为准。
用什么画:polyfit + corrcoef + 散点;数据点跨一个数量级才能撑起相关结论,别只测 3 个样品。
图注示例:
图 162 同批 12 个样品的半定量凝胶灰度与 qPCR 定量的相关性(模拟)。Pearson r = 0.996,回归斜率 0.90:两法排序一致,但凝胶高表达端被压缩(斜率 < 1),绝对定量以 qPCR 为准。
展开查看:两法配对数据与绘图代码
sample,gel_gray,qpcr
S01,1.00,0.870
S02,0.78,0.730
S03,0.55,0.505
S04,0.42,0.389
S05,0.30,0.233
S06,0.18,0.153
S07,1.10,1.001
S08,0.90,0.832
S09,0.62,0.611
S10,0.35,0.354
S11,0.24,0.244
S12,0.12,0.121绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

D = np.genfromtxt("162-gray-qpcr.csv", delimiter=",", names=True)
x, y = D["gel_gray"], D["qpcr"]
k, b = np.polyfit(x, y, 1)
r = np.corrcoef(x, y)[0, 1]
fig, ax = plt.subplots(figsize=(6.6, 5.2))
xx = np.linspace(0.05, 1.15, 50)
ax.plot(xx, k * xx + b, color="#4C72B0", lw=1.4)
ax.scatter(x, y, s=52, color="#C44E52", zorder=3)
ax.text(0.05, 0.93, "Pearson r = %.3f\ny = %.2f x + %.2f" % (r, k, b),
        transform=ax.transAxes, fontsize=9.5, va="top")
ax.set_xlabel("semi-quantitative gel gray ratio")
ax.set_ylabel("qPCR 2^-ddCt")
fig.savefig("162-gray-vs-qpcr.png", dpi=200, bbox_inches="tight")6.8 表达量-表型散点回归(163)#
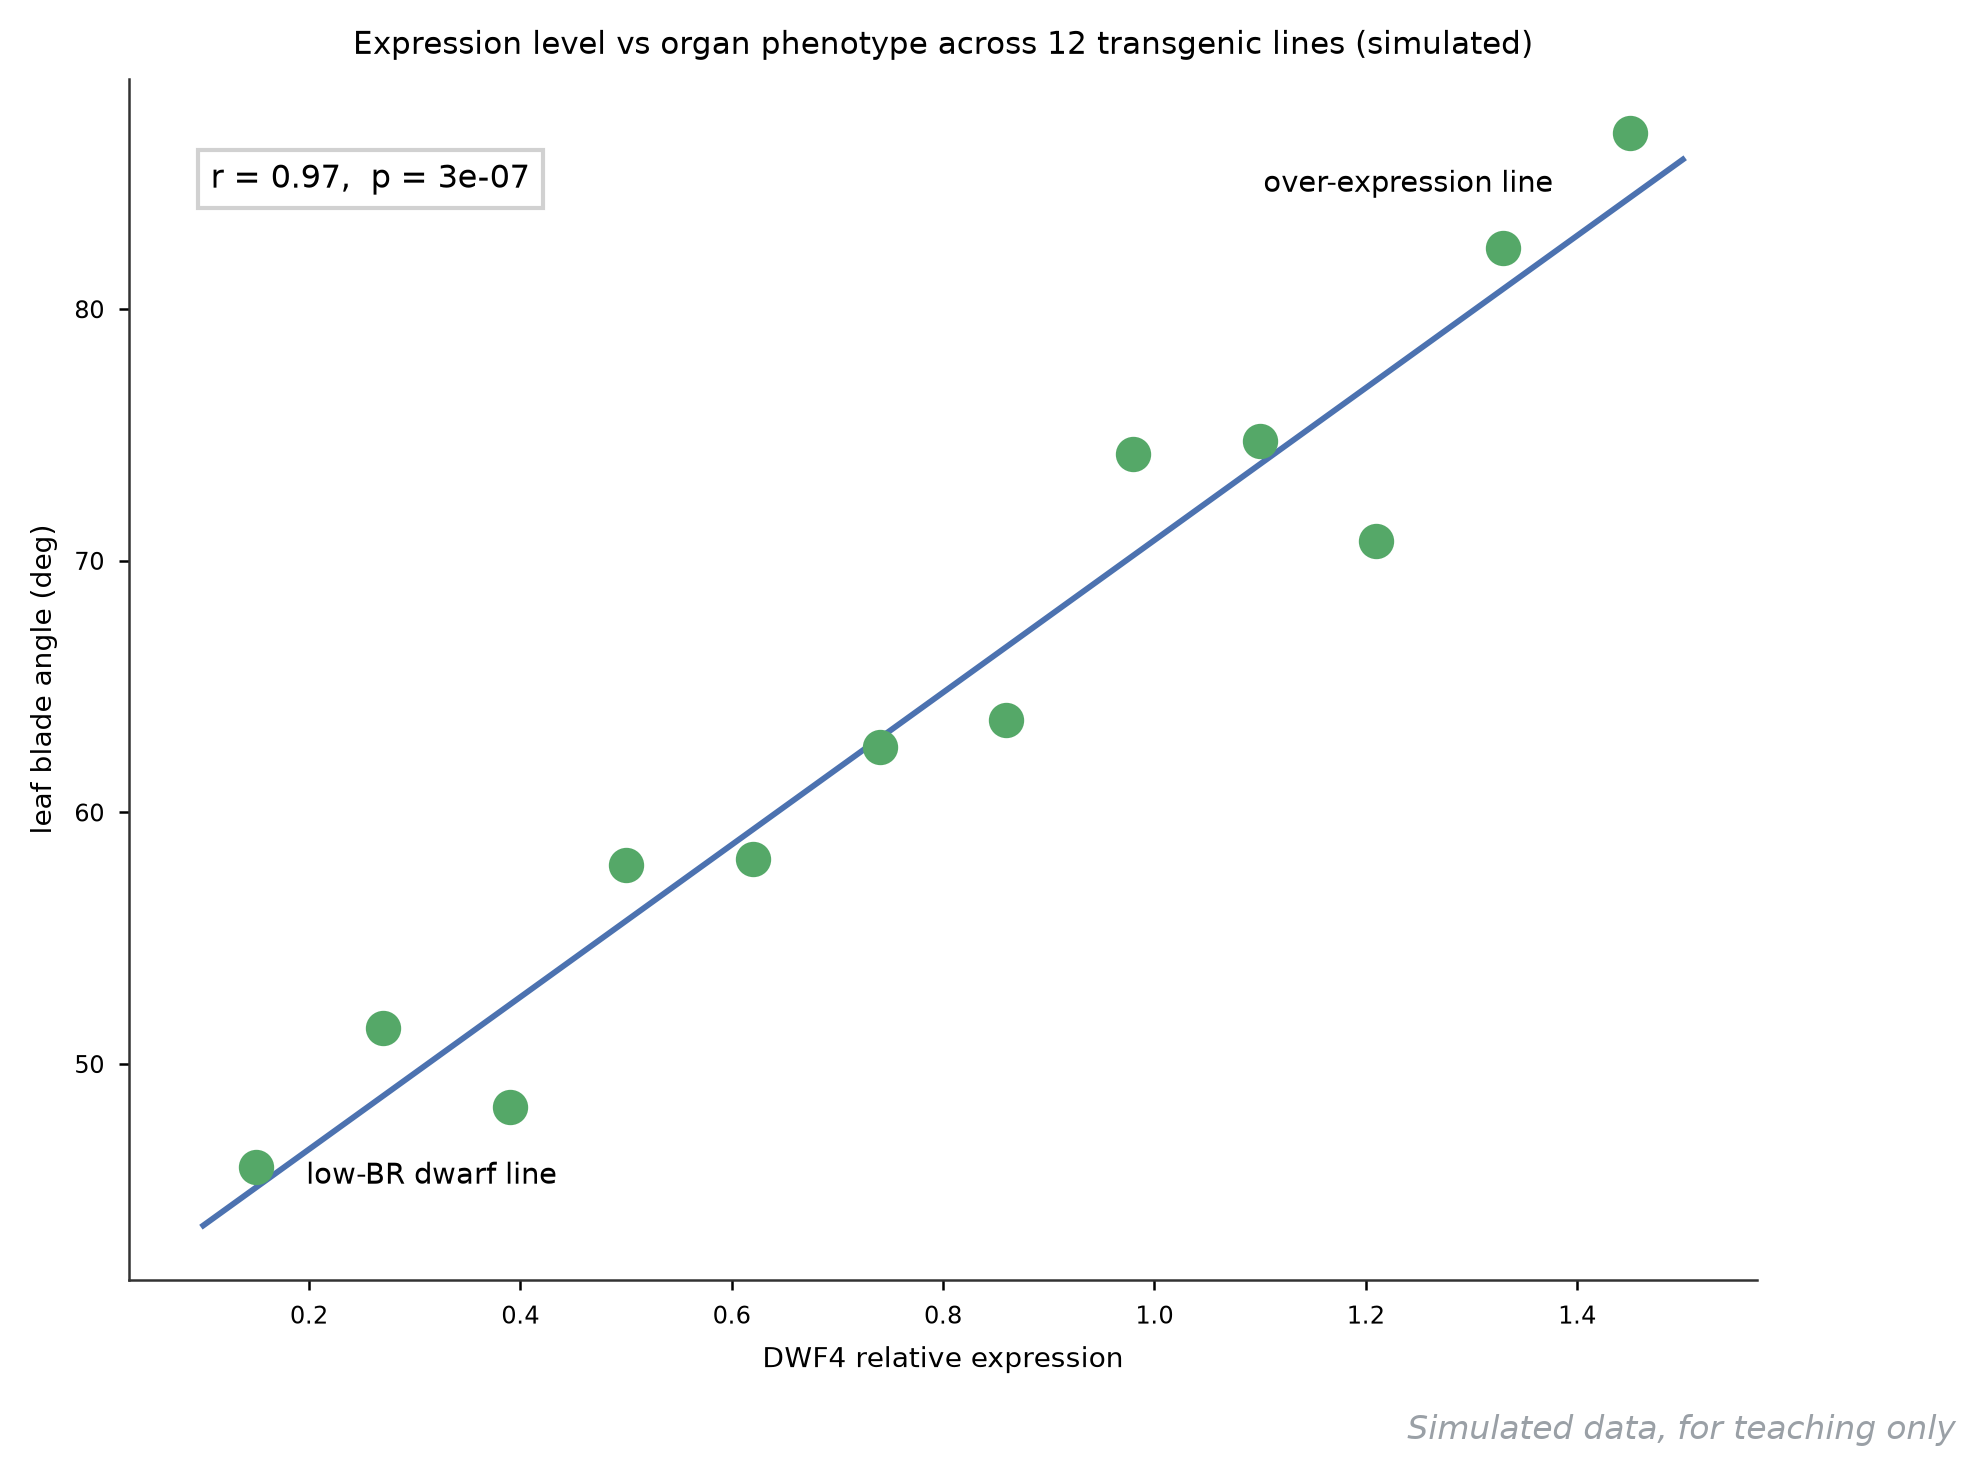
数据:模拟 —— 12 个转基因系的表达与叶角;水印「Simulated data」。
它回答什么问题:表达差异最后连到了农艺性状没有——表达验证的终点图:DWF4 表达量对叶夹角(株型紧凑度)回归,把分子层面的差异翻译成田间看得见的表型。
怎么读:横轴 DWF4 相对表达(0.15-1.45,低表达矮化系到过表达系),纵轴叶夹角(°),12 个系一条回归线。r = 0.97:表达每高 1 个相对单位,叶角张开约 30°;左下角是低 BR 矮化系(叶角 45.9°),右上角过表达系(87.0°)。注意术语:这是相关回归不是因果证明——因果要靠 160 那样的互补实验闭环;过度 claiming 会被审稿人划掉。
用什么画:polyfit 一条线 + 端点注释;12 个系各测一次表达与一次表型,双变量都要报重复。
图注示例:
图 163 12 个转基因系的 DWF4 相对表达与叶夹角的关系(模拟)。回归 r = 0.97,斜率约 30°/表达单位;低表达矮化系叶角 45.9°,过表达系达 87.0°——表达差异与株型表型显著相关(因果关系需互补实验支持)。
展开查看:表达-表型数据与绘图代码
line,expression,leaf_angle_deg
L01,0.15,45.9
L02,0.27,51.4
L03,0.39,48.3
L04,0.50,57.9
L05,0.62,58.1
L06,0.74,62.6
L07,0.86,63.7
L08,0.98,74.3
L09,1.10,74.8
L10,1.21,70.8
L11,1.33,82.4
L12,1.45,87.0绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

D = np.genfromtxt("163-expr-pheno.csv", delimiter=",", names=True)
x, y = D["expression"], D["leaf_angle_deg"]
k, b = np.polyfit(x, y, 1)
r = np.corrcoef(x, y)[0, 1]
fig, ax = plt.subplots(figsize=(7.0, 5.2))
xx = np.linspace(0.1, 1.5, 50)
ax.plot(xx, k * xx + b, color="#4C72B0", lw=1.4)
ax.scatter(x, y, s=56, color="#55A868", zorder=3)
ax.annotate("low-BR dwarf line", (x[0], y[0]), fontsize=9,
            textcoords="offset points", xytext=(12, -4))
ax.annotate("over-expression line", (x[-1], y[-1]), fontsize=9,
            textcoords="offset points", xytext=(-88, -14))
ax.set_xlabel("DWF4 relative expression")
ax.set_ylabel("leaf blade angle (deg)")
ax.text(0.05, 0.93, "r = %.2f" % r, transform=ax.transAxes, fontsize=10,
        va="top")
fig.savefig("163-expr-pheno.png", dpi=200, bbox_inches="tight")七、结构细节与验证补遗(164-173)#
主章讲完,补一批高频但常被漏掉的图:三张真实结构细节图(拉氏图、B 因子、接触数)继续吃 6A15,七张模拟图补齐动力学、氢键、二维互作、共进化和湿实验质控。
7.1 拉氏图(164)#
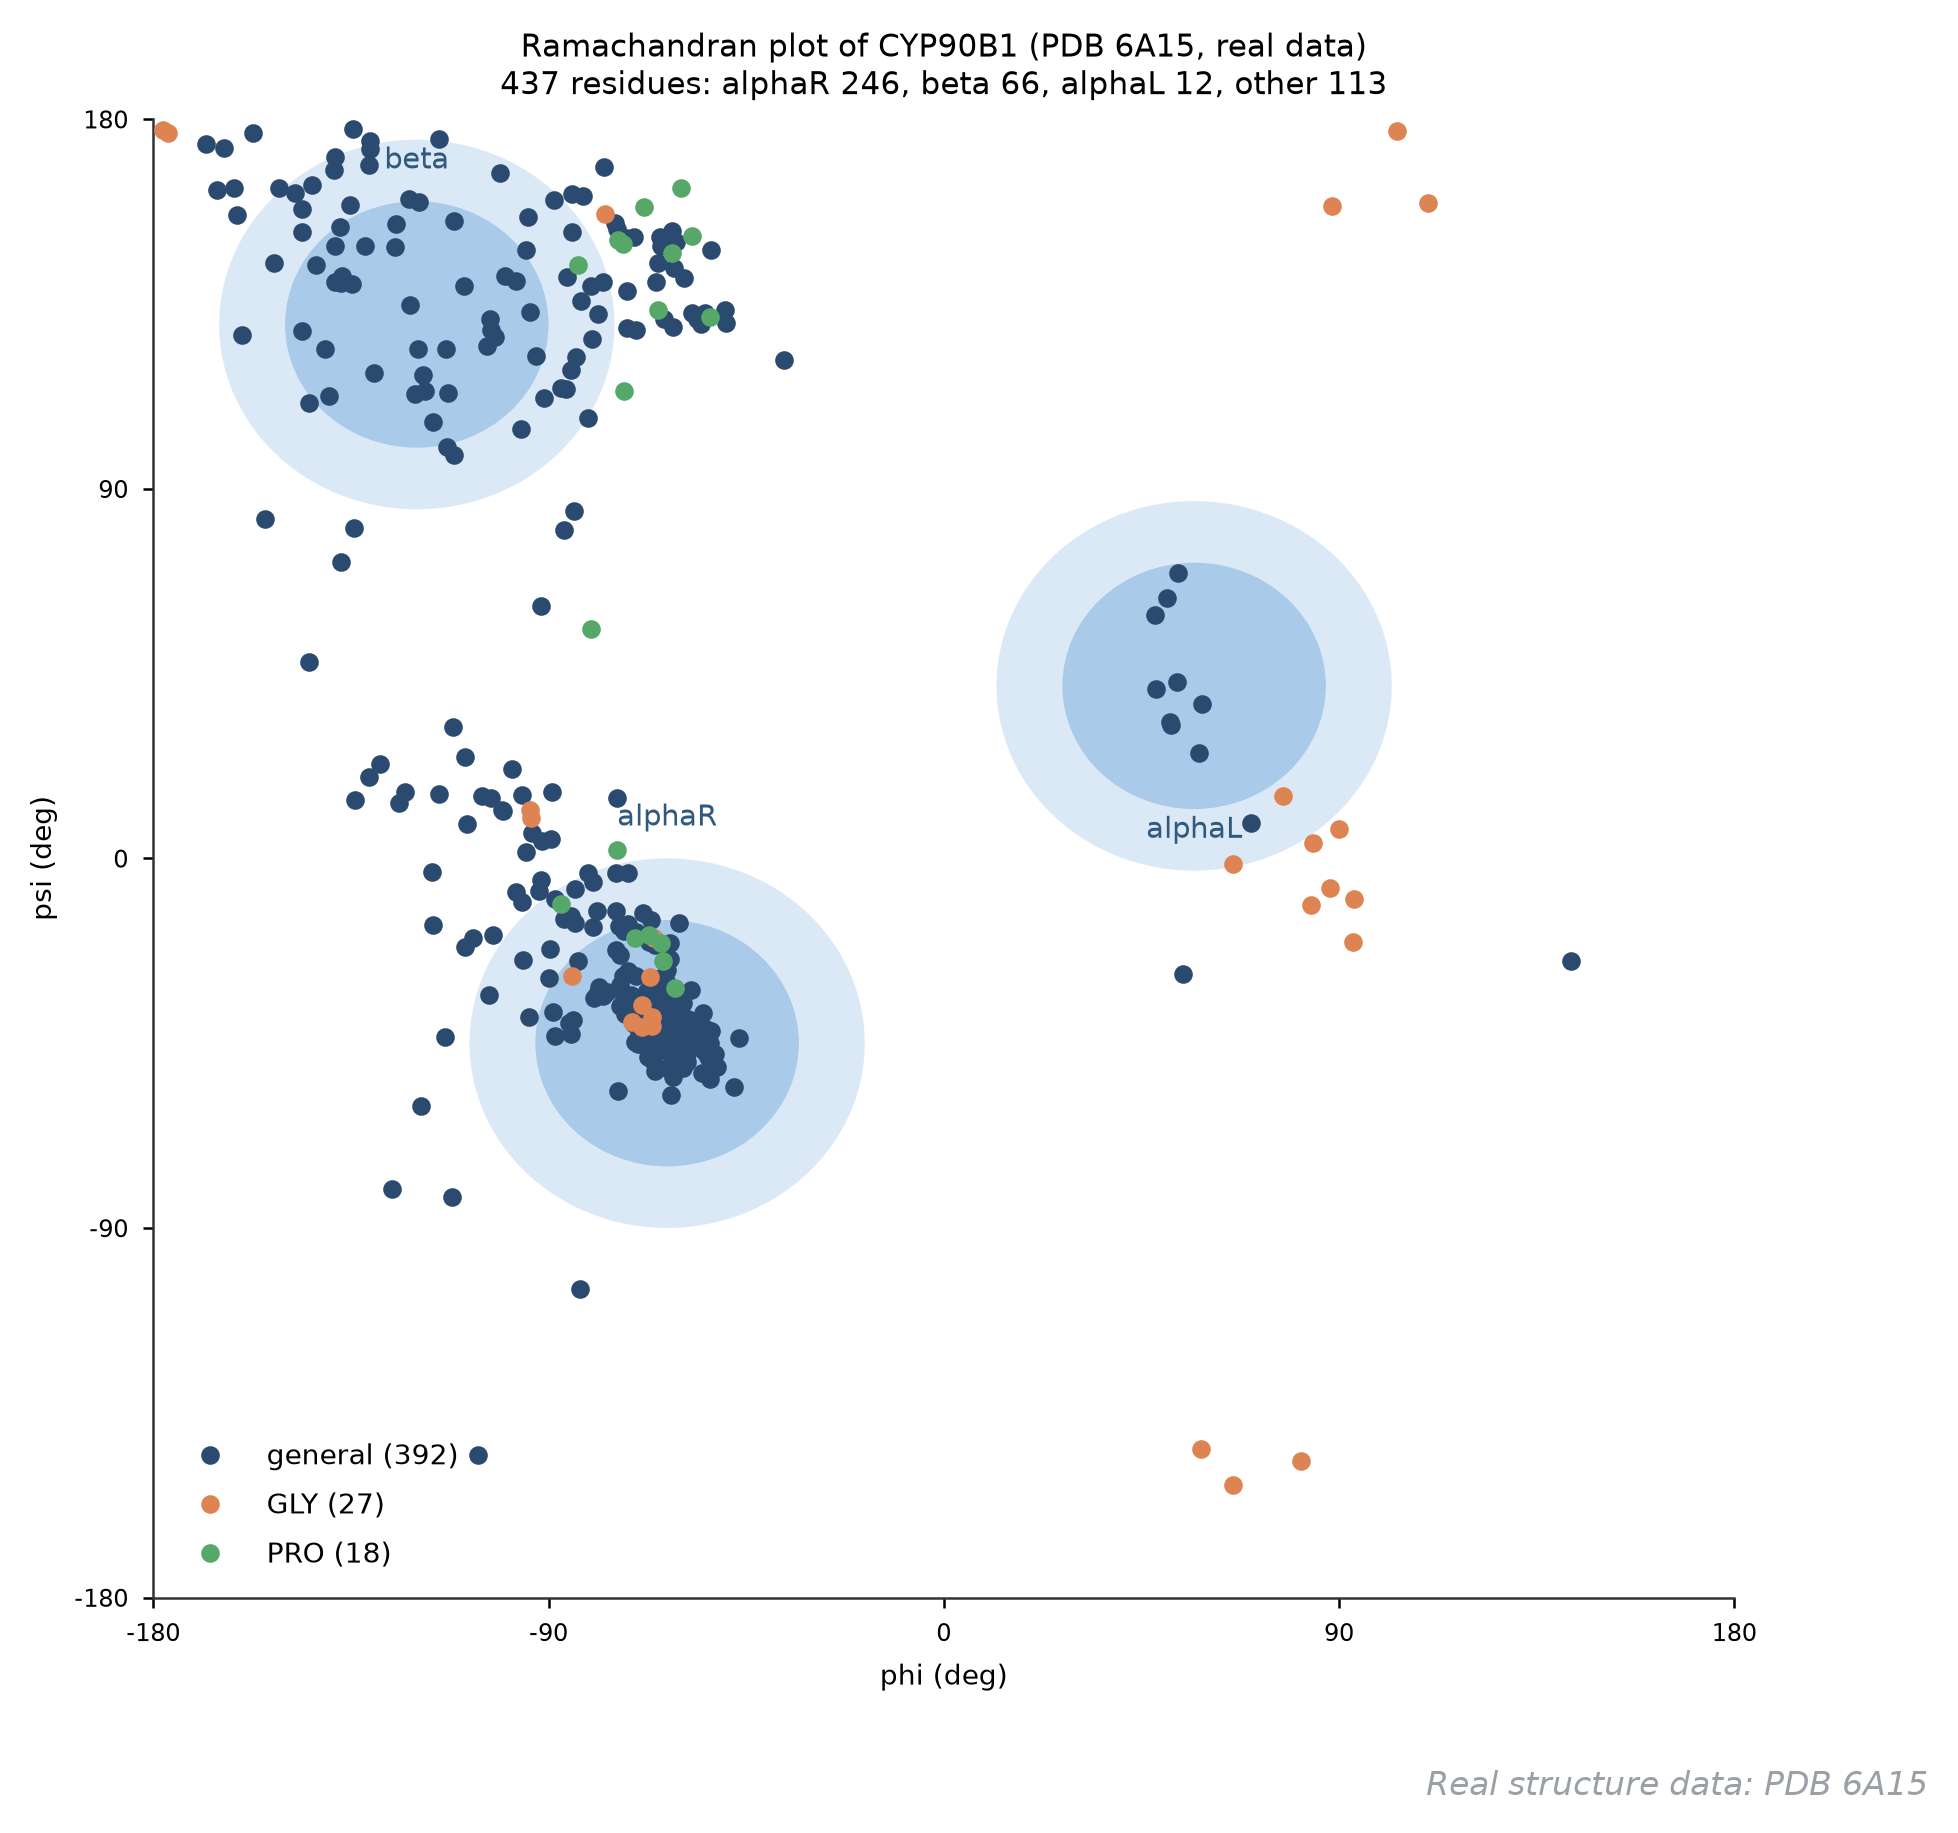
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),φ/ψ 由骨架 N-CA-C 原子直接算出;水印「Real structure data: PDB 6A15」。
它回答什么问题:蛋白主链二面角组合合不合理——结构验证的第一张图,投稿结构论文或用 AlphaFold 模型前的例行体检。
怎么读:横轴 φ(C’-N-CA-C)、纵轴 ψ(N-CA-C-N’),每个非末端残基一个点。本图 437 个可计算残基:246 个落在 αR 区、66 个在 β 区、12 个在左侧手性 αL 区(多为 Gly)、113 个散在区域间隙(桥型与连接构象);一般残基 392、Gly 27(允许区最宽)、Pro 18(挤在 φ≈-60 竖条)。读图纪律:Gly 和 Pro 要分开看——Gly 的允许区几乎是全图,Pro 只占一角。阴影是教学简化的三大偏好区示意,不是 Richardson 标准轮廓,别拿阴影边界当判定线。
用什么画:phenix.ramalyze / MolProbity 出正式判定;本文用 NumPy 二面角公式 + matplotlib 散点自绘。
图注示例:
图 164 CYP90B1 的拉氏图(真实数据,PDB 6A15,437 个可计算残基)。αR 区 246、β 区 66、αL 区 12(多为 Gly)、区域间隙 113;一般残基 392、Gly 27、Pro 18 分色显示。阴影为简化偏好区示意,非标准判定轮廓。
展开查看:二面角计算与绘图代码
绘图代码(Python,独立可运行;需 6a15.pdb)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

def dihedral(p0, p1, p2, p3):
    b0, b1, b2 = (np.array(a) - np.array(b)
                  for a, b in [(p0, p1), (p2, p1), (p3, p2)])
    b1n = b1 / np.linalg.norm(b1)
    v = b0 - np.dot(b0, b1n) * b1n
    w = b2 - np.dot(b2, b1n) * b1n
    return np.degrees(np.arctan2(np.dot(np.cross(b1n, v), w),
                                 np.dot(v, w)))

# 按 PDB 定宽列解析链 A 的 N/CA/C(解析函数同图 134),按残基号排序后
# 逐残基算 phi=C(i-1),N,CA,C 与 psi=N,CA,C,N(i+1),得到 phi/psi 数组。
fig, ax = plt.subplots(figsize=(6.8, 6.4))
for cx, cy in [(-63, -45), (-120, 130), (57, 42)]:
    ax.add_patch(Ellipse((cx, cy), 90, 90, fc="#dbe9f6", ec="none"))
    ax.add_patch(Ellipse((cx, cy), 60, 60, fc="#9dc3e6", alpha=0.8))
ax.scatter(phi, psi, s=12, c="#2b4a6f")
ax.set_xlim(-180, 180); ax.set_ylim(-180, 180)
ax.set_xlabel("phi (deg)"); ax.set_ylabel("psi (deg)")
fig.savefig("164-ramachandran.png", dpi=200, bbox_inches="tight")7.2 逐残基 B 因子曲线(165)#
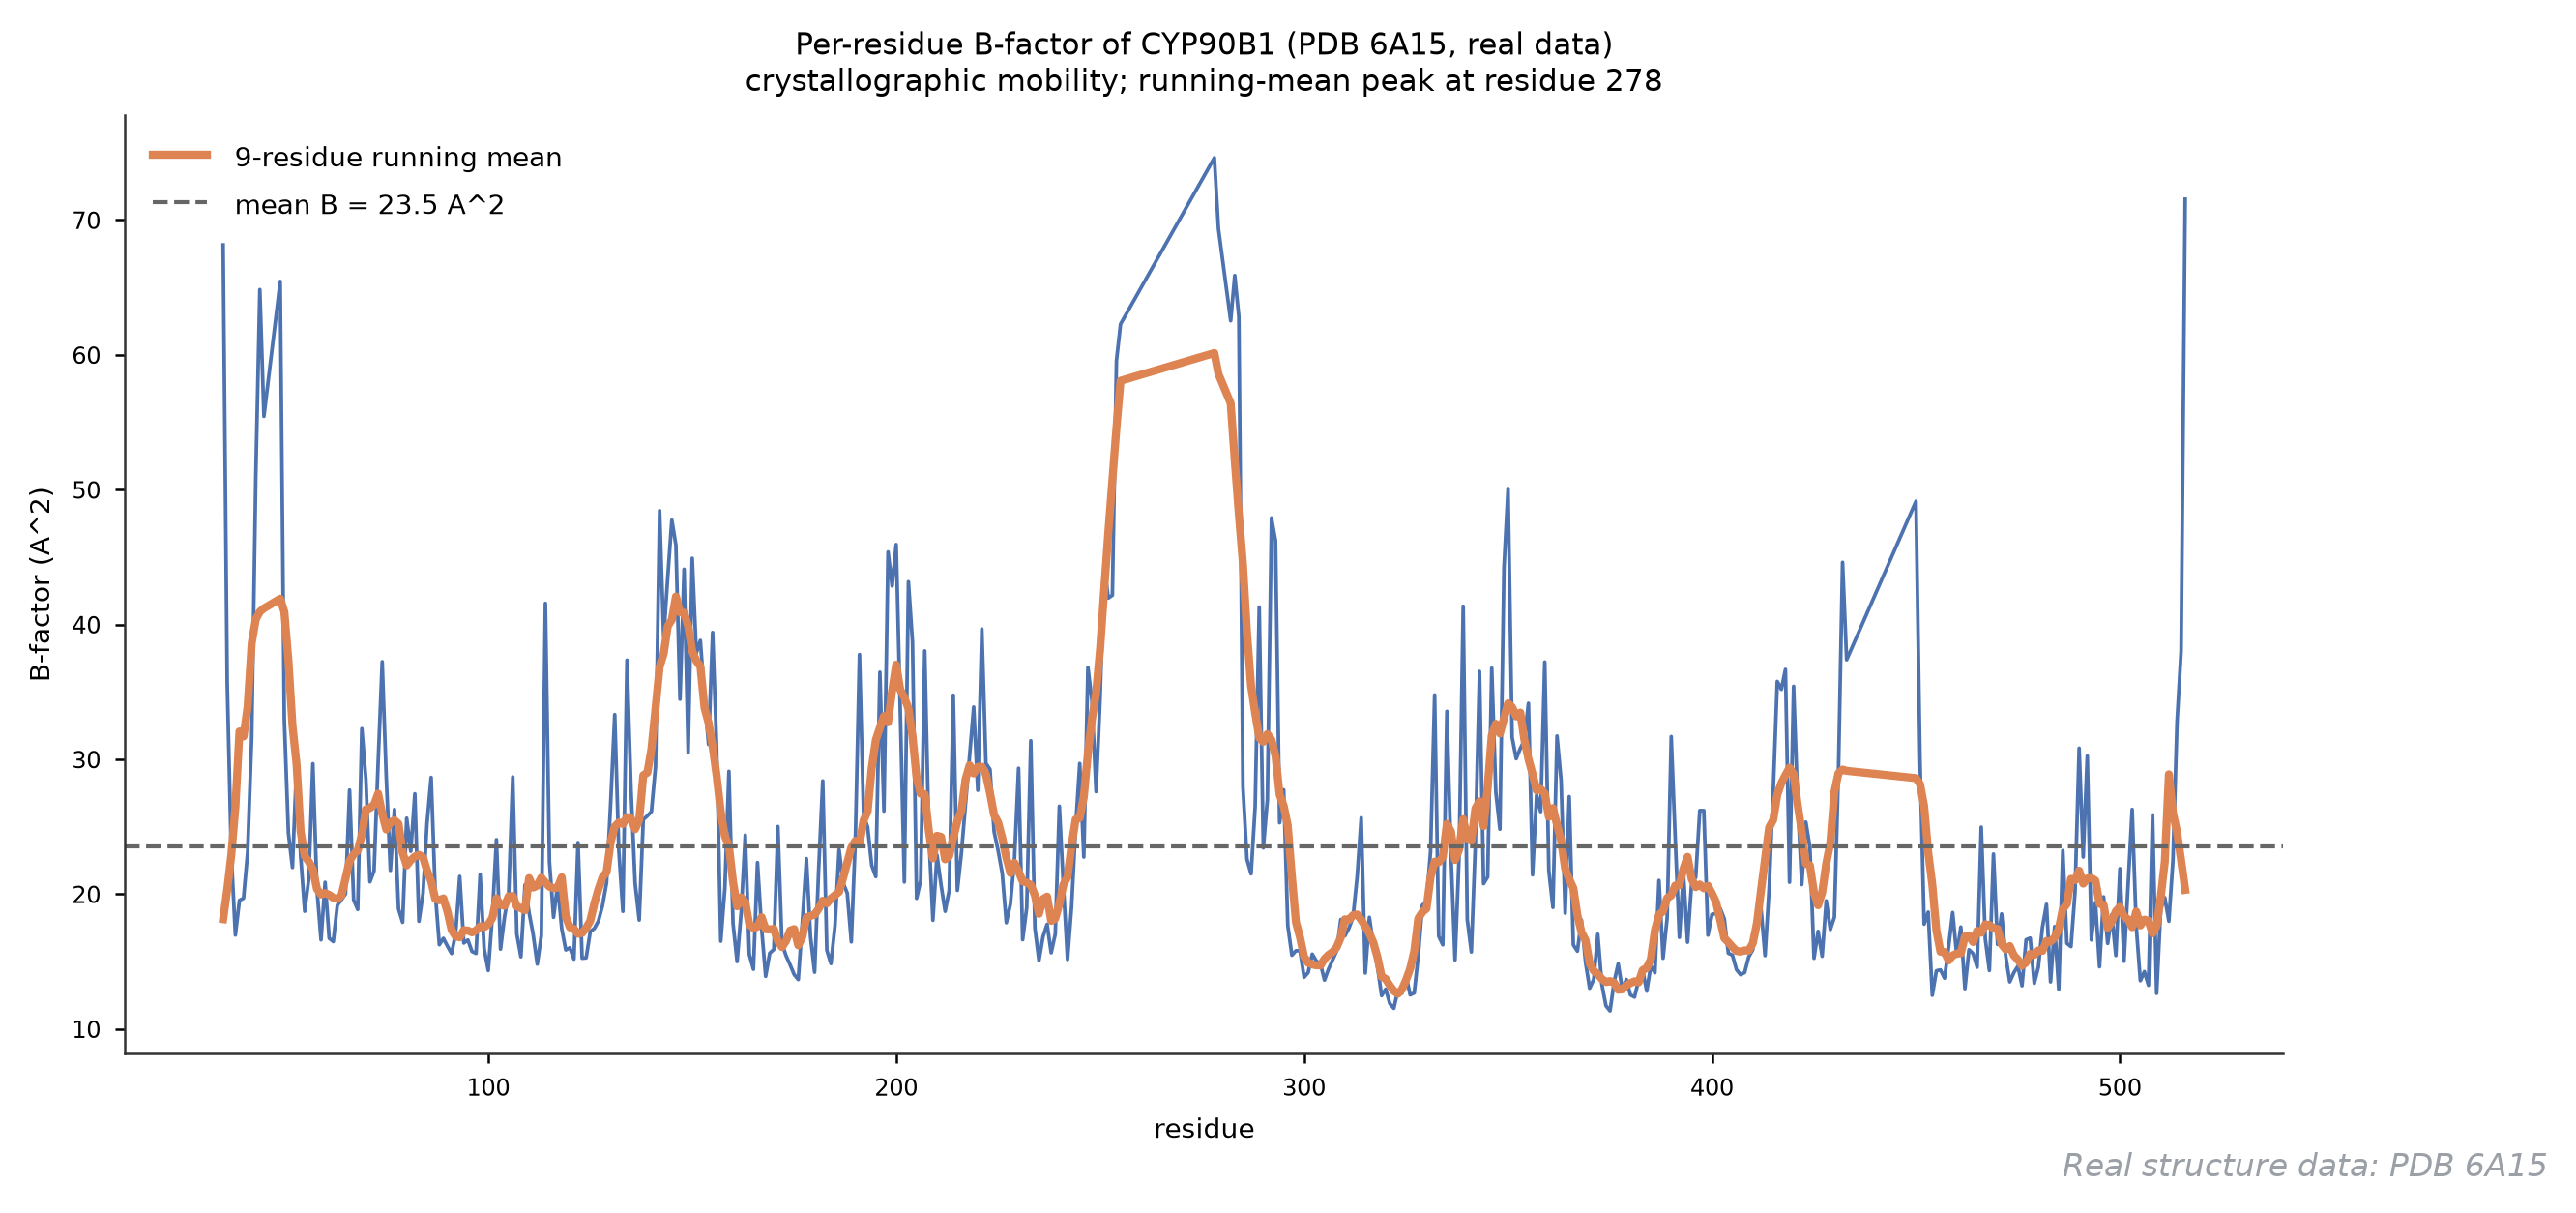
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像),取每个残基全部原子的 B 列均值;水印「Real structure data: PDB 6A15」。
它回答什么问题:晶体里哪段最”晃”——B 因子是实验测到的柔性/无序代理,和 AlphaFold 的 pLDDT(图 141)互为印证:一个来自 X 射线衍射,一个来自深度学习,说的都是同一件事的两面。
怎么读:横轴残基,纵轴平均 B(Ų)。本图均值 23.5 Ų;9 残基滑动均值的最高峰在 残基 278 附近(60.1 Ų)——I 螺旋上的一段柔性转角;C 端 511-516(纯化用 His 尾)飙到 70 以上,典型的”标签尾巴不进晶格”。读法:高峰=表面环或末端(可信度低但常是功能开关),低谷=疏水核心(最刚硬)。讨论功能位点时先看它落峰还是落谷。
用什么画:PDB B 列逐残基均值一行 groupby 搞定;对比版可把 apo/holo 两个结构的 B 差值画双线。
图注示例:
图 165 CYP90B1 逐残基 B 因子(真实数据,PDB 6A15,残基原子均值)。全链均值 23.5 Ų,滑动均值最高峰位于残基 278 附近(60.1 Ų),C 端 His 尾(511-516)超过 70 Ų。
展开查看:B 因子数据(节选)与绘图代码
residue,mean_B
24,36.5
25,41.2
60,15.4
61,14.9
278,60.1
279,58.9
516,72.0(完整 439 残基值由代码从 PDB B 列直接算出。)
绘图代码(接图 134 的 parse())
import numpy as np

per = {}
for a in parse("6a15.pdb"):
    if a["chain"] == "A" and not a["het"]:
        per.setdefault(a["resi"], []).append(a["b"])
ris = sorted(per)
b = np.array([np.mean(per[r]) for r in ris])
k = np.convolve(b, np.ones(9) / 9, "same")
# 画图:ris 对 b 细线 + ris 对 k 粗线 + 均值虚线7.3 逐残基接触数曲线(166)#
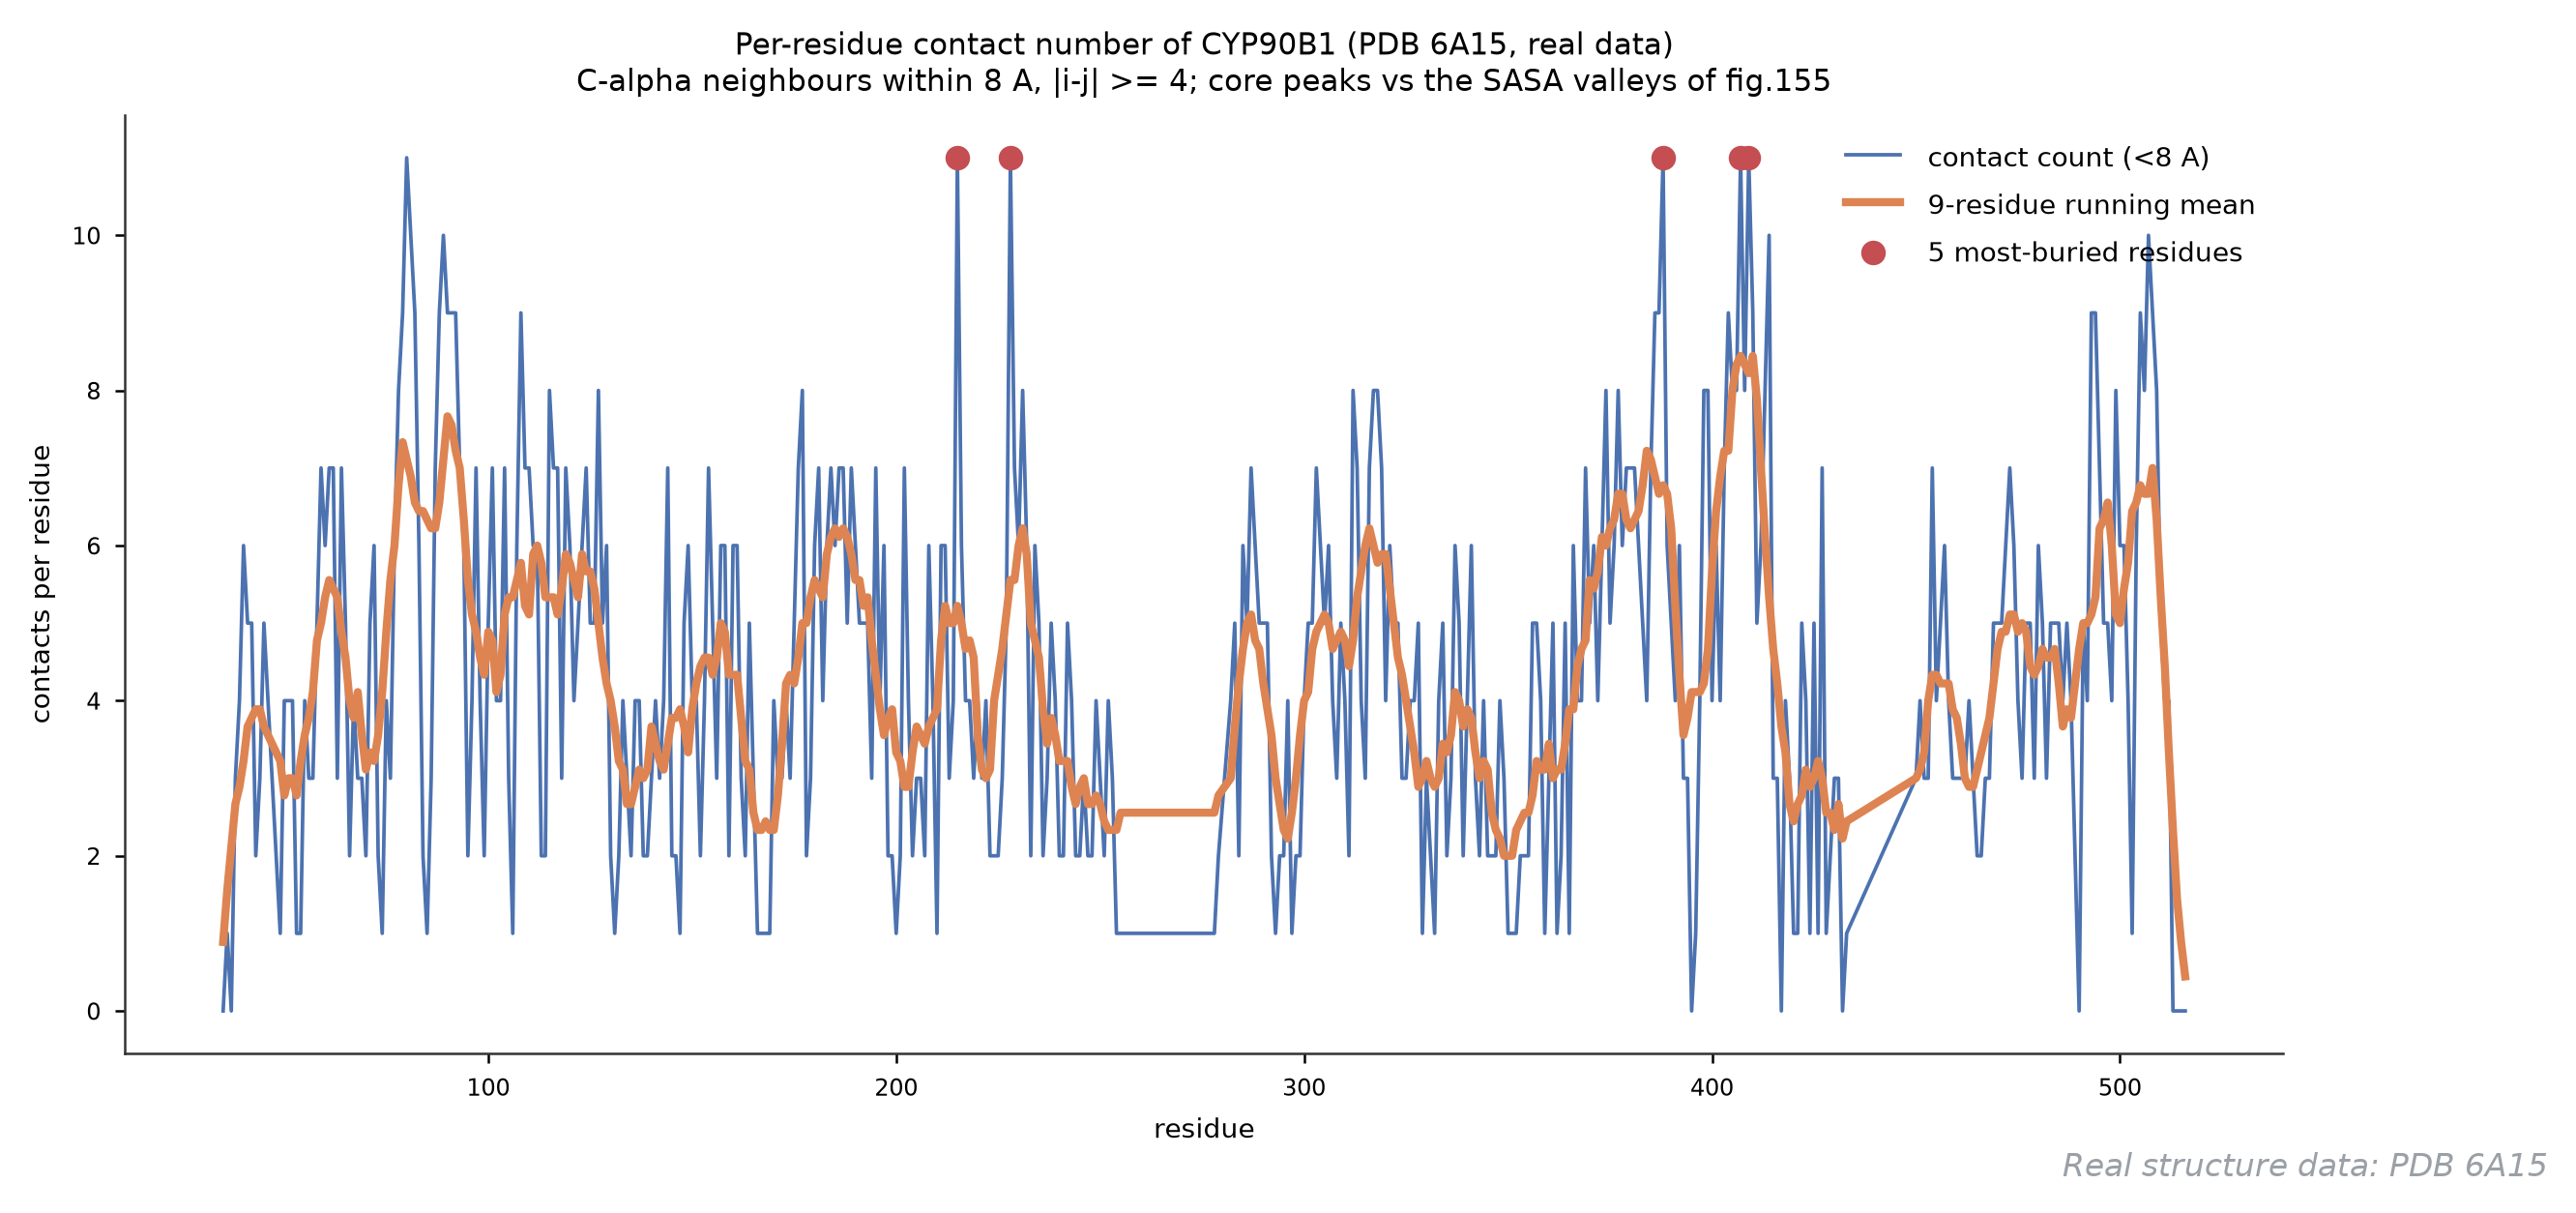
数据:真实 —— PDB 6A15 ↗(下载 ↗ · 本站镜像);水印「Real structure data: PDB 6A15」。
它回答什么问题:谁埋在疏水核心——每个残基周围 8 Å 内有多少个序列远邻的 C-alpha,一个比 SASA 更便宜的”埋没程度”指标,与图 155 严格互补(接触数的峰对 SASA 的谷)。
怎么读:本图最埋没的 5 个残基是 409、215、228、407、388(各 11 个接触),全是 P450 核心螺旋上的残基;表面环只有 0-2 个接触。判读口径:接触数 ≥8 = 核心骨灰级,≤2 = 表面或柔性环。注意晶体缺口(439 个解析残基中间的未解析环)会让缺口两侧的接触数被低估——缺口不是”柔性”,是”没看见”。
用什么画:KD-tree 或距离矩阵 + |i-j|>=4 掩码一行算出;正式分析常用 8/10/12 Å 三档敏感性。
图注示例:
图 166 CYP90B1 逐残基接触数(真实数据,PDB 6A15,C-alpha 距离小于 8 Å 且序列间隔不小于 4)。最埋没的 5 个残基为 409、215、228、407、388(各 11 个接触),均位于折叠核心;接触数与图 155 的 SASA 呈反相关。
展开查看:接触数数据与计算代码
residue,contacts
409,11
215,11
228,11
407,11
388,11(5 个最埋没残基;全残基序列由代码输出。)
计算代码(接图 134 的 parse())
import numpy as np

ca = [a for a in parse("6a15.pdb")
      if a["chain"] == "A" and not a["het"] and a["name"] == "CA"]
ris = [a["resi"] for a in ca]
P = np.array([a["xyz"] for a in ca])
D = np.linalg.norm(P[:, None, :] - P[None, :, :], axis=-1)
sep = np.abs(np.arange(len(ris))[:, None] - np.arange(len(ris))[None, :])
n = ((D < 8.0) & (sep >= 4)).sum(1)7.4 RMSD/Rg 动力学轨迹(167)#
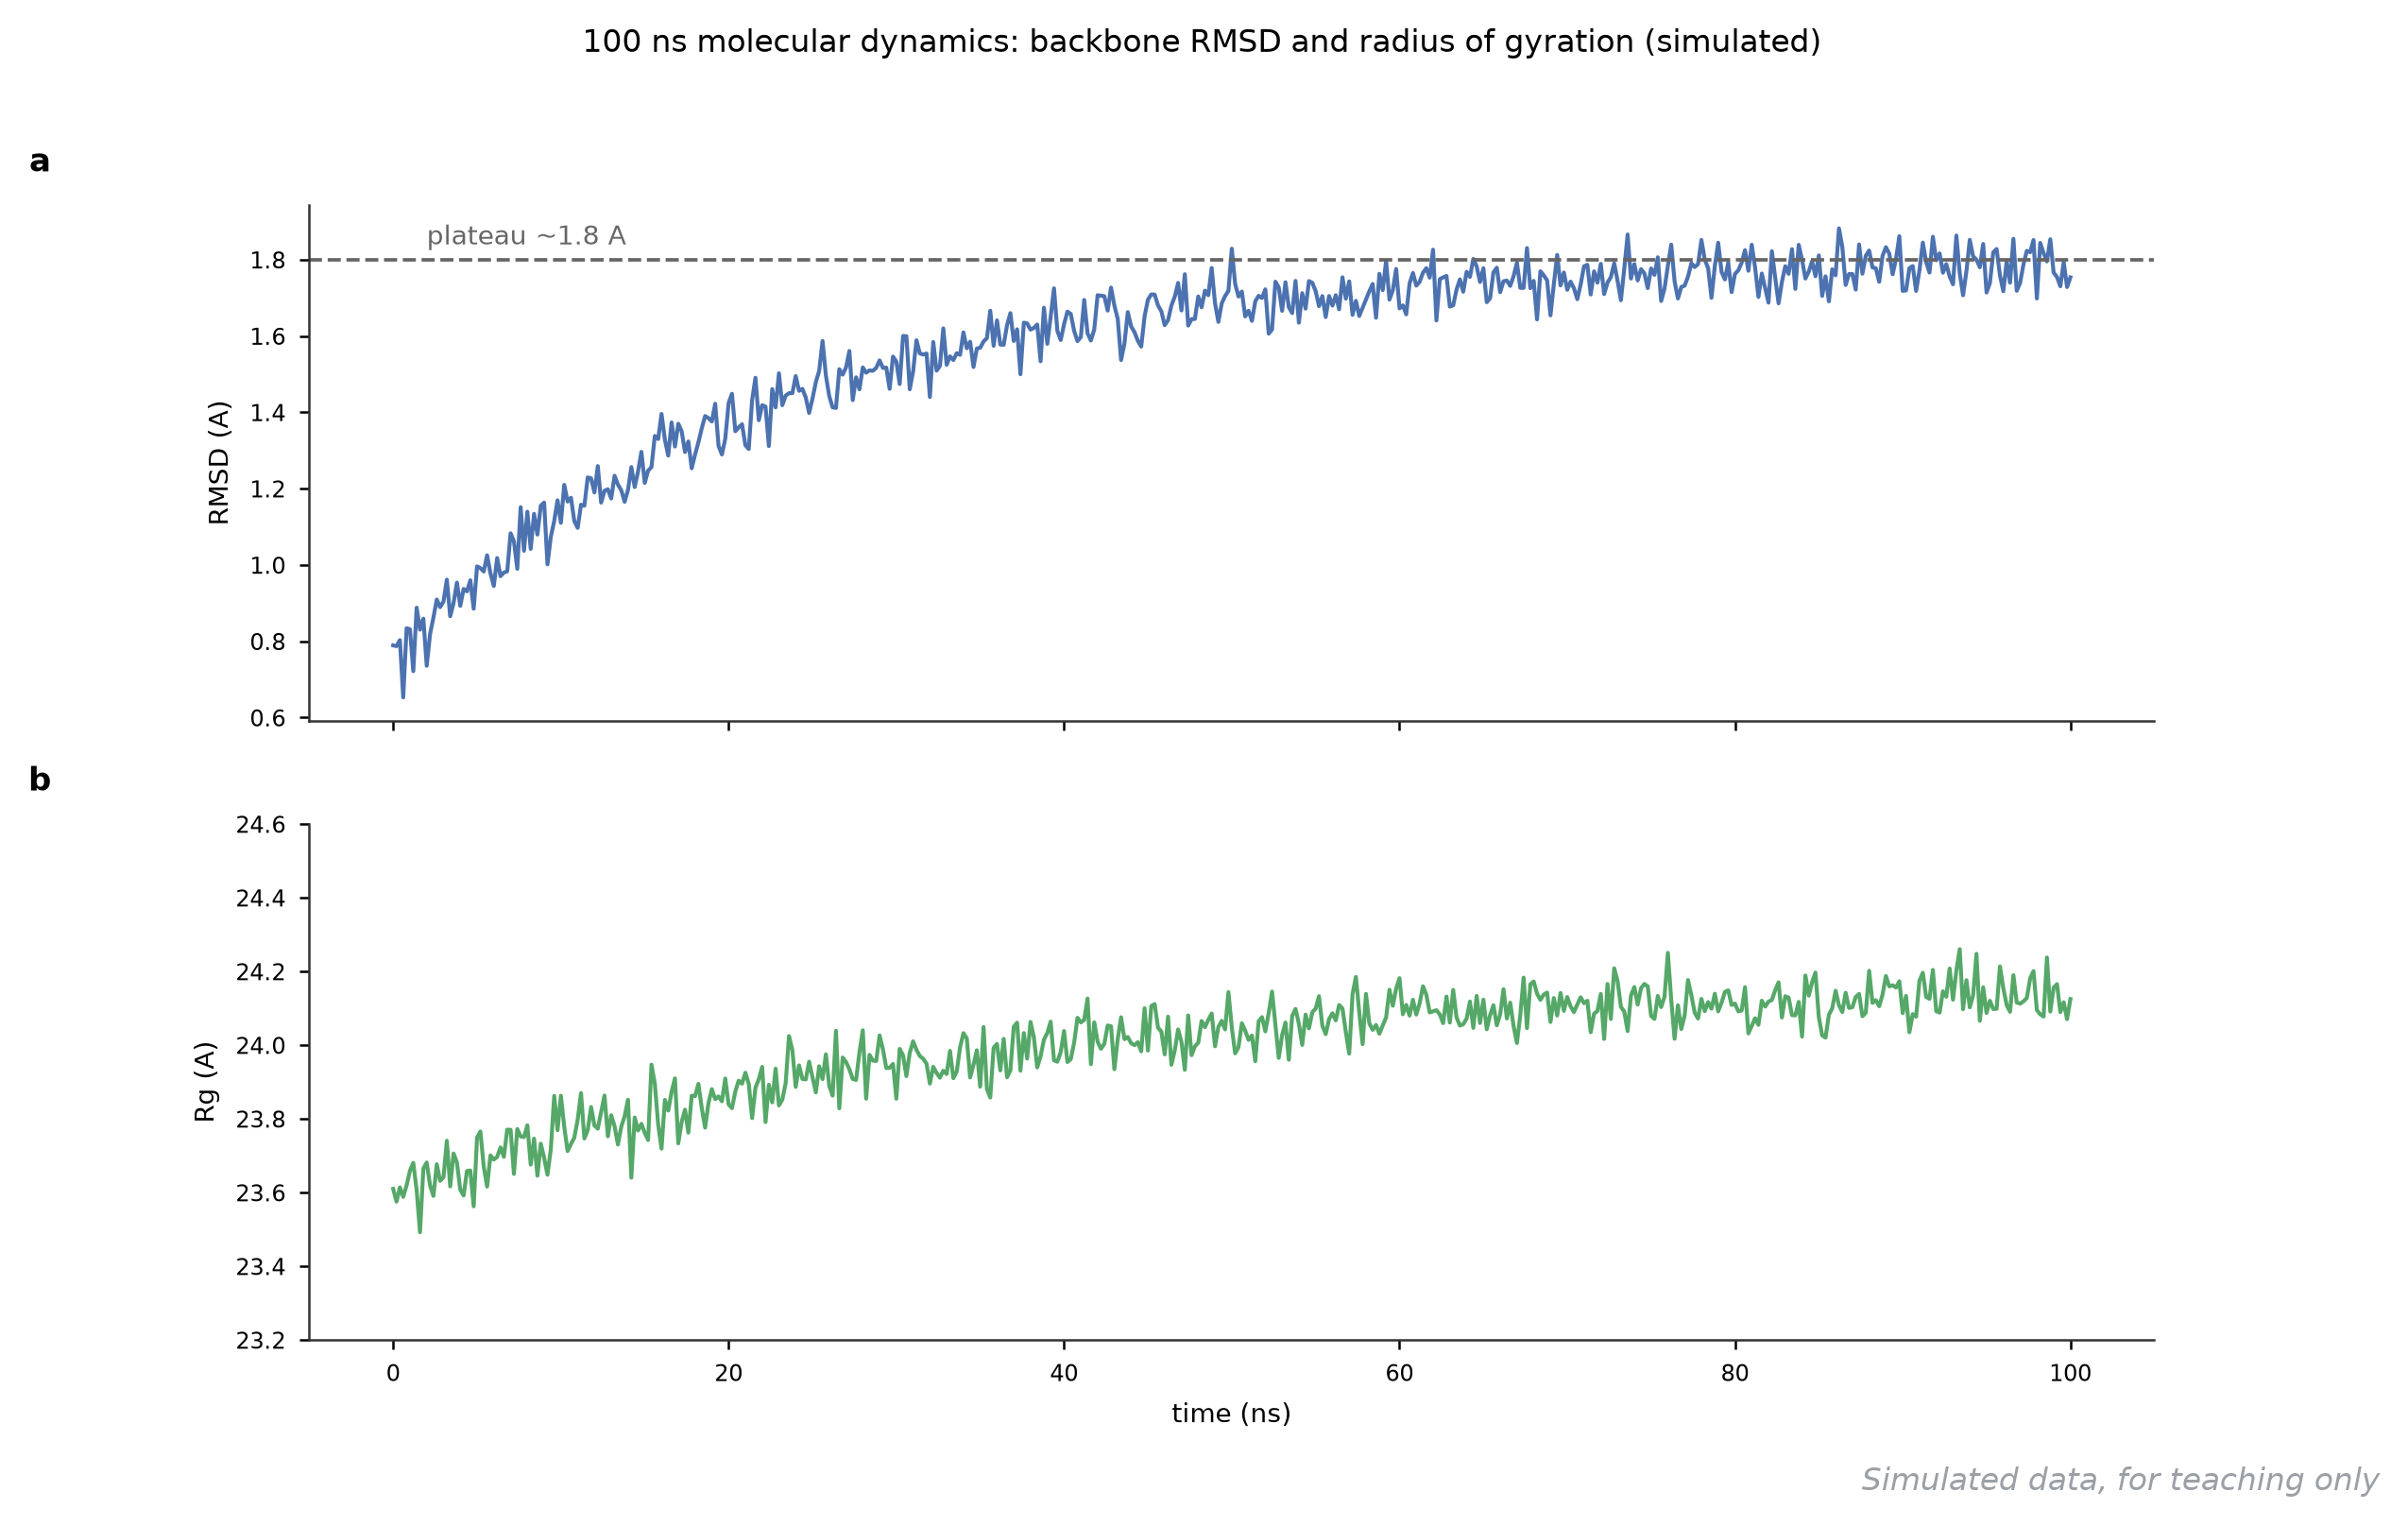
数据:模拟 —— 固定种子生成的 100 ns 轨迹指标;水印「Simulated data」。
它回答什么问题:分子动力学模拟”跑稳了没有”——任何 MD 结论(第四篇的 RMSF 106、自由能 landscape 107,本篇的氢键占用 168)成立的前提,都是 RMSD/Rg 先进入平台期。
怎么读:上轨骨架 RMSD 对初始结构:从 0.80 Å 爬升约 40 ns 后稳定在 ~1.8 Å 平台——爬升是正常弛豫,平台才是采样窗口;下轨回转半径 Rg 从 23.61 → 24.13 Å,微微变松(约 +2%)。判读三律:平台抖动幅度 ≪ 爬升幅度才算稳;两个独立重复都进同一个平台才算收敛;Rg 猛涨=展开,猛跌=塌缩,都要回看轨迹。
用什么画:GROMACS gmx rms/gmx gyrate 或 CPPTRAJ 出表后双面板折线。
图注示例:
图 167 100 ns 分子动力学的主链 RMSD 与回转半径(模拟)。RMSD 自 0.80 Å 弛豫至约 1.8 Å 平台,Rg 由 23.61 Å 微增至 24.13 Å(+2%),整体折叠保持稳定,40 ns 后可视为采样窗口。
展开查看:轨迹数据与绘图代码
time_ns,rmsd_A,rg_A
0,0.80,23.61
20,1.31,23.86
40,1.58,24.01
60,1.71,24.06
80,1.78,24.10
100,1.76,24.13绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rng = np.random.default_rng(5167)
t = np.linspace(0, 100, 501)
rmsd = 0.75 + 1.05 * (1 - np.exp(-t / 22)) + rng.normal(0, 0.045, len(t))
rg = 23.6 + 0.55 * (1 - np.exp(-t / 30)) + rng.normal(0, 0.05, len(t))
fig, (a1, a2) = plt.subplots(2, 1, figsize=(8.4, 5.2), sharex=True)
a1.plot(t, rmsd, color="#4C72B0", lw=1.0)
a1.set_ylabel("RMSD (A)")
a2.plot(t, rg, color="#55A868", lw=1.0)
a2.set_ylabel("Rg (A)")
a2.set_xlabel("time (ns)")
fig.savefig("167-md-trace.png", dpi=200, bbox_inches="tight")7.5 氢键占用率热图(168)#
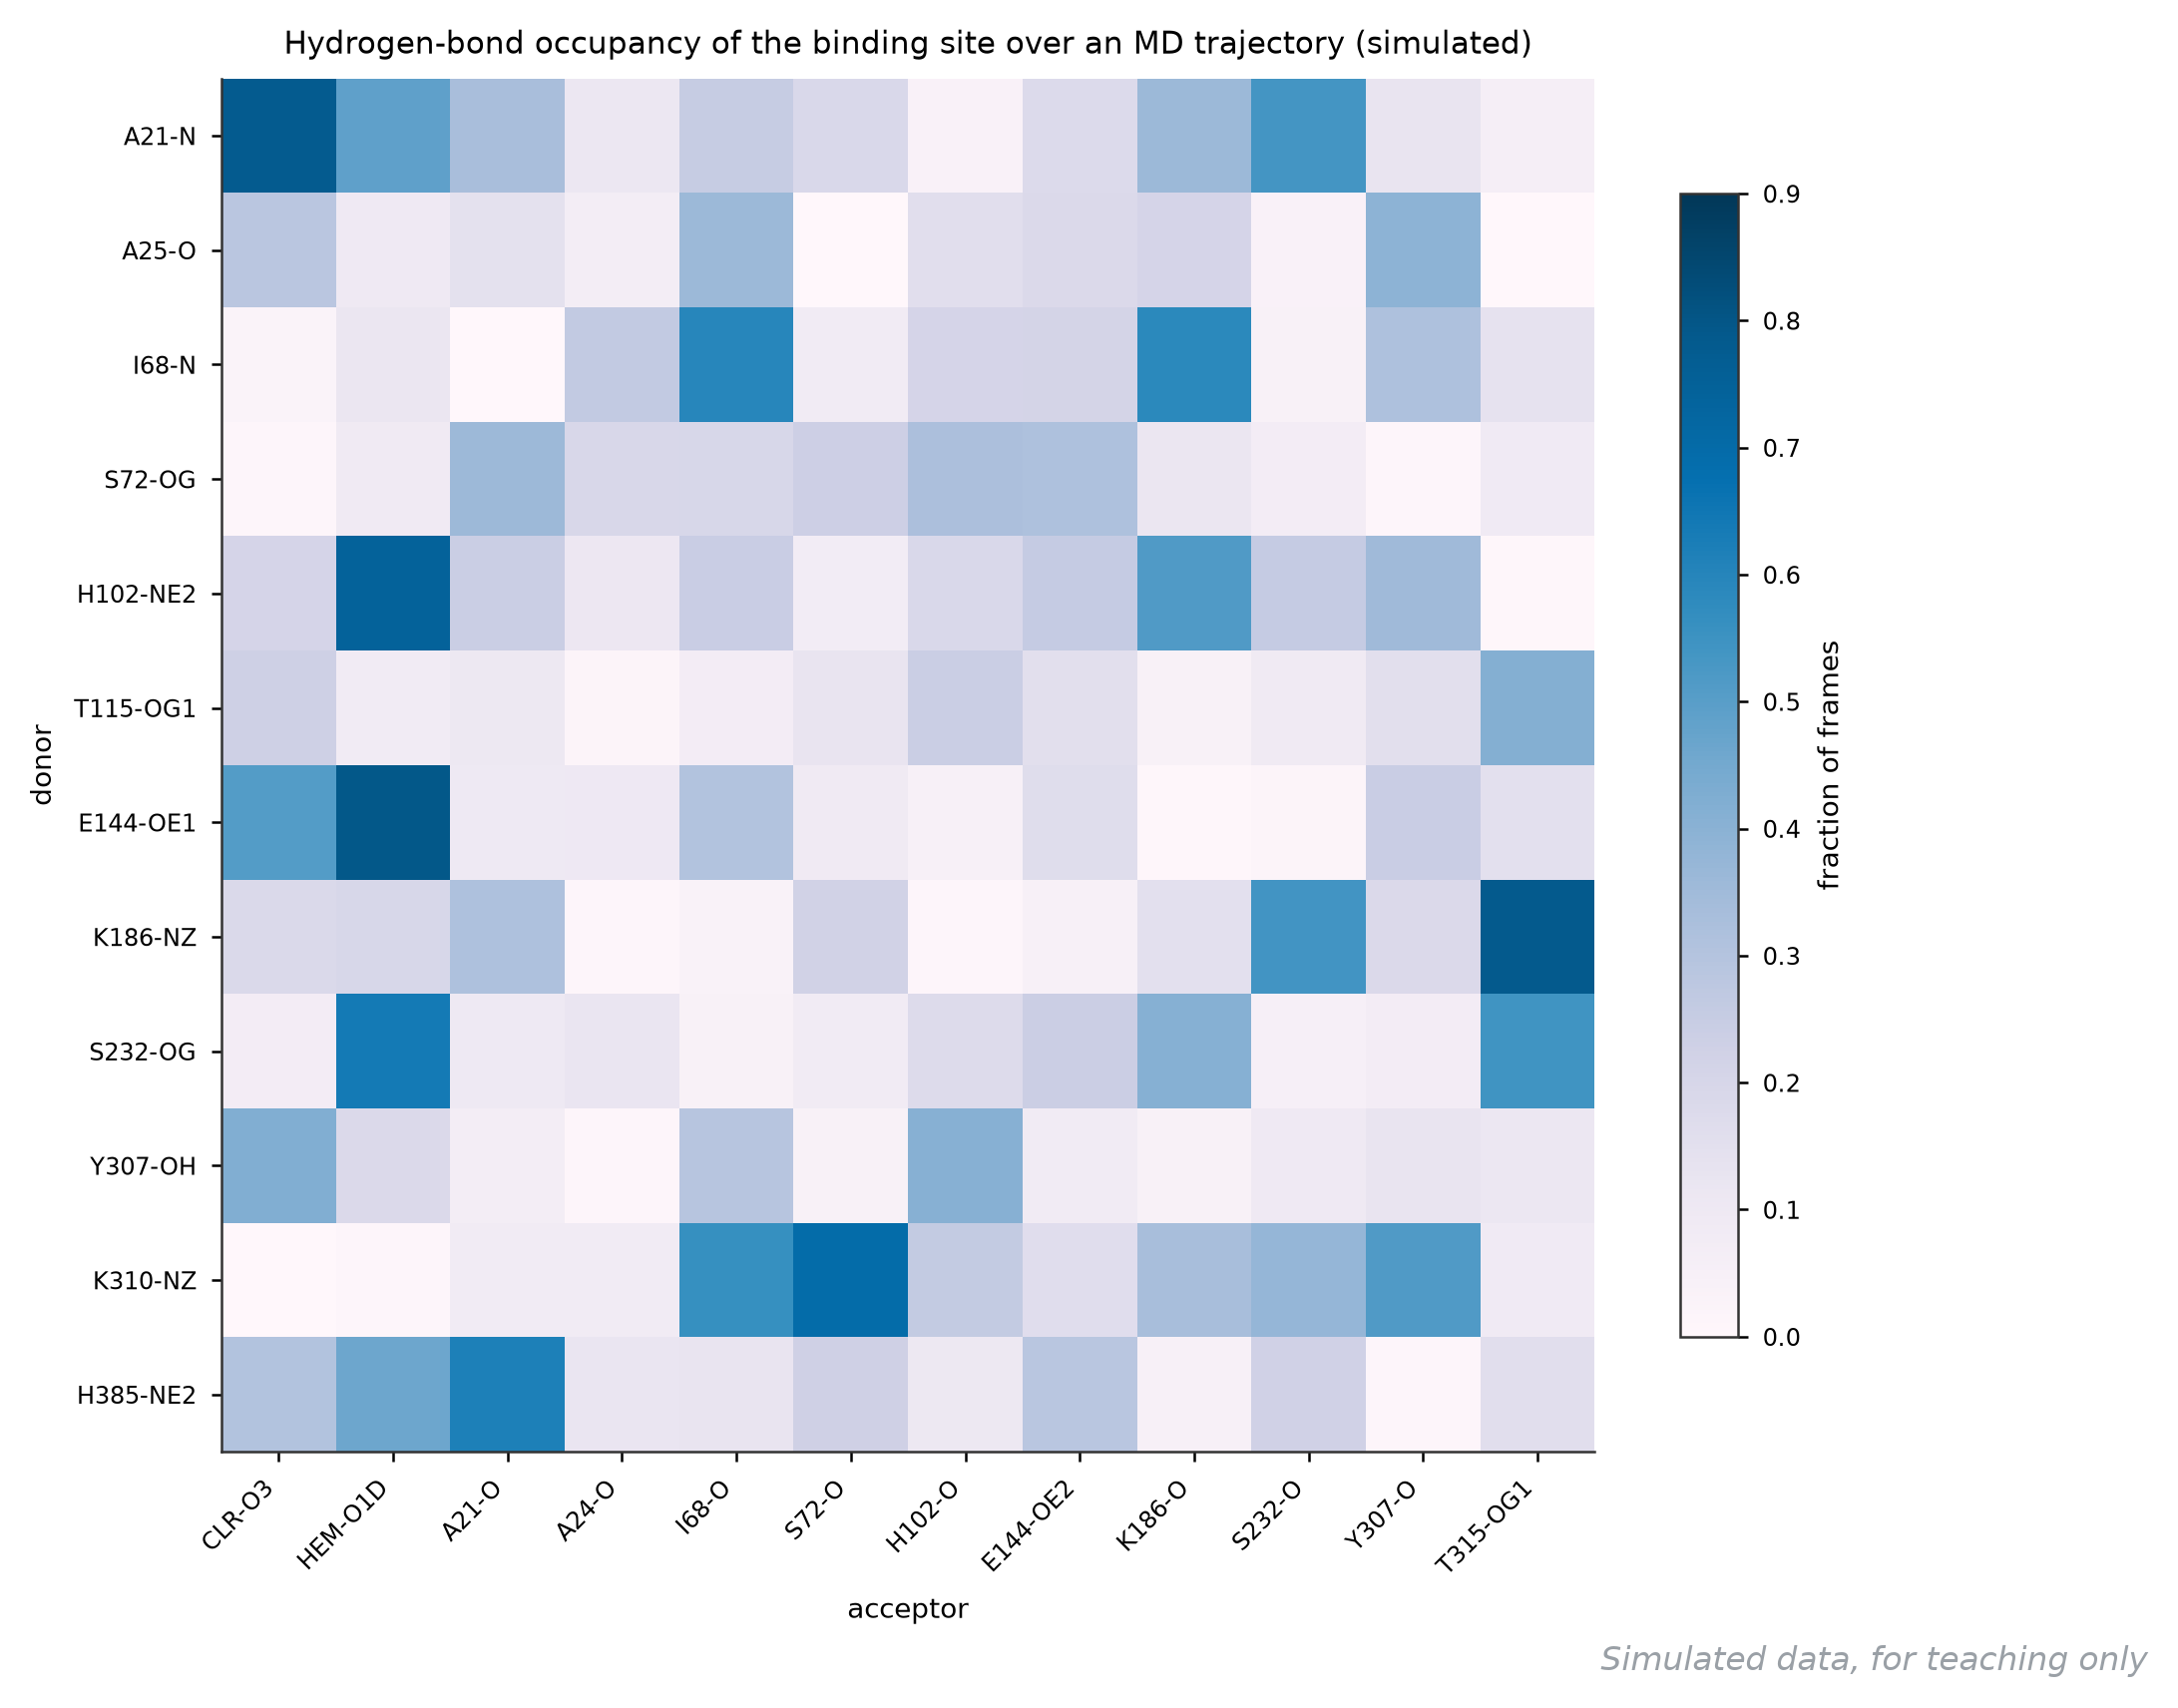
数据:模拟 —— 轨迹中给体-受体对处于氢键几何范围内的帧占比;水印「Simulated data」。
它回答什么问题:静态结构里”看到”的氢键,在溶液里到底常在还是偶现——配体结合模式、突变位点选择的定量化依据(胆固醇 3 位羟基是被锚住还是搭一下就走)。
怎么读:行=给体、列=受体,颜色=占用率(轨迹帧占比)。本图两条主线:A21-N ↔ CLR-O3 占用 0.78(胆固醇 3-OH 的锚定氢键,贯穿大半轨迹)、Y307-OH ↔ CLR-O3 0.42(半程辅助)。判读口径:>0.5 稳定氢键、0.1-0.5 摆动氢键、<0.1 视为噪声;注意给体-受体身份要对(供体 NH/OH 对受体 O/N),对角线附近的”自己对自己”格没有意义。
用什么画:MD 轨迹逐帧判氢键几何(距离 <3.5 Å 且角度 >150°)后 imshow;工具链 CPPTRAJ / MDAnalysis 都有现成函数。
图注示例:
图 168 结合位点氢键占用率热图(模拟,MD 轨迹帧占比)。A21-N 与胆固醇 O3 的氢键占用 0.78 为主要锚点,Y307-OH 占用 0.42 为辅助;占用率低于 0.1 的格视为噪声。
展开查看:占用率数据与绘图代码
donor,acceptor,occupancy
A21-N,CLR-O3,0.78
Y307-OH,CLR-O3,0.42
I68-N,I68-O,0.55
E144-OE1,HEM-O1D,0.60绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

lines = open("168-hbond.csv").read().splitlines()
don = [ln.split(",")[0] for ln in lines[1:]]
acc = [ln.split(",")[1] for ln in lines[1:]]
occ = [float(ln.split(",")[2]) for ln in lines[1:]]
M = np.zeros((12, 12))
for d, a, o in zip(don, acc, occ):
    M[don.index(d), acc.index(a)] = o
fig, ax = plt.subplots(figsize=(7.4, 6.2))
im = ax.imshow(M, cmap="PuBu", vmin=0, vmax=0.9)
fig.colorbar(im, ax=ax, shrink=0.8, label="fraction of frames")
fig.savefig("168-hbond-occupancy.png", dpi=200, bbox_inches="tight")7.6 二维蛋白-配体互作图(169)#
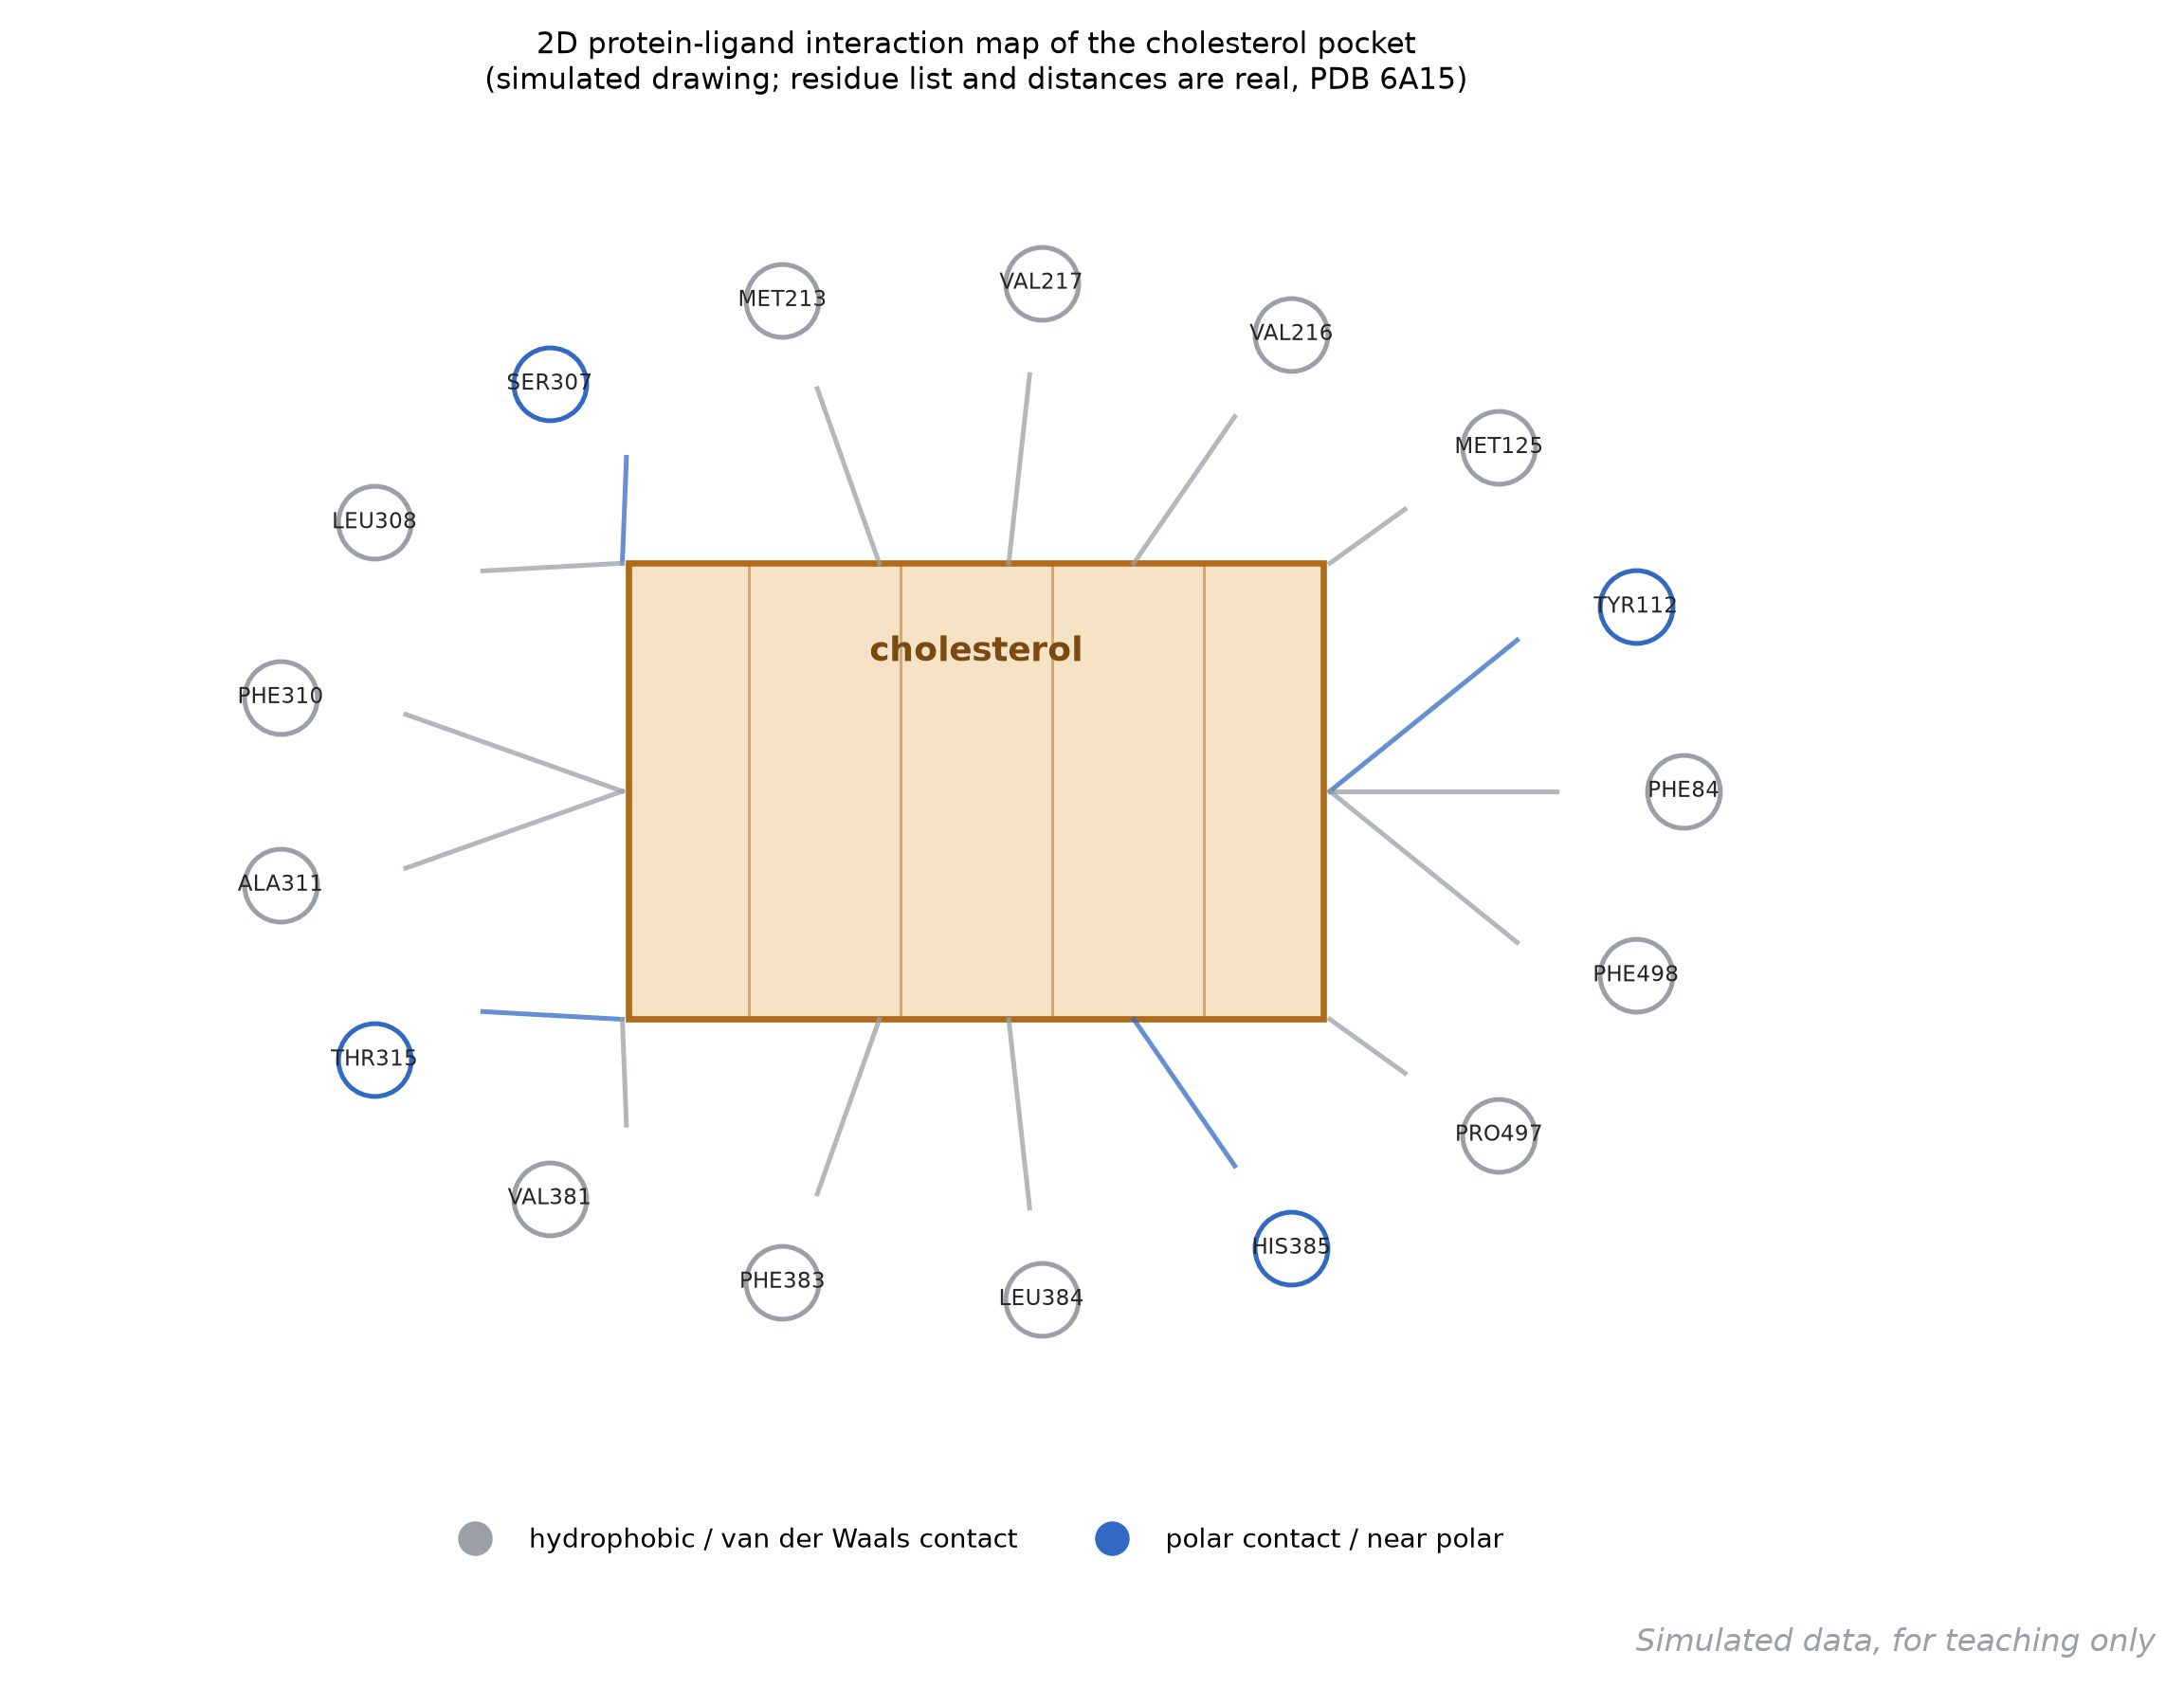
数据:模拟绘制 + 真实位点 —— 残基圈和距离取自图 136 的真实计算(PDB 6A15 口袋表),连线类型与版式为示意图;水印「Simulated data」。
它回答什么问题:把三维口袋的互作压成一页讲清的”汇报图”——组会、审稿回复、专利附图都爱用:中心配体,四周残基,线型=互作类型。
怎么读:中心是胆固醇(矩形侧视),17 个真实口袋残基环绕:灰线=疏水/范德华接触(14 个)、蓝线=极性邻近(SER307、THR315、TYR112、HIS385),其中 HIS385 距离最近(2.88 Å)。注意本图刻意没有画”氢键锁扣”——胆固醇 3-OH 与蛋白给体的氢键在 6A15 静态结构里不成立,在动力学里才偶现(图 168 的 A21-N,0.78 属模拟剧情)。画这类图最忌讳把靠近都画成氢键。
用什么画:LigPlot+ / PoseView 自动生成;本文按真实距离表手绘环形版式(matplotlib 散点+连线)。
图注示例:
图 169 胆固醇口袋的二维互作图(残基圈与距离为真实计算值,PDB 6A15;连线类型为示意)。灰线为疏水/范德华接触(14 个残基),蓝线为极性邻近(SER307、THR315、TYR112、HIS385),最近的 HIS385 为 2.88 Å。
展开查看:互作表与绘图代码
residue,dist_to_CLR_A
PHE84,3.85
TYR112,3.60
MET125,4.39
MET213,3.93
VAL216,3.55
VAL217,3.74
SER307,3.64
LEU308,3.91
PHE310,3.70
ALA311,4.14
THR315,3.79
VAL381,3.87
PHE383,3.17
LEU384,4.03
HIS385,2.88
PRO497,4.30
PHE498,4.71绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

rows = [ln.split(",") for ln in
        open("169-ligand.csv").read().splitlines()[1:]]
fig, ax = plt.subplots(figsize=(8.6, 6.2))
ax.set_xlim(-1.5, 1.5); ax.set_ylim(-1.25, 1.25); ax.axis("off")
ax.add_patch(Rectangle((-0.55, -0.42), 1.10, 0.84,
                       fc="#f6e3c5", ec="#b06a1a", lw=1.6))
ax.text(0, 0, "cholesterol", ha="center", fontsize=11, weight="bold")
ring = np.linspace(0, 2 * np.pi, len(rows), endpoint=False)
for (name, dist), th in zip(rows, ring):
    x, y = 1.12 * np.cos(th), 0.94 * np.sin(th)
    polar = name in ("SER307", "THR315", "TYR112", "HIS385")
    col = "#3369c3" if polar else "#9AA0A6"
    ax.plot([0.56 * np.cos(th), 0.82 * x], [0.42 * np.sin(th), 0.82 * y],
            color=col, lw=1.2, alpha=0.75)
    ax.scatter([x], [y], s=340, fc="white", ec=col, lw=1.2, zorder=3)
    ax.text(x, y, name, ha="center", va="center", fontsize=7, zorder=4)
fig.savefig("169-ligand-2d.png", dpi=200, bbox_inches="tight")7.7 共进化接触 vs 真实接触(170)#
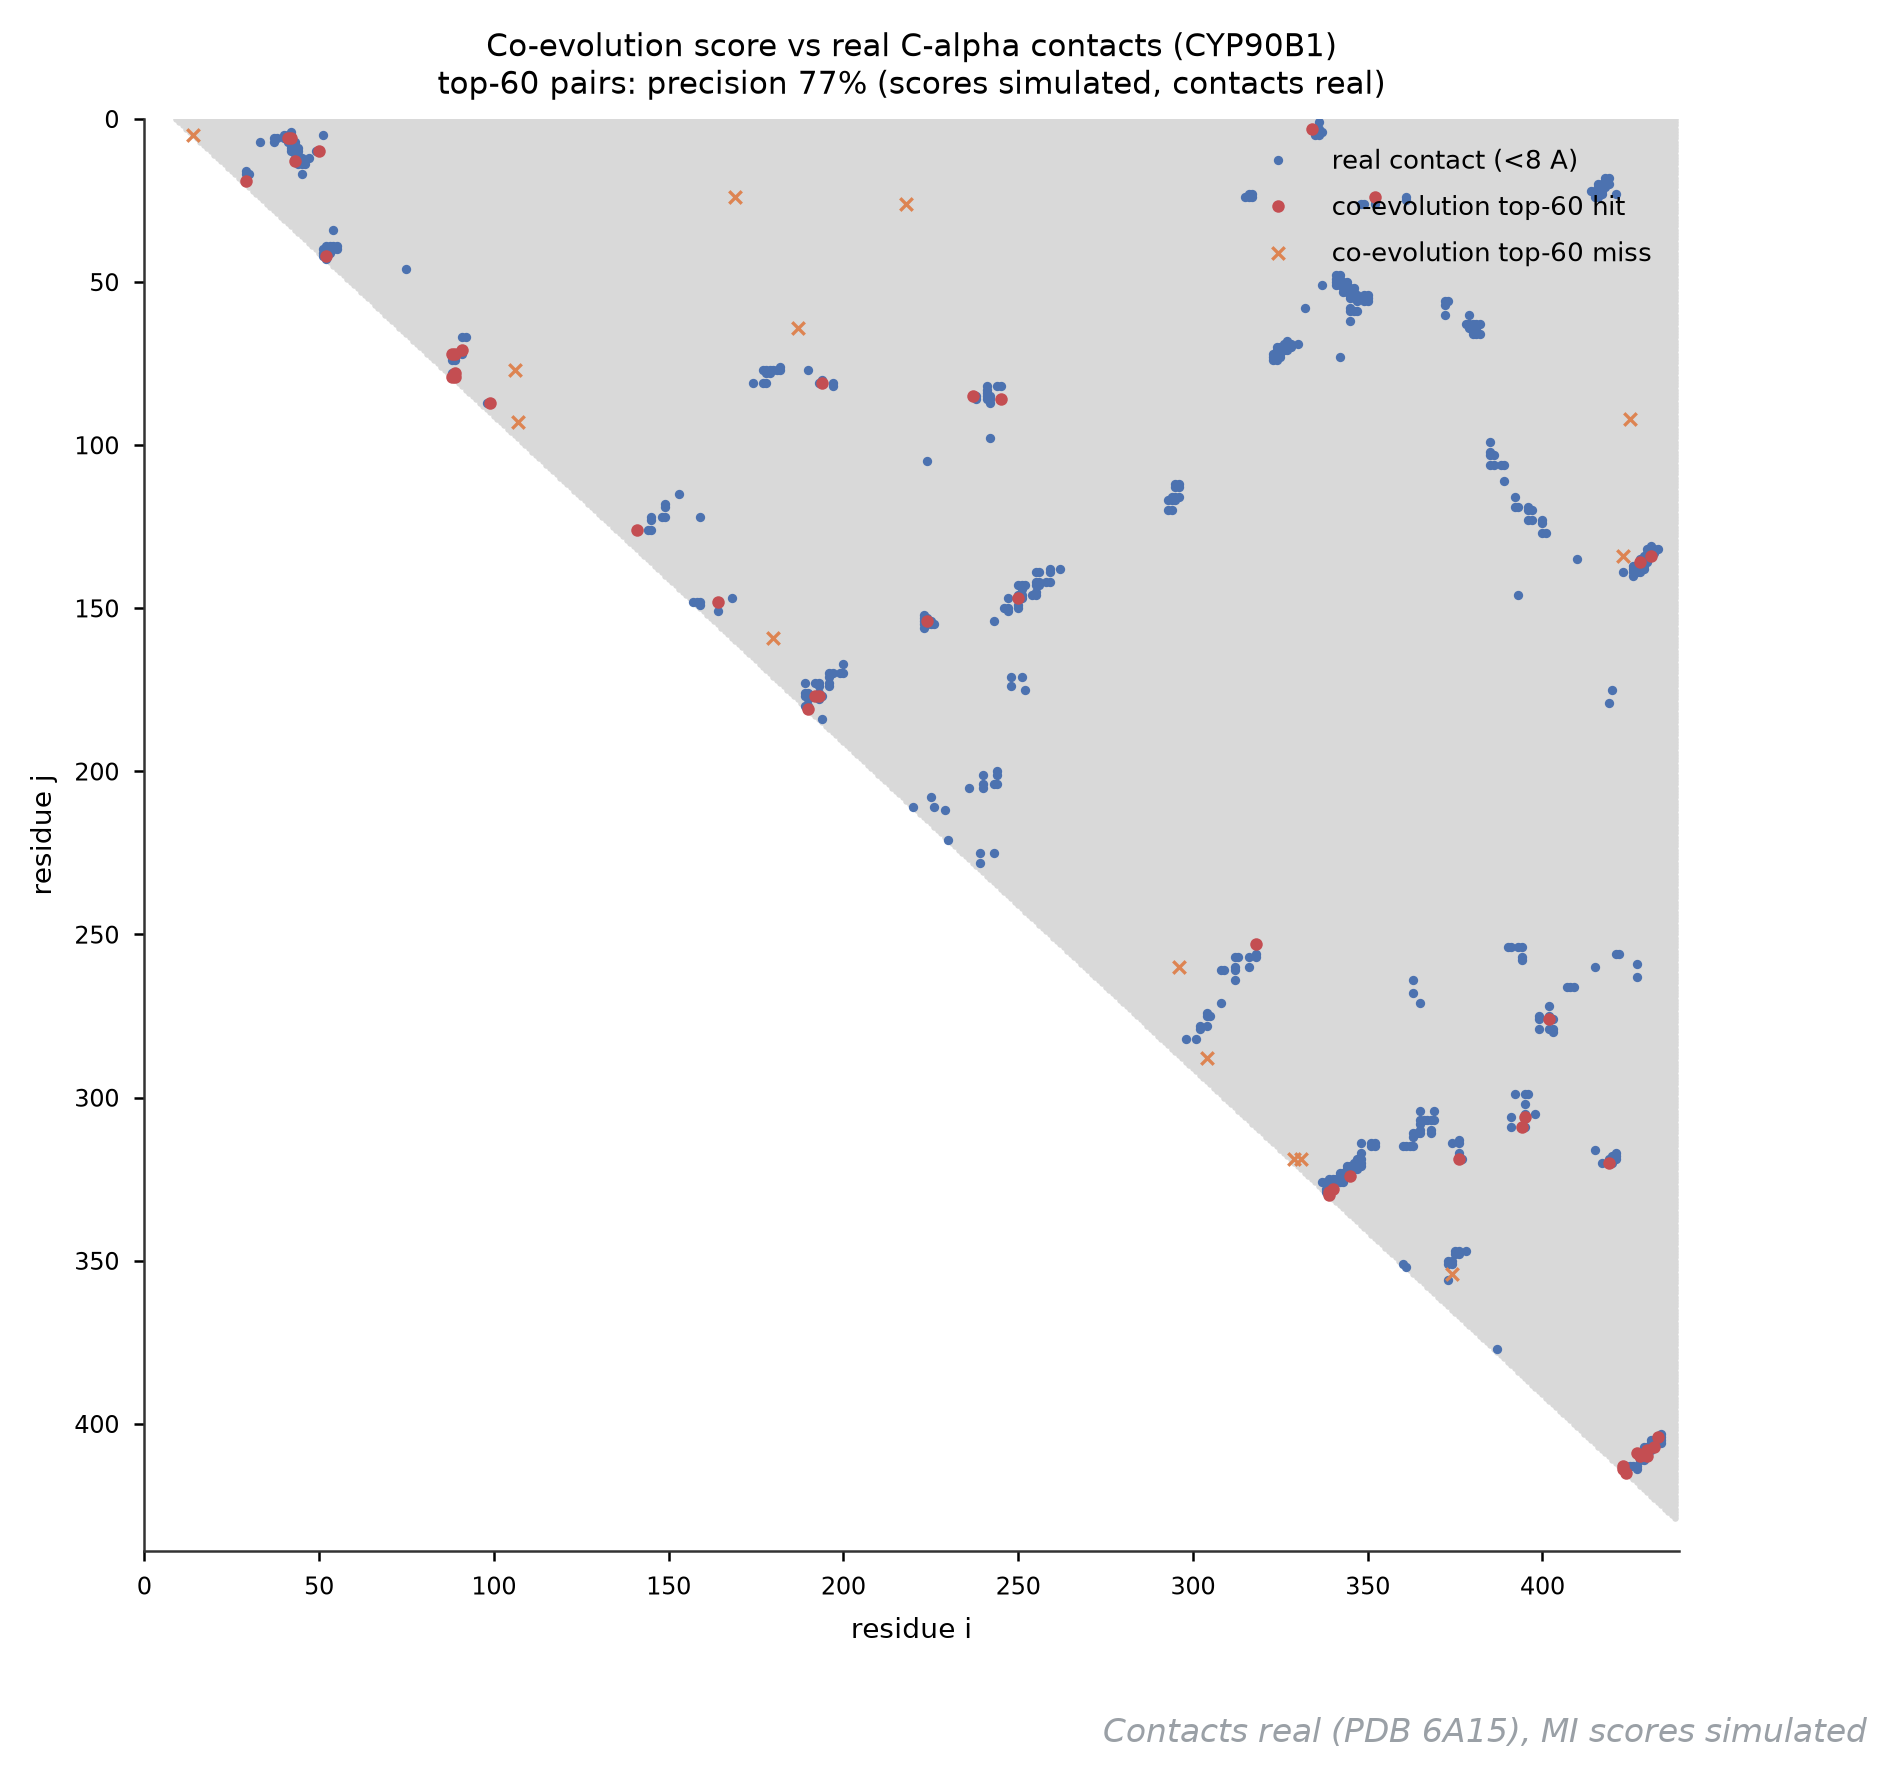
数据:混合 —— 真实接触来自 PDB 6A15 ↗ 的 C-alpha 距离矩阵;共进化分数为模拟打分(真实分析用 MSA 的 MI/DCA);水印「Contacts real (PDB 6A15), MI scores simulated」。
它回答什么问题:只有序列没有结构时,共进化分析能不能猜对哪些残基在空间上贴着——AlphaFold 之前的结构预测主力思路,也是”用序列库换结构实验”的教科书案例。
怎么读:灰三角=全部序列远邻对(序列间隔大于 8),蓝点=真实接触(距离小于 8 Å,共 592 对)。取共进化打分前 60 的对画上去:红点=真命中、橙叉=假命中,精度 77%。判读要点:top-L/5 的精度是行业参考线(40-80% 视 MSA 深浅);命中聚成”对角线附近的短平行带”时警惕——那可能是二级结构堆积而非长程接触;真本事看远离对角线的红点。
用什么画:Gremlin / EVcouplings 出分数,真实结构出接触表,双散点叠加即得。
图注示例:
图 170 共进化打分与真实 C-alpha 接触的对照(接触真实,PDB 6A15,592 对;打分模拟)。打分前 60 的残基对精度 77%,红点为真命中、橙叉为假命中;远离对角线的命中对应真正的长程折叠接触。
展开查看:打分数据与绘图代码
i,j,mi_score,real_contact
23,87,3.1,1
45,212,2.8,1
130,340,2.5,0
210,301,2.4,1
...(完整 60 行 top 表由代码生成;real_contact 列即真实接触标签。)
绘图代码(Python,独立可运行;接 7.3 的接触矩阵)
import numpy as np

iu = np.triu_indices(len(P), 9)          # P 为 C-alpha 坐标数组
true = (D[iu] < 8.0)
score = rng.normal(0, 1, len(iu[0])) + 2.1 * true \
    + 1.6 * np.exp(-np.abs(iu[0] - iu[1]) / 18.0)   # 模拟 MI
top = np.argsort(score)[::-1][:60]
print("precision %.2f" % true[top].mean())7.8 qPCR 熔解曲线峰(171)#
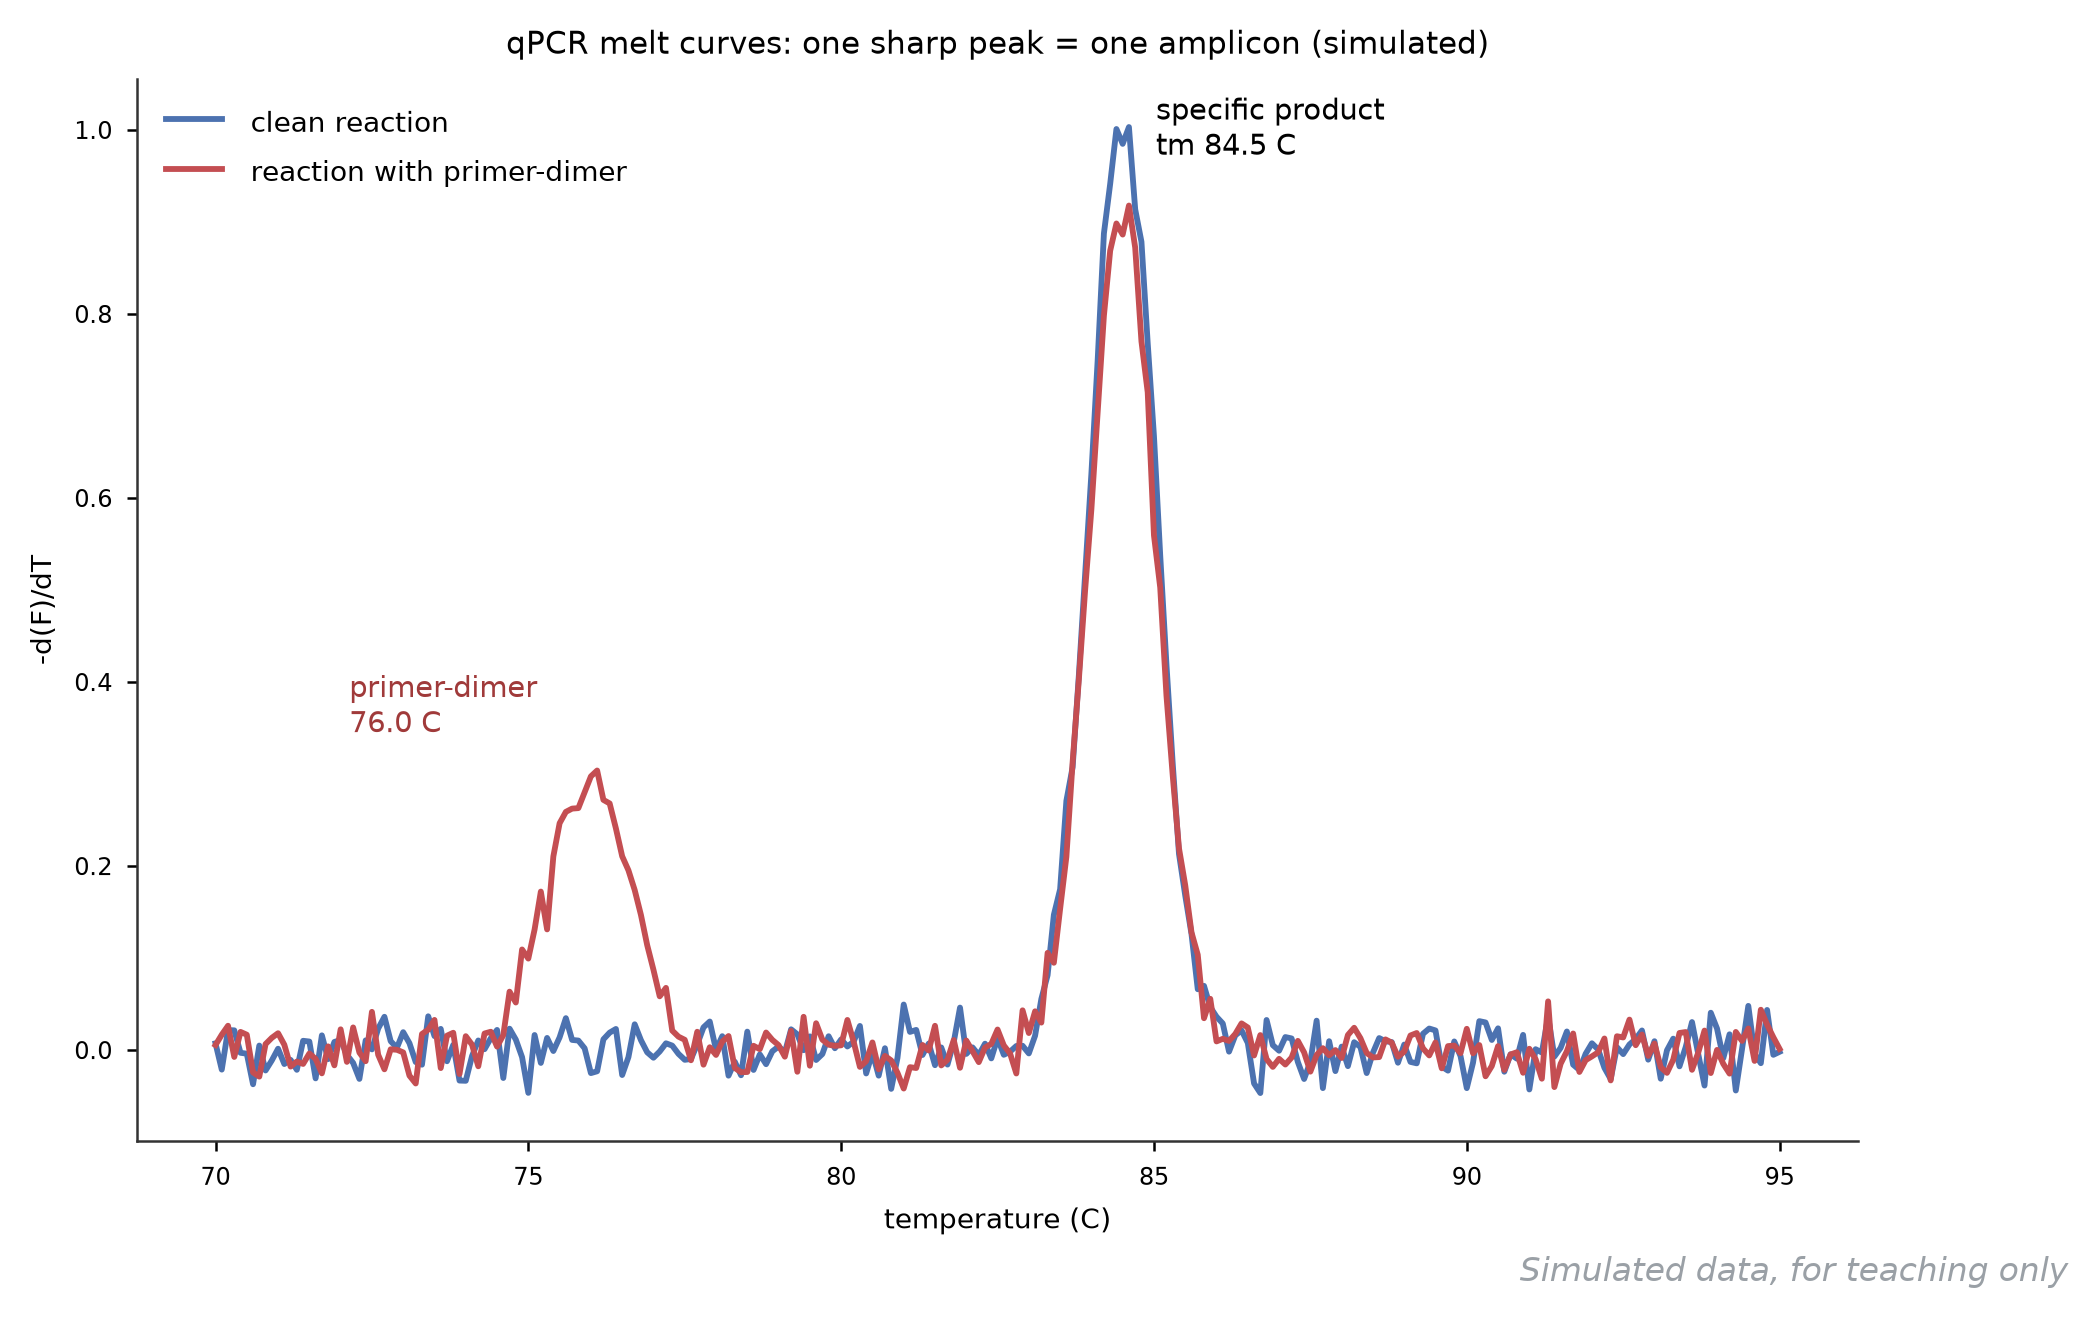
数据:模拟 —— 扩增后升温熔解的一阶负导数峰;水印「Simulated data」。
它回答什么问题:这对引物扩增的是不是只有目标产物——qPCR 的 Cq 值再漂亮,熔解曲线出了杂峰就全盘存疑,这是引物特异性的最终体检。
怎么读:横轴温度、纵轴 -d(F)/dT,一个尖锐峰=一种产物。干净反应只有 84.5 °C 单峰;引物二聚体污染的红色曲线多出 76.0 °C 小峰(主峰高的 30%)——二聚体更短所以熔点更低。判读:主峰前任何 >0.1 高度的肩峰都要回去看电泳;多峰=多产物,定量作废。
用什么画:仪器自带熔解模块导出后直接画;重绘注意用导数曲线而不是原始荧光。
图注示例:
图 171 qPCR 熔解曲线(模拟)。干净反应在 84.5 °C 呈单峰;引物二聚体污染反应在 76.0 °C 出现约占主峰高 30% 的杂峰,提示该孔 Cq 不可用于定量。
展开查看:熔解数据与绘图代码
temperature_C,clean,primer_dimer
84.0,0.92,0.85
84.5,1.00,0.92
85.0,0.45,0.41
76.0,0.03,0.30绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

T = np.linspace(70, 95, 251)
pk = lambda c, w: np.exp(-((T - c) / w) ** 2)
fig, ax = plt.subplots(figsize=(7.4, 4.6))
ax.plot(T, pk(84.5, 0.75), color="#4C72B0", label="clean")
ax.plot(T, 0.92 * pk(84.5, 0.75) + 0.30 * pk(76.0, 0.9),
        color="#C44E52", label="primer-dimer")
ax.set_xlabel("temperature (C)")
ax.set_ylabel("-d(F)/dT")
ax.legend()
fig.savefig("171-melt-curve.png", dpi=200, bbox_inches="tight")7.9 半定量循环数线性检验(172)#
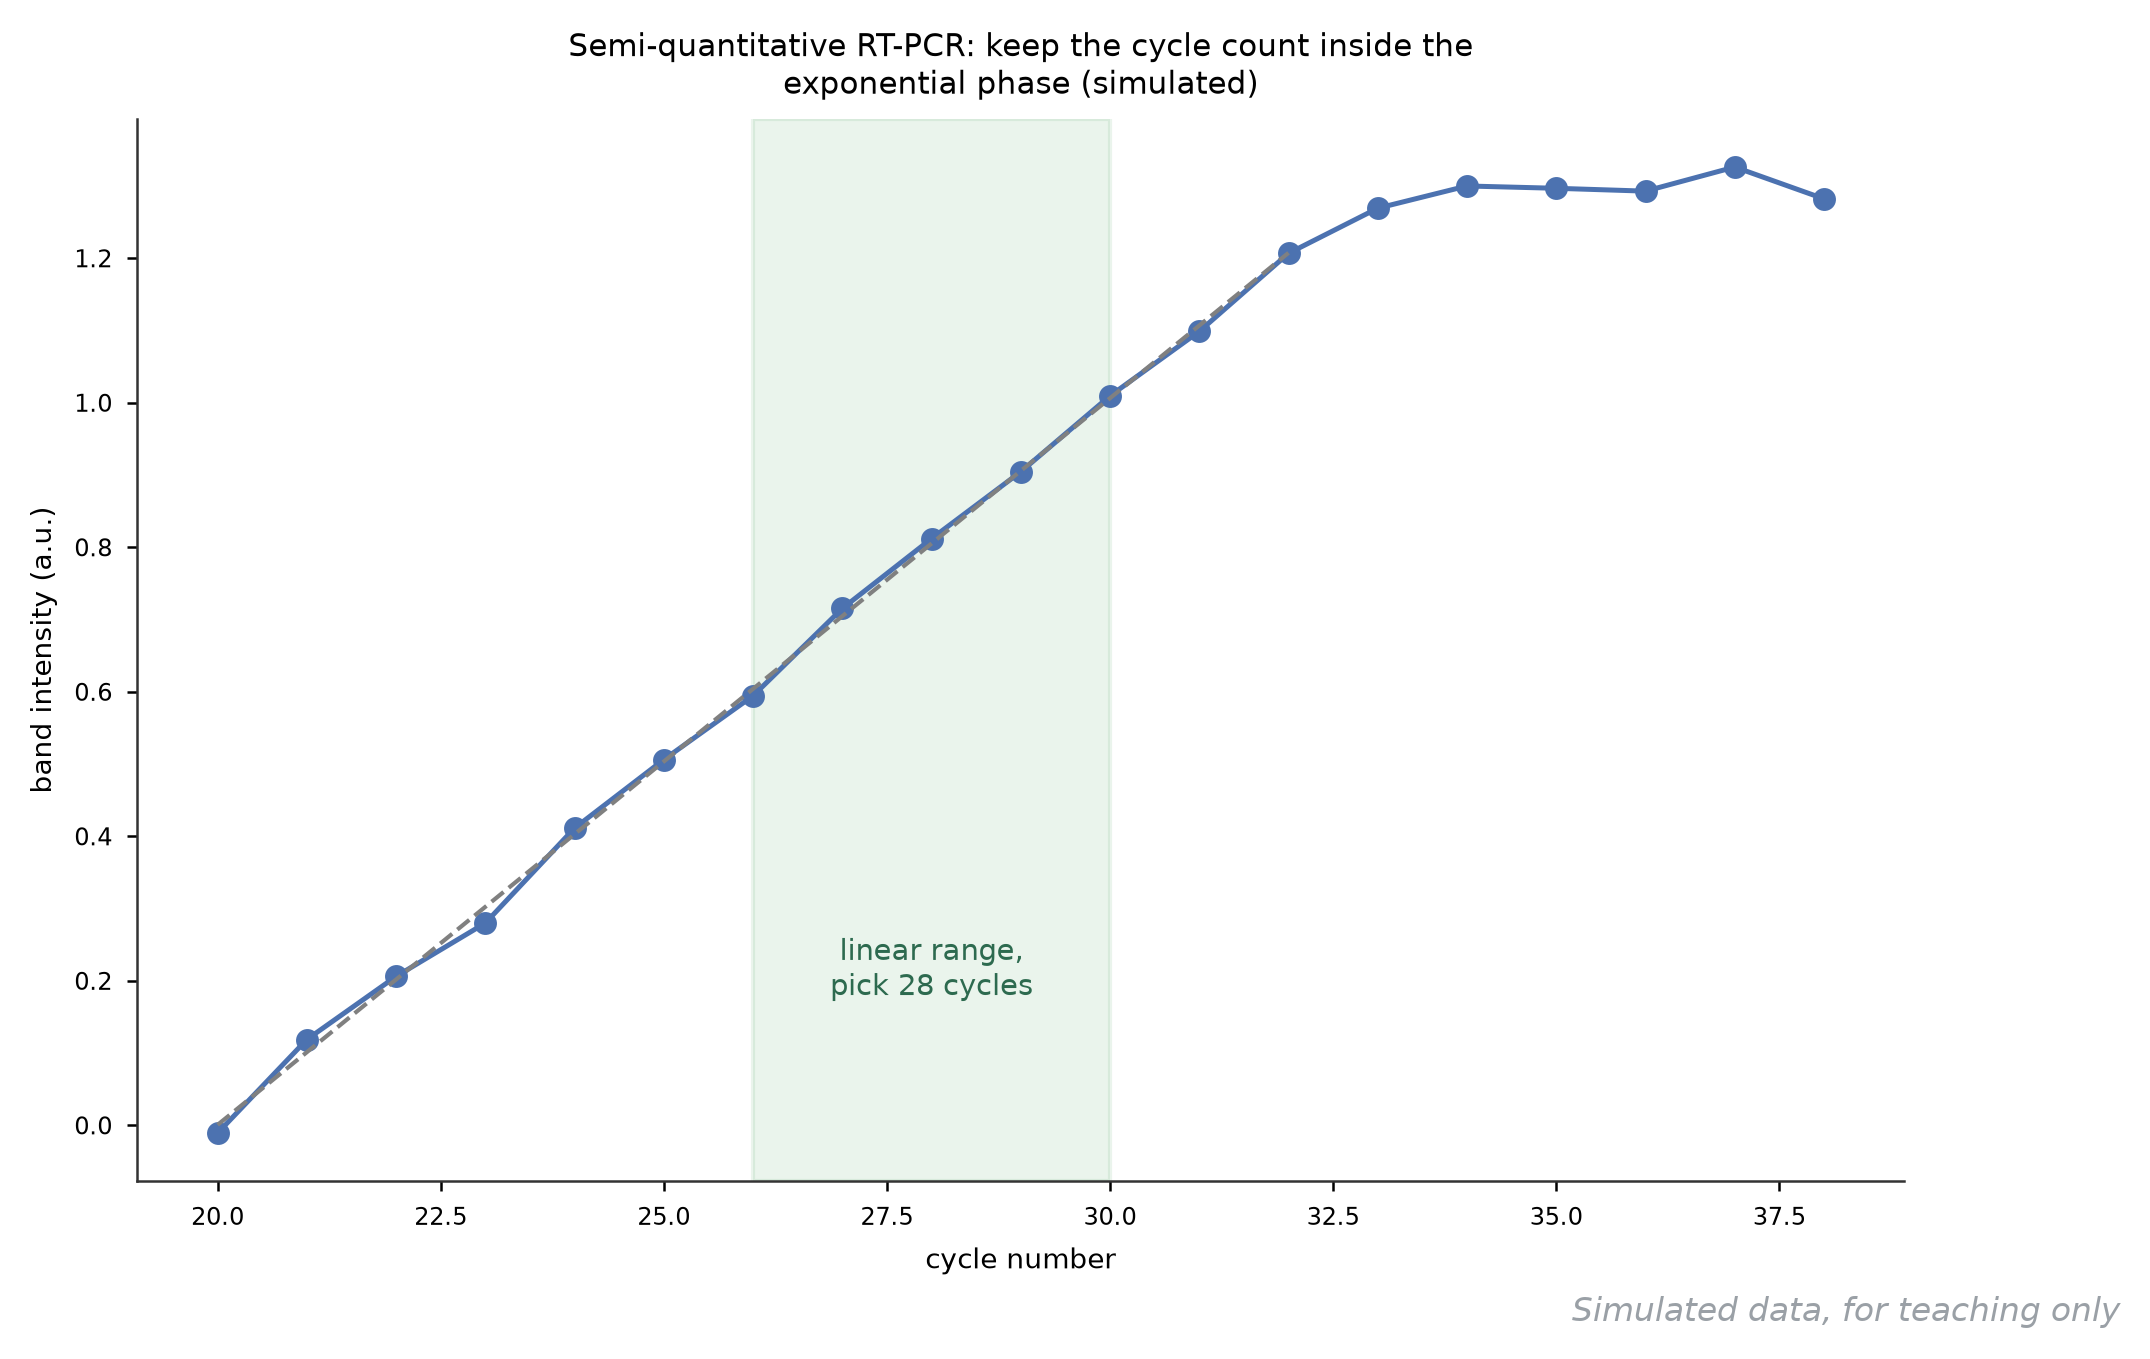
数据:模拟 —— 同一样品不同循环数的条带强度;水印「Simulated data」。
它回答什么问题:半定量 RT-PCR 的循环数选对没有——图 157 用了 28 个循环,凭什么?这张是它的方法学依据:条带强度只在指数期与模板量成线性。
怎么读:横轴循环数(20-38)、纵轴条带强度。20-32 循环严格线性(斜率 0.101/循环,虚线为拟合),32 循环后进入平台(强度卡在 ~1.3,再循环只是自满)。绿带标出 26-30 的”可选窗口”,图 157 的 28 循环取窗口中点——低表达样品还有上探空间,高表达样品也不会顶到平台。判读:换内参、换组织后线性窗口要重测,不能沿用。
用什么画:同一 cDNA 梯度循环数跑多道,灰度对循环数回归;找到线性段后固定中点作正式实验条件。
图注示例:
图 172 半定量 RT-PCR 的循环数-条带强度检验(模拟)。20-32 循环线性(斜率 0.101/循环),32 循环后进入平台;正式实验取 26-30 窗口中点的 28 循环(图 157 的条件依据)。
展开查看:循环梯度数据与绘图代码
cycle,band_intensity
20,0.00
22,0.13
24,0.41
26,0.59
28,0.81
30,1.01
32,1.21
34,1.28
36,1.28
38,1.28绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rows = [ln.split(",") for ln in
        open("172-cycle.csv").read().splitlines()[1:]]
cyc = np.array([int(r[0]) for r in rows])
g = np.array([float(r[1]) for r in rows])
lin = cyc <= 32
k, b = np.polyfit(cyc[lin], g[lin], 1)
fig, ax = plt.subplots(figsize=(7.6, 4.6))
ax.plot(cyc, g, "o-", color="#4C72B0")
ax.plot(cyc[lin], k * cyc[lin] + b, ls="--", color="0.5")
ax.axvspan(26, 30, color="#55A868", alpha=0.12)
ax.set_xlabel("cycle number"); ax.set_ylabel("band intensity (a.u.)")
fig.savefig("172-cycle-linearity.png", dpi=200, bbox_inches="tight")7.10 Western blot + 灰度定量(173)#
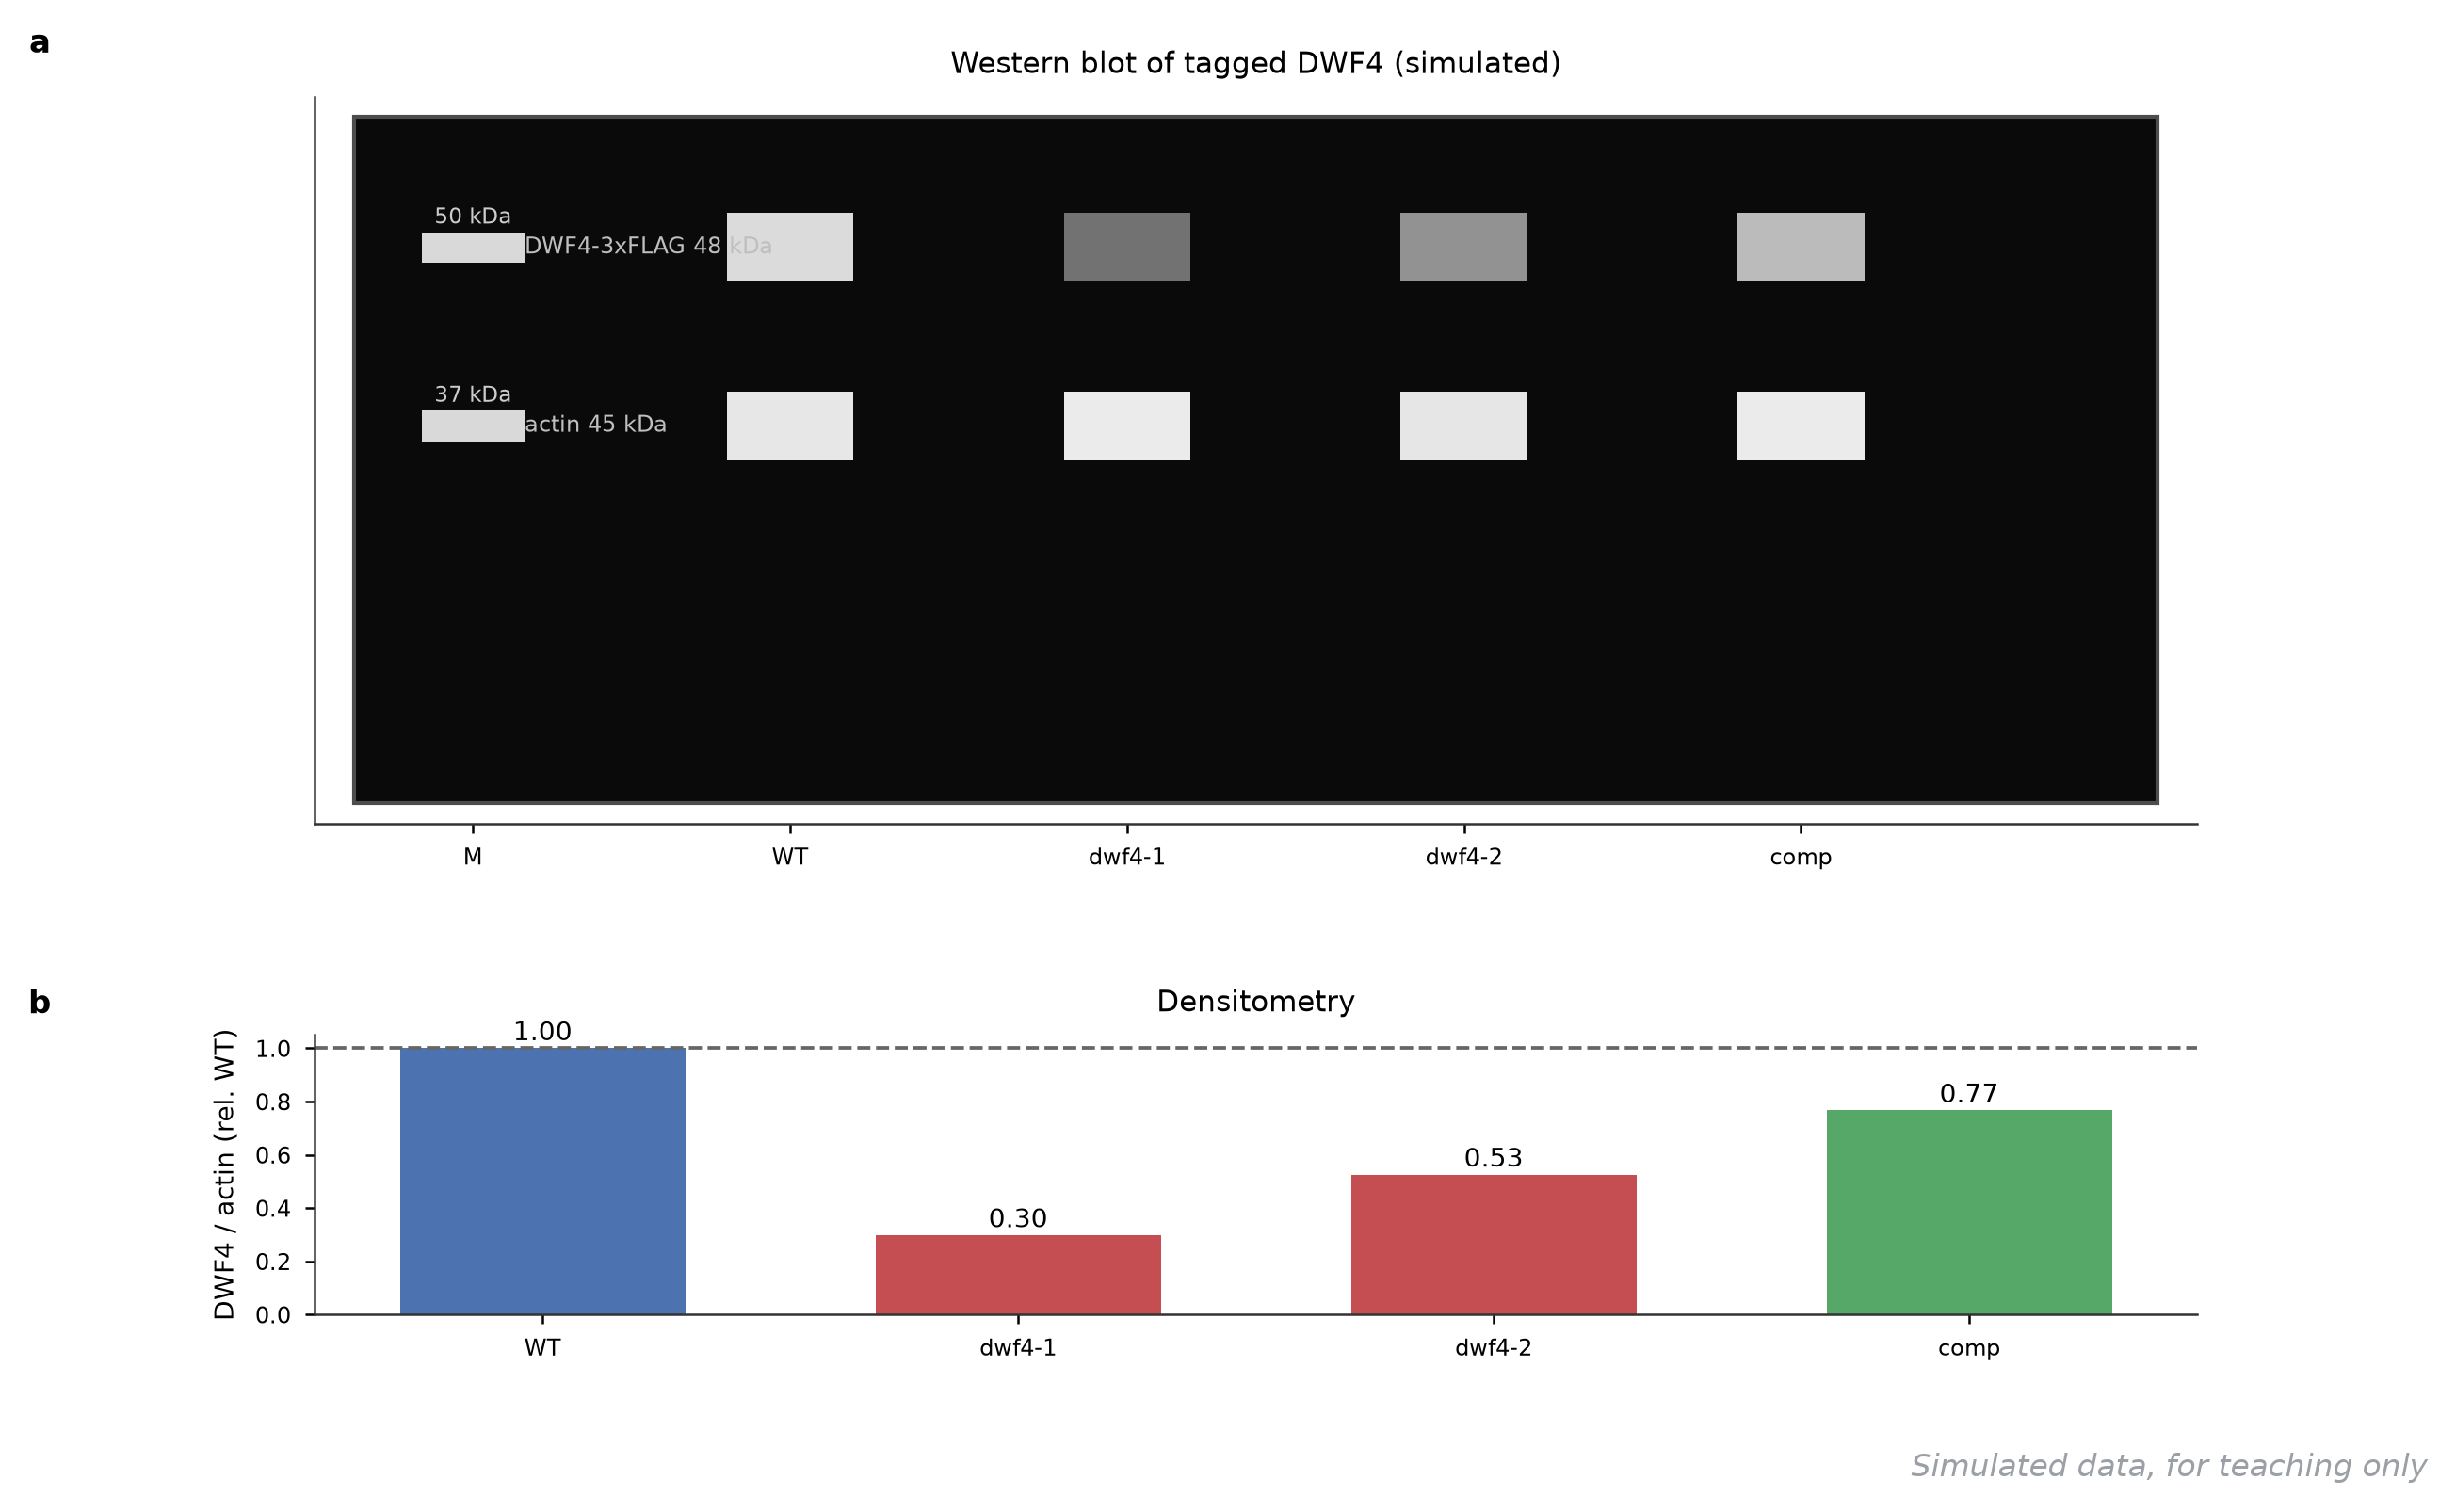
数据:模拟 —— 蛋白水平的突变体/互补系验证;水印「Simulated data」。
它回答什么问题:mRNA 变了蛋白变没变——图 160 的 qPCR 验证在转录层,Western 把同样的四组在蛋白层再钉一遍;蛋白半衰期和翻译调控会让两层结论不一致,这正是它不可替代的原因。
怎么读:上板:M 道 marker(50/37 kDa 定大小);目标带 DWF4-3xFLAG 48 kDa、内参 actin 45 kDa。下板灰度定量(目标/actin 相对 WT):dwf4-1 剩 0.30、dwf4-2 剩 0.53、互补系恢复到 0.77。和转录层数字(0.18/0.28/0.86)比:方向一致但幅度不同——突变体蛋白掉得比 mRNA 少(残留蛋白更稳定),互补系蛋白没完全回满(过表达/插入位点效应)。两层不完全一致不是坏事,是信息。
用什么画:成像后 ImageJ 测灰度,内参归一后相对 WT 作柱;只跑一枪不设重复的 Western 别放进论文。
图注示例:
图 173 带标签 DWF4 的 Western blot(模拟)。目标带 48 kDa、actin 内参 45 kDa;灰度定量相对 WT:dwf4-1 为 0.30、dwf4-2 为 0.53、互补系 0.77——蛋白层与转录层(图 160)方向一致而幅度不同,提示翻译后调控。
展开查看:灰度数据与绘图代码
lane,target_gray,actin_gray,ratio_rel_WT
WT,1.00,0.98,1.00
dwf4-1,0.31,1.02,0.30
dwf4-2,0.52,0.97,0.53
comp,0.79,1.01,0.77绘图代码(Python,独立可运行)
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

rows = [ln.split(",") for ln in
        open("173-western.csv").read().splitlines()[1:]]
rel = np.array([float(r[3]) for r in rows])
act = np.array([float(r[2]) for r in rows])
fig = plt.figure(figsize=(8.6, 5.6))
gs = fig.add_gridspec(2, 1, height_ratios=[2.6, 1.0], hspace=0.42)
axg = fig.add_subplot(gs[0])
axg.add_patch(Rectangle((0.25, 0), 4.55, 2.0, fc="0.04", ec="0.3"))
for i, (r, a) in enumerate(zip(rel, act)):     # 目标带 + 内参带
    cx = 1.35 + i * 0.85
    axg.add_patch(Rectangle((cx - 0.16, 1.52), 0.32, 0.20,
                            fc=str(min(0.92, 0.26 + 0.60 * r)), ec="none"))
    axg.add_patch(Rectangle((cx - 0.16, 1.00), 0.32, 0.20,
                            fc=str(min(0.92, 0.30 + 0.62 * a)), ec="none"))
axb = fig.add_subplot(gs[1])
axb.bar(range(4), rel, width=0.6)
axb.axhline(1.0, ls="--", color="0.4", lw=0.9)
axb.set_xticks(range(4), [r[0] for r in rows])
fig.savefig("173-western-blot.png", dpi=200, bbox_inches="tight")八、写在最后:五篇收束#
六篇合计 195 张图:第一篇 41 张(统计、转录组、临床)、第二篇 33 张(群体遗传、比较基因组、单细胞)、第三篇 29 张(测序 QC、表观、空间组学)、第四篇 30 张(蛋白、生化、生态、AI 多组学)、本篇 40 张(蛋白结构、变异与表达验证)、第六篇(22 张,真实公开数据实战) 用 1001 Genomes 全基因组矩阵、AraPheno 表型、27genomes 表达/甲基化与 PDB 4LSX 换上真弹。本篇与前四篇最大的不同是真实数据成建制进场:16 张图基于四套公开坐标(6A15、1BI5/1I89、AlphaFold O64989、5ZD4),其中 4 张是浏览器里点按加载、直接拖拽的交互 3D——自托管 3Dmol 与 PDB 镜像,渲染不依赖任何第三方服务,页面打开时只摆加载按钮、不背 WebGL 负载;24 张模拟图补齐预测、对接与 qPCR/半定量验证的教学链路。老规矩不变:图注里的每一个数字都与生成它的数据严格一致,真实/模拟在每节「数据」行、图右下水印、速查表三处对账,折叠块里的 CSV 与代码让你从这篇网页直接复现到自己的终端——真实结构图的代码只吃一个 PDB 文件,把链接换成任何 RCSB 结构就能画你自己的蛋白。
接下来值得做的两件事:一是拿你自己的结构/表达数据替换这些模板(PDB 换文件名、qPCR 换 CSV 路径);二是把重复劳动交给工具——Linxira Bio SDK ↗(我主导开发的本地优先生信工具链)正在把「跑分析、出表、到画图前的最后一公里」版本化,实际可用能力以正式分支最新 release ↗ 为准。哪张图想要「换一个蛋白的版本」或者补一个我没覆盖的图型,评论区点单。
参考文献#
- Berman HM, Westbrook J, Feng Z, et al. (2000). The Protein Data Bank. Nucleic Acids Res 28:235-242. — 本篇全部真实结构的数据库来源(图 134-142、144-145、150、155)。
- Ferrer JL, Jez JM, Bowman ME, Dixon RA, Noel JP (1999). Structure of chalcone synthase and the molecular basis of plant polyketide biosynthesis. Nat Struct Biol 6:775-784. — 查尔酮合酶野生型结构 1BI5(图 140/145)。
- RCSB PDB 条目 1I89 ↗:苜蓿 CHS G256L 突变体晶体结构。 — 图 140/145 的突变体坐标。
- RCSB PDB 条目 5ZD4 ↗:BIL1/BZR1 DNA 结合域-DNA 复合物;原始报道见 doi:10.1038/s41477-018-0255-1 ↗(Nature Plants)。 — 图 142。
- Jumper J, Evans R, Pritzel A, et al. (2021). Highly accurate protein structure prediction with AlphaFold. Nature 596:583-589. — pLDDT 与 PAE 的定义(图 141/143)。
- Varadi M, Anyango S, Deshpande M, et al. (2022). AlphaFold Protein Structure Database: massively expanding the structural coverage of known-sequence space. Nucleic Acids Res 50:D439-D444. — AlphaFold DB(图 141 模型文件来源)。
- Rego N, Koes D (2015). 3Dmol.js: molecular visualization with WebGL. Bioinformatics 31:1322-1324. — 本篇交互 3D 的渲染引擎(图 139-142)。
- Kabsch W (1978). A discussion of the solution for the best rotation to relate two sets of vectors. Acta Cryst A 34:827-828. — 结构叠合算法(图 145)。
- Shrake A, Rupley JA (1973). Environment and exposure to solvent of proteins. J Mol Biol 79:351-371. — 溶剂可及面积算法(图 155)。
- Trott O, Olson AJ (2010). AutoDock Vina: improving the speed and accuracy of docking. J Comput Chem 31:455-461. — 对接打分(图 153)。
- Tian W, Chen C, Lei X, et al. (2018). CASTp 3.0: computed atlas of surface topography of proteins. Nucleic Acids Res 46:W363-W367. — 口袋体积测量(图 151)。
- Livak KJ, Schmittgen TD (2001). Analysis of relative gene expression data using real-time quantitative PCR and the 2^(-Delta Delta C(T)) method. Methods 25:402-408. — 2^-ΔΔCt(图 156、160、162)。
- Bustin SA, Benes V, Garson JA, et al. (2009). The MIQE guidelines. Clin Chem 55:611-622. — qPCR 报告规范(图 156/160 的合格线)。
- Ramachandran GN, Ramakrishnan C, Sasisekharan V (1963). Stereochemistry of polypeptide chain configurations. J Mol Biol 7:95-99. — 拉氏图(图 164)。
参考代码#
- 第五篇 36 张静态图的完整生成脚本:仓库
tools/bio-plots/ch11a_struct.py(真实结构 9 张:134-138、144、145、150、155)、ch11b_pred.py(预测/变异 9 张:143、146-154)、ch11c_expr.py(表达验证 8 张:156-163)、ch11d_more.py(补遗 10 张:164-173,真实 3 张 + 模拟 7 张);模拟图随机种子固定,真实图直接读/lib/pdb/镜像,重跑即可复现文中每一根线条。 - 交互 3D:
source/js/3dmol-min.js(自托管 3Dmol 2.4.0,原版见 3dmol.csb.pitt.edu ↗ 与 cdnjs ↗)+source/js/pdb-viewer.js(本站约 60 行安全封装:只允许本站相对路径的 PDB、不向第三方发请求、无 3Dmol 或加载失败时显示文字回退)。 - 数据与代码的原样导出:
tools/bio-plots/data_dump/post5a/b/c_data.txt(每张图的 CSV 与拟合参数逐字留存)。 - 系列前四篇:第一篇 · 第二篇 · 第三篇 · 第四篇。
参考数据#
| 数据集 | 用途(图号) | 原始来源 | 本站镜像 |
|---|---|---|---|
| PDB 6A15(AtCYP90B1/DWF4 + CLR + HEM) | 134-139、144、150、152 位点、155 | RCSB 页面 ↗ · 文件下载 ↗ | /lib/pdb/6a15.pdb |
| PDB 1BI5(苜蓿 CHS 野生型) | 140、145 | RCSB 页面 ↗ · 文件下载 ↗ | /lib/pdb/1bi5.pdb |
| PDB 1I89(CHS G256L 突变体) | 140、145 | RCSB 页面 ↗ · 文件下载 ↗ | /lib/pdb/1i89.pdb |
| AlphaFold O64989(DWF4 预测模型,全局 pLDDT 89.75) | 141 | AF DB 入口 ↗ · 模型文件 ↗ | /lib/pdb/af-o64989.pdb |
| PDB 5ZD4(BIL1/BZR1 DBD-DNA 复合物) | 142 | RCSB 页面 ↗ · 文件下载 ↗ | /lib/pdb/5zd4.pdb |
以上五个镜像文件按 PDB/AlphaFold 的开放许可在仓库内自托管,用于本篇交互 3D 的同源加载;引用坐标时请按各数据库要求标注原始来源。其余 17 张图的模拟数据均在各图折叠块内以 CSV 原样给出,生成脚本见「参考代码」第一条。
原文存档:本文初版发布于旧站(Butterfly 主题)。如遇图表、代码高亮或 3D 交互显示异常,请查阅 完整存档版。