
生信图表大全(第七篇):把 190 张图重画成 Nature 风格
本系列已出七篇:第一篇(41 张,统计与转录组临床) · 第二篇(33 张,群体遗传与基因组) · 第三篇(29 张,测序、表观与空间组学) · 第四篇(30 张,蛋白、生态与 AI 多组学) · 第五篇(40 张,蛋白结构、变异与表达验证) · 第六篇(22 张,真实公开数据实战) · 第七篇(190 张图 Nature 风格重构与方法选型)即本篇。
有读者批评得很难听:”AI 画的图,一眼低质。”这话对了一半——图确实是 AI 画的,但”低质感”不是 AI 的锅,是默认 matplotlib 的锅:默认字号大得像幻灯片、默认色板饱和得像儿童玩具、网格线铺满背景、四条脊柱围一圈框。人画图时会下意识避开这些,AI 不给规范就全踩。所以本篇做两件事:
第一,把全系列 190 张 PNG 按 Nature 图表规范全部重绘(195 张图中 5 张是 3Dmol.js 交互 3D——139-142 与 188——本就没有 PNG)。数据一个字节没动,随机种子没动,图注里的每一个数字在重绘后依然与图内严格一致——变的只有像素。改造前的原图抽了 12 张存在 /img/bio-plots/before/ 里做对照,其余直接覆盖。

第二,把”为什么是这张图、为什么是这个方法”补全。重画只是皮,本篇第五章逐图族过一遍方法选型:同一份数据往往有三条分析路线,每条路线各自回答什么、什么时候失效、我们为什么选这条——这是前六篇”怎么画”之外一直欠着的”为什么画它”。
一、”AI 一眼低质”的病灶清单
先诊断。”AI 味”不是玄学,它是一组可以逐条指认的默认值。下表左边是病灶,中列是本系列旧版的实际取值,右列是 Nature 的处方:
| # | 病灶 | 旧版默认 | Nature 处方 |
|---|---|---|---|
| 1 | 字号过大 | 基准 11pt、标题 12.5pt,脚本里还散落着 10-14pt 的显式覆盖 | 终稿 5-7pt,面板字母 8pt |
| 2 | 网格线铺底 | axes.grid: True 全局开 |
去网格,用稀疏刻度引导视线 |
| 3 | 高饱和类别色板 | seaborn deep(蓝橙绿红…) | Okabe-Ito 色盲安全色环 |
| 4 | 彩虹色图 | 全系列 1 处 jet_r(图 107 自由能面) |
感知均匀色图(viridis) |
| 5 | 无面板字母 | 多面板图靠标题区分 | 粗体小写 a/b/c 钉在各面板左上 |
| 6 | 分辨率偏低 | 200 dpi | 300 dpi 起 |
| 7 | 深色格子配黑字 | 固定 #333333 |
按填充亮度自动换白/黑 |
| 8 | 字重字号逐图漂移 | 每个脚本自己定 | 导出时统一重缩放进 5.5-11.5pt 频段 |
也要说句公道话:旧版有四件事从一开始就做对了——去顶右脊、无框图例、英文轴标、右下角数据来源水印。这次重构是在这四条地基上换墙面。
二、我们用了哪些 skill:仓库、链接与质量判断
动手前先调研。翻的是 GitHub 上的 Agent Skills 生态(Anthropic 去年开放了 SKILL.md 规范后,社区已经形成了几个成规模的技能库),用 gh CLI 直接拉仓库读原文,没有转述:
1 | gh api repos/Yuan1z0825/nature-skills/tarball > ns.tar.gz # 全量 |
读完的判断如下:
| 仓库 | skill | 我们取了什么 | 质量判断 |
|---|---|---|---|
| Yuan1z0825/nature-skills | nature-figure |
排版层级、面板字母规则、图注骨架、QA 清单 | 高,主用。路由式 SKILL.md(约 1.4 万字)+ 19 份 references;规范逐条锚定 Nature 官方 figure guide,图注惯例从 2025 年 20 篇开放获取 Nat Commun 论文语料蒸馏而来;还带三个 QA 脚本(面板对齐审计、PDF 文字审计、图形碰撞审计),是生产级工程不是提示词合集 |
| K-Dense-AI/scientific-agent-skills | scientific-visualization |
nature.mplstyle 作数值起点 |
高。165 个科研技能,这份 mplstyle 把规范落到了数字:89mm 单栏、7pt 正文/6pt 刻度、0.5pt 脊线、2.5pt 刻度线长、Okabe-Ito 五色环、450dpi |
| anthropics/skills | —(无 Nature 专项) | SKILL.md 工程格式参照 | 官方库偏文档/办公(docx/pdf/pptx/xlsx),科研绘图要靠社区库 |
| Boom5426/Nature-Paper-Skills | figure-style 等 |
未采用 | 偏投稿全流程(起草/修回/审计),与”重画已有图”的任务错位 |
两个 skill 的共同原始锚点是 Nature 官方的 figure specifications—— skill 只是转译层,最终对表以它为准。质量差异也很典型:Yuan1z0825 的强项是规范有出处(每条能追到官方 guide 或真实语料),K-Dense 的强项是数值可直接执行(mplstyle 导入即用);两家合起来正好凑齐”为什么”和”是多少”。
三、Nature 规范速查与博客适配
官方硬指标(flagship Nature,production 阶段):
| 项 | 规范 |
|---|---|
| 图幅 | 单栏 89mm,双栏 183mm,高 ≤170mm |
| 正文字号 | 终稿 5-7pt;面板字母 8pt 粗体小写 a, b, c |
| 字体 | 无衬线,Arial/Helvetica 优先;文字保持可编辑 |
| 脊线/网格 | 只留左下两条脊;避免背景网格、阴影、装饰图标 |
| 用色 | 可访问色板;不依赖红绿对比;禁彩虹尺度 |
| 轴 | 轴线与刻度必须保留,每条轴有标签,单位加括号 |
| 图注 | ≤250 词;总题 + 分面板描述;n、误差类型、检验写进图注 |
两处有意识的偏离,说清楚理由:
- DejaVu Sans 代替 Arial。渲染主机是 WSL Linux,没有 Arial 也没有 Liberation Sans;DejaVu 是 matplotlib 自带的人本无衬线体,字形结构同族。博客是读图场景不是投稿场景,字体代谢这一步等真要投稿时再装字体重出即可——
font.sans-serif列表里 Arial 排第二,装上即生效。 - 300 dpi PNG 代替矢量主格式。skill 建议 SVG 为主(文字可再编辑),对投稿正确;但博客 190 张图全上矢量,仓库体积和首屏加载都要付代价。PNG@300dpi 在移动端双指放大后依然锐利,是为阅读优化的折衷。
四、改造前后:12 组对照
同一份数据、同一个脚本、同一行图注——只换了渲染层。前图存档于 before/,点击可在新标签页放大对比。
图 1 火山图
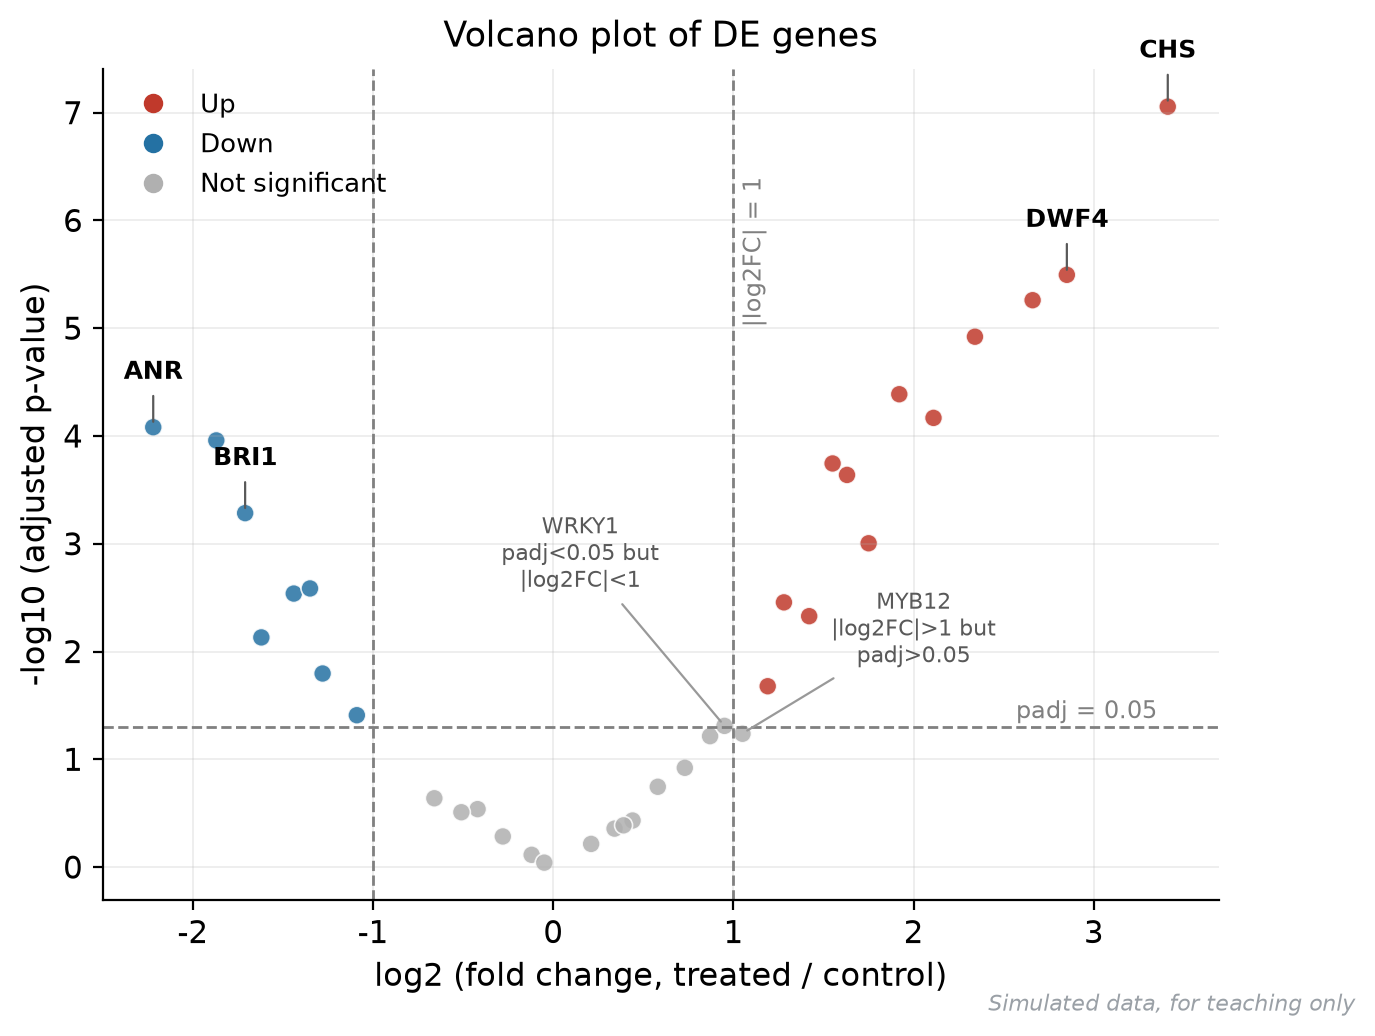
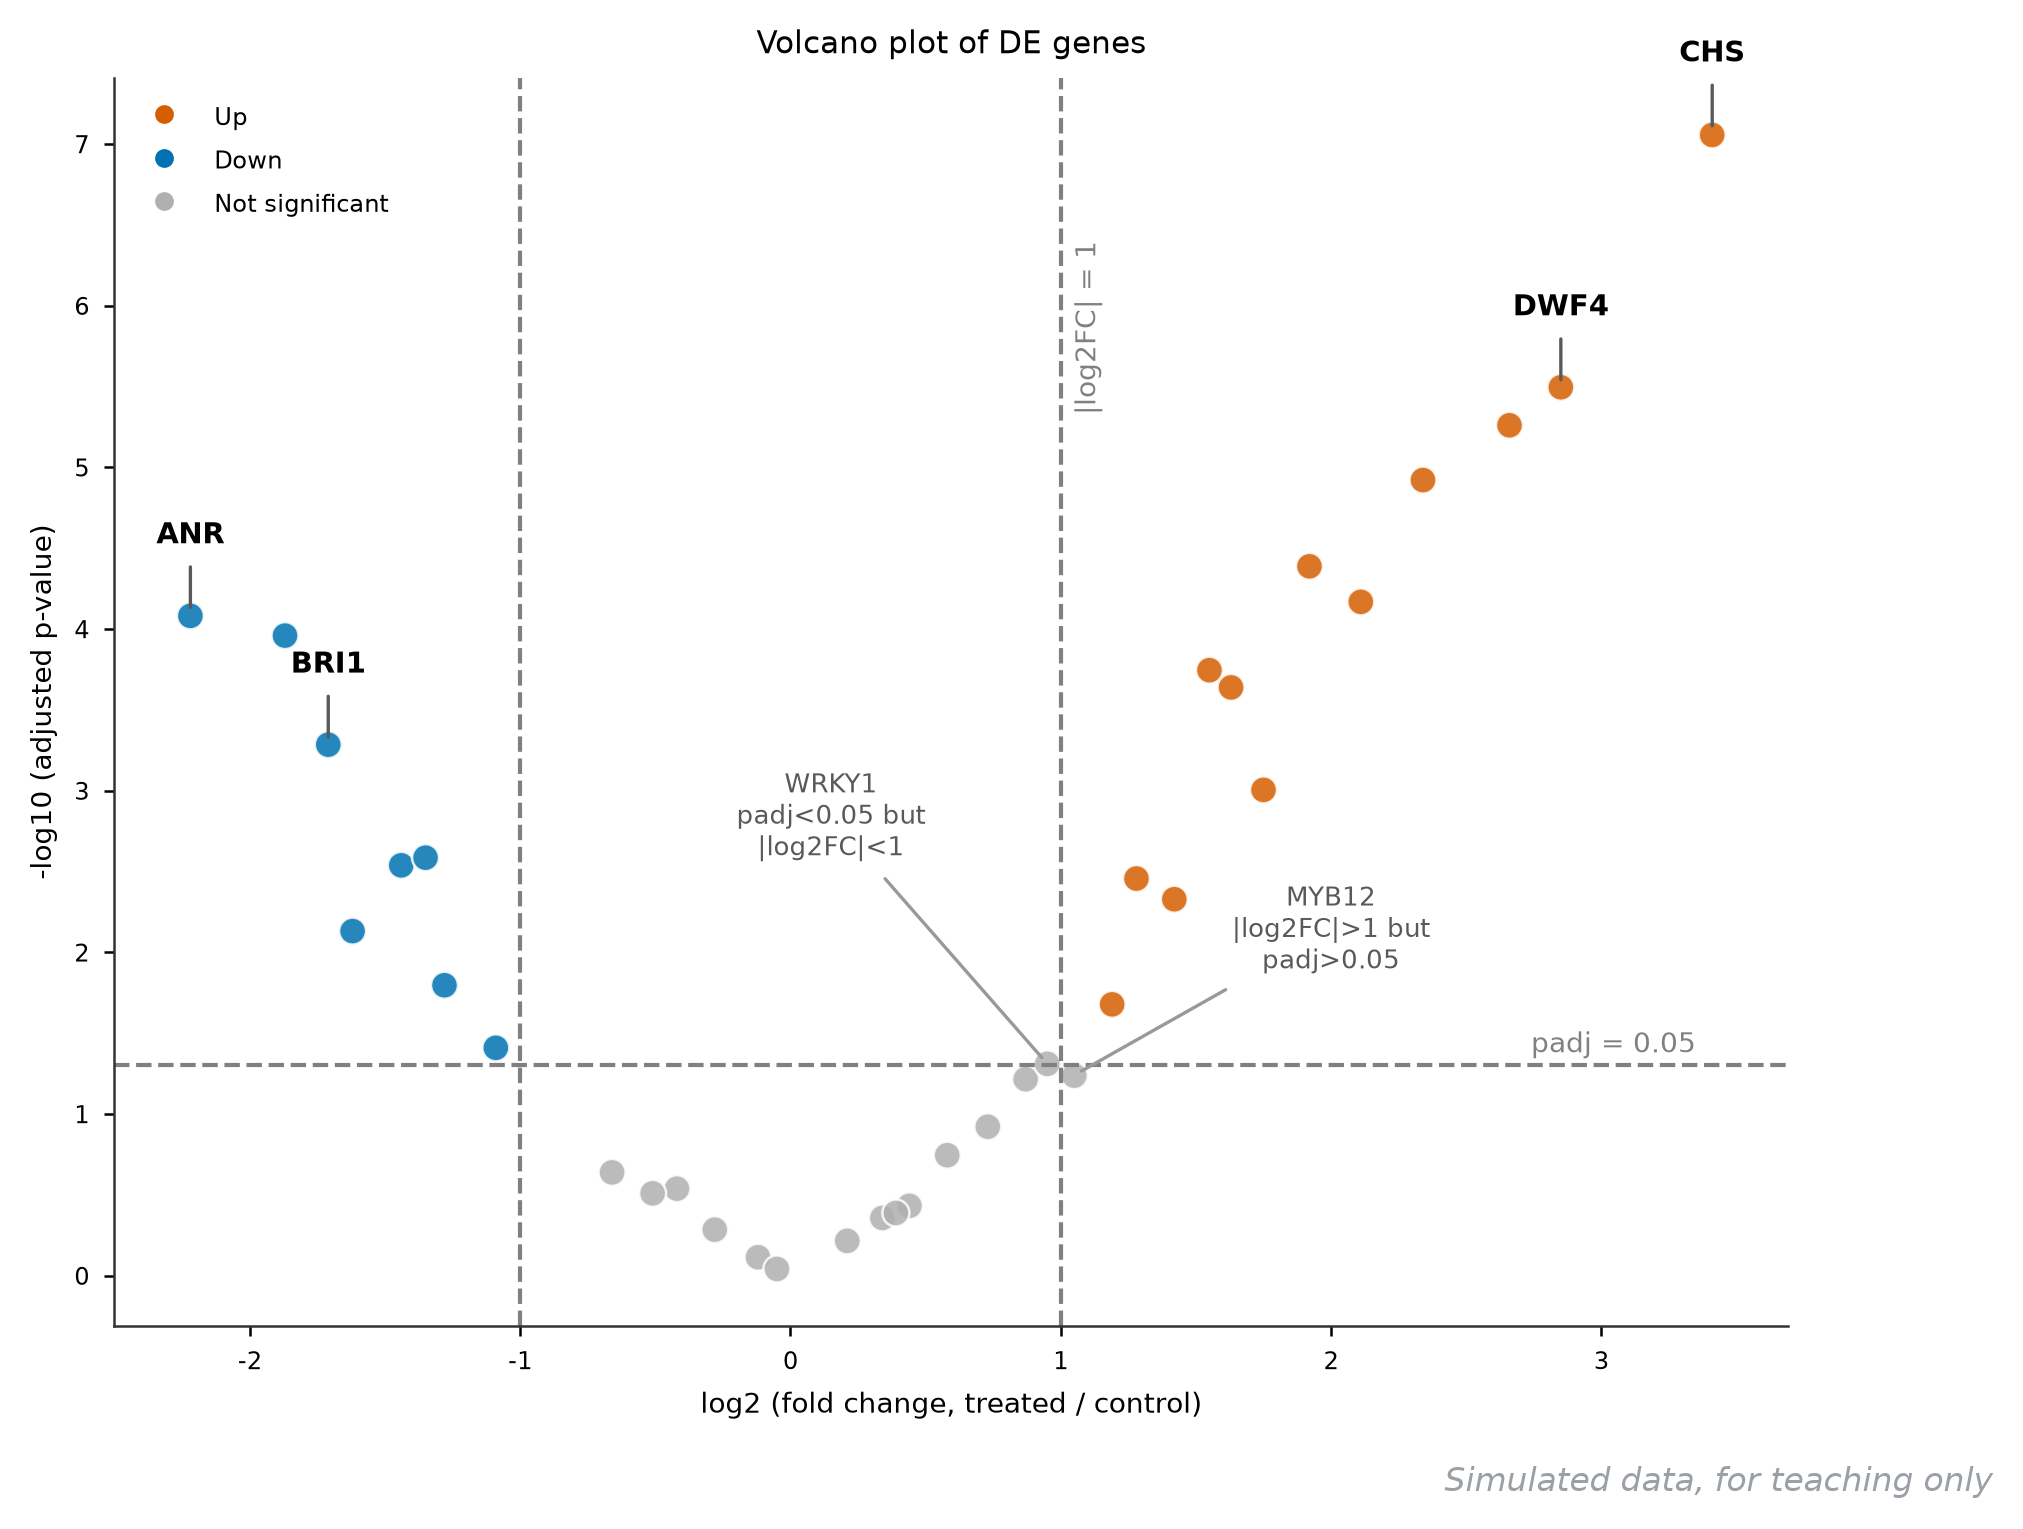
红蓝换成 Okabe-Ito 的朱红/蓝(红绿色盲也能分),网格撤掉,字号缩一档。基因名锚线保留。
图 3 相关性热图
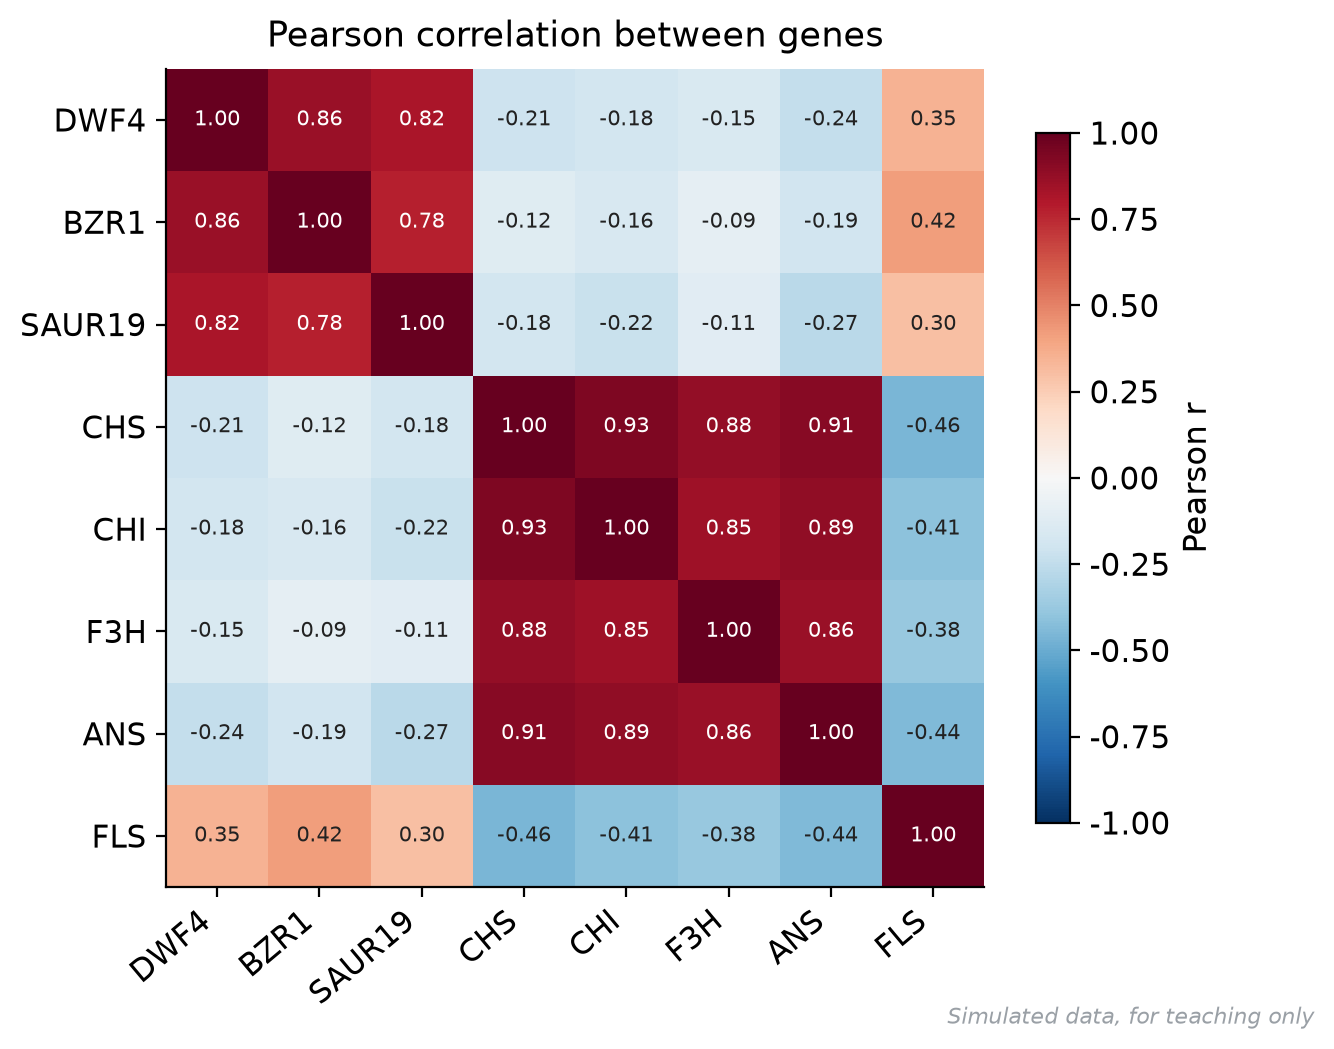
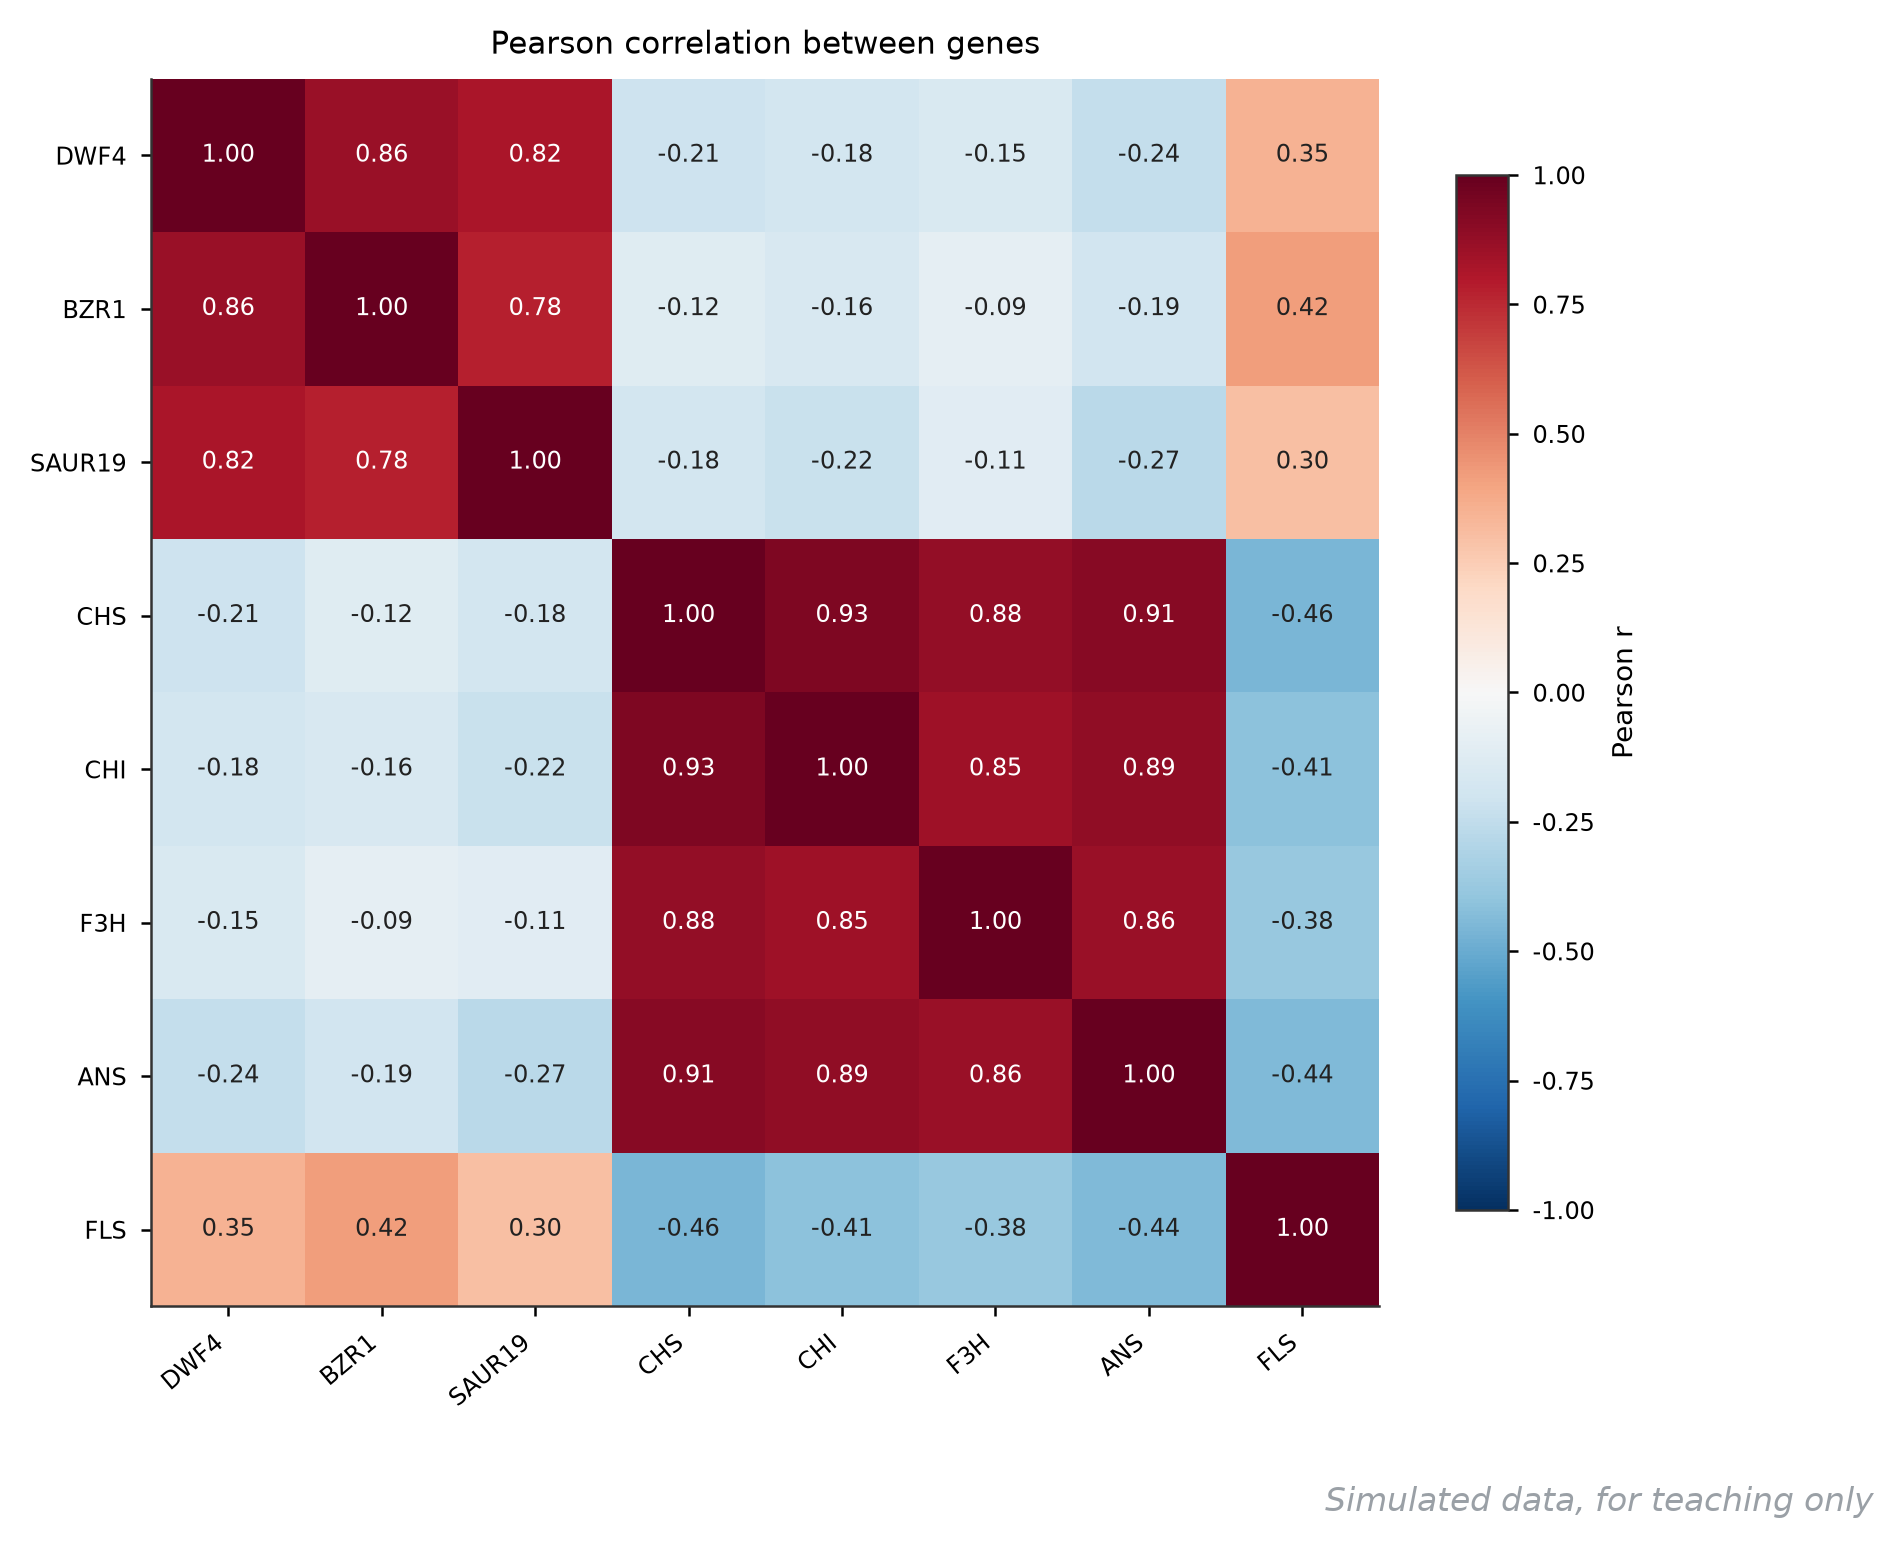
YlGnBu 色图未动,单元格数字改按填充亮度自动换黑/白——旧版深蓝格子上的深灰数字几乎不可读。
图 6 箱线图 / 图 7 小提琴图
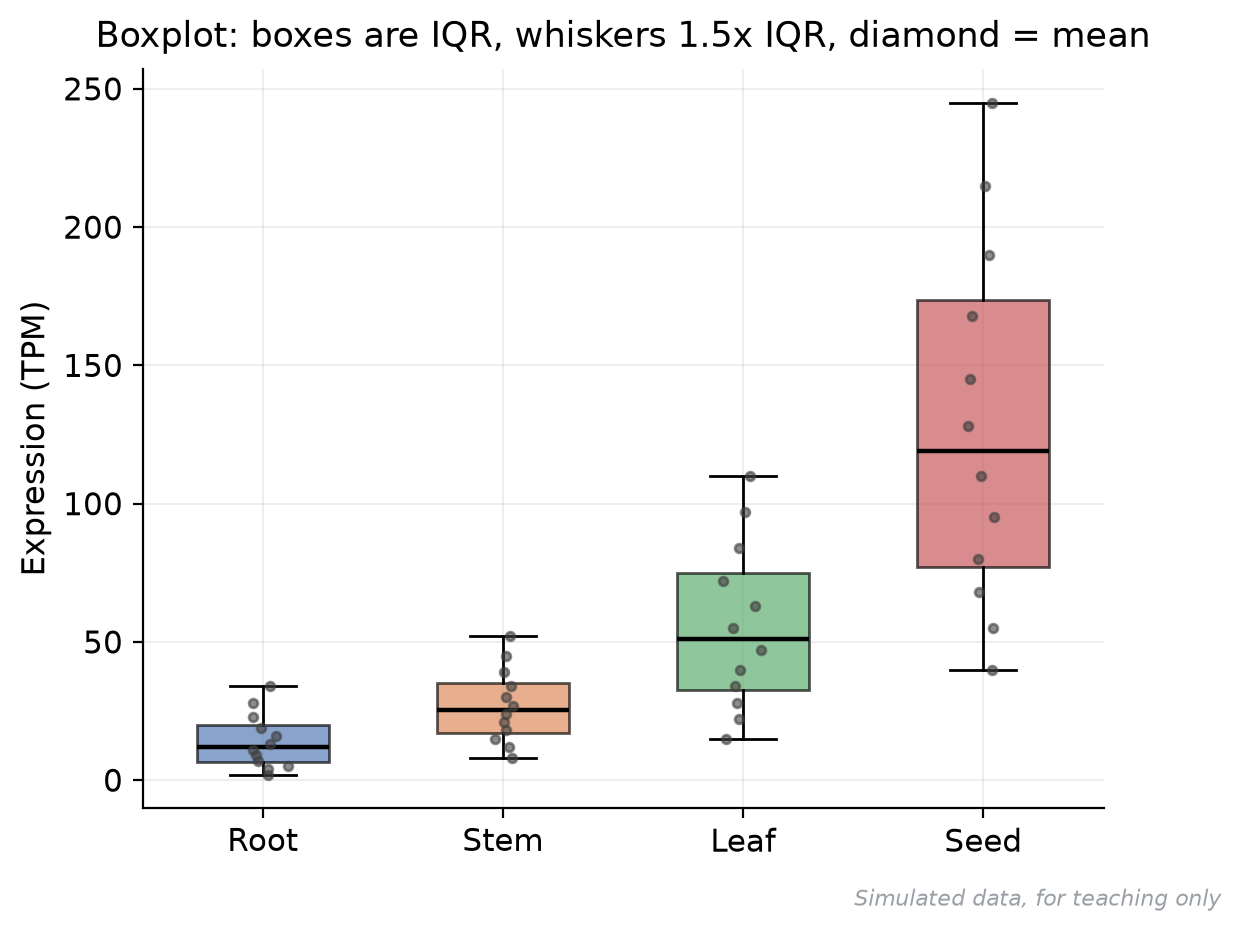
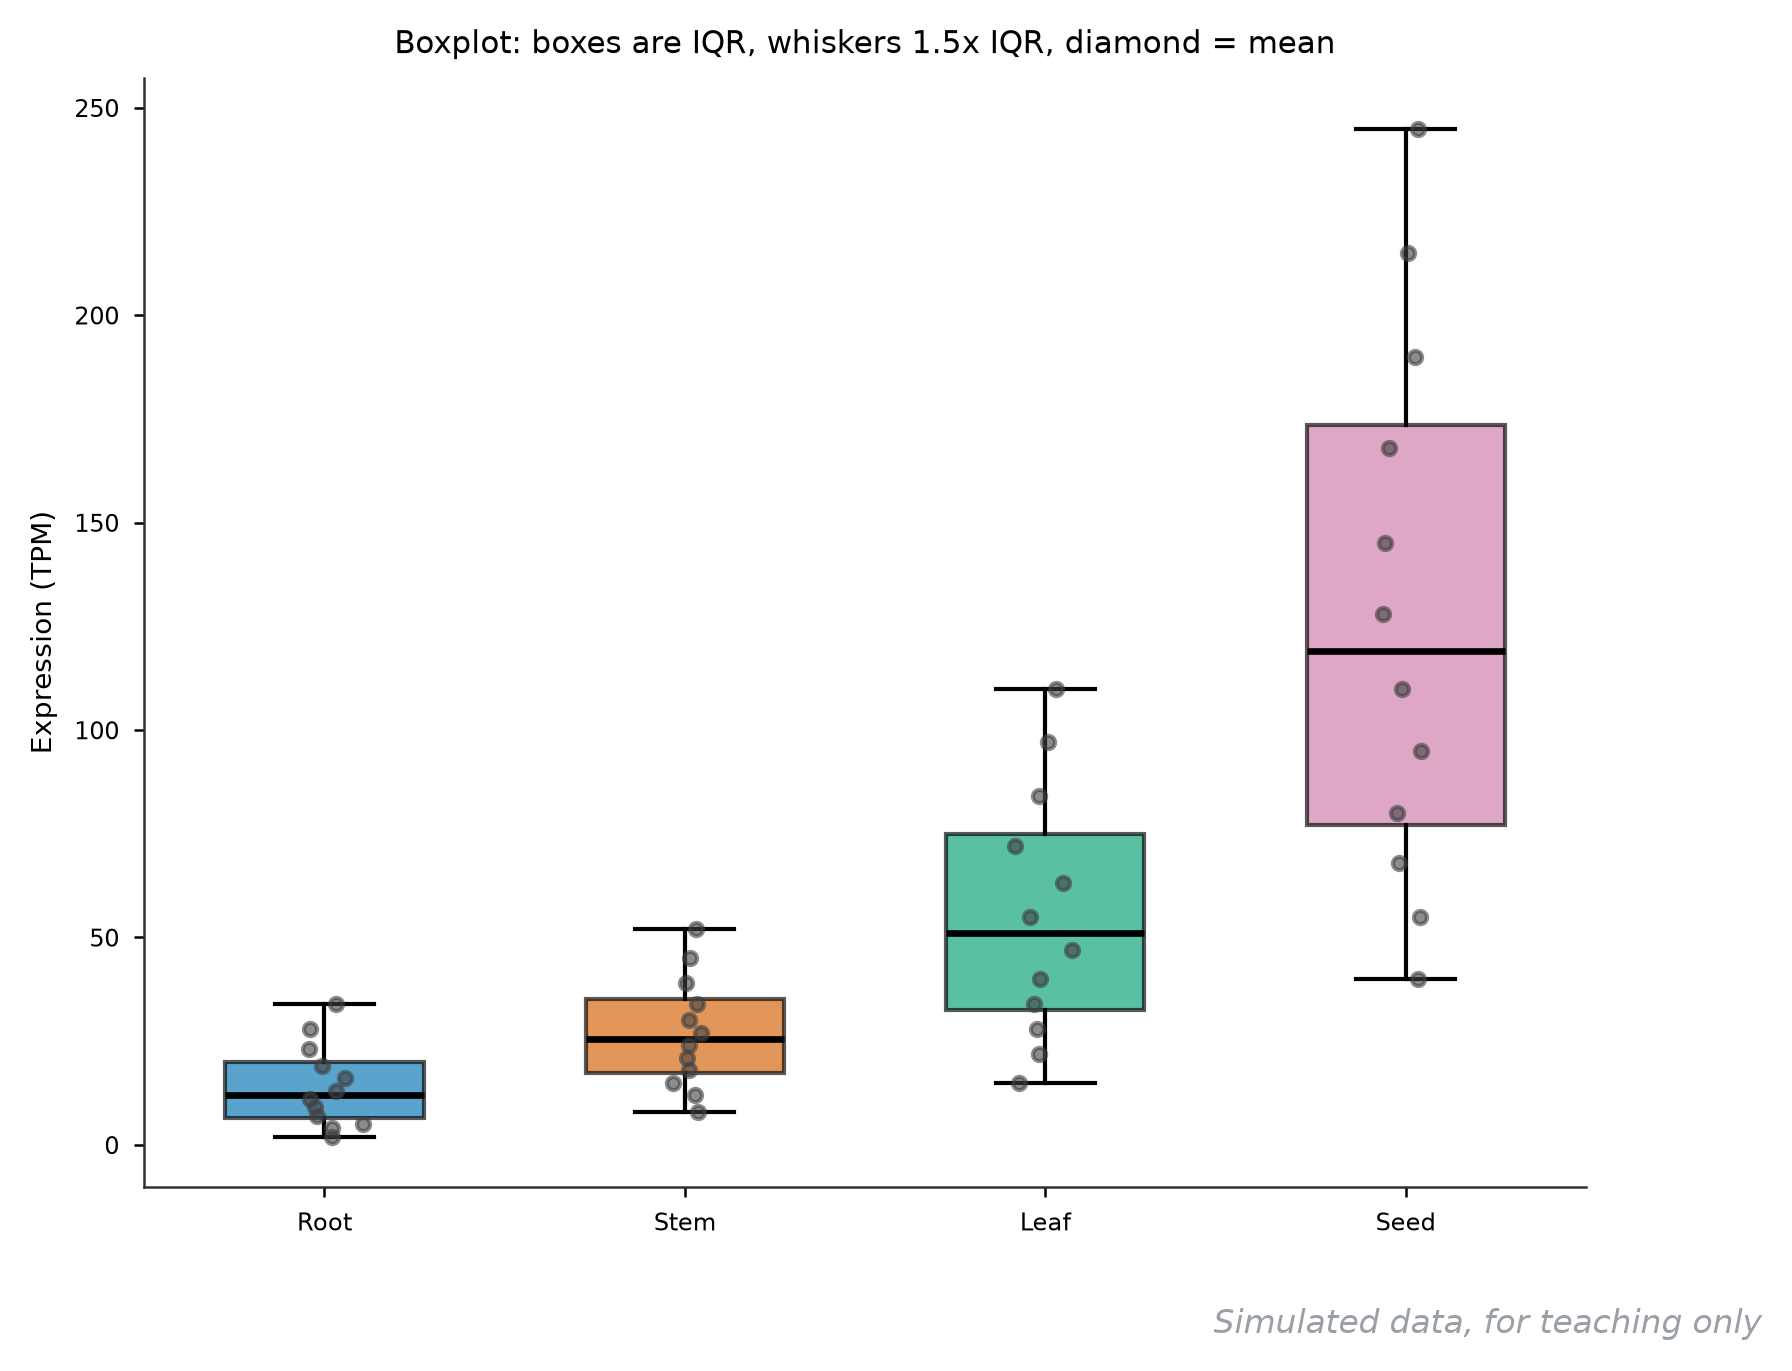
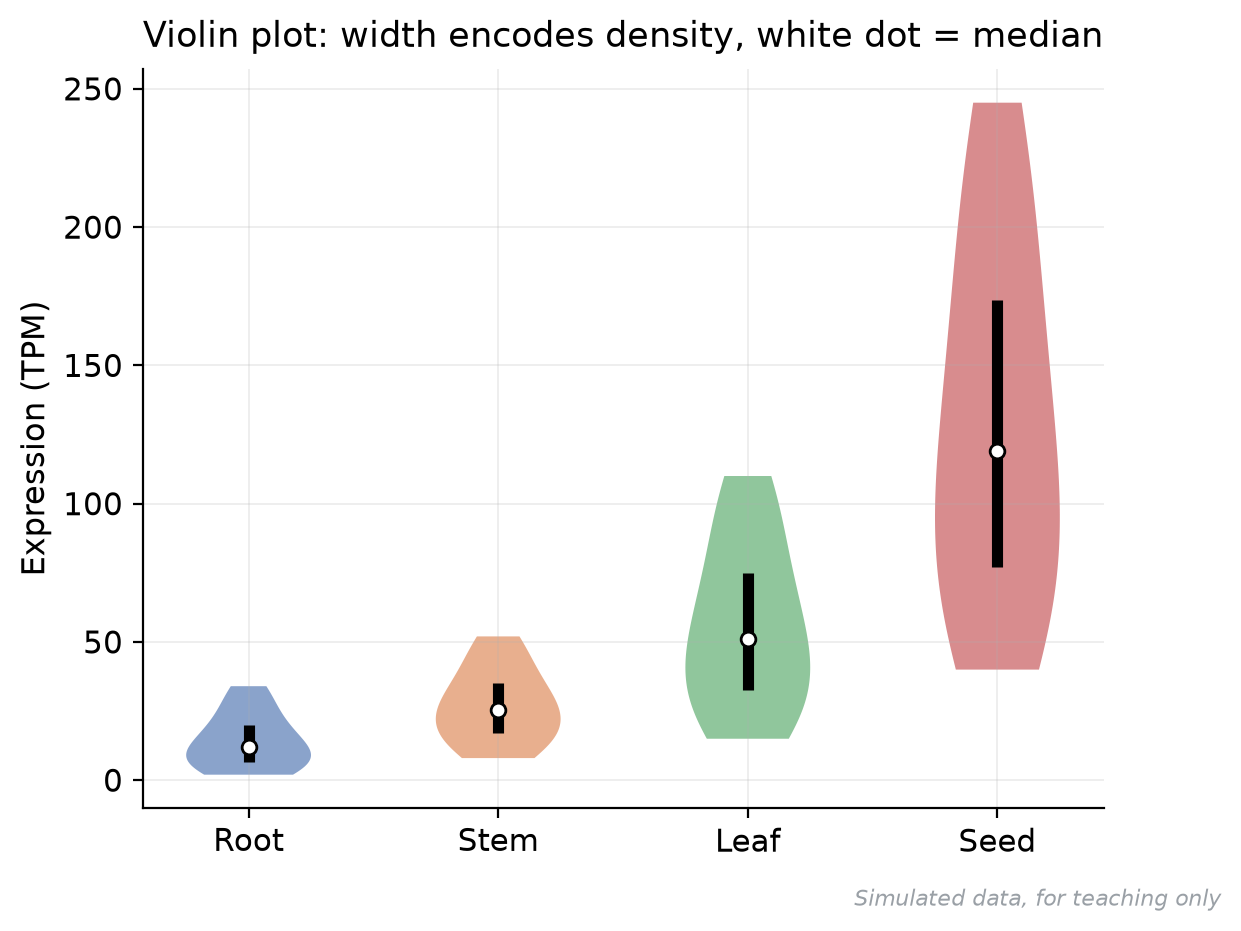
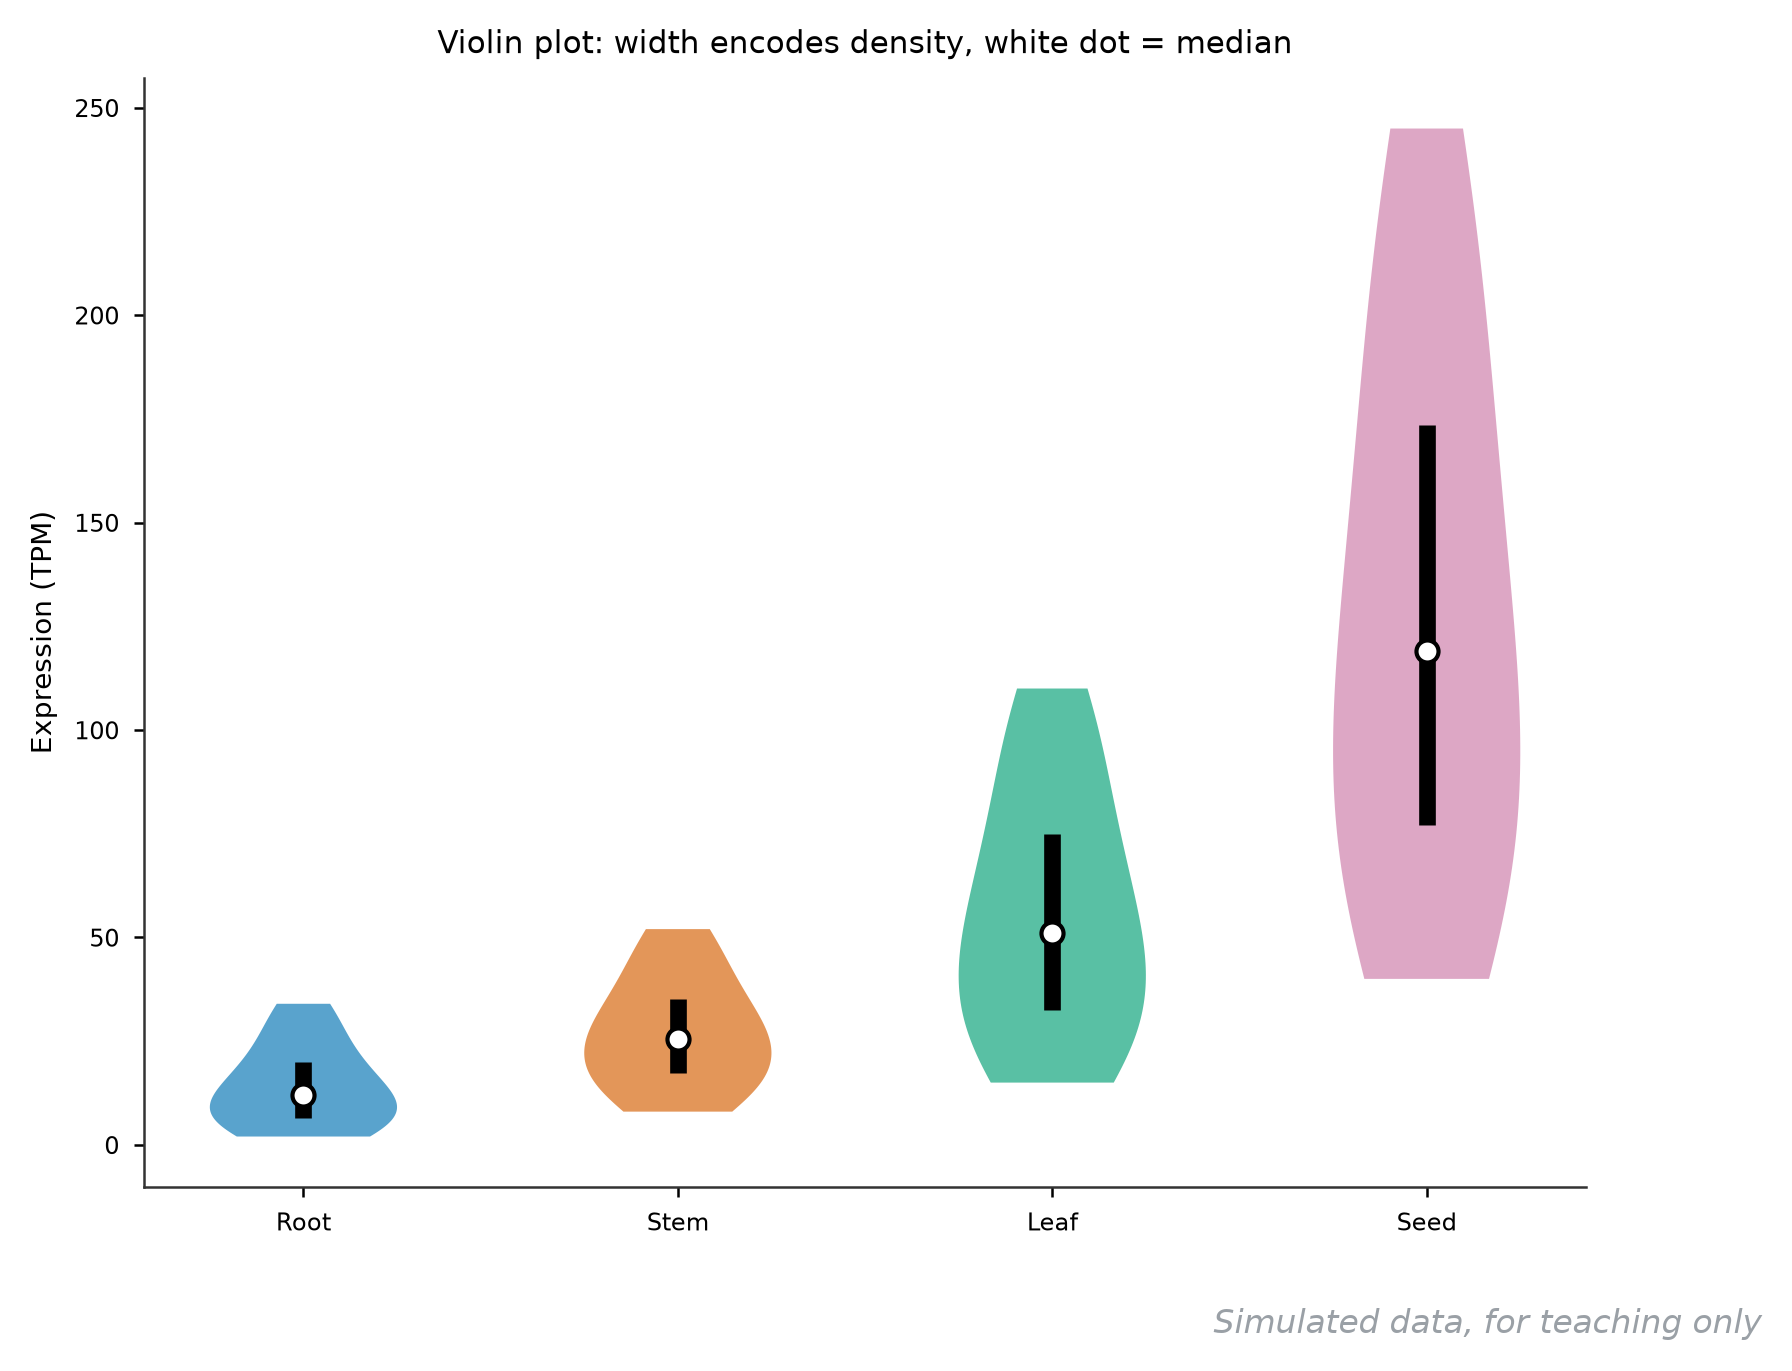
图 10 UpSet 图
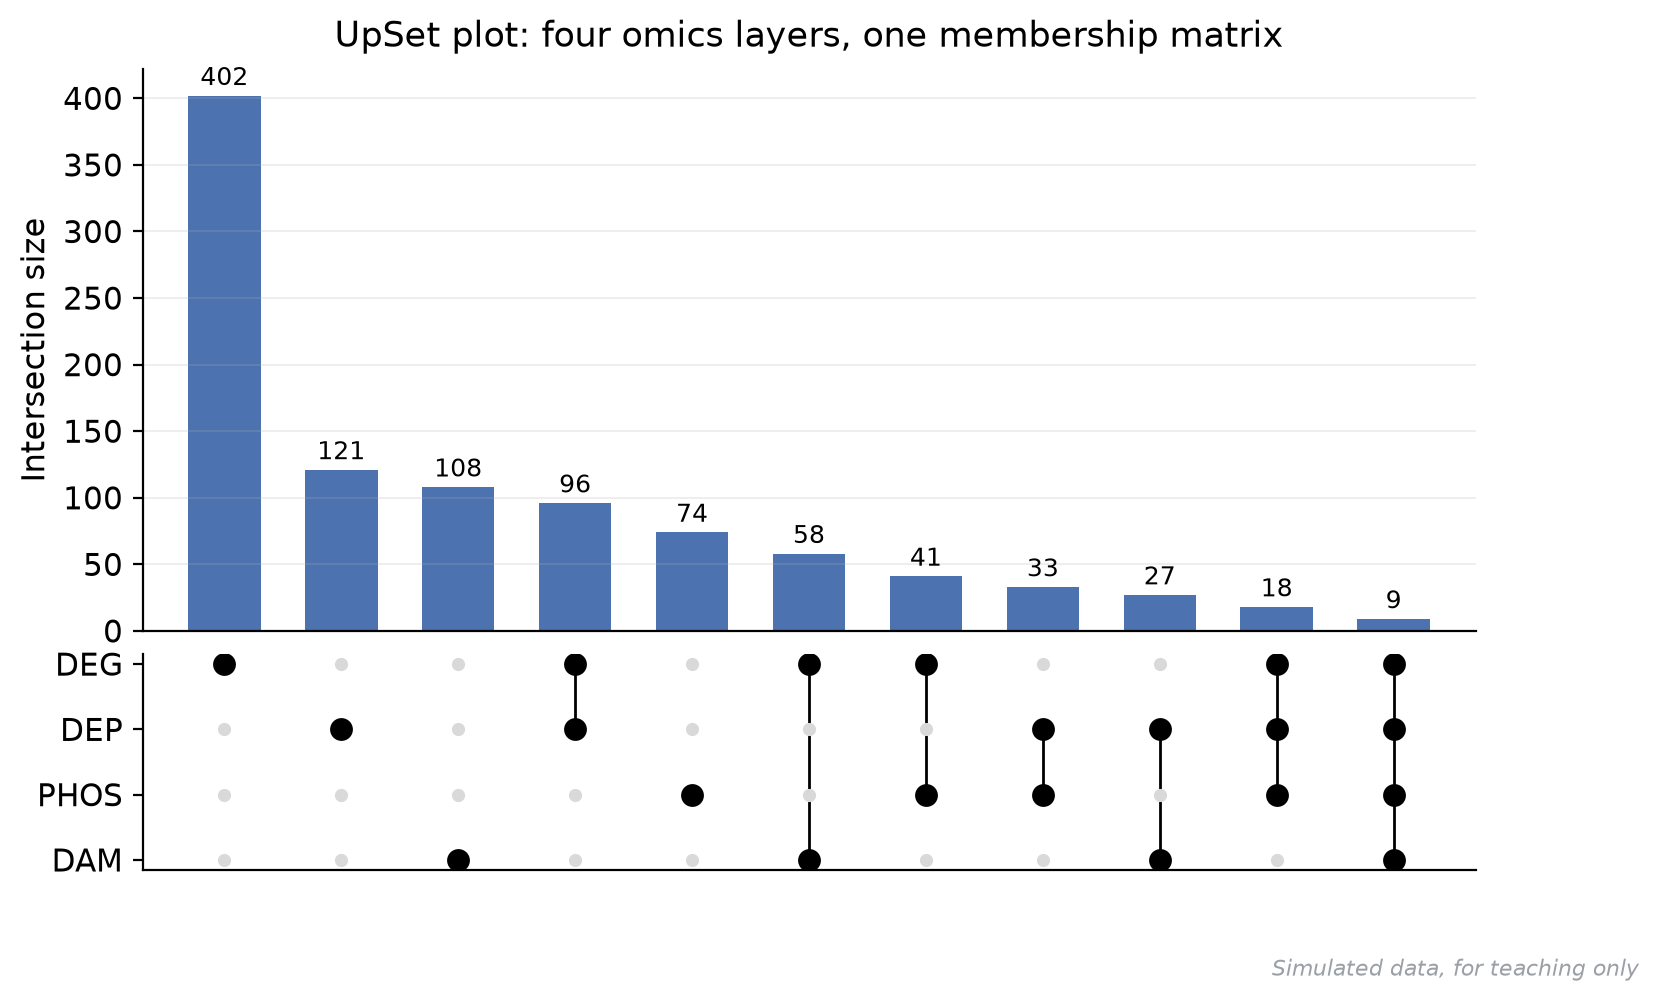
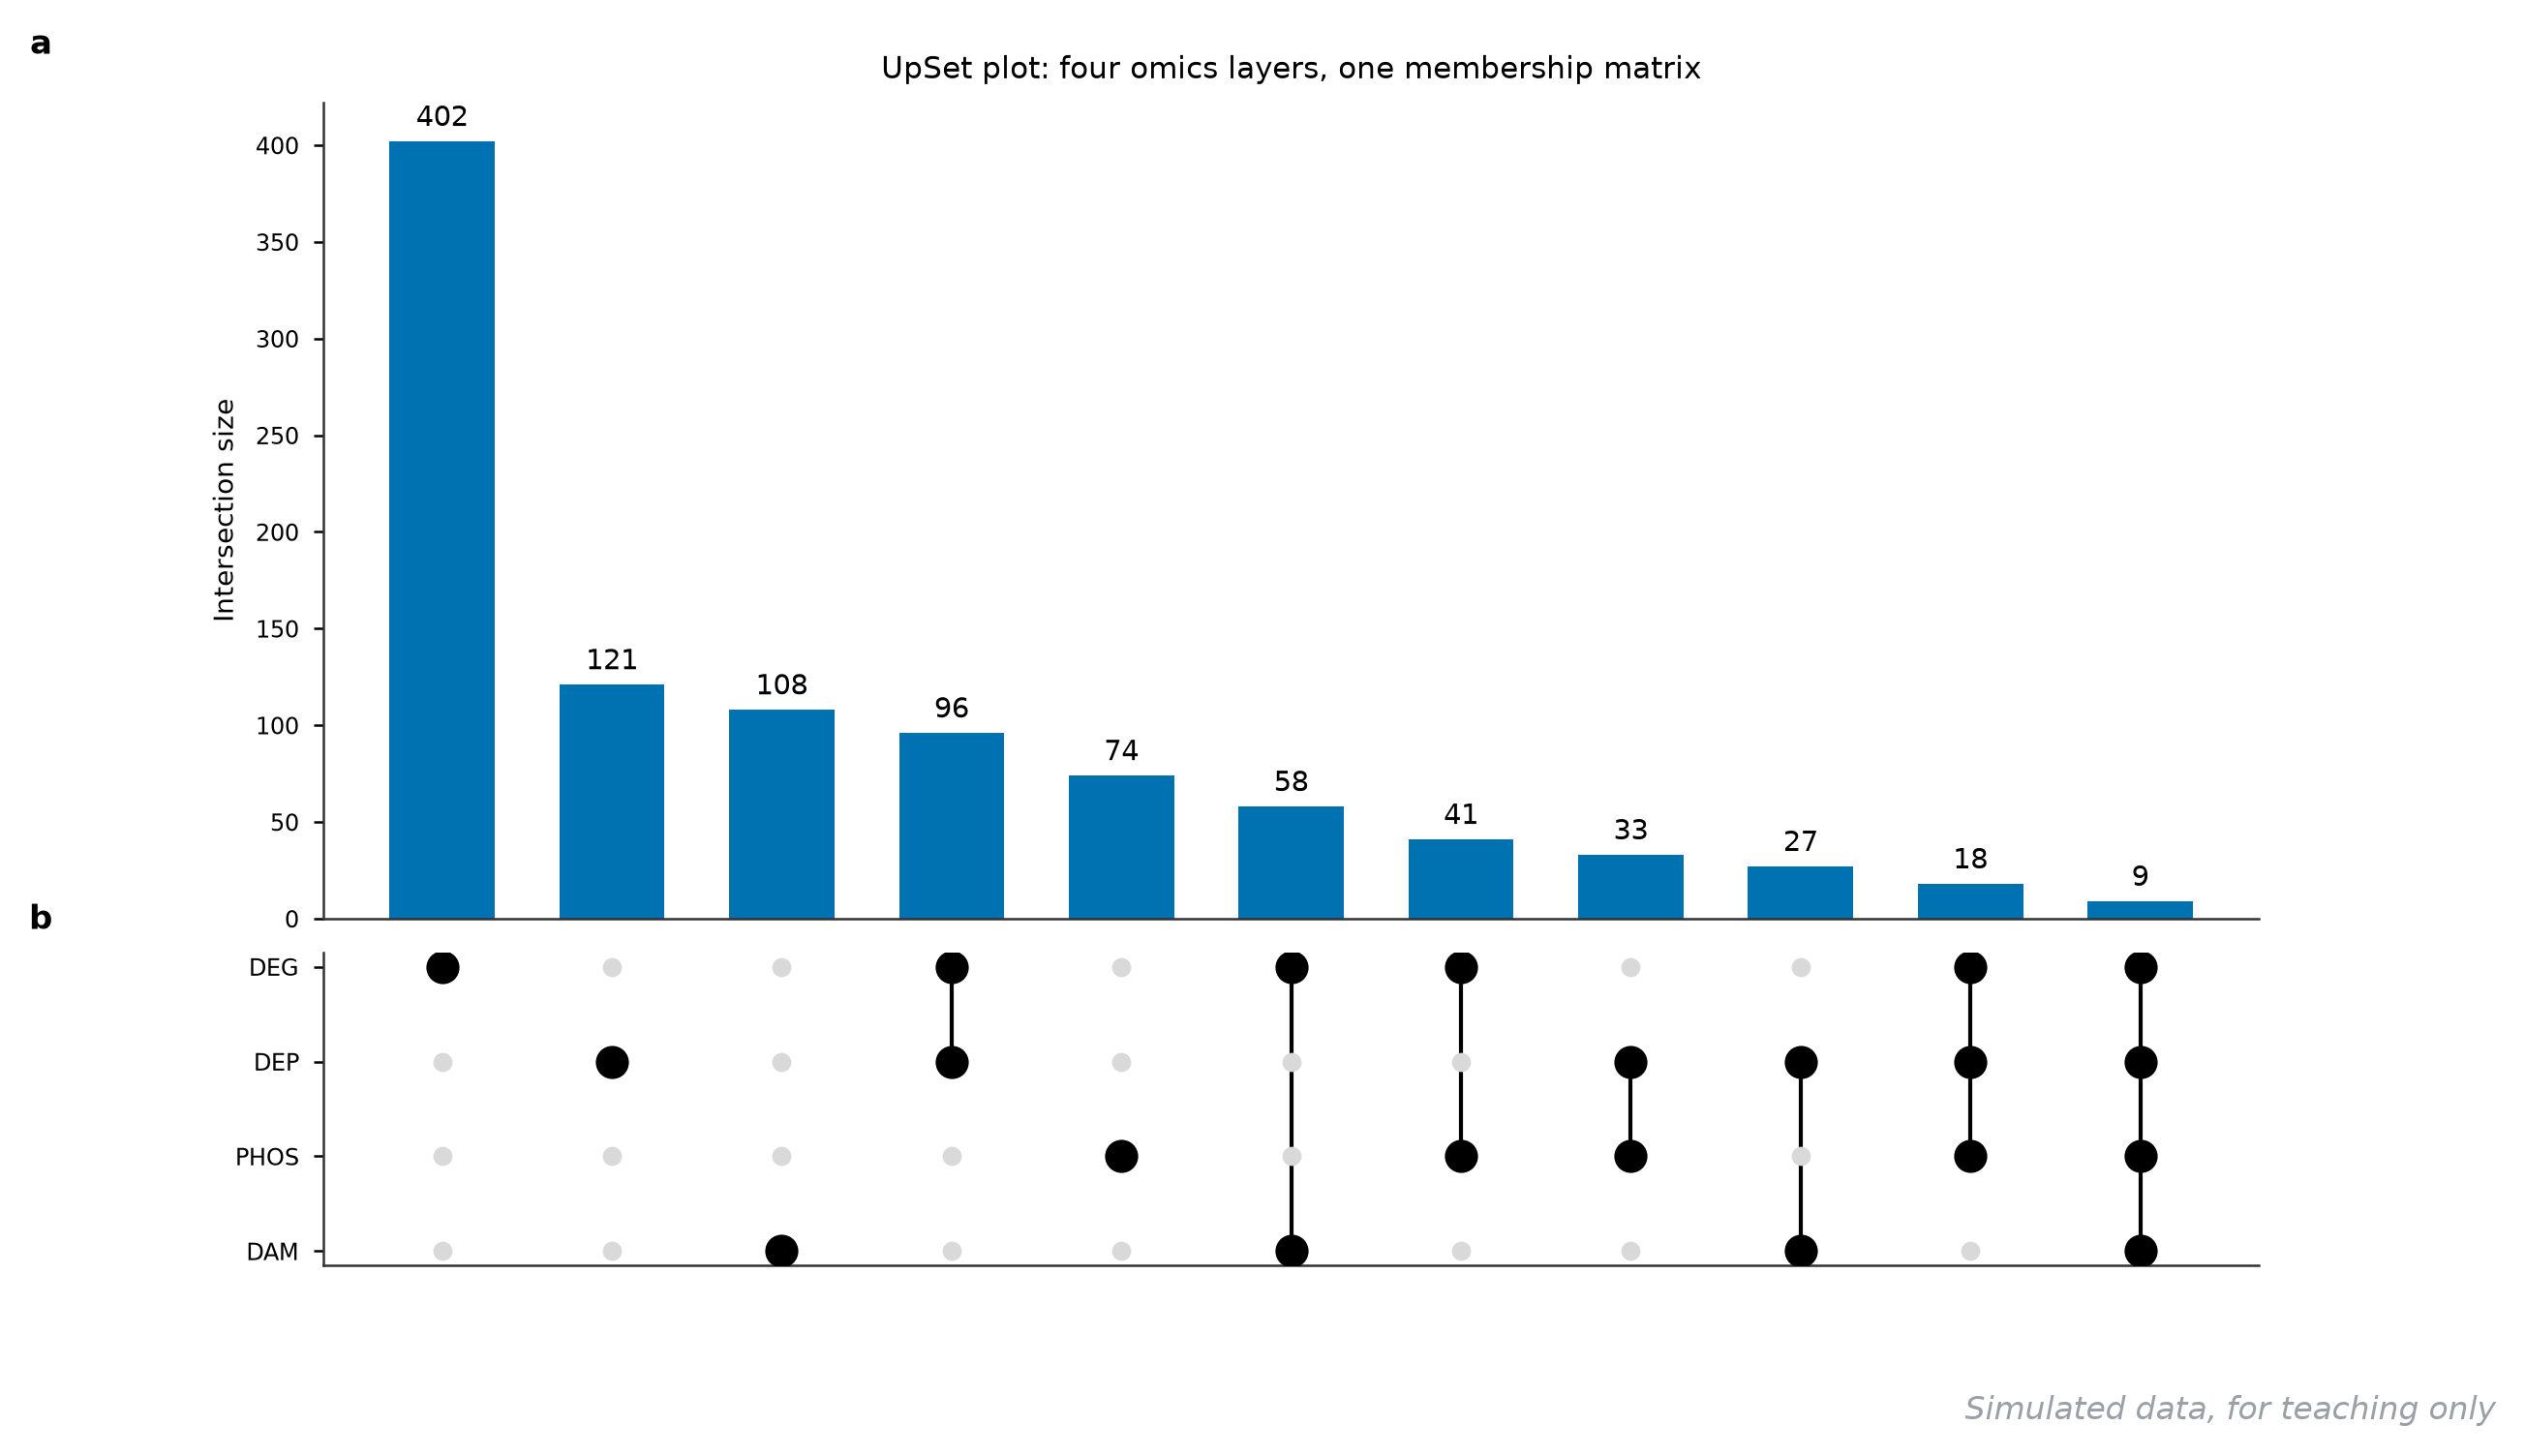
双面板自动钉上 a/b 字母——这是本次新增的导出级规则:任何多于一个数据面板的图,导出时按面板顺序自动标注粗体小写字母(colorbar 与孪生轴自动跳过)。
图 13 UMAP
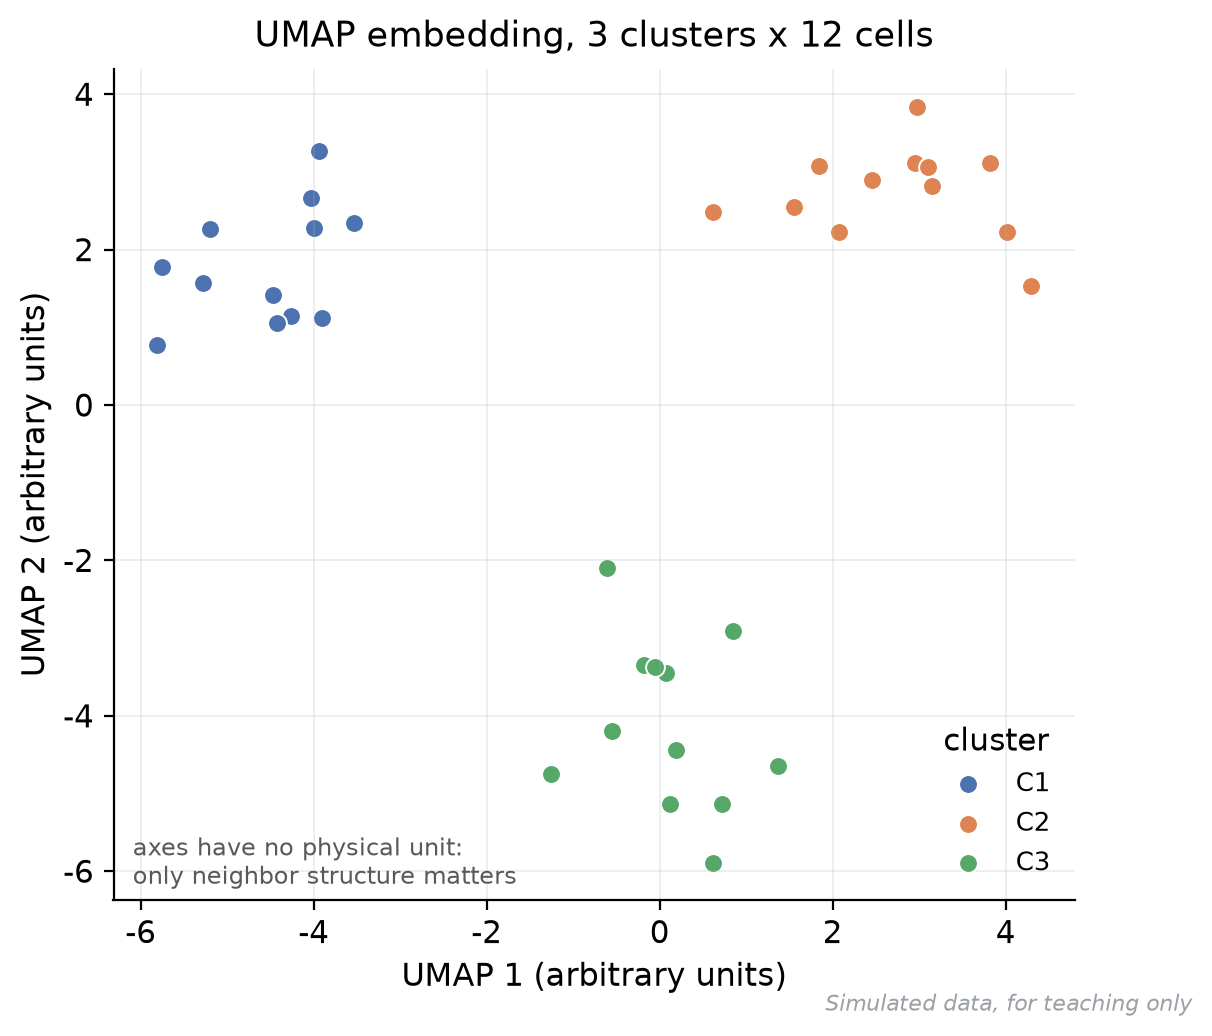
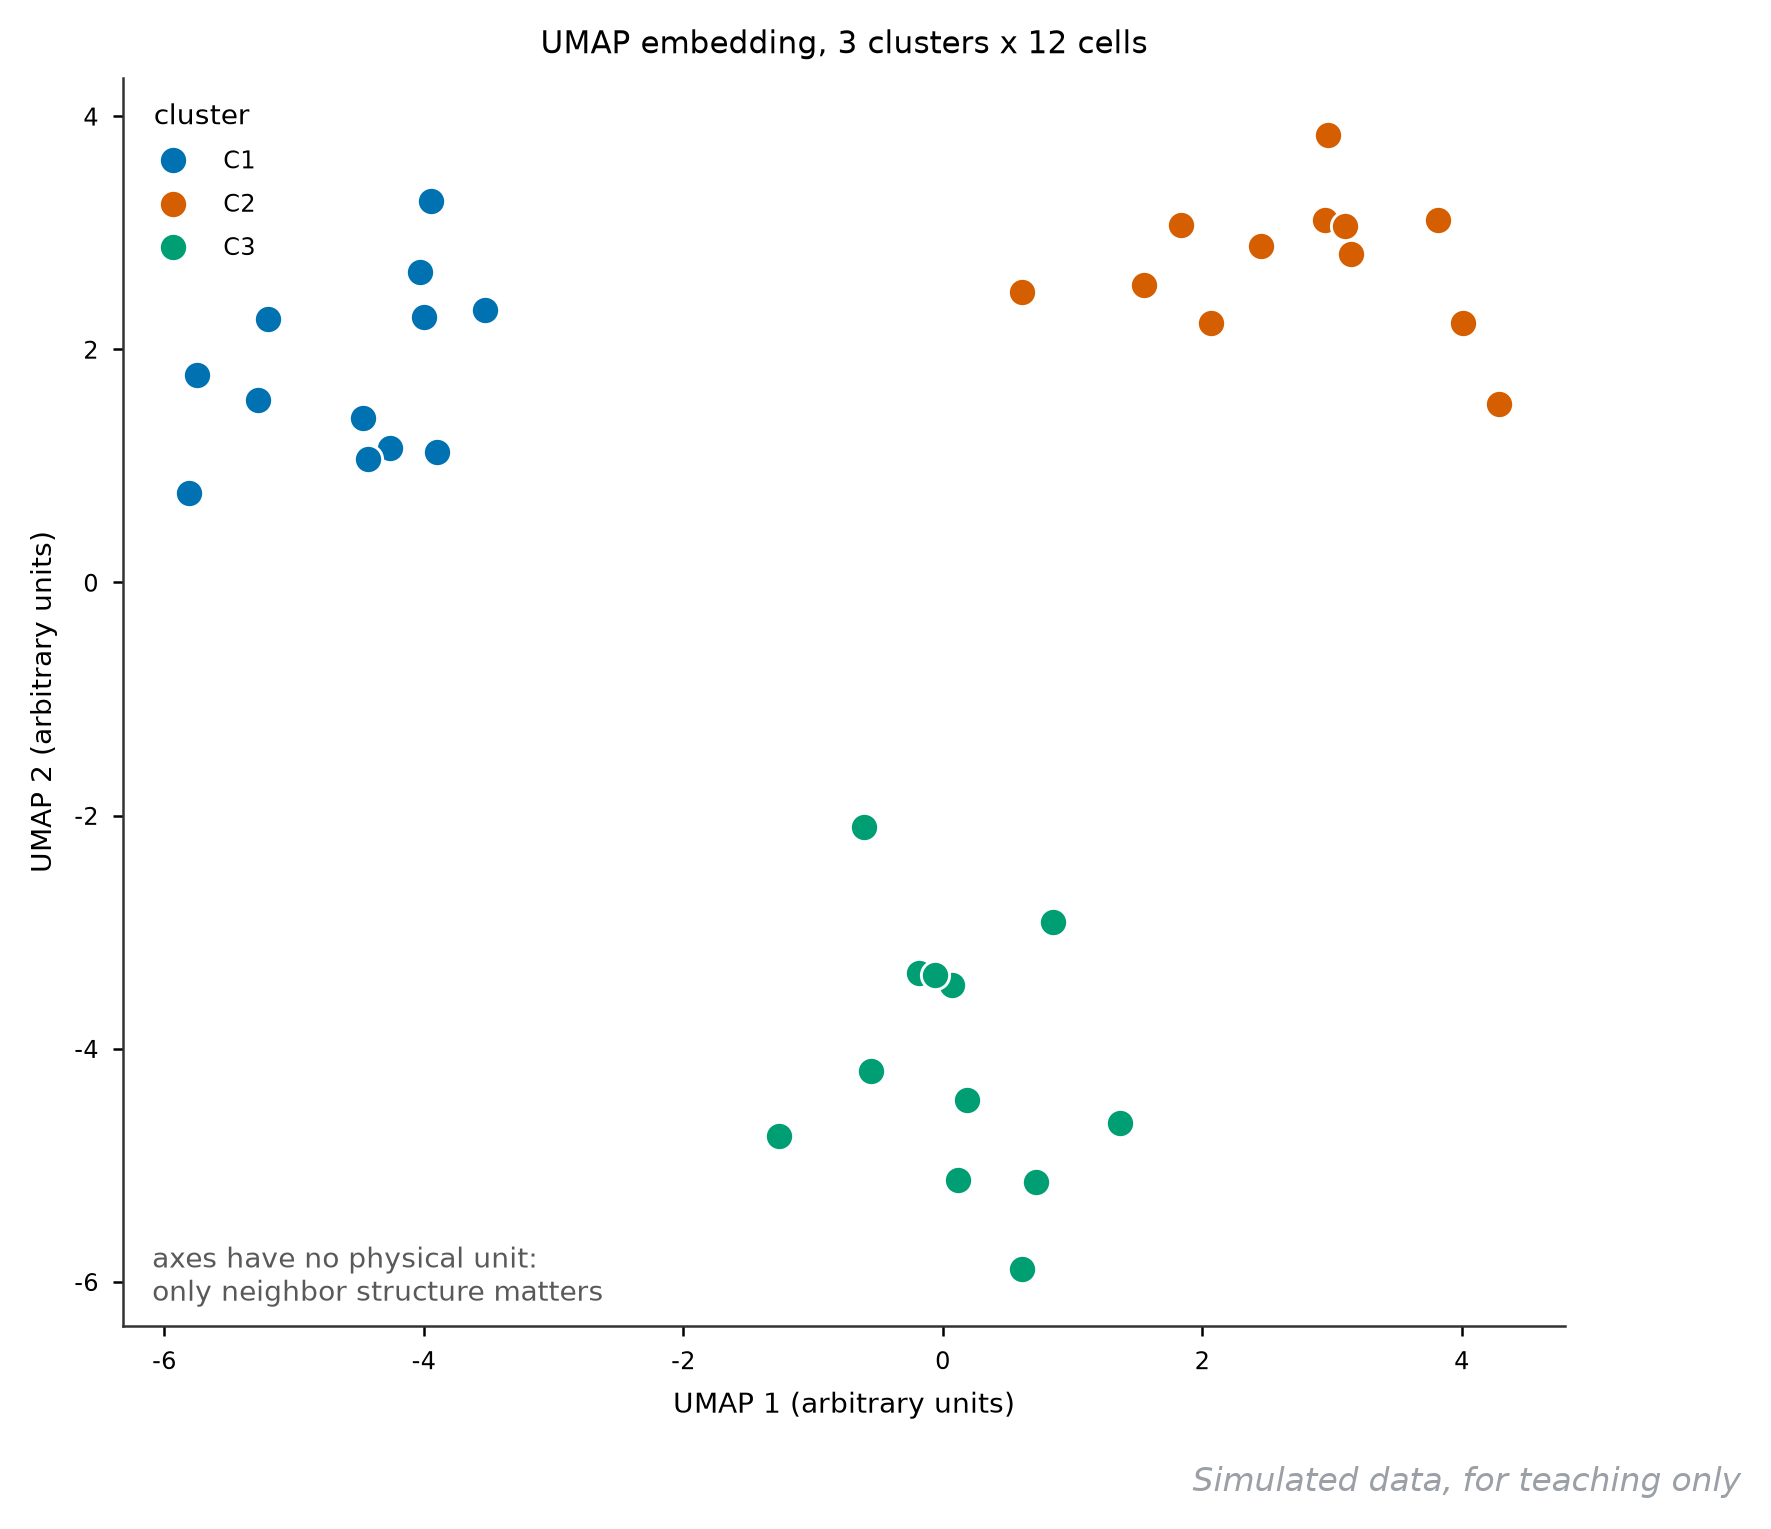
图 51 Circos 风格共线性圈图
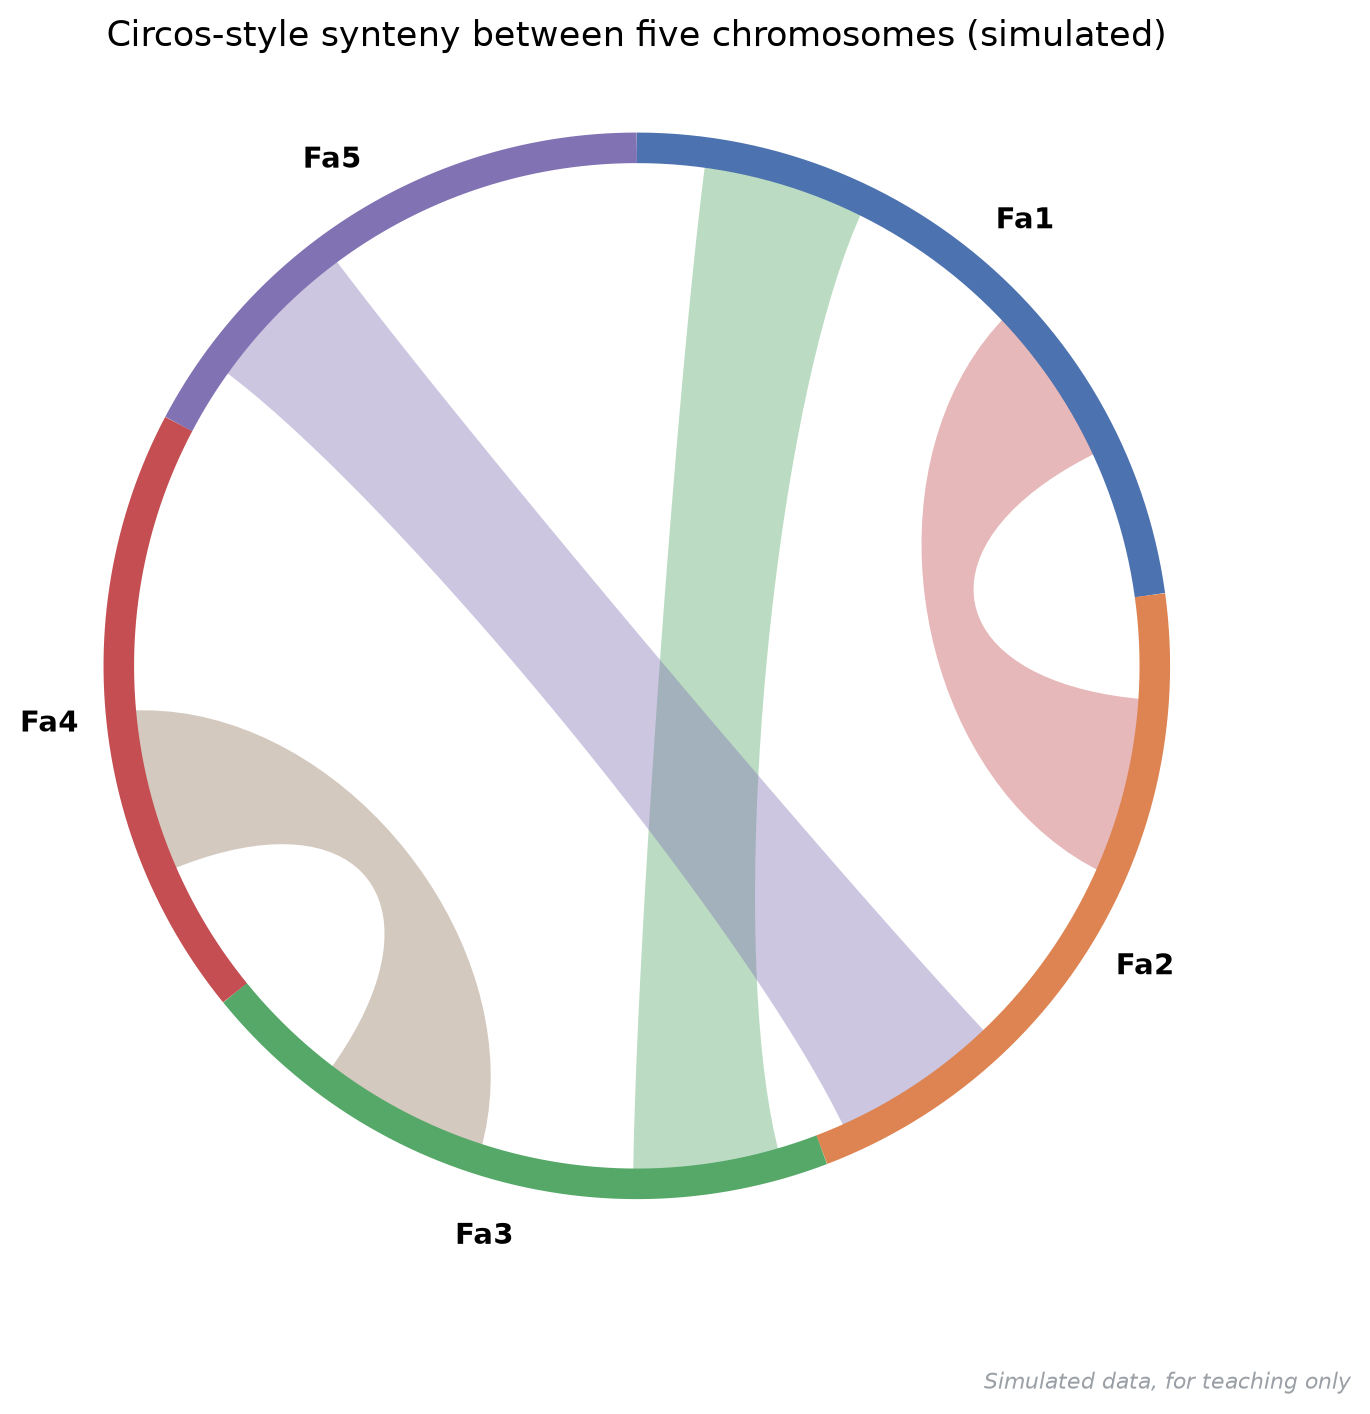
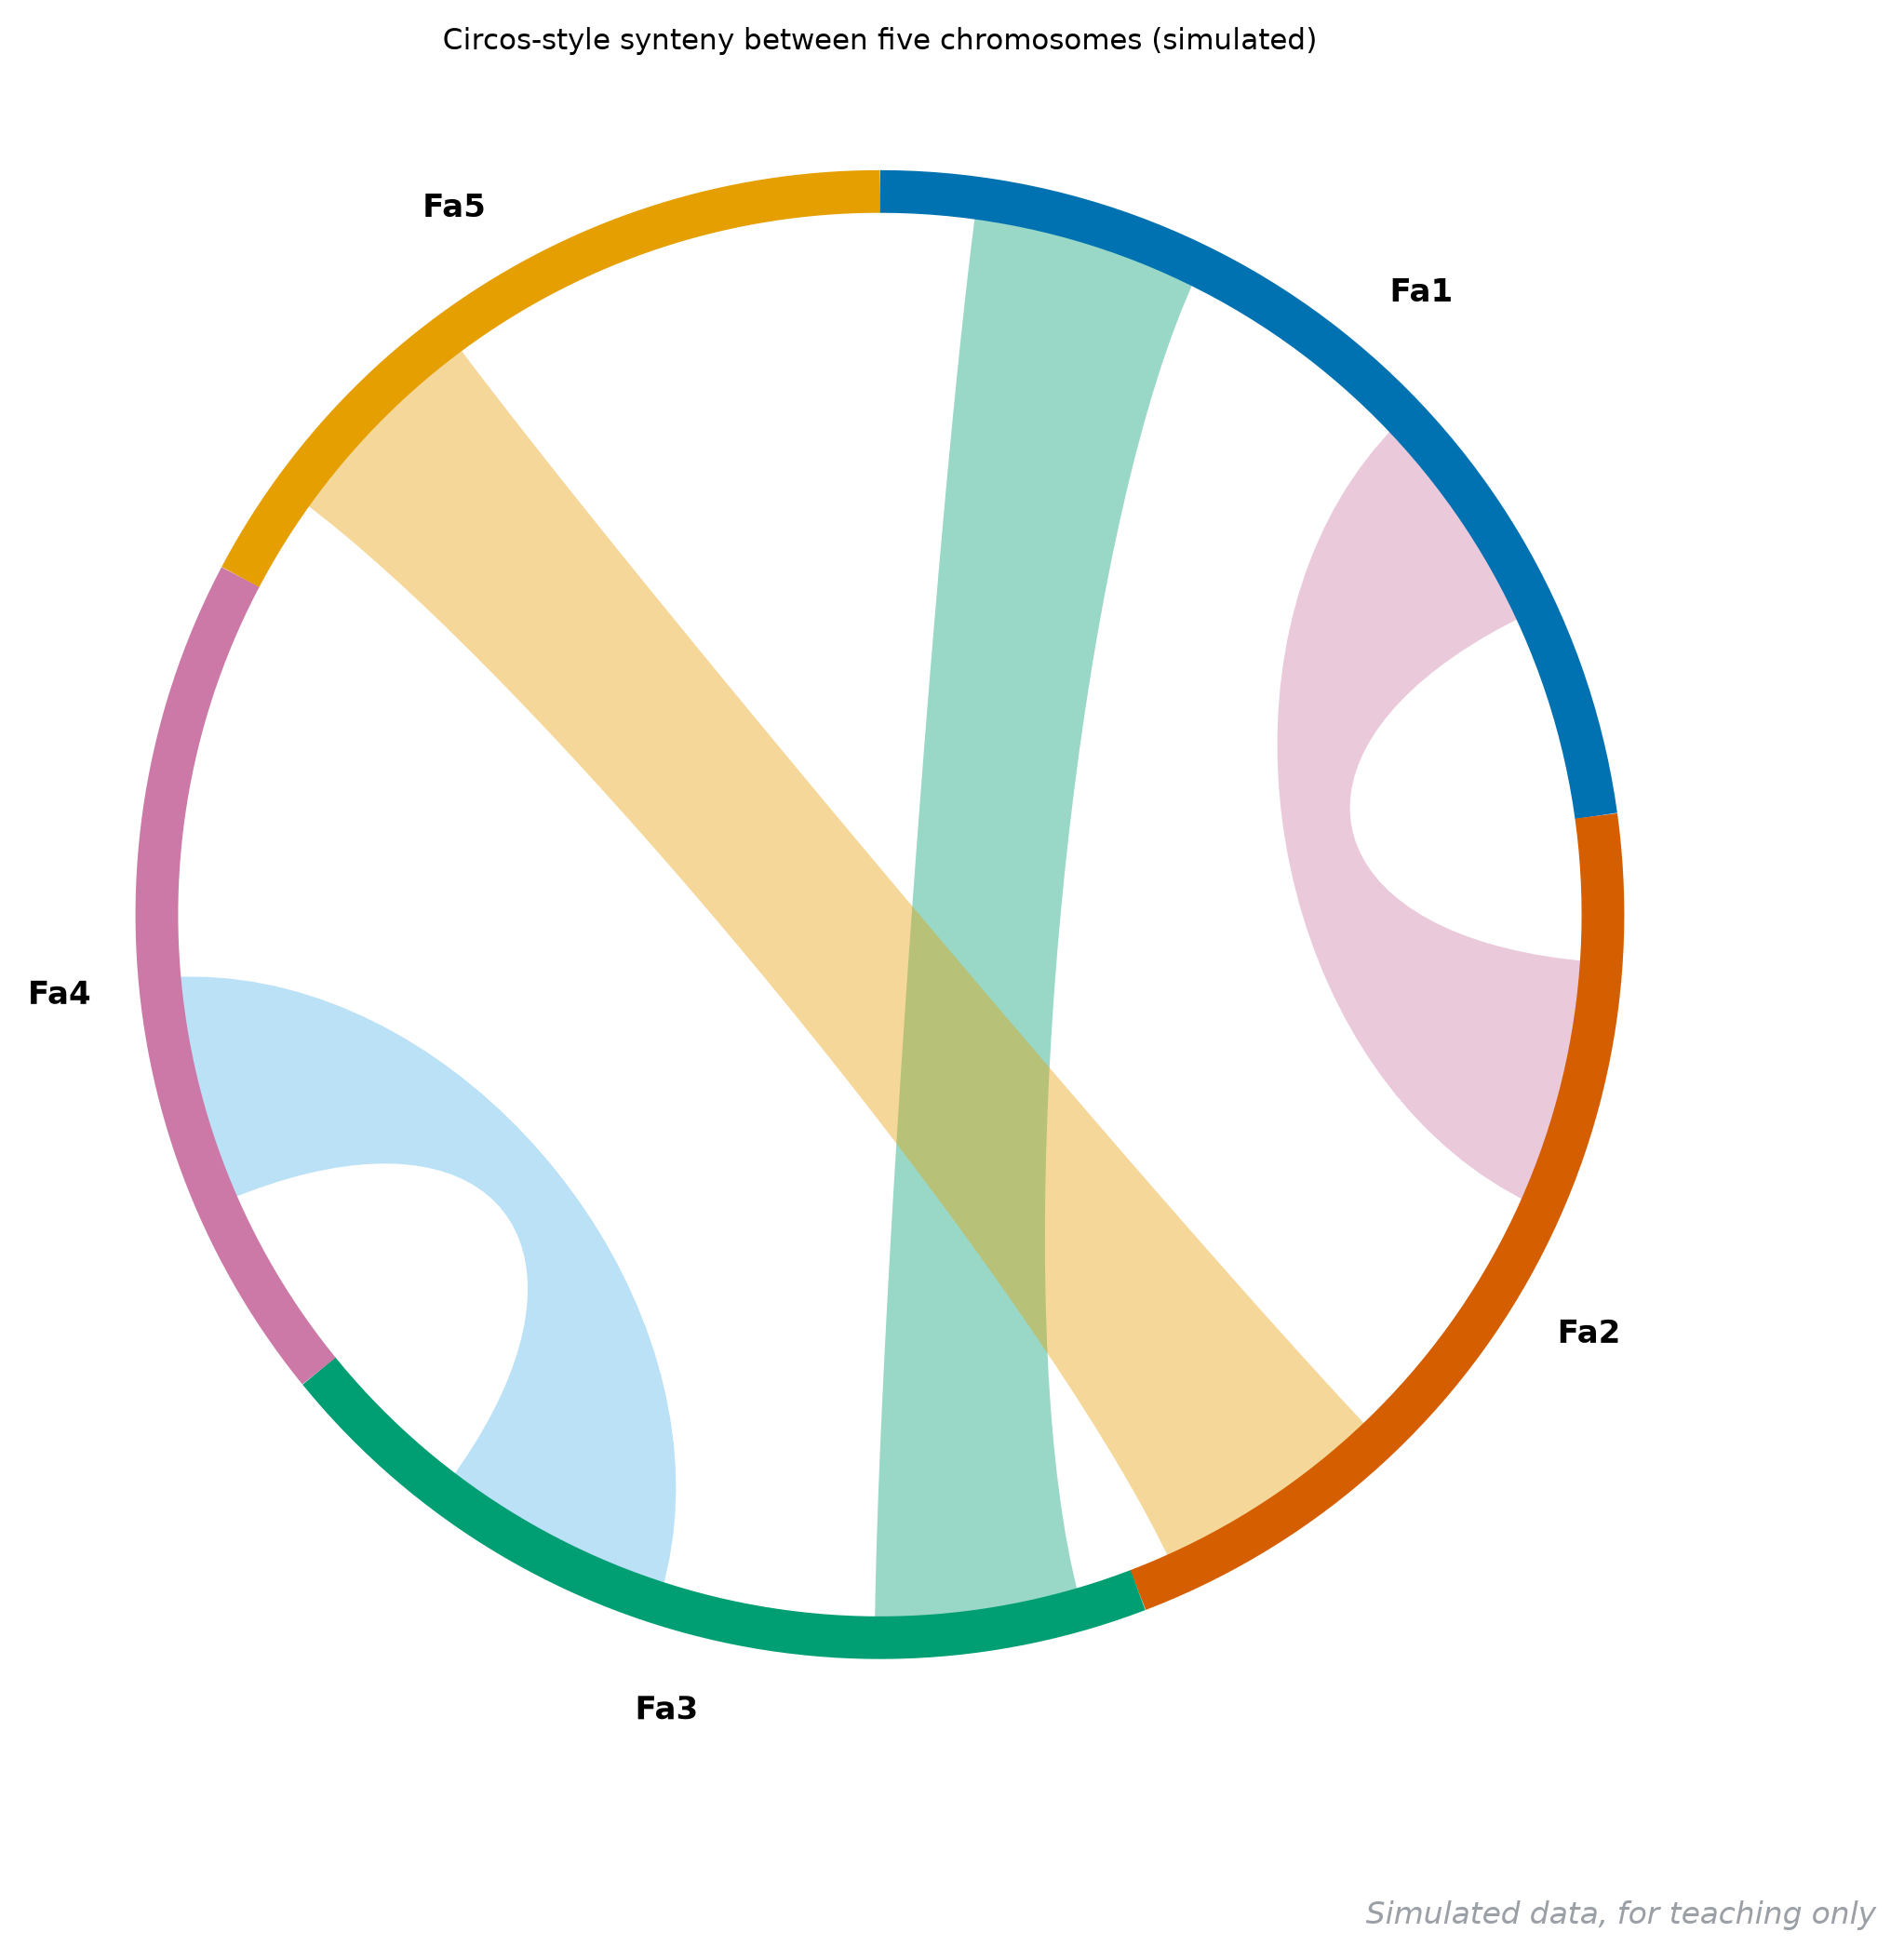
染色体弧与共线性带整体换 Okabe-Ito 低饱和版本,大圆图最怕的高饱和”儿童轮胎”感消失。
图 100 marker 点图 / 图 101 细胞通讯圈图
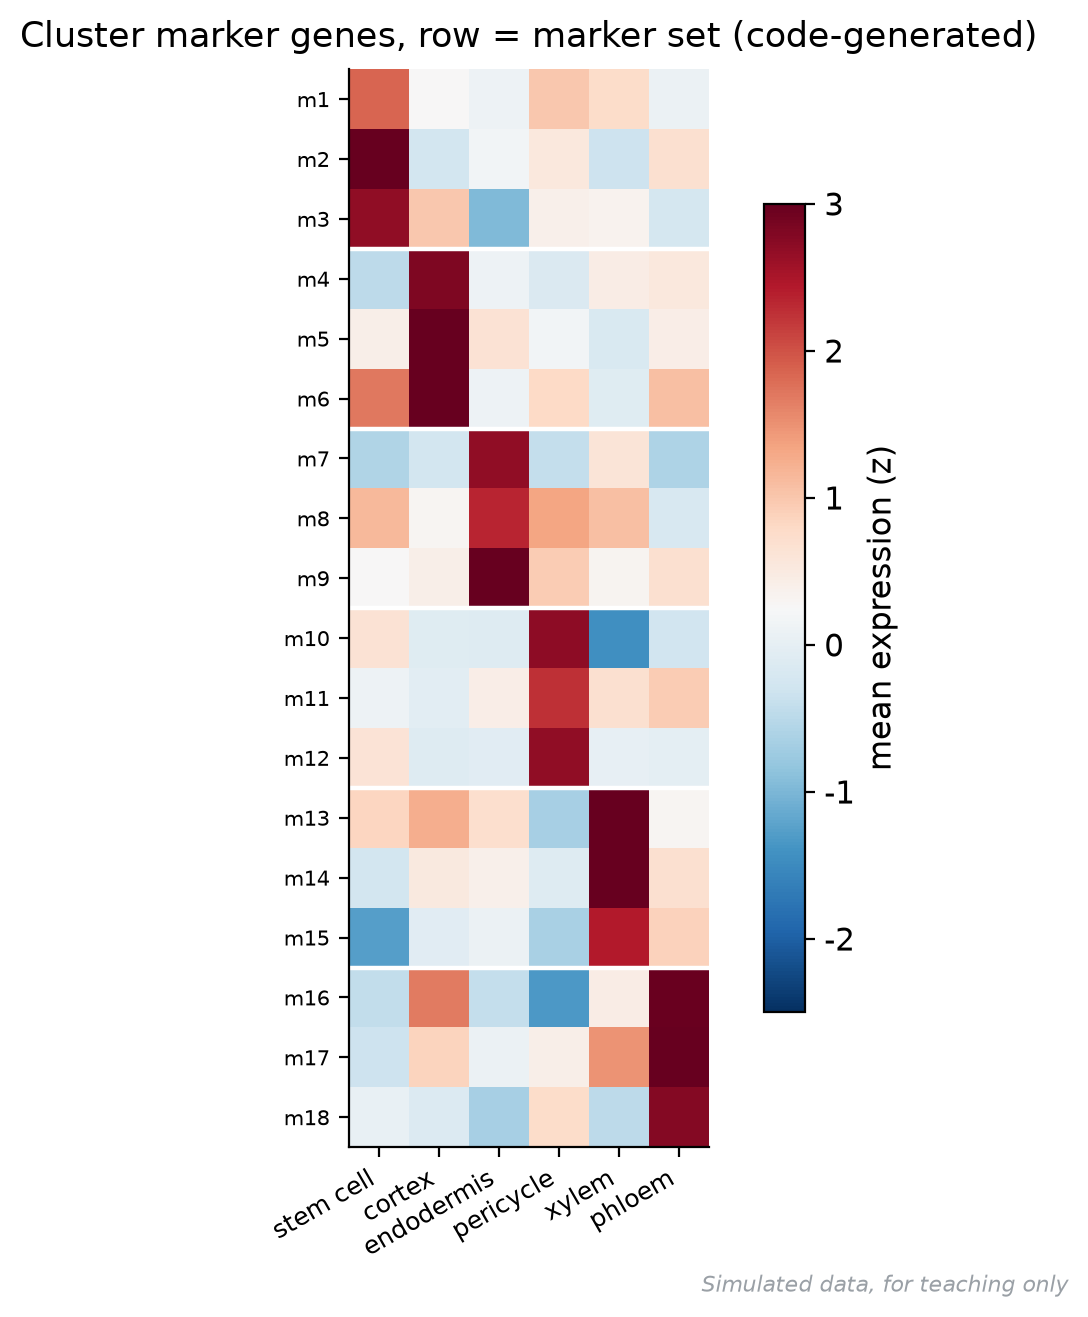
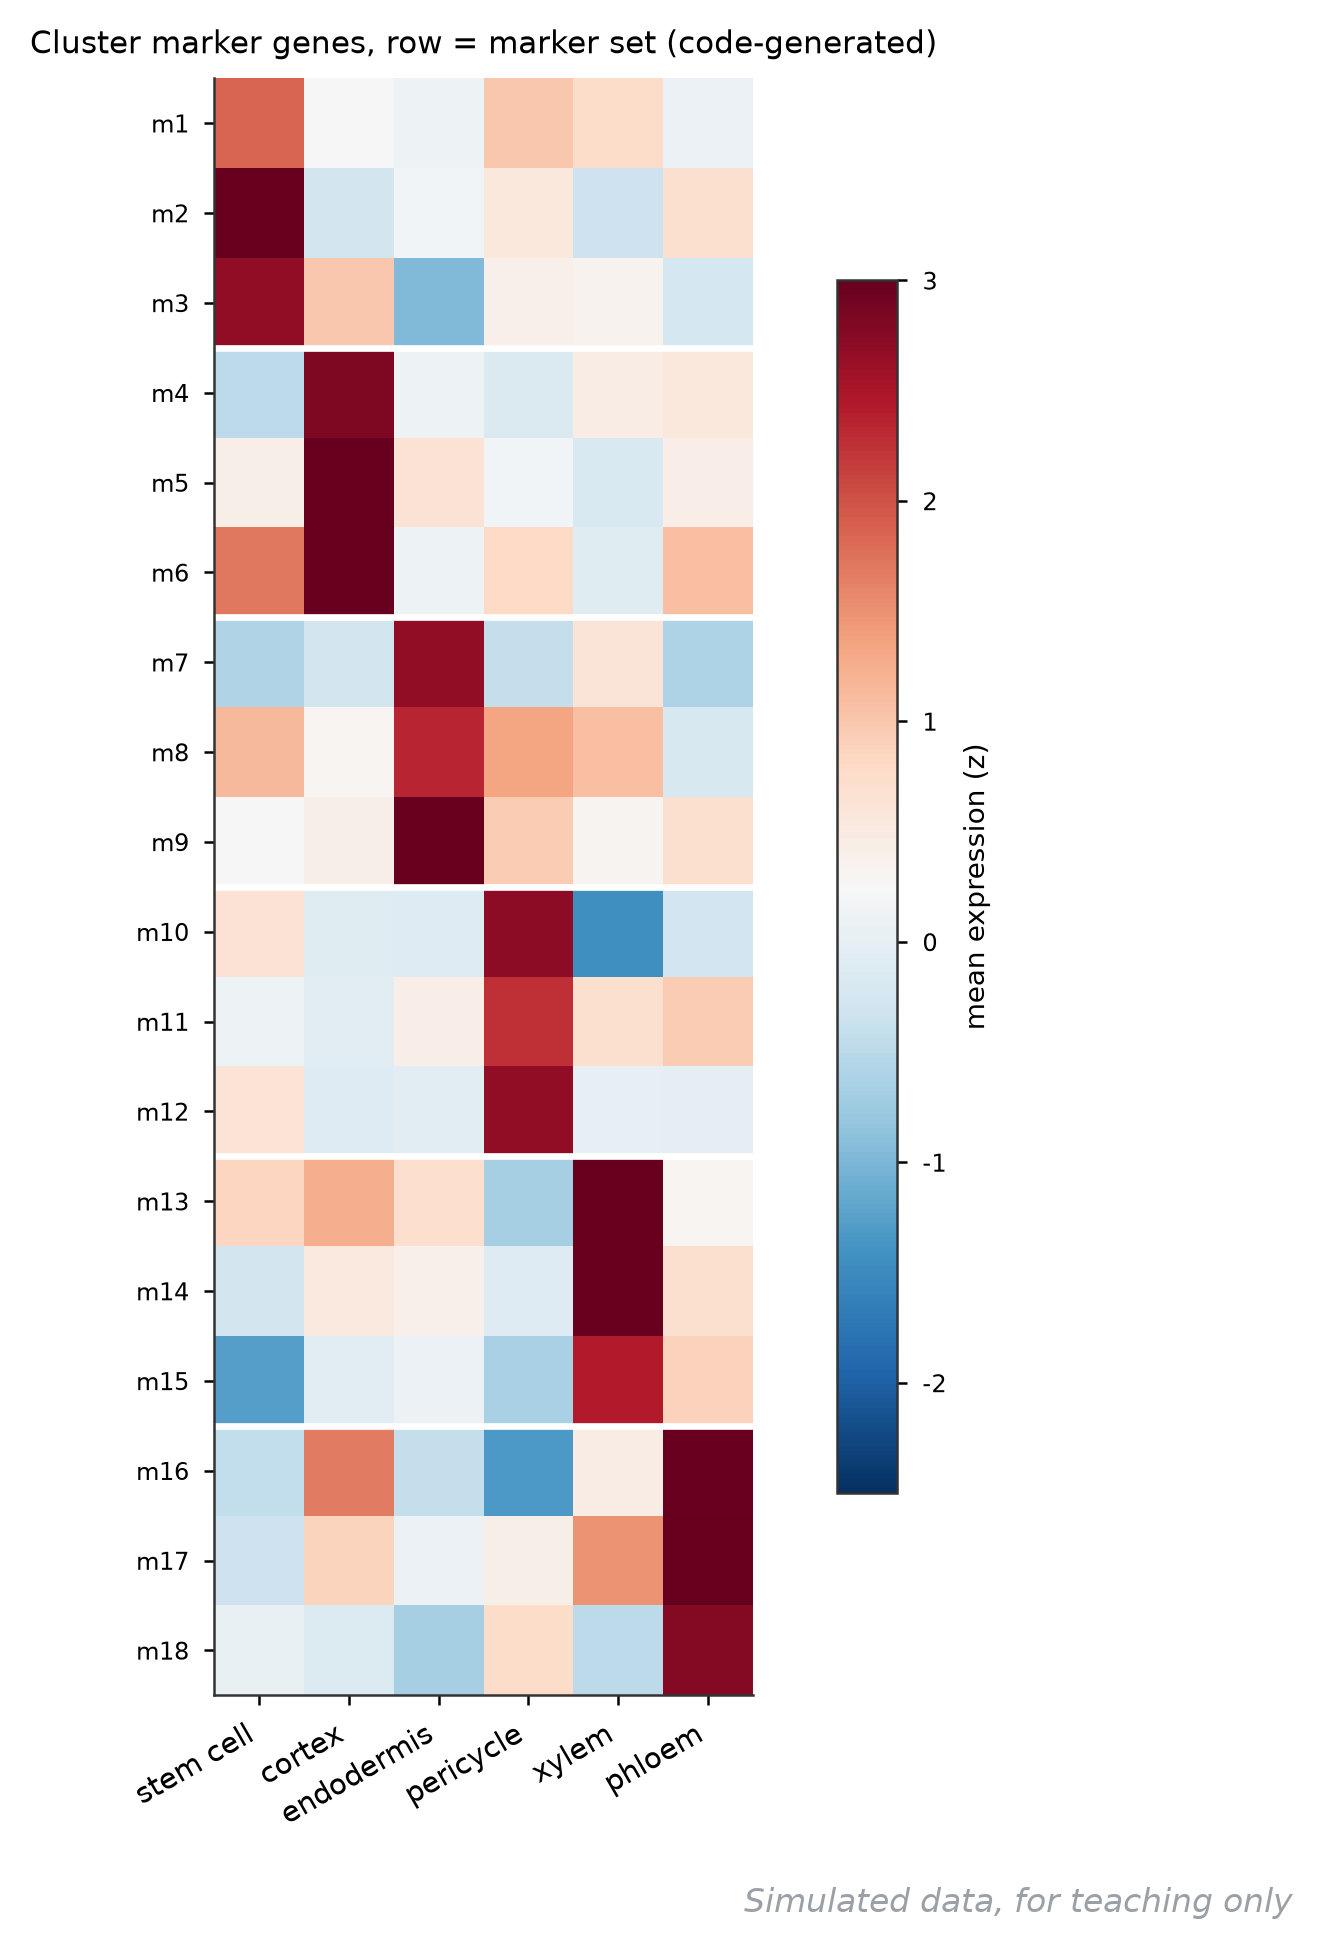
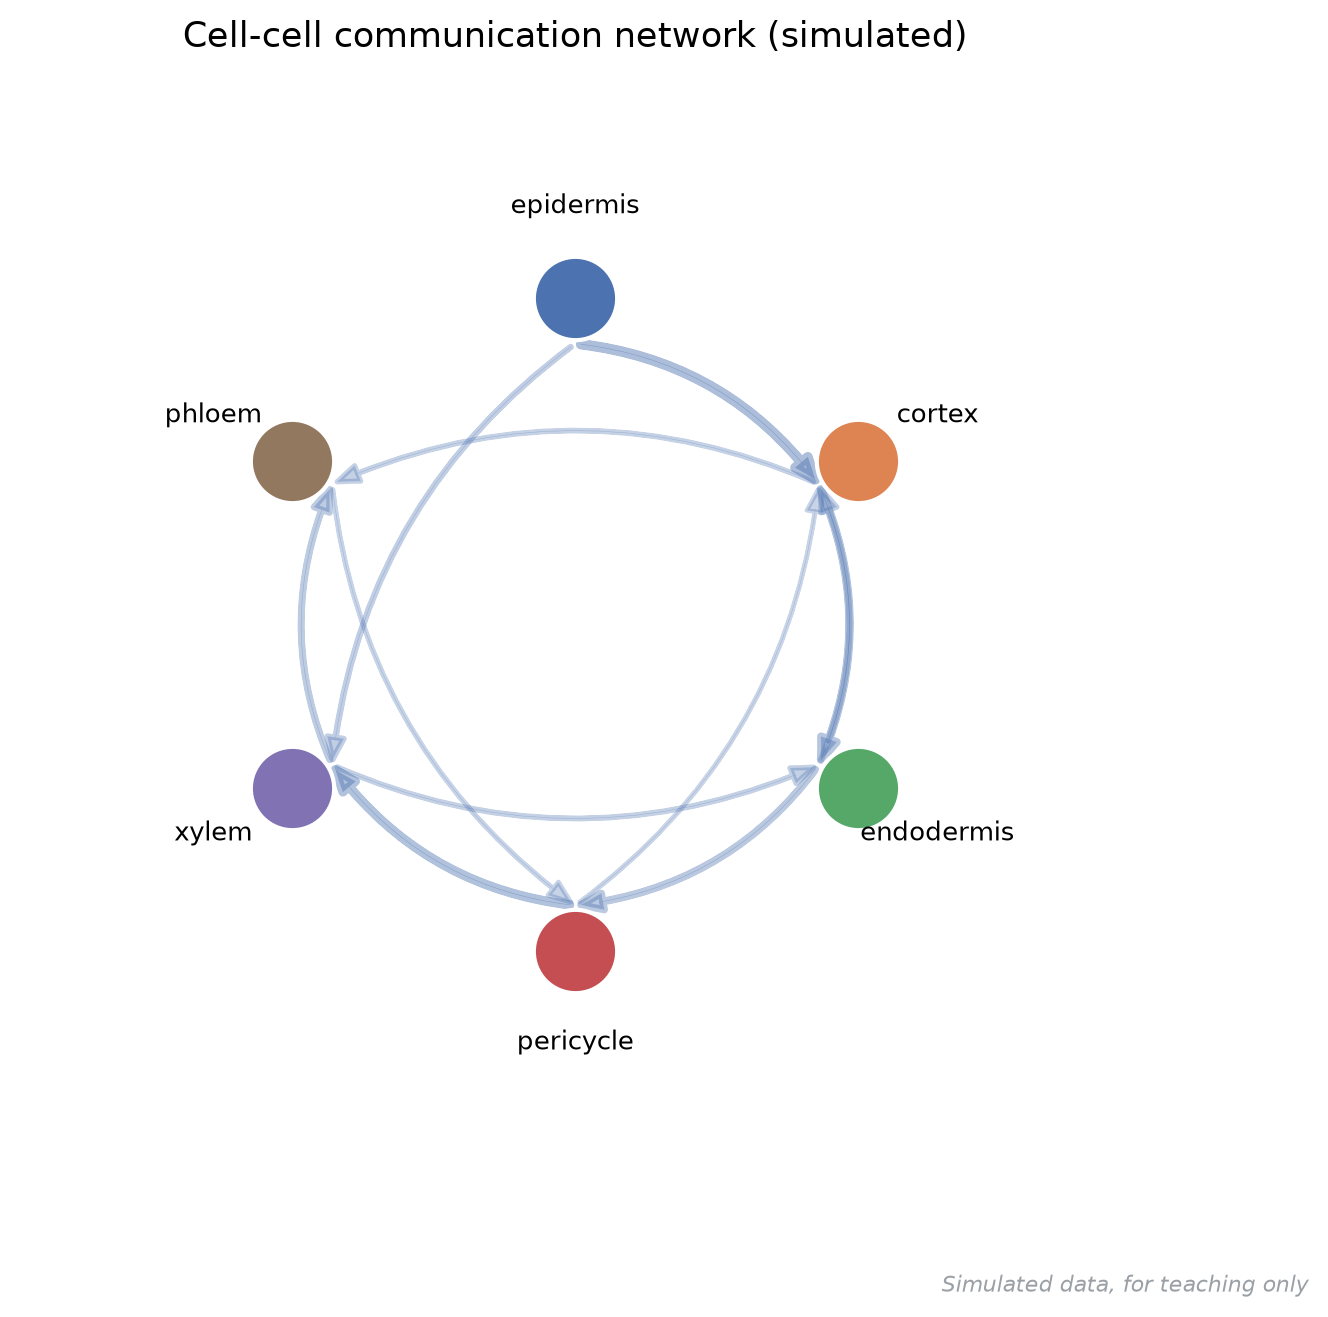
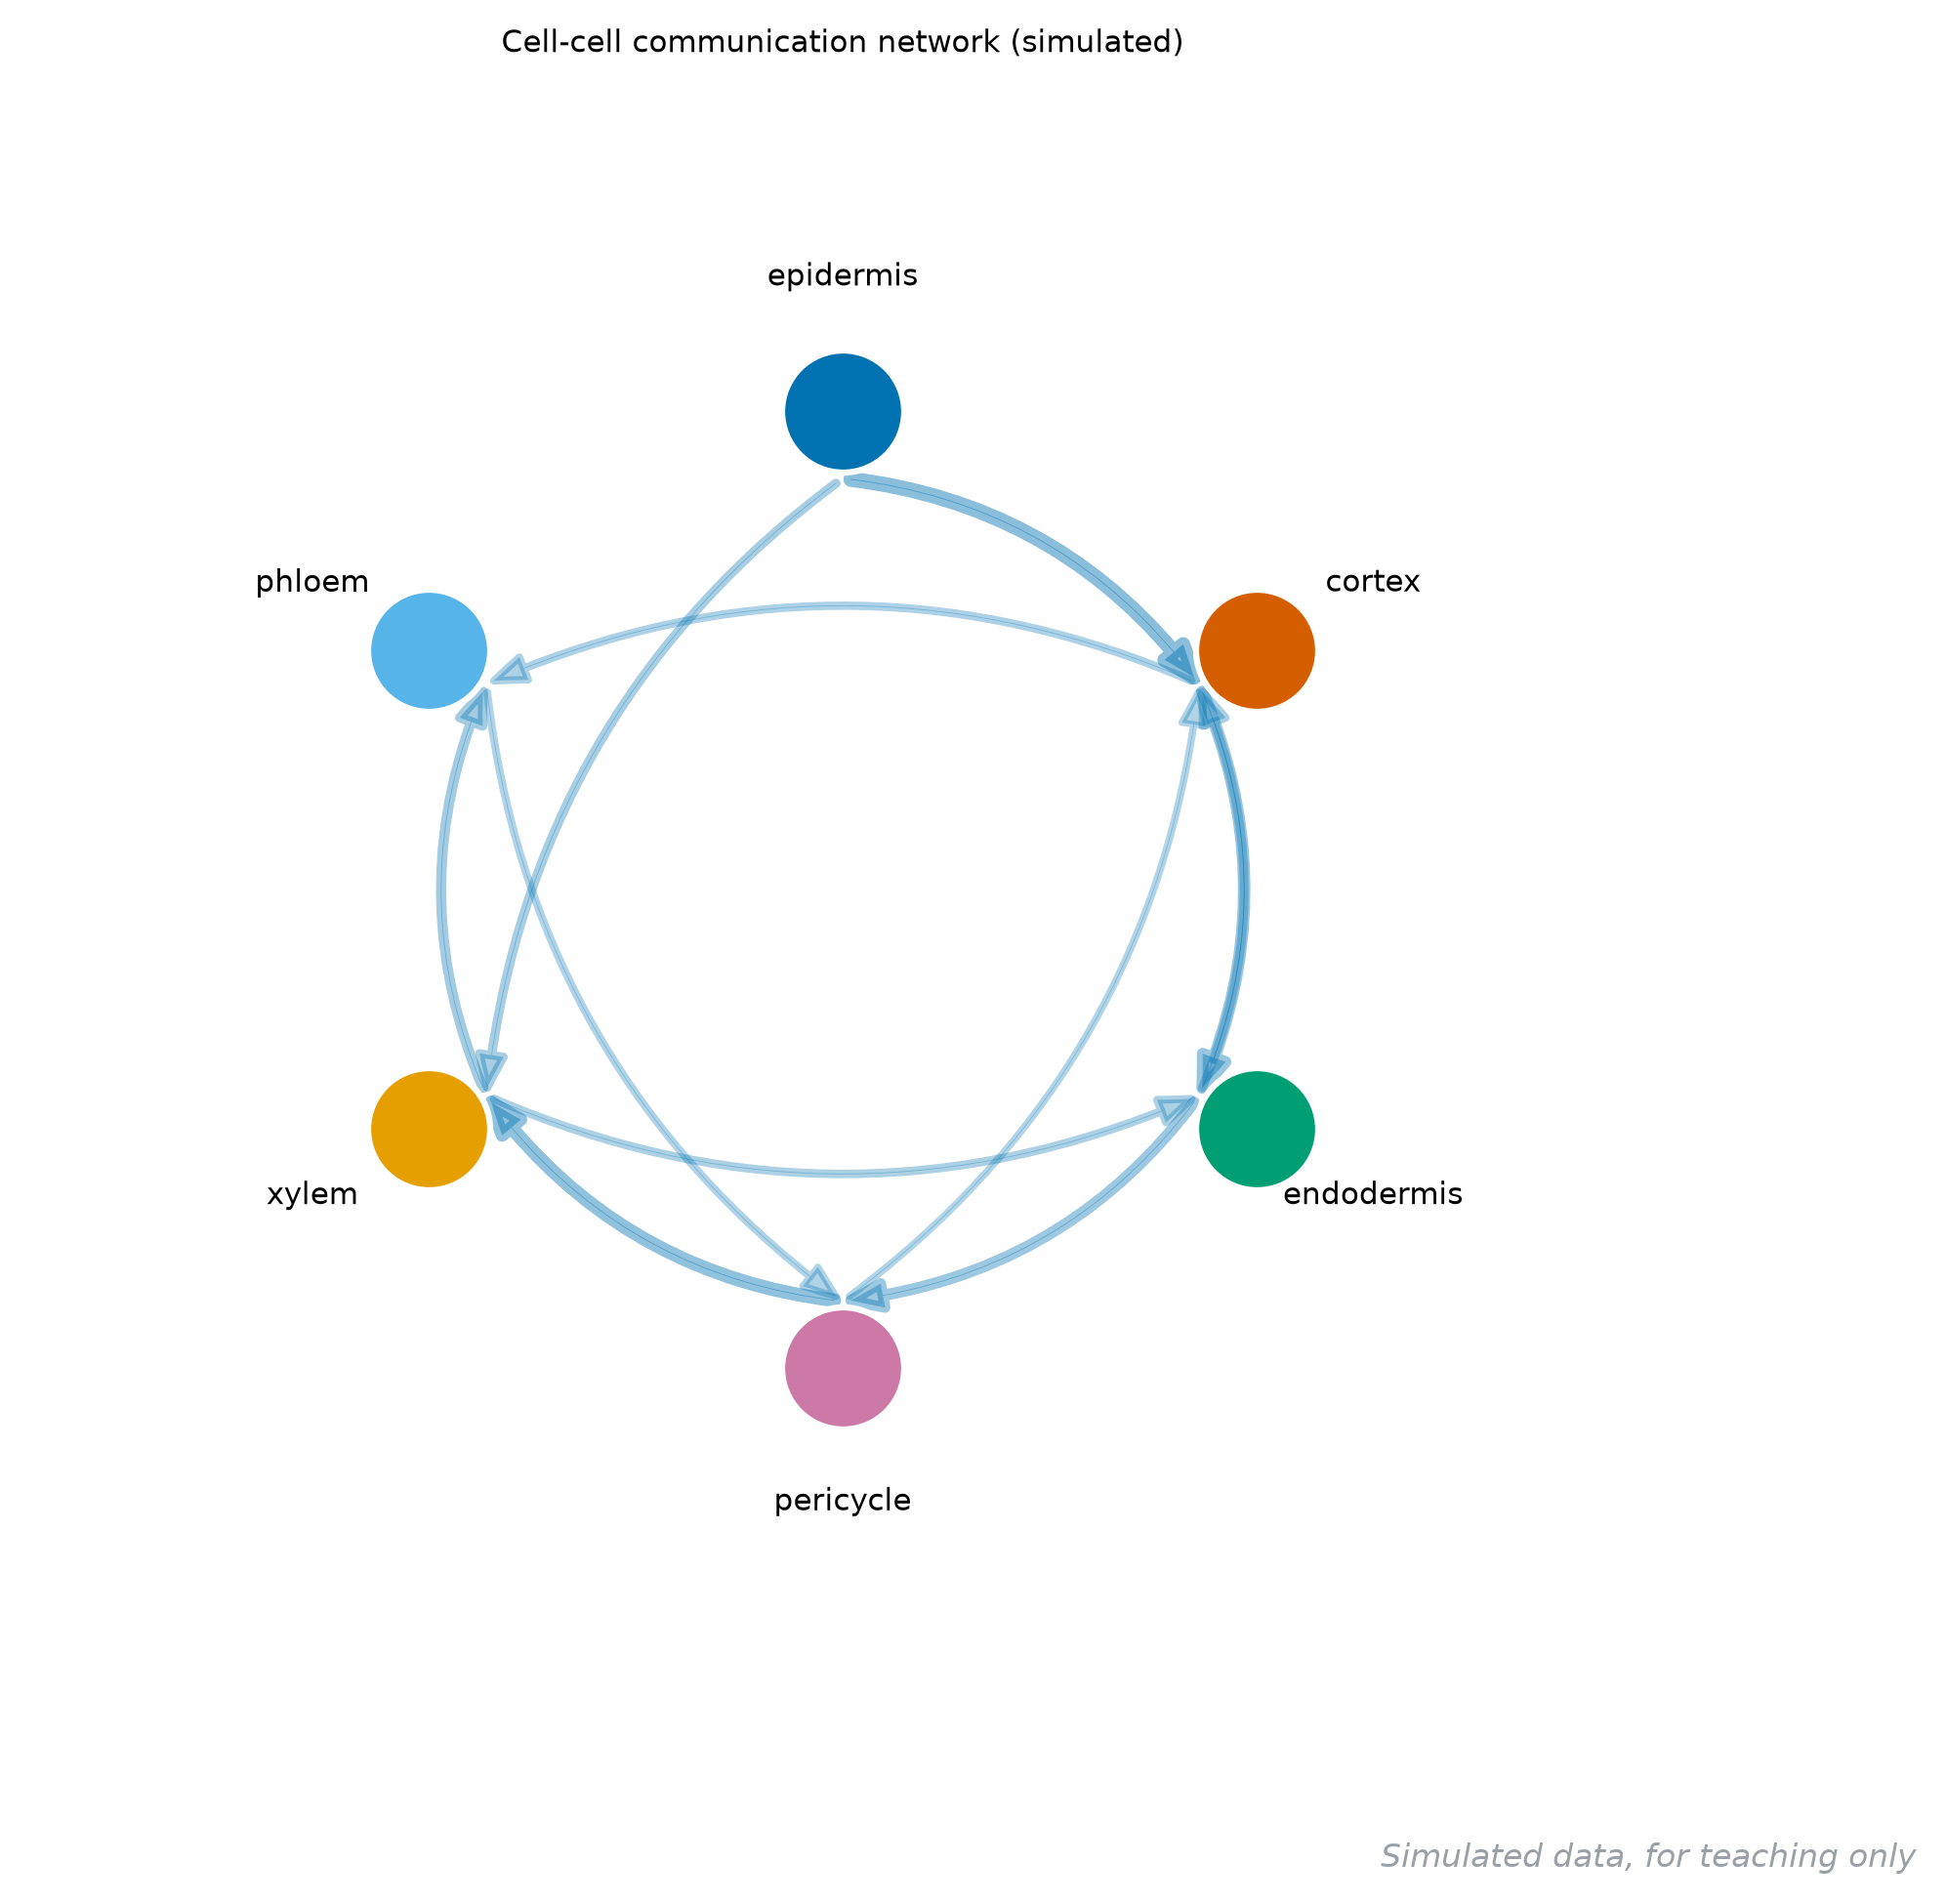
图 134 蛋白 Cα trace
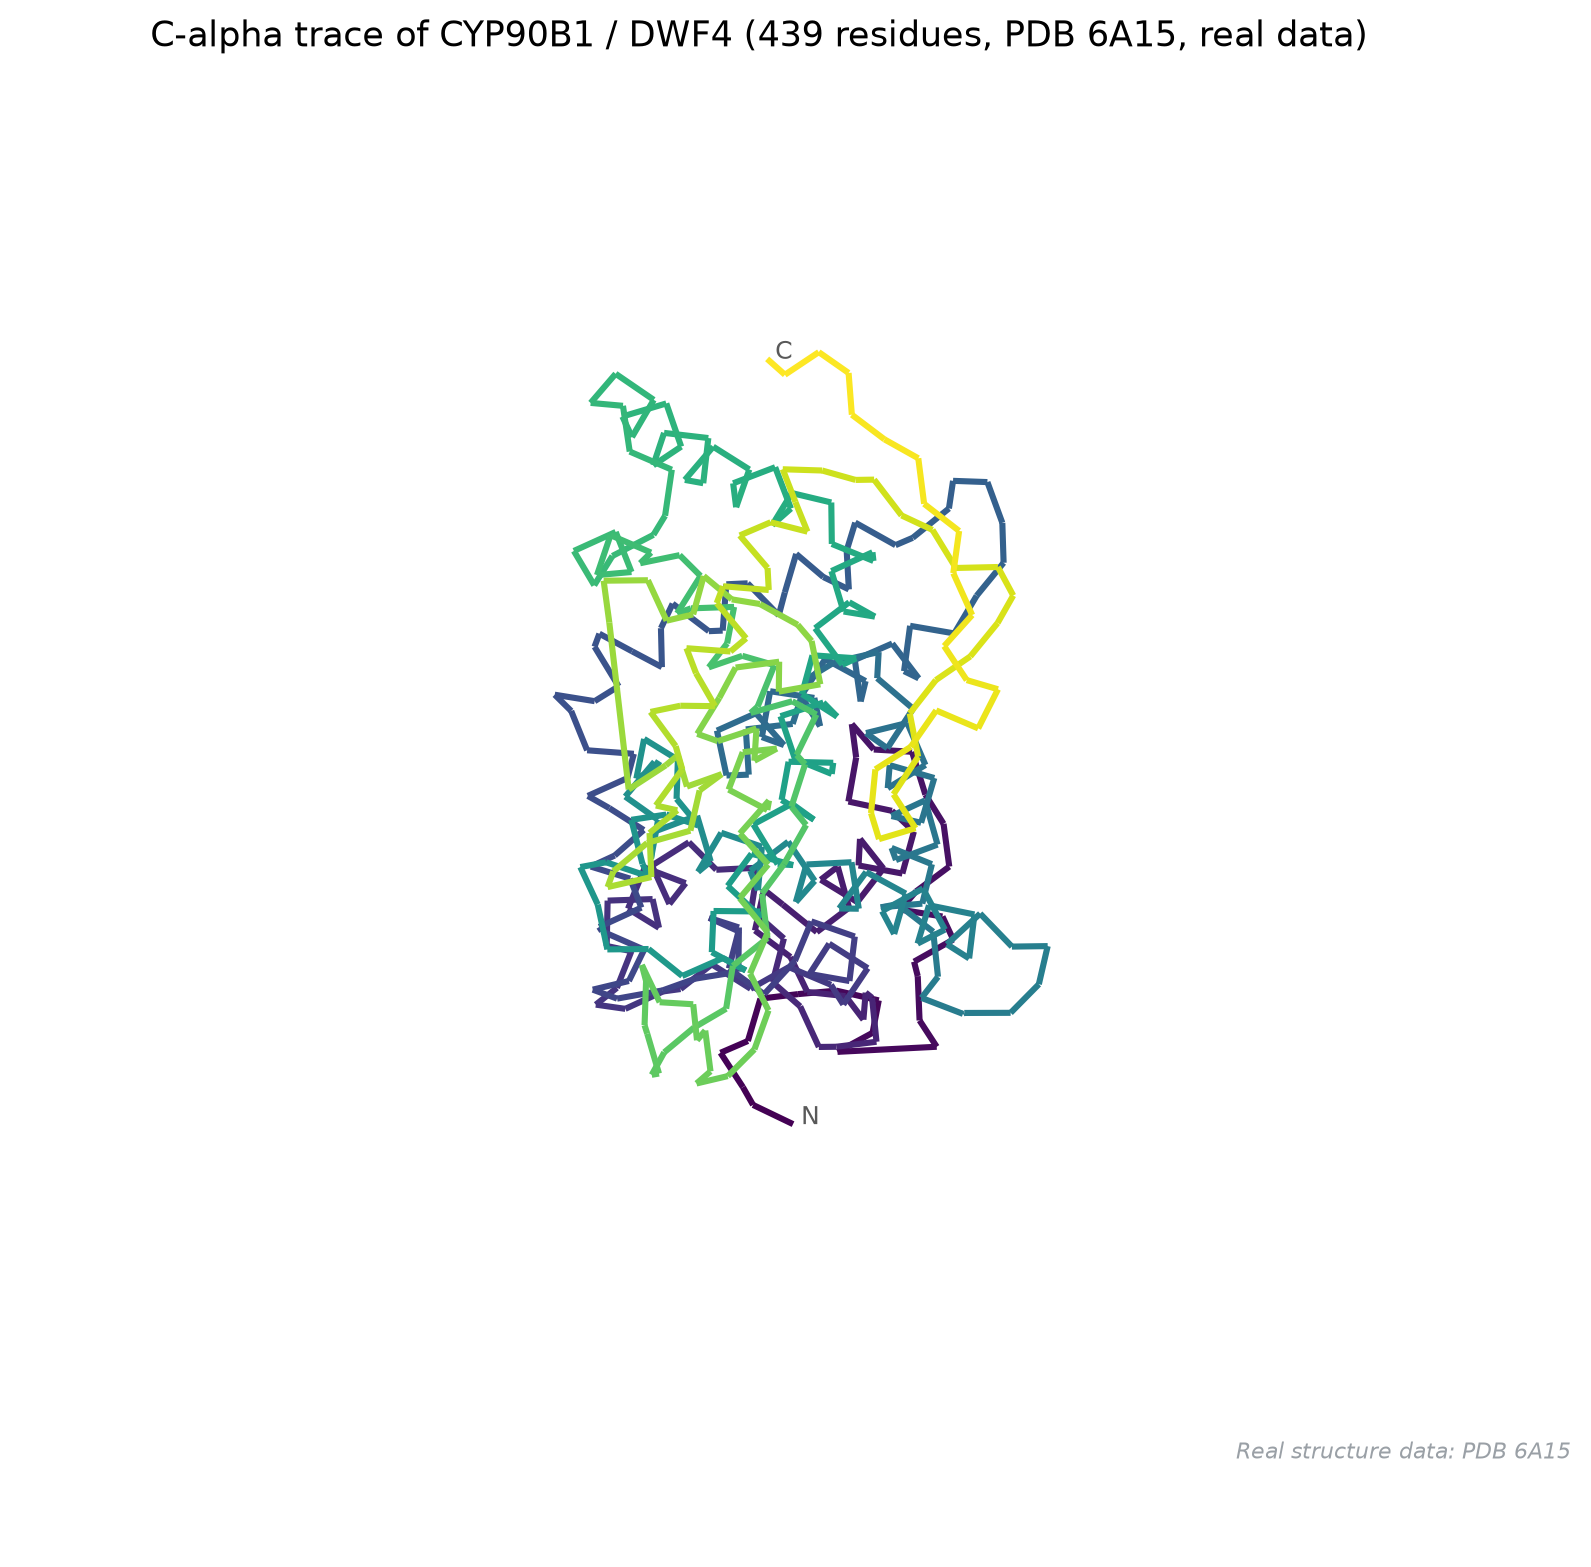
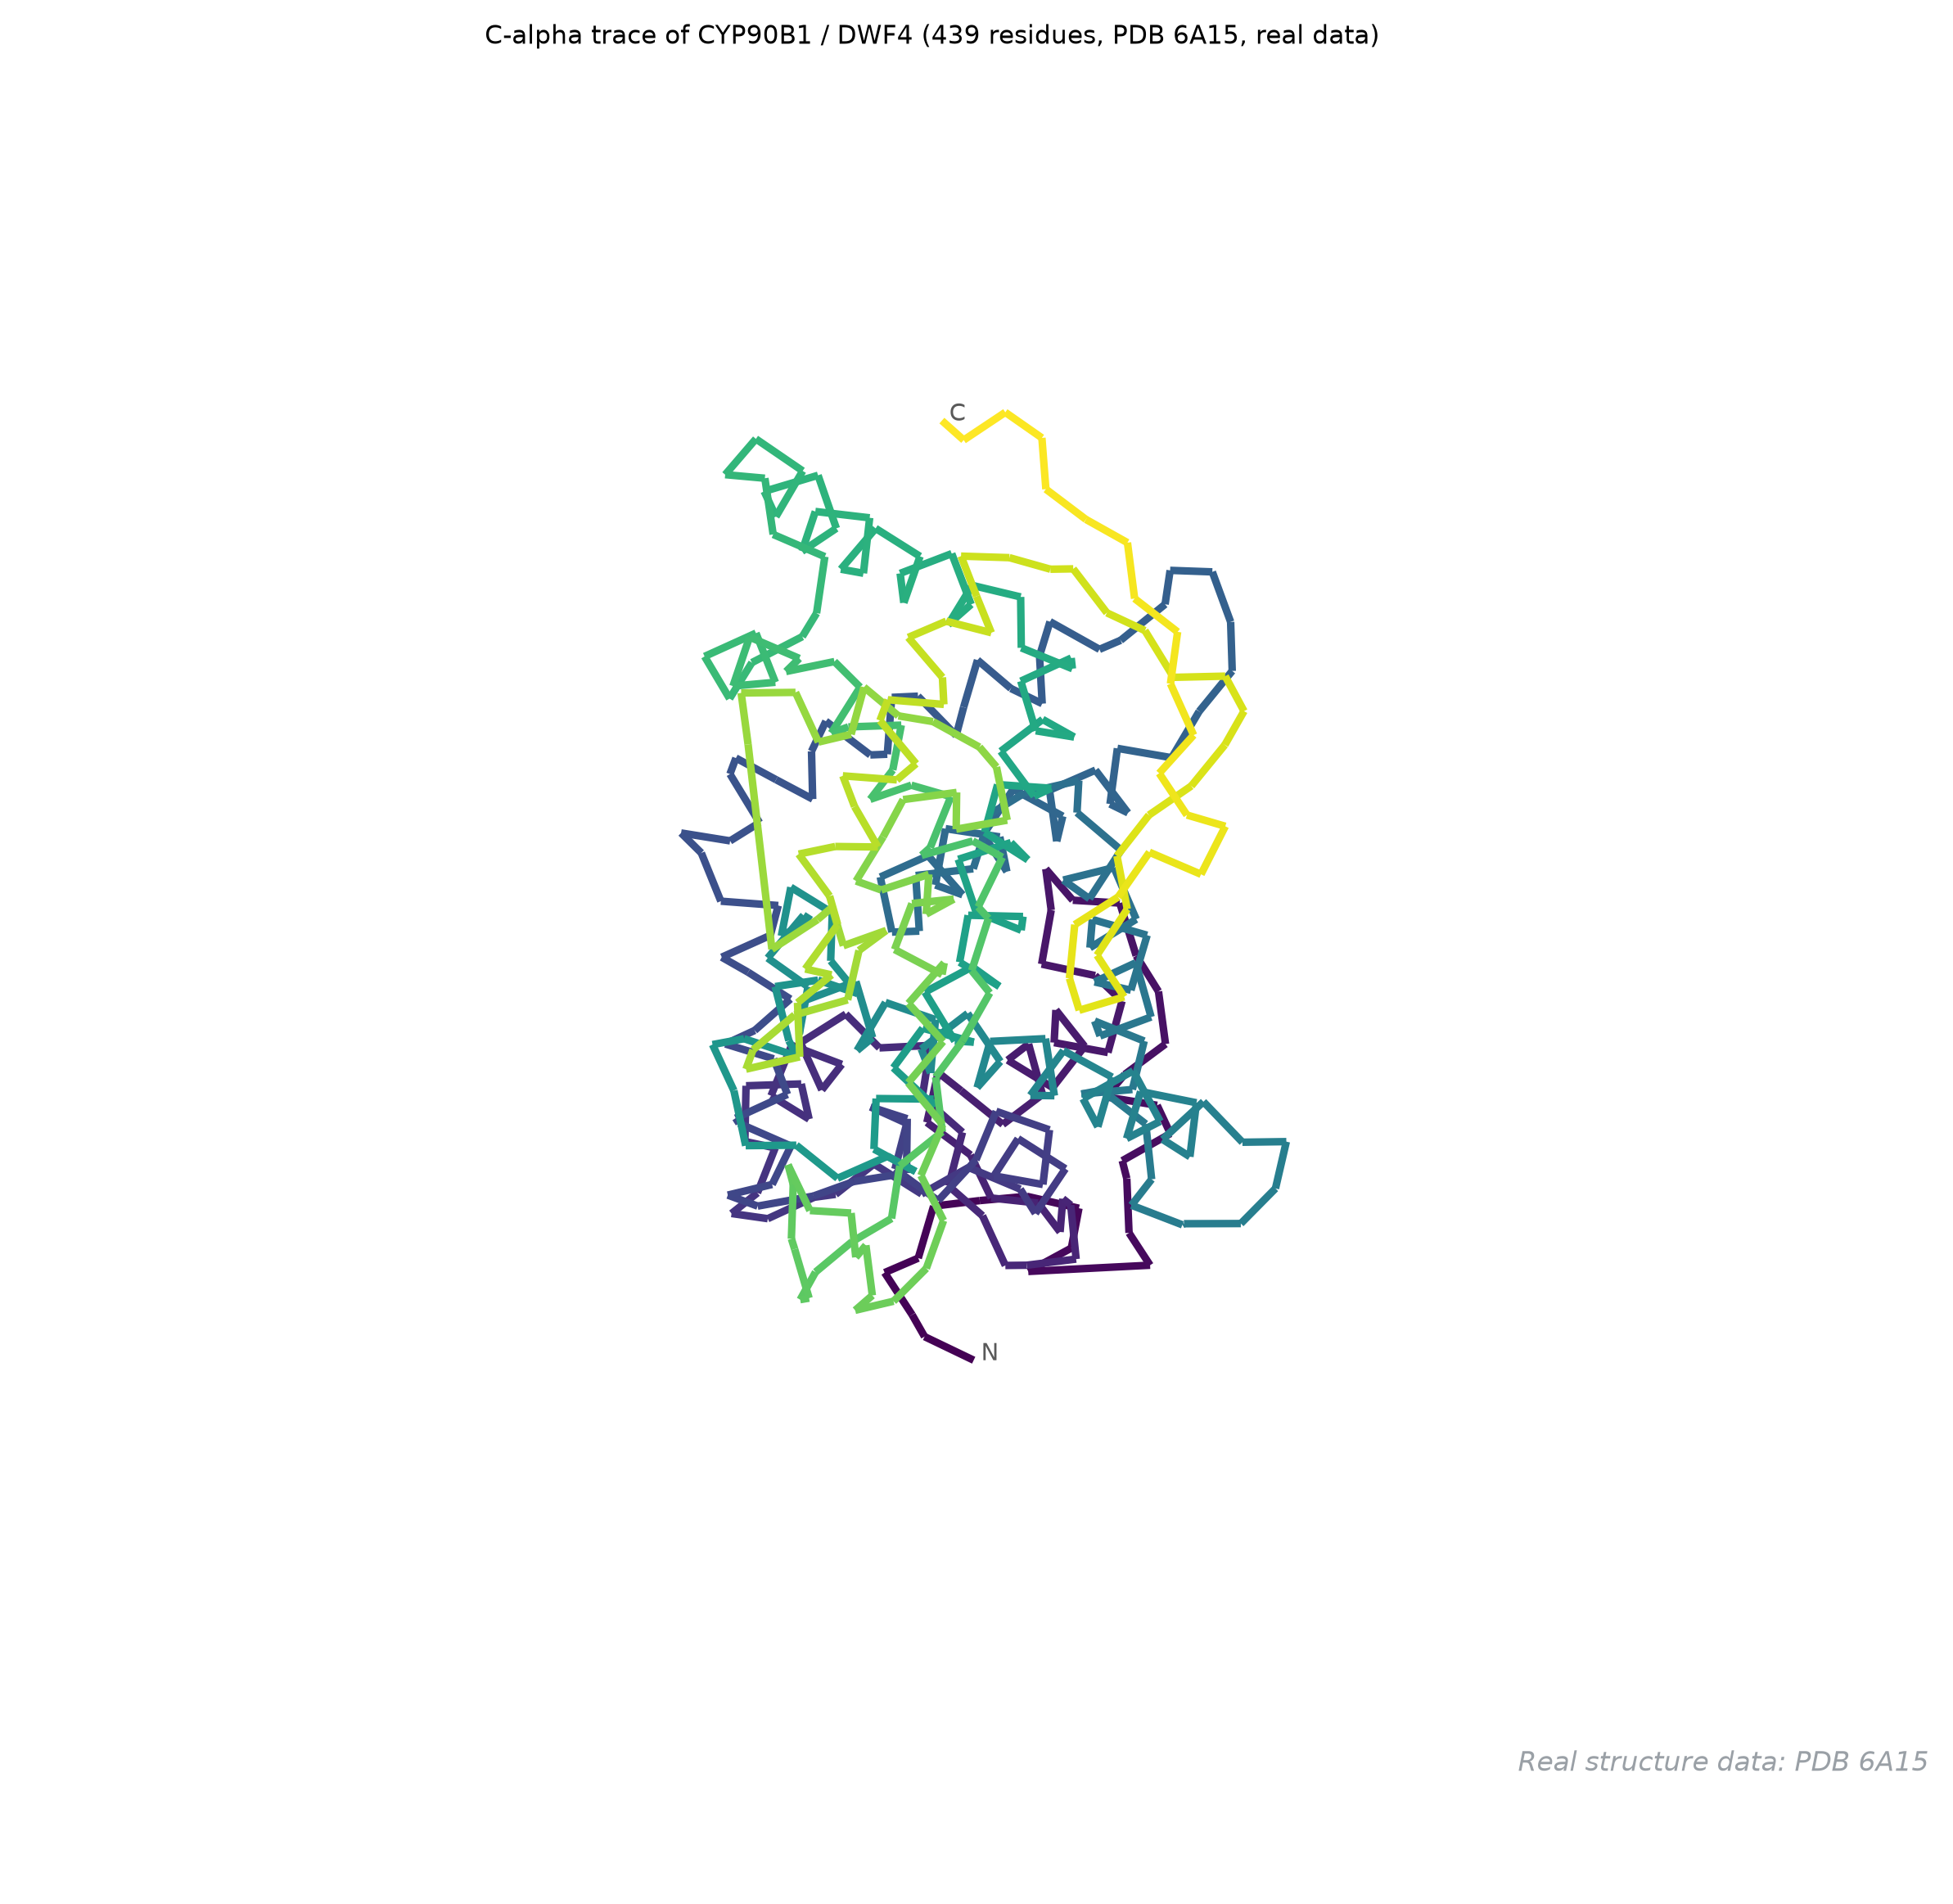
图 174 真实数据 PCA(第六篇)
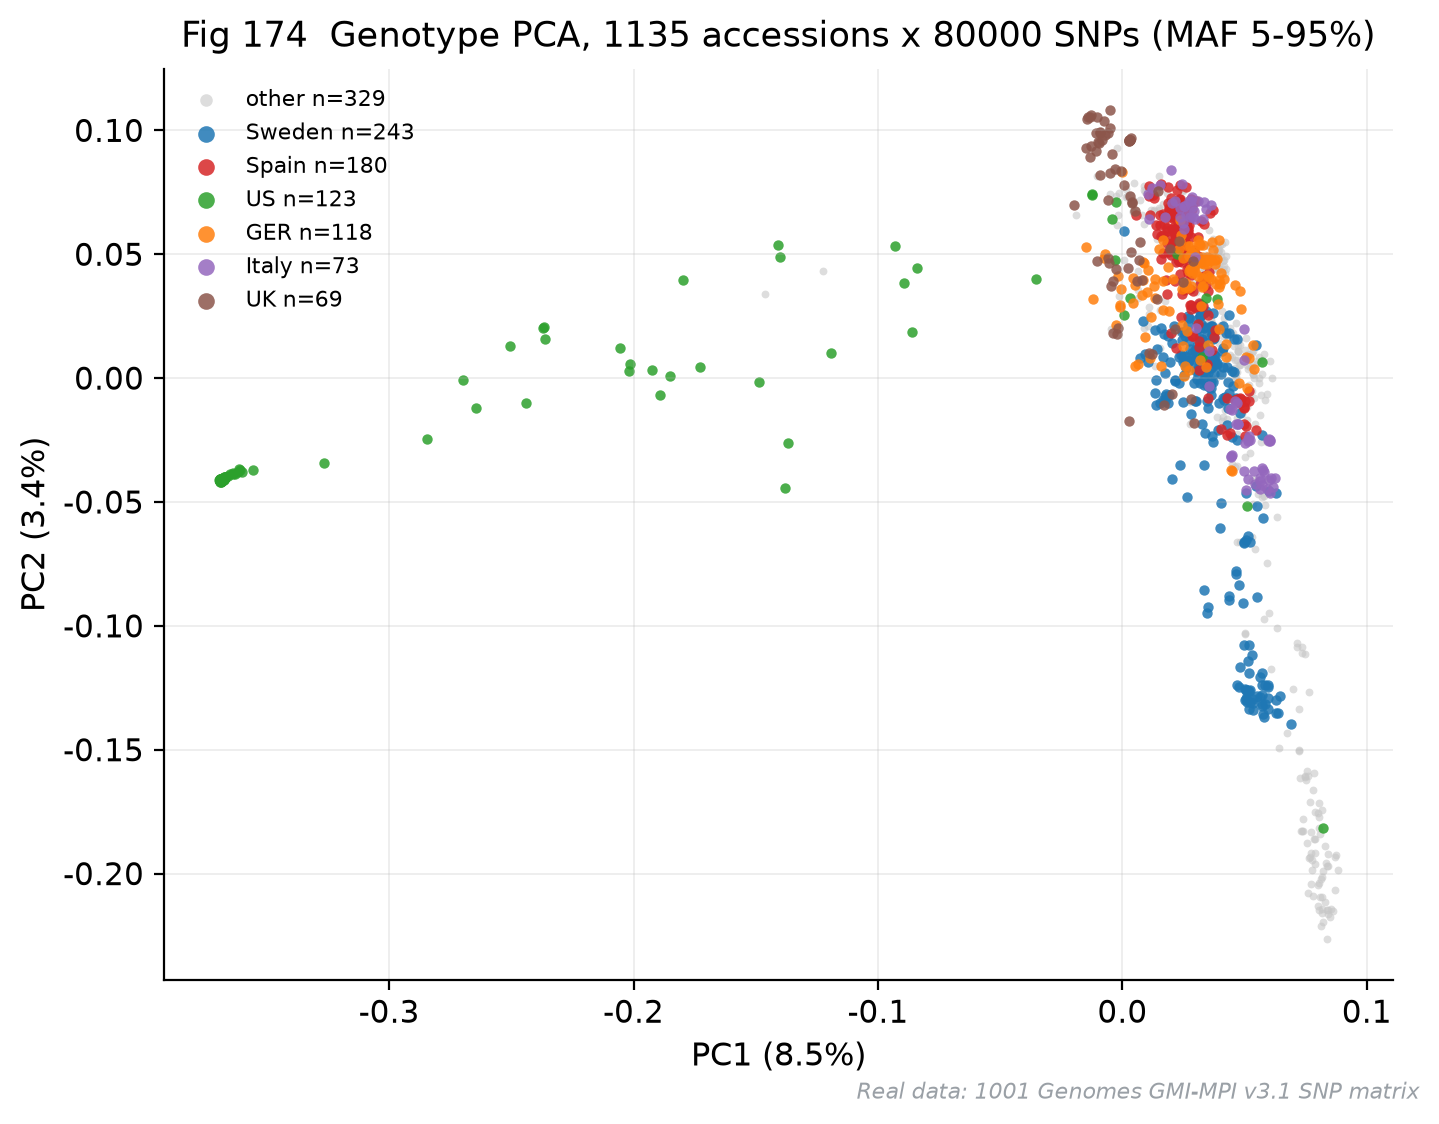
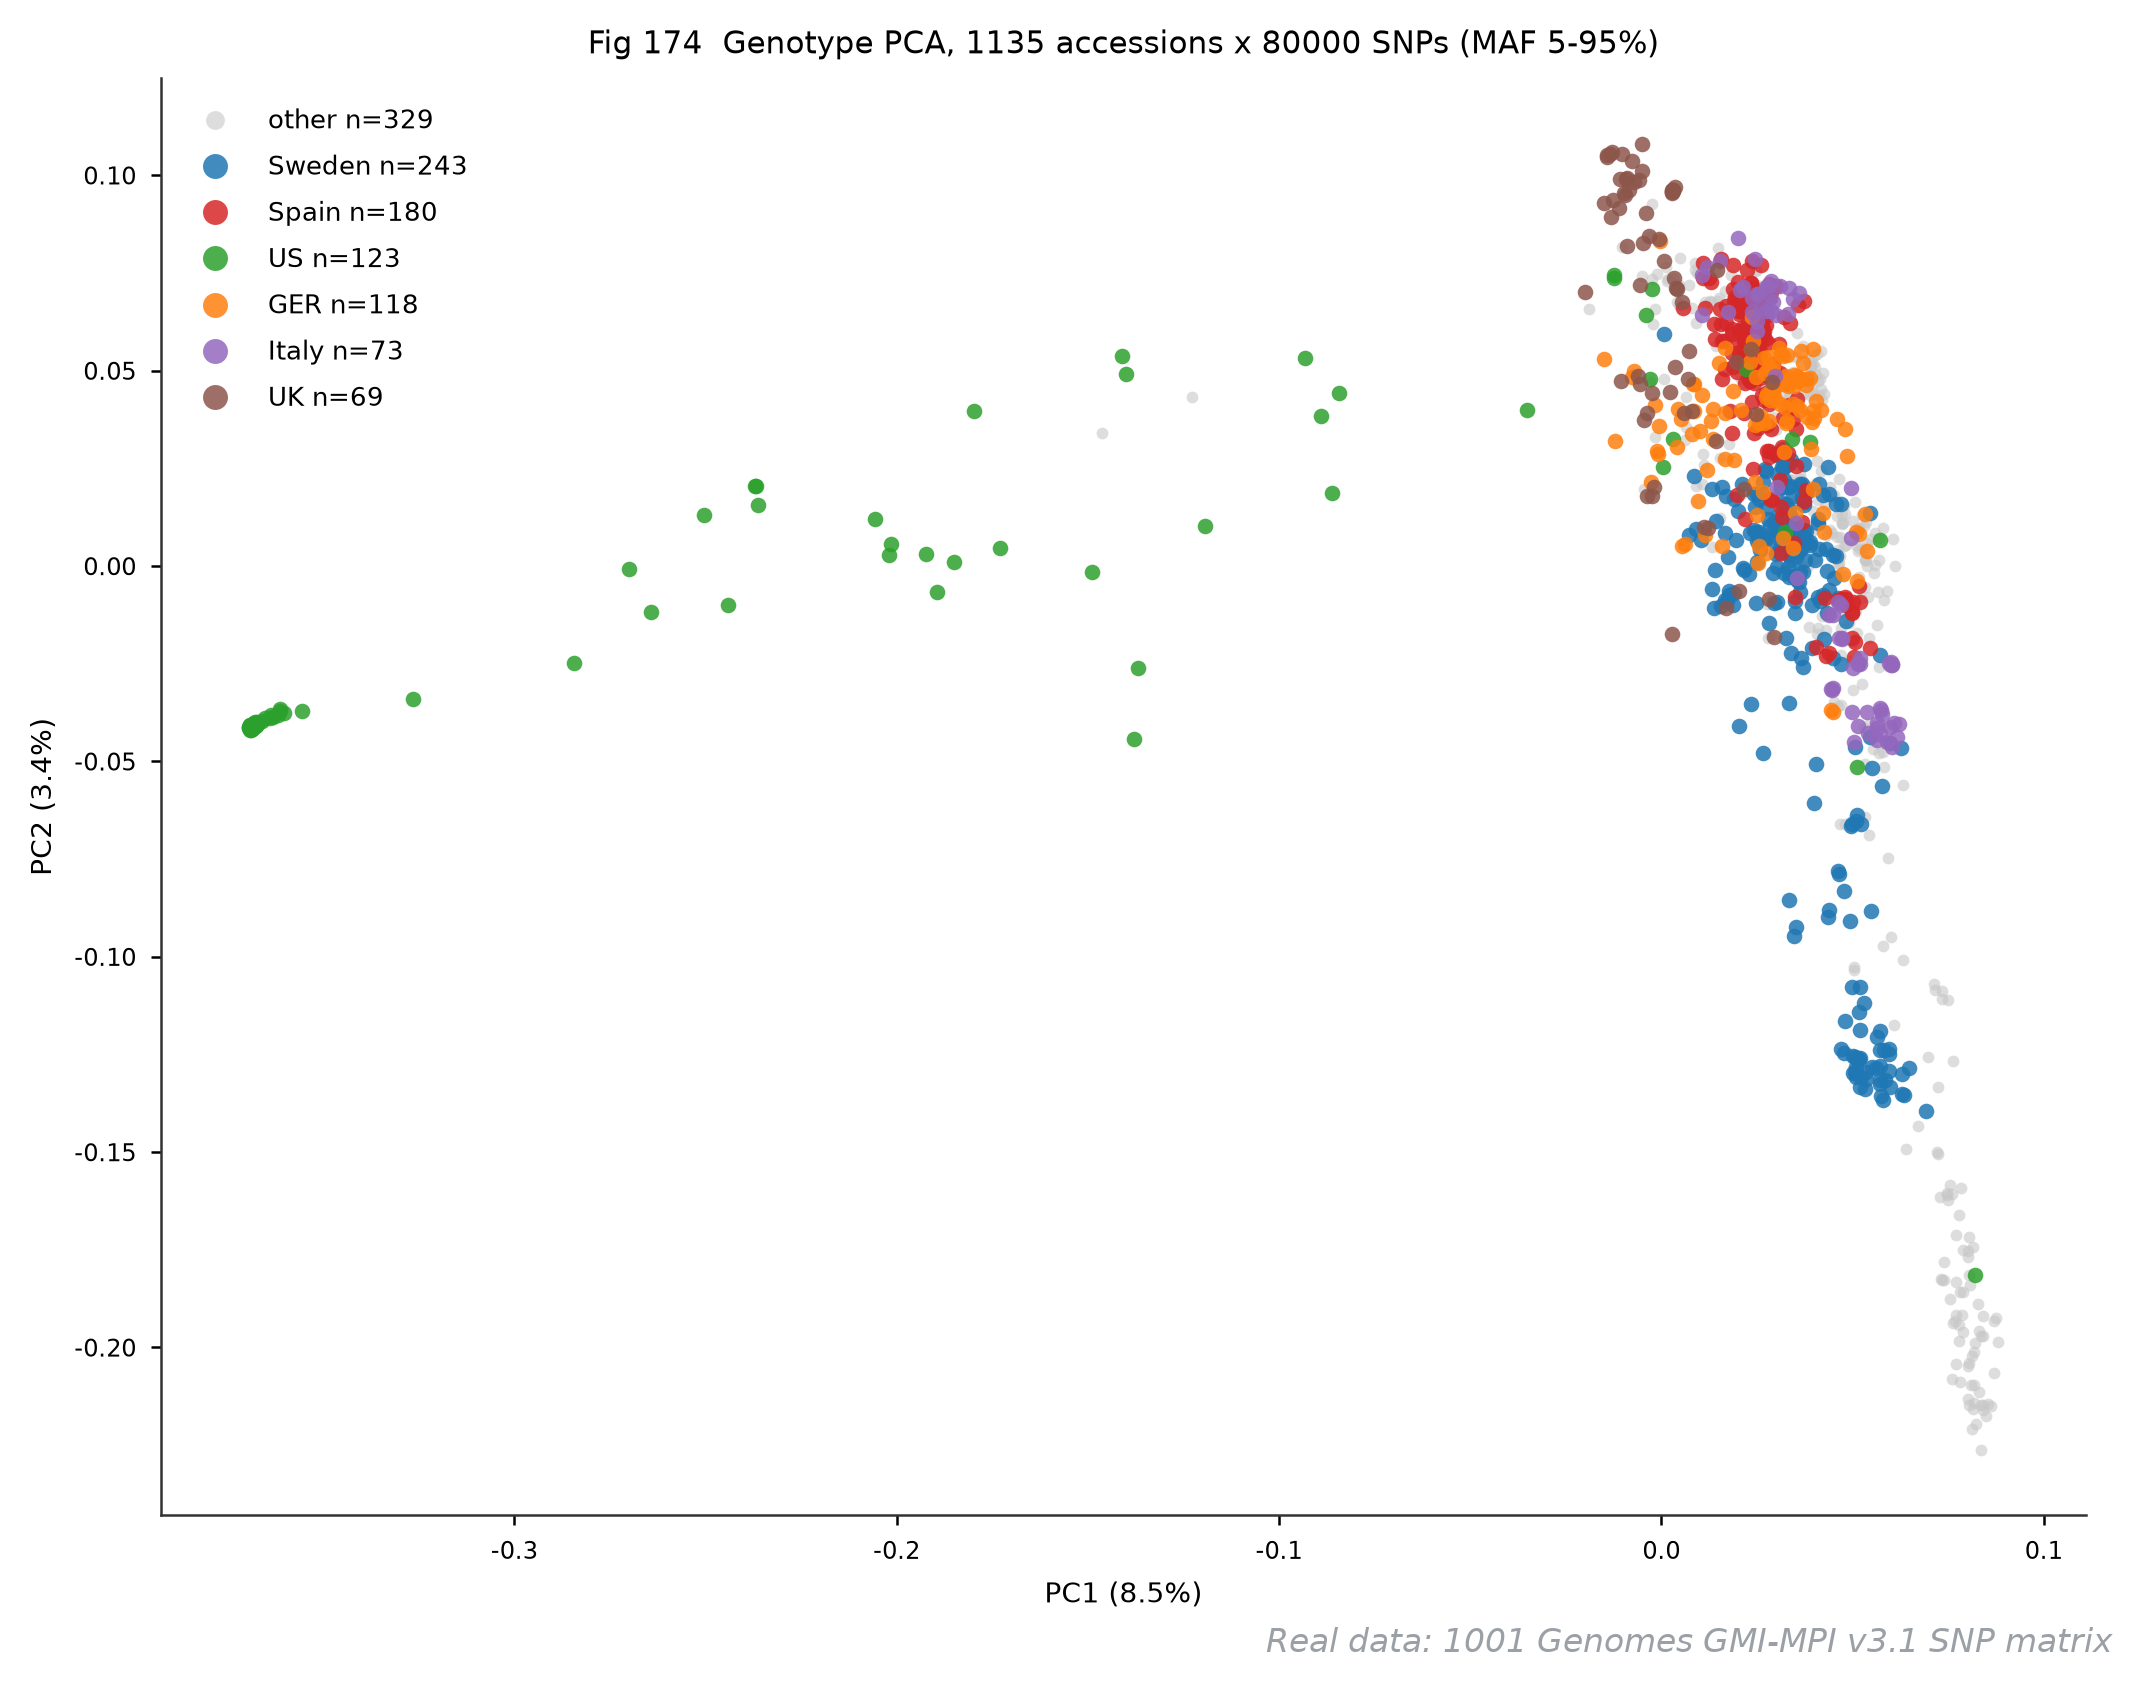
图 180 真实数据 Manhattan(第六篇)
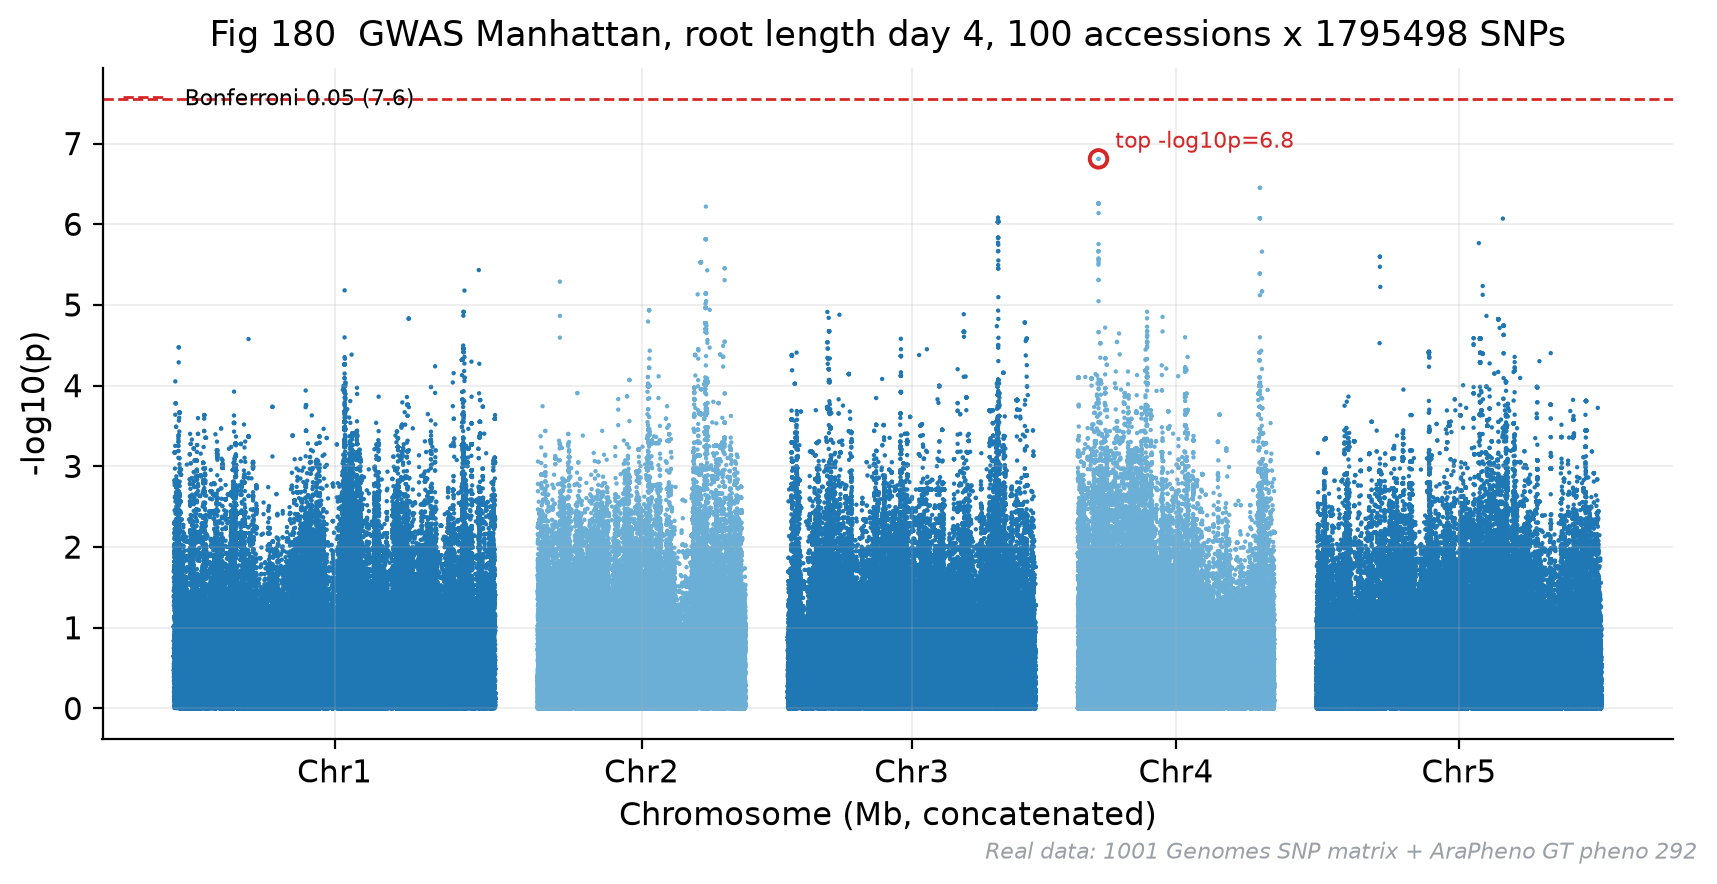
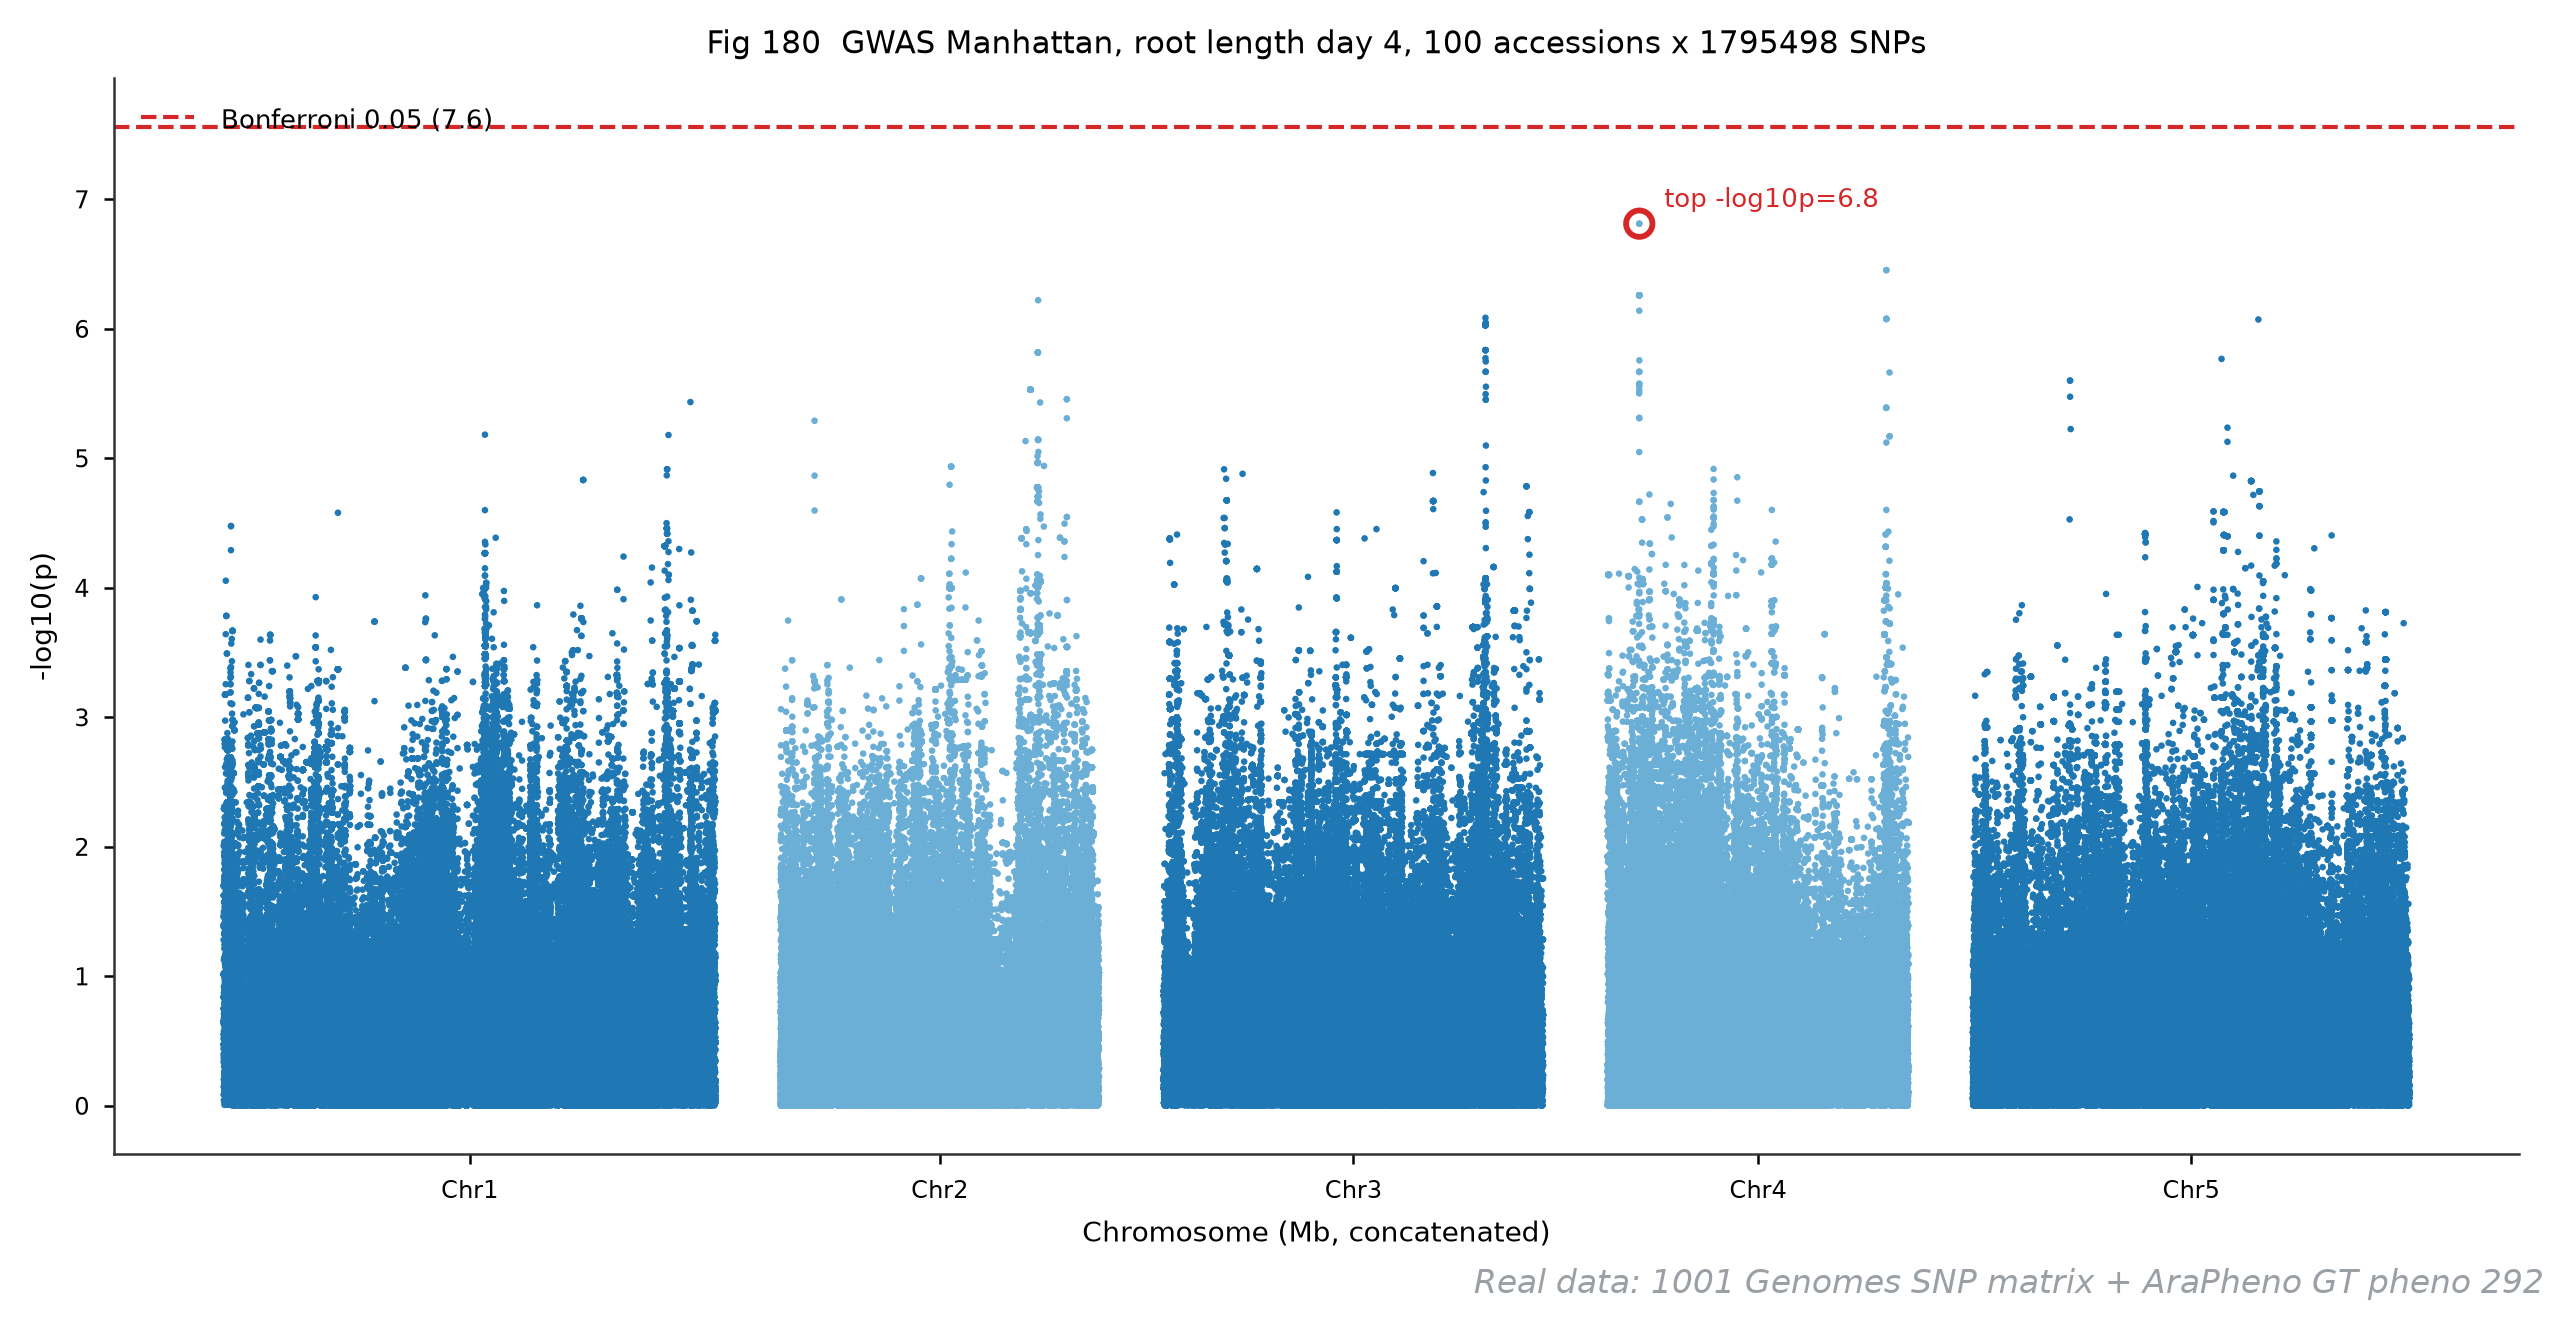
染色体交替色换成深浅双蓝(同色相、明度分离),比红绿交替更适合打印和色盲读者;Bonferroni 阈值线与 top SNP 标注不变。
五、方法选型:为什么这张图用这个方法
重画解决”好看”,这一章解决”该画什么”。逐图族过一遍:这份数据要回答什么问题、候选方法有哪几个、选的这条为什么、什么时候会失效。这也是审稿人问”为什么不用 XXX”时你该有的答案。
5.1 差异表达:为什么是负二项模型,为什么画火山图
RNA-seq counts 的方差随均值增长且过散(overdispersion),这排除了泊松(无过散参数)和在低 counts 小样本上失效的 Welch t 检验。三条主流路线:
| 方法 | 模型 | 适合 | 不适合 |
|---|---|---|---|
| DESeq2 | 负二项 + LFC 收缩 | 中小样本、常规两分组比较 | 样本量极大时偏保守 |
| edgeR | 负二项 + 精确检验/QL | 小样本、计数极端 | — |
| limma-voom | 均值-方差加权线性模型 | 大样本、复杂设计矩阵 | 极低 counts 稳健性差 |
本系列教学图(图 1)用模拟 TPM + t 检验演示原理,正文明说真实分析应回到 counts + DESeq2。选 DESeq2 的核心理由是 LFC 收缩:基因表达量越低,log2FC 的抽样噪声越大,不收缩的火山图会孤出一串”低均值假大效应”点。展示层选火山图(图 1)而不是 MA 图,因为 volcano 同屏编码效应量(x)与显著性(y)两个维度,筛基因直观;MA 图的优势是暴露”效应随均值漂移”的系统性偏差——两图回答的问题不同,不是互相替代。
5.2 降维:群体结构用 PCA,单细胞用 UMAP,不是口味问题
| 方法 | 保什么 | 距离含义 | 超参 | 失效场景 |
|---|---|---|---|---|
| PCA | 全局线性方差 | 线性距离,loadings 可回查基因 | 无 | 非线性流形结构 |
| t-SNE | 局部邻域 | 簇间距离无意义 | perplexity 敏感 | 大数据慢、无 out-of-sample |
| UMAP | 局部邻域+部分全局 | 簇间距离仍不可靠 | n_neighbors/距离 | 同上 |
图 12/174/184 用 PCA:群体结构是等位基因频率的线性梯度,PCA 的 PC1/PC2 方差占比本身就是可报告量(图 174 的 8.5%/3.4%),loadings 能回查”是哪些 SNP 撑起了这个轴”,且无超参意味着可复现。图 13 用 UMAP:36 个单细胞群的分群可视化需要保留局部邻域、把非线性流形摊开,代价是坐标轴只有相对意义——所以图注明确写了”坐标为任意单位,仅反映相对邻域关系”。如果给群体结构上 UMAP:轴不可解释、方差占比消失、审稿人要求换回 PCA。如果给单细胞上 PCA:前两个 PC 往往只解释百分之几的方差,分群被技术噪声淹没。 图 192 的真实 vs 模拟对照用同一套 PCA 管线,则是为了保证两侧可比——比较实验里,方法本身就是变量。
5.3 富集分析:有无阈值决定 ORA 还是 GSEA
输入形态决定方法:手握一份”显著差异基因列表”(有阈值切过的),用超几何检验的 ORA(图 17 KEGG 条形);只有全转录组的排序指标(无干净阈值,或效应都小而协调),用 GSEA(图 19,排序指标从头走到尾)。ORA 会丢掉”每个基因都涨 15%、没有一个过线”的协调信号——这正是 GSEA 的设计动机,图 19 的 ES=0.92 峰值就是这种信号。展示层:条形(图 17)适合 5-10 条通路比数量;弦图(图 18)适合展示”一个基因注释多条通路”的多对多关系——同一数据画条形会丢掉连接信息,画弦图则读不出富集倍数。
5.4 集合交集:三个以内画 Venn,四个以上画 upSet
Venn 图的圆面积不编码任何数值,且四集合以上图形迅速不可读(图 8、9 停在三集合)。图 10 的四组学交集用 upSet:按交集大小降序排柱,成员矩阵一行一个集合,可扩展到十几个集合不失真。反过来两个集合画 upSet 则是杀鸡用牛刀——韦恩图一眼看穿的包含关系,upSet 要读矩阵。
5.5 生存与诊断:KM 展示、Cox 建模;平衡数据看 ROC、不平衡看 PR
图 21 用 Kaplan-Meier + log-rank:无参数、直接可视化单因子的生存差异,但它处理不了协变量和混杂——多变量归 Cox 比例风险模型(给 HR 和置信区间)。图 20(ROC,AUC 0.98/0.81/0.47)与图 67(PR)的分工:两类样本量接近时 ROC 的 FPR 稳定可用;患病率/阳性率 1% 量级的场景,FPR 的分母巨大,ROC 会过度乐观,PR 曲线才敏感——临床筛查类问题必须看 PR。
5.6 相关性:两个系数一起报,先热图后网络
图 4 与图 5 并排放 Pearson 和 Spearman:前者测线性关系、对离群点敏感;后者只要求单调、对数变换后的关系也能抓住。单报一个都有隐藏假设,并排一出,单调非线性那组点立刻现形(图 5 的设计动机)。总览 12 个基因两两相关,相关热图(图 3)O(n²) 全景最直接;要在上百个节点里找模块,阈值切边的网络图(图 61)才读得动——WGCNA(图 62)本质是”相关→软阈值邻接→模块”的系统化版本,用软阈值避免了硬切边的信息丢失。
5.7 群体结构:PCA 看梯度、ADMIXTURE 看成分、树看离散分支
三个方法对”群体结构”给出三种模型化:PCA 无模型,展示连续梯度(适合渐变/混合群体);ADMIXTURE(图 45)有模型,把个体拆成 K 个祖先成分,但 K 的选择自带解释负担(K=3 是我们选的还是数据逼的?);系统树(图 46)暗示离散分支,对渐变群体是误导——把连续梯度硬切成枝。第六篇图 174 的 PCA 左侧离群与图 187 地理分布对上(北美重建群体),正是”无模型方法先看、有模型方法再验证”的顺序。
5.8 群体分化:π、Fst、dXY 回答的是三个问题
第六篇的滑窗三件套各管一件事:π 是组内多样性(位点频率谱图 177 是它的原始形态——SFS 的形状本身就是中性检验的原料),Fst(图 176)是组间方差占比(0-1,受组内多样性影响——组内越匀 Fst 越容易高),dXY 是绝对分歧。只报 Fst 会把”组内瓶颈导致的均一化”误读成”选择性分化”,所以正经群体遗传文章三者并列。LD 衰减(图 44/175)用等距分箱均值而不用逐对散点:原始 SNP 对的 r² 噪声淹没有趋势,分箱是可视化必需而非数据篡改——图注写明 bin 宽(10kb)。
5.9 GWAS:显著性阈值宁保守,QQ 图先于 Manhattan
全基因组扫描的零假设是”M 个检验全无关”,Bonferroni 0.05/M 简单、保守、无可调参数——第二篇图 43 的 λ=1.07 说明模拟数据干净;第六篇图 181 的 λ=1.62 才是真实数据的样子(群体结构残余膨胀,正文如实交代了 n=100 的功效局限:top 信号 -log10p=6.8 够不着 7.6 的阈值线)。替代方案对比:BH-FDR 更宽松,适合探索性排序但”全基因组显著”的声明撑不住;置换检验经验零分布最贴数据,但 10⁶ 级 SNP 的置换成本高。顺序应当是:先 QQ(图 43/181)看整体偏离判膨胀,再 Manhattan(图 42/180)找峰,最后区域图(图 182)配 LD r² 上色收敛候选——直接跳到 Manhattan 容易把膨胀当信号。
5.10 单细胞:marker 用秩检验,通讯用两个图互补
图 100 的 marker 鉴定用 Wilcoxon rank-sum(scanpy 默认):表达量分布普遍偏态、有离群高表达细胞,秩检验免分布假设,比 Welch t 稳;logistic 回归视角(把 marker 当分类器)对稀有细胞类型更敏感,但可解释性下降。图 101(通讯圈图)与图 102(配体-受体气泡)是同一推断的两种呈现:圈图展示”谁和谁有话说的全局”,气泡图展示”具体哪对配受体在说话、强度多大”——只有圈图会被质疑具体互作证据,只有气泡图会丢全局格局。
5.11 结构:四个问题四张图,别混
结构分析的四类问题各有专属图型,互相不可替代:谁挨着谁看残基接触图(图 189,一张矩阵看全界面配对);哪里柔性/可信看 B 因子或 pLDDT(图 190/36/143,pLDDT 四段色带是 AlphaFold 官方口径);界面埋藏了多少看 ΔASA(图 155/191,Shrake-Rupley 算法逐残基差分);构象差多少看 RMSD 叠合(图 74/145)。用接触图回答”埋藏多少”会高估(接触≠埋藏),用 ΔASA 找”谁挨着谁”会漏掉埋藏但非界面的接触。
5.12 定量与验证:TPM、RPK、counts 各有地盘,qPCR 的前提要先验
图 11(TPM 分布)与图 183(RPK)用的是不同标度,不是笔误:TPM 做了样本内归一(库组成校正后基因占比),适合比同一样本内基因间;RPK 只除长度不除库组成,第六篇图 183 只比同一样本内四个组织、且要保流量(不做二次缩放),正文写明了口径。跨样本严格比较必须回到 counts + size factor(DESeq2 口径),这是图注反复强调的边界。qPCR 的 2^-ΔΔCt(图 24-27、156-163)有个常被跳过的前提:目的基因与内参的扩增效率近似相等——所以扩增曲线(图 25)和熔解曲线(图 26)不是装饰,是效率合法性的证据链,MIQE 规范的强制项。
5.13 真实数据特有的选型:链、功效、空壳
第六篇踩的三个坑本质都是选型问题:链特异 bigWig 必须双链均值(图 185)——AP1 的信号几乎全在 R 链文件里(F=0.014 vs R=12.6),只查 F 链会得出”基因不表达”的假阴性;n=100 的 GWAS 拿不到全基因组显著是功效现实不是失败——如实报告 top 信号与阈值线的距离比硬凑”显著”诚实;空壳文件验真(官方 release 36 个甲基化 bigWig 的 nBasesCovered 全为 0)——数据是否可用本身就是分析流程的第一道选型,第六篇第八章的六道闸门就是为此设计的。
六、图注也升级:Nature 的图注骨架
skill 从 2025 年 Nat Commun 语料里蒸馏的图注骨架,与我们的四段式正好互补——四段式管”正文里怎么教读图”,Nature 骨架管”图注自身是否自足”:
图 N |加粗名词短语总题(编号与总题之间用竖线,无句号);- 面板 a/b/c 逐个用现在时电报式描述(”a 三种处理下差异表达基因的火山图”);
- 统计写进图注:n、误差类型(SD/95%CI)、检验方法与校正;
- 颜色/形状映射和关键数值锚点写进图注,脱离正文可读。
拿第六篇图 180 示范改写(前 → 后):
改前:图 180 全基因组关联曼哈顿图(真实数据)。1795498 个 SNP,top -log10p = 6.8。
改后:图 180 | 四天根长的全基因组关联扫描。a 1,795,498 个 MAF 5-95% SNP 的 -log10P(真实数据,n=100,GT292 ∩ v3.1);虚线为 Bonferroni 阈值 -log10(0.05/1795498)=7.6,红色圆圈为 top SNP(Chr4:1951149,-log10P=6.8)。b 观察值对期望 P 的分位数图,λGC=1.62。
改后版本把 n、阈值算式、top 坐标、膨胀系数全部装进了图注——截图流出时证据链完整。本篇起,新写的图注按此骨架执行;前六篇已有的图注示例块保留(教学语境下四段式的”怎么读”比图注自足更优先),后续修订单独排队。
七、AI 味自检清单(发布前 10 问)
- 色板色盲安全吗?把图转灰度,组间还分得开吗?(红绿并排、彩虹尺度直接毙)
- 终稿字号 ≤9pt 了吗?还是一眼幻灯片?
- 背景网格撤了吗?撤掉后视线有刻度引导吗?
- 多面板有 a/b/c 吗?图注逐面板描述了吗?
- 轴标签和单位齐了吗?(”Expression” 不合格,”TPM(transcripts per million)” 合格)
- n、误差类型、检验方法写进图注了吗?
- 图例带框吗?框还在就删。
- 显著性标注是星号堆砌还是给了检验名?”***” 必须能追到 “Welch t, BH 校正”。
- 水印/来源声明在吗?模拟数据有没有明说?
- 导出分辨率 ≥300dpi 吗?手机放大看得出像素块吗?
八、写在最后
技术账:本次重构动了 tools/bio-plots/nature_style.py(新增,约 130 行)、common.py(rcParams 块与 save() 各一处)、全系列 22 个绘图脚本重跑(16 个模拟数据脚本分钟级;第六篇 6 个真实数据脚本因 af/GWAS 缓存与远程 bigWig 查询,约半小时)。190 张 PNG 全部落盘,scripts/scan-html.js 审计保持 0 疑似问题;数据、随机种子、图注数字全部未动。
风格系统的全部代码如下,一个文件,抄走即用:
展开查看:nature_style.py 完整代码
1 | # -*- coding: utf-8 -*- |
接入方式只有两行——common.py 里:
1 | import nature_style as ns |
重跑全系列:
1 | # WSL 内;模拟数据脚本逐个跑,真实数据脚本依赖 data_dump 缓存 |
系列下一步:第八篇回到工具链主线。本篇之后,前六篇的图已经是新样子——如果哪张图你觉得改坏了,评论区指图号,单图回滚只要重跑一个脚本。
参考文献
- Nature Portfolio. Preparing figures: our specifications. research-figure-guide.nature.com(89/183mm、5-7pt、面板字母等硬指标的原始出处,两个 skill 的共同锚点)
- Wong B. Points of view: Color blindness. Nature Methods 8: 441, 2011. doi:10.1038/nmeth.1618——Okabe-Ito 色板(Okabe M, Ito K. Color Universal Design, 2008)的期刊推介文。
- Hunter JD. Matplotlib: a 2D graphics environment. Computing in Science & Engineering 9(3): 90-95, 2007. doi:10.1109/MCSE.2007.55
- 技能仓库(本篇第二章逐一评审):Yuan1z0825/nature-skills(skill: nature-figure,主用)· K-Dense-AI/scientific-agent-skills(skill: scientific-visualization,nature.mplstyle)· anthropics/skills(官方库,格式参照)· Boom5426/Nature-Paper-Skills(未采用)
- 方法选型各条目的方法学出处(DESeq2/GSEA/DESeq 口径等)已随前六篇各自的参考文献节给出,本篇不重复;第六篇真实数据的完整文献见第六篇参考文献。
本篇参考代码
- 风格系统:
tools/bio-plots/nature_style.py(上方全文)+common.py接入两行; - 改造前原图存档:
source/img/bio-plots/before/(12 张,与本篇第四章一一对应); - 全部绘图脚本:仓库
tools/bio-plots/,清单与图号映射见各篇「参考代码」节。