系列的最后一块拼图。前三篇走完了统计、转录组、群体遗传、基因组、表观和空间组学,这一篇收剩下的三大块:分子的层面 (蛋白结构域、分子互作、湿实验验证,104-114)、群落的层面 (微生物生态、代谢组与宏基因组,115-123),以及方法的层面 (深度学习归因、蛋白语言模型、泛基因组图这些近几年的新图型,124-128),最后用五张统计杂图收尾(129-133)。编号 104-133,共 30 张 。
规则不变:四段式讲解,图下折叠块里是原样 CSV 或代码即数据源,全部为 WSL 里 Python 3.14 + matplotlib 渲染的模拟数据,脚本在仓库 tools/bio-plots/ch10c_more.py 与 ch10d_more.py。
本系列已出七篇:第一篇(41 张,统计与转录组临床) · 第二篇(33 张,群体遗传与基因组) · 第三篇(29 张,测序、表观与空间组学) · 第四篇(30 张,蛋白、生态与 AI 多组学) · 第五篇(40 张,蛋白结构、变异与表达验证,含真实 PDB 结构与交互 3D) · 第六篇(22 张,真实公开数据实战) · 第七篇(190 张图 Nature 风格重构与方法选型) 。
自推一句 :蛋白理化性质、结构域解析、结构置信度这些在 Linxira Bio SDK (我主导开发的本地优先生信工具链)里是版本化能力:正式分支 v1.0.1 已提供 structure pdb --alphafold-plddt 等 CLI 与 35 个 agent skills,官网 与拆解文 随时可翻。免责声明 :本文所有配图均为模拟数据的教学演示;SDK 实际可用的分析能力,请以仓库 正式分支的最新 release 为准——文中部分图对应的分析尚在开发路线中,目前仅存在于本地开发分支,未合并进正式分支、代码未公开。
一、地图
    flowchart LR
    START(["第四篇 · 30 张"]):::hub
    subgraph A["① 蛋白 分子互作"]
        direction TB
        A1["结构域 · pLDDT · RMSF"]
        A2["自由能面 · EMSA · 亚细胞"]
    end
    subgraph B["② 生化湿实验"]
        direction TB
        B1["双倒数 · DSF · ELISA"]
        B2["荧光位移 · 双荧光素酶"]
    end
    subgraph C["③ 微生物 生态"]
        direction TB
        C1["稀疏化 · rank-abundance · 三元"]
        C2["RDA · LEfSe · 时间杀菌"]
    end
    subgraph D["④ 代谢 宏基因组"]
        direction TB
        D1["镜像质谱 · VanKrevelen · Blob"]
    end
    subgraph E["⑤ AI 多组学"]
        direction TB
        E1["MOFA · 归因 · 蛋白嵌入"]
        E2["泛基因组图 · 跨组 UMAP"]
    end
    subgraph F["⑥ 统计杂图"]
        direction TB
        F1["漏斗 · 哑铃 · 瀑布 · 帕累托 · 3D-PCA"]
    end
    START --> A --> B --> C --> D --> E --> F
    classDef hub fill:#1f4e79,color:#fff,font-weight:bold
表 1 蛋白、互作与湿实验(104-114)
图
回答什么问题
横轴
纵轴或编码
常用工具
结构域架构图
功能域怎么排布
氨基酸位置
域方块
SMART/Pfam
pLDDT 曲线
结构模型哪段可信
残基
分段着色置信度
AlphaFold DB
RMSF 曲线
哪段柔性大
残基
位移 RMSF
GROMACS
自由能面
构象盆地有几个
PC1
PC2 等高线
GROMACS
EMSA
蛋白结不结合探针
泳道
条带迁移
手绘/成像
亚细胞定位图
蛋白去哪个区室
无
荧光位置示意
共聚焦
双倒数图
抑制剂是哪种类型
1/[S]
1/v 直线族
GraphPad
DSF 熔解曲线
配体稳不稳定蛋白
温度
荧光+Tm 位移
GraphPad
ELISA 标准曲线
含量怎么回算
浓度(log)
OD450 4PL
GraphPad
荧光光谱位移
结合有没有发生
发射波长
峰移+淬灭
荧光仪
双荧光素酶柱状
启动子激活多少
构建分组
LUC/REN 比值
GraphPad
表 2 生态、代谢、AI 与统计(115-133)
图
回答什么问题
横轴
纵轴或编码
常用工具
稀疏化曲线
测够了没有
抽样 reads
观测 ASV 数
QIIME2
rank-abundance
群落均匀度
物种秩
丰度(log)
R vegan
三元相图
三个区室比例
三角坐标
点位=组成
R Ternary
RDA 排序图
环境因子怎么塑造群落
RDA 轴
样方+因子箭头
vegan
LEfSe 分支图
哪些分类元驱动差异
无
环形着色
LEfSe
时间杀菌曲线
抗生素杀得快不快
时间
log10 CFU
GraphPad
镜像质谱图
谱图对上了没有
m/z
上下镜像强度
GNPS
Van Krevelen 图
化合物属于哪类
H/C
O/C 分区
R FTMSPlot
Blob 图
bin 是谁、好不好
GC%
覆盖度+大小
BlobToolKit
MOFA 因子图
多组学共变结构
Factor1
Factor2+R2
MOFA2
归因轨迹图
模型看重哪些碱基
启动子位置
归因分着色
TF-MoDISco
蛋白嵌入 UMAP
家族聚不聚团
UMAP1
UMAP2 按家族着色
ESM/ProtTrans
泛基因组图
样本间结构变异
无
节点路径图
Bandage/pggb
跨组 UMAP
多组学结论一致吗
UMAP 轴
三联小倍数
MOFA/totalVI
漏斗图
Meta 结果有偏吗
效应量
标准误+伪置信带
metafor
哑铃图
两时点差多少
NES 值
成对连线
手绘
瀑布图
个体响应排序
基因型
变化率着色
手绘
帕累托图
主要矛盾是哪几项
类目
计数+累计%
手绘
3D PCA
第三轴有无信息
PC1-3
三维散点
sklearn
二、蛋白与分子互作 2.1 蛋白结构域架构图
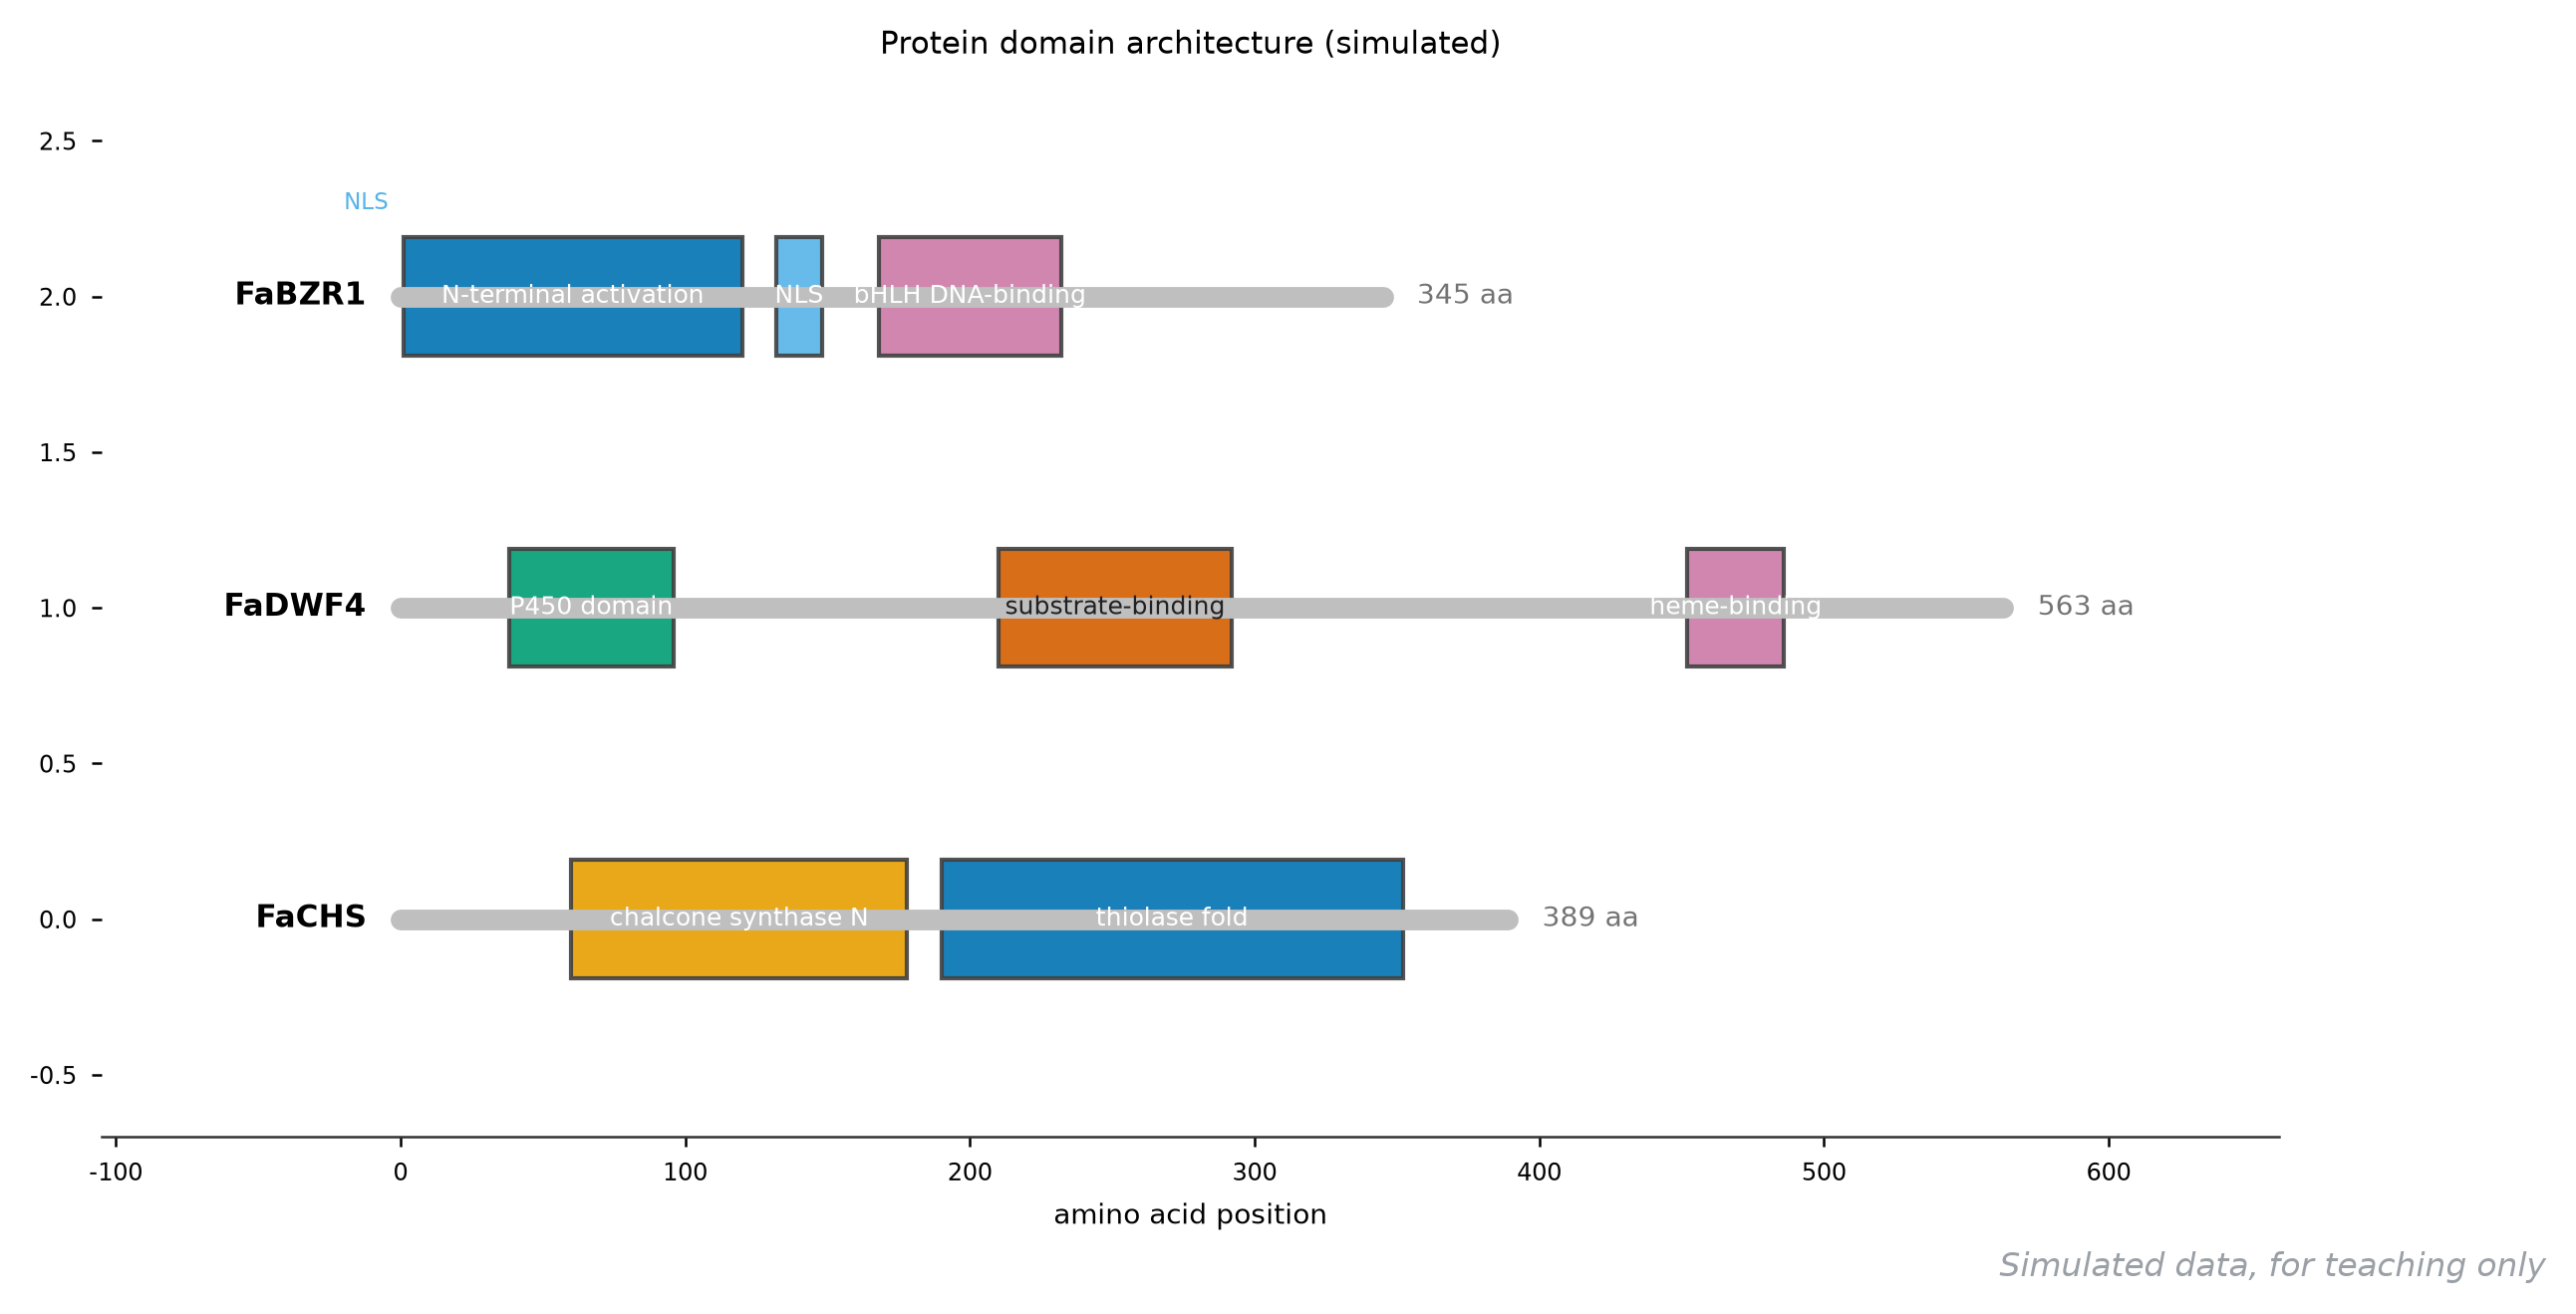
它回答什么问题 :家族成员的功能域怎么排布、长度差在哪——基因家族论文三件套(树、motif、结构)的最后一环,也常是审稿人判断注释对不对的第一眼。
怎么读 :每行一个蛋白,灰色细线是全长,彩色方块是功能域,横轴就是氨基酸坐标,域的宽度=长度。读三样:域的完整性(FaBZR1 的 bHLH DNA-binding 在 168-232,缺了它注释就是错的);域的排列顺序在成员间是否保守(顺序换位提示结构变异);以及低复杂度区/固有无序区的长尾巴(画成空档,别硬塞个域上去)。家族论文的标准句式是「所有成员均含有 X 个保守结构域,结构域排列顺序一致」。
用什么画 :Pfam/SMART 批量扫描后用 TBtools、R 语言 drawProteins;重绘按坐标表画方块。
图注示例 :
图 104 FaBZR1、FaDWF4 与 FaCHS 的结构域架构(模拟)。方块为预测功能域,横轴为氨基酸位置;三个蛋白均含各自家族的完整催化域,域排列顺序与典型成员一致。
展开查看:结构域坐标与绘图代码 1 2 3 4 5 6 7 8 9 protein,domain,start,end FaBZR1,N-terminal activation,1,120 FaBZR1,NLS,132,148 FaBZR1,bHLH DNA-binding,168,232 FaDWF4,P450 domain,38,96 FaDWF4,substrate-binding,210,292 FaDWF4,heme-binding,452,486 FaCHS,chalcone synthase N,60,178 FaCHS,thiolase fold,190,352
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("104-domains.csv" ) lens = {"FaBZR1" : 345 , "FaDWF4" : 563 , "FaCHS" : 389 } CAT = {"N-terminal activation" : "#4C72B0" , "NLS" : "#8172B3" , "bHLH DNA-binding" : "#C44E52" , "P450 domain" : "#55A868" , "substrate-binding" : "#DD8452" , "heme-binding" : "#C44E52" , "chalcone synthase N" : "#8172B3" , "thiolase fold" : "#4C72B0" } fig, ax = plt.subplots(figsize=(9.4 , 4.6 )) for k, (name, L) in enumerate (lens.items()): y = len (lens) - 1 - k ax.plot([0 , L], [y, y], color="0.75" , lw=5 , solid_capstyle="round" ) sub = df[df.protein == name] for _, r in sub.iterrows(): c = CAT[r.domain] ax.add_patch(plt.Rectangle((r.start, y - 0.19 ), r.end - r.start, 0.38 , facecolor=c, edgecolor="0.25" , alpha=0.9 )) ax.text((r.start + r.end) / 2 , y, r.domain, ha="center" , va="center" , fontsize=7.6 , color="white" ) ax.text(-12 , y, name, ha="right" , va="center" , fontsize=9.5 , fontweight="bold" ) ax.text(L + 12 , y, "%d aa" % L, va="center" , fontsize=8.5 , color="0.45" ) ax.set_xlim(-105 , 660 ) ax.set_ylim(-0.7 , 2.7 ) ax.set_xlabel("amino acid position" ) ax.spines["left" ].set_visible(False ) ax.set_title("Protein domain architecture (simulated)" ) fig.savefig("104-domains.png" , dpi=200 , bbox_inches="tight" )
2.2 AlphaFold pLDDT 置信度曲线
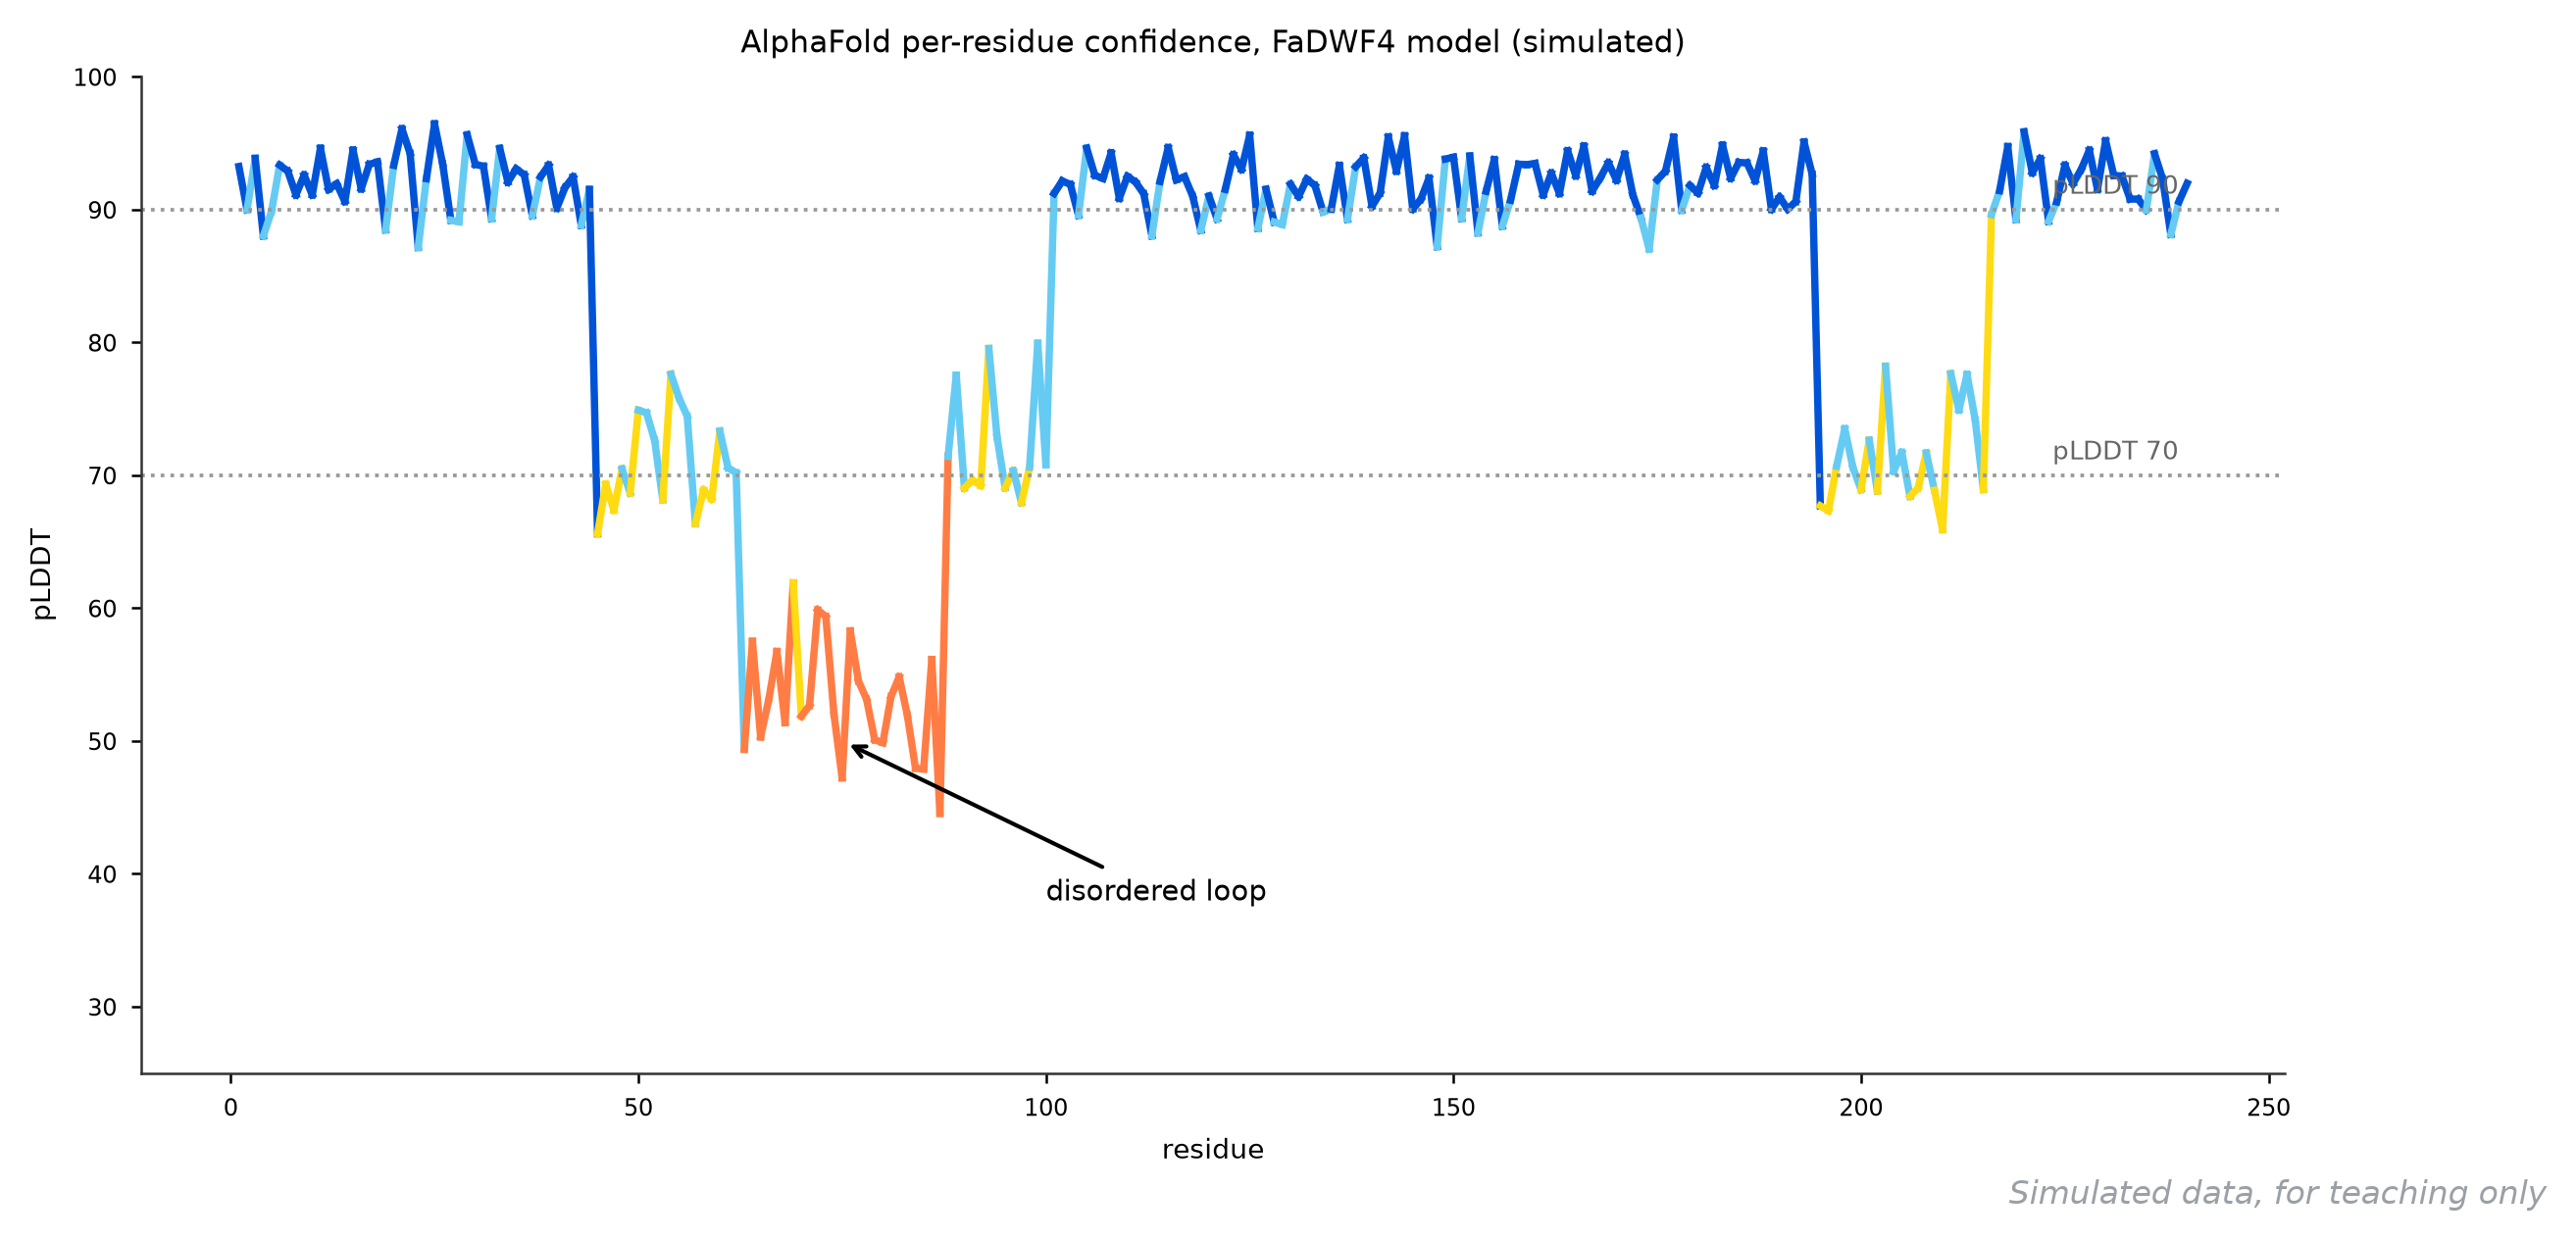
它回答什么问题 :AlphaFold 模型哪几段能信、哪几段是「随机面团」——用结构之前先看 pLDDT,这不是可选项而是纪律。
怎么读 :横轴残基,纵轴 pLDDT(0-100),官方配色:深蓝大于 90(很高,原子级可信)、浅蓝 70-90(骨架可信)、黄 60-70(只可看趋势)、橙小于 60(无序/不可信)。本例 1-43、103-195 与 217-238 三段高置信(pLDDT 不低于 87),46-100 一段走低,其中 64-85 八个位点全部低于 60 (谷底 47.9)——那是一段固有无序环,模型把「没结构」预测成了「不确定」;196-214 另有一个浅坑(67-78),置信度中等。正确写法是「无序区(pLDDT 小于 60)不参与结构解读」,而不是删掉它——低置信度本身就是生物学信号。
用什么画 :AlphaFold DB 直接下载;重绘对逐残基 B-factor 列按阈值分段着色。
图注示例 :
图 105 FaDWF4 AlphaFold 模型的逐残基 pLDDT 曲线(模拟,239 aa)。官方配色四档:深蓝大于 90、浅蓝 70-90、黄 60-70、橙小于 60;残基 64-85 的 pLDDT 低于 60(谷底 47.9),为无序区,不参与结构解读;196-214 一段降至 67-78。
展开查看:pLDDT 数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 pos,plddt 1,93.2 4,88.0 7,92.9 10,91.1 13,91.9 16,91.6 19,88.5 22,94.2 25,96.5 28,89.1 31,93.3 34,92.1 37,89.5 40,90.1 43,88.8 46,69.3 49,68.7 52,72.6 55,75.8 58,68.9 61,70.6 64,57.5 67,56.7 70,51.9 73,59.4 76,58.3 79,50.1 82,54.8 85,47.9 88,71.4 91,69.6 94,72.9 97,67.9 100,70.8 103,91.9 106,92.6 109,90.9 112,91.2 115,94.7 118,91.0 121,89.3 124,93.0 127,91.5 130,91.9 133,91.8 136,93.3 139,93.9 142,95.5 145,90.0 148,87.2 151,89.3 154,91.4 157,90.7 160,93.5 163,91.2 166,94.8 169,93.5 172,91.1 175,92.2 178,90.0 181,93.2 184,92.4 187,92.2 190,90.9 193,95.1 196,67.3 199,70.6 202,68.8 205,71.7 208,71.7 211,77.7 214,74.2 217,91.4 220,95.9 223,89.1 226,92.0 229,91.5 232,92.5 235,90.0 238,88.1
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("105-plddt.csv" ) pos, v = df.pos.values, df.plddt.values cols = np.where(v > 90 , "#0053D6" , np.where(v > 70 , "#65CBF3" , np.where(v > 60 , "#FFDB13" , "#FF7D45" ))) fig, ax = plt.subplots(figsize=(9.4 , 4.4 )) for i in range (len (pos) - 1 ): ax.plot(pos[i:i + 2 ], v[i:i + 2 ], color=cols[i], lw=1.8 ) ax.axhline(90 , color="0.6" , ls=":" , lw=0.9 ) ax.axhline(70 , color="0.6" , ls=":" , lw=0.9 ) ax.text(238 , 91.2 , "pLDDT 90" , fontsize=8 , color="0.4" , ha="right" ) ax.text(238 , 71.2 , "pLDDT 70" , fontsize=8 , color="0.4" , ha="right" ) ax.annotate("disordered loop" , (75 , 50 ), (100 , 38 ), fontsize=9 , arrowprops=dict (arrowstyle="->" , lw=1 )) ax.set_ylim(25 , 100 ) ax.set_xlabel("residue" ) ax.set_ylabel("pLDDT" ) ax.set_title("AlphaFold per-residue confidence, FaDWF4 model (simulated)" ) fig.savefig("105-plddt.png" , dpi=200 , bbox_inches="tight" )
2.3 分子动力学 RMSF 柔性曲线
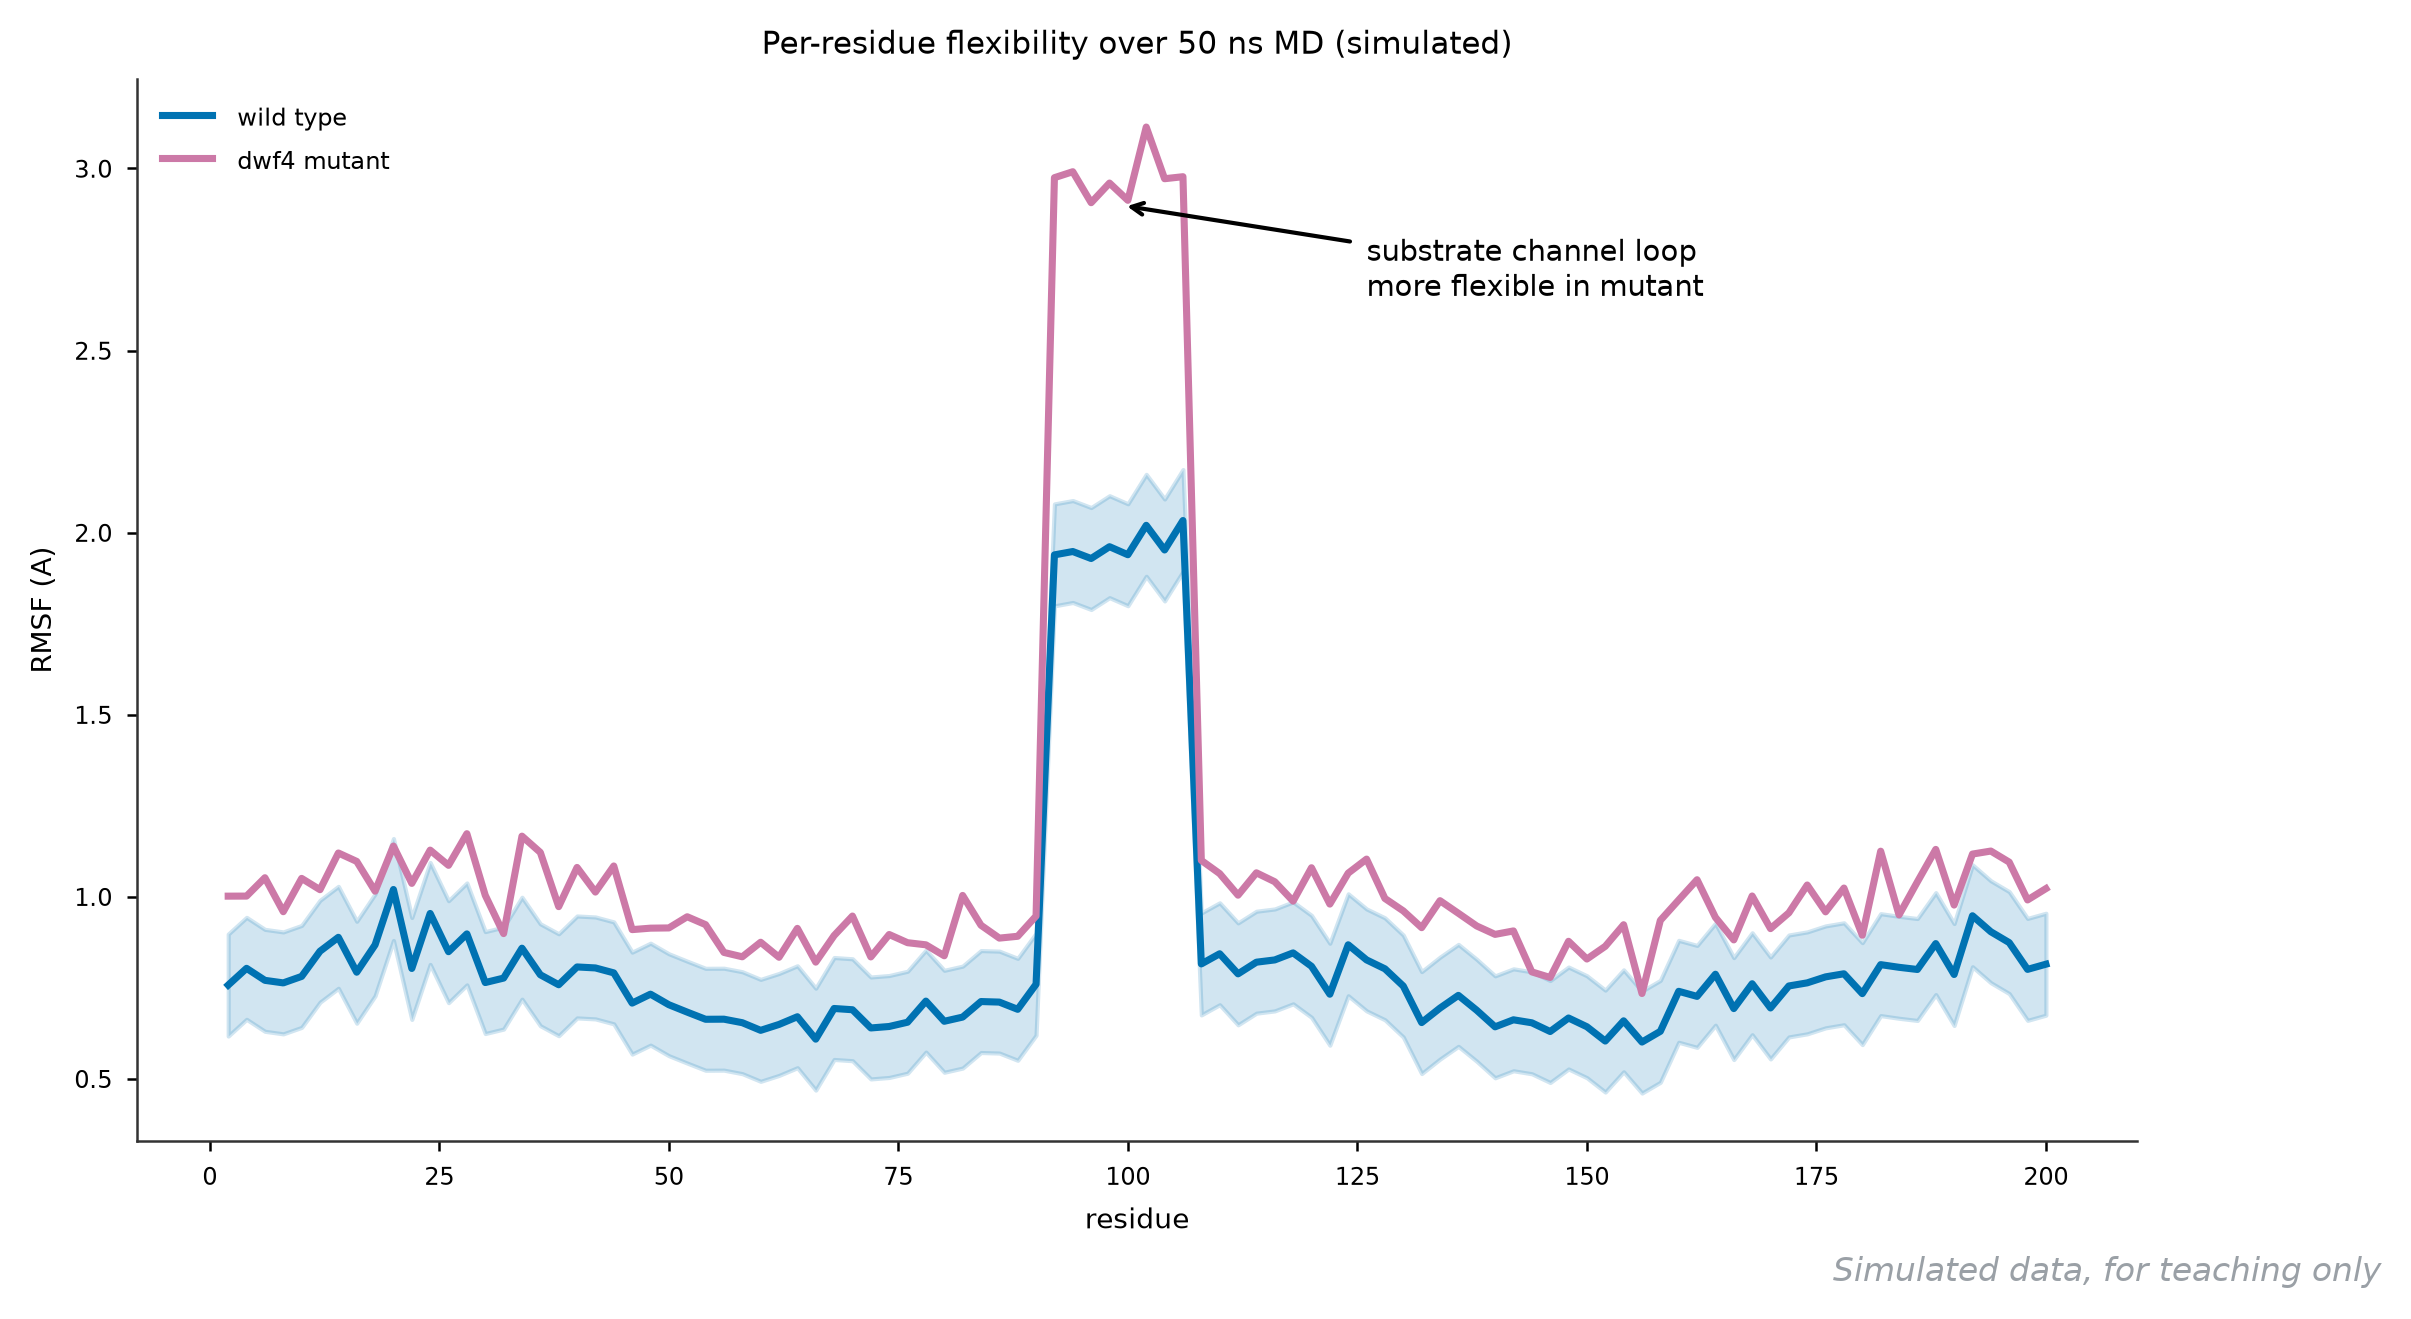
它回答什么问题 :突变改变蛋白的哪些部位、柔性——第三篇 RMSD 讲「整体稳没稳」,RMSF 讲「哪里动得欢」,两个一起才是 MD 分析的完整开场。
怎么读 :横轴残基,纵轴 RMSF(平均位移,埃),突变体(红)整体高于野生型(蓝,均值抬高 0.29 埃)。真正的看点是局部峰:92-106 残基的「底物通道环」在突变体里从约 2.0 埃抬到约 3.0 埃——突变不在环上却放大了环的摆动,这是「远程效应」,也是分子机制假设的来源。曲线其余部分的锯齿是正常热噪声,配阴影带(标准差)更稳。
用什么画 :GROMACS 的 gmx rmsf;重绘对残基-RMSF 表画双线加阴影。
图注示例 :
图 106 野生型与 dwf4 突变体骨架 RMSF 对比(模拟,50 ns)。阴影为标准差带;突变体整体柔性升高(均值 +0.29 埃),底物通道环(92-106 位)差异最大(约 2.0 对 3.0 埃)。
展开查看:RMSF 数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 residue,rmsf_wt,rmsf_mut 2,0.76,1.00 4,0.80,1.00 6,0.77,1.05 8,0.76,0.96 10,0.78,1.05 12,0.85,1.02 14,0.89,1.12 16,0.79,1.10 18,0.87,1.02 20,1.02,1.14 22,0.80,1.04 24,0.95,1.13 26,0.85,1.09 28,0.90,1.17 30,0.76,1.00 32,0.78,0.90 34,0.86,1.17 36,0.79,1.12 38,0.76,0.97 40,0.81,1.08 42,0.80,1.01 44,0.79,1.08 46,0.71,0.91 48,0.73,0.91 50,0.70,0.91 52,0.68,0.94 54,0.66,0.92 56,0.66,0.85 58,0.65,0.83 60,0.63,0.87 62,0.65,0.83 64,0.67,0.91 66,0.61,0.82 68,0.69,0.89 70,0.69,0.95 72,0.64,0.83 74,0.64,0.90 76,0.66,0.87 78,0.71,0.87 80,0.66,0.84 82,0.67,1.00 84,0.71,0.92 86,0.71,0.89 88,0.69,0.89 90,0.76,0.95 92,1.94,2.97 94,1.95,2.99 96,1.93,2.91 98,1.96,2.96 100,1.94,2.91 102,2.02,3.11 104,1.95,2.97 106,2.03,2.98 108,0.82,1.10 110,0.84,1.06 112,0.79,1.00 114,0.82,1.07 116,0.83,1.04 118,0.85,0.99 120,0.81,1.08 122,0.73,0.98 124,0.87,1.06 126,0.83,1.10 128,0.80,1.00 130,0.75,0.96 132,0.65,0.91 134,0.69,0.99 136,0.73,0.95 138,0.69,0.92 140,0.64,0.90 142,0.66,0.91 144,0.65,0.79 146,0.63,0.78 148,0.67,0.88 150,0.64,0.83 152,0.60,0.86 154,0.66,0.92 156,0.60,0.73 158,0.63,0.93 160,0.74,0.99 162,0.73,1.05 164,0.79,0.94 166,0.69,0.88 168,0.76,1.00 170,0.69,0.91 172,0.75,0.96 174,0.76,1.03 176,0.78,0.96 178,0.79,1.02 180,0.73,0.89 182,0.81,1.12 184,0.81,0.95 186,0.80,1.04 188,0.87,1.13 190,0.79,0.98 192,0.95,1.12 194,0.90,1.13 196,0.87,1.09 198,0.80,0.99 200,0.81,1.02
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("106-rmsf.csv" ) fig, ax = plt.subplots(figsize=(8.6 , 4.6 )) ax.fill_between(df.residue, df.rmsf_wt - 0.14 , df.rmsf_wt + 0.14 , color="#4C72B0" , alpha=0.18 ) ax.plot(df.residue, df.rmsf_wt, color="#4C72B0" , lw=1.7 , label="wild type" ) ax.plot(df.residue, df.rmsf_mut, color="#C44E52" , lw=1.7 , label="dwf4 mutant" ) ax.annotate("substrate channel loop\nmore flexible in mutant" , (99 , 2.9 ), (126 , 2.65 ), fontsize=9 , arrowprops=dict (arrowstyle="->" , lw=1 )) ax.set_xlabel("residue" ) ax.set_ylabel("RMSF (A)" ) ax.legend(loc="upper left" ) ax.set_title("Per-residue flexibility over 50 ns MD (simulated)" ) fig.savefig("106-rmsf.png" , dpi=200 , bbox_inches="tight" )
2.4 自由能 landscape 等高线图
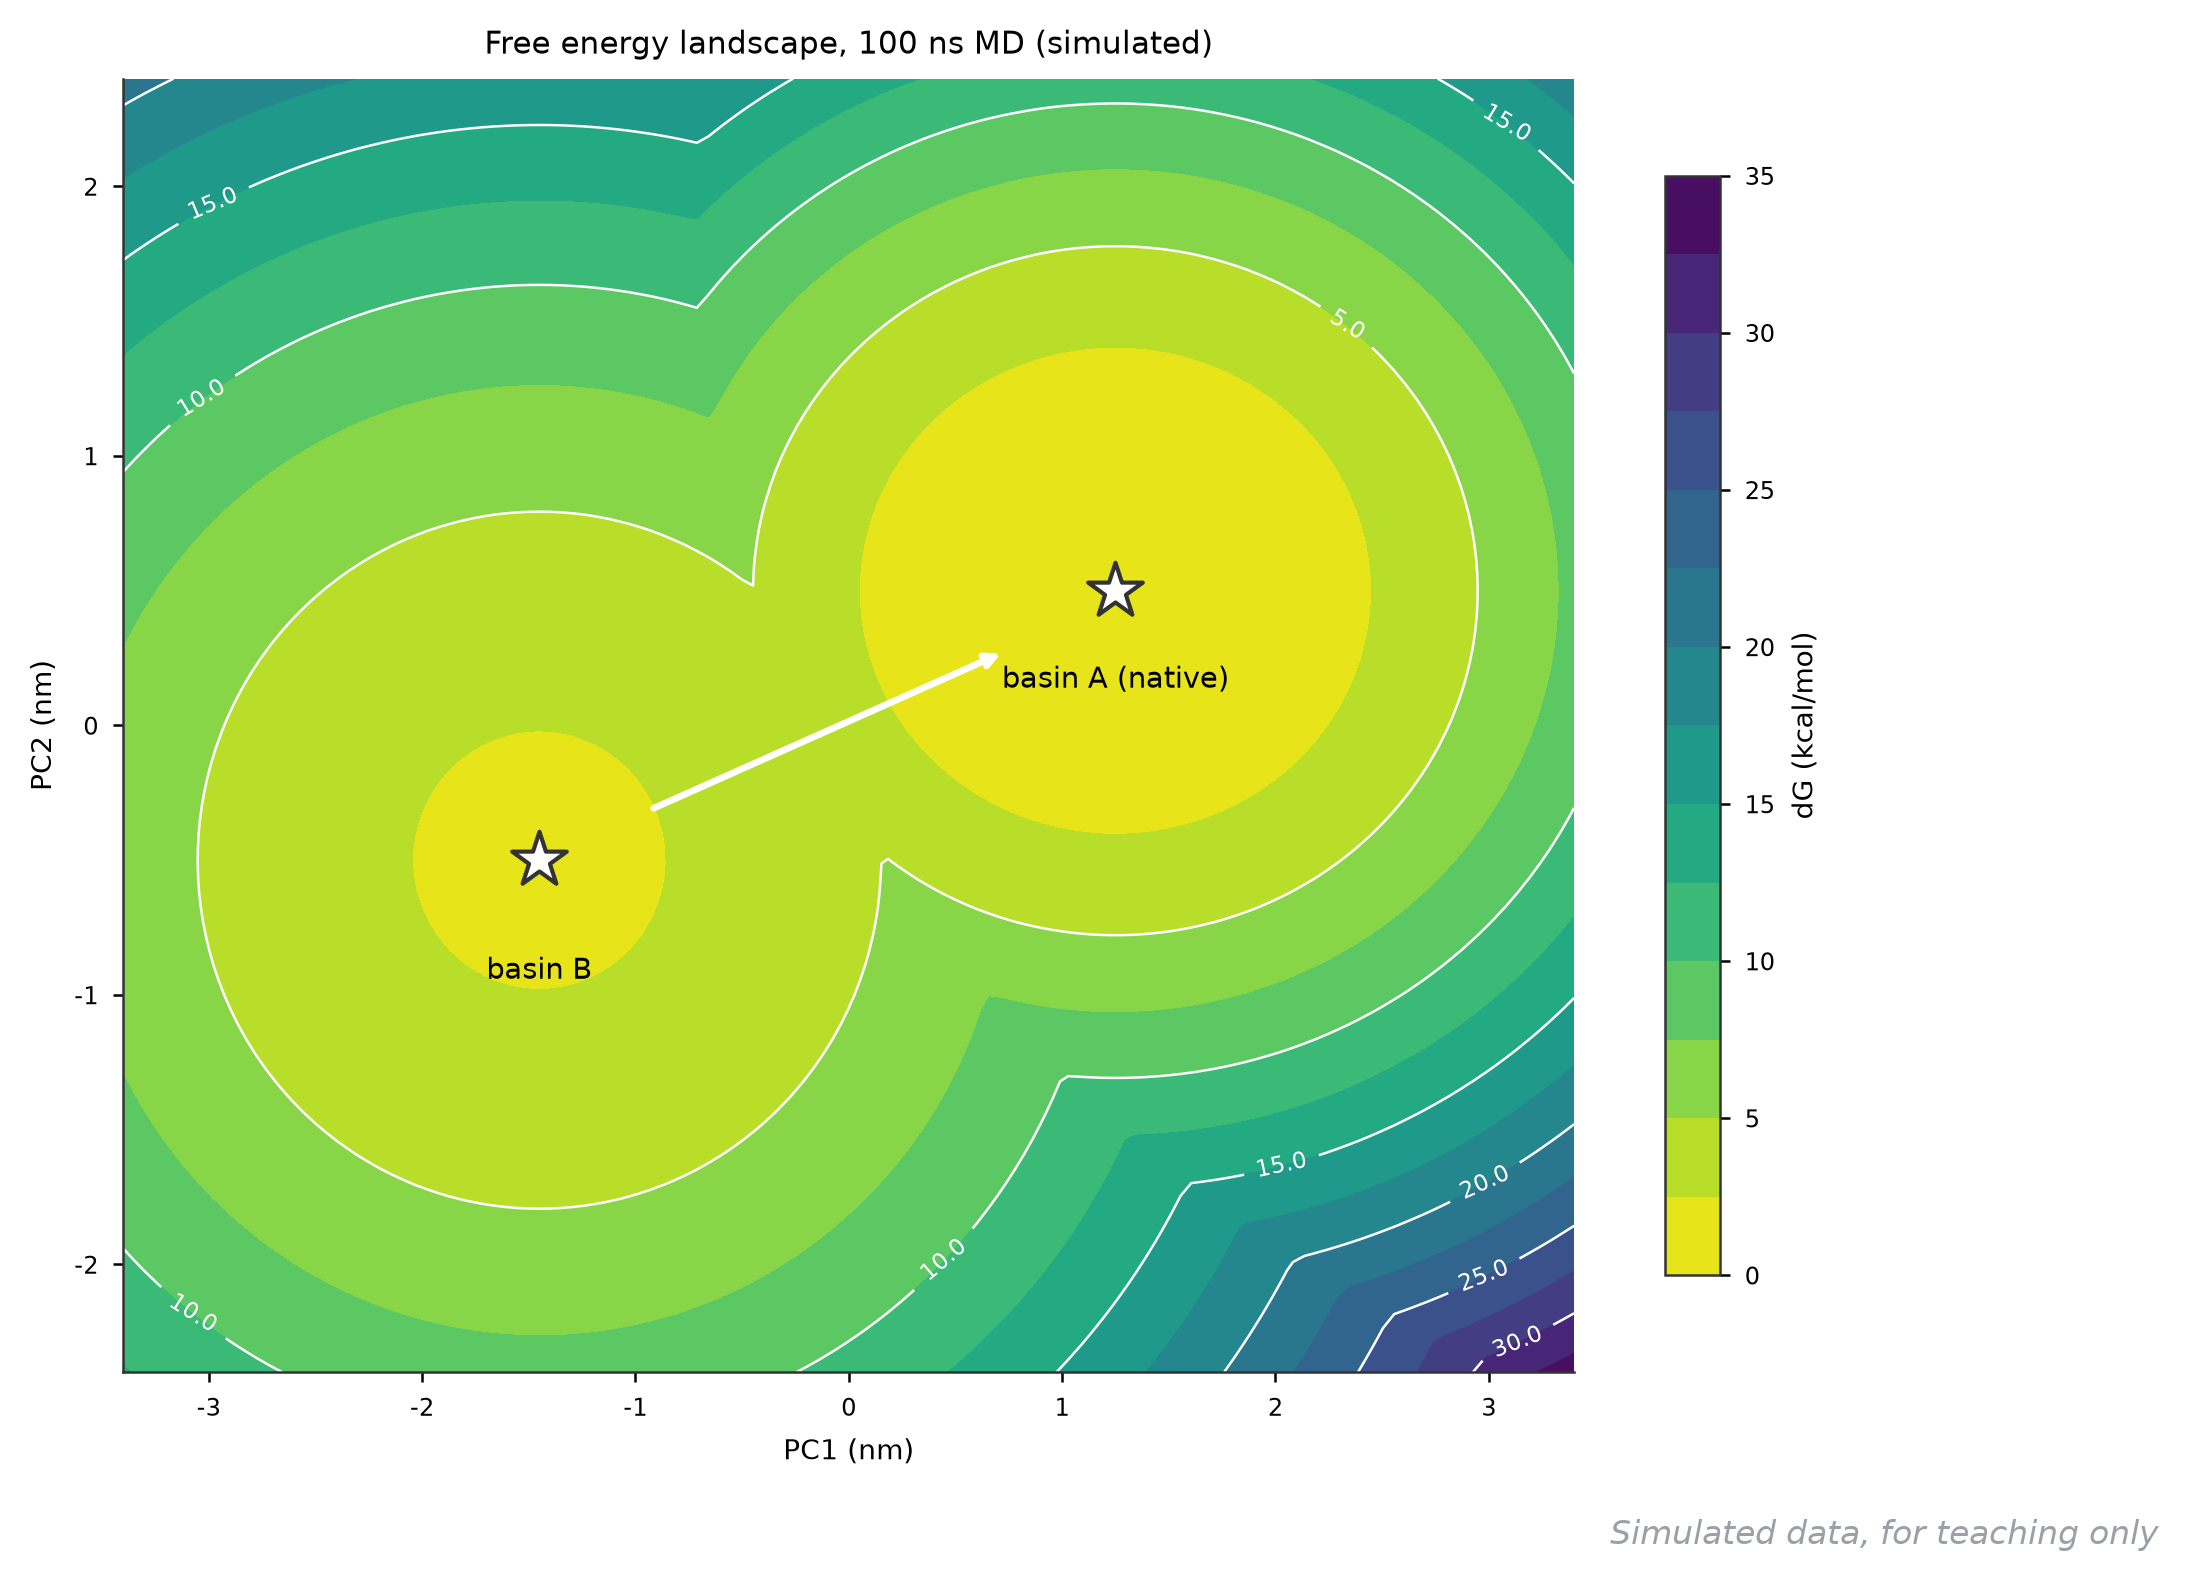
它回答什么问题 :蛋白构象空间里有几个稳定「盆地」、切换要翻多高的山——MD 采样的终极大图,构象切换和折叠路径全画在一张等高线图上。
怎么读 :把 MD 轨迹投影到前两个主成分上,用 -kT ln P 换算成自由能(千卡/摩尔),颜色越深越稳定。两颗星是盆地:盆地 A(原生态,dG = 0)和盆地 B(dG = 2.1,亚稳态);白色箭头是盆地间的切换路径,途经的鞍点高度(约 5)就是切换代价——代价越高切换越罕见。FEL 的最大坑是采样不足:盆地边缘若还「长着」未收敛的山脊,先加模拟时长再谈结论。
用什么画 :GROMACS 的 sham 或 gmx_energy;重绘对粗网格 dG 用 contourf。
图注示例 :
图 107 100 ns 分子动力学的自由能 landscape(模拟,PC1-PC2 投影)。白色细线为等高线,标值为 dG(千卡/摩尔);两个稳定盆地:A(原生态,dG = 0)与 B(dG = 2.1),白色箭头为盆地间最低切换路径。
展开查看:网格数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 pc1,pc2,dG_kcal -3.0,-2.0,8.76 -3.0,-1.0,5.17 -3.0,-0.0,5.13 -3.0,1.0,8.63 -3.0,2.0,15.77 -2.0,-2.0,6.43 -2.0,-1.0,2.84 -2.0,-0.0,2.80 -2.0,1.0,6.30 -2.0,2.0,13.44 -1.0,-2.0,6.37 -1.0,-1.0,2.78 -1.0,-0.0,2.74 -1.0,1.0,6.24 -1.0,2.0,13.38 -0.0,-2.0,8.41 -0.0,-1.0,4.82 -0.0,-0.0,3.67 -0.0,1.0,3.58 -0.0,2.0,9.91 1.0,-2.0,12.77 1.0,-1.0,6.99 1.0,-0.0,0.98 1.0,1.0,0.89 1.0,2.0,7.22 2.0,-2.0,19.39 2.0,-1.0,7.78 2.0,-0.0,1.76 2.0,1.0,1.67 2.0,2.0,8.01 3.0,-2.0,24.64 3.0,-1.0,12.04 3.0,-0.0,6.03 3.0,1.0,5.94 3.0,2.0,12.27
绘图代码(Python,独立可运行;细网格由代码按双盆地函数插值)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 import numpy as npimport matplotlib.pyplot as pltx = np.linspace(-3.4 , 3.4 , 130 ) y = np.linspace(-2.4 , 2.4 , 90 ) X, Y = np.meshgrid(x, y) w1 = 2.6 * ((X - 1.25 ) ** 2 / 1.5 + (Y - 0.5 ) ** 2 / 0.85 ) w2 = 2.6 * ((X + 1.45 ) ** 2 / 2.3 + (Y + 0.5 ) ** 2 / 1.5 ) + 2.1 DG = np.minimum(w1, w2) fig, ax = plt.subplots(figsize=(7.8 , 5.6 )) cf = ax.contourf(X, Y, DG, levels=14 , cmap="jet_r" ) cs = ax.contour(X, Y, DG, levels=6 , colors="white" , linewidths=0.6 ) ax.clabel(cs, fmt="%.1f" , fontsize=7 ) ax.scatter([1.25 , -1.45 ], [0.5 , -0.5 ], marker="*" , s=190 , c="white" , edgecolors="0.2" , zorder=5 ) ax.text(1.25 , 0.14 , "basin A (native)" , ha="center" , fontsize=9 ) ax.text(-1.45 , -0.94 , "basin B" , ha="center" , fontsize=9 ) ax.annotate("" , xy=(0.75 , 0.28 ), xytext=(-0.95 , -0.32 ), arrowprops=dict (arrowstyle="->" , color="white" , lw=1.6 )) ax.set_xlabel("PC1 (nm)" ) ax.set_ylabel("PC2 (nm)" ) ax.set_title("Free energy landscape, 100 ns MD (simulated)" ) fig.colorbar(cf, ax=ax, shrink=0.85 , label="dG (kcal/mol)" ) fig.savefig("107-fel.png" , dpi=200 , bbox_inches="tight" )
2.5 EMSA 凝胶迁移实验示意
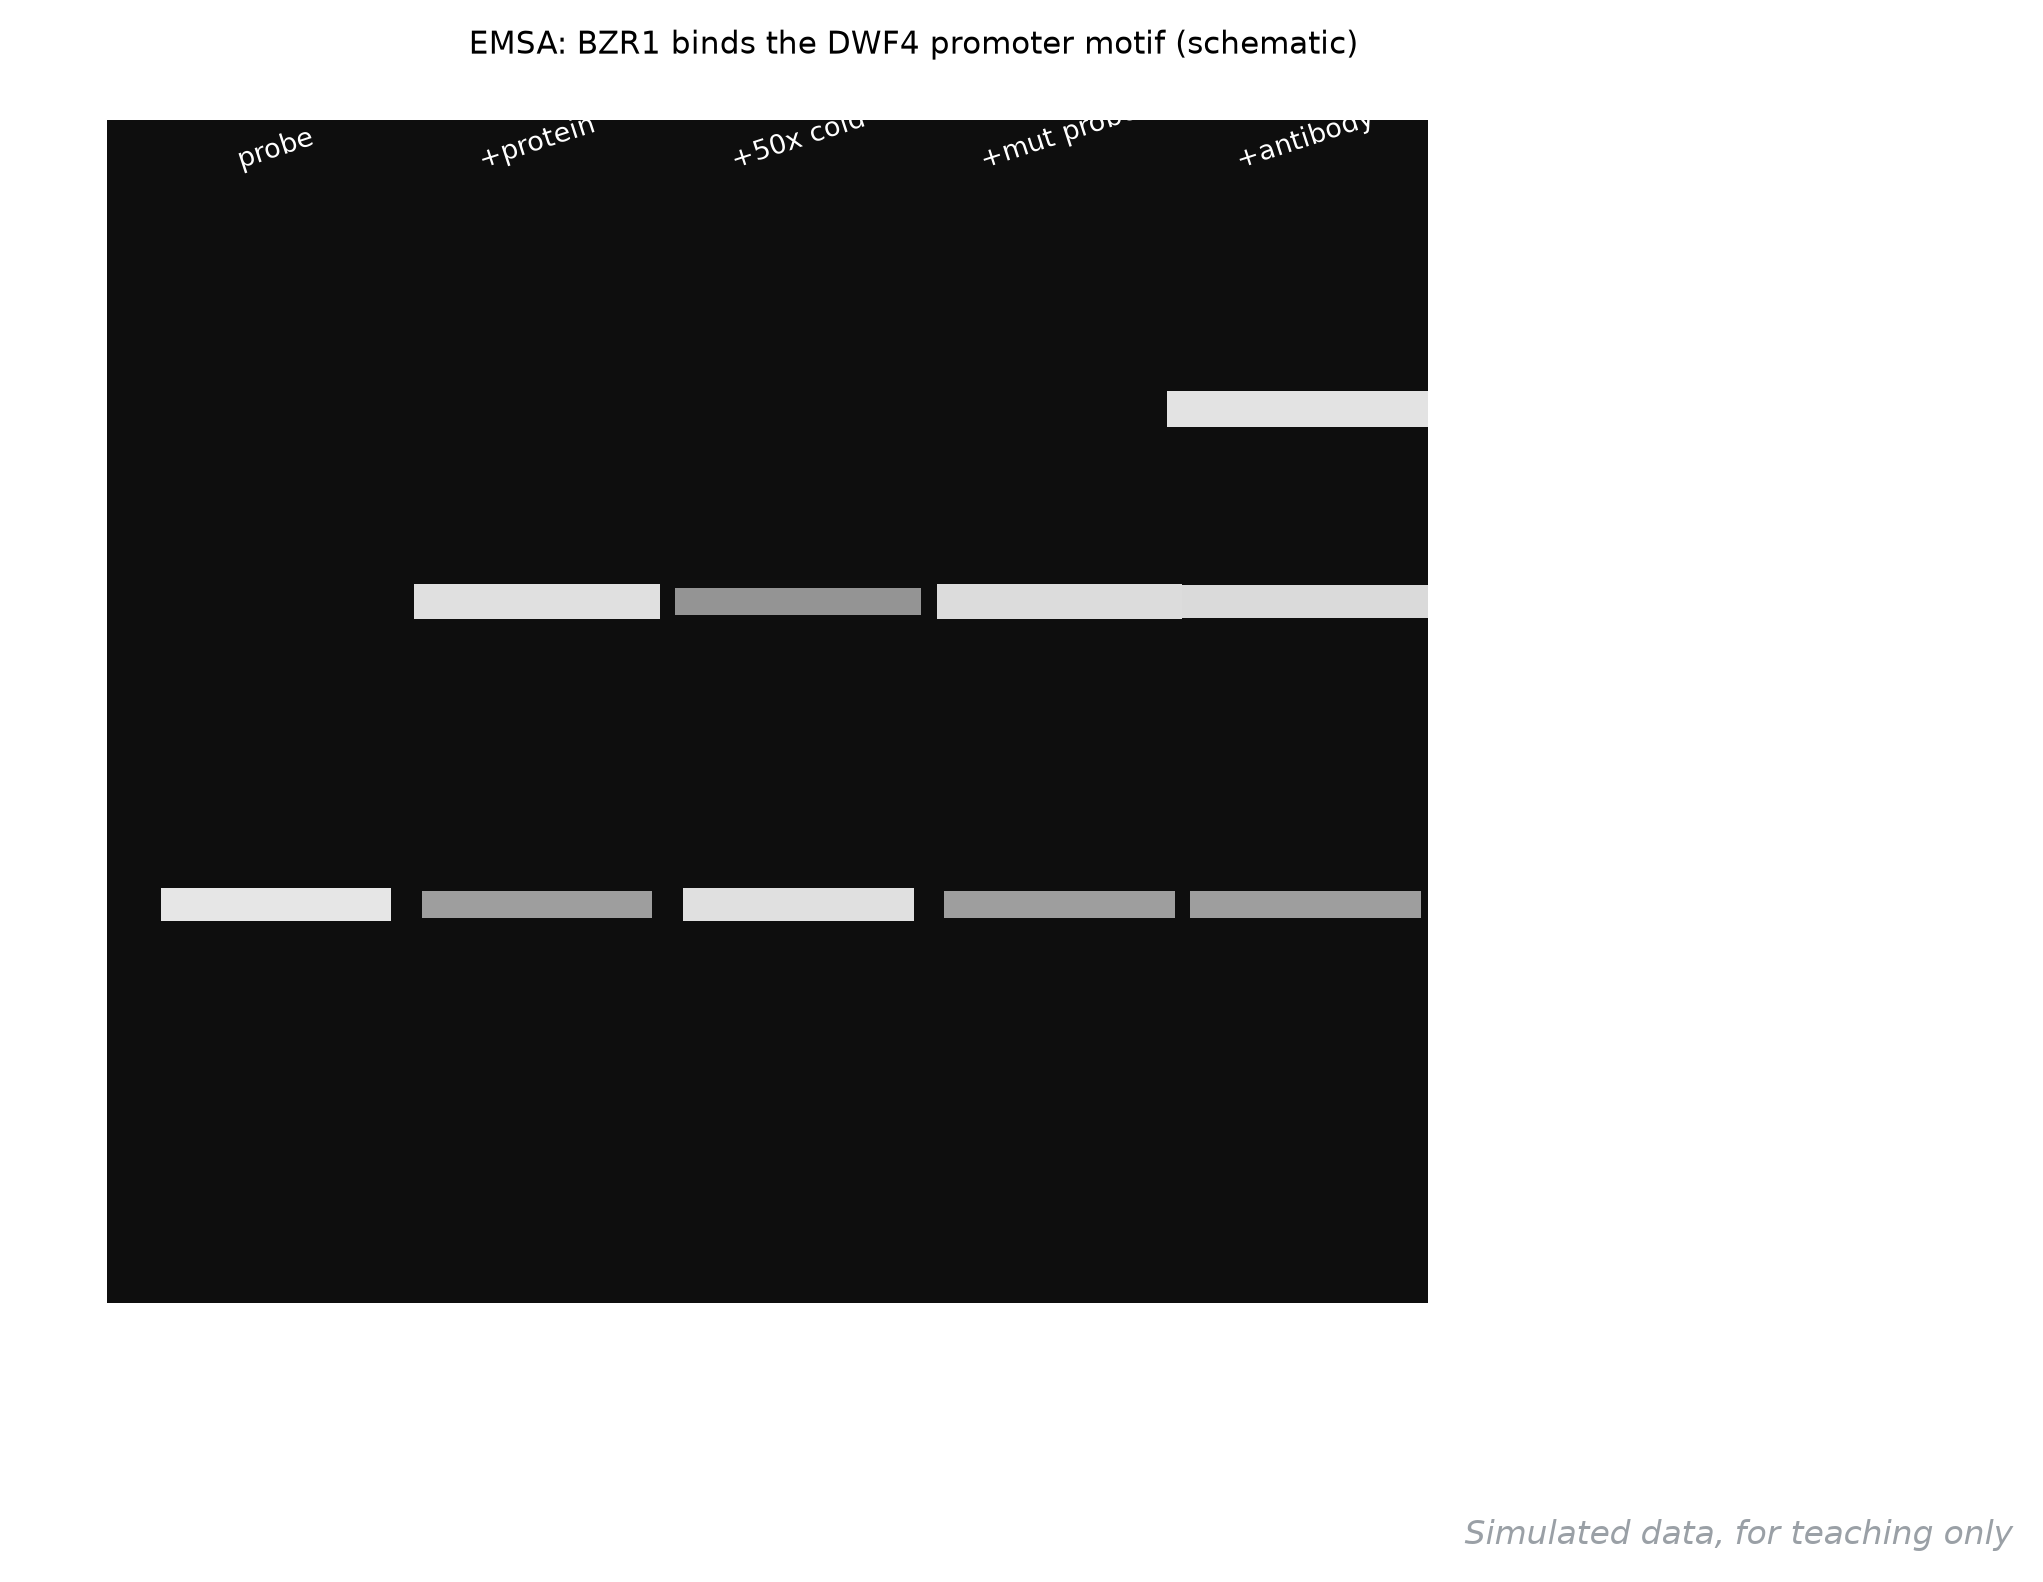
它回答什么问题 :蛋白和这段 DNA 序列在体外结不结合、结合靠不靠特异位点——启动子结合验证的老三样之一(EMSA、Y1H、ChIP-PCR),EMSA 最快也最容易被审稿人追问对照。
怎么读 :泳道就是论证链。「probe」只有游离探针一条带;「+protein」出现向上迁移的滞后带(蛋白-探针复合物,跑得慢);「+50x cold」加 50 倍未标记冷探针竞争,滞后带消失——结合是序列特异的;「+mut probe」突变探针竞争不掉,滞后带仍在——突变位点正是结合位点;「+antibody」加抗体后带子跑得更慢(supershift),坐实复合物里就是这个蛋白。五条泳道缺一不可,少一条对照的 EMSA 基本会被打回。
用什么画 :真实胶图用凝胶成像仪;示意图与排版用 matplotlib 画泳道条带。
图注示例 :
图 108 EMSA 验证 BZR1 与 DWF4 启动子 TGAAG 基序的结合(示意)。泳道依次为游离探针、加蛋白、加 50 倍冷探针竞争、加突变探针、加抗体;滞后带可被冷探针竞争消除、被抗体进一步超迁移。
展开查看:绘图代码(示意条带) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 import matplotlib.pyplot as pltfig, ax = plt.subplots(figsize=(7.6 , 5.6 )) ax.add_patch(plt.Rectangle((0.5 , 0.5 ), 8.6 , 8.6 , facecolor="#0E0E0E" )) lanes = {"probe" : 1.6 , "+protein" : 3.3 , "+50x cold" : 5.0 , "+mut probe" : 6.7 , "+antibody" : 8.3 } def band (x0, y0, w, h, it=1.0 ): ax.add_patch(plt.Rectangle((x0 - w / 2 , y0 - h / 2 ), w, h, facecolor="white" , alpha=0.45 + 0.5 * it)) for name, x0 in lanes.items(): ax.text(x0, 8.75 , name, ha="center" , fontsize=8.2 , color="white" , rotation=18 ) band(1.6 , 3.4 , 1.5 , 0.24 , 0.9 ) band(3.3 , 3.4 , 1.5 , 0.20 , 0.30 ) band(3.3 , 5.6 , 1.6 , 0.26 , 0.85 ) band(5.0 , 3.4 , 1.5 , 0.24 , 0.85 ) band(5.0 , 5.6 , 1.6 , 0.20 , 0.22 ) band(6.7 , 3.4 , 1.5 , 0.20 , 0.30 ) band(6.7 , 5.6 , 1.6 , 0.26 , 0.82 ) band(8.3 , 3.4 , 1.5 , 0.20 , 0.30 ) band(8.3 , 5.6 , 1.6 , 0.24 , 0.80 ) band(8.3 , 7.0 , 1.8 , 0.26 , 0.88 ) ax.text(9.35 , 3.4 , "free probe" , fontsize=8 , color="white" , va="center" ) ax.text(9.35 , 5.6 , "shifted" , fontsize=8 , color="white" , va="center" ) ax.text(9.35 , 7.0 , "supershifted" , fontsize=8 , color="white" , va="center" ) ax.set_xlim(0 , 11.5 ) ax.set_ylim(0 , 9.4 ) ax.axis("off" ) ax.set_title("EMSA: BZR1 binds the DWF4 promoter motif (schematic)" ) fig.savefig("108-emsa.png" , dpi=200 , bbox_inches="tight" )
2.6 亚细胞定位示意图
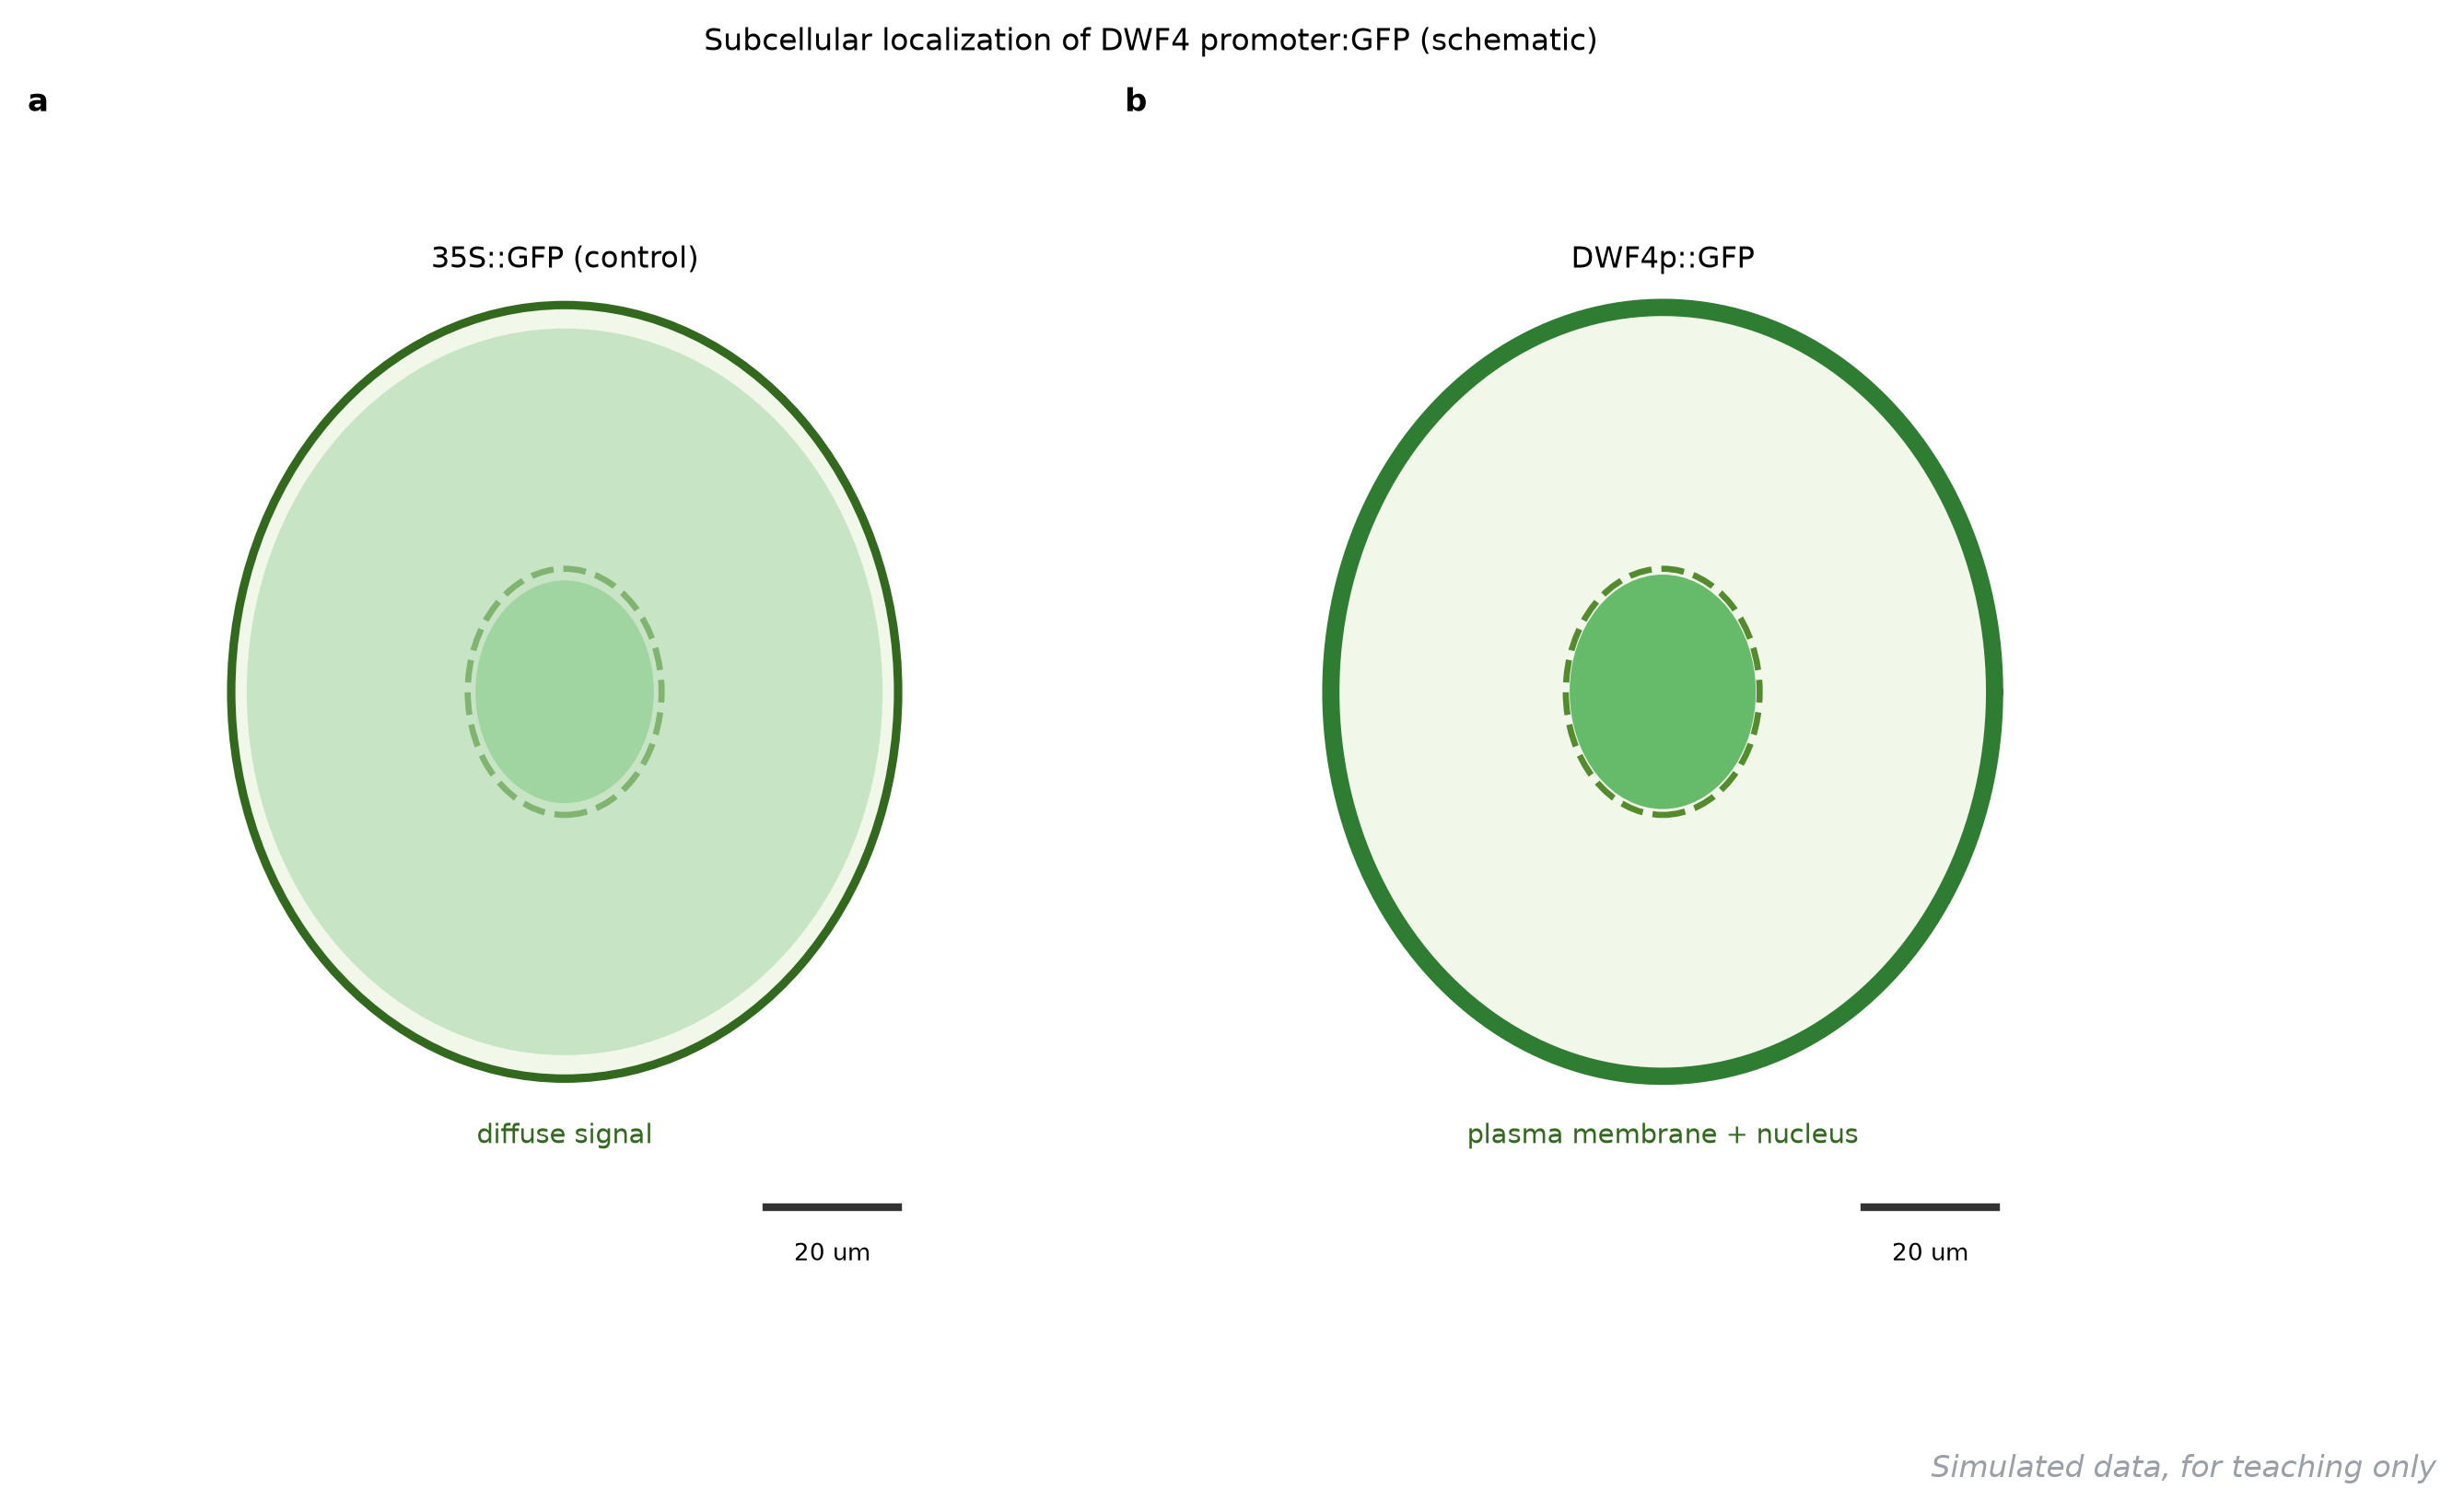
它回答什么问题 :蛋白在细胞里待在哪个区室——基因功能论文的最后一格拼图,GFP 融合表达加共聚焦拍照,画成示意图比贴原始照片更能讲清定位模式。
怎么读 :左右两个细胞是论证的对照组与实验组:左边 35S::GFP 空对照,荧光弥散全细胞(细胞质+细胞核都亮)——证明 GFP 本身不定位;右边 DWF4p::GFP,信号集中在细胞边缘的质膜(粗绿轮廓)加细胞核(实心椭圆)。两图并排、同一标尺(20 um),结论就是「DWF4 定位于质膜与细胞核」。注意审稿人常问质膜信号是不是内质网的假象,正文要补一个质壁分离或共定位 marker 的验证。
用什么画 :共聚焦原始图为主图,示意图用 Illustrator;matplotlib 的椭圆+轮廓也能画个七成像。
图注示例 :
图 109 烟草瞬时表达体系的亚细胞定位(示意)。左:35S::GFP 对照,荧光弥散于细胞质与细胞核;右:DWF4p::GFP,信号定位于质膜与细胞核。比例尺 20 um。
展开查看:绘图代码(示意) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 import numpy as npimport matplotlib.pyplot as pltfrom matplotlib.patches import Ellipsefig, axes = plt.subplots(1 , 2 , figsize=(9.4 , 5.4 )) def cell (ax, mode ): ax.add_patch(Ellipse((5 , 5 ), 8.6 , 6.6 , facecolor="#F1F8E9" , edgecolor="#33691E" , lw=2.2 )) ax.add_patch(Ellipse((5 , 5 ), 2.5 , 2.1 , facecolor="none" , edgecolor="#558B2F" , lw=1.6 , ls="--" )) if mode == "control" : ax.add_patch(Ellipse((5 , 5 ), 8.2 , 6.2 , facecolor="#A5D6A7" , alpha=0.55 , lw=0 )) ax.add_patch(Ellipse((5 , 5 ), 2.3 , 1.9 , facecolor="#81C784" , alpha=0.55 , lw=0 )) ax.text(5 , 8.62 , "35S::GFP (control)" , ha="center" , fontsize=10 ) ax.text(5 , 1.15 , "diffuse signal" , ha="center" , fontsize=9 , color="#33691E" ) else : th = np.linspace(0 , 2 * np.pi, 200 ) ax.plot(5 + 4.28 * np.cos(th), 5 + 3.28 * np.sin(th), color="#2E7D32" , lw=4.5 , solid_capstyle="round" ) ax.add_patch(Ellipse((5 , 5 ), 2.4 , 2.0 , facecolor="#66BB6A" , lw=0 )) ax.text(5 , 8.62 , "DWF4p::GFP" , ha="center" , fontsize=10 ) ax.text(5 , 1.15 , "plasma membrane + nucleus" , ha="center" , fontsize=9 , color="#33691E" ) ax.plot([7.6 , 9.3 ], [0.6 , 0.6 ], color="0.2" , lw=2 ) ax.text(8.45 , 0.15 , "20 um" , ha="center" , fontsize=8 ) ax.set_xlim(0 , 11.8 ) ax.set_ylim(-0.4 , 9.4 ) ax.axis("off" ) cell(axes[0 ], "control" ) cell(axes[1 ], "target" ) fig.suptitle("Subcellular localization of DWF4 promoter:GFP (schematic)" , y=0.98 ) fig.savefig("109-subcell.png" , dpi=200 , bbox_inches="tight" )
三、生化与湿实验曲线 3.1 Lineweaver-Burk 双倒数图
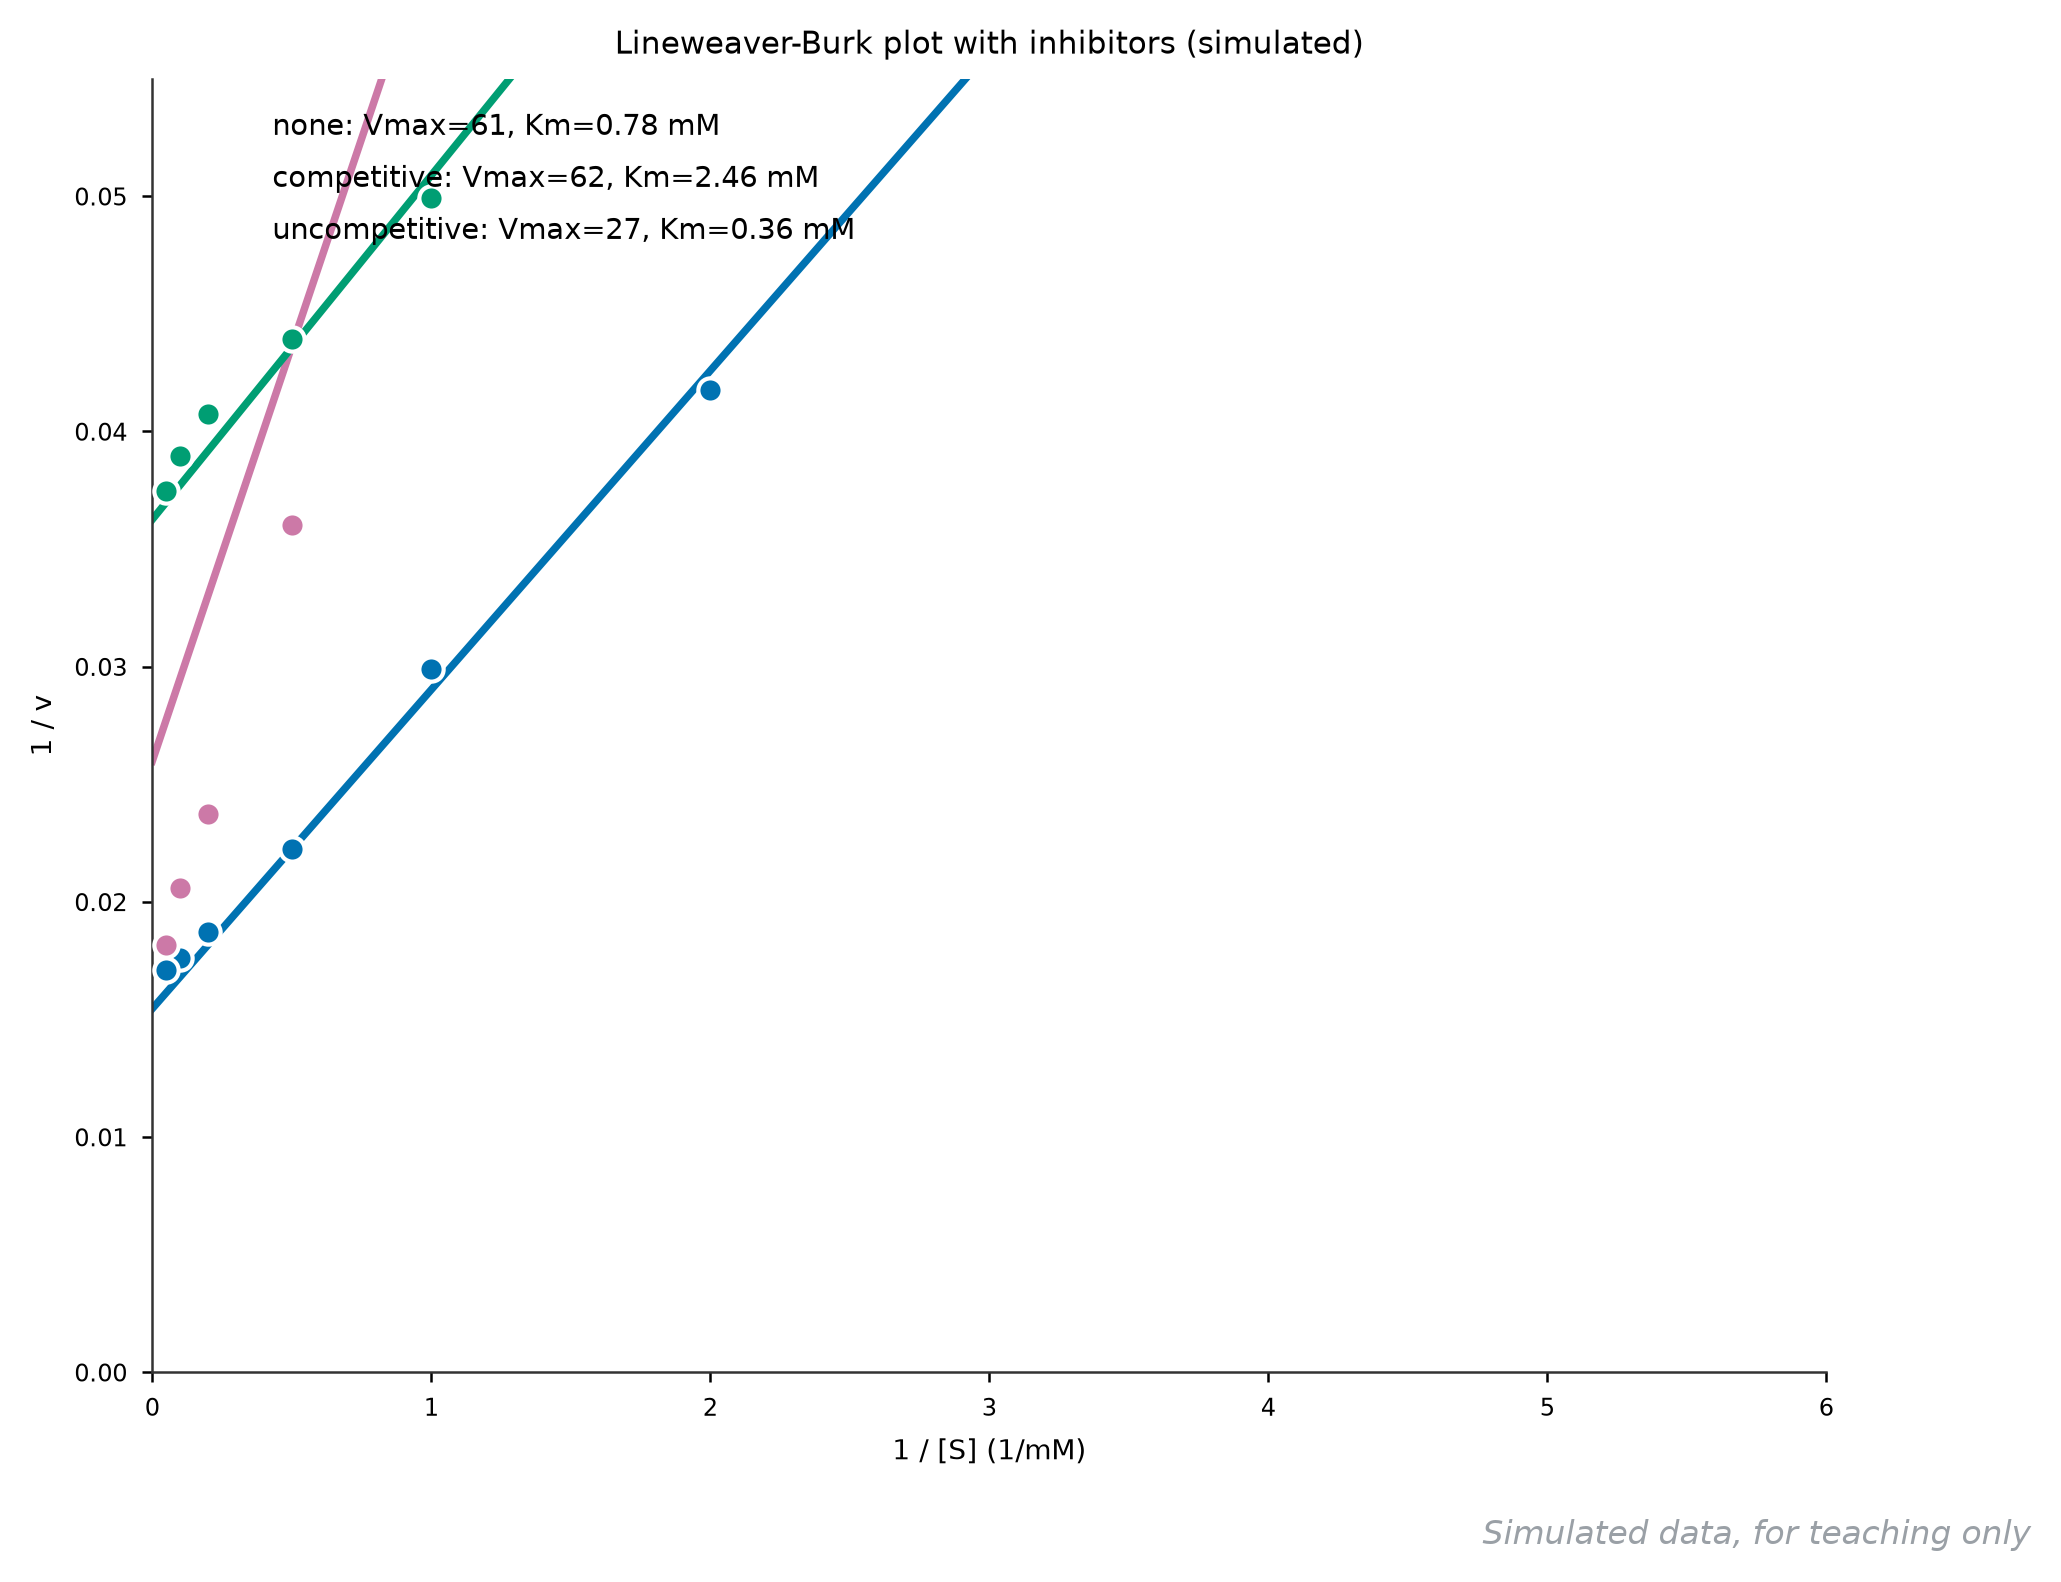
它回答什么问题 :抑制剂是竞争性还是非竞争性的——把米氏方程(第二篇图 64 的双曲线)取双倒数拉直,抑制剂的类型就从「看形状猜」变成「看直线族怎么动」。
怎么读 :横轴 1/[S]、纵轴 1/v,三条直线对应三种处理。判读口诀记直线怎么动:竞争性抑制剂与底物抢活性中心,加大底物能救回来——纵轴截距(1/Vmax)几乎不变(61 对 62)、横轴截距左移(-1/Km 从 -1.27 移到 -0.40),直线族近似在纵轴交汇;非竞争性 Vmax 掉到 27、Km 同时缩到 0.36,三条线各走各的。数据点只在高底物浓度处偏离直线是正常的(双倒数放大低浓度误差),拟合前先看原始双曲线。
用什么画 :GraphPad 的 enzyme kinetics 模块;重绘对双倒数数据线性拟合。
图注示例 :
图 110 三种条件下酶促反应的 Lineweaver-Burk 图(模拟,图例为米氏方程非线性拟合值)。无抑制剂 Vmax = 61、Km = 0.79 mM;竞争性抑制剂使 Km 增至 2.47 mM 而 Vmax 不变(62),直线族近似纵轴交汇;非竞争性抑制剂使 Vmax 降至 27、Km 缩至 0.36 mM。
展开查看:动力学数据与绘图代码 1 2 3 4 5 6 7 8 9 substrate_mM,v_no_inhibitor,v_competitive,v_uncompetitive 0.1,6.5,2.9,5.4 0.2,12.7,3.5,9.2 0.5,23.9,10.8,15.9 1.0,33.4,17.3,20.0 2.0,44.9,27.7,22.8 5.0,53.4,42.1,24.5 10.0,56.8,48.6,25.7 20.0,58.5,55.1,26.7
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy.optimize import curve_fitdf = pd.read_csv("110-michaelis-inhib.csv" ) s = df.substrate_mM.values fig, ax = plt.subplots(figsize=(7.2 , 5.6 )) xs = np.linspace(0 , 6 , 40 ) for col, cname in [("#4C72B0" , "v_no_inhibitor" ), ("#C44E52" , "v_competitive" ), ("#55A868" , "v_uncompetitive" )]: v = df[cname].values ax.scatter(1 / s, 1 / v, s=34 , color=col, edgecolors="white" , zorder=3 ) A = np.vstack([1 / s, np.ones(len (s))]).T k, b = np.linalg.lstsq(A, 1 / v, rcond=None )[0 ] ax.plot(xs, k * xs + b, color=col, lw=1.8 ) popt, _ = curve_fit(lambda x, vm, km: vm * x / (km + x), s, v, p0=[60.0 , 1.0 ]) ax.scatter([], [], s=0 , label="%s: Vmax=%.0f, Km=%.2f mM" % (cname.split("_" )[-1 ], popt[0 ], popt[1 ])) ax.set_xlim(0 , 6 ) ax.set_ylim(0 , 0.055 ) ax.set_xlabel("1 / [S] (1/mM)" ) ax.set_ylabel("1 / v" ) ax.legend(loc="upper left" , fontsize=9 ) ax.set_title("Lineweaver-Burk plot with inhibitors (simulated)" ) fig.savefig("110-lineweaver.png" , dpi=200 , bbox_inches="tight" )
3.2 DSF 差示扫描荧光熔解曲线
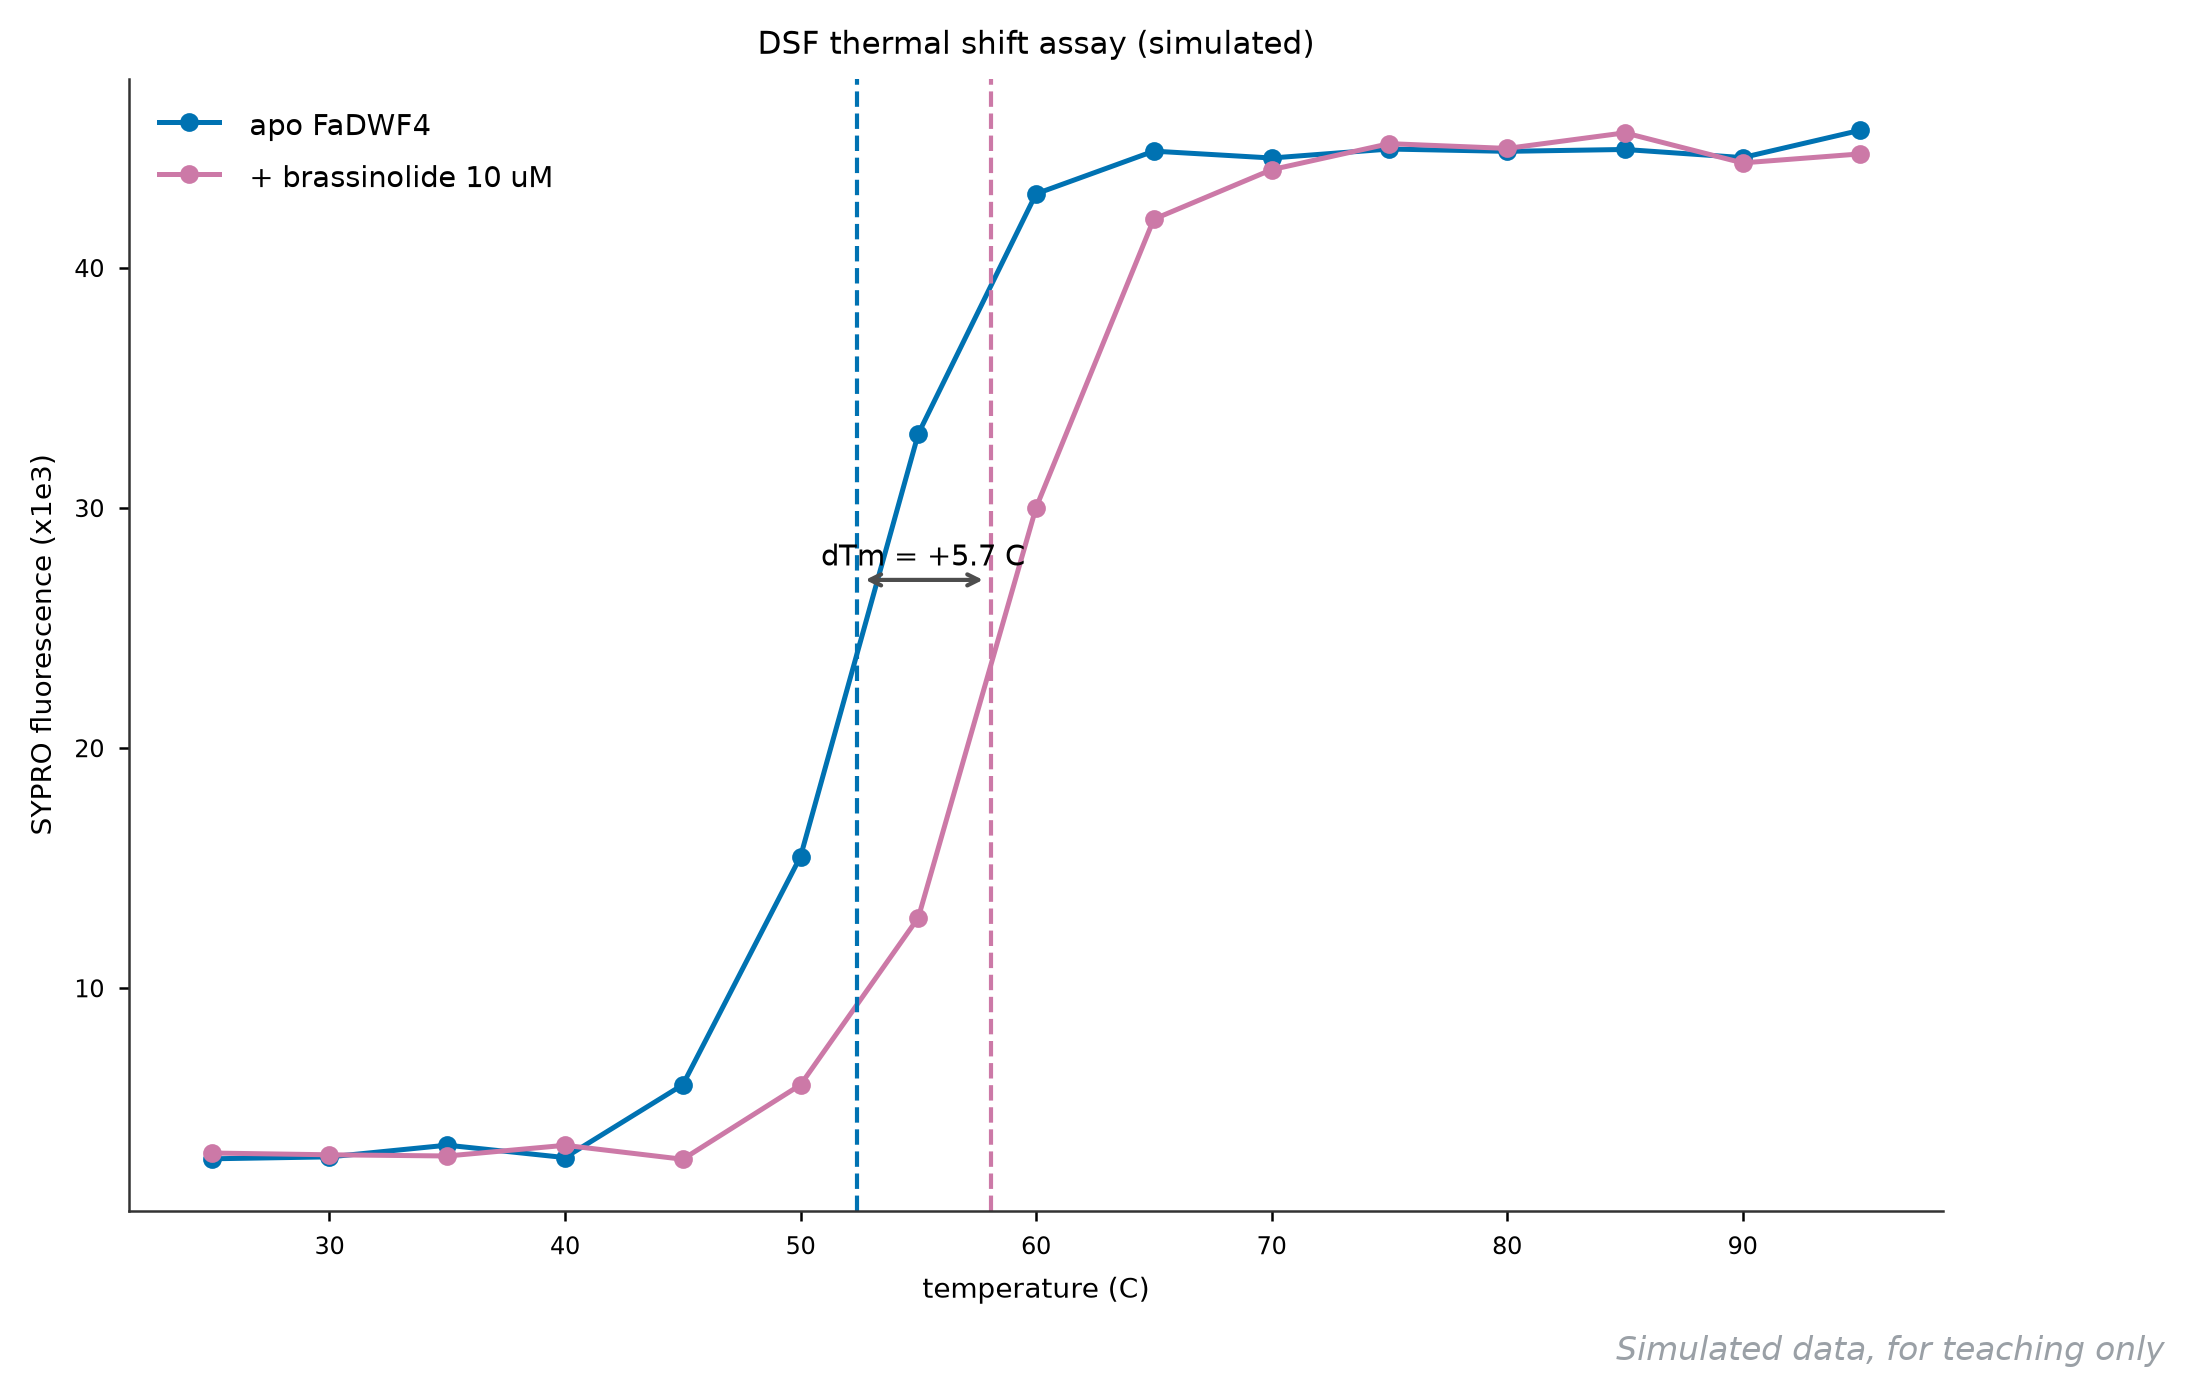
它回答什么问题 :配体结合让蛋白更稳定了吗——热位移实验(DSF/Thermal shift)的产出就是一条熔解曲线加一个 dTm,是低成本筛选结合条件的首选。
怎么读 :横轴升温程序(25-95 C),纵轴染料荧光(蛋白变性展开后疏水区暴露、染料变亮)。曲线的拐点就是熔解温度 Tm:载脂蛋白 52.4 C,加 brassinolide 后 58.1 C——dTm = +5.7 C,说明配体结合把蛋白「钉」得更稳。判读标准:dTm 大于 2 C 才算明确结合信号;正位移(变稳)与负位移(变松)都有意义,重复孔的 Tm 标准差应小于 0.5 C。
用什么画 :定量 PCR 仪或 NanoDSF 自带软件;重绘对 RFU-温度表画双曲线加 Tm 竖线。
图注示例 :
图 111 DSF 热位移实验检测 brassinolide 与 FaDWF4 的结合(模拟)。曲线为 SYPRO 荧光随升温的变化,Tm 由拐点读出:载脂 52.4 C、加配体 58.1 C,dTm = +5.7 C。
展开查看:RFU 数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 temp_c,rfu_apo,rfu_ligand 25,2887,3128 30,2967,3054 35,3454,3004 40,2938,3449 45,5970,2868 50,15478,5969 55,33087,12930 60,43082,30008 65,44860,42025 70,44573,44086 75,44947,45171 80,44851,44973 85,44929,45622 90,44591,44370 95,45729,44744
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("111-dsf.csv" ) fig, ax = plt.subplots(figsize=(7.8 , 4.9 )) ax.plot(df.temp_c, df.rfu_apo / 1000 , "-o" , ms=4 , color="#4C72B0" , label="apo FaDWF4" ) ax.plot(df.temp_c, df.rfu_ligand / 1000 , "-o" , ms=4 , color="#C44E52" , label="+ brassinolide 10 uM" ) ax.axvline(52.4 , color="#4C72B0" , ls="--" , lw=1 ) ax.axvline(58.1 , color="#C44E52" , ls="--" , lw=1 ) ax.annotate("" , xy=(58.1 , 27 ), xytext=(52.4 , 27 ), arrowprops=dict (arrowstyle="<->" , color="0.3" )) ax.text(55.2 , 27.6 , "dTm = +5.7 C" , ha="center" , fontsize=9 ) ax.set_xlabel("temperature (C)" ) ax.set_ylabel("SYPRO fluorescence (x1e3)" ) ax.legend(loc="upper left" , fontsize=9 ) ax.set_title("DSF thermal shift assay (simulated)" ) fig.savefig("111-dsf.png" , dpi=200 , bbox_inches="tight" )
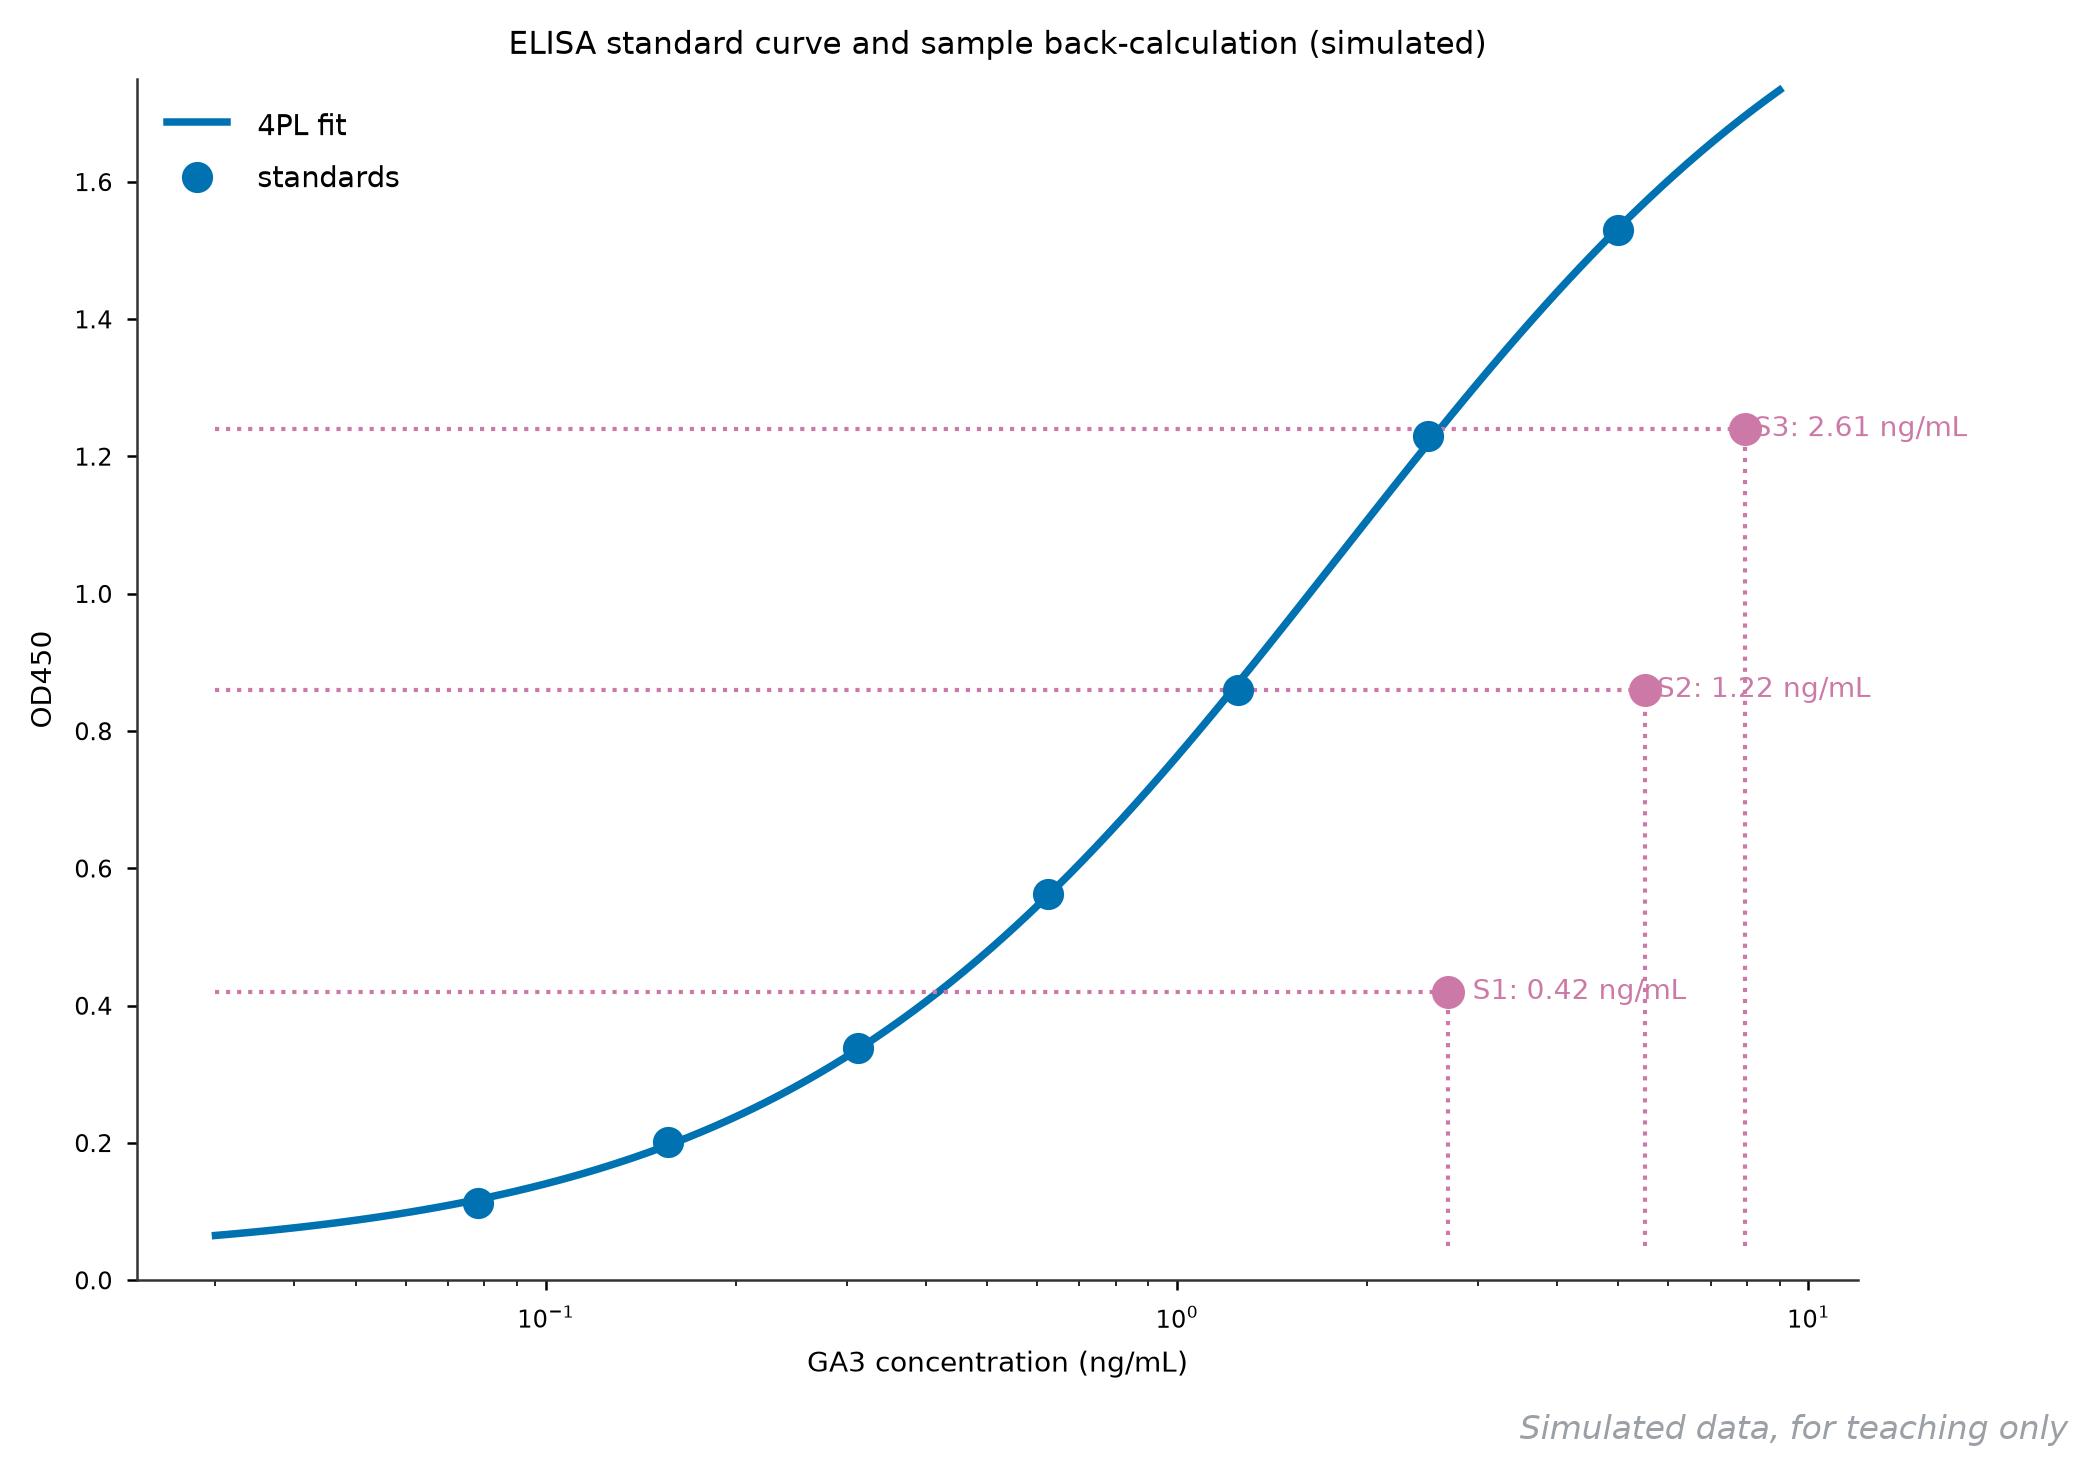
3.3 ELISA 标准曲线与回算
它回答什么问题 :激素定量最后那个数字是怎么来的——标准品的四参数 logistic(4PL)曲线是所有免疫定量的地基,未知样品的浓度是沿着曲线「查」回去的。
怎么读 :蓝点是 8 个标准品(浓度取对数轴),红线是 4PL 拟合;未知样品(红点)测得 OD 后沿水平线找到曲线、再垂直落回横轴读浓度(虚线路径):S1 = 0.42、S2 = 1.22、S3 = 2.61 ng/mL。回算的三条纪律:未知样品 OD 必须落在标准曲线的线性区间内(S3 靠近上平台,重复测定要稀释重做);每个点做复孔报 CV;曲线参数(底、顶、IC50、斜率)要写进方法,不能只贴一条线。
用什么画 :GraphPad、SoftMax;重绘 scipy.optimize.curve_fit 拟合 4PL 后按虚线路径标注。
图注示例 :
图 112 GA3 竞争法 ELISA 的标准曲线与样品回算(模拟)。蓝点为 8 个标准品,红线为 4PL 拟合;三个未知样品沿虚线路径回算,S1 = 0.42、S2 = 1.22、S3 = 2.61 ng/mL。
展开查看:标准品数据与绘图代码 1 2 3 4 5 6 7 8 9 standard_ng,od 0.000,0.067 0.078,0.112 0.156,0.201 0.312,0.339 0.625,0.562 1.250,0.859 2.500,1.230 5.000,1.529
绘图代码(Python,独立可运行;未知样品 OD 见图内标注)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy.optimize import curve_fitdf = pd.read_csv("112-elisa-std.csv" ) unk_od = np.array([0.42 , 0.86 , 1.24 ]) def fourpl (x, b, t, ic, sl ): return b + (t - b) / (1 + (x / ic) ** (-sl)) std = df.standard_ng.values od = df.od.values p, _ = curve_fit(fourpl, std[1 :], od[1 :], p0=[0.05 , 1.7 , 0.8 , 1.1 ]) xs = np.logspace(np.log10(0.03 ), np.log10(9 ), 120 ) unk_conc = p[2 ] * ((p[1 ] - p[0 ]) / (unk_od - p[0 ]) - 1 ) ** (1 / -p[3 ]) fig, ax = plt.subplots(figsize=(7.4 , 5.2 )) ax.plot(xs, fourpl(xs, *p), color="#4C72B0" , lw=1.8 , label="4PL fit" ) ax.scatter(std, od, s=42 , color="#4C72B0" , zorder=3 , label="standards" ) for i, (o, c) in enumerate (zip (unk_od, unk_conc)): ax.scatter([o * 6.4 ], [o], s=48 , color="#C44E52" , zorder=3 ) ax.plot([0.03 , o * 6.4 ], [o, o], color="#C44E52" , ls=":" , lw=1 ) ax.plot([o * 6.4 ] * 2 , [0.05 , o], color="#C44E52" , ls=":" , lw=1 ) ax.text(o * 6.4 + 0.25 , o, "S%d: %.2f ng/mL" % (i + 1 , c), fontsize=8.5 , color="#C44E52" , va="center" ) ax.set_xscale("log" ) ax.set_xlabel("GA3 concentration (ng/mL)" ) ax.set_ylabel("OD450" ) ax.set_ylim(0 , 1.75 ) ax.legend(loc="upper left" , fontsize=9 ) ax.set_title("ELISA standard curve and sample back-calculation (simulated)" ) fig.savefig("112-elisa.png" , dpi=200 , bbox_inches="tight" )
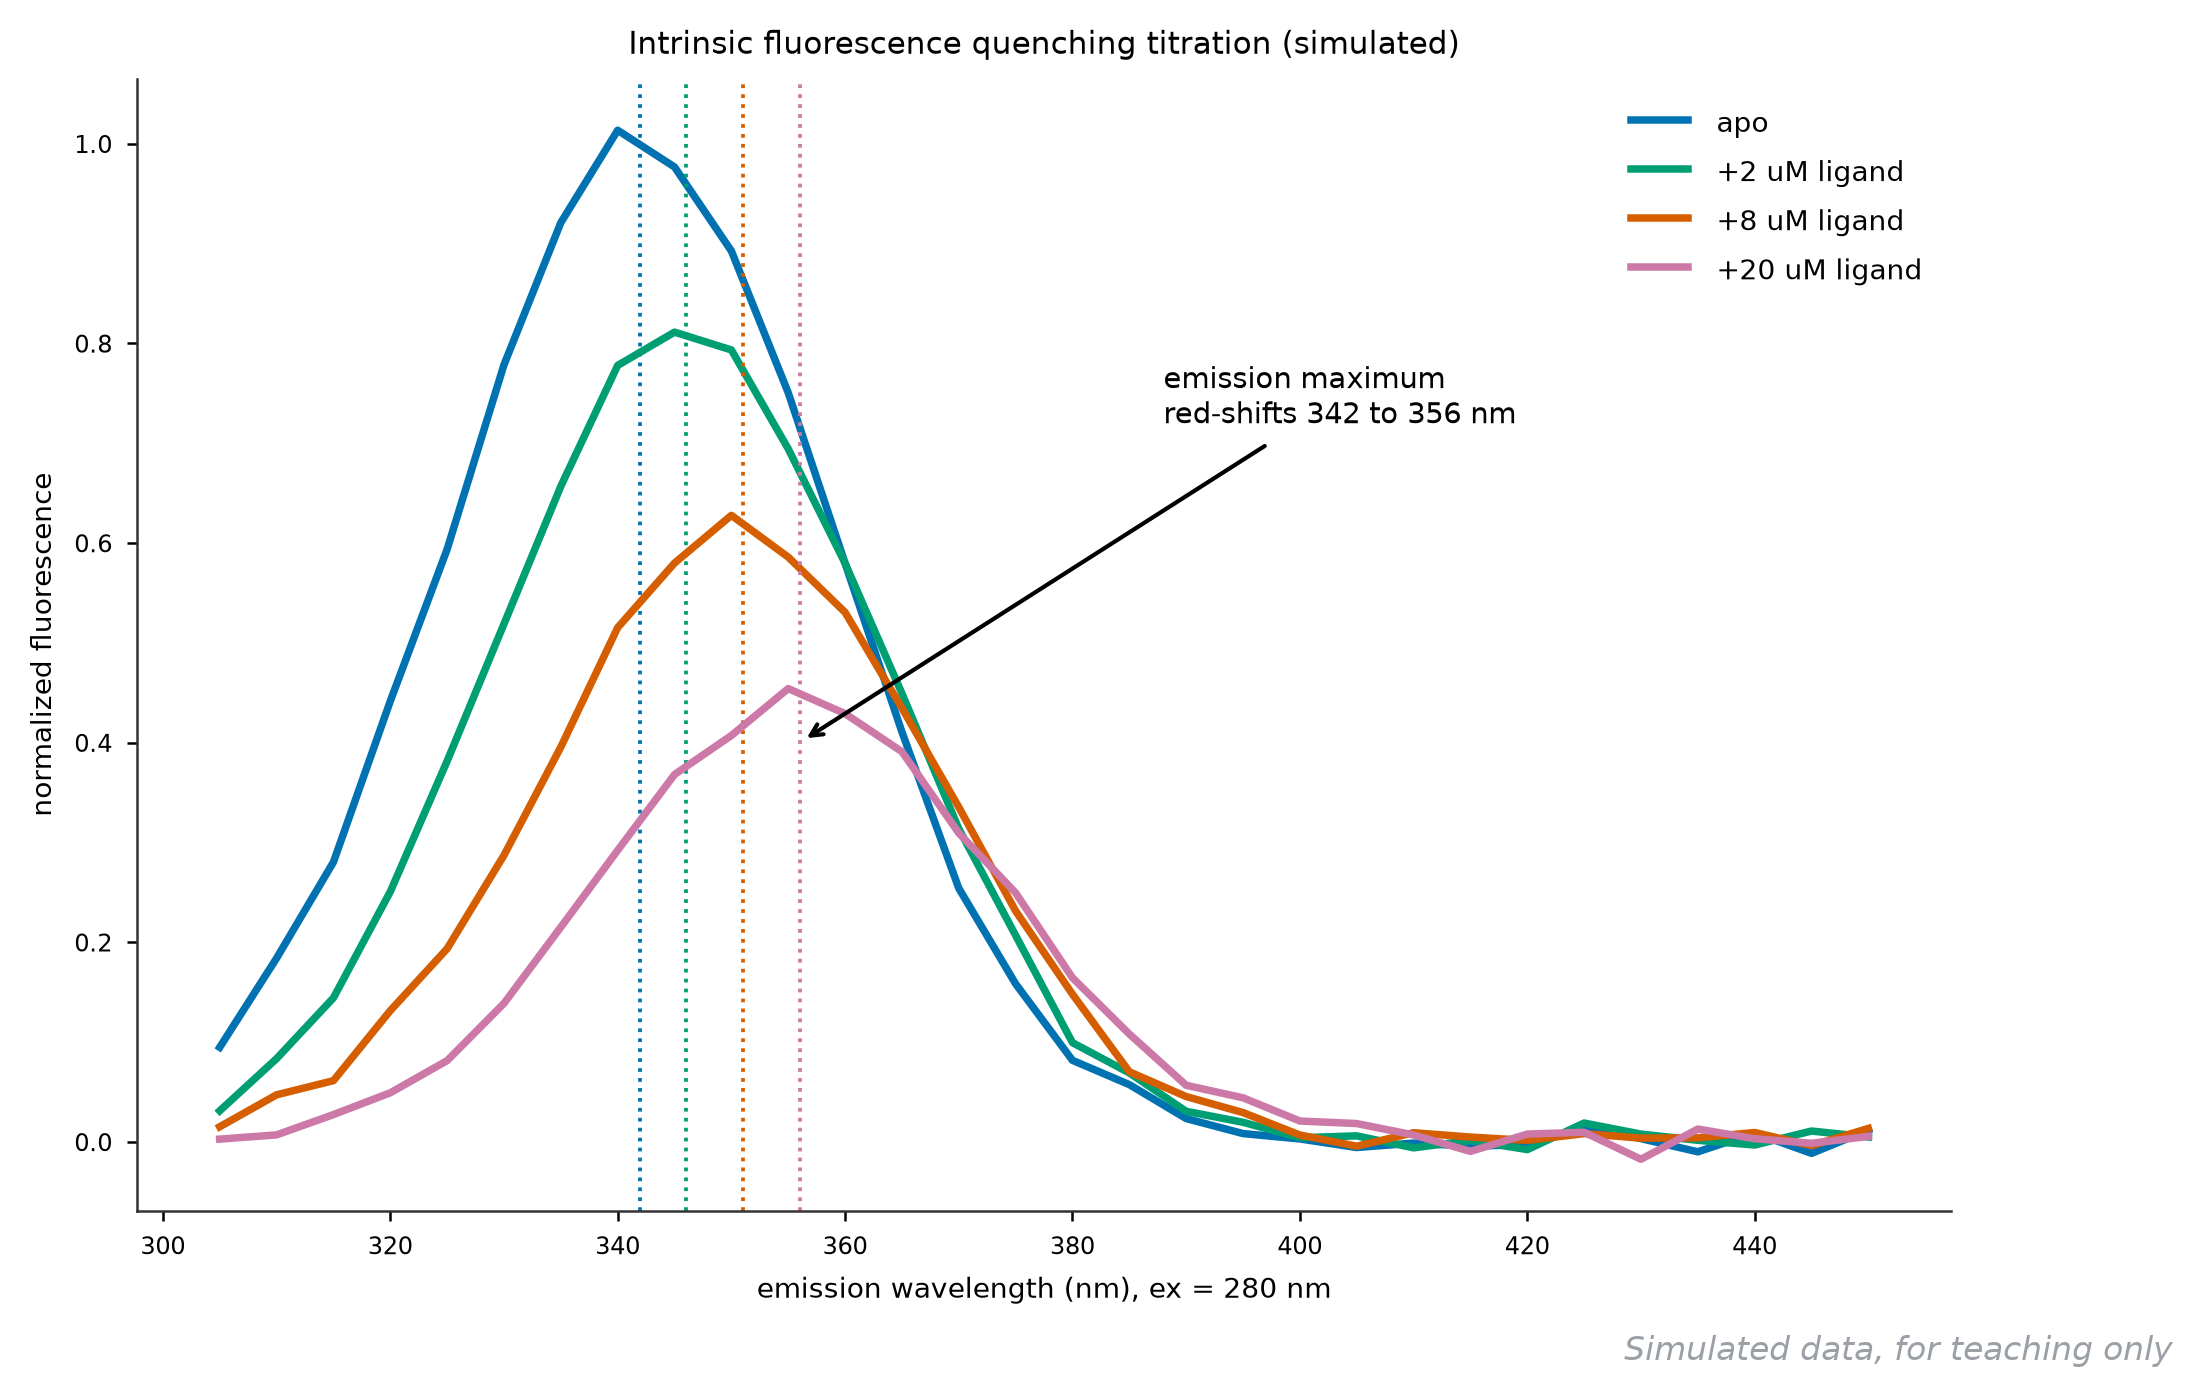
3.4 荧光发射光谱位移图
它回答什么问题 :配体滴进去,蛋白真的动了吗——内源荧光(色氨酸)的峰移与淬灭是结合证据链里最便宜的一环,常与 DSF、ITC 并排出现。
怎么读 :横轴发射波长(激发固定 280 nm),四条曲线是配体浓度梯度。读两个同时发生的现象:峰高被压(荧光淬灭,1.0 降到 0.45)和峰位红移(342 nm 移到 356 nm,色氨酸环境变疏水/构象收紧)。两者随配体浓度渐进且饱和,即可拟合结合常数 Kd;只有强度变化没有峰移,也可能是碰撞淬灭,需加lifetime实验区分。
用什么画 :荧光分光光度计自带;重绘按波长-强度宽表画多线。
图注示例 :
图 113 配体滴定下 FaDWF4 内源荧光的发射光谱(模拟,ex = 280 nm)。配体 0-20 uM 梯度下发射峰由 342 nm 红移至 356 nm,强度淬灭至 45%,呈可饱和结合特征。
展开查看:光谱数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 wavelength_nm,apo,add2,add8,add20 305,0.095,0.031,0.015,0.003 310,0.184,0.083,0.047,0.007 315,0.280,0.144,0.061,0.027 320,0.442,0.251,0.131,0.049 325,0.594,0.382,0.194,0.081 330,0.779,0.519,0.287,0.139 335,0.921,0.657,0.396,0.215 340,1.014,0.778,0.515,0.292 345,0.977,0.811,0.580,0.368 350,0.893,0.793,0.628,0.407 355,0.751,0.694,0.586,0.454 360,0.580,0.580,0.531,0.429 365,0.411,0.449,0.435,0.391 370,0.254,0.314,0.335,0.309 375,0.158,0.207,0.231,0.249 380,0.082,0.099,0.148,0.164 385,0.057,0.069,0.070,0.108 390,0.023,0.031,0.045,0.057 395,0.008,0.020,0.029,0.044 400,0.003,0.004,0.007,0.021 405,-0.006,0.006,-0.004,0.018 410,-0.001,-0.006,0.009,0.007 415,-0.004,0.001,0.005,-0.010 420,-0.003,-0.008,0.001,0.008 425,0.015,0.019,0.008,0.010 430,0.003,0.008,0.004,-0.017 435,-0.010,0.002,0.004,0.013 440,0.009,-0.003,0.009,0.003 445,-0.012,0.011,-0.004,-0.001 450,0.012,0.005,0.013,0.005
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("113-fluorescence.csv" ) cols = {"apo" : "#4C72B0" , "add2" : "#55A868" , "add8" : "#DD8452" , "add20" : "#C44E52" } fig, ax = plt.subplots(figsize=(7.8 , 4.9 )) for c, col in cols.items(): lab = "apo" if c == "apo" else "+%s uM ligand" % c.replace("add" , "" ) ax.plot(df.wavelength_nm, df[c], color=col, lw=1.8 , label=lab) ax.annotate("emission maximum\nred-shifts 342 to 356 nm" , (356 , 0.40 ), (388 , 0.72 ), fontsize=9 , arrowprops=dict (arrowstyle="->" , lw=1 )) ax.set_xlabel("emission wavelength (nm), ex = 280 nm" ) ax.set_ylabel("normalized fluorescence" ) ax.legend(fontsize=8.5 ) ax.set_title("Intrinsic fluorescence quenching titration (simulated)" ) fig.savefig("113-fluor-shift.png" , dpi=200 , bbox_inches="tight" )
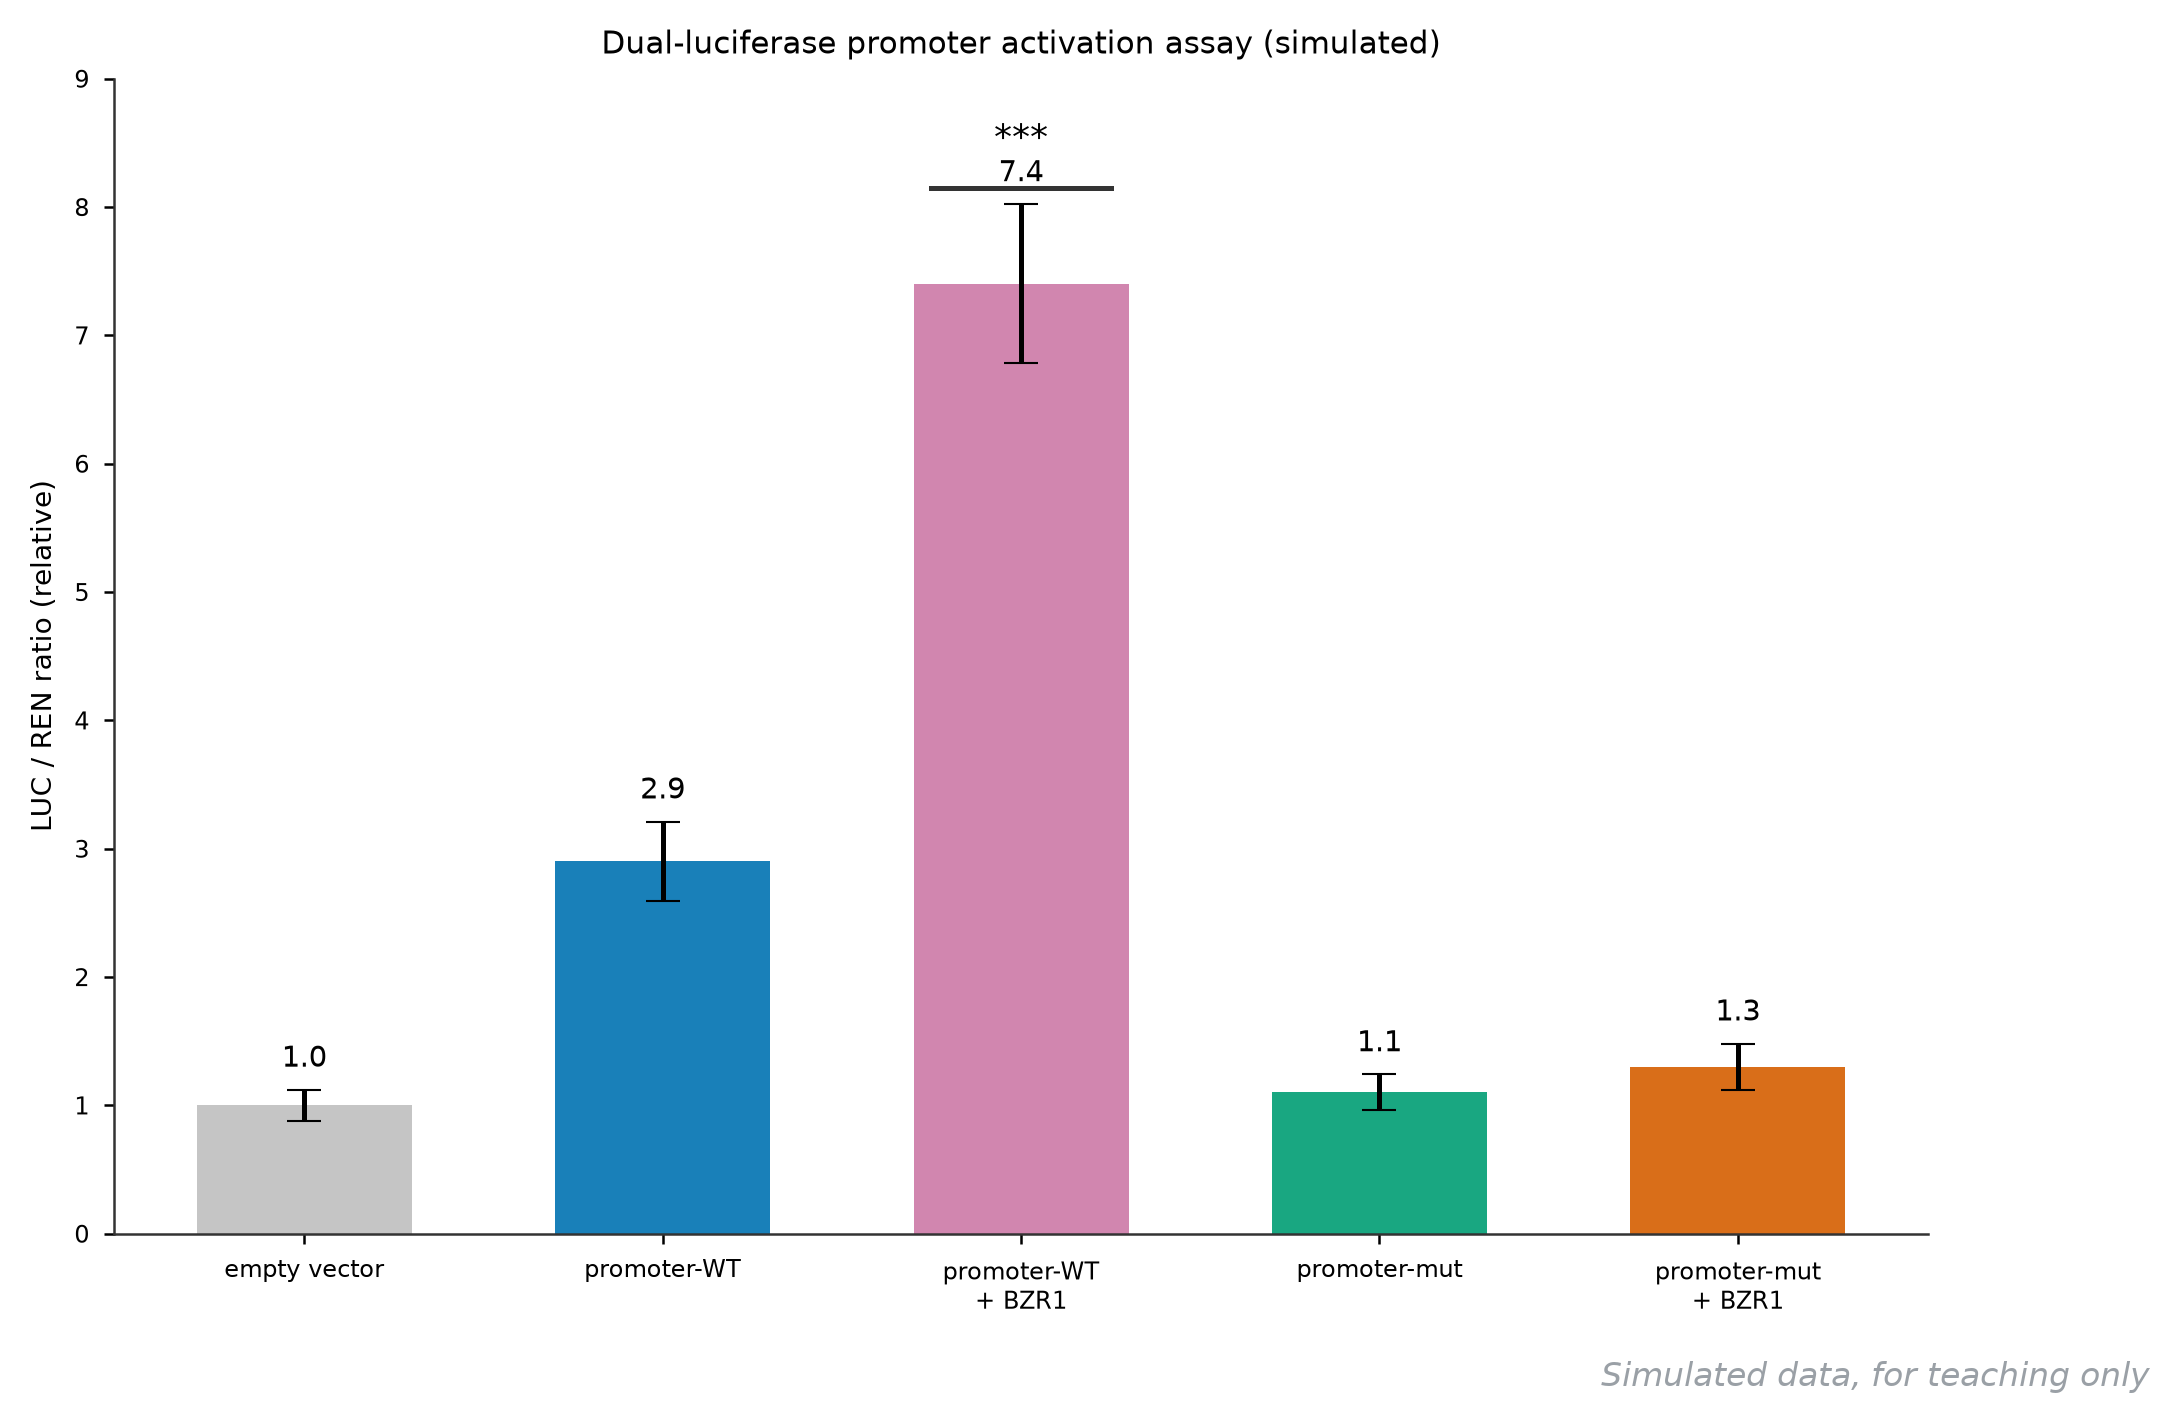
3.5 双荧光素酶报告柱状图
它回答什么问题 :转录因子是不是真的激活了这个启动子、靠不靠那个位点——双荧光素酶(LUC/REN)是启动子-转录因子互作验证的顶梁柱,论证结构全在五根柱子里。
怎么读 :纵轴是 LUC/REN 归一化比值(REN 内参先扣掉转化效率差异)。读论证链:promoter-WT 单独有基础活性(2.9);加 BZR1 效应子冲到 7.4(***,激活);换成 site-mutated 启动子后基础活性掉回 1.1、加 BZR1 也只有 1.3——位点突变既杀基础活性又杀诱导,证明该基序是响应必需。对照的完整度(空载体归一化、突变对照、无效应子对照)决定这张图的说服力。
用什么画 :Promega Dual-Luciferase 仪出原始读数,作图就是带误差线的柱状图加显著性标记。
图注示例 :
图 114 双荧光素酶验证 BZR1 对 DWF4 启动子的激活(模拟)。柱高为 LUC/REN 比值(均值 ± 标准差,n = 6);野生型启动子被 BZR1 激活 2.6 倍(***,p < 0.001),基序突变后激活消失。
展开查看:数据与绘图代码 1 2 3 4 5 6 construct,ratio,sd empty vector,1.00,0.12 promoter-WT,2.90,0.31 promoter-WT + BZR1,7.40,0.62 promoter-mut,1.10,0.14 promoter-mut + BZR1,1.30,0.18
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("114-luciferase.csv" ) labels = ["empty vector" , "promoter-WT" , "promoter-WT\n+ BZR1" , "promoter-mut" , "promoter-mut\n+ BZR1" ] CAT = ["0.75" , "#4C72B0" , "#C44E52" , "#55A868" , "#DD8452" ] fig, ax = plt.subplots(figsize=(7.8 , 5.0 )) ax.bar(labels, df.ratio, color=CAT, alpha=0.9 , width=0.6 , yerr=df.sd, capsize=4 ) for i, (r, s_) in enumerate (zip (df.ratio, df.sd)): ax.text(i, r + s_ + 0.18 , "%.1f" % r, ha="center" , fontsize=9 ) ax.annotate("***" , (2 , 8.45 ), ha="center" , fontsize=11 ) ax.plot([1.75 , 2.25 ], [8.15 , 8.15 ], color="0.2" , lw=1.2 ) ax.set_ylabel("LUC / REN ratio (relative)" ) ax.set_ylim(0 , 9 ) ax.set_title("Dual-luciferase promoter activation assay (simulated)" ) fig.savefig("114-luciferase.png" , dpi=200 , bbox_inches="tight" )
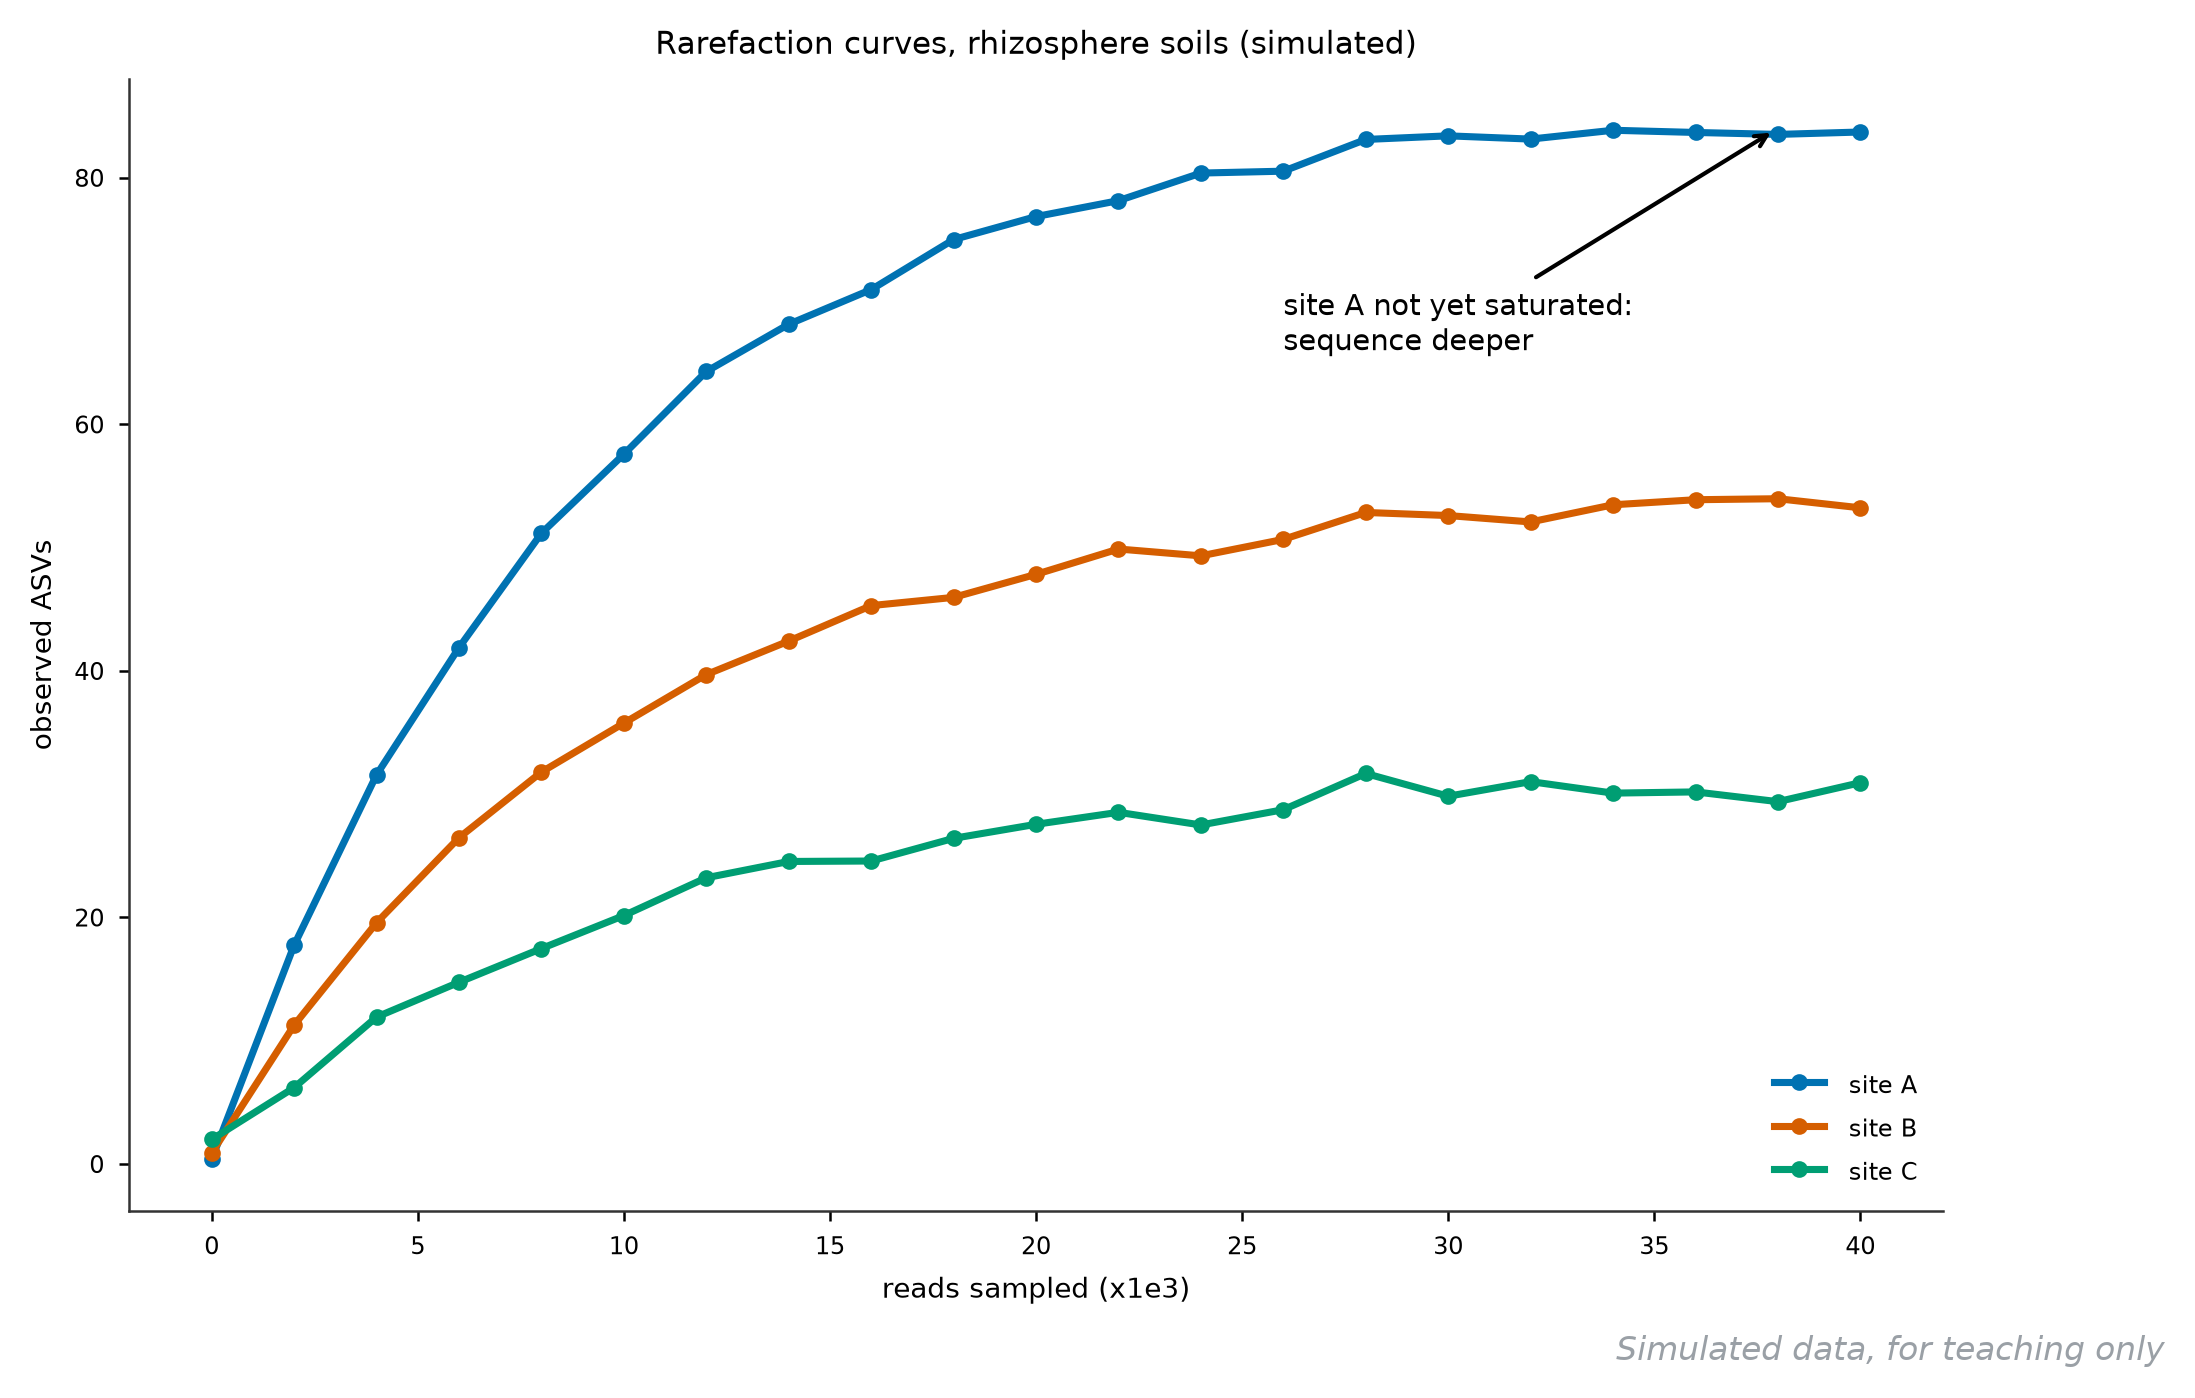
四、微生物与生态 4.1 稀疏化曲线
它回答什么问题 :每个样本的测序量够不够、多样性还能不能再挖出来——alpha 多样性比较前必须先过这一关,否则「物种多」可能只是「测得多」。
怎么读 :横轴抽样 reads 数,纵轴在该深度下重复抽样能观测到的 ASV 数。三条曲线前段陡(新 reads 不断带来新物种)、后段缓(物种池接近抽干)。本例 site A 到 4 万 reads 仍有爬升(83 附近还在涨,图内标注「未饱和、值得加测」),site B 在 52-54 波动、site C 在 30 上下已平台。判读口诀:比较多样性的样本必须都落在平台区;没平台的样本要么加测,要么稀释到共同深度再算。
用什么画 :QIIME2 的 qiime diversity alpha-rarefaction、R vegan 的 rarecurve;重绘按深度-ASV 表画多线。
图注示例 :
图 115 三个根际土壤样点的稀疏化曲线(模拟)。横轴为抽样 reads 数,纵轴为观测 ASV 数;site A 至 40,000 reads 仍未完全饱和(83.7 且持续上升),site B(54.0 附近)与 site C(约 30)已进入平台。
展开查看:稀疏化数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 reads,site A,site B,site C 0,0.4,0.9,2.0 2000,17.7,11.3,6.2 4000,31.6,19.6,11.9 6000,41.9,26.5,14.7 8000,51.2,31.8,17.5 10000,57.6,35.8,20.1 12000,64.3,39.7,23.2 14000,68.1,42.4,24.5 16000,70.9,45.3,24.6 18000,75.0,45.9,26.4 20000,76.8,47.8,27.5 22000,78.1,49.9,28.5 24000,80.4,49.3,27.5 26000,80.5,50.7,28.7 28000,83.1,52.8,31.7 30000,83.4,52.6,29.8 32000,83.1,52.1,31.0 34000,83.8,53.5,30.1 36000,83.7,53.9,30.2 38000,83.5,54.0,29.4 40000,83.7,53.2,30.9
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("115-rarefaction.csv" ) CAT = {"site A" : "#4C72B0" , "site B" : "#DD8452" , "site C" : "#55A868" } fig, ax = plt.subplots(figsize=(7.8 , 4.9 )) for c, col in CAT.items(): ax.plot(df.reads / 1000 , df[c], "-o" , ms=3.5 , color=col, lw=1.7 , label=c) ax.annotate("site A not yet saturated:\nsequence deeper" , (38 , 84 ), (22 , 66 ), fontsize=9 , arrowprops=dict (arrowstyle="->" , lw=1 )) ax.set_xlabel("reads sampled (x1e3)" ) ax.set_ylabel("observed ASVs" ) ax.legend(fontsize=9 ) ax.set_title("Rarefaction curves, rhizosphere soils (simulated)" ) fig.savefig("115-rarefaction.png" , dpi=200 , bbox_inches="tight" )
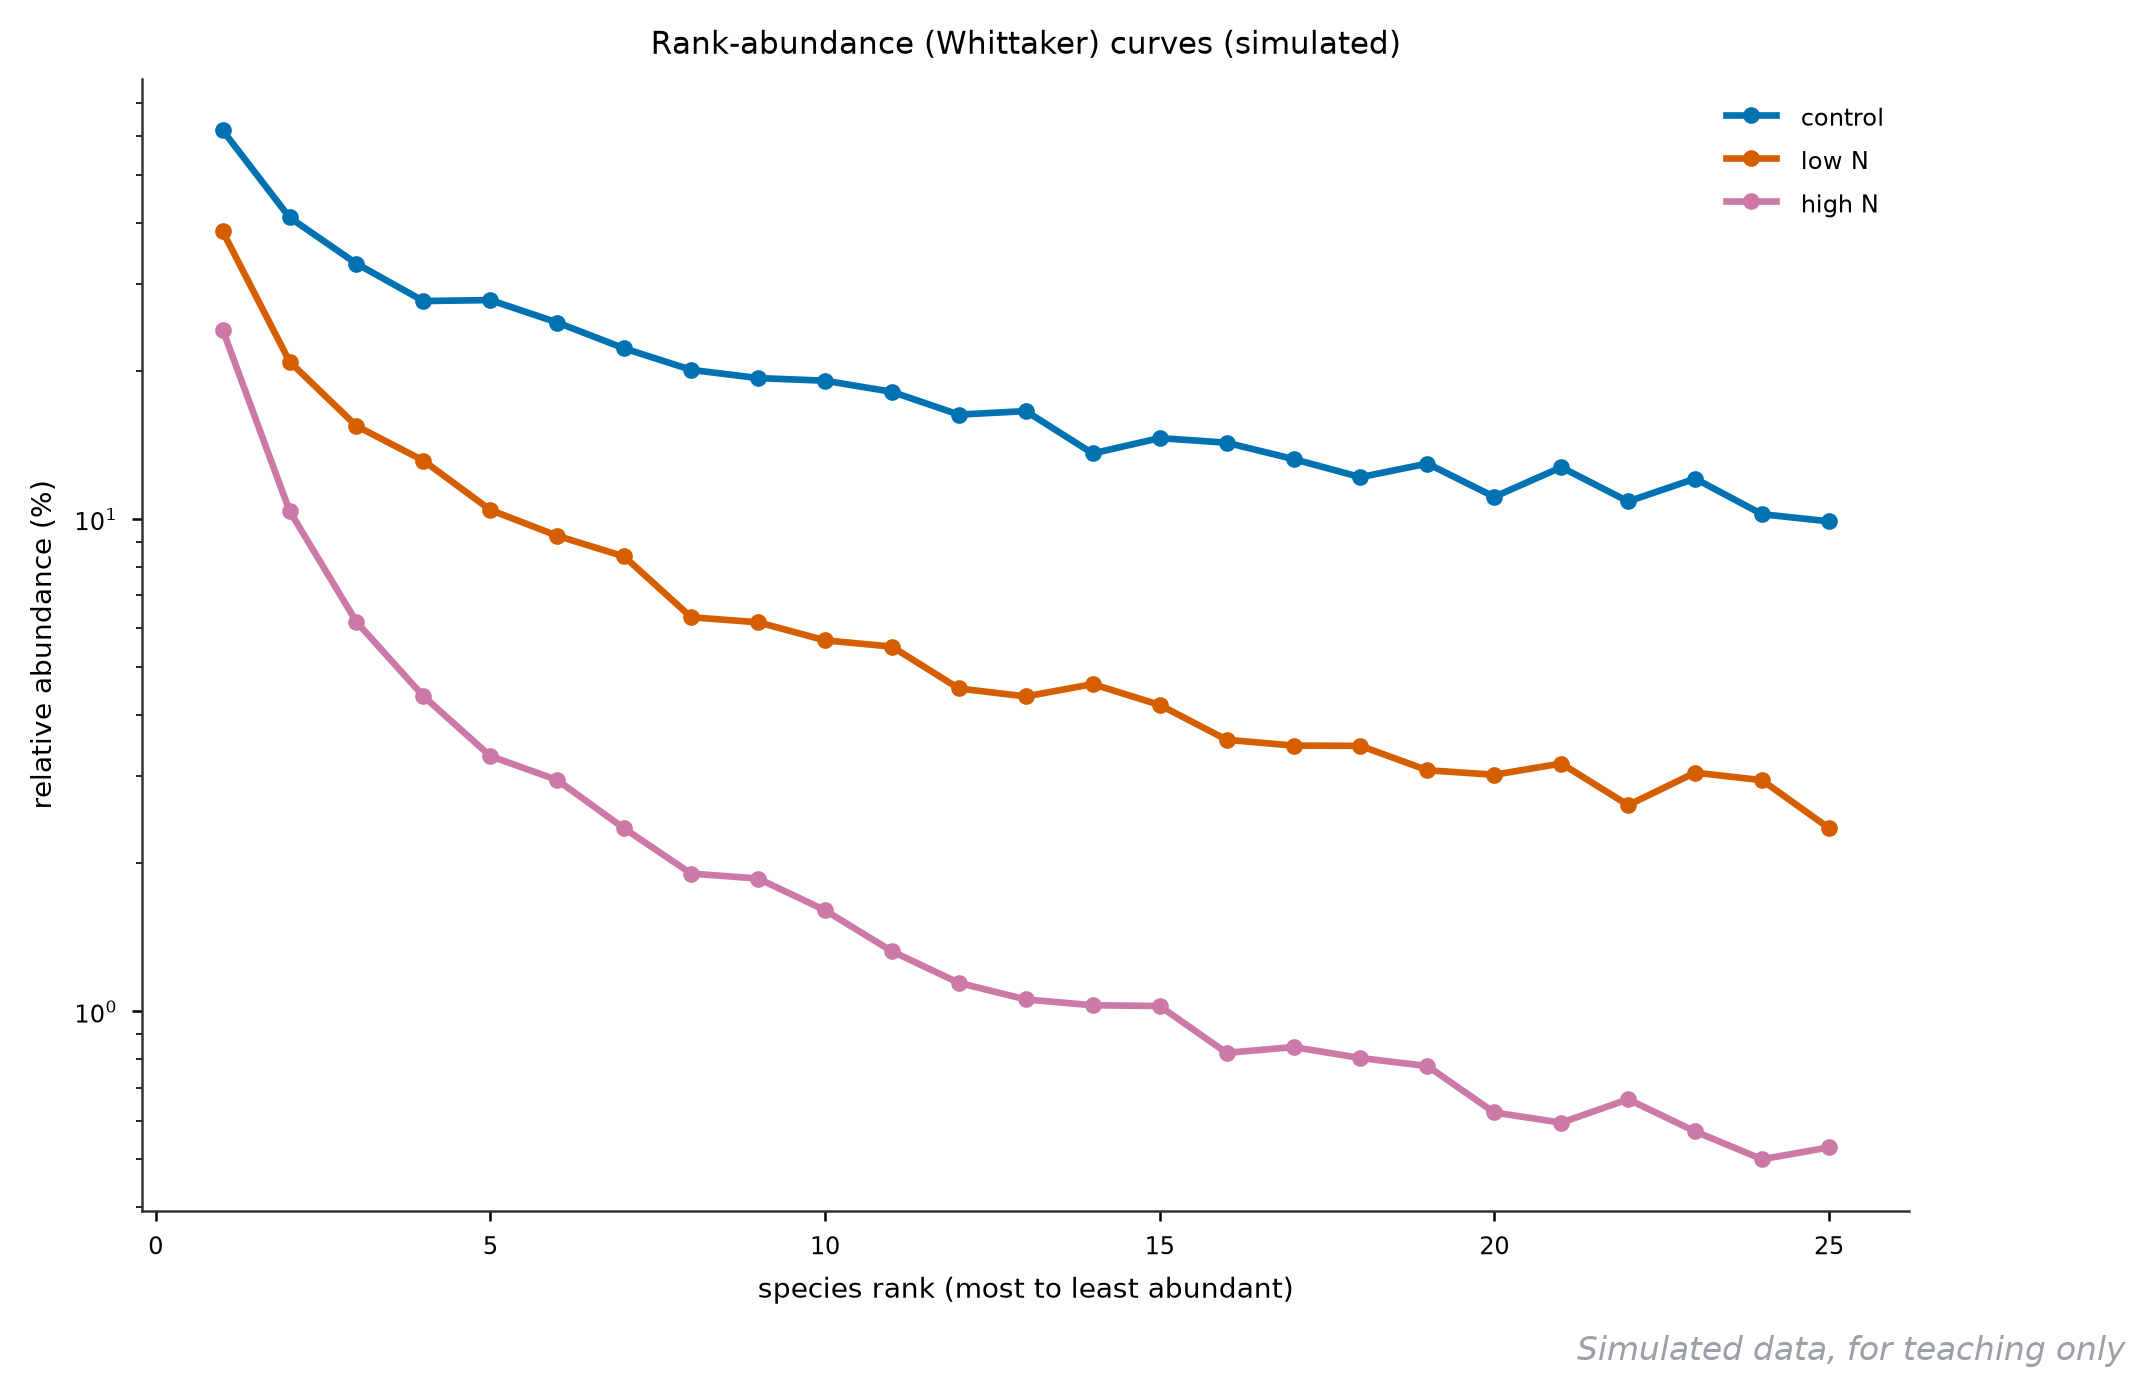
4.2 rank-abundance 曲线
它回答什么问题 :群落的优势度结构——是少数物种说了算,还是雨露均沾。稀疏化回答「够不够」,这张回答「匀不匀」,一对好搭子。
怎么读 :横轴把物种按丰度从高到低排的秩,纵轴相对丰度(常取对数)。曲线的起点高度 是最强优势种的分量:treatment A 首位物种占 61.7%,C 只有 24.3%;曲线的下降陡度 是均匀度:A 掉得快(高优势模式),C 平缓拖出长尾(均匀模式)。生态学上对应的指数就是 Simpson/Shannon——这张图是它们的「形状版」,一张图同时看到优势度和丰富度。
用什么画 :R vegan 的 radfit;重绘对秩-丰度表画多线。
图注示例 :
图 116 三种处理下根际细菌的 rank-abundance 曲线(模拟,各取前 25 个 ASV)。处理 A 首位优势种占 61.7% 且曲线陡降,为高优势度结构;处理 C 首位仅 24.3%、长尾平缓,群落更均匀。
展开查看:秩-丰度数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 rank,treatment_A,treatment_B,treatment_C 1,61.66,38.43,24.27 2,41.00,20.90,10.39 3,33.04,15.46,6.18 4,27.73,13.15,4.37 5,27.86,10.44,3.30 6,25.08,9.25,2.95 7,22.22,8.40,2.35 8,20.10,6.32,1.90 9,19.34,6.17,1.86 10,19.10,5.67,1.60 11,18.14,5.51,1.32 12,16.30,4.53,1.14 13,16.57,4.36,1.06 14,13.59,4.62,1.03 15,14.61,4.19,1.03 16,14.30,3.56,0.82 17,13.24,3.47,0.85 18,12.17,3.46,0.80 19,12.97,3.09,0.77 20,11.10,3.02,0.62 21,12.75,3.19,0.59 22,10.86,2.62,0.66 23,12.08,3.05,0.57 24,10.23,2.95,0.50 25,9.89,2.36,0.53
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("116-rank-abundance.csv" ) CAT = {"treatment_A" : "#4C72B0" , "treatment_B" : "#DD8452" , "treatment_C" : "#55A868" } fig, ax = plt.subplots(figsize=(7.6 , 4.9 )) for c, col in CAT.items(): top = df[c].iloc[0 ] ax.plot(df["rank" ], df[c], "-o" , ms=3.5 , color=col, lw=1.6 , label="%s (top %.1f%%)" % (c.replace("_" , " " ), top)) ax.set_yscale("log" ) ax.set_xlabel("species rank" ) ax.set_ylabel("relative abundance (%)" ) ax.legend(fontsize=9 ) ax.set_title("Rank-abundance (Whittaker) curves (simulated)" ) fig.savefig("116-rank-abund.png" , dpi=200 , bbox_inches="tight" )
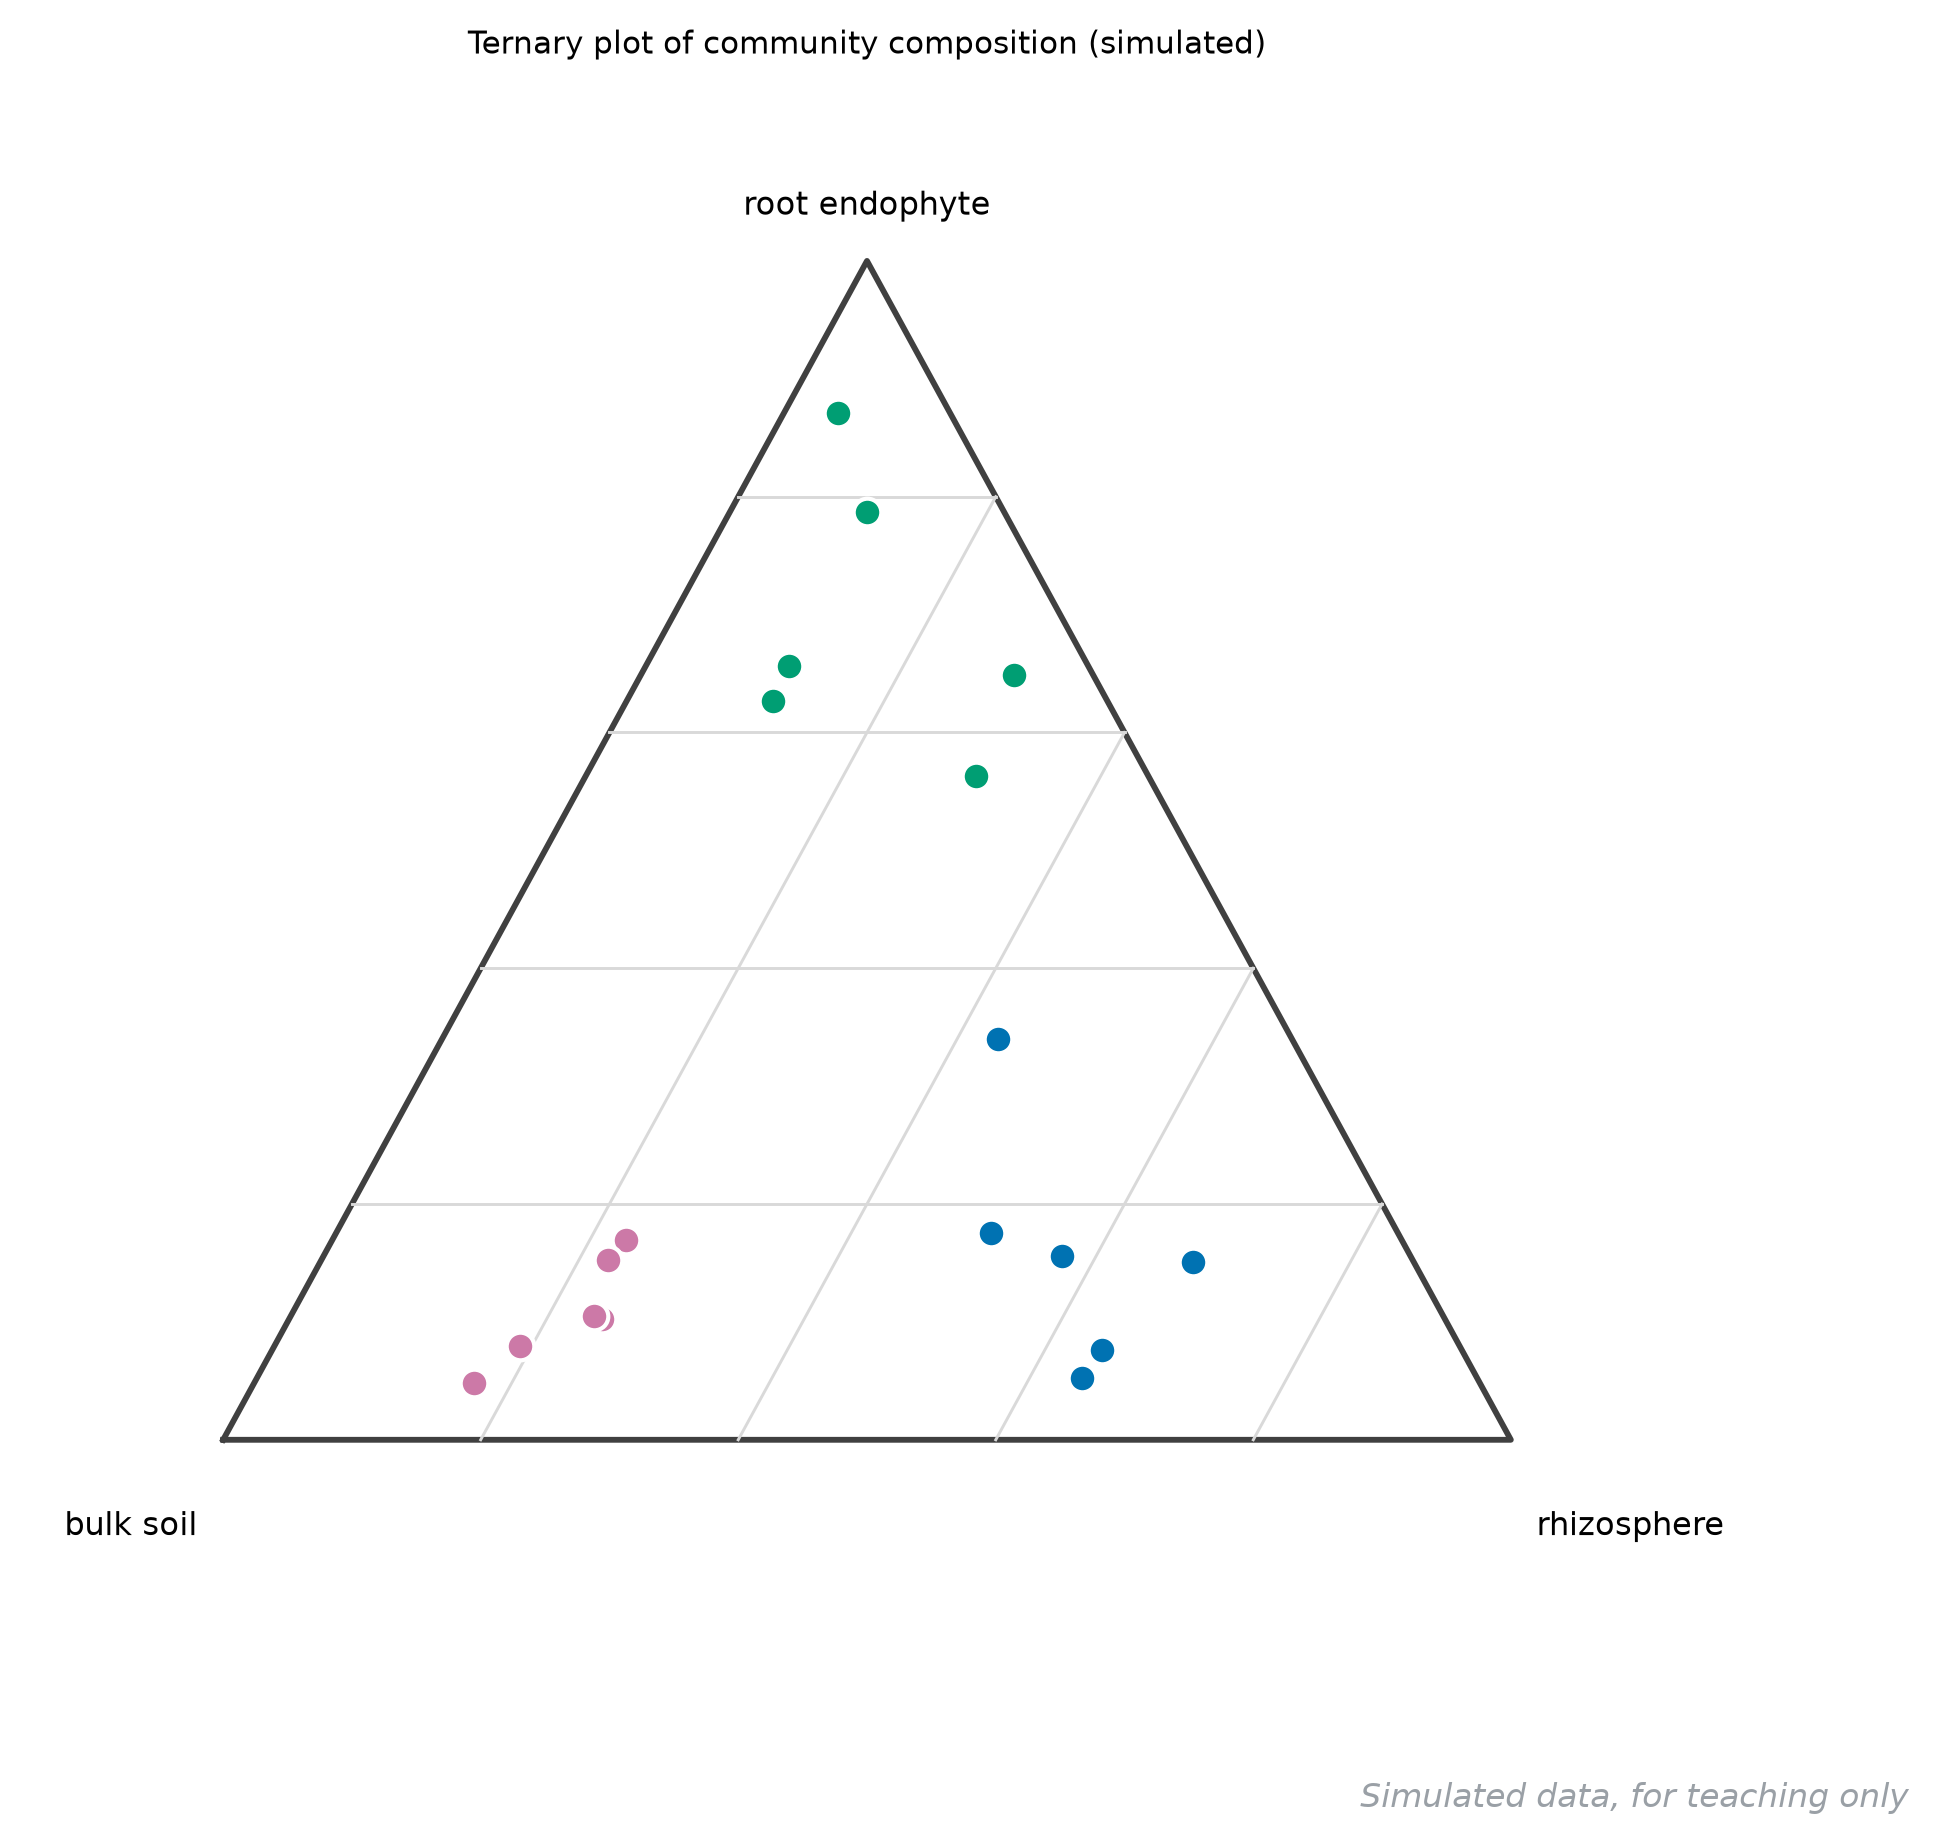
4.3 三元相图
它回答什么问题 :每个样本在三个区室(土体、根际、根内)之间的组成比例——植物微生物组研究「梯度假说」的标准图:从土到根,一路过滤出特定类群。
怎么读 :三角形三个顶点各代表 100% 属于某一区室端(顶=根内 endophyte、左下=土体 bulk soil、右下=根际 rhizosphere),点在三角形内的位置就是三个比例的合成。本例土体样 B1-B6 挤向左下角(bulk 占 0.60-0.78),根际样 R1-R6 落在右下-中部带(rhizo 0.43-0.68),根内样 E1-E6 拉向顶点(endo 0.56-0.87,其中 E3 高达 0.87)——梯度清晰。特别注意「跨界」的点:R5(0.23/0.43/0.34)根内比例偏高,值得单独看它的物种组成是不是混入了根内优势菌。
用什么画 :R 的 Ternary 包、Python 的 python-ternary;重绘把三元坐标线性变换到二维再散点。
图注示例 :
图 117 根-土连续体 18 个样本群落组成的三元相图(模拟)。顶点分别为根内(上)、土体(左下)、根际(右下);土体、根际、根内样本各自聚向对应顶点,梯度清晰;R5 的根内比例(34%)高于根际组其余样本。
展开查看:组成数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 sample,frac_bulk,frac_rhizo,frac_endo B1,0.60,0.23,0.17 B2,0.66,0.24,0.10 B3,0.73,0.19,0.08 B4,0.62,0.22,0.15 B5,0.78,0.17,0.05 B6,0.66,0.23,0.11 R1,0.28,0.64,0.08 R2,0.31,0.64,0.05 R3,0.17,0.68,0.15 R4,0.27,0.57,0.16 R5,0.23,0.43,0.34 R6,0.32,0.51,0.17 E1,0.06,0.29,0.65 E2,0.13,0.30,0.56 E3,0.09,0.04,0.87 E4,0.23,0.11,0.66 E5,0.11,0.11,0.79 E6,0.26,0.11,0.63
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("117-ternary.csv" ) def tri (b, r, e ): return b + r / 2 , e * np.sqrt(3 ) / 2 fig, ax = plt.subplots(figsize=(7.4 , 6.6 )) th = np.linspace(0 , 2 * np.pi, 4 ) + np.pi / 2 ax.plot(np.r_[np.cos(th), np.cos(th[0 ])], np.r_[np.sin(th), np.sin(th[0 ])], color="0.35" , lw=1.4 ) for i, r in df.iterrows(): x, y = tri(r.frac_bulk, r.frac_rhizo, r.frac_endo) g = r.sample[0 ] col = {"B" : "#4C72B0" , "R" : "#DD8452" , "E" : "#55A868" }[g] ax.scatter([x], [y], s=52 , color=col, edgecolors="white" , zorder=3 ) ax.text(x, y + 0.035 , r.sample, ha="center" , fontsize=8 ) ax.text(0.5 , 0.90 , "root endophyte" , ha="center" , fontsize=10 ) ax.text(-0.02 , -0.07 , "bulk soil" , ha="right" , fontsize=10 ) ax.text(1.02 , -0.07 , "rhizosphere" , ha="left" , fontsize=10 ) ax.set_xlim(-0.15 , 1.15 ) ax.set_ylim(-0.14 , 1.0 ) ax.axis("equal" ) ax.axis("off" ) ax.set_title("Ternary plot of community composition (simulated)" ) fig.savefig("117-ternary.png" , dpi=200 , bbox_inches="tight" )
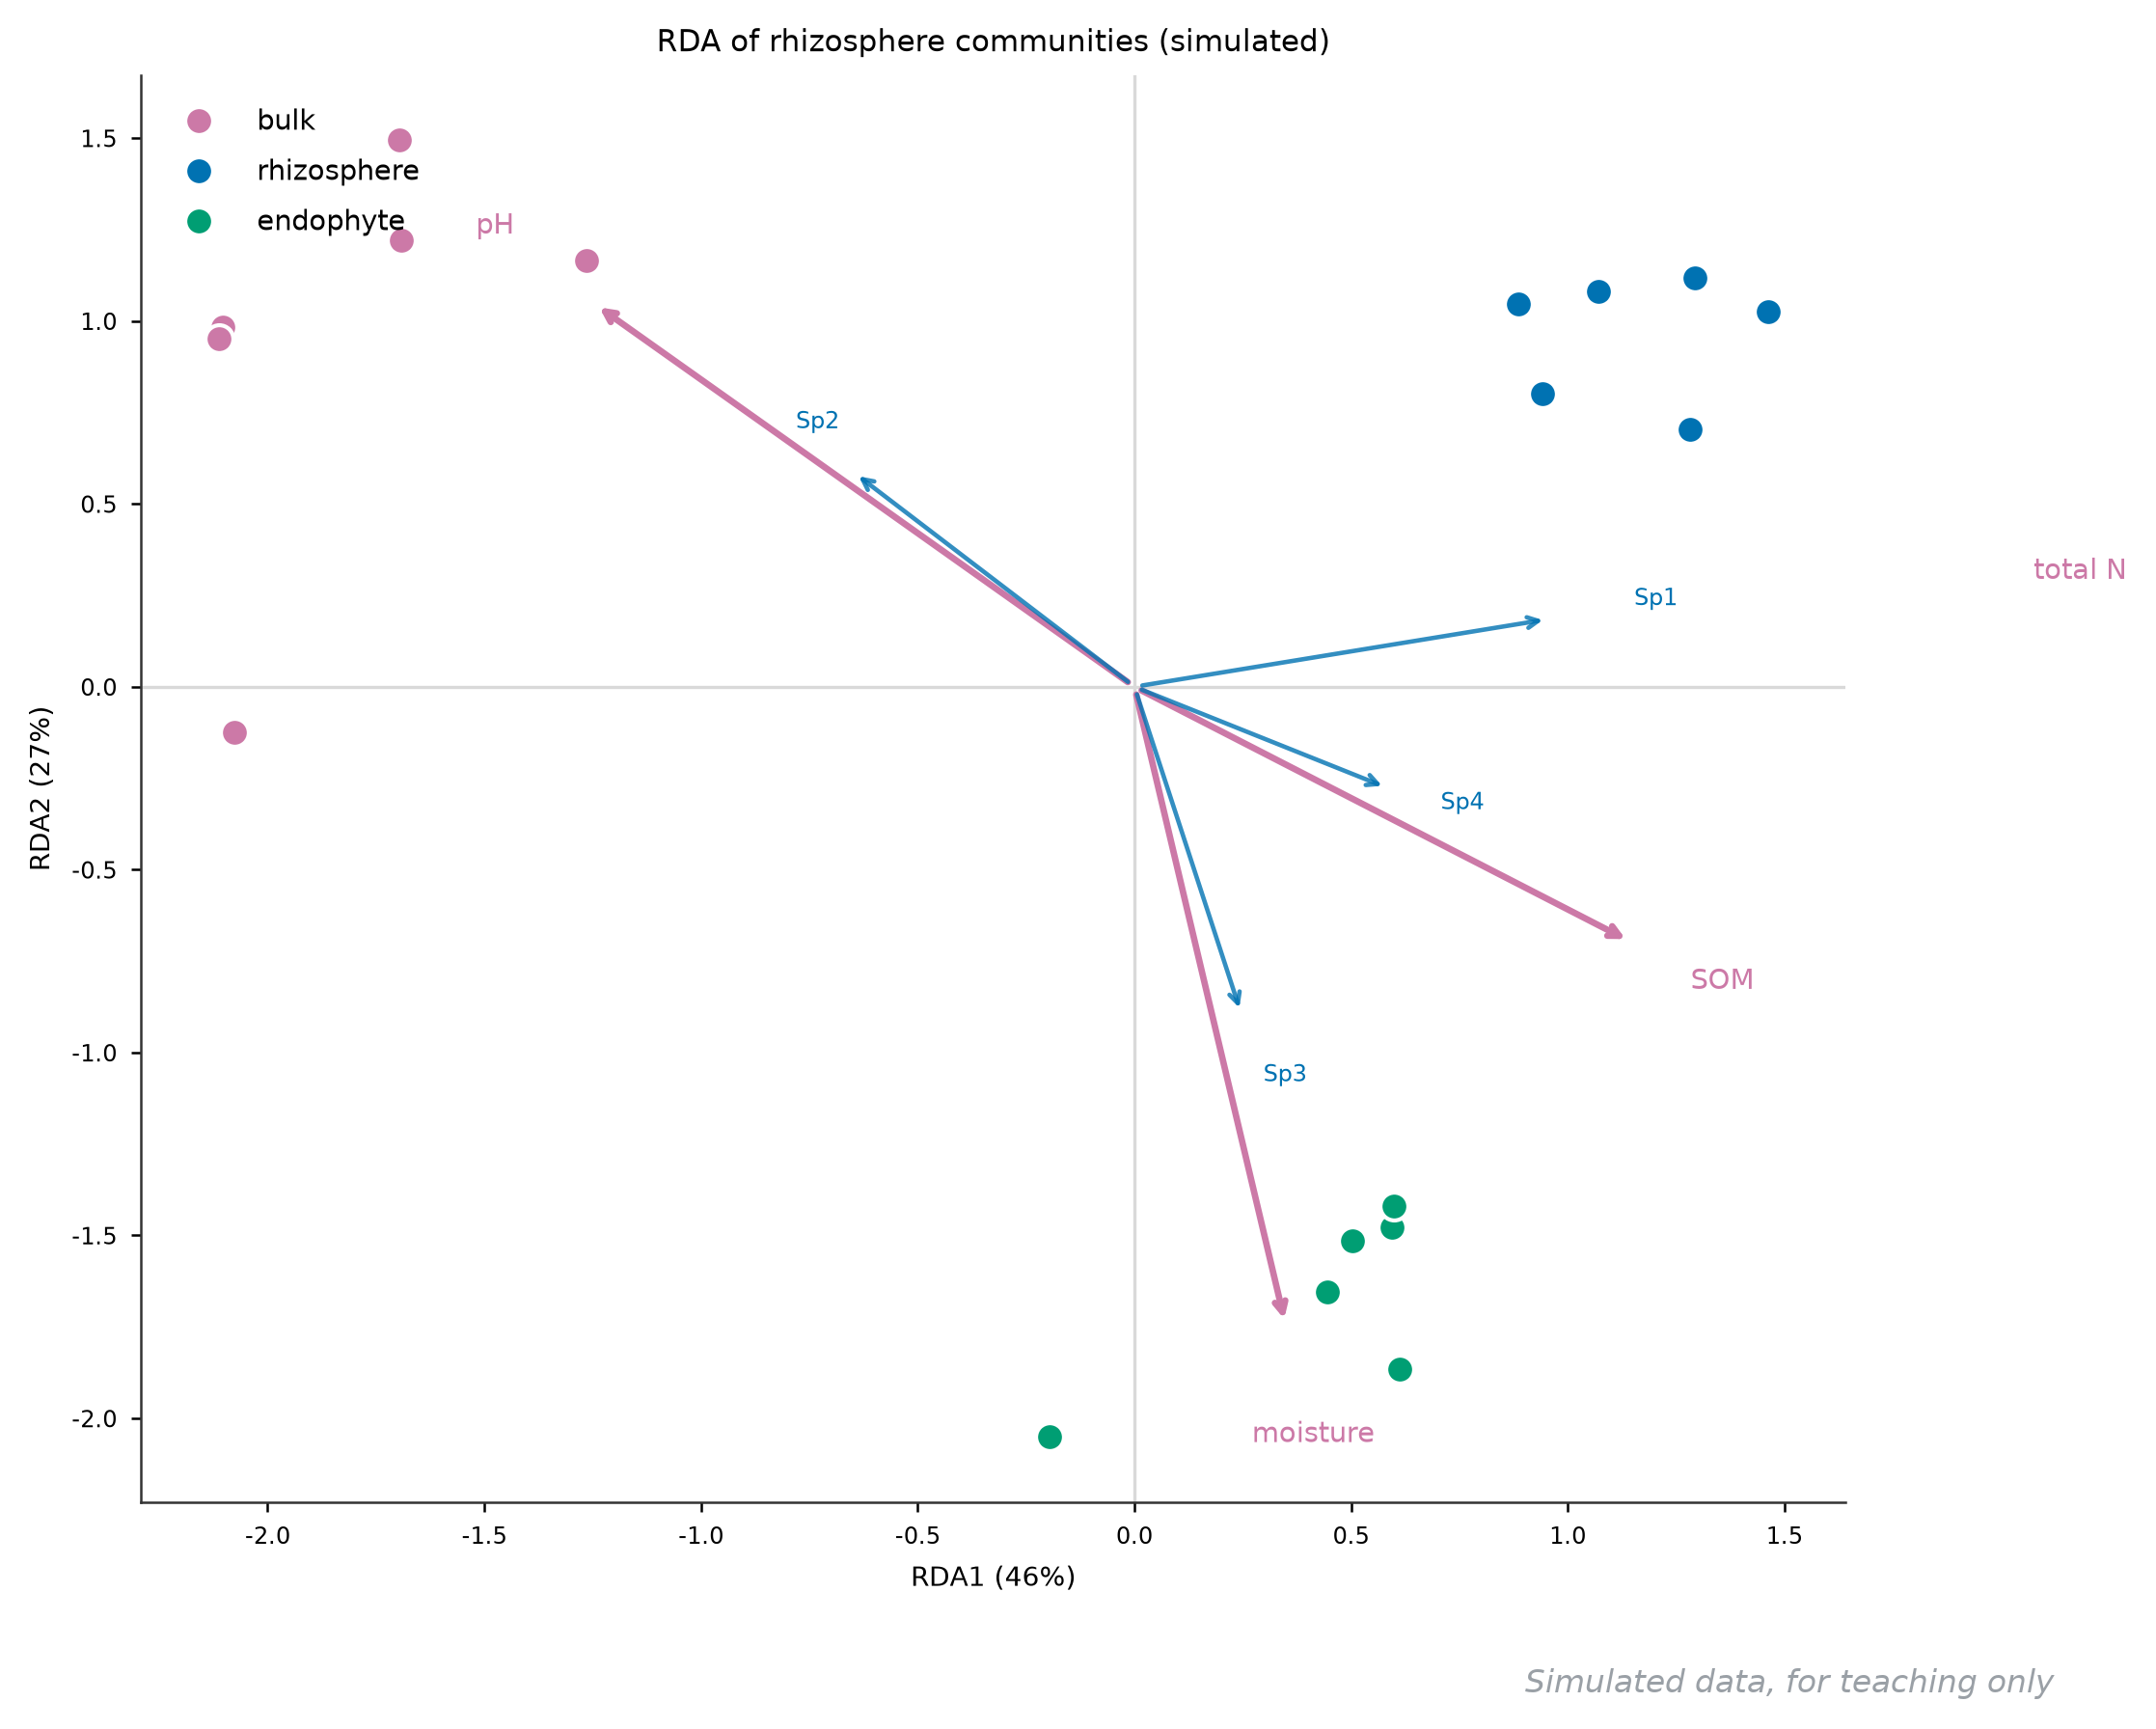
4.4 RDA 排序图
它回答什么问题 :哪些环境因子在塑造群落组成——把样方和因子箭头画进同一坐标系,「谁跟谁走」一眼可读,是土壤/微生物组论文出场率最高的排序图。
怎么读 :点是一个样方,箭头是一个环境因子,箭头越长该因子解释力越强,两箭头夹角近似其相关性。读法一句话:样方落在某箭头的延长线方向上,该因子的值就高 。本例土体组(B,左侧)沿 pH 正方向,根际组(R,右上)沿 total N 箭头(1.85, 0.25),根内组(E,右下)在 moisture 负端——三个区室各被不同因子「拉住」。正式分析要报约束轴的解释率与 permutation 检验 p 值,图里至少标注 RDA1/RDA2 的解释百分比。
用什么画 :R vegan 的 rda + envfit;重绘对样方坐标与因子箭头坐标分面板散点加箭头。
图注示例 :
图 118 根-土连续体 18 个样本的 RDA 排序图(模拟)。点为样方(按区室着色),箭头为环境因子:土体组与 pH 同向,根际组沿 total N 方向(箭头终点 1.85, 0.25),根内组位于 moisture 负端。
展开查看:样方与因子数据、绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 site,group,rda1,rda2 B1,bulk,-1.69,1.22 B2,bulk,-2.08,-0.13 B3,bulk,-1.26,1.17 B4,bulk,-2.10,0.98 B5,bulk,-1.70,1.49 B6,bulk,-2.11,0.95 R1,rhizosphere,1.28,0.70 R2,rhizosphere,0.89,1.05 R3,rhizosphere,1.29,1.12 R4,rhizosphere,1.07,1.08 R5,rhizosphere,0.94,0.80 R6,rhizosphere,1.46,1.03 E1,endophyte,0.59,-1.48 E2,endophyte,0.61,-1.87 E3,endophyte,0.45,-1.65 E4,endophyte,0.50,-1.52 E5,endophyte,0.60,-1.42 E6,endophyte,-0.20,-2.05
1 2 3 4 5 variable,rda1,rda2 total N,1.85,0.25 pH,-1.25,1.05 moisture,0.35,-1.75 SOM,1.15,-0.70
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltsites = pd.read_csv("118-rda-sites.csv" ) arrows = pd.read_csv("118-rda-arrows.csv" ) gcol = {"bulk" : "#4C72B0" , "rhizosphere" : "#DD8452" , "endophyte" : "#55A868" } fig, ax = plt.subplots(figsize=(7.4 , 6.2 )) for g, sub in sites.groupby("group" ): ax.scatter(sub.rda1, sub.rda2, s=52 , color=gcol[g], edgecolors="white" , label=g, zorder=3 ) for _, r in arrows.iterrows(): x, y = r.rda1, r.rda2 ax.annotate("" , xy=(x, y), xytext=(0 , 0 ), arrowprops=dict (arrowstyle="->" , color="#C44E52" , lw=1.8 )) ax.text(x * 1.18 , y * 1.18 , r.variable, fontsize=9 , color="#C44E52" , ha="center" , va="center" ) ax.axhline(0 , color="0.85" , lw=0.8 ) ax.axvline(0 , color="0.85" , lw=0.8 ) ax.set_xlabel("RDA1" ) ax.set_ylabel("RDA2" ) ax.legend(fontsize=9 , loc="upper left" ) ax.set_title("RDA of rhizosphere communities (simulated)" ) fig.savefig("118-rda.png" , dpi=200 , bbox_inches="tight" )
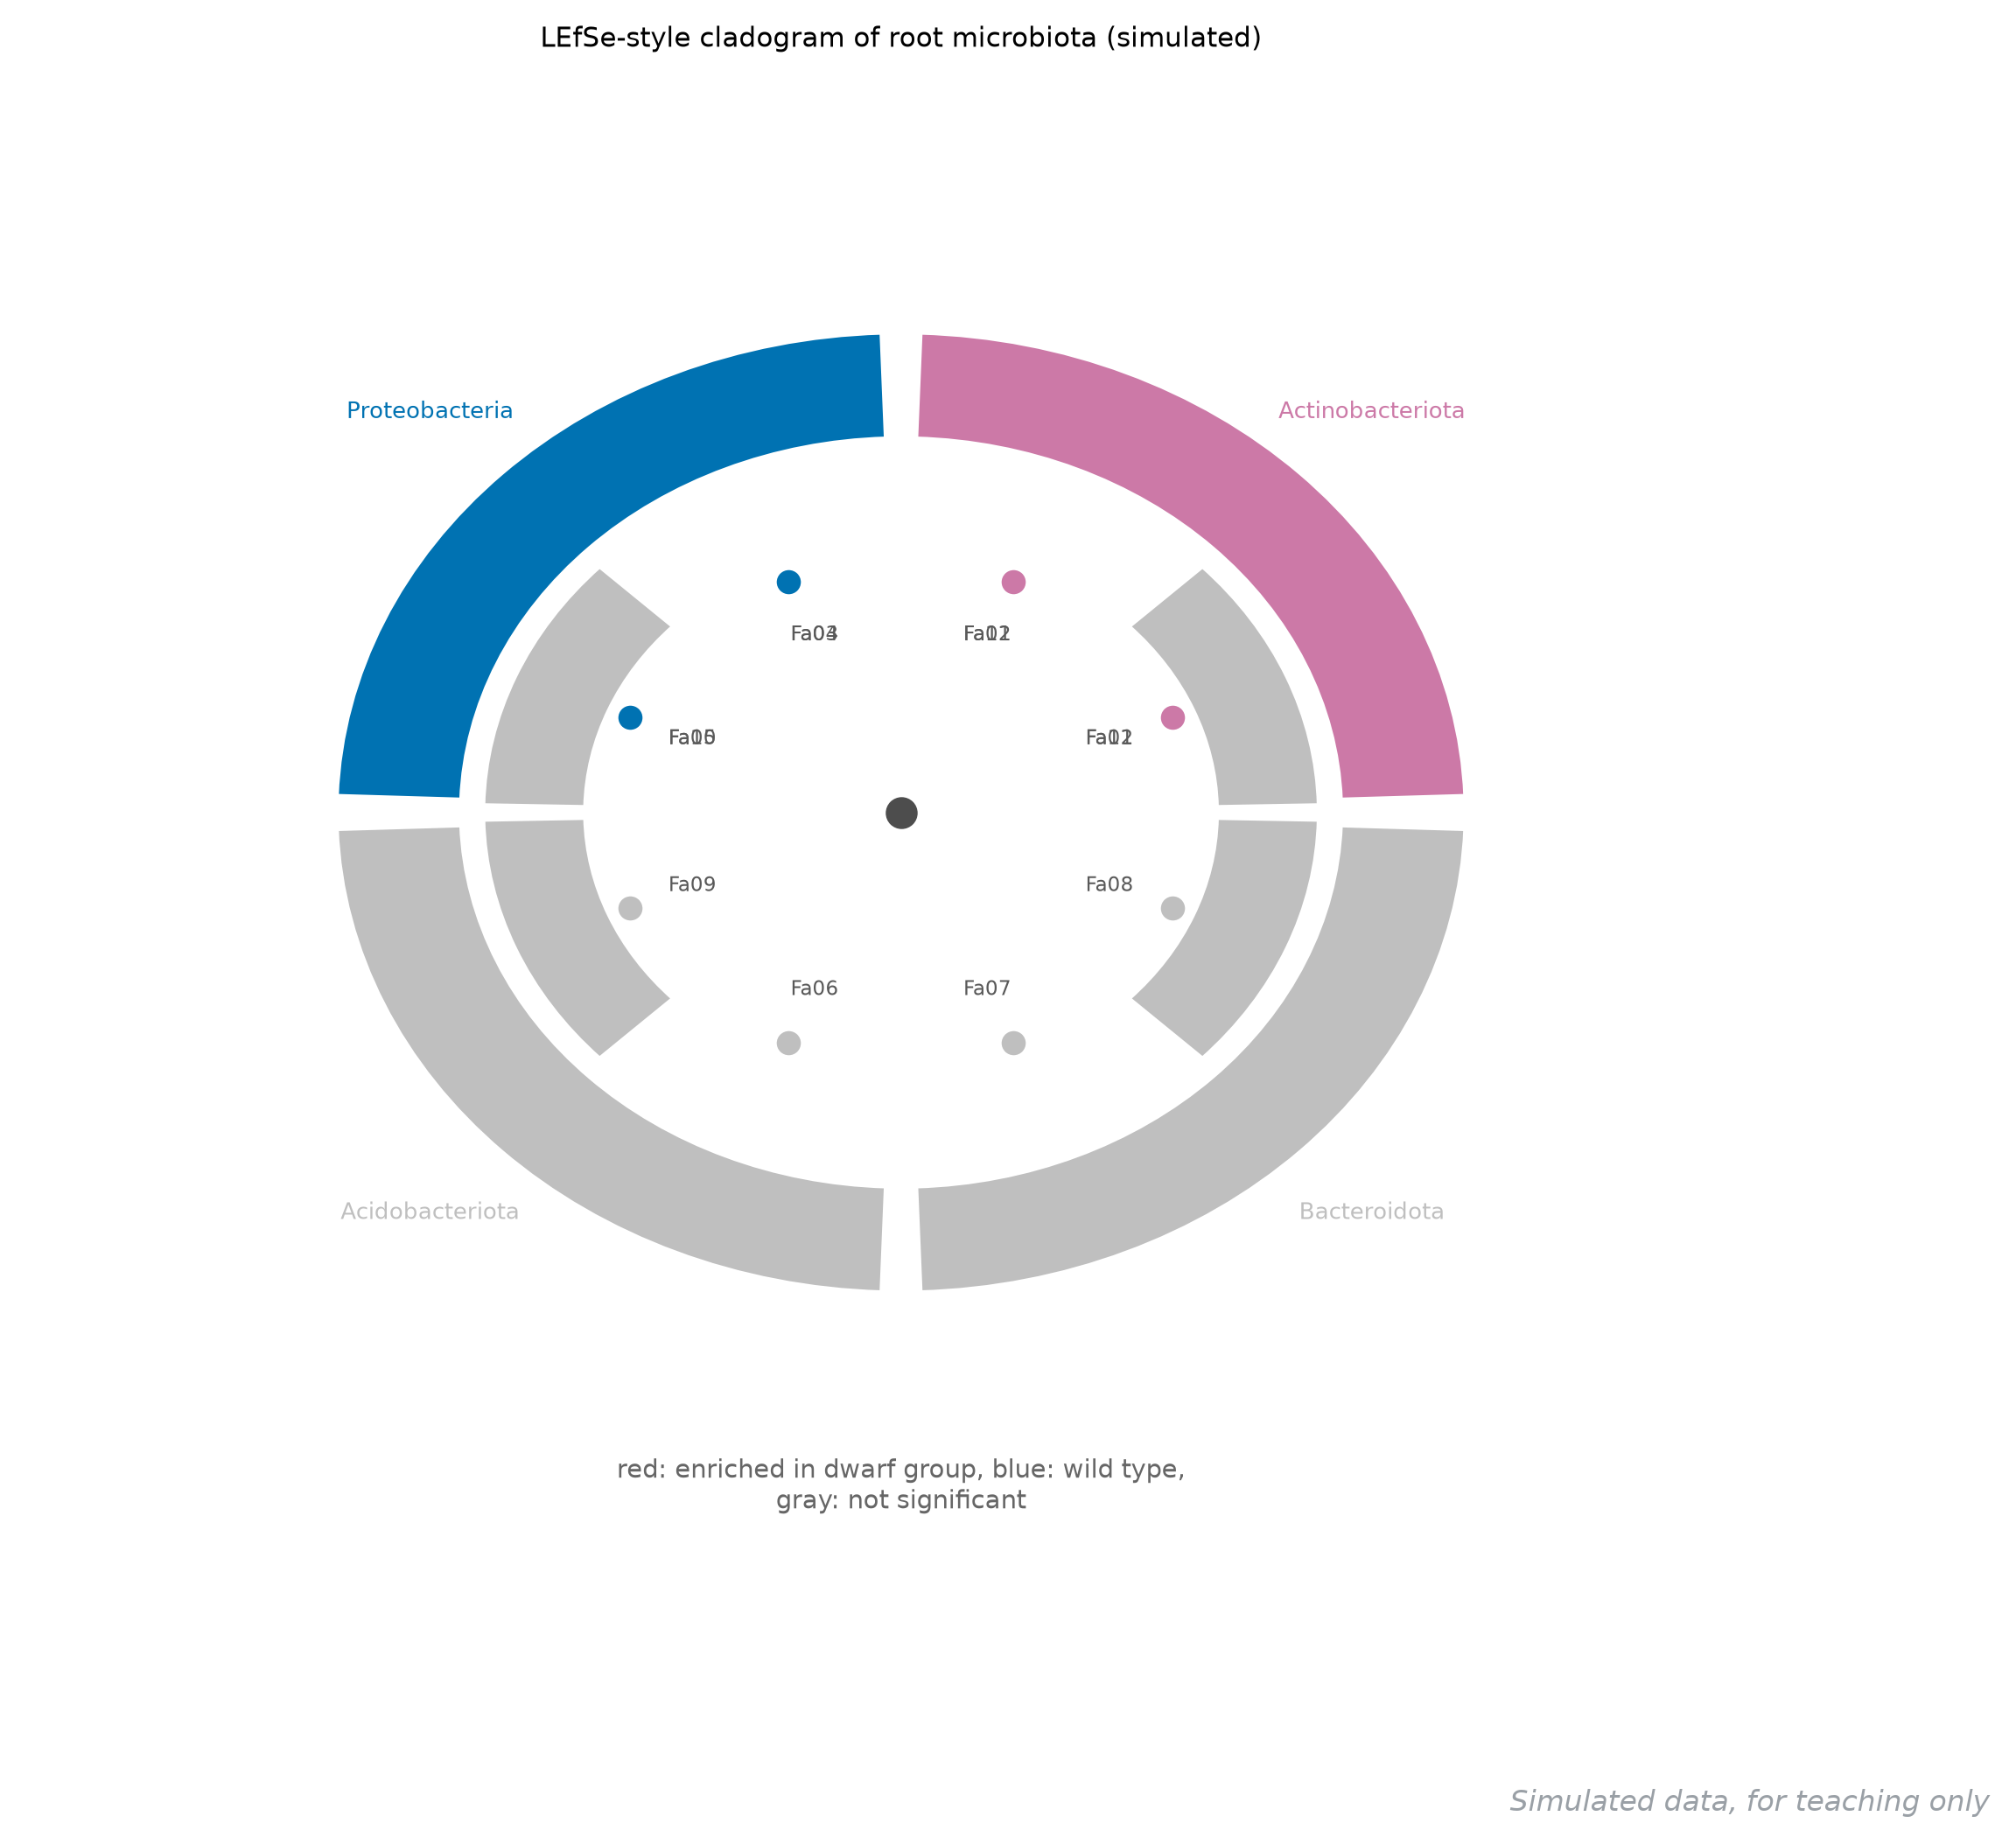
4.5 LEfSe 分支图(cladogram)
它回答什么问题 :两组微生物组的差异集中在分类树的哪些枝条上——不是「哪些物种差异」(那是火山图/柱状图的事),而是「差异有没有分类学上的系统性」。
怎么读 :同心圆从内到外是 门 → 纲 → 属,每个扇形一个分类单元,颜色标注它在哪一组显著富集,半径对应相对丰度。本例四根红色枝条(Actinomycetes、Coriobacteriia、Alpha- 与 Gammaproteobacteria 四个纲)及其下属 8 个属全部富集于矮化组,野生型组没有独立富集的枝,灰色为不显著——「矮化伴随一支放线菌的系统性扩张」这样的结论才立得住。正式版要配 LDA 评分柱状图(通常 LDA > 2 才画进 cladogram)。
用什么画 :LEfSe 原流程(Huttenhower 实验室)或在线版 microbiomeanalysis;重绘按 分类单元-层级-分组 表用楔形块拼。
图注示例 :
图 119 矮化与野生型植株根际菌群差异的 LEfSe 分支图(模拟)。环层由内向外为门、纲、属;红色为矮化组显著富集(Actinomycetes、Coriobacteriia、Alphaproteobacteria、Gammaproteobacteria 及其下属属),灰色为不显著;本例野生型侧无独立富集枝。
展开查看:分类层级数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 taxon,rank,parent_index,group Actinobacteriota,phylum,, Proteobacteria,phylum,, Acidobacteriota,phylum,, Bacteroidota,phylum,, Actinomycetes,class,0,dwarf Coriobacteriia,class,1,dwarf Alphaproteobacteria,class,2,dwarf Gammaproteobacteria,class,3,dwarf Acidobacteriia,class,4,ns Chlorobia,class,5,ns Bacteroidia,class,6,ns Flavobacteriia,class,7,ns Fa01,genus,0,dwarf Fa02,genus,1,dwarf Fa03,genus,2,dwarf Fa04,genus,2,dwarf Fa05,genus,3,dwarf Fa06,genus,5,ns Fa07,genus,6,ns Fa08,genus,7,ns Fa09,genus,4,ns Fa10,genus,3,dwarf Fa11,genus,1,dwarf Fa12,genus,0,dwarf
绘图代码(Python,独立可运行;核心是把每个分类单元放到所属父类的扇区里)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom matplotlib.patches import Wedgedf = pd.read_csv("119-lefse.csv" ) ns = [i for i, r in df.iterrows() if r["rank" ] == "phylum" ] color = {"dwarf" : "#C44E52" , "ns" : "0.72" , "" : "#8da0cb" } ring = {"phylum" : 0.45 , "class" : 0.72 , "genus" : 0.94 } fig, ax = plt.subplots(figsize=(8.4 , 8.4 )) def draw (i, a0, a1, level ): r = df.iloc[i] ax.add_patch(Wedge((0 , 0 ), ring[r["rank" ]], np.degrees(a0), np.degrees(a1), width=0.22 , facecolor=color[r["group" ]] if isinstance ( r["group" ], str ) else color["" ], edgecolor="white" , lw=1.2 )) am = (a0 + a1) / 2 kids = df.index[df.parent_index == i].tolist() span = (a1 - a0) / max (len (kids), 1 ) for k, ki in enumerate (kids): draw(ki, a0 + k * span, a0 + (k + 1 ) * span, level + 1 ) if r["rank" ] == "phylum" : ax.text(1.28 * np.cos(am), 1.28 * np.sin(am), r.taxon, fontsize=8 , ha="center" , va="center" , rotation=np.degrees(am) % 360 - 180 if 90 < np.degrees( am) % 360 < 270 else np.degrees(am) % 360 ) n1 = len (ns) w = 2 * np.pi / n1 for ci in range (n1): draw(ns[ci], ci * w, (ci + 1 ) * w, 0 ) ax.text(0 , -1.45 , "red: enriched in dwarf group, blue: wild type,\ngray: not significant" , ha="center" , fontsize=8.5 , color="0.35" ) ax.set_xlim(-1.6 , 1.6 ) ax.set_ylim(-1.6 , 1.6 ) ax.axis("off" ) ax.set_title("LEfSe-style cladogram of root microbiota (simulated)" ) fig.savefig("119-lefse.png" , dpi=200 , bbox_inches="tight" )
4.6 时间杀菌曲线
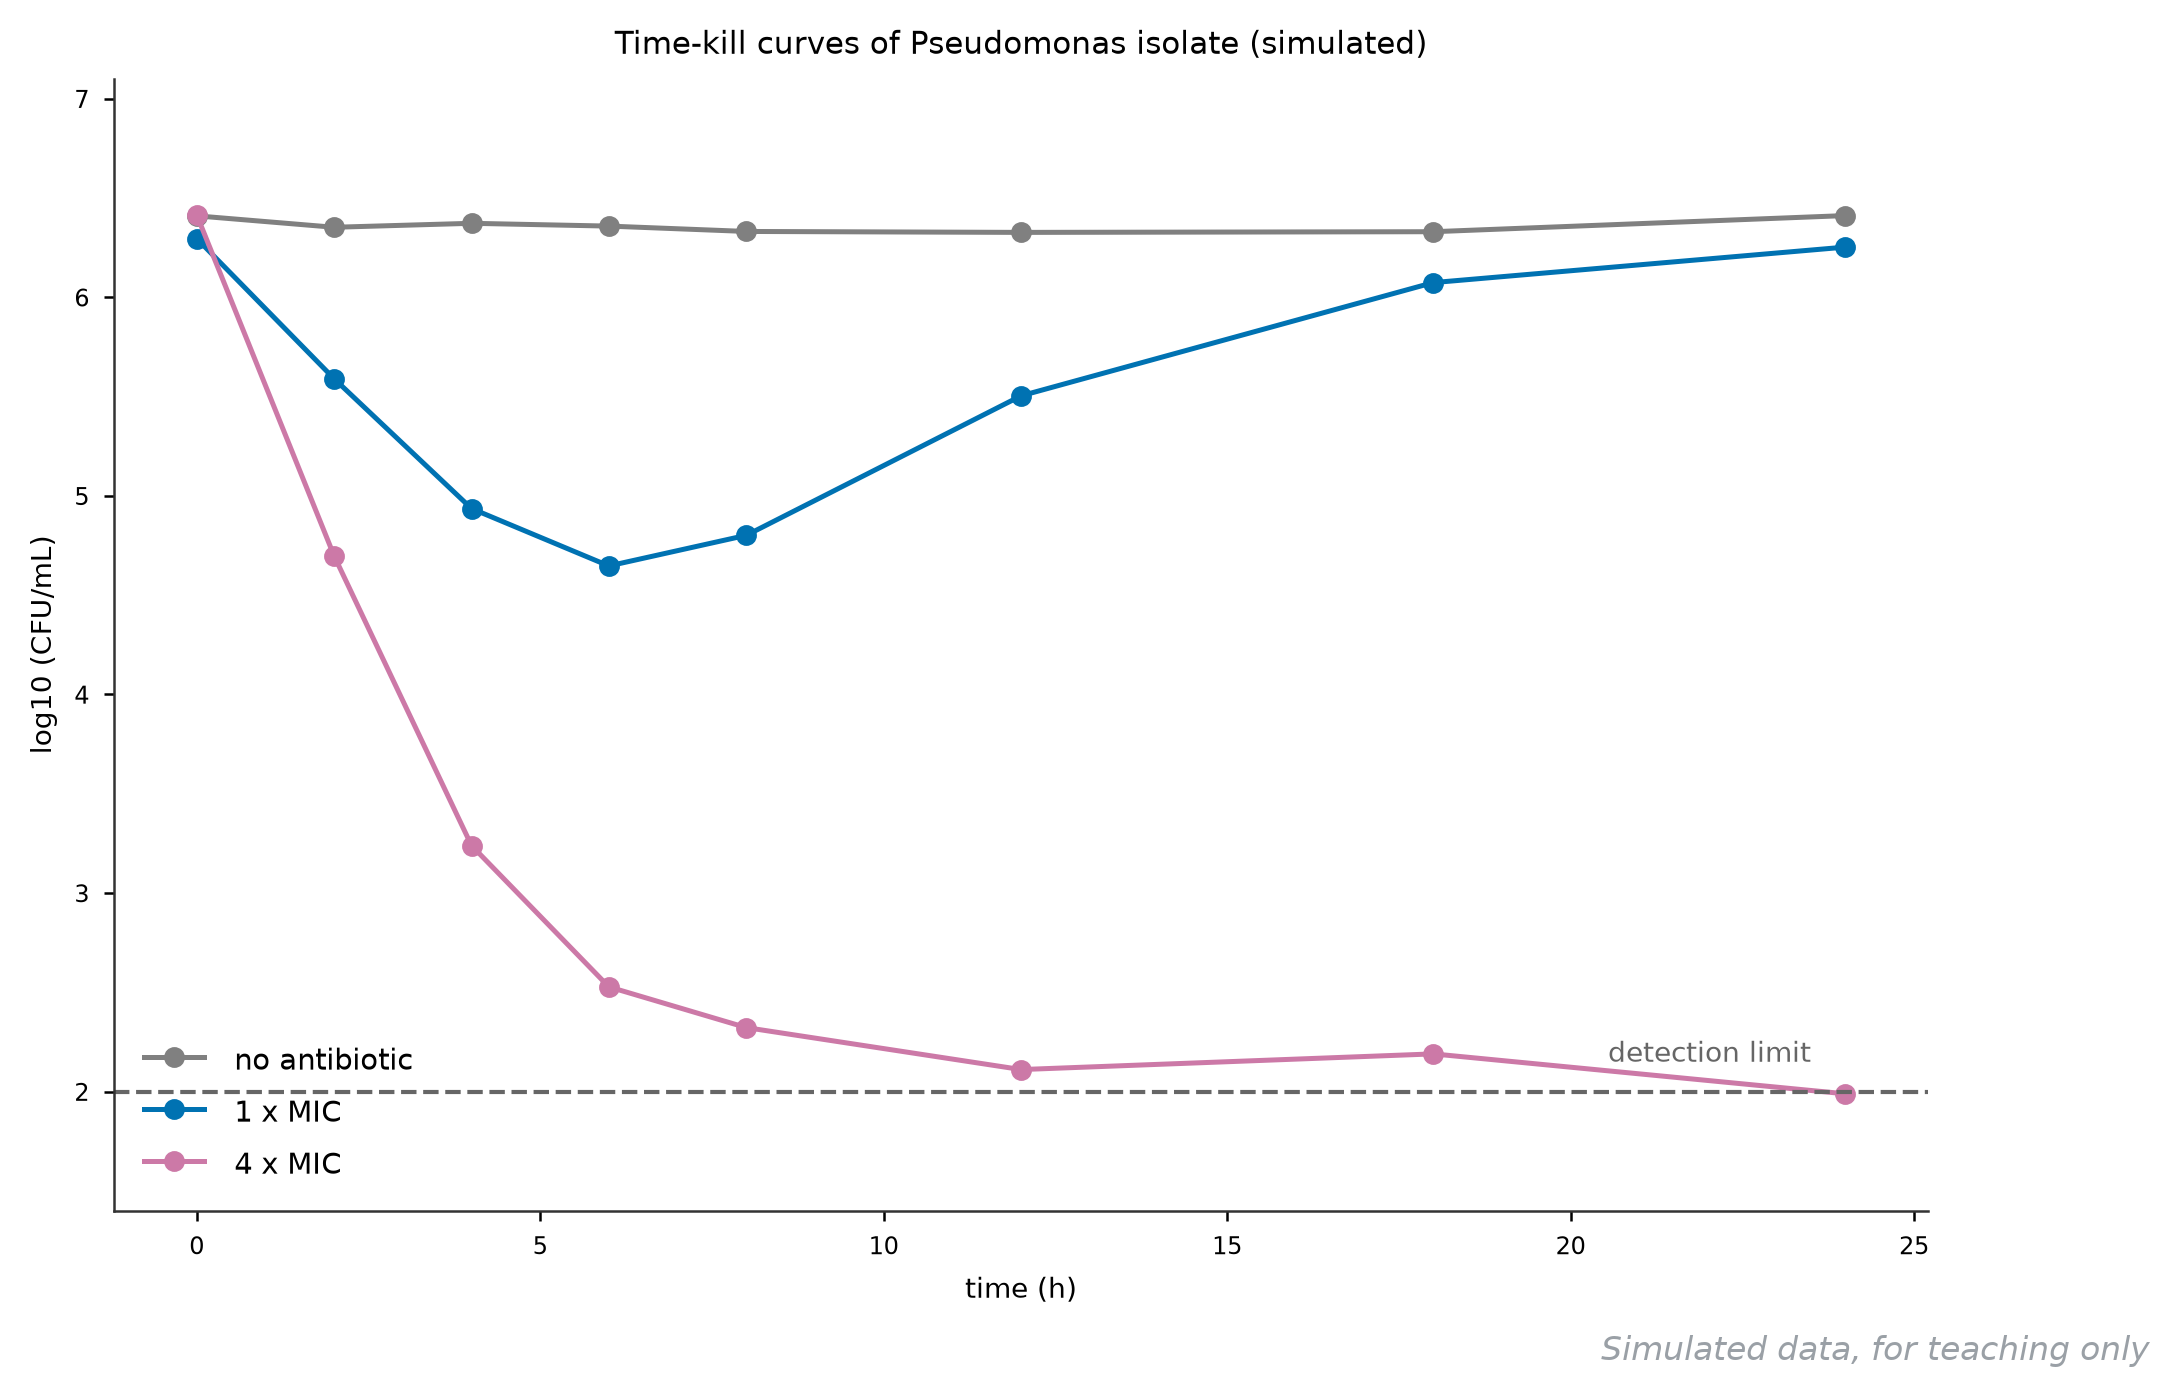
它回答什么问题 :抗生素在 24 小时里把菌压到哪、会不会反弹——药敏试验里 MIC 只给一个终点的量,time-kill 给全过程形状,直接指导给药频次。
怎么读 :横轴时间,纵轴 log10 CFU/mL。三条线三种故事:4× MIC 两小时压降 1.7 个对数(6.41→4.70),24 h 到 1.99、贴着检测限(灰色虚线附近);1× MIC 前段有效(6 h 最低 4.65)但随后回升(24 h 回到 6.25)——初压不住后的 regrowth,提示浓度不足或耐受亚群被筛出;对照平稳(6.3-6.4)。形状判读口诀:持续下坠是浓度依赖,早降后平是时间依赖,回弹是耐药信号。
用什么画 :GraphPad 生长曲线模板;重绘按 时间-分组 表画多线加检测限横线。
图注示例 :
图 120 铜绿假单胞菌分离株的时间杀菌曲线(模拟)。0-24 h 每 2-6 h 计数一次;4× MIC 组 2 h 内降 1.7 log10(6.41→4.70)、24 h 达 1.99 log10 CFU/mL(检测限附近);1× MIC 组 6 h 后回弹至 6.25,提示再生。
展开查看:计数数据与绘图代码 1 2 3 4 5 6 7 8 9 time_h,control,abx_1x,abx_4x 0,6.41,6.30,6.41 2,6.35,5.59,4.70 4,6.37,4.94,3.24 6,6.36,4.65,2.53 8,6.33,4.80,2.32 12,6.33,5.50,2.11 18,6.33,6.07,2.19 24,6.41,6.25,1.99
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("120-time-kill.csv" ) fig, ax = plt.subplots(figsize=(7.8 , 4.9 )) ax.plot(df.time_h, df.control, "-o" , ms=4.5 , color="0.5" , label="no antibiotic" ) ax.plot(df.time_h, df.abx_1x, "-o" , ms=4.5 , color="#4C72B0" , label="1 x MIC" ) ax.plot(df.time_h, df.abx_4x, "-o" , ms=4.5 , color="#C44E52" , label="4 x MIC" ) ax.axhline(2.0 , color="0.6" , ls="--" , lw=1 ) ax.text(23.5 , 2.15 , "detection limit" , fontsize=8.5 , color="0.4" , ha="right" ) ax.annotate("regrowth at 1 x MIC" , (18 , 6.07 ), (10 , 6.6 ), fontsize=9 , arrowprops=dict (arrowstyle="->" , lw=1 )) ax.set_xlabel("time (h)" ) ax.set_ylabel("log10 CFU/mL" ) ax.legend(fontsize=9 , loc="lower left" ) ax.set_title("Time-kill curves of Pseudomonas isolate (simulated)" ) fig.savefig("120-time-kill.png" , dpi=200 , bbox_inches="tight" )
五、代谢组与宏基因组 5.1 镜像质谱图
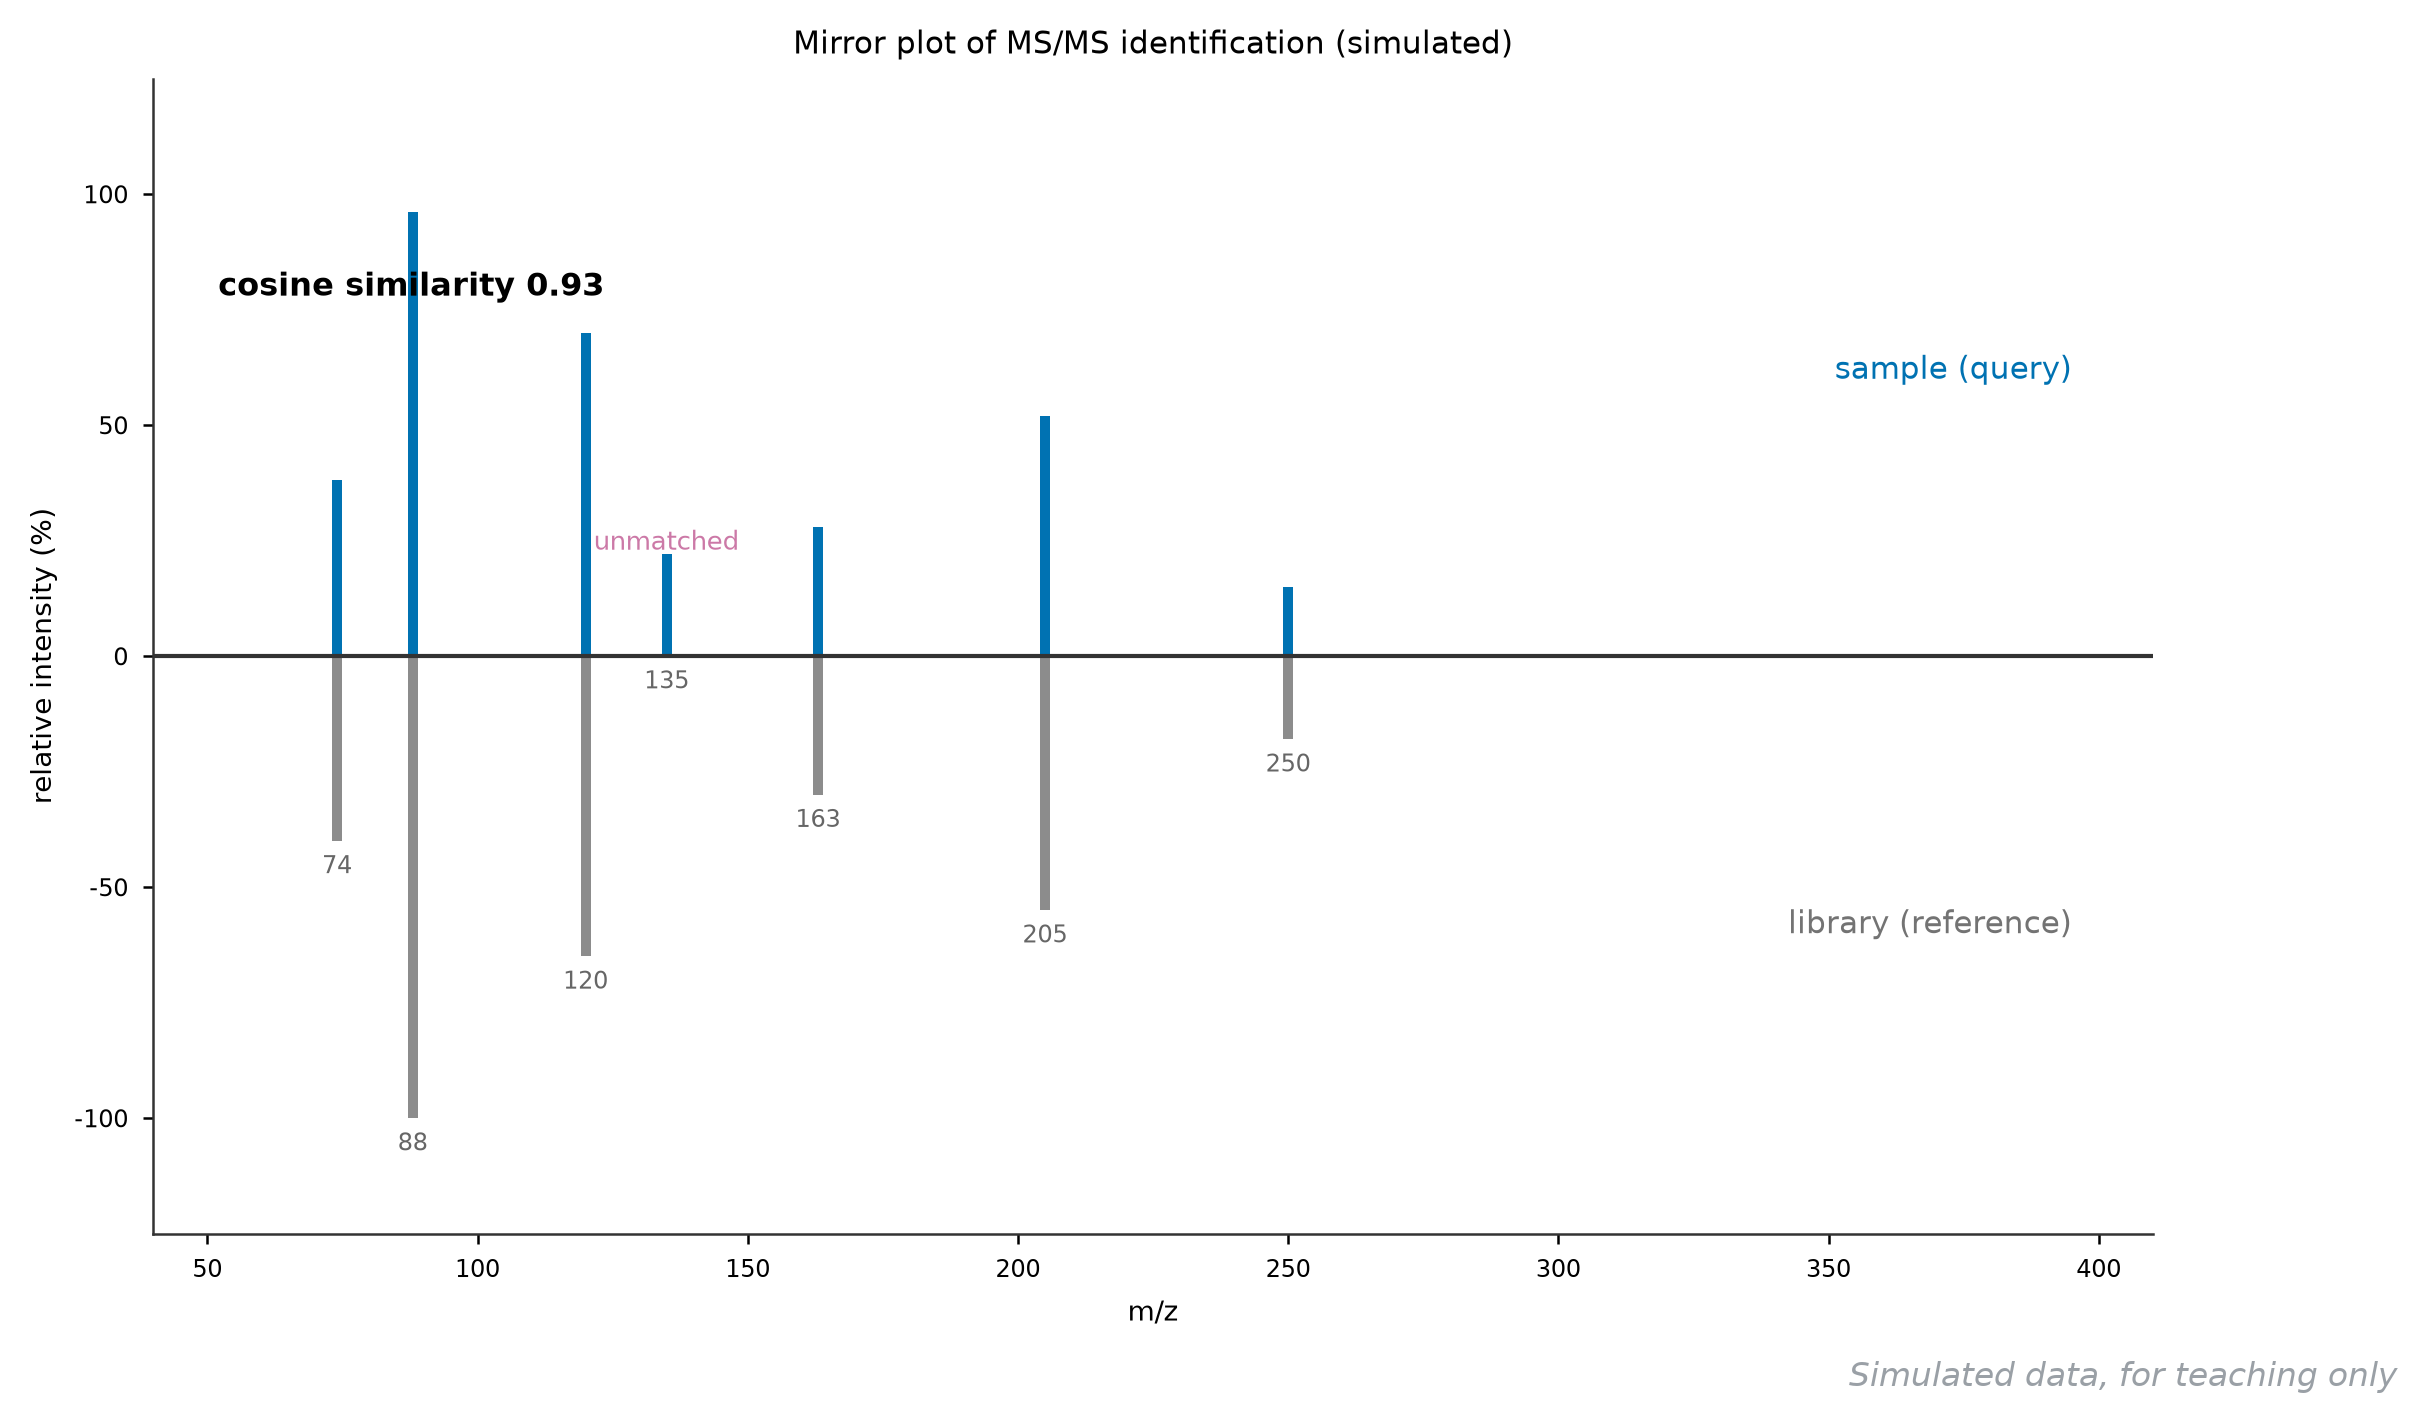
它回答什么问题 :这个质谱峰到底是不是注释表里那个分子——把样品谱图和数据库标准谱图上下镜像叠起来,匹配质量一眼可见,是代谢组注释审核的最后一道关。
怎么读 :上方向为样品谱(query),下方向为库谱(reference),横轴 m/z。峰对得越齐,匹配越可信——图内标注余弦相似度 0.93(GNPS 常用 0.7 作阈值)。重点看「不对称」的峰:m/z 135 处库里有强峰(22)而样品缺失(标 unmatched),提示它可能是加合离子或共洗脱碎片,不参与打分;反过来样品独有的峰则要去查同位素/加合物。谱图对不齐但相似度高的,往往是无关分子「撞分」,镜像一摆就露馅。
用什么画 :GNPS 的 spectral library match 页面直接出镜像图;重绘对 m/z-强度双列画上下镜像杆图。
图注示例 :
图 121 未知代谢物与数据库标准品的 MS/MS 镜像比对(模拟)。上方为样品谱、下方为库谱,余弦相似度 0.93;m/z 135 仅存在于库谱(unmatched),判为加合离子相关峰。
展开查看:谱峰数据与绘图代码 1 2 3 4 5 6 7 8 mz,sample_intensity,library_intensity 74,40,38 88,100,96 120,65,70 135,0,22 163,30,28 205,55,52 250,18,15
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("121-mirror.csv" ) fig, ax = plt.subplots(figsize=(7.6 , 5.2 )) ax.vlines(df.mz, 0 , df.sample_intensity, color="#4C72B0" , lw=2.4 ) ax.vlines(df.mz, 0 , -df.library_intensity, color="0.55" , lw=2.4 ) for mz, lib in zip (df.mz, df.library_intensity): ax.text(mz, -lib - 7 , str (mz), ha="center" , fontsize=7.5 , color="0.4" ) ax.text(135 , 23 , "unmatched" , fontsize=8 , color="#C44E52" , ha="center" ) ax.text(395 , 60 , "sample (query)" , color="#4C72B0" , fontsize=9.5 , ha="right" ) ax.text(395 , -60 , "library (reference)" , color="0.45" , fontsize=9.5 , ha="right" ) ax.text(52 , 78 , "cosine similarity 0.93" , fontsize=10 , fontweight="bold" ) ax.axhline(0 , color="0.2" , lw=0.8 ) ax.set_xlim(40 , 410 ) ax.set_ylim(-90 , 90 ) ax.set_xlabel("m/z" ) ax.set_ylabel("relative intensity" ) ax.set_title("Mirror plot of MS/MS identification (simulated)" ) fig.savefig("121-mirror.png" , dpi=200 , bbox_inches="tight" )
5.2 Van Krevelen 图
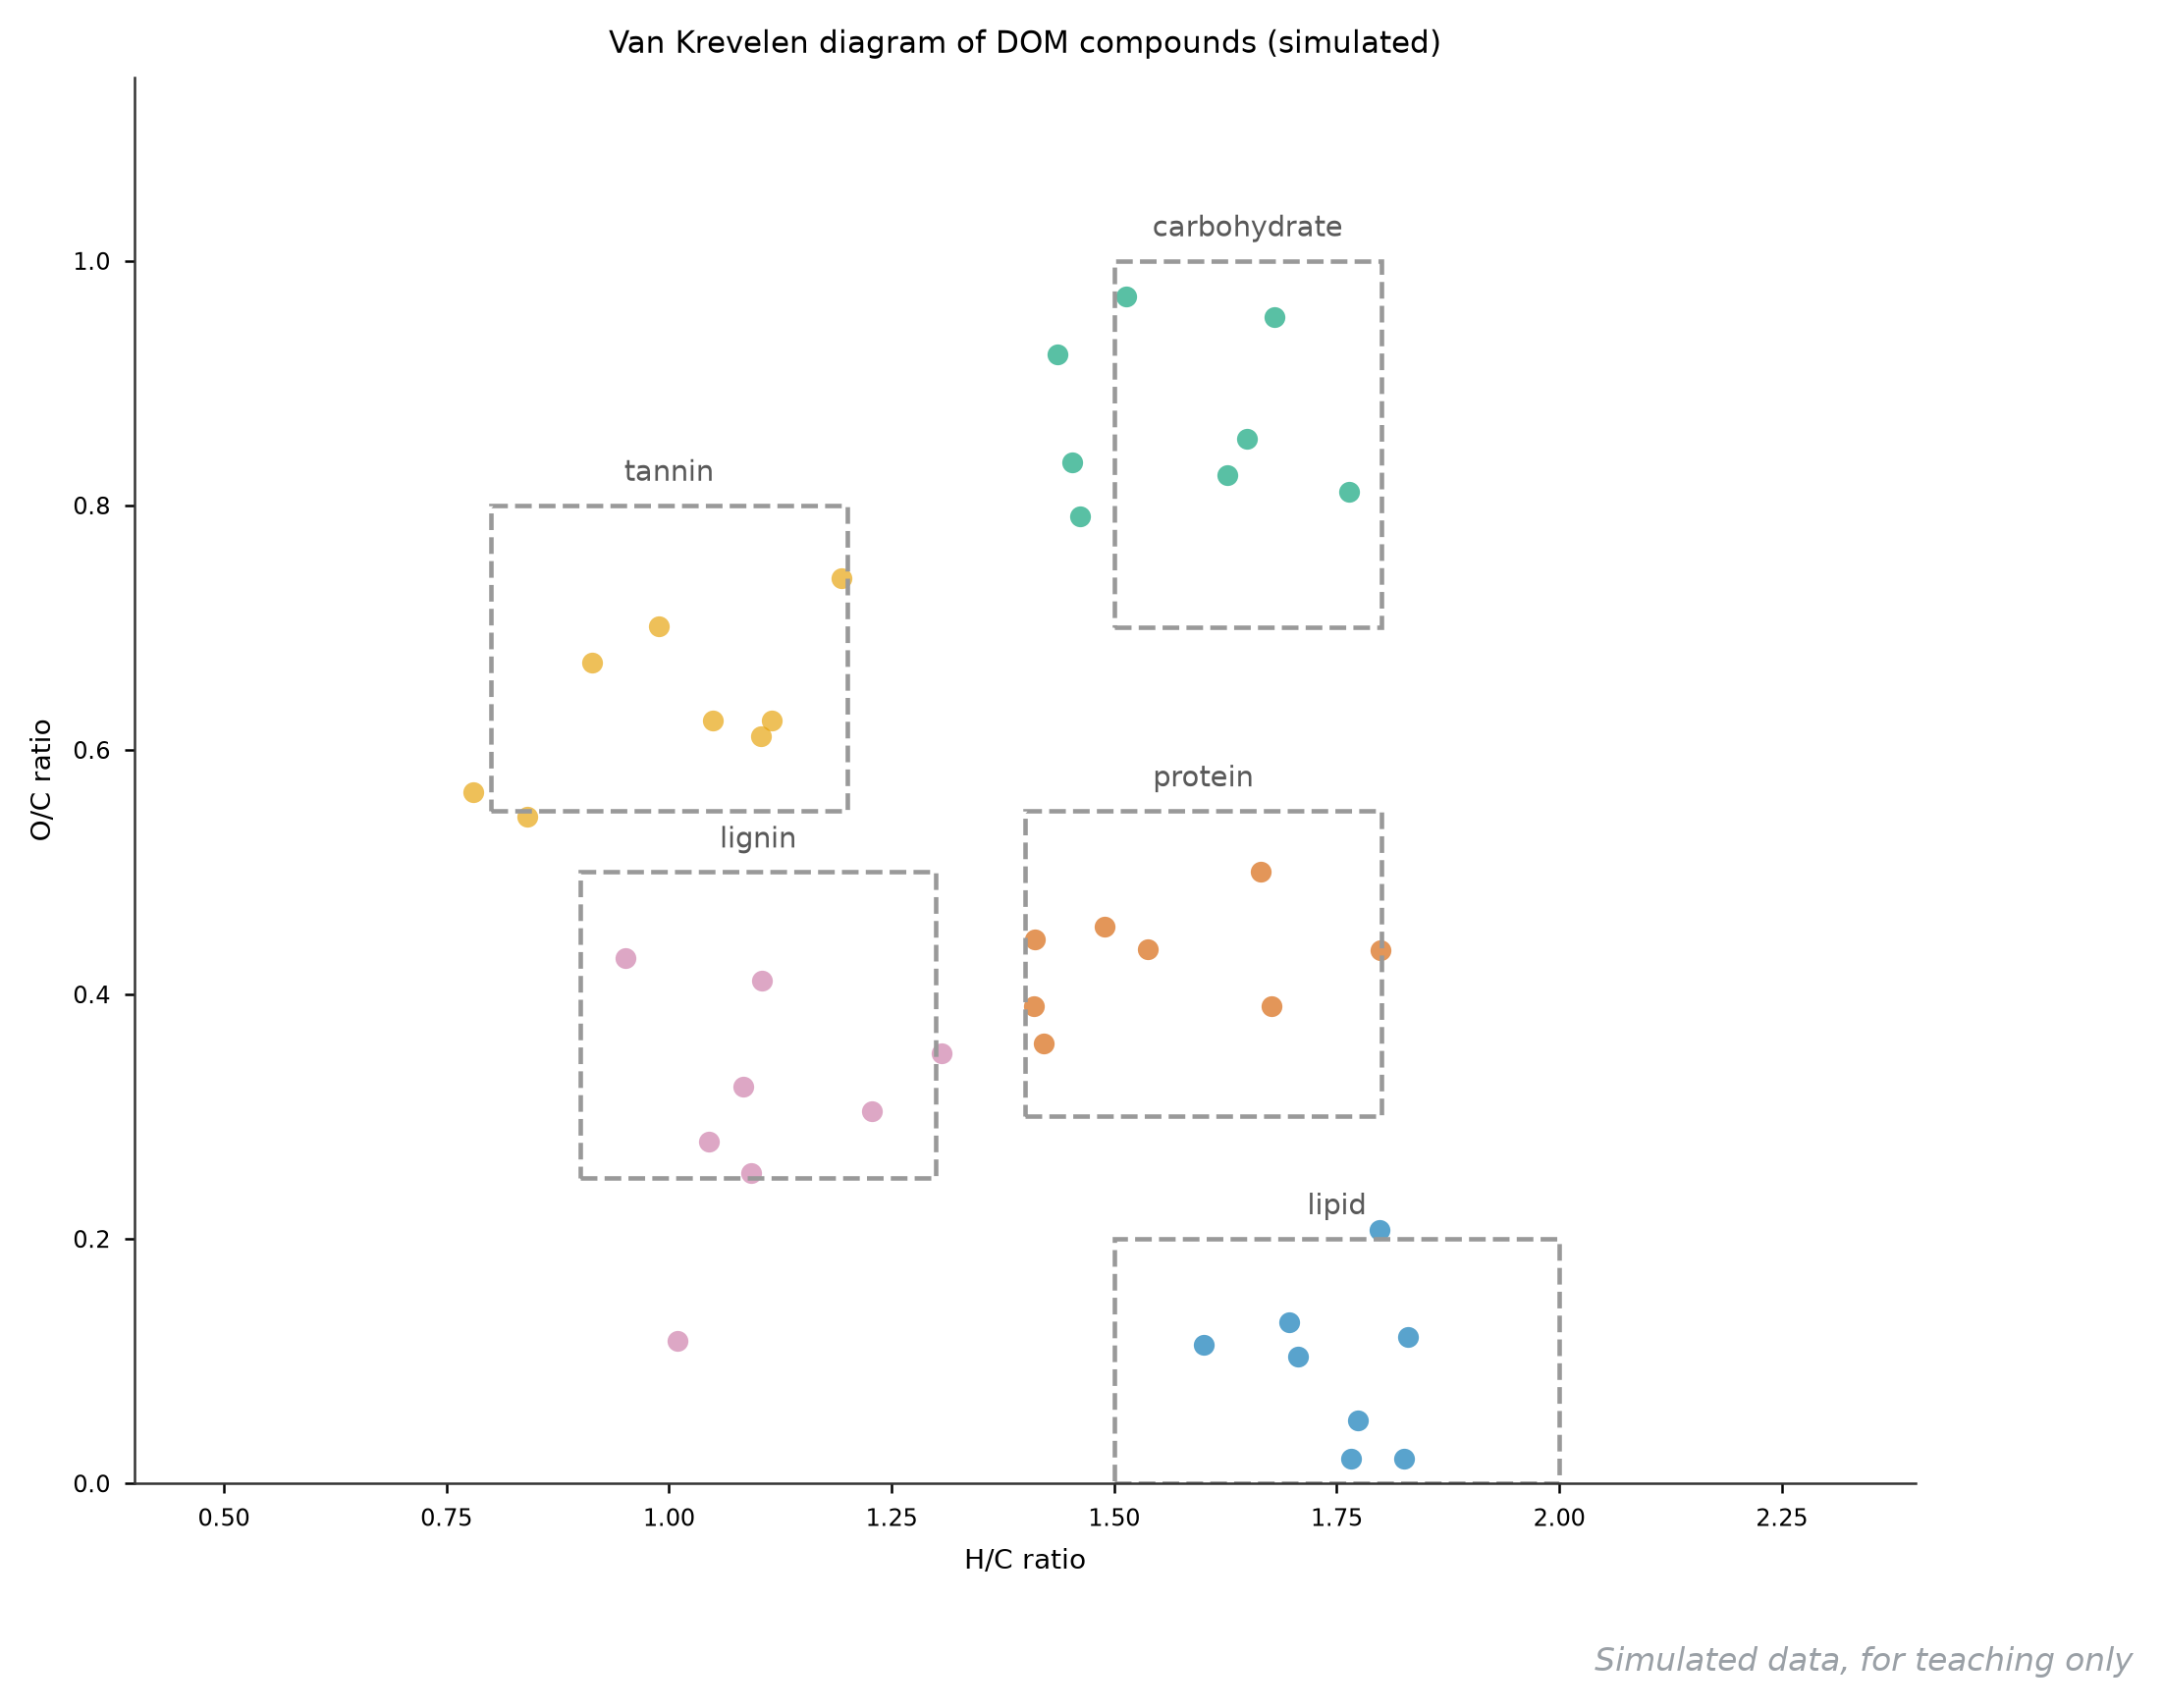
它回答什么问题 :几百个 DOM/代谢物分子各自属于哪个化学家族——只用两个原子比(H/C、O/C)就把元素组成翻译成化学语义,傅里叶变换离子回旋共振质谱(FT-ICR MS)论文的标配。
怎么读 :横轴 H/C、纵轴 O/C,每个点一个分子式,图上按经验区域划分 lipid、protein、carbohydrate、lignin、tannin 等分区。本例脂类聚在右下(H/C 1.6-1.8、O/C 小于 0.2),糖类在高氧区(O/C 0.8-1.0),木质素-单宁偏左上(低 H/C 高 O/C 的芳香区)——木质素与单宁点占比高,说明这批溶解性有机质以难降解芳香结构为主。判读口诀:点沿脱氧方向移动=还原过程,向高 O/C 移动=氧化过程,处理前后分区占比的变化就是「化学故事线」。
用什么画 :R 的 FTMSPlotting、Python 手写分区背景;重绘按 H/C-O/C-分类表散点加分区底色。
图注示例 :
图 122 40 个 DOM 化合物的 Van Krevelen 图(模拟)。横轴 H/C、纵轴 O/C,底色区为经验分类区;脂类(H/C 1.6-1.8,O/C ≤ 0.21)、糖类(O/C 0.79-0.97)与木质素-单宁芳香区(H/C ≤ 1.31 且 O/C 0.12-0.74)各有聚集。
展开查看:元素比数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 compound,HC,OC,class C1,1.77,0.02,lipid C2,1.83,0.12,lipid C3,1.77,0.05,lipid C4,1.70,0.13,lipid C5,1.60,0.11,lipid C6,1.71,0.10,lipid C7,1.83,0.02,lipid C8,1.80,0.21,lipid C9,1.49,0.45,protein C10,1.54,0.44,protein C11,1.80,0.44,protein C12,1.41,0.39,protein C13,1.66,0.50,protein C14,1.68,0.39,protein C15,1.41,0.44,protein C16,1.42,0.36,protein C17,1.46,0.79,carbohydrate C18,1.68,0.95,carbohydrate C19,1.76,0.81,carbohydrate C20,1.45,0.84,carbohydrate C21,1.63,0.82,carbohydrate C22,1.44,0.92,carbohydrate C23,1.51,0.97,carbohydrate C24,1.65,0.85,carbohydrate C25,1.23,0.30,lignin C26,1.10,0.41,lignin C27,1.08,0.32,lignin C28,0.95,0.43,lignin C29,1.04,0.28,lignin C30,1.01,0.12,lignin C31,1.09,0.25,lignin C32,1.31,0.35,lignin C33,0.84,0.55,tannin C34,1.05,0.62,tannin C35,1.10,0.61,tannin C36,1.11,0.62,tannin C37,0.78,0.57,tannin C38,0.99,0.70,tannin C39,0.91,0.67,tannin C40,1.19,0.74,tannin
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("122-vankrevelen.csv" ) regions = {"lipid" : ((1.5 , 2.0 ), (0.0 , 0.25 ), "#F2E8D5" ), "protein" : ((1.4 , 1.8 ), (0.3 , 0.55 ), "#D5E3F2" ), "carbohydrate" : ((1.4 , 1.8 ), (0.65 , 1.1 ), "#D8EFD3" ), "lignin" : ((0.9 , 1.35 ), (0.1 , 0.45 ), "#F0DCE0" ), "tannin" : ((0.7 , 1.2 ), (0.5 , 0.8 ), "#E4DCF0" )} CAT = {"lipid" : "#DD8452" , "protein" : "#4C72B0" , "carbohydrate" : "#55A868" , "lignin" : "#C44E52" , "tannin" : "#8172B3" } fig, ax = plt.subplots(figsize=(7.6 , 6.2 )) for name, (hx, oy, bg) in regions.items(): ax.add_patch(plt.Rectangle((hx[0 ], oy[0 ]), hx[1 ] - hx[0 ], oy[1 ] - oy[0 ], facecolor=bg, alpha=0.55 , zorder=0 )) ax.text((hx[0 ] + hx[1 ]) / 2 , oy[1 ] + 0.02 , name, ha="center" , fontsize=9 , color="0.35" ) for c, sub in df.groupby("class" ): ax.scatter(sub.HC, sub.OC, s=34 , color=CAT[c], edgecolors="white" , label=c, zorder=3 ) ax.set_xlim(0.6 , 2.1 ) ax.set_ylim(0 , 1.15 ) ax.set_xlabel("H/C" ) ax.set_ylabel("O/C" ) ax.legend(fontsize=9 , loc="lower right" ) ax.set_title("Van Krevelen diagram of DOM compounds (simulated)" ) fig.savefig("122-vankrevelen.png" , dpi=200 , bbox_inches="tight" )
5.3 Blob 图(bin 质控散点)
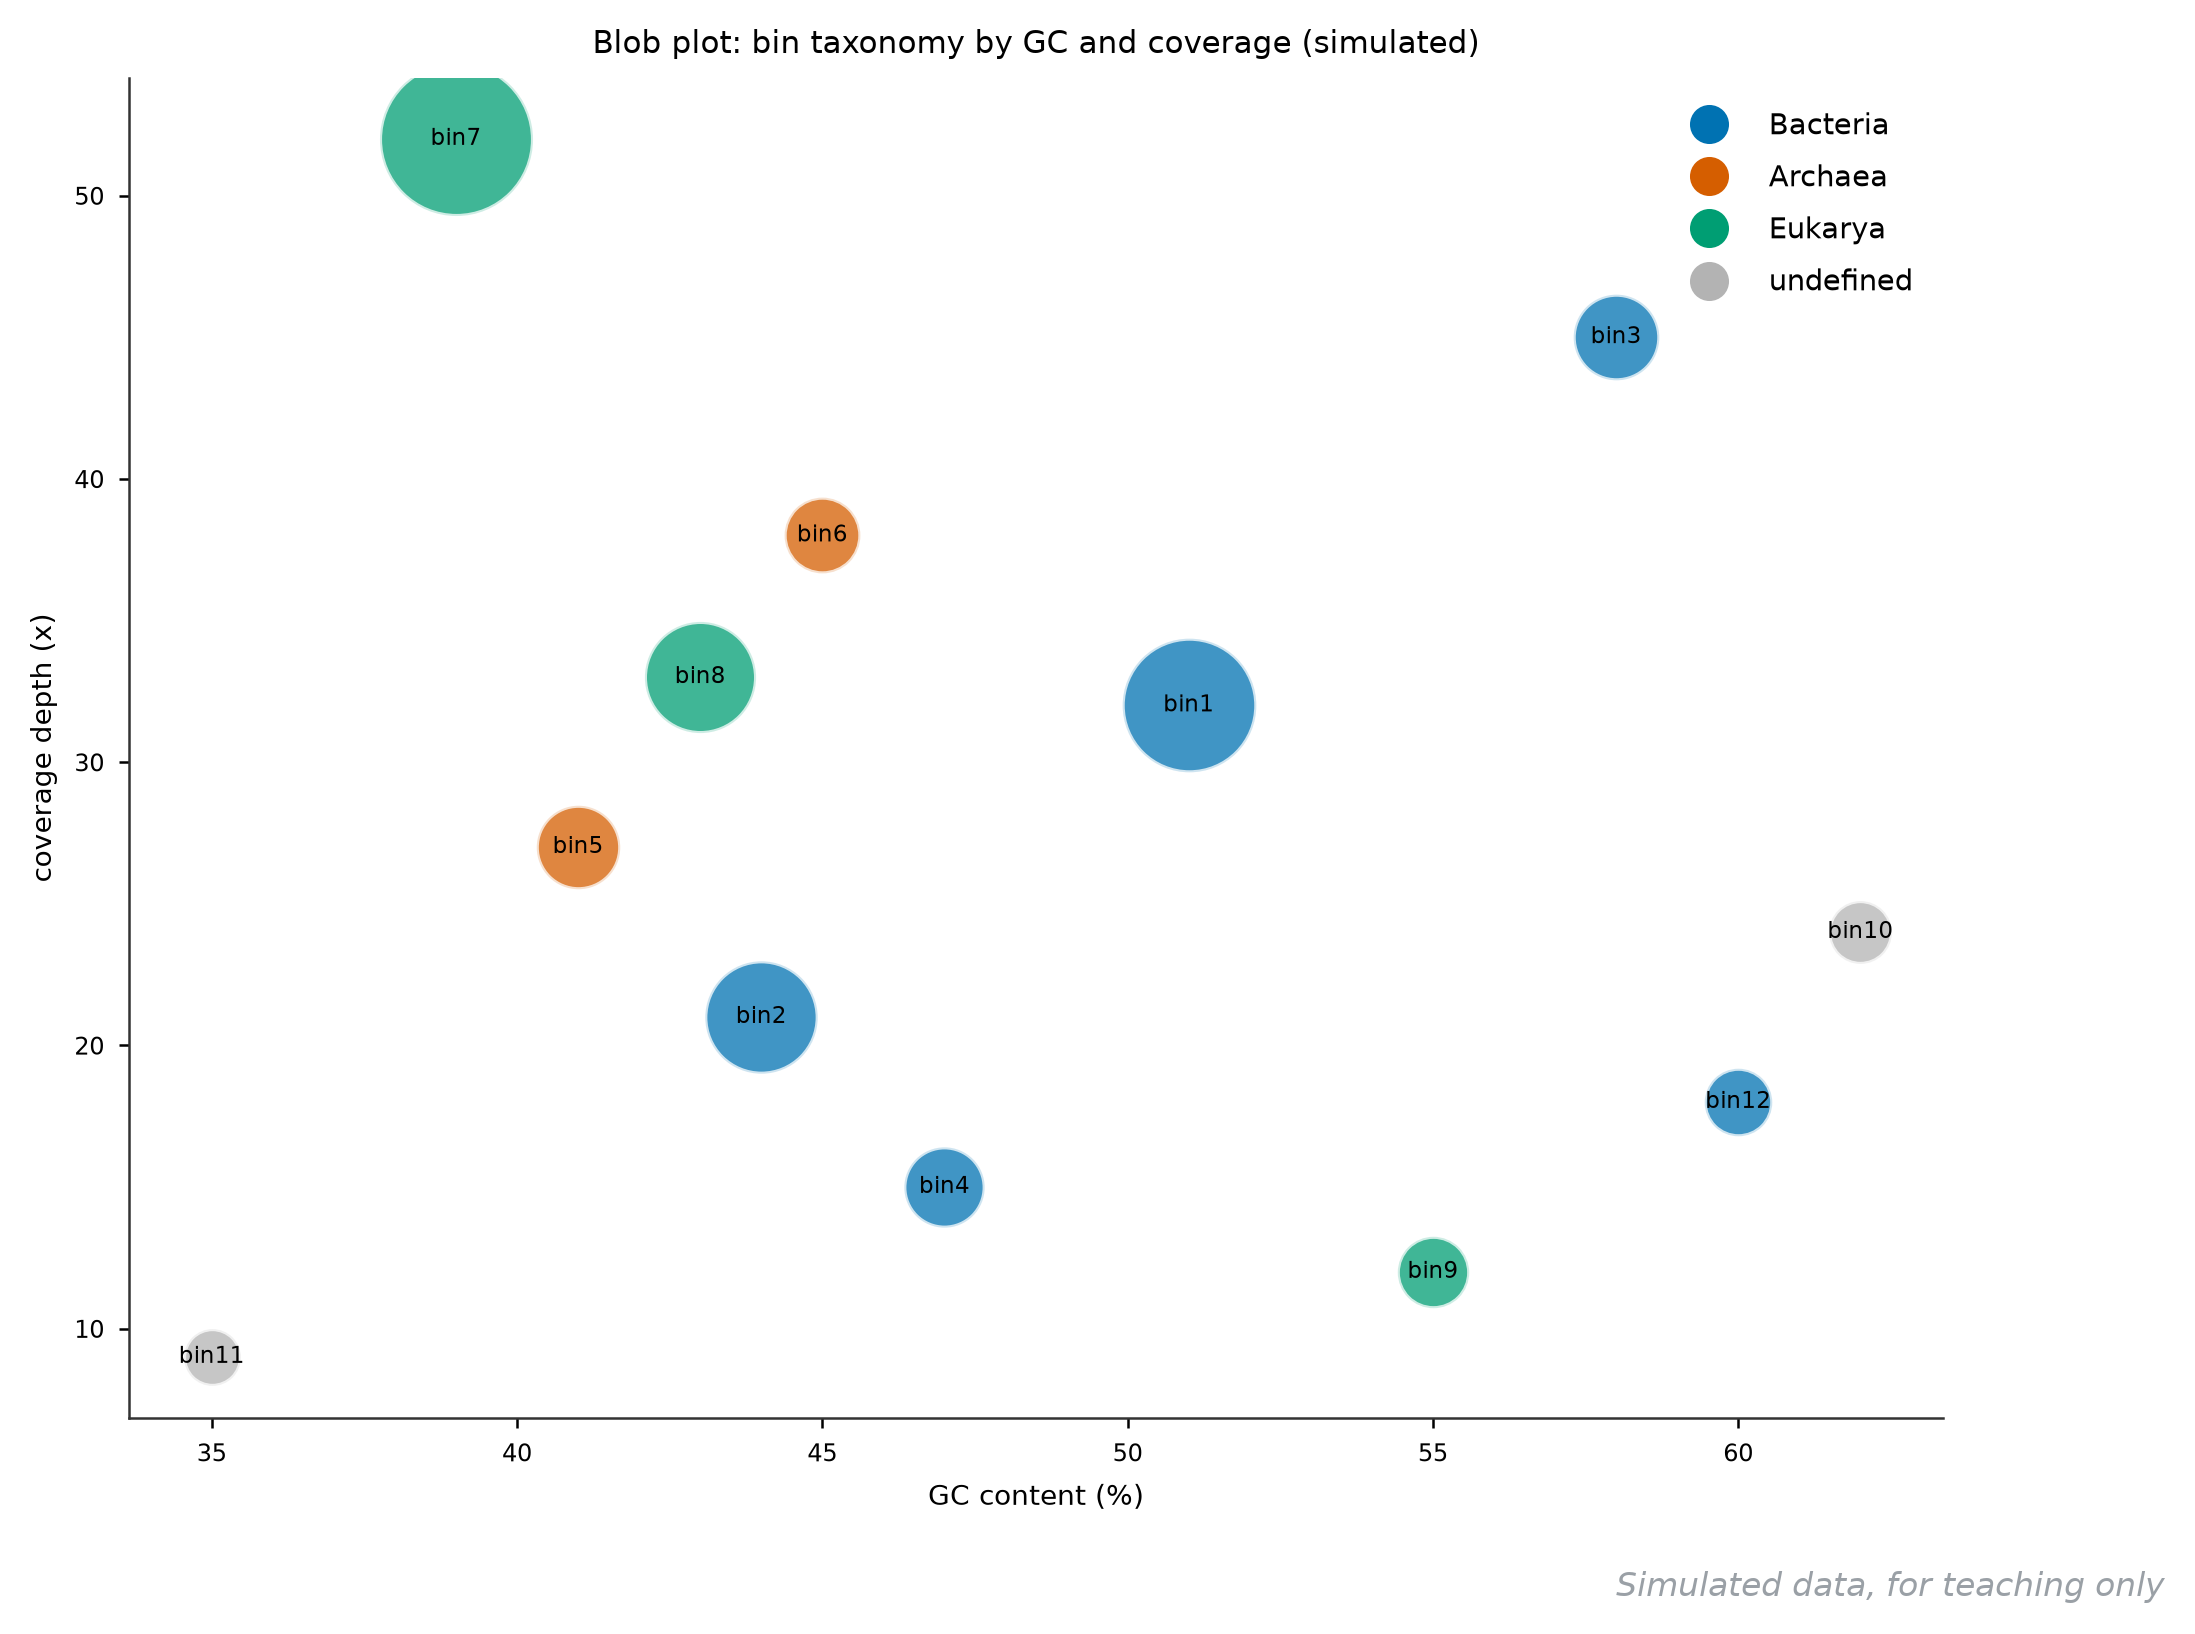
它回答什么问题 :宏基因组组装出的每个 bin 是「谁」、干净不干净——GC 含量、覆盖度、分类三重证据叠在一张图上,bin 提纯(rectification)前的必看图。
怎么读 :横轴 GC%、纵轴覆盖度,点大小与 bin 长度成正比,颜色是分类学归属。同一基因组应聚成 GC/覆盖度一致的「云」:bin7(Eukarya,39% GC、52×、31.6 Mb 的大泡泡)自成一团没问题;但要警惕「一色多点散开」——若同一分类的点覆盖度差好几倍,多半混了多个物种或菌株。右下角的 undefined 小碎片(bin11,35% GC、9×、0.6 Mb)通常是低质量 bin,先查 completeness/contamination 再决定并入还是丢弃;GC 极端(62%)又小的 bin12 要防污染。
用什么画 :BlobToolKit 一条命令出全套;重绘按 bin-分类-GC-覆盖度-长度表画气泡图。
图注示例 :
图 123 12 个宏基因组组装 bin 的 Blob 图(模拟)。横轴 GC%、纵轴覆盖度,气泡面积与 bin 长度成正比;bin7(Eukarya)以 31.6 Mb、52× 覆盖度独立成团,bin11(undefined,0.6 Mb)与 bin12(60% GC)需进一步质控。
展开查看:bin 数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 bin,taxonomy,gc,coverage,length_mb bin1,Bacteria,51,32,18.4 bin2,Bacteria,44,21,9.2 bin3,Bacteria,58,45,3.1 bin4,Bacteria,47,15,2.4 bin5,Archaea,41,27,2.8 bin6,Archaea,45,38,1.9 bin7,Eukarya,39,52,31.6 bin8,Eukarya,43,33,8.8 bin9,Eukarya,55,12,1.5 bin10,undefined,62,24,0.9 bin11,undefined,35,9,0.6 bin12,Bacteria,60,18,1.2
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("123-blob.csv" ) CAT = {"Bacteria" : "#4C72B0" , "Archaea" : "#DD8452" , "Eukarya" : "#55A868" , "undefined" : "0.6" } fig, ax = plt.subplots(figsize=(7.8 , 5.6 )) for tax, sub in df.groupby("taxonomy" ): ax.scatter(sub.gc, sub.coverage, s=sub.length_mb * 26 + 40 , color=CAT[tax], alpha=0.75 , edgecolors="white" , label=tax) for _, r in df.iterrows(): ax.text(r.gc, r.coverage, r["bin" ], fontsize=7 , ha="center" , va="center" , zorder=4 ) ax.set_xlim(30 , 68 ) ax.set_ylim(0 , 62 ) ax.set_xlabel("GC content (%)" ) ax.set_ylabel("coverage (x)" ) ax.legend(fontsize=9 , loc="upper right" ) ax.set_title("Blob plot: bin taxonomy by GC and coverage (simulated)" ) fig.savefig("123-blob.png" , dpi=200 , bbox_inches="tight" )
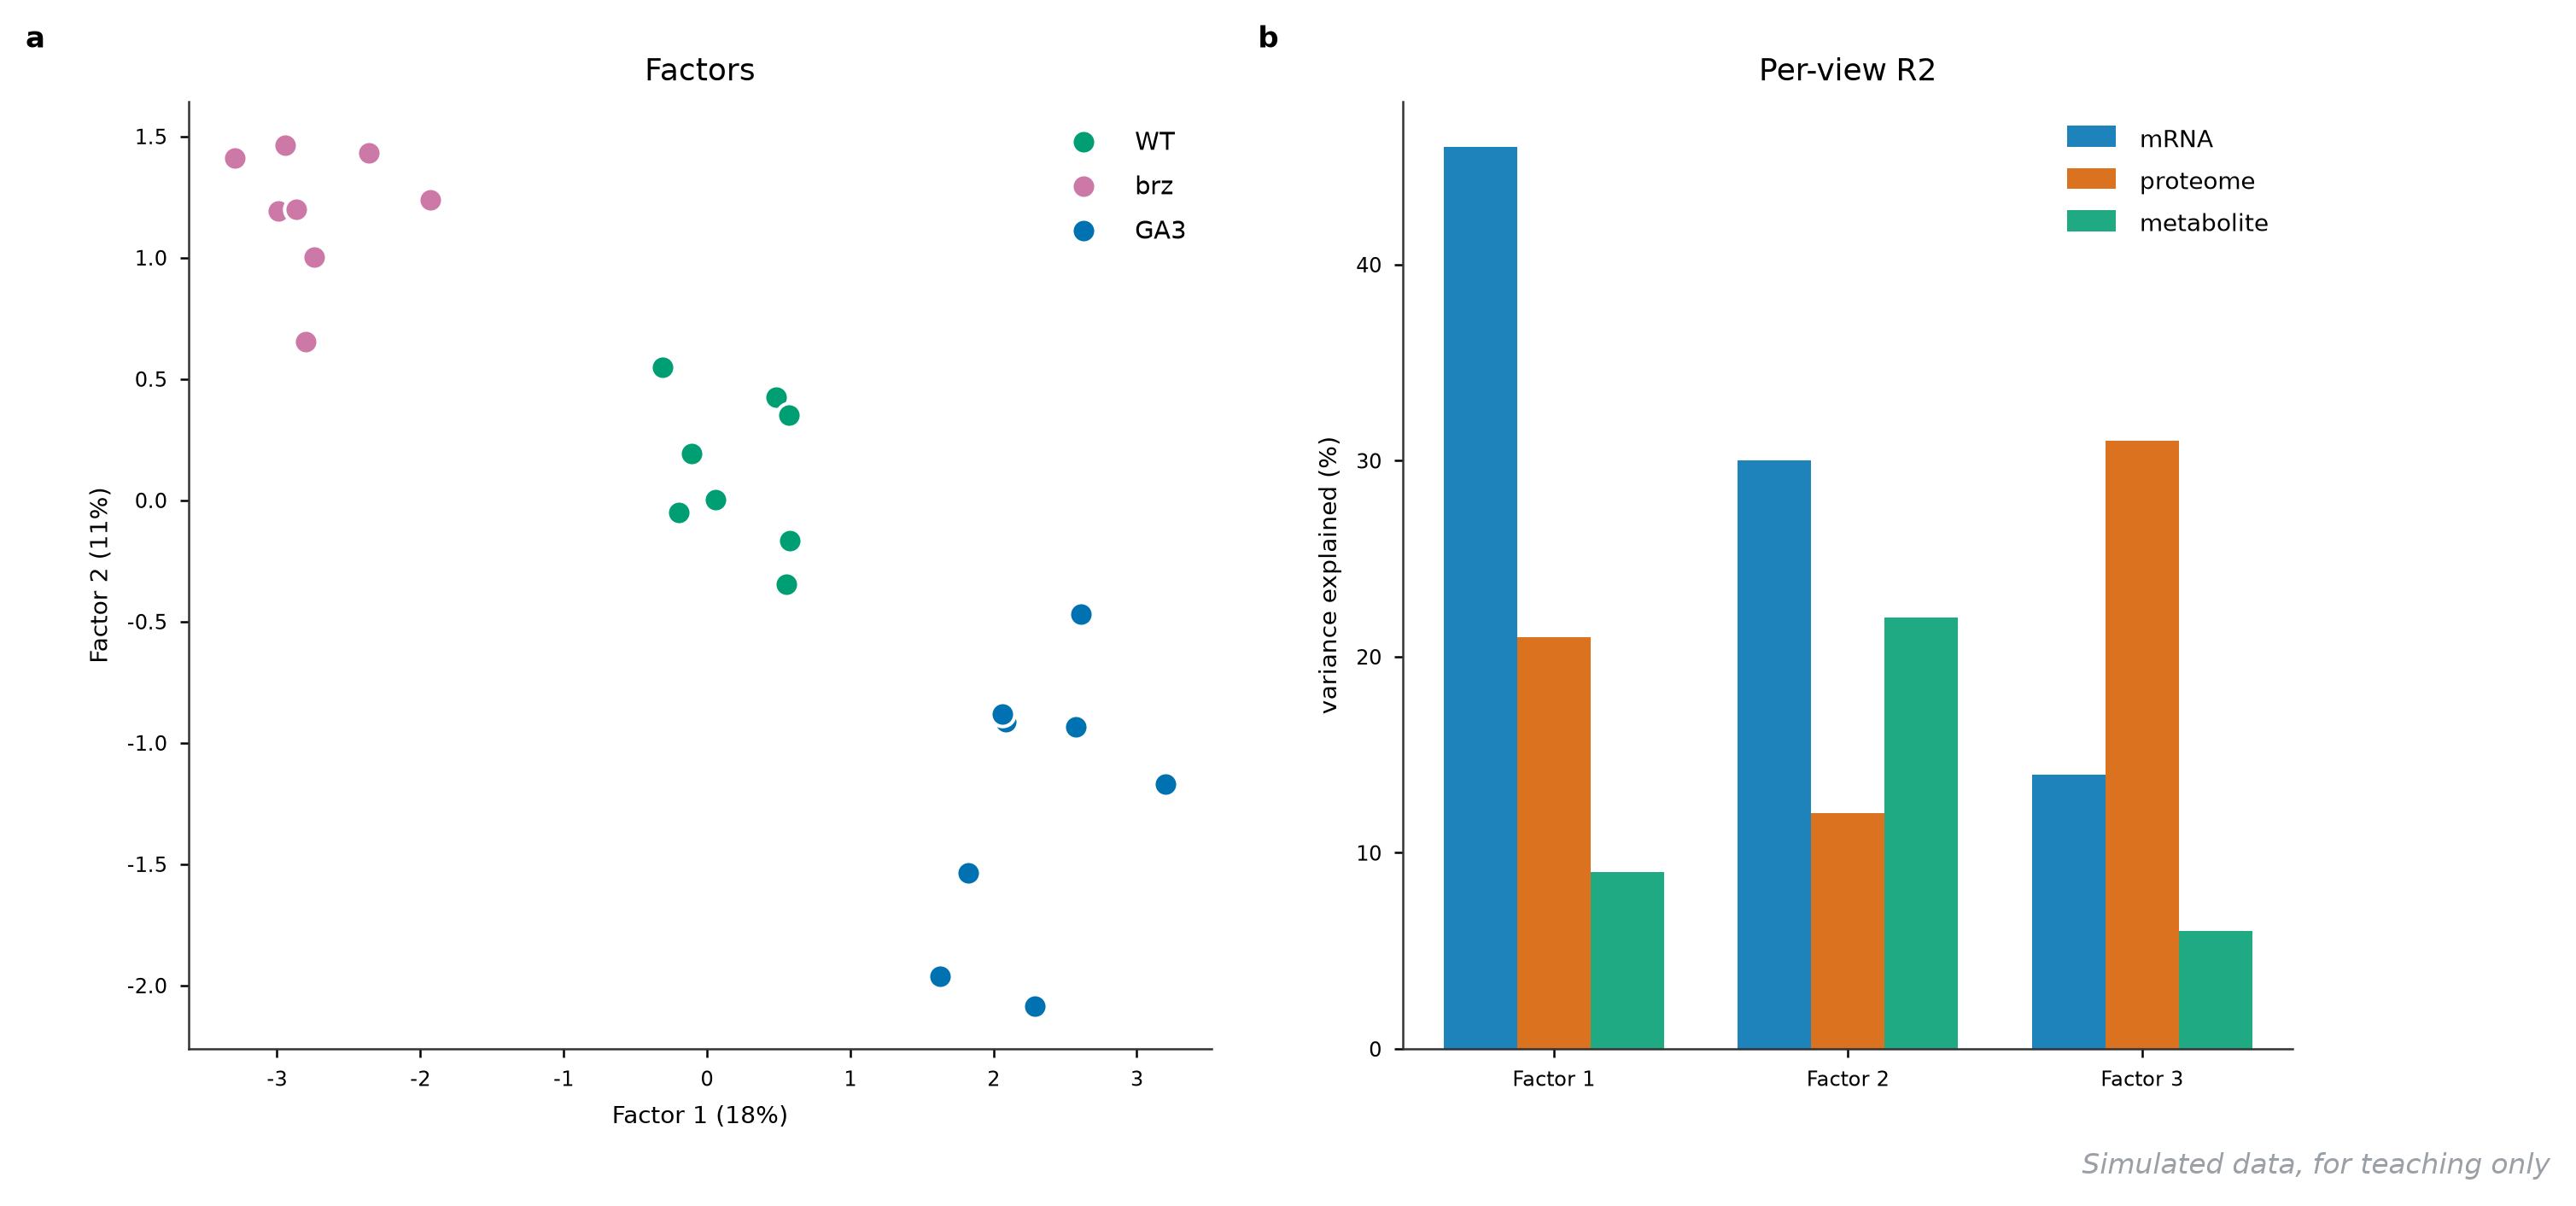
六、AI 与多组学前沿 6.1 MOFA 因子图
它回答什么问题 :转录组、蛋白组、代谢组一起测时,各组学共享的「变化主线」是什么——MOFA 把三套数据压进少数几个因子,多组学整合从「三张图各说各话」变成一张图。
怎么读 :左面板是样本在前两个因子上的散点(按基因型着色):Factor1 把三组排成一条直线(brz 在 -3.3 到 -1.9,WT 居中,GA3 在 +1.6 到 +3.2)——这是处理效应的「总轴」;Factor2 上 WT7 独自上飘(0.55),值得查批次。右面板是每个因子在各组学里的解释方差 R2:Factor1 主要由 mRNA(46%)和蛋白组(30%)驱动,Factor2 则代谢组贡献最大(31%)——哪个组学主导哪个生物学过程,一目了然。判读纪律:因子要回头去看载荷(哪些基因/代谢物压在因子上),不能停在「分开了」。
用什么画 :MOFA2(R/Python)官方 pipeline;重绘按 样本-因子 坐标与 组学-R2 表拼双面板。
图注示例 :
图 124 24 个样本转录组-蛋白组-代谢组的 MOFA 因子分析(模拟)。左:Factor1-Factor2 散点,Factor1 沿 brz-WT-GA3 排列;右:各因子逐组学解释方差,Factor1 由 mRNA(46%)与蛋白组(30%)主导,Factor2 以代谢组最高(31%)。
展开查看:因子坐标与 R2 数据、绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 sample,genotype,factor1,factor2 WT1,WT,-0.11,0.19 WT2,WT,0.06,0.00 WT3,WT,0.48,0.42 WT4,WT,0.57,0.35 WT5,WT,-0.20,-0.05 WT6,WT,0.56,-0.35 WT7,WT,-0.31,0.55 WT8,WT,0.58,-0.17 brz1,brz,-1.93,1.24 brz2,brz,-2.99,1.19 brz3,brz,-2.94,1.46 brz4,brz,-2.80,0.65 brz5,brz,-2.87,1.20 brz6,brz,-2.74,1.00 brz7,brz,-2.36,1.43 brz8,brz,-3.29,1.41 GA31,GA3,2.57,-0.93 GA32,GA3,2.08,-0.91 GA33,GA3,1.83,-1.53 GA34,GA3,2.61,-0.47 GA35,GA3,3.20,-1.17 GA36,GA3,1.62,-1.96 GA37,GA3,2.29,-2.08 GA38,GA3,2.06,-0.88
1 2 3 4 view,factor1_r2,factor2_r2,factor3_r2 mRNA,46,21,9 proteome,30,12,22 metabolite,14,31,6
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfac = pd.read_csv("124-mofa-factors.csv" ) r2 = pd.read_csv("124-mofa-r2.csv" ) gcol = {"WT" : "#4C72B0" , "brz" : "#C44E52" , "GA3" : "#55A868" } fig, (ax1, ax2) = plt.subplots(1 , 2 , figsize=(11.4 , 4.8 ), gridspec_kw={"width_ratios" : [1.15 , 1 ]}) for g, sub in fac.groupby("genotype" ): ax1.scatter(sub.factor1, sub.factor2, s=48 , color=gcol[g], edgecolors="white" , label=g, zorder=3 ) ax1.axhline(0 , color="0.85" , lw=0.8 ) ax1.axvline(0 , color="0.85" , lw=0.8 ) ax1.set_xlabel("Factor 1" ) ax1.set_ylabel("Factor 2" ) ax1.legend(fontsize=9 ) ax1.set_title("Factors" , fontsize=11 ) views = r2["view" ].tolist() x = np.arange(3 ) for k, fk in enumerate (["factor1_r2" , "factor2_r2" , "factor3_r2" ]): ax2.bar(x + (k - 1 ) * 0.26 , r2[fk], width=0.24 , color=["#4C72B0" , "#DD8452" , "#55A868" ][k], label="Factor %d" % (k + 1 )) ax2.set_xticks(x) ax2.set_xticklabels(views) ax2.set_ylabel("R2 (%)" ) ax2.legend(fontsize=9 ) ax2.set_title("Per-view R2" , fontsize=11 ) fig.savefig("124-mofa.png" , dpi=200 , bbox_inches="tight" )
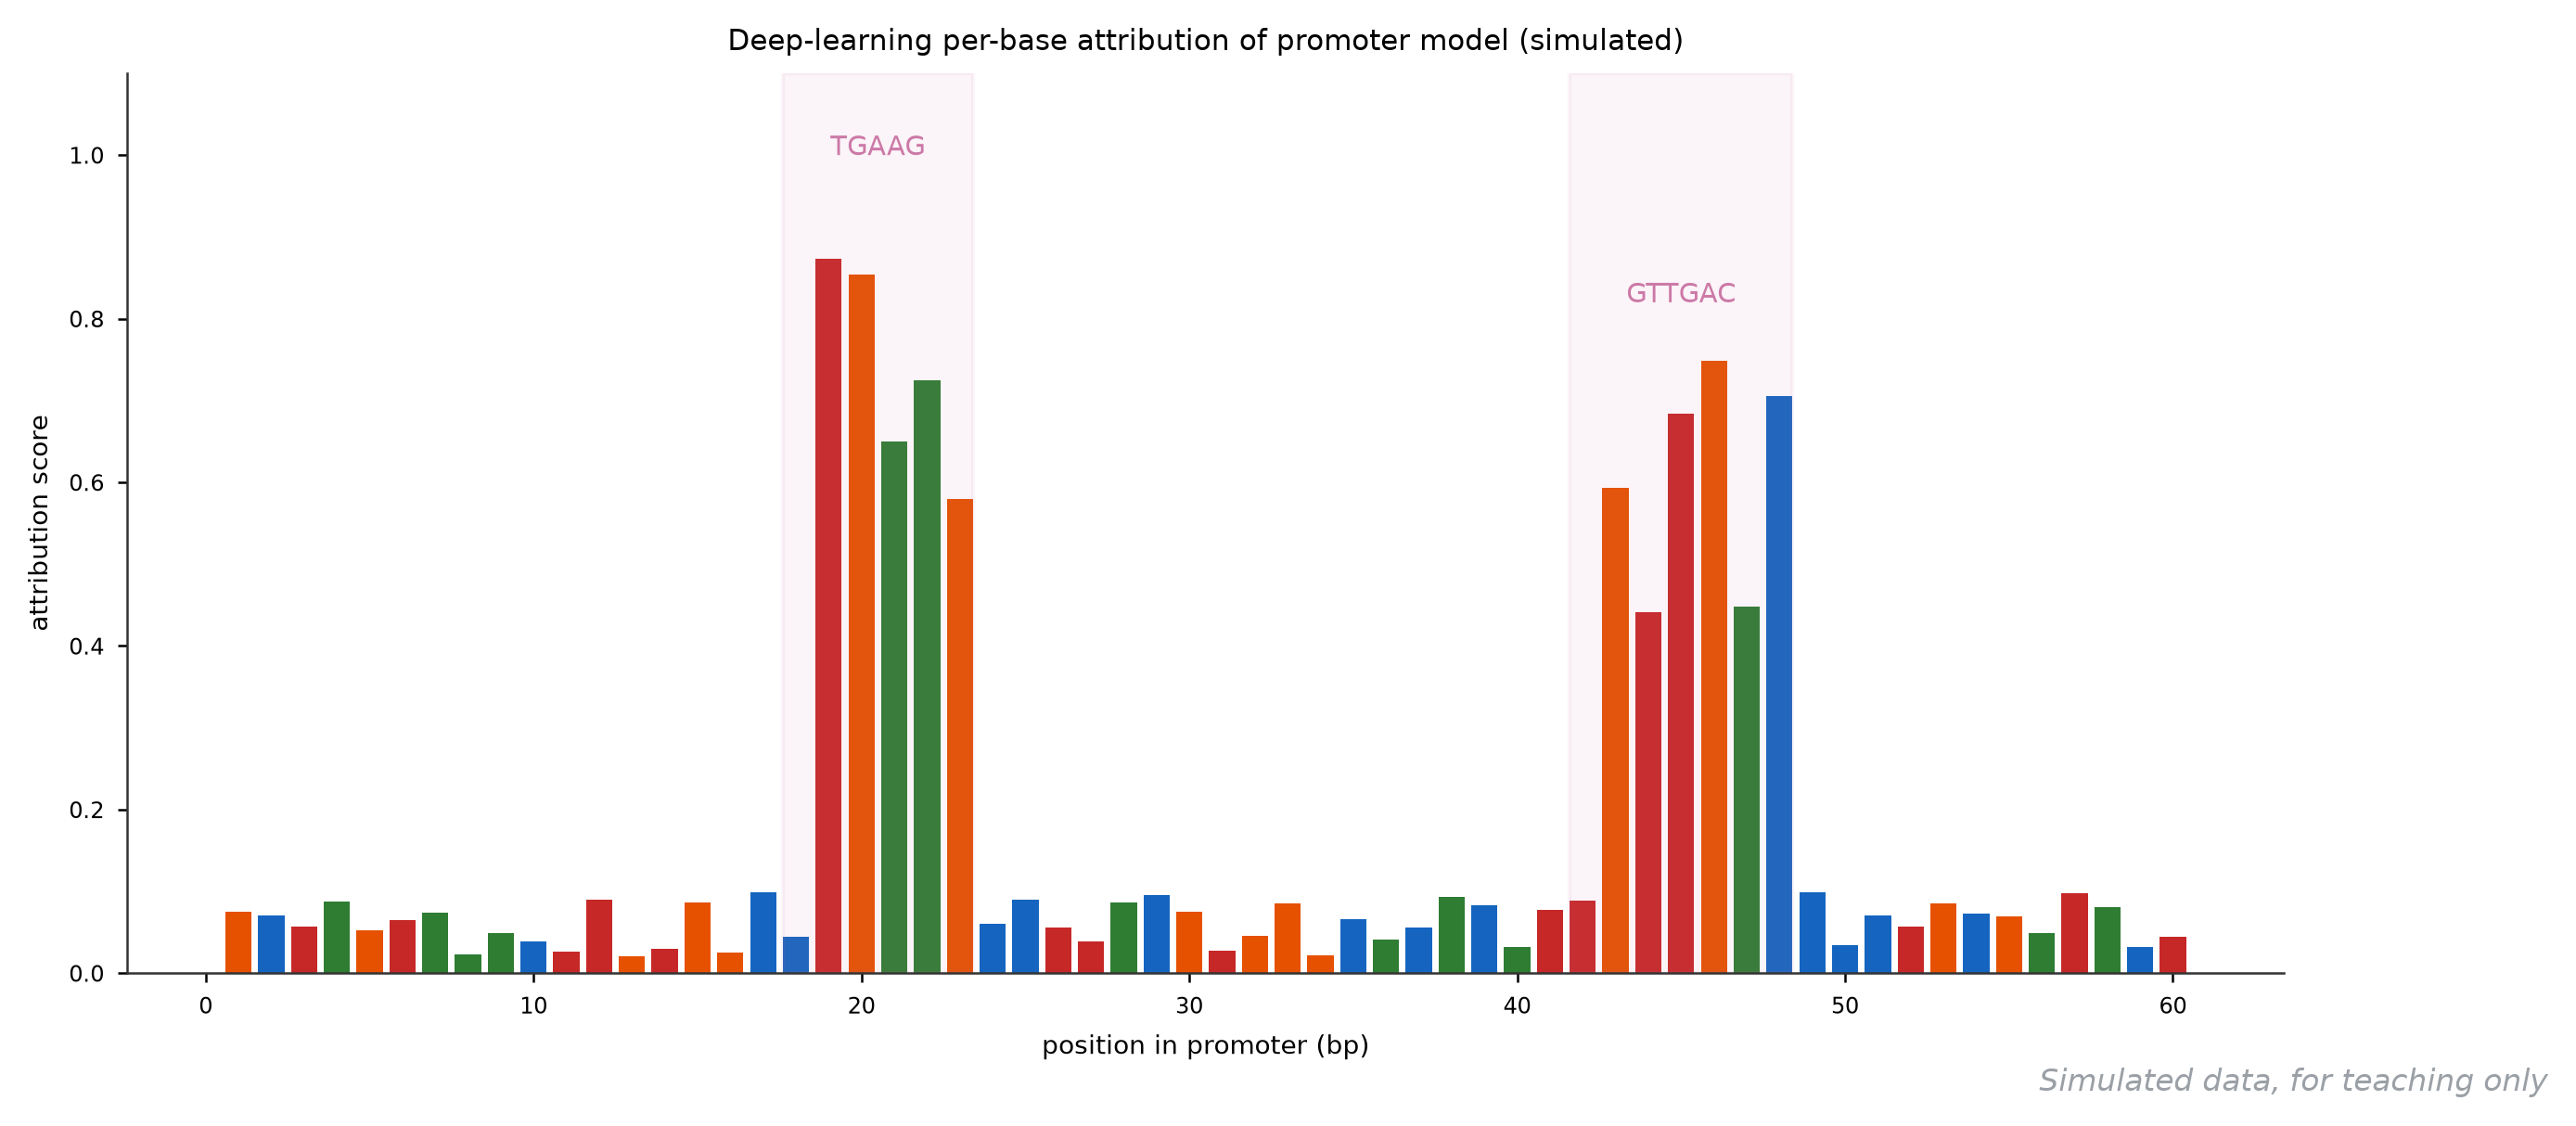
6.2 深度学习归因轨迹图
它回答什么问题 :模型预测启动子强度时,到底在「看」哪些碱基——把逐碱基归因分数画成轨迹,深度学习模型从黑箱变成可核对的假设生成器。
怎么读 :横轴启动子位置(60 bp),每根柱是一个碱基(按 A/C/G/T 着色),柱高为归因分数。两个高归因区跳出来:19-23 位的 TGAAG(0.58-0.87)和 43-48 位的 GTTGAC(0.44-0.75),与 EMSA 验证的 BZR1 结合基序对上了——模型「看重」的位置和湿实验「验证」的位点咬合,这是 AI 结果可信的最强证据形式。判读纪律:归因高≠因果,要 shuffle 对照(打乱序列后归因应消失);多个高归因区但都不匹配已知 motif 时,先怀疑模型学了背景特征(GC 含量、poly-A)。
用什么画 : saliency/integrated gradients 出原始分数,TF-MoDISco 聚成 motif;重绘按 位置-碱基-归因 表画彩色柱状。
图注示例 :
图 125 启动子强度模型的逐碱基归因轨迹(模拟,60 bp)。柱高为归因分数、颜色为碱基;19-23 位 TGAAG(峰值 0.87)与 43-48 位 GTTGAC(0.75)两个高归因区,与 EMSA 验证的 BZR1 结合基序一致。
展开查看:归因数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 pos,base,attribution 1,G,0.07 2,C,0.07 3,T,0.06 4,A,0.09 5,G,0.05 6,T,0.06 7,A,0.07 8,A,0.02 9,A,0.05 10,C,0.04 11,T,0.03 12,T,0.09 13,G,0.02 14,T,0.03 15,G,0.09 16,G,0.03 17,C,0.10 18,C,0.04 19,T,0.87 20,G,0.85 21,A,0.65 22,A,0.72 23,G,0.58 24,C,0.06 25,C,0.09 26,T,0.06 27,T,0.04 28,A,0.09 29,C,0.10 30,G,0.07 31,T,0.03 32,G,0.05 33,G,0.08 34,G,0.02 35,C,0.07 36,A,0.04 37,C,0.06 38,A,0.09 39,C,0.08 40,A,0.03 41,T,0.08 42,T,0.09 43,G,0.59 44,T,0.44 45,T,0.68 46,G,0.75 47,A,0.45 48,C,0.71 49,C,0.10 50,C,0.03 51,C,0.07 52,T,0.06 53,G,0.09 54,C,0.07 55,G,0.07 56,A,0.05 57,T,0.10 58,A,0.08 59,C,0.03 60,T,0.04
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("125-saliency.csv" ) BASE = {"A" : "#55A868" , "C" : "#4C72B0" , "G" : "#DD8452" , "T" : "#C44E52" } fig, ax = plt.subplots(figsize=(9.6 , 4.2 )) ax.bar(df.pos, df.attribution, color=[BASE[b] for b in df.base], width=0.82 ) ax.text(20.5 , 1.0 , "TGAAG" , ha="center" , fontsize=9 , color="#C44E52" ) ax.text(45 , 0.82 , "GTTGAC" , ha="center" , fontsize=9 , color="#C44E52" ) ax.set_xlim(0 , 61 ) ax.set_ylim(0 , 1.08 ) ax.set_xlabel("promoter position (bp)" ) ax.set_ylabel("attribution score" ) ax.set_title("Deep-learning per-base attribution of promoter model (simulated)" ) fig.savefig("125-saliency.png" , dpi=200 , bbox_inches="tight" )
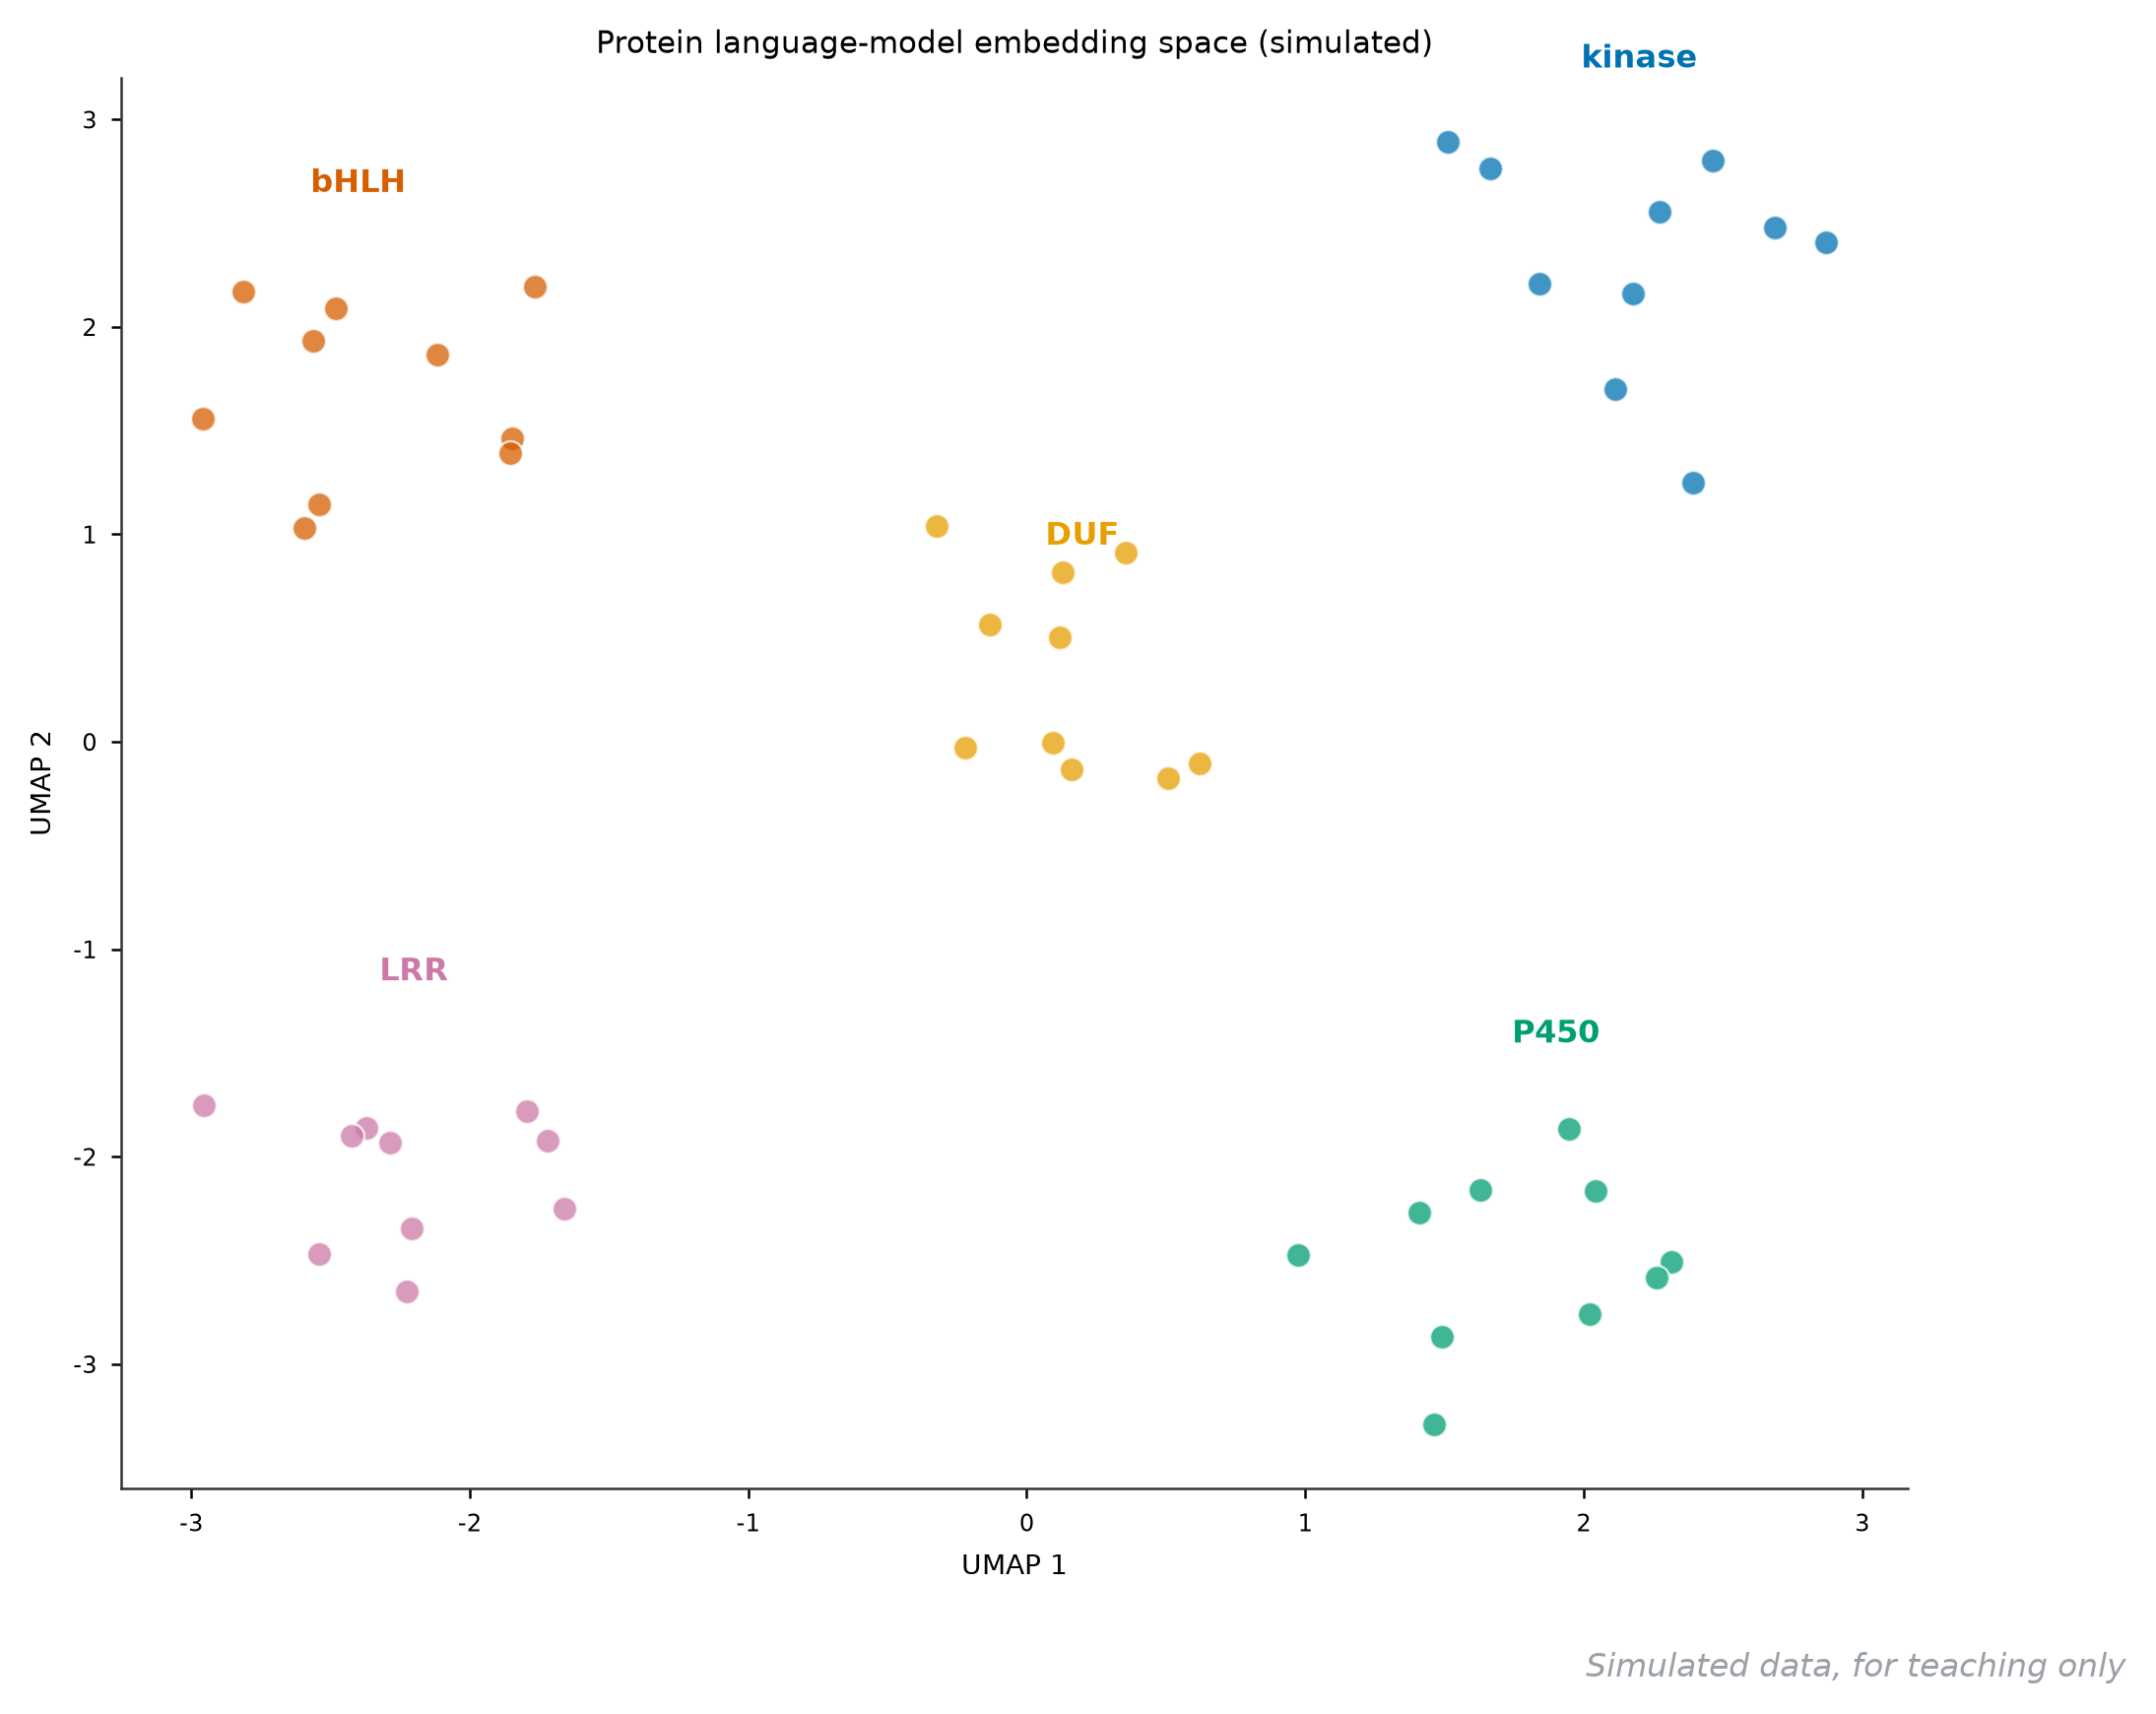
6.3 蛋白语言模型嵌入 UMAP
它回答什么问题 :不用比对,只靠序列「语感」,蛋白能不能按家族分开——ESM 这类蛋白语言模型把每条序列变成向量后降维,是大规模功能注释的当红路线。
怎么读 :每个点一条蛋白(此处每家族 10 条),颜色是已知家族标签。四个已知家族各自聚团、团间零重叠,说明嵌入空间里「序列相似=功能相近」成立;中央的 DUF(未知功能域)团不与任何家族融合——它是个真实的未知家族,语言模型给出的最近邻家族就是注释候选。判读纪律:UMAP 的距离没有全局意义,只看「团与团的关系」;团若散碎,先查序列长度分布是不是被嵌入长度偏置带偏了。
用什么画 :ESM-2/ProtTrans 出嵌入,UMAP 降维;重绘对 嵌入坐标-家族 表散点并标质心。
图注示例 :
图 126 50 条蛋白的 ESM 嵌入 UMAP 投影(模拟)。每家族 10 条:kinase、bHLH、P450、LRR 各自聚团,中心 DUF 家族(绿色)与已知家族均不重叠,为候选新家族。
展开查看:嵌入坐标与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 protein,family,umap1,umap2 kinase_1,kinase,1.51,2.89 kinase_2,kinase,1.67,2.76 kinase_3,kinase,2.69,2.48 kinase_4,kinase,1.84,2.21 kinase_5,kinase,2.18,2.16 kinase_6,kinase,2.87,2.41 kinase_7,kinase,2.11,1.70 kinase_8,kinase,2.27,2.56 kinase_9,kinase,2.39,1.25 kinase_10,kinase,2.47,2.80 bHLH_1,bHLH,-1.77,2.19 bHLH_2,bHLH,-2.96,1.56 bHLH_3,bHLH,-1.85,1.46 bHLH_4,bHLH,-2.48,2.09 bHLH_5,bHLH,-2.81,2.17 bHLH_6,bHLH,-2.54,1.14 bHLH_7,bHLH,-1.85,1.39 bHLH_8,bHLH,-2.56,1.93 bHLH_9,bHLH,-2.59,1.03 bHLH_10,bHLH,-2.12,1.86 P450_1,P450,1.49,-2.87 P450_2,P450,2.31,-2.51 P450_3,P450,0.97,-2.47 P450_4,P450,2.04,-2.17 P450_5,P450,2.26,-2.58 P450_6,P450,1.46,-3.29 P450_7,P450,2.02,-2.76 P450_8,P450,1.63,-2.16 P450_9,P450,1.95,-1.87 P450_10,P450,1.41,-2.27 LRR_1,LRR,-1.72,-1.92 LRR_2,LRR,-2.28,-1.93 LRR_3,LRR,-2.37,-1.86 LRR_4,LRR,-2.23,-2.65 LRR_5,LRR,-2.21,-2.35 LRR_6,LRR,-2.42,-1.90 LRR_7,LRR,-1.79,-1.78 LRR_8,LRR,-2.54,-2.47 LRR_9,LRR,-1.66,-2.25 LRR_10,LRR,-2.95,-1.75 DUF_1,DUF,0.09,-0.00 DUF_2,DUF,-0.13,0.56 DUF_3,DUF,-0.22,-0.03 DUF_4,DUF,0.62,-0.10 DUF_5,DUF,0.13,0.81 DUF_6,DUF,-0.32,1.04 DUF_7,DUF,0.35,0.91 DUF_8,DUF,0.12,0.50 DUF_9,DUF,0.51,-0.18 DUF_10,DUF,0.16,-0.13
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("126-protein-embed.csv" ) CAT = {"kinase" : "#4C72B0" , "bHLH" : "#C44E52" , "P450" : "#DD8452" , "LRR" : "#8172B3" , "DUF" : "#55A868" } fig, ax = plt.subplots(figsize=(7.6 , 6.4 )) for fam, sub in df.groupby("family" ): ax.scatter(sub.umap1, sub.umap2, s=52 , color=CAT[fam], edgecolors="white" , label=fam, zorder=3 ) mx, my = sub.umap1.mean(), sub.umap2.mean() ax.text(mx, my + 0.85 , fam, ha="center" , fontsize=10 , fontweight="bold" , color=CAT[fam]) ax.set_xlabel("UMAP1" ) ax.set_ylabel("UMAP2" ) ax.legend(fontsize=9 , loc="lower right" ) ax.set_title("Protein language-model embedding space (simulated)" ) fig.savefig("126-protein-embed.png" , dpi=200 , bbox_inches="tight" )
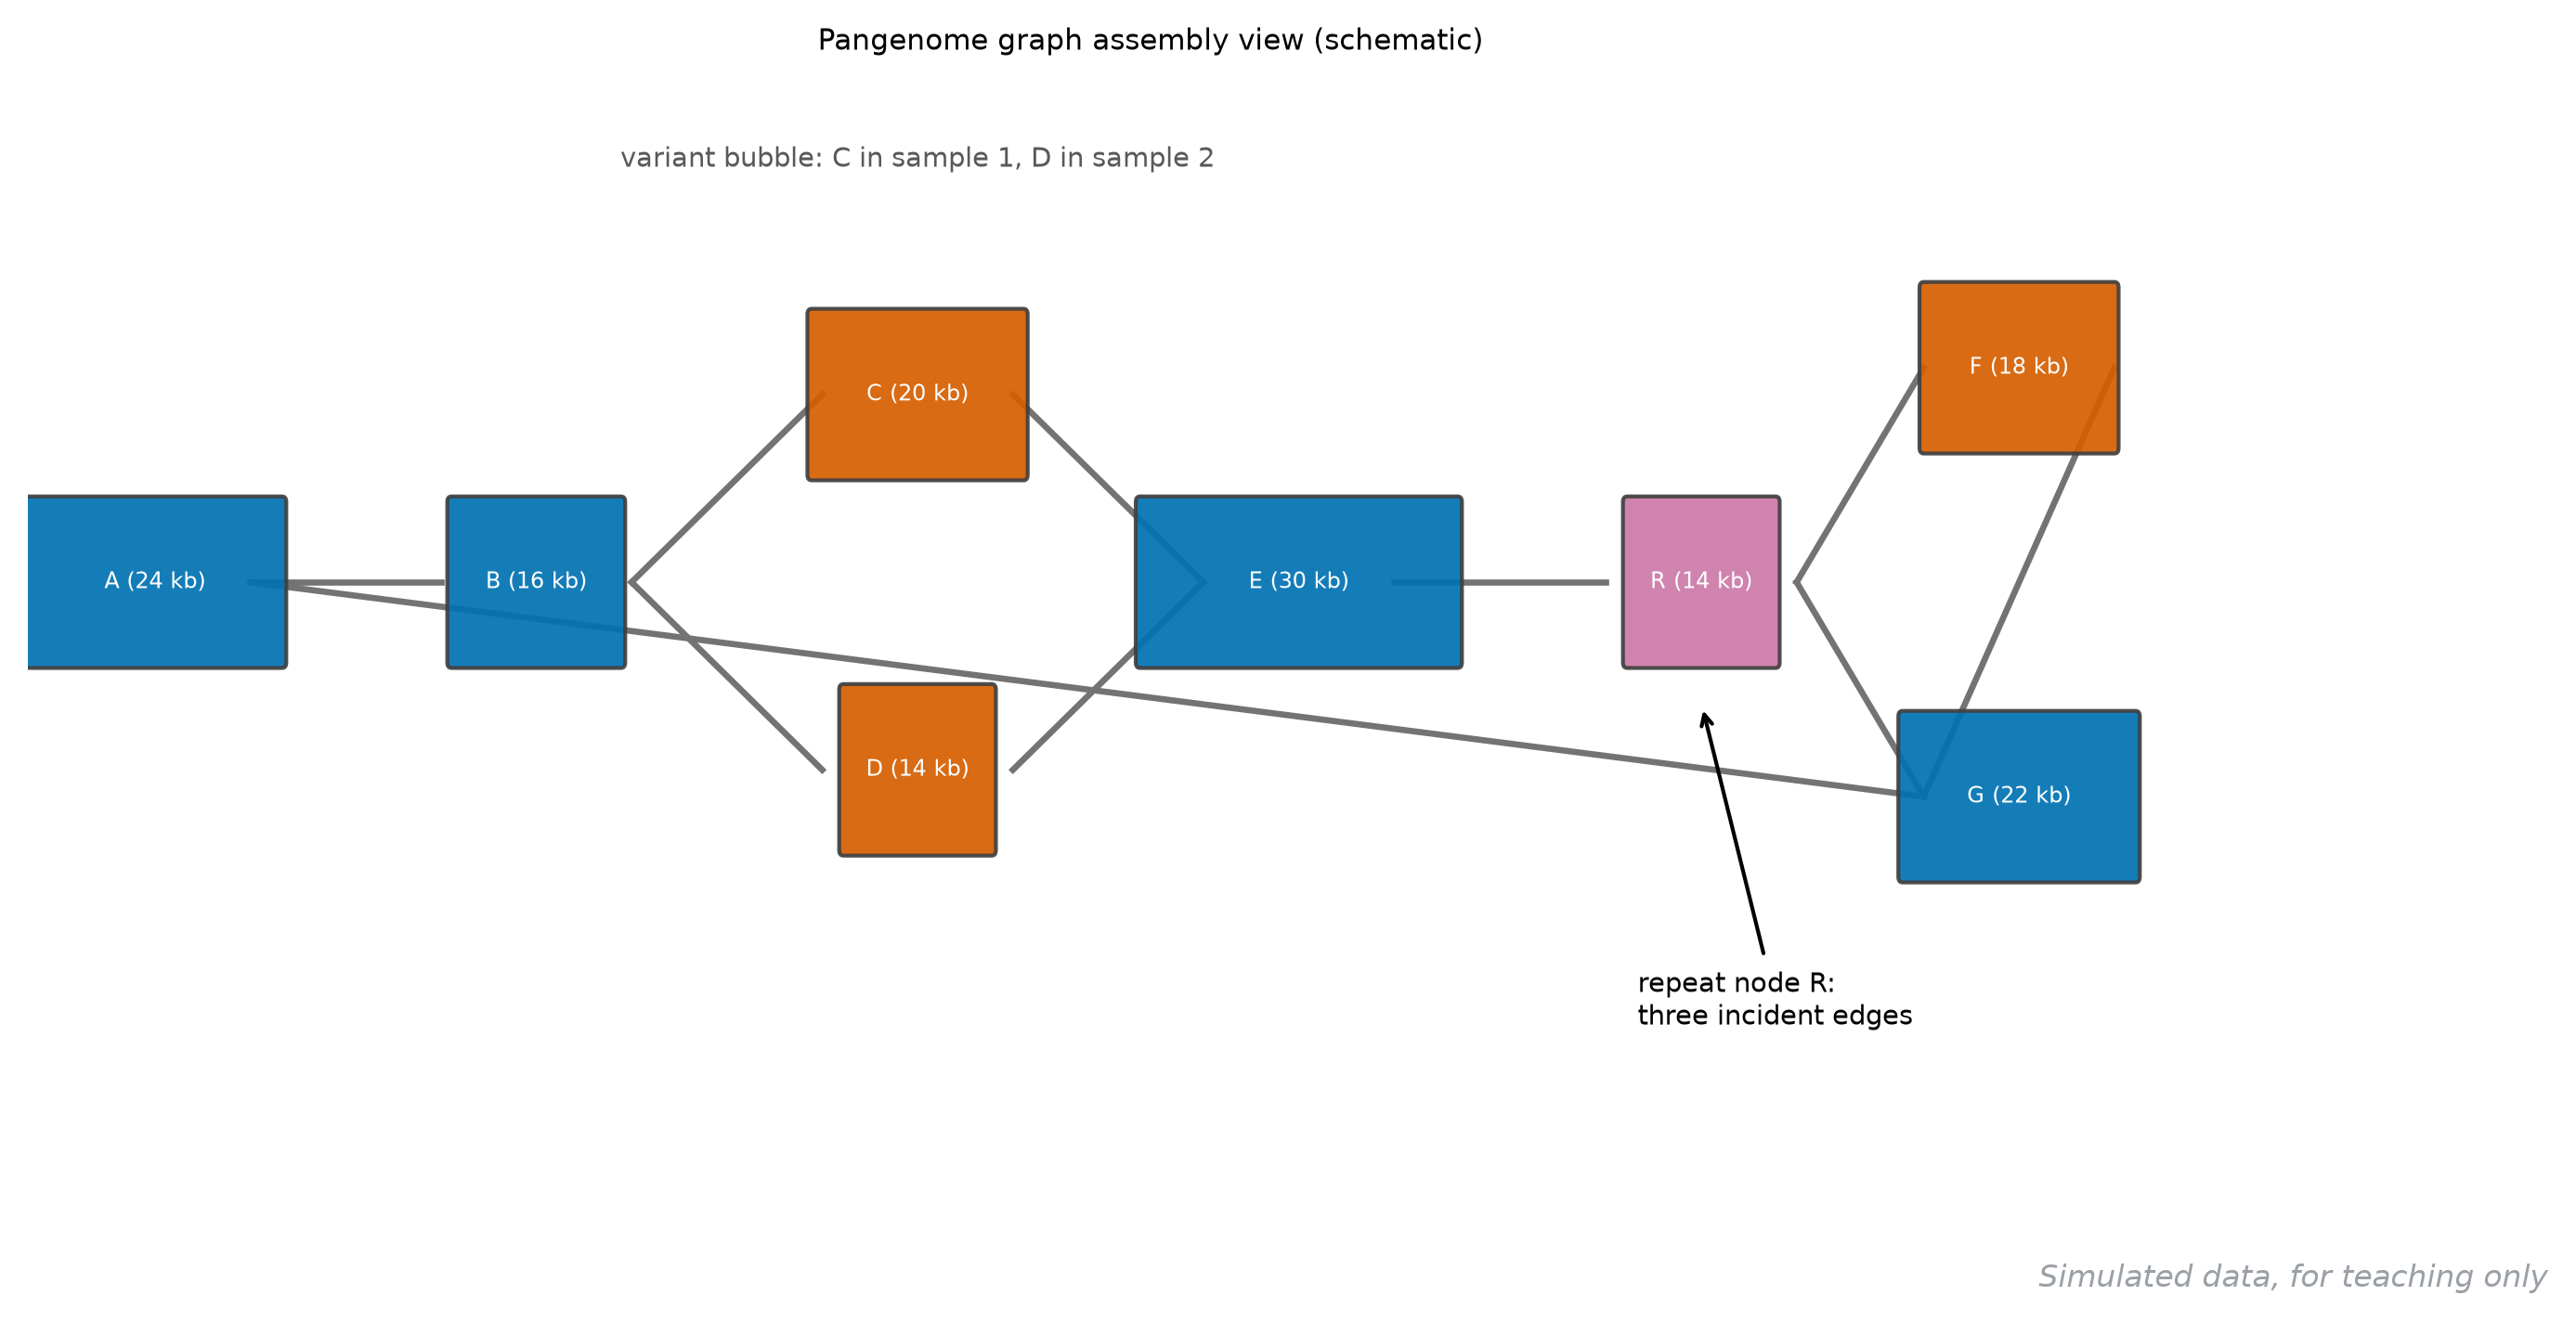
6.4 泛基因组组装图(graph 视图)
它回答什么问题 :单线性参考会漏掉的样本间结构变异长什么样——泛基因组把「一个参考」换成「一张图」,图视图(Bandage 风格)是检查组装图质量的肉眼关卡。
怎么读 :每个节点一段序列(标注长度),边是相邻关系;样本的基因组=图里的一条路径。三个看点:core 节点(深色,所有样本都走)构成主干;泡(bubble )是等位/结构分歧——C 与 D 组成泡,样本 1 走 C(20 kb)、样本 2 走 D(14 kb);repeat 节点 (R,14 kb,三条入射边)是多拷贝重复,也是长读长比对歧义的高发地。 accessory 节点(浅色)只在部分样本出现——泛基因组分析的核心产出就是统计「哪些 accessory 路径与表型共分离」。
用什么画 :pggb 构建图、Bandage 可视化;重绘按 节点表+边表 用圆角方块加连线。
图注示例 :
图 127 五样本泛基因组组装图的示意视图(模拟)。节点为序列段(标注长度,kb),core/accessory/repeat 三类着色;C-D 节点对构成样本间变异泡,repeat 节点 R 有三条入射边。
展开查看:节点与边数据、绘图代码 1 2 3 4 5 6 7 8 9 node,length_kb,class A,24,core B,16,core C,20,accessory D,14,accessory E,30,core R,14,repeat F,18,accessory G,22,core
1 2 3 4 5 6 7 8 9 10 11 node1,node2 A,B B,C B,D C,E D,E E,R R,F R,G F,G A,G
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 import pandas as pdimport matplotlib.pyplot as pltfrom matplotlib.patches import FancyBboxPatchnodes = pd.read_csv("127-pangenome-nodes.csv" ) edges = pd.read_csv("127-pangenome-edges.csv" ) pos = {"A" : (1.2 , 3.4 ), "B" : (2.8 , 3.4 ), "C" : (4.3 , 4.2 ), "D" : (4.3 , 2.6 ), "E" : (5.8 , 3.4 ), "R" : (7.2 , 2.1 ), "F" : (8.3 , 4.1 ), "G" : (9.4 , 3.0 )} col = {"core" : "#4C72B0" , "accessory" : "#DD8452" , "repeat" : "#C44E52" } w = {"A" : 1.2 , "B" : 0.8 , "C" : 1.0 , "D" : 0.7 , "E" : 1.5 , "R" : 0.7 , "F" : 0.9 , "G" : 1.1 } fig, ax = plt.subplots(figsize=(10.6 , 5.6 )) for _, e in edges.iterrows(): x1, y1 = pos[e.node1] x2, y2 = pos[e.node2] ax.plot([x1, x2], [y1, y2], color="0.55" , lw=1.6 , zorder=1 ) for _, n in nodes.iterrows(): x, y = pos[n.node] ax.add_patch(FancyBboxPatch((x - w[n.node] / 2 , y - 0.30 ), w[n.node], 0.60 , boxstyle="round,pad=0.02" , facecolor=col[n["class" ]], zorder=2 )) ax.text(x, y, "%s (%d kb)" % (n.node, n.length_kb), ha="center" , va="center" , fontsize=8 , color="white" , zorder=3 ) ax.text(4.3 , 4.72 , "variant bubble: C in sample 1, D in sample 2" , ha="center" , fontsize=9 , color="0.3" ) ax.annotate("repeat node R:\nthree incident edges" , (7.9 , 2.15 ), (8.6 , 1.5 ), fontsize=8.5 , arrowprops=dict (arrowstyle="->" , lw=1 )) ax.set_xlim(0.2 , 10.6 ) ax.set_ylim(0.9 , 5.1 ) ax.axis("off" ) ax.set_title("Pangenome graph assembly view (schematic)" ) fig.savefig("127-pangenome.png" , dpi=200 , bbox_inches="tight" )
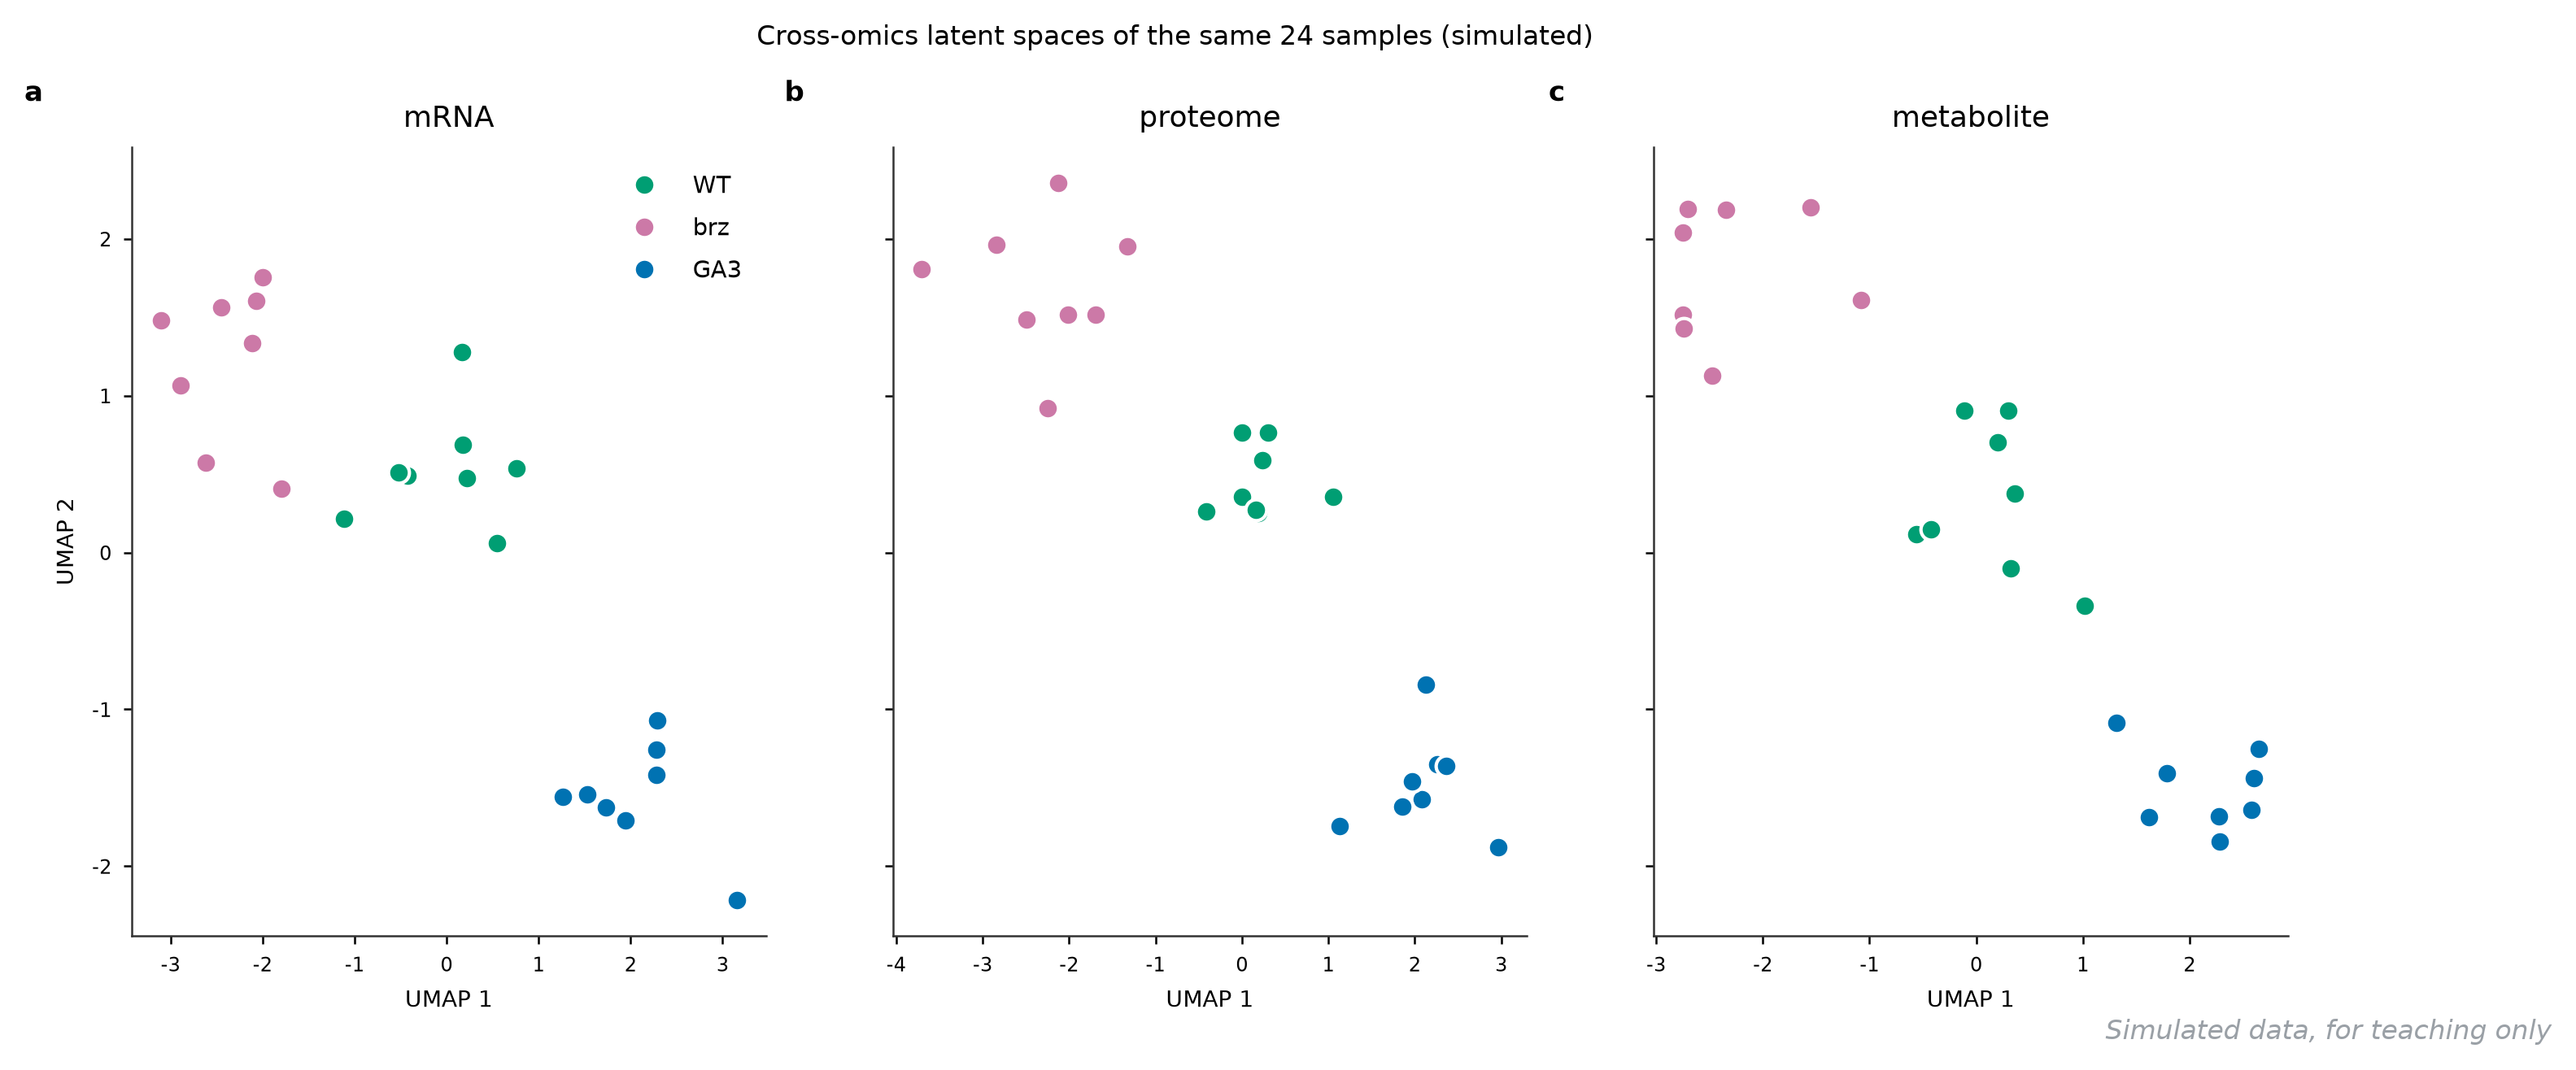
6.5 跨组学 UMAP 三联图
它回答什么问题 :三个组学各自降维后,结论互相印证吗——比 MOFA 少了统计建模,但更直观:同一样本集在三个空间里的「形状」应该讲同一个故事。
怎么读 :三个面板是同一批 24 个样本在 mRNA、蛋白组、代谢组各自 UMAP 空间里的位置,颜色统一按基因型。健康的整合:三张图里组间分离方向一致(brz 一侧、GA3 另一侧、WT 居中),且同一样本的三个影子相对位置不打架。本例三联全部按基因型分离——结论跨组学稳健;若某个组学面板里混作一团,先查它的批次效应与标准化,而不是急着下「该组学无差异」的结论。注意 UMAP 坐标跨面板不可比,比较的只是「分组结构」。
用什么画 :totalVI/MOFA 输出或各组学分别跑 UMAP 后拼图;重绘对 宽表(样本-基因型-三对 UMAP 坐标)画三联小倍数。
图注示例 :
图 128 同一批 24 个样本在转录组、蛋白组、代谢组三个 UMAP 空间中的投影(模拟,三联小倍数)。三个组学面板中样本均按基因型分离且方向一致,结论跨组学稳健。
展开查看:坐标数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 sample,genotype,umap1_mrna,umap2_mrna,umap1_prot,umap2_prot,umap1_met,umap2_met WT1,WT,0.18,0.69,0.31,0.77,0.30,0.90 WT2,WT,0.17,1.28,-0.41,0.26,-0.56,0.12 WT3,WT,-0.43,0.49,0.23,0.59,0.36,0.38 WT4,WT,-0.52,0.51,0.00,0.76,0.32,-0.10 WT5,WT,-1.12,0.22,0.19,0.25,-0.42,0.15 WT6,WT,0.55,0.06,0.00,0.36,0.20,0.70 WT7,WT,0.22,0.47,1.05,0.36,1.01,-0.34 WT8,WT,0.76,0.54,0.16,0.27,-0.11,0.90 brz1,brz,-2.07,1.61,-2.01,1.52,-1.55,2.20 brz2,brz,-3.11,1.48,-2.49,1.49,-2.75,1.52 brz3,brz,-2.62,0.57,-2.24,0.92,-2.74,1.43 brz4,brz,-2.11,1.33,-1.69,1.52,-2.71,2.19 brz5,brz,-2.89,1.07,-1.32,1.95,-2.34,2.19 brz6,brz,-2.00,1.75,-3.71,1.81,-2.75,2.04 brz7,brz,-1.80,0.41,-2.84,1.96,-2.47,1.13 brz8,brz,-2.45,1.56,-2.12,2.36,-1.08,1.61 GA31,GA3,1.94,-1.71,2.26,-1.35,2.28,-1.68 GA32,GA3,3.16,-2.22,2.96,-1.88,2.28,-1.84 GA33,GA3,1.73,-1.62,2.08,-1.58,2.60,-1.44 GA34,GA3,1.27,-1.56,2.37,-1.36,2.65,-1.25 GA35,GA3,1.53,-1.54,1.85,-1.62,2.58,-1.64 GA36,GA3,2.29,-1.07,1.96,-1.46,1.79,-1.41 GA37,GA3,2.28,-1.42,1.13,-1.75,1.31,-1.09 GA38,GA3,2.28,-1.26,2.13,-0.84,1.62,-1.69
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("128-multiomics.csv" ) gcol = {"WT" : "#4C72B0" , "brz" : "#C44E52" , "GA3" : "#55A868" } panels = [("umap1_mrna" , "umap2_mrna" , "mRNA" ), ("umap1_prot" , "umap2_prot" , "proteome" ), ("umap1_met" , "umap2_met" , "metabolite" )] fig, axes = plt.subplots(1 , 3 , figsize=(12.6 , 4.4 ), sharey=False ) for ax, (x, y, name) in zip (axes, panels): for g, sub in df.groupby("genotype" ): ax.scatter(sub[x], sub[y], s=38 , color=gcol[g], edgecolors="white" , label=g, zorder=3 ) ax.set_title(name, fontsize=11 ) axes[0 ].legend(fontsize=9 ) fig.suptitle("Cross-omics latent spaces of the same 24 samples (simulated)" , y=1.02 ) fig.savefig("128-multiomics.png" , dpi=200 , bbox_inches="tight" )
七、统计与呈现杂图 7.1 漏斗图
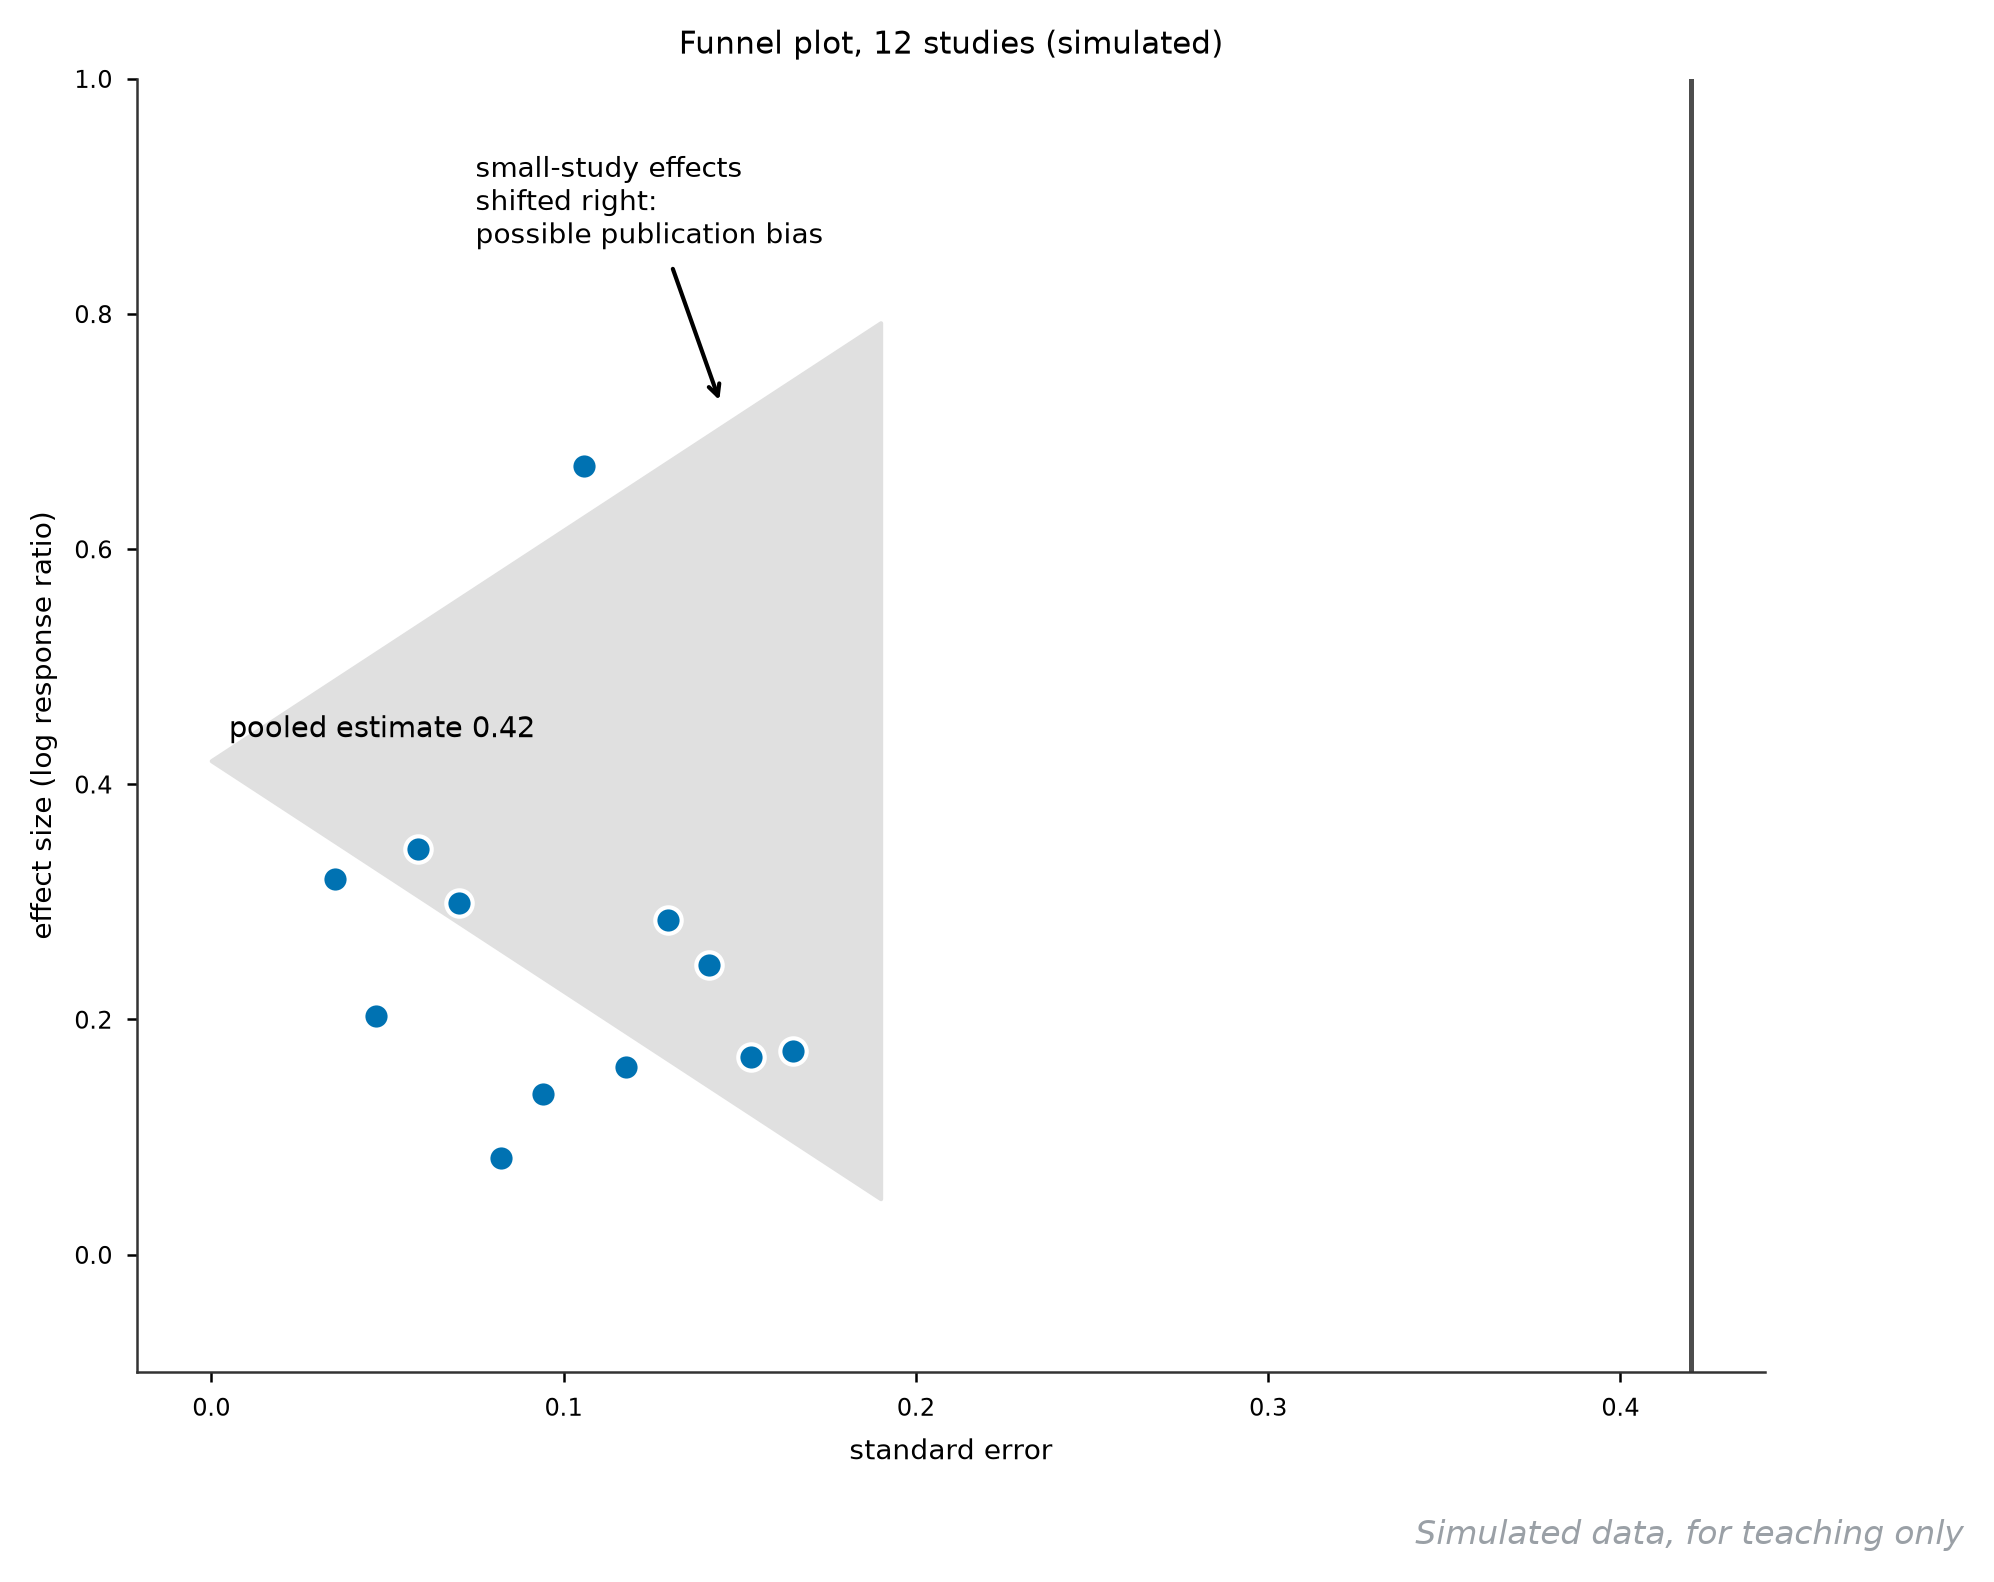
它回答什么问题 :把十几个研究合成一个结论的 meta 分析,有没有被「只发表阳性结果」带偏——漏斗图是发表偏倚的体检表。
怎么读 :横轴各研究的效应量,纵轴标准误(研究越弱越靠下),中竖线是合并效应(0.42),两侧斜线围出 95% 置信「漏斗」。理想状态:点关于竖线对称,小研究均匀散在漏斗两翼。本例 12 项研究整体围绕 0.42,但右翼漏出 S7(0.67、se 0.106)一类「小样本+高效应」的研究,右移明显——先做 Egger 回归检验,显著就跑剪补法(trim-and-fill)看合并效应会不会缩水。漏斗对称性差不是「删掉证据」,而是「降结论强度」的信号。
用什么画 :R metafor 的 funnel();重绘对 研究-效应-标准误 表散点加合并线与伪置信带。
图注示例 :
图 129 12 项研究效应量的漏斗图(模拟)。横轴效应量、纵轴标准误,中竖线为合并效应 0.42;右翼小样本研究(如 S7,0.67)整体右移,提示潜在发表偏倚。
展开查看:研究数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 study,effect,se S1,0.32,0.035 S2,0.20,0.047 S3,0.34,0.059 S4,0.30,0.070 S5,0.08,0.082 S6,0.14,0.094 S7,0.67,0.106 S8,0.16,0.118 S9,0.28,0.130 S10,0.25,0.141 S11,0.17,0.153 S12,0.17,0.165
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("129-funnel.csv" ) pooled = 0.42 se = np.linspace(0 , 0.19 , 50 ) fig, ax = plt.subplots(figsize=(6.8 , 5.4 )) ax.fill_betweenx(se, pooled - 1.96 * se, pooled + 1.96 * se, color="0.88" , zorder=0 ) ax.plot([pooled, pooled], [0 , 0.19 ], color="0.35" , lw=1.2 ) ax.scatter(df.effect, df.se, s=46 , color="#4C72B0" , edgecolors="white" , zorder=3 ) ax.scatter([0.67 ], [0.106 ], s=60 , color="#C44E52" , edgecolors="white" , zorder=4 ) ax.text(0.665 , 0.122 , "S7" , fontsize=8.5 , ha="center" , color="#C44E52" ) ax.text(0.005 , 0.44 , "pooled estimate 0.42" , fontsize=9 ) ax.set_xlim(0 , 0.85 ) ax.set_ylim(0.19 , 0 ) ax.set_xlabel("effect size" ) ax.set_ylabel("standard error" ) ax.set_title("Funnel plot, 12 studies (simulated)" ) fig.savefig("129-funnel.png" , dpi=200 , bbox_inches="tight" )
7.2 哑铃图
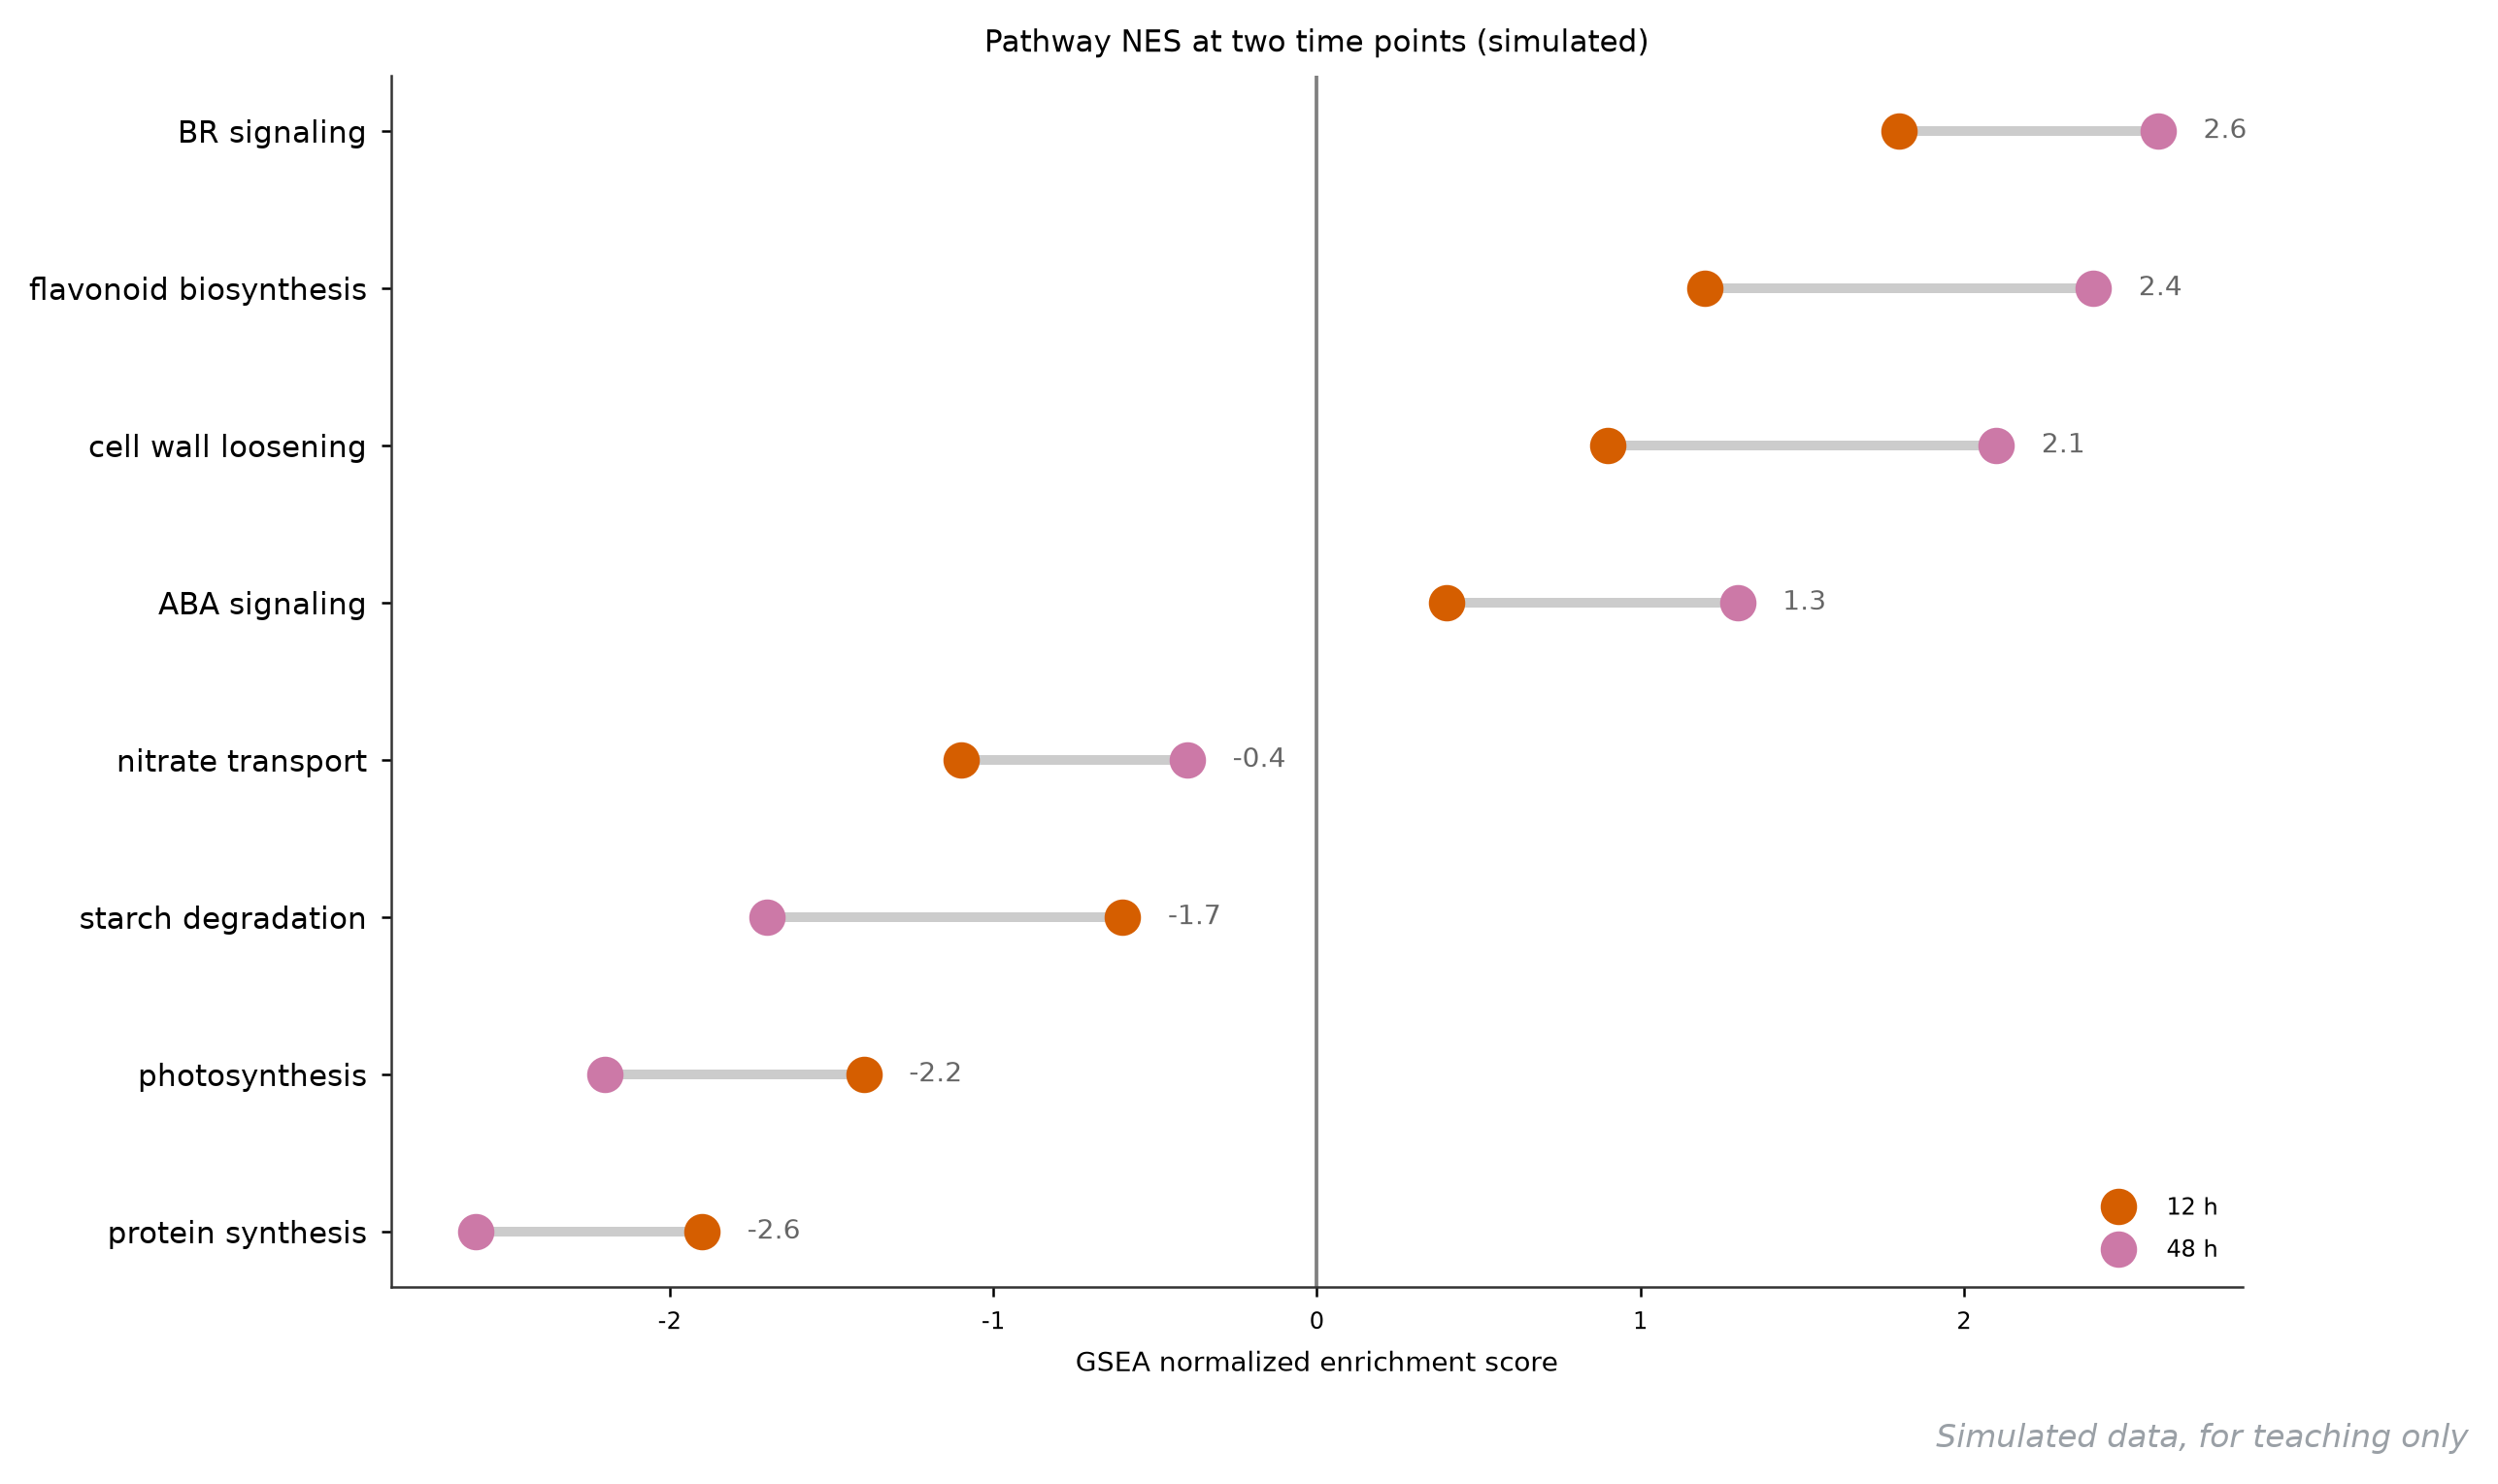
它回答什么问题 :同一通路在两个时点间的 NES 变化方向与幅度——两次独立条形图各自看是「都变了」,哑铃一连才知道「往哪边变」。
怎么读 :每行一条通路,两端圆点是 12 h 与 48 h 的标准化富集分数(NES),连线即变化轨迹,48 h 数值标在点旁。三种形状三种结论:BR signaling 从 1.8 拉长到 2.6(持续增强)、photosynthesis 从 -1.4 深到 -2.2(抑制加深)、nitrate transport 从 -1.1 收回到 -0.4(早期抑制回调)——「早期下调、后期恢复」的适应型通路只有哑铃能一眼看出来。排序建议按 48 h 值排,读图者扫一眼就能抓最两端。
用什么画 :R 的 ggalt geom_dumbbell;重绘对 通路-两时点 表画横线加双点。
图注示例 :
图 130 缺水处理后 12 h 与 48 h 两个时点的通路 NES 哑铃图(模拟)。蓝点 12 h、红点 48 h(数值标注);BR signaling 由 1.8 增至 2.6,photosynthesis 由 -1.4 深至 -2.2,nitrate transport 由 -1.1 回调至 -0.4。
展开查看:NES 数据与绘图代码 1 2 3 4 5 6 7 8 9 pathway,nes_12h,nes_48h BR signaling,1.8,2.6 flavonoid biosynthesis,1.2,2.4 cell wall loosening,0.9,2.1 photosynthesis,-1.4,-2.2 starch degradation,-0.6,-1.7 ABA signaling,0.4,1.3 nitrate transport,-1.1,-0.4 protein synthesis,-1.9,-2.6
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("130-dumbbell.csv" ) df = df.sort_values("nes_48h" ) fig, ax = plt.subplots(figsize=(8.4 , 5.2 )) for k, (_, r) in enumerate (df.iterrows()): ax.plot([r.nes_12h, r.nes_48h], [k, k], color="0.78" , lw=2.6 , zorder=1 ) ax.scatter([r.nes_12h], [k], s=64 , color="#4C72B0" , zorder=3 ) ax.scatter([r.nes_48h], [k], s=64 , color="#C44E52" , zorder=3 ) ax.text(r.nes_48h + 0.14 , k, "%.1f" % r.nes_48h, va="center" , fontsize=8.5 , color="#C44E52" ) ax.set_yticks(range (len (df))) ax.set_yticklabels(df.pathway, fontsize=9 ) ax.axvline(0 , color="0.6" , lw=0.9 ) ax.scatter([], [], s=64 , color="#4C72B0" , label="12 h" ) ax.scatter([], [], s=64 , color="#C44E52" , label="48 h" ) ax.legend(fontsize=9 , loc="lower right" ) ax.set_xlabel("normalized enrichment score (NES)" ) ax.set_title("Pathway NES at two time points (simulated)" ) fig.savefig("130-dumbbell.png" , dpi=200 , bbox_inches="tight" )
7.3 瀑布图
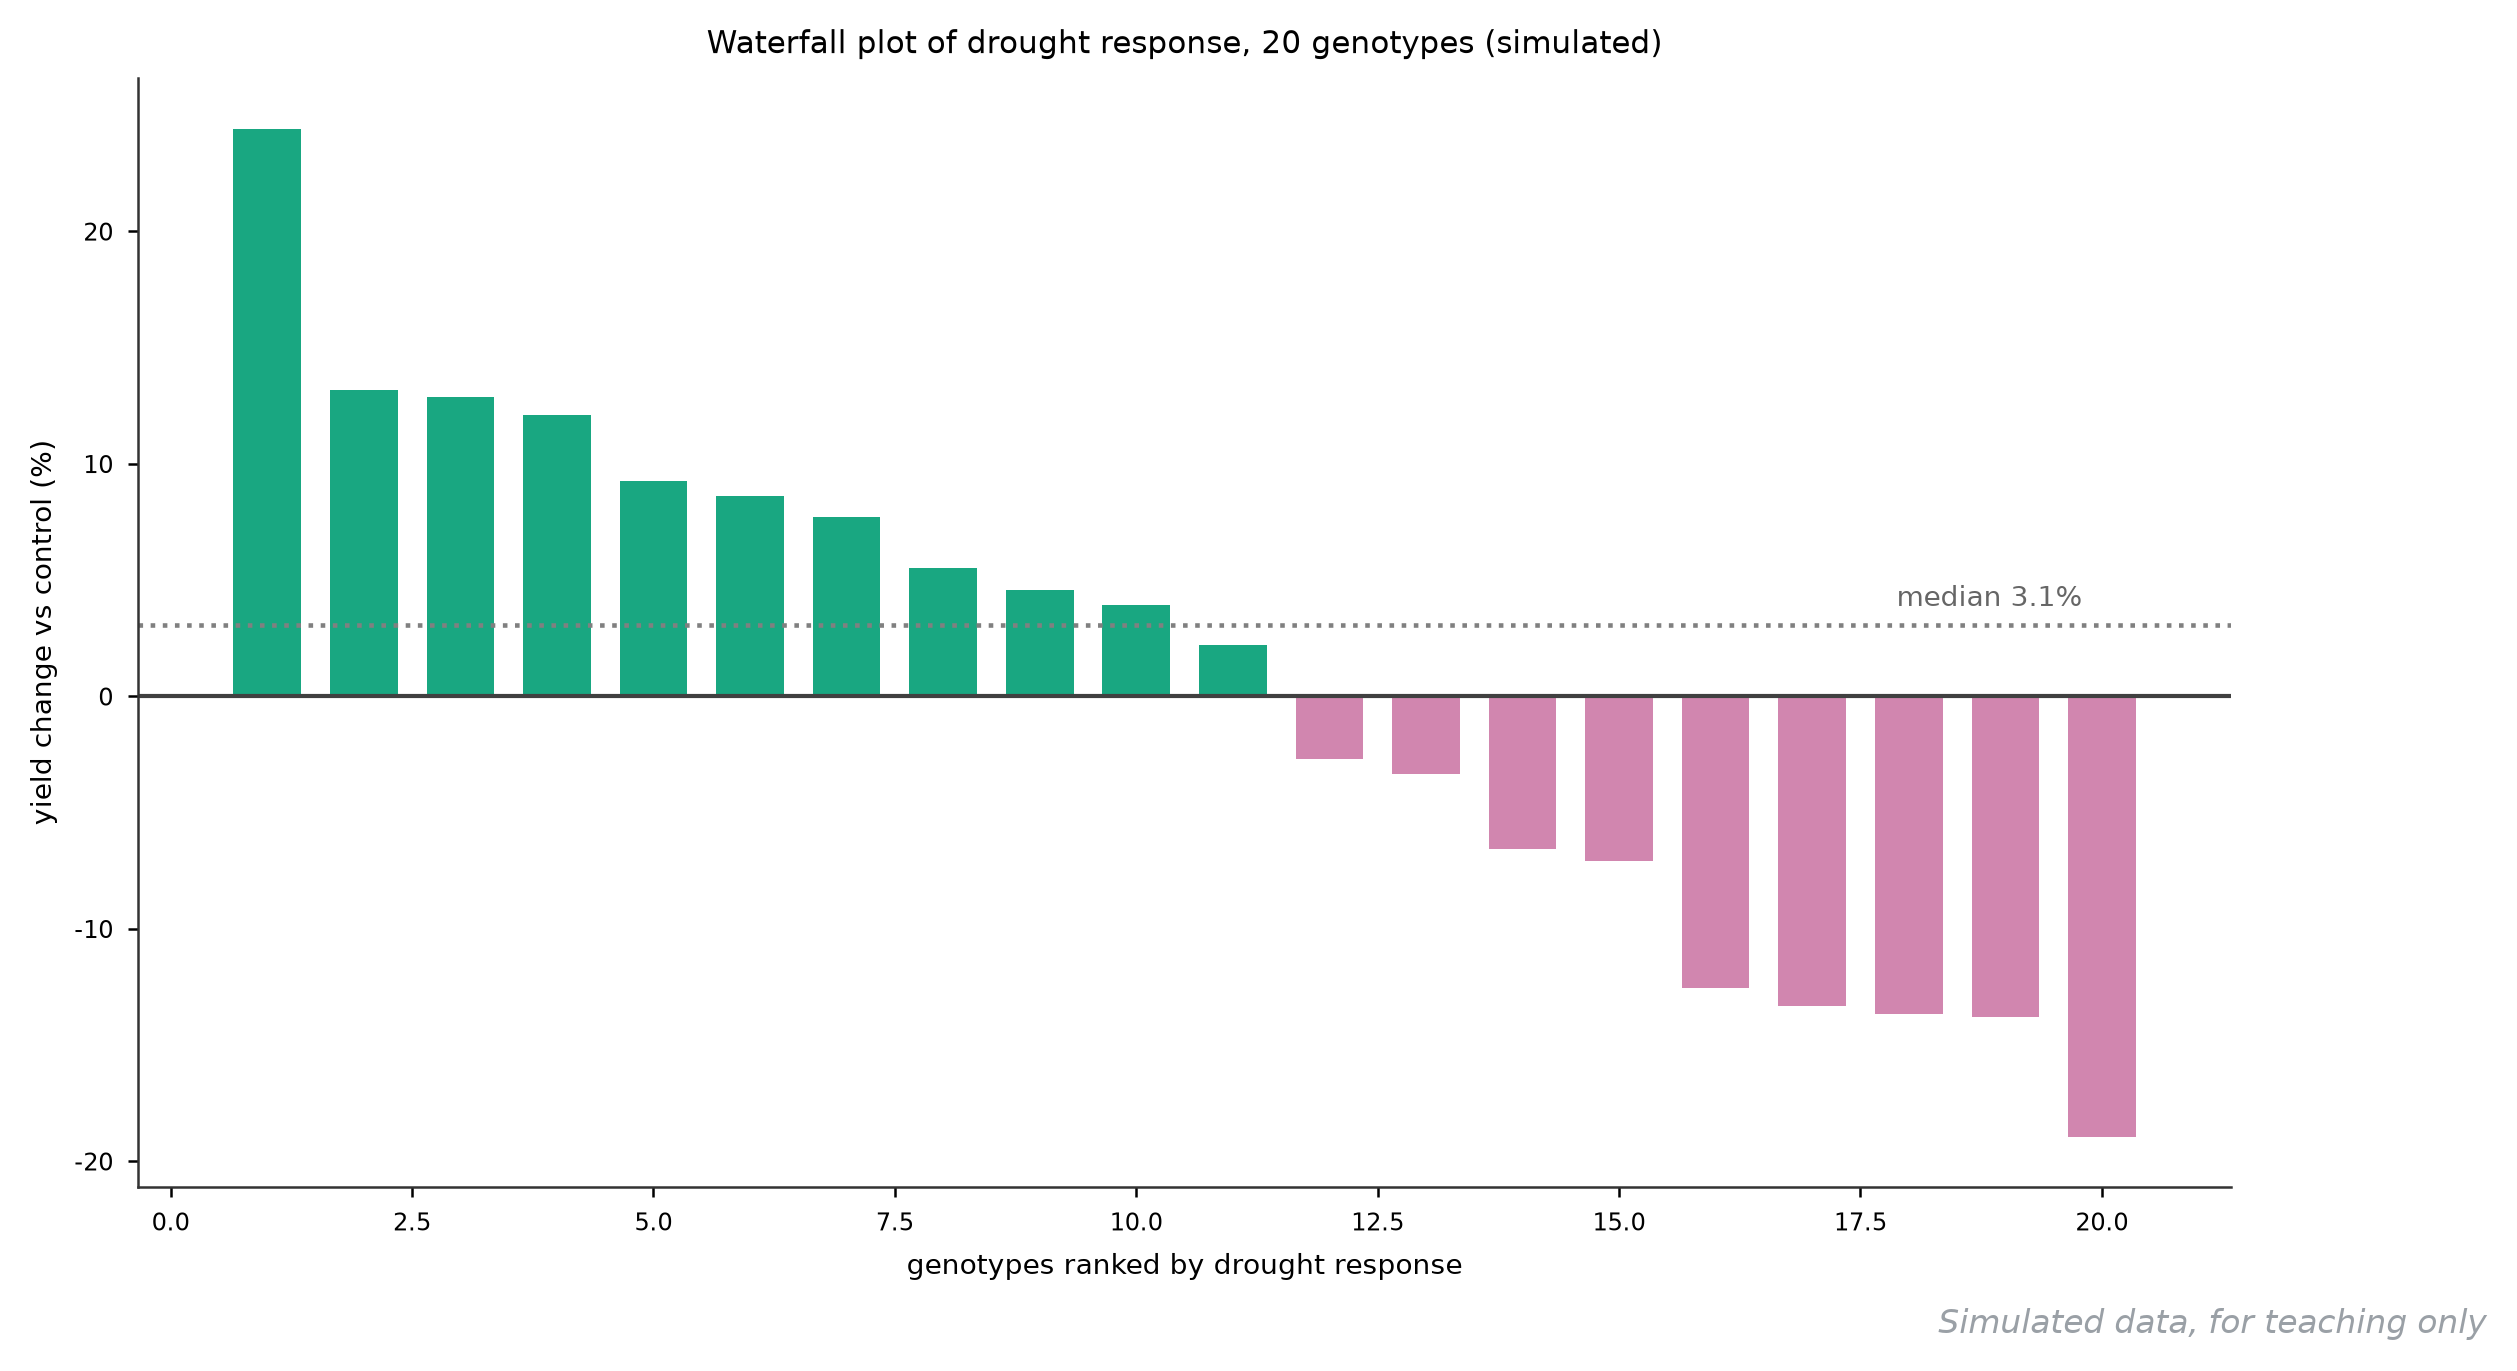
它回答什么问题 :20 个基因型对处理的响应分布全貌——均值会埋掉极端材料,瀑布图把每一个体排成阶梯,育种里挑极端材料的「选种图」。
怎么读 :横轴是按响应率排序的基因型,纵轴是产量变化百分比,绿升红降(按符号着色),中位线标注群体典型响应(+3.0%)。两端即信息:G1(+24.4%)与 G2(+13.2%)是候选耐旱材料,G20(-18.9%)、G19(-13.8%)是敏感材料;中段密密麻麻的「平庸带」提醒你效应主要靠两端少数基因型拉动。判读纪律:先确认响应率的分母(对照是哪一年的、重复几次),瀑布图最怕单点极端值其实是测量误差。
用什么画 :肿瘤学术圈的标准图(R 的 waterfalls 包),农业里同样好用;重绘按 基因型-变化率 表排序柱状并按符号着色。
图注示例 :
图 131 20 个基因型干旱处理下的产量变化瀑布图(模拟)。按变化率降序排列,绿色为正响应、红色为负响应;中位数 +3.0%,两端 G1(+24.4%)与 G20(-18.9%)为极端材料。
展开查看:响应数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 genotype,dy_pct G1,24.4 G2,13.2 G3,12.9 G4,12.1 G5,9.3 G6,8.6 G7,7.7 G8,5.5 G9,4.6 G10,3.9 G11,2.2 G12,-2.7 G13,-3.4 G14,-6.6 G15,-7.1 G16,-12.5 G17,-13.3 G18,-13.7 G19,-13.8 G20,-18.9
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 import numpy as npimport pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("131-waterfall.csv" ) dy = df.dy_pct fig, ax = plt.subplots(figsize=(9.8 , 5.0 )) ax.bar(df.genotype, dy, color=["#55A868" if v > 0 else "#C44E52" for v in dy], width=0.72 ) ax.axhline(0 , color="0.25" , lw=1 ) ax.axhline(np.median(dy), color="0.4" , ls="--" , lw=1 ) ax.text(19.8 , np.median(dy) + 0.8 , "median %.1f%%" % np.median(dy), fontsize=9 , ha="right" , color="0.35" ) ax.set_ylabel("yield change under drought (%)" ) ax.set_ylim(-22 , 28 ) ax.set_title("Waterfall plot of drought response, 20 genotypes (simulated)" ) fig.savefig("131-waterfall.png" , dpi=200 , bbox_inches="tight" )
7.4 帕累托图
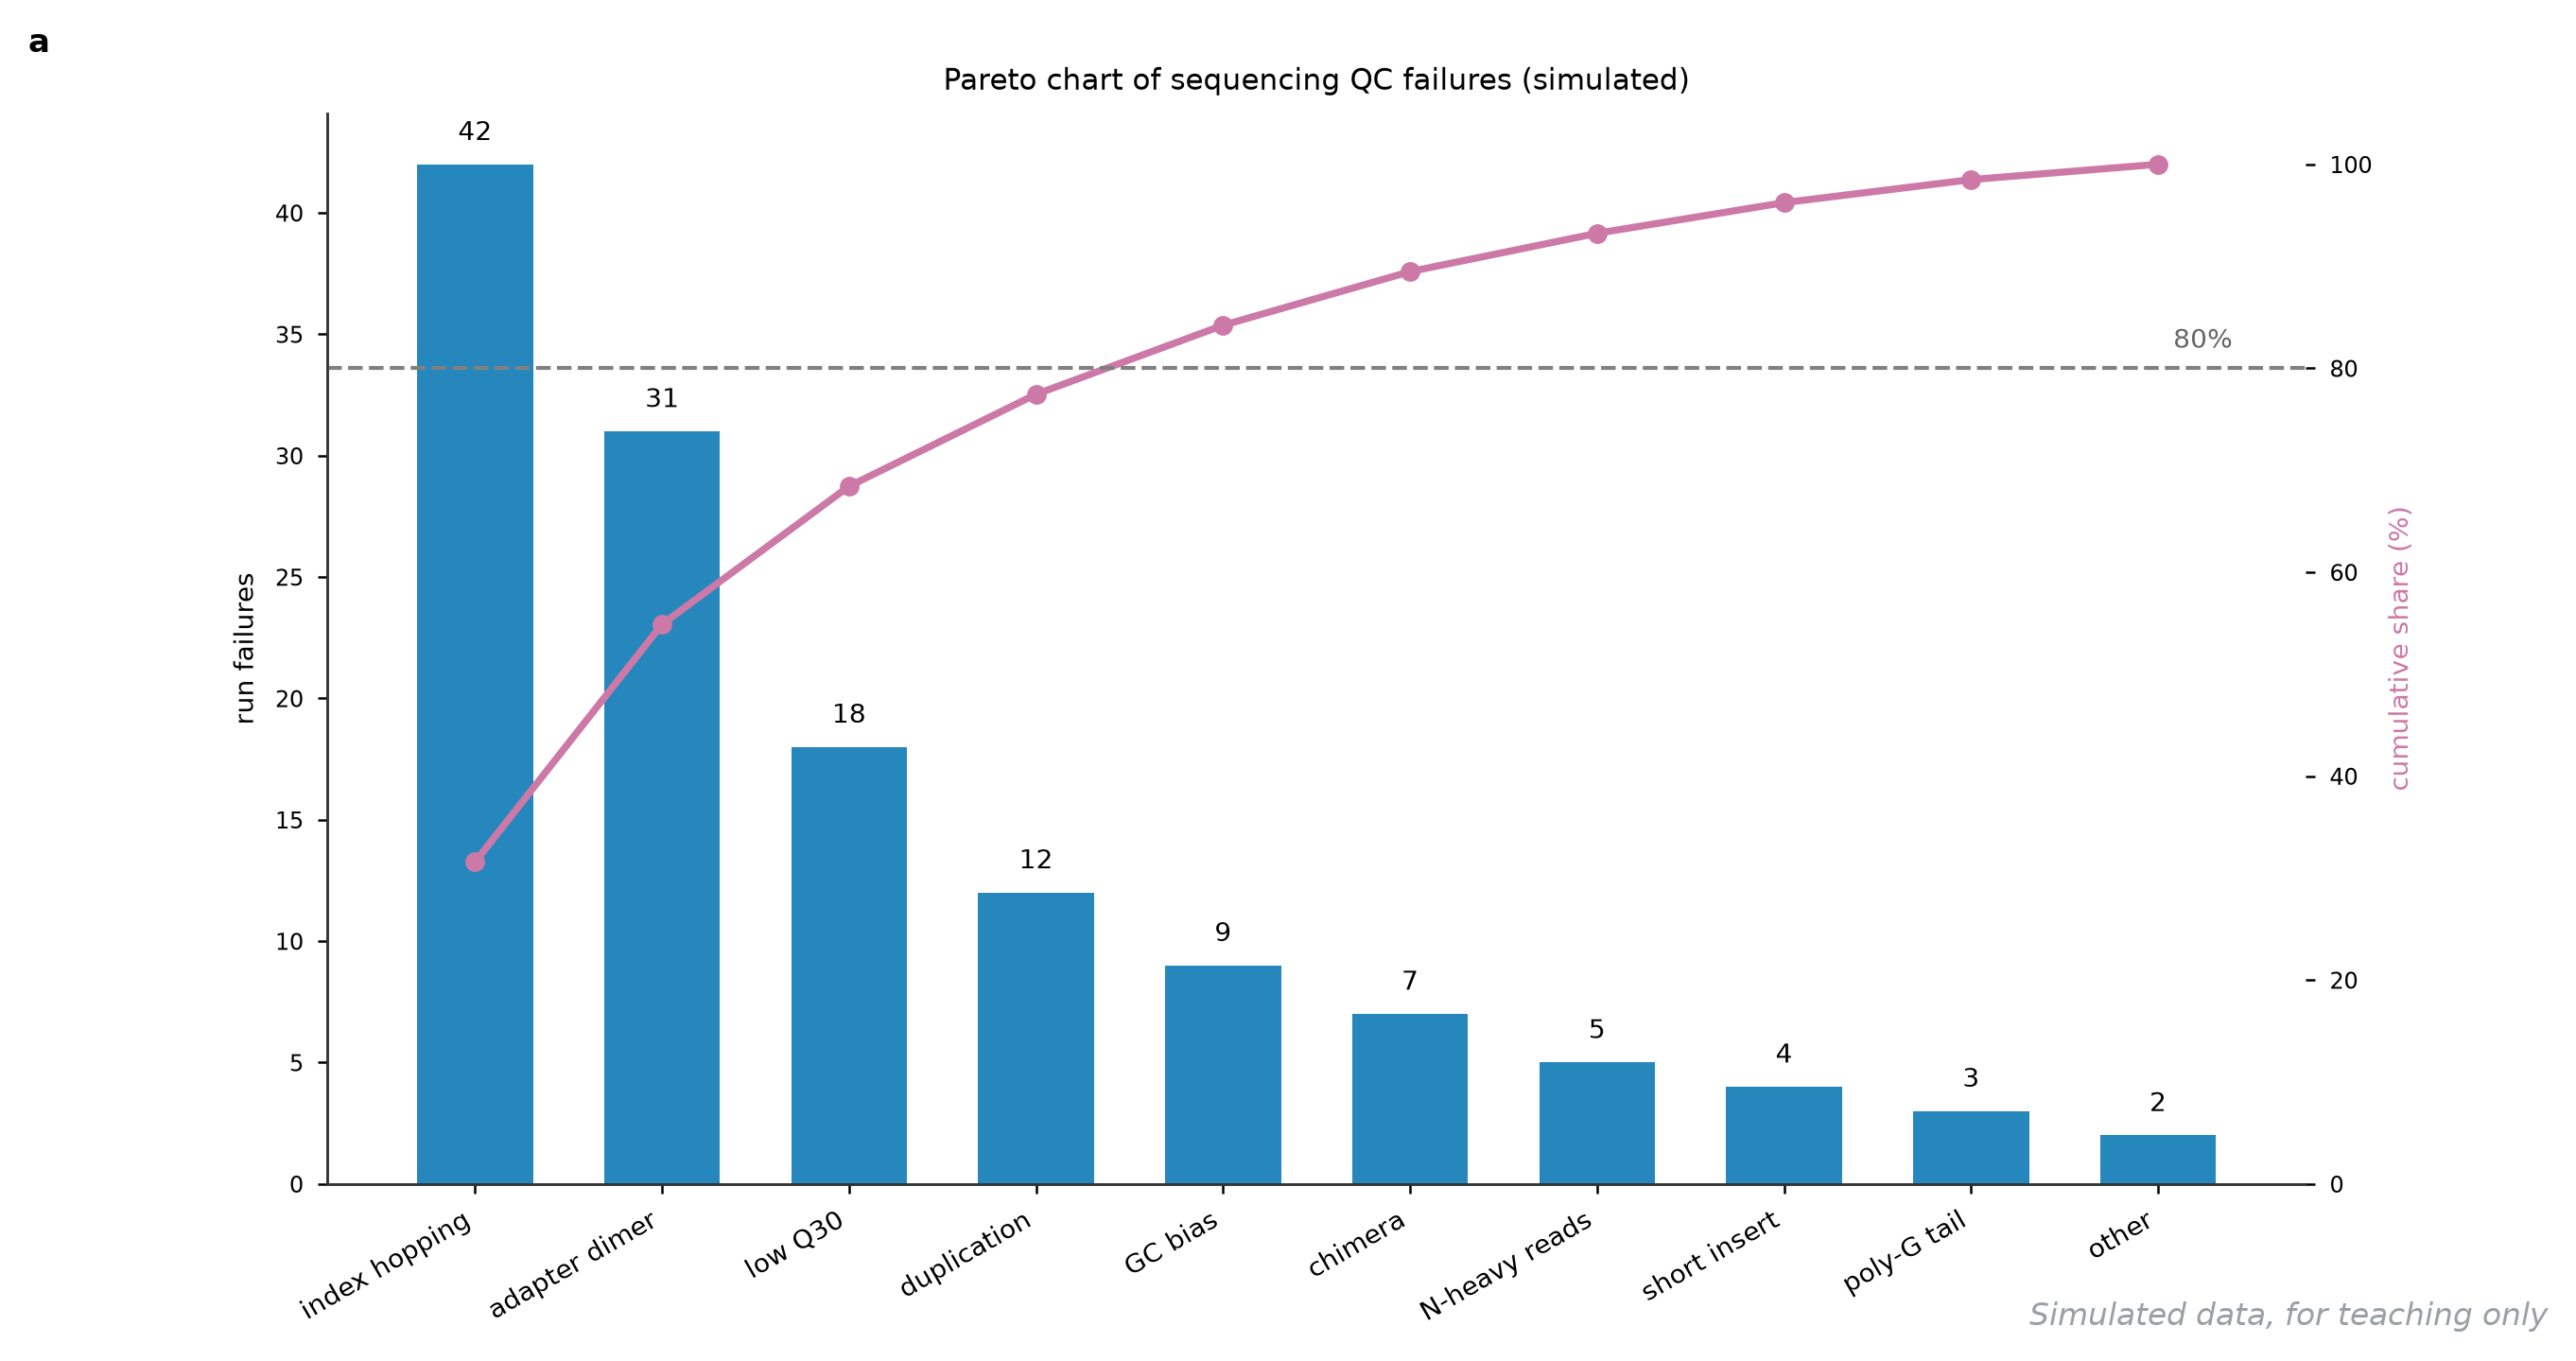
它回答什么问题 :测序 QC 失败原因里,哪两三类占了八成——把频次柱状图和累计百分比折线叠起来,资源该往哪投一目了然。
怎么读 :柱子按频次降序(index hopping 42、adapter dimer 31、low Q30 18……),右轴折线是累计占比:前两类合计 55%,前三类 68%——抓头三类就能消掉七成问题,剩下的长尾(poly-G、other 各 2-3 例)不值得单独立项。帕累托图的读法就一句:折线越过 80% 的位置之前的所有柱子才是「主要矛盾」 。柱顶直接标频次数值,省得读者来回对轴。
用什么画 :Excel/Pareto 图表类型一步出;重绘双 y 轴(左频次、右累计百分比)。
图注示例 :
图 132 一个季度测序 QC 失败原因的帕累托图(模拟,共 133 例)。柱为各类频次(降序,柱顶标注),折线为累计占比:index hopping 与 adapter dimer 合计 55%,前三类累计 68%。
展开查看:频次数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 category,count index hopping,42 adapter dimer,31 low Q30,18 duplication,12 GC bias,9 chimera,7 N-heavy reads,5 short insert,4 poly-G tail,3 other,2
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("132-pareto.csv" ) cum = df["count" ].cumsum() / df["count" ].sum () * 100 fig, ax = plt.subplots(figsize=(9.6 , 5.0 )) ax.bar(df.category, df["count" ], color="#4C72B0" , width=0.66 ) for i, v in enumerate (df["count" ]): ax.text(i, v + 1 , str (v), ha="center" , fontsize=8.5 ) ax2 = ax.twinx() ax2.plot(df.category, cum, "-o" , ms=4 , color="#C44E52" , lw=1.6 ) ax2.axhline(80 , color="0.6" , ls=":" , lw=1 ) ax2.set_ylim(0 , 105 ) ax2.set_ylabel("cumulative (%)" , color="#C44E52" ) ax.set_ylabel("count" ) ax.tick_params(axis="x" , rotation=38 ) ax.set_title("Pareto chart of sequencing QC failures (simulated)" ) fig.savefig("132-pareto.png" , dpi=200 , bbox_inches="tight" )
7.5 三维 PCA
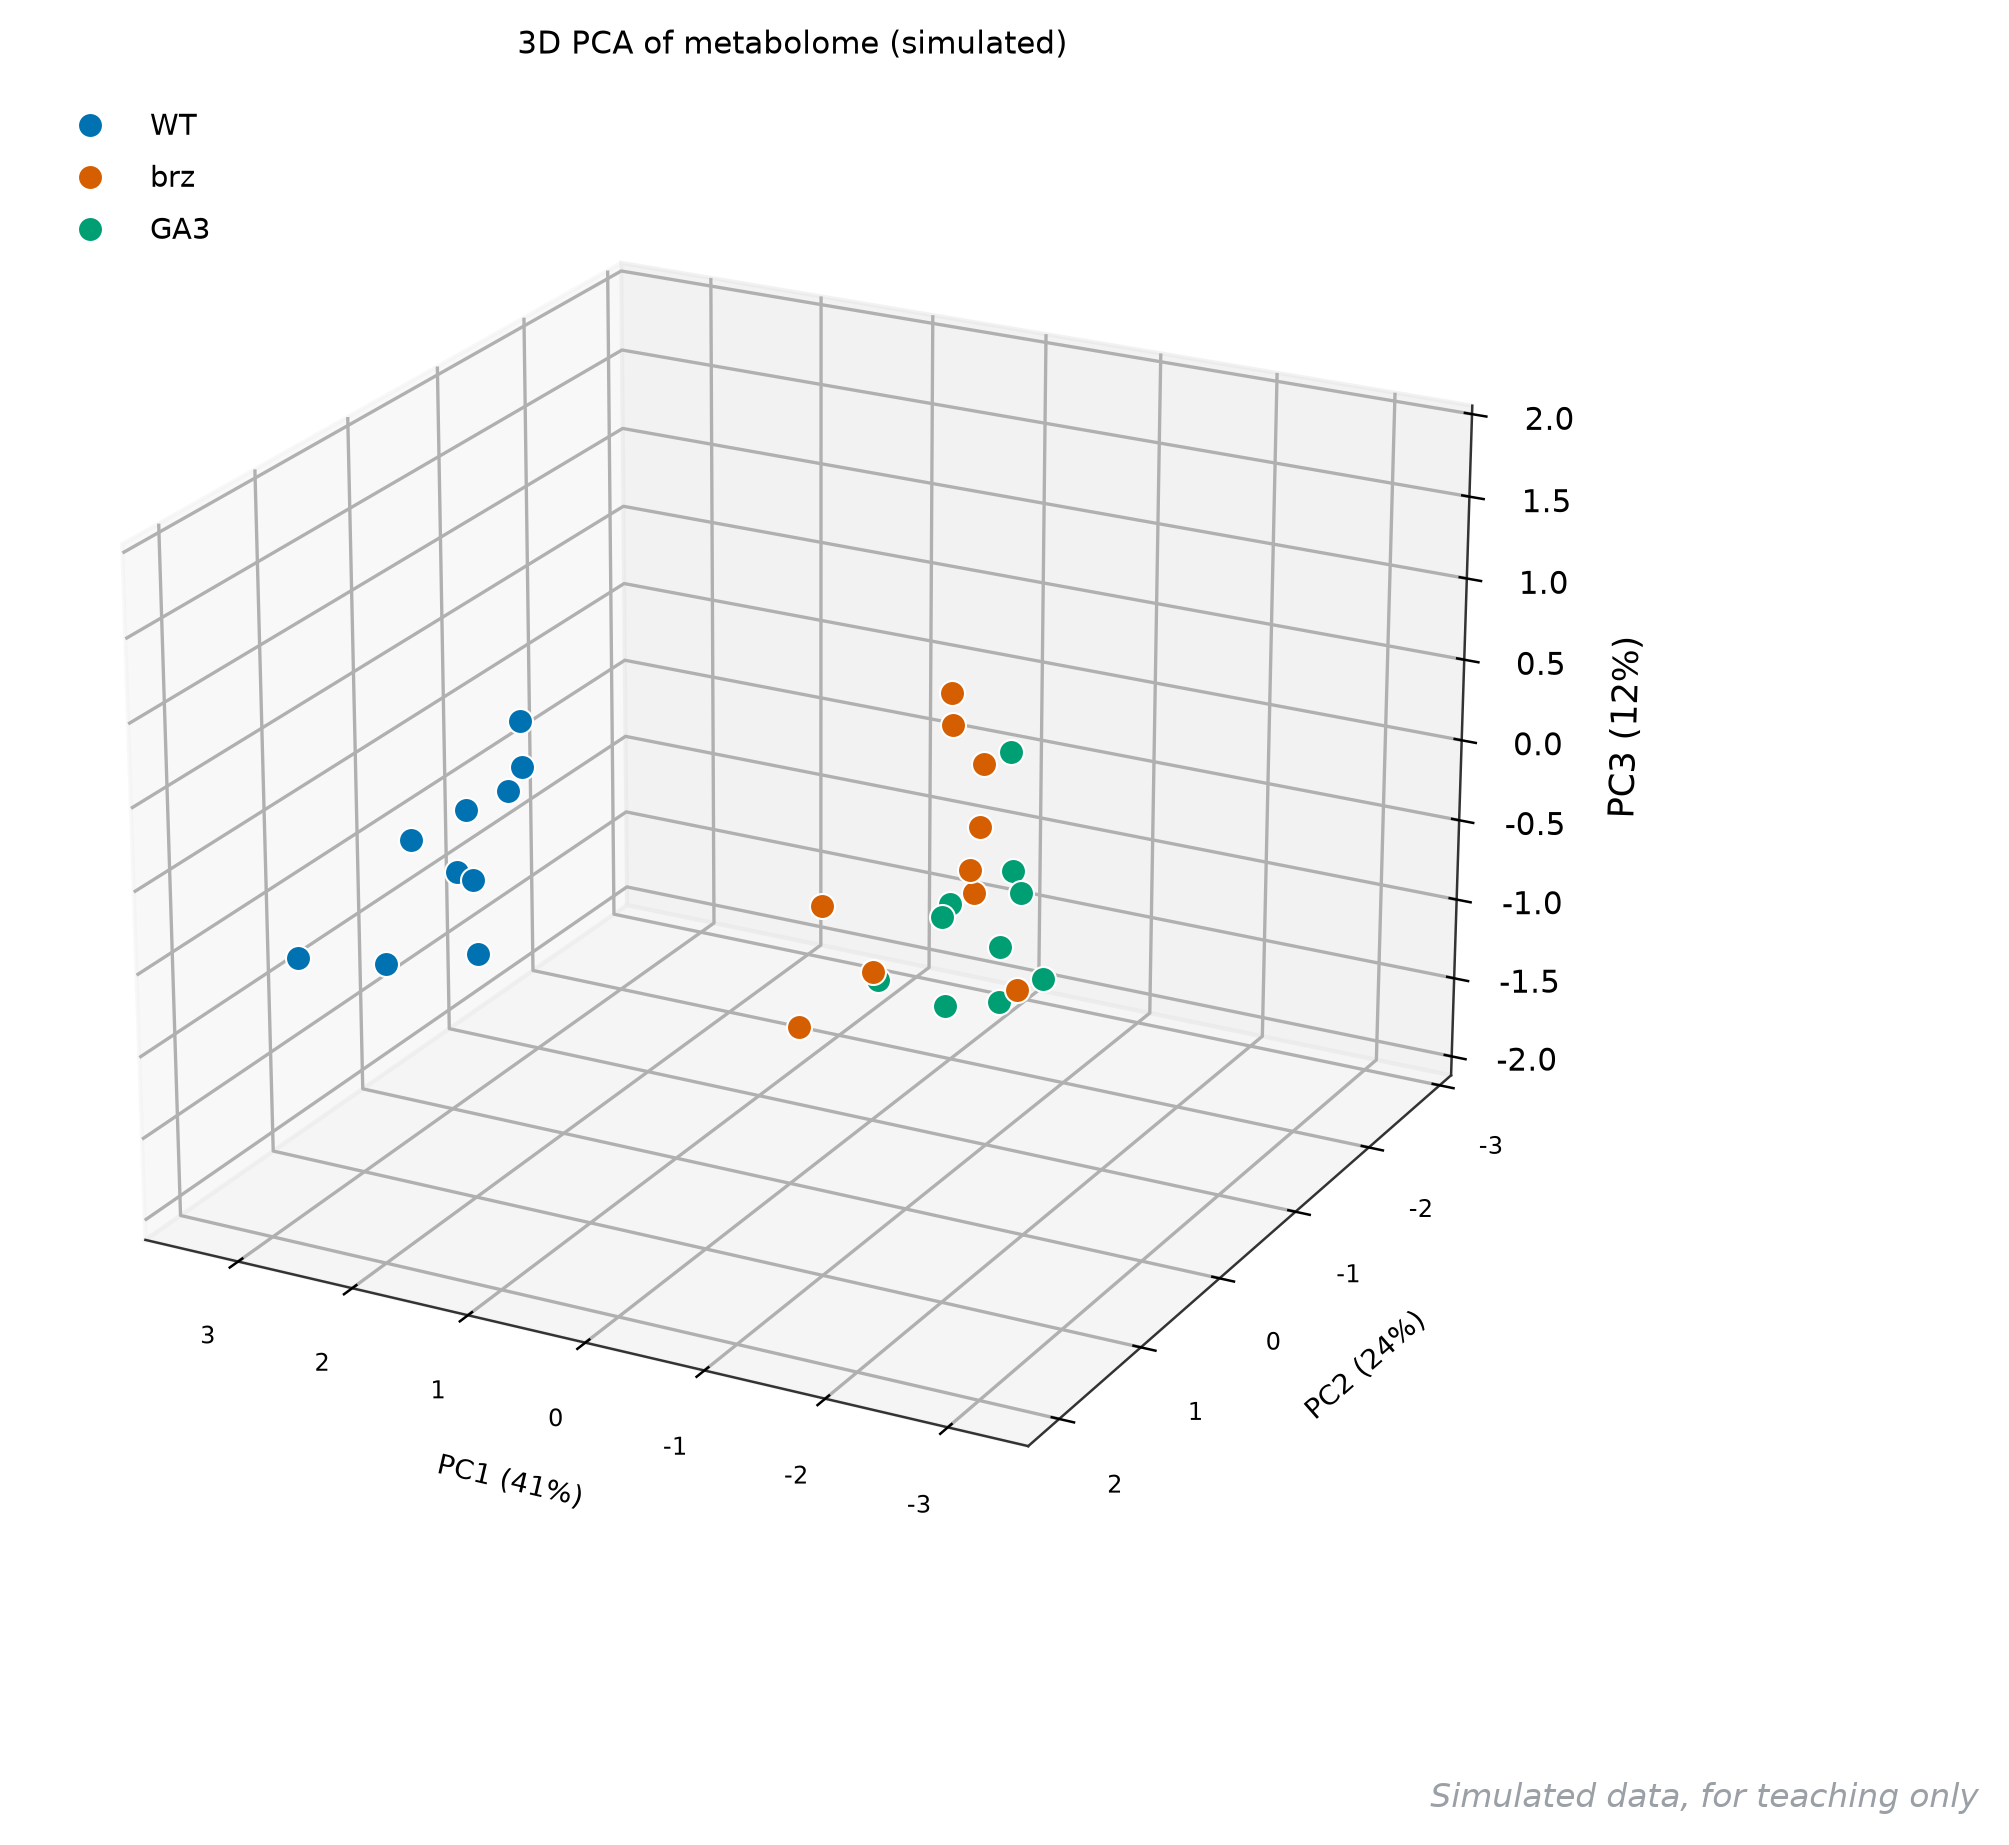
它回答什么问题 :二维 PCA 看不出分组时,第三主成分里有没有藏着信息——也是本系列唯一一张「先想想再画」的图:3D 好看,但常不如两张 2D 投影诚实。
怎么读 :30 个代谢组样本投到 PC1-PC3 空间(视角 elev 22、azim 118,标注在代码里,固定视角才可复现)。三组分离清晰:WT 占 PC1 正端,brz 与 GA3 沿 PC2 分开,PC3 贡献的是组内散布。判读纪律:3D 图必有遮挡与透视失真,发表时配 1-2 张 2D 投影作「诚实版」;交互式旋转图(plotly HTML)是更好的补充;「PC 轴解释百分比」照旧标进轴标签。
用什么画 :sklearn PCA 出分后 matplotlib 的 projection="3d" 或 plotly 交互图;重绘对 样本-基因型-PC1/2/3 表三维散点。
图注示例 :
图 133 30 个代谢组样本(三基因型各 10 个)的 3D PCA(模拟)。三组沿 PC1-PC2 分离,视角 elev = 22、azim = 118;3D 透视仅作补充,结论以 2D 投影为准。
展开查看:坐标数据与绘图代码 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 sample,genotype,pc1,pc2,pc3 WT1,WT,2.59,0.91,-0.04 WT2,WT,2.66,0.22,-0.12 WT3,WT,2.50,0.36,-0.47 WT4,WT,2.34,-0.02,0.11 WT5,WT,2.63,-0.37,0.23 WT6,WT,3.23,-0.37,-0.79 WT7,WT,2.14,0.77,-0.72 WT8,WT,2.24,1.64,-0.47 WT9,WT,2.17,0.37,0.12 WT10,WT,3.35,1.25,-0.75 brz1,brz,-2.92,1.88,1.53 brz2,brz,-1.19,1.29,0.24 brz3,brz,-1.54,2.02,-0.14 brz4,brz,-2.31,1.36,1.48 brz5,brz,-2.49,1.64,1.79 brz6,brz,-3.17,1.85,0.26 brz7,brz,-2.48,1.34,0.53 brz8,brz,-2.54,1.49,0.73 brz9,brz,-1.99,1.80,0.17 brz10,brz,-2.57,1.41,0.95 GA31,GA3,-0.42,-2.59,-1.77 GA32,GA3,-0.51,-2.15,-1.04 GA33,GA3,0.86,-2.30,-1.85 GA34,GA3,-0.07,-2.66,-0.39 GA35,GA3,0.00,-2.81,-1.22 GA36,GA3,0.27,-2.37,-1.30 GA37,GA3,0.16,-2.11,-1.27 GA38,GA3,-0.36,-2.10,-1.74 GA39,GA3,-0.09,-2.51,-1.58 GA310,GA3,0.15,-2.14,-1.86
绘图代码(Python,独立可运行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 import pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("133-pca3d.csv" ) gcol = {"WT" : "#4C72B0" , "brz" : "#C44E52" , "GA3" : "#55A868" } fig = plt.figure(figsize=(8.2 , 6.4 )) ax = fig.add_subplot(projection="3d" ) for g, sub in df.groupby("genotype" ): ax.scatter(sub.pc1, sub.pc2, sub.pc3, s=44 , color=gcol[g], depthshade=False , edgecolors="white" , linewidths=0.5 , label=g) ax.view_init(elev=22 , azim=118 ) ax.set_xlabel("PC1" ) ax.set_ylabel("PC2" ) ax.set_zlabel("PC3" ) ax.legend(loc="upper left" , fontsize=9 ) ax.set_title("3D PCA of metabolome (simulated)" ) fig.savefig("133-pca3d.png" , dpi=200 , bbox_inches="tight" )
八、写在最后:此篇收束,系列续于第五篇 前四篇合计 133 张图 :第一篇 41 张打底(统计、转录组、临床)、第二篇 33 张进阶(群体遗传、比较基因组、单细胞)、第三篇 29 张承接(测序 QC、表观、空间组学)、本篇 30 张(蛋白、生化、生态、AI 多组学)。系列未完——第五篇(40 张,蛋白结构、变异与表达验证) 首次成建制引入真实 PDB/AlphaFold 坐标与 4 张浏览器可拖拽的交互 3D,第六篇(22 张,真实公开数据实战) 再用 1001 Genomes 全基因组矩阵把全套推到 195 张。写完这轮最大的体会还是那句朴素的话:先想清楚这张图要回答的那句话,再挑图型;反过来就会画出漂亮但没用的图 。133 张里没有一张是因为「好看」被选进来的——它们各自回答一个具体问题,图注里的每一个数字都与生成它的数据严格一致,折叠块里的 CSV 和代码让你从这张网页直接复现到自己的终端。
再往前走,有两件事值得做:一是把这批模拟图换成你自己的真实数据(每张图的代码都只吃一张 CSV,替换路径就能跑);二是把重复劳动交给工具——Linxira Bio SDK (我主导开发的本地优先生信工具链)正在把「跑分析、出表、到画图前的最后一公里」版本化,实际可用能力以正式分支最新 release 为准。哪张图你想要「真实数据版」「交互版」或者补一个我没覆盖的图型,评论区点单。
参考文献
Michaelis L, Menten ML (1913). Die Kinetik der Invertinwirkung. Biochem Z 49:333-369. — 米氏方程原始论文(图 110 的上游)。
Lineweaver H, Burk D (1934). The determination of enzyme dissociation constants. J Am Chem Soc 56:658-666. — 双倒数作图法。
Jumper J et al. (2021). Highly accurate protein structure prediction with AlphaFold. Nature 596:583-589. — pLDDT 置信度的出处(图 105)。
Lin Z et al. (2023). Evolutionary-scale prediction of atomic-level protein structure with a language model. Science 379:1123-1130. — ESM 蛋白语言模型(图 126)。
Wang M et al. (2016). Sharing and community curation of mass spectrometry data with GNPS. Nat Biotechnol 34:828-837. — 分子网络与镜像谱图比对(图 121)。
Caporaso JG et al. (2010). QIIME allows analysis of high-throughput community sequencing data. ISME J 4:664-672. — 稀疏化等多样性分析流程(图 115)。
Segata N et al. (2011). Metagenomic biomarker discovery and explanation. Genome Biology 12:R60. — LEfSe(图 119)。
Argelaguet R et al. (2018). Multi-Omics Factor Analysis—a framework for unsupervised integration of multi-omics data sets. Mol Syst Biol 14:e8124. — MOFA(图 124)。
Shrikumar A et al. (2018). Technical note: Transcription factor motif discovery from attribution scores (TF-MoDISco). — 深度学习归因聚 motif(图 125)。
参考代码
第四篇 30 张图的全部生成脚本:仓库 tools/bio-plots/ch10c_more.py(104-120)与 ch10d_more.py(121-133),随机种子固定,重跑即可复现文中每一根线条。
Linxira Bio SDK :本地优先的生信执行工具链(官网 );架构思路见我的拆解文 。系列前三篇:第一篇 · 第二篇 · 第三篇 。