第一篇收统计与转录组临床的 41 张,第二篇收群体遗传与基因组的 33 张。这一篇把镜头对准数据的入口和出口:测序数据拿到手先做什么质检(75-79),变异与群体层面有哪些图(80-86),GWAS 显著位点怎么往下讲(87-88),育种和功能基因组怎么收尾(89-97),最后一章进到单细胞与空间组学(98-103)。编号接着第二篇,从 75 排到 103,共 29 张。
规则不变:每张图四段式(回答什么问题、怎么读、用什么画、图注示例),图下默认折叠的「展开查看」块里是原样 CSV 加完整绘图代码;点云类大图(Sanger 波形、Hi-C 矩阵、空间 spot 等)的数据由代码现场生成、种子固定,折叠块里就是生成代码本身。全部图仍是 WSL 里 Python 3.14 + matplotlib 渲染的模拟数据,带 Simulated data 水印,脚本在仓库 tools/bio-plots/ch10a_more.py 与 ch10b_more.py。
本系列已出七篇:第一篇(41 张,统计与转录组临床) · 第二篇(33 张,群体遗传与基因组) · 第三篇(29 张,测序、表观与空间组学) · 第四篇(30 张,蛋白、生态与 AI 多组学) · 第五篇(40 张,蛋白结构、变异与表达验证,含真实 PDB 结构与交互 3D) · 第六篇(22 张,真实公开数据实战) · 第七篇(190 张图 Nature 风格重构与方法选型)。
自推一句:本篇正好撞在 Linxira Bio SDK ↗(我主导开发的本地优先生信工具链)的能力带上:正式分支已发布 v1.0.1,
fastq qc、alignment coverage、variant stats、structure pdb --alphafold-plddt等命令正是本篇多张图的直接上游,另有 35 个 agent skills 与官网 ↗、拆解文。免责声明:本文所有配图均为模拟数据的教学演示;SDK 实际可用的分析能力,请以仓库 ↗正式分支的最新 release 为准——文中部分图对应的分析尚在开发路线中,目前仅存在于本地开发分支,未合并进正式分支、代码未公开。
一、地图#
{% mermaid %} flowchart LR START([“第三篇 · 29 张”]):::hub subgraph A[“① 测序 QC 比对”] direction TB A1[“逐循环质量 · GC 偏倚 · Sanger”] A2[“覆盖度剪接 · pileup”] end subgraph B[“② 变异 群体遗传”] direction TB B1[“突变频谱 · SFS · TajimaD”] B2[“单倍型网络 · GRM · 三联 · 结构”] end subgraph C[“③ 精细定位 育种”] direction TB C1[“LocusZoom · PIP”] C2[“QTL-LOD · 连锁图 · AMMI”] end subgraph D[“④ 功能基因组 表观”] direction TB D1[“GO-DAG · ChIP 剖面 · 足迹”] D2[“WGCNA 树 · 甲基化 · Hi-C”] end subgraph E[“⑤ 单细胞 空间”] direction TB E1[“velocity · 相图 · 组成堆叠”] E2[“marker 热图 · 通讯圈 · spot”] end START —> A —> B —> C —> D —> E classDef hub fill:#1f4e79,color:#fff,font-weight:bold {% endmermaid %}
速查表两张,按章节分组。
表 1 测序 QC 与变异群体(75-86)
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| 逐循环质量箱线 | 测序质量沿读长怎么掉 | 循环位 | Phred 分数箱线 | FastQC |
| GC 偏倚散点 | 覆盖度偏不偏 GC | 窗口 GC% | log2 覆盖倍数 | MultiQC/Bioinfo |
| Sanger 峰图 | 一代测序结果可信吗 | 碱基位置 | 四通道信号峰 | Chromas |
| 覆盖度+剪接图 | 转录本怎么剪接 | 转录本位置 | 覆盖曲线+剪接弧 | IGV/sashimi |
| 读段 pileup | 变异位点读段支持如何 | 区域位置 | 读段条带 | samtools/BAM |
| 突变频谱 | 六类替换谁占大头 | 替换类型 | SNV 数 | GATK |
| 位点频率谱 SFS | 群体历史怎么读 | 等位基因计数 | 变体数 | dadi/ANGSD |
| Tajima’s D 滑窗 | 哪段受选择 | 基因组位置 | Tajima’s D | VCFtools |
| 单倍型网络 | 单倍型谁传给谁 | 平面布局 | 圆面积=频数 | Network/PopART |
| 亲缘 GRM 热图 | 谁和谁沾亲 | 个体×个体 | 亲缘系数 | GCTA |
| 选择信号三联 | 哪段被选择清除 | 窗口位置 | π+Fst+XP-CLR 三轨 | VCFtools/SweepFinder |
| 群体结构双联 | 群体分几群 | PC1/个体 | 散点+祖先堆叠 | EIGENSOFT+ADMIXTURE |
表 2 精细定位、功能表观与单细胞空间(87-103)
| 图 | 回答什么问题 | 横轴 | 纵轴或编码 | 常用工具 |
|---|---|---|---|---|
| LocusZoom 区域图 | 显著位点周围怎么关联 | 区域位置 | -log10(p)+LD 上色 | LocusZoom |
| PIP 精细定位 | 哪个因果变异可信度最高 | 区域位置 | 后期包含概率 PIP | SuSiE |
| QTL LOD 曲线 | QTL 定在哪 | 遗传位置 cM | LOD 分数 | R/qtl |
| 遗传连锁图谱 | 标记怎么排布 | 无 | 染色体群+cM 标尺 | JoinMap |
| AMMI 双标图 | 品种×环境互作谁大 | IPCA1 | IPCA2+品种环境 | metan |
| GO 有向无环图 | 富集项的层级关系 | 无 | 节点着色=padj | AgriGO |
| ChIP 剖面+热图 | 信号在 TSS 怎么分布 | TSS 距离 | 曲线+信号热图 | deepTools |
| 转录因子足迹 | 因子占没占住基序 | 基序偏移 | 切割信号 | TOBIAS/HINT |
| WGCNA 聚类树全装 | 基因怎么分模块 | 无 | 树+模块色带+性状 r | WGCNA |
| 甲基化三语境 | CG/CHG/CHH 各多少 | 语境分组 | 甲基化率 | Bismark |
| Hi-C 接触热图 | 染色质怎么折叠 | 基因组 bin | 接触数热图 | Juicer/HiC-Pro |
| velocity 相图 | 基因在升还是在降 | spliced | unspliced+latent time | scVelo |
| 组成堆叠柱 | 细胞型比例怎么变 | 处理分组 | 比例堆叠 | scanpy |
| marker 热图 | 各群标志基因对不对 | 细胞群 | 均值表达 z 值 | scanpy |
| 通讯圈图 | 细胞间谁给谁发信号 | 无 | 弧宽=通讯概率 | CellChat |
| LR 气泡图 | 哪对配受体在哪群强 | 靶细胞群 | 气泡=概率颜色=p | CellChat |
| 空间 spot 图 | 基因在切片哪里表达 | 组织坐标 | spot 颜色=表达 | Seurat/Squidpy |
二、测序数据 QC 与比对#
2.1 逐循环碱基质量箱线图#
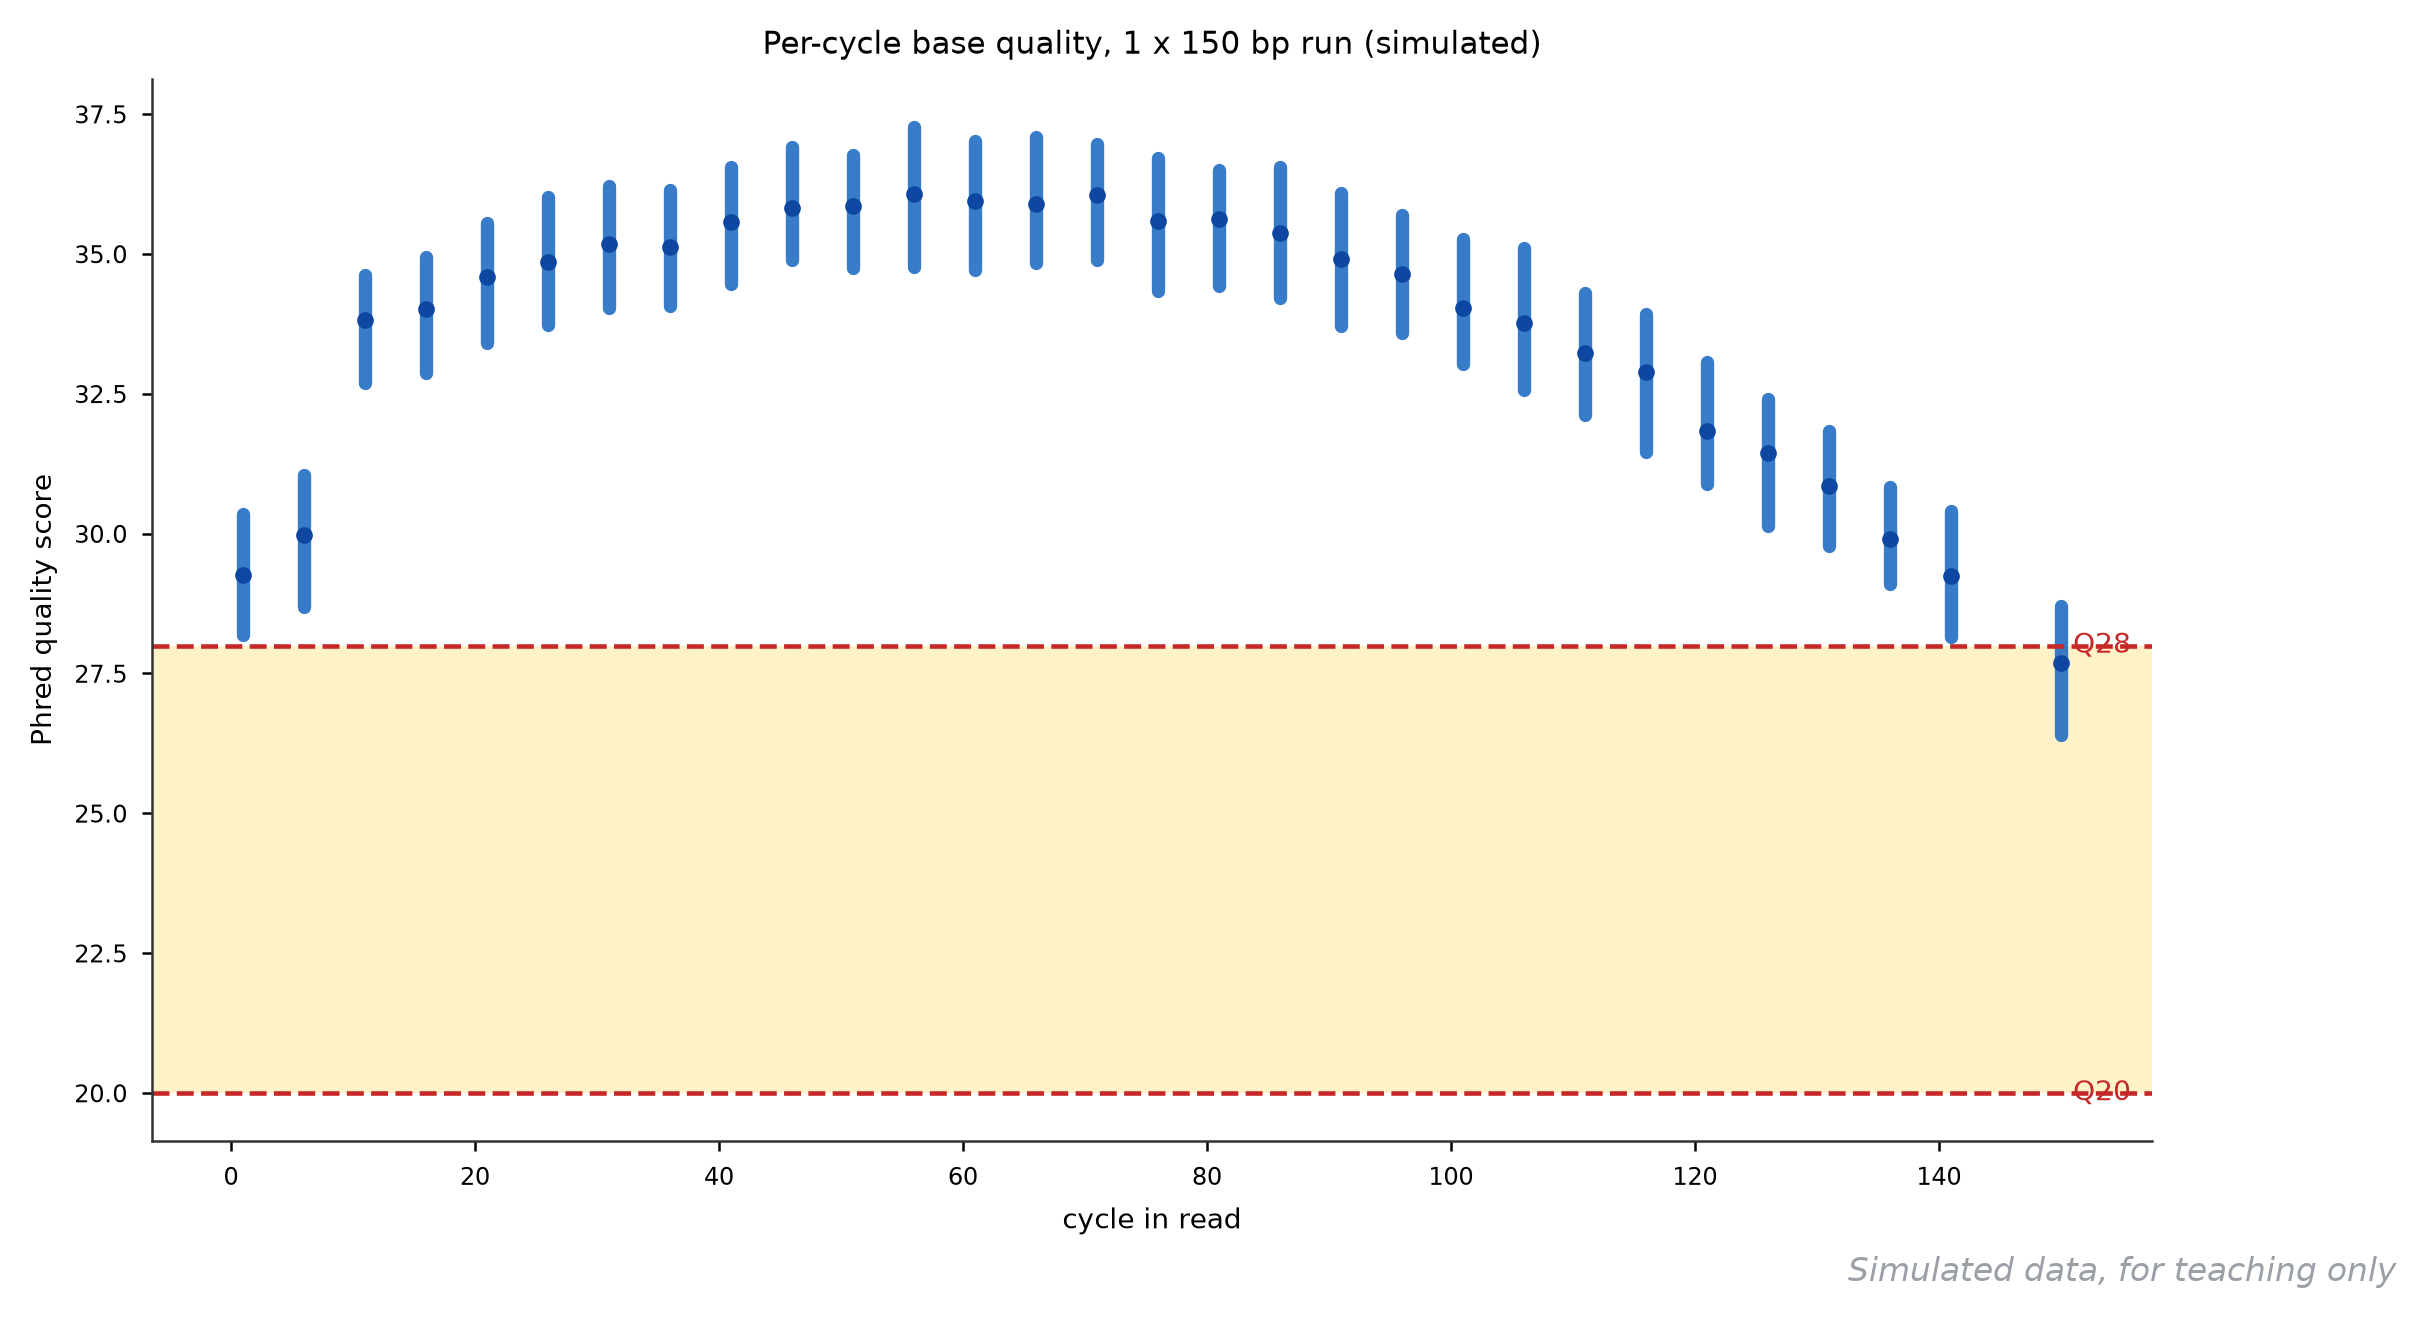
它回答什么问题:这批 reads 的质量沿读长怎么分布——FASTQ 质检的第一张图,决定后面要不要剪接、要不要降通量重测。
怎么读:横轴是读长上的循环位(1-150),纵轴 Phred 质量分(Q20=1% 错误率,Q28≈0.16%)。黄色带是 FastQC 的警示区:箱体整体在 Q28 线上方最理想。看两处:开头几个循环的塌陷(染料残留,前 6-11 个循环明显偏低,剪掉即可)和尾段 141-150 的下滑(Q 中位数跌到 27.7,到了要修整的临界)。整条曲线缓慢下斜是化学的宿命,突然塌一截才是事故。
用什么画:FastQC 自带;批量汇总用 MultiQC;重绘用 Python matplotlib 的逐循环箱线。
图注示例:
图 75 单端 150 bp 测序的逐循环碱基质量分布(模拟)。箱线为每 5 个循环的 Q 中位数与四分位距,红色虚线为 Q20 与 Q28 参考线;起始循环质量偏低,末端 10 个循环降至 Q28 以下。
展开查看:QC 数据与绘图代码
cycle,median_q,q25,q75
1,29.3,28.2,30.4
6,30.0,28.7,31.0
11,33.8,32.7,34.6
16,34.0,32.9,35.0
21,34.6,33.4,35.6
26,34.9,33.7,36.0
31,35.2,34.0,36.2
36,35.1,34.1,36.1
41,35.6,34.5,36.5
46,35.8,34.9,36.9
51,35.9,34.8,36.8
56,36.1,34.8,37.3
61,35.9,34.7,37.0
66,35.9,34.8,37.1
71,36.0,34.9,37.0
76,35.6,34.3,36.7
81,35.6,34.4,36.5
86,35.4,34.2,36.6
91,34.9,33.7,36.1
96,34.6,33.6,35.7
101,34.0,33.0,35.3
106,33.8,32.6,35.1
111,33.2,32.1,34.3
116,32.9,31.5,33.9
121,31.8,30.9,33.1
126,31.4,30.1,32.4
131,30.8,29.8,31.8
136,29.9,29.1,30.8
141,29.2,28.2,30.4
150,27.7,26.4,28.7绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("75-fastq-qc.csv")
fig, ax = plt.subplots(figsize=(8.6, 4.6))
ax.axhspan(20, 28, color="#FFD54F", alpha=0.30, lw=0)
ax.plot(df.cycle, df.q25, color="none")
for c, a, b in zip(df.cycle, df.q25, df.q75):
    ax.plot([c, c], [a, b], color="#1565C0", lw=3.2,
            solid_capstyle="round", alpha=0.85)
ax.plot(df.cycle, df.median_q, "o", ms=4, color="#0D47A1", zorder=3)
ax.axhline(20, color="#C62828", ls="--", lw=1.1)
ax.axhline(28, color="#C62828", ls="--", lw=1.1)
ax.text(151, 20, "Q20", fontsize=8.5, color="#C62828", va="center")
ax.text(151, 28, "Q28", fontsize=8.5, color="#C62828", va="center")
ax.set_xlabel("cycle in read")
ax.set_ylabel("Phred quality score")
ax.set_title("Per-cycle base quality, 1 x 150 bp run (simulated)")
fig.savefig("75-fastq-qc.png", dpi=200, bbox_inches="tight")2.2 GC 含量与覆盖深度偏倚图#
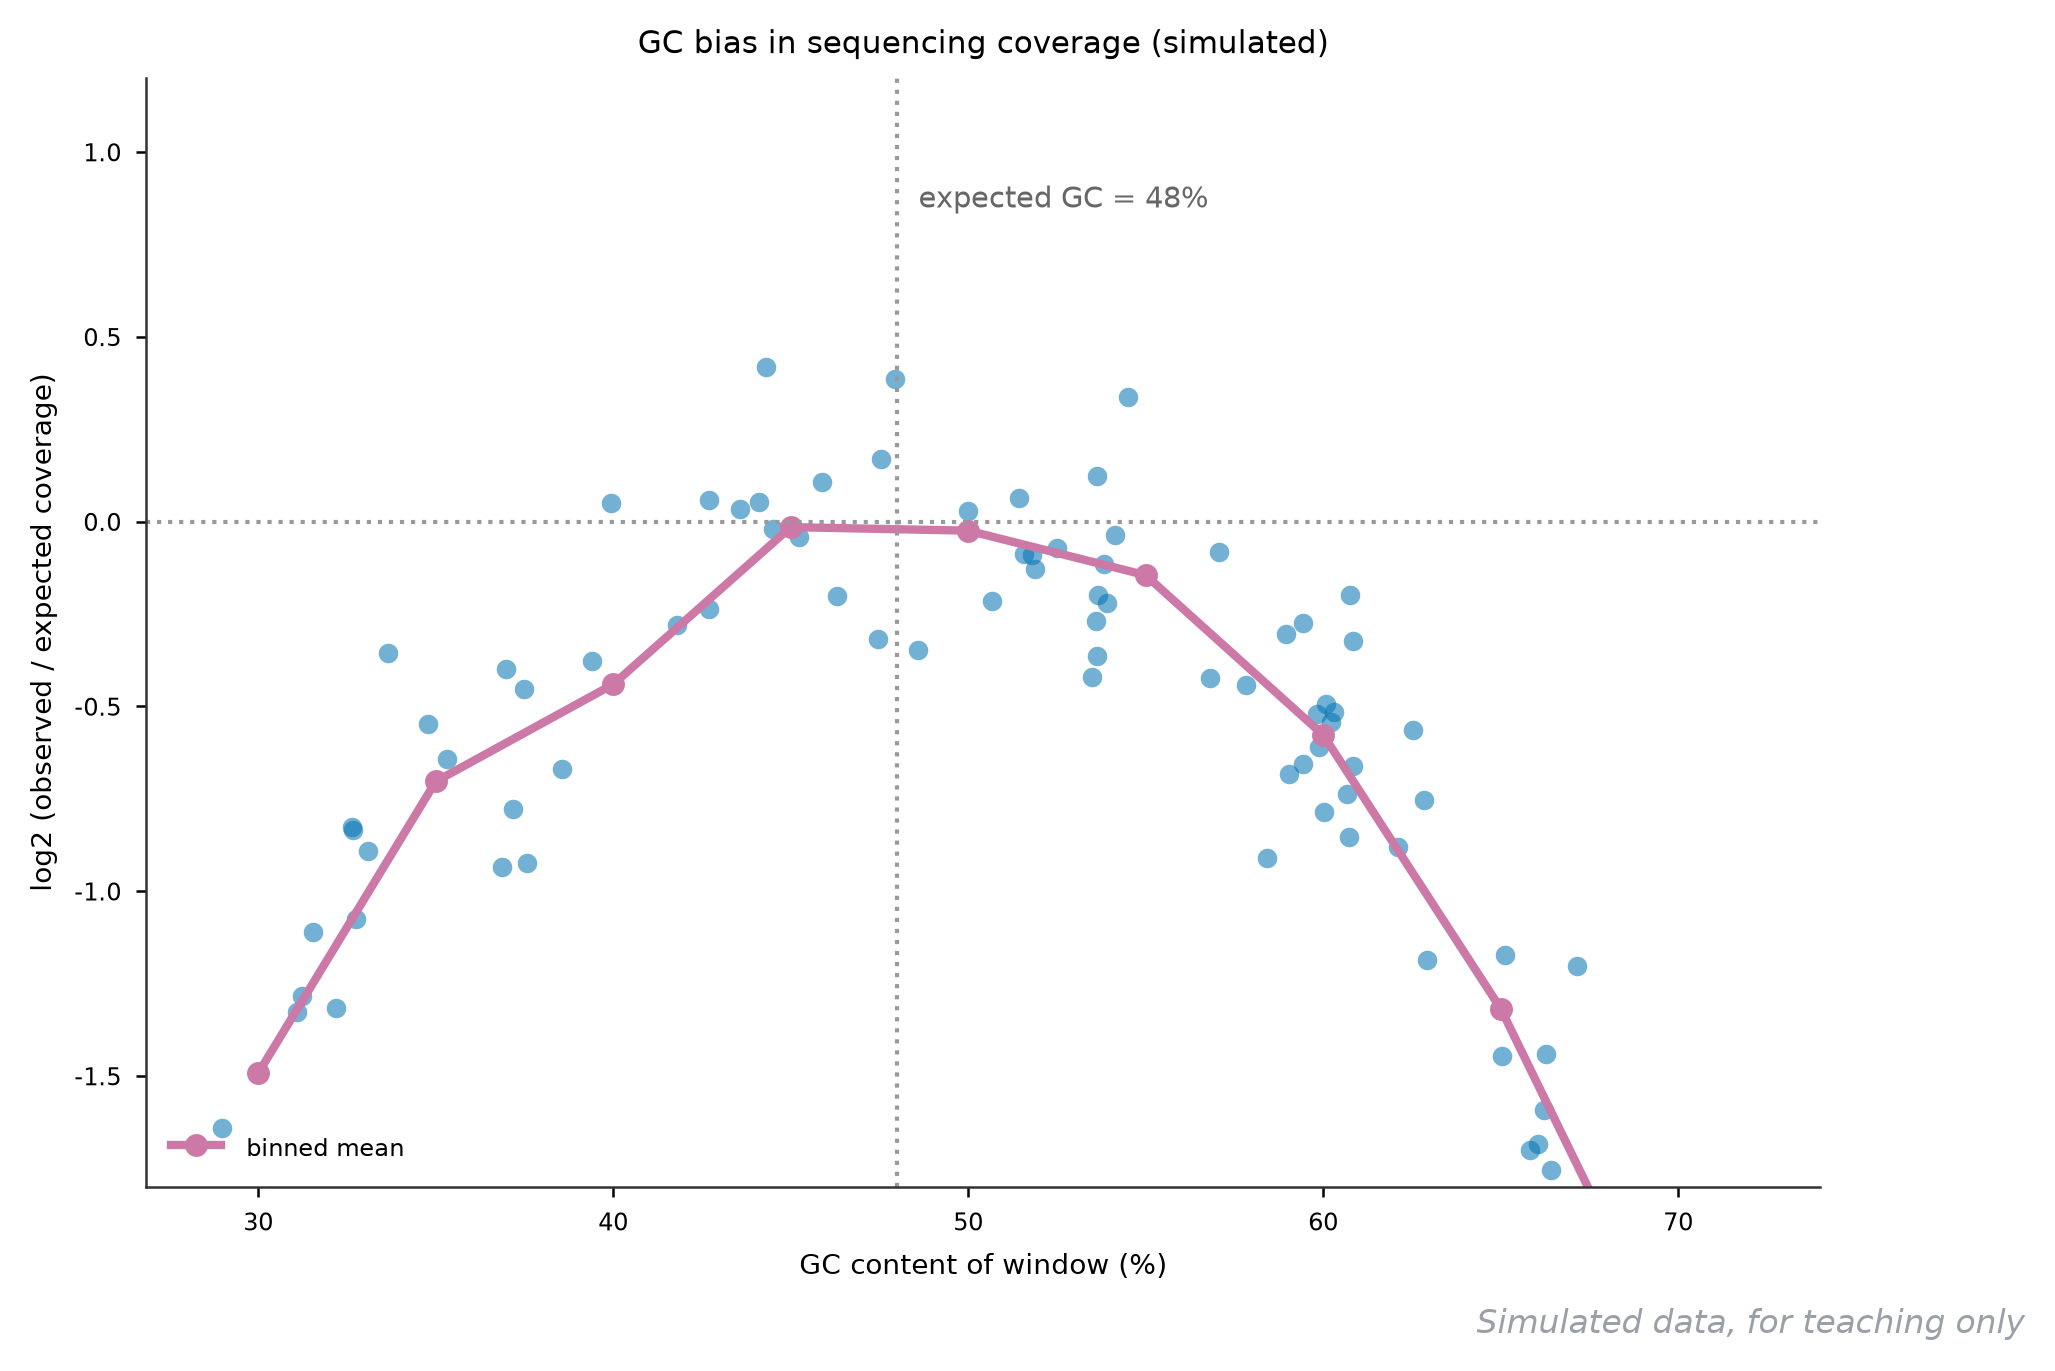
它回答什么问题:覆盖度的波动是随机噪声还是 GC 偏倚——WGS/WES 分析前的必要质检,偏倚重会影响 CNV 和变异检出。
怎么读:每点一个窗口,横轴窗口 GC 含量,纵轴观测覆盖度相对期望的 log2 倍数。健康文库是以期望 GC(本例 48%)为顶点的倒 U 形:极端 GC 的窗口系统性欠覆盖(GC 70% 处 log2 倍数跌到 -2.3,即只剩四分之一)。分箱均值线(红点)把点云的趋势说清楚;报告时给一句「GC 40-60% 区间内覆盖度稳定在期望 ±10% 以内」就足够。
用什么画:GATK CollectGcBiasMetrics 直接输出;重绘用 matplotlib 散点加分箱均值线。
图注示例:
图 76 全基因组测序的 GC 偏倚曲线(模拟)。散点为 90 个 100 kb 窗口,红线为按 5% GC 分箱的均值 log2 覆盖倍数;覆盖度在期望 GC 48% 处达峰,极端 GC 窗口系统性欠覆盖。
展开查看:分箱数据与绘图代码
gc_bin_center,mean_log2fc
30.0,-1.492
35.0,-0.703
40.0,-0.440
45.0,-0.015
50.0,-0.024
55.0,-0.145
60.0,-0.577
65.0,-1.317
70.0,-2.300绘图代码(Python,独立可运行;背景散点由代码生成)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("76-gc-bias.csv")
rng = np.random.default_rng(2076)
gc = rng.uniform(28, 72, 90)
cov = rng.normal(-0.0042 * (gc - 48) ** 2, 0.24)
fig, ax = plt.subplots(figsize=(7.2, 4.8))
ax.scatter(gc, cov, s=22, color="#4C72B0", alpha=0.55, linewidths=0)
ax.plot(df.gc_bin_center, df.mean_log2fc, "-o", color="#C44E52", lw=2,
        ms=5, label="binned mean")
ax.axhline(0, color="0.6", ls=":", lw=1)
ax.axvline(48, color="0.6", ls=":", lw=1)
ax.text(48.6, 0.85, "expected GC = 48%", fontsize=9, color="0.4")
ax.set_xlabel("GC content of window (%)")
ax.set_ylabel("log2 (observed / expected coverage)")
ax.set_ylim(-1.8, 1.2)
ax.legend(loc="lower left")
ax.set_title("GC bias in sequencing coverage (simulated)")
fig.savefig("76-gc-bias.png", dpi=200, bbox_inches="tight")2.3 Sanger 测序峰图#
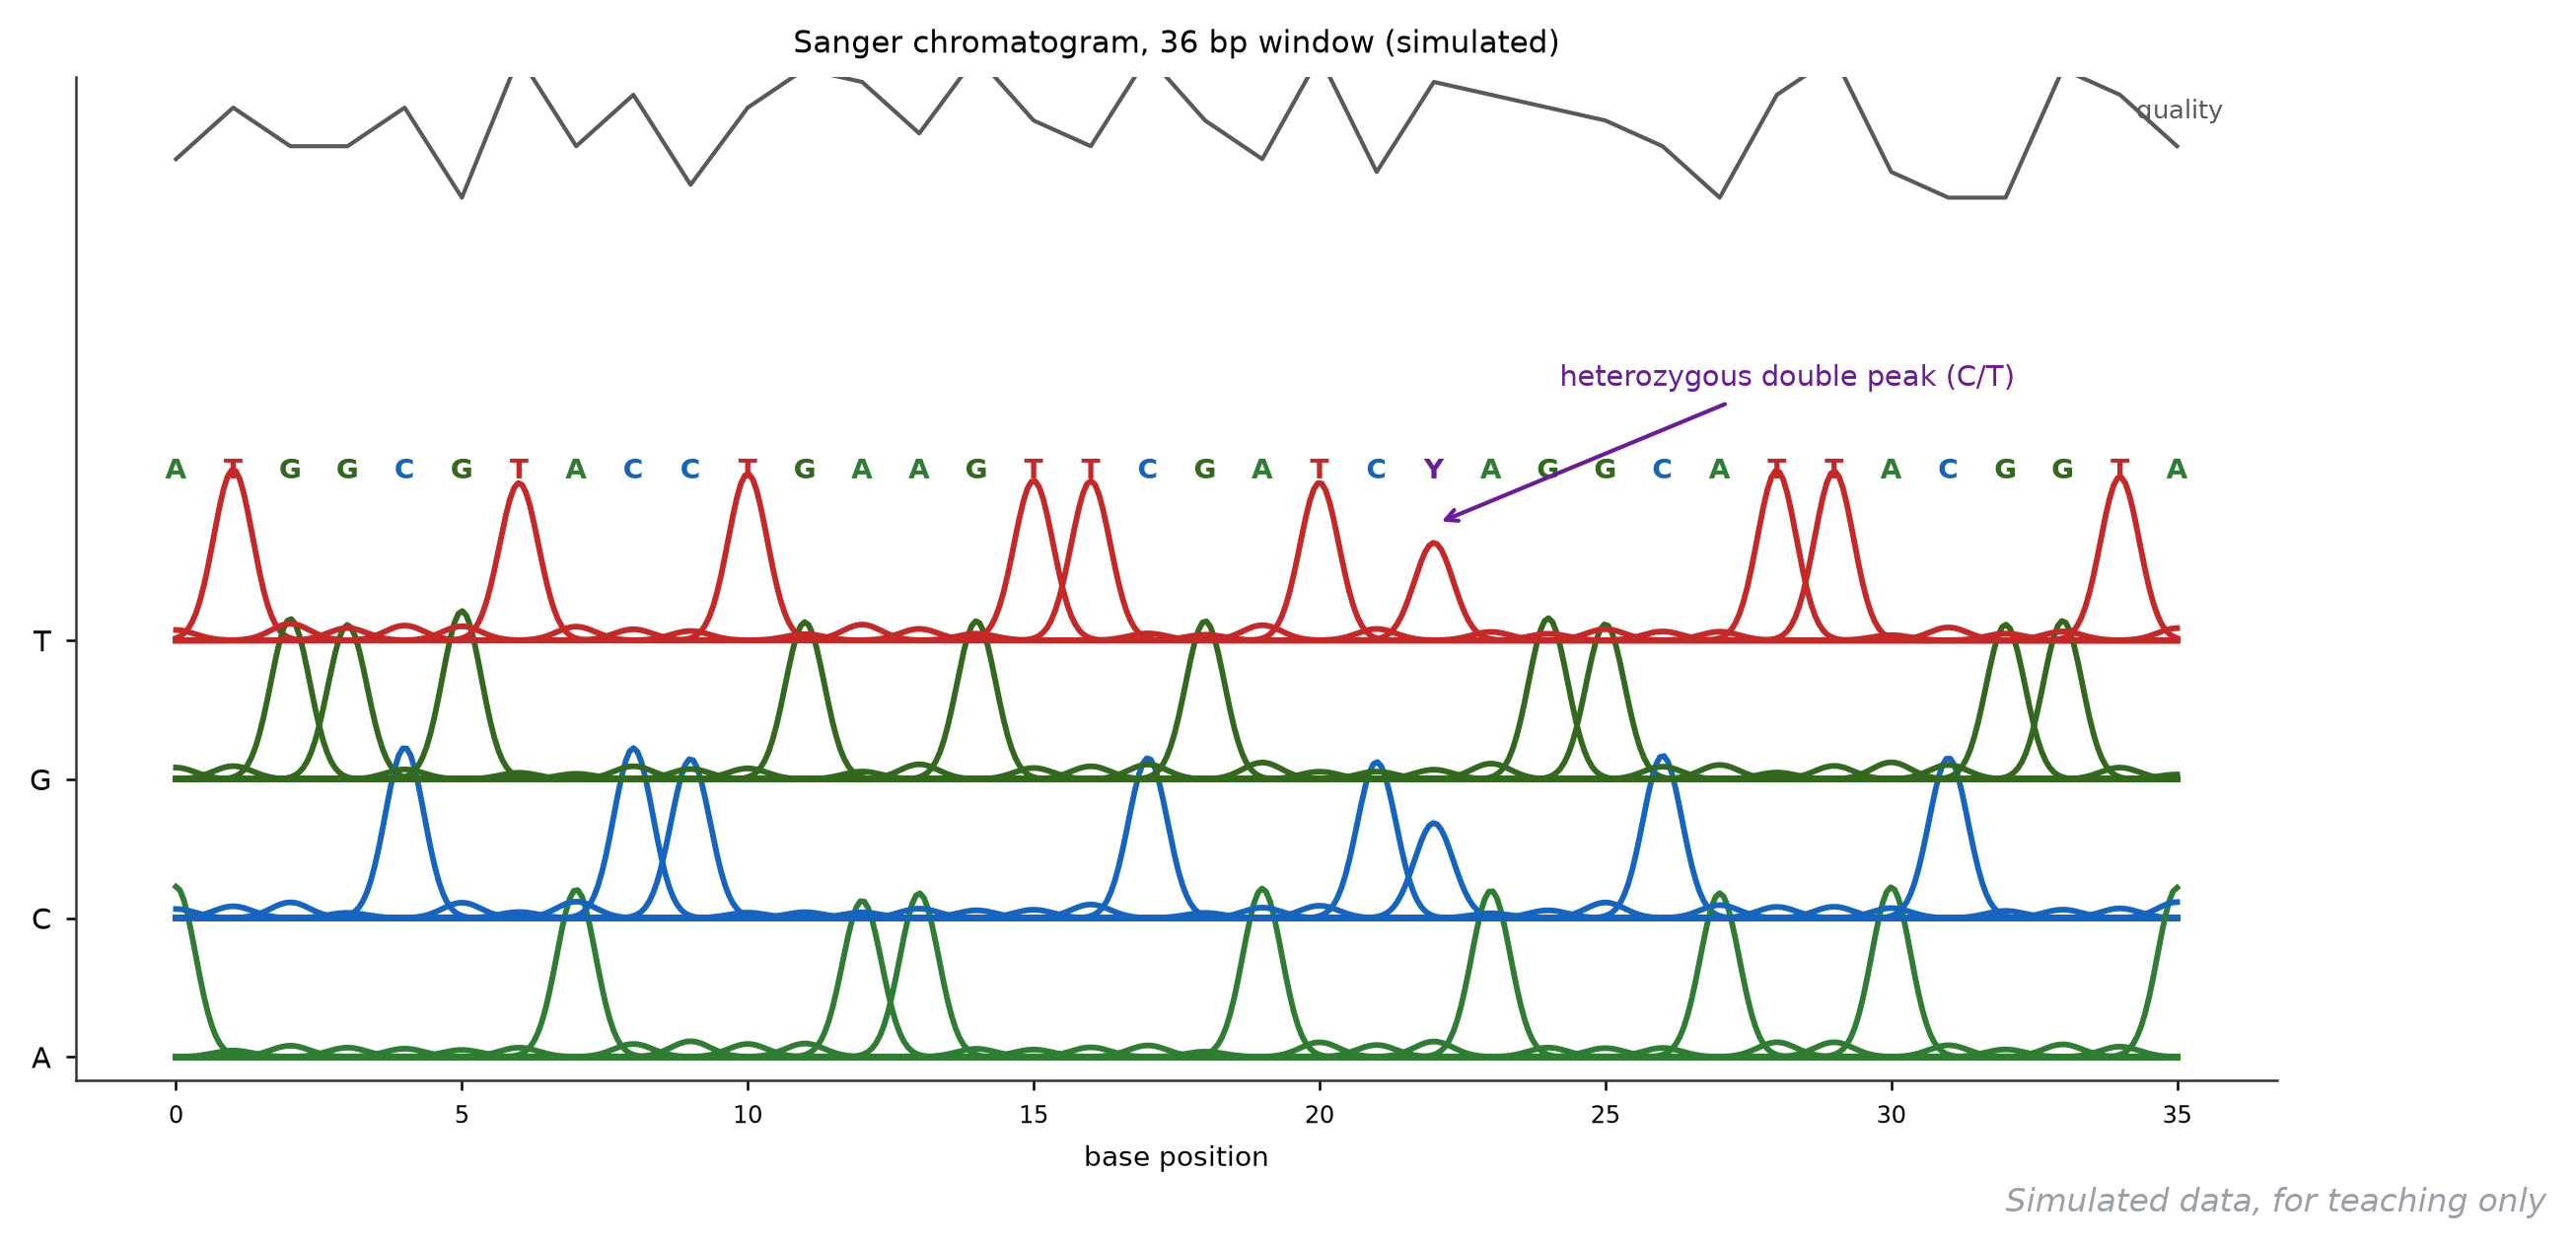
它回答什么问题:一代测序的碱基判读可不可信——载体构建、突变位点验证的最终证据图,也是审稿人最爱让你补的那种图。
怎么读:四个通道(A 绿、C 蓝、G 深绿、T 红)各一排峰,峰顶上方的字母是软件判读。判读三看:峰是否单一干净(单克隆);质量曲线(上方细线,Q 大于 30 的区段可信);以及双峰——位置 23 出现等高的 C/T 两峰(紫色标注 Y),是杂合子或混合克隆的典型指纹,不能硬判。双峰之后质量往往掉下去,因为软件从那里开始乱。
用什么画:Chromas、SnapGene 或 ab1 原始文件自带查看器;教学重绘用 matplotlib 画四通道高斯峰。
图注示例:
图 77 36 bp 测序窗口的 Sanger 峰图(模拟)。A/C/G/T 四通道信号峰,顶部字母为判读碱基,细线为逐碱基 Phred 质量值;位置 23 呈 C/T 等高双峰(Y),提示杂合位点。
展开查看:判读数据与绘图代码
pos,base,quality
1,A,33
2,T,37
3,G,34
4,G,34
5,C,37
6,G,30
7,T,41
8,A,34
9,C,38
10,C,31
11,T,37
12,G,40
13,A,39
14,A,35
15,G,41
16,T,36
17,T,34
18,C,41
19,G,36
20,A,33
21,T,41
22,C,32
23,Y,39
24,A,38
25,G,37
26,G,36
27,C,34
28,A,30
29,T,38
30,T,41
31,A,32
32,C,30
33,G,30
34,G,40
35,T,38
36,A,34绘图代码(Python,独立可运行;信号峰由代码按判读生成)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("77-sanger.csv")
rng = np.random.default_rng(2077)
seq, qual = df.base.tolist(), df.quality.values
bcol = {"A": "#2E7D32", "C": "#1565C0", "G": "#33691E", "T": "#C62828",
        "Y": "#6A1B9A"}
x = np.linspace(0, len(seq) - 1, len(seq) * 14)
fig, ax = plt.subplots(figsize=(9.6, 4.4))
order = ["A", "C", "G", "T"]
for i, b in enumerate(seq):
    c = b if b in order else ("C" if i == 22 else "T")
    for j, base in enumerate(order):
        h = 1.05 + rng.uniform(-0.06, 0.06) if base == c else \
            rng.uniform(0.03, 0.11)
        if i == 22 and base in ("C", "T"):
            h = 0.62 + rng.uniform(-0.04, 0.04)
        ax.plot(x, 0.9 * j - 0.45 + h * np.exp(-0.5 * ((x - i) / 0.34) ** 2),
                color=bcol[base], lw=1.4)
for i, b in enumerate(seq):
    ax.text(i, 3.30, b, ha="center", fontsize=8.5,
            color="#6A1B9A" if i == 22 else bcol[b], fontweight="bold")
ax.plot(range(len(seq)), qual / 12.0 + 2.62, color="0.35", lw=1)
ax.annotate("heterozygous double peak (C/T)", (22, 3.0), (24.2, 3.9),
            fontsize=9, color="#6A1B9A",
            arrowprops=dict(arrowstyle="->", color="#6A1B9A"))
ax.text(35.8, qual[-1] / 12.0 + 2.80, "quality", fontsize=8, color="0.35",
        ha="right")
ax.set_yticks([0.9 * j - 0.45 for j in range(4)], order, fontsize=9)
ax.set_xlabel("base position")
ax.set_ylim(-0.6, 5.9)
ax.set_title("Sanger chromatogram, 36 bp window (simulated)")
fig.savefig("77-sanger.png", dpi=200, bbox_inches="tight")2.4 覆盖度与剪接事件图(sashimi)#
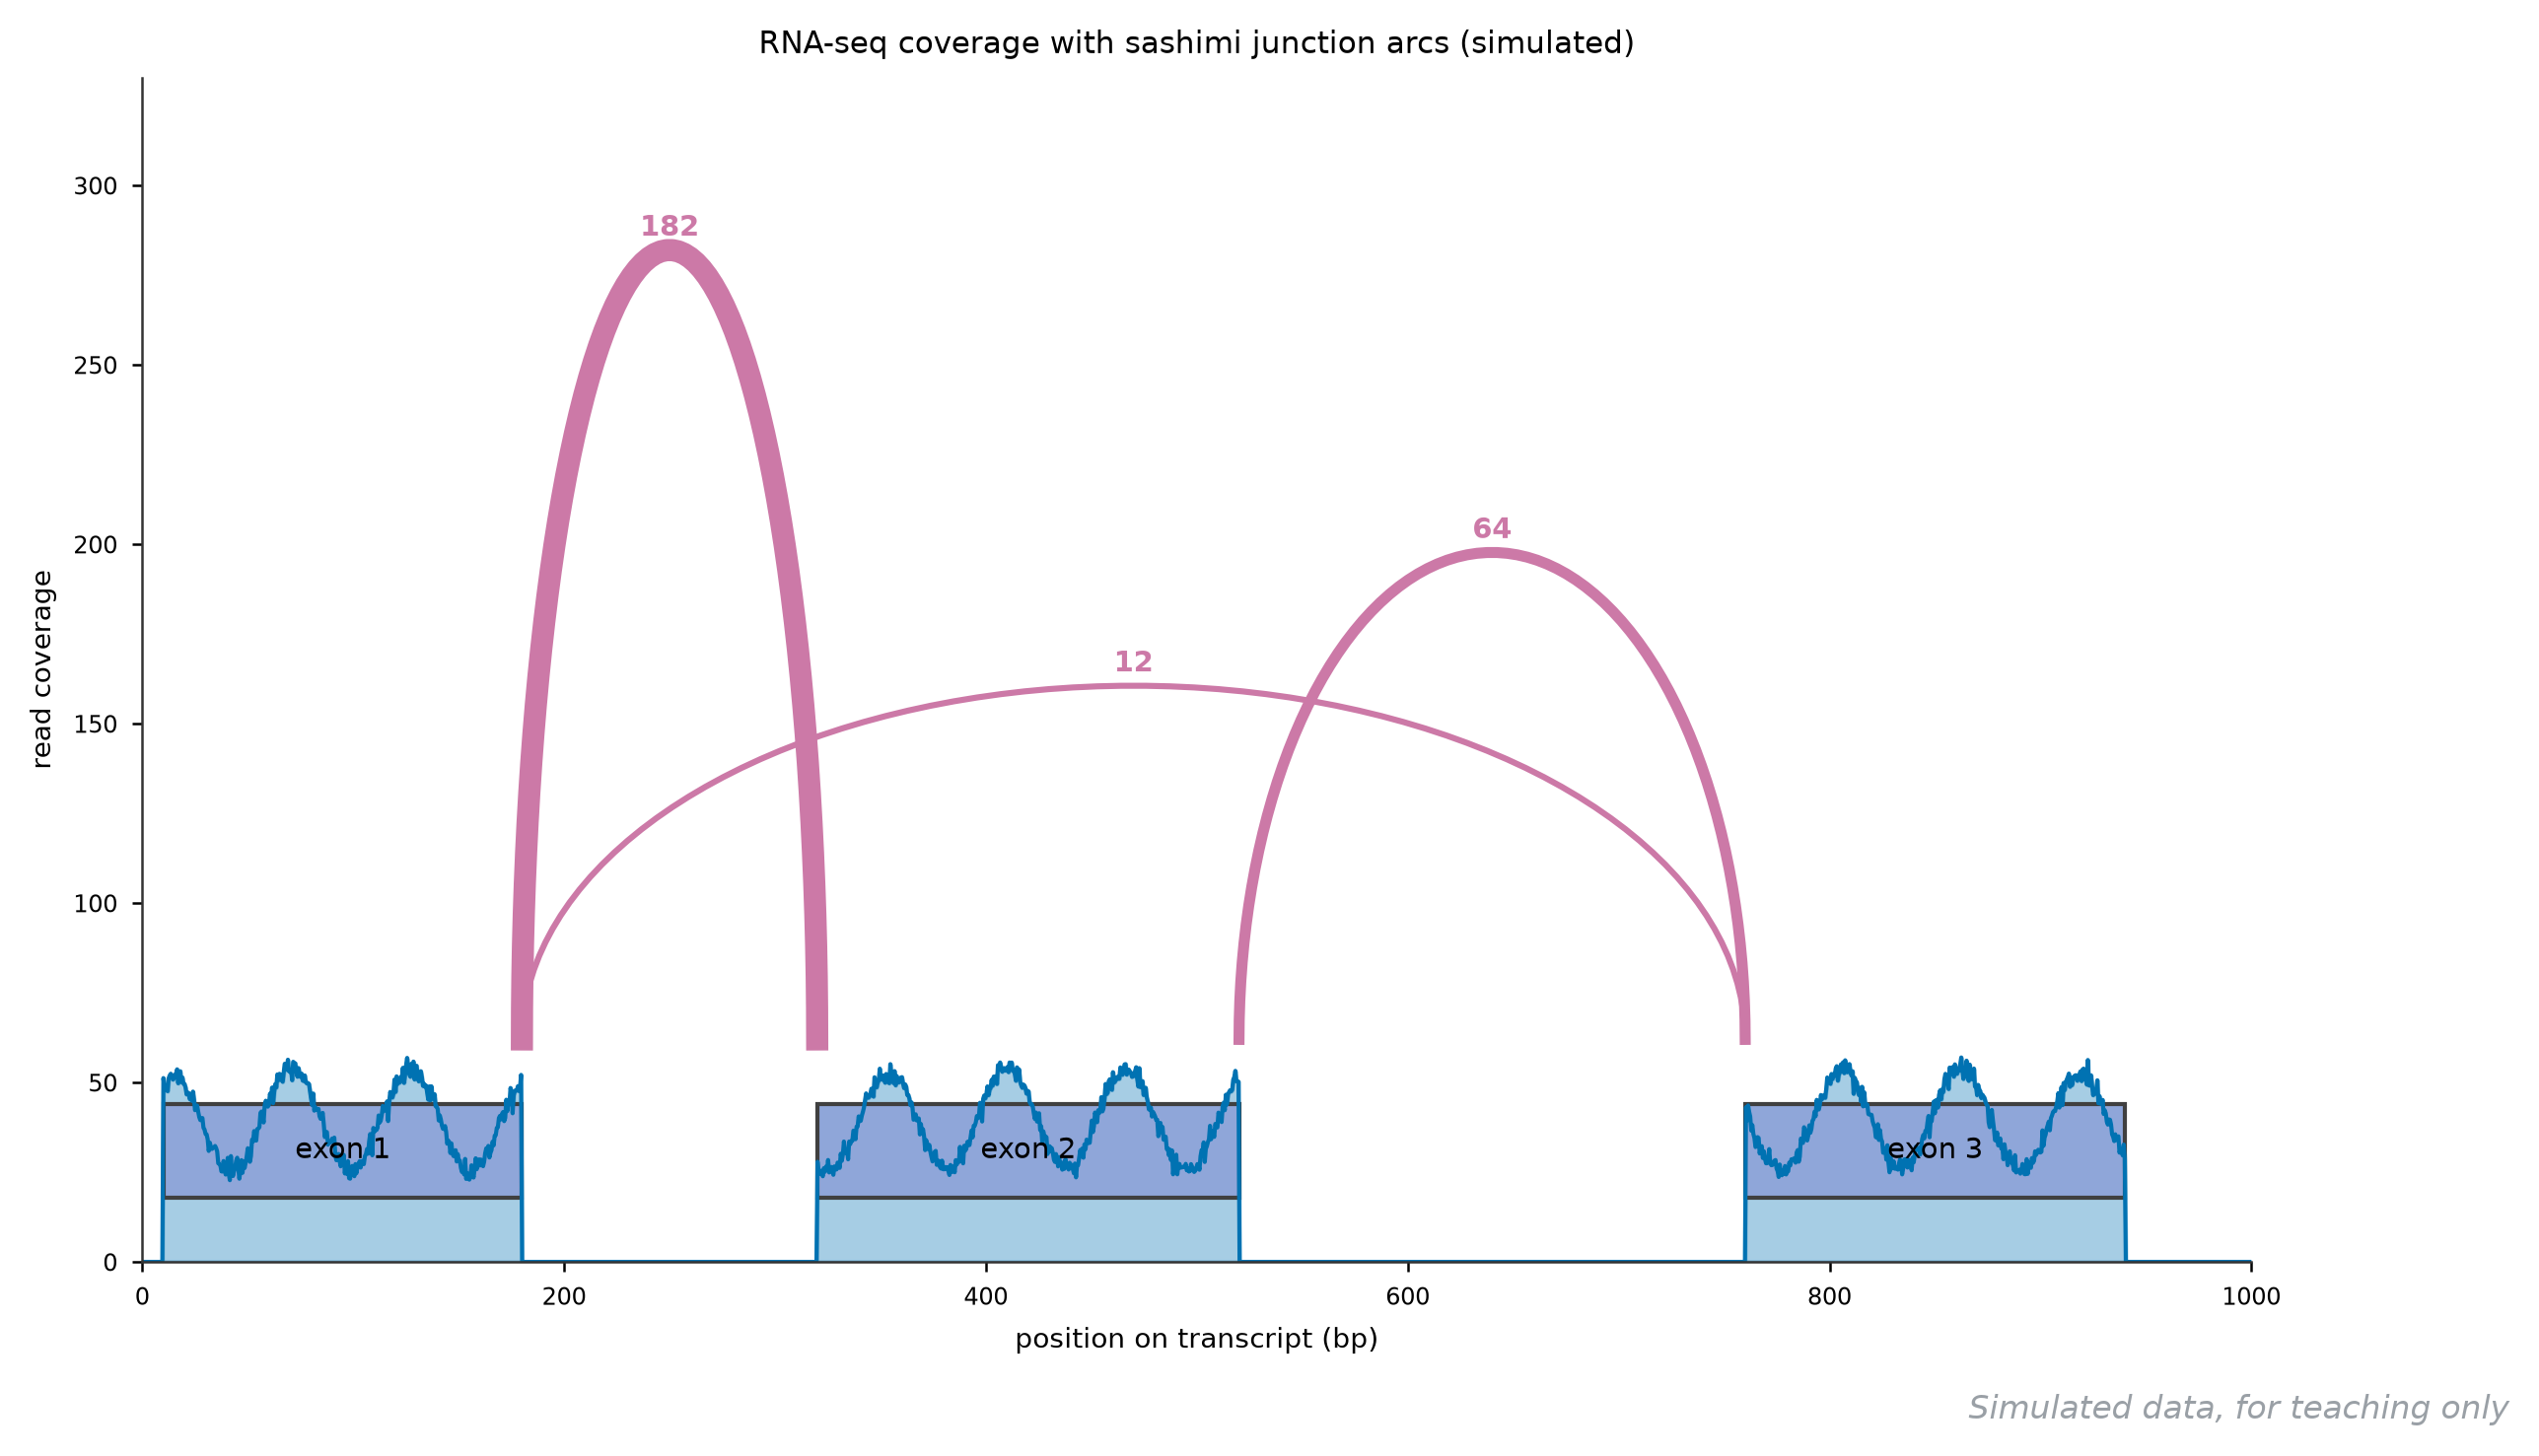
它回答什么问题:这个基因在样本里怎么剪接、剪接跃迁有多少读段支持——IGV 里最常截图给合作者的那种图,sashimi 弧线把剪接事件变成了可数的数字。
怎么读:底部方块是外显子(1-3),蓝色填充曲线是逐碱基覆盖度,外显子区高、内含子区接近零。红色弧线是剪接事件:弧线两脚是剪接供体/受体,弧宽正比于跨越该剪接的读段数(外显子 1-2 之间 182 条、2-3 之间 64 条);从外显子 1 直接到 3 的低弧(12 条)是外显子 2 跳跃(skipping)证据——弧宽比例就是可变剪接的 PSI 的雏形。
用什么画:IGV 的 sashimi plot 一键切换;批量用 ggsashimi;重绘按坐标画弧。
图注示例:
图 78 某转录本的 RNA-seq 覆盖度与剪接弧线(模拟)。外显子以方块标示,弧线宽度正比于支持剪接的读段数;外显子 1 跨连外显子 3 的弧(12 reads)提示外显子 2 跳跃事件。
展开查看:外显子剪接数据与绘图代码
element,start,end,note
exon,10,180,transcript X1
exon,320,520,transcript X1
exon,760,940,transcript X1
junction,180,320,182 reads
junction,520,760,64 reads
junction,180,760,12 reads绘图代码(Python,独立可运行;覆盖曲线由代码生成)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("78-sashimi.csv")
ex = df[df.element == "exon"][["start", "end"]].values
jn = df[df.element == "junction"]
x = np.linspace(0, 1000, 2000)
cov = np.zeros_like(x)
for a, b in ex:
    sel = (x >= a) & (x <= b)
    cov[sel] = 40 + 14 * np.sin(x[sel] / 9)
    cov[sel] *= np.exp(-0.5 * ((x[sel] - (a + b) / 2) / (b - a)) ** 2 * 0.4)
fig, ax = plt.subplots(figsize=(9.2, 5.2))
ax.fill_between(x, 0, cov, color="#4C72B0", alpha=0.35)
ax.plot(x, cov, color="#4C72B0", lw=1)
for _, r in jn.iterrows():
    a, b = r.start, r.end
    n = int(r.note.split()[0])
    h = 90 + 130 * (n / 182.0)
    t = np.linspace(0, np.pi, 80)
    ax.plot(a + (b - a) * (1 - np.cos(t)) / 2, h * np.sin(t) + 62,
            color="#C44E52", lw=1.2 + 4.2 * n / 182.0)
    ax.text((a + b) / 2, h + 66, str(n), ha="center", fontsize=9,
            color="#C44E52", fontweight="bold")
for k, (a, b) in enumerate(ex):
    ax.add_patch(plt.Rectangle((a, 18), b - a, 26, facecolor="#8FA6D9",
                               edgecolor="0.25"))
    ax.text((a + b) / 2, 31, "exon %d" % (k + 1), ha="center", va="center",
            fontsize=9)
ax.set_ylim(0, 330)
ax.set_xlabel("position on transcript (bp)")
ax.set_ylabel("read coverage")
ax.set_title("RNA-seq coverage with sashimi junction arcs (simulated)")
fig.savefig("78-sashimi.png", dpi=200, bbox_inches="tight")2.5 读段 pileup 与变异位点图#
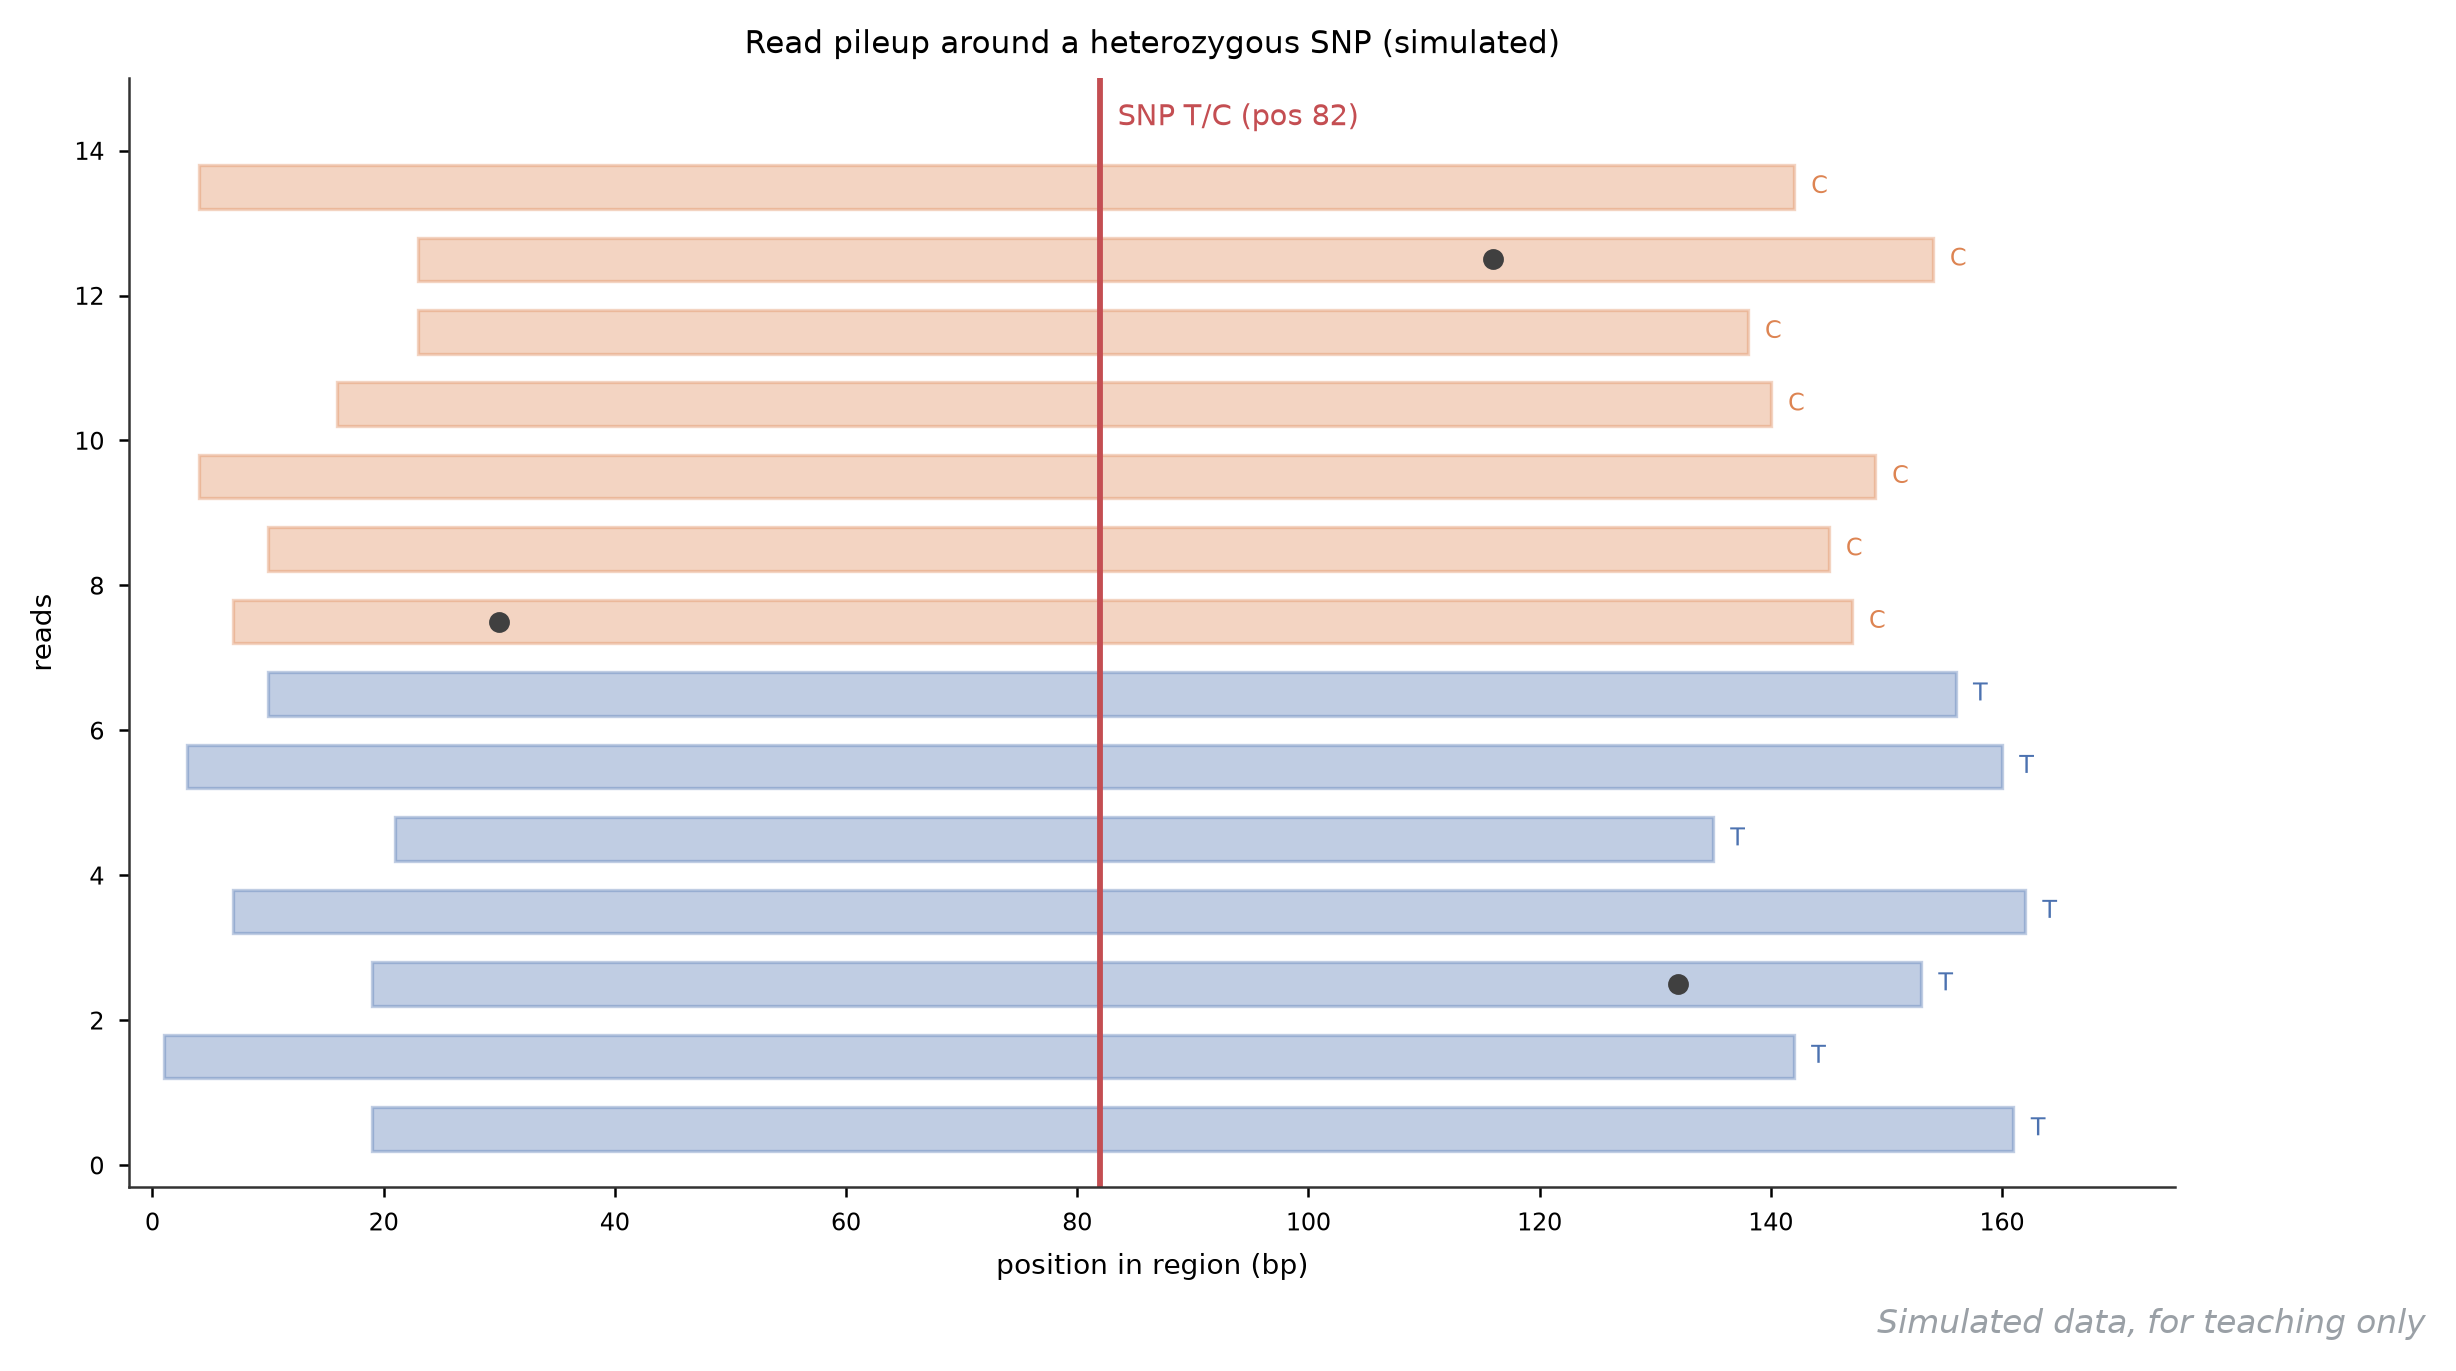
它回答什么问题:一个变异位点有多少读段、从哪条单倍型来——BAM 文件展开后的样子,也是理解基因型判读(genotyping)直觉的最佳教具。
怎么读:每条横带是一条读段(r1-r14),蓝色单倍型在位点 82 携带 T,橙色携带 C,各自整段涂色说明两条单倍型界限分明。三条经验法则一眼可验:基因型判读看深度(本例 7:7,杂合);孤立的杂色刻度(r3、r8 上的灰点)是测序错误,不成簇就别管;读段起点参差不齐是正常剪切富集,齐得可疑反而像 PCR 重复。
用什么画:IGV / samtools tview 直接看;重绘按读段坐标画横条。
图注示例:
图 79 杂合 SNP 位点(pos 82,T/C)附近的读段 pileup(模拟)。蓝/橙横带分属两条单倍型,各 7 条读段支持;孤立灰色刻度为散在测序错误。
展开查看:读段列表与绘图代码
read,haplotype,start,end,base_at_82
r1,0,19,161,T
r2,0,1,142,T
r3,0,19,153,T
r4,0,7,162,T
r5,0,21,135,T
r6,0,3,160,T
r7,0,10,156,T
r8,1,7,147,C
r9,1,10,145,C
r10,1,4,149,C
r11,1,16,140,C
r12,1,23,138,C
r13,1,23,154,C
r14,1,4,142,C绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("79-pileup.csv")
hcol = ["#4C72B0", "#DD8452"]
fig, ax = plt.subplots(figsize=(8.8, 4.8))
for k, (_, r) in enumerate(df.iterrows()):
    i, hap = k, int(r.haplotype)
    ax.add_patch(plt.Rectangle((r.start, i + 0.2), r.end - r.start, 0.6,
                               facecolor=hcol[hap], alpha=0.35,
                               edgecolor=hcol[hap], lw=0.8))
    ax.text(r.end + 1.5, i + 0.5, r.base_at_82, fontsize=7.5, va="center",
            color=hcol[hap])
    if i % 5 == 2:
        e = r.start + 8 + (i * 7) % max(int(r.end - r.start - 16), 1)
        if abs(e - 82) > 6:
            ax.scatter([e], [i + 0.5], s=16, color="0.25", zorder=4)
ax.axvline(82, color="#C44E52", lw=1.4)
ax.text(83.5, 14.35, "SNP T/C (pos 82)", fontsize=9, color="#C44E52")
ax.set_ylim(-0.3, 15)
ax.set_xlim(-2, 175)
ax.set_xlabel("position in region (bp)")
ax.set_ylabel("reads")
ax.set_title("Read pileup around a heterozygous SNP (simulated)")
fig.savefig("79-pileup.png", dpi=200, bbox_inches="tight")三、变异与群体遗传#
3.1 突变频谱图#
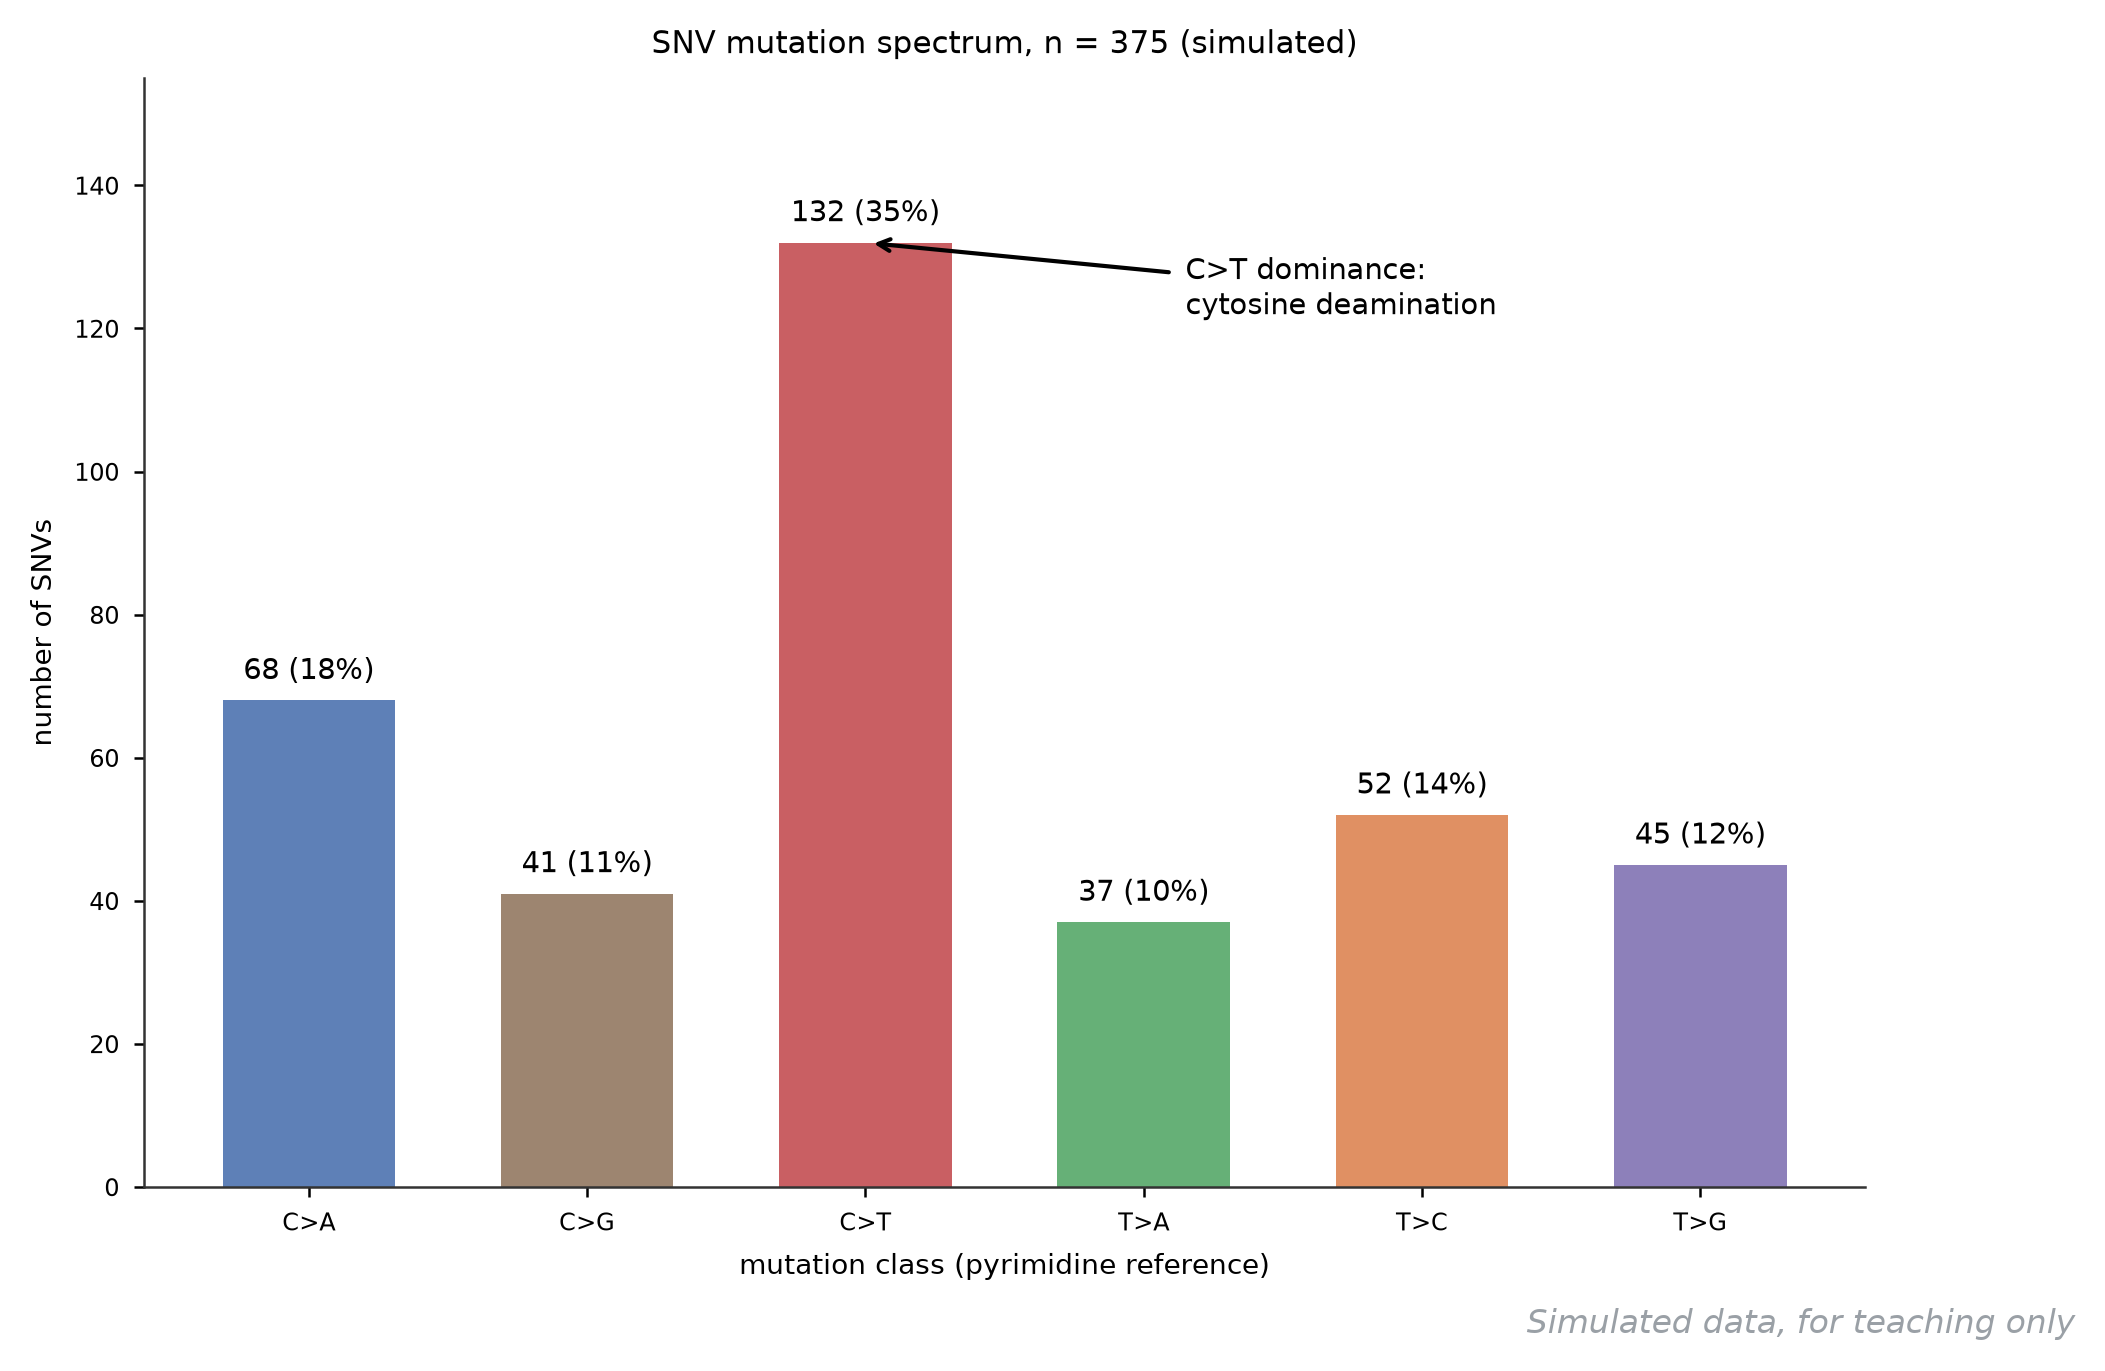
它回答什么问题:这批 SNV 的六类替换比例正不正常——突变过程的「指纹」,肿瘤学靠它分签名,植物诱变实验靠它验证诱变剂类型。
怎么读:六根柱是按嘧啶链记的 C>A、C>G、C>T、T>A、T>C、T>G(互补替换合并计数)。自发突变里 C>T 通常最高(本例 132 个,占 35%)——胞嘧啶自发脱氨是内源性突变的主渠道;若 C>A 异常抬升,想想氧化损伤或烷化剂处理;诱变图谱分析(如 EMS 诱变后 C>G/T>C 飙升)也是这张图。图注要给总数和取样组织。
用什么画:GATK CollectSequencingArtifactMetrics 或 SigProfilerExtractor;重绘就是六根柱。
图注示例:
图 80 群体重测序 375 个 SNV 的突变频谱(模拟)。按嘧啶参考链合并互补替换;C>T 替换占 35%,符合自发脱氨为主的突变过程。
展开查看:数据与绘图代码
mutation_class,count
C>A,68
C>G,41
C>T,132
T>A,37
T>C,52
T>G,45绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("80-mut-spectrum.csv")
cols = ["#4C72B0", "#937860", "#C44E52", "#55A868", "#DD8452", "#8172B3"]
fig, ax = plt.subplots(figsize=(7.4, 4.8))
ax.bar(df.mutation_class, df["count"], color=cols, alpha=0.9, width=0.62)
for i, v in enumerate(df["count"]):
    ax.text(i, v + 3, "%d (%.0f%%)" % (v, v / 375 * 100), ha="center",
            fontsize=9)
ax.annotate("C>T dominance:\ncytosine deamination", (2, 132), (3.15, 122),
            fontsize=9, arrowprops=dict(arrowstyle="->", lw=1))
ax.set_xlabel("mutation class (pyrimidine reference)")
ax.set_ylabel("number of SNVs")
ax.set_ylim(0, 155)
ax.set_title("SNV mutation spectrum, n = 375 (simulated)")
fig.savefig("80-mut-spectrum.png", dpi=200, bbox_inches="tight")3.2 位点频率谱(SFS)#
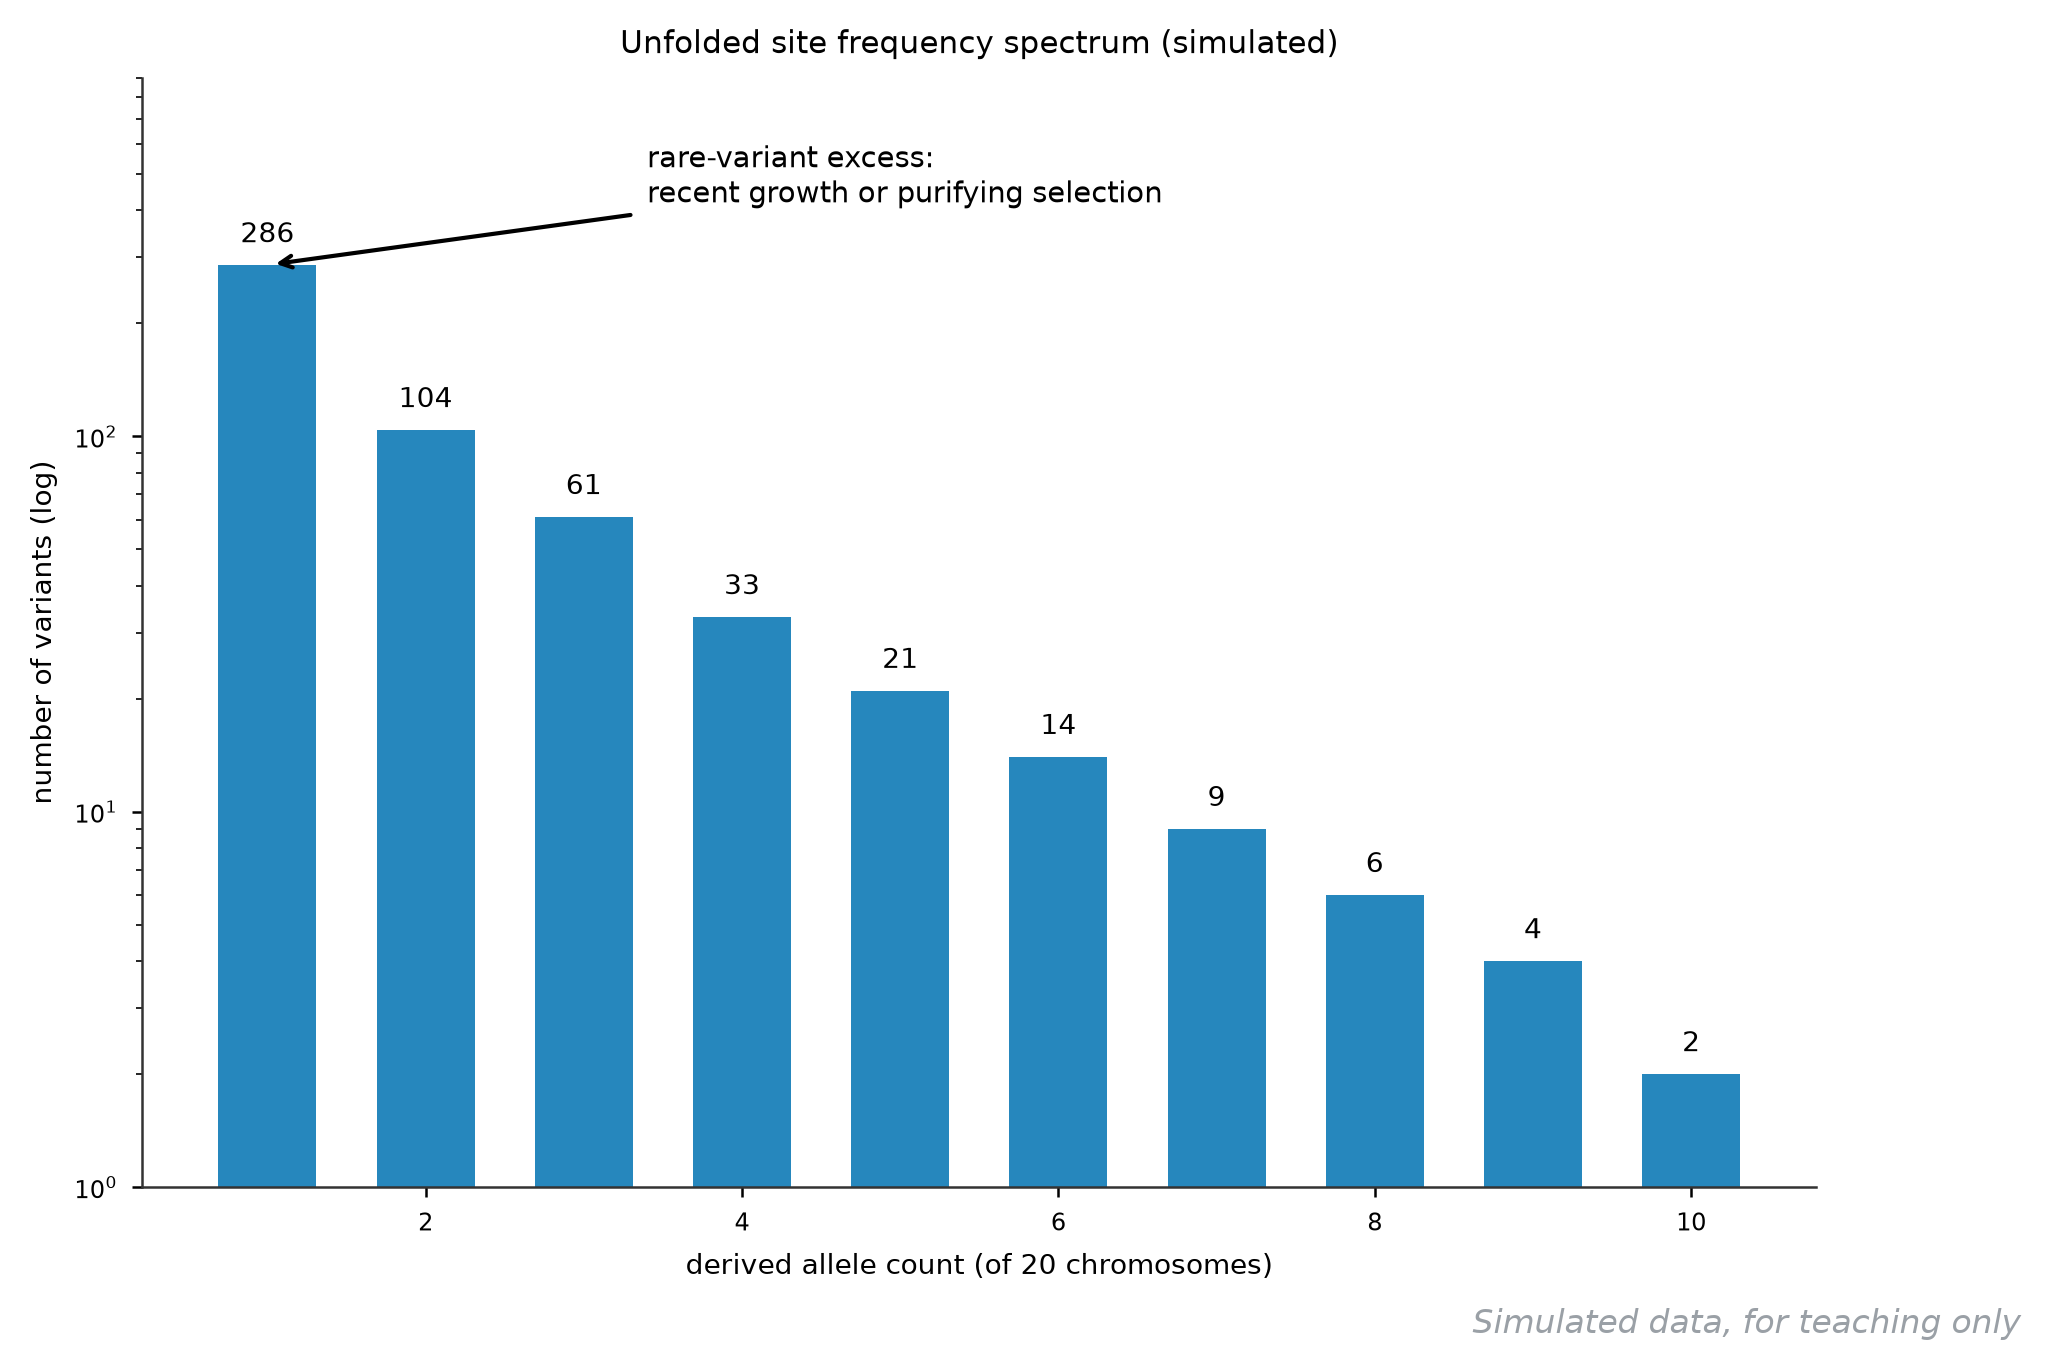
它回答什么问题:变异的频率分布偏向稀有还是均摊——群体遗传学信息密度最高的一张直方图,群体大小变化、选择全都压在这条曲线上。
怎么读:横轴是衍生等位基因在 20 条染色体里的计数(1=单例稀有,10=近固定),纵轴是对数尺度的变体数。中性稳态群体呈 L 形但比例可预期;本例单例变体 286 个、远超中性预期,是稀有变异过剩——指向群体快速扩张或纯化选择。注意展开 SFS 需要可靠的外群定衍生等位基因,定不了就用折叠 SFS(横轴砍半)。
用什么画:ANGSD 的 saf 或 dadi 估 SFS;重绘对 bins 画对数柱。
图注示例:
图 81 20 条染色体折叠前的位点频率谱(模拟,540 个变体)。单例(单拷贝衍生等位基因)变体 286 个,稀有变异显著过剩,提示群体扩张。
展开查看:数据与绘图代码
derived_allele_count,variants
1,286
2,104
3,61
4,33
5,21
6,14
7,9
8,6
9,4
10,2绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("81-sfs.csv")
fig, ax = plt.subplots(figsize=(7.2, 4.8))
ax.bar(df.derived_allele_count, df.variants, color="#4C72B0", alpha=0.85,
       width=0.62)
ax.set_yscale("log")
ax.set_ylim(1, 900)
for _, r in df.iterrows():
    ax.text(r.derived_allele_count, r.variants * 1.15, str(r.variants),
            ha="center", fontsize=8.5)
ax.annotate("rare-variant excess:\nrecent growth or purifying selection",
            (1, 286), (3.4, 420), fontsize=9,
            arrowprops=dict(arrowstyle="->", lw=1))
ax.set_xlabel("derived allele count (of 20 chromosomes)")
ax.set_ylabel("number of variants (log)")
ax.set_title("Unfolded site frequency spectrum (simulated)")
fig.savefig("81-sfs.png", dpi=200, bbox_inches="tight")3.3 Tajima’s D 滑窗图#
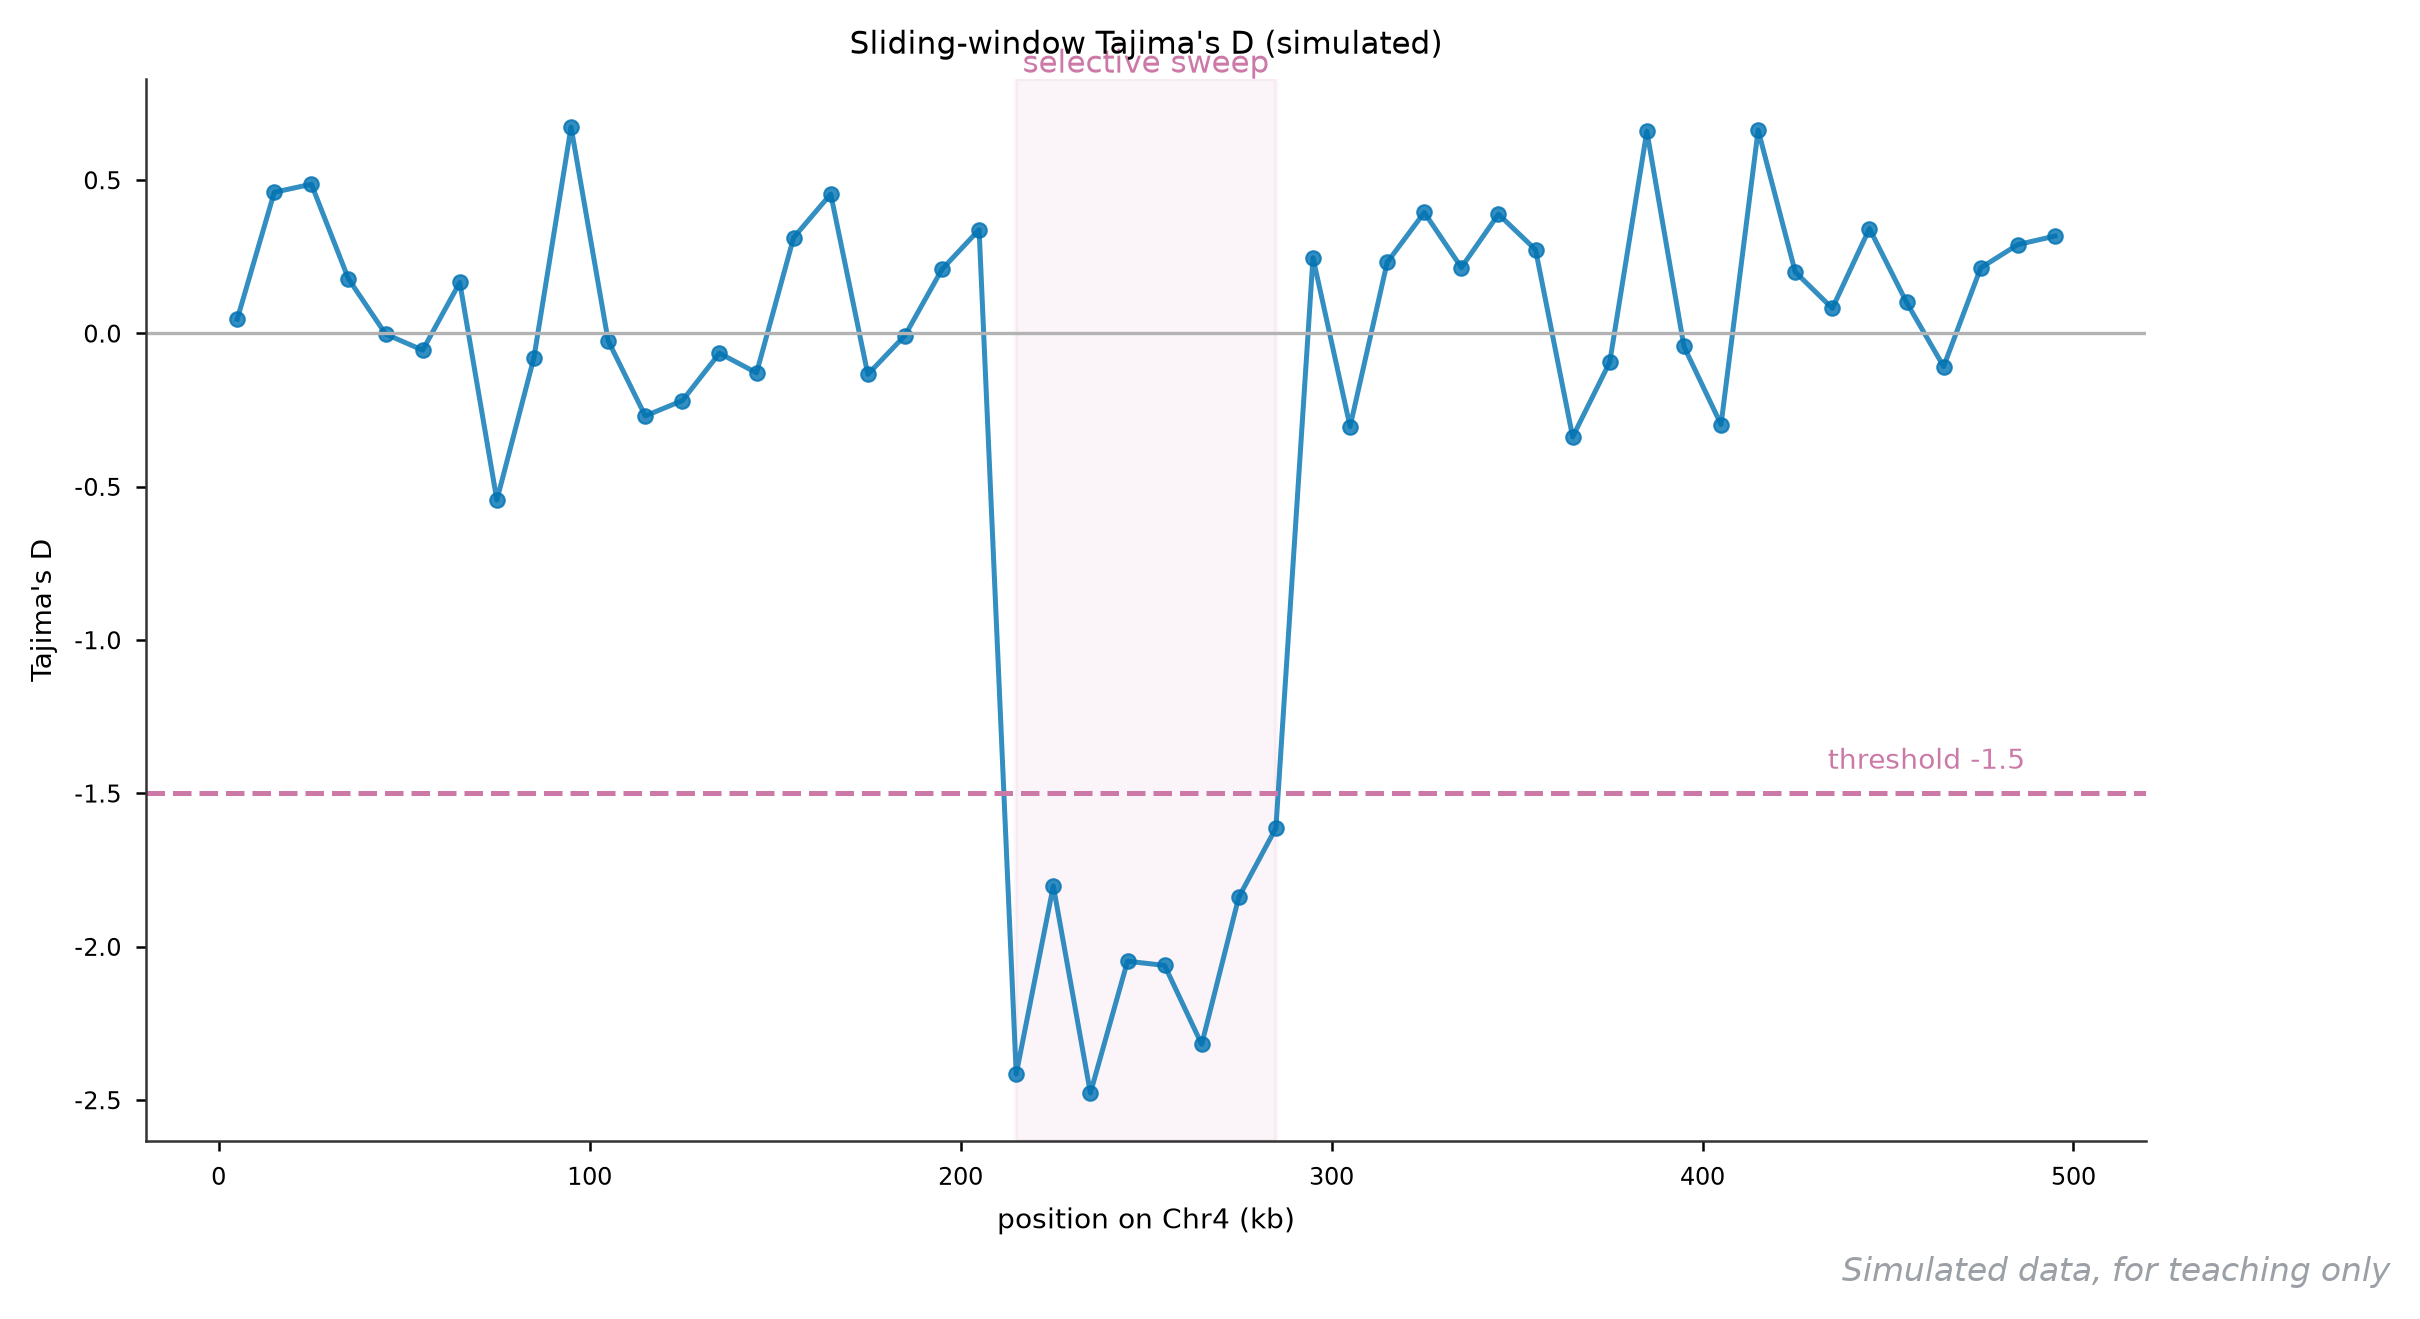
它回答什么问题:基因组哪一段的历史「不对劲」——中性检验的滑窗版,选择清除和群体扩张在 D 值上留下相反的符号。
怎么读:横轴基因组位置,纵轴 Tajima’s D。基线在 0 附近晃(本例 215-285 kb 之外,D 在 ±0.7 内);D 显著为负=稀有等位基因过剩(选择清除刚扫过,新突变还没来得及积累频率);D 显著为正=中等频率变异过剩(平衡选择或群体收缩)。本例 215-285 kb 一段 D 掉到 -2.5,穿过 -1.5 警戒线,是候选选择区段——但负 D 也可能只是局部重组率低,下结论前要联合 Fst 与核苷酸多样性(见 3.5)。
用什么画:VCFtools --TajimaD 或 PopGenome;重绘按窗口画线加阴影。
图注示例:
图 82 Chr4 10 kb 滑窗 Tajima’s D(模拟)。红色虚线为 -1.5 经验阈值,阴影区间 215-285 kb 的 D 值跌至 -2.5,提示近期选择清除。
展开查看:滑窗数据与绘图代码
window_kb,tajima_d
5,0.046
15,0.460
25,0.486
35,0.177
45,-0.002
55,-0.055
65,0.166
75,-0.544
85,-0.079
95,0.673
105,-0.024
115,-0.269
125,-0.219
135,-0.065
145,-0.129
155,0.312
165,0.454
175,-0.134
185,-0.007
195,0.209
205,0.338
215,-2.416
225,-1.802
235,-2.477
245,-2.048
255,-2.061
265,-2.319
275,-1.839
285,-1.613
295,0.247
305,-0.304
315,0.231
325,0.394
335,0.215
345,0.388
355,0.273
365,-0.338
375,-0.094
385,0.659
395,-0.043
405,-0.297
415,0.663
425,0.200
435,0.081
445,0.342
455,0.101
465,-0.108
475,0.213
485,0.289
495,0.317绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("82-tajima.csv")
fig, ax = plt.subplots(figsize=(8.6, 4.6))
ax.plot(df.window_kb, df.tajima_d, "-o", ms=3.5, color="#4C72B0", alpha=0.8)
ax.axhline(0, color="0.7", lw=0.8)
ax.axhline(-1.5, color="#C44E52", ls="--", lw=1.2)
ax.text(487, -1.42, "threshold -1.5", fontsize=8.5, color="#C44E52",
        ha="right")
ax.axvspan(215, 285, color="#C44E52", alpha=0.08)
ax.text(250, 0.85, "selective sweep", ha="center", fontsize=9.5,
        color="#C44E52")
ax.set_xlabel("position on Chr4 (kb)")
ax.set_ylabel("Tajima's D")
ax.set_title("Sliding-window Tajima's D (simulated)")
fig.savefig("82-tajima.png", dpi=200, bbox_inches="tight")3.4 单倍型网络图#
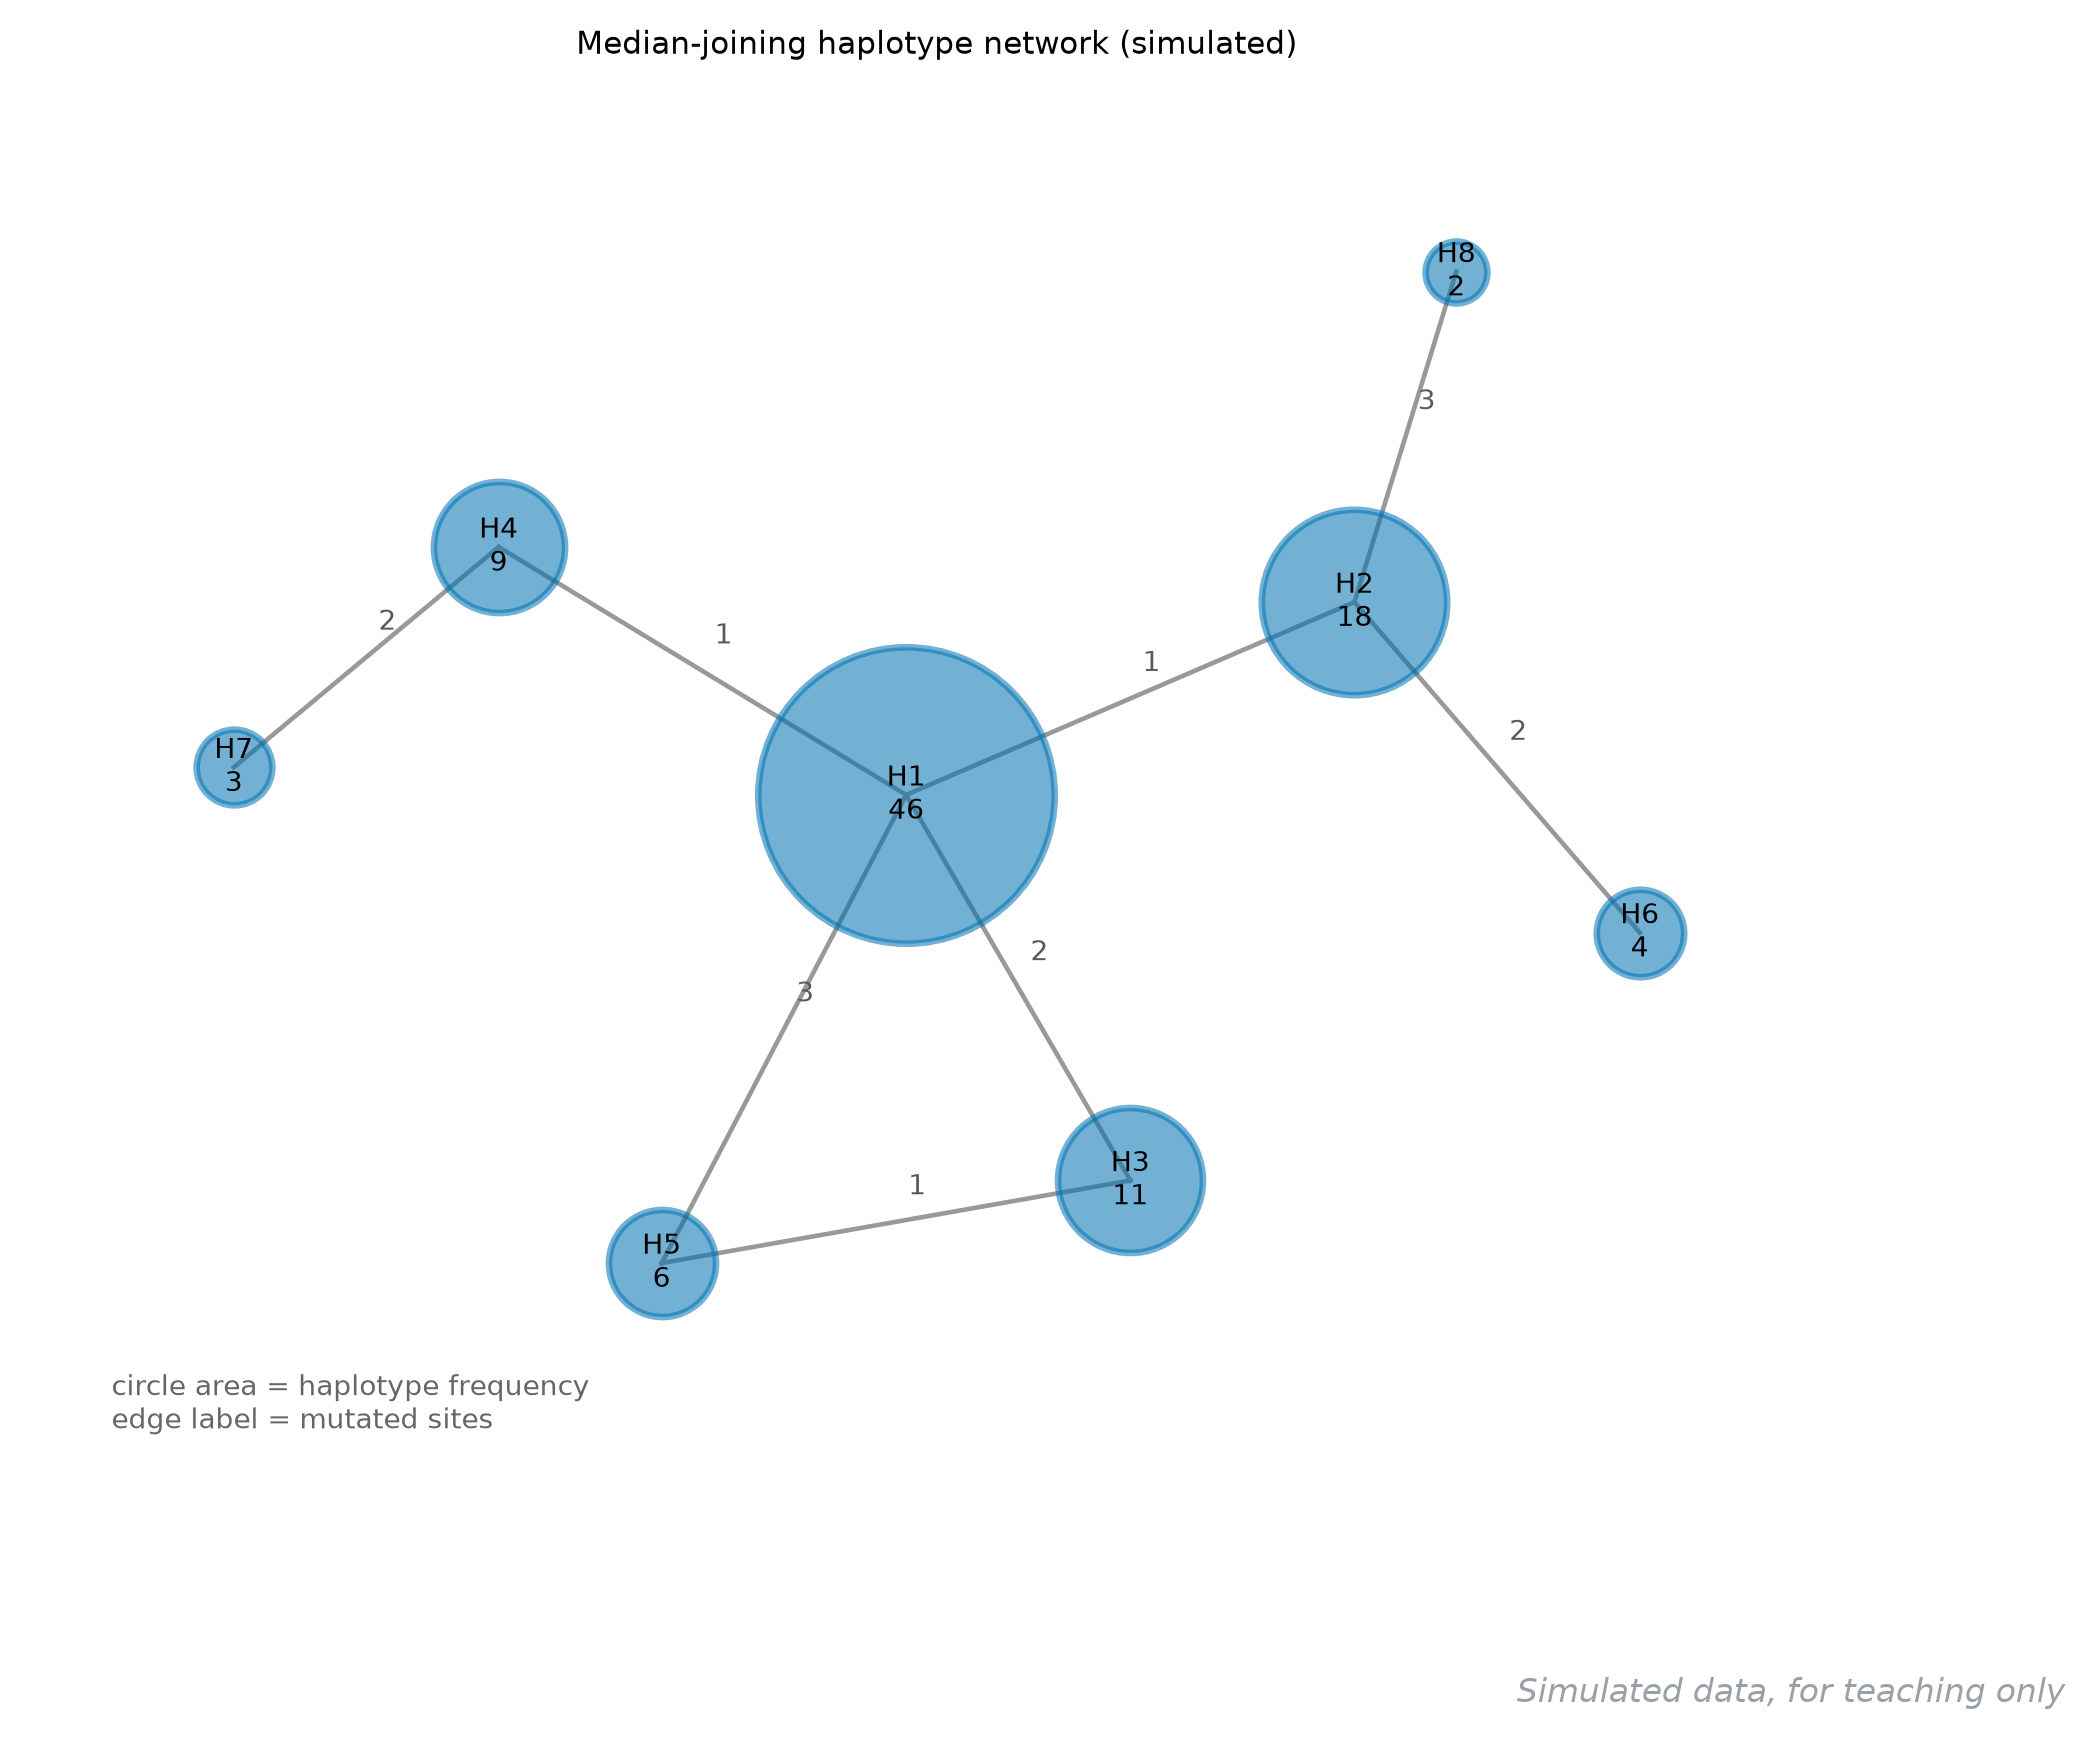
它回答什么问题:这些单倍型谁从谁变来、怎么扩散——比系统发育树更诚实的种内关系图(单倍型之间本来就不该有「树」),驯化与传播研究的标配。
怎么读:圆是单倍型,圆面积正比于携带者数量(H1 有 46 个,绝对主单倍型);连线上的数字是分开两个单倍型需要几步突变。读三样:中心大圆=祖先型或广布型;从它辐射出的低步数分支(1-2 步)是常见衍生;孤悬的远端小圆(H6 走 2 步、H8 走 3 步)值得看地理分布——如果它们只在一个采样点出现,那就是局域扩张的故事。网状结构(H3-H5-H1 三角)提示重组或平行突变,这正是「网络」比「树」诚实的地方。
用什么画:PopART(median-joining)、Network;重绘按坐标画圆连线。
图注示例:
图 83 群体单倍型的 median-joining 网络(模拟,99 个样本 8 种单倍型)。圆面积正比单倍型频数,连线上数字为突变步数;H1 为核心单倍型,H8 由 H2 经 3 步突变衍生。
展开查看:节点边表与绘图代码
haplotype,x,y,samples
H1,0.0,0.0,46
H2,2.2,0.7,18
H3,1.1,-1.4,11
H4,-2.0,0.9,9
H5,-1.2,-1.7,6
H6,3.6,-0.5,4
H7,-3.3,0.1,3
H8,2.7,1.9,2hap1,hap2,mutations
H1,H2,1
H1,H3,2
H1,H4,1
H1,H5,3
H2,H6,2
H4,H7,2
H2,H8,3
H3,H5,1绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

nodes = pd.read_csv("83-hap-nodes.csv")
edges = pd.read_csv("83-hap-edges.csv")
pos = {r.haplotype: (r.x, r.y) for _, r in nodes.iterrows()}
fig, ax = plt.subplots(figsize=(7.8, 6.2))
for _, e in edges.iterrows():
    (x0, y0), (x1, y1) = pos[e.hap1], pos[e.hap2]
    ax.plot([x0, x1], [y0, y1], color="0.6", lw=1.1, zorder=1)
    ax.text((x0 + x1) / 2 + 0.06, (y0 + y1) / 2 + 0.10, str(e.mutations),
            fontsize=8.5, color="0.35")
for _, r in nodes.iterrows():
    ax.scatter([r.x], [r.y], s=110 * r.samples, color="#4C72B0",
               alpha=0.55, edgecolors="#4C72B0", linewidths=1.6, zorder=3)
    ax.text(r.x, r.y, "%s\n%d" % (r.haplotype, r.samples), ha="center",
            va="center", fontsize=8.5, zorder=4)
ax.text(-3.9, -2.3, "circle area = haplotype frequency\nedge label = mutated sites",
        fontsize=8.5, color="0.4")
ax.set_xlim(-4.3, 4.6)
ax.set_ylim(-2.6, 2.6)
ax.axis("off")
ax.set_title("Median-joining haplotype network (simulated)")
fig.savefig("83-hap-network.png", dpi=200, bbox_inches="tight")3.5 亲缘关系热图(GRM)#
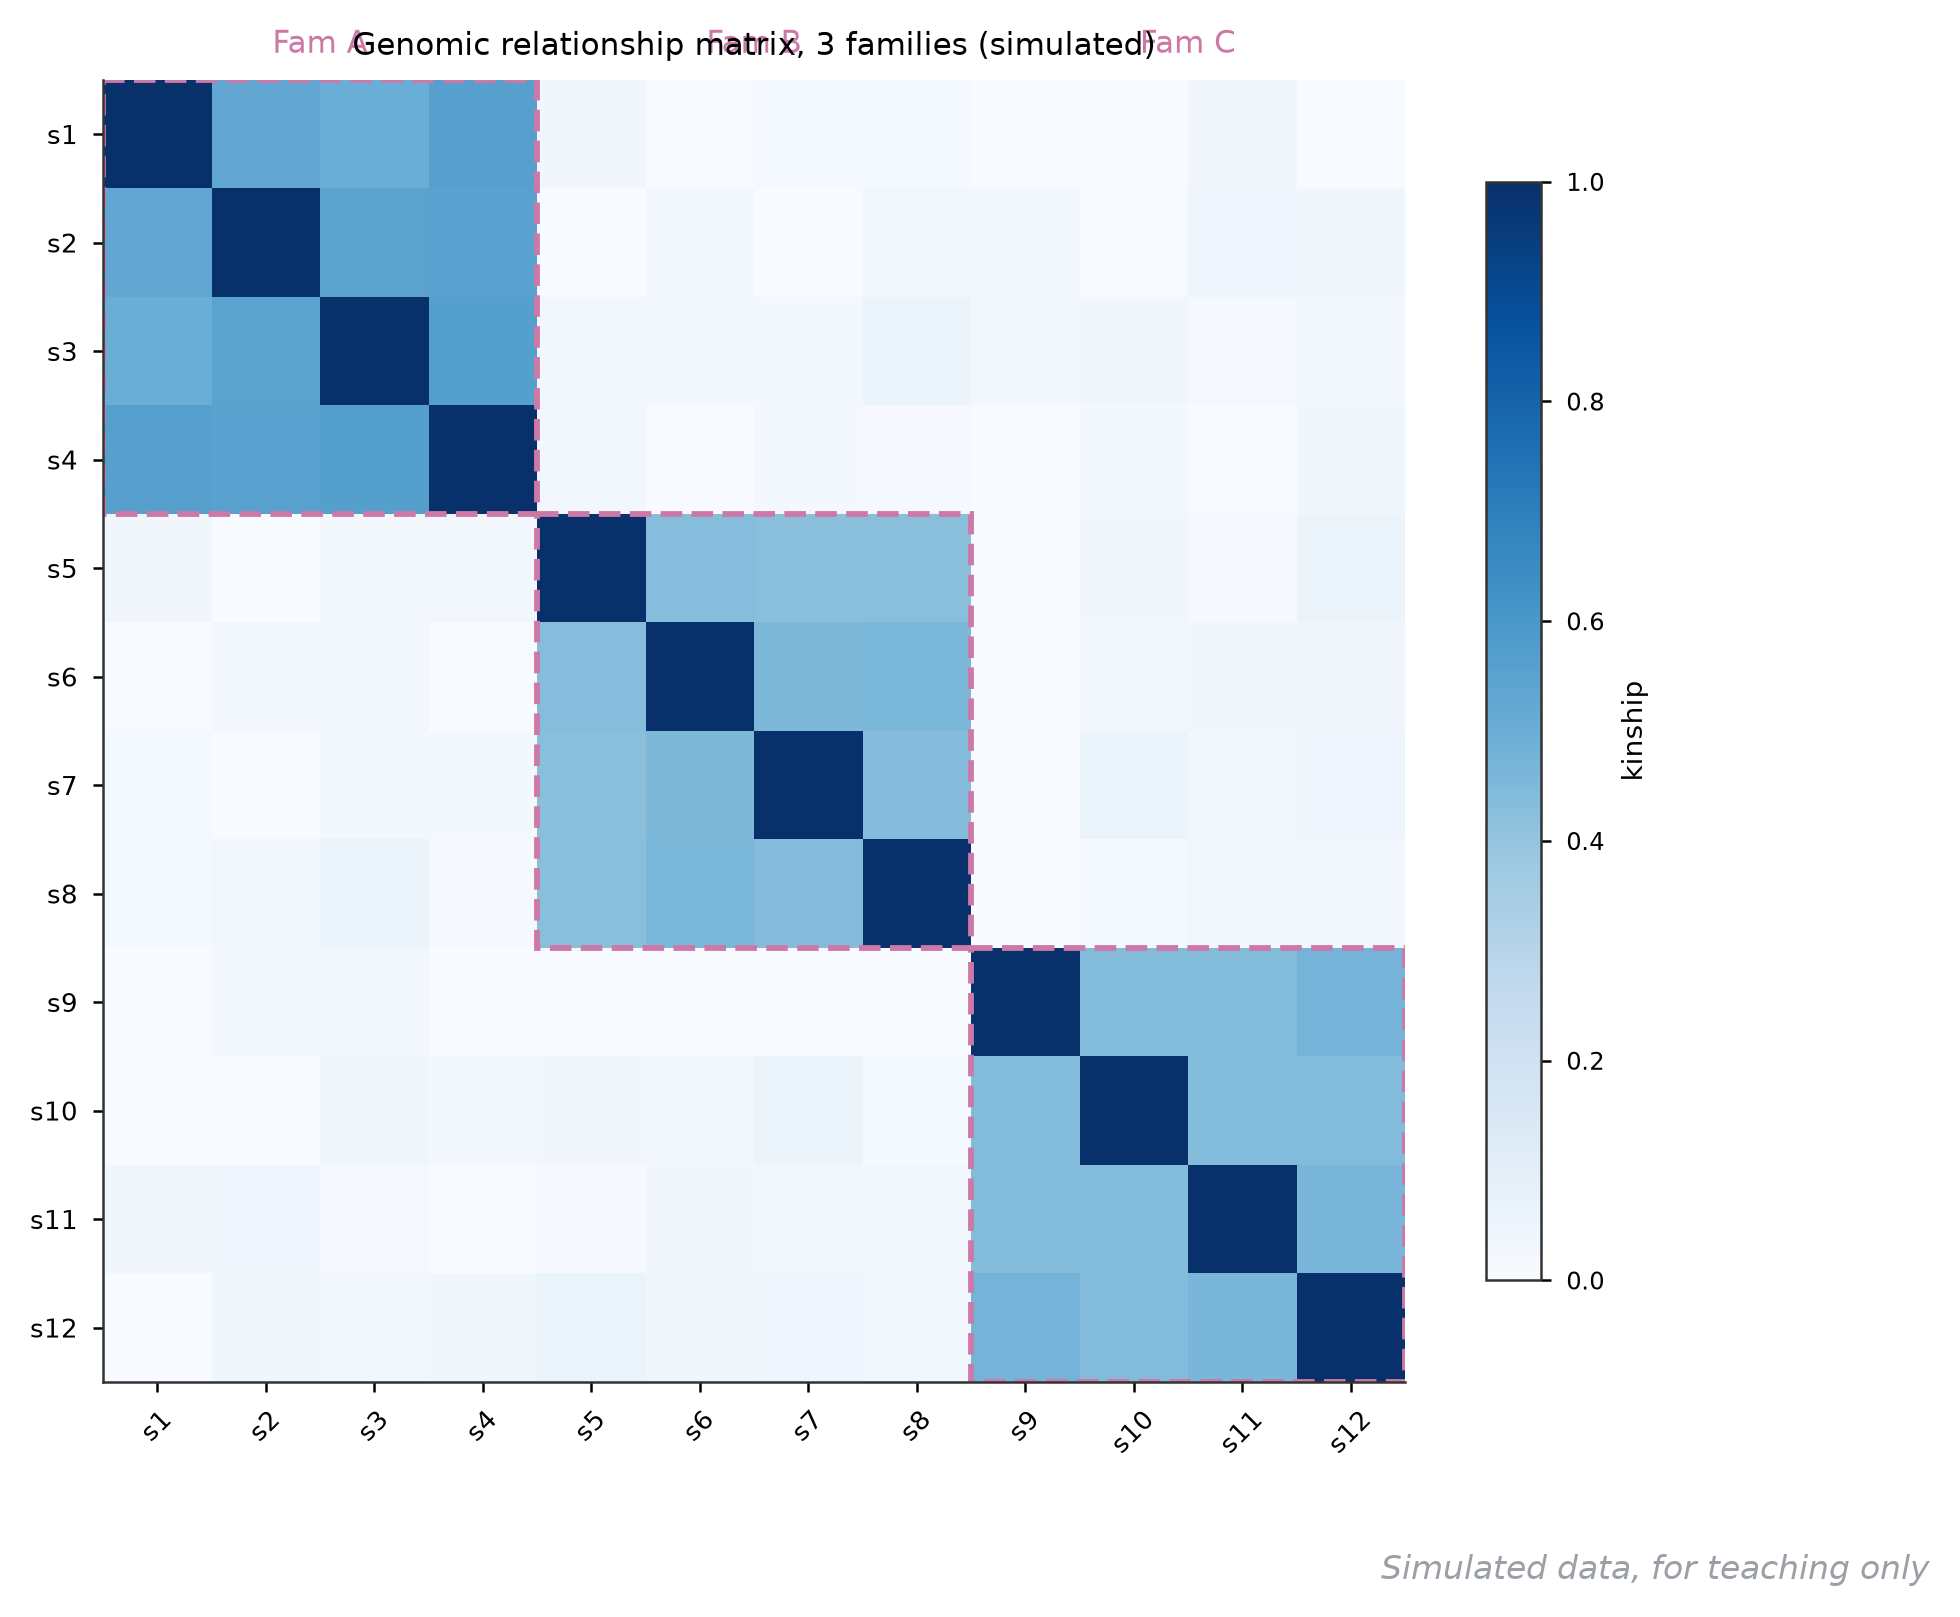
它回答什么问题:样本之间谁和谁沾亲——GWAS 之前必查的一张图:隐藏的亲缘和群体结构是膨胀因子的头号来源,也是混 pests 群体育种配组的依据。
怎么读:12×12 矩阵,颜色越蓝亲缘越高,对角线恒为 1。看三样:对角线外的深色块(本例三个 4×4 家系块,块内 s1-s4 亲缘 0.5 左右=全同胞水平);块间接近 0 的区域(无关系);以及「不该热却热」的格子——那是 pedigree 记录错误的线索。GWAS 用这份矩阵做随机效应(混合模型),PCA 用它的特征向量。
用什么画:GCTA 的 --make-grm 加 R 语言 heatmap;重绘直接 imshow。
图注示例:
图 84 12 个样本的基因组关系矩阵(模拟)。颜色为标准化亲缘系数,对角线为 1;三个 4 样本家系块清晰可辨(块内均值约 0.49),家系间近无亲缘。
展开查看:矩阵数据与绘图代码
id,s1,s2,s3,s4,s5,s6,s7,s8,s9,s10,s11,s12
s1,1.000,0.531,0.502,0.560,0.033,0.007,0.013,0.015,0.003,0.003,0.035,0.003
s2,0.531,1.000,0.548,0.553,-0.005,0.027,-0.016,0.025,0.029,0.007,0.044,0.039
s3,0.502,0.548,1.000,0.565,0.024,0.030,0.023,0.054,0.029,0.037,0.008,0.031
s4,0.560,0.553,0.565,1.000,0.025,-0.005,0.022,0.008,0.003,0.023,-0.019,0.038
s5,0.033,-0.005,0.024,0.025,1.000,0.432,0.425,0.423,-0.003,0.033,0.010,0.051
s6,0.007,0.027,0.030,-0.005,0.432,1.000,0.454,0.458,0.005,0.025,0.035,0.032
s7,0.013,-0.016,0.023,0.022,0.425,0.454,1.000,0.435,-0.023,0.062,0.030,0.044
s8,0.015,0.025,0.054,0.008,0.423,0.458,0.435,1.000,-0.011,0.015,0.024,0.025
s9,0.003,0.029,0.029,0.003,-0.003,0.005,-0.023,-0.011,1.000,0.440,0.439,0.474
s10,0.003,0.007,0.037,0.023,0.033,0.025,0.062,0.015,0.440,1.000,0.440,0.441
s11,0.035,0.044,0.008,-0.019,0.010,0.035,0.030,0.024,0.439,0.440,1.000,0.464
s12,0.003,0.039,0.031,0.038,0.051,0.032,0.044,0.025,0.474,0.441,0.464,1.000绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

K = pd.read_csv("84-grm.csv", index_col="id")
fig, ax = plt.subplots(figsize=(7.0, 5.8))
im = ax.imshow(K.values, cmap="Blues", vmin=0, vmax=1)
for b, c in zip([0, 4, 8], ["Fam A", "Fam B", "Fam C"]):
    ax.add_patch(plt.Rectangle((b - 0.5, b - 0.5), 4, 4, fill=False,
                               edgecolor="#C44E52", ls="--", lw=1.4))
    ax.text(b + 1.5, -0.75, c, ha="center", fontsize=9.5, color="#C44E52")
ax.set_xticks(range(12), K.columns, fontsize=8, rotation=45)
ax.set_yticks(range(12), K.index, fontsize=8)
ax.grid(False)
fig.colorbar(im, ax=ax, shrink=0.82, label="kinship")
ax.set_title("Genomic relationship matrix, 3 families (simulated)")
fig.savefig("84-grm.png", dpi=200, bbox_inches="tight")3.6 选择信号三联图(π + Fst + XP-CLR)#
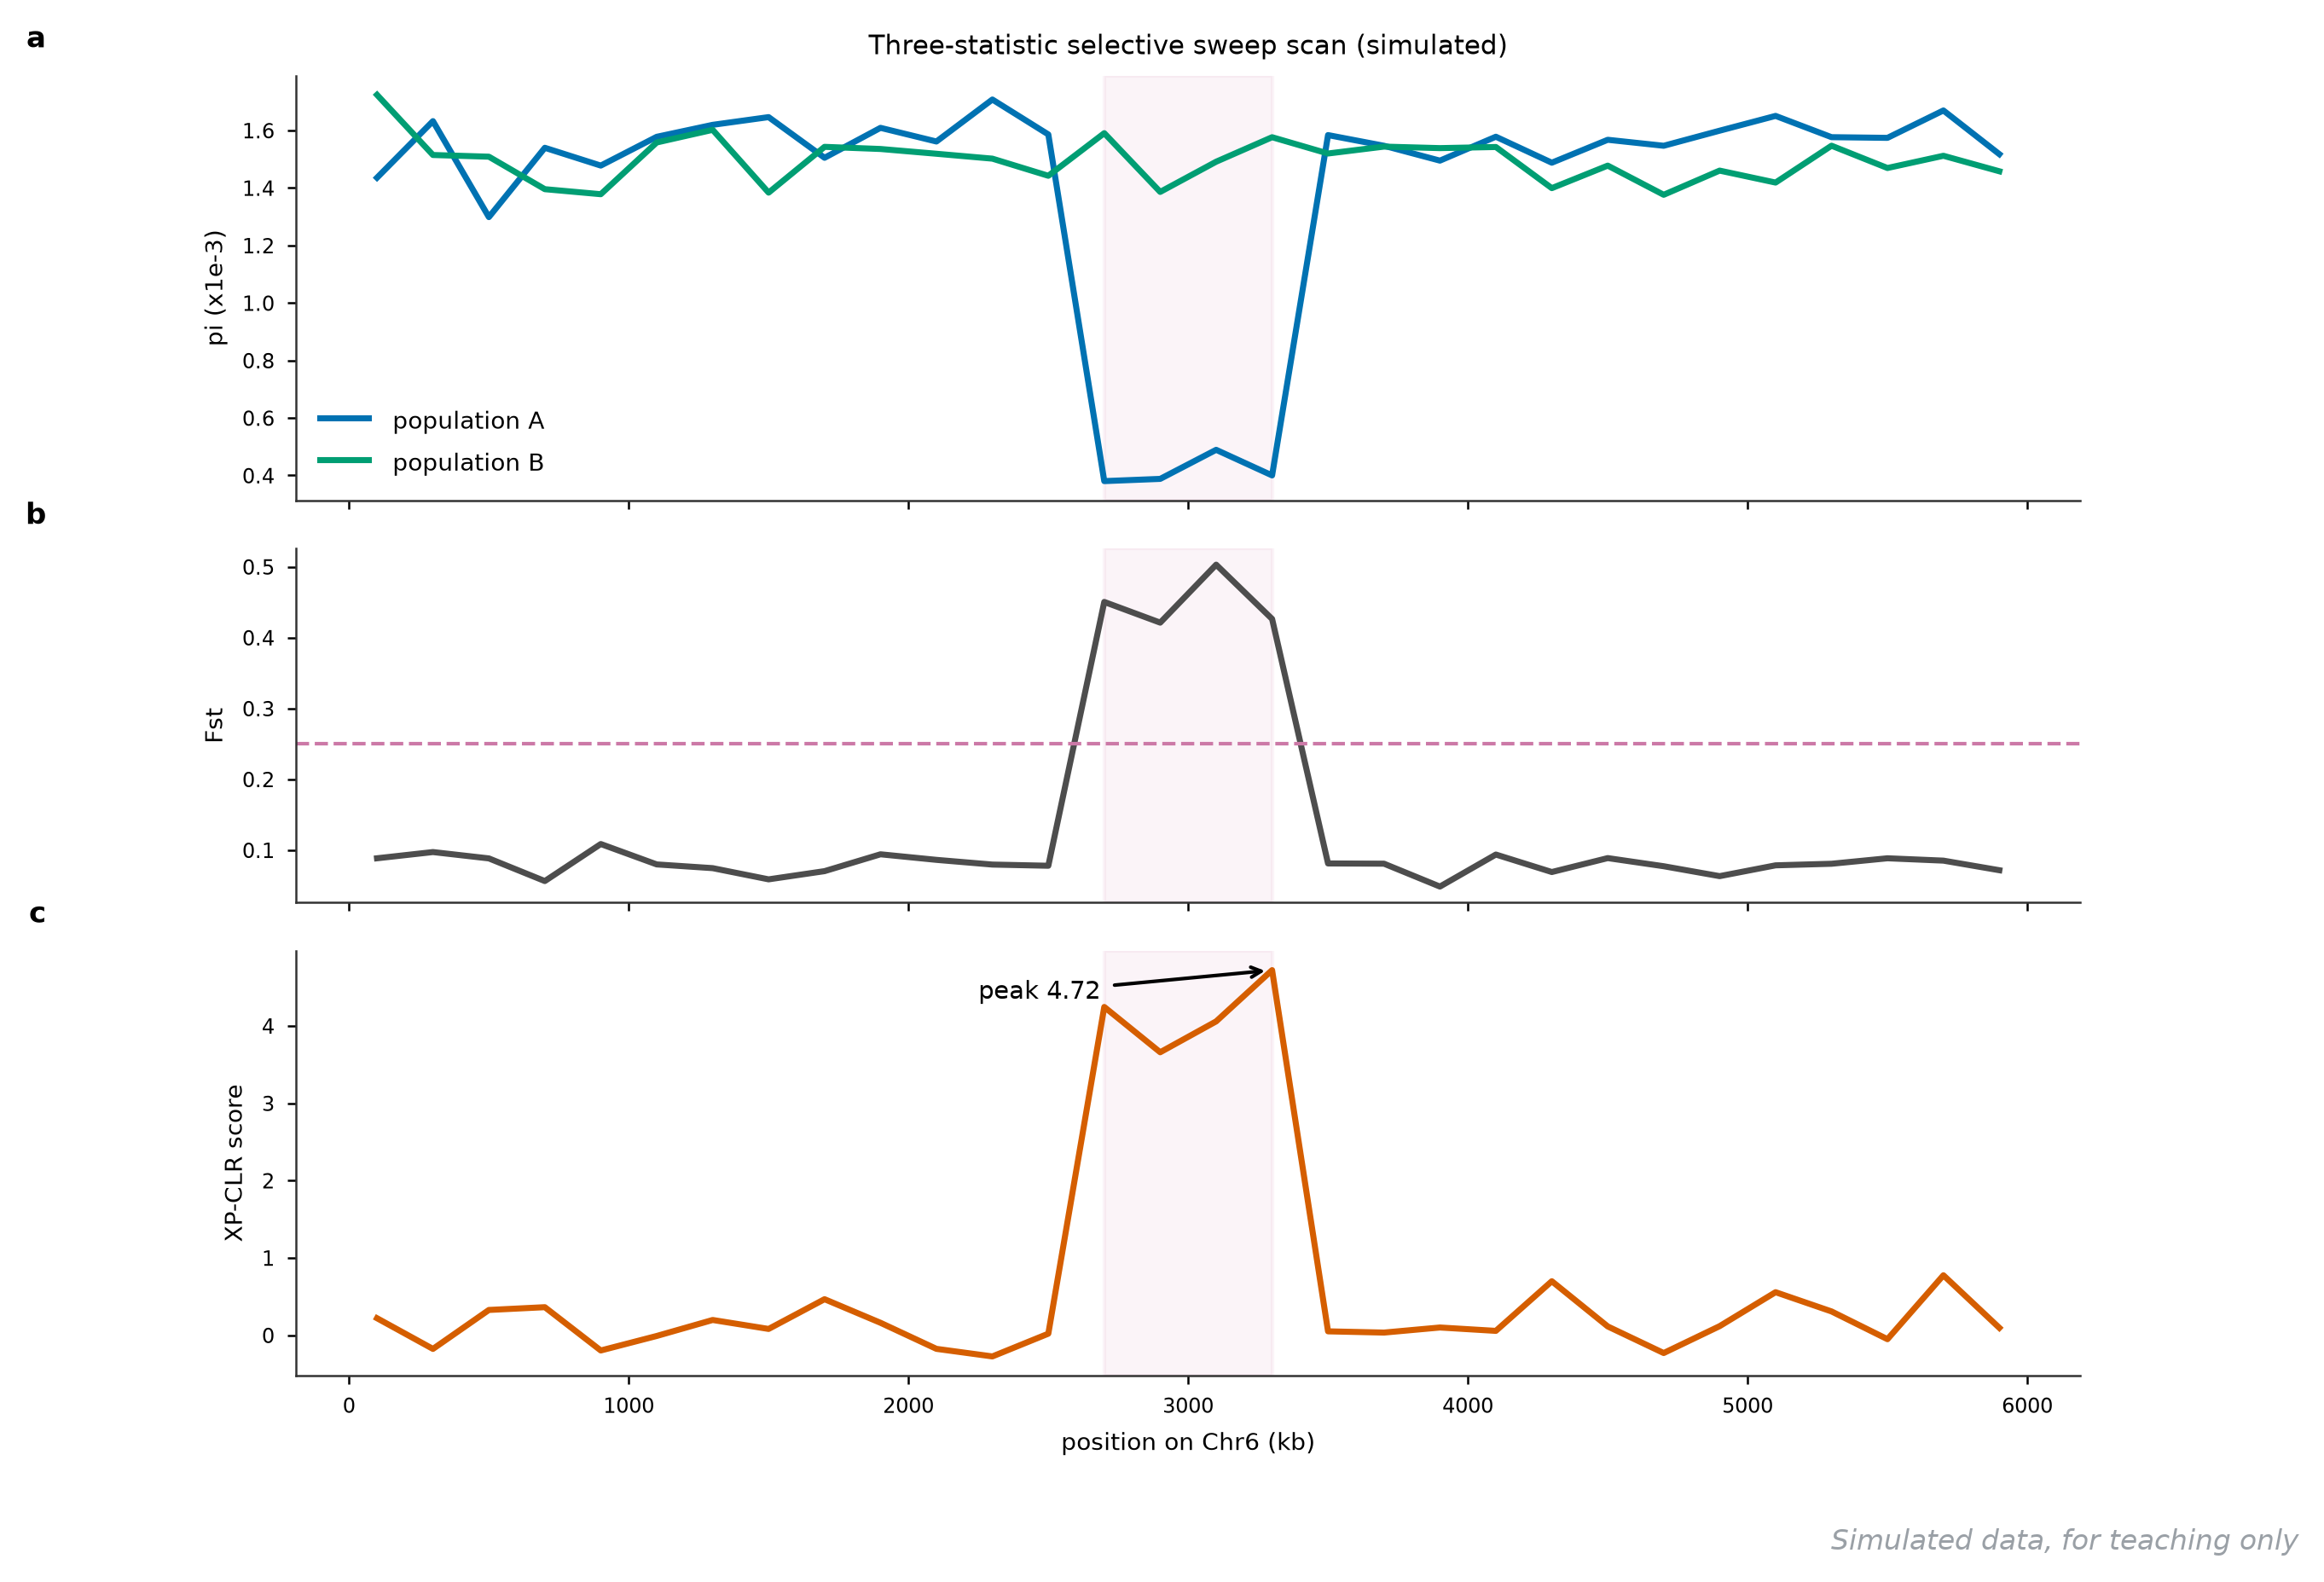
它回答什么问题:基因组哪一段正在被选择——第二篇的 π/Fst 双轨升级版,把聚类分析(XP-CLR)也排上来,三证齐全再点名候选区间。
怎么读:三条轨道共享 x 轴(Chr6 窗口位置)。第一轨 π:群体 A 在 2700-3300 kb 从 0.0016 跌到 0.0004(多样性塌方);第二轨 Fst:同区间从 0.08 跳到 0.45(群体间分化);第三轨 XP-CLR:同区间出现 4.72 的峰(单倍型簇的似然证据)。三个统计机理不同、偏倚也不同,同时异常的区间才是硬候选——只有 Fst 高的窗口可能只是低重组区的假信号。
用什么画:VCFtools(π、Fst)加 SweepFinder/XP-CLR;重绘三个子图共享 x 轴。
图注示例:
图 85 群体 A(矮秆)与 B 在 Chr6 的 200 kb 滑窗三统计扫描(模拟)。候选区间 2700-3300 kb 内 π 由 0.0016 降至 0.0004、Fst 升至 0.50、XP-CLR 峰值 4.72,三种证据一致。
展开查看:滑窗数据与绘图代码
window_kb,pi_A,pi_B,fst,xp_clr
100,0.00144,0.00172,0.088,0.22
300,0.00163,0.00151,0.097,-0.18
500,0.00130,0.00151,0.088,0.33
700,0.00154,0.00140,0.056,0.36
900,0.00148,0.00138,0.109,-0.20
1100,0.00158,0.00156,0.080,-0.01
1300,0.00162,0.00160,0.075,0.20
1500,0.00165,0.00138,0.059,0.08
1700,0.00150,0.00154,0.070,0.47
1900,0.00161,0.00154,0.094,0.16
2100,0.00156,0.00152,0.086,-0.18
2300,0.00171,0.00150,0.080,-0.27
2500,0.00159,0.00144,0.078,0.02
2700,0.00038,0.00159,0.450,4.24
2900,0.00039,0.00139,0.421,3.66
3100,0.00049,0.00149,0.503,4.06
3300,0.00040,0.00158,0.426,4.72
3500,0.00158,0.00152,0.081,0.05
3700,0.00155,0.00154,0.081,0.03
3900,0.00149,0.00154,0.048,0.10
4100,0.00158,0.00154,0.094,0.06
4300,0.00149,0.00140,0.069,0.70
4500,0.00157,0.00148,0.089,0.11
4700,0.00155,0.00138,0.077,-0.23
4900,0.00160,0.00146,0.063,0.12
5100,0.00165,0.00142,0.078,0.56
5300,0.00158,0.00155,0.081,0.31
5500,0.00157,0.00147,0.088,-0.05
5700,0.00167,0.00151,0.085,0.78
5900,0.00152,0.00146,0.072,0.10绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("85-sweep-trio.csv")
fig, axes = plt.subplots(3, 1, figsize=(9.0, 6.6), sharex=True,
                         gridspec_kw=dict(hspace=0.12,
                                          height_ratios=[1.2, 1, 1.2]))
for ax in axes:
    ax.axvspan(2700, 3300, color="#C44E52", alpha=0.08)
axes[0].plot(df.window_kb, df.pi_A * 1000, color="#4C72B0", lw=1.7,
             label="population A")
axes[0].plot(df.window_kb, df.pi_B * 1000, color="#55A868", lw=1.7,
             label="population B")
axes[0].set_ylabel("pi (x1e-3)")
axes[0].legend(loc="lower left", fontsize=8.5)
axes[1].plot(df.window_kb, df.fst, color="0.3", lw=1.7)
axes[1].axhline(0.25, color="#C44E52", ls="--", lw=1)
axes[1].set_ylabel("Fst")
axes[2].plot(df.window_kb, df.xp_clr, color="#DD8452", lw=1.7)
axes[2].set_ylabel("XP-CLR score")
axes[2].set_xlabel("position on Chr6 (kb)")
imax = df.xp_clr.idxmax()
axes[2].annotate("peak %.2f" % df.xp_clr.max(), (df.window_kb[imax],
                 df.xp_clr.max()), (df.window_kb[imax] - 1050, 4.35),
                 fontsize=9, arrowprops=dict(arrowstyle="->", lw=1))
axes[0].set_title("Three-statistic selective sweep scan (simulated)")
fig.savefig("85-sweep-trio.png", dpi=200, bbox_inches="tight")3.7 群体结构双联图(PCA + ADMIXTURE)#
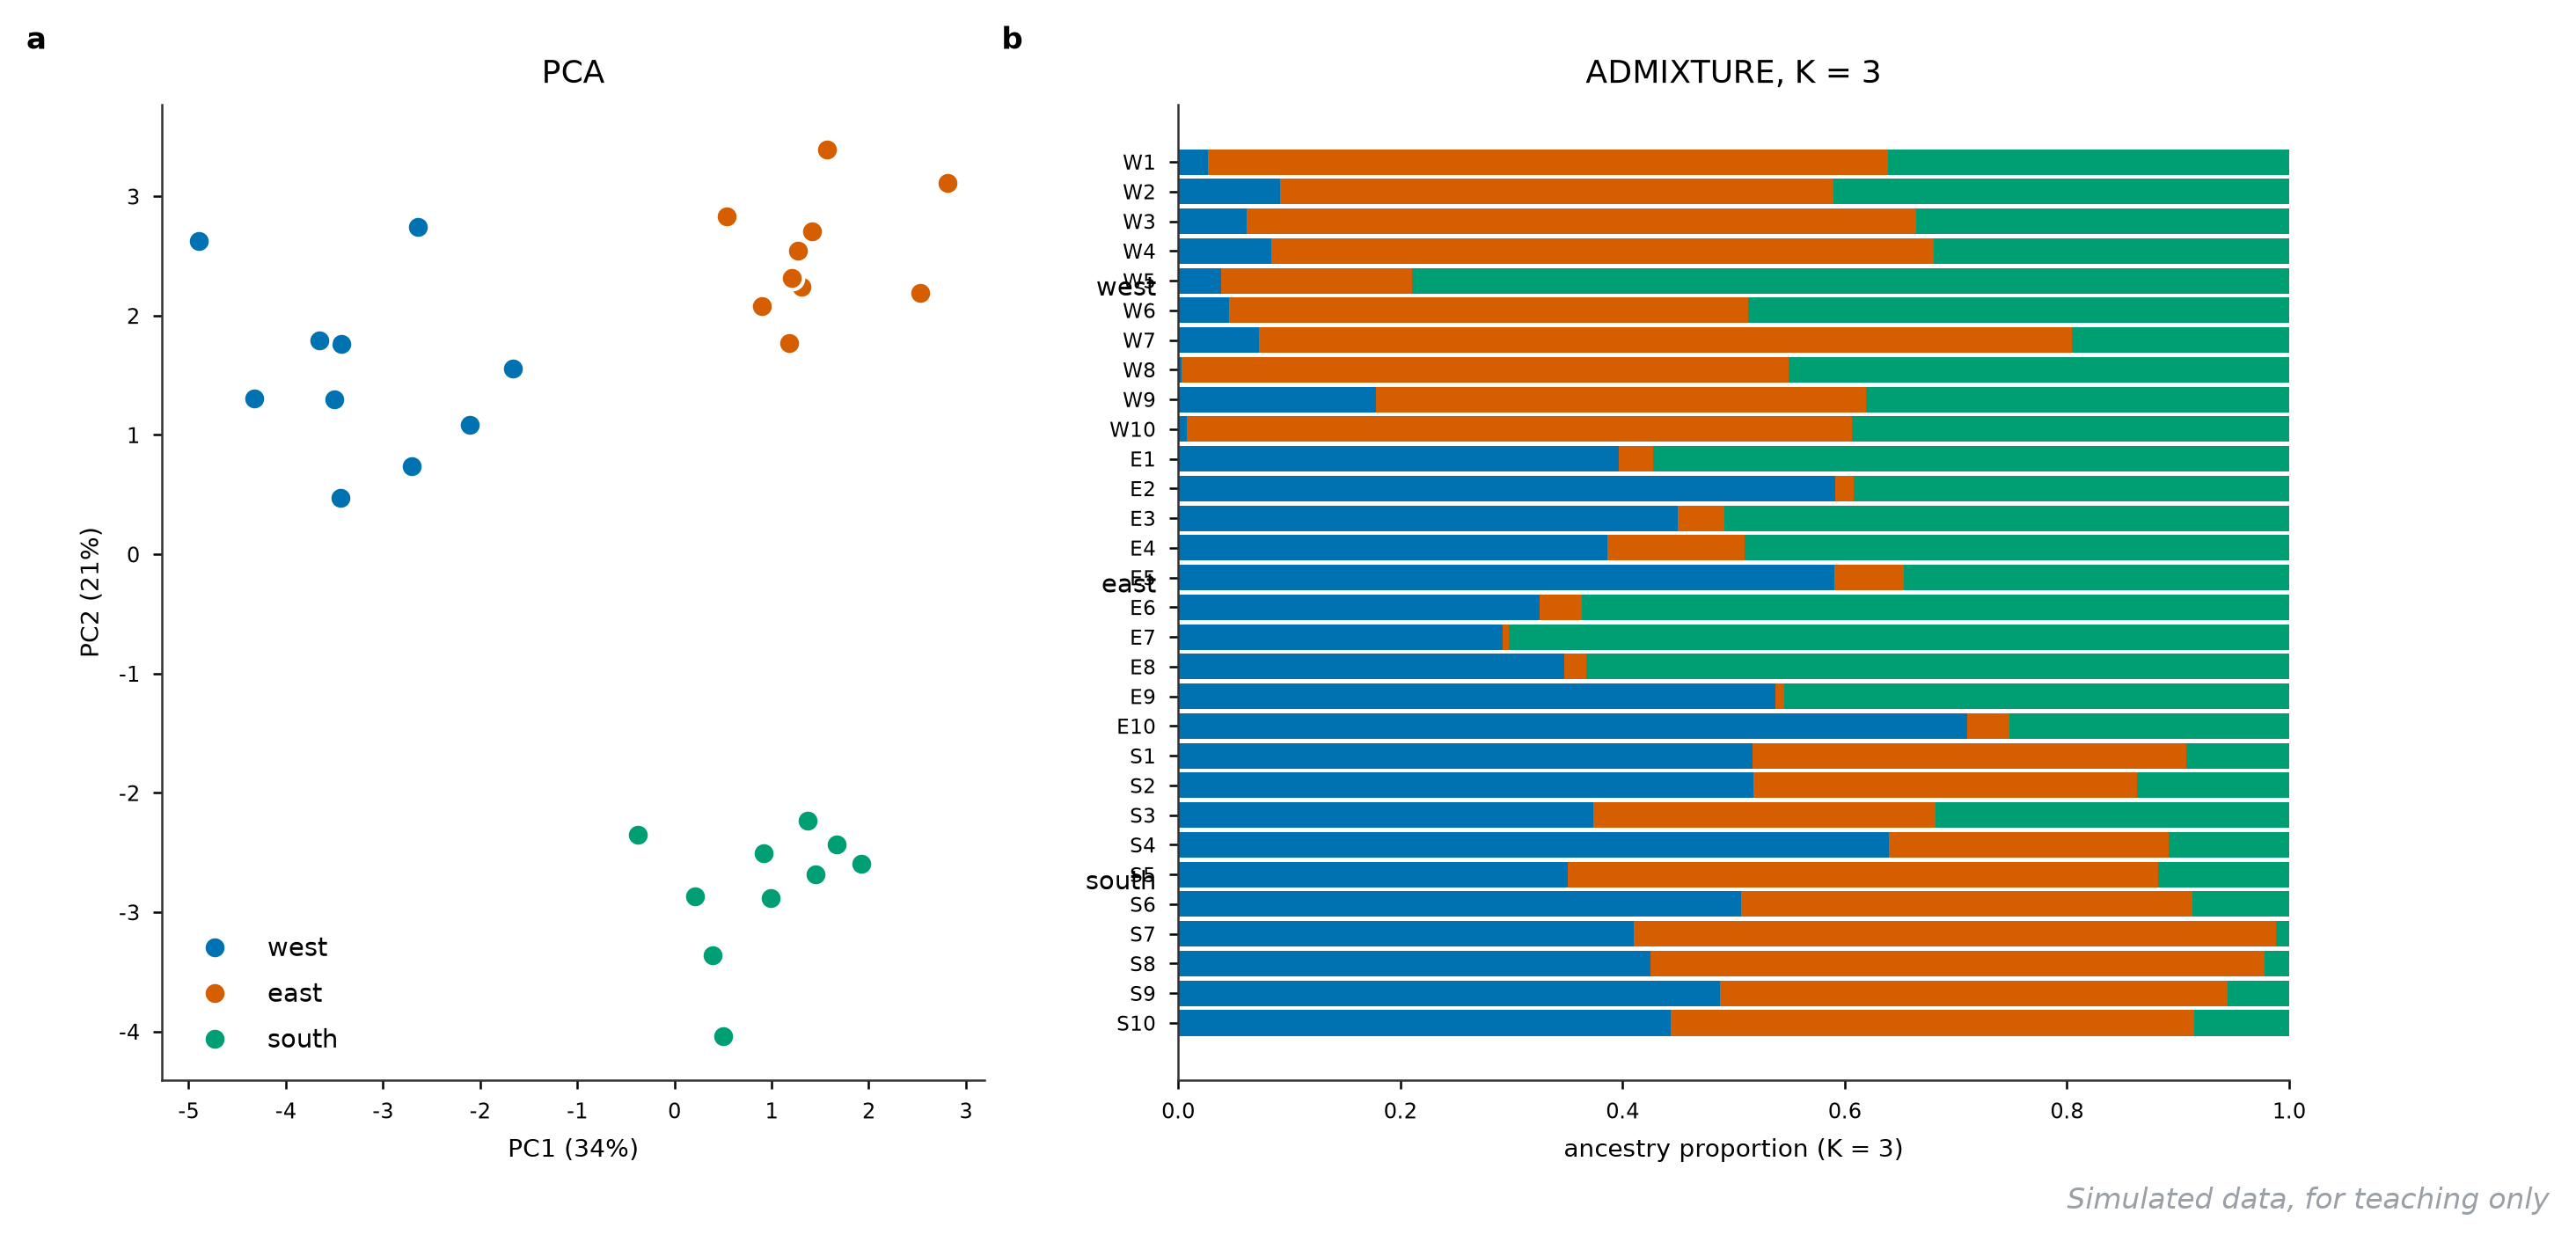
它回答什么问题:这批材料分几群、有没有混血个体——第二篇单图版的合体:PCA 管连续结构,ADMIXTURE 管祖先成分,一张图互相印证。
怎么读:左 PCA:三群各 10 个个体在 PC1/PC2 上各成一岛,个体离群的(W5 偏向中心)要留意。右 ADMIXTURE(K=3):每行一个体的祖先成分堆叠,按群体排序后 west 行以橙绿为主、east 以蓝绿为主、south 以蓝橙为主;行内混色的个体(如 W5 有 0.79 的 K3)是基因渗入候选。两个图讲一个故事才可信:PCA 上的离群个体在 ADMIXTURE 里也该混色。
用什么画:EIGENSOFT(PCA)加 ADMIXTURE(Q 矩阵),R 语言 pophelper 排版;重绘双子图。
图注示例:
图 86 30 个个体的群体结构(模拟)。左:PC1/PC2 散点三群分离;右:K=3 的祖先成分堆叠,west、east、south 各有主导成分,W5 个体含 79% 的 K3 成分提示渗入。
展开查看:数据与绘图代码
ind,pop,pc1,pc2,q1,q2,q3
W1,west,-2.64,2.74,0.027,0.612,0.361
W2,west,-1.66,1.56,0.092,0.498,0.410
W3,west,-2.71,0.74,0.062,0.603,0.336
W4,west,-3.44,0.48,0.084,0.596,0.320
W5,west,-4.33,1.31,0.039,0.171,0.790
W6,west,-3.42,1.76,0.046,0.467,0.487
W7,west,-4.89,2.62,0.073,0.731,0.196
W8,west,-3.50,1.30,0.003,0.547,0.450
W9,west,-3.65,1.79,0.178,0.440,0.381
W10,west,-2.11,1.08,0.008,0.599,0.393
E1,east,1.57,3.40,0.397,0.031,0.573
E2,east,1.18,1.77,0.592,0.017,0.392
E3,east,0.90,2.08,0.450,0.042,0.508
E4,east,1.27,2.54,0.387,0.123,0.490
E5,east,2.81,3.12,0.591,0.062,0.347
E6,east,1.42,2.71,0.325,0.038,0.637
E7,east,0.54,2.83,0.292,0.006,0.703
E8,east,2.53,2.19,0.347,0.020,0.633
E9,east,1.31,2.24,0.537,0.008,0.455
E10,east,1.20,2.32,0.710,0.038,0.252
S1,south,1.37,-2.23,0.517,0.390,0.093
S2,south,1.67,-2.43,0.518,0.345,0.137
S3,south,0.21,-2.87,0.374,0.308,0.319
S4,south,1.45,-2.68,0.640,0.252,0.108
S5,south,0.50,-4.04,0.351,0.531,0.118
S6,south,0.39,-3.36,0.507,0.406,0.087
S7,south,-0.38,-2.35,0.410,0.579,0.012
S8,south,0.99,-2.88,0.425,0.553,0.022
S9,south,1.92,-2.59,0.488,0.457,0.055
S10,south,0.92,-2.51,0.443,0.471,0.086绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("86-structure.csv")
CAT = ["#4C72B0", "#DD8452", "#55A868"]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10.4, 4.8),
                               gridspec_kw=dict(width_ratios=[1, 1.35]))
pcol = dict(zip(["west", "east", "south"], CAT))
for p in pcol:
    sub = df[df["pop"] == p]
    ax1.scatter(sub.pc1, sub.pc2, s=38, color=pcol[p],
                edgecolors="white", label=p)
ax1.set_xlabel("PC1 (34%)")
ax1.set_ylabel("PC2 (21%)")
ax1.legend(fontsize=9)
left = pd.Series(0.0, index=df.index)
for k in range(3):
    ax2.barh(df.index, df["q%d" % (k + 1)], left=left, color=CAT[k],
             height=0.86)
    left = left + df["q%d" % (k + 1)]
ax2.set_yticks(df.index, df["ind"], fontsize=6.5)
ax2.invert_yaxis()
ax2.set_xlabel("ancestry proportion (K = 3)")
for y, p in [(4.5, "west"), (14.5, "east"), (24.5, "south")]:
    ax2.text(-0.02, y, p, transform=ax2.get_yaxis_transform(), ha="right",
             fontsize=9)
ax2.set_xlim(0, 1)
ax1.set_title("PCA", fontsize=11)
ax2.set_title("ADMIXTURE, K = 3", fontsize=11)
fig.savefig("86-structure.png", dpi=200, bbox_inches="tight")四、GWAS 精细定位#
4.1 LocusZoom 风格区域关联图#
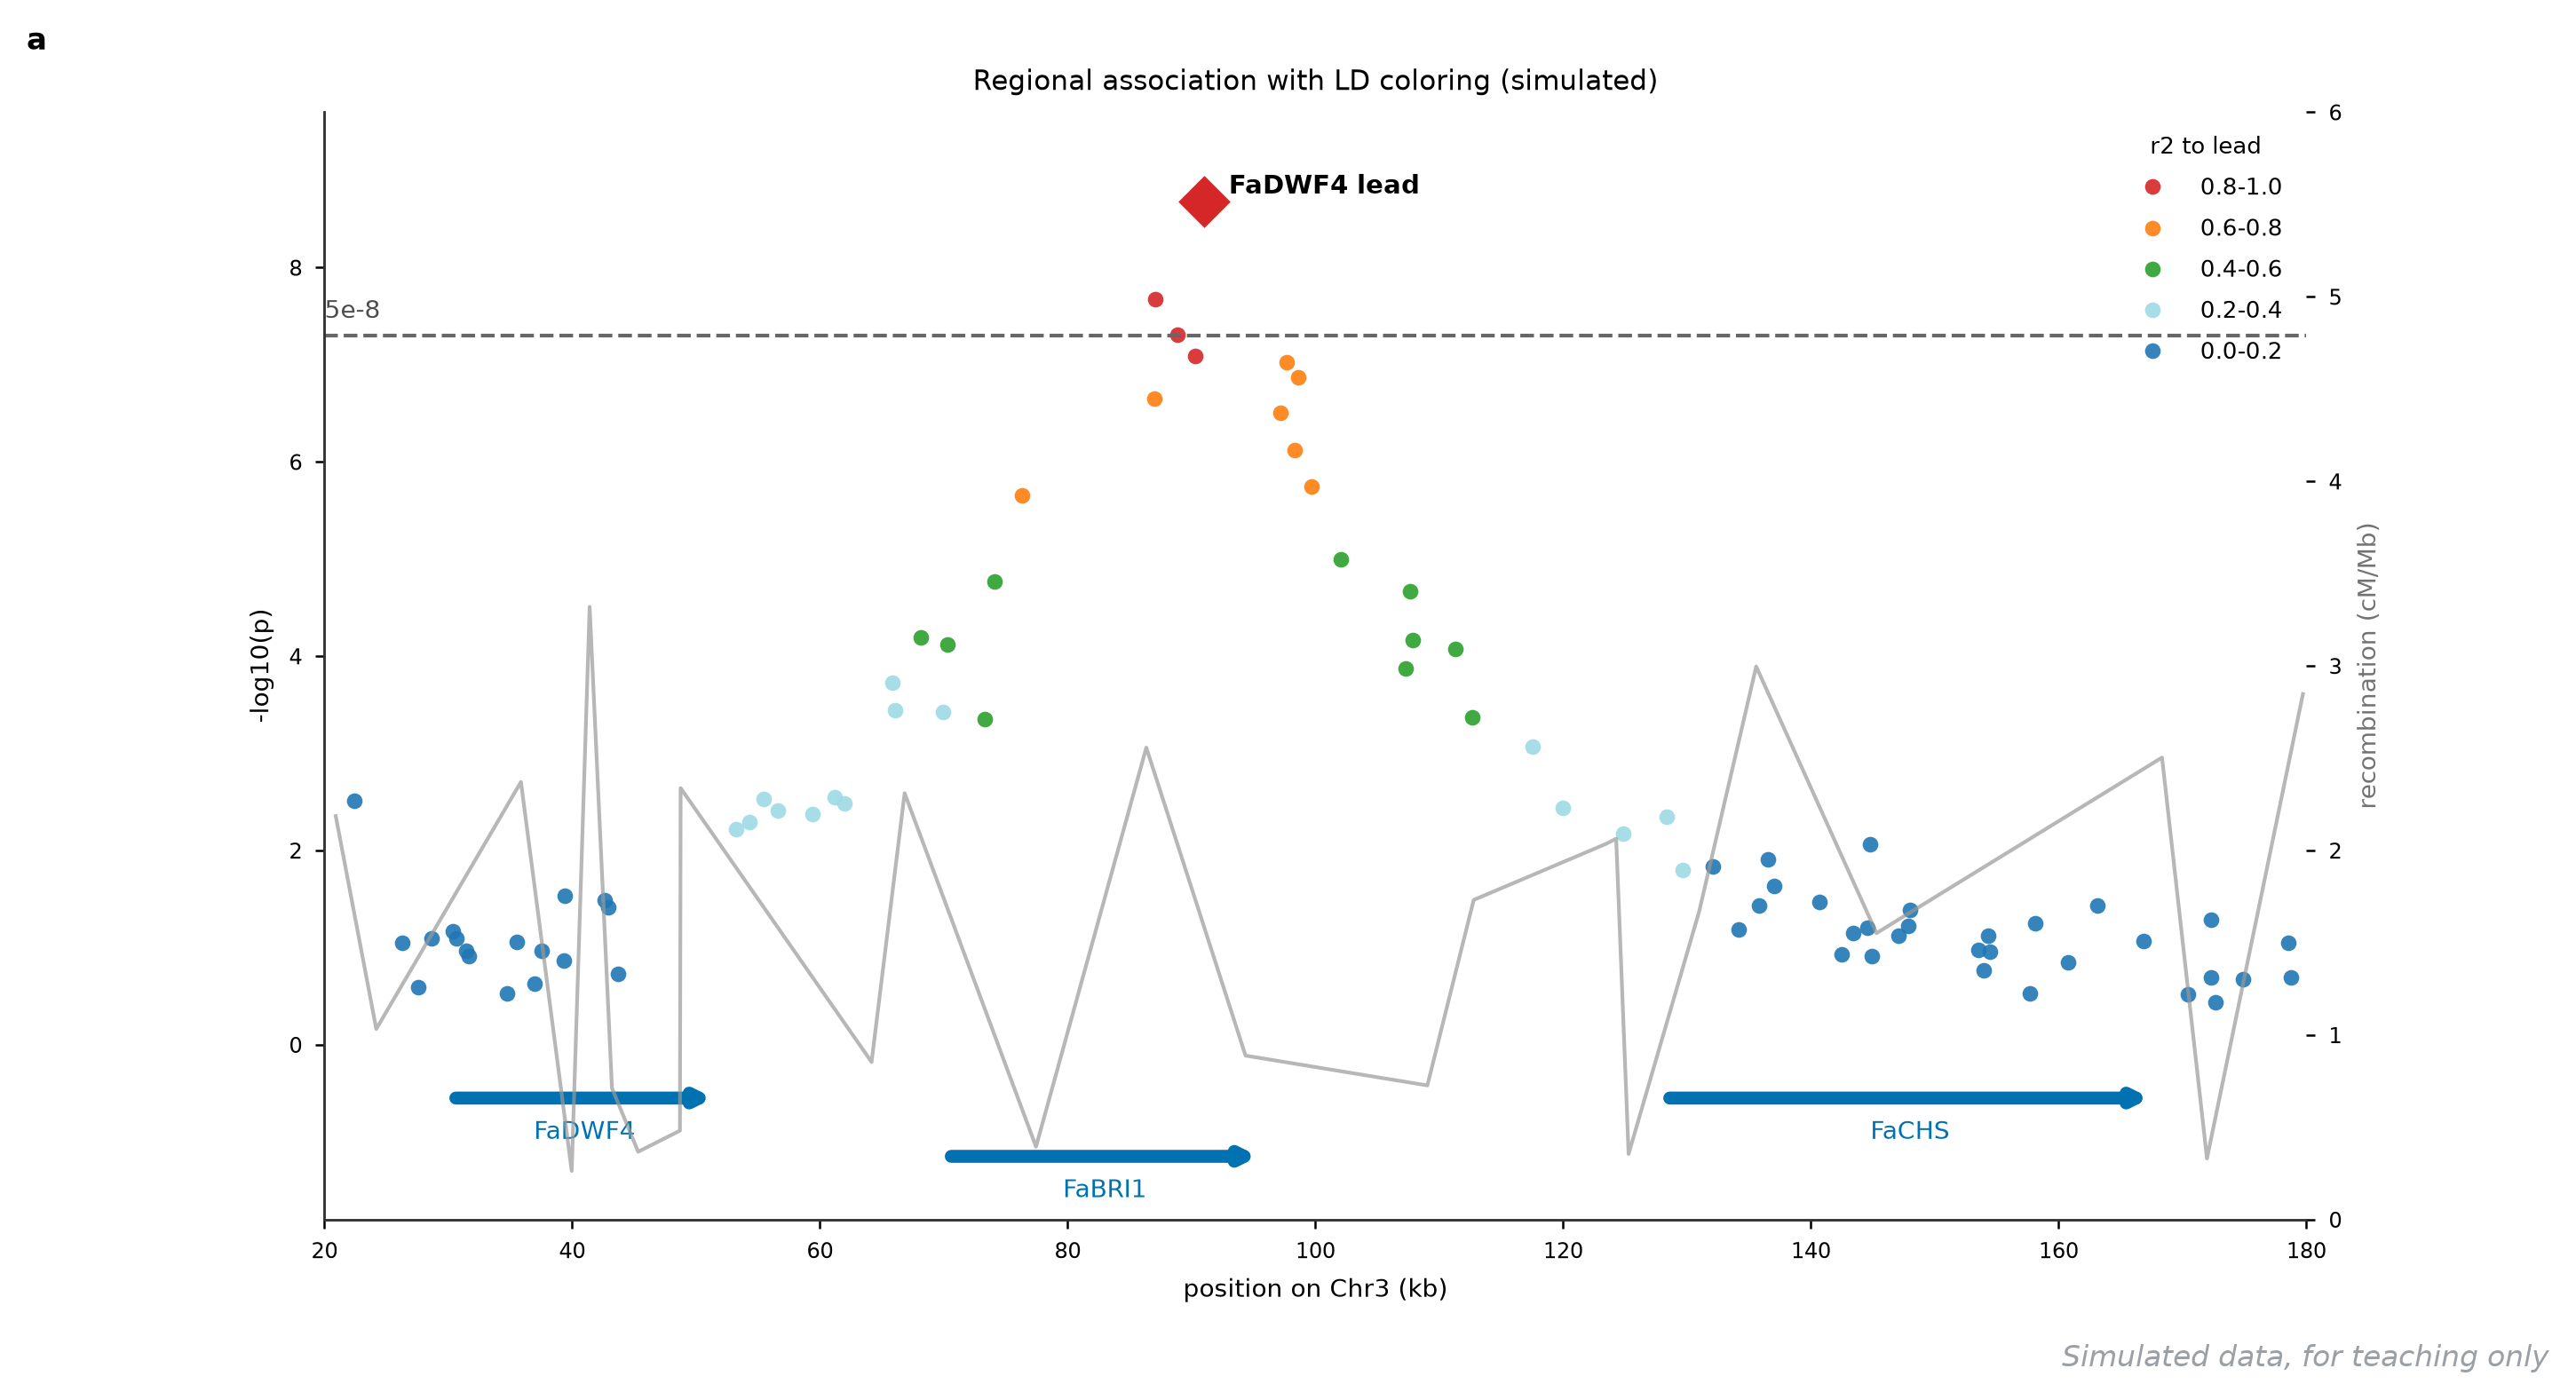
它回答什么问题:曼哈顿图上那个显著峰周围发生了什么——区域级放大:哪些 SNP 因为和因果位点连锁而「沾光」,重组率怎么变化,峰落在哪个基因上。GWAS 论文里每报一个显著位点,标配一张这个图。
怎么读:每个点一个 SNP,横轴是区域位置(Chr3 20-180 kb),纵轴 -log10(p)。颜色是灵魂:按与 lead SNP(红菱形,91 kb)的 LD 系数 r2 从红(r2>0.8)到蓝(r2<0.2)渐变——如果信号只有一个因果变异,越靠近它的点应该越红、p 值越高;本例的红色点群贴着菱形、随距离衰减成蓝,教科书式的单信号峰。灰色细线是重组率(右轴),低重组区的「高原」要警惕是复杂信号。底部箭头是区域基因,lead 落在 FaDWF4 区间内。
用什么画:LocusZoom(在线版填 region 就出图);本地用 locuszoomr 或 gwaslab;重绘按坐标上色。
图注示例:
图 87 Chr3 91 kb 关联信号的区域放大图(模拟,93 个 SNP)。点色按与 lead 变异的 r2 分箱,红色菱形为 lead(p = 2.1e-9);灰色曲线为重组率(右轴)。信号呈单一峰形,lead 位于 FaDWF4 基因区间。
展开查看:区域 SNP 数据与绘图代码
pos_kb,pvalue,r2_to_lead
22.4,3.09e-03,0.07
26.3,9.01e-02,0.07
27.6,2.56e-01,0.09
28.7,8.02e-02,0.08
30.4,6.78e-02,0.09
30.7,8.14e-02,0.08
31.4,1.07e-01,0.08
31.7,1.22e-01,0.08
34.7,2.95e-01,0.11
35.5,8.70e-02,0.13
36.9,2.36e-01,0.11
37.5,1.08e-01,0.11
39.3,1.35e-01,0.12
39.4,2.95e-02,0.15
42.7,3.27e-02,0.16
42.9,3.89e-02,0.17
43.7,1.88e-01,0.16
53.2,6.07e-03,0.24
54.3,5.13e-03,0.26
55.5,2.98e-03,0.24
56.6,3.92e-03,0.28
59.4,4.26e-03,0.31
61.2,2.85e-03,0.28
62.0,3.27e-03,0.30
65.9,1.89e-04,0.40
66.0,3.61e-04,0.36
68.2,6.43e-05,0.43
70.0,3.75e-04,0.38
70.3,7.68e-05,0.48
73.3,4.42e-04,0.45
74.1,1.72e-05,0.51
76.3,2.21e-06,0.60
87.0,2.25e-07,0.76
87.0,2.13e-08,0.89
88.9,4.95e-08,0.81
90.3,8.14e-08,0.83
90.5,2.72e-09,0.99
90.7,1.73e-09,1.00
90.9,2.95e-09,1.00
91.0,2.10e-09,1.00
91.5,1.79e-09,1.00
97.2,3.12e-07,0.74
97.7,9.52e-08,0.75
98.3,7.50e-07,0.75
98.6,1.36e-07,0.78
99.7,1.80e-06,0.64
102.0,1.01e-05,0.59
107.3,1.34e-04,0.44
107.6,2.17e-05,0.53
107.8,6.77e-05,0.47
111.3,8.47e-05,0.46
112.7,4.26e-04,0.43
117.6,8.50e-04,0.37
120.0,3.64e-03,0.29
124.8,6.76e-03,0.25
128.4,4.50e-03,0.21
129.6,1.59e-02,0.21
132.1,1.45e-02,0.20
134.2,6.59e-02,0.19
135.8,3.68e-02,0.15
136.6,1.25e-02,0.17
137.0,2.34e-02,0.18
140.7,3.41e-02,0.14
142.5,1.19e-01,0.12
143.4,7.16e-02,0.14
144.6,6.28e-02,0.11
144.8,8.63e-03,0.13
144.9,1.23e-01,0.12
147.1,7.64e-02,0.10
147.9,5.96e-02,0.11
148.0,4.15e-02,0.11
153.5,1.06e-01,0.10
153.9,1.74e-01,0.08
154.3,7.54e-02,0.07
154.4,1.10e-01,0.07
157.6,3.00e-01,0.07
158.1,5.69e-02,0.07
160.8,1.41e-01,0.07
163.1,3.73e-02,0.05
166.8,8.63e-02,0.05
170.4,3.01e-01,0.04
172.3,2.04e-01,0.05
172.3,5.17e-02,0.04
172.6,3.63e-01,0.04
174.9,2.13e-01,0.04
178.5,9.02e-02,0.03
178.8,2.04e-01,0.03绘图代码(Python,独立可运行;重组线与基因箭头由代码补齐)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("87-locuszoom.csv")
rng = np.random.default_rng(2087)
bins = [(0.8, 1.01, "#D62728"), (0.6, 0.8, "#FF7F0E"), (0.4, 0.6, "#2CA02C"),
        (0.2, 0.4, "#9EDAE5"), (0.0, 0.2, "#1F77B4")]
fig, ax = plt.subplots(figsize=(9.6, 5.4))
for lo, hi, c in bins:
    sel = (df.r2_to_lead >= lo) & (df.r2_to_lead < hi)
    ax.scatter(df.pos_kb[sel], -np.log10(df.pvalue[sel]), s=18, color=c,
               alpha=0.9, label="%.1f-%.1f" % (lo, min(hi, 1.0)),
               linewidths=0)
lead = df.loc[df.pvalue.idxmin()]
ax.scatter([lead.pos_kb], [-np.log10(lead.pvalue)], s=120, marker="D",
           color="#D62728", edgecolors="white", zorder=5)
ax.text(lead.pos_kb + 2, -np.log10(lead.pvalue) + 0.15, "FaDWF4 lead",
        fontsize=9, fontweight="bold")
ax.axhline(-np.log10(5e-8), color="0.4", ls="--", lw=1)
ax.text(20, -np.log10(5e-8) + 0.18, "5e-8", fontsize=8.5, color="0.3")
ax2 = ax.twinx()
ax2.plot(np.sort(rng.uniform(20, 180, 25)), rng.uniform(0.2, 3.4, 25),
         color="0.6", lw=1, alpha=0.7)
ax2.set_ylabel("recombination (cM/Mb)", color="0.45")
ax2.set_ylim(0, 6)
for g0, g1, name, side in [(30, 52, "FaDWF4", 1), (70, 96, "FaBRI1", -1),
                           (128, 168, "FaCHS", 1)]:
    y = -1.15 if side < 0 else -0.55
    ax.annotate("", xy=(g1, y), xytext=(g0, y),
                arrowprops=dict(arrowstyle="->", color="#4C72B0", lw=3.5))
    ax.text((g0 + g1) / 2, y - 0.42, name, ha="center", fontsize=8.5,
            color="#4C72B0")
ax.set_xlim(20, 180)
ax.set_ylim(-1.8, 9.6)
ax.set_xlabel("position on Chr3 (kb)")
ax.set_ylabel("-log10(p)")
ax.set_title("Regional association with LD coloring (simulated)")
ax.legend(title="r2 to lead", loc="upper right", fontsize=8,
          title_fontsize=8)
fig.savefig("87-locuszoom.png", dpi=200, bbox_inches="tight")4.2 精细定位 PIP 图#
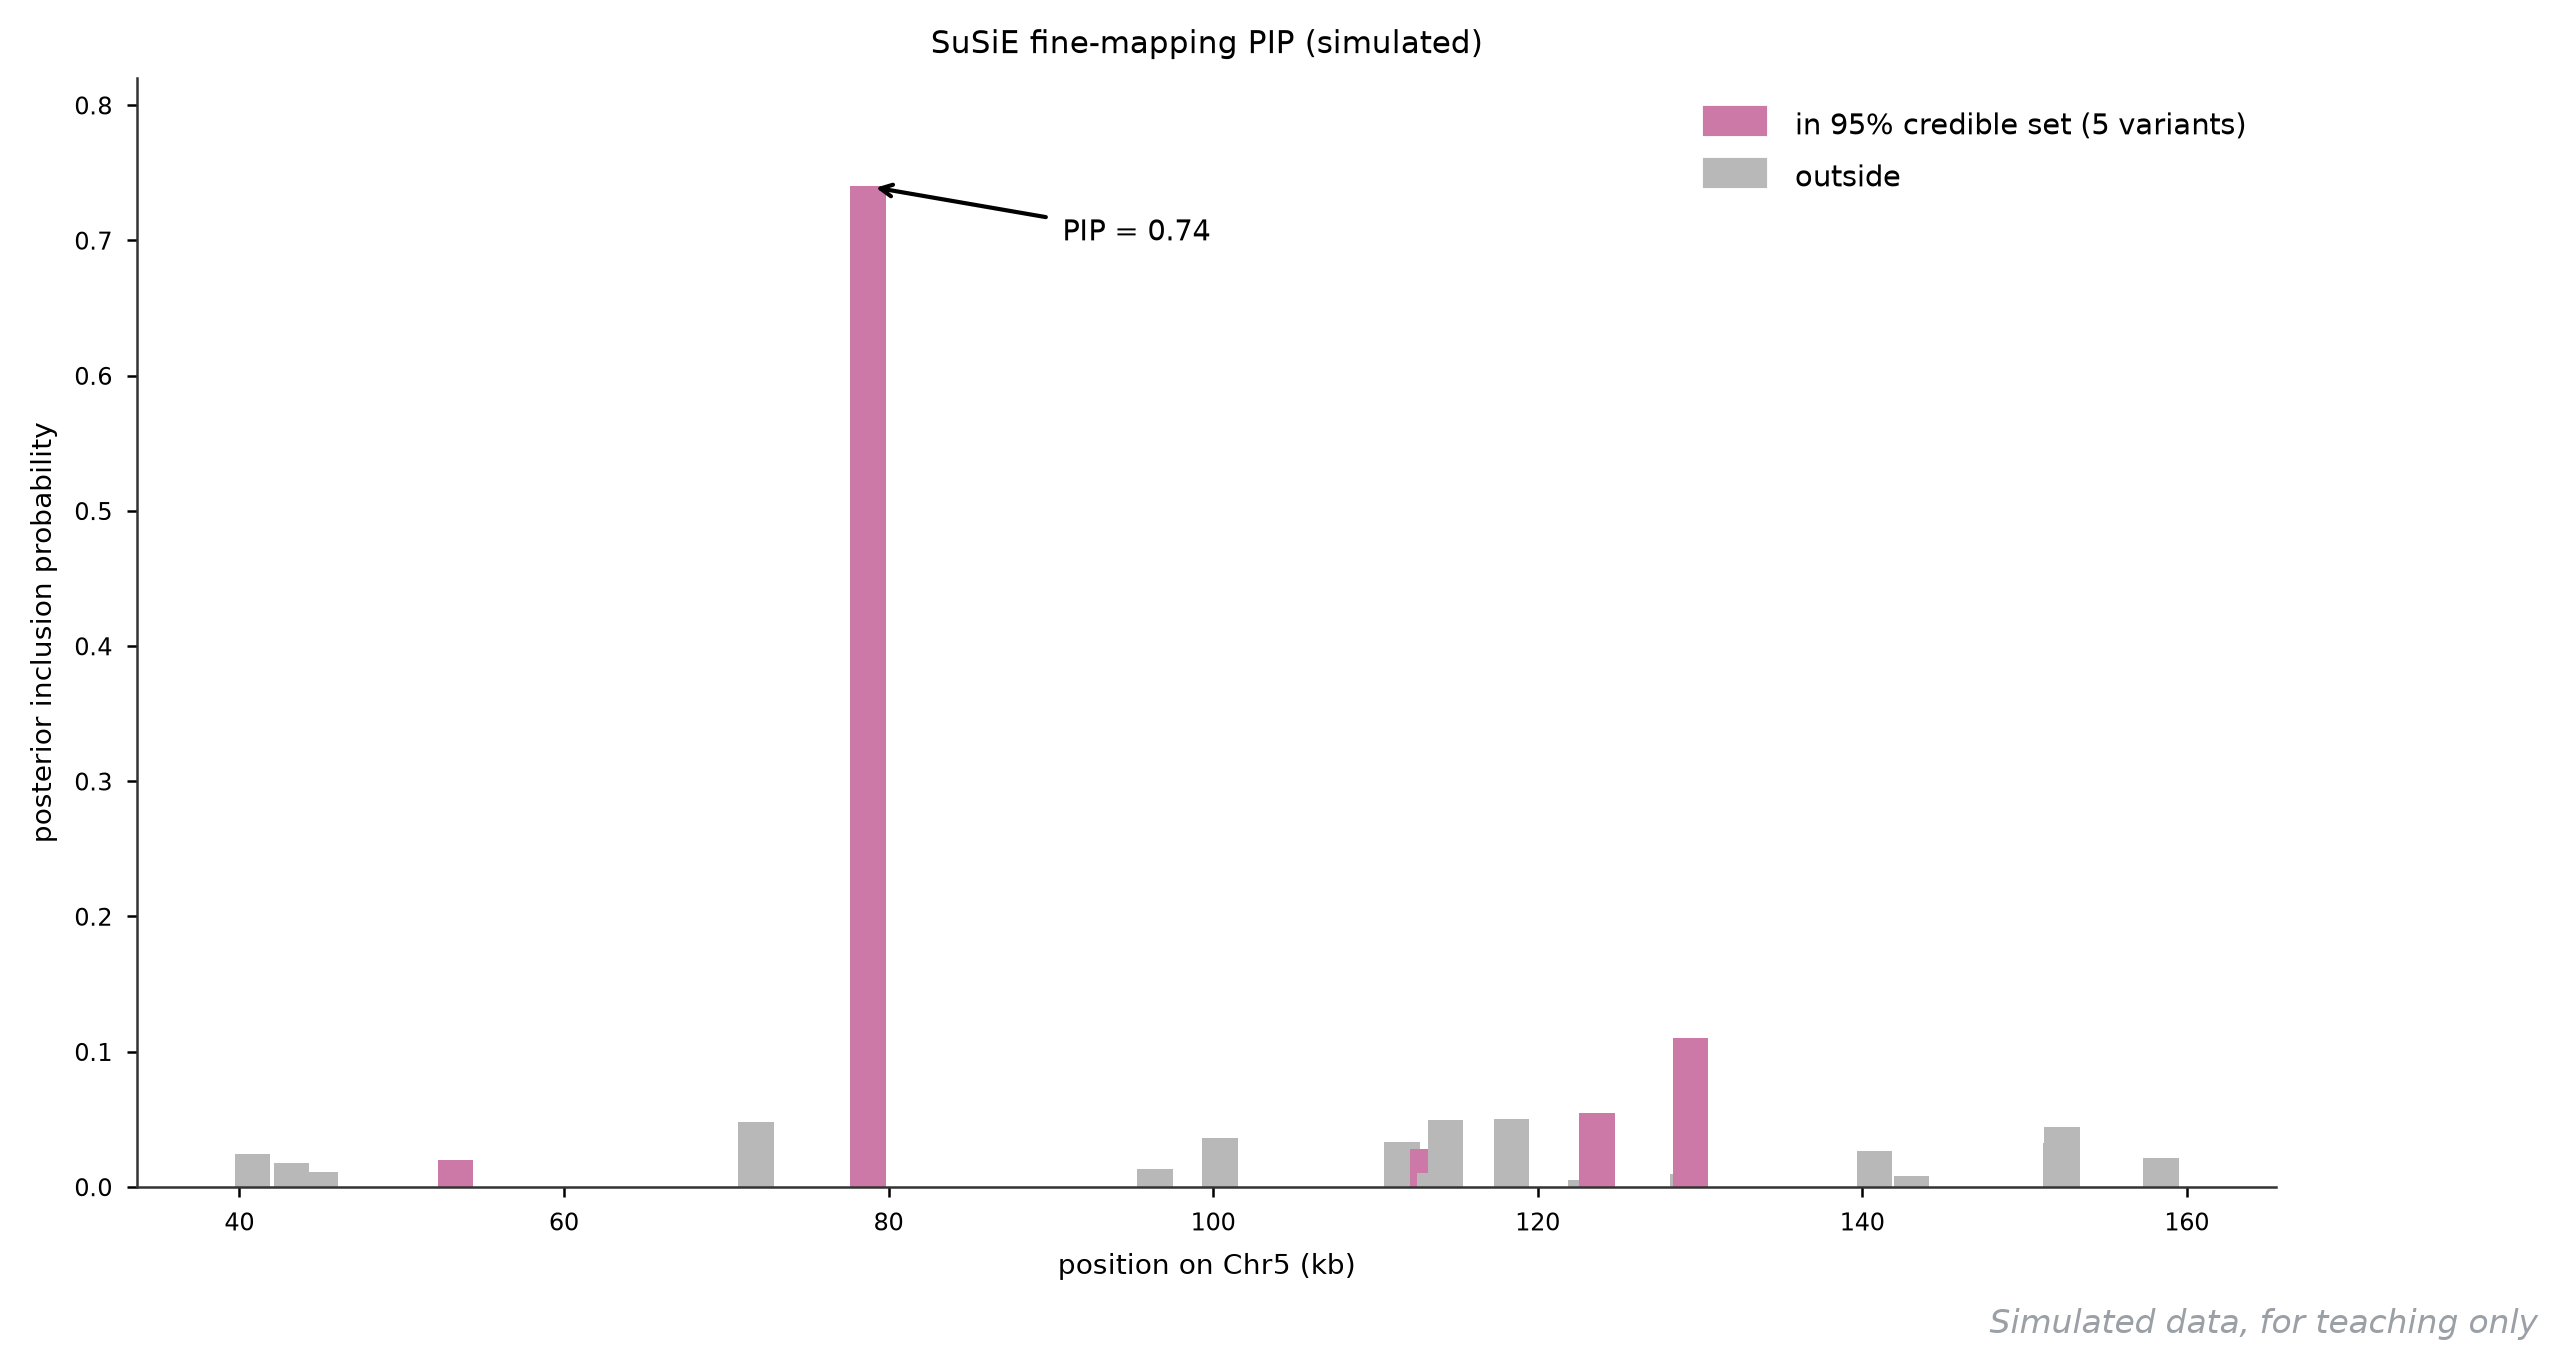
它回答什么问题:LD 一团红点里,到底哪个是因果变异——SuSiE 等精细定位方法给每个 SNP 打一个后期包含概率(PIP),95% 可信集把「绕圈子的借口」压缩到最少的几个候选。
怎么读:横轴仍是区域位置,每根柱一个 SNP 的 PIP。看两点:柱高的绝对值(rs6 的 PIP = 0.74,断层的领先)和红色柱的个数(95% 可信集共 5 个,PIP 合计 0.953)——可信集越小,后续验证越省力;如果可信集有 30 个变体,这张位点基本只能「先记着」。位置挨着的 rs10(PIP 0.028)与 rs11(0.010)之间的高度差,就是精细定位对 LD 的拆解能力。
用什么画:SuSiE / FINEMAP 输出 PIP,susieR 自带画法;重绘按位置画柱、可信集上色。
图注示例:
图 88 Chr5 关联信号的 SuSiE 精细定位(模拟,22 个候选变异)。柱高为 PIP,红色为 95% 可信集(5 个变异,PIP 合计 0.95);rs6 以 PIP 0.74 显著领先,为优先验证对象。
展开查看:PIP 数据与绘图代码
variant,pos_kb,pip,in_95set
rs1,40.8,0.024,false
rs2,43.2,0.018,false
rs3,45.0,0.011,false
rs4,53.3,0.020,true
rs5,71.8,0.048,false
rs6,78.7,0.740,true
rs7,96.4,0.013,false
rs8,100.4,0.036,false
rs9,111.7,0.034,false
rs10,113.3,0.028,true
rs11,113.7,0.010,false
rs12,114.3,0.050,false
rs13,118.4,0.050,false
rs14,122.9,0.005,false
rs15,123.6,0.055,true
rs16,129.3,0.009,false
rs17,129.4,0.110,true
rs18,140.8,0.027,false
rs19,143.0,0.008,false
rs20,152.2,0.032,false
rs21,152.3,0.044,false
rs22,158.4,0.021,false绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import Patch

df = pd.read_csv("88-pip.csv")
fig, ax = plt.subplots(figsize=(9.2, 4.8))
for _, r in df.iterrows():
    ax.bar([r.pos_kb], [r.pip], width=2.2,
           color="#C44E52" if r.in_95set == "true" else "0.72")
ax.annotate("PIP = 0.74", (78.7, 0.74), (90.7, 0.70), fontsize=9,
            arrowprops=dict(arrowstyle="->", lw=1))
ax.set_xlabel("position on Chr5 (kb)")
ax.set_ylabel("posterior inclusion probability")
ax.set_ylim(0, 0.82)
ax.legend(handles=[Patch(color="#C44E52",
                         label="in 95% credible set (5 variants)"),
                   Patch(color="0.72", label="outside")],
          loc="upper right", fontsize=9)
ax.set_title("SuSiE fine-mapping PIP (simulated)")
fig.savefig("88-pip.png", dpi=200, bbox_inches="tight")五、遗传图谱与育种#
5.1 QTL 定位 LOD 曲线#
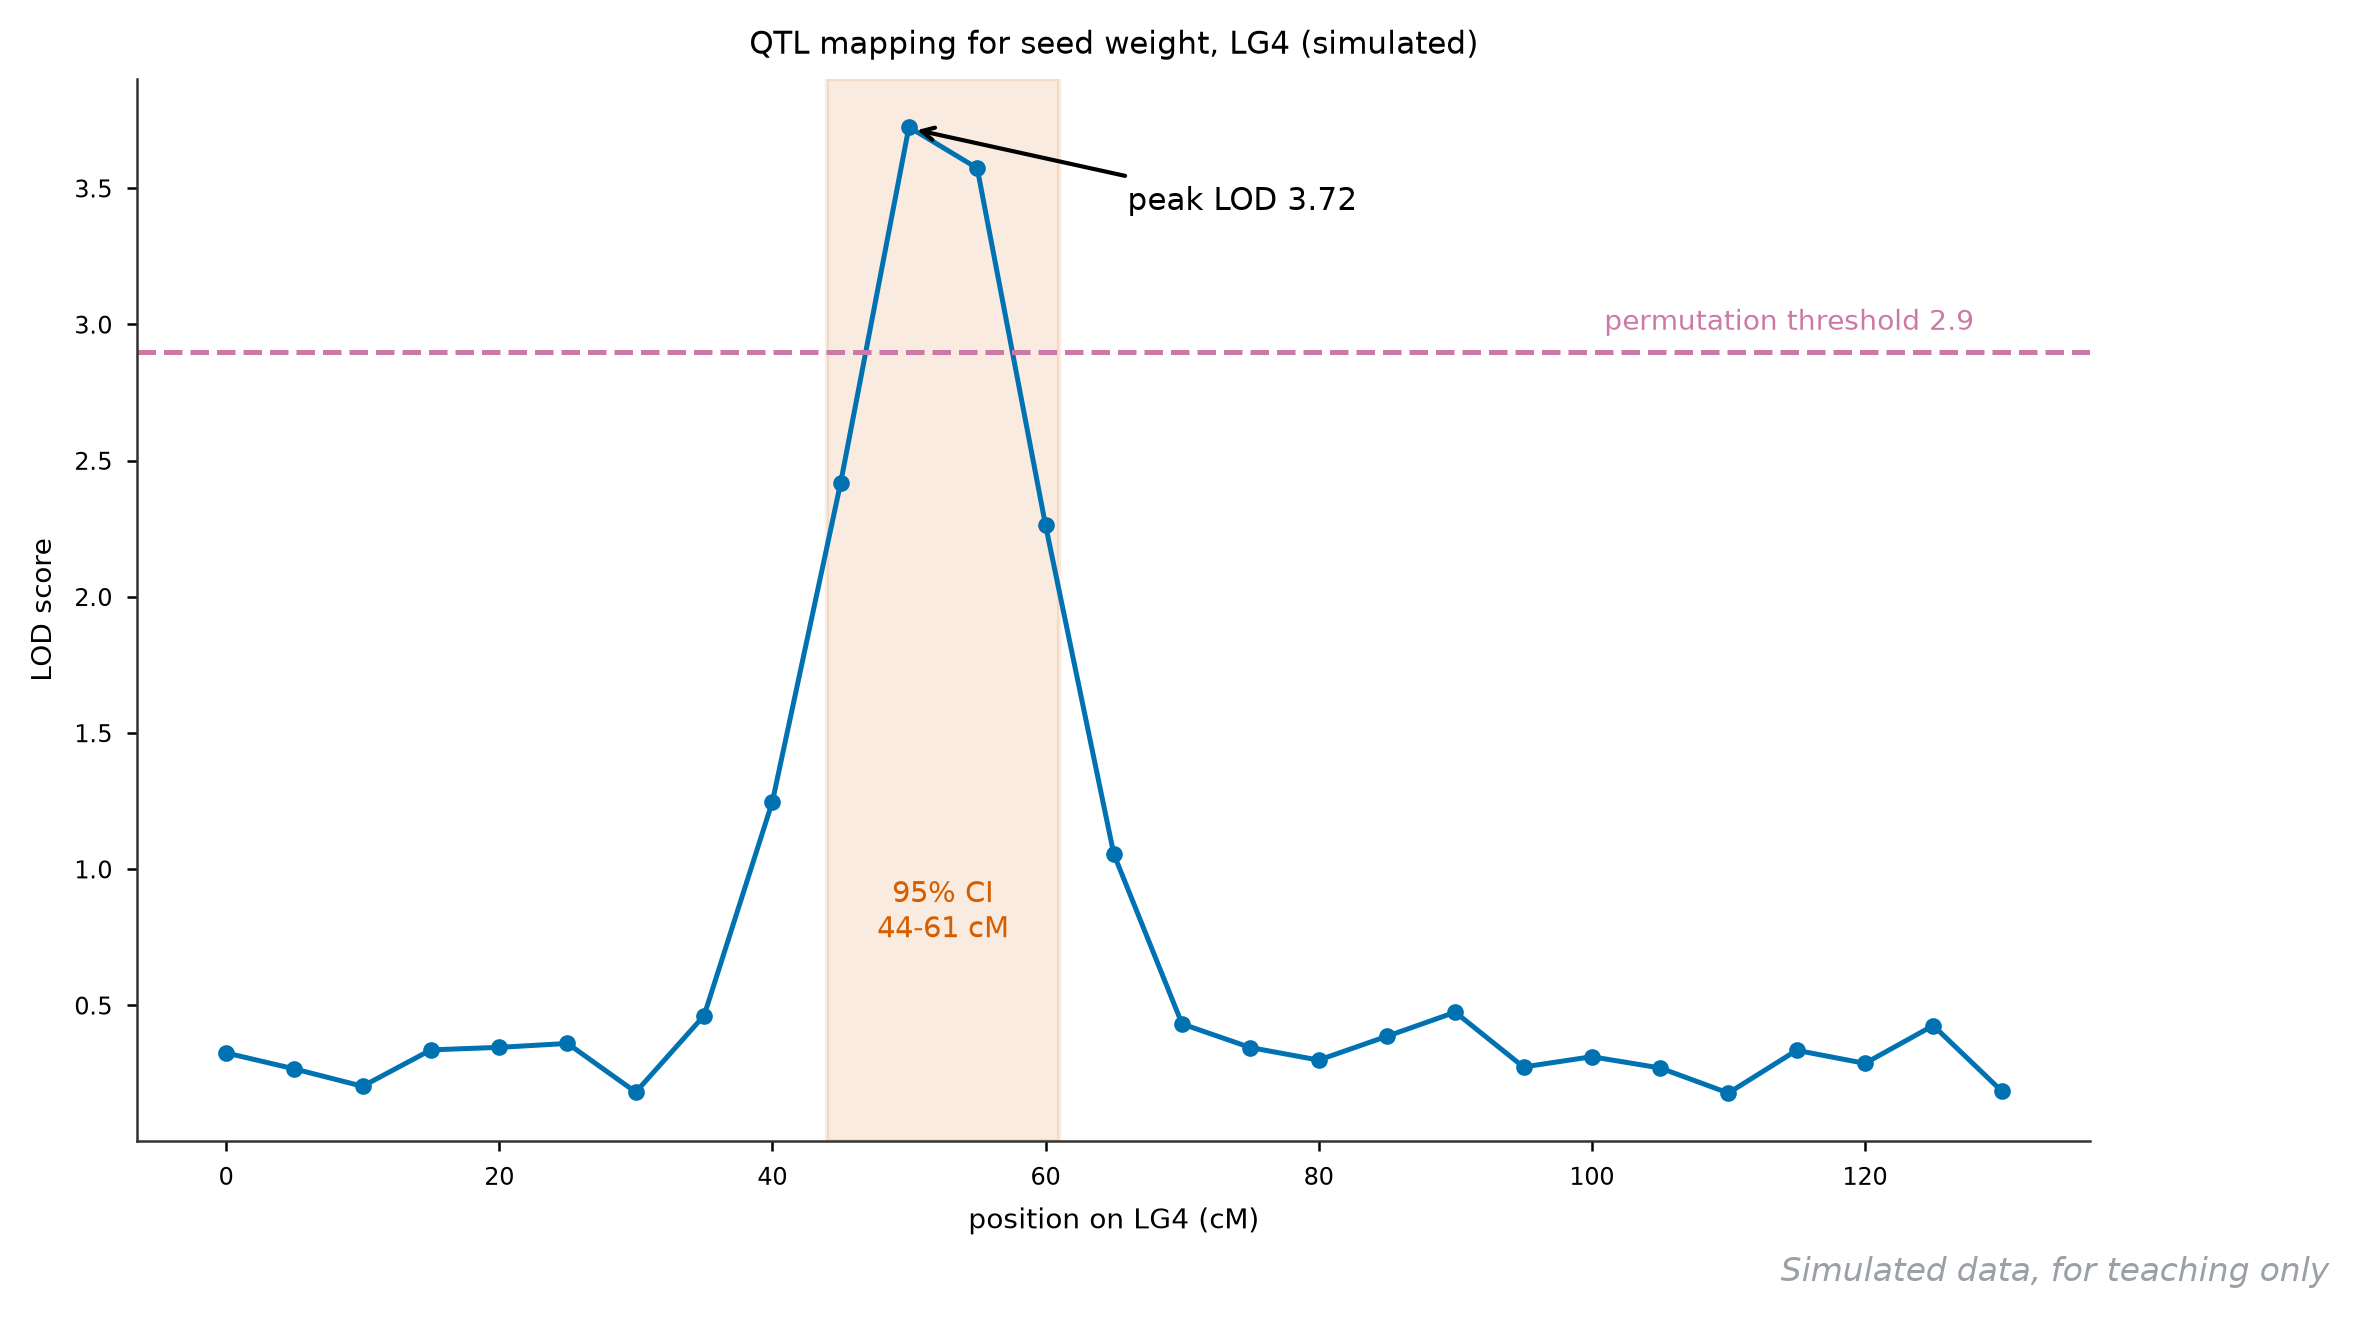
它回答什么问题:性状由哪条染色体哪个区段主导——连锁分析定位 QTL 的经典输出,在做转录组、做 GWAS 之前,育种家们用这张图找了几十年基因。
怎么读:横轴是遗传图位置(cM),纵轴 LOD(连锁与否的对数几率比)。曲线在 LG4 的 50 cM 处隆起到 LOD 3.72,越过置换检验阈值(虚线 2.9,经验上约等于基因组级 p 0.05)——这个区段与粒重显著连锁。阴影是 LOD-1.5 区间(44-61 cM,约 95% 置信区间),区间内所有标记和基因都是候选;区间越窄定位越准,取决于重组代数与样本量。
用什么画:R/qtl、QTL IciMapping;重绘按 cM-LOD 表画曲线加阈值线。
图注示例:
图 89 粒重 QTL 在 LG4 上的连锁分析(模拟)。曲线为 LOD 分数,虚线为 1000 次置换检验的显著性阈值 2.9;峰值 LOD 3.72 位于 50 cM,95% 置信区间 44-61 cM。
展开查看:LOD 数据与绘图代码
cM,lod
0,0.33
5,0.27
10,0.20
15,0.34
20,0.35
25,0.36
30,0.18
35,0.46
40,1.25
45,2.42
50,3.72
55,3.57
60,2.26
65,1.06
70,0.43
75,0.34
80,0.30
85,0.39
90,0.47
95,0.27
100,0.31
105,0.27
110,0.18
115,0.33
120,0.29
125,0.43
130,0.19绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("89-qtl-lod.csv")
fig, ax = plt.subplots(figsize=(8.4, 4.6))
ax.plot(df.cM, df.lod, "-o", ms=3.5, color="#4C72B0")
ax.axhline(2.9, color="#C44E52", ls="--", lw=1.2)
ax.text(128, 2.98, "permutation threshold 2.9", fontsize=8.5,
        color="#C44E52", ha="right")
ax.axvspan(44, 61, color="#DD8452", alpha=0.12)
ax.text(52.5, 0.75, "95% CI\n44-61 cM", ha="center", fontsize=9,
        color="#DD8452")
ax.annotate("peak LOD 3.72", (50, 3.72), (66, 3.42), fontsize=9.5,
            arrowprops=dict(arrowstyle="->", lw=1))
ax.set_xlabel("position on LG4 (cM)")
ax.set_ylabel("LOD score")
ax.set_title("QTL mapping for seed weight, LG4 (simulated)")
fig.savefig("89-qtl-lod.png", dpi=200, bbox_inches="tight")5.2 遗传连锁图谱#
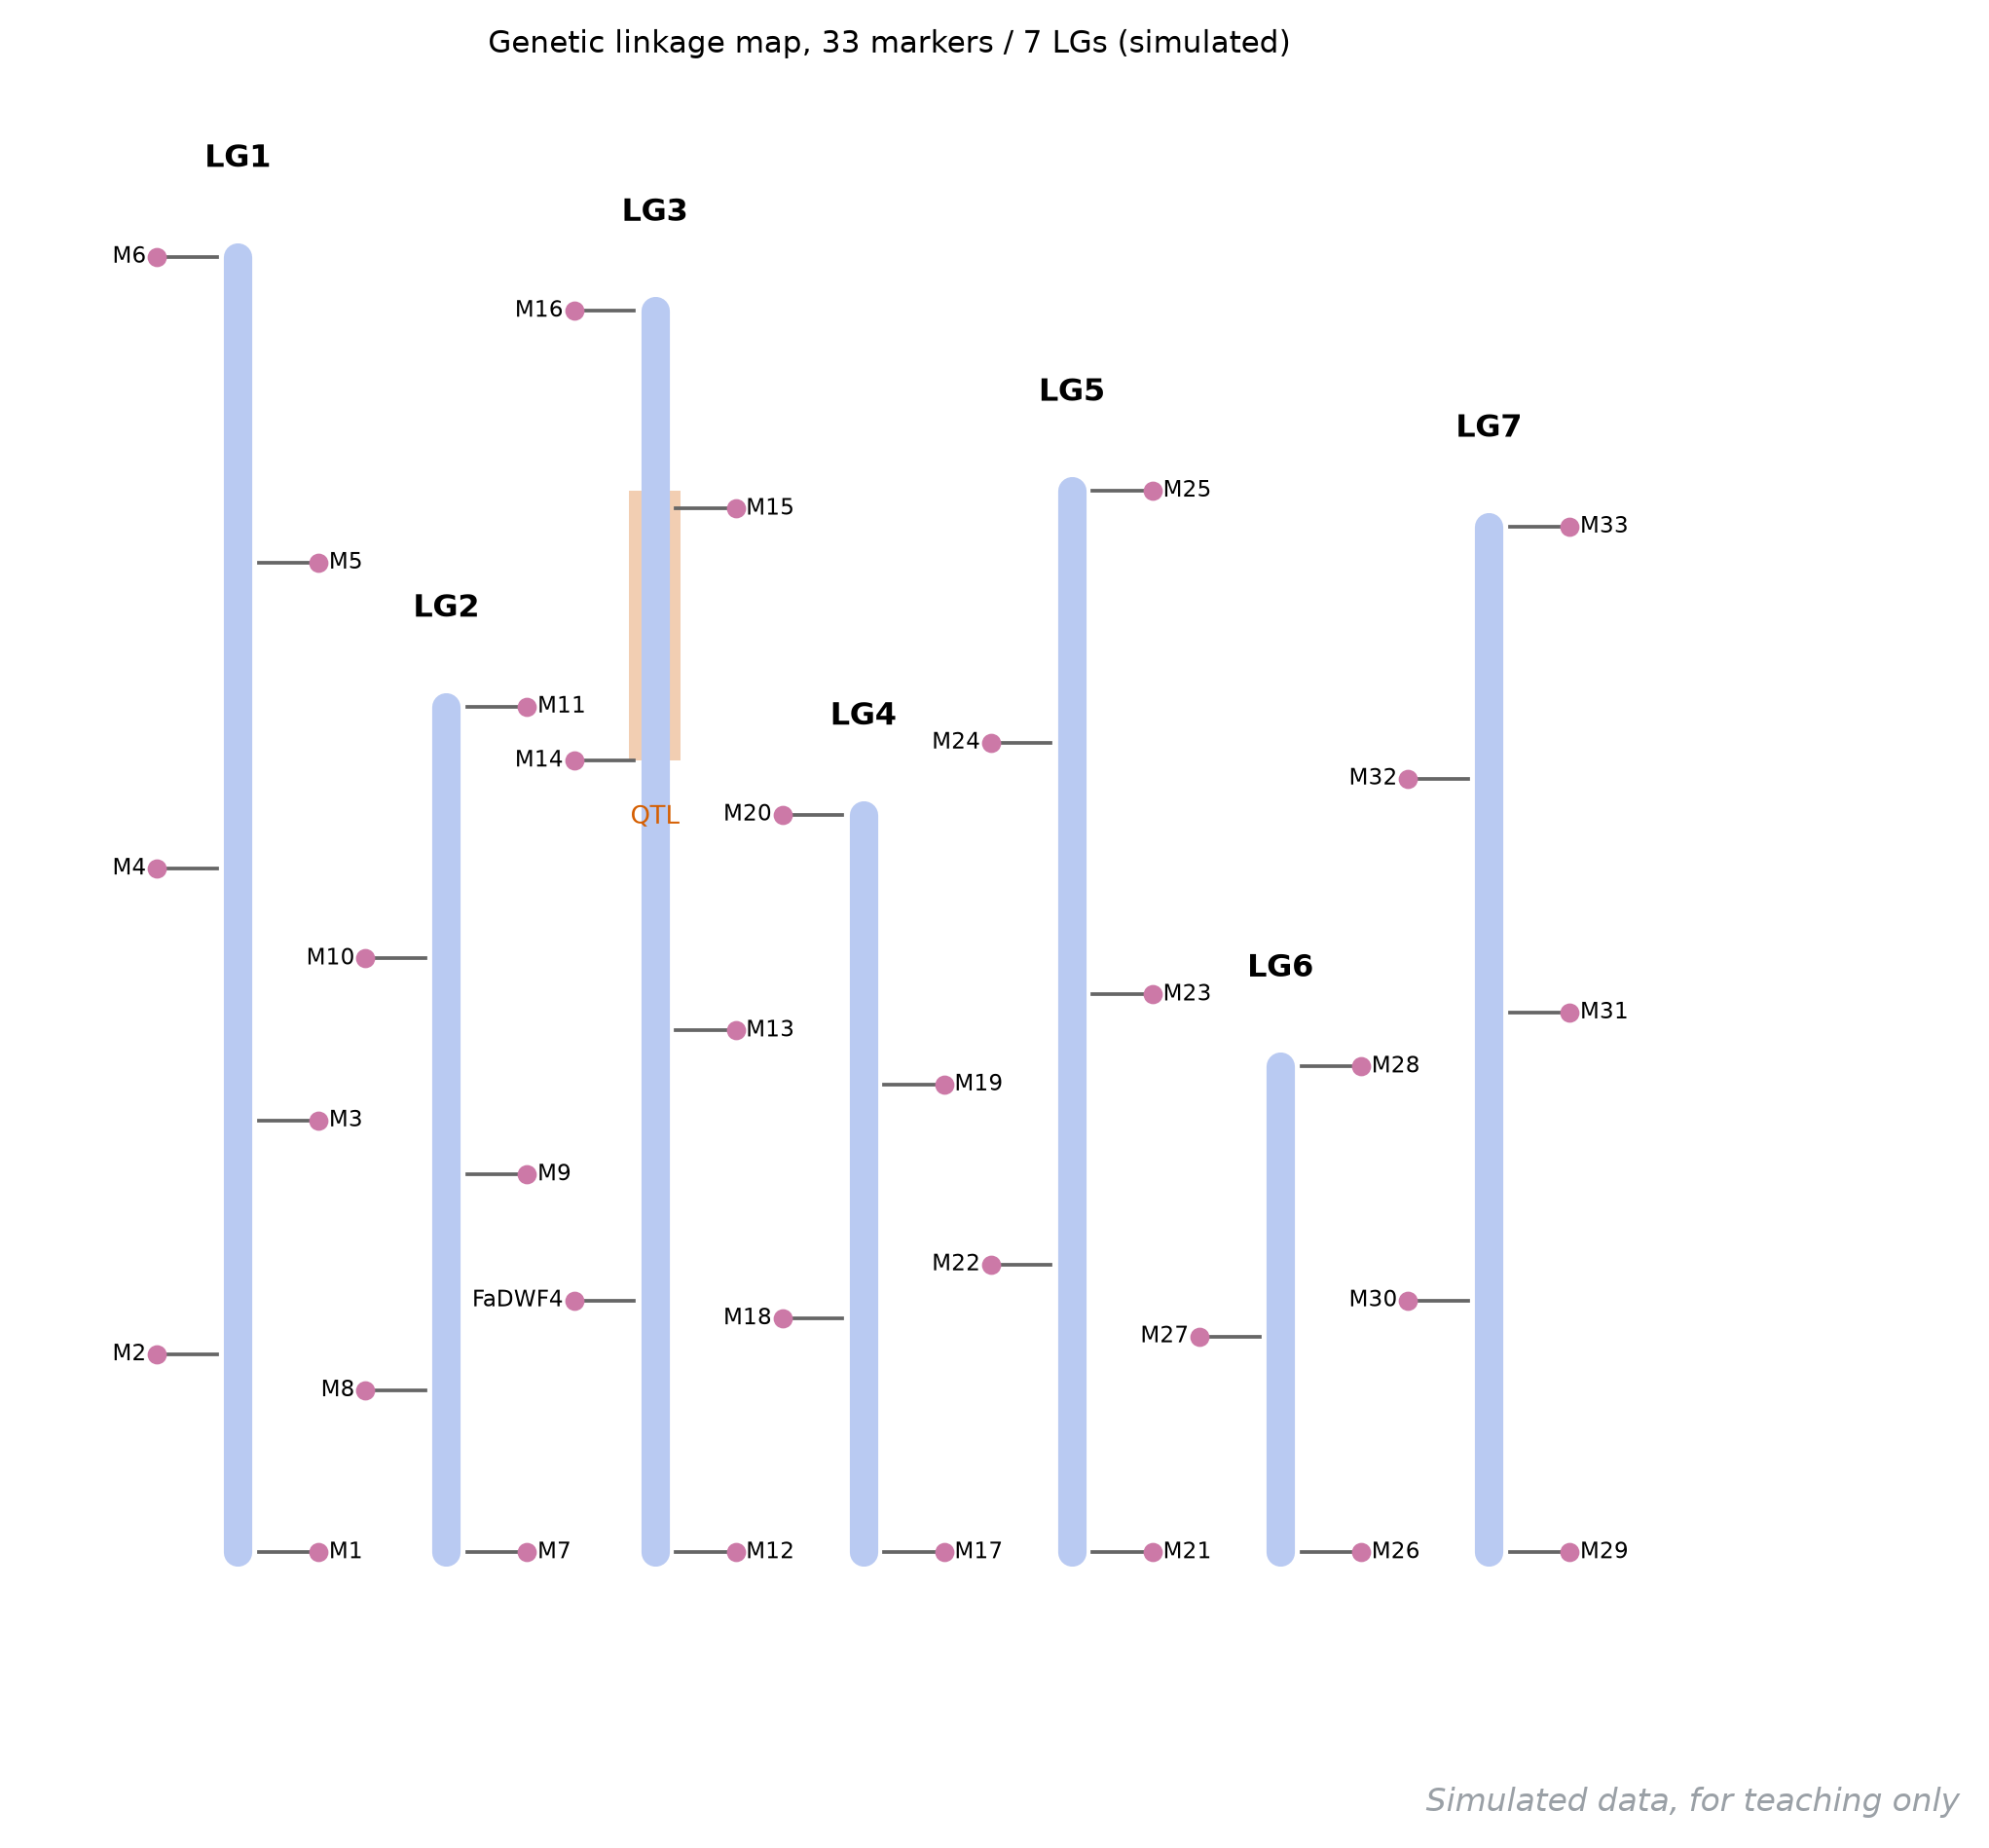
它回答什么问题:标记在基因组上怎么排布、QTL 坐落在哪两个标记之间——基因组时代的连锁图谱更像「历史文物」,但它仍是把 QTL、标记和候选基因串起来的框架图。
怎么读:每根竖条一个连锁群(LG1-LG7),长度按 cM 比例,红点是标记,名字左右交替排开避免打架。读两样:标记密度(LG6 只有 3 个标记,是断档区,QTL 定位力弱)和 QTL 区间(LG3 的橙色阴影 44-59 cM,落在 M14 与 M15 之间,候选基因 FaDWF4 就在 14 cM 处)。图注要给总图距(本例 7 群合计约 520 cM)和标记数。
用什么画:JoinMap/MapChart(GB);批量自定义用 matplotlib 按坐标画条加点。
图注示例:
图 90 荞麦遗传连锁图谱(模拟,33 个标记、7 个连锁群)。竖条长度正比重组距离(cM),红点为标记;橙色阴影为粒重 QTL 区间(LG3,44-59 cM),候选基因 FaDWF4 位于 14 cM。
展开查看:标记坐标与绘图代码
group,marker,cM
1,M1,0
1,M2,11
1,M3,24
1,M4,38
1,M5,55
1,M6,72
2,M7,0
2,M8,9
2,M9,21
2,M10,33
2,M11,47
3,M12,0
3,FaDWF4,14
3,M13,29
3,M14,44
3,M15,58
3,M16,69
4,M17,0
4,M18,13
4,M19,26
4,M20,41
5,M21,0
5,M22,16
5,M23,31
5,M24,45
5,M25,59
6,M26,0
6,M27,12
6,M28,27
7,M29,0
7,M30,14
7,M31,30
7,M32,43
7,M33,57绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("90-linkage-map.csv")
fig, ax = plt.subplots(figsize=(7.6, 6.8))
gw = 1.6
for gi, (g, sub) in enumerate(df.groupby("group")):
    x = gi * gw
    top = sub.cM.max()
    ax.plot([x, x], [0, top], color="#B9CAF2", lw=7, solid_capstyle="round")
    ax.text(x, top + 5, "LG%d" % g, ha="center", fontsize=10,
            fontweight="bold")
    for mi, (_, r) in enumerate(sub.iterrows()):
        side = 1 if mi % 2 == 0 else -1
        ax.plot([x + side * 0.16, x + side * 0.62], [r.cM, r.cM],
                color="0.4", lw=0.9)
        ax.scatter([x + side * 0.62], [r.cM], s=14, color="#C44E52", zorder=3)
        ax.text(x + side * 0.70, r.cM, r.marker, fontsize=7.2, va="center",
                ha="left" if side == 1 else "right")
    if g == 3:
        ax.add_patch(plt.Rectangle((x - 0.20, 44), 0.40, 15,
                                   facecolor="#DD8452", alpha=0.30))
        ax.text(x, 40.5, "QTL", ha="center", fontsize=8, color="#DD8452")
ax.set_xlim(-1.6, 7 * gw + 0.4)
ax.set_ylim(-3, 82)
ax.axis("off")
ax.set_title("Genetic linkage map, 33 markers / 7 LGs (simulated)")
fig.savefig("90-linkage-map.png", dpi=200, bbox_inches="tight")5.3 AMMI 双标图#
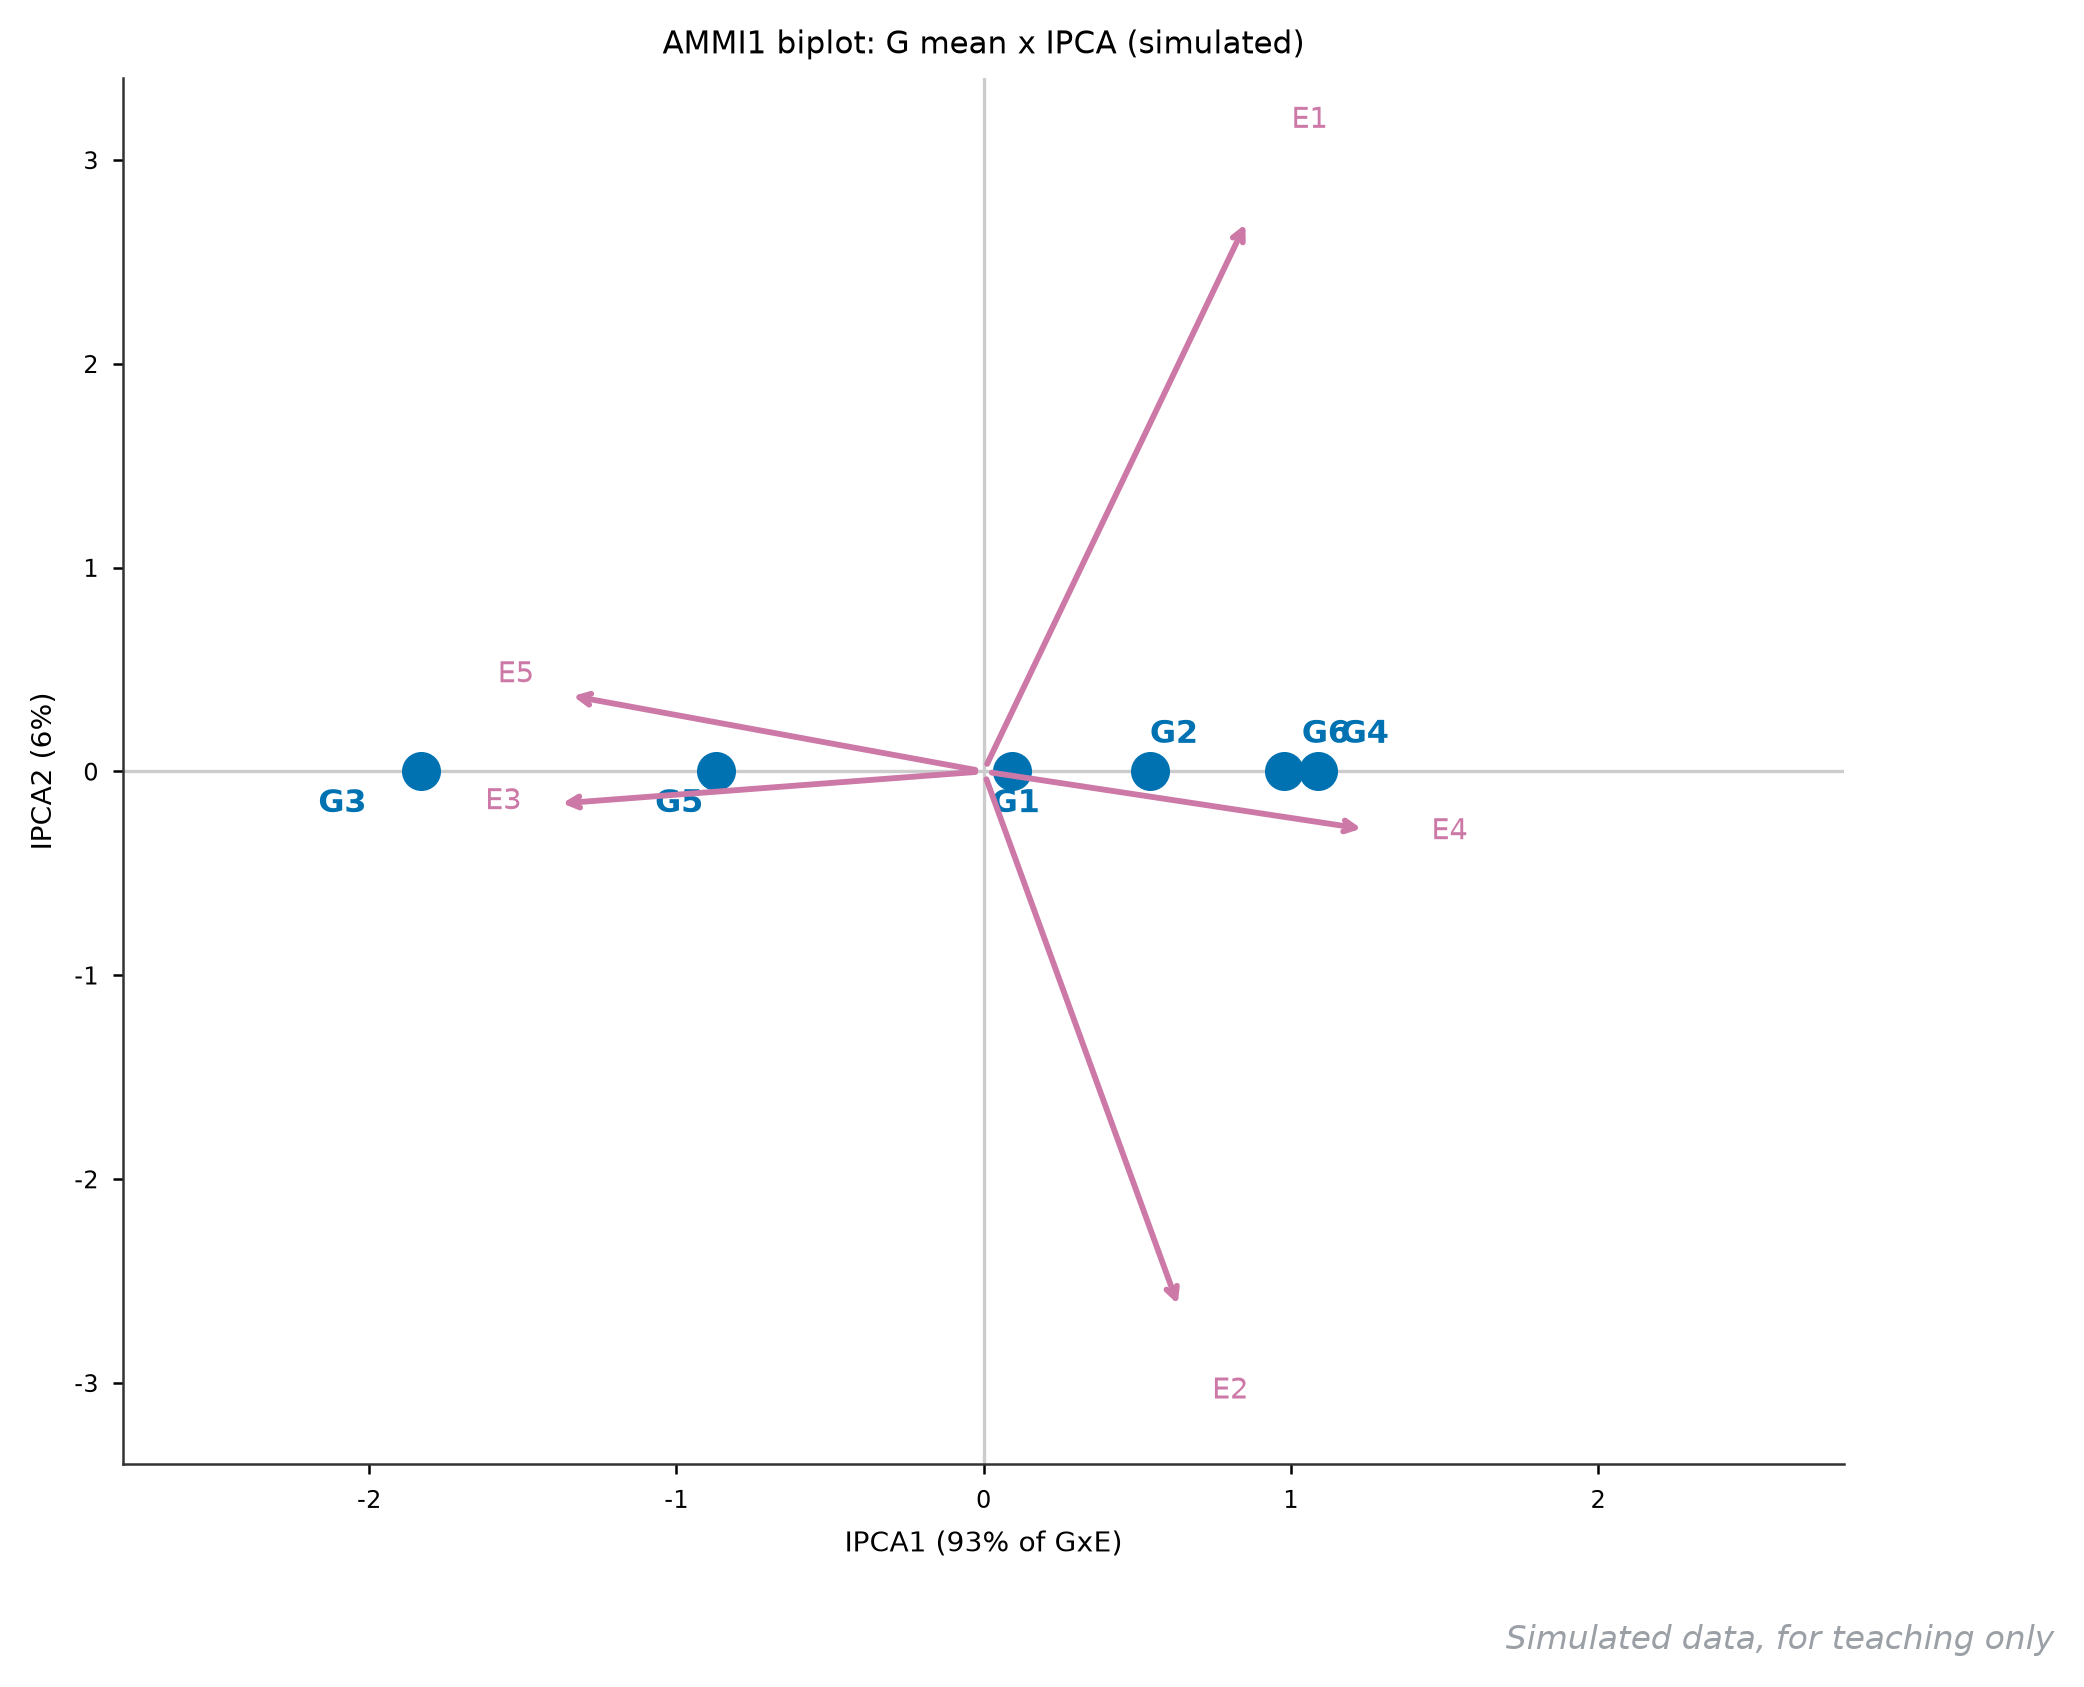
它回答什么问题:品种排名怎么随环境翻转——多点试验里基因型×环境互作(G×E)的主成分分解,GGE 之外的另一把老刀,胜在能同时看出「谁高产」和「谁稳产」。
怎么读:先对产量矩阵做加性模型(总均值+基因型+环境)再对残差做 SVD。蓝点是基因型在 IPCA1 上的得分(离原点越远=互作越强、稳产性越差),红箭头是环境。G3 在 IPCA1 = -1.8(强互作),E3、E5 与它同向——G3 在这些环境里超常发挥,换个方向的环境(E4)就垮;G1、G4 贴近原点=广适应但不出彩。横轴注明 IPCA1 吃掉了 93% 的互作方差,看一根轴就够。
用什么画:R 语言 metan 的 AMMI();重绘对残差矩阵 SVD 后画点加箭头。
图注示例:
图 91 六个品种五个环境的 AMMI1 双标图(模拟)。蓝点为基因型 IPCA1 得分,红箭头为环境;IPCA1 解释互作方差的 93%。G3 与 E3、E5 同向属专适型,G1、G4 贴近原点属广适型。
展开查看:产量矩阵与绘图代码
env,G1,G2,G3,G4,G5,G6
E1,4.2,4.8,3.4,5.0,3.8,4.5
E2,4.9,5.1,3.9,4.7,4.3,5.4
E3,3.1,2.9,3.8,2.6,3.4,2.8
E4,4.6,5.0,3.5,5.3,4.1,5.5
E5,3.4,3.6,4.3,3.1,3.9,3.3绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("91-ammi-yield.csv", index_col="env")
Y = df.values
R = Y - Y.mean(0) - Y.mean(1)[:, None] + Y.mean()
U, S, Vt = np.linalg.svd(R, full_matrices=False)
g = Vt.T[:, 0] * S[0]
e = U[:, 0] * S[0]
fig, ax = plt.subplots(figsize=(7.4, 6.0))
ax.scatter(g, np.zeros(6), s=70, color="#4C72B0", zorder=3)
for i in range(6):
    ax.text(g[i] * 1.14, 0.14 if i % 2 else -0.20, "G%d" % (i + 1),
            fontsize=10, color="#4C72B0", fontweight="bold", ha="center")
for j, env in enumerate(df.index):
    ax.annotate("", xy=(e[j], U[j, 1] * S[1] * 6), xytext=(0, 0),
                arrowprops=dict(arrowstyle="->", color="#C44E52", lw=1.4))
    ax.text(e[j] * 1.16, U[j, 1] * S[1] * 6 * 1.16, env, fontsize=9,
            color="#C44E52")
ax.axhline(0, color="0.8", lw=0.8)
ax.axvline(0, color="0.8", lw=0.8)
ax.set_xlim(-2.8, 2.8)
ax.set_ylim(-3.4, 3.4)
ax.set_xlabel("IPCA1 (%.0f%% of GxE)" % (S[0] ** 2 / (S ** 2).sum() * 100))
ax.set_ylabel("IPCA2 (%.0f%%)" % (S[1] ** 2 / (S ** 2).sum() * 100))
ax.set_title("AMMI1 biplot: G mean x IPCA (simulated)")
fig.savefig("91-ammi.png", dpi=200, bbox_inches="tight")六、功能基因组与表观#
6.1 GO 有向无环图#
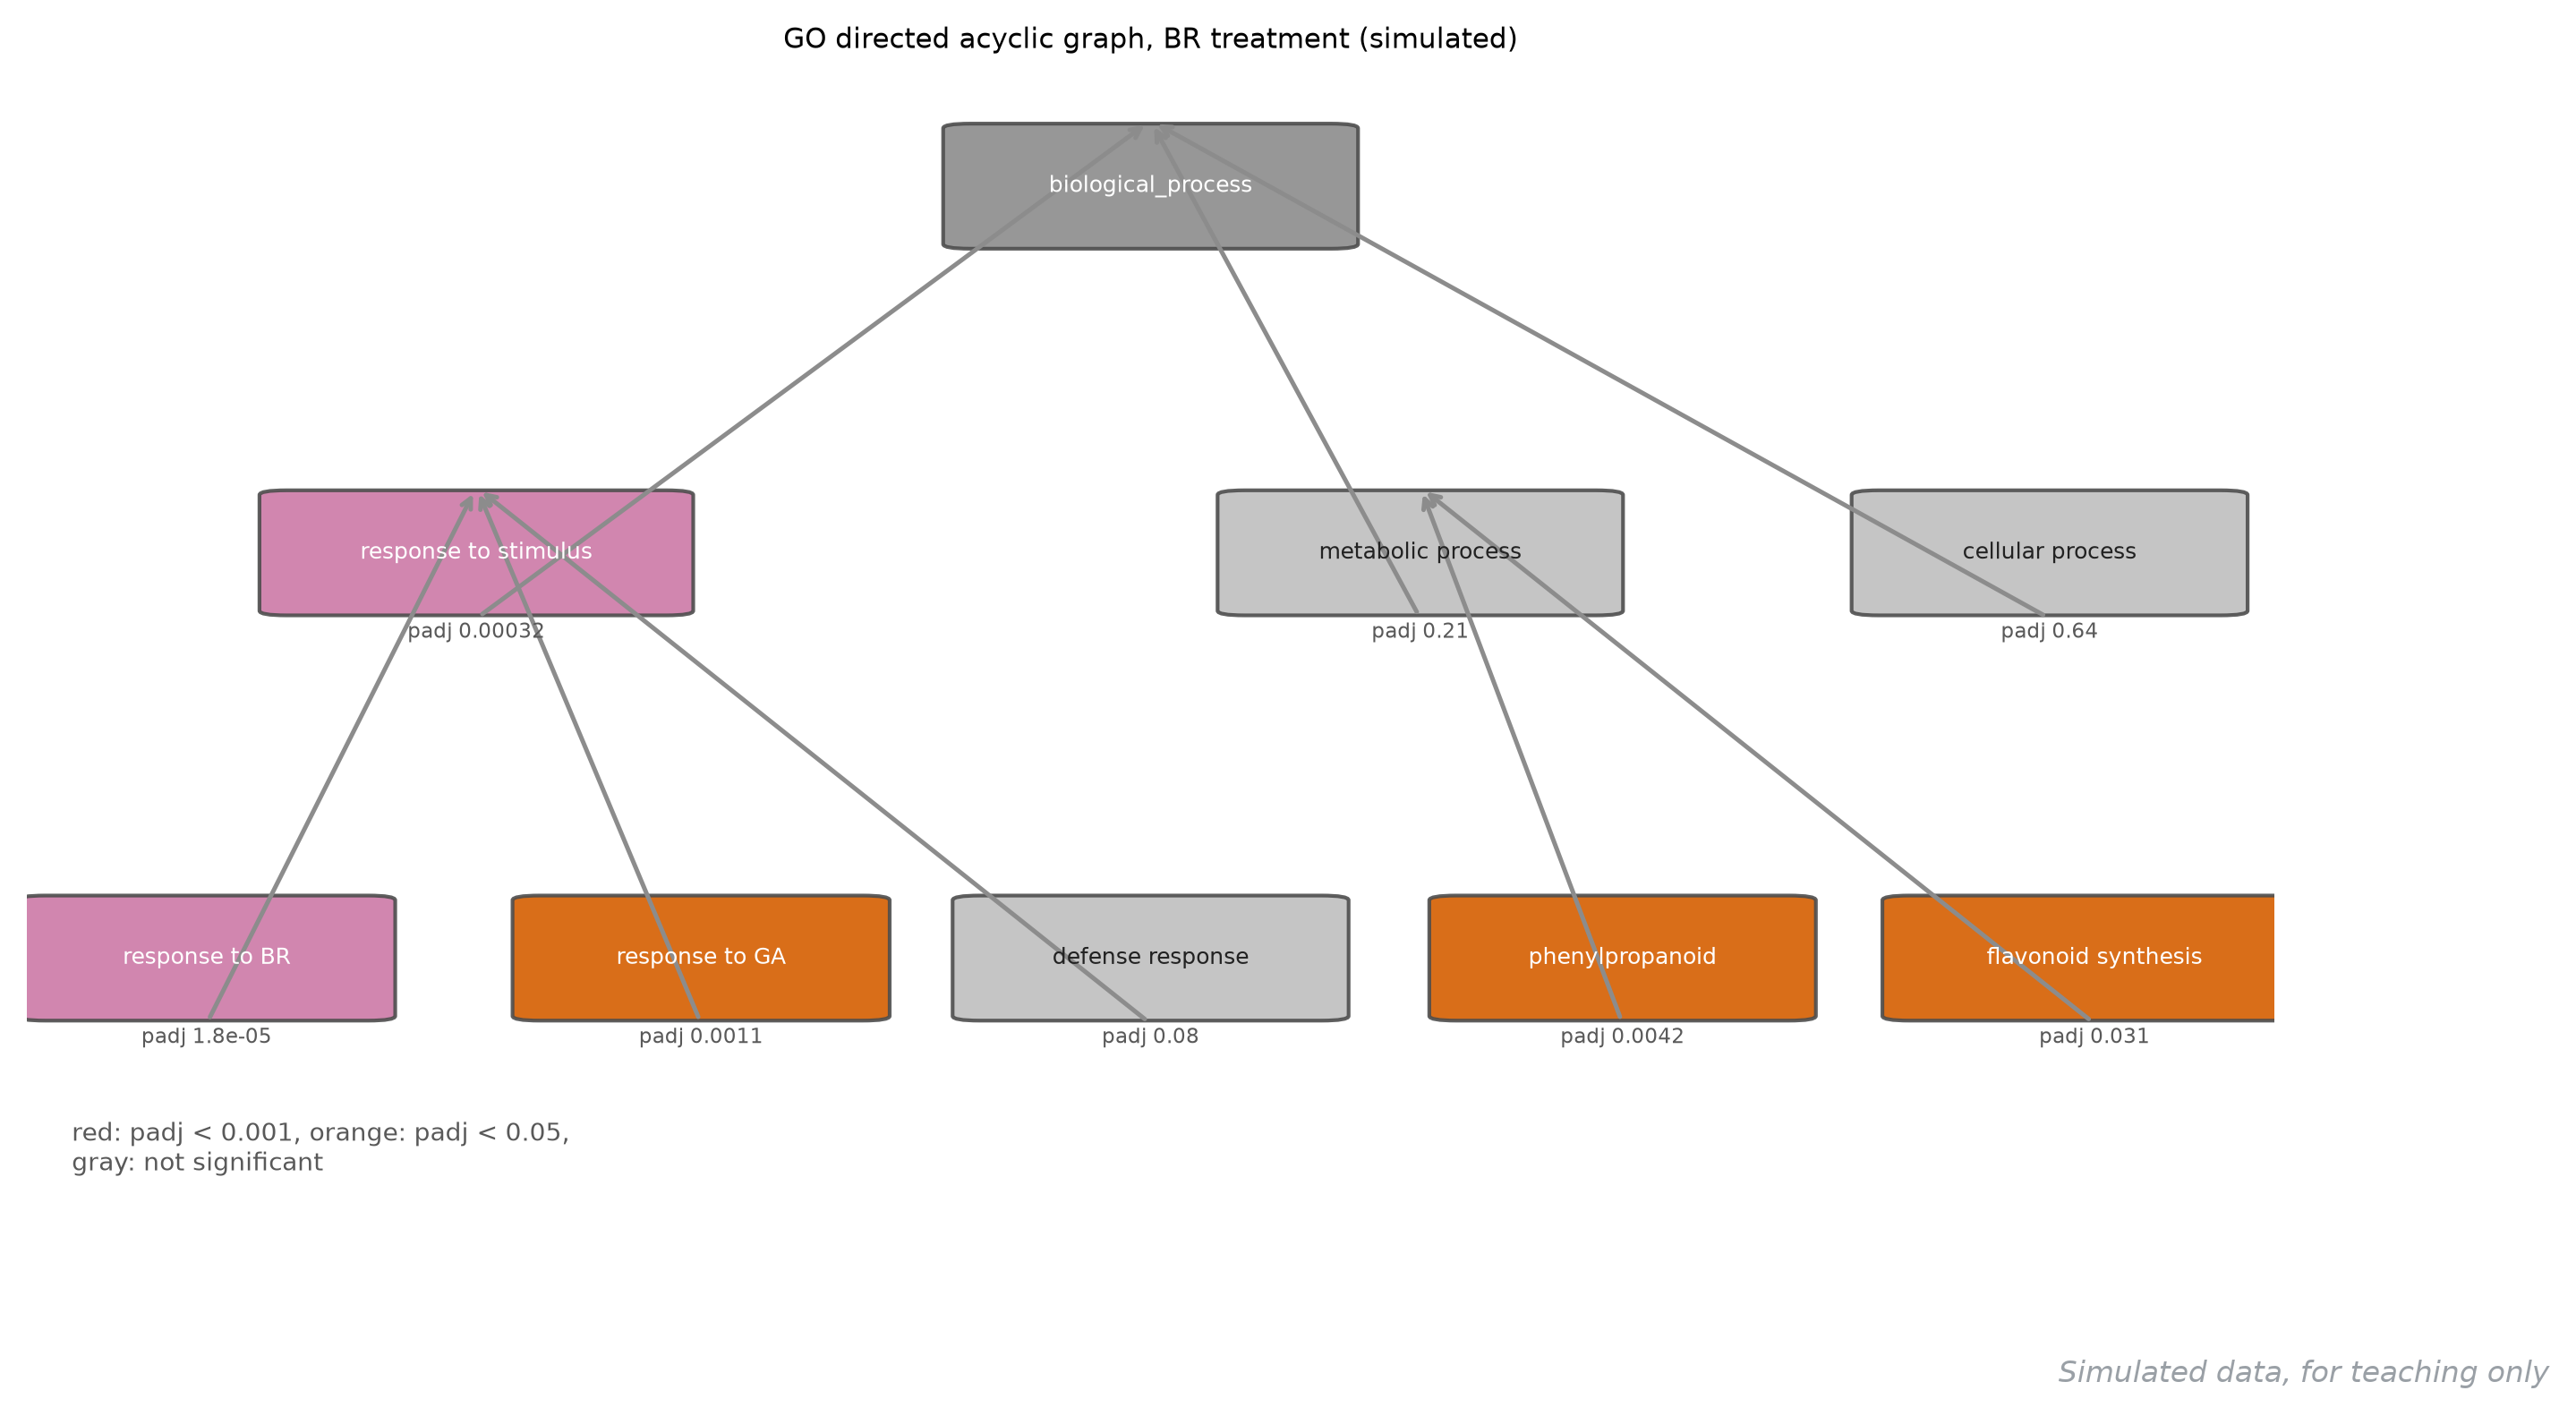
它回答什么问题:富集分析的一串 GO 条目之间是什么层级关系——条形图告诉你「哪些词显著」,DAG 图告诉你「显著的是叶子还是主干」,审稿人看后者判断你是不是真读懂了结果。
怎么读:自上而下是从泛到专的父子关系(有向无环:一个节点可以有多个父节点)。节点颜色编码 padj:红=padj 小于 0.001,橙=小于 0.05,灰=不显著。读的关键是显著性梯度:本例最深的红出现在叶子「response to BR」(padj 1.8e-5),它的父节点「response to stimulus」次之(3.2e-4),再往上的根只是背景——结论应该写「BR 响应通路被特异激活」,而不是「生物过程显著」。灰叶子夹在红通路里(defense response,padj 0.08)说明激活是 BR 特异的、不是应激泛反应。
用什么画:AgriGO、REVIGO(化简冗余);重绘按坐标画圆角框加箭头。
图注示例:
图 92 BR 处理差异基因的 GO 有向无环图(模拟,7 个节点)。节点颜色编码 padj(红小于 0.001、橙小于 0.05、灰不显著);「response to brassinosteroid」显著最深,其父层「response to stimulus」次之, defense response 不显著,提示通路激活具 BR 特异性。
展开查看:节点数据与绘图代码
child,parent,padj
BP,stimulus,0.0
BP,metabolic,0.0
BP,cellular,0.0
stimulus,BR,0.00032
stimulus,GA,0.00032
stimulus,defense,0.00032
metabolic,phenyl,0.21
metabolic,flavonoid,0.21(padj 列为 child 节点的校正值,根节点 0.0 为占位;对应节点:BP=biological process,BR=response to brassinosteroid,GA=response to gibberellin,phenyl=phenylpropanoid,flavonoid=flavonoid synthesis。)
绘图代码(Python,独立可运行)
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch

nodes = {
    "BP":        (0.50, 3.00, "biological_process", 0.0),
    "stimulus":  (0.20, 2.05, "response to stimulus", 3.2e-4),
    "metabolic": (0.62, 2.05, "metabolic process", 0.21),
    "cellular":  (0.90, 2.05, "cellular process", 0.64),
    "BR":        (0.08, 1.00, "response to BR", 1.8e-5),
    "GA":        (0.30, 1.00, "response to GA", 1.1e-3),
    "defense":   (0.50, 1.00, "defense response", 0.08),
    "phenyl":    (0.71, 1.00, "phenylpropanoid", 4.2e-3),
    "flavonoid": (0.92, 1.00, "flavonoid synthesis", 0.031),
}
edges = [("BP", "stimulus"), ("BP", "metabolic"), ("BP", "cellular"),
         ("stimulus", "BR"), ("stimulus", "GA"), ("stimulus", "defense"),
         ("metabolic", "phenyl"), ("metabolic", "flavonoid")]
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52"]
fig, ax = plt.subplots(figsize=(10.8, 5.6))

def ncol(p):
    if p == 0.0:
        return "0.55"
    return CAT[3] if p < 0.001 else (CAT[1] if p < 0.05 else "0.75")

for c, p in edges:
    (x0, y0, _, _), (x1, y1, _, _) = nodes[p], nodes[c]
    ax.annotate("", xy=(x1, y1 + 0.17), xytext=(x0, y0 - 0.17),
                arrowprops=dict(arrowstyle="->", color="0.55", lw=1.2))
for name, (x, y, term, p) in nodes.items():
    w = 0.085 + 0.0042 * len(term)
    ax.add_patch(FancyBboxPatch((x - w / 2, y - 0.15), w, 0.30,
                                boxstyle="round,pad=0.012",
                                facecolor=ncol(p), edgecolor="0.3",
                                alpha=0.90))
    ax.text(x, y, term, ha="center", va="center", fontsize=7.6,
            color="white" if p < 0.05 else "#222")
    if p > 0:
        ax.text(x, y - 0.22, "padj %.3g" % p, ha="center", fontsize=6.5,
                color="0.35")
ax.text(0.02, 0.45, "red: padj < 0.001, orange: padj < 0.05,\n"
        "gray: not significant", fontsize=8.5, color="0.35")
ax.set_xlim(0, 1)
ax.set_ylim(0.3, 3.3)
ax.axis("off")
ax.set_title("GO directed acyclic graph, BR treatment (simulated)")
fig.savefig("92-go-dag.png", dpi=200, bbox_inches="tight")6.2 ChIP-seq 剖面与信号热图#
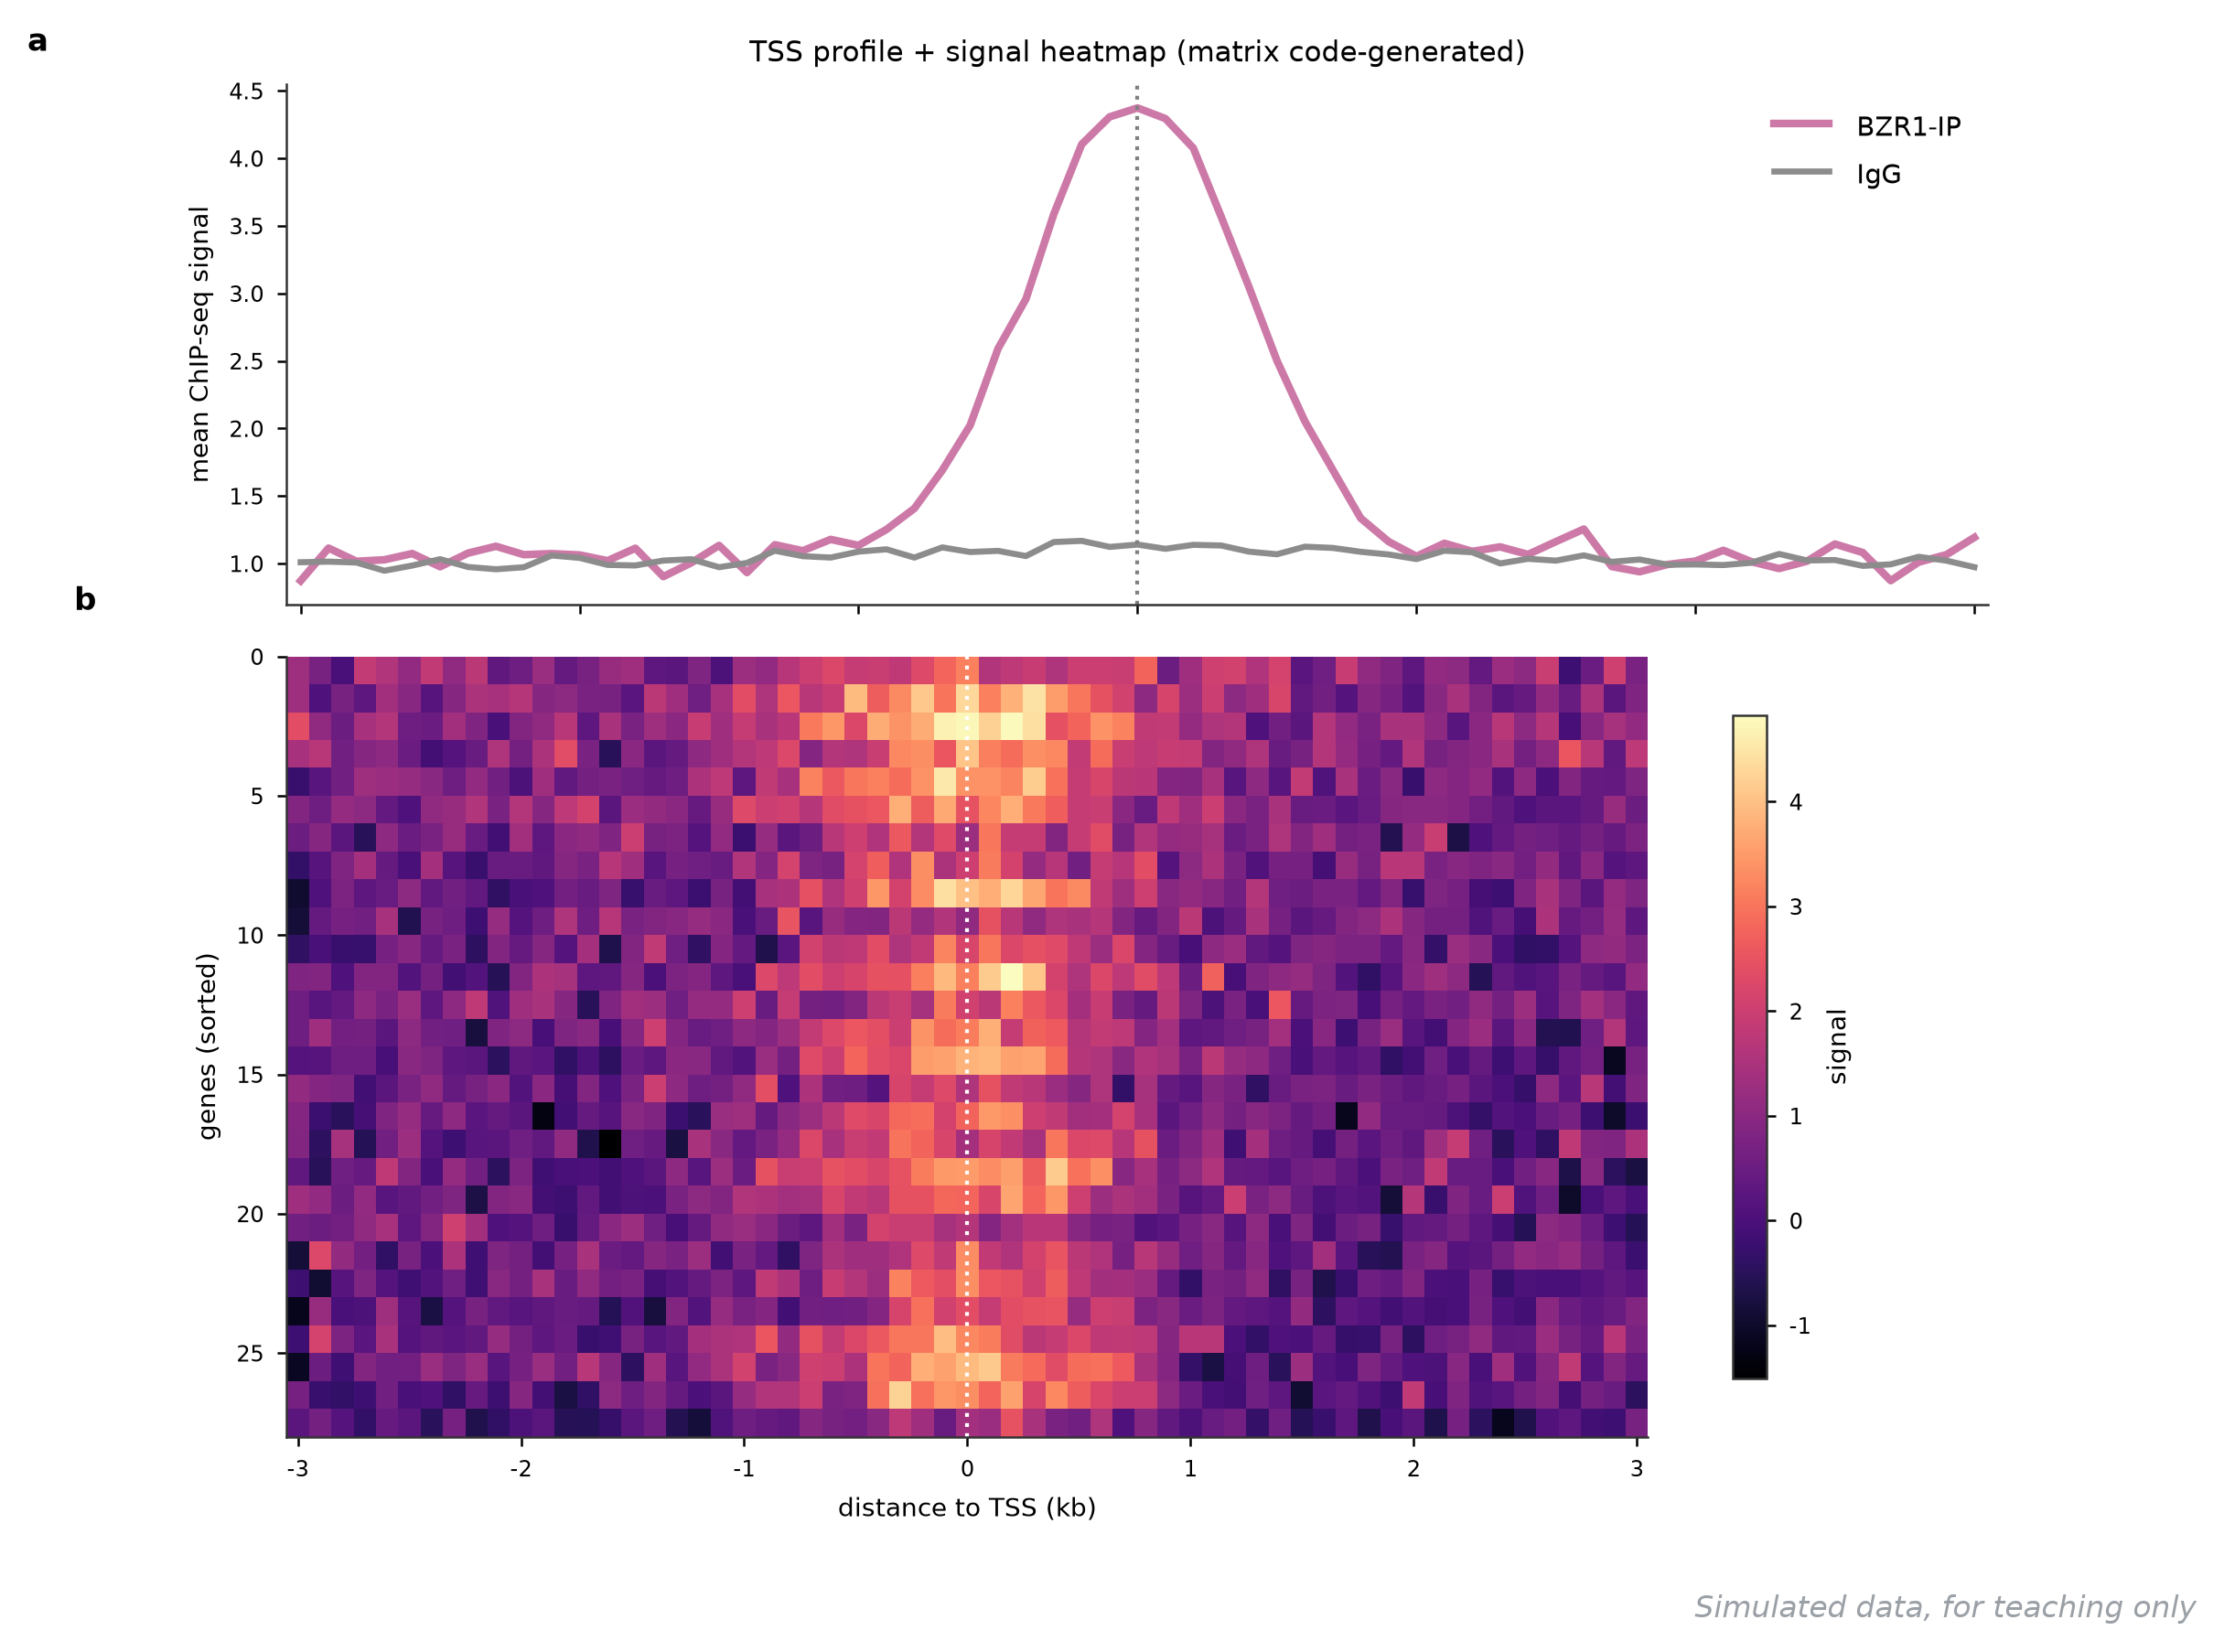
它回答什么问题:转录因子结合信号富集在 TSS 附近多强、哪些靶基因富集最深——ChIP/ATAC 标准出的「剖面+热图」双联,上图讲平均行为,下图讲个体差异。
怎么读:上图是全部靶基因在 TSS ±3 kb 的平均信号:BZR1-IP 红线在 TSS 处耸起 4.37 倍峰,IgG 对照平贴 1.0——峰形对称、半宽约 0.7 kb,是典型的启动子型因子。下图每行一个基因(按信号强度排序),颜色是标准化信号,可以一眼看出不是所有基因都均等结合:上半部深(强结合)、下半部接近背景。两图配合才能写「BZR1 优先结合高表达基因的启动子」这类结论。
用什么画:deepTools 的 plotProfile 与 plotHeatmap 一套流程;重绘按距离-信号表画线加 imshow。
图注示例:
图 93 BZR1 在 28 个靶基因 TSS ±3 kb 的 ChIP-seq 信号(模拟)。上:均值剖面,IP 在 TSS 处峰值 4.37,IgG 对照平坦;下:逐基因信号热图,基因按 TSS 信号强度排序。
展开查看:剖面数据与绘图代码
distance_kb,ip,igg
-3.0,0.87,1.01
-2.9,1.11,1.01
-2.8,1.02,1.01
-2.7,1.03,0.95
-2.6,1.07,0.98
-2.5,0.98,1.03
-2.4,1.08,0.97
-2.3,1.13,0.96
-2.2,1.07,0.97
-2.1,1.07,1.06
-2.0,1.06,1.04
-1.9,1.02,0.99
-1.8,1.11,0.99
-1.7,0.90,1.02
-1.6,1.01,1.03
-1.5,1.13,0.97
-1.4,0.93,1.00
-1.3,1.14,1.09
-1.2,1.09,1.05
-1.1,1.18,1.04
-1.0,1.13,1.09
-0.9,1.25,1.11
-0.8,1.41,1.04
-0.7,1.69,1.12
-0.6,2.02,1.09
-0.5,2.59,1.09
-0.4,2.96,1.06
-0.3,3.59,1.16
-0.2,4.10,1.17
-0.1,4.31,1.12
0.0,4.37,1.14
0.1,4.29,1.11
0.2,4.08,1.14
0.3,3.57,1.13
0.4,3.04,1.09
0.5,2.50,1.07
0.6,2.05,1.12
0.7,1.69,1.12
0.8,1.34,1.09
0.9,1.16,1.07
1.0,1.05,1.03
1.1,1.15,1.10
1.2,1.09,1.08
1.3,1.12,1.00
1.4,1.07,1.03
1.5,1.16,1.02
1.6,1.26,1.06
1.7,0.98,1.01
1.8,0.94,1.03
1.9,0.99,0.99
2.0,1.02,0.99
2.1,1.10,0.99
2.2,1.01,1.01
2.3,0.96,1.07
2.4,1.02,1.02
2.5,1.14,1.03
2.6,1.08,0.98
2.7,0.87,0.99
2.8,1.01,1.05
2.9,1.07,1.02
3.0,1.19,0.97绘图代码(Python,独立可运行;热图矩阵由代码生成)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("93-chip-profile.csv")
rng = np.random.default_rng(2093)
d = df.distance_kb.values
m = rng.normal(0, 1, (28, 61)) * 0.6
bump = np.exp(-0.5 * (d / 0.55) ** 2) * 2.4
m = m + rng.uniform(0.5, 1.6, 28)[:, None] * bump[None, :]
m += rng.normal(0.6, 0.25, (28, 1))
m = m[np.argsort(-m[:, 41:50].mean(1))]
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(8.0, 6.4), sharex=True,
                               gridspec_kw=dict(height_ratios=[1, 1.5],
                                                hspace=0.08))
ax1.plot(d, df.ip, color="#C44E52", lw=2, label="BZR1-IP")
ax1.plot(d, df.igg, color="0.55", lw=1.6, label="IgG")
ax1.axvline(0, color="0.5", ls=":", lw=1)
ax1.set_ylabel("mean ChIP-seq signal")
ax1.legend(fontsize=9)
ax1.set_title("TSS profile + signal heatmap (matrix code-generated)")
im = ax2.imshow(m, aspect="auto", cmap="magma", extent=[-3.05, 3.05, 28, 0])
ax2.axvline(0, color="white", ls=":", lw=1)
ax2.set_xlabel("distance to TSS (kb)")
ax2.set_ylabel("genes (sorted)")
fig.colorbar(im, ax=ax2, shrink=0.85, label="signal")
fig.savefig("93-chip.png", dpi=200, bbox_inches="tight")6.3 转录因子足迹图#
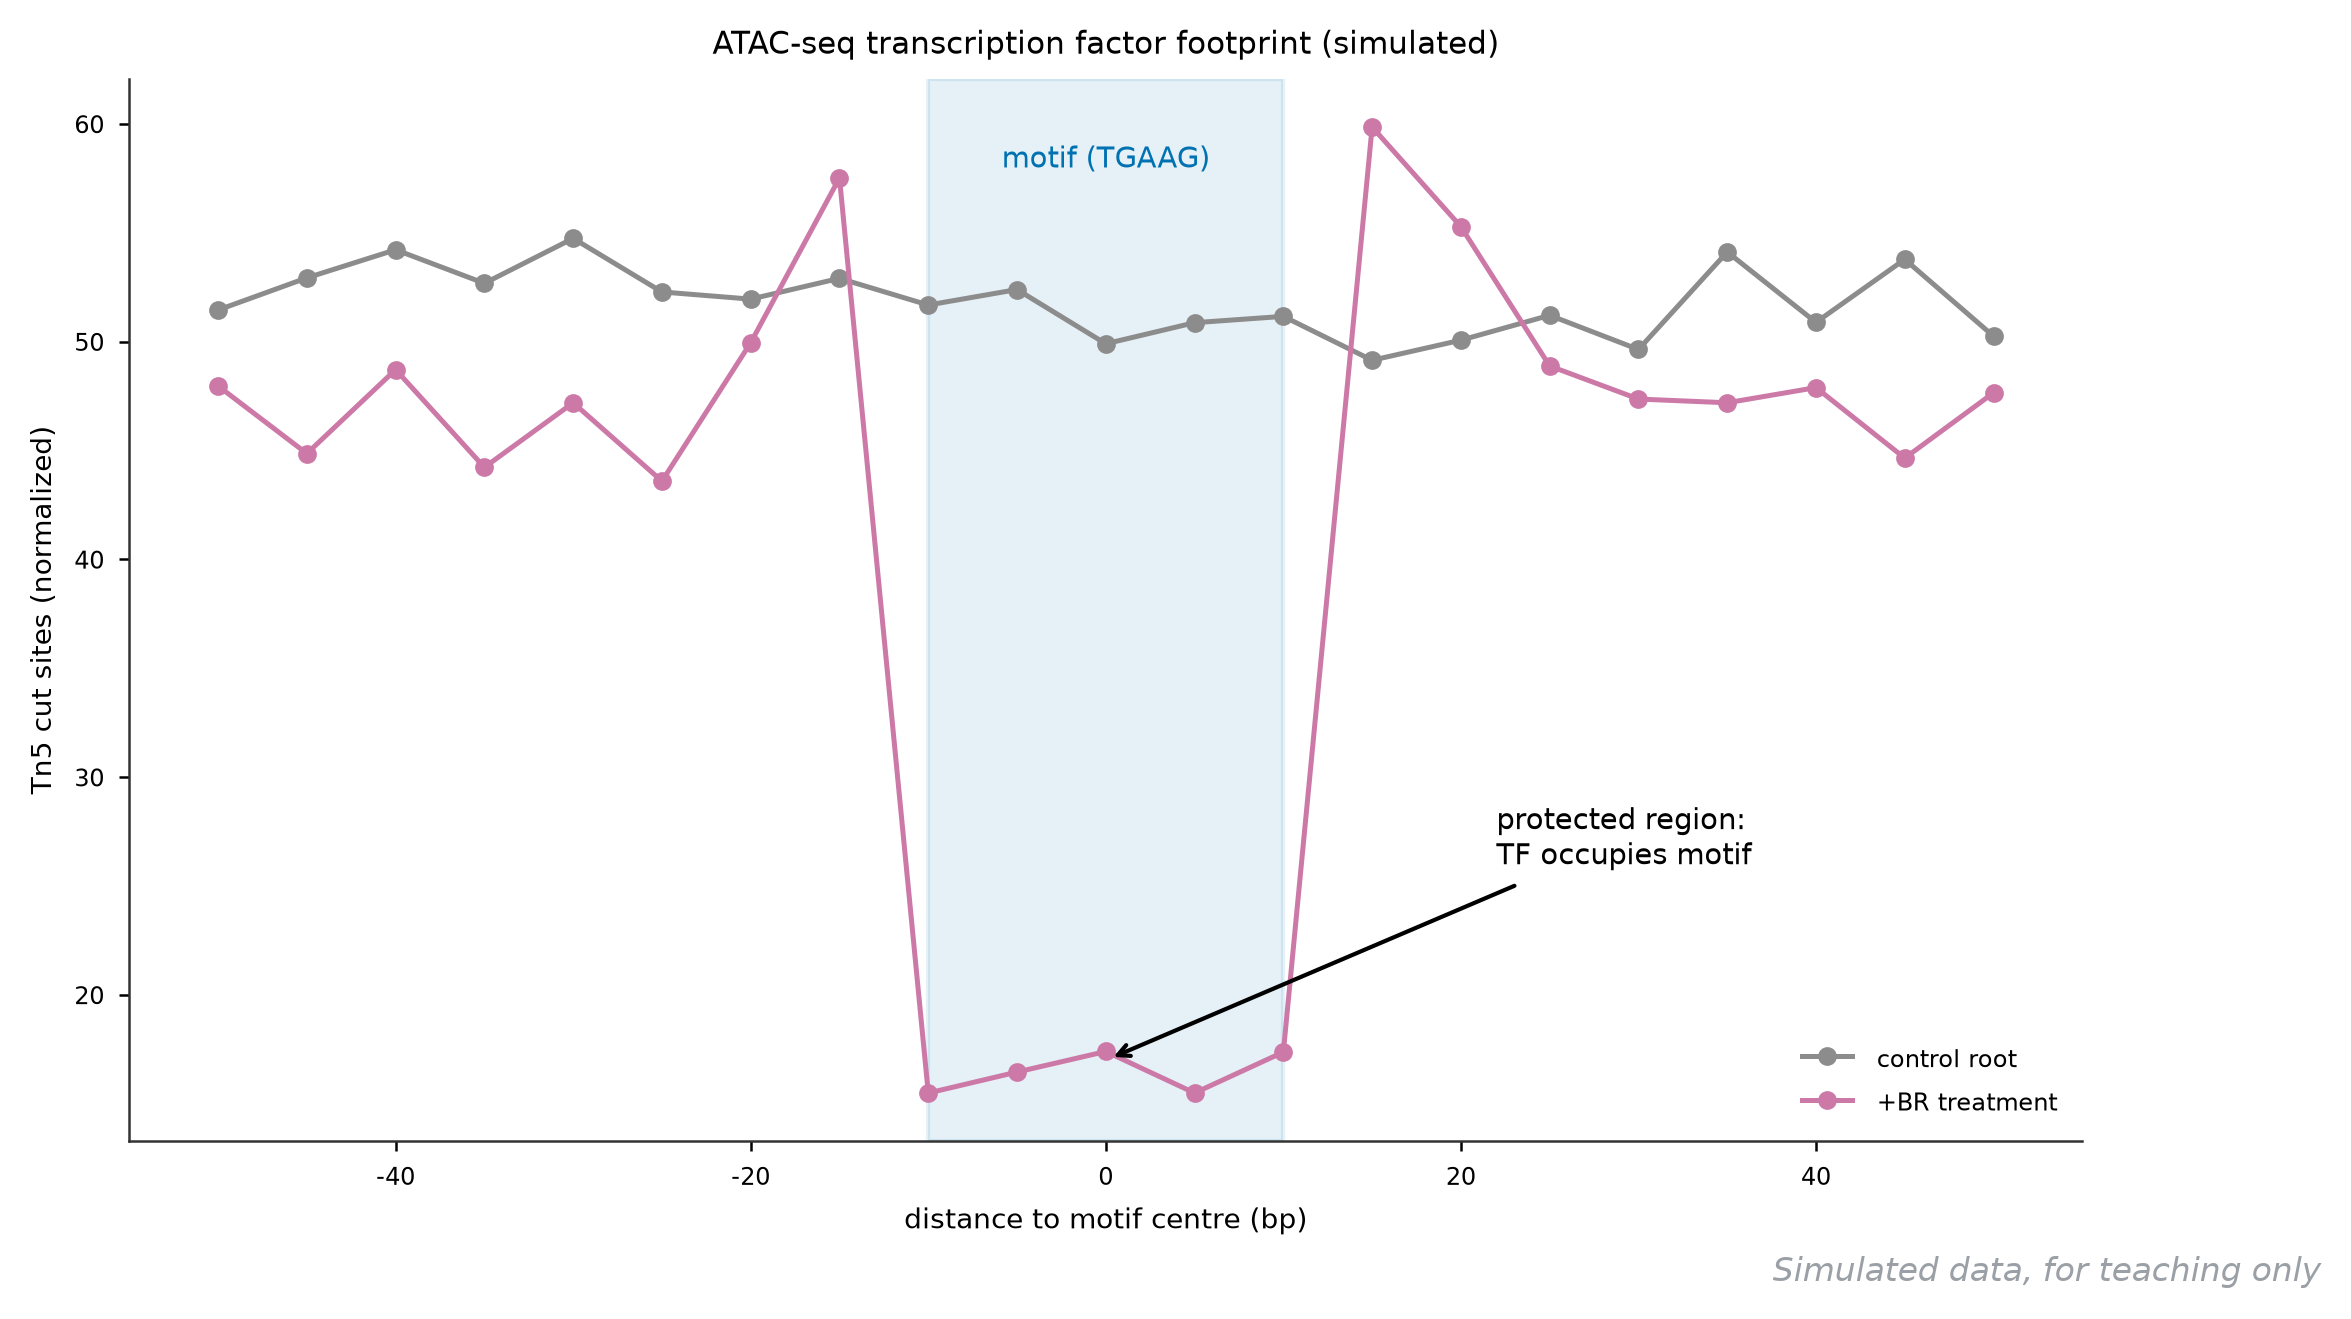
它回答什么问题:转录因子在活细胞里真的占住了这个基序吗——ATAC-seq 的进阶用法:因子结合处的 DNA 被保护,Tn5 切不动,会在切割信号上留下一个「脚印」。
怎么读:横轴是相对基序中心(TGAAG,蓝色阴影)的位置,纵轴是归一化切割计数。对照组(灰线)平铺在 50 左右;处理组(红线,加 BR 后 BZR1 入核)在基序 ±10 bp 内塌到 15-17——这就是足迹;两侧 ±15-20 bp 处反而鼓出两个包(60 左右),因为 Tn5 偏好切结合因子边缘暴露的 DNA。判断标准:处理/对照的比值差在基序内显著、边缘有凸起、基序两侧信号对称。
用什么画:TOBIAS 或 HINT-ATAC 出图;重绘按偏移-计数表画双线加阴影。
图注示例:
图 94 BR 处理前后 BZR1 基序(TGAAG)的 ATAC-seq 足迹(模拟)。处理组在基序 ±10 bp 内切割信号降至 17,两侧 ±15-20 bp 出现保护性凸起;对照组全程平坦。
展开查看:切割数据与绘图代码
offset_bp,control,treated
-50,51.5,48.0
-45,52.9,44.9
-40,54.2,48.7
-35,52.7,44.2
-30,54.7,47.2
-25,52.3,43.6
-20,52.0,50.0
-15,52.9,57.5
-10,51.7,15.5
-5,52.4,16.5
0,49.9,17.4
5,50.9,15.5
10,51.2,17.4
15,49.1,59.9
20,50.1,55.3
25,51.2,48.9
30,49.6,47.4
35,54.1,47.2
40,50.9,47.9
45,53.8,44.7
50,50.3,47.7绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("94-footprint.csv")
fig, ax = plt.subplots(figsize=(8.4, 4.6))
ax.axvspan(-10, 10, color="#4C72B0", alpha=0.10)
ax.text(0, 58, "motif (TGAAG)", ha="center", fontsize=9, color="#4C72B0")
ax.plot(df.offset_bp, df.control, "-o", ms=4, color="0.55",
        label="control root")
ax.plot(df.offset_bp, df.treated, "-o", ms=4, color="#C44E52",
        label="+BR treatment")
ax.annotate("protected region:\nTF occupies motif", (0, 17), (22, 26),
            fontsize=9, arrowprops=dict(arrowstyle="->", lw=1))
ax.set_xlabel("distance to motif centre (bp)")
ax.set_ylabel("Tn5 cut sites (normalized)")
ax.legend(loc="lower right")
ax.set_title("ATAC-seq transcription factor footprint (simulated)")
fig.savefig("94-footprint.png", dpi=200, bbox_inches="tight")6.4 WGCNA 聚类树与模块-性状关联全装图#
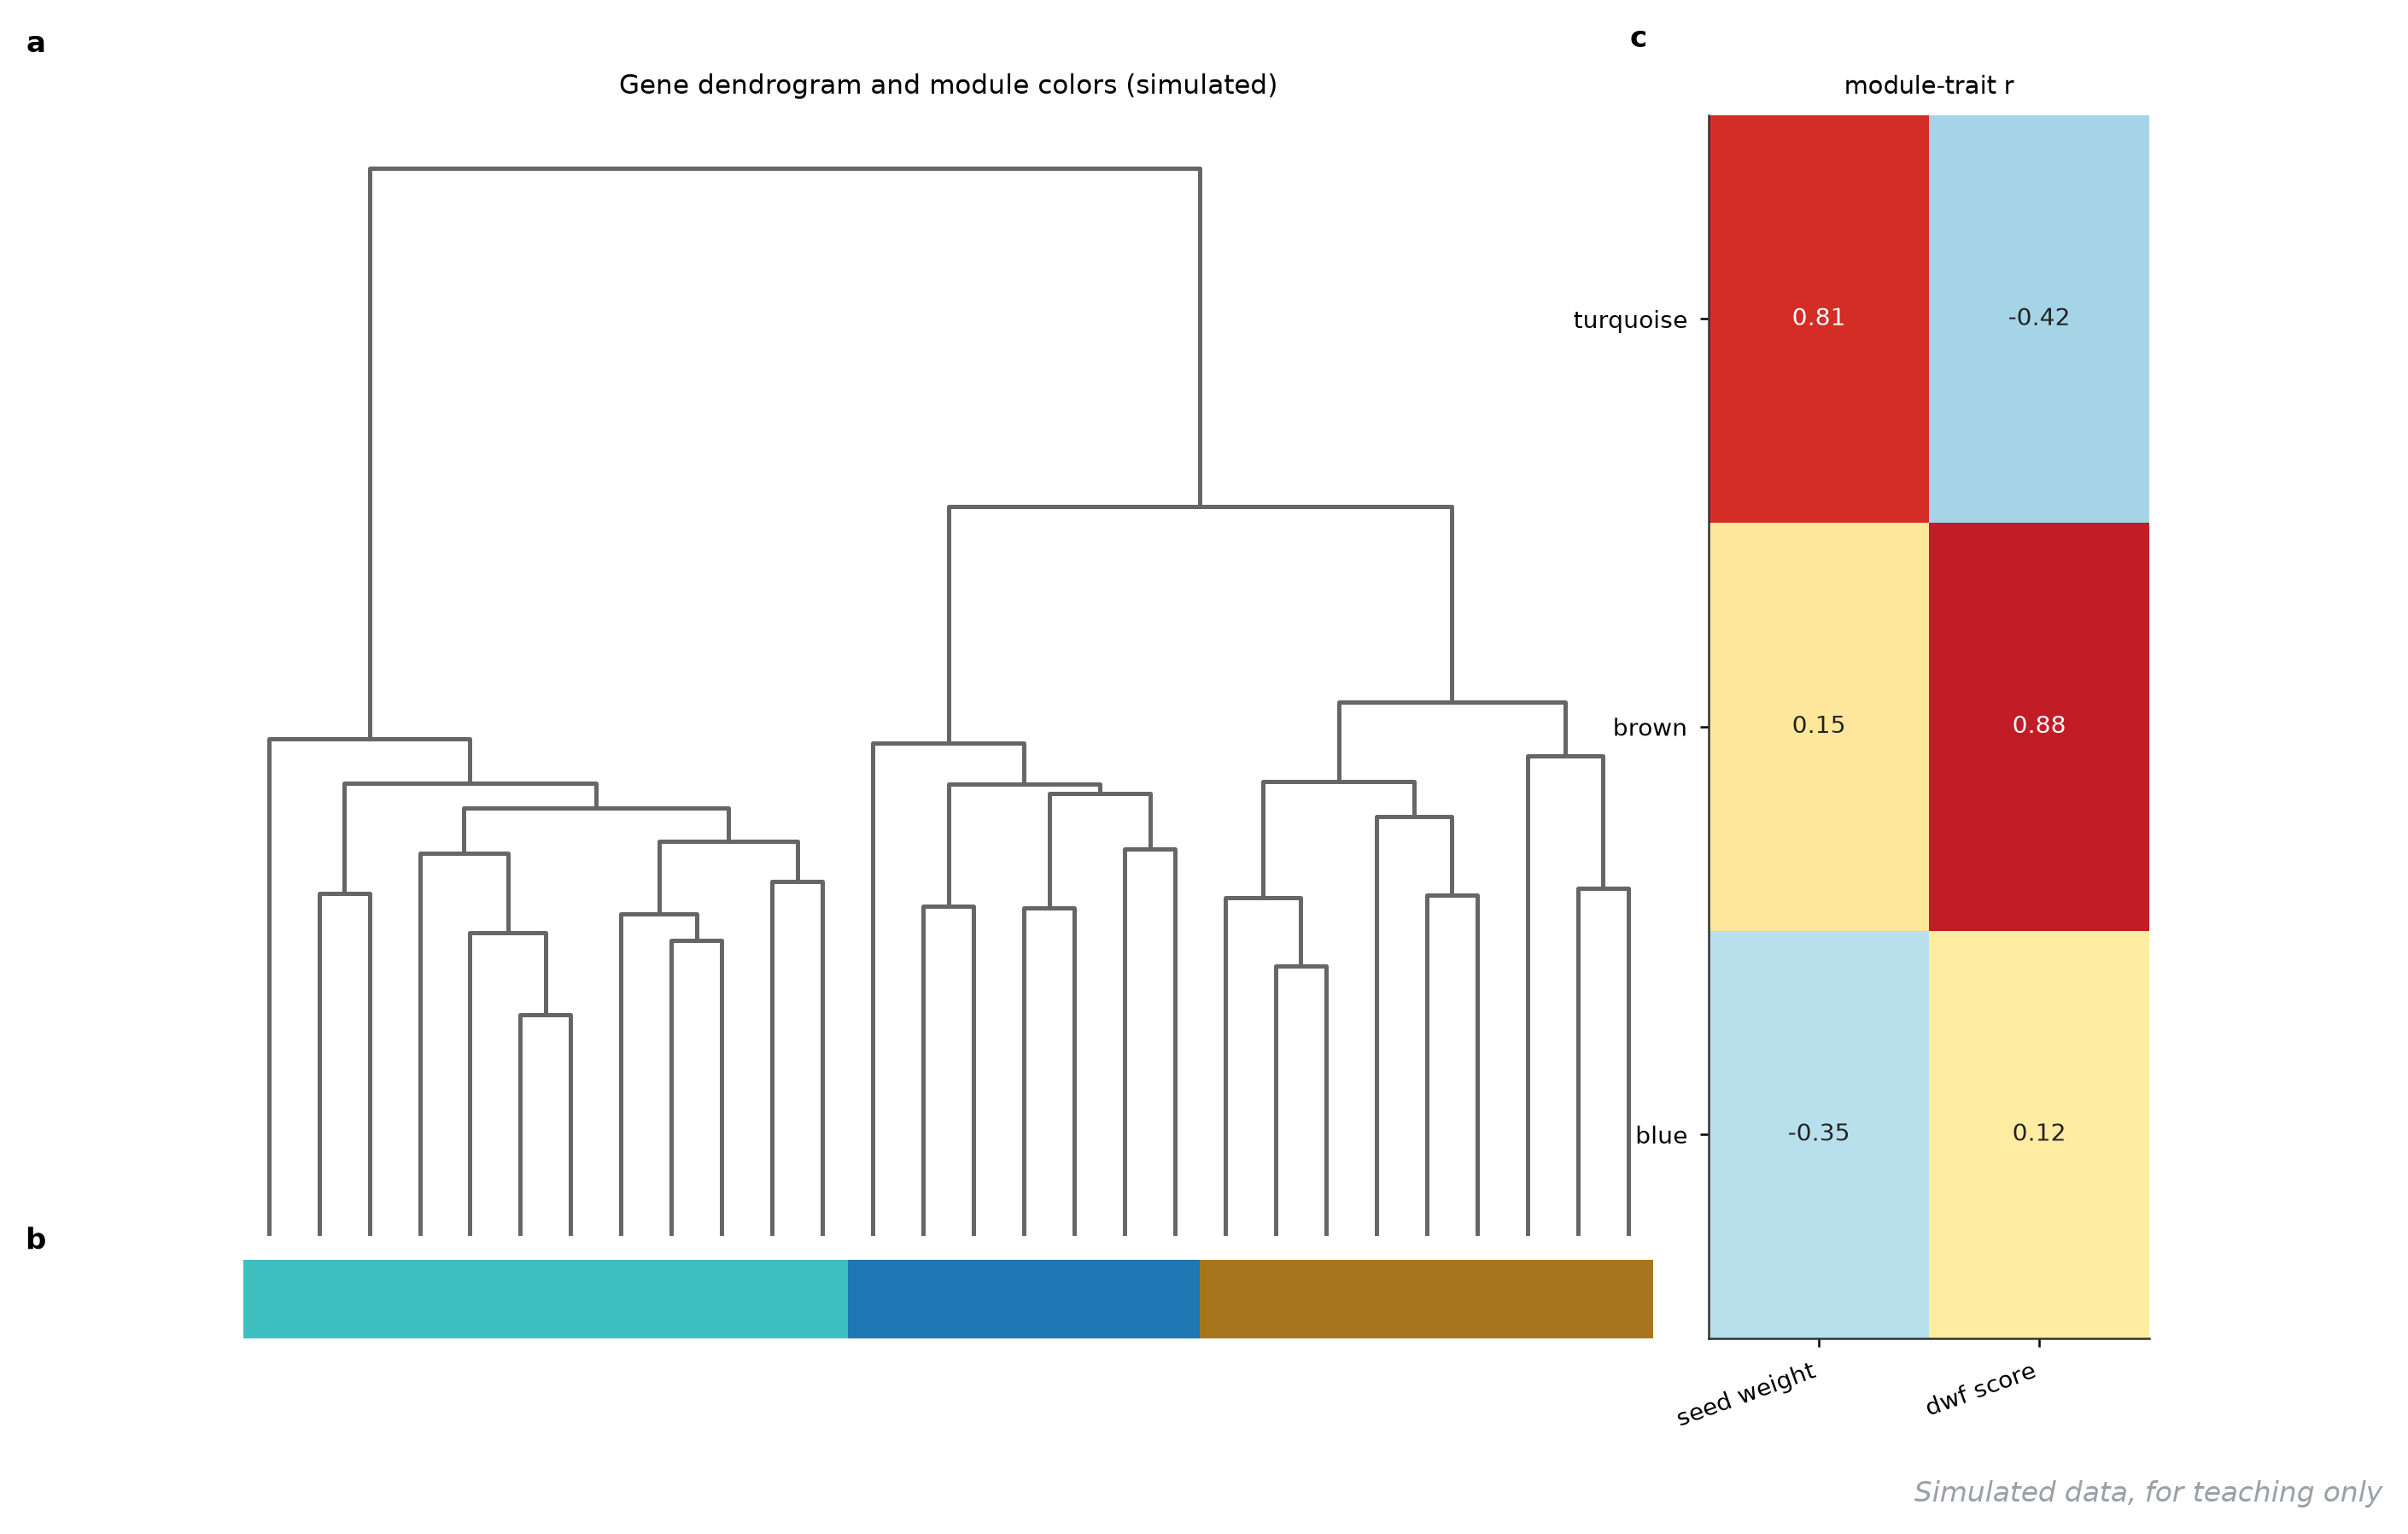
它回答什么问题:共表达基因怎么自动归模块、哪个模块和性状走最近——第二篇的模块-性状热图(图 62)只是这张图的右下角,这里把聚类树和模块色带也装上,才是 WGCNA 的完整输出。
怎么读:左上是 28 个基因的层次聚类树:枝先合的地方表达模式越像。树正下方一条色带按叶子顺序给模块上色(turquoise 12 个、brown 9 个、blue 7 个)——色带颜色与树枝断开的位置必须对齐,对不齐就是 cutHeight 设错了。右侧 3×2 热图是模块特征值与性状的相关 r:turquoise 与粒重 r = 0.81、brown 与矮秆评分 r = 0.88,这两个模块就是各自性状的候选基因库,下一步提取模块内 hub 基因做验证。
用什么画:WGCNA 流程原生输出(plotDendroAndColors);重绘用 scipy 树+色带+小热图三栏拼装。
图注示例:
图 95 28 个候选基因的 WGCNA 聚类树、模块色带与性状关联(模拟)。聚类树按平均表达相关分层,色带为三个模块;右侧为模块特征值与性状的 Pearson r,turquoise 模块与粒重(r = 0.81)、brown 模块与矮秆评分(r = 0.88)显著相关。
展开查看:模块归属与绘图代码
gene,module
g1,turquoise
g2,turquoise
g3,turquoise
g4,turquoise
g5,turquoise
g6,turquoise
g7,turquoise
g8,turquoise
g9,turquoise
g10,turquoise
g11,turquoise
g12,turquoise
g13,brown
g14,brown
g15,brown
g16,brown
g17,brown
g18,brown
g19,brown
g20,brown
g21,brown
g22,blue
g23,blue
g24,blue
g25,blue
g26,blue
g27,blue
g28,blue绘图代码(Python,独立可运行;表达矩阵由代码生成)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import linkage, dendrogram

mods = pd.read_csv("95-wgcna-modules.csv")
rng = np.random.default_rng(2095)
n = len(mods)
base = rng.normal(0, 1, (n, 12))
for sl, add in [(slice(0, 12), 2.2), (slice(12, 21), -1.8),
                (slice(21, 28), 0.9)]:
    base[sl] += add * rng.normal(0, 1, (1, 12))
Z = linkage(base, "average")
mcol = {"turquoise": "#40BFC0", "brown": "#A6761D", "blue": "#1F77B4"}
fig = plt.figure(figsize=(9.6, 6.2))
gs = fig.add_gridspec(2, 2, width_ratios=[3.2, 1],
                      height_ratios=[4, 0.28], hspace=0.04, wspace=0.06)
axd = fig.add_subplot(gs[0, 0])
dn = dendrogram(Z, ax=axd, no_labels=True, color_threshold=0,
                above_threshold_color="0.4",
                link_color_func=lambda k: "0.4")
axd.axis("off")
axd.set_title("Gene dendrogram and module colors (simulated)")
axm = fig.add_subplot(gs[1, 0])
for li, gi in enumerate(dn["leaves"]):
    axm.bar(li * 10 + 5, 1, width=10, color=mcol[mods.module[gi]])
axm.set_xlim(axd.get_xlim())
axm.set_ylim(0, 1)
axm.axis("off")
axt = fig.add_subplot(gs[0:2, 1])
R = np.array([[0.81, -0.42], [0.15, 0.88], [-0.35, 0.12]])
axt.imshow(R, cmap="RdYlBu_r", vmin=-1, vmax=1, aspect="auto")
axt.set_xticks(range(2), ["seed weight", "dwf score"], rotation=20,
               ha="right", fontsize=8.5)
axt.set_yticks(range(3), ["turquoise", "brown", "blue"], fontsize=8.5)
for i in range(3):
    for j in range(2):
        axt.text(j, i, "%.2f" % R[i, j], ha="center", va="center",
                 fontsize=8.5, color="white" if abs(R[i, j]) > 0.6 else "#222")
axt.set_title("module-trait r", fontsize=9)
fig.savefig("95-wgcna-tree.png", dpi=200, bbox_inches="tight")6.5 DNA 甲基化三语境柱状图#
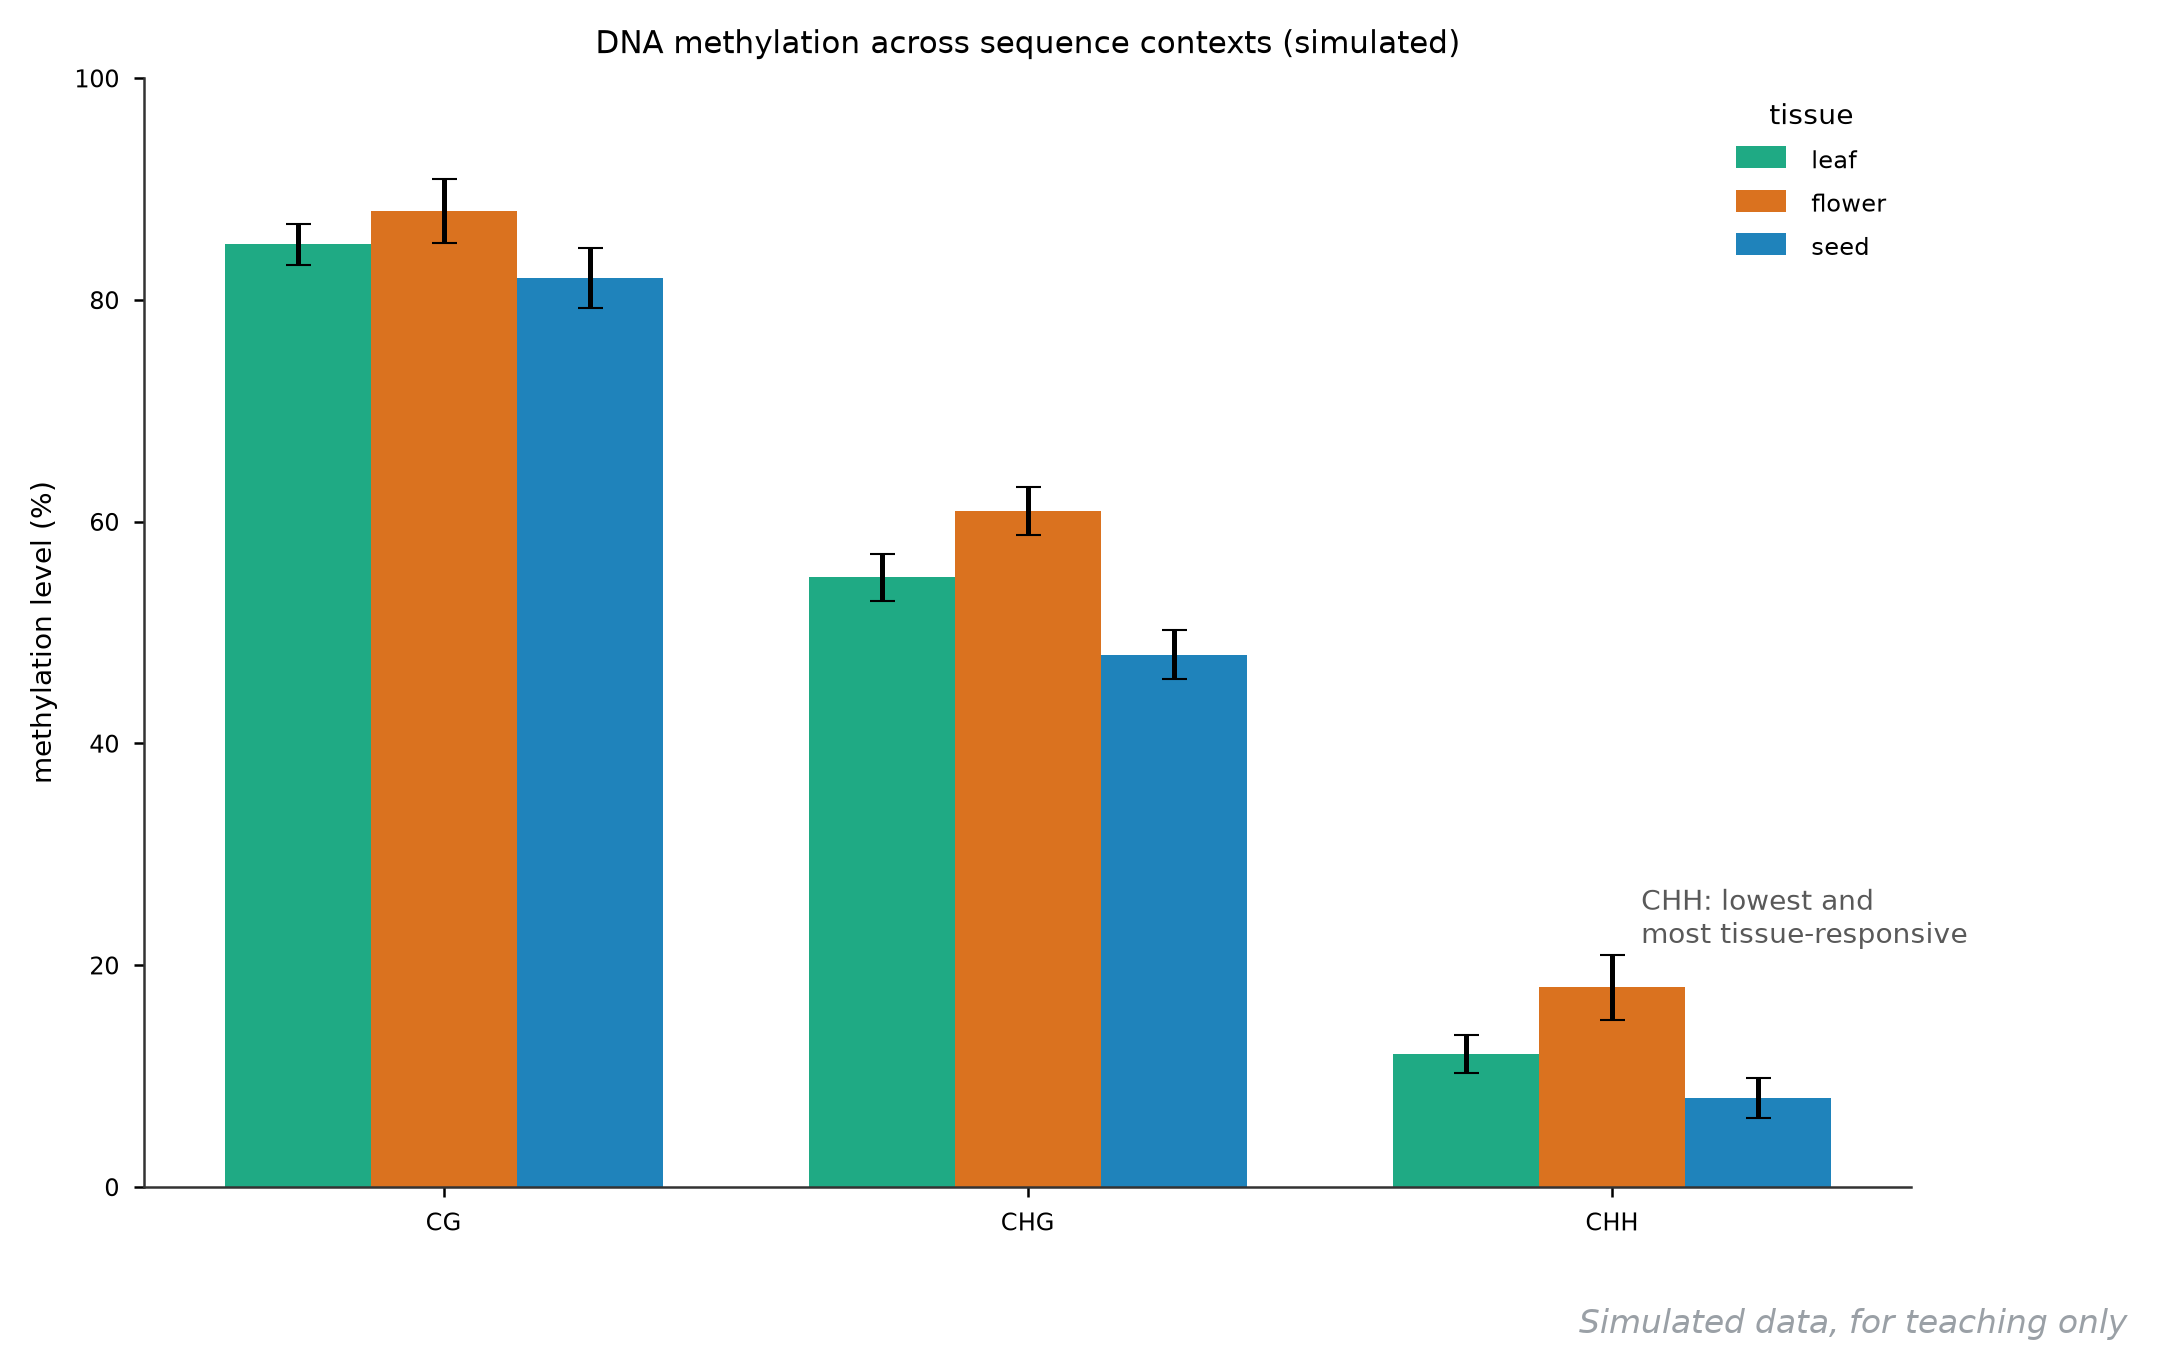
它回答什么问题:全基因组甲基化在 CG、CHG、CHH 三种序列语境下各是什么水平——植物表观组的第一句话,三语境的比例结构是植物独有的故事(动物几乎只有 CG)。
怎么读:三组柱对应三种语境,组内三根柱是三种组织。读出植物 methylome 的标准句式:CG 最高且组织间稳定(82-88%),由 MET1 维持;CHG 居中(48-61%),CMT3 负责;CHH 最低(8-18%)但对组织最敏感——本例花中 18%、种子里只有 8%,CHH 波动往往对应小 RNA 通路和转座子活性,是文章里最爱写的「动态语境」。误差线来自生物学重复,三语境必须同图而非拆成三张,否则比例感全无。
用什么画:Bismark 加 methylKit 统计,绘图就是分组柱状图。
图注示例:
图 96 叶、花、种子三个组织的 CG/CHG/CHH 甲基化水平(模拟)。误差线为生物学重复标准差;CG 最高且稳定(82-88%),CHH 最低且组织间波动最大(8-18%)。
展开查看:数据与绘图代码
context,tissue,meth_pct
CG,leaf,85
CG,flower,88
CG,seed,82
CHG,leaf,55
CHG,flower,61
CHG,seed,48
CHH,leaf,12
CHH,flower,18
CHH,seed,8绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("96-methylation.csv")
contexts = ["CG", "CHG", "CHH"]
tissues = ["leaf", "flower", "seed"]
CAT = ["#55A868", "#DD8452", "#4C72B0"]
rng = np.random.default_rng(2096)
x = np.arange(3)
w = 0.25
fig, ax = plt.subplots(figsize=(7.6, 4.8))
for k, (t, col) in enumerate(zip(tissues, CAT)):
    v = [df[(df.context == c) & (df.tissue == t)].meth_pct.iloc[0]
         for c in contexts]
    ax.bar(x + (k - 1) * w, v, width=w, color=col, alpha=0.88, label=t,
           yerr=rng.uniform(1.5, 3.0, 3), capsize=3)
ax.set_xticks(x, contexts)
ax.set_ylabel("methylation level (%)")
ax.set_ylim(0, 100)
ax.legend(title="tissue")
ax.set_title("DNA methylation across sequence contexts (simulated)")
ax.text(2.05, 22, "CHH: lowest and\nmost tissue-responsive", fontsize=8.5,
        color="0.35")
fig.savefig("96-methylation.png", dpi=200, bbox_inches="tight")6.6 Hi-C 接触热图#
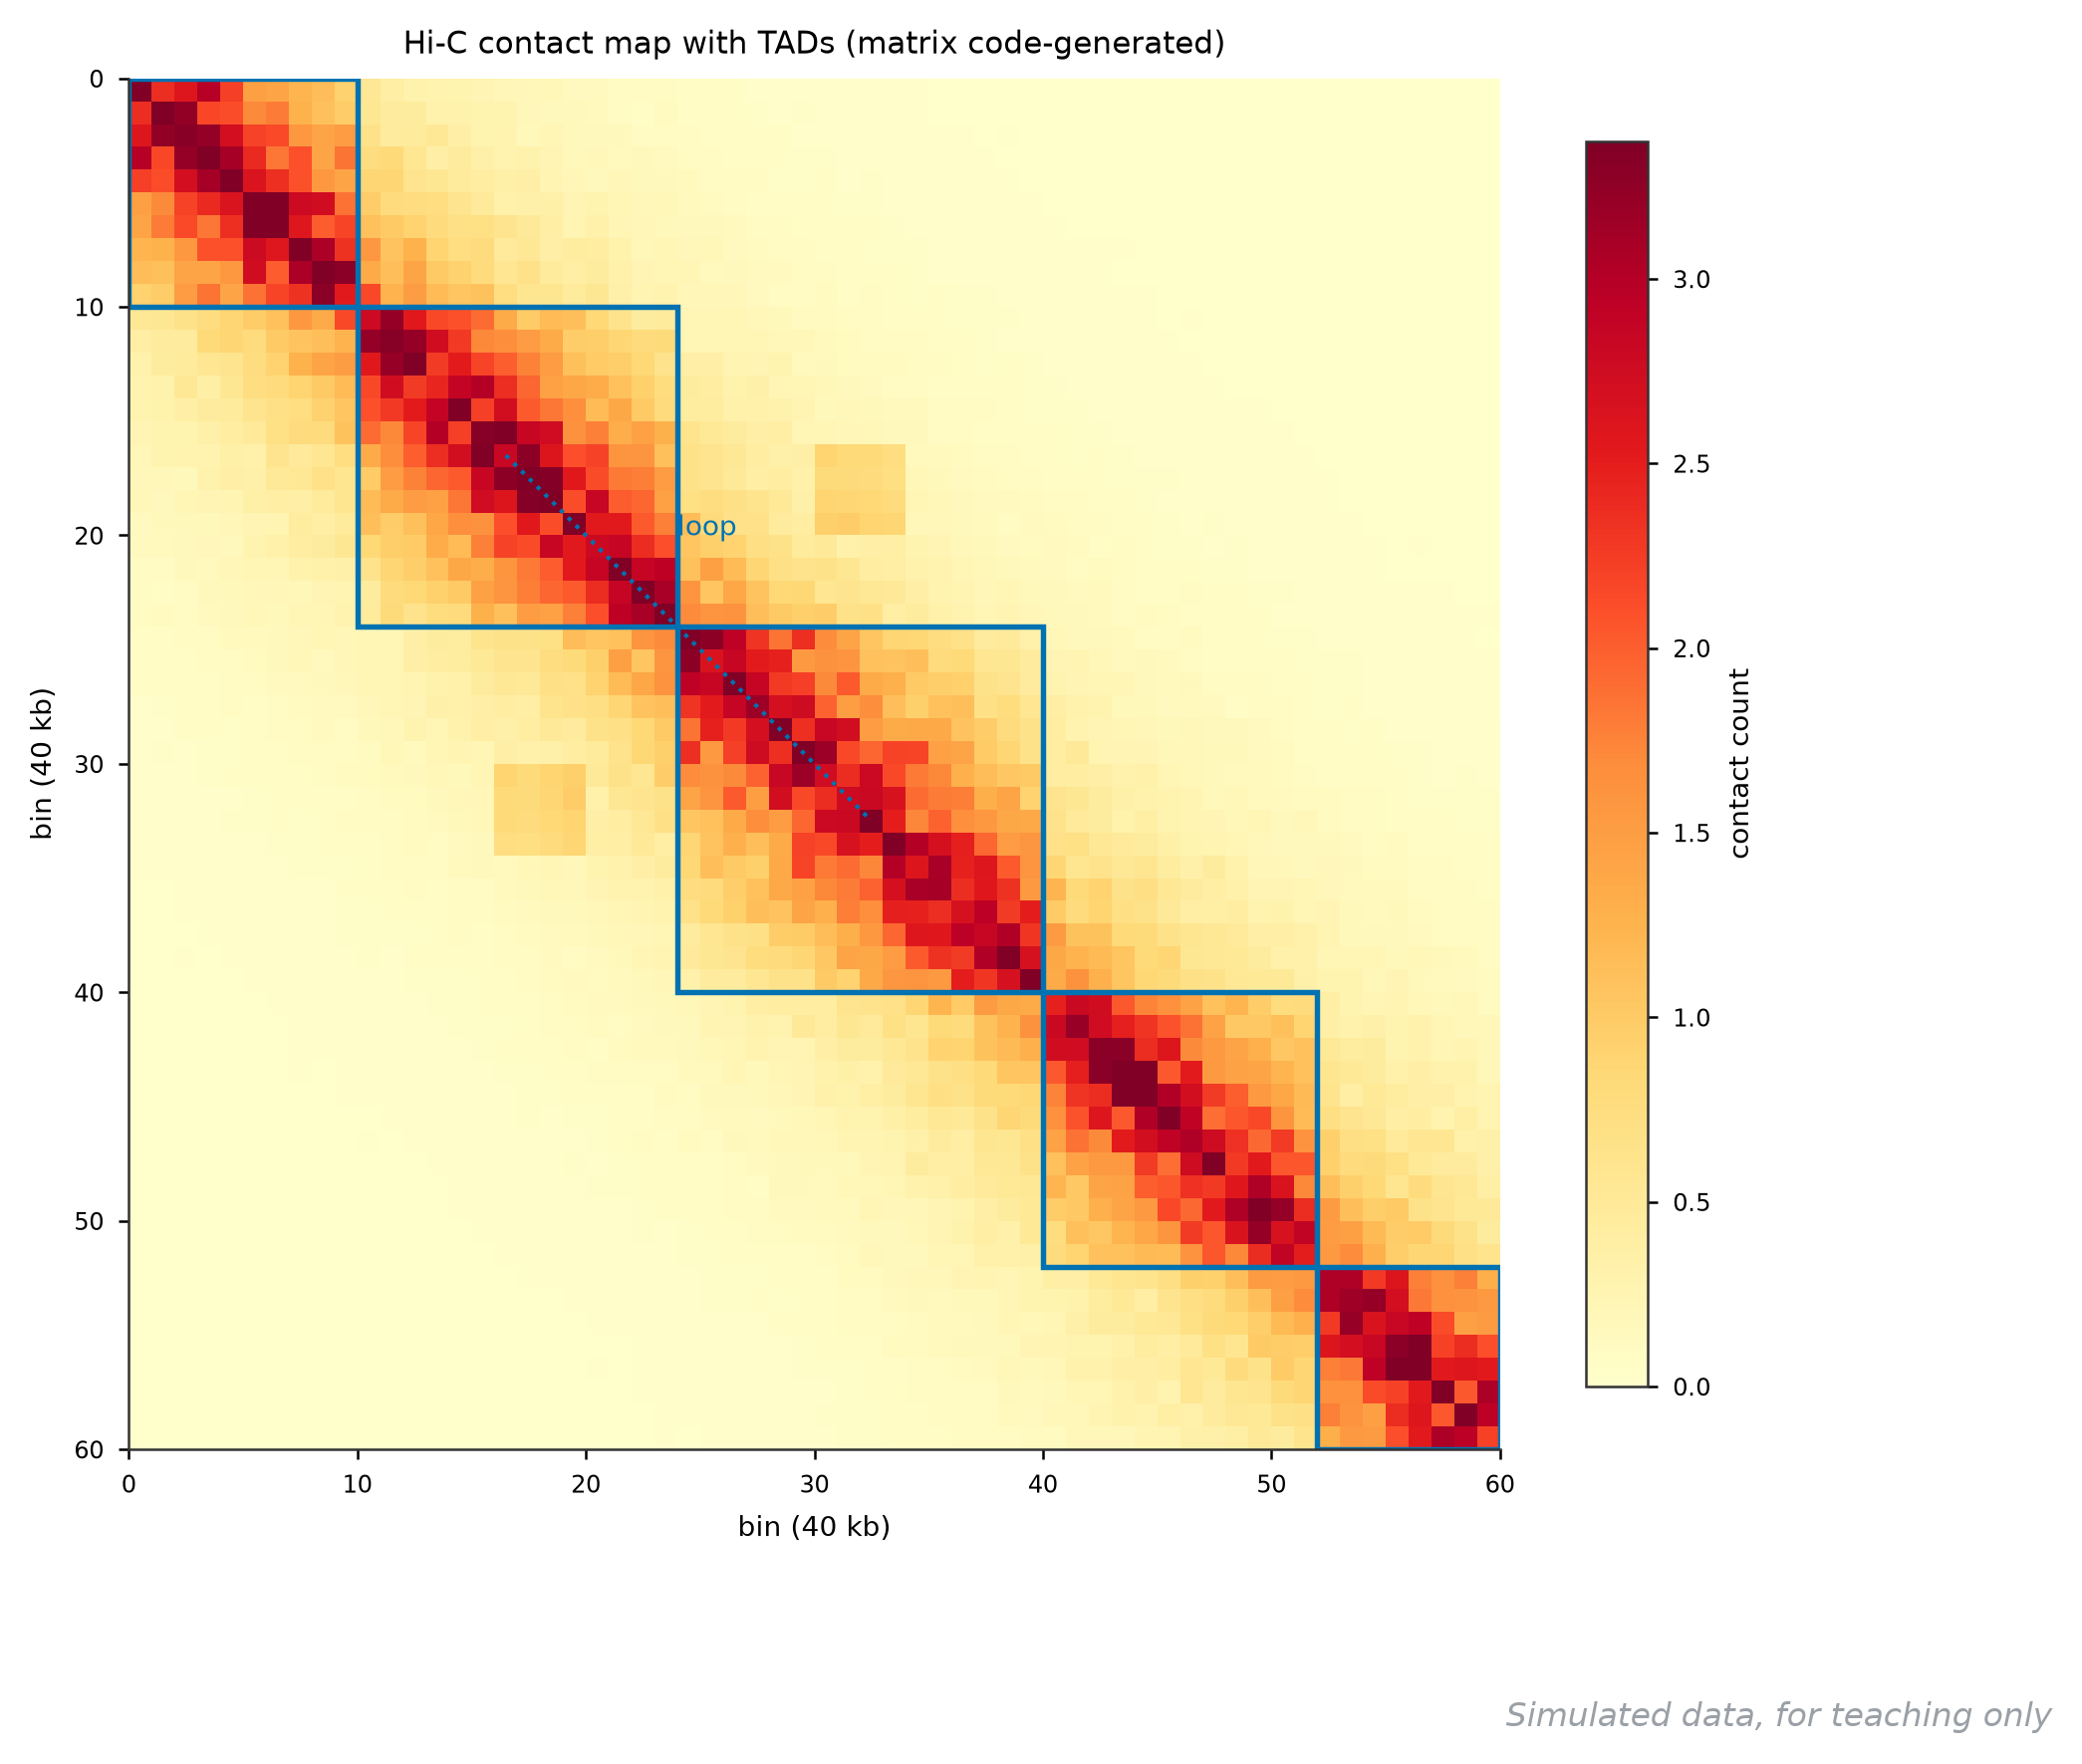
它回答什么问题:染色质在细胞核里怎么折叠——接触热图是 Hi-C 的一切:基因组组装挂载、TAD 边界、增强子-启动子环,全部从这张对角线图上读出来。
怎么读:60×60 矩阵,颜色是两个 bin 的染色质接触频率,越红越接触。基本语法:沿对角线的亮带=距离越近接触越多;蓝色方框标出的对角块是 TAD(拓扑结构域),块内接触显著高于块间;对角线之外的孤立亮点(bin 16 与 32 之间)是增强子-启动子环。读组装质量时看对角线外的「异常热块」:那是错误挂接的信号。
用什么画:Juicer/Juicebox、HiC-Pro;重绘按矩阵 imshow 加 TAD 框。
图注示例:
图 97 染色体区段 2.4 Mb 的 Hi-C 接触热图(40 kb bin,模拟)。蓝色方框为五个 TAD(区间见表内坐标),对角亮带为顺式接触衰减;bin 16-32 之间的孤立亮点为候选染色质环。
展开查看:TAD 区间与绘图代码
tad,start_bin,end_bin
TAD1,0,9
TAD2,10,23
TAD3,24,39
TAD4,40,51
TAD5,52,59绘图代码(Python,独立可运行;接触矩阵由代码生成)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

tads = pd.read_csv("97-hic-tads.csv")
rng = np.random.default_rng(2097)
n = 60
ii, jj = np.meshgrid(np.arange(n), np.arange(n), indexing="ij")
M = np.exp(-np.abs(ii - jj) / 7.0) * rng.lognormal(0, 0.18, (n, n))
for _, r in tads.iterrows():
    a, b = int(r.start_bin), int(r.end_bin)
    M[a:b + 1, a:b + 1] *= 1.65
M[16:20, 30:34] += 0.28
M[30:34, 16:20] += 0.28
M = np.clip(M + M.T, 0, None)
fig, ax = plt.subplots(figsize=(7.4, 6.6))
im = ax.imshow(M, cmap="YlOrRd", origin="upper", extent=[0, n, n, 0],
               vmin=0, vmax=np.percentile(M, 99))
for _, r in tads.iterrows():
    a, b = int(r.start_bin), int(r.end_bin)
    ax.add_patch(plt.Rectangle((a, a), b - a + 1, b - a + 1, fill=False,
                               edgecolor="#4C72B0", lw=1.3))
ax.plot([16.5, 32.5], [16.5, 32.5], color="#4C72B0", ls=":", lw=1)
ax.text(24, 20, "loop", fontsize=8.5, color="#4C72B0")
ax.set_xlabel("bin (40 kb)")
ax.set_ylabel("bin (40 kb)")
ax.set_title("Hi-C contact map with TADs (matrix code-generated)")
fig.colorbar(im, ax=ax, shrink=0.82, label="contact count")
fig.savefig("97-hic.png", dpi=200, bbox_inches="tight")七、单细胞与细胞通讯#
7.1 RNA velocity 相图#
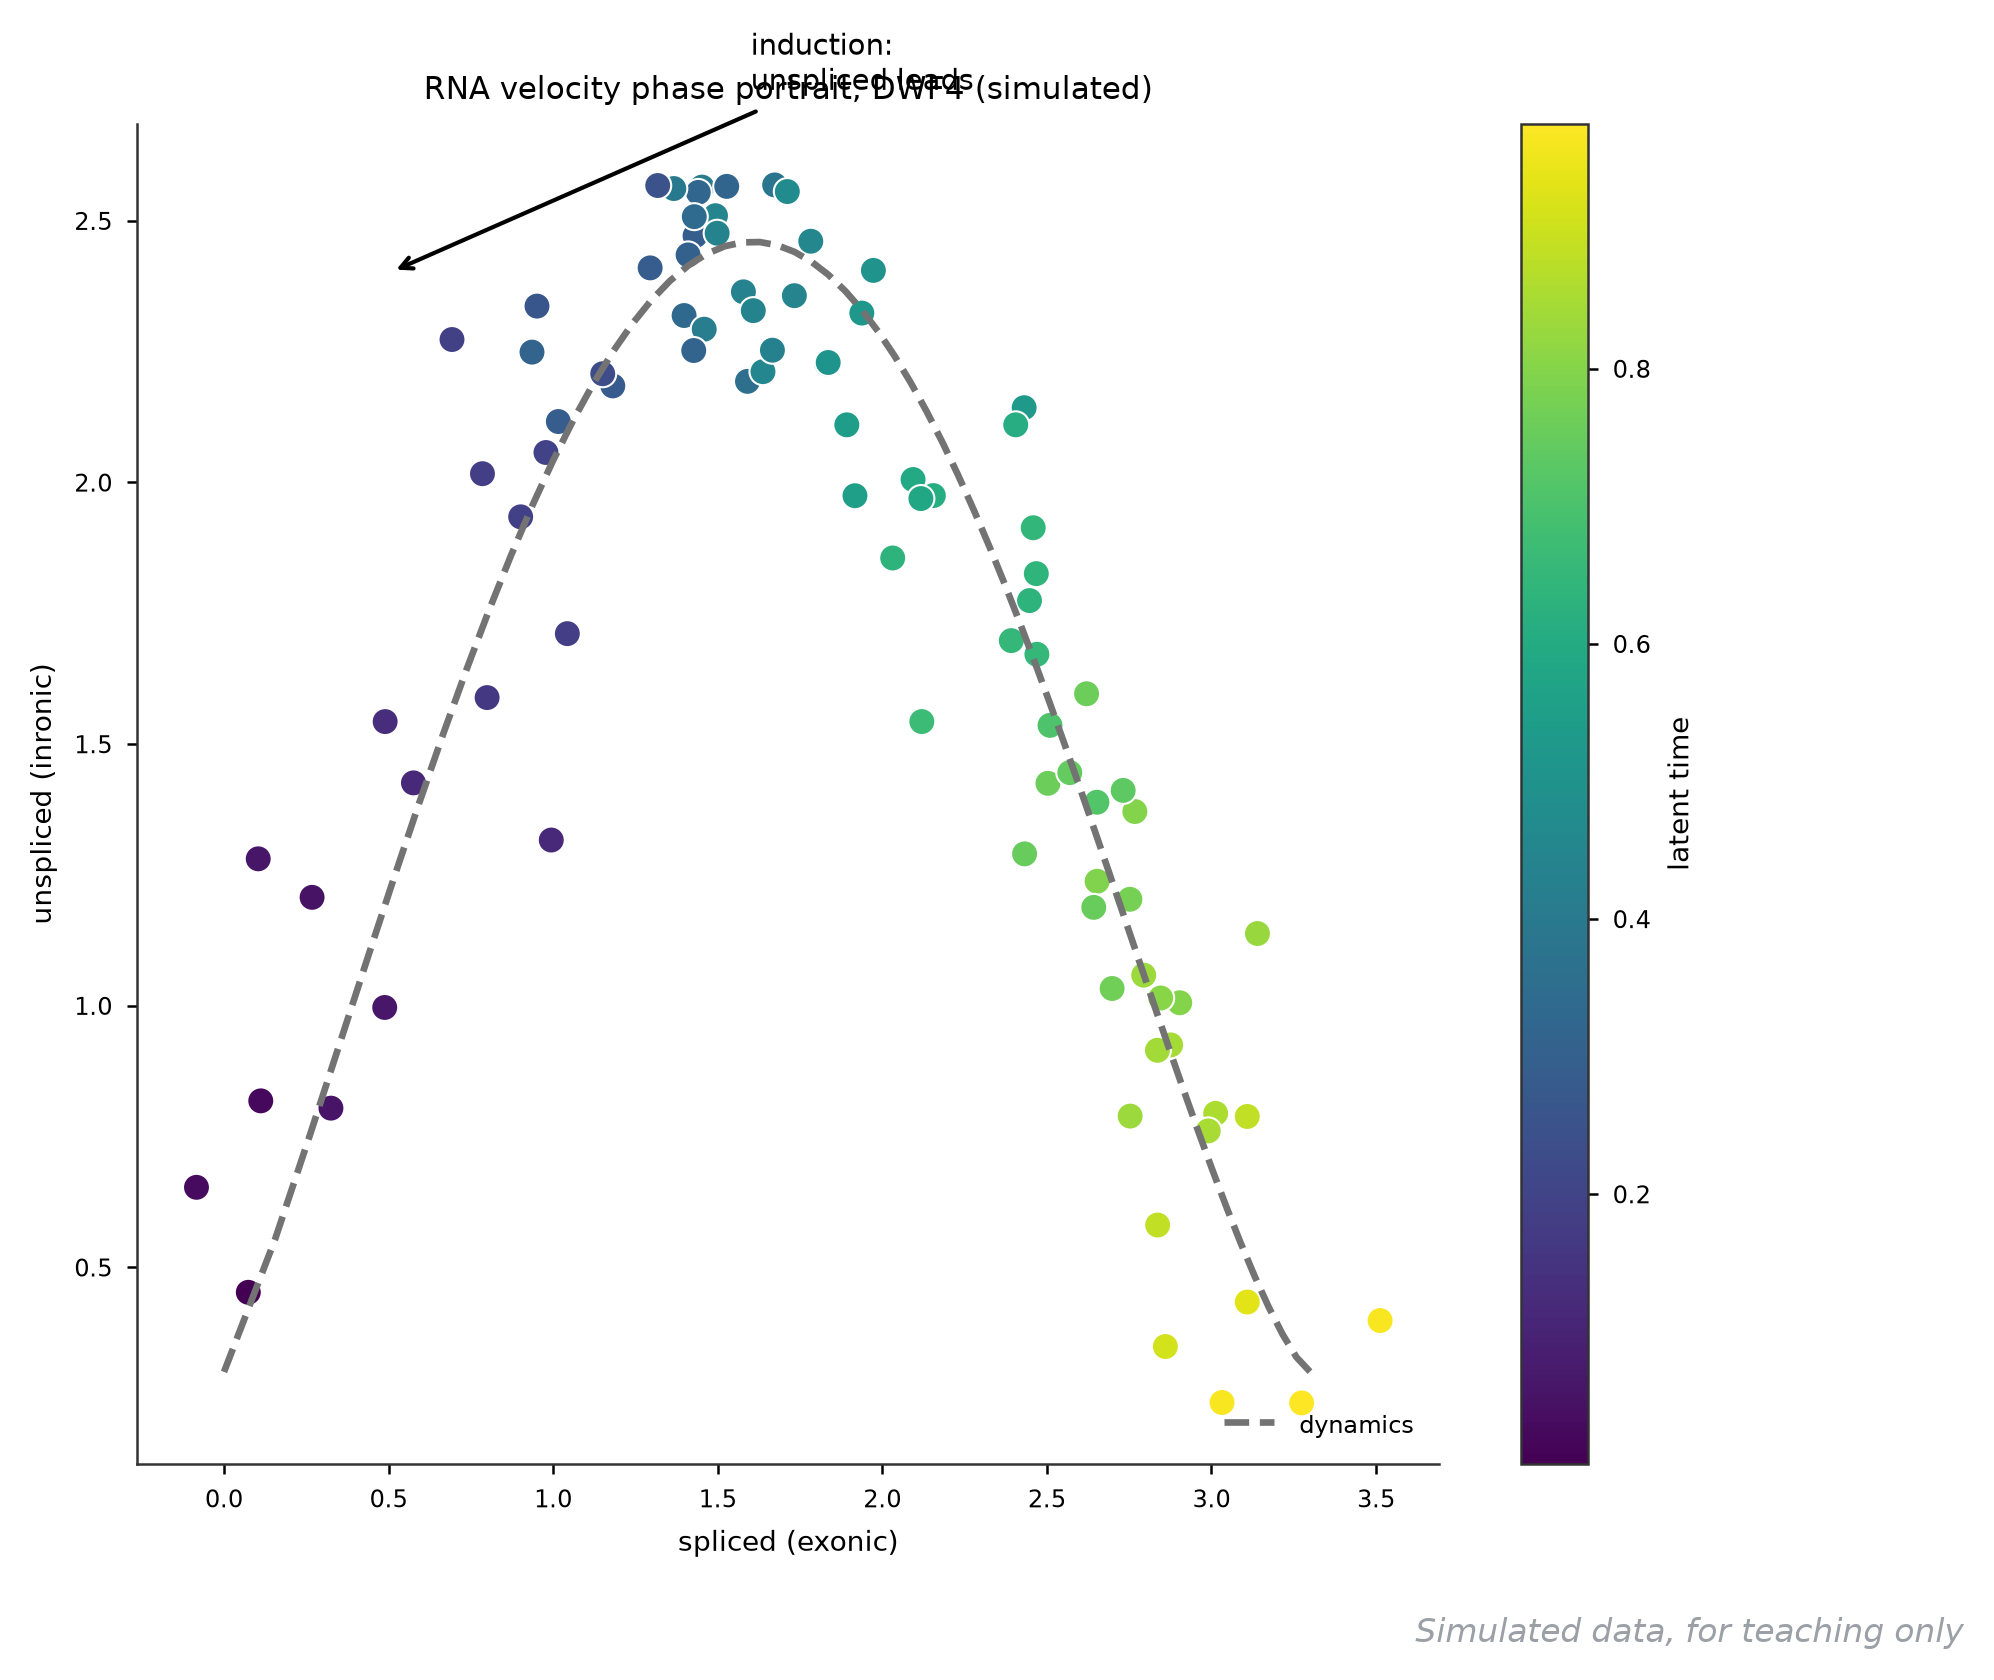
它回答什么问题:这个基因此刻在被上调还是下调——velocity 用外显子(spliced)与内含子(unspliced)读数的时滞关系推「基因的未来」,相图是理解它的入门图。
怎么读:横轴 spliced、纵轴 unspliced,每个点一个细胞,颜色是推断的潜在时间。读相图的口诀是「逆时针走一圈」:诱导早期 unspliced 先涨(点在左上)、中期两者齐升、晚期 spliced 到平台而 unspliced 泄回(点滑向右下)。虚线是动力学的稳态轨迹;落在斜率线左上方的细胞群体意味着该基因正被诱导。相图看单基因,全基因组的 velocity 场再投影回 UMAP 才是流线图。
用什么画:scVelo 的 scv.pl.velocity_graph;单基因相图直接对 spliced/unspliced 列散点。
图注示例:
图 98 DWF4 在 90 个根尖细胞的 RNA velocity 相图(模拟)。横轴 spliced、纵轴 unspliced,颜色为潜在时间;虚线为动力学轨迹,细胞沿诱导弧线逆时针推进。
展开查看:完整绘图代码(含数据生成)
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(2098)
t = rng.uniform(0, 1, 90)
u = np.clip(2.6 * np.sin(np.pi * t ** 0.85) * (1 - t) ** 0.35
            + rng.normal(0, 0.14, 90) + 0.3, 0, None)
s = 3.3 * t ** 0.75 + rng.normal(0, 0.16, 90)
fig, ax = plt.subplots(figsize=(7.0, 5.8))
sc = ax.scatter(s, u, c=t, cmap="viridis", s=42, edgecolors="white",
                linewidths=0.5)
tt = np.linspace(0, 1, 60)
ax.plot(3.3 * tt ** 0.75,
        np.clip(2.6 * np.sin(np.pi * tt ** 0.85) * (1 - tt) ** 0.35 + 0.3,
                0, None), ls="--", color="0.45", lw=1.6, label="dynamics")
ax.annotate("induction:\nunspliced leads", (0.5, 2.4), (1.6, 2.75),
            fontsize=9, arrowprops=dict(arrowstyle="->", lw=1))
fig.colorbar(sc, ax=ax, label="latent time")
ax.set_xlabel("spliced (exonic)")
ax.set_ylabel("unspliced (inronic)")
ax.legend(loc="lower right")
ax.set_title("RNA velocity phase portrait, DWF4 (simulated)")
fig.savefig("98-velocity.png", dpi=200, bbox_inches="tight")7.2 细胞类型组成堆叠柱#
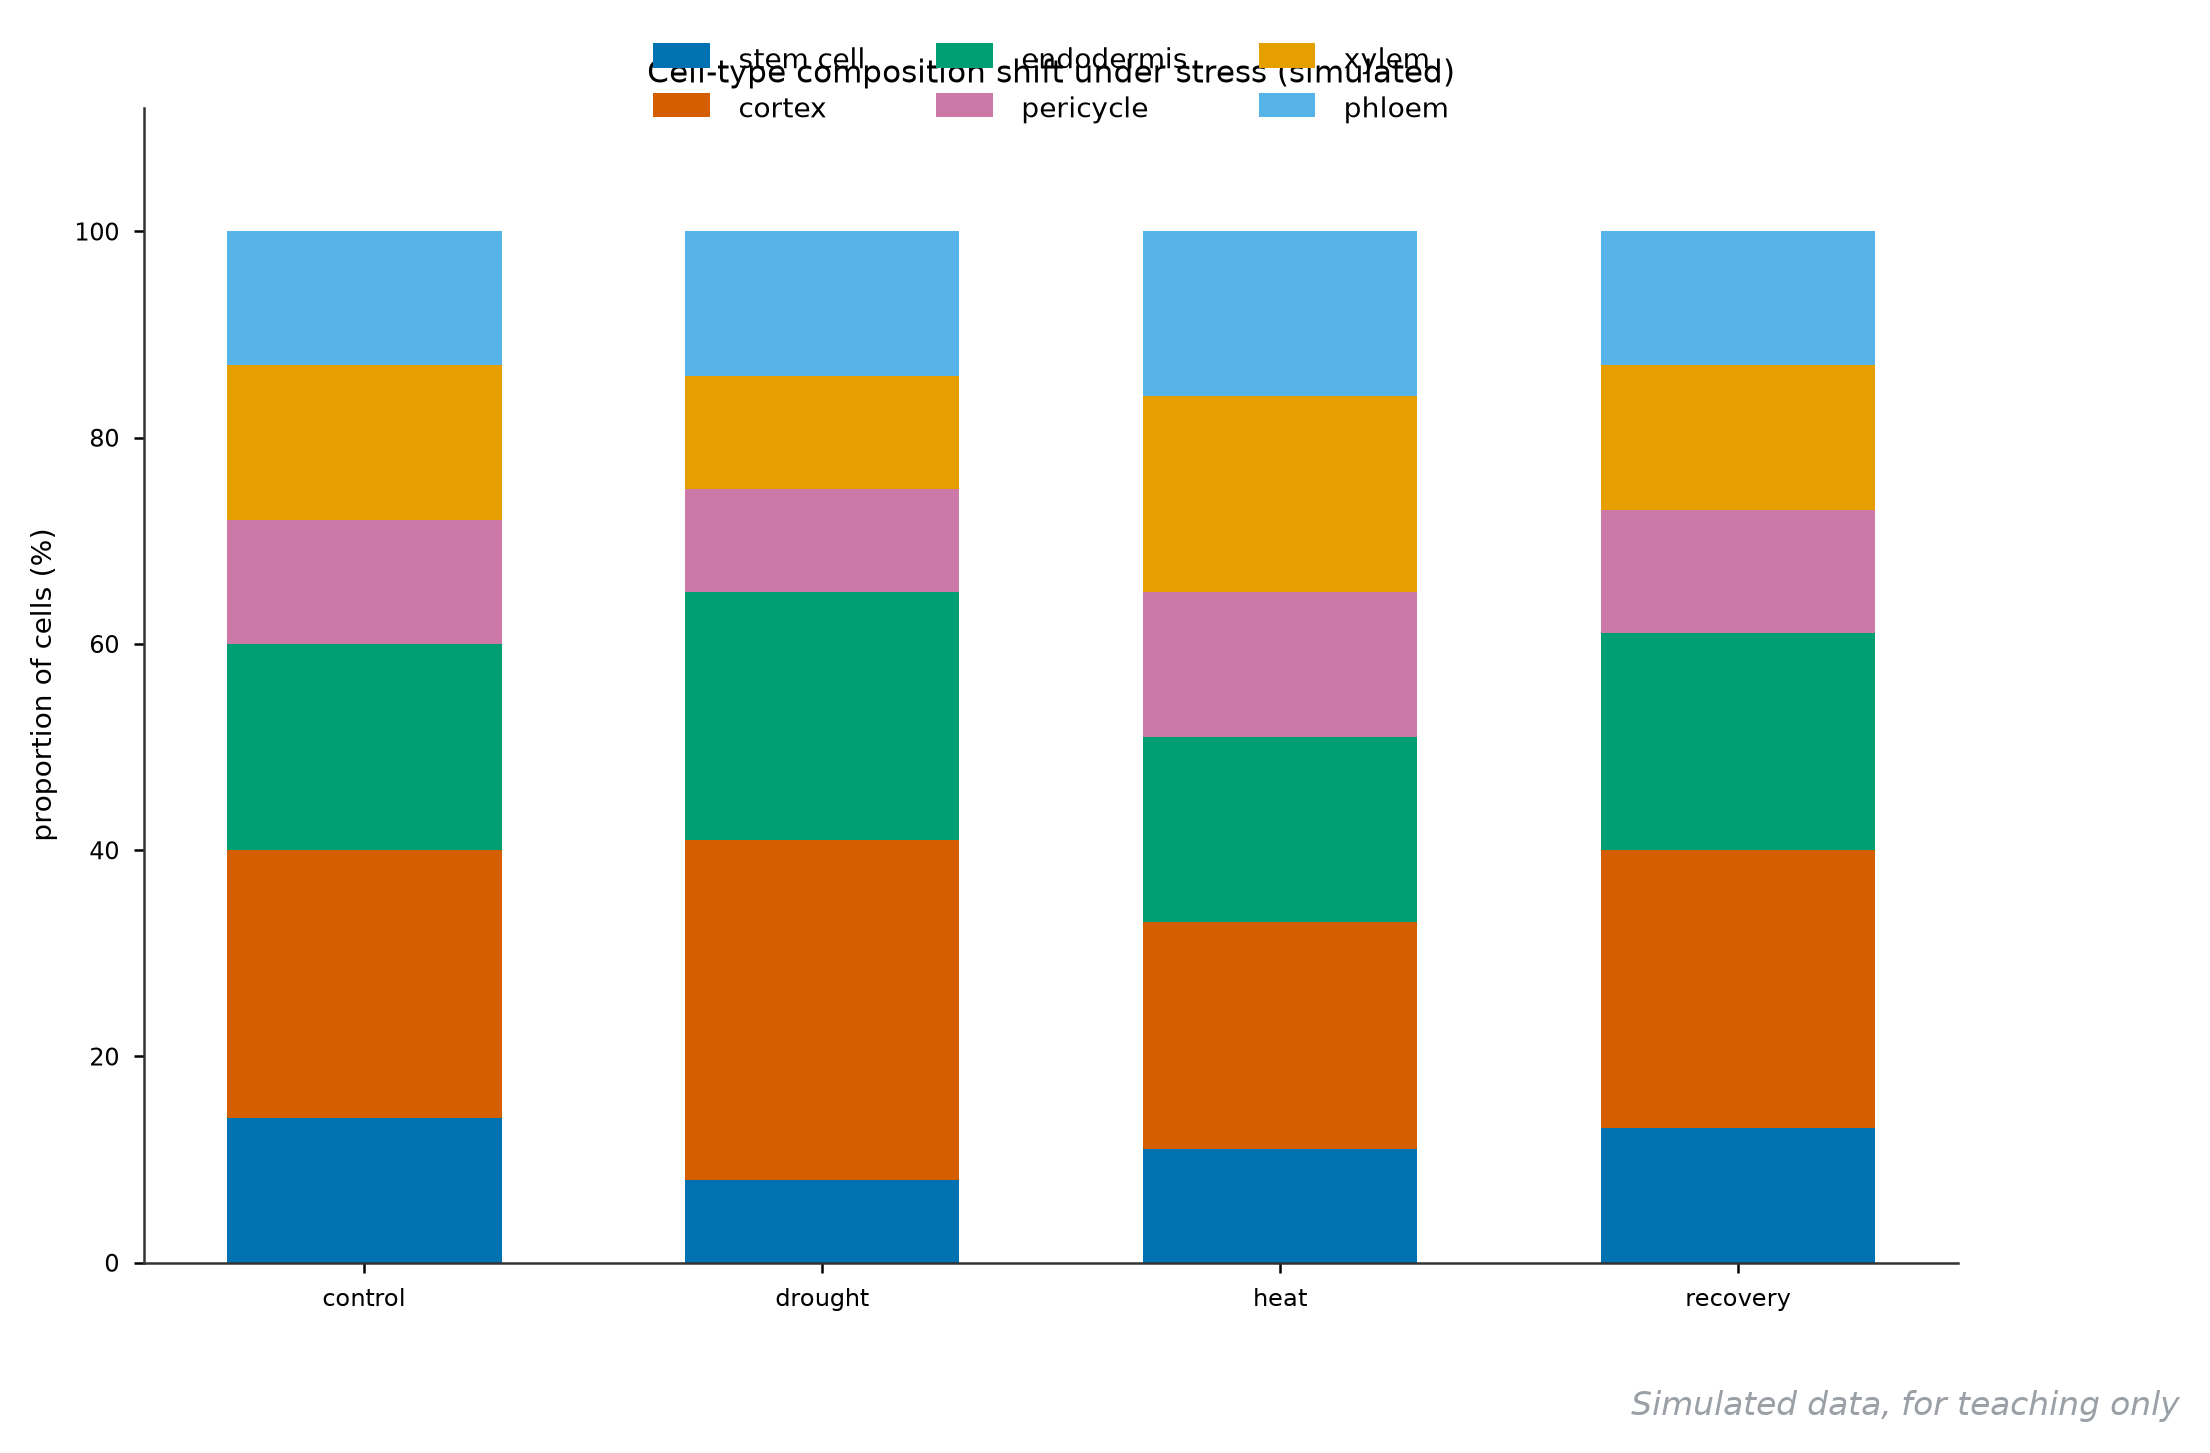
它回答什么问题:处理之后细胞类型的比例变了还是只是表达变了——单细胞文章的必答题:差异表达之前先确认「细胞普查」没有偏移。
怎么读:每根柱一个处理,颜色段是六种细胞型的占比(合计 100%)。看两样:比例真的变的类型(干旱下 stem cell 从 14% 缩到 8%、cortex 涨到 33%——分生区细胞对干旱最脆弱)和恢复组是否回到对照水平(recovery 柱与 control 几乎同构,处理效应可逆)。写结论时要配一个组成比例的显著性检验(scCODA 或卡方),光靠眼睛说「差不多」审稿人不收。
用什么画:scanpy 的 sc.pl.stacked_violin 不干这个,用 pandas 透视表加 plot.bar(stacked=True) 或 MA-scripts;重绘直接堆叠。
图注示例:
图 99 四种处理下根尖单细胞图谱的细胞类型组成(模拟,各处理约 3000 细胞)。干旱组干细胞比例由 14% 降至 8%,皮层升至 33%;恢复组组成与对照无显著差异。
展开查看:组成数据与绘图代码
condition,cell_type,pct
control,stem cell,14
control,cortex,26
control,endodermis,20
control,pericycle,12
control,xylem,15
control,phloem,13
drought,stem cell,8
drought,cortex,33
drought,endodermis,24
drought,pericycle,10
drought,xylem,11
drought,phloem,14
heat,stem cell,11
heat,cortex,22
heat,endodermis,18
heat,pericycle,14
heat,xylem,19
heat,phloem,16
recovery,stem cell,13
recovery,cortex,27
recovery,endodermis,21
recovery,pericycle,12
recovery,xylem,14
recovery,phloem,13绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("99-composition.csv")
mat = df.pivot(index="condition", columns="cell_type", values="pct")
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860"]
fig, ax = plt.subplots(figsize=(7.8, 5.0))
bottom = pd.Series(0, index=mat.index, dtype=float)
for k, c in enumerate(mat.columns):
    ax.bar(mat.index, mat[c], bottom=bottom, label=c, color=CAT[k],
           width=0.6)
    bottom = bottom + mat[c].values
ax.set_ylabel("proportion of cells (%)")
ax.set_ylim(0, 112)
ax.legend(ncol=3, fontsize=8.5, loc="upper center",
          bbox_to_anchor=(0.5, 1.08))
ax.set_title("Cell-type composition shift under stress (simulated)")
fig.savefig("99-composition.png", dpi=200, bbox_inches="tight")7.3 marker 基因分块热图#
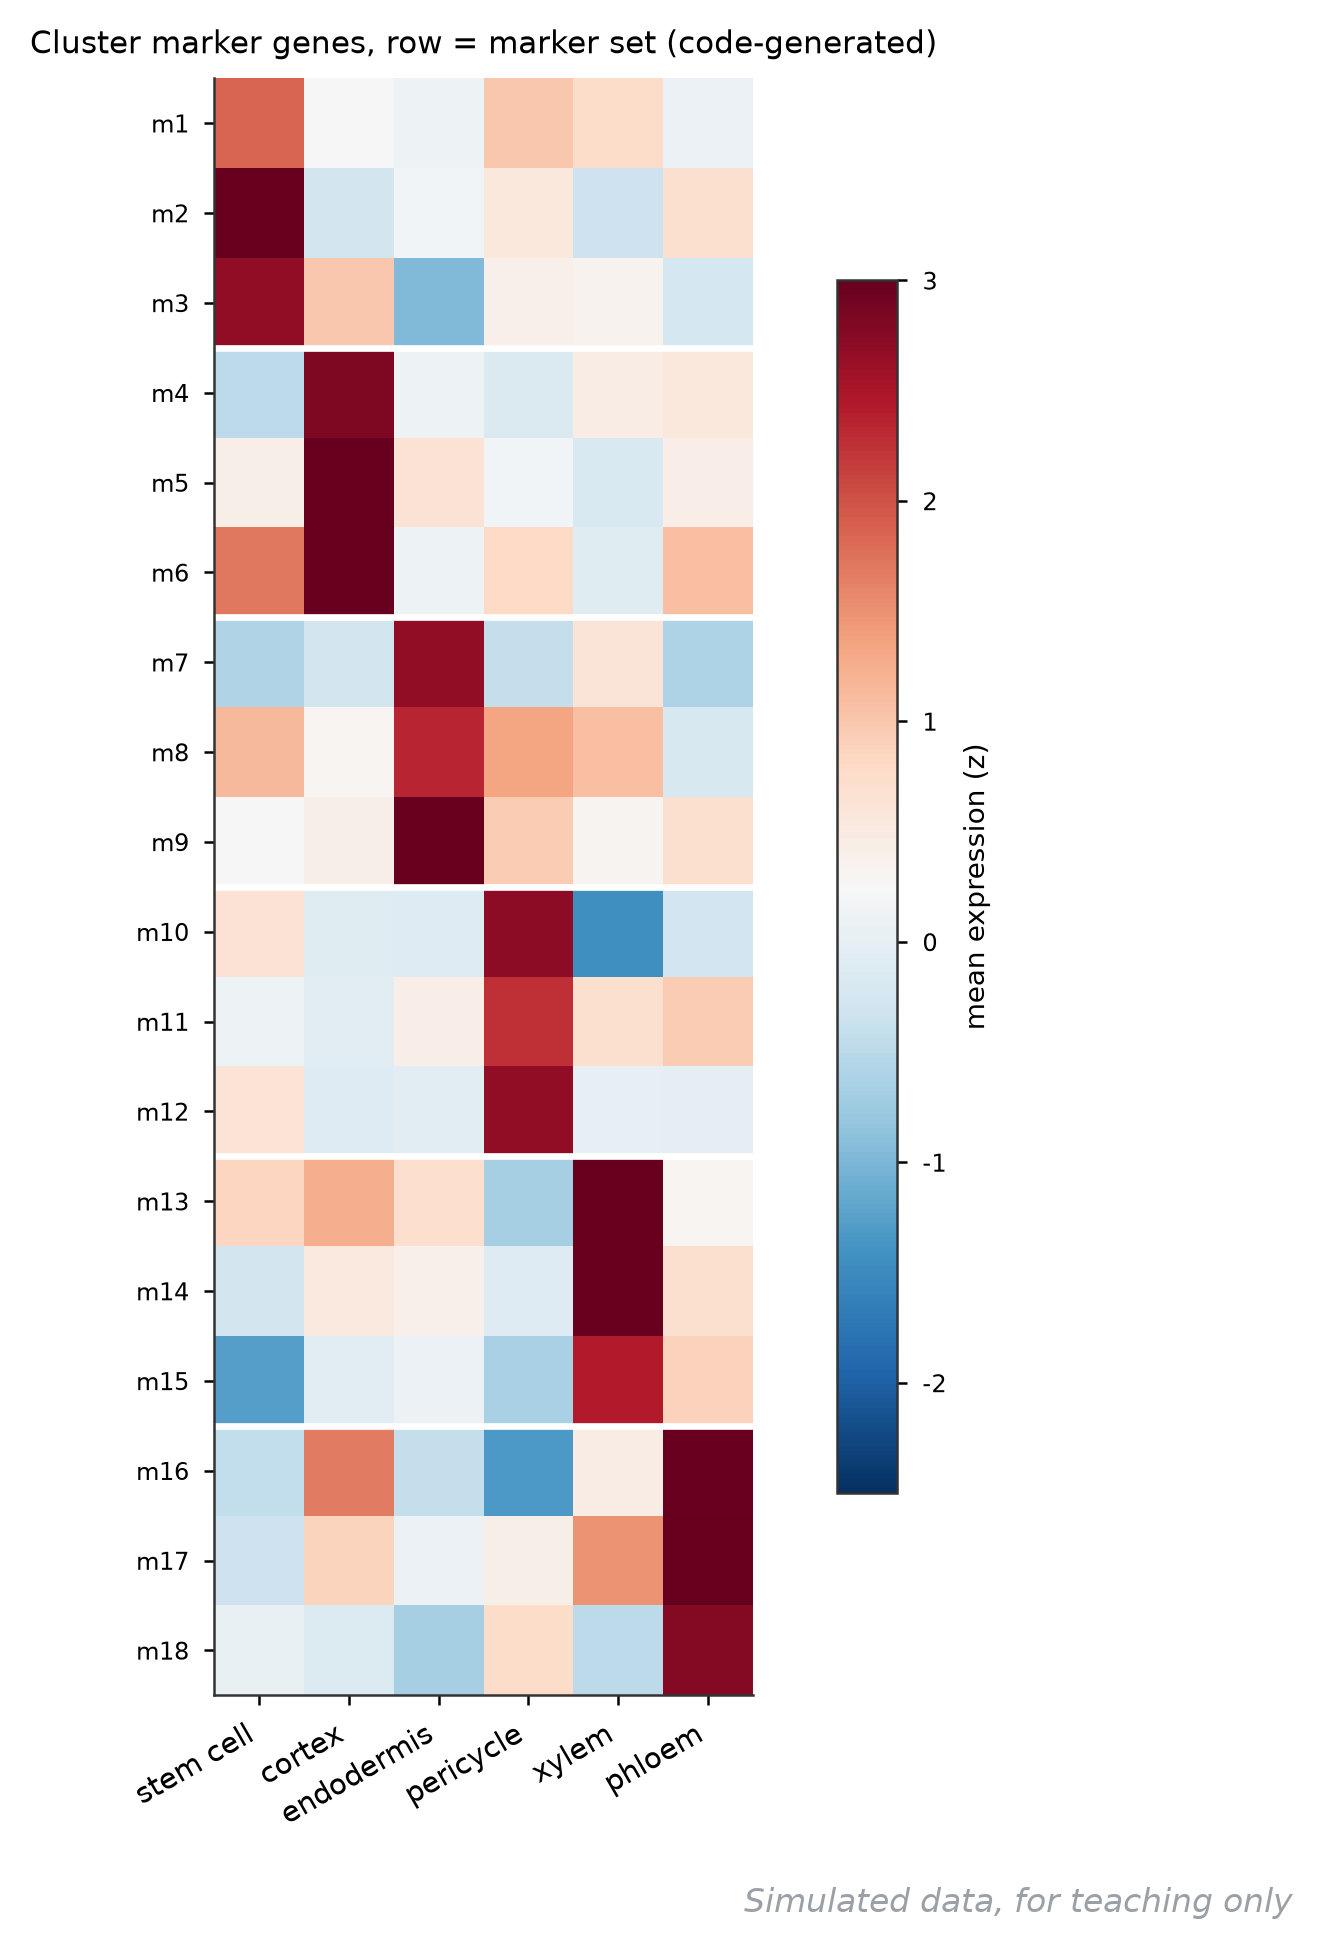
它回答什么问题:每个细胞群的 marker 基因是不是「真marker」——聚类结果的身份证:对角线亮、其余暗,说明群与基因一一咬合;不咬合的行混着跨群信号,就是注释要返工的地方。
怎么读:18 行 = 6 群各 3 个 marker,6 列 = 细胞群,颜色是平均表达的 z 值(红高蓝低),白色横线分隔基因块。理想形态是干净的「对角条纹」:每个 marker 只在自己的群里亮(z > 2)。读三处:对角线是否有断档(本例 6 块齐全);非对角线上的暗红杂讯(z 在 0.5-1 的跨群低表达是常态,别过度解读);以及整行全灰的 marker——它在哪个群都不特异,换。
用什么画:scanpy 的 sc.pl.heatmap 或 dotplot;重绘对 z 值矩阵 imshow 加白色分隔线。
图注示例:
图 100 六个细胞群各 3 个 marker 基因的平均表达热图(模拟,z 值)。行按群分组(白色分隔线),对角线区块 z 值大于 2,非对角区块接近背景,支持当前聚类注释。
展开查看:完整绘图代码(含数据生成)
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(2100)
clusters = ["stem cell", "cortex", "endodermis", "pericycle", "xylem",
            "phloem"]
genes = ["m%d" % (i + 1) for i in range(18)]
Z = rng.normal(0, 0.55, (18, 6))
for k in range(6):
    Z[k * 3:(k + 1) * 3, k] += rng.uniform(2.1, 2.9)
Z += rng.normal(0.25, 0.2, (18, 6))
fig, ax = plt.subplots(figsize=(7.2, 7.0))
im = ax.imshow(Z, cmap="RdBu_r", vmin=-2.5, vmax=3)
ax.set_xticks(range(6), clusters, rotation=30, ha="right", fontsize=9)
ax.set_yticks(range(18), genes, fontsize=7.5)
for k in range(1, 6):
    ax.axhline(k * 3 - 0.5, color="white", lw=1.6)
ax.grid(False)
ax.set_title("Cluster marker genes, row = marker set (code-generated)")
fig.colorbar(im, ax=ax, shrink=0.75, label="mean expression (z)")
fig.savefig("100-markers.png", dpi=200, bbox_inches="tight")7.4 细胞通讯圈图(CellChat 风格)#
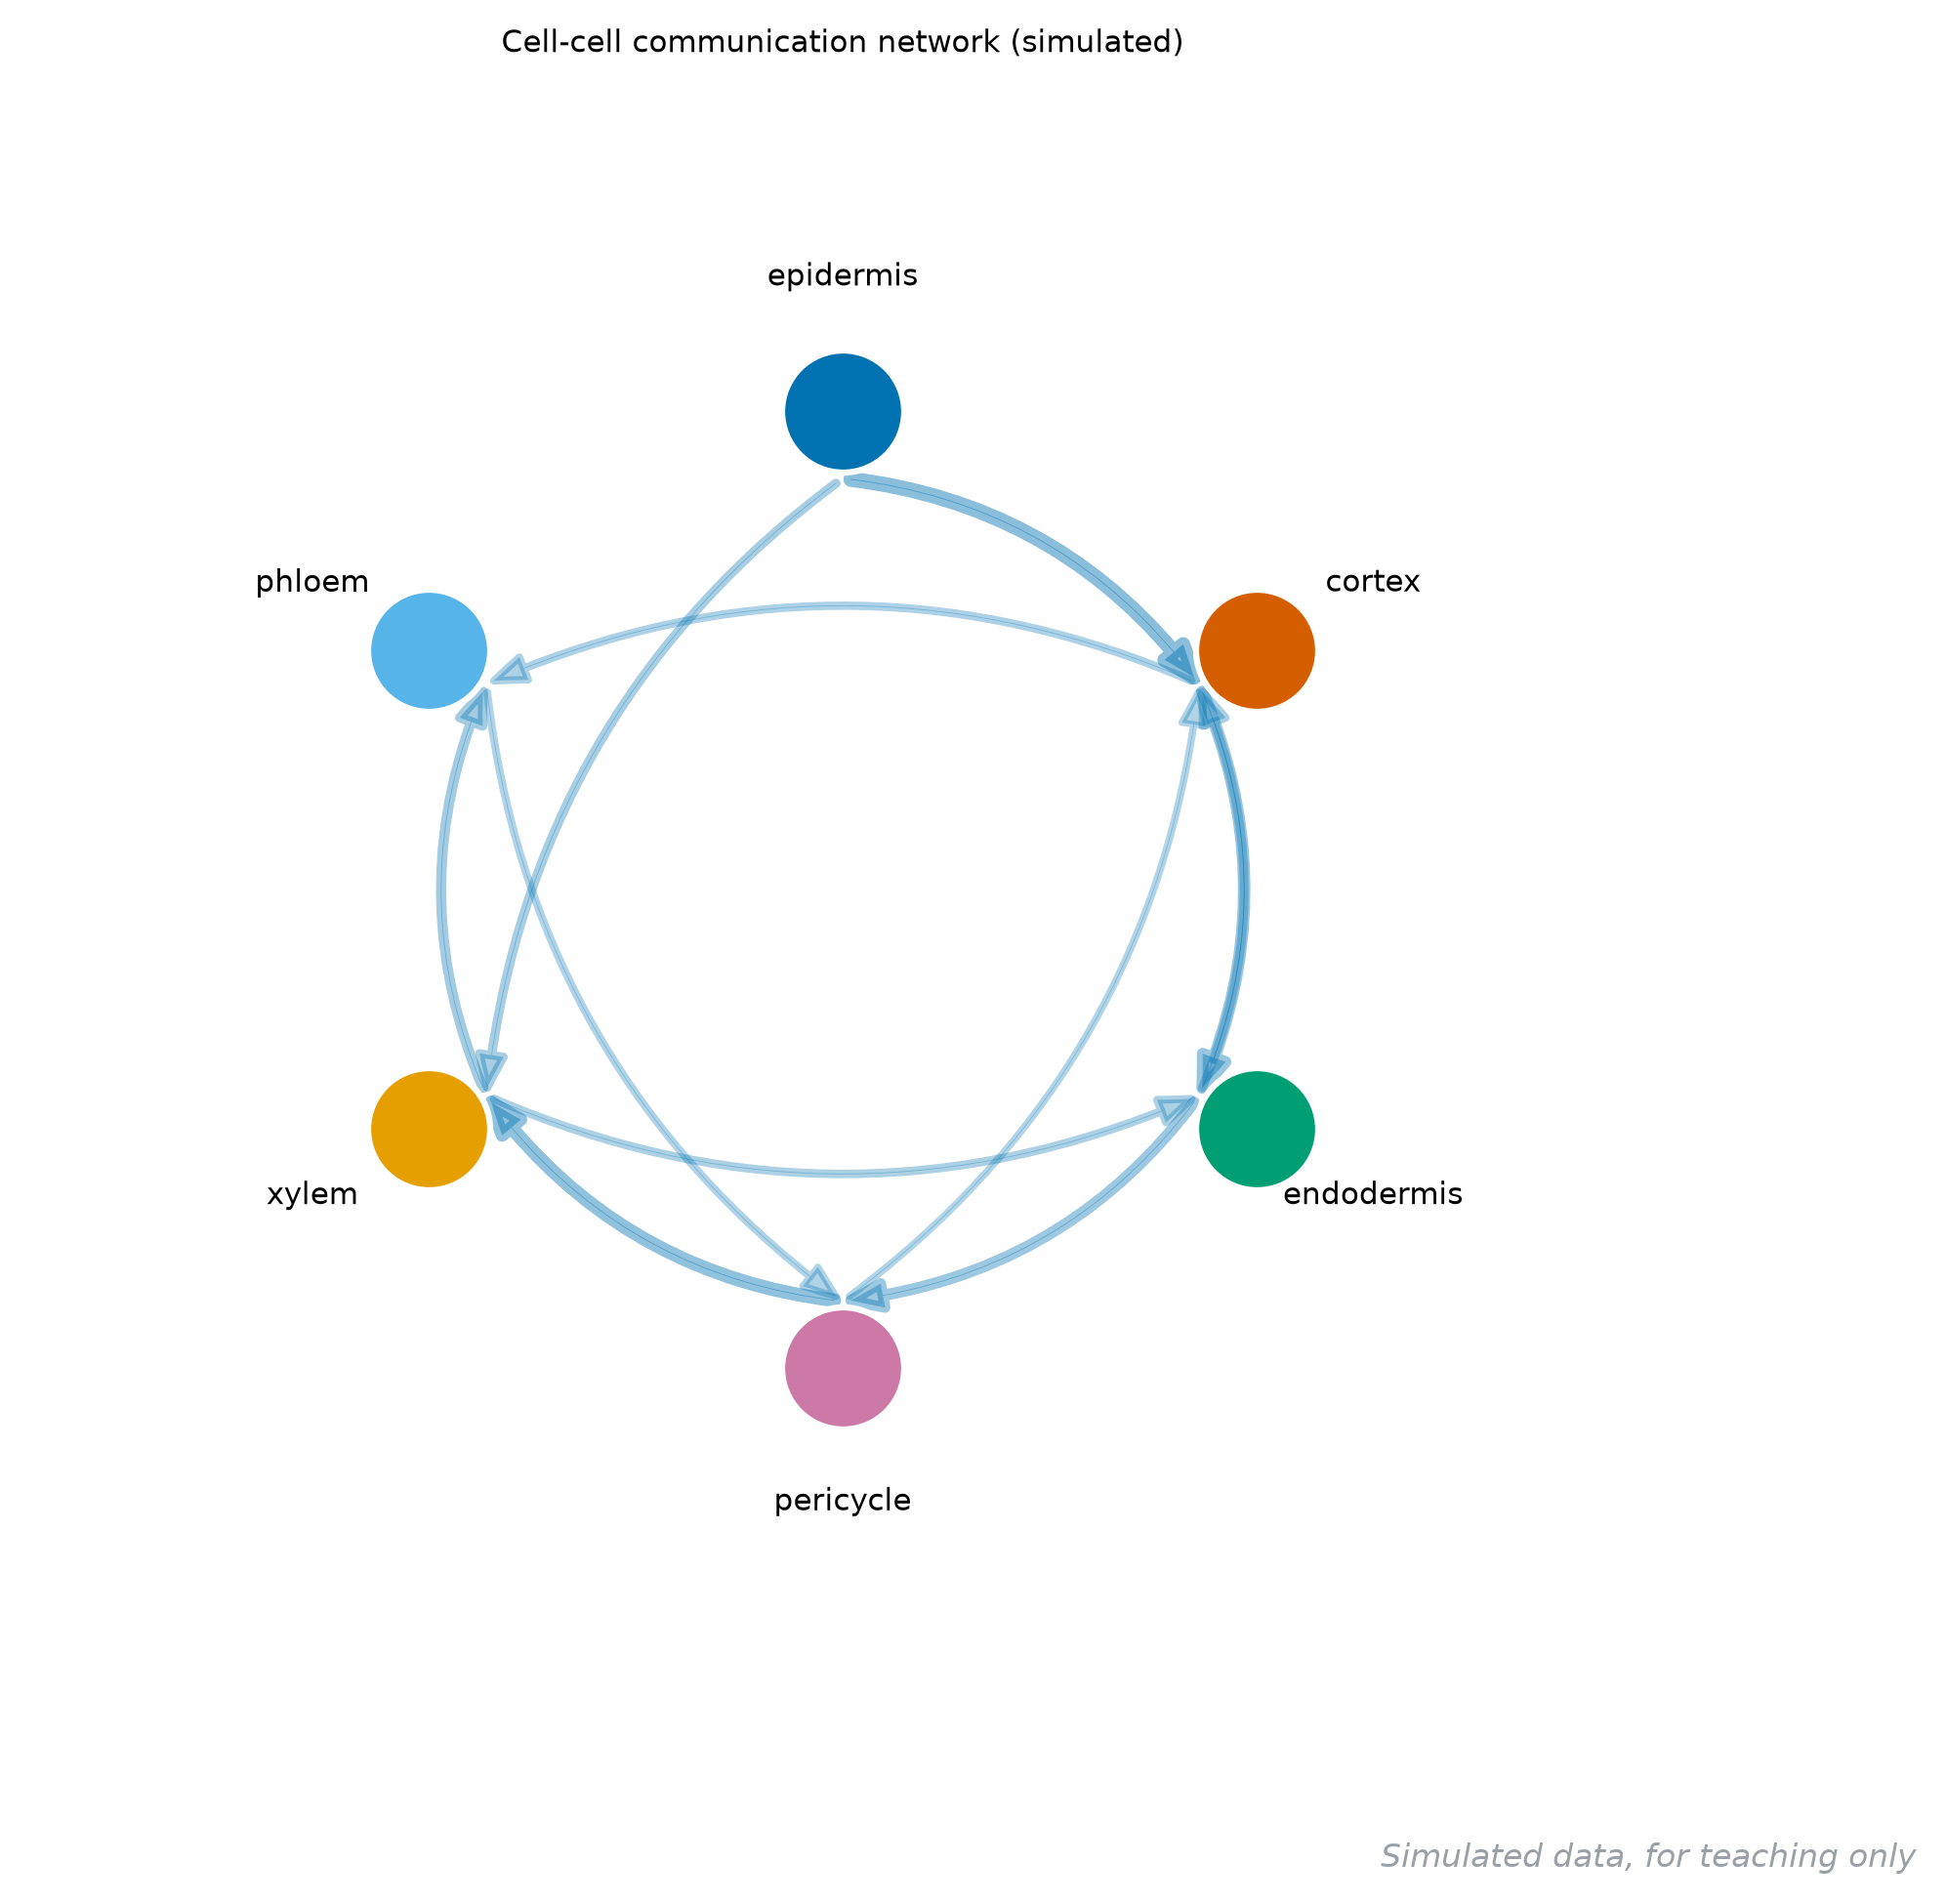
它回答什么问题:细胞群之间谁在给谁发信号——配受体推断后把「通讯流」画成环上的加权箭头,是 CellChat 的招牌输出,一张图讲完整个对话网络。
怎么读:六个圆是细胞群,箭头从信号发出群指向接收群,箭头宽度与颜色深浅正比通讯概率。读三样:最粗的箭头(表皮→皮层 0.42,PSK 通路)是网络主干;把同一通路的多条箭头并排看(CLE 通路连了皮层→内皮层→中柱鞘一条线,像接力);只进不出的群(皮层收 4 发 1)是信号中心,只出不进的(表皮)是传感哨兵。图注必须写推断依据是配受体表达、不是实测互作。
用什么画:CellChat 的 netVisual_circle;重绘按边表画弧形箭头,宽度映射概率。
图注示例:
图 101 根尖六个细胞群的通讯网络(模拟)。箭头由信号发送群指向接收群,宽度与透明度正比通讯概率;主干通路为表皮向皮层的 PSK 信号(0.42),皮层为最大信号接收方。
展开查看:边表与绘图代码
source,target,prob,pathway
epidermis,cortex,0.42,PSK
epidermis,xylem,0.18,EPF
cortex,endodermis,0.31,CLE
cortex,phloem,0.14,PSK
endodermis,pericycle,0.27,CLE
pericycle,xylem,0.36,TDIF
xylem,phloem,0.22,CLE
phloem,pericycle,0.12,PSK
endodermis,cortex,0.16,IDA
pericycle,cortex,0.10,IDA
xylem,endodermis,0.15,TDIF绘图代码(Python,独立可运行)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.patches import FancyArrowPatch

df = pd.read_csv("101-ccc-edges.csv")
groups = list(dict.fromkeys(df.source.tolist() + df.target.tolist()))
ang = np.linspace(90, 90 - 360, len(groups), endpoint=False)
pos = {g: (np.cos(np.deg2rad(a)), np.sin(np.deg2rad(a)))
       for g, a in zip(groups, ang)}
CAT = ["#4C72B0", "#DD8452", "#55A868", "#C44E52", "#8172B3", "#937860"]
fig, ax = plt.subplots(figsize=(7.6, 7.0))
ax.set_aspect("equal")
ax.axis("off")
for _, r in df.iterrows():
    (x0, y0), (x1, y1) = pos[r.source], pos[r.target]
    rad = 0.22 if np.cross([x0, y0, 0], [x1, y1, 0])[2] > 0 else -0.22
    ax.add_patch(FancyArrowPatch((x0 * 0.86, y0 * 0.86),
                                 (x1 * 0.86, y1 * 0.86),
                                 connectionstyle="arc3,rad=%.2f" % rad,
                                 arrowstyle="simple,head_length=8,head_width=6",
                                 color=CAT[0], alpha=0.25 + 0.5 * r.prob,
                                 lw=1 + 6 * r.prob, zorder=1))
for g, (x, y) in pos.items():
    ax.scatter([x], [y], s=900, color=CAT[groups.index(g)], zorder=3,
               edgecolors="white", linewidths=1.5)
    ax.text(x * 1.28, y * 1.28, g, ha="center", va="center", fontsize=9.5)
ax.set_xlim(-1.7, 1.7)
ax.set_ylim(-1.6, 1.7)
ax.set_title("Cell-cell communication network (simulated)")
fig.savefig("101-ccc-circle.png", dpi=200, bbox_inches="tight")7.5 配体-受体通讯气泡图#
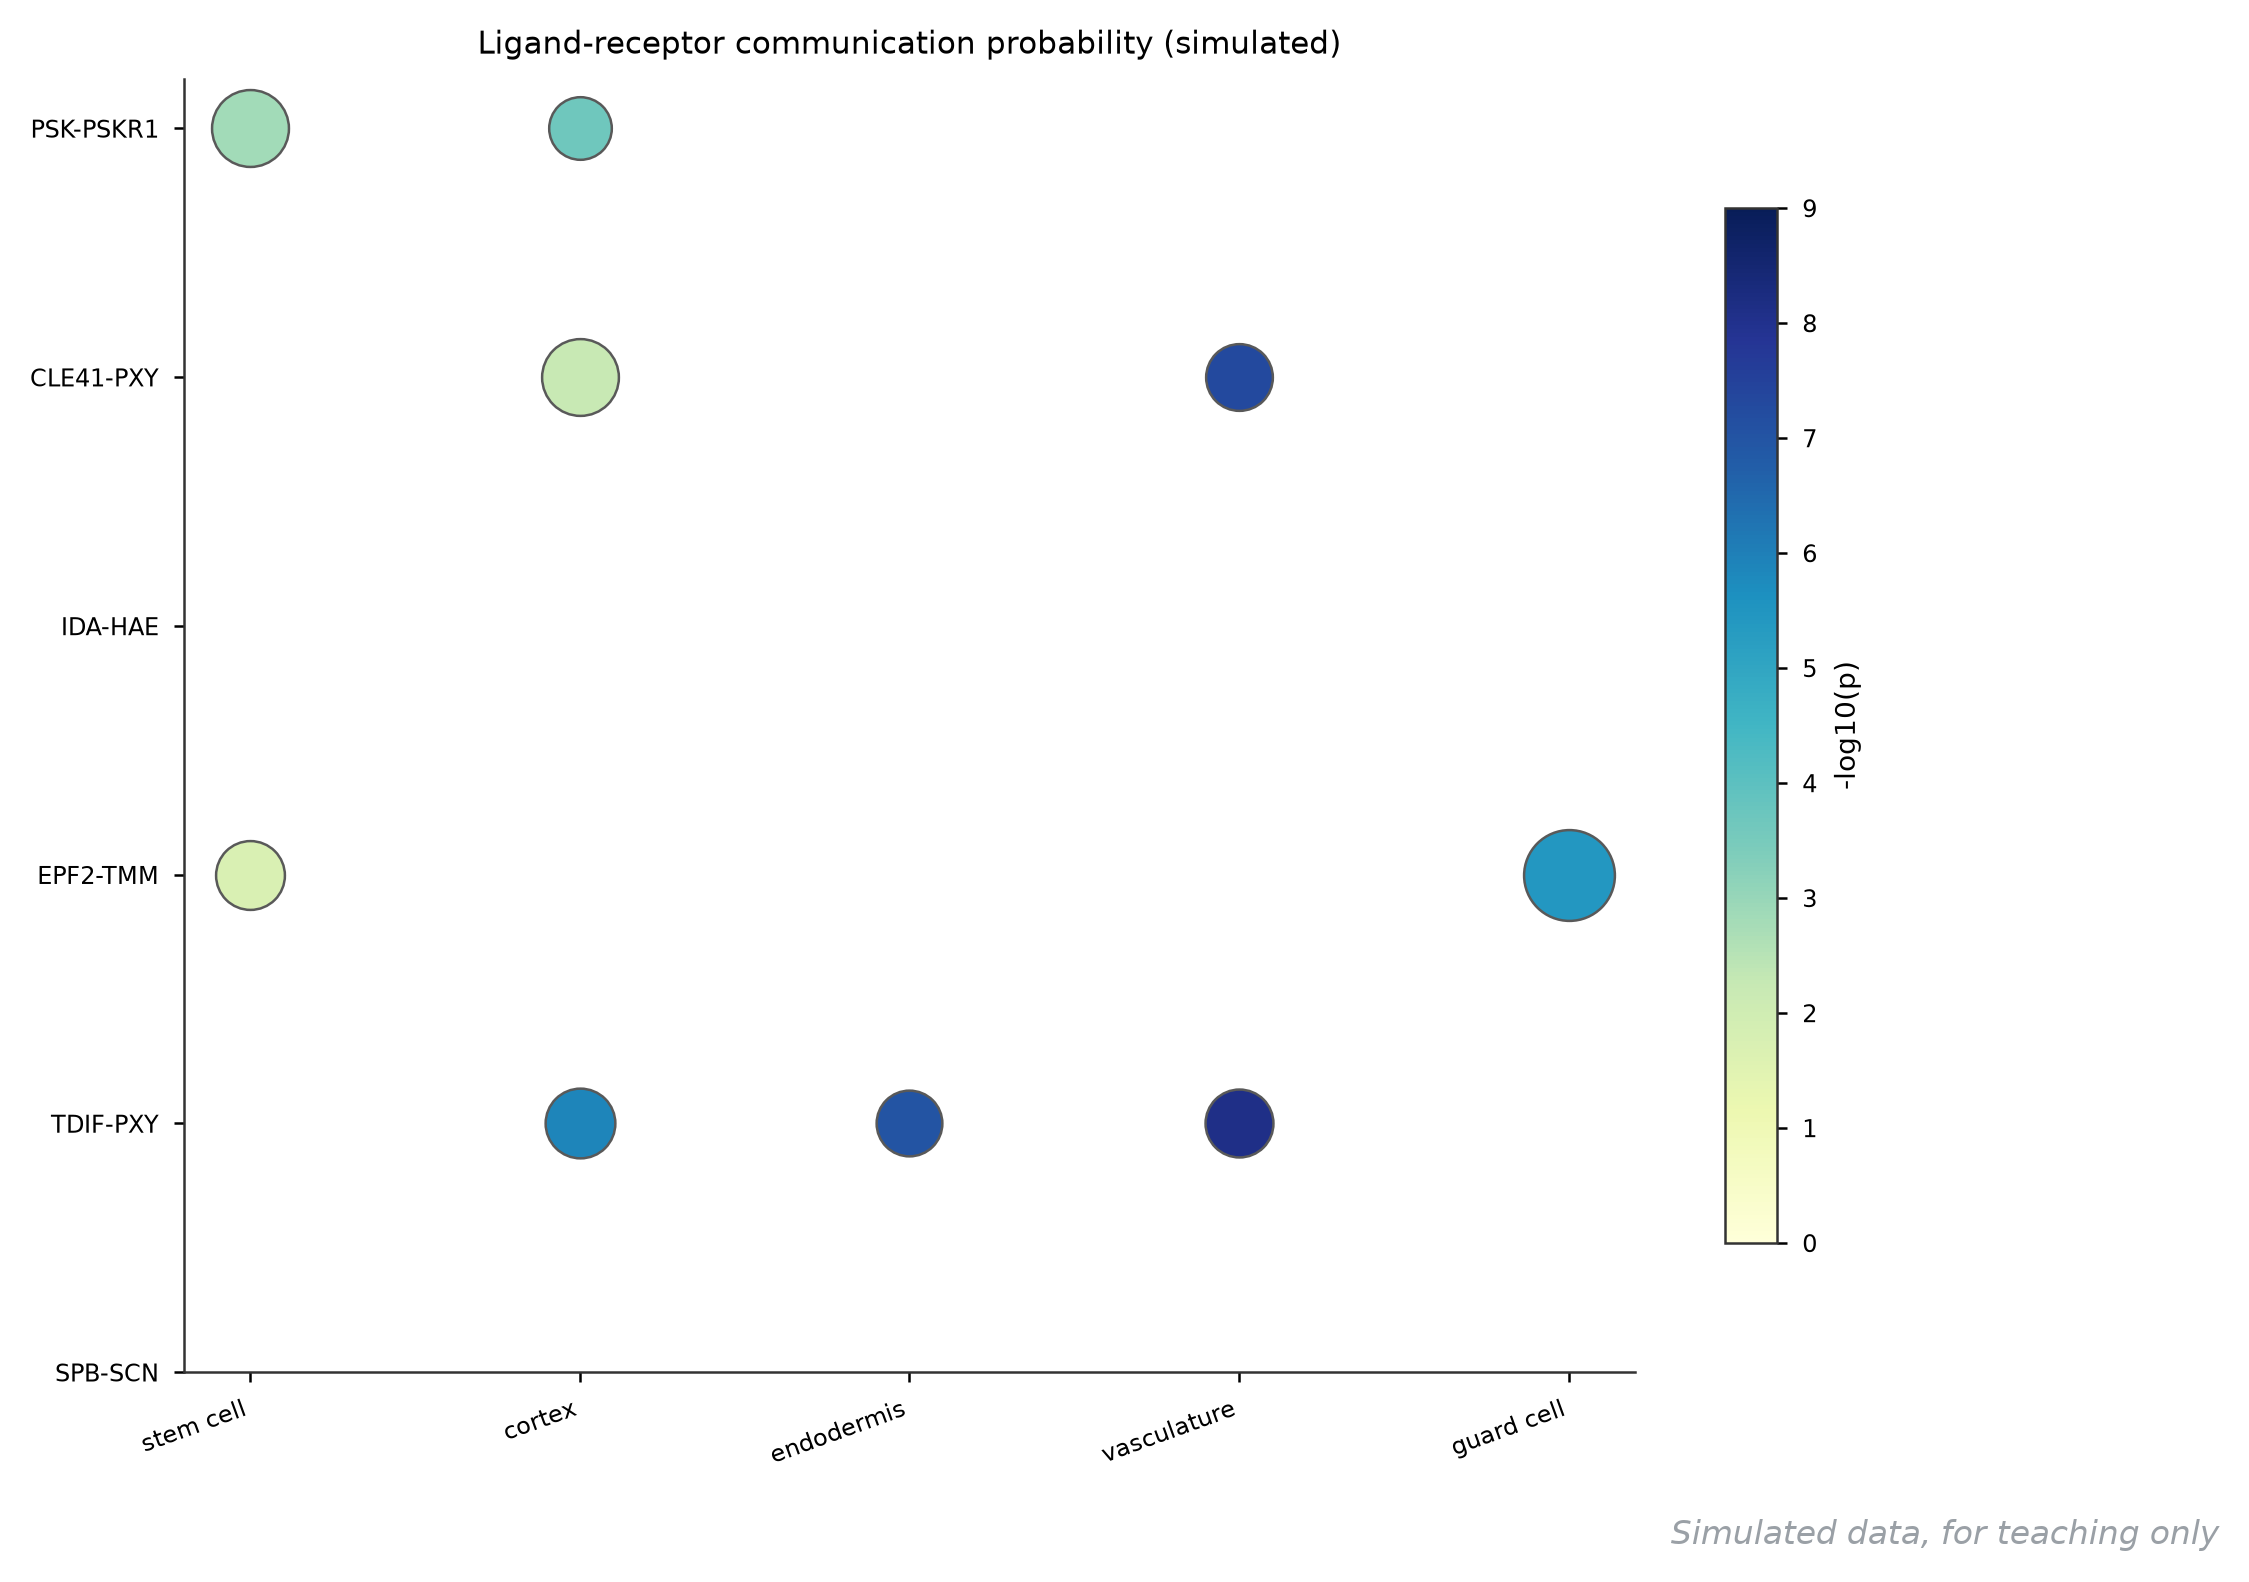
它回答什么问题:具体到「哪一对配受体在哪个靶细胞群里最强」——圈图讲全局,气泡图讲细节,CellChat 两个图永远一起出。
怎么读:每行一条配受体对,每列一个靶细胞群。气泡双重编码:面积=通讯概率,颜色=-log10(p)。扫描「大而深」:EPF2-TMM 在 guard cell(概率 0.74,p 峰值 5.4)和 TDIF-PXY 在 vasculature(0.42,p 最强 8.1)是各自行的定点投放;灰点(-log10 p = 0)是不显著,画出来只为保持网格完整。若某行所有气泡都很小,说明这条通路整体弱,删掉不心疼。
用什么画:CellChat 的 netVisual_bubble;重绘对长表做双重编码散点。
图注示例:
图 102 六条配受体对在五个靶细胞群的通讯气泡图(模拟)。气泡面积为通讯概率,颜色为 -log10(p),灰色为不显著;EPF2-TMM 在 guard cell(0.74)与 TDIF-PXY 在 vasculature(0.42)为最强定点通讯。
展开查看:气泡数据与绘图代码
pair,cluster,prob,neglog10p
PSK-PSKR1,stem cell,0.53,2.8
PSK-PSKR1,cortex,0.35,3.7
CLE41-PXY,stem cell,0.24,0.0
CLE41-PXY,cortex,0.53,2.2
CLE41-PXY,vasculature,0.40,7.3
IDA-HAE,cortex,0.27,0.0
EPF2-TMM,stem cell,0.43,1.7
EPF2-TMM,endodermis,0.22,0.0
EPF2-TMM,guard cell,0.74,5.4
TDIF-PXY,cortex,0.44,5.9
TDIF-PXY,endodermis,0.39,7.0
TDIF-PXY,vasculature,0.42,8.1
SPB-SCN,stem cell,0.22,0.0
SPB-SCN,endodermis,0.23,0.0绘图代码(Python,独立可运行)
import pandas as pd
import matplotlib.pyplot as plt

df = pd.read_csv("102-lr-bubble.csv")
pairs = list(dict.fromkeys(df["pair"]))
clusters = list(dict.fromkeys(df.cluster))
fig, ax = plt.subplots(figsize=(7.8, 5.6))
for _, r in df.iterrows():
    if r.neglog10p > 0.5:
        ax.scatter(clusters.index(r.cluster), pairs.index(r["pair"]),
                   s=r.prob * 640, c=r.neglog10p, cmap="YlGnBu",
                   vmin=0, vmax=9, edgecolor="0.35", linewidth=0.6, zorder=3)
ax.set_xticks(range(len(clusters)), clusters, rotation=20, ha="right")
ax.set_yticks(range(len(pairs)), pairs)
ax.invert_yaxis()
sm = plt.cm.ScalarMappable(cmap="YlGnBu", norm=plt.Normalize(0, 9))
fig.colorbar(sm, ax=ax, shrink=0.8, label="-log10(p)")
ax.set_title("Ligand-receptor communication probability (simulated)")
fig.savefig("102-lr-bubble.png", dpi=200, bbox_inches="tight")7.6 空间转录组 spot 特征图#
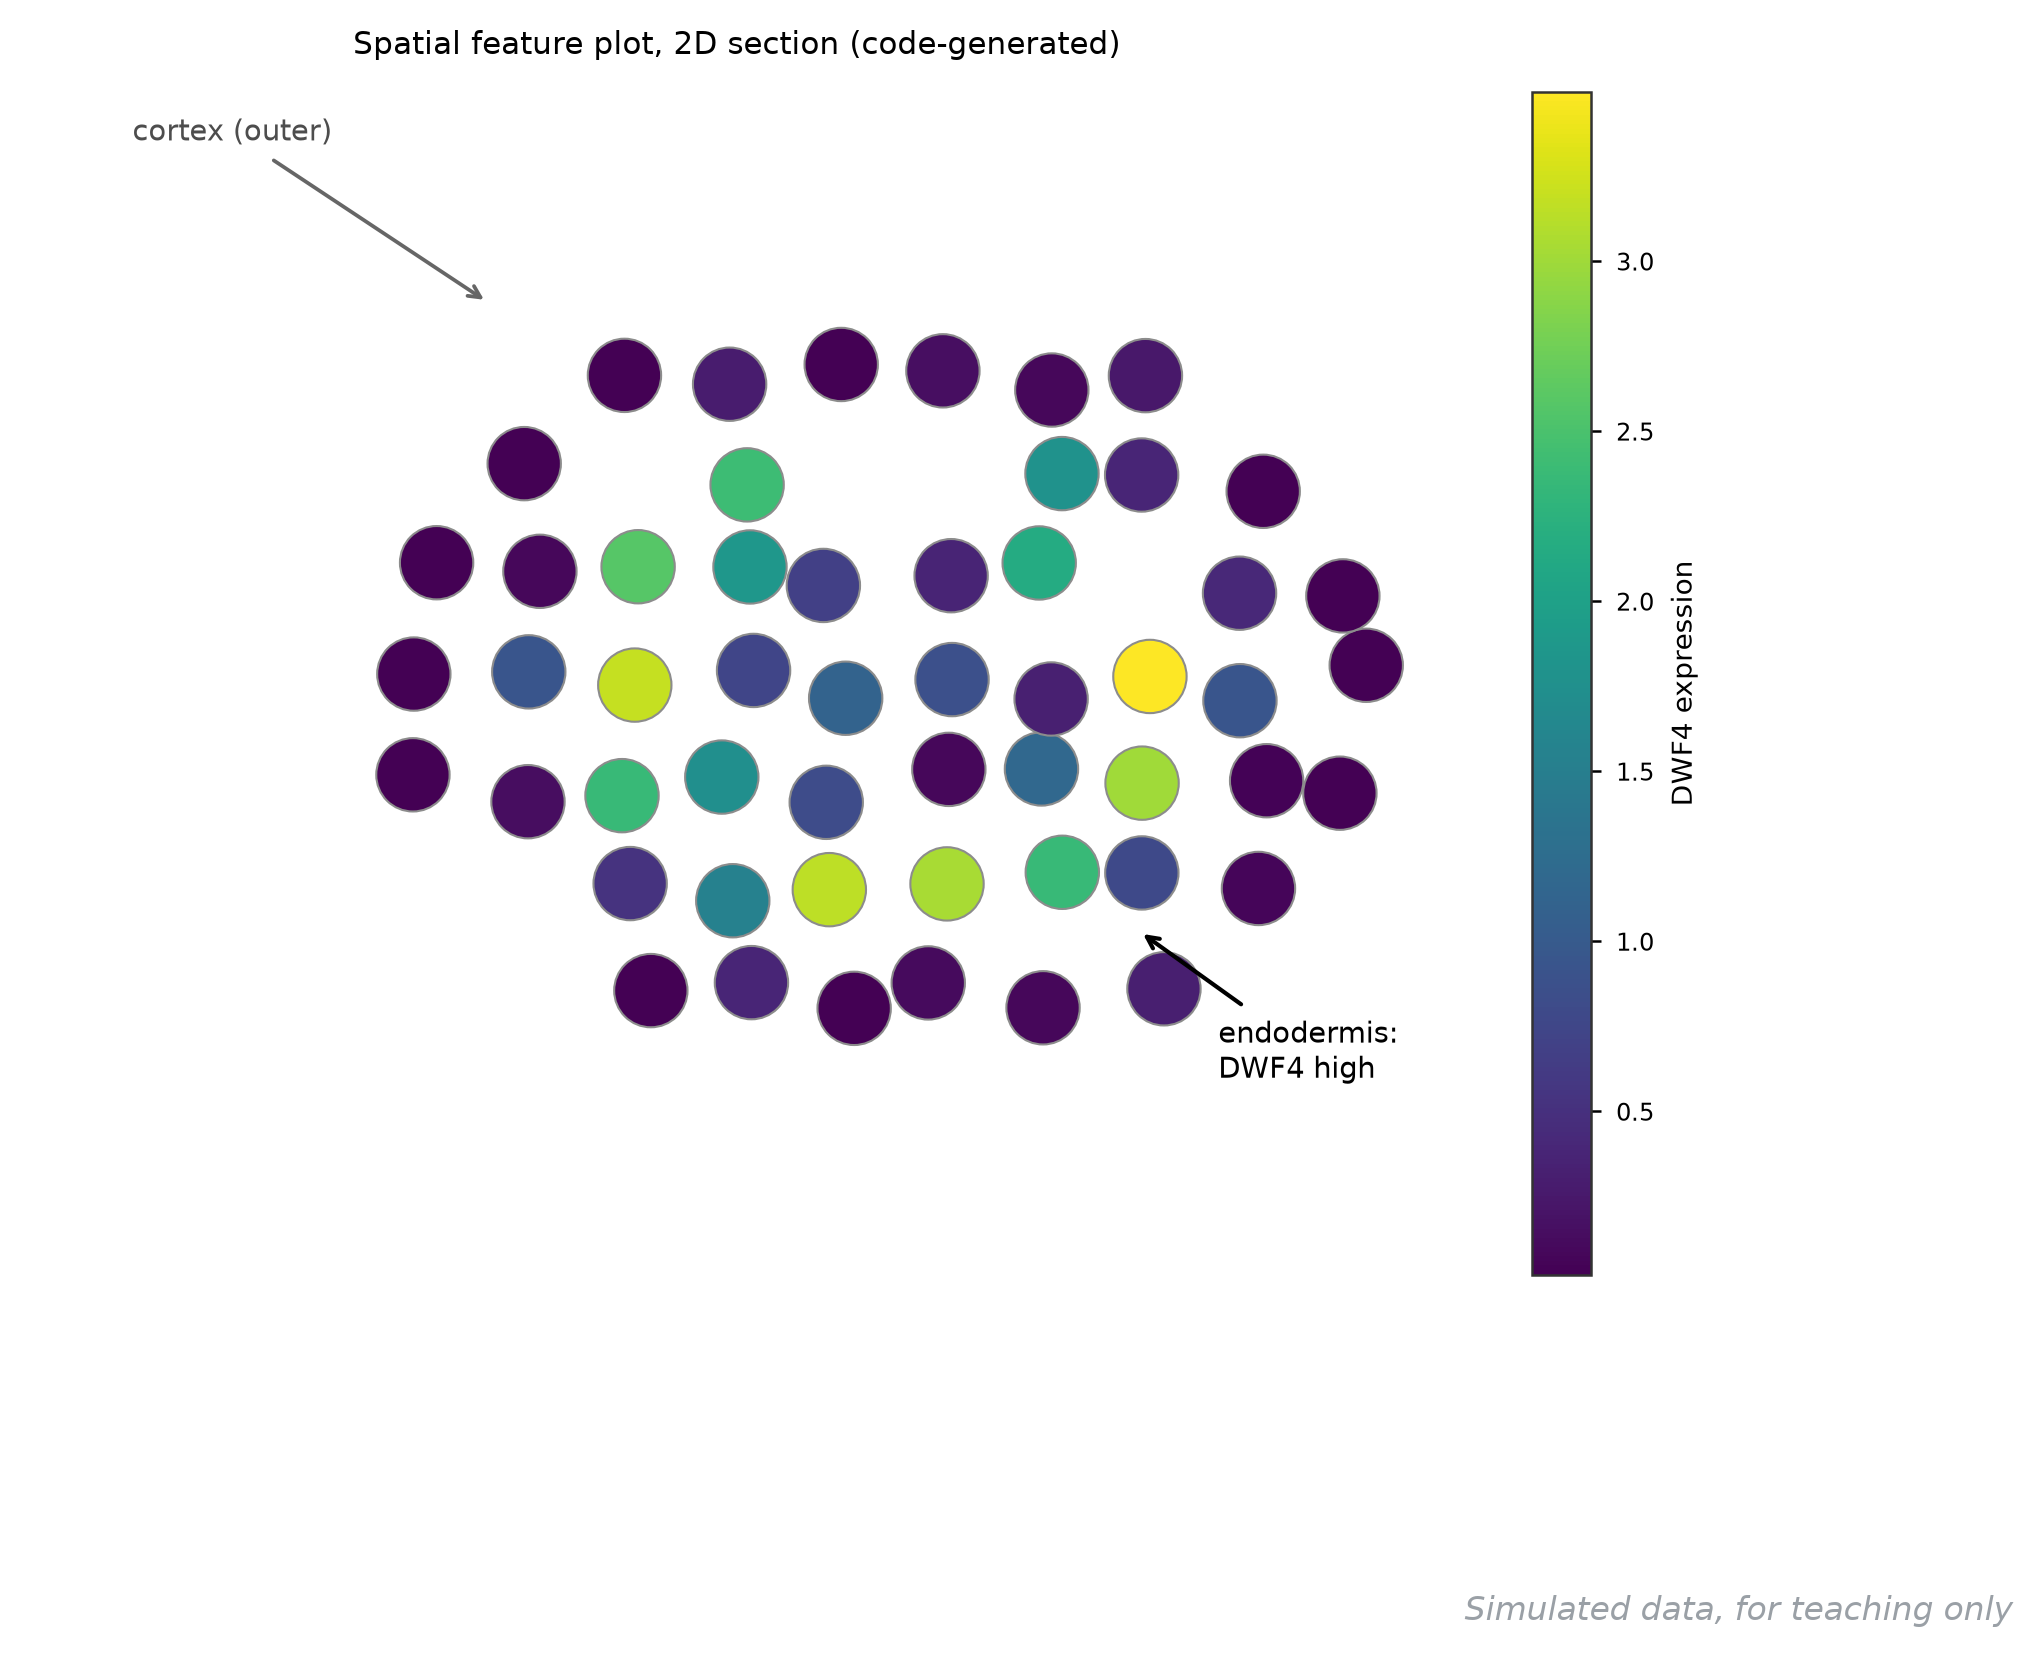
它回答什么问题:基因表达在组织切片的哪里高——单细胞图丢了坐标,空间转录组把它找回来:每个 spot(或像素)按组织位置摆放,颜色是表达量。
怎么读:每个圆是一个捕获 spot,按切片上的原始坐标摆放,颜色为 DWF4 表达。读两样:表达的空间结构(本例中柱外一圈内皮层高表达、外侧皮层与中心后生木质部低——激素合成基因在「环带」表达是根尖的典型模式)和结构的完整性(spot 网格的空洞是组织缺口或低质量 spot 被滤掉)。聚类分析(BayesSpace/GraphST)就是在这些 spot 的颜色模式上做的。
用什么画:Seurat 的 SpatialFeaturePlot、Squidpy;重绘按 spot 坐标表散点上色。
图注示例:
图 103 根尖横切的空间转录组特征图,DWF4 表达(模拟,约 150 个 spot)。spot 按切片坐标摆放,颜色为表达量;高表达集中于内皮层环带,皮层与中柱中心接近背景。
展开查看:完整绘图代码(含数据生成)
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(2103)
pts = []
for gx in range(16):
    for gy in range(11):
        x = gx + rng.uniform(-0.18, 0.18)
        y = gy + rng.uniform(-0.18, 0.18)
        r = np.hypot(x - 7.5, (y - 5.0) * 1.35)
        if r < 4.9 and rng.uniform() > 0.06:
            e = (np.exp(-0.5 * ((r - 2.6) / 0.55) ** 2) * 3.1
                 + np.exp(-0.5 * ((r - 0.4) / 0.5) ** 2) * 1.2
                 + rng.normal(0, 0.18))
            pts.append((x, y, max(e, 0.02)))
fig, ax = plt.subplots(figsize=(7.6, 6.4))
xs, ys, es = zip(*pts)
sc = ax.scatter(xs, ys, s=310, c=es, cmap="viridis", edgecolors="0.55",
                linewidths=0.5)
ax.annotate("cortex (outer)", xy=(3.6, 8.7), xytext=(0.1, 10.3), fontsize=9,
            color="0.3", arrowprops=dict(arrowstyle="->", lw=0.9, color="0.4"))
ax.annotate("endodermis:\nDWF4 high", xy=(9.9, 2.6), xytext=(10.7, 1.15),
            fontsize=9, arrowprops=dict(arrowstyle="->", lw=1))
ax.set_aspect("equal")
ax.set_xlim(-0.9, 12.9)
ax.set_ylim(-0.9, 10.9)
ax.axis("off")
ax.set_title("Spatial feature plot, 2D section (code-generated)")
fig.colorbar(sc, ax=ax, shrink=0.8, label="DWF4 expression")
fig.savefig("103-spatial.png", dpi=200, bbox_inches="tight")八、写到第三篇为止#
到这里三篇合计 103 张图,从一张柱状图走到了组织的空间地图。本篇全部脚本在仓库 tools/bio-plots/ch10a_more.py 与 ch10b_more.py,随机种子固定,跑出来的图与文中一致。最后一块拼图在第四篇:蛋白与分子互作、生化曲线、微生物生态、代谢质谱,以及深度学习归因、蛋白语言模型这些新技术的图。
参考文献#
- Ewels P, et al. MultiQC: summarize analysis results for multiple tools and samples in one report. Bioinformatics, 2016.
- Li H, Durbin R. Fast and accurate short read alignment with Burrows-Wheeler transform (BWA). Bioinformatics, 2009.
- DePristo MA, et al. A framework for variation discovery and genotyping using next-generation DNA sequencing data (GATK). Nature Genetics, 2011.
- Broman KW, et al. R/qtl: QTL mapping in experimental crosses. Bioinformatics, 2003.
- Rao SSP, et al. A 3D map of the human genome at kilobase resolution reveals principles of chromatin looping (Hi-C). Cell, 2014.
- La Manno G, et al. RNA velocity of single cells. Nature, 2018.
- Jin S, et al. Inference and analysis of cell-cell communication using CellChat. Nature Communications, 2021.
- Ståhl PL, et al. Visualization and analysis of gene expression in tissue sections by spatial transcriptomics. Science, 2016.
参考代码#
- 本文 29 张图的绘图脚本:仓库
tools/bio-plots/ch10a_more.py、ch10b_more.py,逐图独立、随机种子固定; - Linxira Bio SDK ↗(GitHub)· 官网 ↗:
fastq qc、alignment qc、alignment coverage、variant stats、structure pdb --alphafold-plddt等命令即本篇测序 QC、变异与结构图的直接上游(以正式分支最新 release 为准); - 工具链架构细节见拆解文:拆 Bio SDK:一个”不生成脚本”的本地生信工具链是怎么搭的。
原文存档:本文初版发布于旧站(Butterfly 主题)。如遇图表、代码高亮或 3D 交互显示异常,请查阅 完整存档版。